Per la scelta tra Muse Wonder e ChatGPT, opta per ChatGPT se desideri uno spazio di lavoro integrato; prova invece Muse Wonder se cerchi un altro modello professionale per la correzione del codice e l'analisi basata sul codice sorgente. Muse Wonder si è guadagnata quel posto nei nostri test di produzione: i modelli selezionati hanno superato 29 controlli indipendenti. Questi risultati costituiscono una selezione pratica, piuttosto che una classifica universale di qualità.
La prima scelta riguarda ciò che si sta acquistando. Muse Wonder è un modello con diverse modalità di accesso. ChatGPT è un’applicazione il cui modello, gli strumenti e il limite di utilizzo dipendono dalla superficie e dal piano. Per gli sviluppatori, il confronto utile a livello di modello è tra Wonder e GPT-6.1 Sol o GPT-6 Astra. Per il lavoro quotidiano, l’applicazione che ruota attorno al modello può avere la stessa importanza.
Riutilizziamo i risultati ottenuti dal nostro Recensione di Muse Wonder, testato il 14 ottobre 2026. L'esempio di codice riportato di seguito presenta requisiti di identità espliciti. Per questo articolo abbiamo aggiornato le fonti ufficiali relative ai prodotti e ai prezzi; non è stato eseguito alcun nuovo benchmark ChatGPT. Questo confronto è pubblicato da GlobalGPT, dove sono stati completati i test su Muse.
Se desideri confrontare le risposte dei modelli prima di optare per un flusso di lavoro separato, apri Muse Wonder su GlobalGPT e porta un compito con una soluzione che tu possa controllare.
Muse Wonder vs ChatGPT: il confronto a colpo d'occhio
Scegli un'area di lavoro
ChatGPTProgetti, file e strumenti raggruppati, con disponibilità in base al piano.
Prova un altro modello
Muse WonderCodice promettente e gestione del codice sorgente nei nostri esempi di produzione selezionati.
Sviluppare con un'API
Confronta gli ID esattiDa notare che GPT-6.1 Sol e Astra hanno tariffe e modalità di accesso diverse.
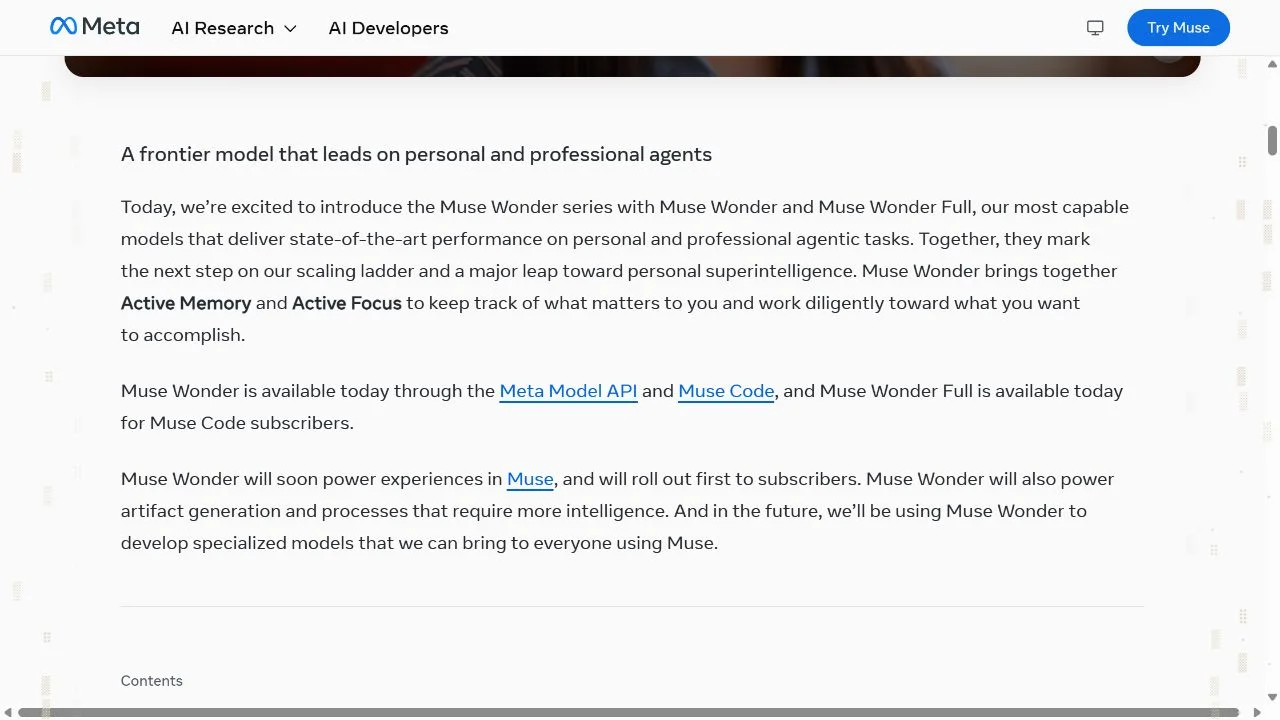
Quelli di Meta Annuncio del lancio di Muse Wonder distingue la versione standard di Wonder, disponibile tramite l’API Meta Model e Muse Code, da Wonder Full, riservata agli abbonati a Muse Code. Descrive il lancio di Muse per i consumatori come un’iniziativa riservata innanzitutto agli abbonati. L’accesso a una delle due opzioni non implica la disponibilità di tutte le funzionalità accessibili tramite l’altra.
OpenAI documentazione attuale relativa al modello ChatGPT raccomanda GPT-6.1 Sol per attività complesse di programmazione e di gestione degli agenti, quando disponibile, e Astra per i compiti end-to-end più impegnativi. Colloca esplicitamente GPT-6.1 Sol nelle categorie “Work” e “Codex”, anziché in “Chat”. La sola etichetta “ChatGPT” è quindi troppo vaga per consentire un confronto riproducibile.
Confronta lo strato che conta davvero
Denominazione esatta del modello, prompt, impostazioni di ragionamento e output accettato.
File, progetti, integrazioni, autorizzazioni per gli strumenti e un prodotto finale.
Costo dell'abbonamento o dell'utilizzo dell'API, più i tentativi di ripetizione e il tempo dedicato alla revisione manuale.
Per quanto riguarda il GPT, il nostro Confronto tra GPT-6.1 Sol e GPT-6 Astra fornisce una regola di partenza utile: valutare Sol in termini di valore, poi optare per Astra laddove le funzionalità aggiuntive giustificano il prezzo. L’articolo mette a confronto specifiche e scenari di costo; non fornisce risultati comparativi per lo stesso prompt rispetto a Muse Wonder.
Programmazione: cosa emerge dai risultati di Muse Wonder
Il nostro test su Muse è iniziato con una funzione JavaScript di deduplicazione che trattava allo stesso modo lo zero, il valore false e gli ID assenti. Il follow-up selezionato ha reso esplicita l’identità di Symbol, object, function e BigInt. Muse Wonder ha restituito un’implementazione compatta che converte le stringhe in minuscolo e conserva gli altri valori direttamente in un Set.
Test di verifica della correzione del codice per lo stesso task 'uniqueById'. Restituisci una funzione JavaScript eseguibile corretta, una breve spiegazione ed esattamente cinque test in stile 'assert'. Non dichiarare di aver eseguito i test.

Requisiti di accettazione:
- Mantieni l'ordine degli input e restituisci il primo record per ogni ID duplicato. Non modificare mai l'array o i record.
- I record il cui ID è assente, nullo o non definito vengono sempre mantenuti.
- Confrontare gli ID stringa senza distinzione tra maiuscole e minuscole. Mantenere distinti il numero 0, il valore booleano false e la stringa '0'.
- Mantieni l’identità degli ID in JavaScript: due valori distinti di Symbol('x') devono rimanere separati, la ripetizione dello stesso identico Symbol deve essere deduplicata e i valori ripetuti di Symbol.for('shared') devono essere deduplicati.
- Oggetti o funzioni diversi utilizzati come ID rimangono distinti; i riferimenti ripetuti vengono deduplicati. BigInt 1n e il numero 1 rimangono distinti.
- Utilizzare l’esempio originale [{id:0},{id:false},{id:'A'},{id:'a'},{name:'one'},{name:'two'}], mantenendo 0, false, la prima A ed entrambi i record privi di ID.

I cinque test forniti dovrebbero coprire l’esempio standard, gli ID mancanti/nulli, l’identità dei simboli, l’identità dei riferimenti agli oggetti e il confronto tra BigInt e numero. Utilizzare un’implementazione che preservi i valori anziché ridurre le identità distinte a chiavi testuali.
Se la copia automatica è disabilitata, seleziona il testo e premi Ctrl/Cmd+C.function uniqueById(records) {
const seen = new Set();
return records.filter((record) => {
// Absent, null, and undefined IDs are always kept.
if (record == null || record.id == null) {
return true;
}
const id = record.id;
// Normalize only strings for case-insensitive comparison.
// All other values are stored as-is, preserving their identity.
const key = typeof id === "string" ? id.toLowerCase() : id;
if (seen.has(key)) {
return false;
}
seen.add(key);
return true;
});
}Se la copia automatica è disabilitata, seleziona il testo e premi Ctrl/Cmd+C.Verifiche indipendenti del codice
13 / 13Ordine, identificatori mancanti, conservazione degli input, tipi distinti e identità.
Asserzioni fornite dal modello
5 superatiEseguito separatamente; non è stato aggiunto ai 29 controlli indipendenti.
Ambiente di test
GlobalGPTInserimento in Production Muse Wonder, impostazioni predefinite dell'interfaccia utente, 14 ottobre.
Il risultato è utile perché i criteri di accettazione sono concreti. Due simboli con la stessa descrizione rimangono distinti; l'uso ripetuto dello stesso simbolo comporta la deduplicazione. Gli oggetti e le funzioni mantengono l'identità di riferimento, e 1n rimane diverso da 1. La funzione mantiene inoltre l'ordine dei record e lascia inalterato l'input.
Questi controlli sono stati eseguiti nel nostro ambiente di verifica dopo che il modello ha restituito la risposta. Il modello non ha modificato alcun repository né ha dimostrato di aver eseguito i test autonomamente. L'interfaccia di produzione era contrassegnata come muse-wonder, senza alcun selettore che ne rivelasse il processo di ragionamento; la versione esatta del backend del provider non è stata verificata in modo indipendente.
Per un acquirente che si occupa di programmazione, ciò rende Muse Wonder un candidato credibile per una riparazione limitata. Ciò non significa che Wonder sia migliore di Sol o Astra in termini di migrazione del repository. Utilizza il Guida al miglior modello di IA per la programmazione per decidere quale modello concorrente e quale famiglia di attività valutare successivamente.
Ricerca e pianificazione: valutare la gestione delle prove
L'esempio sulla gestione delle fonti è particolarmente rilevante se si utilizza ChatGPT a fini di ricerca. Abbiamo fornito un breve pacchetto fittizio di Orion Agent contenente un vecchio annuncio, pagine ufficiali più recenti relative ai prezzi e allo stato del prodotto, nonché un'affermazione della comunità non supportata. Il risultato finale doveva risolvere il conflitto e preservare le informazioni mancanti.
Test di revisione di Muse Wonder 2: riconciliazione delle prove.
Utilizza esclusivamente questo pacchetto di fonti fittizio. Restituisci SOLO un JSON valido contenente le chiavi launch_date, plan_monthly_usd, api_input_per_million_usd, region_status, unresolved, citations. Ogni valore fattuale deve riportare i relativi ID di fonte in citations. Non calcolare silenziosamente la media delle contraddizioni né inventare fatti mancanti.

[S1] Annuncio del prodotto, datato 12-10-2026: Orion Agent lanciato il 12 ottobre. Piano Pro $19/mese. Disponibile negli Stati Uniti e nell’Unione Europea.
[S2] Pagina ufficiale dei prezzi, aggiornata il 14/10/2026: piano Pro $24/mese, fatturato mensilmente. Input API $4 per milione di token. L’output API non è indicato.
[S3] Pagina ufficiale di stato, aggiornata il 14-10-2026: accesso negli Stati Uniti operativo. Lancio nell’UE sospeso; nessuna data di ripresa fornita.
[S4] Post della community, datato 14/10/2026: Qualcuno afferma che il piano è di $12 e che l’UE funziona; nessun screenshot o link.

Preferire prove ufficiali più recenti per lo stesso campo. Elencare esplicitamente eventuali informazioni non risolte.
Se la copia automatica è disabilitata, seleziona il testo e premi Ctrl/Cmd+C.
{"data_di_lancio": "2026-10-12", "canone_mensile_in_USD": 24, "input_API_per_milione_di_USD": 4, "stato_regione": {"USA": "operativo", "UE": "sospeso"}, "irrisolti": ["Il prezzo di uscita dell’API non è riportato nelle fonti.", "La data di ripresa del lancio nell’UE non è stata fornita.", "Le affermazioni contrastanti non sono state utilizzate come base per i valori selezionati: S1 indicava il piano Pro a $19/mese e l’UE come disponibile, mentre la fonte non ufficiale e non supportata S4 sosteneva $12/mese e che l’UE funzionasse; si è preferito invece utilizzare le più recenti fonti ufficiali S2 e S3."], "citazioni": {"data_lancio": ["S1"], "piano_mensile_usd": ["S2"], "api_input_per_million_usd": ["S2"], "region_status": ["S3"]}}La risposta ha superato tutti e otto i controlli. Ha selezionato il prezzo mensile ufficiale più recente $24, ha mantenuto la data di lancio originale, ha contrassegnato la distribuzione nell’UE come sospesa e ha lasciato irrisolti il prezzo di output dell’API mancante e la data di riavvio. Si tratta di valori di attività fittizi, non dei prezzi di Wonder o ChatGPT.
Questo è un buon modello per l’assistenza alla ricerca: conservare gli identificatori delle fonti, confrontare le date relative allo stesso campo e indicare ciò che il pacchetto non è in grado di risolvere. Il compito ha utilizzato un testo fornito, quindi non misura né l’accuratezza delle ricerche web in tempo reale né il recupero di un milione di token. Un confronto ChatGPT richiederebbe lo stesso pacchetto e gli stessi controlli di accettazione.
Per i documenti aziendali, scegliete il percorso dei dati con la stessa attenzione con cui scegliete il modello. Il nostro Confronto sulla privacy dei dati nell'ambito dell'intelligenza artificiale spiega quali sono le questioni di natura normativa da considerare prima di caricare i file. La corretta selezione della fonte, di per sé, non determina i termini relativi alla privacy o alla conservazione dei dati di nessuno dei due servizi.
Risultato della pianificazione: un piano valido deve ancora essere messo in pratica
Test di valutazione di Muse Wonder n. 3: pianificazione del recupero, non esecuzione effettiva dello strumento.
Un agente browser deve raccogliere i prezzi pubblici dei prodotti e preparare una bozza di confronto. La pagina ufficiale dei prezzi restituisce un codice di errore HTTP 500. Un marketplace riporta come dato di input $4/M e come dato di output $20/M. Uno snippet di ricerca su Reddit riporta $1/M. L’utente desidera uno screenshot a conferma e un risultato pratico. Non è disponibile alcuna chiave API autorizzata.
Scrivi esattamente sei passaggi numerati, per un totale massimo di 140 parole. Includi un numero limitato di tentativi, conserva la registrazione della pagina con errore, attribuisci i prezzi al marketplace, non considerare verificato lo snippet di Reddit e distingue chiaramente la fase di preparazione dal test completo del modello. Non aggirare la procedura di accesso né falsificare screenshot o risultati. Concludi il passaggio 6 con una condizione di interruzione concreta.
Se la copia automatica è disabilitata, seleziona il testo e premi Ctrl/Cmd+C.
1. Riprovare ad accedere alla pagina ufficiale dei prezzi fino a tre volte, con brevi intervalli; conservare il timestamp, l’URL, lo stato HTTP 500 ed eventuali screenshot autentici della pagina di errore come documentazione del malfunzionamento.
2. Registrare l’inserzione sul marketplace come prezzo attribuito al marketplace: inserire $4/M ed estrarre $20/M, con URL di origine e data; non presentarlo come prezzo ufficiale.
3. Registrare la segnalazione su Reddit relativa a $1/M solo come indizio non verificato; escluderla dal confronto verificato fino a quando non sarà confermata da una fonte ufficiale o attendibile.
4. Redigere una tabella di confronto che separi le voci verificate, attribuite e non verificate, segnalando la mancanza di conferma ufficiale.
5. Preparare — senza eseguirli — il piano di test del modello, i prompt e la scheda di valutazione; in assenza di una chiave API autorizzata, non aggirare la procedura di accesso né falsificare screenshot o risultati; contrassegnare lo stato come “non testato”.
6. Segnalare la bozza come semplice preparazione, non come test del modello completato, e interrompere l’operazione quando tre tentativi falliscono e non perviene alcuna chiave autorizzata entro la scadenza concordata.
Il piano ha superato otto controlli, utilizzando sei fasi e 126 parole, esclusi i numeri delle fasi. Ha limitato i tentativi di ripetizione, ha attribuito il tasso di mercato e ha mantenuto separata la fase di preparazione da quella dei test completati. Si è trattato di un’attività di pianificazione; non sono state effettuate operazioni di ripristino del browser né esecuzioni autonome.
Follow-up del codice · controlli superati
JSON di origine · controlli superati
Piano di ripristino · controlli superati
29 verifiche indipendenti selezionate relative a tre tipi di attività. Le cinque affermazioni fornite sono distinte. Si tratta di una sintesi dei risultati, non di una classifica dei concorrenti.
Memoria, file e strumenti: confronta l'intero flusso di lavoro
Il motivo principale per cui il modello ChatGPT merita di rimanere nella vostra lista dei preferiti è lo spazio di lavoro. Il modello OpenAI Documentazione sulle caratteristiche del modello ChatGPT riunisce progetti, chat di lunga durata, navigazione sul web, file, immagini e plugin. Le sue interfacce "Work" e "Codex" supportano diversi tipi di risultati finali e attività di sviluppo. Valuta quale interfaccia useresti effettivamente.
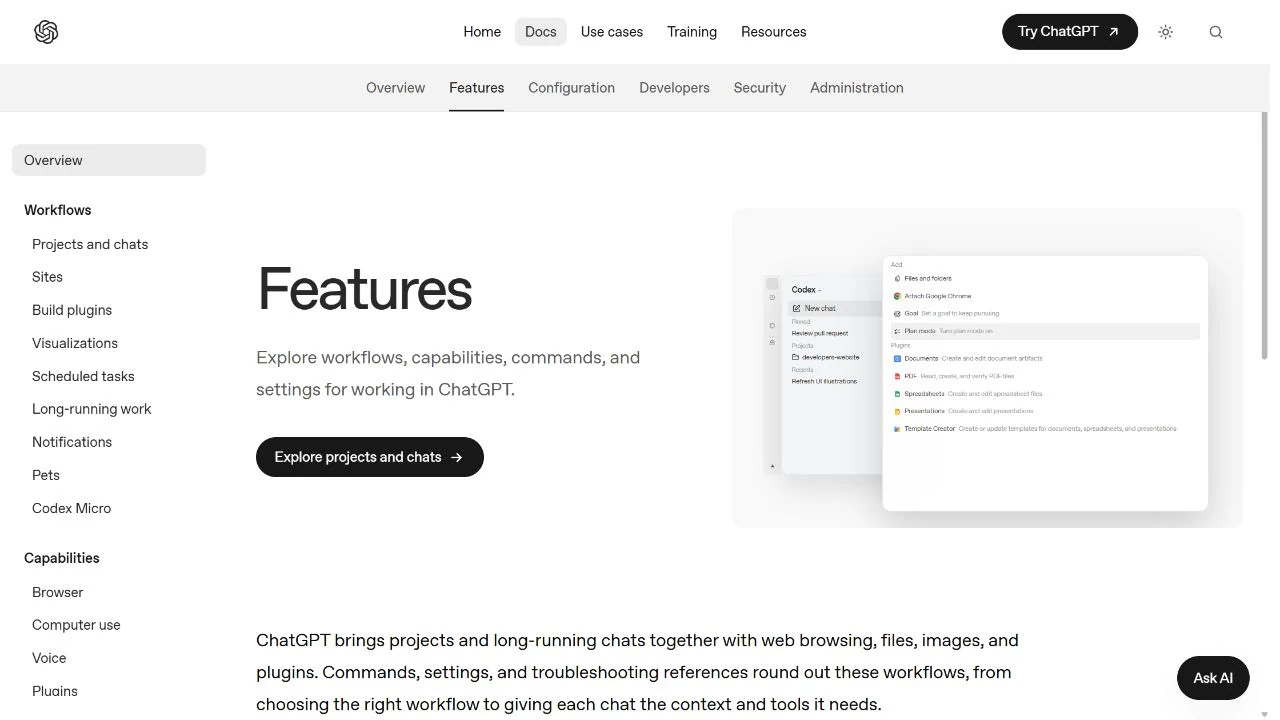
Per chi si muove tra un foglio di calcolo, una nota di ricerca e un codice sorgente, tale integrazione può essere più importante del modello che fornisce la risposta iniziale più accattivante. ChatGPT è la soluzione più adatta da valutare per prima se il requisito reale è un prodotto finito con file e strumenti gestiti in un unico flusso di lavoro. La disponibilità e i controlli dipendono comunque dall’account, dal cliente e dall’area di lavoro.
Meta descrive l’Active Memory come la capacità di conservare e recuperare il contesto utile nel corso delle conversazioni, mentre l’Active Focus è definito come la capacità di lavorare per raggiungere un obiettivo difficile adattandosi agli ostacoli. Si tratta di affermazioni dei creatori del modello che hanno una reale rilevanza per il flusso di lavoro. I nostri brevi test sui testi non hanno verificato la memoria persistente, il contesto esteso, i file multimodali o l’utilizzo del computer in tempo reale, e le sessioni di chat GlobalGPT non dimostrano che tutte le funzionalità native di Muse siano effettivamente disponibili.
Per un confronto in termini di memoria, assegnate a ciascuna applicazione supportata la stessa impostazione innocua, avviate una conversazione separata, quindi verificate l’accuratezza del richiamo, l’aggiornamento dell’impostazione e i controlli di rimozione. Per quanto riguarda l’utilizzo degli strumenti, richiedete un piccolo risultato concreto e ispezionate il file o la traccia effettivi. Un piano scritto e un’azione completata meritano punteggi diversi.
Prezzi: gli abbonamenti e i costi delle API variano
Piani ChatGPT: pagamento per una domanda e relativa indennità
Il Pagina ufficiale dedicata ai prezzi di ChatGPT Work e Codex Elenca le opzioni Free a $0, Go a $8/mese, Plus a $20/mese e Pro a $100, $200 o $500/mese. Si tratta dei prezzi dei piani in USD verificati il 14 ottobre 2026. L’accesso al lancio di GPT-6.1 Sol include i piani Plus, Pro, Business, Enterprise ed Edu; i piani Free e Go non rientrano in questa fase di lancio.
In più
$20 / mesePrezzo di abbonamento indicato; l'utilizzo varia a seconda del modello, dell'attività e degli strumenti.
Pro
A partire da $100 al meseOpzioni di piano $100, $200 o $500; non si tratta di un traffico API illimitato a tariffa fissa.
Accesso a Wonder
Specifico per il percorsoI crediti Standard API, Muse Code e GlobalGPT sono soggetti a modalità di fatturazione diverse.
L'utilizzo condiviso di ChatGPT Work e Codex e i prezzi dei token API sono distinti dall'utilizzo incluso nell'abbonamento. Non dividere un abbonamento $20 per il prezzo di una richiesta API per calcolare un numero garantito di attività. Il nostro per quale IA vale la pena pagare si concentra sulla questione più ampia di stabilire se l’opera finita valga il costo dell’abbonamento.
Tariffe API: confronta Wonder con i modelli GPT specifici
Il Scheda prodotto OpenRouter Muse Wonder indica $4 per milione di token di input non memorizzati nella cache, $0,20 per milione di token di input memorizzati nella cache e $20 per milione di token di output. Si tratta dei tassi Wonder quotati sul mercato, non del prezzo di acquisto di Muse Code né di un addebito GlobalGPT sottoposto a revisione.
OpenAI Pagina del modello GPT-6.1 Sol elenca le velocità standard dell'API per l'input $2/M, l'input in cache $0,10/M e l'output $10/M. Il suo Documentazione di GPT-6 Astra indica rispettivamente i codici $10/M, $1/M e $50/M. Tali tariffe si riferiscono all’utilizzo dell’API, non al prezzo dei messaggi ChatGPT.
Tassi API indicati · USD per 1 milione di token
GPT-6.1 Sol
- Dati di input non memorizzati nella cache
- $2
- Input memorizzato nella cache
- $0.10
- Uscita
- $10
Muse Wonder
- Dati di input non memorizzati nella cache
- $4
- Input memorizzato nella cache
- $0.20
- Uscita
- $20
GPT-6 Astra
- Dati di input non memorizzati nella cache
- $10
- Input memorizzato nella cache
- $1
- Uscita
- $50
Wonder: scheda tecnica di OpenRouter. Modelli GPT: tariffe API standard OpenAI. Dati verificati il 14 ottobre 2026. Diverse modalità di fatturazione; nessuna dichiarazione di equivalenza con un abbonamento.
Per una stima approssimativa con 10.000 token di input non memorizzati nella cache e 2.000 token di output, Sol è $0.04, La meraviglia è $0.08 e Astra è $0.20. La formula è: token in ingresso ÷ 1.000.000 × tasso di input, più token in uscita ÷ 1.000.000 × tasso di output. Ciò mantiene fissi i volumi dei token ai fini del calcolo; lo stesso prompt può utilizzare un numero diverso di token a seconda dei modelli.
10.000 token di input non memorizzati nella cache + 2.000 token di output · solo stima
Limiti di costo, non punteggi di qualità. Sono esclusi gli scritti in cache, gli strumenti, le modifiche al livello di servizio, le imposte e altri oneri applicabili. Non è stato verificato alcun addebito relativo alle attività di revisione.
A queste velocità per le richieste brevi, Wonder è due volte più veloce di Sol per input e output non memorizzati nella cache, e pari a 40% di Astra. Il vantaggio di Astra rispetto a Sol rimane quintuplo. OpenAI applica velocità di richiesta complete più elevate al di sopra dei 272.000 token in ingresso, quindi questi esempi non dovrebbero essere estesi a stime nell’ordine dei milioni di token. Il Guida ai prezzi di GPT-6 Astra copre quel limite di costo relativo alle richieste più grandi.
La regola di acquisto consiste nel calcolare il costo per risultato accettato. Una risposta più economica che richiede un lavoro di revisione consistente può, in pratica, rivelarsi più costosa. Questi esempi evidenziano differenze di tariffa; non garantiscono però la stessa qualità del risultato, una tokenizzazione identica o il costo delle nostre attività Muse salvate.
Cosa aggiungono X e Reddit al confronto
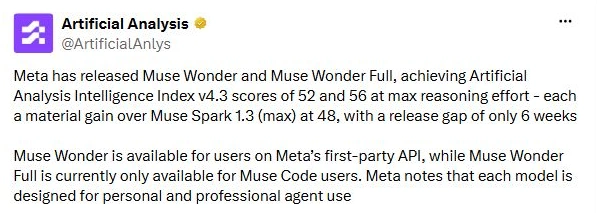
Analisi artificiale’s valutazione X originale riporta punteggi dell'Intelligence Index v4.3 pari a 52 per Wonder e 56 per Wonder Full al massimo sforzo di ragionamento. Si tratta di risultati di terze parti ripresi dalla nostra recensione. Non si tratta dei nostri test GlobalGPT e questo estratto non individua un vincitore del test ChatGPT.
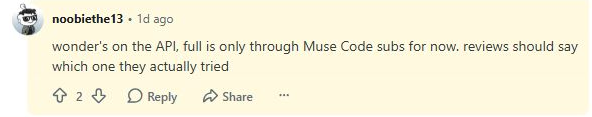
L'aspetto più concreto per la comunità è la chiarezza sulle versioni. Su Reddit, u/noobiethe13 ha scritto: “wonder è disponibile sull’API, mentre full è accessibile solo tramite gli abbonamenti a Muse Code, per ora. Le recensioni dovrebbero specificare quale delle due versioni abbiano effettivamente provato”. Il post originale su LocalLLaMA è stato rimosso, mentre questo commento era ancora leggibile al momento della sua acquisizione, il 14 ottobre.
Applicare lo stesso criterio a ChatGPT: registrare Chat, Work o Codex, il modello selezionato e gli strumenti disponibili. Un commento su Wonder Full e una risposta da Wonder standard possono essere entrambi autentici, pur descrivendo prodotti diversi. Queste fonti citate aggiungono contesto; non rappresentano un consenso a livello di X o di Reddit.
Come confrontare entrambi con il proprio compito
Utilizza un compito recente che sai già come valutare. Per il codice, definisci gli input accettati ed esegui gli stessi controlli. Per la ricerca, fornisci lo stesso pacchetto di fonti datato. Per un compito relativo all’area di lavoro, richiedi il documento, il foglio di calcolo o i file modificati effettivi. Avvia nuove conversazioni in modo che i feedback precedenti non diano un vantaggio a un modello rispetto agli altri.
01 · Risolvi il compito
Stesso inputAssicurati che i prompt, i file, le autorizzazioni e i criteri di accettazione rimangano gli stessi.
02 · Salva il risultato
Risultato effettivoRegistrare il modello, la superficie, le impostazioni, i tentativi e le eventuali correzioni apportate manualmente.
03 · Scegli in base al valore
Lavori accettatiConfronta la correttezza, i risultati finali utilizzabili, i tempi e la spesa totale.
Per un rapido confronto delle risposte, apri GPT-6.1 Sol su GlobalGPT accanto alla voce verificata di Muse Wonder e riutilizzare le istruzioni riportate sopra. In questo modo l'interfaccia rimane intuitiva, mentre le funzionalità native di ChatGPT Work e Codex vengono testate come applicazione separata.
Il flusso di lavoro con modelli di IA "tutto in uno" spiega come conservare le prove ripetute del modello in un unico spazio di lavoro. GlobalGPT è utile per confrontare le risposte delle chat; non sostituisce un agente di repository, non offre tutte le funzionalità native né trasforma un'etichetta della piattaforma in un'attestazione indipendente della versione del backend.
Quale dovresti scegliere?
Scegli prima ChatGPT se ciò di cui hai principalmente bisogno è un ambiente di lavoro integrato. I progetti, la gestione dei file, i plugin e le interfacce Work/Codex sono motivi concreti per valutare l'applicazione. Valuta l'artefatto che ricevi e il tempo che ti fa risparmiare in fase di modifica. Verifica l'accesso al modello dell'account prima di dare per scontato che un determinato modello GPT sia disponibile ovunque.
Prova Muse Wonder se cerchi un altro modello affidabile per un compito specifico e verificabile. Il codice riutilizzato, gli esempi in formato JSON e quelli relativi alla pianificazione hanno ottenuto una valutazione positiva in fase di prova. Iniziate con una piccola correzione del codice o con un pacchetto sorgente, per poi ampliare il progetto solo dopo che il risultato avrà superato i vostri controlli.
Per chi sviluppa API, è consigliabile iniziare il confronto dei costi con GPT-6.1 Sol. Le velocità di ingresso e uscita senza cache indicate sono pari alla metà di quelle di Wonder. Tenete in considerazione Astra nella valutazione per i lavori più impegnativi, dove le sue capacità aggiuntive possono giustificare il costo. Non ci sono dati disponibili che consentano di stabilire quale di questi tre modelli soddisfi i vostri specifici standard di qualità.
Per il confronto tra Muse Wonder e ChatGPT, il passo successivo più sensato è una prova a livello di attività. Mantenete ChatGPT se l’area di lavoro vi fa risparmiare tempo; aggiungete Muse Wonder quando i suoi risultati migliorano un flusso di lavoro che potete misurare. Potete confrontare le risposte su GlobalGPT prima di decidere se valga la pena passare a un’applicazione nativa separata o a un’integrazione API.
Muse Wonder vs ChatGPT - Domande frequenti
Muse Wonder è migliore di ChatGPT?
Vale la pena provare Muse Wonder per la codifica e l’analisi basata sul codice sorgente. ChatGPT è la soluzione più indicata quando si desidera un ambiente di lavoro integrato. I nostri test riutilizzati su Muse hanno superato 29 controlli; tuttavia, non consentono di stabilire un vincitore in termini di qualità in un confronto diretto.
Quale modello ChatGPT viene utilizzato in questo confronto?
La discussione sul modello utilizza GPT-6.1 Sol e GPT-6 Astra. Il documento OpenAI descrive Sol in ChatGPT Work e Codex, non in Chat. La disponibilità dipende dal piano, dal cliente, dalla fase di implementazione e dalle impostazioni dell'area di lavoro.
Qual è la scelta migliore per la programmazione?
Il test di verifica del codice effettuato da Muse Wonder ha superato 13 controlli indipendenti, oltre a cinque asserzioni fornite. GPT-6.1 Sol è l'opzione GPT più economica da valutare per prima; esegui gli stessi test sul repository prima di scegliere un'impostazione predefinita per la codifica.
Quanto costa Muse Wonder rispetto a ChatGPT?
OpenRouter indica per Wonder un consumo di $4/M in entrata e $20/M in uscita. Il piano ChatGPT Plus prevede un consumo di $20/mese, mentre il piano Pro parte da $100/mese. Le tariffe dei token API e le quote di abbonamento sono gestite da sistemi di fatturazione distinti.
Muse Wonder costa meno di GPT-6.1 Sol o Astra?
In base alle tariffe API per le richieste brevi indicate, Wonder costa il doppio di Sol per input e output non memorizzati nella cache e 40% di Astra. Questi rapporti mettono a confronto le tariffe API, non gli abbonamenti ChatGPT né il costo di un risultato accettato.
Posso utilizzare Muse Wonder e GPT-6.1 Sol su GlobalGPT?
Sì. Abbiamo verificato entrambe le voci relative al prodotto GlobalGPT. I test Muse riutilizzati sono stati eseguiti sul percorso di produzione di Muse Wonder. Il confronto delle risposte in chat è una questione a sé stante rispetto al test delle funzionalità native di Work o Codex di ChatGPT.
La versione testata in questa sede è Muse Wonder Full?
No. L'interfaccia di produzione riutilizzata è stata denominata Muse Wonder. Meta distingue la versione standard di Wonder da Wonder Full, che, come indicato nell'annuncio di lancio, è disponibile per gli abbonati a Muse Code.
Hai eseguito un nuovo benchmark tra Muse Wonder e ChatGPT?
No. Questo articolo riutilizza i test su Muse Wonder già pubblicati e il quadro di riferimento dei costi del confronto GPT, attingendo a fonti ufficiali aggiornate. Non sono stati effettuati test per individuare output corrispondenti a ChatGPT, né prove con memoria persistente, né confronti sull’uso effettivo dei computer.