
Risposta rapida: GPT-6 Sol ha completato il brief di prova composto da cinque sezioni entro un limite di output di 2.400 token; Claude Opus 5.5 ha fornito la diagnosi più precisa nel nostro breve compito di revisione del codice. Nessuno dei due risultati determina un vincitore assoluto definitivo.
Il confronto significativo va oltre il semplice punteggio. Claude Opus 5.5 e GPT-6 Sol si differenziano per il modo in cui gestiscono la scrittura, la sintesi delle ricerche, la revisione del codice, le risposte strutturate, i percorsi di accesso e il flusso di lavoro quotidiano. I risultati delle prove riportati di seguito mostrano in quali ambiti tali differenze sono rilevanti.
GlobalGPT ti offre entrambi i modelli in un unico abbonamento multi-modello a prezzi accessibili, insieme ad altri modelli e funzionalità di intelligenza artificiale. Un'unica dashboard permette di gestire un progetto dalla fase di ricerca e scrittura fino alla programmazione, alle immagini e ai video, mentre la sua interfaccia a riga di comando (CLI) collega lo stesso contesto di lavoro al terminale e agli strumenti di produzione.
Risposta rapida
Scegli GPT-6 Sol innanzitutto per il flusso di lavoro di scrittura con vincoli qui testato; ha completato tutte e cinque le sezioni rispettando il limite massimo di output condiviso di 2.400 token. Scegli Claude Opus 5,5 quando la diagnosi, l’analisi esplicita dei rischi e un JSON rigoroso assumono maggiore importanza. Utilizzale entrambe quando il lavoro subisce cambiamenti nel corso della giornata.
I punti di forza di ciascun modello
Claude Opus 5,5 si adatta a un lavoro meticoloso: rivedere una modifica al codice, districarsi tra requisiti complessi, individuare i rischi e garantire il rispetto di un contratto di output rigoroso. Anthropic lo colloca nell’ambito della programmazione, dell’uso del computer, del lavoro intellettuale, della sicurezza e di una comunicazione più naturale durante sessioni prolungate. Vedi il Recensione del Claude Opus 5.5 per una visione separata incentrata sul modello. È una scelta naturale quando vale la pena dedicare più tempo a una seconda analisi approfondita piuttosto che a una prima risposta più sintetica.
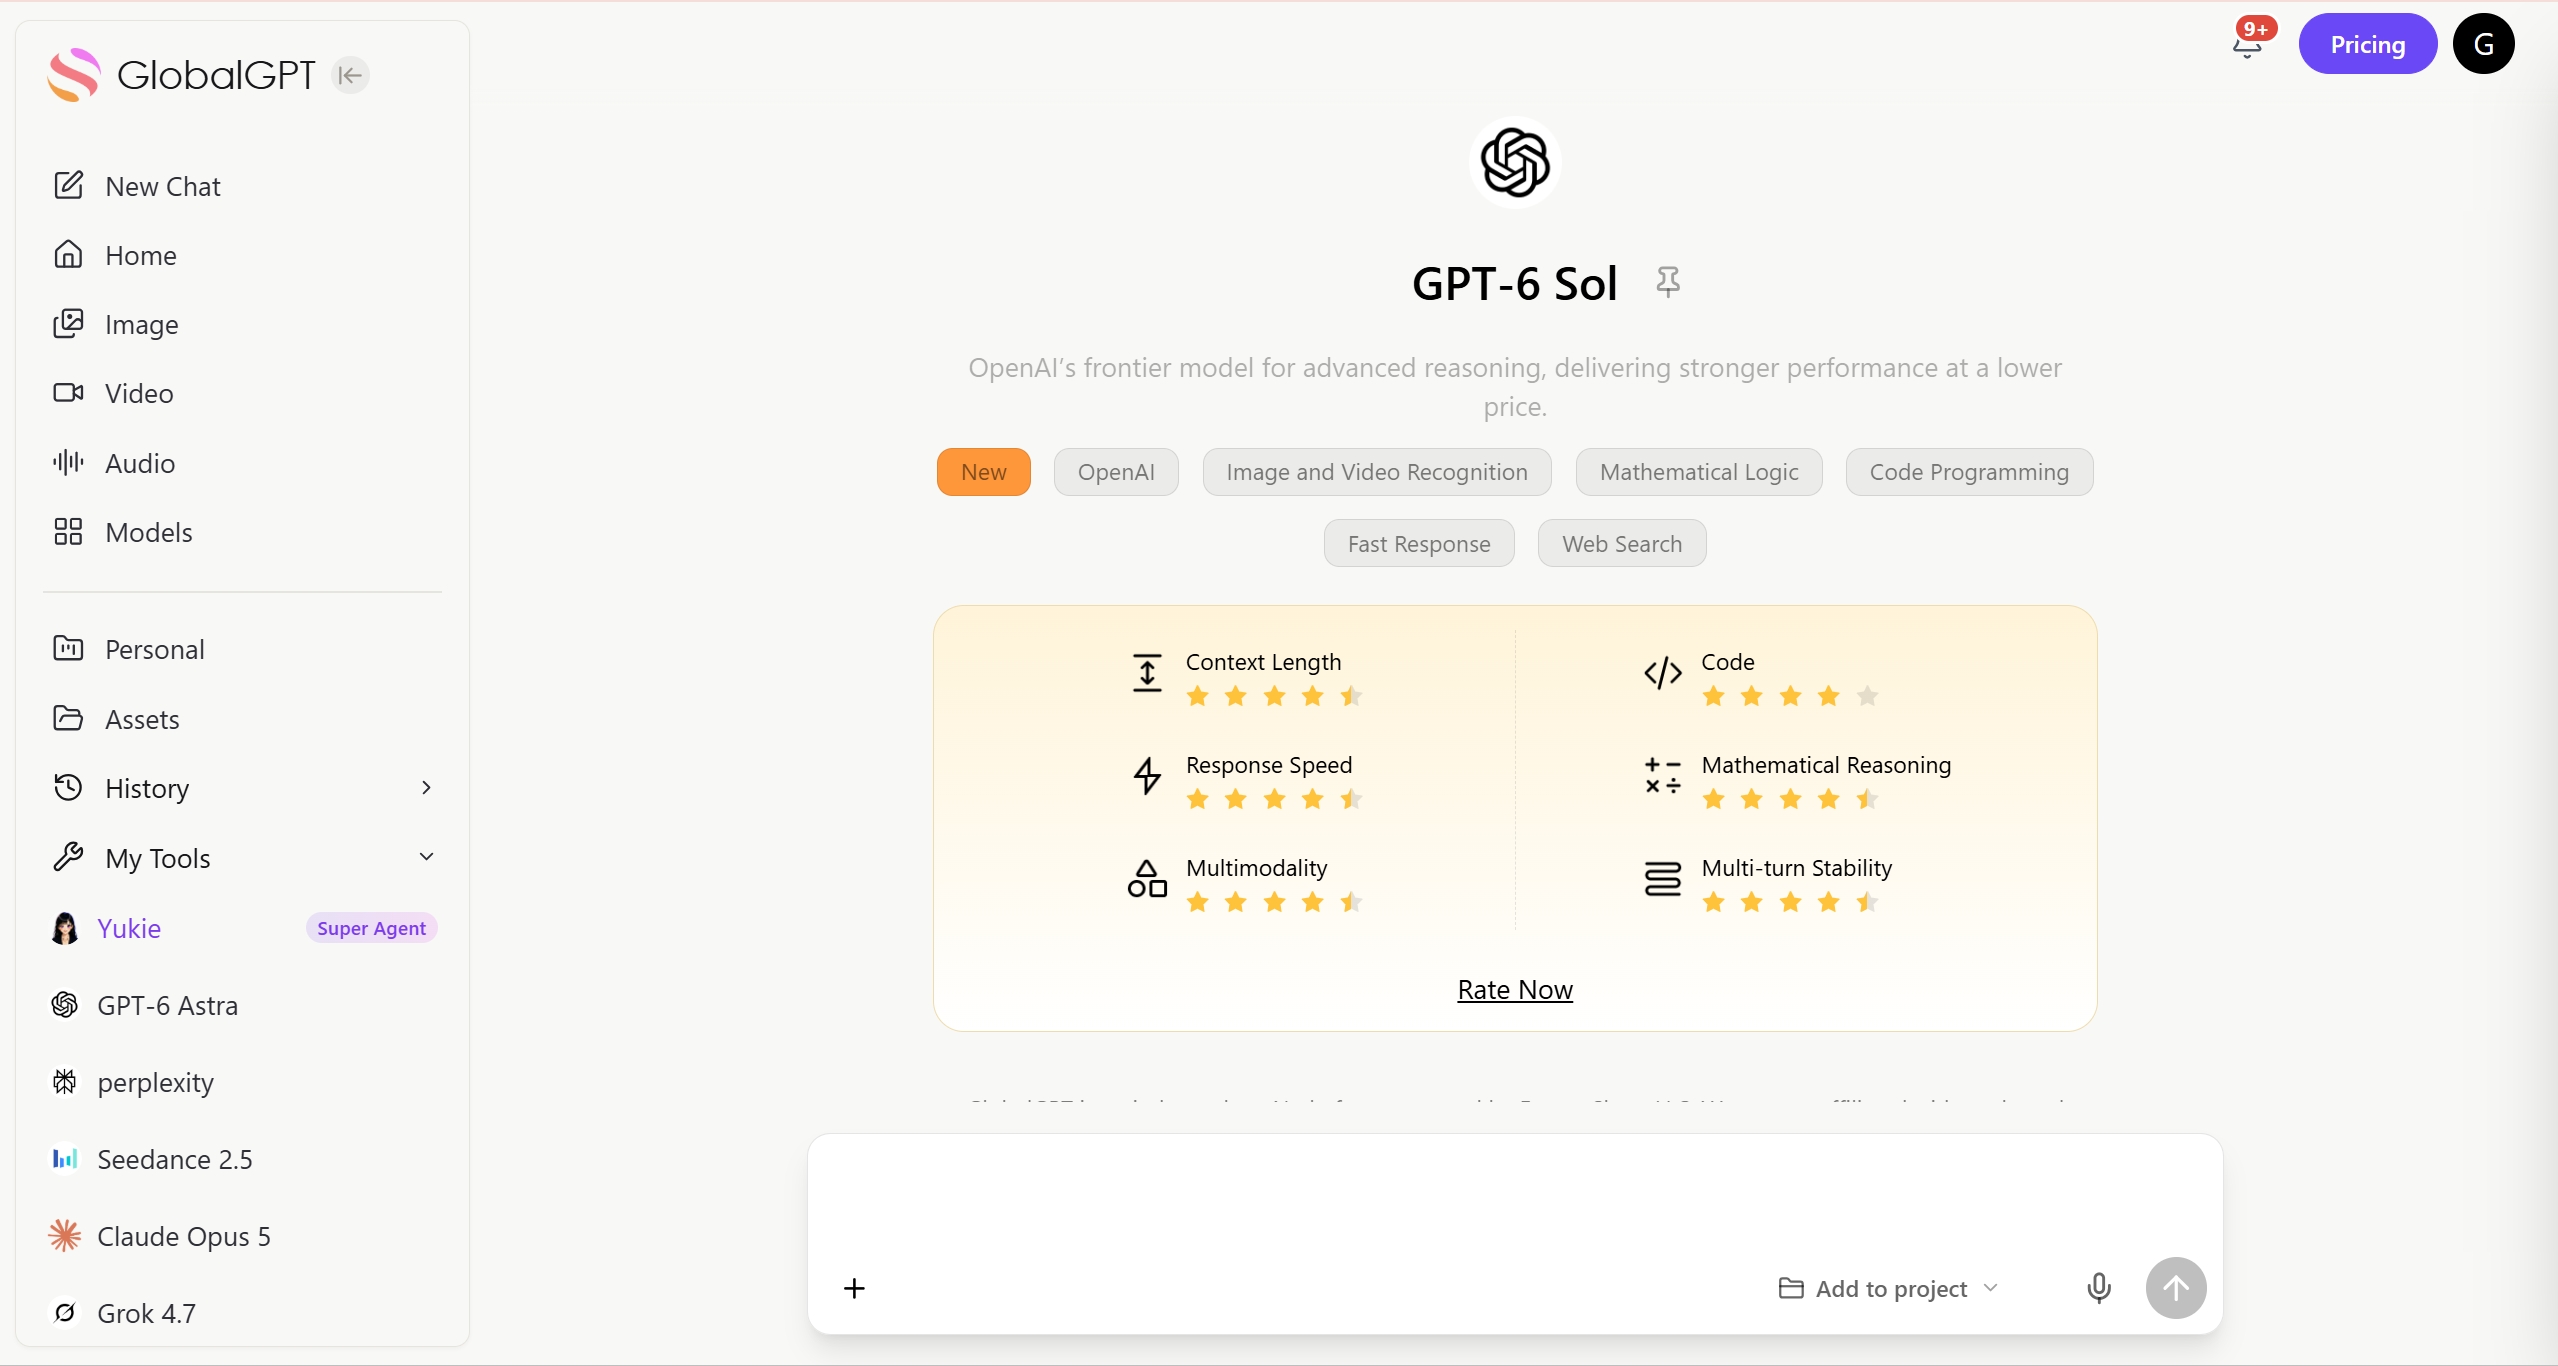
GPT-6 Sol si adatta a volumi di lavoro con vincoli specifici: un documento di sintesi di lunghezze variabili, una nota decisionale, un piano strutturato o una bozza che deve includere numerose sezioni richieste. OpenAI lo descrive come un modello GPT-6 più accessibile per attività professionali, accuratezza dei fatti, programmazione, utilizzo del computer e collaborazione. Il Recensione di GPT-6 Sol tratta il modello a sé stante; nell’esercizio di formato lungo qui riportato, ha completato il contratto già nel primo risultato, il che risulta utile quando il costo di una sezione mancante è elevato.
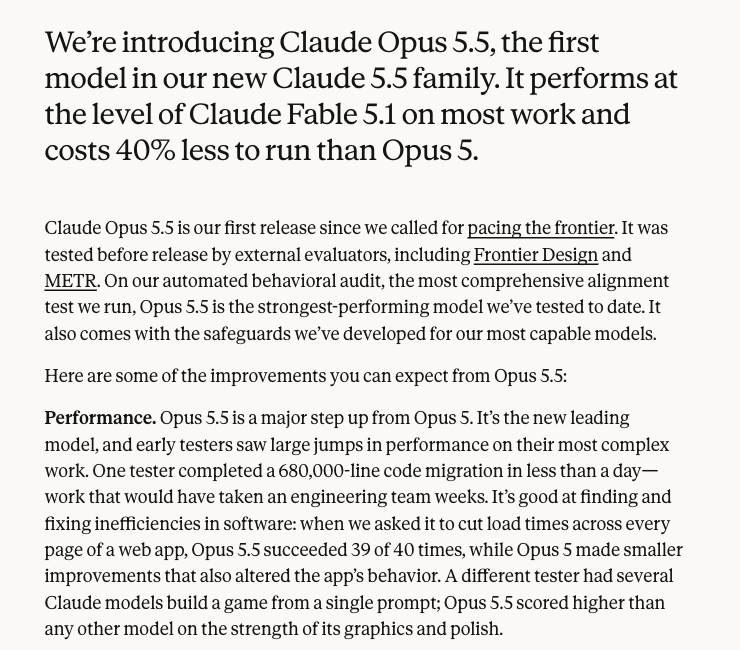
Questo è il resoconto fornito da Anthropic sul rilascio, che include esempi forniti dai primi tester. Esso conferma la direzione prevista per il prodotto; non stabilisce però un risultato di confronto diretto con GPT-6 Sol. I prompt abbinati riportati di seguito affrontano la questione più specifica di cosa abbia restituito ciascun modello in questa sessione.
Confronto tra caratteristiche e funzionalità
Claude Opus 5.5 vs GPT-6 Sol: mappa delle capacità
| Area decisionale | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Scrittura di testi lunghi | Eccelle nella redazione di testi accurati e ricchi di sfumature, con avvertenze esplicite | È bravo a portare a termine un incarico lungo e con molteplici vincoli in un’unica fase |
| Sintesi della ricerca | Riconciliazione dettagliata e spiegazione dei rischi | Sintesi concisa con una chiara raccomandazione |
| Codifica e revisione | Diagnosi precisa e rendicontazione strutturata dei rischi | Patch minime utili; verificare le spiegazioni relative ai casi limite |
| Output strutturato | JSON rigoroso e affidabile nell'attività sottoposta a test | JSON valido contenente tutte le chiavi richieste nell'attività sottoposta a test |
| Multimodale e strumenti | Verificare il percorso e il modello di accesso per l'attività specifica | Verificare il percorso e il modello di accesso per l'attività specifica |
| Lo stile di lavoro migliore | Analisi ponderata, ragionamento complesso e attività sensibili al rischio | Ho completato il brief con vincoli prestabiliti, rispettando il limite massimo di output fissato |
Come leggere questo testo: Si tratta di tendenze relative al flusso di lavoro, non di una classifica universale. La scelta giusta dipende dal fatto che si dia maggiore importanza alla revisione accurata o al completamento di questo brief complesso, pur rispettando lo stesso limite di output.
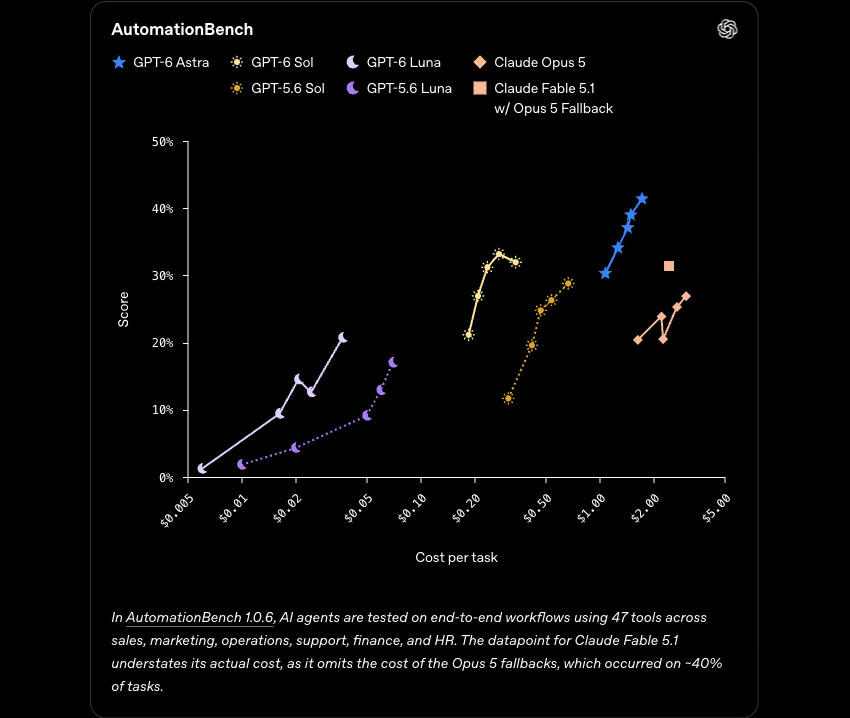
Leggere entrambi gli assi: spostarsi verso l’alto indica un punteggio più alto, mentre spostarsi verso sinistra indica un costo per attività più basso. La serie Claude qui indicata è l’Opus 5, non l’Opus 5.5. Questo grafico fornito dall’editore aiuta a spiegare il posizionamento di Sol in termini di rapporto costo-efficienza; non può tuttavia risolvere il confronto oggetto di questo articolo. La nota a piè di pagina precisa inoltre che il dato relativo a Fable omette alcuni costi di ripiego.
Scrittura, documenti lunghi e sintesi di ricerche
Per quanto riguarda la scrittura, questo test distingue il completamento entro un limite massimo prestabilito di output dalla qualità del controllo editoriale. GPT-6 Sol ha ottenuto risultati migliori nel compito di scrittura di testi lunghi. Claude Opus 5.5 ha ottenuto risultati migliori quando il compito consisteva nel diagnosticare, valutare e spiegare. Per quanto riguarda le note di ricerca, entrambi i modelli hanno raggiunto la stessa risoluzione pratica, quindi la qualità del materiale di partenza e del processo di revisione continua ad avere maggiore importanza rispetto al semplice vincitore in termini di risultati.
- Utilizza GPT-6 Sol per una prima bozza con molti vincoli, una nota decisionale o un piano strutturato dei contenuti.
- Utilizza Claude Opus 5.5 per mettere in discussione le ipotesi, individuare i rischi e perfezionare una bozza prima che raggiunga un cliente o un sistema di produzione.
- Quando i fatti contano, fornite a entrambi i modelli il materiale di partenza e mantenete una fase di revisione umana.
Programmazione, output strutturato e lavoro pronto per l'utilizzo con gli strumenti
Entrambi i modelli hanno restituito un JSON valido con tutte le chiavi richieste e la stessa patch minima. Claude ha descritto correttamente il filtro esistente; GPT-6 Sol ha erroneamente affermato che un elemento None avrebbe generato un errore. Ciò avvalora Claude per la diagnosi in questo particolare compito. Il tipo del campo «risk» non era specificato nel prompt, quindi la stringa «risk» fornita da Sol non costituisce una violazione del contratto.
Per i lavori pronti per l'utilizzo con gli strumenti, valuta il formato di output di cui hai effettivamente bisogno: struttura JSON valida, campi completi, comandi riproducibili e una patch applicabile senza necessità di interpretazione. Entrambi i modelli possono far parte di tale pipeline, con test e revisioni integrati nel processo.
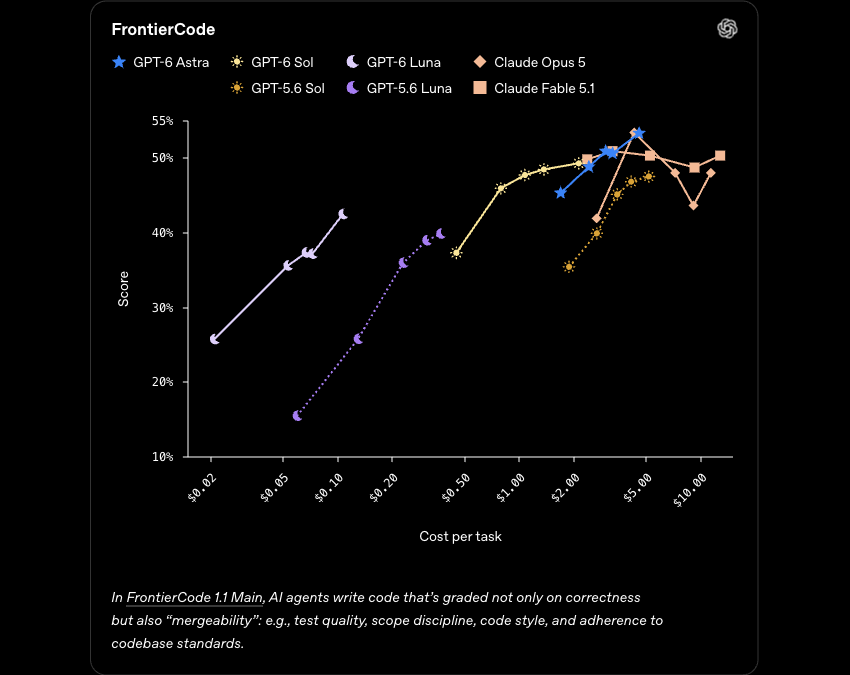
Questo benchmark copre una codifica agentica più ampia rispetto al nostro breve prompt di revisione del codice. Il suo comparatore Claude è Opus 5, quindi funge da contesto per il posizionamento di Sol in termini di codifica piuttosto che da prova del fatto che Sol superi Opus 5.5. Nel nostro compito, entrambe le correzioni erano corrette; la distinzione rilevante era l’accuratezza della diagnosi.
Prezzo e accesso
Prezzo e accessibilità: confronta il percorso, non solo il modello
| Percorso | Cosa stai pagando | Quando è opportuno |
|---|---|---|
| Claude Opus 5.5 API | Nella pagina dedicata al rilascio del 22 settembre 2026, Anthropic riporta i seguenti valori: $4 per milione di token in ingresso, $20 per milione di token in uscita e $0,20 per milione di token letti dalla cache. | Stai sviluppando un prodotto o una pipeline automatizzata e desideri la fatturazione diretta tramite token |
| API GPT-6 Sol | OpenAI prevede $2 per milione di token in ingresso e $10 per milione di token in uscita, con una riduzione di 50% rispetto al prezzo promozionale di GPT-5.6 Sol; le letture in cache in ingresso beneficiano di uno sconto di 90% | Hai bisogno di un contratto API con un fornitore diretto e desideri ridurre i costi a consumo per le attività continuative |
| GlobalGPT | Un unico abbonamento conveniente che include entrambi i modelli, oltre a molti altri modelli e funzioni di intelligenza artificiale | Vuoi riunire in un'unica dashboard le attività di ricerca, scrittura, programmazione, elaborazione di immagini e video |
Queste cifre si riferiscono alle tariffe dei token API, non ai prezzi degli abbonamenti. OpenAI posiziona GPT-6 Sol come il modello più economico della famiglia GPT-6 per attività professionali, accuratezza dei fatti, programmazione, utilizzo del computer e collaborazione, mentre Anthropic posiziona Claude Opus 5.5 in ambito di programmazione, utilizzo del computer, lavoro intellettuale, sicurezza e comunicazione. GlobalGPT rende disponibili entrambi i modelli e il resto della catena di strumenti tramite un unico abbonamento conveniente, mentre la sua CLI collega tale accesso a un terminale, al flusso di lavoro di sviluppo e agli strumenti di produzione esistenti.
Fonti primarie: Pagina dedicata alla versione Claude Opus 5.5 di Anthropic e Pagina di lancio di Sol e Luna (GPT-6) di OpenAI.
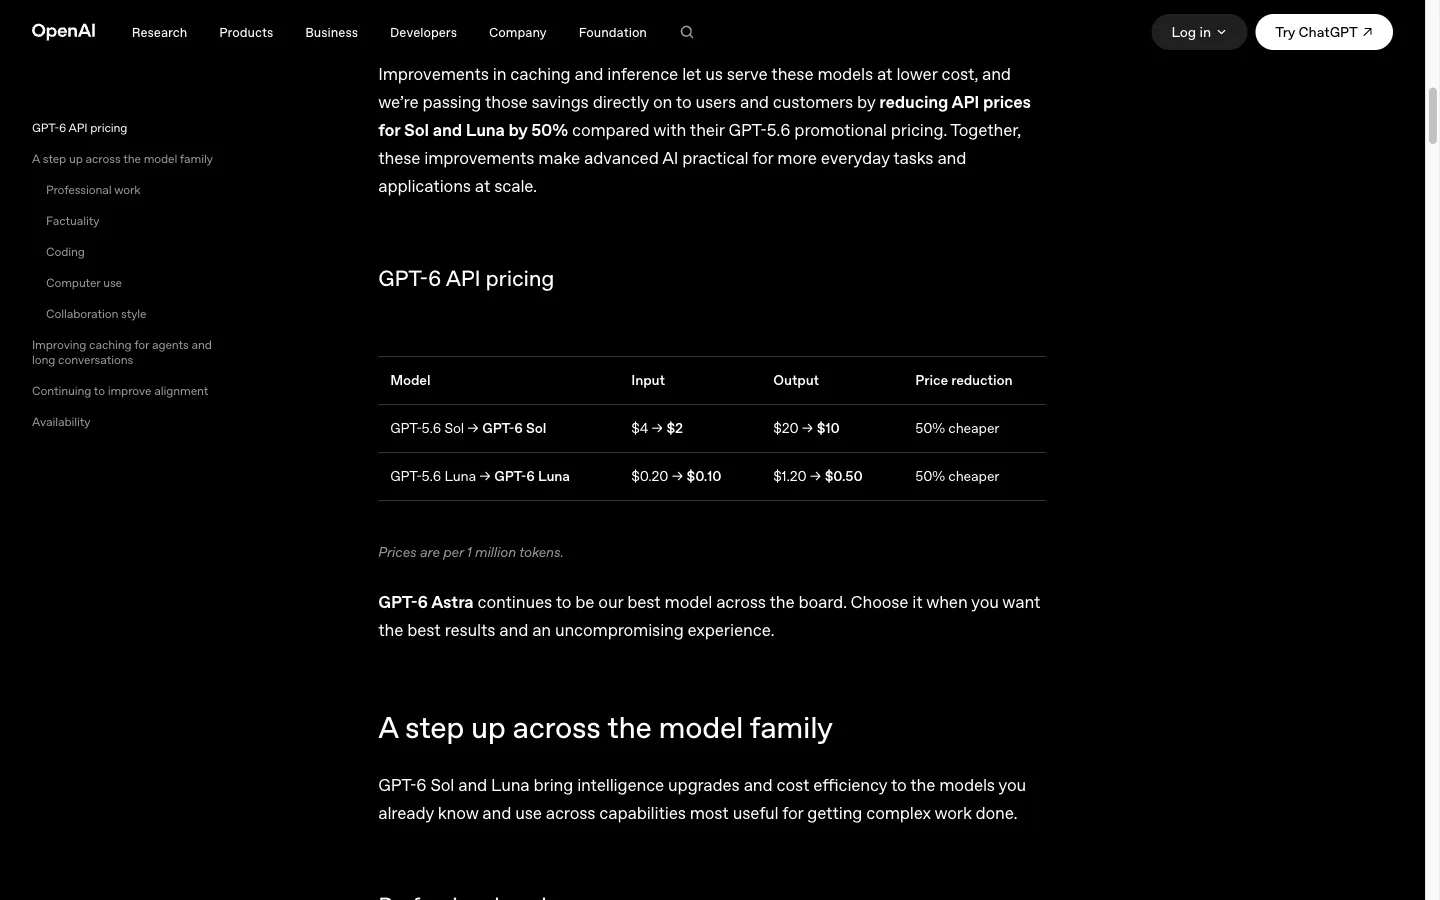
Queste tariffe si applicano ai token API. Non si riferiscono a un abbonamento mensile per utenti finali né a un piano GlobalGPT.
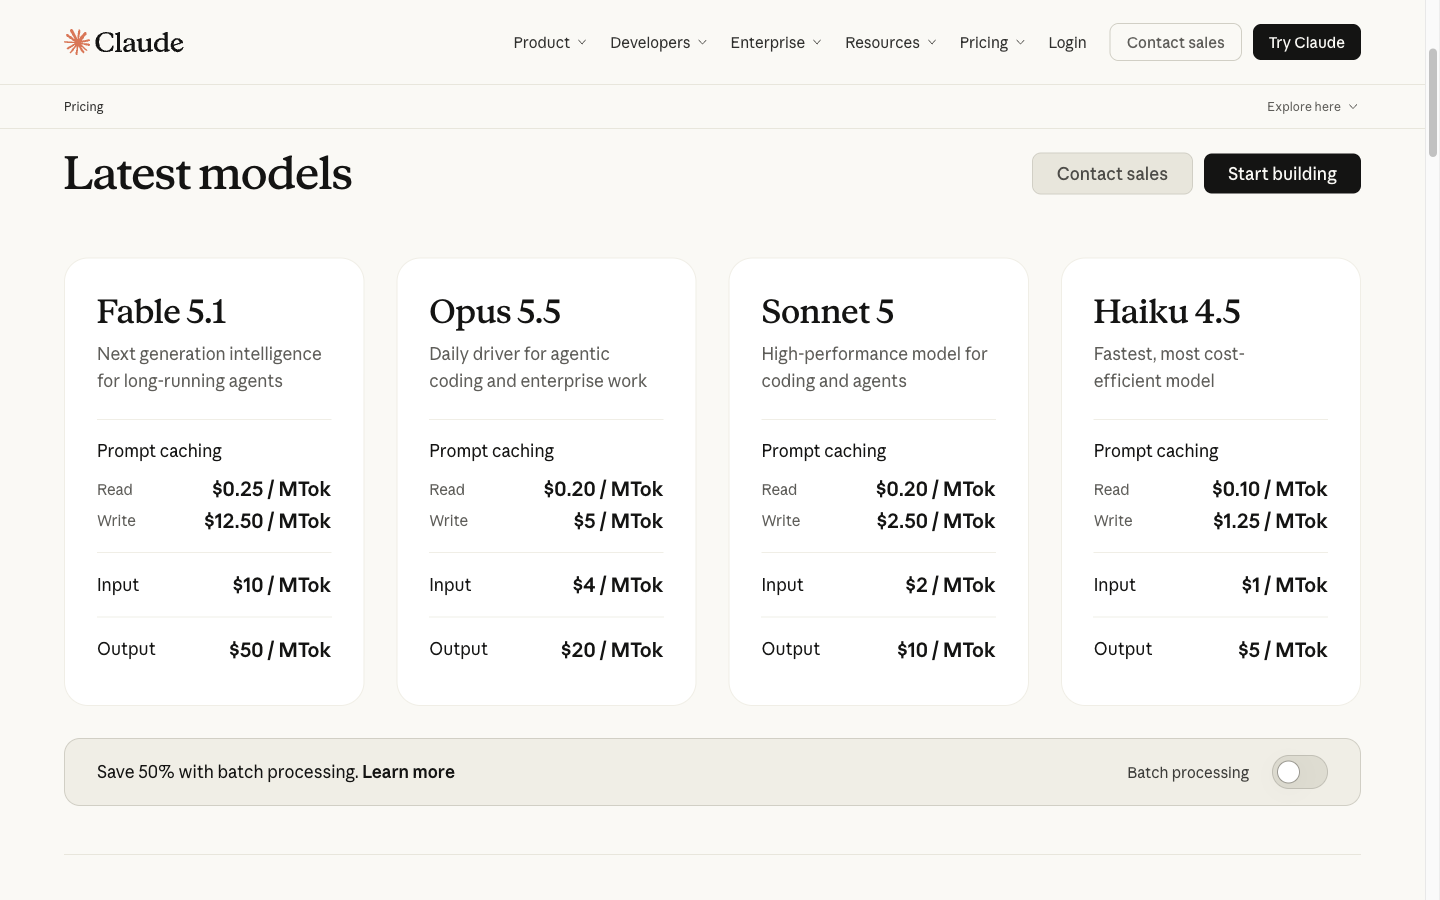
Le velocità standard di input e output di Opus 5.5 sono doppie rispetto a quelle di Sol, mentre entrambe le velocità di lettura dalla cache pubblicate sono pari a $0.20/M. Un flusso di lavoro con un uso intensivo della cache può quindi presentare un divario di costo diverso rispetto a uno senza cache; si consiglia di confrontare la stessa combinazione di token prima di scegliere in base al prezzo.
Cosa comporta la differenza di velocità a parità di carico di lavoro
Esempio di calcolo: 1 milione di token di input non memorizzati nella cache + 100.000 token di output, tariffe API standard. Il colore verde acqua indica il costo di input; il color ruggine indica il costo di output.
Sol costa la metà per questo stesso mix di token. Si tratta di un calcolo basato sul listino prezzi, non di un’affermazione secondo cui ogni attività completata costa la metà: i tentativi ripetuti, la lunghezza dell’output, gli accessi alla cache, i costi degli strumenti e le impostazioni di ragionamento possono influire sul costo finale.
Fonti: Prezzi API Anthropic e Prezzi di lancio del modello OpenAI, consultato il 25 settembre 2026.Stima del costo diretto dell'API
Calcolatore dei costi API
Inserisci i token che prevedi di inviare e ricevere. La stima utilizza le tariffe API verificate sopra indicate: Claude Opus 5,5 con input $4/M e output $20/M; GPT-6 Sol con input $2/M e output $10/M.
| Modello | Velocità di immissione | Tasso di produzione | Costo stimato |
|---|---|---|---|
| Claude Opus 5,5 | $4 / M | $20 / M | $9.00 |
| GPT-6 Sol | $2 / M | $10 / M | $4.50 |
Si tratta di una stima dei costi basata sui token per l'utilizzo diretto dell'API. Non tiene conto del prezzo dell'abbonamento per gli utenti né del piano GlobalGPT ed esclude gli sconti sulla cache, gli strumenti, le imposte e altri costi specifici del fornitore.
Chi dovrebbe scegliere quale modello?
Quale modello scegliere?
| La tua priorità | Scegli per primo | Perché |
|---|---|---|
| Un lungo promemoria ben strutturato, soggetto a numerosi vincoli | GPT-6 Sol | Il compito in formato esteso rivisto ha raggiunto la regola decisionale richiesta in un unico risultato |
| Diagnosi del codice, JSON rigoroso e rischi espliciti | Claude Opus 5,5 | L'attività di codifica ha permesso di ottenere una diagnosi più accurata e un quadro più preciso dei rischi |
| Note di ricerca che richiedono una riconciliazione | Oppure | Il compito di sintesi con sorgente controllata si è concluso con un pareggio |
| Un flusso di lavoro settimanale misto | GlobalGPT con entrambi | Raggruppa la scelta del modello, la scrittura, la programmazione, le immagini e i video in un'unica dashboard; usa la CLI quando il lavoro si sposta sul terminale |
Utilizza entrambi i modelli in un unico flusso di lavoro completo
Un flusso di lavoro pratico per GlobalGPT
- Inizia con una sintesi della ricerca e chiedi a un modello di mettere in luce le ipotesi.
- Trasferisci il progetto pulito nell'altro modello per la stesura o per un secondo parere.
- Utilizzare l'approccio di codifica più avanzato per l'implementazione, la revisione e l'output strutturato.
- Conserva il lavoro ottenuto nella stessa dashboard, quindi utilizza il Flusso di lavoro CLI GlobalGPT quando deve essere inserito in un terminale o in uno strumento di produzione.
Questo flusso di lavoro rappresenta il valore principale dell’accesso a entrambi i modelli: è possibile indirizzare l’attività, anziché dover riorganizzare il proprio processo in base a un unico modello.

Come è stato effettuato il confronto
Entrambi i modelli hanno ricevuto lo stesso messaggio di sistema, gli stessi input relativi alle attività e lo stesso materiale di partenza, senza l’uso di strumenti o la navigazione. Ciascun risultato riporta il primo output restituito, compreso l’eventuale troncamento dovuto al limite di output. Si tratta di un confronto pratico finalizzato alla scelta di un flusso di lavoro, non di una classifica universale di tutte le funzionalità.
Metodo di confronto
Come è stato effettuato questo confronto
| Condizione | Regola di confronto |
|---|---|
| Modelli | Claude Opus 5.5 e GPT-6 Sol, ID esatti confermati nella directory dei modelli live |
| Parità di prompt | Stesso messaggio di sistema, stessa richiesta di azione, stesso materiale di partenza, nessun strumento né navigazione |
| Compiti | Controllo dei limiti T01, confronto esplicito in formato esteso T01R, sintesi del codice sorgente T02, codice/JSON T03 |
| Tentativi di ripetizione | Solo errori relativi a trasporto, capacità o busta vuota; i risultati validi ma deboli vengono mantenuti |
| Punteggio | 10 punti per ogni attività completata: contratto oggettivo 4, tracciabilità 3, utilità 2, formato 1 |
Il primo test verifica se un modello è in grado di formulare un'ipotesi in assenza di contesti chiave, pertanto viene tenuto separato dal calcolo del vincitore. Il confronto diretto coinvolge entrambi i modelli e assegna loro lo stesso brief. Non sono state effettuate ripetizioni per verificare la stabilità.
Perché il primo bando non ha selezionato un vincitore
Gestione del contesto
Perché il primo bando non ha selezionato un vincitore
Entrambi i modelli si sono rifiutati di inventare identità per i modelli poiché il prompt originale non li menzionava. Questa è la risposta corretta in assenza di contesto, ma non ci permette di stabilire quale modello sia più efficace nell'esecuzione del compito stesso.
Claude Opus 5,5 · ingresso completo
Stai mettendo a confronto due modelli di intelligenza artificiale per una guida pratica all’acquisto. Utilizzando esclusivamente il pacchetto di informazioni riportato di seguito, scrivi un testo di 700–900 parole con esattamente i seguenti titoli: Decisione, Prove, Avvertenze, Passo successivo. Riporta esattamente questi dati: il Progetto North ha una scadenza di 12 settimane; il budget per la migrazione è pari a $48.000; la revisione della sicurezza non è ancora stata programmata. Se un dato non è chiaro, indicarlo esplicitamente. Non inventare prezzi, benchmark o funzionalità dei prodotti.

DOCUMENTAZIONE DI RIFERIMENTO:
Il Progetto North è una migrazione della durata di 12 settimane per un team di 40 persone. Il budget approvato per la migrazione è pari a $48.000. Non è stata ancora fissata la tempistica per la revisione di sicurezza. Il team desidera una raccomandazione su un modello per la ricerca, la redazione e la revisione del codice. Una nota di una parte interessata indica che l’attuale bozza è troppo lunga, ma non fornisce il conteggio delle parole.

Inviare solo la guida.
Claude Opus 5,5 · potenza massima
## Decisione

Dal pacchetto informativo fornito non è possibile formulare alcuna raccomandazione tra i due modelli. Il pacchetto non indica né il nome di alcun modello né fornisce prezzi, risultati dei benchmark o caratteristiche del prodotto. Scegliere ora un modello piuttosto che l’altro significherebbe inventare le prove su cui questa guida dovrebbe basarsi.

La decisione pratica è quella di sospendere la selezione del modello. Considerare la fase successiva come una valutazione strutturata regolata da tre vincoli fissi:

- Il Progetto North ha una scadenza di 12 settimane.
- Il budget per la migrazione è pari a $48.000.
- La revisione di sicurezza non è ancora stata programmata.

Qualsiasi modello che verrà portato avanti dovrà rientrare nella scadenza di 12 settimane e nel budget di migrazione di $48.000. Deve inoltre superare una revisione di sicurezza, che non è ancora in calendario. Finché i due modelli non saranno identificati e valutati in base ai tre utilizzi dichiarati dal team (ricerca, scrittura e revisione del codice), la selezione rimane irrisolta. Questa guida lo afferma chiaramente, anziché offrire una preferenza che le prove non possono sostenere.

## Prove

Il pacchetto di riferimento contiene i seguenti fatti, e solo questi fatti sono alla base della presente guida:

- **Ambito e tempistiche:** il Progetto North è una migrazione della durata di 12 settimane.
- **Dimensione del team:** la migrazione è destinata a un team di 40 persone.
- **Budget:** il budget approvato per la migrazione è di $48.000.
- **Sicurezza:** non è stata ancora fissata la tempistica per la revisione della sicurezza.
- **Casi d’uso:** il team desidera una raccomandazione sul modello da adottare per la ricerca, la redazione e la revisione del codice.
- **Feedback delle parti interessate:** Una nota delle parti interessate indica che l’attuale bozza è troppo lunga, ma non fornisce il conteggio delle parole.

Il pacchetto non contiene diversi elementi su cui normalmente si baserebbe un confronto. Non identifica i due modelli oggetto di confronto. Non indica i prezzi per postazione, per token o in abbonamento per nessuna delle due opzioni. Non fornisce punteggi di benchmark né risultati di test interni. Non descrive cosa ciascuno dei due modelli possa o non possa fare per la ricerca, la scrittura o la revisione del codice. Non dice nulla in merito alle condizioni di gestione dei dati, alle opzioni di implementazione o ai requisiti di integrazione.

Poiché nessuno di questi elementi compare nel documento, la presente guida non fornisce alcuna stima al riguardo. Non è noto se uno dei due modelli rientri nel budget di $48.000 per un team di 40 persone. Non è noto nemmeno se uno dei due modelli offra prestazioni migliori nella ricerca, nella scrittura o nella revisione del codice. Qualsiasi cifra o affermazione sulle capacità aggiunta in questa sede sarebbe inventata.

## Avvertenze

Diverse questioni irrisolte influenzano il modo in cui questa decisione dovrebbe essere interpretata.

**L’identità dei modelli è irrisolta.** Il confronto riguarda due modelli di IA, ma il fascicolo non specifica quali. Ogni valutazione successiva dipende dalla risposta a questa domanda preliminare.

**L’ambito del budget non è chiarito.** Il documento definisce la cifra di $48.000 come il "budget di migrazione approvato". Non specifica se tale importo sia destinato a coprire i costi di licenza dei modelli o i canoni di utilizzo. Potrebbe invece coprire solo le attività di migrazione, quali il tempo del personale, gli strumenti o i servizi. Se i costi dei modelli dovessero essere coperti dallo stesso importo di $48.000, il margine di spesa per entrambi i modelli sarebbe più ridotto di quanto suggerisca la cifra indicata. Ciò richiede una conferma.

**I tempi della revisione di sicurezza non sono stati definiti e rappresentano un rischio per il calendario.** La revisione di sicurezza non è stata programmata. Con una scadenza di 12 settimane, una revisione non programmata rappresenta un rischio concreto per il rispetto dei tempi. Il fascicolo non specifica quanto tempo richieda una revisione né se una revisione non superata costringerebbe a passare all’altro modello. Entrambi gli esiti potrebbero richiedere una parte significativa delle 12 settimane. Nessun modello dovrebbe essere considerato approvato fino al completamento della revisione.

**La ponderazione dei casi d’uso è ancora da definire.** Il team ha indicato tre utilizzi: ricerca, scrittura e revisione del codice. Il documento non specifica se abbiano lo stesso peso o se uno prevalga sugli altri. Un modello più forte in un’area potrebbe risultare più debole in un’altra e, in assenza di una ponderazione, non vi è alcuna base per trovare un compromesso tra questi aspetti.

**Il volume di utilizzo è ancora da definire.** Il team è composto da 40 persone, ma il documento non specifica quante di esse utilizzeranno il modello né con quale intensità. Il volume di utilizzo potrebbe influire notevolmente sui costi in alcune strutture di prezzo. Ciò non può essere valutato senza dati sui prezzi e stime di utilizzo.

**La durata dell'istruzione con
GPT-6 Sol · input completo
Stai mettendo a confronto due modelli di intelligenza artificiale per una guida pratica all’acquisto. Utilizzando esclusivamente il pacchetto di informazioni riportato di seguito, scrivi un testo di 700–900 parole con esattamente i seguenti titoli: Decisione, Prove, Avvertenze, Passo successivo. Riporta esattamente questi dati: il Progetto North ha una scadenza di 12 settimane; il budget per la migrazione è pari a $48.000; la revisione della sicurezza non è ancora stata programmata. Se un dato non è chiaro, indicarlo esplicitamente. Non inventare prezzi, benchmark o funzionalità dei prodotti.

DOCUMENTAZIONE DI RIFERIMENTO:
Il Progetto North è una migrazione della durata di 12 settimane per un team di 40 persone. Il budget approvato per la migrazione è pari a $48.000. Non è stata ancora fissata la tempistica per la revisione di sicurezza. Il team desidera una raccomandazione su un modello per la ricerca, la redazione e la revisione del codice. Una nota di una parte interessata indica che l’attuale bozza è troppo lunga, ma non fornisce il conteggio delle parole.

Inviare solo la guida.
GPT-6 Sol · output completo
## Decisione

Non indicare ancora un modello vincitore. Il pacchetto di partenza richiede una raccomandazione tra due modelli di IA, ma non identifica nessuno dei due modelli né fornisce risultati relativi alla ricerca, alla stesura di documenti o alla revisione del codice. Affermare che uno dei due sia migliore sarebbe quindi privo di fondamento. La raccomandazione pratica è quella di confrontare i due candidati con il lavoro effettivo del team prima di effettuare una selezione.

Il Progetto North ha una scadenza di 12 settimane. Il budget per la migrazione è pari a $48.000. La revisione di sicurezza non è ancora stata programmata. Questi fatti rendono la decisione urgente, ma non giustificano una scelta a caso. Una scelta utile deve tenere conto del fatto che un modello aiuti il team di 40 persone a portare a termine i propri compiti effettivi, di come il suo utilizzo rientri nel budget approvato e di ciò che rimane incerto fino a quando non si conoscerà la tempistica della revisione di sicurezza.

Considerare la raccomandazione come condizionata: scegliere il modello che offre prestazioni migliori su attività rappresentative, che possa essere utilizzato entro il budget di migrazione approvato e che superi qualsiasi revisione necessaria per l’uso previsto. Se nessuno dei due candidati soddisfa tali condizioni, la guida dovrebbe indicare che nessuno dei due può ancora essere raccomandato. Il materiale disponibile non dimostra che una delle due condizioni sia stata soddisfatta.

## Prove

Il team desidera una raccomandazione su un modello per tre tipi di attività: ricerca, scrittura e revisione del codice. Queste sono le categorie di confronto appropriate poiché derivano dall’esigenza dichiarata, non dai presunti punti di forza del prodotto. Il fascicolo non contiene esempi dei risultati di entrambi i modelli, né risultati di valutazione, né una descrizione di ciò che i due candidati offrono. Non contiene inoltre prezzi o parametri di riferimento. Di conseguenza, non vi è alcuna base probatoria per classificare i modelli in termini di accuratezza, velocità, qualità, costo o idoneità.

Il contesto del progetto fornisce tuttavia criteri decisionali utili. Il Progetto North consiste nella migrazione di un team di 40 persone, pertanto un confronto dovrebbe riflettere le attività che i membri di quel team svolgerebbero effettivamente. Il budget approvato per la migrazione è di $48.000; qualsiasi proposta di utilizzo di un modello deve essere valutata in relazione a tale importo piuttosto che a una dotazione inventata per gli strumenti di IA. La revisione di sicurezza non è in programma, il che lascia irrisolta la tempistica di tale revisione — e il suo effetto sull’adozione.

Una parte interessata ha affermato che l’attuale bozza è troppo lunga, ma non ha fornito un conteggio delle parole. Ciò è indice di una preferenza per la concisione, non di un limite misurabile per l’output del modello. Nel confrontare i campioni di scrittura, i revisori possono valutare se ciascun candidato rispetti la richiesta di concisione e mantenga i fatti essenziali. Non dovrebbero affermare che uno dei due modelli soddisfi un limite di parole specificato da una parte interessata, poiché non ne è stato fornito alcuno.

Per la ricerca, una prova utile sarebbe verificare se ciascun candidato distingua i fatti forniti dalle questioni aperte ed eviti conclusioni non supportate. Per quanto riguarda la scrittura, sarebbe importante verificare se ciascuno produca una bozza chiara e adeguatamente concisa senza tralasciare i vincoli. Per la revisione del codice, sarebbe importante verificare se ciascuno identifichi i problemi in un esempio fornito e li spieghi in modo che un revisore possa verificarli. Si tratta di test proposti, non di risultati relativi a nessuno dei due modelli.

## Avvertenze

L’avvertenza principale è che i candidati stessi non sono stati identificati: il fascicolo non ne indica i nomi. Inoltre, non specifica in che modo il team potrebbe accedervi, quale sia il loro costo, né se uno dei due sia disponibile per il lavoro previsto. Non si dovrebbe dedurre alcuna funzionalità del prodotto dalla frase “modelli di IA”. Anche un confronto ben progettato non può fornire una raccomandazione sul prodotto finché non si conoscono i candidati e le prove di valutazione.

Il budget per la migrazione è stato approvato, ma il documento non ne destina alcuna parte all’uso o al collaudo dei modelli. Non considerare $48.000 come un budget per l’acquisto di IA. Allo stesso modo, una scadenza di 12 settimane non stabilisce una data entro la quale avrà luogo la revisione di sicurezza. Poiché la revisione di sicurezza non è programmata, resta irrisolta la questione se e quando un candidato possa essere utilizzato in base ai requisiti del team.

I tre utilizzi richiesti potrebbero inoltre produrre risultati diversi. Un candidato potrebbe essere preferibile per un’attività e non per un’altra; il pacchetto non fornisce alcuna base per ipotizzare un unico vincitore tra ricerca, scrittura e revisione del codice. Una raccomandazione dovrebbe rendere visibile qualsiasi compromesso di questo tipo, anziché nasconderlo in un’etichetta generica. Se il team decide che una categoria è più importante delle altre, tale priorità dovrebbe provenire dalle parti interessate, non da questa guida.

Infine, l’osservazione relativa alla lunghezza eccessiva della bozza non dovrebbe essere scambiata per una prova delle prestazioni del modello. Essa descrive il feedback su una bozza attuale, senza identificarne l’autore né indicare una lunghezza target. Può fornire indicazioni su come presentare la raccomandazione finale, ma non può risolvere il confronto.

## Passo successivo

Identificate i due candidati e chiedete al team di fornire compiti rappresentativi di ricerca, scrittura e revisione del codice. Fornire a ciascun modello gli stessi materiali e le stesse istruzioni per ogni attività, comprese le indicazioni per segnalare l’incertezza ed evitare di aggiungere fatti. Chiedere ai revisori di registrare cosa ogni risposta ha azzeccato, cosa ha tralasciato e quali affermazioni richiedono verifica. Tenere separate le osservazioni specifiche per ciascuna attività, in modo che un campione di scrittura di alto livello non sostituisca le prove relative alla revisione del codice.

Prima di scegliere, verificare che il costo dell’utilizzo previsto rientri nel budget di migrazione di $48.000 e stabilire quando potrà avvenire la revisione di sicurezza. Nessuna delle due risposte è contenuta nel fascicolo. Se tali questioni non possono essere risolte in tempo per prendere una decisione, segnalare chiaramente tale vincolo anziché presentare una preferenza provvisoria come scelta approvata.

La raccomandazione finale all’acquirente potrà quindi essere concisa e verificabile: indicare i candidati, esporre le prove relative a ciascuno dei tre utilizzi, spiegare eventuali compromessi e identificare le questioni in sospeso relative all’approvazione o al budget. Finché tali informazioni non saranno disponibili, la risposta onesta per il Progetto North non è “Modello A” o “Modello B”, bensì che il confronto non è ancora stato supportato da prove.
Consideratelo come una verifica volta a valutare il contesto, non come una classifica di qualità.
Scrittura di testi lunghi
Completamento entro lo stesso limite massimo di produzione di 2.400 token
Lo stesso brief prevedeva cinque sezioni. Entrambi i modelli avevano un limite di 2.400 token per l’output; i metadati restituiti spiegano la differenza visibile.
Claude ha raggiunto il limite massimo di output configurato prima della regola di decisione. Sol ha completato il brief entro tale limite. Ciò avvalora una raccomandazione relativa a questa esecuzione con vincoli, non una valutazione generale della massima capacità di scrittura o velocità. Il testo completo restituito, compresa la risposta troncata, è riportato di seguito.
Compito di lunga durata
Testi di lunga durata: GPT-6 Sol ha completato il brief
Questo è il primo esercizio di confronto diretto. Il prompt indicava esplicitamente Claude Opus 5,5 e GPT-6 Sol, ha fornito a entrambi lo stesso fascicolo informativo sul “Progetto Nord” e ha richiesto una nota di decisione condizionata.
| Misura | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Lunghezza visibile | 648 parole; motivo_interruzione=lunghezza | 1.065 parole; motivo_di_conclusione=interruzione |
| Sezioni obbligatorie | 4 su 5; Regola di decisione mancante dopo il troncamento | 5 su 5 |
| Scheda di valutazione a quattro colonne | Presente e simmetrico | Presente e simmetrico |
| Controlli pilota / condizioni di arresto | Iniziato ma interrotto prima del completamento | Tre controlli e una condizione di arresto |
| Punteggio | 7.0 / 10 | 10.0 / 10 |
Da qui il risultato: Con lo stesso limite di output di 2.400 token, GPT-6 Sol ha restituito tutte e cinque le sezioni, mentre Claude Opus 5.5 ha raggiunto il limite prima della regola “Decision”. Ciò dimostra il completamento del compito con questa configurazione; non stabilisce né la capacità massima di scrittura di entrambi i modelli né la loro velocità generale.
Dati di input completi condivisi
Stai redigendo una nota decisionale per un team che deve scegliere tra Claude Opus 5.5 e GPT-6 Sol. I nomi dei modelli sono fissi e devono apparire esattamente come riportati. Utilizzando esclusivamente il pacchetto di dati di seguito riportato, scrivi un testo di 900–1100 parole che comprenda esattamente le seguenti sezioni: Raccomandazione esecutiva; Cosa emerge dalle prove; Dove mancano le prove; Progetto pilota di 30 giorni; Criteri decisionali.

Requisiti: (1) confrontare Claude Opus 5.5 e GPT-6 Sol in modo simmetrico; (2) distinguere tra prove osservate, ipotesi e incognite; (3) mantenere le date esatte, il budget, le dimensioni del team e lo stato di sicurezza irrisolto; (4) includere una scheda di valutazione compatta di quattro righe che copra la sintesi della ricerca, la redazione di testi estesi, la revisione del codice e il JSON strutturato; (5) fornire una raccomandazione condizionata anziché inventare un vincitore; (6) elencare tre verifiche pilota misurabili e una condizione di interruzione; (7) non inventare prezzi, benchmark, limiti di contesto o funzionalità del prodotto.

PACCHETTO DI PROVE
- Il Progetto North è una migrazione della durata di 12 settimane per un team di 40 persone.
- Il budget approvato per la migrazione è di $48.000. Il pacchetto non specifica se l’utilizzo del modello rientri in tale budget.
- Non è stata fissata alcuna tempistica per la revisione della sicurezza.
- Il team necessita di sintesi di ricerche, redazione di testi estesi, revisione del codice ed estrazione strutturata di dati JSON.
- Uno stakeholder sostiene che la bozza attuale sia troppo lunga, ma non è stato approvato alcun numero target di parole.
- Non sono ancora stati forniti output controllati da Claude Opus 5.5 o GPT-6 Sol.
- Il team desidera una scelta verificabile e può eseguire una fase pilota di 30 giorni con prompt identici e revisione umana.

Restituisci solo la nota. Non affermare che il pacchetto di prove dimostri che uno dei due modelli sia migliore dell’altro.
Claude Opus 5.5 · uscita completa restituita
## Raccomandazione esecutiva

Non selezionare ancora Claude Opus 5.5 né GPT-6 Sol. Il pacchetto di dati non contiene output controllati provenienti da nessuno dei due modelli. Non vi è quindi alcuna base osservabile per dichiarare uno migliore dell’altro su nessuno dei quattro carichi di lavoro richiesti.

La raccomandazione è condizionata. Eseguire un progetto pilota di 30 giorni in cui a entrambi i modelli vengano forniti prompt identici e venga applicata la stessa revisione umana. Successivamente, selezionare il modello che soddisfa le soglie concordate prima dell’inizio del progetto pilota, a condizione che vengano prima risolte le questioni relative alla sicurezza e al budget riportate di seguito. Sono possibili tre esiti:

- **Un modello supera le soglie:** scegliere quel modello.
- **Entrambi superano le soglie:** applicare i criteri di spareggio previsti nella regola decisionale.
- **Nessuno dei due supera le soglie:** non adottare nessuno dei due.

Questo approccio offre al team la scelta verificabile che ha richiesto.

I dati fissi del progetto sono:

- Il Progetto North è una migrazione della durata di 12 settimane per un team di 40 persone.
- Il budget approvato per la migrazione è di $48.000. Il fascicolo non specifica se l’utilizzo del modello rientri in tale budget.
- Non è prevista alcuna tempistica per la revisione di sicurezza.
- Il fascicolo non fornisce date precise (né data di inizio del progetto, né data di fine, né finestra temporale per la fase pilota), pertanto la presente nota non ne assegna alcuna.

## Cosa dimostrano le prove

**Prove osservate.** Si tratta di fatti indicati direttamente nel fascicolo:

- Il Progetto North consiste in una migrazione della durata di 12 settimane per un team di 40 persone.
- Il budget approvato per la migrazione è pari a $48.000 e non è specificato se tale importo copra l’utilizzo del modello.
- Non è stata fissata alcuna tempistica per la revisione di sicurezza.
- I carichi di lavoro richiesti sono la sintesi di ricerche, la redazione di testi estesi, la revisione del codice e l’estrazione strutturata di dati JSON.
- Uno stakeholder afferma che l’attuale bozza è troppo lunga, ma non è stato approvato alcun numero di parole target.
- Non sono stati forniti output controllati da Claude Opus 5.5 o GPT-6 Sol.
- Il team desidera una scelta verificabile e può condurre una fase pilota di 30 giorni con prompt identici e revisione umana.

**Cosa sostiene questo.** Le prove definiscono cosa deve essere valutato e in che modo, ma non quale modello risulti vincente. Giustificano una fase pilota strutturata e comparativa. Non giustifica alcuna affermazione relativa a qualità, velocità, costo, gestione del contesto o disponibilità di funzionalità per nessuno dei due modelli.

**Scheda di valutazione (stato attuale delle prove)**

| Carico di lavoro | Claude Opus 5.5 | GPT-6 Sol | Misura pilota |
|---|---|---|---|
| Sintesi della ricerca | Nessun output controllato fornito | Nessun output controllato fornito | Punteggio della rubrica del revisore in cieco |
| Scrittura di testi estesi | Nessun output controllato fornito | Nessun output controllato fornito | Punteggio della rubrica più rispetto di un obiettivo di lunghezza approvato |
| Revisione del codice | Nessun output controllato fornito | Nessun output controllato fornito | Percentuale di problemi noti identificati |
| JSON strutturato | Nessun output controllato fornito | Nessun output controllato fornito | Tasso di superamento della convalida dello schema |

Ogni cella per entrambi i modelli è identica perché il pacchetto li tratta allo stesso modo. Nessuna riga attualmente favorisce uno dei due modelli.

## Dove mancano le prove

**Incertezze.** Il documento non fornisce indicazioni su ciascuno dei seguenti punti:

- Se i costi di utilizzo dei modelli rientrino nel budget di migrazione di $48.000 o richiedano un finanziamento separato.
- Quando avrà luogo la revisione di sicurezza, quali aspetti coprirà e se uno dei due modelli sia accettabile in base a essa. Lo stato di sicurezza è irrisolto per entrambi i modelli.
- Le date del calendario per la migrazione di 12 settimane e il progetto pilota di 30 giorni.
- Un numero di parole target approvato per la scrittura di testi lunghi. Senza di esso, non è possibile valutare il commento "troppo lungo" espresso dalle parti interessate.
- Prezzi, risultati dei benchmark, limiti di contesto e funzionalità del prodotto per Claude Opus 5.5 e GPT-6 Sol. Non viene fornito alcun dato in merito e la presente nota non formula alcuna ipotesi al riguardo.
- Chi sono i revisori umani, quanti sono e come verranno risolte le divergenze tra loro.
- Quali dati potrà utilizzare la fase pilota prima che la revisione di sicurezza sia completata.

**Ipotesi.** Si tratta di proposte formulate in questa nota, non di fatti tratti dal fascicolo, e ciascuna richiede l’approvazione del team:

- Il progetto pilota può utilizzare materiale non sensibile o sintetico fino a quando la revisione di sicurezza non autorizzi l’uso di dati reali.
- Ai revisori può essere nascosto quale modello abbia prodotto ciascun risultato.
- Il team può assemblare un set fisso di prompt per ciascun carico di lavoro che rappresenti le attività reali del Progetto North.
- Le soglie di superamento proposte di seguito sono punti di partenza che il team può modificare prima dell’inizio del progetto pilota, ma non durante lo stesso.

## Progetto pilota di 30 giorni

**Progettazione**

1.
GPT-6 Sol · output completo restituito
## Raccomandazione dell'esecutivo

Non selezionare ancora Claude Opus 5.5 o GPT-6 Sol. Il Progetto North prevede una migrazione di 12 settimane per un team di 40 persone e il pacchetto non fornisce risultati controllati da nessuno dei due modelli. È quindi opportuno elaborare un piano di confronto, non un giudizio sulle prestazioni. Eseguire il pilot di 30 giorni disponibile con prompt identici e revisione umana, quindi effettuare una scelta verificabile in base ai criteri concordati prima di esaminare i risultati. Scegliere uno dei due modelli solo se il lavoro sottoposto a revisione soddisfa le esigenze del team, il suo utilizzo rientra nell’accordo finanziario approvato e la revisione di sicurezza in sospeso ne consente l’adozione. Se tali condizioni non sono soddisfatte, rinviare la selezione piuttosto che considerare un confronto incompleto come un risultato positivo.

Il budget approvato per la migrazione è di $48.000. Il fascicolo non specifica se l’utilizzo del modello rientri in tale budget. Non è prevista una tempistica per la revisione di sicurezza. Questi sono vincoli decisionali validi sia per Claude Opus 5.5 che per GPT-6 Sol, non prove a favore di uno piuttosto che dell’altro.

## Cosa supportano le prove

**Osservato:** Il team necessita di sintesi di ricerca, scrittura di testi estesi, revisione del codice ed estrazione strutturata di dati JSON. Desidera una scelta verificabile e può eseguire una fase pilota di 30 giorni utilizzando prompt identici e revisione umana. Un stakeholder afferma che la bozza attuale è troppo lunga, ma non è stato approvato alcun numero di parole target. Tale feedback individua un problema da verificare nei risultati scritti; non stabilisce un modello preferito né una lunghezza accettabile.

L’attuale scheda di valutazione per singola attività è volutamente priva di classifica:

| Flusso di lavoro | Claude Opus 5.5 | GPT-6 Sol | Dati pilota da raccogliere |
|---|---|---|---|
| Sintesi di ricerca | Non ancora testata | Non ancora testata | Accuratezza, copertura e tracciabilità valutate dai revisori |
| Scrittura estesa | Non ancora testato | Non ancora testato | Utilità, chiarezza e concisione valutate dai revisori |
| Revisione del codice | Non ancora testato | Non ancora testato | Risultati verificati dai revisori e affermazioni non supportate |
| JSON strutturato | Non ancora testato | Non ancora testato | Risultati validi ed estrazione corretta dei campi |

**Ipotesi ai fini della pianificazione, non un risultato osservato:** Campioni di lavoro comparabili e una griglia di valutazione comune possono rivelare differenze rilevanti per il Progetto North. Il progetto pilota dovrebbe verificare tale ipotesi. Le sole istruzioni identiche non renderanno la scelta verificabile: il team deve anche conservare gli input, entrambi gli output, i criteri di revisione, i giudizi dei revisori e le motivazioni di eventuali esclusioni o ripetizioni. La revisione umana dovrebbe applicare lo stesso standard a ciascun modello.

Per la scrittura di testi estesi, i revisori dovrebbero distinguere tra “troppo lungo” e “non utile”. Una risposta più breve potrebbe omettere materiale necessario; una risposta più lunga potrebbe comunque essere chiara e utilizzabile. Poiché non è stato approvato alcun numero di parole target, il progetto pilota può registrare la lunghezza e i giudizi dei revisori, ma non dovrebbe dichiarare retroattivamente un numero arbitrario di parole come standard di accettazione. La stessa disciplina si applica alle altre attività: registrare ciò che i revisori hanno osservato, piuttosto che convertire le preferenze in affermazioni sulle capacità generali del modello.

## Dove mancano le prove

**Sconosciuto:** Il pacchetto non contiene output controllati provenienti da Claude Opus 5.5 o GPT-6 Sol. Non stabilisce alcuna qualità relativa, affidabilità o idoneità per nessuno dei quattro flussi di lavoro. Non fornisce inoltre prezzi, limiti di contesto, benchmark o informazioni sulle capacità del prodotto. Di conseguenza, questa nota non può stimare i costi di utilizzo né dedurre quale modello funzionerebbe meglio sul materiale del Progetto North.

Il limite di bilancio necessita di chiarimenti prima di una decisione di acquisto. Il $48.000 rappresenta il budget approvato per la *migrazione*; non è specificato se l’utilizzo del modello debba essere pagato attingendo da esso. Considerarlo come incluso o aggiuntivo creerebbe un’ipotesi finanziaria che il pacchetto non supporta. Il team dovrebbe documentare la risposta e il percorso di approvazione applicabile prima di impegnarsi in un utilizzo continuativo.

Anche la questione della sicurezza rimane irrisolta per entrambi i candidati. Non è prevista una tempistica per la revisione di sicurezza e il fascicolo non fornisce alcun esito in materia. Un risultato positivo della fase pilota non risolverebbe tale situazione. Il team dovrebbe identificare chi può programmare e decidere la revisione, quali informazioni siano necessarie al revisore e se l’attività pilota stessa sia consentita dalle norme applicabili; il fascicolo non risponde a tali domande. Non vengono fornite date di inizio o fine per la migrazione, la fase pilota o la revisione di sicurezza; pertanto, il team non dovrebbe dare ad intendere che una decisione in materia di sicurezza arriverà entro i 30 giorni della fase pilota o le 12 settimane della migrazione.

## Prova pilota di 30 giorni

Prima del primo confronto, il team dovrebbe selezionare prompt rappresentativi per tutti e quattro i flussi di lavoro, definire la forma prevista di ciascuna risposta e concordare una griglia di valutazione per la revisione umana. Entrambi i modelli dovrebbero ricevere prompt identici e le stesse istruzioni di revisione. I revisori dovrebbero registrare i propri giudizi in base al lavoro svolto piuttosto che alla reputazione di un modello. Conservare il prompt, l’output, la revisione ed eventuali correzioni richieste in modo che un lettore successivo possa ricostruire ogni giudizio. Registrare le deviazioni dal processo comune invece di tralasciare silenziosamente i casi difficili.

Utilizzare tre controlli misurabili:

1. **Qualità dell’attività valutata:** per la sintesi di ricerche, la scrittura di testi estesi e la revisione del codice, calcolare la percentuale di output che i valutatori accettano per l’attività specificata. Registrare inoltre separatamente i motivi di rifiuto — ad esempio, copertura mancante, scrittura poco chiara o un risultato non verificato nella revisione del codice. Riportare i risultati per flusso di lavoro e modello, non solo come un unico punteggio aggregato.
2. **Affidabilità del JSON strutturato:** Contare i risultati che corrispondono alla struttura concordata e quelli i cui campi estratti sono verificati come corretti da un revisore. Riportare entrambi i tassi per Claude Opus 5.5 e GPT-6 Sol; una risposta strutturalmente valida non dovrebbe essere considerata accurata solo perché analizzabile.
3. **Impegno di revisione e tracciabilità:** Registrare il tempo impiegato dal revisore per controllare e, se necessario, correggere ciascun output. Contare i casi in cui mancano prove sufficienti a giustificare la decisione del revisore. Confrontare queste misure sullo stesso insieme di prompt, inclusi i casi in cui nessuno dei due output è accettabile.

Concordare gli standard di accettazione e le modalità di gestione dei casi di parità prima di esaminare i risultati della fase pilota; il pacchetto non fornisce alcun benchmark da cui ricavare soglie numeriche. Al termine dei 30 giorni, pubblicare la griglia di valutazione, i conteggi, le motivazioni dei revisori e le questioni irrisolte. **Condizione di interruzione:** sospendere l’adozione se i requisiti di sicurezza per la fase pilota o l’uso successivo non possono essere soddisfatti, oppure se il team non è in grado di stabilire un budget valido e un percorso di approvazione. Non sostituire le autorizzazioni con punteggi di qualità favorevoli.

## Regola decisionale

Selezionare Claude Opus 5.5 se i risultati del progetto pilota soddisfano gli standard concordati in precedenza, risultano sostanzialmente più solidi nei flussi di lavoro a cui il team attribuisce priorità e le relative condizioni di sicurezza e finanziarie sono state risolte. Applicare esattamente la stessa regola a GPT-6 Sol. Se entrambi soddisfano gli standard senza differenze sostanziali e rilevanti, decidere in base alle priorità di progetto documentate e ai vincoli risolti, piuttosto che indicare un vincitore in termini di prestazioni. Se nessuno dei due si qualifica — o se i limiti di budget o lo stato di sicurezza rimangono irrisolti — non effettuare ancora alcuna selezione del modello. Tale esito garantisce una decisione verificabile per il team di 40 persone senza affermare più di quanto le prove possano sostenere.
Metadati: Claude — HTTP 200 · 25,98 s · finish_reason=length · prompt_tokens=598 · completion_tokens=2400
GPT — HTTP 200 · 27,763 s · finish_reason=stop · prompt_tokens=386 · completion_tokens=1695
Sintesi da sorgente
Compito di ricerca
Sintesi da sorgente: un pareggio
Entrambi i modelli hanno risolto il conflitto relativo alla data fissandola al 15 ottobre, hanno mantenuto il budget concordato di $12.000 e hanno considerato l’affermazione “sempre accurato” come un’affermazione del manager priva di fondamento. Il risultato è un pareggio in questa attività.
| Misura | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Punteggio | 9.5 / 10 | 9.5 / 10 |
| Gestione dei conflitti | S2 gestisce la scadenza | S2 gestisce la scadenza |
| Affermazione priva di fondamento | Contrassegnato come non supportato | Contrassegnato come non supportato |
| Differenza pratica | Spiegazione più dettagliata dei rischi | Raccomandazione più sintetica |
Dati di input completi condivisi
Riconcilia le note di riferimento riportate di seguito. Fornisci (1) una tabella in formato Markdown con le colonne “Affermazione”, “Fonte di riferimento”, “Stato”, “Motivo” e (2) una raccomandazione di circa 250 parole. Utilizza la nota politica con data più recente come fonte di riferimento solo per il conflitto relativo alla scadenza. Contrassegna le affermazioni non comprovate come “non comprovate”. Non aggiungere fatti.

[S1 01/09/2026] Il progetto pilota termina il 30 settembre. Il budget è di $12.000.
[S2 03/09/2026] Il progetto pilota termina il 15 ottobre. Il budget rimane $12.000.
[S3 02/09/2026] L’ufficio legale non ha approvato la condivisione di dati esterni.
[S4 04/09/2026] Un responsabile afferma che il modello è “sempre accurato”; non è allegata alcuna prova di verifica.
[S5 04/09/2026] Il team del progetto pilota è composto da 8 membri.
[S6 05/09/2026] La nota decisionale deve elencare i rischi irrisolti.

Restituire solo la tabella e la raccomandazione.
Claude Opus 5,5 · produzione completa
| Affermazione | Fonte di riferimento | Stato | Motivo |
|---|---|---|---|
| Il progetto pilota termina il 30 settembre | S2 (03/09/2026) | Superata | In conflitto con S2. La nota con data più recente prevale in caso di conflitto di scadenze. |
| Il progetto pilota termina il 15 ottobre | S2 (03/09/2026) | Confermata (prevalente) | Si tratta della nota con data più recente relativa al conflitto di scadenze, pertanto prevale su S1. |
| Il budget è di $12.000 | S1 e S2 | Confermato | Entrambe le fonti concordano e S2 afferma che il budget "rimane" $12.000. Non vi è alcun conflitto. |
| L’ufficio legale non ha approvato la condivisione di dati esterni | S3 | Confermato | Affermato direttamente e non contraddetto da nessun’altra fonte. |
| Il modello è "sempre accurato" | S4 | Non confermato | Si tratta di un’affermazione di un dirigente senza prove a sostegno. |
| Il team pilota è composto da 8 membri | S5 | Confermato | Affermato esplicitamente e non contraddetto. Proviene da un’unica fonte. |
| La nota decisionale deve elencare i rischi irrisolti | S6 | Confermato | Si tratta di un requisito esplicito per la nota e non è contraddetto. |

**Raccomandazione**

La nota decisionale dovrebbe indicare il 15 ottobre come data di conclusione del progetto pilota. S2 è la nota con data più recente e risolve il conflitto di scadenze, sostituendo la data del 30 settembre riportata in S1. La regola della data più recente si applica solo a questo conflitto. Le altre affermazioni sono state valutate in base alle rispettive prove a sostegno.

Il budget dovrebbe essere registrato come $12.000. S1 e S2 concordano su questa cifra, quindi non è necessaria alcuna riconciliazione. È possibile includere anche la dimensione del team di otto membri. Ciò si basa esclusivamente su S5, ma nessuna fonte lo contraddice.

S6 richiede che la nota elenchi i rischi irrisolti, e le note ne supportano almeno due.

- **Condivisione dei dati esterni:** l’ufficio legale non l’ha approvata (S3). La nota dovrebbe indicarlo chiaramente. Non dovrebbe sottintendere che la condivisione dei dati esterni sia consentita durante la fase pilota.
- **Accuratezza del modello:** L’affermazione secondo cui il modello è "sempre accurato" non è supportata. S4 rileva che non è allegata alcuna prova di verifica e registra l’affermazione solo come dichiarazione di un dirigente. La nota non dovrebbe presentarla come un risultato né basarsi su di essa per giustificare decisioni. Dovrebbe indicare l’accuratezza del modello come non verificata fino a quando non vengano fornite prove a sostegno.

Infine, la nota dovrebbe segnalare brevemente che la data di conclusione della fase pilota è cambiata tra S1 e S2. I lettori potrebbero imbattersi altrove nella data precedente del 30 settembre, e questa nota spiegherebbe perché viene utilizzata quella del 15 ottobre. La nota non dovrebbe aggiungere spiegazioni relative alla modifica, risultati di test o aggiornamenti sullo stato giuridico, poiché nulla di tutto ciò compare nelle note di riferimento.
GPT-6 Sol · output completo
| Affermazione | Fonte di riferimento | Stato | Motivo |
|---|---|---|---|
| Il progetto pilota termina il 30 settembre. | S2 (03/09/2026) | Superata | La nota con data successiva risolve il conflitto di scadenze e indica il 15 ottobre. |
| Il progetto pilota termina il 15 ottobre. | S2 (03/09/2026) | Confermato | S2 fornisce la scadenza determinante. |
| Il budget è pari a $12.000. | S1 e S2 | Confermato | Entrambe le note indicano lo stesso importo. |
| L’ufficio legale non ha approvato la condivisione di dati esterni. | S3 | Confermato | S3 lo afferma esplicitamente; nessuna nota successiva affronta tale approvazione. |
| Il modello è “sempre accurato”. | S4 | Non confermato | Un manager fa questa affermazione, ma non è allegata alcuna prova di verifica. |
| Il team del progetto pilota è composto da 8 membri. | S5 | Supportato | S5 indica la dimensione del team. |
| La nota decisionale deve elencare i rischi irrisolti. | S6 | Supportato | S6 indica questo requisito. |

**Raccomandazione:** Utilizzare il 15 ottobre come data di conclusione del progetto pilota nella nota decisionale. S2 è successivo a S1 e risolve il conflitto tra le scadenze. Mantenere il budget a $12.000: le note concordano su tale importo, quindi la modifica della scadenza non fornisce alcun motivo per modificarlo. Registrare la dimensione del team del progetto pilota come 8 membri, come indicato in S5.

Elencare esplicitamente i rischi irrisolti, come richiesto da S6. La nota dovrebbe indicare che l’Ufficio Legale non ha approvato la condivisione di dati esterni, senza sottintendere che l’approvazione sia stata concessa successivamente o che la condivisione sia consentita. Dovrebbe inoltre distinguere l’affermazione del responsabile riguardo all’accuratezza da un risultato accertato. L’S4 riporta l’affermazione secondo cui il modello è “sempre accurato”, ma non fornisce alcuna prova di verifica. Non presentare tale affermazione come un risultato verificato.

Limitare la riconciliazione a un ambito ristretto. L’S2 risolve la questione delle date di scadenza contrastanti; non sostituisce le note separate relative all’Ufficio Legale, all’accuratezza, alla composizione del team o ai requisiti della nota. Laddove le note non stabiliscano un esito, lasciare la questione irrisolta piuttosto che fornire un’ipotesi. In particolare, la documentazione non supporta né l’affermazione che la condivisione dei dati con soggetti esterni sia stata approvata, né quella che l’accuratezza del modello sia stata dimostrata.

La nota risultante può quindi utilizzare la scadenza del 15 ottobre e il budget di $12.000, identificando al contempo le due lacune probatorie evidenti in queste note: l’approvazione legale in sospeso per la condivisione dei dati esterni e l’assenza di prove di verifica a sostegno dell’affermazione sull’accuratezza.
Metadati: Claude — HTTP 200 · 12,846 s · finish_reason=stop · prompt_tokens=338 · completion_tokens=1193
GPT — HTTP 200 · 12,322 s · finish_reason=stop · prompt_tokens=230 · completion_tokens=714
Codifica e output strutturato
La differenza nella codifica risiedeva nella spiegazione
Condizione di filtraggio originale: se t
Un elemento None è considerato falso, quindi questo filtro lo ignora già.
Entrambi i modelli hanno restituito un JSON valido contenente le quattro chiavi richieste e la stessa patch minima. Claude ha descritto correttamente il filtro esistente; GPT-6 Sol ha erroneamente affermato che un elemento None avrebbe causato un errore. Questo specifico errore di diagnosi è rilevante quando un revisore deve decidere se una patch risolva effettivamente il problema.
Claude ha fornito un elenco di rischi, mentre Sol ha fornito una breve stringa relativa ai rischi. Il prompt non richiedeva un tipo specifico per quel campo, quindi questa differenza non costituisce una violazione del contratto. Il punteggio dell’attività di Sol è 9,0/10 dopo la correzione della precedente deduzione di mezzo punto non giustificata; la deduzione relativa all’accuratezza fattuale rimane.
Attività di codifica
Codifica e output strutturato: Claude Opus 5.5 è risultato più preciso
Entrambi i modelli hanno restituito un JSON valido contenente le chiavi richieste e la stessa patch minima. Claude ha spiegato correttamente che il filtro originale salta già un Nessuno elemento. GPT-6 Sol ha erroneamente affermato che un Nessuno L'elemento causerebbe un errore. Il prompt non richiedeva un tipo specifico per il campo "rischi".
| Misura | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Punteggio | 10.0 / 10 | 9.0 / 10 |
| Patch | Corretto ed essenziale | Corretto ed essenziale |
| Diagnosi | Isola correttamente entrambi i difetti | Esagera l'errore relativo all'elemento "None" |
| Contratto JSON richiesto | JSON valido; tutte e quattro le chiavi sono presenti | JSON valido; tutte e quattro le chiavi sono presenti |
Dati di input completi condivisi
Restituisci solo un JSON rigoroso contenente le chiavi diagnosis, patch, tests, risks. Esegui la diagnosi e applica una correzione minima a questa funzione Python in modo che tutti e tre i casi superino il test. La correzione deve mantenere la firma della funzione.

def normalize_tags(tags):
    return ','.join(sorted(set(t.strip().lower() for t in tags if t)))

Casi:
1) [' AI ', 'ai', 'Code'] -> 'ai,code'
2) None -> ''
3) ['  ', None, 'SEO'] -> 'seo'

Non eseguire codice e non includere blocchi Markdown o testo libero al di fuori del JSON.
Claude Opus 5,5 · produzione completa
{"diagnosis":"Due difetti, individuati leggendo il codice (non eseguito). (a) Caso 2: quando `tags` è `None`, il generatore itera su `None` e genera un `TypeError` invece di restituire `''`. (b) Caso 3: il filtro `if t` viene eseguito prima della rimozione degli spazi. Il tag composto esclusivamente da spazi ' ' è considerato vero, quindi viene accettato e diventa ''. Il risultato è sorted(['', 'seo']), che viene unito a ',seo' invece che a 'seo'. L’elemento None nel caso 3 viene già scartato da 'if t'. Il caso 1 funziona già: ' AI ', 'ai' e 'Code' vengono normalizzati in {'ai', 'code'}, dando 'ai,code'.','patch":"def normalize_tags(tags):\n return ",".join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))','tests":["assert normalize_tags([" AI ", 'ai', 'Code']) == 'ai,code' # tracciato: {'ai','code'} -> 'ai,code'','assert normalize_tags(None) == "" # tracciato: (None or []) -> [] -> ''','assert normalize_tags([" ", None, 'SEO']) == 'seo' # tracciato: ' ' fallisce in t.strip(), None fallisce in t, 'SEO' -> 'seo''],'rischi":["Gli elementi non stringa, come 123, genereranno un AttributeError su .strip(). Questo comportamento rimane invariato rispetto a quello originale.",""tags o []" considerano qualsiasi input falsy (ad esempio '' o una tupla vuota) come vuoto. Ciò è coerente con il comportamento richiesto None -> ''.','Se viene passata una singola stringa invece di un iterabile di tag, questa viene iterata carattere per carattere. Questo comportamento rimane invariato rispetto a quello originale.","Gli spazi interni non vengono uniti, quindi "machine learning" e 'machine learning' rimangono tag distinti.','I test sono stati ricavati esclusivamente tramite tracciamento manuale e non sono stati eseguiti, come da istruzioni."]}GPT-6 Sol · output completo
{"diagnosis":"La funzione genera un errore quando `tags` è `None` o contiene `None`, e mantiene le voci che diventano vuote dopo la rimozione degli spazi.","patch":"def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":[{"input":[" AI ","ai","Code"],"risultato atteso":"ai,code"},{"input":null,"risultato atteso":""},{"input":[" ",null,"SEO"],"expected":"seo"}],"risks":"Non eseguito. Le voci diverse da None vengono considerate stringhe."}Metadati: Claude — HTTP 200 · 10,832 s · finish_reason=stop · prompt_tokens=244 · completion_tokens=965
GPT — HTTP 200 · 7,71 s · finish_reason=stop · prompt_tokens=146 · completion_tokens=305
Il verdetto finale
Una scelta pratica
Quale modello si adatta meglio al tuo lavoro?
GPT-6 Sol è in testa a questa prima piccola serie di risultati perché ha completato il contratto in versione estesa modificato, mentre Claude Opus 5.5 ha raggiunto il limite massimo condiviso di 2.400 token. Claude Opus 5.5 è in testa nell’attività codice/JSON per quanto riguarda la precisione diagnostica. Per la sintesi del codice c’è un pareggio.
Scegliere GPT-6 Sol quando la priorità immediata è quella di completare in un’unica sessione un documento decisionale lungo e soggetto a molteplici vincoli. Scegli Claude Opus 5,5 quando la revisione del codice o dell’output strutturato trae vantaggio da una diagnosi più esplicita e da un inventario dei rischi. Se il vostro lavoro prevede entrambi gli aspetti, assegnate ogni attività al modello più adatto, invece di imporre un unico approccio universale.
GlobalGPT ti offre un modo pratico per tenere sia i modelli che il resto del tuo flusso di lavoro di intelligenza artificiale in un'unica dashboard. Ricerca, scrittura, programmazione, immagini, video e attività di produzione collegate alla CLI possono rimanere tutti nello stesso ambiente di lavoro.
Domande frequenti
Quale modello ha vinto il confronto?
GPT-6 Sol ha guidato il piccolo insieme di primi risultati con un punteggio di 28,5 a 26,5, dopo l’esclusione del compito originale relativo ai confini e la correzione della deduzione del contratto JSON. Tale vantaggio è derivato dal completamento del contratto in forma estesa rivisto, rispettando lo stesso limite di 2.400 token per l’output; Claude Opus 5.5 ha guidato l’attività relativa al codice e all’output strutturato, mentre la sintesi del codice sorgente ha registrato un pareggio.
Perché è stato escluso il primo test di lunga durata?
Il prompt originale non menzionava nessuno dei due modelli. Entrambi i modelli si sono correttamente rifiutati di indovinare le identità mancanti, quindi quella risposta serve a verificare se un modello richiede il contesto mancante invece di fingere di sapere.
Il modello Claude Opus 5.5 è più adatto alla codifica?
In questo esercizio relativo al codice e al formato JSON, Claude Opus 5.5 ha fornito una diagnosi più precisa e un elenco strutturato dei rischi. Un solo esercizio non è sufficiente per stabilire una classifica universale di codifica.
GPT-6 Sol è più adatto alla scrittura?
GPT-6 Sol ha completato la versione rivista del promemoria esteso entro i limiti richiesti già nel primo output. Il risultato conferma la validità di quella raccomandazione relativa al flusso di lavoro per questo test, non una generalizzazione valida per ogni attività di scrittura.
Posso provare entrambi i modelli senza cambiare piattaforma?
GlobalGPT è concepito come un abbonamento AI multimodello che riunisce diverse funzioni di intelligenza artificiale in un’unica dashboard. È utile per utilizzare lo stesso pacchetto di prompt di ricerca, scrittura e programmazione su diversi modelli e per mantenere il flusso di lavoro in un unico posto.
GlobalGPT ti permette di conservare sia i modelli che il resto del tuo flusso di lavoro di intelligenza artificiale in un unico posto. Inizia con il modello più adatto all'attività immediata, poi passa alle fasi successive del lavoro: ricerca, scrittura, programmazione, immagini, video o produzione tramite interfaccia a riga di comando, senza dover aprire un servizio separato per ogni fase.









