
Il API audio per il riconoscimento vocale OpenAI converte il testo in audio parlato tramite POST https://api.openai.com/v1/audio/speech. Invia un modello, il testo da elaborare e una voce; salva la risposta in formato MP3 o in un altro formato audio supportato. Per una nuova integrazione che richiede istruzioni relative al tono e alla pronuncia, inizia con gpt-4o-mini-tts.
Una richiesta di lavoro è solo il primo passo. Servono anche l’unità di fatturazione corretta, un file di output riproducibile e un piano per i copioni lunghi. Il modello TTS più recente di OpenAI utilizza token di testo e audio per il calcolo dei prezzi; i suoi modelli TTS precedenti utilizzano i caratteri. Questa differenza è importante quando si calcola il costo di un mese di narrazione.
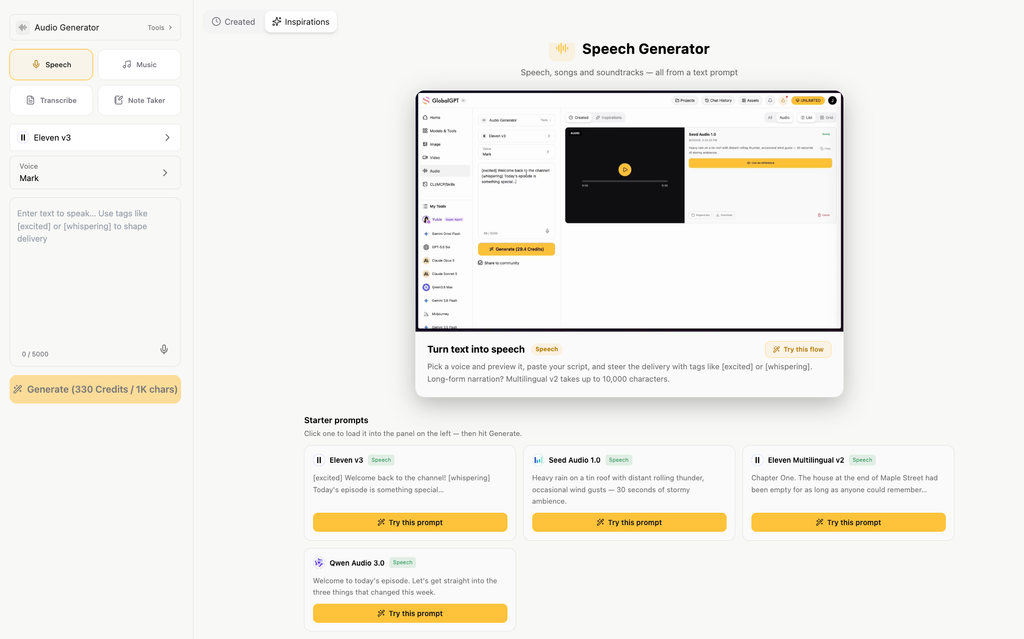
Se il tuo lavoro prevede anche la stesura della sceneggiatura, la realizzazione delle immagini e il montaggio di un video, L'area di lavoro audio di GlobalGPT rende accessibile la generazione vocale attraverso una piattaforma multimediale in abbonamento a prezzi contenuti. È possibile lavorare con testo, voce, immagini e video da un’unica dashboard, per poi utilizzare la sua API e la CLI per attività di produzione ripetibili. La sua API TTS pubblica utilizza un flusso di lavoro dedicato, descritto di seguito.
A cosa serve l'API OpenAI Audio Speech?
L'API Speech è un endpoint di sintesi vocale: l'applicazione fornisce il testo scritto e riceve la sintesi vocale generata. Tra gli utilizzi tipici figurano le guide all'uso dei prodotti, la narrazione per l'accessibilità, il materiale didattico e brevi voci fuori campo. È possibile controllare il testo prima che venga pronunciato, il che lo rende utile quando la formulazione deve seguire un copione approvato.
Per la trascrizione, il processo è invertito: si inserisce l’audio registrato e si ottiene il testo. Un assistente vocale in tempo reale aggiunge un ulteriore requisito: ascoltare e rispondere nell’ambito di una conversazione. OpenAI’s documentazione audio separa questi flussi di lavoro. Scegli l'endpoint "Speech" quando disponi già del testo che desideri far leggere ad alta voce.
La generazione vocale supporta lo streaming, quindi un'applicazione può ricevere l'audio in blocchi. Il salvataggio di tale flusso in un file non ne avvia automaticamente la riproduzione in un browser né crea un agente conversazionale; l'applicazione continua a gestire la riproduzione e qualsiasi logica di conversazione. OpenAI richiede inoltre che venga chiaramente indicato agli ascoltatori che la voce è generata dall'intelligenza artificiale.
Crea il tuo primo file audio con l'API vocale OpenAI
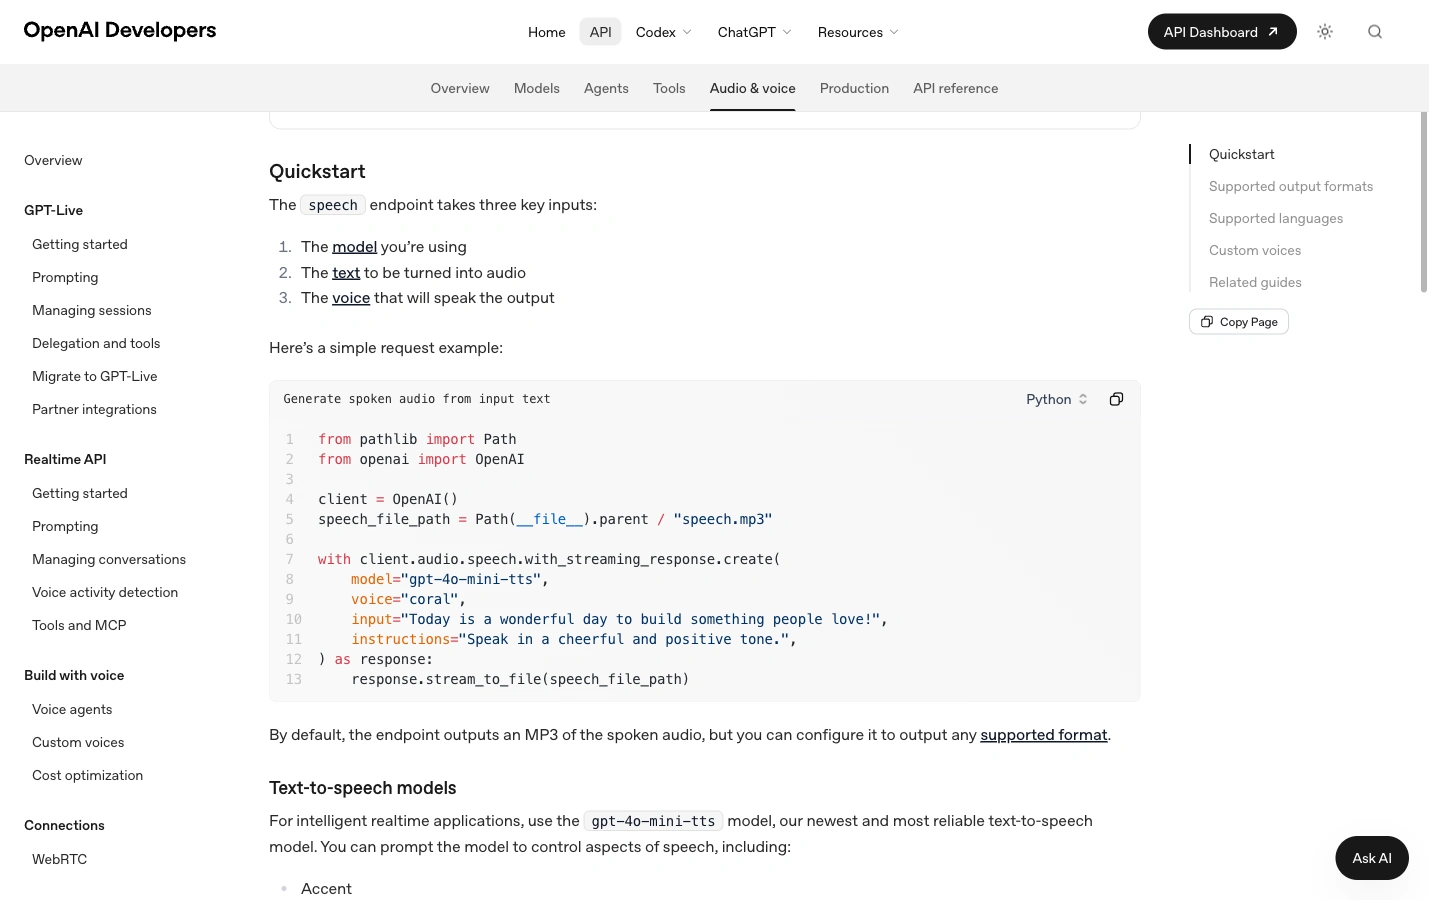
Esegui la richiesta su un server o sul tuo computer di sviluppo, utilizzando una chiave API OpenAI memorizzata nel OPENAI_API_KEY variabile d'ambiente. Evitare di inserire la chiave nel codice JavaScript del browser. Gli esempi seguenti utilizzano lo stesso breve script di presentazione del prodotto e salvano il risultato come openai-product-tour.mp3.
Opzione 1: inviare una richiesta curl
API vocale OpenAI · curl
#!/bin/sh
# Imposta prima OPENAI_API_KEY nell'ambiente del tuo server.
curl --fail-with-body --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "Benvenuto nel tour del prodotto Acorn Studio. In tre passaggi puoi trasformare un breve copione in un'audioguida. Per prima cosa, scrivi il messaggio. Poi, scegli una voce. Infine, salva il file audio e prova la riproduzione sul tuo telefono.",
    "voice": "coral",
    "instructions": "Parla chiaramente con un tono cordiale e colloquiale.",
    "response_format": "mp3"
  }' \
  --output openai-product-tour.mp3
La risposta contiene byte audio, quindi è consigliabile salvarla in un file anziché tentare di analizzarla come JSON. Il --errore-con-corpo L'opzione restituisce a curl uno stato di uscita negativo in caso di errore HTTP. Verifica tale stato prima di aprire il file: una risposta di errore può comunque lasciare dati JSON nel file denominato .mp3.
Opzione 2: utilizzare l'SDK Python
Installa il pacchetto OpenAI con python -m pip install openai. L'SDK legge la chiave API dall'ambiente. Questo esempio scrive la risposta man mano che arriva, evitando così di caricare l'intera risposta audio nel proprio buffer Python.
API di riconoscimento vocale OpenAI · Python
"""Installazione: python -m pip install openai. Impostare OPENAI_API_KEY sul server."""
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
script = (
    "Benvenuto nel tour dei prodotti di Acorn Studio. In tre passaggi, puoi trasformare "
    "un breve copione in un'audioguida. Per prima cosa, scrivi il messaggio. Poi, "
    "scegli una voce. Infine, salva il file audio e prova la riproduzione sul tuo telefono."
)

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=script,
    instructions="Parla chiaramente con un tono cordiale e colloquiale.",
    response_format="mp3",
) as response:
    response.stream_to_file(Path("openai-product-tour.mp3"))

print("Salvato openai-product-tour.mp3")
I tre campi fondamentali sono modello, input, e voce. Qui, istruzioni richiede uno stile di lettura cordiale e colloquiale; guida la voce piuttosto che aggiungere parole al testo parlato. Questo campo funziona con GPT-4o Mini TTS e non è supportato da tts-1 e tts-1-hd.
Se il documento è lungo, suddividete il testo in base alle frasi o ai paragrafi, numerate i segmenti e salvate ogni file con il numero corrispondente. Mantenete lo stesso tono e le stesse istruzioni in tutti i segmenti. Lasciate un contesto sufficiente per garantire una formulazione naturale e riascoltate i punti di giunzione prima di distribuire la registrazione assemblata.
Scegli un modello, una voce e un formato di output
| Modello | Come scegliere | Istruzioni per la consegna |
|---|---|---|
gpt-4o-mini-tts | Un punto di partenza per una narrazione e un'esposizione orale controllabili. | Supporti istruzioni per quanto riguarda il tono, lo stile e il ritmo. |
tts-1 | OpenAI rende questo modello adatto alla generazione del parlato a bassa latenza. | Utilizza i comandi vocali e di regolazione della velocità supportati; ometti istruzioni. |
tts-1-hd | OpenAI consente a questo modello di offrire una qualità vocale superiore rispetto a TTS-1. | Utilizza i comandi vocali e di regolazione della velocità supportati; ometti istruzioni. |
Il Pagina del modello GPT-4o Mini TTS associa l'alias del modello al gpt-4o-mini-tts-15-dicembre-2025 snapshot. Se la riproducibilità del comportamento è importante per la tua applicazione, scegli consapevolmente uno snapshot documentato e registralo insieme agli script salvati.
Voci integrate e limiti di ingresso
La documentazione di riferimento dell'API Speech elenca 13 voci integrate per GPT-4o Mini TTS: lega, frassino, ballata, corallo, eco, favola, onice, nova, salvia, luccichio, verso, marin e cedro. OpenAI raccomanda marin o cedro per ottenere la massima qualità. Questo è il consiglio di OpenAI: scegliete la vostra voce di produzione ascoltando i vostri nomi, i vostri numeri e le vostre strutture sintattiche.
I modelli TTS precedenti supportano un insieme più ristretto di voci: alloy, ash, coral, echo, fable, onyx, nova, sage e shimmer. Non date per scontato che ogni voce sia compatibile con ogni modello. Il Riferimento all'API Speech accetta anche una velocità compresa tra 0,25 e 4,0, con 1.0 come impostazione predefinita.
Occorre tenere conto di due limiti di input: i limiti di riferimento degli endpoint input a 4.096 caratteri, e la pagina del modello Mini TTS indica un massimo di 2.000 token di input. I caratteri e i token hanno dimensioni diverse. Verificate entrambi i limiti per Mini TTS, soprattutto in caso di testi multilingue, e suddividete i testi di grandi dimensioni prima di inviarli.
Scegli il formato del file per la sua destinazione
| Formato | Uso pratico |
|---|---|
| MP3 | Output predefinito: un pratico file compresso, ideale per la condivisione e la riproduzione sul web. |
| Opus | Utile per le applicazioni di streaming e comunicazione che supportano il codec. |
| AAC | Valuta in quali casi il tuo ambiente di riproduzione o il tuo flusso di lavoro multimediale richiedano l'uso del formato AAC. |
| FLAC | Compressione senza perdita di dati per flussi di lavoro che richiedono il mantenimento del segnale audio. |
| WAV | Audio non compresso in un formato familiare per l'editing e l'elaborazione. |
| PCM | Campioni grezzi a 24 kHz, 16 bit con segno in formato little-endian, senza intestazione del file; il tuo lettore richiede queste impostazioni. |
Inizia con il formato MP3 se ti serve un link per il download o un semplice lettore audio. Scegli il formato WAV se il passo successivo prevede la modifica del file. Seleziona il formato PCM non compresso solo se la tua applicazione è in grado di interpretarlo; per modificare il nome di un file da .pcm a .wav non crea un'intestazione WAV.
Quanto costa l'API vocale OpenAI?
In base ai dati del 28 settembre 2026, OpenAI riporta il modello GPT-4o Mini TTS a $0,60 per milione di token di testo inseriti più $12 per milione di token di uscita audio. Costi del TTS-1 $15 per milione di caratteri, e il costo del TTS-1 HD è $30 per milione di caratteri. Calcolare ciascun modello nelle proprie unità di misura.
Prezzi dell'API Speech: mantenere separate le unità
OpenAI addebita il costo del suo modello TTS più recente in base ai token, mentre per i due modelli TTS precedenti il costo viene calcolato in base ai caratteri. GlobalGPT indica il costo delle sue attività TTS in crediti.
| Percorso e modello | Tasso | Esempio |
|---|---|---|
| OpenAI · GPT-4o Mini TTS | $0.60 / 1 milione di token di input di testo $12 / 1M token di uscita audio | $0.0606 per 1.000 token di input testuale + 5.000 token di output audio |
| OpenAI · TTS-1 | $15 / 1 milione di caratteri | $0.015 per 1.000 caratteri |
| OpenAI · TTS-1 HD | $30 / 1 milione di caratteri | $0.030 per 1.000 caratteri |
| GlobalGPT · Eleven v3, Eleven Multilingual v2 o Qwen Audio 3.0 TTS Flash | 330 crediti / 1.000 caratteri | 330 crediti alla tariffa indicata di 1.000 caratteri; richiedere un preventivo prima dell'invio |
Si tratta di esempi di prezzi, non di costi relativi agli estratti audio riportati di seguito. Token, caratteri, minuti e crediti sono unità di misura diverse. Il preventivo dell'attività GlobalGPT indica l'importo in crediti applicabile; la tabella non converte i crediti in dollari.
Tariffe verificate il 28 settembre 2026. Fonti: Prezzi dell'API OpenAI e Documentazione API GlobalGPT.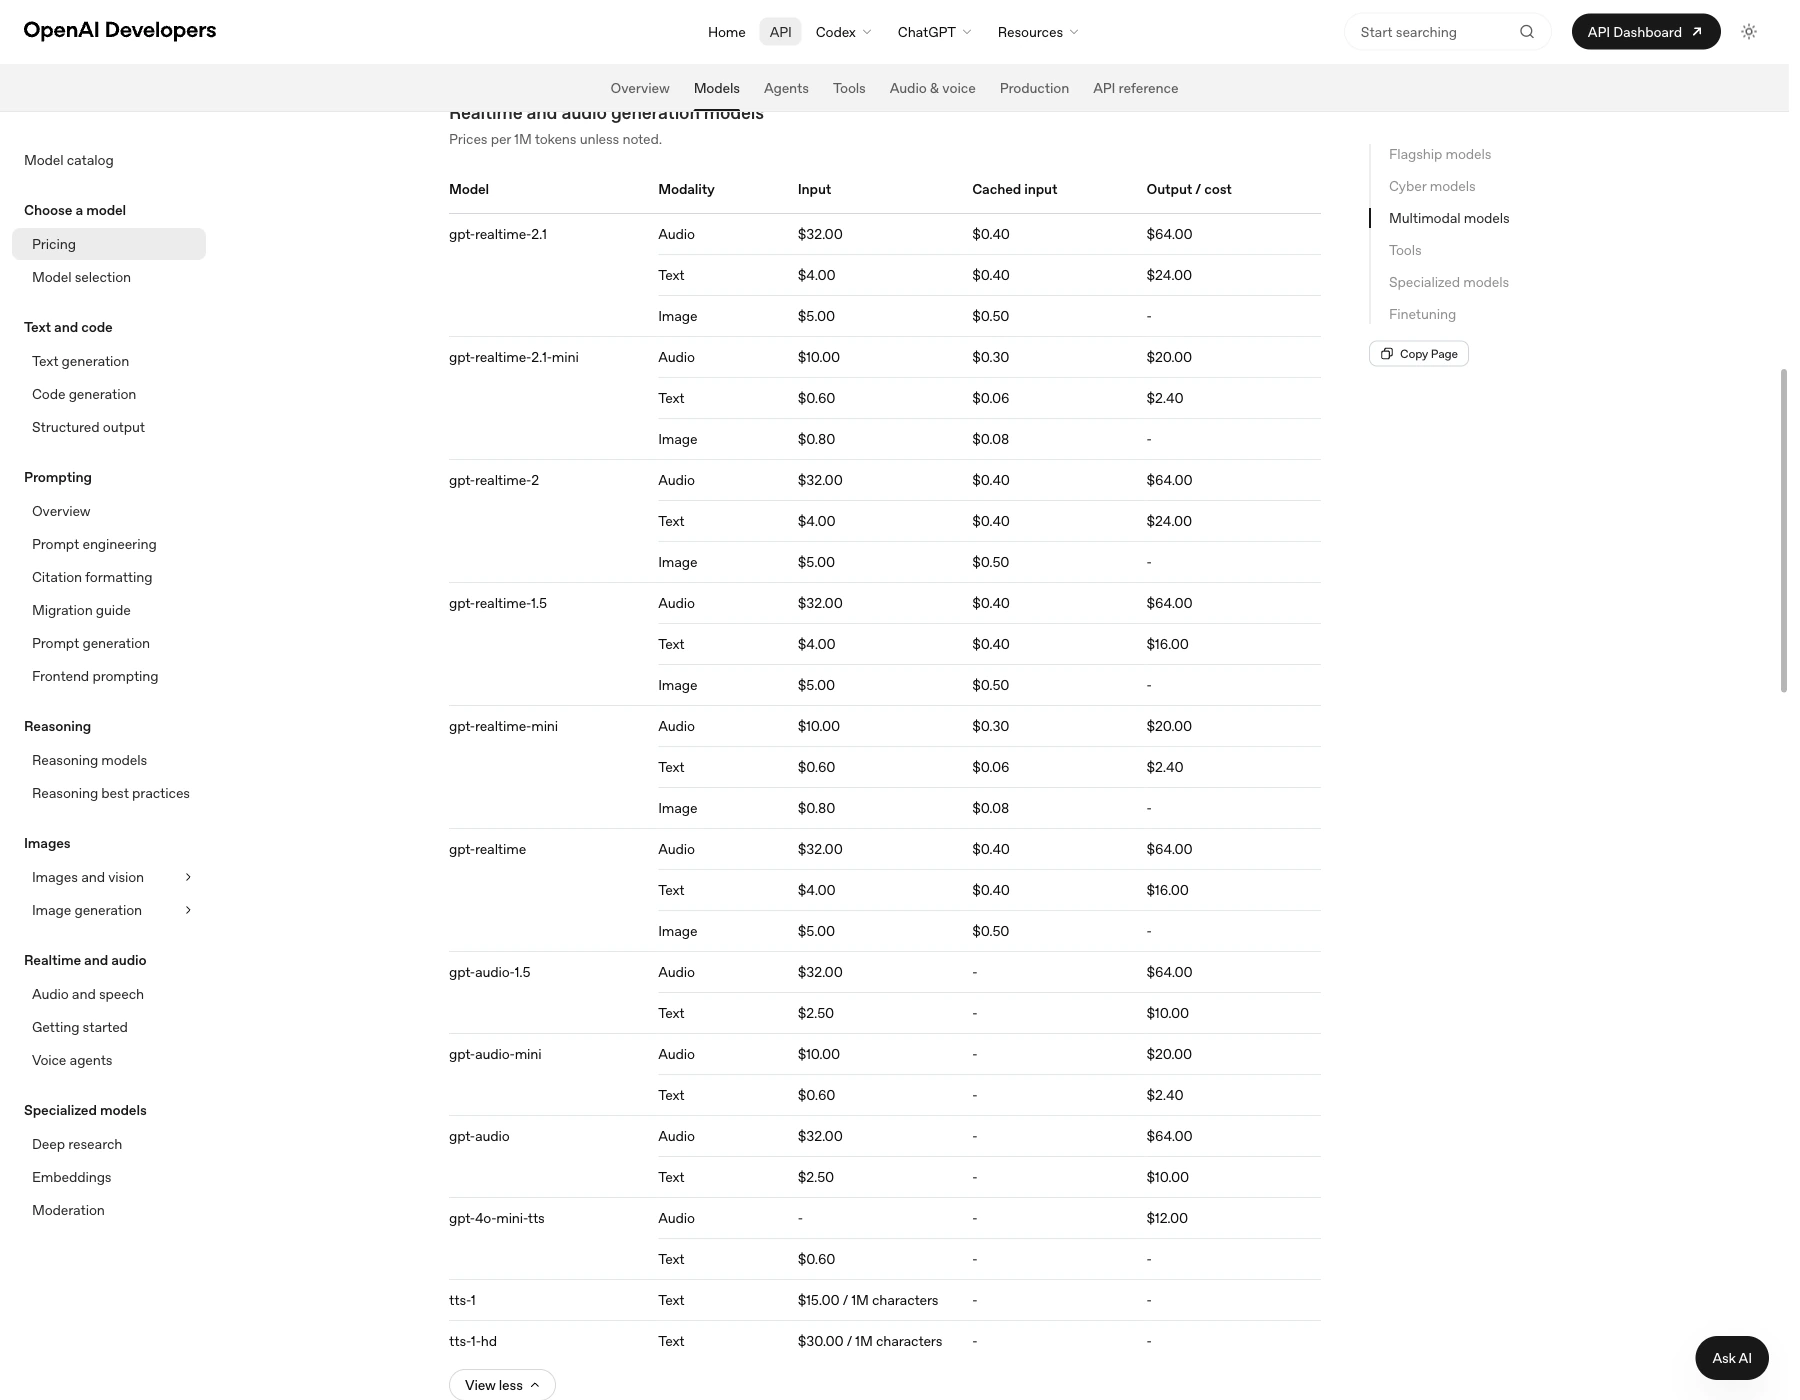
Ad esempio, 100 script da 1.000 caratteri ciascuno ammontano a un totale di 100.000 caratteri. Alle tariffe indicate, ciò equivale a $1.50 con TTS-1 o $3.00 con TTS-1 HD, al netto degli altri costi applicabili. Lo stesso numero di caratteri non è sufficiente per calcolare con precisione il costo del Mini TTS: occorrono le quantità di token relative all'input di testo e all'output audio.
Calcola il costo della generazione del discorso
Inserisci le unità di fatturazione del percorso che hai scelto. Non è prevista alcuna conversione automatica da caratteri a token o da minuti a token.
Formula: caratteri × $15 ÷ 1.000.000. Il totale del testo può essere suddiviso su più richieste API.
Tariffe verificate il 28 settembre 2026: OpenAI · GlobalGPT. Sono esclusi i costi di archiviazione, hosting, tasse e altre parti della tua applicazione.
Ai fini della pianificazione, inserisci nel calcolatore i dati effettivi di utilizzo o ipotesi esplicite. Considera il campo “Mini TTS audio-token” come un dato di riferimento fino a quando non avrai misurato l’utilizzo effettivo. Non trasformare una cifra approssimativa al minuto in un prezzo garantito per ogni voce, ritmo di pronuncia o lingua.
Il catalogo dei modelli GlobalGPT indica i prezzi dei servizi TTS in crediti e il suo endpoint di stima fornisce un preventivo per la richiesta che intendi inviare. Tieni separata la spesa dei crediti API dalla scelta di un abbonamento a uno spazio di lavoro multi-modello per le attività quotidiane di scrittura e gestione dei contenuti multimediali. In questo modo è più facile tenere sotto controllo il budget, senza dare per scontato che i due prodotti condividano lo stesso limite di fatturazione.
Creare un flusso di lavoro TTS con l'API GlobalGPT
Per un flusso di lavoro ripetibile che va dallo script alla voce al video, crea un discorso in GlobalGPT e mantenere il resto del progetto nello stesso spazio di lavoro. Il API GlobalGPT mette in luce come la generazione dei media sia costituita da compiti, mentre il GlobalGPT CLI connessioni compatibili con il tuo terminale e i tuoi strumenti di sviluppo.
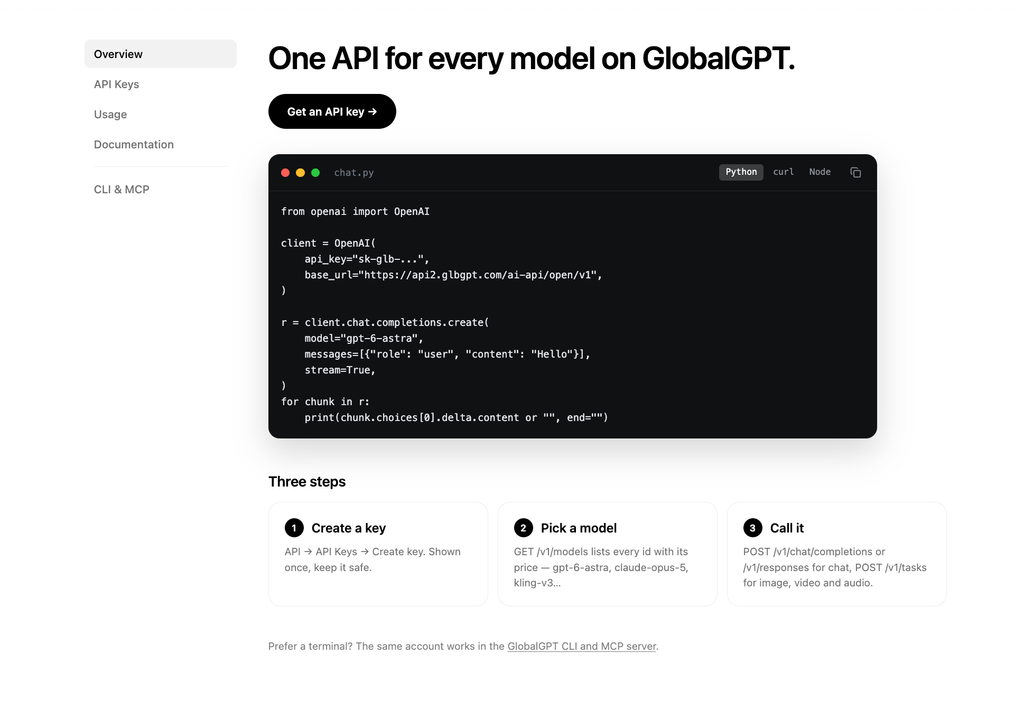
Utilizza l'URL di base pubblico https://api2.glbgpt.com/ai-api/open/v1. Invia le richieste TTS a POST /tasks, query GET /tasks/{id}, e scarica output.url una volta completata l'operazione. Il campo di testo è tempestivamente. Implementa direttamente questo contratto di attività; è diverso dalla risposta audio immediata di OpenAI.
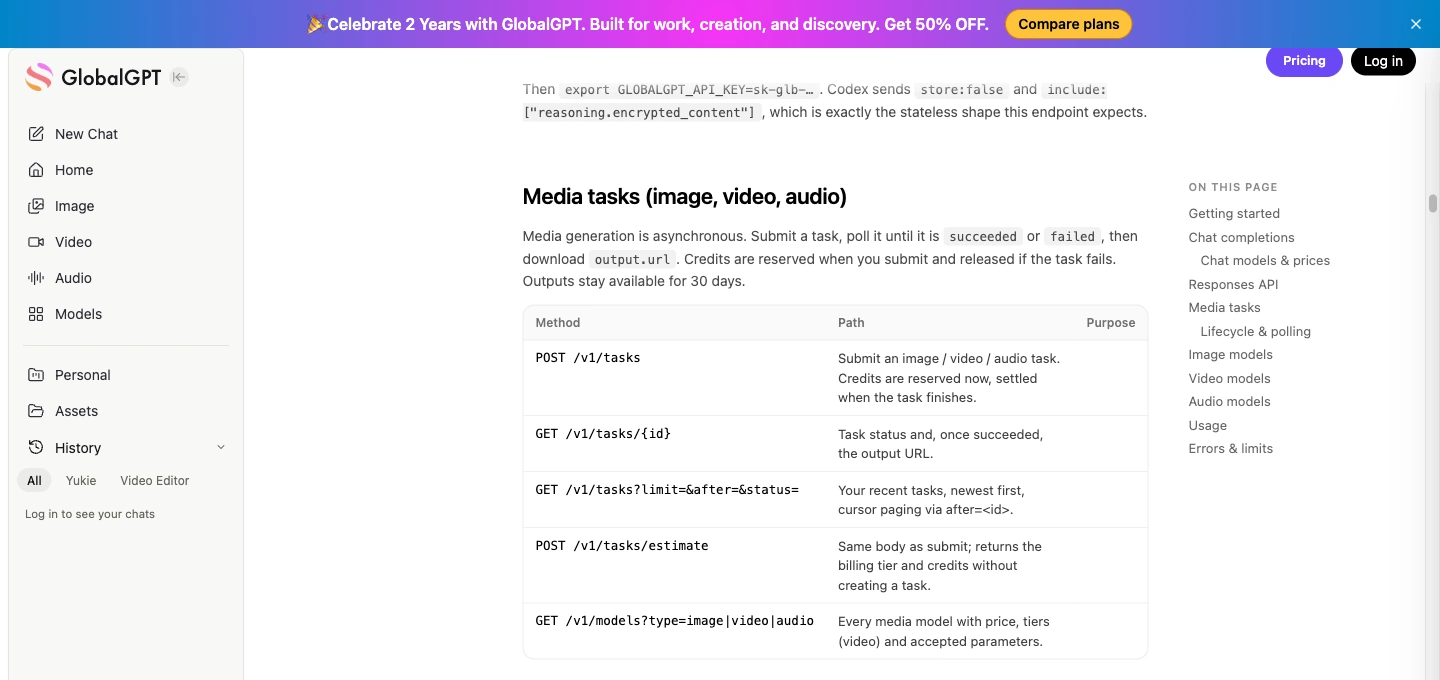
Scegli un modello TTS GlobalGPT documentato
| ID modello | Input e output | Una distinzione utile |
|---|---|---|
eleven-v3 | Fino a 5.000 caratteri; MP3 | Supporta tag audio descrittivi. |
undici-multilingue-v2 | Fino a 10.000 caratteri; MP3 | 29 lingue; i tag audio vengono letti come testo. |
qwen-audio-3.0-tts-flash | Fino a 4.096 caratteri; WAV | 49 voci; i controlli relativi alla voce e al linguaggio utilizzano campi specifici per Qwen. |
Elenco di tutte e tre le voci 330 crediti ogni 1.000 caratteri. Utilizzare POST /tasks/estimate con il corpo della richiesta previsto per il preventivo in questione; secondo la documentazione, ciò non comporta la creazione di alcuna attività né la prenotazione di crediti. L'accesso all'API pubblica utilizza crediti a pagamento.
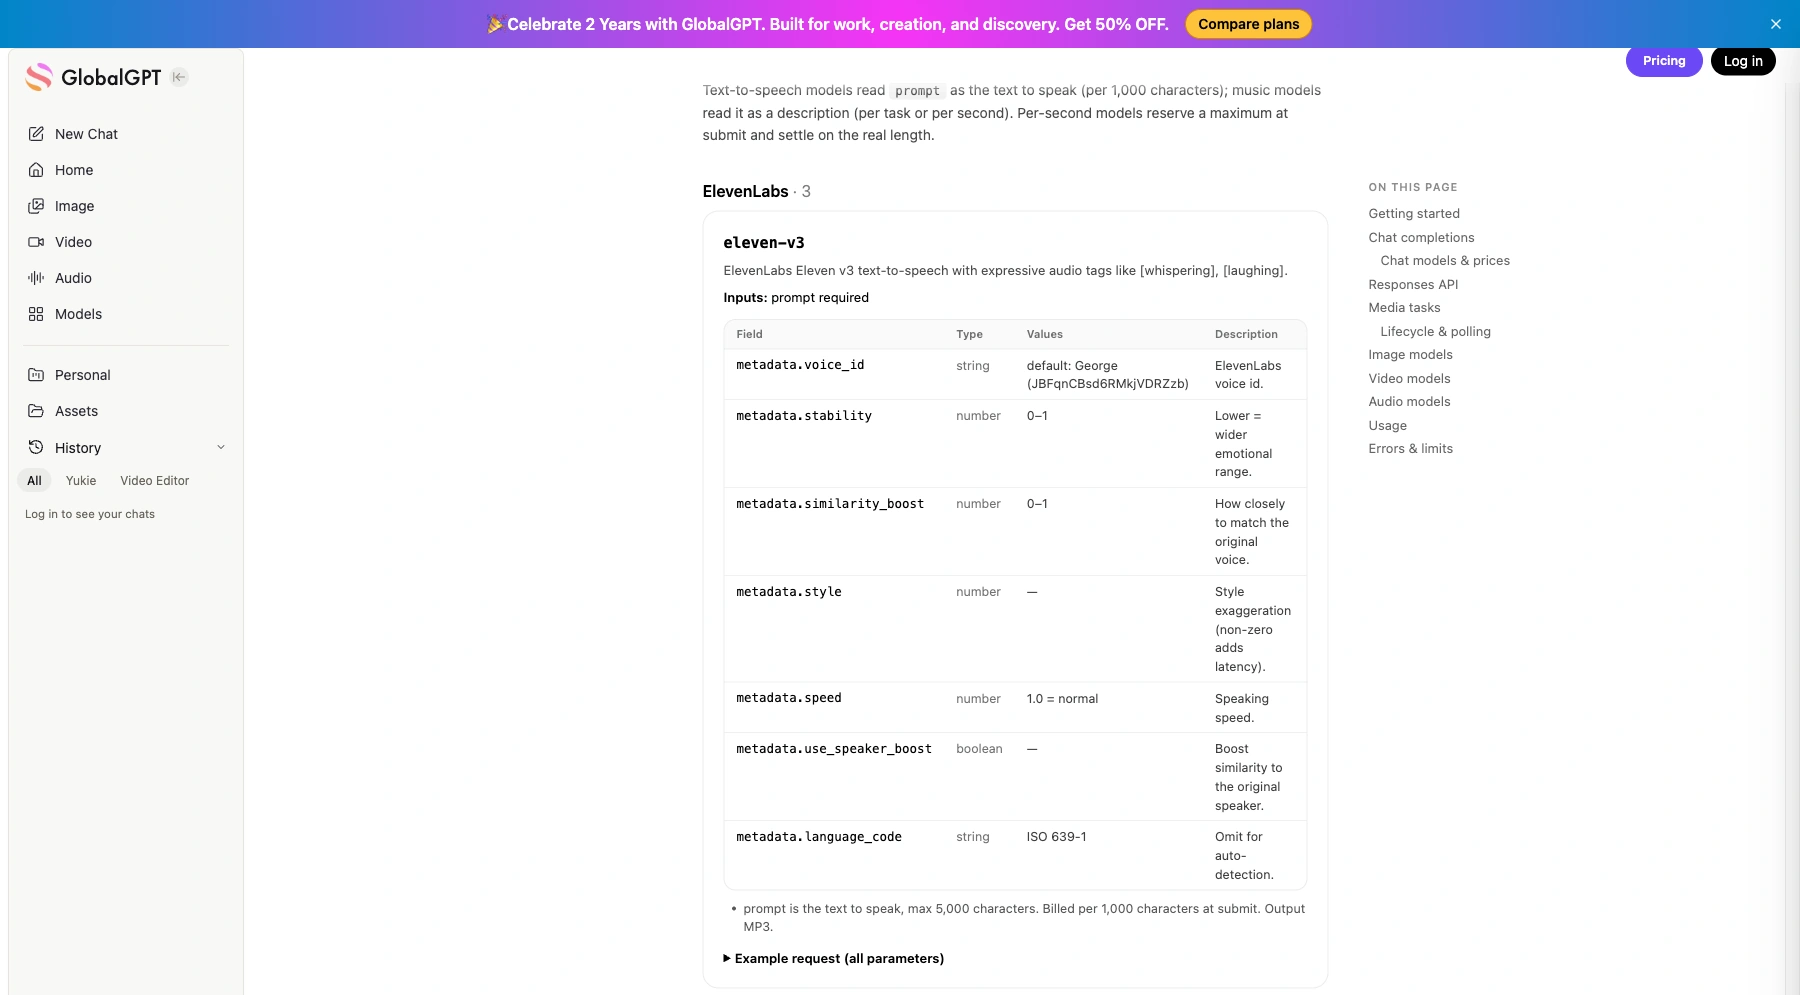
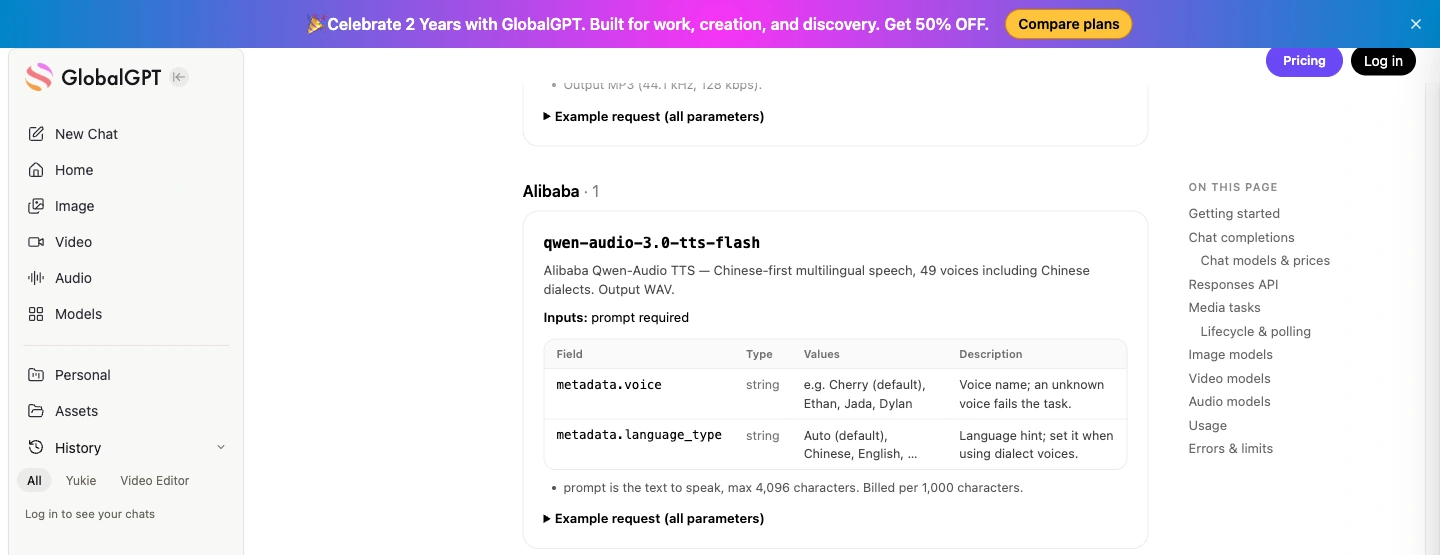
Per informazioni più generali sul flusso di lavoro di creazione, consultare flussi di lavoro di sintesi vocale in GlobalGPT. Se stai effettuando ricerche sulla famiglia di prodotti open source denominata Qwen3-TTS, leggi Modelli Qwen3-TTS e opzioni API; non considerare l'ID del modello Qwen-Audio sopra indicato come una versione intercambiabile con Qwen3-TTS.
Preventivo: invialo una volta sola, poi controlla lo stato dell'attività salvata
Installare richieste con python -m pip install requests e impostare GLOBALGPT_API_KEY sul server. L'esempio riportato di seguito utilizza Eleven v3, seleziona un ID vocale pubblico documentato e imposta un limite massimo indicativo di 500 crediti. Modifica tale limite in base al tuo budget prima di eseguire il codice.
API pubblica per attività TTS GlobalGPT · Python
"""Installa requests; imposta GLOBALGPT_API_KEY. Utilizza l'API pubblica per i task di GlobalGPT."""
import json
import os
import time
import uuid
from pathlib import Path
import requests

BASE = "https://api2.glbgpt.com/ai-api/open/v1"
STATE = Path("globalgpt-tts-job.json")
OUTPUT = Path("globalgpt-product-tour.mp3")
MAX_CREDITS = 500  # Il limite massimo per ogni lavoro; modificare prima dell’esecuzione.

payload = {
    "model": "eleven-v3",
    "prompt": (
 "Benvenuto nel tour del prodotto Acorn Studio. In tre passaggi, puoi trasformare "
 "un breve copione in un'audioguida. Per prima cosa, scrivi il messaggio. Poi, "
 "scegli una voce. Infine, salva il file audio e prova la riproduzione sul tuo telefono."
    ),
    "metadata": {
 "voice_id": "JBFqnCBsd6RMkjVDRZzb",
 "stability": 0.5,
 "language_code": "en",
    },
}

api = requests.Session()
api.headers["Authorization"] = "Bearer " + os.environ["GLOBALGPT_API_KEY"]

if STATE.exists():
    job = json.loads(STATE.read_text())
    if job["payload"] != payload:
 raise RuntimeError("Questo lavoro appartiene a un input diverso. Utilizza un nuovo nome di file di stato.")
else:
    estimate = api.post(BASE + "/tasks/estimate", json=payload, timeout=30)
    estimate.raise_for_status()
    quote = estimate.json()
    print("Crediti stimati:", quote["credits"])
    if quote["credits"] > MAX_CREDITS:
 raise RuntimeError("Il preventivo supera il limite massimo per singolo lavoro.")
    job = {"payload": payload, "idempotency_key": str(uuid.uuid4())}
    STATE.write_text(json.dumps(job, indent=2))

if "task_id" not in job:
    # La chiave memorizzata associa un tentativo di ritrasmissione a questa specifica richiesta.
    submitted = api.post(
 BASE + "/tasks", json=payload,
 headers={"Idempotency-Key": job["idempotency_key"]}, timeout=60,
    )
    submitted.raise_for_status()
    task = submitted.json()
    job["task_id"] = task["id"]
    STATE.write_text(json.dumps(job, indent=2))
    if task.get("ignored_parameters"):
 print("Parametri ignorati:", task["ignored_parameters"])

print("Attività:", job["task_id"])
deadline = time.monotonic() + 600
while time.monotonic() < deadline:
    checked = api.get(BASE + "/tasks/" + str(job["task_id"]), timeout=30)
    checked.raise_for_status()
    task = checked.json()
    if task.get("ignored_parameters"):
 print("Parametri ignorati:", task["ignored_parameters"])
    if task["status"] == "failed":
 raise RuntimeError("Generazione fallita: " + json.dumps(task.get("error", {})))
    if task["status"] == "succeeded":
        # Utilizza una nuova richiesta: non inviare la chiave API all'host multimediale.
 audio = requests.get(task["output"]["url"], timeout=60)
 audio.raise_for_status()
        OUTPUT.write_bytes(audio.content)
 print("Salvato:", OUTPUT)
 break
    time.sleep(10)
else:
    raise TimeoutError("Attività ancora in sospeso. Eseguire nuovamente per interrogare l’ID dell’attività salvata.")
Il file di lavoro salva la richiesta esatta, una chiave di idempotenza e l'ID dell'attività. Se la connessione si interrompe, riesegui lo stesso lavoro in modo che il codice possa riprendere l'attività in corso. Per generare intenzionalmente un audio diverso, utilizza un nuovo nome per il file di lavoro. Mantieni il file di lavoro privato se lo script contiene informazioni riservate.
Controllo parametri_ignorati in questo modo, un’impostazione non supportata non diventa automaticamente la configurazione predefinita. I controlli ElevenLabs quali voice_id differiscono da quelli di Qwen voce e tipo_di_lingua campi. Eseguire un polling ogni 5–10 secondi, gestire un fallito stato e salvare tempestivamente i file corretti: la conservazione dei risultati documentata è 30 giorni.
Ascolta due esempi di presentazioni di prodotti
Questi due campioni generati dall’intelligenza artificiale utilizzano lo stesso copione di 216 caratteri per il tour del prodotto con Eleven v3 e Qwen Audio 3.0 TTS Flash. Ciascuno rappresenta il primo risultato ottenuto da una singola richiesta, con le impostazioni predefinite della voce. Si tratta di due brevi file da esaminare e ascoltare; non costituiscono un confronto controllato tra voci corrispondenti né un benchmark delle voci OpenAI.
Eleven v3: audio della presentazione del prodotto
eleven-v3 · Esempio di tour del prodotto
- Uscita
- MP3 · mono · 44,1 kHz
- Lunghezza
- Circa 15,6 secondi
- Generazione
- Primo risultato · 1 richiesta
Impostazioni: il testo esatto riportato di seguito, la voce predefinita e altre impostazioni; nessuna sostituzione della voce né istruzioni di pronuncia. L'identità vocale predefinita non è stata registrata.
Stato e tempistiche: La generazione è andata a buon fine. I timestamp del server relativi all'operazione indicano 13 secondi dal momento dell'invio al completamento; si tratta di una singola richiesta, non di un test di latenza.
Osservazioni sul file: Il file MP3 contiene un flusso mono a 44,1 kHz e ha una dimensione di circa 251 kB. I suoi frame possono essere letti fino alla fine del file.
Riferimento ai costi: La tariffa indicata nel catalogo pubblico è di 330 crediti ogni 1.000 caratteri. Per una nuova richiesta, si prega di utilizzare un preventivo; questa tariffa non costituisce una fattura per il campione.
Uso pratico: Un file MP3 di dimensioni ridotte per ascoltare un breve tour del prodotto. Verifica il testo completo e la riproduzione sul dispositivo di destinazione prima di utilizzarlo in una versione definitiva.
Leggi l'input esatto · 216 caratteri
Benvenuti al tour dei prodotti di Acorn Studio. In tre semplici passaggi potrete trasformare un breve testo in un’audioguida. Per prima cosa, scrivete il messaggio. Poi, scegliete una voce. Infine, salvate il file audio e provate la riproduzione sul vostro telefono.
Qwen Audio 3.0 TTS Flash: audio della presentazione del prodotto
qwen-audio-3.0-tts-flash · Esempio di presentazione del prodotto
- Uscita
- WAV · mono · 24 kHz
- Lunghezza
- 15,52 secondi di dati PCM
- Generazione
- Primo risultato · 1 richiesta
Impostazioni: il testo esatto riportato di seguito, la voce predefinita e altre impostazioni; nessuna sostituzione della voce né istruzioni di pronuncia. L'identità vocale predefinita non è stata registrata.
Stato e tempistiche: La generazione è andata a buon fine. I timestamp del server indicano che sono trascorsi 17 secondi dal momento dell'invio al completamento; si tratta di una singola richiesta, non di un test di latenza.
Osservazioni sul file: Il file WAV contiene dati PCM mono a 16 bit e 24 kHz e ha una dimensione di circa 745 kB. L'intestazione indica una quantità di dati superiore a quella effettivamente contenuta nel file; qui è stata mantenuta l'intestazione originale.
Riferimento ai costi: La tariffa indicata nel catalogo pubblico è di 330 crediti ogni 1.000 caratteri. Per una nuova richiesta, si prega di utilizzare un preventivo; questa tariffa non costituisce una fattura per il campione.
Uso pratico: Un campione WAV per valutare il flusso di lavoro della narrazione. Risolvi l'incoerenza nella lunghezza dell'intestazione nella tua pipeline di produzione e verifica la riproduzione completa prima della distribuzione.
Leggi l'input esatto · 216 caratteri
Benvenuti al tour dei prodotti di Acorn Studio. In tre semplici passaggi potrete trasformare un breve testo in un’audioguida. Per prima cosa, scrivete il messaggio. Poi, scegliete una voce. Infine, salvate il file audio e provate la riproduzione sul vostro telefono.
Il campione Qwen ha una dimensione circa tre volte superiore a quella del campione Eleven a parità di durata, il che riflette la differenza tra i formati WAV e MP3. Inoltre, l’intestazione WAV indica una quantità di dati superiore a quella effettivamente contenuta nel file. Si tratta di un problema di struttura del file che vale la pena verificare nel lettore di destinazione; di per sé non dice nulla sulla qualità della voce parlata.
Risolvere i problemi più comuni relativi alla generazione del parlato
| Sintomo | Cosa controllare per prima cosa |
|---|---|
| Il file MP3 salvato non viene riprodotto | Verifica lo stato HTTP e il tipo di risposta. È possibile che un errore dell'API sia stato salvato con un'estensione audio. |
| La richiesta rifiuta una voce o un comando | Abbinare la voce e i campi opzionali al modello selezionato. I modelli TTS OpenAI meno recenti non accettano istruzioni. |
| Uno script troppo lungo viene respinto | Verifica il limite di caratteri del percorso e il limite di token Mini TTS, quindi suddividi il testo in base a punti di separazione naturali. |
| Viene visualizzata una risposta 401 o 429 | Verificare la chiave/l'account per il codice 401. Per il codice 429, distinguere i limiti di frequenza da una quota insufficiente prima di riprovare. |
| Una richiesta GlobalGPT rimane in sospeso | Recupera l'ID dell'attività salvata e verifica lo stato; un timeout non costituisce un motivo valido per inviare un'attività duplicata. |
| La voce non corrisponde alle impostazioni richieste | Verificare i metadati specifici del modello e i parametri ignorati prima di dare per scontato che l'impostazione sia stata applicata. |
| La barra che indica la durata dell'audio o quella di navigazione sembra errata | Confronta i metadati del file con il contenuto effettivo del file multimediale e verifica il funzionamento del file completo nel lettore di destinazione. |
In caso di errore OpenAI, inizia con il suo Guida ai codici di errore. Per un’attività GlobalGPT, salvare l’ID dell’attività e i dettagli dell’errore restituito. Durante lo sviluppo, tenere separati gli errori di trasporto, quelli di fatturazione e le registrazioni vocali non soddisfacenti: ciascuno richiede una soluzione diversa.
Prima di inviare la narrazione, ascolta l'intera registrazione sul dispositivo che utilizzerà il tuo pubblico. Controlla l'introduzione, i nomi e i numeri, le transizioni e la frase finale. Includi un avviso relativo all'uso della voce generata dall'IA all'inizio della riproduzione e conserva una copia del testo esatto e delle impostazioni del modello, in modo da poter rigenerare accuratamente il copione modificato.
Domande frequenti
Che cos’è l’endpoint dell’API Audio Speech OpenAI?
Utilizza il metodo POST all'indirizzo https://api.openai.com/v1/audio/speech. I campi obbligatori sono model, input e voice. La risposta è un file audio generato; il formato predefinito è MP3.
L'API OpenAI Speech è gratuita?
L'API Speech prevede una tariffazione basata sull'utilizzo. Si consiglia di pianificare il budget in base alle tariffe API attuali, anziché partire dal presupposto che sia prevista una quota gratuita: il servizio GPT-4o Mini TTS viene fatturato in base ai token di input testuale e di output audio, mentre i servizi TTS-1 e TTS-1 HD vengono fatturati in base al numero di caratteri.
Posso controllare la voce e lo stile di espressione?
Scegli una voce supportata dal tuo modello. GPT-4o Mini TTS accetta anche istruzioni relative al tono di voce, come ad esempio un tono caloroso o calmo. Il campo delle istruzioni non funziona con TTS-1 o TTS-1 HD.
L'API Speech supporta lo streaming?
Sì. È in grado di trasmettere in streaming l'audio generato in blocchi. La tua applicazione deve comunque gestire la riproduzione; lo streaming della sintesi vocale da solo non garantisce una conversazione vocale in tempo reale completa.
Posso utilizzare GlobalGPT modificando l'URL di base di OpenAI?
Utilizza il flusso di lavoro documentato di GlobalGPT per le attività multimediali relative alla sintesi vocale (TTS): invia la richiesta al POST /tasks, esegui il polling con GET /tasks/{id} e scarica output.url una volta completata con successo l'operazione. Il suo catalogo TTS documentato include i modelli ElevenLabs e Qwen, ciascuno con i propri ID e parametri.
Da quale formato audio dovrei iniziare?
Inizia con il formato MP3 per un semplice download o per la riproduzione via browser. Il formato WAV è utile quando il passo successivo prevede l'editing. Il formato PCM grezzo richiede un lettore configurato in base alla sua frequenza di campionamento e alla profondità di bit, poiché non presenta un'intestazione del file.
Inizia con un breve copione, una voce e un file salvato. Una volta che la riproduzione e i costi saranno prevedibili, aggiungi il chunking, i tentativi di riproduzione e il resto del tuo flusso di lavoro multimediale. Nella tua implementazione, mantieni coerenti il formato delle richieste dell’API scelta, le unità di fatturazione e la gestione dei risultati.
Dai una voce alla tua prossima sceneggiatura
Prepara una breve presentazione del prodotto, crea una voce fuori campo con ElevenLabs o Qwen e prosegui con immagini e video nell'area di lavoro multimodello di GlobalGPT.
Crea un file audio vocale con GlobalGPT








