
La versione Grok 4.7 rappresenta un importante aggiornamento per la programmazione e il lavoro intellettuale, ma è ancora troppo presto per trarre conclusioni definitive: le dichiarazioni ufficiali relative al lancio e i benchmark indipendenti indicano un miglioramento, ma non un successo unanime.
Risposta rapida
Grok 4.7 è l'aggiornamento di xAI del 21 settembre 2026, pensato per la programmazione e le attività complesse di elaborazione delle conoscenze. xAI afferma che il sistema dedica più tempo ai problemi complessi, verifica il proprio lavoro con maggiore attenzione e aggiunge un nuovo stack di misure di sicurezza, pur mantenendo lo stesso prezzo e la stessa velocità della versione Grok 4.6. La pagina di lancio lo presenta inoltre come due volte più veloce e a metà prezzo rispetto a modelli comparabili, un confronto tra fornitori che va letto tenendo conto delle attività e del percorso sottostanti. I dati indipendenti di Artificial Analysis gli attribuiscono un leggero miglioramento complessivo rispetto a Grok 4.6 e registrano una finestra di contesto di 500K. Nel nostro test API a tre attività, il modello Grok 4.7 si è dimostrato il più efficace nel debug e nel rispetto dei confini del codice sorgente; il suo piano di progetto ha gestito bene l’incertezza, ma era meno attuabile di quanto richiesto. Si tratta di prove pratiche utili, non della dimostrazione che superi ogni modello concorrente.
Che cos’è Grok 4.7?
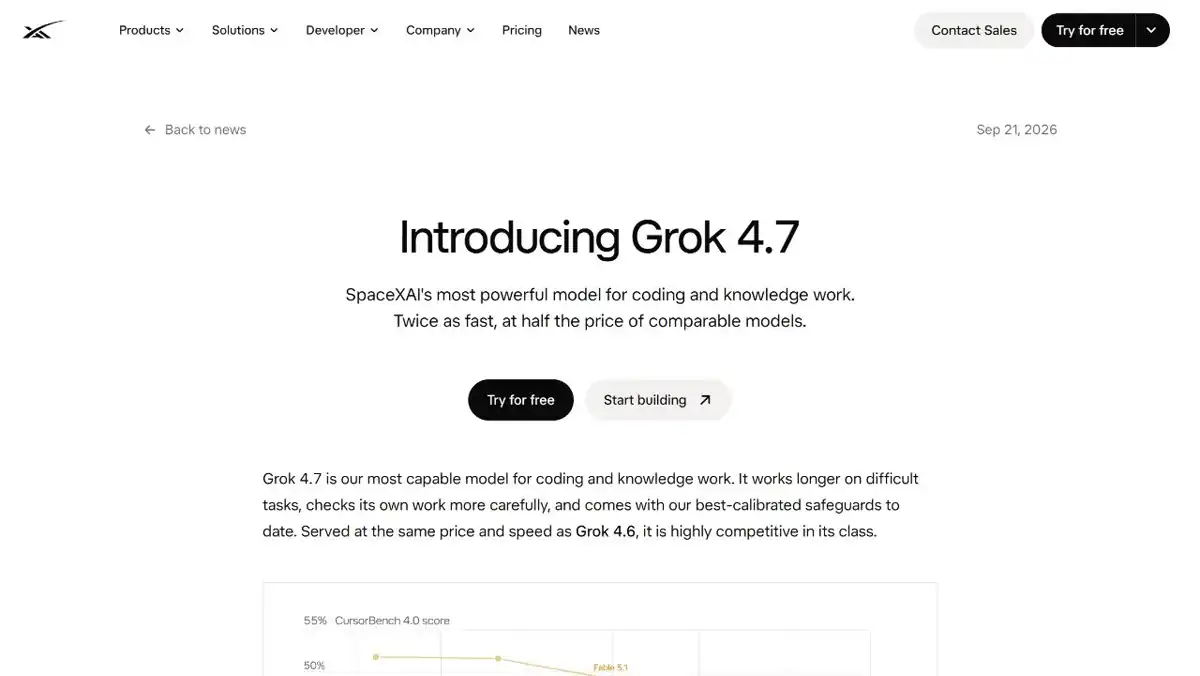
Il modello Grok 4.7 è l'ultimo modello della linea Grok di xAI, annunciato il 21 settembre 2026. Il Annuncio ufficiale di xAI lo posiziona come il modello più performante dell’azienda per la programmazione e il lavoro intellettuale. Il cambiamento significativo non risiede in una nuova lista di funzionalità rivolte all’utente finale, bensì in un cambiamento nel modo in cui il modello dovrebbe impiegare le proprie risorse: più tempo dedicato alle attività complesse, un maggiore autocontrollo e un livello di sicurezza pensato per rendere tale capacità aggiuntiva più controllabile.
Questo posizionamento è importante perché descrive un modello di flusso di lavoro piuttosto che la personalità di un chatbot. Grok 4.7 viene proposto come modello per attività che traggono vantaggio da un’analisi continuativa: debug, pianificazione, redazione di documenti tecnici, sintesi di ricerche e prompt lunghi che richiedono al modello di tenere presenti diversi vincoli.
Anche il confine è altrettanto importante. L’annuncio di xAI è una dichiarazione del fornitore sul comportamento previsto. Non costituisce una prova indipendente del fatto che Grok 4.7 superi ogni modello concorrente, ogni prompt o ogni repository di codice. Considerate la pagina di lancio come la fonte delle affermazioni di xAI, quindi ricorrete a misurazioni indipendenti e al vostro compito specifico per decidere se tali affermazioni siano rilevanti.
Grok 4.7 vs Grok 4.6: cosa è cambiato in realtà?
La sintesi più plausibile è quella di un miglioramento in termini di impegno e affidabilità, non di un prodotto completamente diverso.
| Area | Grok 4,7 | Cosa emerge dai dati disponibili |
|---|---|---|
| Rilascio | 21 settembre 2026 | Data indicata sulla pagina ufficiale di lancio di xAI |
| Posizionamento principale | Programmazione e lavoro intellettuale | Posizionamento ufficiale di xAI |
| Compiti difficili | Uno sforzo più prolungato e un autocontrollo più accurato | Descrizione ufficiale di xAI; la nostra prova dell’API con tre attività offre una breve verifica pratica, non un confronto diretto |
| Sicurezza | Nuova pila di misure di salvaguardia | Descrizione ufficiale di xAI |
| Prezzo e velocità | Come per il modello Grok 4.6, secondo xAI | Una dichiarazione relativa al lancio del prodotto, non una verifica dei prezzi effettuata da terzi |
| Contesto | 500.000 token nel profilo "Analisi artificiale" | Profilo modello indipendente; verificare il percorso utilizzato |
| Controlli di ragionamento | Da ’Low" a "xhigh" nell'elenco di Artificial Analysis | Metadati indipendenti relativi al percorso/modello |
Si tratta di una distinzione utile per gli acquirenti. Se la versione Grok 4.6 si adatta già al vostro flusso di lavoro, la 4.7 rappresenta un aggiornamento senza particolari difficoltà che vale la pena valutare. Se invece la 4.6 non era adatta a causa di limitazioni legate all’ecosistema, alla latenza, all’affidabilità o all’accessibilità, un punteggio di benchmark più elevato di per sé non risolve tali problemi.
Per un quadro più ampio relativo all'acquisto di modelli, il Guida ai prezzi GPT-5.6 e Confronto GPT-5.6 sono utili promemoria per distinguere la qualità del modello dagli aspetti economici del progetto e dall'adeguatezza al flusso di lavoro.
Funzionalità: in quali ambiti Grok 4.7 dovrebbe essere d’aiuto
Codifica e debug
Il punto di forza principale di xAI è la programmazione. La promessa non è semplicemente che Grok 4.7 scriva più codice; è che possa dedicarsi più a lungo a un problema ingegneristico complesso, esaminare la propria risposta e fornire una patch o una spiegazione più ponderata. Questo è il comportamento che ci si aspetta da un vero repository: preserva il design esistente, identifica la causa principale, aggiunge test utili e indica ciò che ancora non è in grado di sapere?
Non valutare il modello con un prompt generico del tipo “crea un’app per le cose da fare”. Forniscigli un bug ben definito con un test che fallisce, un piccolo insieme di file e vincoli espliciti. Chiedi una diagnosi prima di una correzione. In questo modo sarà più facile capire se il ragionamento più articolato comporti effettivamente un minor carico di lavoro di revisione o se si tratti semplicemente di un testo più lungo.
La stessa regola vale per i team che mettono a confronto diversi percorsi di programmazione. A Recensione del DeepSeek V4 Pro e il Revisione del piano di codifica GLM forniscono un utile contesto di confronto, ma nessuno dei due dovrebbe essere considerato un sostituto del test del repository e della catena di strumenti che utilizzi effettivamente.
Lavoro intellettuale in contesti estesi
Artificial Analysis indica una finestra di contesto di 500.000 token per la versione Grok 4.7. Si tratta di una dimensione sufficientemente ampia da cambiare il modo in cui si affrontano i lavori che richiedono molto materiale di riferimento: una lunga specifica tecnica, una serie di appunti di riunione, una porzione di codice o un fascicolo di ricerca possono rimanere all’interno di un’unica conversazione, invece di dover essere ripetutamente riassunti.
La capacità contestuale non è la stessa cosa della qualità contestuale. Un modello può accettare un input di grandi dimensioni e tuttavia trascurare un vincolo presente nella parte centrale, attribuire un peso eccessivo all’ultimo paragrafo o produrre un riassunto apparentemente attendibile che richiede però una verifica delle fonti. Il test pratico consiste nel recupero delle informazioni sotto pressione: inserire alcuni fatti determinanti in diverse parti di un lungo documento, richiedere una decisione soggetta a vincoli e verificare se la risposta cita i passaggi corretti.
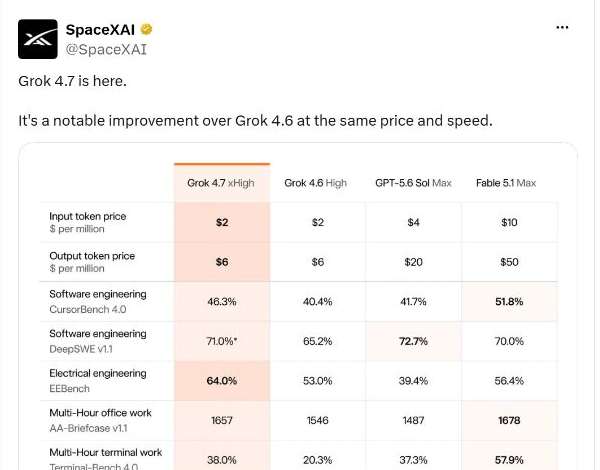
L'account ufficiale di SpaceXAI su X ha ribadito il 22 settembre la presentazione del lancio, definendo il modello Grok 4.7 un notevole miglioramento rispetto al Grok 4.6 a parità di prezzo e velocità e condividendo il grafico di confronto tra i modelli. Quel post costituisce una prova utile del posizionamento pubblico dell’azienda, ma non rappresenta una convalida indipendente né un consenso della comunità.
Se il modello viene utilizzato a fini di ricerca, mantenere visibile il ciclo delle prove. Il nostro Confronto tra Gemini e Perplexity e Guida alle alternative a Perplexity sottolineano entrambi lo stesso aspetto pratico: una risposta ben formulata non equivale a una verifica delle fonti.
Autocontrollo e sicurezza
xAI afferma che Grok 4.7 verifica il proprio lavoro con maggiore attenzione e introduce una nuova serie di misure di sicurezza. Si tratta di obiettivi importanti, soprattutto quando al modello viene richiesto di prendere una lunga serie di decisioni. Tuttavia, ciò non garantisce che l'output sia corretto o sicuro per l'esecuzione automatica.
In ambito produttivo, è necessario mantenere i normali controlli a tutela del modello: test, autorizzazioni, revisione umana, verifica delle citazioni e una chiara condizione di interruzione. L’autocontrollo del modello è un ulteriore segnale da tenere in considerazione, non un sostituto dei controlli che lo circondano.
Benchmark Grok 4.7: cosa dimostrano i numeri
Ottimo risultato nella codifica: secondo la classifica ufficiale, il modello Grok 4.7 si è classificato davanti al modello Grok 4.6.
Il confronto con il modello più grande evidenzia un netto miglioramento in questo benchmark relativo al lavoro intellettuale.
Un indicatore utile per i flussi di lavoro che prevedono l'uso di strumenti, ma si tratta comunque di una singola valutazione piuttosto che di un punteggio universale.
L'indice indipendente conferma la stessa tendenza: un miglioramento, non la prova di una vittoria generale.
Considerate queste schede come indicazioni di massima. La composizione del set di dati, l’accesso agli strumenti, il campionamento e le impostazioni del modello possono influire sulla classifica.
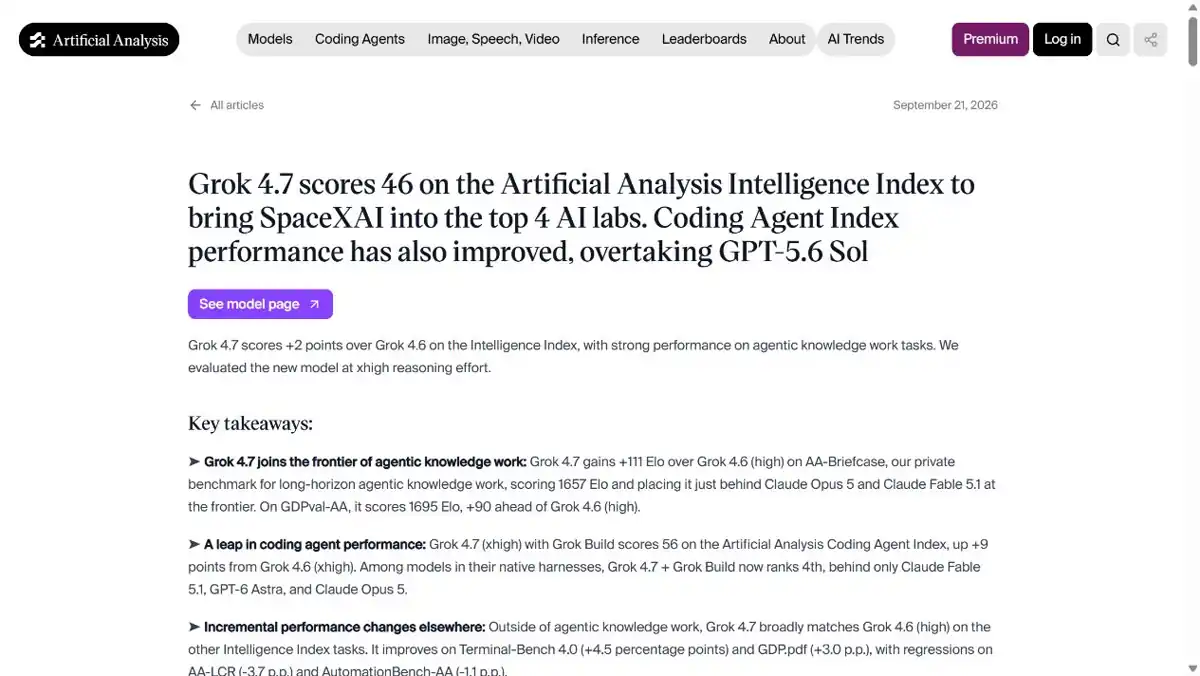
L'istantanea indipendente più utile al momento proviene da Articolo di benchmarking su Grok 4.7 di ’Artificial Analysis", in data 21 settembre 2026.
| Misura | Risultato riportato | Come leggerlo |
|---|---|---|
| Indice di intelligenza artificiale applicata all'analisi | 46 | Due punti in più rispetto a Grok 4,6 nello stesso indice |
| AA-Cartella | 1.657 Elo | 111 Elo in più rispetto a Grok 4,6 in quella valutazione |
| Finestra contestuale | 500.000 token | Un campo di profili di modelli, non una prova del recupero perfetto in contesti estesi |
| Sforzo di ragionamento | Da basso a xalto | Un controllo a livello di percorso indicato da Artificial Analysis |
La tendenza è incoraggiante: l’indice indipendente mostra un miglioramento rispetto alla versione precedente, e il divario Elo più ampio in AA-Briefcase suggerisce un guadagno più evidente in quella specifica valutazione. Tuttavia, la tabella descrive ancora due set di dati, non una classifica universale. La composizione dei benchmark, l’accesso agli strumenti, il campionamento e le impostazioni del modello possono influenzare il risultato.
La pagina ufficiale di lancio di xAI riporta Grok 4.7 a 46,31 TP40T su CursorBench 4.0 nella sua tabella comparativa, accanto a Grok 4.6 a 40.4%, GPT-5.6 Sol a 41.7% e Fable 5.1 a 51.8%. La pagina riporta inoltre 71,01 TP40T su DeepSWE v1.1 con livello di sforzo elevato, 64,01 TP40T su EEBench e 1.657 su AA-Briefcase v1.1. Si tratta di dati comparativi presentati dal fornitore, pertanto è opportuno considerarli come risultati ufficiali riportati piuttosto che come sostituti di una replica indipendente. La conclusione più prudente è che xAI sia orientato verso attività di programmazione complessa e di elaborazione professionale delle conoscenze, mentre le misurazioni indipendenti mostrano un miglioramento significativo in alcune attività e risultati più modesti in altre.
Prova pratica Grok 4.7: tre attività pratiche
Abbiamo eseguito tre prompt fissi sul grok-4.7 ID del modello tramite un'API di test compatibile con OpenAI il 23 settembre 2026. Si è trattato di una valutazione a percorso singolo, non dell'API xAI diretta né di un test comparativo con la concorrenza. Di seguito è riportata la risposta visibile di ciascuna esecuzione; le tracce di ragionamento private sono state escluse.
| Compito | Tempo osservato | Risultato |
|---|---|---|
| Bug di concorrenza in TypeScript | 333,7 secondi, in streaming | Risultato eccellente: diagnosi corretta della "shared promise", patch minima, due test utili e una limitazione accurata di ciò che lo snippet poteva dimostrare |
| Note di ricerca contraddittorie | 68,7 secondi | Approvazione con riserva: attribuzione mantenuta, calcolo di entrambi gli scenari di indennità e rifiuto dell'approvazione fino alla verifica del conflitto relativo alla fonte |
| Piano disordinato di una settimana | 50,6 secondi | Approvazione parziale: sono state mantenute le scadenze, le contraddizioni, i proprietari sconosciuti e i cinque rischi, ma il lavoro non è stato trasformato in un programma giornaliero chiaro |
I valori di latenza si riferiscono esclusivamente a questo percorso e a questi prompt. L'operazione di codifica ha inizialmente registrato un timeout del gateway non in streaming, per poi completarsi con lo streaming abilitato. Si tratta di un avviso pratico relativo all'implementazione, riguardante il trasporto e la gestione dei timeout, non di un punteggio generale di velocità Grok 4,7.
Test 1: Debug della concorrenza in TypeScript
Compito 1 — Debug della concorrenza in un handler API TypeScript

Un piccolo handler TypeScript restituisce in modo intermittente un codice di stato HTTP 200 con un corpo vuoto quando due richieste arrivano a breve distanza l'una dall'altra.

File forniti:

src/cache.ts
```ts
let current: Promise | null = null;

export async function getPayload(load: () => Promise): Promise {
  if (!current) {
    current = load();
  }
  const value = await current;
  current = null;
  return value;
}
```

src/handler.ts
```ts
import { getPayload } from './cache';

export async function handler(load: () => Promise) {
  const payload = await getPayload(load);
  return { status: 200, body: payload };
}
```

Il sintomo riscontrato in produzione si manifesta in modo intermittente solo quando due richieste si sovrappongono. Il caricatore stesso può essere chiamato in modo concorrente in tutta sicurezza e restituisce un payload diverso per ogni richiesta. Non sono disponibili altri file.

Riporta esattamente queste sezioni:
1. Causa principale
2. Patch minima sicura (mostra un diff unificato)
3. Due test di regressione (codice in stile TypeScript o Jest)
4. Ipotesi e limiti
Non affermare di aver eseguito il codice.1. Causa principale
`current` è uno stato a livello di modulo condiviso da ogni chiamata. In un ciclo JavaScript, il controllo di null e l’assegnazione sono atomici, quindi due chiamate sovrapposte non eseguono entrambe `load()`. La prima chiamata memorizza la propria promessa; una seconda chiamata che arriva prima che quella promessa si risolva salta il proprio `load()` e attende la stessa promessa. `handler` restituisce quindi un codice di stato HTTP 200 il cui `body` è la stringa della prima chiamata, non il payload della seconda richiesta. Questa finestra temporale esiste solo mentre una chiamata è in corso, quindi l’errore si manifesta solo quando le richieste si sovrappongono.
`current = null` viene eseguito in ogni continuazione dopo che `await` ha già catturato la promessa. Non induce l’altro soggetto in attesa a rileggere la variabile, quindi questi file da soli non risolvono quel soggetto in attesa in `null` o `""`. Ciò che producono in caso di sovrapposizione è una risoluzione condivisa e un caricamento per richiesta saltato. Inoltre, ciò rende lo slot una cache a volo singolo inadeguata: la prima continuazione che riprende l’esecuzione abbandona `current`, e un chiamante successivo può avviare un `load()` diverso mentre un altro chiamante sta ancora completando l’esecuzione.
2. Patch minima sicura (mostra un diff unificato)
Ogni richiesta deve chiamare `load()` autonomamente. Sono consentite chiamate `load()` concorrenti e ciascuna restituisce un payload diverso, quindi la deduplicazione su un’unica promessa condivisa non è sicura. `handler.ts` non necessita di modifiche.
```diff
--- a/src/cache.ts
+++ b/src/cache.ts
@@ -1,10 +1,3 @@
-let current: Promise | null = null;
-
export async function getPayload(load: () => Promise): Promise {
- if (!current) {
- current = load();
- }
- const value = await current;
- current = null;
- return value;
+ return await load();
}
```
3. Due test di regressione (codice in stile TypeScript o Jest)
```ts
import { handler } from '../src/handler';
function deferred() {
let resolve!: (value: T) => void;
let reject!: (reason: unknown) => void;
const promise = new Promise((res, rej) => {
resolve = res;
reject = rej;
});
return { promise, resolve, reject };
}
test('le richieste sovrapposte vengono caricate ad ogni esecuzione e mantengono il proprio corpo', async () => {
const first = deferred();
const second = deferred();
const started: string[] = [];
const p1 = handler(() => {
started.push('a');
return first.promise;
});
const p2 = handler(() => {
started.push('b');
return second.promise;
});
expect(started).toEqual(['a', 'b']);
second.resolve('payload-b');
first.resolve('payload-a');
await expect(p1).resolves.toEqual({ status: 200, body: 'payload-a' });
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
test('un payload sovrapposto rifiutato non modifica l'altra risposta', async () => {
const failed = deferred();
const ok = deferred();
let started = 0;
const p1 = handler(() => {
started += 1;
return failed.promise;
});
const p2 = handler(() => {
started += 1;
return ok.promise;
});
expect(started).toBe(2);
failed.reject(new Error('errore a monte'));
ok.resolve('payload-b');
await expect(p1).rejects.toThrow('errore a monte');
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
```
4. Presupposti e limiti
Non ho eseguito né questo codice né i test. I test presuppongono l’uso di un runner in stile Jest e la presenza di un file in una directory a livello di `src/` (ad esempio `test/cache.test.ts`).
Ho considerato il requisito “payload diverso per ogni richiesta” nel senso che le chiamate sovrapposte a `getPayload` non devono condividere lo stesso risultato di `load()`. Una corretta riscrittura a volo singolo (`load().finally(() => { current = null; }); return current`) continuerebbe comunque ad accoppiare tali richieste, pertanto non l’ho utilizzata. Non è presente alcuna chiave di cache e non viene specificato alcun requisito di deduplicazione.
Un corpo HTTP letteralmente vuoto non viene scritto dalle istruzioni mostrate se `load` restituisce una stringa non vuota. Se quel sintomo proviene da un adattatore esterno a questi file, qui non è visibile. La patch rimuove solo l’accoppiamento dovuto alla sovrapposizione che questi file implementano effettivamente. Non aggiunge blocchi, tentativi di riprova o una cache con chiave.Grok 4.7 ha correttamente rilevato che a livello di modulo corrente La promise fa sì che le richieste sovrapposte condividano un unico risultato del loader, anche se ogni richiesta necessita del proprio payload. È stata proposta la modifica minima necessaria: rimuovere la promise condivisa e chiamare load() su richiesta. I due test di regressione hanno riguardato payload concorrenti distinti e l’isolamento nel caso in cui un caricatore restituisca un errore. Il punto di forza della risposta è stata proprio la sua moderazione: ha affermato esplicitamente che il codice mostrato dimostra l’accoppiamento tra richieste, ma di per sé non spiega la presenza di un corpo letteralmente vuoto se il caricatore restituisce sempre una stringa non vuota.
Verdetto: Ottimi risultati in termini di accuratezza nell'individuazione delle cause alla radice, ambito delle patch, copertura dei test di regressione e gestione delle incertezze.
Test 2: Nota di ricerca su fonti contrastanti
Compito 2 — Riconciliare le note di ricerca contraddittorie in una nota decisionale.

Utilizza solo queste sei note e indica il nome della fonte accanto a ogni affermazione fattuale:

- Fornitore A, pagina dei prezzi, 20/09/2026: Il piano Team costa $40 al mese per postazione e include 100.000 azioni incluse.
- Fornitore B, post di confronto, 21/09/2026: Il piano Team del Fornitore A include 120.000 azioni al mese per postazione.
- Intervista al cliente, 18/09/2026: Il nostro team ha 8 postazioni e il mese scorso ha utilizzato 710.000 azioni.
- Foglio di calcolo finanziario, 19/09/2026: L’attuale tetto di bilancio è di $360 al mese.
- Fornitore A, pagina dei limiti, 20/09/2026: Il superamento del limite viene fatturato a $0,004 per azione oltre la quota inclusa.
- Nota sugli appalti, 22/09/2026: un cambio di fornitore è accettabile solo se il totale mensile rimane entro il budget e la quota inclusa è verificata.

Restituire esattamente queste sezioni:
1. Fatti verificati
2. Affermazioni attribuite
3. Tabella dei conflitti
4. Calcoli indipendenti (calcolare entrambi gli scenari 8 x 100.000 e 8 x 120.000, più eventuali eccedenze)
5. Raccomandazione
6. Una sola domanda chiarificatrice, solo se il conflitto modifica la raccomandazione
Non risolvere in silenzio il conflitto tra 100.000 e 120.000.
1. Fatti verificati
- Il piano Team prevede $40 al mese per postazione (Fornitore A, pagina dei prezzi, 20 settembre 2026).
- Il team dispone di 8 postazioni e il mese scorso ha utilizzato 710.000 azioni (colloquio con il cliente, 18/09/2026).
- L’attuale tetto di bilancio è di $360 al mese (foglio di calcolo della contabilità, 19/09/2026).
- Il superamento del limite viene fatturato a $0,004 per azione oltre la quota inclusa (Fornitore A, pagina dei limiti, 20/09/2026).
- Un cambio di fornitore è accettabile solo se il totale mensile rimane entro il budget e la quota inclusa è verificata (Nota degli acquisti, 22/09/2026).

2. Richieste attribuite
- Il Team include 100.000 azioni incluse (Fornitore A, pagina dei prezzi, 20/09/2026). Tale nota non specifica esplicitamente “per postazione”.
- Il pacchetto del Fornitore A comprende 120.000 azioni al mese per postazione (Fornitore B, post di confronto, 21/09/2026).

3. Tabella dei conflitti
| Voce | Affermazione | Fonte | Stato |
| --- | --- | --- | --- |
| Azioni incluse | 100.000 azioni incluse; non è specificato “per postazione” | Fornitore A, pagina dei prezzi, 20/09/2026 | Irrisolta |
| Azioni incluse | 120.000 azioni al mese per postazione | Fornitore B, post di confronto, 21/09/2026 | Irrisolto |

Il conflitto tra 100.000 e 120.000 non è stato risolto. Queste note non indicano quale cifra sia corretta.

4. Calcoli indipendenti
Costo base per postazione, uguale in entrambi gli scenari: 8 postazioni (Intervista al cliente, 18/09/2026) × $40 al mese per postazione (Fornitore A, pagina dei prezzi, 20/09/2026) = $320 al mese.

Entrambi i moltiplicatori riportati di seguito sono calcolati come richiesto. Non costituiscono una conclusione secondo cui il Fornitore A abbia indicato un'indennità per postazione.

- 8 × 100.000 = 800.000 azioni incluse, utilizzando la cifra di 100.000 (Fornitore A, pagina dei prezzi, 20/09/2026).
- L’utilizzo di 710.000 (colloquio con il cliente, 18/09/2026) è inferiore di 90.000 rispetto a 800.000, quindi le azioni in eccesso = 0.
- Costo per il superamento del limite = 0 × $0,004 = $0 (Fornitore A, pagina dei limiti, 20/09/2026).
- Totale mensile = $320 + $0 = $320, che rientra nel limite massimo di $360 (foglio di calcolo della divisione Finanza, 19/09/2026).

- 8 × 120.000 = 960.000 azioni incluse, utilizzando la cifra di 120.000 (Fornitore B, post di confronto, 21/09/2026).
- L’utilizzo di 710.000 (colloquio con il cliente, 18/09/2026) è inferiore di 250.000 rispetto a 960.000, quindi le azioni in eccesso = 0.
- Addebito per eccedenza = 0 × $0,004 = $0 (Fornitore A, pagina dei limiti, 20/09/2026).
- Totale mensile = $320 + $0 = $320, che rientra nel limite massimo di $360 (foglio di calcolo della direzione finanziaria, 19/09/2026).

5. Raccomandazione
Non approvare ancora il passaggio. In base a entrambi i limiti calcolati, le 710.000 azioni del mese scorso (Intervista al cliente, 18/09/2026) non generano alcun superamento e un totale mensile di $320, che rientra nel limite massimo di $360 (foglio di calcolo della Finanza, 19/09/2026). Tale risultato in termini di costo non dipende dalla scelta tra 100.000 o 120.000. Il passaggio non soddisfa comunque la seconda condizione: la quota deve essere verificata (Nota degli acquisti, 22/09/2026), e queste note indicano 100.000 (Fornitore A, pagina dei prezzi, 20/09/2026) in conflitto con 120.000 (Fornitore B, post di confronto, 21/09/2026).

6. Una sola domanda di chiarimento solo se il conflitto modifica la raccomandazione
Nessuna domanda di chiarimento. Il conflitto tra 100.000 e 120.000 non modifica la raccomandazione.
Il materiale di ricerca presentava deliberatamente informazioni contrastanti sul fatto che la quota fosse di 100.000 o 120.000 azioni per posto. Il documento Grok 4.7 ha tenuto separate le due fonti, ha rilevato che la prima fonte non specificava esplicitamente “per postazione”, ha calcolato entrambi gli scenari da otto postazioni e ha dimostrato che entrambi si attestavano a $320 senza superamento della quota per l’utilizzo fornito. Ha comunque raccomandato di sospendere l’approvazione poiché l’ufficio acquisti richiedeva la verifica della quota. Questa è la giusta distinzione tra una raccomandazione numericamente stabile e un fatto contrattuale irrisolto.
Verdetto: Ottimo risultato in materia di attribuzione, aritmetica, gestione dei conflitti e disciplina decisionale.
Test 3: Da appunti disordinati al piano di esecuzione
Compito 3 — Trasforma queste note disordinate sul progetto in un piano di esecuzione di una settimana di meno di 700 parole.

Note:
- Lancio della landing page venerdì alle 17:00; il product owner indica giovedì mattina in una nota successiva.
- Mina: scrivere il titolo e la tabella dei prezzi. Mina precisa inoltre che potrà revisionare il testo solo mercoledì pomeriggio.
- Arjun: eventi di analisi; una nota duplicata indica che il responsabile dell’analisi è ancora da definire.
- Il reparto Design presenta due attività duplicate: “ritaglio hero per mobile” e “ritaglio hero per mobile – versione finale”.
- La revisione legale deve avvenire prima di qualsiasi lancio pubblico.
- Il controllo qualità (QA) necessita di un giorno intero dopo che gli eventi di analisi saranno disponibili.
- Omar sarà assente martedì pomeriggio.
- L’invio dell’e-mail di lancio è previsto per venerdì alle 16:00.
- Sconosciuto: chi è responsabile della decisione finale sul via libera o meno.

Requisiti: raggruppare i lavori duplicati, contrassegnare i responsabili sconosciuti come “da definire”, mantenere entrambe le scadenze inderogabili, segnalare le contraddizioni invece di risolverle in silenzio e concludere con un elenco di cinque rischi.

Restituire esattamente queste sezioni:
1. Piano settimanale
2. Contraddizioni e incognite
3. Cinque rischi
Non inventare responsabili o date.
1. Piano settimanale

Nelle note non sono presenti date di calendario, quindi non ne vengono aggiunte. Vengono utilizzati solo i punti di riferimento e le dipendenze indicati. Il lavoro di progettazione duplicato costituisce un’unica attività. I responsabili non identificati rimangono “da definire”. Le tempistiche di lancio in conflitto vengono mantenute entrambe.

- Testi: Mina scrive il titolo e la tabella dei prezzi. La revisione dei suoi testi è prevista solo per mercoledì pomeriggio.
- Design: un’unica attività, ritaglio dell’hero image per dispositivi mobili, compresa la revisione “finale”. Non è stato indicato alcun responsabile specifico.
- Eventi di analisi: devono essere definiti prima del controllo qualità. Il responsabile non è stato stabilito (Arjun in una nota; da definire in un’altra).
- Controllo qualità: una giornata intera, solo dopo che gli eventi di analisi saranno disponibili. Responsabile da definire. Non è assegnata alcuna data per il controllo qualità.
- Revisione legale: richiesta prima di qualsiasi lancio pubblico. Responsabile da definire. Non programmata nelle note.
- Via libera/rifiuto: responsabile da definire. Non considerata decisa.
- Punti di riferimento del lancio pubblico, entrambi mantenuti: giovedì mattina (product owner) e venerdì alle 17:00 (pagina di destinazione).
- Email di lancio: venerdì alle 16:00. Responsabile da definire.
- Omar è assente martedì pomeriggio. Nessuna attività in queste note è assegnata a Omar, quindi nessuna viene spostata.

Ordine, senza nuove date: la bozza di Mina deve essere pronta per la revisione di mercoledì pomeriggio; il team di design completa il ritaglio dell’immagine principale; gli eventi di analisi vengono forniti dal responsabile non ancora definito; il team QA ha poi a disposizione un’intera giornata; la revisione legale termina prima di qualsiasi lancio pubblico; il “via/stop” (da definire) è ancora senza responsabile. Non eliminare giovedì mattina, venerdì alle 17:00 o venerdì alle 16:00.

2. Contraddizioni e incognite

Contraddizioni (non risolte):
- Il lancio della landing page è previsto per venerdì alle 17:00, mentre una nota successiva del product owner indica giovedì mattina.
- Il responsabile dell’analisi dei dati è Arjun in una nota e “da definire” in una nota duplicata.

Incertezze, contrassegnate come “da definire”:
- Responsabile definitivo del “via libera/no”.
- Responsabile definitivo dell’analisi dei dati.
- Responsabile della revisione legale.
- Responsabile del controllo qualità.
- Responsabile dell’e-mail di lancio.
- Responsabile del design specificato oltre alla voce “Design”.
- Il ruolo di Omar; è indicata solo l’assenza di martedì pomeriggio.
- Quale orario di lancio è quello ufficiale e se l’e-mail di venerdì alle 16:00 corrisponde a uno dei due orari. Non vengono fornite date oltre a tali orari nei giorni feriali.

3. Cinque rischi

1. Giovedì mattina e venerdì alle 17:00 non possono essere entrambi l’orario di lancio della pagina di destinazione; utilizzare uno dei due senza una decisione definitiva può comportare un lancio anticipato o il mancato rispetto dell’altra scadenza.
2. L’e-mail di lancio è fissata per venerdì alle 16:00, prima delle 17:00 di venerdì e non è allineata nelle note con la mattina di giovedì; pertanto, potrebbe essere inviata in riferimento a una pagina che non è ancora o non è più nello stato previsto.
3. La responsabilità per l’analisi dei dati è oggetto di controversia, quindi gli eventi potrebbero subire ritardi; il controllo qualità richiede ancora un’intera giornata dopo gli eventi e potrebbe non rientrare prima di nessuno dei due punti di riferimento del lancio.
4. La revisione legale deve precedere qualsiasi lancio pubblico, ma non ha un responsabile né una fascia oraria assegnata, quindi il lancio potrebbe essere bloccato o avvenire senza revisione.
5. Non è stato nominato alcun responsabile per la decisione di procedere o meno, quindi nessuna delle due scadenze fisse ha una persona designata per approvare o bloccare il lancio.
Grok 4.7 ha unificato l'attività duplicata "mobile-hero", ha mantenuto il conflitto tra il lancio del giovedì mattina e quello del venerdì alle 17:00, ha mantenuto la scadenza per l'invio dell'e-mail del venerdì alle 16:00, ha contrassegnato i responsabili non ancora definiti come "da definire" e ha concluso con esattamente cinque rischi. Non ha inventato date di calendario né responsabili. Il punto debole era l’attuabilità: invece di assegnare il lavoro in una sequenza dal lunedì al venerdì, ha restituito un elenco ordinato di dipendenze e ha indicato che non era possibile assegnare alcuna giornata dedicata al controllo qualità (QA). Tale cautela è giustificabile, ma la richiesta prevedeva un piano di esecuzione di una settimana, quindi la risposta ha soddisfatto solo in parte il formato richiesto.
Verdetto: Risultato parziale: eccellente conservazione dei vincoli, minore utilità in termini di pianificazione.
Quali cambiamenti apporta la versione Grok 4.7 nei flussi di lavoro reali
Il modo più utile per interpretare il lancio è quello di considerarlo come una questione relativa al flusso di lavoro: in quali casi il ragionamento approfondito riduce il carico di lavoro di revisione e in quali casi produce semplicemente una risposta più lunga? Le tre attività relative alle API suggeriscono uno schema pratico. Grok 4.7 riesce bene a mantenere visibili contemporaneamente diversi vincoli, specialmente quando il prompt gli chiede di separare i fatti dalle ipotesi. Risulta meno convincente quando l’attività richiede un calendario concreto o una sequenza di esecuzione che le note di partenza non specificano completamente.
Codifica e debug
Per quanto riguarda il lavoro sul repository, il modello è più adatto a una diagnosi circoscritta che a una richiesta aperta del tipo “crea un’app”. Fornite il set di file più piccolo possibile, descrivete il sintomo del malfunzionamento e richiedete l’individuazione della causa principale prima di una patch. Chiedete test che falliscano prima della modifica e superino il test dopo di essa. Nel nostro test dell’handler, la risposta è rimasta vicina al codice fornito e ha evitato di inventare una causa esterna per il sintomo del corpo vuoto.
Questo comportamento è importante perché la qualità della programmazione non si limita alla semplice generazione di codice. Una risposta di programmazione efficace dovrebbe preservare il design locale, limitare le differenze, identificare i presupposti e rendere la verifica poco onerosa. Grok 4.7 ha fatto tutto questo in un piccolo task, ma un singolo task non può garantire l’affidabilità a livello di repository. I team dovrebbero applicare lo stesso schema di valutazione a un bug reale, a un refactoring, a una modifica su più file e a un percorso sensibile dal punto di vista della sicurezza prima di passare al lavoro in produzione.
Ricerca e sintesi delle fonti
Il lavoro di ricerca ha messo in luce un altro punto di forza: la rigorosa separazione tra fonti e confini. Grok 4.7 non ha fuso acriticamente la dichiarazione del fornitore relativa a 100.000 azioni con la cifra di 120.000 riportata nel post di confronto. Ha inoltre distinto un calcolo che risulta valido in entrambi gli scenari da una condizione di approvvigionamento che richiede ancora verifica.
Questo è lo schema giusto per lavori che richiedono un'intensa attività di ricerca. Chiedi al modello di contrassegnare separatamente i fatti verificati, le affermazioni attribuite, i conflitti irrisolti, i calcoli e le raccomandazioni. Anche una nota ben redatta può comunque essere errata se presenta un'affermazione secondaria come un fatto non citato. La risposta di Grok 4.7 è stata utile perché ha mantenuto visibile il conflitto, anche se il risultato aritmetico non è cambiato.
Pianificazione e operazioni
È nella fase di pianificazione che i limiti sono diventati più evidenti. Il modello ha mantenuto tutte le scadenze e i proprietari sconosciuti, ma non è riuscito a definire un programma dal lunedì al venerdì. Si tratta di una soluzione più sicura rispetto all’invenzione di date, ma implica comunque che l’utente debba convertire le dipendenze in assegnazioni di calendario.
Per le indicazioni operative, includere l’orizzonte di pianificazione, i giorni lavorativi disponibili, la disponibilità del proprietario e il responsabile delle decisioni. Se tali campi non sono presenti, richiedere innanzitutto una mappa delle dipendenze e, in secondo luogo, un calendario. Questo flusso di lavoro in due fasi rende utile l’avviso del modello, anziché considerarlo come un’incapacità di prendere decisioni.
Recupero in contesto esteso
Una finestra di contesto da 500K modifica ciò che può essere contenuto in una singola richiesta, ma non ciò di cui ci si può fidare senza effettuare verifiche. Il lavoro su contesti estesi dovrebbe avvalersi di "sonde di recupero": inserire fatti determinanti all’inizio, a metà e alla fine di un pacchetto; aggiungere un conflitto intenzionale; quindi richiedere una decisione indicando le posizioni delle fonti. Misurare sia il recall che la disciplina dei confini.
Non giudicare un percorso a contesto lungo in base alla sua capacità di accettare una richiesta di grandi dimensioni. Prendi nota dei casi in cui il modello tralascia alcuni fatti, se attribuisce un peso eccessivo alla sezione finale, di quanto aumenta la latenza al crescere delle dimensioni dell’input e se il provider tronca o trasforma la richiesta. Una finestra di grandi dimensioni pubblicizzata è una dichiarazione di capacità, non una garanzia di ragionamento stabile al limite.
Come valutare autonomamente il modello Grok 4.7
Prima di modificare un’impostazione predefinita di produzione, utilizza un set di test ridotto e ripetibile. L’obiettivo non è ricreare una classifica, bensì confrontare il modello con il percorso e il processo di revisione per cui paghi già.
- Blocca gli input. Salvare il prompt esatto, i file, il pacchetto sorgente, l'ID del modello, la temperatura, le impostazioni di ragionamento e le autorizzazioni dello strumento. Non confrontare un percorso diretto con un percorso del provider mentre si modifica contemporaneamente il prompt.
- Valuta l’opera, non la prosa. Per la programmazione, valutare l’accuratezza nell’individuazione delle cause alla radice, l’ambito della patch, i test e le ipotesi. Per la ricerca, valutare i limiti delle citazioni, i calcoli aritmetici, i conflitti e la qualità delle raccomandazioni. Per la pianificazione, valutare il rispetto delle scadenze, la responsabilità, le dipendenze e l’attuabilità.
- Registrare separatamente i trasporti. Registra nel log della route il tempo trascorso fino al primo token, il tempo totale, la modalità stream/non-stream, lo stato HTTP e il comportamento dei tentativi di riprova. Un timeout del gateway non costituisce automaticamente un errore a livello di modello, ma rappresenta comunque un costo di produzione.
- Verificare il comportamento in caso di errore. Includere un dato ambiguo, una fonte contraddittoria e una serie di file volutamente incompleta. La domanda rilevante è se il modello segnali l’incertezza o colmi la lacuna con un’ipotesi sicura.
- Valutate insieme i costi e l'impegno richiesto. Tieni traccia dei token di input, dei token di output, degli input memorizzati nella cache, dei token di ragionamento quando vengono esposti e dei minuti dedicati alla revisione umana. Una risposta più economica che richiede il doppio del tempo per la verifica potrebbe non risultare più conveniente nella pratica.
- Ripetere prima di cambiare. Esegui ogni compito almeno due volte o su diversi esempi rappresentativi prima di modificare un'impostazione predefinita del team. Conserva la risposta grezza visibile e le note relative al punteggio, in modo che un altro revisore possa riprodurre la decisione.
Le tre esecuzioni riportate in questa recensione costituiscono un campione iniziale e non sostituiscono la serie di valutazioni di una squadra. Esse mostrano come si comporta Grok 4.7 in un compito di codifica, in un promemoria relativo a un conflitto tra fonti e in un pacchetto di pianificazione; non stabiliscono tuttavia una classifica universale.
Prezzi e accesso all’API per Grok 4.7
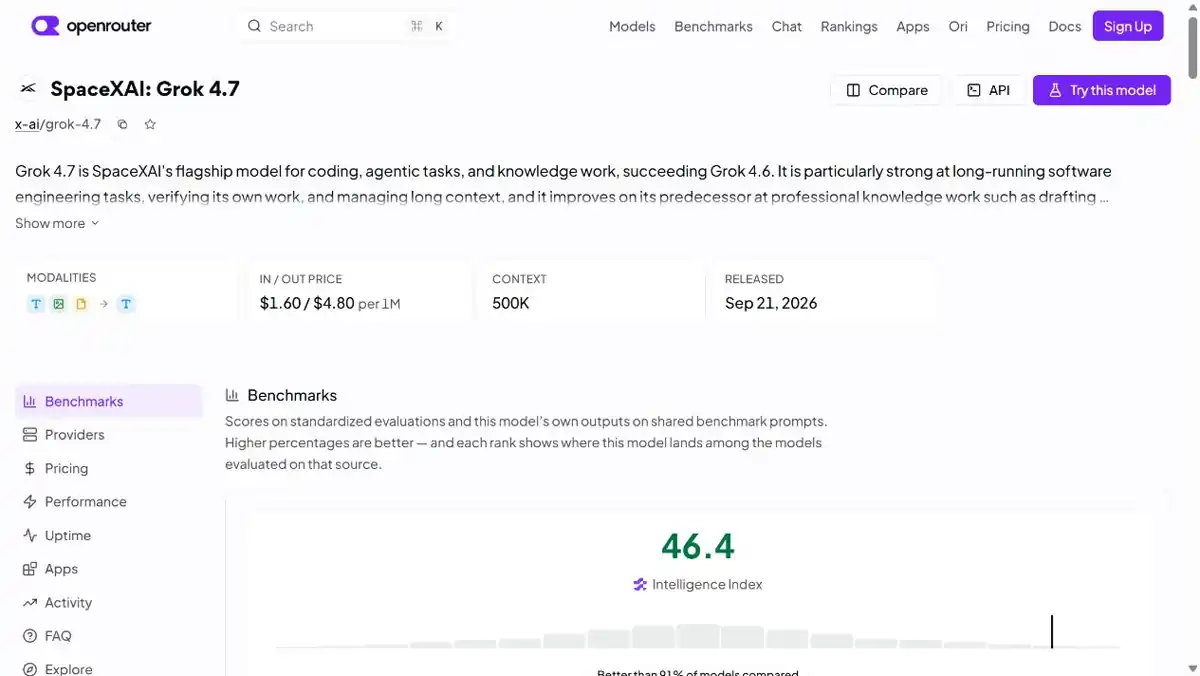
È proprio sul fronte dei prezzi che le recensioni dei modelli rischiano spesso di diventare fuorvianti. Ci sono almeno tre cifre diverse che un lettore può trovare: il prezzo diretto dell’API di xAI, il prezzo della rotta indicato da un aggregatore e il prezzo dell’abbonamento per i consumatori. Non sono intercambiabili.
Secondo quanto annunciato da xAI, il modello Grok 4.7 viene offerto allo stesso prezzo e con la stessa velocità del modello Grok 4.6. La pagina di lancio indica che il modello standard parte da $2 per ogni milione di token in ingresso e $6 per ogni milione di token emessi; "Artificial Analysis" riporta separatamente gli stessi dati relativi al percorso diretto e $0,50 per ogni milione di token di input memorizzati nella cache. xAI afferma inoltre che una variante veloce raddoppia la velocità di produzione a un prezzo doppio. Utilizza il documentazione ufficiale per gli sviluppatori per verificare il contratto API attuale e la disponibilità specifica dell'account prima di inviare traffico di produzione.
Pagina 4.7 del Grok di OpenRouter mostra $1,60 per ogni milione di token in ingresso e $4,80 per ogni milione di token emessi per il proprio percorso. Si tratta di un prezzo OpenRouter/provider, non di una correzione del prezzo di listino diretto di xAI. Il routing, il ricarico, la memorizzazione nella cache, i limiti e la disponibilità possono variare a seconda del provider.
Non è possibile dare una risposta univoca alla domanda “Quanto costa il Grok 4.7?” senza specificare la rotta. Per chi acquista API, è opportuno confrontare:
- frequenze dei token in ingresso e in uscita;
- trattamento degli input memorizzati nella cache;
- contesto e limiti di output;
- limiti di tariffa e disponibilità a livello regionale;
- se il fornitore mette a disposizione controlli di ragionamento;
- condizioni relative alla raccolta, alla conservazione e al trattamento dei dati.
Per quanto riguarda l'accesso da parte degli utenti, non dare per scontato che il prezzo indicato dall'API corrisponda al costo di un abbonamento X o Grok. Il piano per gli utenti, il percorso API e l'aggregatore di terze parti possono avere regole di accesso diverse.
Quale route API dovresti scegliere?
| Percorso | Il migliore per | Cosa verificare prima dell'uso | Principale compromesso |
|---|---|---|---|
| API Direct xAI | Sistemi di produzione che richiedono un contratto stipulato direttamente con il fornitore | ID modello ufficiale, limiti di frequenza, condizioni relative ai dati, regioni, streaming e prezzo attuale | La provenienza più trasparente, ma sei tu a gestire direttamente la fatturazione e la disponibilità |
| OpenRouter | Confronto rapido tra provider e simulazione di percorsi | Fornitore effettivo a monte, prezzo della rotta, cache, privacy, contesto e comportamento di fallback | Il cambio è più semplice, ma il percorso non è lo stesso del servizio diretto xAI |
| API di test compatibile con OpenAI | Valutazione interna o un client preesistente che supporta già lo schema OpenAI | Mappatura dei modelli, limiti di timeout, supporto allo streaming, campi di utilizzo, conservazione dei dati e semantica degli errori | Integrazione pratica, ma la compatibilità non garantisce un comportamento identico da parte dei provider |
Il percorso compatibile utilizzato per la parte pratica ha restituito grok-4.7 e supportava lo streaming. La sua richiesta di codifica non in streaming ha superato la finestra di attesa del gateway prima che il tentativo di streaming fosse completato. Questa osservazione è utile nella progettazione di un client, ma non dovrebbe essere riportata in una dichiarazione relativa alla latenza di DirectX AI.
Come accedere a Grok 4.7
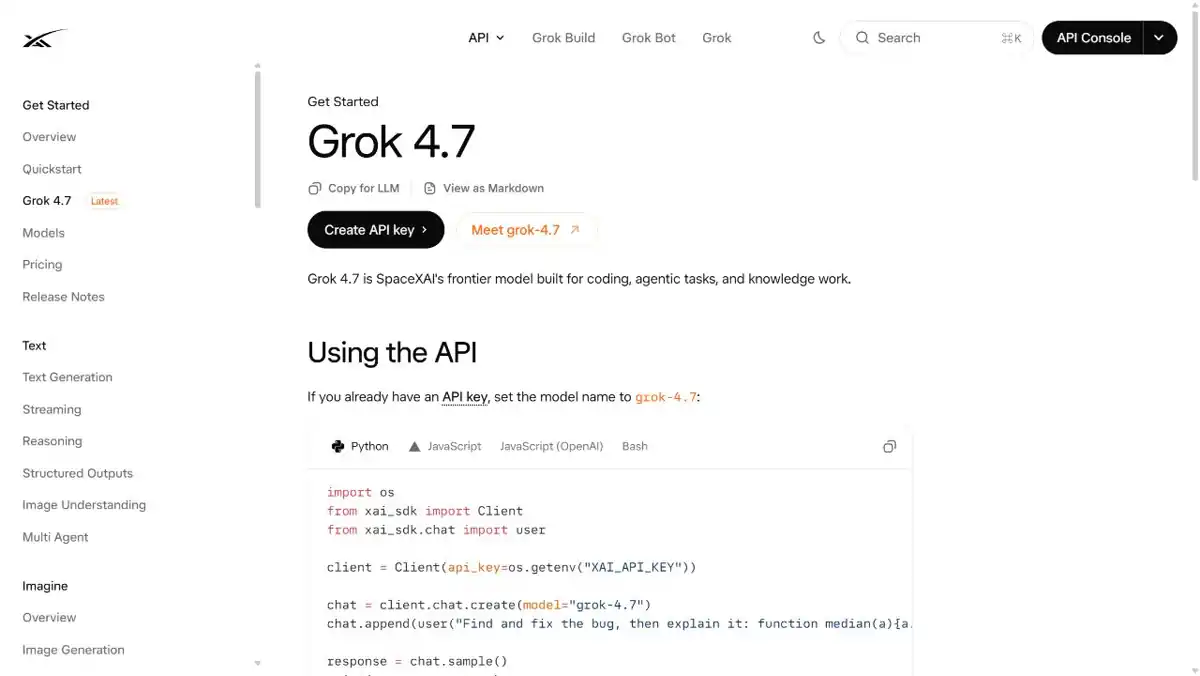
Il modo più semplice è iniziare con il Annuncio di xAI e Pagina degli sviluppatori di xAI, quindi verifica se ti serve Grok Build, Cursor, l’API diretta o un aggregatore. xAI afferma che Grok 4.7 è disponibile in Cursor e Grok Build, tramite l’API Grok, nonché tramite harness di codifica di terze parti, router di modelli e piattaforme cloud. Tale distinzione determina la fatturazione, i controlli sui modelli, i termini sulla privacy e gli strumenti disponibili.
Se si utilizza un aggregatore, aprire la pagina del modello e verificare il percorso del provider, i prezzi dei token, il limite di contesto e l'identificatore del modello prima di procedere alla creazione. OpenRouter è un percorso documentato, ma i relativi prezzi non devono essere copiati in una tabella di fatturazione xAI.
Per i lettori che desiderano confrontare diverse famiglie di modelli in un unico spazio di lavoro, L'area di lavoro multimodello di GlobalGPT può essere utile per una valutazione comparativa dei prompt. Questo articolo non affermano che il percorso Grok 4.7 sia già disponibile in quella località. La disponibilità del percorso indicata nel catalogo è una questione a sé stante e dovrebbe essere verificata nell’interfaccia utente del prodotto prima dell’acquisto.
Grok 4,7 rispetto a ChatGPT, Claude e Gemini
Questa analisi include i risultati di tre task Grok 4.7, ma non presenta confronti con ChatGPT, Claude o Gemini. Una conclusione generica del tipo “Grok 4.7 vince” rimarrebbe comunque una mossa di marketing, non un’analisi. Una scelta più appropriata dipende dal lavoro svolto attorno al modello:
| Se la vostra priorità è... | Inizia valutando… | Perché |
|---|---|---|
| Pacchetti tecnici di grandi dimensioni | Grok 4.7 e altre rotte con contesto esteso | Verificate l’accuratezza del recupero dei dati, non solo l’intervallo dichiarato |
| Debug del repository | Grok 4.7, un modello incentrato sulla programmazione, e il tuo solito ciclo di test | Confronta la qualità delle analisi delle cause alla radice e i tempi di revisione |
| Ricerca incentrata sulle fonti | Un flusso di lavoro orientato alla ricerca unito a un modello di ragionamento generale | Verificare le citazioni prima di accettare le conclusioni |
| Integrazioni esistenti relative alla produttività | Il modello già integrato nei tuoi strumenti | I costi di passaggio possono superare il guadagno derivante dall'indice di riferimento |
| Fattura API più bassa | Percorsi diretti e tramite aggregatori a confronto | I prezzi variano a seconda del provider e del comportamento della cache |
Il “Guida ”Per quale IA vale la pena spendere?” pone la domanda giusta in fase di acquisto: quale attività ricorrente offre un miglioramento tale da giustificare il costo dell’abbonamento o dell’API? Si tratta di una regola decisionale più solida rispetto al perseguire l’ultima novità in classifica.
Limiti e questioni aperte
La versione Grok 4.7 è troppo recente per poter raggiungere un ampio consenso indipendente. I dati disponibili lasciano aperte diverse questioni:
- In che misura il miglioramento è uniforme tra le attività di programmazione, ricerca, scrittura e quelle multimodali?
- Il contesto da 500K rimane affidabile in prossimità del limite, oppure il recupero dei dati subisce un deterioramento già prima?
- Quanta latenza aggiuntiva comporta lo sforzo di ragionamento più intenso?
- Quali piani tariffari, regioni, strumenti e limiti di velocità rendono il modello vulnerabile?
- In che modo le nuove misure di sicurezza si applicano alle attività tecniche legittime ma sensibili?
- Direct xAI, OpenRouter e altri fornitori restituiscono risultati o limiti sostanzialmente diversi?
Queste domande non sono motivi per scartare il modello. Sono invece il motivo per cui è necessario condurre una valutazione su piccola scala ma rappresentativa prima di migrare un flusso di lavoro o promettere un risparmio sui costi.
A chi è destinato il modello Grok 4.7?
Vale la pena provare prima Grok 4.7 se:
- lavorare a lungo al debug del codice o all'analisi di documentazione tecnica;
- lavorare con pacchetti sorgente che superano le dimensioni delle normali finestre di chat;
- apprezzare un modello disposto a dedicare maggiore impegno a un prompt complesso;
- può verificare i risultati prima di inviarli direttamente in produzione;
- stanno mettendo a confronto i modelli economici delle API dirette e degli aggregatori.
Non è la soluzione più adatta se avete bisogno di un'integrazione matura, di un piano per gli utenti chiaramente documentato o di un vantaggio comprovato nello svolgimento dello stesso compito rispetto al modello già presente nel vostro stack. In questi casi, il livello di accesso e il flusso di lavoro potrebbero avere maggiore importanza rispetto a un miglioramento di due punti nell'indice.
FAQ
Che cos’è Grok 4.7?
Grok 4.7 è la versione del modello rilasciata da xAI il 21 settembre 2026 per la programmazione e le attività intellettuali. Secondo xAI, questa versione dedica più tempo alle attività complesse, verifica il proprio lavoro con maggiore attenzione e introduce una nuova serie di misure di sicurezza, pur mantenendo lo stesso prezzo e la stessa velocità della versione Grok 4.6.
Quando è stata rilasciata la versione Grok 4.7?
Il 21 settembre 2026 xAI ha annunciato il modello Grok 4.7. La pagina ufficiale di lancio e la documentazione per gli sviluppatori rappresentano le fonti più attendibili per informazioni sullo stato del rilascio, sulla disponibilità dei modelli e sulle modifiche alle API.
Il modello Grok 4.7 è migliore del modello Grok 4.6?
Artificial Analysis riporta un Indice di Intelligenza pari a 46, due punti al di sopra del valore Grok 4,6, e un punteggio Elo AA-Briefcase di 1.657, 111 punti al di sopra di 4,6. Si tratta di segnali utili, non di un risultato universale valido per ogni flusso di lavoro.
Che cos’è la finestra di contesto di Grok 4.7?
Artificial Analysis indica una finestra di contesto di 500.000 token per Grok 4.7. Una finestra di grandi dimensioni non garantisce un recupero perfetto, pertanto è consigliabile testare il modello con informazioni inserite in diversi punti di un documento lungo prima di affidarsi ad esso per attività che richiedono un uso intensivo di fonti.
Quanto costa l'API Grok 4.7?
Artificial Analysis indica che la velocità dell'API diretta è di $2 per ogni milione di token in ingresso e di $6 per ogni milione di token in uscita, mentre quella con input memorizzato nella cache è di $0,50 per ogni milione di token. Si raccomanda di consultare la documentazione aggiornata di xAI prima dell'utilizzo in produzione.
Il prezzo del modello Grok 4.7 di OpenRouter è uguale a quello di xAI?
No. OpenRouter indica $1,60 per ogni milione di token in ingresso e $4,80 per ogni milione di token in uscita per il proprio percorso. Si tratta di un prezzo specifico del provider e dovrebbe essere confrontato separatamente dai prezzi dell’API diretta di xAI. OpenRouter mostra anche i campi relativi alla cache, alla latenza, al throughput e alla privacy specifici del provider, che possono modificare il costo effettivo di una rotta.
Come posso accedere a Grok 4.7?
Inizia consultando l'annuncio ufficiale di xAI e la documentazione per gli sviluppatori, quindi scegli il prodotto Grok destinato ai consumatori, l'API diretta di xAI o un aggregatore come OpenRouter. Verifica l'ID del modello, la regione, i limiti di velocità, il contesto e la fatturazione relativi al percorso che intendi effettivamente utilizzare.
Il modello Grok 4.7 è disponibile per il modello GlobalGPT?
Questa recensione non garantisce la presenza di un percorso Grok 4.7 verificato su GlobalGPT. Il modello GlobalGPT può essere utilizzato per confrontare le famiglie di modelli disponibili, ma è necessario verificare l’attuale catalogo e l’esatta disponibilità dei modelli nell’interfaccia utente del prodotto prima dell’acquisto.
Il modello Grok 4.7 è adatto per la codifica degli agenti?
Vale la pena testarlo per il debug circoscritto, la revisione del codice e il ragionamento su più file, in cui l’agente deve spiegare le ipotesi e generare test. L’attività pratica di programmazione era valida, ma non ha messo alla prova l’esecuzione degli strumenti, la modifica del repository, le autorizzazioni né un ciclo completo dell’agente.
Perché era necessario lo streaming per il test di programmazione?
La prima richiesta senza streaming ha superato la finestra di attesa del gateway della rotta di test. La stessa richiesta è stata completata con lo streaming abilitato. Ciò dimostra perché i client di produzione dovrebbero supportare lo streaming e i timeout espliciti; non dimostra però che ogni rotta Grok 4.7 presenti lo stesso comportamento in termini di latenza.
Come dovrei testare la finestra di contesto da 500K?
Utilizzate un pacchetto fisso con elementi chiave collocati all'inizio, a metà e alla fine, oltre a un conflitto intenzionale. Richiedete le posizioni delle fonti e valutate la capacità di richiamo, la gestione dei conflitti e la latenza con diverse dimensioni di input, anziché basarvi esclusivamente sul valore massimo dichiarato.
Vale la pena passare dalla versione Grok 4.6 alla Grok 4.7?
I primi risultati indicano un miglioramento significativo ma graduale: le misurazioni indipendenti mostrano un miglioramento e la sessione pratica ha dato ottimi risultati in termini di debug e sintesi del codice sorgente. Effettuate l’aggiornamento solo dopo aver verificato che le vostre attività richiedano un minore sforzo di revisione o garantiscano una maggiore precisione, a un costo specifico per il percorso che ritenete giustificabile.
Il verdetto finale
Grok 4.7 sembra un aggiornamento serio e incrementale del modello, con un obiettivo chiaro: la programmazione e il lavoro intellettuale che premiano l’impegno costante. Il comunicato ufficiale fornisce una spiegazione credibile del cambiamento, i primi dati di Artificial Analysis mostrano un miglioramento rispetto alla versione Grok 4.6 piuttosto che una regressione, e i nostri test sull’API aggiungono un segnale pratico, seppur modesto. Il modello ha gestito particolarmente bene un bug di concorrenza e un memo con fonti in conflitto; la sua risposta in termini di pianificazione è stata accurata ma non così operativa come richiesto.
Il verdetto oggettivo è ancora provvisorio. Si è trattato di tre singole esecuzioni lungo un unico percorso di test; l’attività più lenta ha richiesto lo streaming a seguito di un timeout del gateway in assenza di streaming, e non vi sono né risultati comparabili di concorrenti né un ampio consenso indipendente. Iniziate con un’attività complessa del vostro flusso di lavoro reale, confrontate i risultati e i tempi di elaborazione con quelli del modello che già utilizzate, quindi decidete se l’aggiornamento giustifica il costo specifico del percorso.









