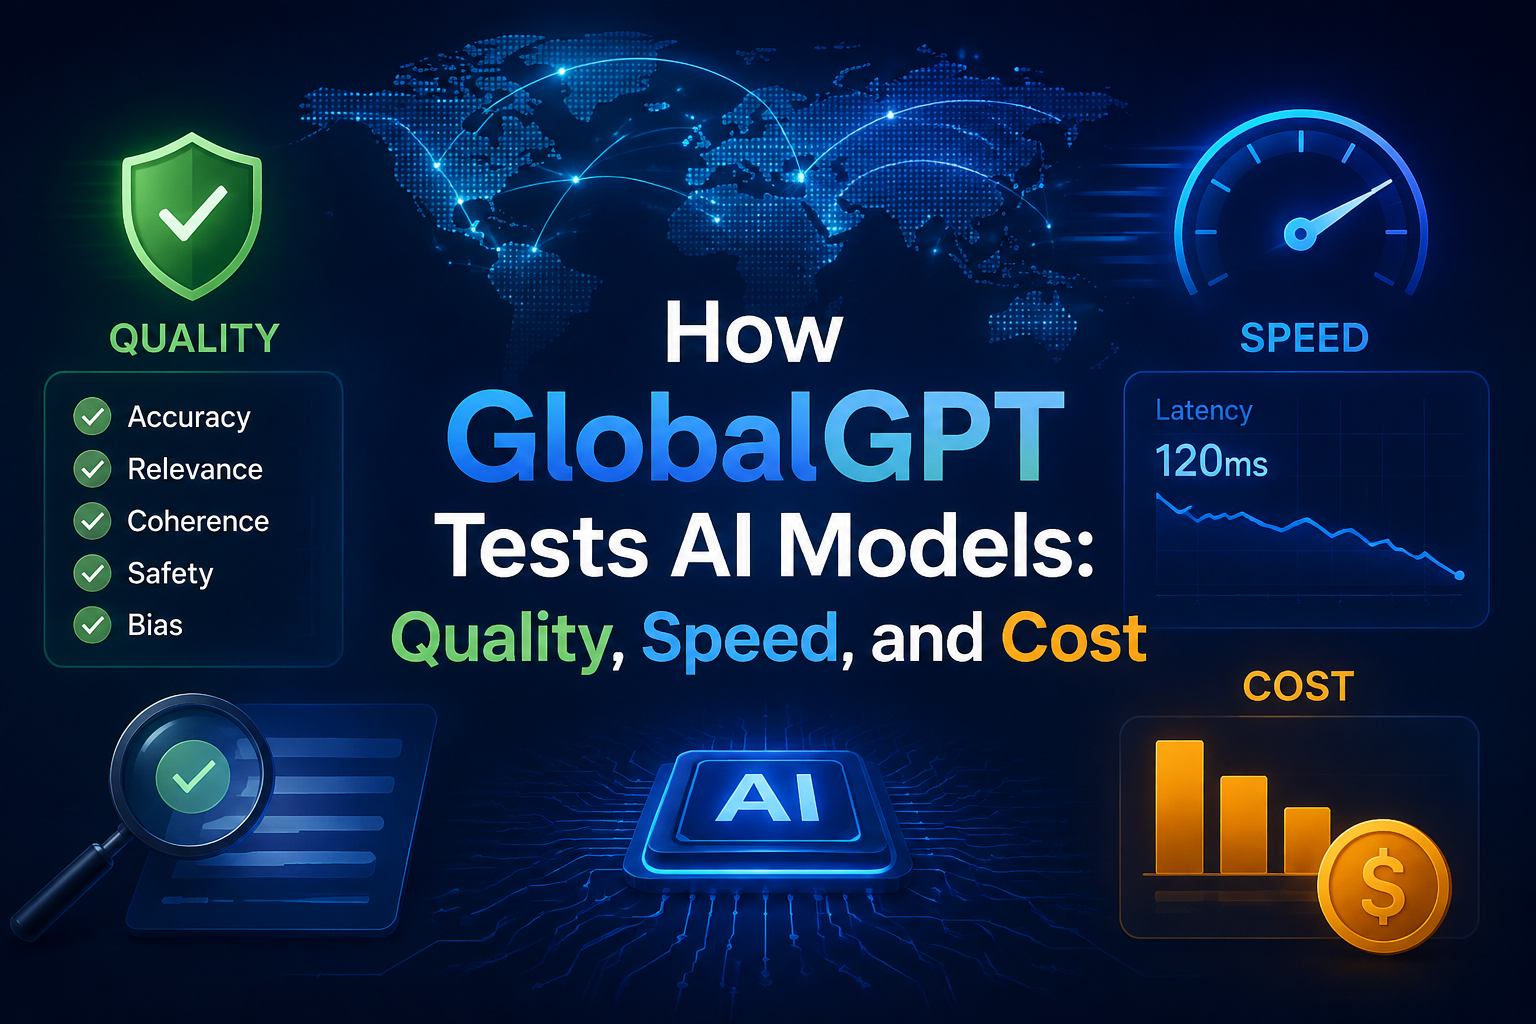
Perbandingan model dimulai dengan tugas tertentu: apa yang kita minta, dan apakah hasilnya memenuhi persyaratan? Kami menguji model AI di GlobalGPT menggunakan CLI GlobalGPT. Pengecualian dijelaskan dalam artikel terkait.
AI memeriksa hasil keluaran untuk mendeteksi kesalahan dan memastikan kepatuhan terhadap prompt. Jika hasil keluaran lolos pemeriksaan tersebut, kami membandingkan kecepatan, harga, dan penggunaan token—jika berlaku. Para penulis juga menilai aspek-aspek subjektif, seperti gaya penulisan dan daya tarik visual. Evaluasi audio dilakukan sepenuhnya oleh AI menggunakan Gemini 3.6 Flash.
Kami adalah Tim Peninjau GlobalGPT, yang merupakan bagian dari GlobalGPT. Metodologi ini mencakup pengujian yang kami publikasikan di Blog saat model-model baru diluncurkan, beserta perbandingan antar model. Laporan penelitian yang didasarkan pada data pengguna GlobalGPT menjelaskan kumpulan data dan metode analisis yang mereka gunakan.
Lingkungan Pengujian Kami: GlobalGPT CLI
CLI GlobalGPT adalah lingkungan pengujian bawaan kami. Pengujian yang menggunakan antarmuka, rute API, atau alat pemrograman native yang berbeda perlu dipahami dalam konteks tersebut. Nama model, pengaturan yang tersedia, alat, dan akses dapat berbeda-beda di setiap lingkungan.
Model yang menghasilkan keluaran dan AI yang mengevaluasinya memiliki peran yang berbeda. Penilaian dari evaluator merupakan bukti mengenai keluaran yang dihasilkan; hal itu tidak menjelaskan bagaimana model yang diuji bekerja secara internal.
Desain Tugas: Petunjuk, Masukan, dan Persyaratan
Kami memberikan tugas-tugas konkret kepada model dengan persyaratan yang jelas. Tugas menulis mungkin mengharuskan pembuatan ringkasan yang hanya didasarkan pada catatan yang disediakan. Tugas pemrograman mungkin mengharuskan pembuatan fungsi untuk menangani input kosong. Tugas terkait gambar mungkin mengharuskan penggunaan kalimat yang tepat pada sebuah poster.
Sebagai perbandingan, prompt dan materi masukan menentukan apa yang diminta untuk dilakukan oleh masing-masing model. Perbedaan dalam format yang didukung, pengaturan, atau alat yang tersedia memengaruhi cara menafsirkan hasilnya. Perbandingan prompt yang tetap dan tutorial yang menyempurnakan prompt melalui beberapa percobaan menjawab pertanyaan yang berbeda.
Evaluasi Hasil: Kesalahan, Petunjuk, dan Efisiensi
Kesalahan dan Kepatuhan yang Segera
AI mengevaluasi apakah hasil yang dihasilkan sesuai dengan tugas dan mengandung kesalahan yang dapat diidentifikasi. Pemeriksaan yang relevan dapat mencakup perhitungan yang salah, klaim yang tidak didukung, kolom yang terlewat, atau ketidakpatuhan terhadap format yang diwajibkan.
Hasil "lulus" berarti tidak ada kesalahan yang terdeteksi oleh pemeriksaan yang dilakukan. Hal ini tidak menjamin bahwa hasilnya bebas dari segala kemungkinan kesalahan. Penilai AI dapat melewatkan kesalahan atau membuat penilaian yang keliru.
Bukti pelaksanaan merupakan bagian tersendiri dari penilaian. Dalam laporan kami Uji coba rencana pemrograman Kimi, kode yang dihasilkan diikuti oleh lima pemeriksaan lokal. Membaca kode, meminta model untuk memeriksa jawabannya sendiri, dan menjalankan pengujian memberikan bukti yang berbeda-beda.
Kecepatan, Harga, dan Penggunaan Token
Setelah suatu hasil memenuhi persyaratan tugas, efisiensi membantu membedakan opsi-opsi yang bermanfaat. Jawaban cepat yang melewatkan perhitungan yang diperlukan belum menyelesaikan tugas yang sama seperti jawaban yang benar.
| Ukuran | Cara Membacanya |
|---|---|
| Waktu | Periksa jendela pengukuran. Waktu dari permintaan hingga penyelesaian mencakup rute dan proses yang terlibat; hal ini belum tentu sama dengan latensi model di sisi penyedia. |
| Penggunaan token | Gunakan kategori yang dihasilkan oleh layanan tersebut. Jika data input, output, cache, atau token penalaran tidak tersedia, hal itu tidak berarti tidak ada penggunaan sama sekali. |
| Biaya | Bedakan tagihan atau kredit GlobalGPT yang tercatat dari perkiraan yang didasarkan pada harga API penyedia layanan. Biaya langganan merupakan indikator lain. |
| Generasi media | Pertimbangkan pengaturan keluaran serta kredit yang berlaku atau biaya per keluaran. Jumlah token mungkin tidak tersedia atau tidak relevan. |
Perkiraan harga harus disertai dengan dasar perhitungan yang jelas. Kredit tidak dapat dikonversi ke dolar tanpa aturan konversi yang terverifikasi, dan kolom respons bernilai nol saja tidak cukup untuk membuktikan bahwa permintaan tersebut gratis.
Penilaian Penulis untuk Tugas-Tugas Subjektif
Para penulis juga membandingkan hasil karya ketika preferensi memengaruhi kegunaannya. Untuk tulisan atau gambar, hal itu bisa berarti menjelaskan hasil mana yang menggunakan bahasa yang lebih jelas, tata letak yang lebih mudah dibaca, atau komposisi yang lebih sesuai dengan arahan.
Kami Perbandingan Seedream 5.0 Pro vs GPT Image 2 menampilkan gambar-gambar berpasangan untuk berbagai tugas tertentu. Teks dan tata letak yang terlihat memberikan pembaca bahan untuk diperhatikan bersamaan dengan preferensi penulis. Preferensi estetika tetap berbeda dari persyaratan yang diverifikasi secara objektif.
Evaluasi Audio AI dengan Gemini 3.6 Flash
Evaluasi pendengaran audio kami sepenuhnya dilakukan oleh AI. Kami menggunakan Gemini 3.6 Flash untuk menganalisis audio yang sebenarnya. Ini adalah penilaian berbasis AI, bukan hasil dari panel pendengar manusia.
Penilaian tersebut bergantung pada tugas yang diberikan: ucapan yang diminta, bahasa, peristiwa bunyi, waktu, atau struktur musik. Kami Ulasan Seed Audio 1.0 mencakup rekaman audio yang dihasilkan serta analisis berbasis AI terhadap konten, peristiwa, waktu, dan artefak.
Sifat-sifat file seperti format dan durasi bersifat terpisah dari penilaian terhadap isi. Keberadaan trek audio tidak membuktikan bahwa kata-kata atau bunyi yang dimaksud benar. Setiap partitur yang diterbitkan harus dibaca dengan mempertimbangkan kriteria evaluasi serta rekaman audio yang dijelaskannya.
Cara Membaca Tanggal Uji, Pengaturan, dan Bukti Hasil
Artikel tersebutlah yang menjadi tempat untuk menyajikan bukti pengujian secara terperinci. Konteks yang berguna meliputi:
- Tanggal pengujian, pengenal model, dan lingkungan.
- Tugas, petunjuk, bahan masukan, dan hasil yang diharapkan.
- Pengaturan yang tersedia, jumlah upaya, dan perubahan yang terkait.
- Penilai, pemeriksaan yang dilakukan, dan alasan di balik preferensi penulis.
- Hasil aktual atau kutipan, tangkapan layar atau materi media, serta catatan terkait waktu, penggunaan, dan biaya yang tersedia.
Catatan yang tercantum bervariasi antar artikel dan tes-tes yang lebih lama. Pengukuran yang hilang tidak dapat direkonstruksi sebagai fakta yang teramati. Bagian "Blog & Panduan" pada halaman koleksi model menyertakan tautan ke ulasan-ulasan yang relevan serta metodologi ini; prompt lengkap dan bukti hasil tetap tersedia dalam artikel-artikel Blog.
Memahami Upaya Ulang, Permintaan yang Gagal, dan Revisi
Hasil pertama, hasil yang dipilih, dan upaya yang telah direvisi menyampaikan pesan yang berbeda kepada pembaca. Riwayat upaya dalam artikel tersebut sangat penting, termasuk kegagalan teknis, respons kosong, jawaban yang terpotong, serta perubahan pada prompt atau pengaturan.
Sebuah permintaan yang berhasil diselesaikan mungkin tetap menghasilkan jawaban yang tidak dapat digunakan. Sebaliknya, permintaan yang gagal mungkin mengungkap adanya masalah pada rute yang diuji tanpa menunjukkan adanya kelemahan umum pada model. Artikel-artikel kami menggunakan cakupan pengujian yang berbeda-beda; tidak ada jumlah pengulangan atau prosedur pengujian buta yang seragam di balik setiap hasil.
Apa yang Dapat dan Tidak Dapat Anda Ketahui dari Hasil Tugas
Sebuah hasil mendukung kesimpulan mengenai tugas, model, tanggal, dan lingkungan yang diuji. Kumpulan tugas yang kecil dan pengukuran waktu secara individual tidak dapat menentukan peringkat kinerja yang universal. Jika hanya satu sisi dari perbandingan yang diuji, bukti tersebut tidak dapat mendukung penentuan pemenang antara kedua model tersebut.
Spesifikasi resmi, uji perbandingan eksternal, pengujian sebelumnya, dan hasil yang diperoleh dari artikel itu sendiri memberikan berbagai jenis bukti. Setiap skor bergantung pada skala, bobot, dan pengecualian yang ditetapkan. Pembaca harus dapat mengaitkan kesimpulan dengan bukti-bukti tersebut, termasuk hasil yang parsial atau tidak berhasil.
Perbedaan Antara Pembaruan Artikel dan Pengujian Ulang Model
Kami biasanya meninjau artikel setiap dua hingga empat minggu sekali, sebagaimana dijelaskan dalam Standar Redaksi. Pemeriksaan konten tidak berarti setiap uji model telah dijalankan ulang.
Memperbarui harga, mengoreksi evaluasi terhadap hasil yang sudah ada, dan menghasilkan hasil baru adalah tindakan yang terpisah. Temuan historis tetap terikat pada konteks pengujian aslinya; tanggal pembaruan artikel yang lebih baru saja tidak menjadikan temuan tersebut sebagai hasil pengujian baru.