Ya—Grok 4.6 adalah model xAI resmi yang diluncurkan pada 12 Agustus 2026, dan model ini layak mendapat perhatian serius jika pekerjaan Anda melibatkan paket penelitian yang panjang, pemrograman, analisis bertahap, atau tugas-tugas berbasis gambar. Jendela konteks sebesar 500 ribu token dan kemampuan penalaran yang dapat dikonfigurasi membuatnya mampu menangani proyek-proyek yang menuntut, meskipun sistem ini tidak selalu menjadi pilihan tercepat atau terbaik untuk setiap prompt. Pertanyaan sesungguhnya kini bukan lagi apakah Grok 4.6 itu ada, melainkan apakah keunggulannya sesuai dengan pekerjaan yang benar-benar perlu Anda selesaikan.
Jika Anda ingin menjawab pertanyaan itu tanpa harus mengandalkan satu penyedia layanan saja untuk seluruh alur kerja Anda, GlobalGPT adalah tempat yang sangat tepat untuk memulai. Ruang kerja berbasis browser ini memungkinkan Anda menggunakan Grok 4.6 bersamaan dengan model-model terkemuka lainnya, menjalankan perintah yang sama untuk riset, penulisan, analisis, atau pemrograman, serta membandingkan hasilnya di satu tempat. Ini adalah cara praktis dan sederhana yang menyegarkan untuk melihat di mana Grok 4.6 benar-benar unggul—dan di mana model lain lebih cocok untuk tugas Anda—sebelum memilih pengaturan atau langganan yang sesuai untuk Anda.
Apa sebenarnya yang dimaksud dengan Grok 4.6?
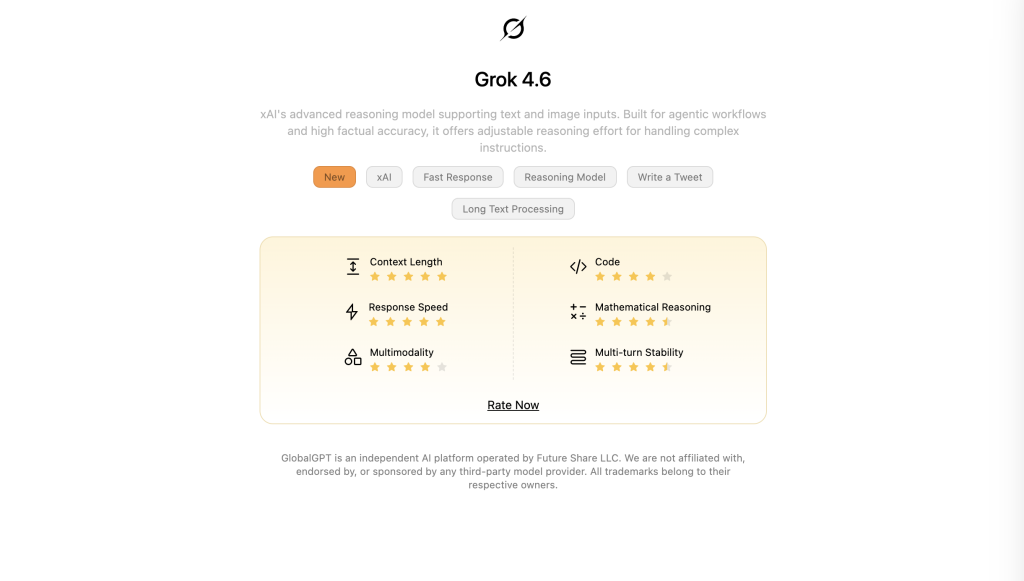
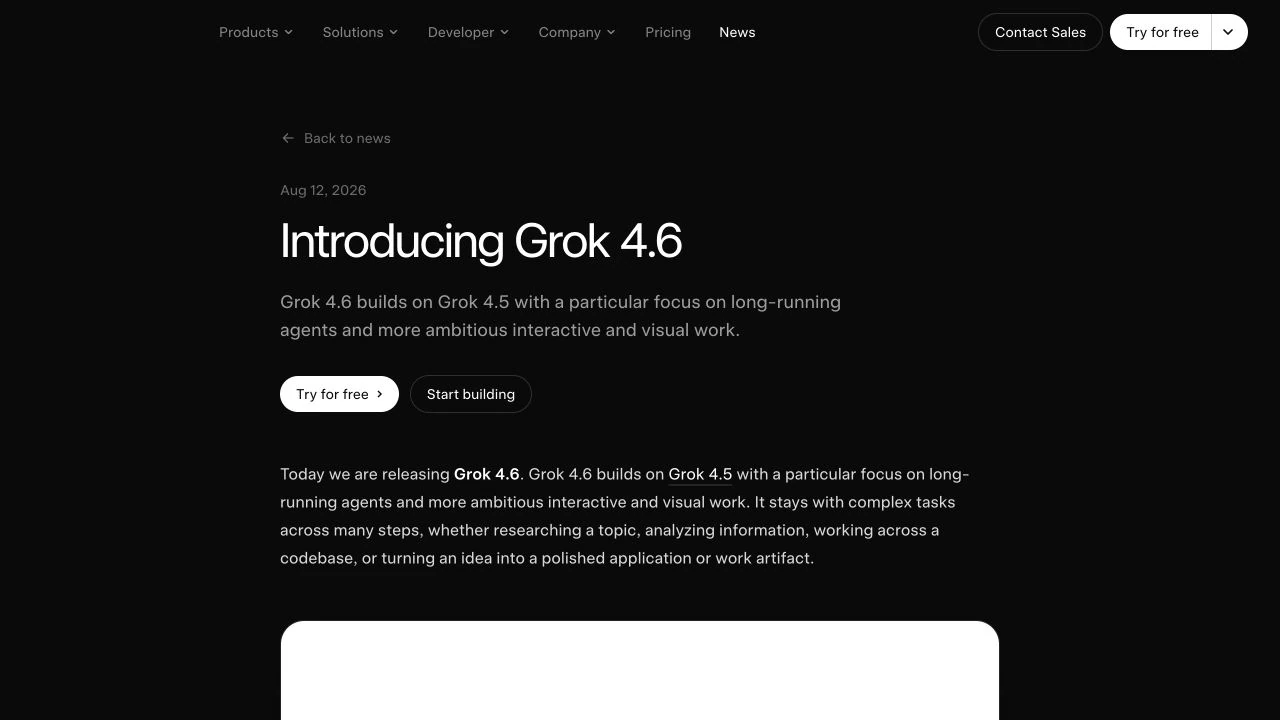
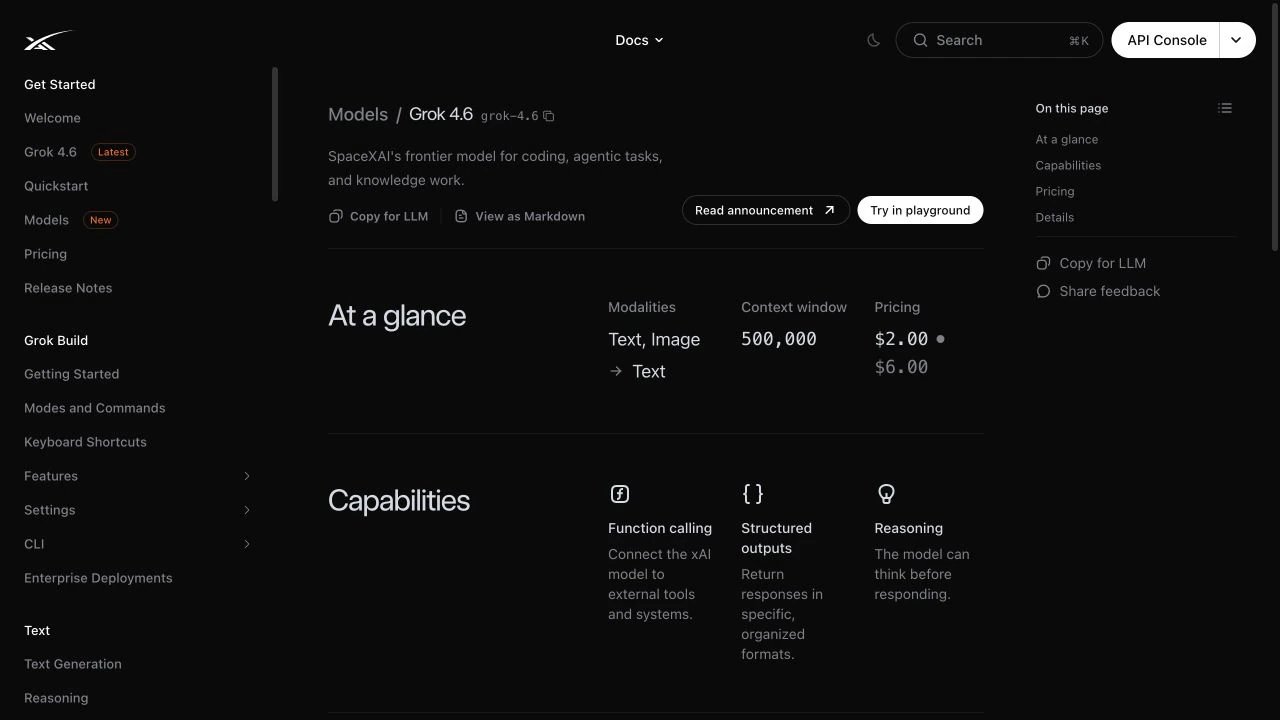
Grok 4.6 adalah model andalan xAI tahun 2026 dalam lini Grok. Halaman model resminya menjelaskan tentang masukan teks dan gambar, keluaran teks, proses penalaran yang dapat dikonfigurasi, serta jendela konteks sebesar 500 ribu token. Pengenal API-nya adalah grok-4.6; itulah nilai yang harus digunakan oleh pengembang dalam sebuah permintaan.
Bahasa rilis xAI sendiri cukup spesifik: Grok 4.6 berfokus pada agen yang telah beroperasi dalam waktu lama serta karya interaktif dan visual yang lebih ambisius. Dokumen resmi mengemukakan bahwa platform ini dirancang untuk pemrograman, tugas-tugas berbasis agen, dan pekerjaan berbasis pengetahuan, dengan fitur pemanggilan fungsi dan keluaran terstruktur untuk alur kerja yang memerlukan alat bantu atau format respons yang dapat diprediksi.
Kartu model tersebut mencantumkan batas waktu pra-pelatihan pada Januari 2026. Perbedaan ini penting. Jendela konteks sebesar 500 ribu memungkinkan Anda memberikan paket sumber yang sangat besar, tetapi hal itu tidak secara otomatis menjadikan model tersebut sebagai mesin pencari yang aktif. Untuk harga terkini, berita, atau kebijakan produk yang berubah, carilah sumbernya dan verifikasi jawabannya.
Apa saja spesifikasi resmi Grok 4.6?
| Spesifikasi | Nilai yang tercatat secara resmi | Mengapa ini penting |
|---|---|---|
| Tanggal rilis | 12 Agustus 2026 | Menegaskan bahwa ini adalah rilis resmi xAI. |
| ID model API | grok-4.6 | Gunakan slug persis seperti ini dalam permintaan API. |
| Jendela konteks | 500 ribu token | Berguna untuk laporan panjang, basis kode, dan penelitian yang sarat dengan kode sumber. |
| Masukan / keluaran | Masukan teks dan gambar; keluaran teks | Mendukung prompt multimodal, tetapi tidak mendukung pembuatan gambar. |
| Penalaran | Dapat dikonfigurasi | Memungkinkan alur kerja menyeimbangkan kecepatan dengan analisis yang lebih mendalam. |
| Pemanggilan fungsi | Didukung | Menghubungkan model dengan berbagai alat dan sistem eksternal. |
| Hasil terstruktur | Didukung | Berguna untuk JSON, ekstraksi, dan alur kerja yang terstruktur. |
| Batas kualifikasi prapelatihan | Januari 2026 | Jangan menganggap model dasar tersebut secara otomatis sudah terbaru. |
Sumber: Pengumuman xAI, dokumentasi model, dan Kartu Model Grok 4.6. Spesifikasi resmi tidak sama dengan hasil kinerja yang diperoleh secara independen.
Apa saja yang bisa dilakukan oleh Grok 4.6?
Penalaran dan analisis terstruktur
Kemampuan penalaran yang dapat dikonfigurasi menjadikan Grok 4.6 cocok untuk tugas-tugas yang membutuhkan jawaban yang disusun secara cermat: membandingkan bukti, menyusun tabel keputusan, merencanakan implementasi, atau memeriksa perhitungan yang memiliki batasan. Penalaran yang lebih mendalam tidak selalu lebih baik untuk setiap permintaan, sehingga ekstraksi dan penulisan ulang rutin sebaiknya menggunakan pengaturan yang sesuai.
Penelitian dan pekerjaan yang banyak mengandalkan sumber
Jendela konteks berukuran 500K memberikan ruang bagi model untuk menangani laporan besar, transkrip, dokumen kebijakan, dan paket sumber. Alur kerja yang paling efektif adalah pencarian menggunakan penanda lokasi eksplisit dan aturan kutipan, dilanjutkan dengan membuka sumber asli untuk verifikasi.
Pemrograman dan pemecahan masalah
Evaluasi rekayasa perangkat lunak yang telah dipublikasikan serta uji debugging sederhana kami mendukung penggunaannya untuk tinjauan kode, perbaikan bug, dan tugas-tugas agen terstruktur. Para pengembang tetap disarankan untuk menjalankan uji coba secara lokal dan meninjau patch sebelum penerapan.
Pemahaman gambar
xAI memproses masukan berupa teks dan gambar dengan menghasilkan keluaran berupa teks. Fitur ini mendukung interpretasi tangkapan layar, analisis gambar dokumen, dan jawaban atas pertanyaan visual, namun tidak boleh disamakan dengan pembuatan gambar.
Penggunaan agen dan alat yang telah berjalan lama
Inilah kemampuan yang paling erat kaitannya dengan posisi peluncuran xAI. Fitur pemanggilan fungsi memungkinkan Grok 4.6 terhubung ke alat eksternal, sementara keluaran terstruktur memudahkan hasil tersebut diteruskan ke langkah berikutnya. Kombinasi tersebut cocok untuk agen yang mengumpulkan konteks, mengolah basis kode, memanggil alat, memeriksa hasil, dan mengembalikan artefak yang sudah selesai. Model ini masih memerlukan runtime eksternal, izin, dan pemeriksaan tujuan; istilah “agentic” tidak berarti model dasarnya bertindak secara mandiri.
Karya interaktif dan visual
xAI juga menyoroti karya interaktif dan visual yang lebih ambisius. Salah satu uji coba yang masuk akal adalah ringkasan produk yang sarat dengan tangkapan layar atau laporan yang didukung grafik, di mana model harus mengaitkan bukti visual dengan rekomendasi tertulis. Periksa label, sumbu, satuan, dan detail yang terlewatkan sebelum menganggap hasilnya sebagai hasil akhir.
Apa saja perubahannya pada Grok 4.6 dibandingkan dengan model-model Grok sebelumnya?
Posisi xAI menekankan pada kemampuan penalaran yang lebih kuat, kerja agen pemrograman, dan kinerja dalam konteks yang panjang. Peningkatan praktis ini bukanlah sekadar satu fitur yang mencolok; melainkan kombinasi dari ruang kerja yang lebih luas, kemampuan penalaran yang dapat disesuaikan, serta model yang disesuaikan untuk tugas-tugas kompleks bertahap.
Hal itu masih perlu diuji dalam konteks alur kerja. Sebuah model bisa saja meraih skor tinggi dalam uji benchmark, namun tetap tidak sesuai dengan gaya penulisan, persyaratan kutipan, atau basis kode Anda. Grok 4.6 sebaiknya dievaluasi berdasarkan tugas-tugas yang Anda ulangi setiap minggu, bukan hanya berdasarkan satu angka di papan peringkat.
Bagaimana performa Grok 4.6 jika dibandingkan dalam pengujian benchmark yang diakui?
Tabel di bawah ini memisahkan hasil model-card dari xAI sendiri dengan hasil pengukuran independen. Hal ini sangat penting karena kedua angka dari Terminal-Bench tersebut merupakan versi yang berbeda dan tidak boleh disajikan sebagai perbandingan skor langsung.
| Penilai | Tugas / metrik | Hasil yang dilaporkan | Jenis bukti dan batasan |
|---|---|---|---|
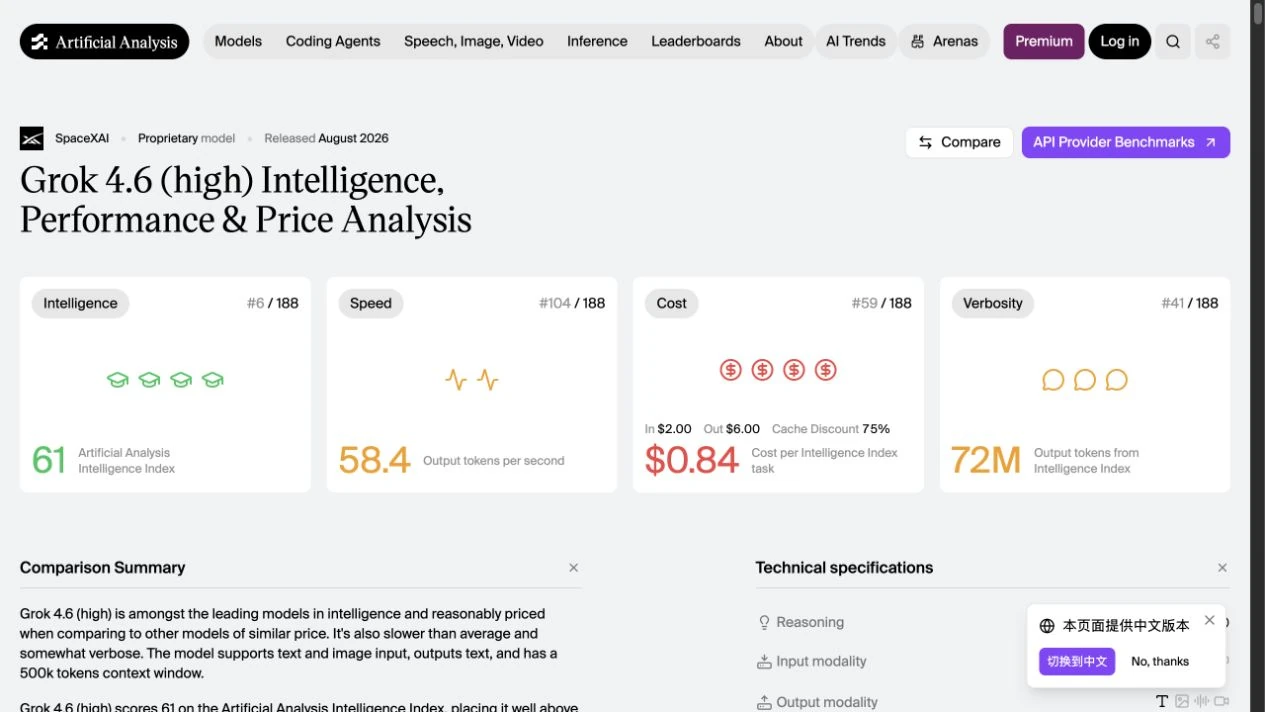
| Analisis Buatan | Indeks Kecerdasan | 61 (#6 / 188 pada saat penangkapan) | Komposit independen; gunakan metodologi dan tanggal dari AA. |
| Analisis Buatan | Kecepatan keluaran | 58,4 token per detik | Pengukuran kecepatan independen; rute dan perangkat keras memengaruhi latensi. |
| Analisis Buatan | Biaya per tugas intelijen | $0.84 | Perkiraan AA berdasarkan komposisi tugasnya sendiri; bukan faktur xAI. |
| Analisis Buatan | GDPval-AA v2 | 1753 | Evaluasi hasil kerja secara mandiri. |
| Analisis Buatan | AA-Tas Kerja | 1577 | Evaluasi gaya kerja berbasis pengetahuan yang independen. |
| Analisis Buatan | Terminal-Bench v2.1 | 88.4% | Hasil Independent v2.1; tidak dapat dibandingkan dengan Terminal-Bench 3.0. |
| Kartu Model xAI | Terminal-Bench 3.0 | 26% | Hasil resmi kartu model pada versi yang berbeda. |
| Mercor APEX-SWE | Rekayasa perangkat lunak | 56,41 TP40T ± 6,21 TP40T | 200 tugas; interval ketidakpastian harus dipertahankan. |
| Agen Mercor APEX | Tugas agen | 57,5% ± 3,5% | 33 dunia / 480 tugas; evaluasi agen tertentu. |
| Kartu Model xAI | DeepSearchQA | 81.6% | Kondisi jaminan mutu penelitian yang dilaporkan oleh vendor. |
| Kartu Model xAI | Tingkat halusinasi faktual | 1.7% | Kondisi pengujian model-kartu, bukan tingkat kesalahan universal. |
Sumber: Artificial Analysis, papan peringkat Mercor APEX, dan xAI Model Card. Jangan menggabungkan skor dari berbagai kumpulan data, versi, pengaturan tingkat kesulitan, atau penilai yang berbeda.
Apakah Grok 4.6 lebih baik daripada Grok 4.5?
Kartu model resmi memberikan jawaban yang ambigu, bukan sekadar “ya.” Grok 4.6 mencatat hasil DeepSearchQA yang jauh lebih tinggi, sementara kartu yang sama melaporkan tingkat halusinasi faktual yang lebih tinggi dibandingkan Grok 4.5. Sebuah tinjauan yang serius tidak boleh mengubah satu tolok ukur yang kuat menjadi klaim keandalan universal.
| Evaluasi resmi | Grok 4,6 | Grok 4,5 | Bagaimana cara menafsirkannya |
|---|---|---|---|
| DeepSearchQA | 81.6% | 38.4% | Terdapat peningkatan yang signifikan dalam evaluasi yang berfokus pada pencarian ini. |
| Tingkat halusinasi faktual | 1.7% | 0.98% | Semakin rendah, semakin baik; Grok 4,5 lebih baik dalam kondisi yang dilaporkan ini. |
Sumber: Kartu Model xAI Grok 4.6. Evaluasi-evaluasi ini menjawab pertanyaan-pertanyaan yang berbeda dan tidak menentukan pemenang yang mutlak.
Seberapa cepat, andal, dan mumpuni Grok 4.6 dalam penggunaan sehari-hari?
Bukti yang telah dipublikasikan menunjukkan model dengan kemampuan tinggi, namun “kinerja” terdiri dari beberapa aspek: kualitas jawaban, latensi, retensi konteks, kepatuhan terhadap instruksi, dan pemulihan dari kegagalan. Dalam pendekatan langsung kami, uji kesiapan mengembalikan status HTTP 200 dan SIAP. Hasil yang valid pertama untuk tugas-tugas lainnya berhasil dikembalikan, sementara satu permintaan pengeditan yang dibatasi menyebabkan kegagalan infrastruktur di sisi klien.
Analisis Buatan memberikan penilaian realistis yang berguna di luar kemampuan yang tertera di judul: halaman yang ditampilkan menunjukkan Indeks Kecerdasan sebesar 61, kecepatan keluaran 58,4 token per detik, dan perkiraan biaya sebesar $0,84 per tugas Kecerdasan. Kombinasi tersebut menunjukkan model yang mumpuni namun tidak super cepat—lebih cocok untuk pekerjaan yang bermakna daripada balasan satu baris yang sekadar asal-asalan.
Hasil yang beragam itu berguna. Grok 4.6 bisa sangat andal dalam pekerjaan terstruktur, tetapi pengguna di lingkungan produksi sebaiknya tetap menerapkan aturan percobaan ulang, batas waktu, dan model cadangan, alih-alih menganggap setiap rute akan berperilaku sama persis.
Di mana Grok 4.6 terlihat paling berguna?
Pekerjaan pemrograman dan pengembangan produk yang telah berlangsung lama
Contoh penerapan xAI mencakup penelitian terhadap suatu topik, analisis informasi, pengembangan berbasis kode, hingga mengubah sebuah ide menjadi aplikasi atau hasil karya yang matang. Hal ini menjadikan pekerjaan berskala fitur sebagai tolok ukur evaluasi yang lebih baik daripada prompt sederhana yang hanya memiliki satu fungsi. Berikan model tersebut tujuan yang terdefinisi dengan jelas, berkas-berkas yang relevan, serangkaian pengujian, serta definisi penyelesaian.
Sintesis penelitian dan pekerjaan berbasis pengetahuan
Jendela 500K, hasil terstruktur, dan hasil DeepSearchQA yang solid menjadikan Grok 4.6 sebagai pilihan yang tepat untuk mengubah paket sumber menjadi ringkasan, memetakan perbedaan pendapat, atau mengekstrak tabel keputusan. Uji verifikasi sumber mendukung penggunaan tersebut ketika aturan kutipan dinyatakan secara eksplisit.
Laporan berskala besar dan analisis multi-dokumen
Gunakan jendela konteks untuk laporan tahunan, transkrip, paket kebijakan, dan riwayat proyek yang, tanpa itu, akan membutuhkan pemecahan bagian yang rumit. Mintalah penanda halaman atau bagian, lalu verifikasi angka-angka penting dalam dokumen aslinya.
Analisis berbasis gambar
Masukan berupa teks dan gambar berguna untuk tangkapan layar, grafik, dan diagram. Hal ini menjadi sangat bermanfaat ketika elemen visual tersebut merupakan bagian dari tugas penalaran yang lebih luas, seperti meninjau dasbor bersamaan dengan konteks bisnis tertulis.
Alur kerja yang berorientasi pada agen dengan batas akhir yang jelas
Pemanggilan fungsi dan keluaran terstruktur mendukung alur kerja seperti menyelidiki suatu masalah, menjalankan alat, memperbarui rencana, dan menghasilkan hasil yang dapat dibaca oleh mesin. Titik awal yang paling aman adalah tugas dengan izin terbatas, kondisi penghentian yang jelas, dan pemeriksa tujuan.
| Alur kerja | Mengapa Grok 4.6 cocok | Tugas awal yang paling baik |
|---|---|---|
| Pemrograman | Posisi xAI ditambah bukti dari APEX-SWE dan CursorBench | Perubahan yang benar-benar berupa bug atau penambahan fitur, disertai dengan pengujian |
| Penelitian | Konteks 500K, keluaran terstruktur, dan DeepSearchQA | Sesi pengarahan yang didukung sumber dengan penunjuk halaman |
| Dokumen yang panjang | Jendela konteks resmi berukuran besar | Laporan tahunan atau paket kebijakan yang terdiri dari beberapa dokumen |
| Analisis visual | Masukan gambar ditambah penempatan visual xAI | Laporan yang sarat dengan grafik dan dilengkapi penjelasan tertulis |
| Agen | Pemanggilan fungsi dan keluaran terstruktur | Sebuah penyelidikan terbatas dengan pemeriksa yang jelas |
Apakah Grok 4.6 mampu menangani penelitian dan verifikasi fakta?
Dalam uji paket sumber, Grok 4.6 diminta untuk mengklasifikasikan enam klaim, hanya mengutip URL yang telah disetujui, dan menolak dua kesimpulan yang menggoda.
(1) didukung — Pengumuman xAI tertanggal 12 Agustus 2026 dan menyebutkan bahwa mereka akan merilis Grok 4.6 pada hari itu.
(2) didukung — Dokumen resmi model xAI mencantumkan ID model sebagai grok-4.6.
(3) didukung — Dokumen resmi menyebutkan jendela konteks sebesar 500 ribu.
(5) bertentangan — Itu adalah versi Terminal-Bench yang berbeda dan bukan metrik yang sama.
(6) bertentangan — Halaman tersebut hanya menampilkan entri ruang kerja, bukan penyertaan dalam setiap paket.
Tampilkan hasil lengkap Grok 4,6
| Klaim | Kesimpulan | Jawaban satu kalimat | URL sumber | Batasan tepat |
|---|---|---|---|---|
| (1) xAI mengumumkan Grok 4.6 pada 12 Agustus 2026 | didukung | Pengumuman xAI bertanggal 12 Agustus 2026 dan menyatakan bahwa mereka akan merilis Grok 4.6 pada hari itu. | https://x.ai/news/grok-4-6 | Paket tersebut hanya mengutip tanggal dan baris rilis, bukan postingan lengkapnya. |
| (2) ID model API resmi adalah grok-4.6 | didukung | Dokumen model resmi xAI mencantumkan ID model sebagai grok-4.6. | https://docs.x.ai/developers/models/grok-4.6 | Ringkasan Packet tidak mencantumkan alias atau ID lainnya. |
| (3) jendela konteks resmi adalah 500 ribu token | didukung | Dokumen resmi menyatakan jendela konteks sebesar 500 ribu token. | https://docs.x.ai/developers/models/grok-4.6 | Paket menyebutkan “konteks 500 ribu,” bukan kutipan eksplisit “token.” |
| (4) Artificial Analysis secara independen mengukur Intelligence 61 | didukung | AA menerbitkan Indeks Intelligence sebesar 61 untuk Grok 4.6. | https://artificialanalysis.ai/models/grok-4-6 | Packet melaporkan skor AA, bukan audit terpisah terhadap metode AA. |
| (5) Terminal-Bench 3.0 26% dan v2.1 88,4% dapat dibandingkan secara langsung | bertentangan | Itu adalah versi Terminal-Bench yang berbeda dan bukan metrik yang sama. | https://artificialanalysis.ai/models/grok-4-6 ; https://media.x.ai/v1/website/card-4p6-4cd2dc57.pdf | Packet memberikan kedua skor tersebut tanpa kesetaraan atau tabel konversi. |
| (6) halaman GlobalGPT Grok 4,6 membuktikan bahwa setiap paket mencakup model tersebut | bertentangan | Halaman tersebut hanya menampilkan entri ruang kerja, bukan pencantuman dalam setiap paket. | https://www.glbgpt.com/home/grok-4-6 | Paket itu sendiri menyatakan bahwa ini adalah entri antarmuka, bukan setiap rencana. |
Kesimpulan ulasan: Model tersebut mampu mengikuti batasan bukti dengan baik ketika paket sumber dan format jawabannya dinyatakan secara eksplisit. Hal itu berguna untuk alur kerja penelitian, namun jawaban model tersebut tetap hanya merupakan alat bantu penelitian—bukan bukti eksternal itu sendiri.
Tampilkan petunjuk soal yang tepat
Gunakan hanya paket sumber yang terlampir. Untuk masing-masing dari enam klaim, berikan jawaban berupa “didukung”, “bertentangan”, atau “belum terbukti”, disertai satu kalimat penjelasan, URL sumber, dan batasan yang tepat.
Apakah Grok 4.6 cocok untuk pemrograman dan debugging?
Tugas JavaScript tersebut mensyaratkan perbedaan minimal, pengurutan numerik, penanganan median ganjil/genap yang benar, sifat tidak dapat diubah (immutability), dan dua kondisi kesalahan yang tepat.
```diff
--- a/median.js
+++ b/median.js
@@ -1 +1,12 @@
-function median(values) { values.sort(); return values[Math.floor(values.length / 2)]; }
+function median(values) {
+  if (!Array.isArray(values)) throw new TypeError();
+  if (values.length === 0) throw new Error("empty input");
+  const sorted = values.slice().sort((a, b) => a - b);
+  const mid = Math.floor(sorted.length / 2);
+  if (sorted.length % 2 === 0) {
+    return (sorted[mid - 1] + sorted[mid]) / 2;
+  }
+  return sorted[mid];
+}Tampilkan penjelasan yang dikembalikan oleh Grok 4.6
Fungsi aslinya melakukan mutasi terhadap argumennya dan menggunakan metode sort() leksikografis bawaan, sehingga dibuat salinan menggunakan slice() dan diurutkan secara numerik melalui (a, b) => a - b. Setelah menyaring elemen yang bukan array dengan TypeError dan array kosong dengan Error("input kosong"), hasil dengan panjang ganjil adalah elemen tengah tunggal, sedangkan hasil dengan panjang genap adalah rata-rata dari dua nilai tengah, yang merupakan median konvensional.Penggunaan terbaik: pembetulan kode skala kecil hingga menengah, penulisan tes, tinjauan kode, dan penjelasan mengenai fungsi yang belum dikenal. Untuk repositori berskala besar, padukan model tersebut dengan alat pelaksana tes Anda sendiri dan tinjau perbedaan (diff) sebelum melakukan penggabungan.
Tampilkan cakupan pengujian
Perbaiki nilai median(values) tanpa mengubah tanda fungsinya. Jangan mengubah data masukan; lemparkan TypeError untuk tipe data non-array dan Error("masukan kosong") untuk array kosong; kembalikan perbedaan terpadu minimal.Apakah jendela konteks 500K membantu saat menangani dokumen yang panjang?
Sebuah prosedur pengambilan lebih dari 220 ribu token meminta tujuh kolom, penunjuk bagian/halaman, serta penjelasan mengenai dua versi Terminal-Bench.
{
  "release_date": {"value": "12 Agustus 2026", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "locator": "p.2"},
  "jendela_konteks": {"nilai": "500 ribu token", "penunjuk": "p.2"},
  "long_context_input_price": {"value": "$4 per juta token (prompt lebih dari 200 ribu token)", "locator": "p.3"},
  "terminal_bench_version": ["3.0", "v2.1"],
  "terminal_bench_score": ["26%", "88.4%"]
}Tampilkan hasil JSON lengkap Grok 4.6
{
  "release_date": {"value": "12 Agustus 2026", "section": "rilis xAI", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "section": "Model API", "locator": "p.2"},
  "jendela_konteks": {"nilai": "500 ribu token", "bagian": "Model API", "penunjuk": "hal. 2"},
  "harga_input_konteks_panjang": {"nilai": "$4 per juta token (prompt lebih dari 200 ribu token)", "bagian": "penetapan harga", "penunjuk": "hal. 3"},
  "terminal_bench_version": [{"value": "3.0", "section": "kartu tolok ukur", "locator": "p.4"},{"value": "v2.1", "section": "tolok ukur independen", "locator": "p.5"}],
  "terminal_bench_score": [{"value": "26%", "section": "kartu tolok ukur", "locator": "hal. 4"},{"value": "88.4%", "section": "independent benchmark", "locator": "p.5"}],
  "evidence_limits": {"value": "Kedua hasil Terminal-Bench tersebut tidak dapat dibandingkan karena merupakan versi benchmark yang berbeda. Ketersediaan real-time tidak disebutkan.", "section": "pengujian independen", "locator": "hal. 5"}
}
Hal ini membuktikan bahwa: Model tersebut mampu mengekstrak dan menyusun informasi dari paket data yang besar dan berisik sesuai dengan skema yang ketat. Hal-hal yang tidak dibuktikan olehnya: bahwa setiap permintaan sebesar 500 ribu token akan memiliki kecepatan, biaya, atau akurasi yang sama pada dokumen pelanggan mana pun.
Apakah Grok 4.6 mampu mengikuti instruksi yang ketat dan berpikir secara transparan?
Untuk teka-teki alokasi dengan batasan, sistem tersebut menghasilkan satu-satunya solusi: Penelitian 7 jam, Pemrograman 9 jam, dan Pengujian Kualitas (QA) 8 jam.
{"R":7,"C":9,"Q":8,"total":24,"check":"Nilai-nilai tersebut memenuhi persamaan R+C+Q=24 dengan C=R+2 dan Q=R+1."}Tampilkan prompt yang tepat
Alokasikan 24 jam untuk Penelitian (R), Pemrograman (C), dan Jaminan Kualitas (Q). Kembalikan hanya JSON dengan kunci integer R, C, Q, total, dan satu kalimat verifikasi. Batasan: R + C + Q = 24; C = R + 2; Q = R + 1. Jangan sertakan alur pemikiran tersembunyi.
Tugas penulisan ulang dengan batasan terpisah tidak menghasilkan respons API pada dua upaya yang dilakukan klien. Hal tersebut dicatat sebagai anomali infrastruktur, bukan skor kualitas. Pelajaran praktisnya adalah untuk selalu menyiapkan jalur cadangan dalam proses produksi editorial.
Berapa harga Grok 4.6?
| Opsi | Harga yang berlaku saat ini | Terbaik untuk | Batas yang penting |
|---|---|---|---|
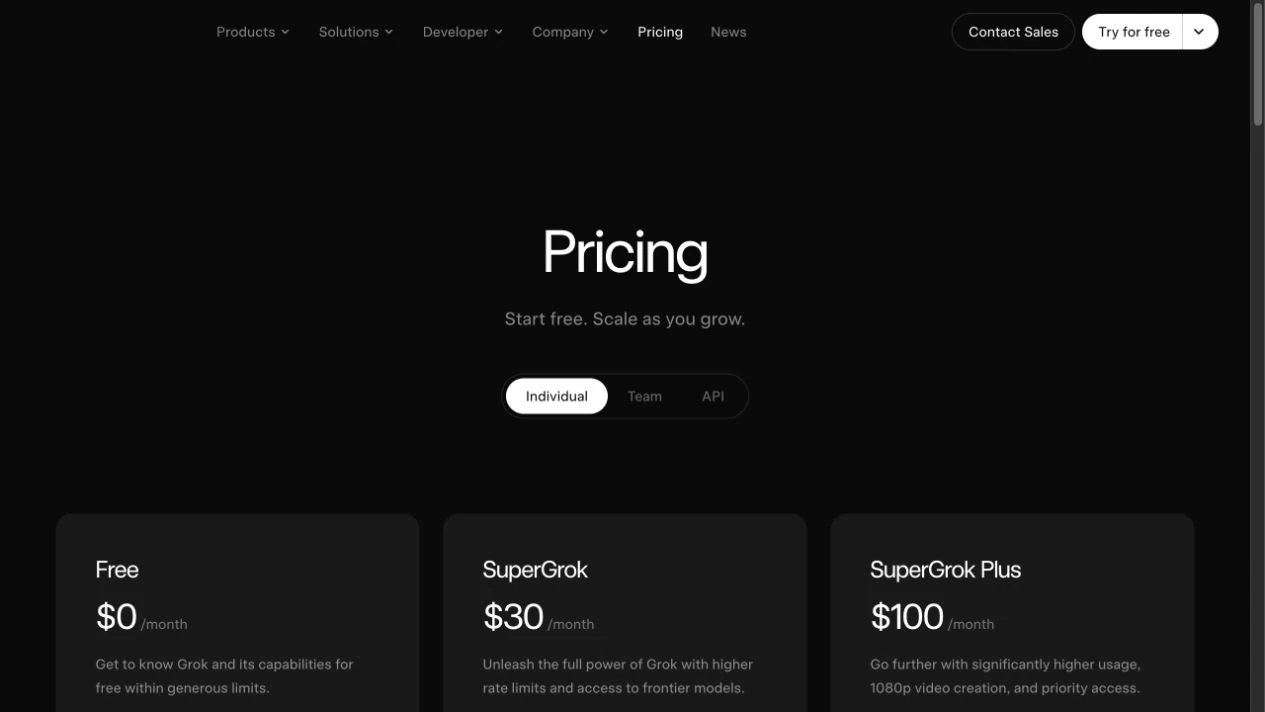
| xAI untuk Konsumen Gratis | $0 per bulan | Mencoba pengalaman pengguna asli. | Akses dan batasan pada model paket gratis dapat berubah. |
| SuperGrok | $30 per bulan | Penggunaan konsumen biasa; halaman ini mencantumkan Grok 4.6. | Pastikan hak akses saat ini sebelum mempublikasikan. |
| SuperGrok Plus | $100/bulan | Penggunaan yang sangat intensif oleh konsumen; halaman ini mencantumkan Grok 4.6. | Jangan mengasumsikan adanya akses untuk paket lain. |
| Tingkat Dasar API xAI | Masukan $2/M; keluaran $6/M; masukan yang disimpan dalam cache $0.50/M | Pengembang yang membangun integrasi berbasis penggunaan. | Biaya alat akan ditagihkan secara terpisah jika berlaku. |
| Tingkat konteks panjang API xAI | Di atas 200K: masukan $4/M; $1/M disimpan dalam cache; keluaran $12/M | Prompt dan dokumen yang sangat besar. | Jangan gunakan harga dasar untuk permintaan yang nilainya lebih dari 200 ribu. |
| GlobalGPT | Lihat rencana GlobalGPT terkini | Membandingkan Grok dengan beberapa model terkemuka dalam satu ruang kerja. | Jangan berasumsi bahwa setiap paket mencakup Grok 4.6; periksa halaman paketnya. |
Berapa biaya permintaan API Grok 4.6?
| Contoh permintaan | Perhitungan | Perkiraan biaya model per token |
|---|---|---|
| Masukan 50K + keluaran 5K | 50.000 × $2/M + 5.000 × $6/M | $0.13 |
| 100 ribu masukan + 10 ribu keluaran | 100.000 × $2/M + 10.000 × $6/M | $0.26 |
| Masukan 250K + keluaran 10K | 250.000 × $4/M + 10.000 × $12/M | $1.12 |
| Masukan 400K + keluaran 20K | 400.000 × $4/M + 20.000 × $12/M | $1.84 |
Contoh perhitungan menggunakan harga katalog xAI. Harga tersebut belum termasuk diskon input yang disimpan dalam cache, pajak, biaya pemanggilan alat, dan mark-up dari penyedia pihak ketiga.
GlobalGPT sangat cocok digunakan ketika pertimbangan Anda adalah “model mana yang paling cocok untuk tugas ini?” daripada “bagaimana cara mengintegrasikan setiap tugas ke dalam satu API?” Anda dapat membandingkan prompt untuk menulis, riset, pemrograman, dan analisis dalam satu ruang kerja, lalu menggunakan Halaman harga GlobalGPT untuk memilih paket langganan yang sesuai dengan pola penggunaan Anda. Ini adalah rekomendasi paket langganan dengan berbagai opsi, bukan konversi kredit GlobalGPT ke harga token xAI.
Bagaimana cara mengakses Grok 4.6?
Konsumen dapat memulai dengan opsi langganan Grok xAI yang tersedia saat ini. Para pengembang disarankan untuk menggunakan dokumentasi API resmi xAI dan ID model yang tepat grok-4.6. Pembaca yang ingin membandingkan model tanpa perlu membuat beberapa akun API dapat menggunakan entri ruang kerja Grok 4.6 yang telah diverifikasi di GlobalGPT; akses antarmuka pengguna (UI) platform tidak boleh disamakan dengan setiap fitur bawaan xAI.
Apa saja keterbatasan utama Grok 4.6?
- Informasi terkini tersebut masih memerlukan bukti: Batas waktu prapelatihan pada Januari 2026 bukanlah jaminan atas pengetahuan praktis.
- Judul berita perbandingan bisa menyesatkan: Versi, penilai, upaya penalaran, dan kumpulan data harus selalu disertakan pada setiap skor.
- Konteks yang panjang biayanya lebih mahal: Perintah yang memiliki lebih dari 200 ribu token menggunakan tingkatan API konteks panjang yang lebih tinggi.
- Keandalan rute bervariasi: Permintaan pengeditan dengan batasan yang kami ajukan mengalami kegagalan infrastruktur, meskipun tugas-tugas lainnya berhasil.
- Akses ke platform tidak sama: Entri ruang kerja GlobalGPT tidak mencakup semua fitur xAI bawaan atau semua hak langganan.
Apakah sebaiknya Anda memilih Grok 4.6 atau model AI lainnya?
Pilih Grok 4.6 jika konteks yang panjang, pemrograman, dan penalaran terstruktur menjadi inti dari pekerjaan tersebut. Pilih model lain jika prioritas utama Anda adalah ekosistem alat tertentu, biaya yang lebih rendah dan dapat diprediksi, keluaran multimodal tertentu, atau alur kerja yang sudah didukung dengan baik oleh tim Anda. Perbandingan yang paling adil adalah menggunakan prompt yang sama, paket sumber yang sama, dan pemeriksa yang sama di seluruh model—sesuatu yang mudah diatur dengan GlobalGPT.
Siapa yang sebaiknya menggunakan Grok 4.6?
- Para peneliti dan analis: paket sumber, tabel bukti, dan berkas berkas yang tebal.
- Pengembang: debugging, tinjauan kode, dan rencana implementasi terstruktur.
- Pencipta dan editor: penulisan artikel panjang jika Anda memberikan arahan yang jelas dan panduan gaya.
- Tim-tim yang membandingkan model: penilaian berulang dengan prompt yang sama dalam satu ruang kerja.
Apa saja pertanyaan yang biasanya diajukan pembaca mengenai Grok 4.6?
Apakah Grok 4.6 sudah dirilis secara resmi?
Ya. Pengumuman peluncuran xAI tertanggal 12 Agustus 2026.
Apa ID model API resminya?
grok-4.6.
Apa itu jendela konteks?
xAI mencatat jendela konteks sebesar 500 ribu token.
Apakah Grok 4.6 mendukung gambar?
Ya. Dokumentasi resmi model tersebut mencantumkan masukan berupa gambar dan keluaran berupa teks.
Berapa harga Grok 4,6?
Halaman konsumen saat ini menampilkan paket Free seharga $0 per bulan, SuperGrok seharga $30 per bulan, dan SuperGrok Plus seharga $100 per bulan. Penetapan harga API didasarkan pada penggunaan dan memiliki tingkatan konteks panjang terpisah di atas 200 ribu token.
Apakah Grok 4.6 lebih baik daripada Grok 4.5?
Sistem ini lebih baru dan menunjukkan kinerja yang sangat baik dalam beberapa evaluasi yang disebutkan, namun tugas-tugas dan versi benchmark-nya berbeda. Uji alur kerja rutin Anda sendiri.
Apakah saya bisa menggunakan Grok 4,6 pada GlobalGPT?
GlobalGPT memiliki entri ruang kerja Grok 4.6 yang telah dirender. Periksa kuota paket saat ini di halaman harga.
Apakah Grok 4.6 dapat diandalkan untuk penelitian?
Hasilnya memuaskan dalam uji paket sumber yang dibatasi, namun klaim-klaim penting harus selalu diverifikasi dengan mengacu pada sumber yang dikutip.
Apakah Grok 4.6 layak digunakan pada tahun 2026?
Grok 4.6 adalah model yang kredibel dan telah dirilis secara resmi, dilengkapi dengan jendela konteks 500K yang berguna, kemampuan penalaran yang dapat dikonfigurasi, bukti benchmark yang kuat dan telah dipublikasikan, serta hasil putaran pertama yang baik pada tugas-tugas penelitian terstruktur dan dokumen panjang. Kelemahannya juga bersifat praktis: angka-angka benchmark memerlukan label versi yang cermat, fakta-fakta terkini masih memerlukan sumber, dan keandalan rute dapat bervariasi.
Untuk akses konsumen secara langsung atau pengembangan API, mulailah dengan dokumentasi xAI saat ini. Untuk alur kerja berbasis perbandingan, coba Grok 4,6 di GlobalGPT bersama dengan model-model terkemuka lainnya, silakan pilih paket yang sesuai dengan beban kerja Anda dalam hal penulisan, penelitian, analisis, atau pemrograman.
Sumber primer: Peluncuran xAI, Dokumentasi model xAI, Harga API xAI, Harga xAI untuk konsumen, Analisis Buatan, Mercor APEX-SWE dan Kartu Model xAI.