La page API actuelle de OpenAI indique que, pour un contexte court, GPT-5.6 Sol correspond à $4 par million de jetons d'entrée et à $20 par million de jetons de sortie. Les taux de contexte long sont de $8/M en entrée et de $30/M en sortie. Les entrées mises en cache sont de $0,40/M pour le contexte court ou de $0,80/M pour le contexte long, et les écritures dans le cache sont respectivement de $5/M ou de $10/M.
Cette même page indique, à titre d’aperçu, que le forfait « GPT-5.6 Cyber » propose un débit de $12,50/M et un débit sortant de $75/M. La rubrique « OpenAI » précise que le tarif promotionnel du forfait « GPT-5.6 Sol » est valable au moins jusqu’au 21 novembre 2026. Il s'agit là des tarifs API ; un forfait ChatGPT ou un crédit Codex constituent un achat distinct.
Pour un travail interactif alliant modélisation, programmation et fonctions créatives, GlobalGPT vous offre un espace de travail par abonnement dédié à cette tâche. La question qui se pose est de savoir si vous avez besoin d'un appel de production facturé à l'utilisation, d'un workflow de développement ou d'un environnement moins coûteux pour tester et finaliser votre travail avant de vous engager sur un budget API.
- Aperçu des tarifs GPT-5.6
- Tarifs GPT-5.6 Sol et Cyber API
- Estimations des jetons GPT-5.6 traitées
- Données mises en cache et contexte étendu
- Les forfaits ChatGPT et les crédits Codex ne relèvent pas de la tarification API
- Choix d'une API, d'une interface en ligne de commande (CLI) ou d'un espace de travail multimodèle
- L'accès au plan ChatGPT relève d'un budget distinct
- Choisissez l'itinéraire type pour réaliser cette tâche
- Un test reproductible d'utilisation des jetons
- Quand une mise à niveau justifie une dépense supplémentaire liée à l'API
- De l'appel d'API au workflow complet du développeur
- FAQ
Aperçu des tarifs GPT-5.6
| Modèle / mode | Entrée courte | Sortie courte | Entrée longue | Sortie longue |
|---|---|---|---|---|
| GPT-5.6 Sol | $4.00/M | $20,00/M | $8.00/M | $30,00/M |
| GPT-5.6 Cyber | $12,50/M | $75,00/M | - | - |
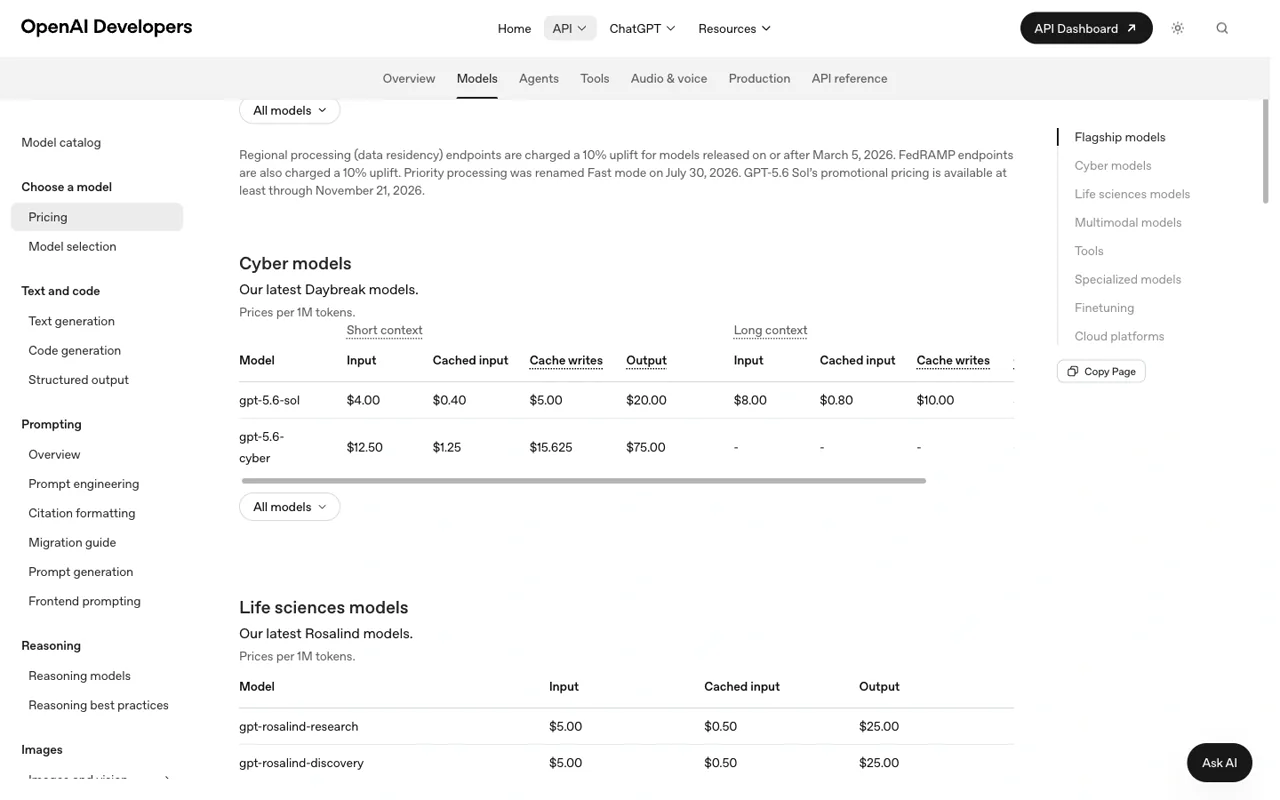
Consultez la grille tarifaire par unité de facturation : les entrées, les entrées mises en cache, les écritures en cache et les sorties constituent des lignes distinctes, tandis que les requêtes à contexte long relèvent d'un niveau tarifaire différent.
Les entrées en cache et les écritures en cache ont chacune leur propre débit. La page de l’API de OpenAI distingue également les colonnes « Standard », « Batch » et « Flex » ; choisissez un mode que votre application peut réellement utiliser avant d’appliquer une remise à une prévision.
Tarifs GPT-5.6 Sol et Cyber API
| Taux par million de jetons | GPT-5.6 Position courte sur Sol | GPT-5.6 Position longue sur Sol | GPT-5.6 Cyber court |
|---|---|---|---|
| Entrée | $4.00 | $8.00 | $12.50 |
| Entrée mise en cache | $0.40 | $0.80 | $1.25 |
| Écritures dans le cache | $5.00 | $10.00 | $15.625 |
| Sortie | $20.00 | $30.00 | $75.00 |
GPT-5.6 Cyber est conçu comme un modèle dédié à la cybersécurité plutôt que comme un simple substitut général à Sol. Utilisez-le lorsque la tâche tire spécifiquement parti de cette approche ; ne vous contentez pas de comparer le prix final pour en conclure qu'il s'agit d'une mise à niveau universelle.
Estimations des jetons GPT-5.6 traitées
Utilisez le nombre de jetons divisé par 1 000 000, multiplié par le taux applicable. Ces exemples utilisent le contexte court « GPT-5.6 Sol » et ne tiennent pas compte des taxes, des frais d'outillage, des différences entre les formules « Batch » et « Flex », ni des frais liés au forfait.
| Scénario | Entrée | Sortie | Devis |
|---|---|---|---|
| Petite modification | 20 000 × $4/M = $0,08 | 3 000 × $20/M = $0,06 | $0.14 |
| Examen du code | 250 000 × $8/M = $2,00 (long) | 20 000 × $30/M = $0,60 | $2.60 |
| Lot important à contexte court | 1M × $4/M = $4,00 | 100 000 × $20/M = $2,00 | $6.00 |
coût estimé de l'API = jetons d'entrée / 1 000 000 × tarif d'entrée + données mises en cache / 1 000 000 × tarif des données mises en cache + jetons de sortie / 1 000 000 × tarif de sortie + frais liés aux outils
Données mises en cache et contexte étendu
La mise en cache des entrées s'avère utile lorsqu'un préfixe récurrent — tel qu'un identifiant système ou un contexte de référentiel — remplit les conditions requises pour être mis en cache. Elle ne rend toutefois pas toutes les invites récurrentes peu coûteuses. Utilisez les données de facturation relatives à l'utilisation pour vérifier les accès au cache et ajoutez les coûts liés à l'écriture dans le cache ou au stockage lorsque le fournisseur les mentionne.
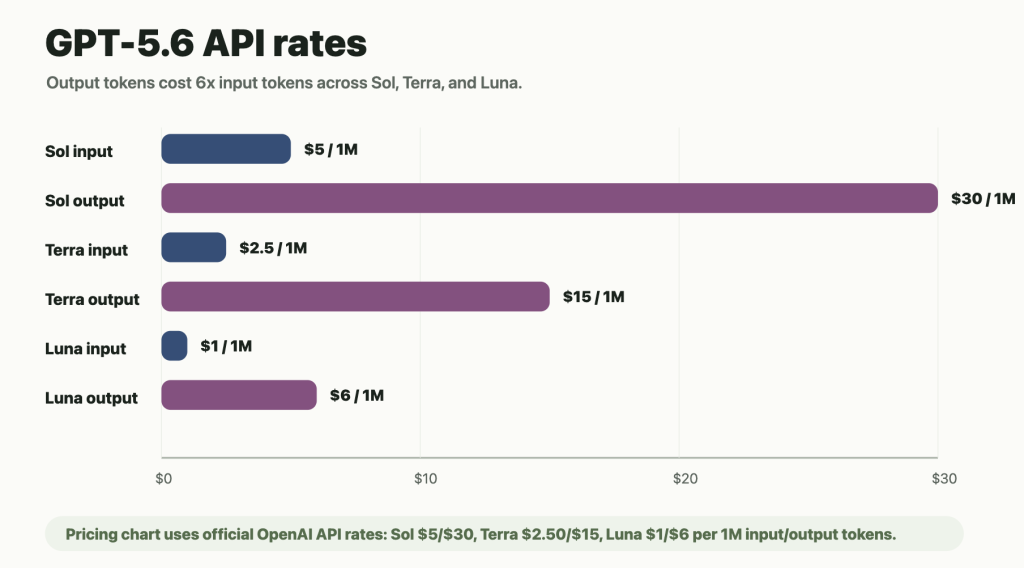
Le contexte long modifie également le niveau tarifaire. Si la demande dépasse la limite du contexte long du fournisseur, utilisez les prix d'entrée et de sortie du contexte long pour cette demande plutôt que d'appliquer le tarif du contexte court à l'ensemble de la facture.
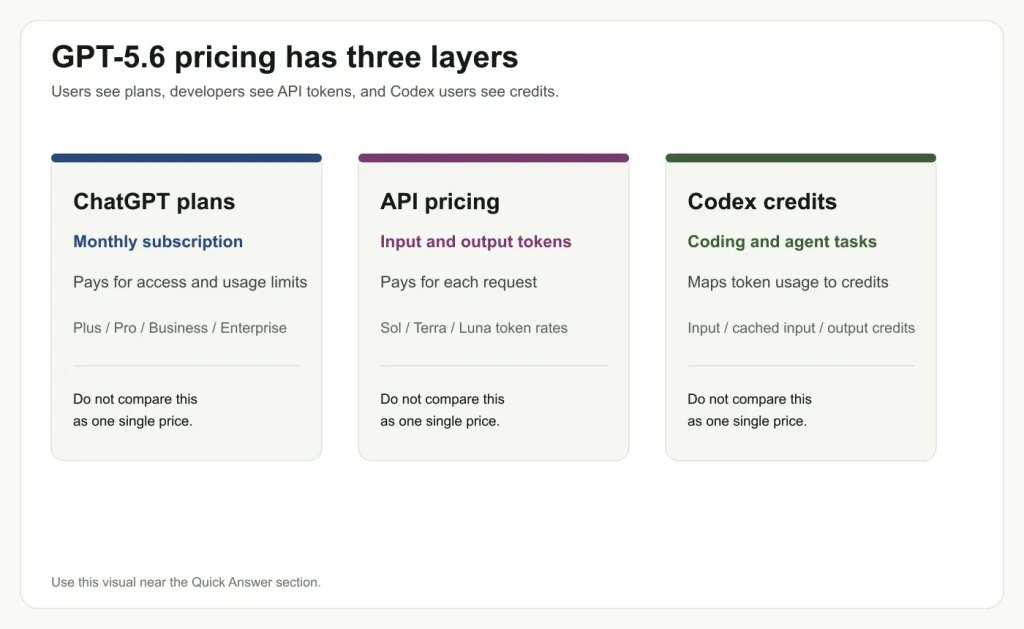
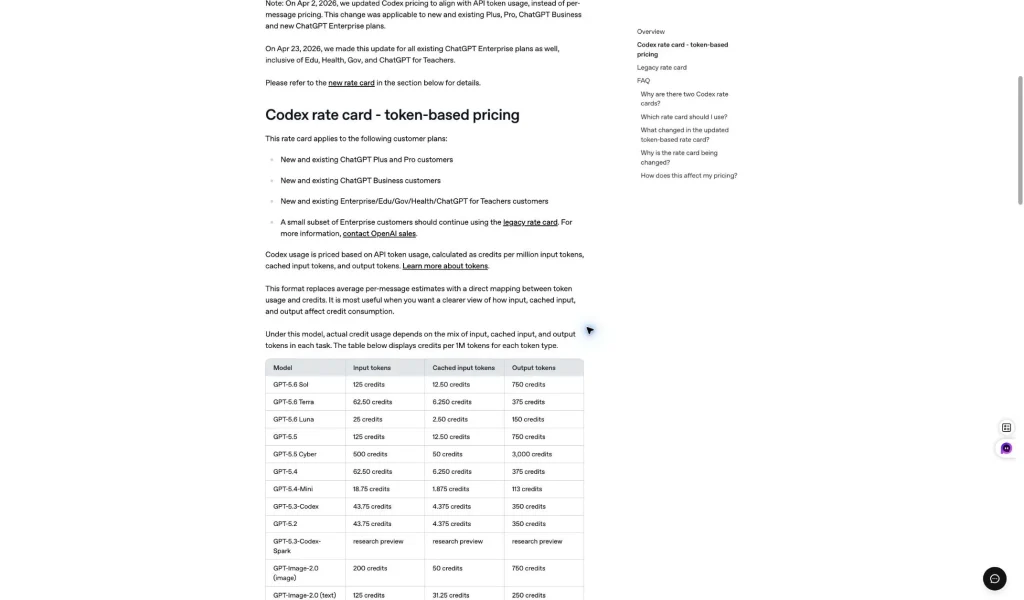
Les forfaits ChatGPT et les crédits Codex ne relèvent pas de la tarification API
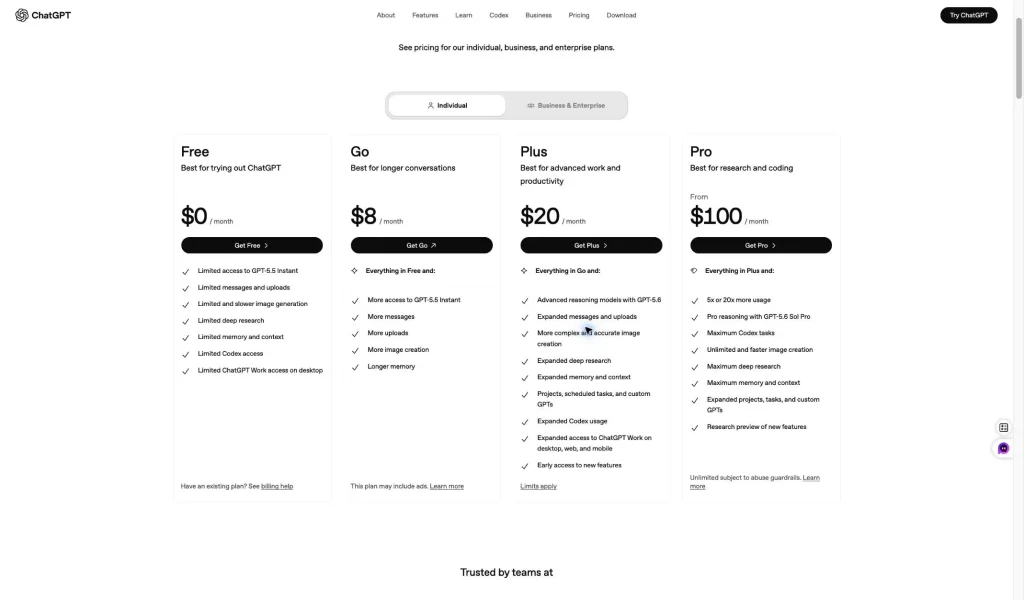
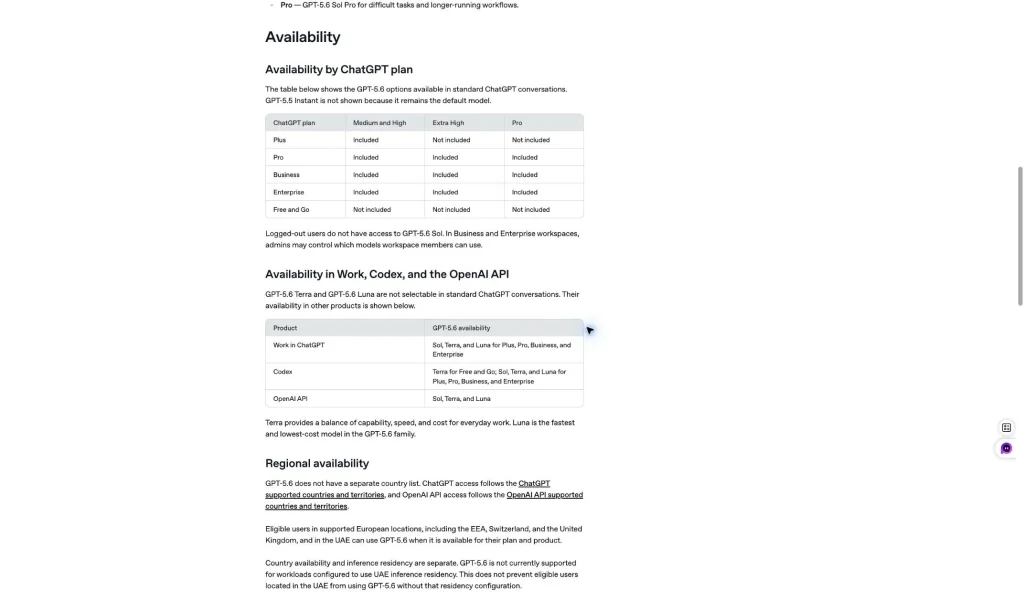
Les abonnements ChatGPT regroupent l'accès aux applications et aux fonctionnalités. Les crédits Codex correspondent à l'utilisation au sein d'une interface produit. Les appels API sont facturés au titre d'un projet de développeur. Veillez à bien distinguer ces trois budgets lorsque vous comparez les “ tarifs GPT-5.6 ”.”
Choix d'une API, d'une interface en ligne de commande (CLI) ou d'un espace de travail multimodèle

Utilisez l'API pour gérer le trafic de production de manière programmable et pour la comptabilisation au niveau des jetons. Utilisez l'interface en ligne de commande (CLI) lorsque le modèle doit être associé à un terminal et à un référentiel. Utilisez MCP lorsque le flux de travail repose sur des outils approuvés. Utilisez un agent Yukie lorsque la tâche englobe la planification, l'utilisation d'outils et les transferts de tâches.
GlobalGPT convient à la couche de comparaison interactive et de diffusion : testez différents modèles, passez à la phase de codage ou à d’autres fonctionnalités d’IA, et séparez la décision d’abonnement de la facture de l’API de OpenAI. Le coût global réduit du flux de travail constitue un argument de vente, et non une affirmation selon laquelle cela modifierait les tarifs de OpenAI.
L'accès au plan ChatGPT relève d'un budget distinct
Un abonnement ChatGPT donne accès à une interface produit. L'API facture un projet de développement par jeton, et les crédits Codex correspondent à l'utilisation au sein d'un workflow produit. Ces comptes peuvent être associés à la même famille de modèles tout en correspondant à des achats distincts.
| Itinéraire | Ce pour quoi vous payez | La meilleure question à poser |
|---|---|---|
| Plan ChatGPT | Accès à l'application interactive et fonctionnalités de l'abonnement | Ce forfait inclut-il le modèle et les outils dont j'ai besoin ? |
| API OpenAI | Entrées, entrées mises en cache, écritures dans le cache, sorties et frais d'outillage | Quel sera le coût de cette charge de travail compte tenu du volume réel de jetons ? |
| Générique de Codex | Utilisation à l'intérieur de la surface du produit Codex | Quelle part du travail lié au dépôt de code ou au développement le budget alloué aux crédits couvre-t-il ? |
| Espace de travail GlobalGPT | Un processus de souscription plus global, couvrant l'ensemble des modèles et des outils | Puis-je mener à bien cette tâche sans avoir à acheter plusieurs produits distincts ? |
N'utilisez pas le prix d'un forfait ChatGPT comme prévision API, et n'utilisez pas un tarif API pour décrire un accès par abonnement. Une comparaison pertinente commence par identifier l'itinéraire qui permettra réellement de mener à bien votre projet.
Choisissez l'itinéraire type pour réaliser cette tâche
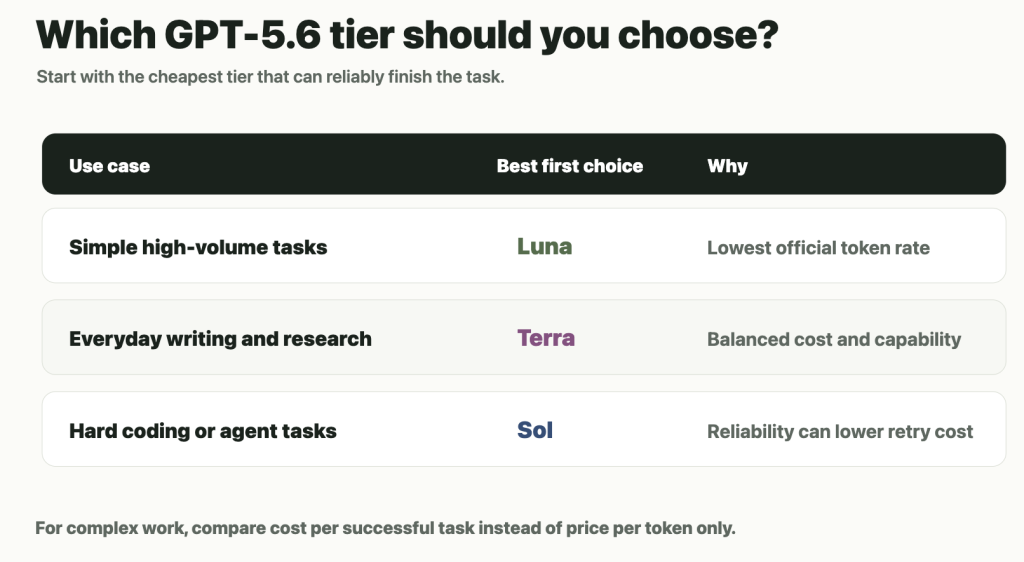
La ligne la moins chère n'est pas forcément la tâche exécutée la moins chère. Une modification courte peut s'avérer peu coûteuse dans un modèle général, tandis qu'un contexte de référentiel étendu peut faire en sorte que le niveau de contexte et la longueur de la sortie aient davantage d'importance. Pour un appel en production, enregistrez séparément les jetons d'entrée, les données d'entrée mises en cache, les jetons de sortie et tous les appels d'outils.
| Rythme de travail | Signal budgétaire | Bonnes pratiques d'utilisation |
|---|---|---|
| Transformation d'un texte court | La production reste souvent modeste | Définissez clairement le format de sortie et la condition d'arrêt. |
| Examen approfondi d'un code ou d'un document | Un niveau de contexte étendu peut s'appliquer | Mesurez la taille de la requête avant d'envoyer l'intégralité du référentiel. |
| Contexte de système ou de référentiel récurrent | La mise en cache des données d'entrée peut avoir son importance | Vérifiez le nombre réel d'accès au cache dans les données d'utilisation. |
| Flux de travail autonome des outils | Ajout d'informations sur l'utilisation des appels d'outils | Enregistrer ensemble le modèle, l'outil et le coût de production. |
Consultez le sélecteur de modèles et la grille tarifaire actuels pour connaître les noms exacts des modèles et les conditions d'accès. Si la désignation d'un modèle change, la méthode de calcul reste la même : associez la tâche à l'itinéraire, puis multipliez par les unités réelles.
Un test reproductible d'utilisation des jetons
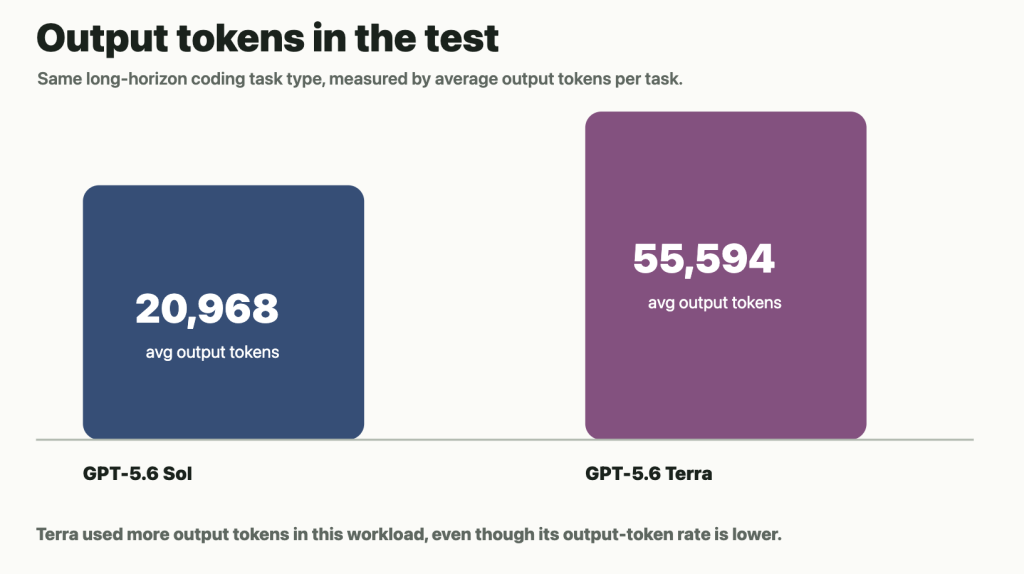
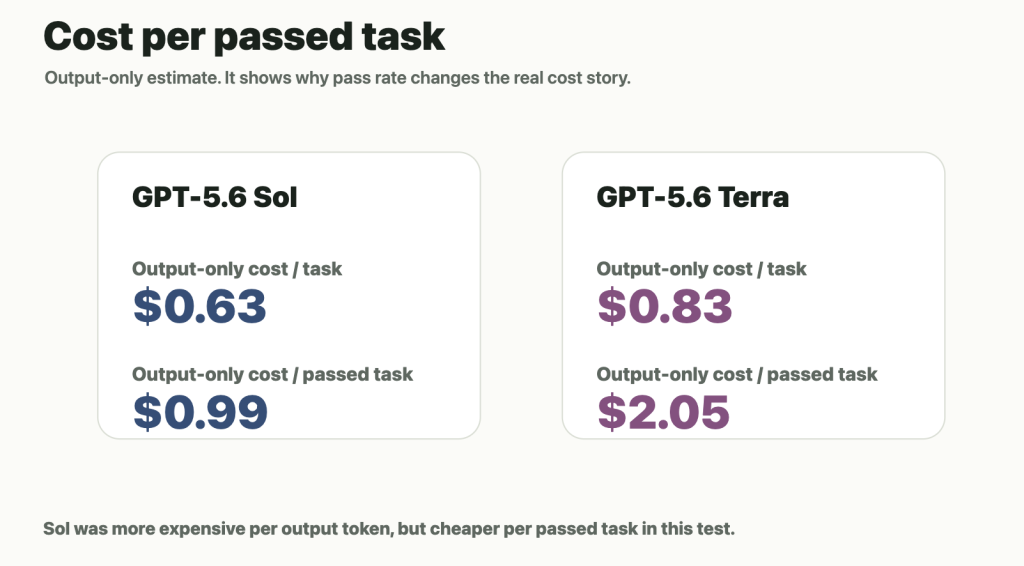
Pour évaluer une tâche réelle, utilisez la même requête, les mêmes données d'entrée et le même résultat attendu lors de deux exécutions. Enregistrez les tokens d'entrée, les tokens de sortie, l'état du cache et indiquez si un appel à un outil a été effectué. Comparez ensuite le coût d'un résultat réussi, plutôt que de comparer isolément un prix affiché.
- Utilisez un petit exercice de programmation ou d'écriture représentatif.
- Veillez à conserver le même format de sortie afin que la comparaison soit équitable.
- Notez le premier résultat et le résultat final après chaque nouvelle tentative.
- Dissocier les erreurs des prestataires, les limites de débit et la qualité du modèle du calcul du prix.
- Notez bien la date, car les prix promotionnels et la disponibilité des modèles peuvent varier.
Cela transforme la question “ quel modèle est le moins cher ? ” en une question opérationnelle utile : quelle approche permet d'accomplir la tâche en minimisant les dépenses prévisibles et les retouches ?
Quand une mise à niveau justifie une dépense supplémentaire liée à l'API
Un modèle plus récent justifie son coût plus élevé lorsqu’il permet d’éliminer un véritable risque de défaillance : corrections répétées, appels d’outils manqués, code fragile ou invite trop longue que la solution moins coûteuse ne peut pas gérer de manière fiable. Si le résultat est déjà correct et concis, un modèle plus coûteux peut s’avérer inutile.
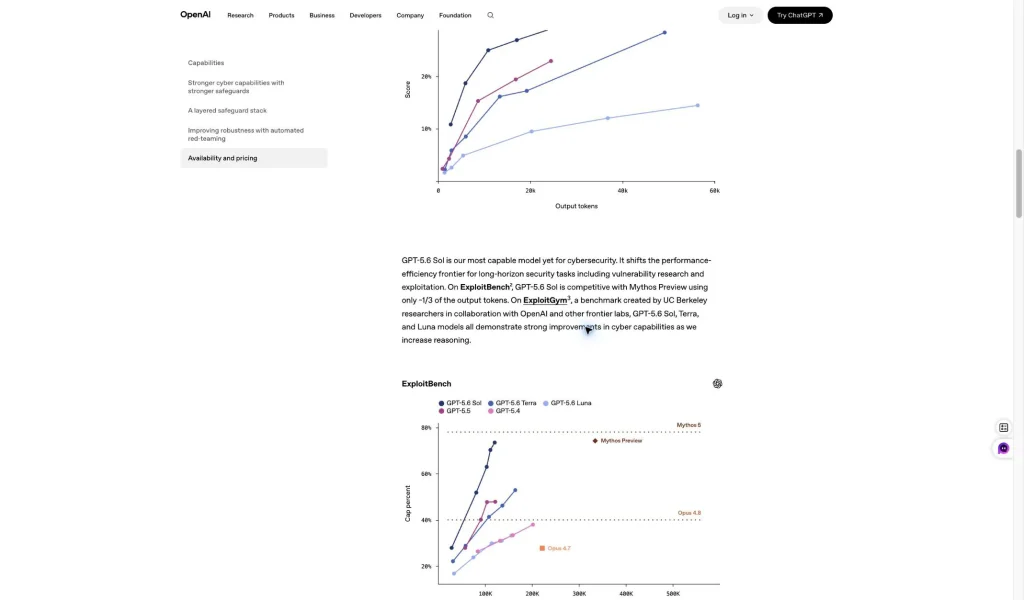
Pour une équipe, comparez trois indicateurs relatifs à un même ensemble de tâches : le nombre de tâches menées à bien, le nombre moyen de tokens générés et le temps de correction par un humain. Le modèle présentant le coût par token le plus bas n'est pas toujours celui qui offre le coût total du projet le plus bas.
De l'appel d'API au workflow complet du développeur
Utilisez le Itinéraire API GlobalGPT pour les appels programmables, CLI lorsque le modèle doit être associé à un terminal et à un référentiel, et MCP lorsque le flux de travail repose sur des outils validés. Un agent Yukie peut coordonner la planification, l'utilisation des outils et les transferts de tâches. Pour les tâches interactives, Accès à l'espace de travail GlobalGPT et GPT-5.6 vous permet de tester la tâche avant de vous engager dans un parcours de production à débit mesuré.
L'avantage pratique réside dans la démarche suivante : définir clairement la tâche, comparer un modèle adapté, effectuer le test minimal utile, puis intégrer le script fonctionnel dans l'API, l'interface en ligne de commande (CLI) ou le MCP. Cela permet de séparer les coûts liés à l'expérimentation de ceux liés à la production.
FAQ
Quelle est la tarification de l'API GPT-5.6 Sol ?
OpenAI répertorie les entrées $4/M et les sorties $20/M pour le contexte court, ainsi que les entrées $8/M et les sorties $30/M pour le contexte long. Les entrées mises en cache et les écritures dans le cache utilisent des débits distincts.
Le modèle GPT-5.6 Cyber est-il plus cher ?
Ses taux de contexte court publiés sont de $12,50/M en entrée et de $75/M en sortie ; il s'agit donc d'un choix budgétaire différent, et il convient de l'opter pour une tâche nécessitant cet itinéraire spécifique.
Le forfait ChatGPT Plus comprend-il des crédits API ?
Ne partez pas de ce principe. Les abonnements ChatGPT et les projets API constituent des entités de facturation distinctes.
Que sont les crédits Codex ?
Il s'agit de crédits d'utilisation de produits dont la consommation effective dépend du modèle et de l'utilisation des jetons. Ne les confondez pas avec les prévisions d'un projet API.
Quel est le moyen le moins cher d'utiliser GPT-5.6 ?
Pour les travaux multimodèles interactifs, comparez un plan d'espace de travail actuel. Pour les logiciels de production, comparez les estimations de jetons, les accès au cache, le niveau de contexte et le taux de réussite du modèle que vous choisissez.
Commençons par l'unité de facturation : Les tarifs des jetons répondent à la question relative à l'API ; l'accès au forfait, les crédits et la valeur du workflow répondent à la question relative au produit.