
API PERPLEXITY · TUTORIEL PYTHON · 2026
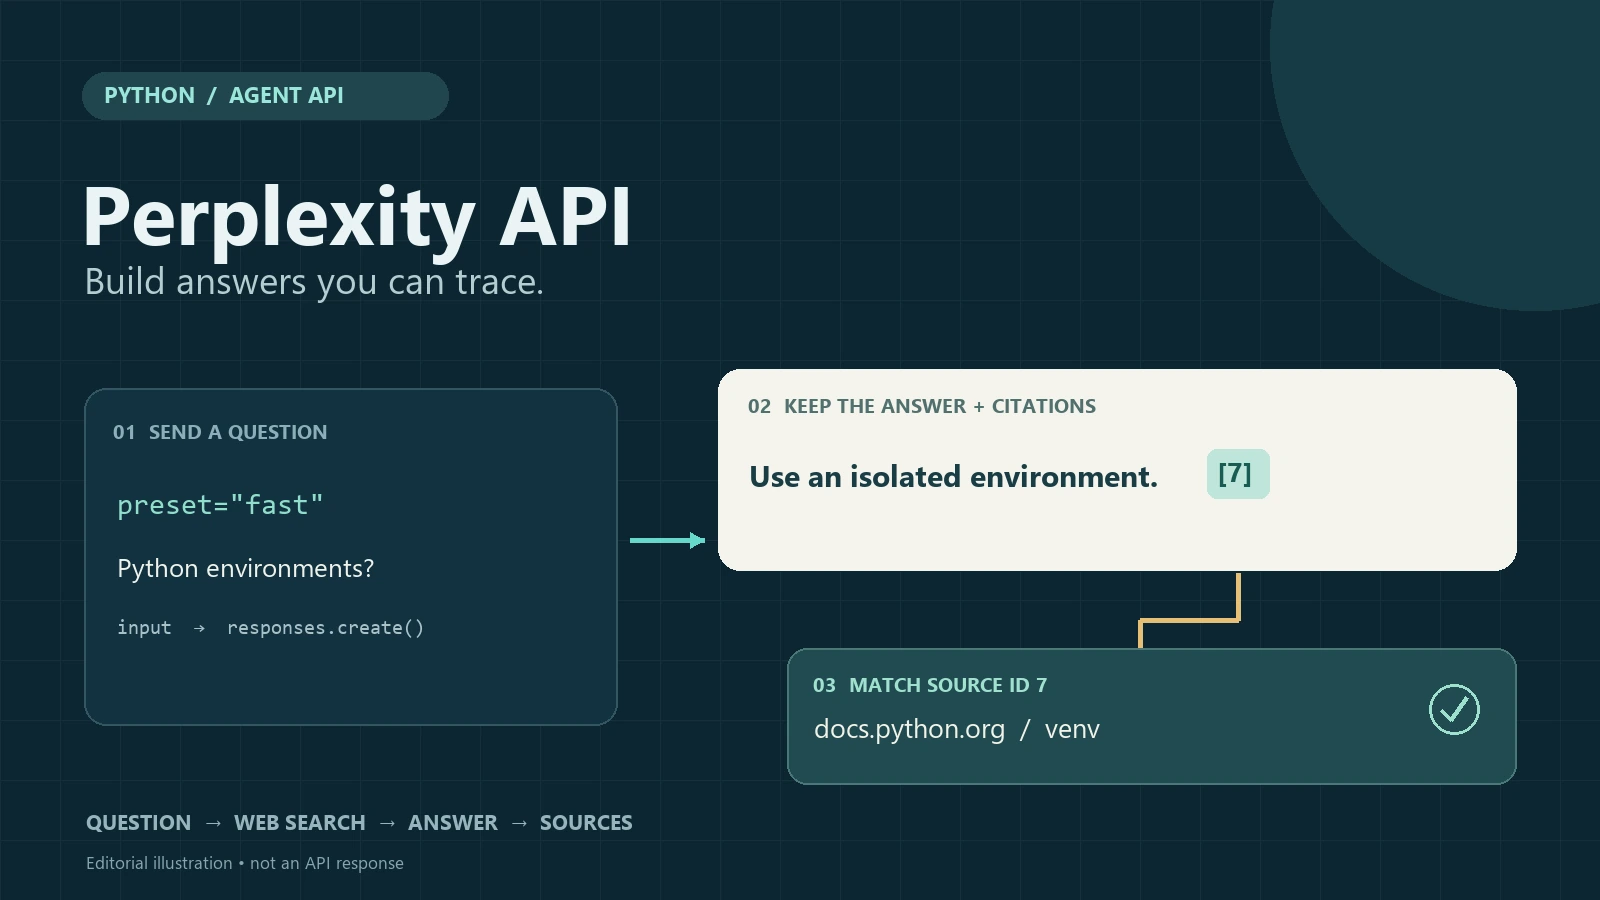
Ce tutoriel sur l'API Perplexity vous explique comment créer un script Python qui renvoie une réponse contenant des sources Web cliquables. Utilisez l'API Agent pour envoyer une question, lire la réponse, associer ses marqueurs de citation aux identifiants des sources, puis exporter un fichier Markdown que vous pourrez consulter.
Nous nous appuierons sur une seule question tout au long de ce texte : Comment un petit projet Python devrait-il utiliser les environnements virtuels et gérer ses dépendances ? Commencez par une requête simple, puis ajoutez l'analyse de la source et les filtres de domaine. Vous devez disposer de connaissances de base en Python et d'un compte développeur Perplexity avec la facturation API configurée.
Si vous utilisez vous aussi l'IA pour vos recherches et vos travaux d'écriture au quotidien, Perplexity sur GlobalGPT permet d'accéder à un espace de travail IA tout-en-un, ce qui évite d'avoir à passer d'un outil à l'autre. Ce flux de travail destiné aux consommateurs est distinct de la clé développeur et de la facturation des API utilisées ici.
Réponse rapide : Utilisez le rapidement Préréglage de l'agent pour une première réponse basée sur le Web, lire response.output_text pour connaître la réponse, et lisez le résultats_de_recherche élément dans response.output pour les sources. Associez chaque marqueur intégré à une source en fonction de la valeur renvoyée par celui-ci id. Une référence signifie que “ la réponse conduit à ce résultat ” ; elle ne garantit pas que la page démontre chacune des affirmations.
Exemple de statut : La syntaxe de la requête est conforme à la documentation officielle consultée le 28 septembre 2026. L'outil d'aide à la citation a été testé à l'aide d'échantillons de données hors ligne ; aucune requête API payante n'a été effectuée dans le cadre de ce tutoriel. Les enregistrements sources présentés dans l'illustration sont des exemples à titre explicatif.
- Quelle API Perplexity devez-vous utiliser ?
- Étape 1 : Obtenir une clé API et configurer Python
- Étape 2 : Envoyez votre première requête avec mise à la terre à la source
- Étape 3 : Extraire la réponse et identifier ses sources
- Étape 4 : Affiner la réponse à l'aide des filtres de recherche
- Étape 5 : Enregistrer une réponse complète avec des sources cliquables
- Diffusion en continu et sortie structurée
- Coûts et erreurs courantes
- À partir d'un ancien tutoriel sur Sonar
- Foire aux questions
Tutoriel sur l'API Perplexity : choisir la bonne API
Il s'agit d'interfaces destinées aux développeurs. Le produit de chat peut proposer des fonctionnalités similaires sous une forme différente ; notre présentation de Fonctionnalités de Perplexity décrit l'expérience utilisateur.
Perplexity’s Guide de démarrage rapide de l'API officielle regroupe ses produits destinés aux développeurs en fonction des tâches à accomplir. Choisissez la surface la plus petite qui génère les données dont votre application a réellement besoin.
| API | Meilleure adéquation | Ce que votre code reçoit |
|---|---|---|
| Agent | Une réponse complète s'appuyant sur des recherches sur Internet ou d'autres outils | Éléments de sortie saisis, texte des réponses et enregistrements des résultats de recherche |
| Recherche | Votre application classera, filtrera ou résumera elle-même les résultats | Résultats de recherche sans demander à Perplexity de fournir la réponse définitive |
| Routeur | Acheminer les requêtes vers un modèle adapté | Une réponse type sélectionnée via le routeur |
| Représentations | Recherche sémantique et index RAG | Données vectorielles pour votre propre couche de recherche |
Ce tutoriel utilise « Agent » car le résultat souhaité est une réponse complète accompagnée de ses sources. Pour en savoir plus sur le processus de recherche dans son ensemble, consultez notre guide consacré à Utilisation de Perplexity à des fins de recherche.
À propos de Sonar : Le courant Aperçu de la migration précise que la fonctionnalité « Sonar Chat Completions » est toujours prise en charge et recommande l'utilisation d'Agent pour tous les nouveaux projets. Ce tutoriel utilise donc Agent. Il ne faut pas en déduire qu'une ancienne intégration a cessé de fonctionner simplement parce qu'une date butoir est mentionnée dans un tutoriel plus ancien.
Étape 1 : Obtenir une clé API et configurer Python
Créer la clé et préparer la facturation
Ouvrir la console de l'API Perplexity, choisissez ou créez le projet que vous allez utiliser, configurez la facturation de l'API et créez une clé. Conservez-la côté serveur. Les API pour développeurs sont facturées séparément des abonnements grand public ; vérifiez le solde de votre projet avant d'effectuer des requêtes.
Installez le SDK officiel
python -m venv .venv

# macOS/Linux : choisissez cette commande d'activation
source .venv/bin/activate

# Windows PowerShell : utilisez plutôt cette commande
.venv\Scripts\Activate.ps1

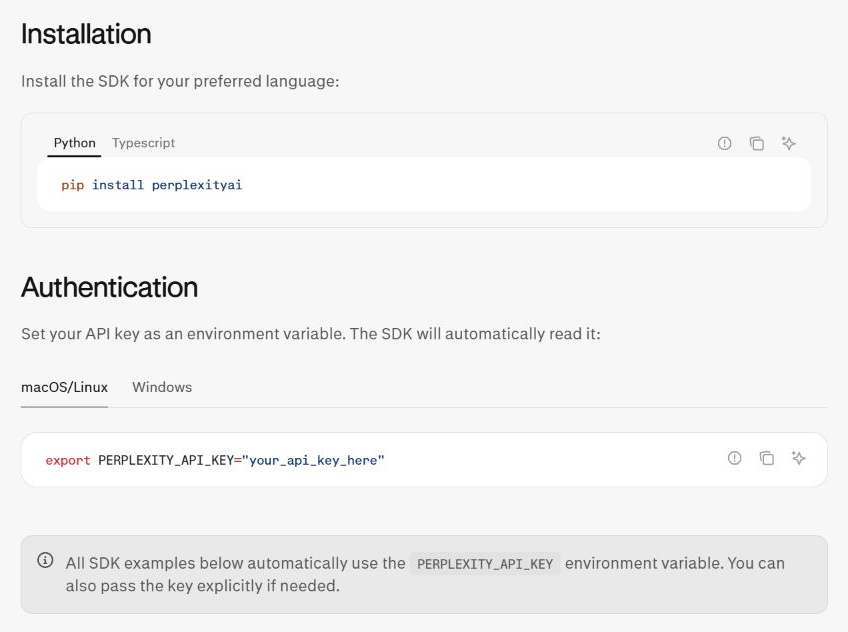
python -m pip install --upgrade perplexityai
Utilisez Python 3.10 ou une version plus récente pour le code ci-dessous. Activez l'environnement à l'aide de la commande adaptée à votre système d'exploitation, puis installez le SDK. Si PowerShell bloque l'activation, utilisez .venv\Scripts\python.exe à la place de python pour l'installation et l'exécution du script.
Le nom du paquet est perplexityai, tandis que l'importation en Python est perplexité. Utilisez un environnement virtuel afin que les dépendances de ce tutoriel n'affectent pas un autre projet.
Cet exemple s'appuie sur une question relative au codage, car ses affirmations peuvent être vérifiées à l'aide d'une documentation mise à jour. Notre guide sur Perplexity pour le codage explique comment le soutien à la recherche s'inscrit dans le cadre des tests de code que vous effectuez vous-même.
Définissez la clé API en tant que variable d'environnement
# macOS/Linux
export PERPLEXITY_API_KEY="votre-clé-ici"

# Windows PowerShell
$env:PERPLEXITY_API_KEY = "votre-clé-ici"
Le SDK indique PERPLEXITÉ_CLÉ_API lorsque vous créez le client. Ne collez pas la clé dans un bloc-notes, ne la soumettez pas à Git et ne l'envoyez pas à un navigateur. Si vous utilisez un fichier .env en local, veillez à ce que ce fichier ne soit pas soumis au contrôle de version et chargez-le à l'aide de la bibliothèque de variables d'environnement de votre choix.
Étape 2 : Envoyez votre première requête avec mise à la terre à la source
Guide de démarrage rapide de l'API Agent documents ARTICLE https://api.perplexity.ai/v1/agent. Son client Python encapsule la requête avec client.responses.create(). Le rapidement Ce paramètre par défaut active la recherche sur le Web, ce qui permet de limiter la taille du premier exemple.
from perplexity import Perplexity

client = Perplexity()

question = (
    "Comment un petit projet Python devrait-il utiliser les environnements virtuels "
    "et gérer ses dépendances ?"
)

response = client.responses.create(
    preset="fast",
    input=question,
)

print(response.output_text)
Enregistrez cet extrait sous le nom de first_request.py, puis exécutez python first_request.py dans le même terminal que celui où vous avez défini la clé. Si l'appel aboutit, un texte de réponse non vide devrait s'afficher. Si vous avez besoin d'une confirmation du résultat, passez à l'étape d'extraction de la source ; le texte seul ne constitue pas une vérification complète.
La propriété de commodité texte_de_sortie vous fournit le texte de la réponse finale. Conservez également l'objet de réponse dans son intégralité : les enregistrements sources et les détails d'utilisation figurent dans la sortie saisie, et non pas uniquement dans le paragraphe imprimé.
La même requête avec cURL
curl https://api.perplexity.ai/v1/agent \
  -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "preset": "fast",
    "input": "Comment un petit projet Python devrait-il utiliser les environnements virtuels et gérer ses dépendances ?"
  }'
Cet exemple cURL utilise la syntaxe Bash pour macOS/Linux ou un shell compatible avec Bash. Chaque exécution génère une nouvelle requête facturable. N'utilisez-le que lorsque vous avez besoin d'isoler un problème lié à un point de terminaison d'un problème lié à Python ; n'exécutez pas toutes les versions simplement pour suivre le guide.
Équivalent en JavaScript côté serveur
Node.js 18+ inclut récupérer, un test de fonctionnement côté serveur ne nécessite donc aucune bibliothèque supplémentaire. Lire le code brut sortie éléments de la réponse JSON ; le SDK Python propose la fonction pratique texte_de_sortie accessoire.
const res = await fetch("https://api.perplexity.ai/v1/agent", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.PERPLEXITY_API_KEY}`,
    "Content-Type": "application/json"
  },
  body: JSON.stringify({
    preset: "fast",
    input: "Comment un petit projet Python devrait-il utiliser les environnements virtuels et gérer ses dépendances ?"
  })
});
if (!res.ok) throw new Error(`Perplexity HTTP ${res.status}`);
console.log(await res.json());
Étape 3 : Extraire la réponse et identifier ses sources
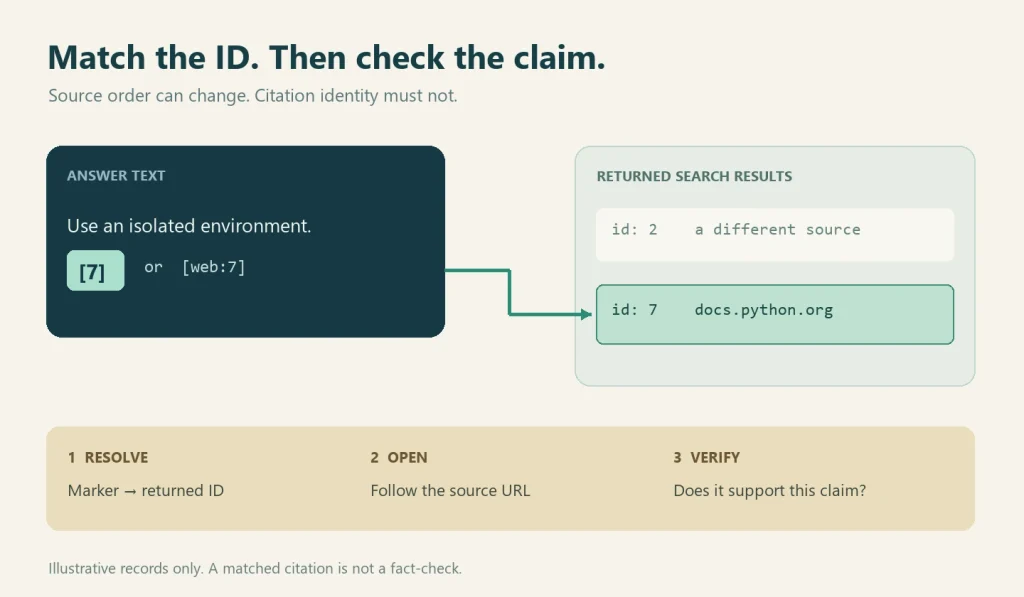
Les recommandations officielles en matière de citations distingue le texte de ses pièces justificatives. Les sources arrivent dans un sortie élément de type résultats_de_recherche. Lire l'article en question résultats et associer chaque repère de citation au résultat correspondant id. Un résultat comporte un titre et une URL ; il faut gérer les valeurs manquantes avant de l'afficher.
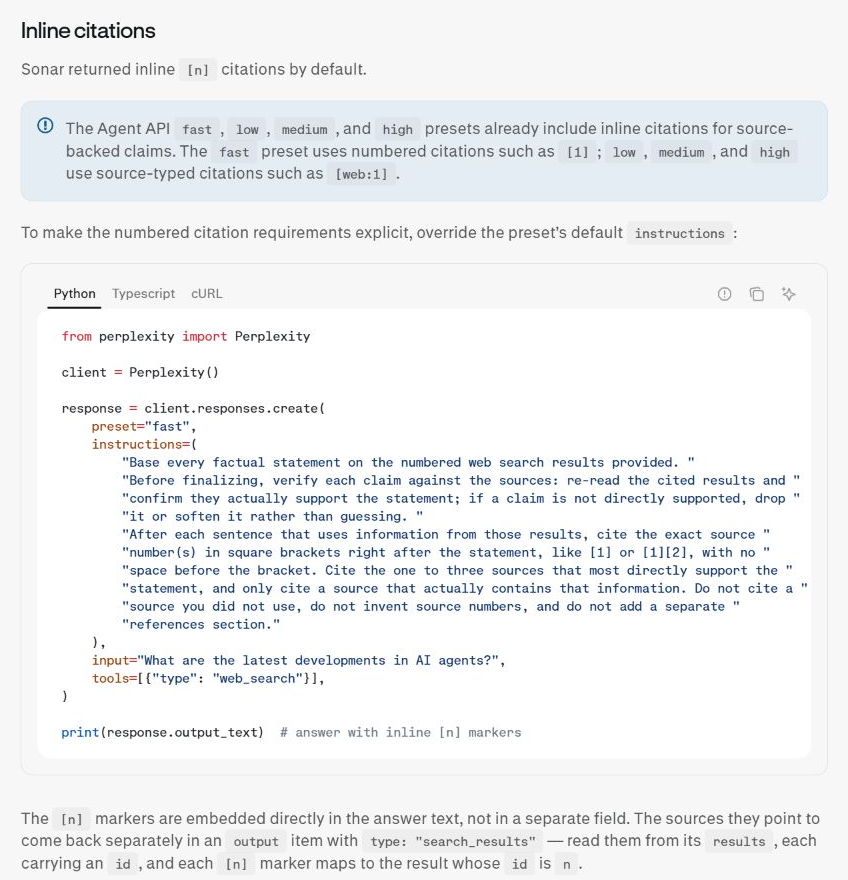
Ce dernier détail est important. Ne partez pas du principe que la “ citation 1 ” est toujours le premier élément d'un tableau après qu'un autre outil y a ajouté un élément. Effectuez une recherche par identifiant, puis identifiez les marqueurs qui apparaissent effectivement dans la réponse.
def field(obj, name, default=None) :
    return obj.get(name, default) if isinstance(obj, dict) else getattr(obj, name, default)

def source_index(output) :
    sources = {}
    for item in output or [] :
    if field(item, "type") != "search_results" :
        continue
    for result in field(item, "results", []) or [] :
            sid, url = field(result, "id"), field(result, "url")
 si sid est None :
 passer à la ligne suivante
 key = str(sid)
 si key est dans sources et si field(sources[key], "url") != url :
                raise ValueError(f"URL en conflit pour l'ID de source {key}")
 sources[key] = result
    return sources

sources = source_index(response.output)
print(sources.get("7"))  # Un ID de source, et non la position 7 du tableau
Le script complet ci-dessous reconnaît [1] et [web:1], les formats de citation documentés pour les préréglages courants. L'utilitaire ci-dessus prend en charge à la fois les objets SDK et les dictionnaires, et rejette les URL conflictuelles attribuées au même identifiant. Il ne renuméro pas les résultats et ne devine pas une source manquante.
Pour une analyse plus approfondie de la qualité des citations, consultez notre Guide sur la précision des citations Perplexity. Une référence constitue une trace d'audit ; votre application doit tout de même disposer d'une politique concernant les pages obsolètes, les URL en double et les affirmations non étayées.
Par exemple, si le tableau renvoyé contient l'ID 2 suivi de l'ID 7, le marqueur [7] doit renvoyer vers l'ID 7. Si la même URL apparaît sous les ID 7 et 9, vous pouvez l'afficher une seule fois tout en conservant les deux ID. Si l'ID 8 n'apparaît jamais, conservez [8] le rendre visible et le marquer comme « non apparié ».
Étape 4 : Affiner la réponse à l'aide des filtres de recherche
Une fois que la requête de base fonctionne, affinez votre recherche lorsque votre question porte sur un domaine bien précis. Pour la création de paquets Python, la documentation du langage et le guide de création de paquets constituent de meilleurs points de départ qu'un tutoriel choisi au hasard.
response = client.responses.create(
    preset="fast",
    input=(
 "Comment un petit projet Python devrait-il utiliser les environnements virtuels "
 "et gérer ses dépendances ? Citez les recommandations que vous suivez."
    ),
    tools=[
 {
 "type": "web_search",
 "filters": {
 "search_domain_filter": [
 "docs.python.org",
                    "packaging.python.org",
 ]
 },
 }
    ],
)
Le filtre doit être défini dans la configuration de l'outil de recherche sur le Web. La documentation relative à la migration décrit également filtre_par_date_de_publication pour les questions liées à l'actualité. Privilégiez la récence lorsque la question repose sur des publications ou des actualités récentes ; une combinaison trop restrictive entre domaine et date peut vous laisser avec trop peu d'éléments.
Pour une question concernant les sorties du mois dernier, ajoutez "search_recency_filter" : "mois" à côté de filtre_de_recherche_par_domaine. Ne l'incluez pas dans l'exemple de l'environnement virtuel : la documentation stable peut comporter une date de publication antérieure. Si vous passez d'un modèle prédéfini à un modèle sélectionné directement, veillez à inclure explicitement l'outil de recherche sur le Web.
Comparez les résultats filtrés et non filtrés au cours du développement. Si la réponse change, notez pourquoi : un filtre peut supprimer du contexte utile, ou éliminer des pages peu fiables qui perturbaient le modèle. Il s'agit d'un choix lié à la qualité, et non d'une garantie que toutes les pages restantes sont correctes.
Si votre application n'a besoin que de liens classés et d'extraits, appelez la fonction API de recherche et de réaliser la synthèse vous-même. Cette distinction peut faciliter la révision et la mise en cache. Pour une comparaison plus approfondie avec Google, voir En quoi Perplexity se distingue de Google.
Étape 5 : Enregistrer une réponse complète avec des sources cliquables
Enregistrez ce qui suit sous le nom de perplexity_tutorial.py. Il est autonome : il intègre l'assistant de source, applique le filtre de domaine de la documentation Python, transforme les marqueurs de citation correspondants en liens, regroupe les URL en double sans perdre les identifiants, et enregistre la réponse SDK complète avec le code Markdown.
from pathlib import Path
from collections import defaultdict
from urllib.parse import urlsplit
import json
import re

QUESTION = (
    "How should a small Python project use virtual environments "
    "and manage dependencies?"
)
# Supports the documented [1] and [web:1] forms in prose answers.
CITATION_RE = re.compile(r"(?<!!)\[(?:web:)?(\d+)\](?!\()")

def field(obj, name, default=None):
    return obj.get(name, default) if isinstance(obj, dict) else getattr(obj, name, default)

def source_index(output):
    sources = {}
    for item in output or []:
        if field(item, "type") != "search_results":
            continue
        for result in field(item, "results", []) or []:
            sid, url = field(result, "id"), field(result, "url")
            if sid is None:
                continue
            key = str(sid)
            if key in sources and field(sources[key], "url") != url:
                raise ValueError(f"Conflicting URLs for source ID {key}")
            sources[key] = result
    return sources

def safe_url(value):
    if not isinstance(value, str):
        return None
    parsed = urlsplit(value)
    if parsed.scheme not in ("http", "https") or not parsed.netloc:
        return None
    # Protect a Markdown angle-bracket destination.
    return value.replace("<", "%3C").replace(">", "%3E").replace(" ", "%20")

def md_label(value):
    return re.sub(r"([\\\[\]<>])", r"\\\1", str(value).replace("\n", " "))

def export_markdown(answer, output, question=QUESTION):
    sources = source_index(output)
    cited = list(dict.fromkeys(CITATION_RE.findall(answer)))
    missing = [
        sid for sid in cited
        if sid not in sources or not safe_url(field(sources[sid], "url"))
    ]
    def link(match):
        sid = match.group(1)
        url = safe_url(field(sources.get(sid, {}), "url"))
        return f"[{match.group(0)[1:-1]}](<{url}>)" if url else match.group(0)

    # Keep every ID when the same URL appears under different IDs.
    grouped = defaultdict(list)
    titles = {}
    for sid in cited:
        source = sources.get(sid, {})
        url = safe_url(field(source, "url"))
        if url:
            grouped[url].append(sid)
            titles.setdefault(url, field(source, "title") or url)

    lines = ["# Source-grounded answer", "", question, "",
             CITATION_RE.sub(link, answer), "", "## Cited sources", ""]
    for url, ids in grouped.items():
        lines.append(f"- IDs {', '.join(ids)}: [{md_label(titles[url])}](<{url}>)")
    if missing:
        lines.append("- Unmatched or unusable source IDs: " + ", ".join(missing))
    if not cited:
        lines.append("- No recognized inline citations; evidence not verified.")
    lines.extend(["", "Source links require review; matching IDs does not verify claims."])
    return "\n".join(lines) + "\n"

def main():
    from perplexity import Perplexity
    response = Perplexity().responses.create(
        preset="fast",
        input=QUESTION,
        tools=[{"type": "web_search", "filters": {
            "search_domain_filter": ["docs.python.org", "packaging.python.org"]
        }}],
    )
    answer = response.output_text or ""
    if not answer.strip():
        raise RuntimeError("No answer text returned; inspect response status and errors.")
    Path("perplexity-response.json").write_text(
        response.model_dump_json(indent=2), encoding="utf-8"
    )
    Path("perplexity-answer.md").write_text(
        export_markdown(answer, response.output), encoding="utf-8"
    )
    print("Saved perplexity-answer.md and perplexity-response.json")

if __name__ == "__main__":
    main()
Courir python perplexity_tutorial.py à partir du répertoire de votre projet. Il écrit perplexity-answer.md et perplexity-response.json là, en remplaçant les fichiers antérieurs portant ces noms. Le fichier Markdown contient la question, la réponse associée, les sources citées et les identifiants non appariés. Le fichier JSON conserve la sortie renvoyée et les informations d'utilisation à des fins de diagnostic.
L'analyseur se concentre sur les formes à marqueur unique répertoriées dans la prose. Il ne s'agit pas d'un analyseur Markdown complet : si votre application nécessite du Markdown arbitraire, des exemples de code ou des citations telles que [1,2], ajoutez un moteur de rendu prenant en charge la syntaxe ainsi que des tests pour ce format. Ne réinterprétez pas silencieusement les marqueurs inconnus.
Vérifiez si la page vers laquelle renvoie le lien corrobore la réponse
Dans cet exemple, vérifiez si la documentation citée explique réellement l'isolation de l'environnement et l'installation des dépendances. Un lien vers la page d'accueil de Python est moins utile que la section correspondante de la documentation. Si une réponse recommande une commande spécifique, vérifiez le système d'exploitation et la version de Python avant de l'exécuter. Mark affirme que le texte cité ne justifie pas le statut « non résolu ».
Ajouter une sortie en continu ou structurée si nécessaire
Diffusion en continu
Le streaming améliore la latence perçue dans une interface de chat. Le guide de migration des agents décrit les événements « delta » de texte, tels que response.output_text.delta. Affichez ces mises à jour au fur et à mesure qu'elles arrivent, mais récupérez également les éléments de la réponse finale afin que votre interface utilisateur puisse afficher les sources une fois la réponse terminée. Un simple flux de texte ne constitue pas à lui seul une liste de sources.
Ce qui suit est uniquement un affichage de texte. Conservez l'exportation sans streaming pour votre premier enregistrement source complet ; une implémentation de streaming en production doit également collecter les événements liés aux outils et aux sorties, et gérer les exécutions interrompues ou ayant échoué.
stream = client.responses.create(
    preset="fast", input=question, stream=True
)
for event in stream:
    if event.type == "response.output_text.delta":
 print(event.delta, end="", flush=True)
Sortie structurée
Utilisez une réponse structurée lorsque le code en aval a besoin de champs tels que réponse, note_de_confiance et questions_de_suivi. Conservez les identifiants source dans un champ distinct ou conservez la sortie d'origine d'Agent afin que votre schéma ne masque pas les informations pertinentes. Validez le schéma à l'aide de vos propres cas de test avant de l'intégrer dans un workflow.
La référence de migration conserve format_de_réponse avec type : " json_schema " pour un résultat structuré. Définissez les champs obligatoires et interdisez les propriétés inattendues lorsque cela s'avère nécessaire. Les contrôles de validité du schéma portent sur la forme, et non sur la véracité : les identifiants source doivent toujours correspondre aux enregistrements effectivement renvoyés, et une étiquette de confiance générée par le modèle ne constitue pas une mesure de précision.
Coûts de l'API Perplexity et erreurs courantes
Page officielle des tarifs de Perplexity, consulté le 28 septembre 2026, distingue les jetons du modèle d'agent des appels d'outils. Vous trouverez ci-dessous les frais liés aux outils et aux recherches USD. Le rapidement Préréglage de l'agent et search_type : " fast " Il s'agit de différentes options de configuration ; ne déduisez pas la fréquence de recherche à partir du nom du préréglage.
| Prestation facturable | USD par action | USD pour 1 000 |
|---|---|---|
| Recherche Web standard par l'agent | $0.0025 | $2.50 |
| Appel de la fonction « Recherche rapide » de l'agent | $0.001 | $1.00 |
| Récupération de l'URL par l'agent | $0.0005 | $0.50 |
| Requête réussie via l'API de recherche | $0.005 | $5.00 |
| API de recherche avec Fast Search | $0.001 | $1.00 |
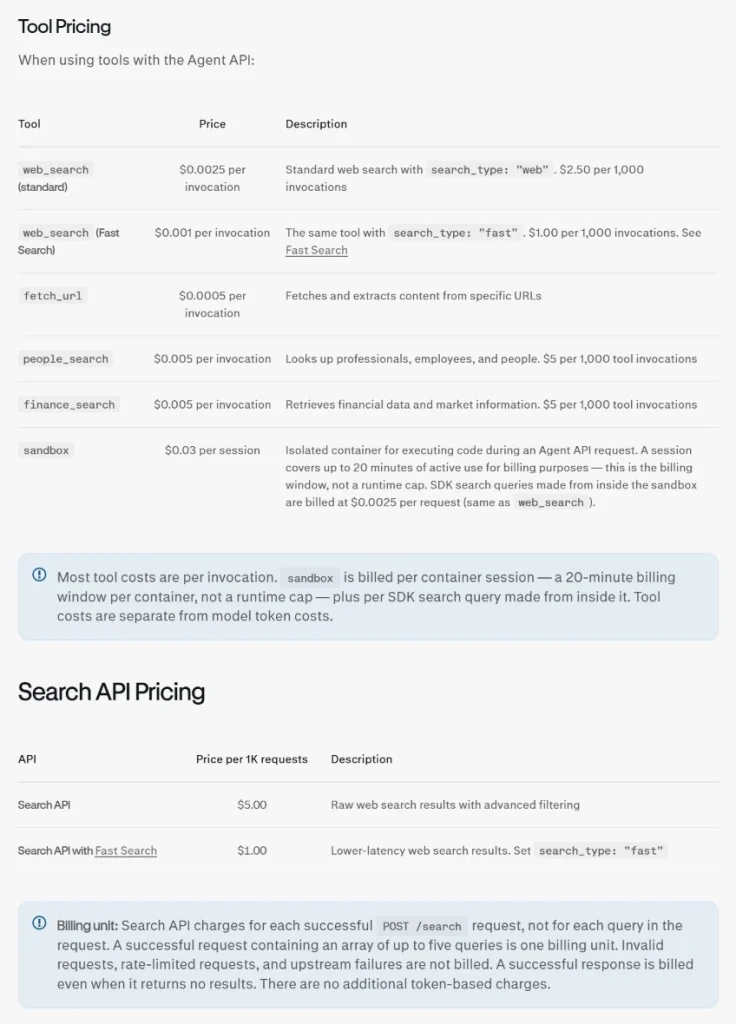
Exemple : Coût de 1 000 requêtes de recherche standard sur le Web plus 1 000 récupérations d'URL $3.00 en frais d'outillage ($2.50 + $0.50), avant les jetons de modèle ou autres frais. Il s'agit d'une charge de travail estimée, et non d'un coût mesuré pour le tutoriel. Une seule requête d'Agent peut faire appel à plusieurs outils. Lorsque cela est possible, vérifiez utilisation.coût.coût_total sur la réponse complétée.
| Symptôme | Ce qu'il faut vérifier en premier |
|---|---|
| 401 ou 403 | Nom de la variable d'environnement, validité de la clé, accès au compte et vérification que la requête parvient bien au point de terminaison actuel. |
| Erreur de facturation ou de quota | Crédits API, configuration des paiements, frais liés aux modèles/outils et limites de compte. Un forfait grand public Perplexity ne donne pas automatiquement droit à des crédits API. |
| 429 | Limites de débit et comportement en cas de nouvelle tentative. Utilisez un recul exponentiel limité et évitez de réenvoyer aveuglément une requête déjà traitée. |
| Délai d'attente | Paramètres relatifs au chemin réseau, à la taille de l'invite, au nombre d'outils et au délai d'expiration du client. Enregistrez l'identifiant de la requête si le SDK en fournit un, mais n'enregistrez jamais la clé. |
| La réponse ne correspond à aucune source. | Examiner le produit brut response.output, la syntaxe des citations et les identifiants des sources ; indiquez que la réponse n'a pas été vérifiée plutôt que d'inventer des liens. |
L'API de recherche facture les requêtes abouties, y compris celles qui ne renvoient aucun résultat ; le prix de la requête ne comprend pas de frais supplémentaires liés aux jetons. Les coûts liés aux agents dépendent des jetons de modèle et des outils. Veillez à bien distinguer ces unités de facturation lorsque vous comparez un workflow de réponse à un workflow de recherche seule.
Pour comparer les tarifs des API, notre Guide des tarifs de l'API Perplexity apporte des informations complémentaires, tandis que la page officielle des tarifs reste la référence en matière de tarifs en vigueur.
À partir d'un ancien tutoriel sur Sonar
De nombreux résultats de recherche affichent encore l'ancienne forme « Chat Completions ». Le guide de migration des agents utilise une correspondance conceptuelle directe. Si vous comparez les libellés du modèle grand public avec les préréglages de l'API, consultez notre guide explicatif sur ce que LLM Perplexité utilise Elle fournit des informations contextuelles, mais ne remplace pas la documentation relative à l'API Agent.
| Ancien modèle Sonar | Modèle d'API d'agent |
|---|---|
messages | entrée |
modèle | préréglage |
choices[0].message.content | texte_de_sortie |
| Anciennes hypothèses relatives aux tableaux de citations | résultats_de_recherche élément de sortie et mise en correspondance basée sur l'ID |
| Paramètres de recherche dans la requête | tools=[{"type":"web_search","filters":{...}}] |
Lire le direct Aperçu de la migration et détails de la migration avant de modifier le code de production. Les correspondances prédéfinies constituent un point de départ, et non une garantie que les anciens et les nouveaux modèles offriront une qualité, une latence ou un coût identiques.
Foire aux questions
L'API Perplexity est-elle gratuite ?
Les API sont facturées à l'utilisation, conformément au guide de démarrage rapide et à la documentation sur les tarifs en vigueur. Ne partez pas du principe qu'un abonnement « Consumer », une période d'essai ou un crédit promotionnel rend chaque requête API gratuite.
Ai-je besoin de Perplexity Pro pour utiliser l'API ?
L'accès à l'API et l'abonnement Pro pour les particuliers sont deux produits distincts. Créez des identifiants d'accès à l'API et vérifiez la facturation liée à l'API pour le compte développeur que vous comptez utiliser.
Dois-je utiliser l'API Agent ou l'API Search ?
Choisissez « Agent » lorsque vous souhaitez obtenir une réponse complète et étayée, accompagnée de sources. Choisissez « Recherche » lorsque votre application doit prendre en charge le classement, le filtrage et la synthèse. Vous pouvez combiner la « Recherche » avec votre propre modèle si vous avez besoin d'un contrôle strict sur chaque étape de génération.
Puis-je appeler Perplexity depuis JavaScript ?
Oui. Utilisez l'exemple Node.js côté serveur ci-dessus ou le SDK JavaScript officiel. Conservez la clé sur le serveur. Lors de la lecture du JSON brut, examinez les éléments de sortie typés et appliquez les mêmes règles de mappage des identifiants source.
La justesse des citations Perplexity est-elle garantie ?
Non. Une référence vous indique à quel résultat la réponse renvoie. Votre demande ou votre évaluateur doit tout de même vérifier l'actualité, la fiabilité de la source et si la page corrobore bien l'affirmation en question.
Pourquoi mon analyseur n'a-t-il trouvé aucune source ?
Examinez les types d'éléments de sortie bruts, vérifiez que la recherche sur le Web a bien été effectuée et vérifiez si votre expression régulière correspond au format de citation défini dans le préréglage. Si aucun marqueur n'apparaît, enregistrez la réponse comme « non vérifiée » et examinez la requête plutôt que d'ajouter un lien au hasard.
La clé API GlobalGPT peut-elle remplacer une clé API Perplexity ?
GlobalGPT est un espace de travail IA tout-en-un destiné à une utilisation quotidienne de l'IA. Son abonnement et l'accès aux modèles sont distincts du compte développeur Perplexity, de la clé API et des crédits API ; ce tutoriel Python utilise le compte développeur.
Une liste de contrôle pratique pour le lancement
- Créer une clé côté serveur et valider la facturation de l'API.
- Exécutez la version minimale
rapidementdemande avant d'ajouter des filtres ou de lancer la diffusion en continu. - Enregistrez la réponse complète, et pas seulement le texte de la réponse visible.
- Associer les marqueurs de citation aux identifiants de source renvoyés et signaler les marqueurs non associés.
- Vérifiez les pages citées pour vous assurer qu'elles étayent les affirmations, qu'elles sont à jour et qu'il n'y a pas d'URL en double.
- Vérifiez à nouveau la documentation relative à Live Agent, aux tarifs et à la migration avant le déploiement.
Vous disposez désormais du modèle de base pour une intégration fiable de l'API Perplexity : posez une question ciblée, laissez l'API Agent effectuer la recherche, conservez la réponse et les sources ensemble, et veillez à ce que chaque citation puisse être vérifiée. À partir de là, ajoutez la mise en cache, les tentatives de réessai et vos propres règles de vérification dans le cadre du même workflow basé sur l'identifiant de source.









