
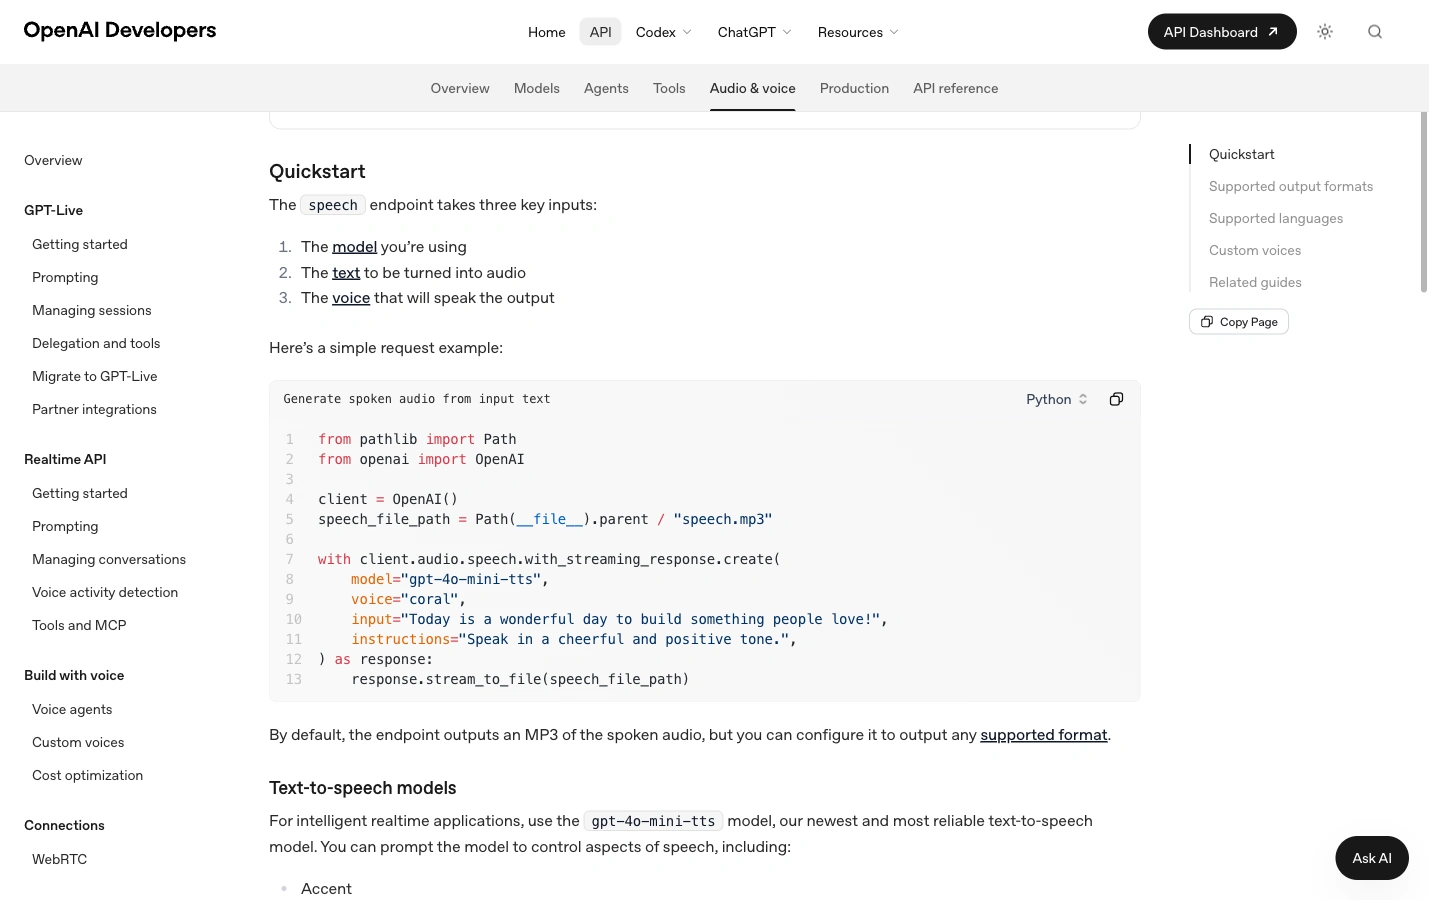
Le API Audio Speech OpenAI convertit le texte en audio parlé grâce à ARTICLE https://api.openai.com/v1/audio/speech. Envoyez un modèle, votre texte d'entrée et une voix ; enregistrez la réponse au format MP3 ou dans un autre format audio pris en charge. Pour une nouvelle intégration nécessitant des instructions concernant le ton et la manière de s'exprimer, commencez par gpt-4o-mini-tts.
Une demande de travail n’est qu’une première étape. Il vous faut également choisir l’unité de facturation appropriée, disposer d’un fichier de sortie lisible et établir un plan pour les scripts longs. Le nouveau modèle de synthèse vocale de OpenAI utilise des jetons de texte et audio pour la tarification ; ses anciens modèles se basaient sur le nombre de caractères. Cette différence est importante lorsque vous estimez le coût d’un mois de narration.
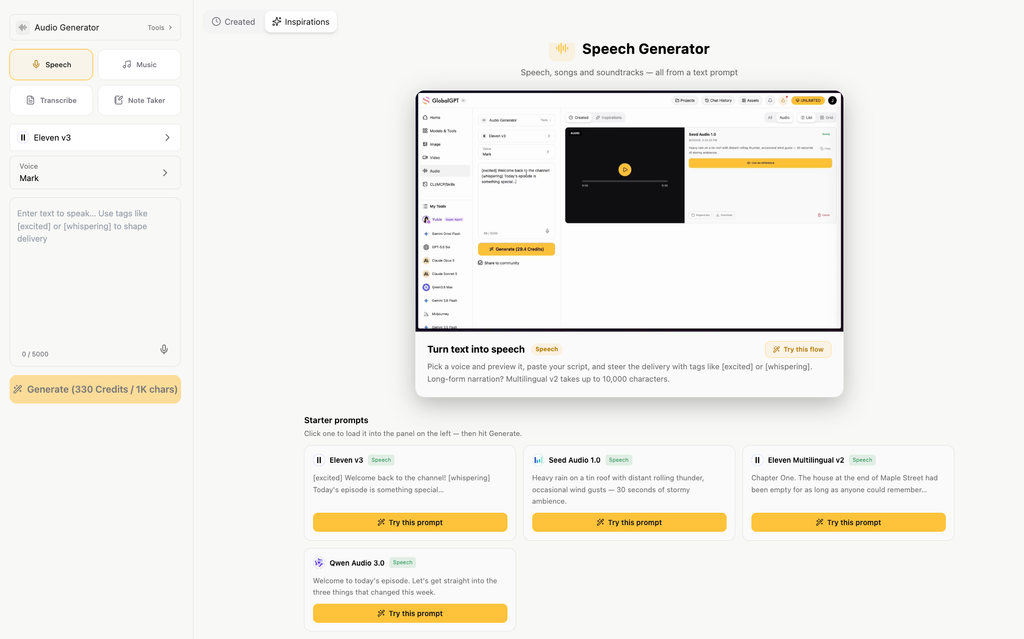
Si votre travail consiste également à rédiger le scénario, à créer les éléments visuels et à monter une vidéo, L'espace de travail audio de GlobalGPT intègre la génération de parole dans une plateforme multimodale par abonnement à un prix abordable. Vous pouvez travailler à la fois sur du texte, de la voix, des images et des vidéos depuis un seul tableau de bord, puis utiliser son API et son interface en ligne de commande (CLI) pour des tâches de production reproductibles. Son API publique de synthèse vocale (TTS) utilise un flux de travail distinct, décrit ci-dessous.
À quoi sert l'API audio de reconnaissance vocale OpenAI ?
L'API Speech est un point de terminaison de synthèse vocale : votre application fournit du texte écrit et reçoit la synthèse vocale générée. Parmi les utilisations courantes, on peut citer les présentations de produits, les descriptions pour l'accessibilité, les supports pédagogiques et les courtes voix off. Vous contrôlez le texte avant qu'il ne soit lu à voix haute, ce qui s'avère utile lorsque la formulation doit respecter un script approuvé.
Pour la transcription, le processus est inversé : on introduit un enregistrement audio et on obtient du texte en sortie. Un assistant vocal en temps réel ajoute une exigence supplémentaire : écouter et répondre dans le cadre d’une conversation. OpenAI’s documentation audio sépare ces flux de travail. Choisissez le point de terminaison « Speech » lorsque vous disposez déjà du texte que vous souhaitez faire lire à voix haute.
La génération de discours prend en charge la diffusion en continu, ce qui permet à une application de recevoir des données audio par blocs. L'enregistrement de ce flux dans un fichier ne déclenche pas automatiquement sa lecture dans un navigateur ni ne crée un agent conversationnel ; c'est toujours votre application qui gère la lecture et toute logique de conversation. OpenAI exige également que les auditeurs soient clairement informés que la voix est générée par l'IA.
Créez votre premier fichier audio avec l'API vocale OpenAI
Exécutez la requête sur un serveur ou sur votre machine de développement, en utilisant une clé API OpenAI enregistrée dans le fichier OPENAI_API_KEY variable d'environnement. Veillez à ne pas inclure la clé dans le code JavaScript du navigateur. Les exemples suivants utilisent le même script succinct de présentation du produit et enregistrent le résultat sous le nom openai-product-tour.mp3.
Option 1 : envoyer une requête Curl
API vocale OpenAI · curl
#!/bin/sh
# Définissez d'abord la variable OPENAI_API_KEY dans l'environnement de votre serveur.
curl --fail-with-body --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "Bienvenue dans la présentation du produit Acorn Studio. En trois étapes, vous pouvez transformer un court script en guide audio. Commencez par rédiger le message. Choisissez ensuite une voix. Enfin, enregistrez le fichier audio et testez la lecture sur votre téléphone.",
    "voice": "coral",
    "instructions": "Parlez clairement, d'un ton chaleureux et conversationnel.",
    "response_format": "mp3"
  }' \
  --output openai-product-tour.mp3
La réponse contient des octets audio ; il est donc préférable de l'enregistrer dans un fichier plutôt que d'essayer de l'analyser au format JSON. Le --fail-with-body Cette option attribue à curl un code de sortie indiquant un échec en cas d'erreur HTTP. Vérifiez ce code avant d'ouvrir le fichier : une réponse d'erreur peut tout de même laisser du contenu JSON dans le fichier nommé .mp3.
Option 2 : utiliser le SDK Python
Installez le paquet OpenAI à l'aide de la commande suivante : python -m pip install openai. Le SDK lit la clé API à partir de l'environnement. Cet exemple écrit la réponse au fur et à mesure de son arrivée, ce qui évite de charger l'intégralité de la réponse audio dans votre propre tampon Python.
API vocale OpenAI · Python
"""Installation : python -m pip install openai. Définissez la variable OPENAI_API_KEY sur le serveur."""
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
script = (
    "Bienvenue dans la présentation des produits Acorn Studio. En trois étapes, vous pouvez transformer "
    "un court script en guide audio. Tout d’abord, rédigez le message. Ensuite, "
    "choisissez une voix. Enfin, enregistrez le fichier audio et testez la lecture sur votre téléphone."
)

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=script,
    instructions="Parlez clairement, d’un ton chaleureux et conversationnel.",
    response_format="mp3",
) as response:
    response.stream_to_file(Path("openai-product-tour.mp3"))

print("Fichier openai-product-tour.mp3 enregistré")
Les trois domaines essentiels sont les suivants : modèle, entrée, et voix. Ici, instructions nécessite une interprétation chaleureuse et conversationnelle ; il guide la voix plutôt que d'ajouter des mots au texte parlé. Ce champ fonctionne avec GPT-4o Mini TTS et n'est pas pris en charge par tts-1 et tts-1-hd.
Pour un document plus long, divisez le texte au niveau des phrases ou des paragraphes, numérotez les segments et enregistrez chaque fichier avec ce numéro. Veillez à conserver le même ton et les mêmes instructions d’un segment à l’autre. Laissez suffisamment de contexte pour permettre une formulation naturelle, et écoutez attentivement les transitions avant de diffuser l’enregistrement final.
Choisissez un modèle, une voix et un format de sortie
| Modèle | Comment choisir | Instructions de livraison |
|---|---|---|
gpt-4o-mini-tts | Un point de départ pour une narration et une expression orale maîtrisées. | Soutien instructions en termes de ton, de style et de rythme. |
tts-1 | Le modèle OpenAI est conçu pour la génération de la parole à faible latence. | Utilisez les commandes vocales et de vitesse prises en charge ; omettez instructions. |
tts-1-hd | Le modèle OpenAI offre une qualité vocale supérieure à celle du modèle TTS-1. | Utilisez les commandes vocales et de vitesse prises en charge ; omettez instructions. |
Le Page du modèle GPT-4o Mini TTS associe l'alias du modèle à la gpt-4o-mini-tts-15-décembre-2025 instantané. Si la reproductibilité du comportement est importante pour votre application, choisissez délibérément un instantané documenté et enregistrez-le avec vos scripts sauvegardés.
Voix intégrées et limites d'entrée
La documentation de référence de l'API Speech répertorie 13 voix intégrées pour le GPT-4o Mini TTS : alliage, cendre, ballade, corail, écho, fable, onyx, nova, sauge, scintillement, vers, marin et cèdre. OpenAI recommande marin ou cèdre pour obtenir la meilleure qualité possible. C'est la recommandation de OpenAI : choisissez votre voix de synthèse en écoutant la façon dont vous prononcez vos propres noms, chiffres et structures de phrases.
Les anciens modèles TTS prennent en charge un ensemble plus restreint : alloy, ash, coral, echo, fable, onyx, nova, sage et shimmer. Ne partez pas du principe que toutes les voix fonctionnent avec tous les modèles. Le Référence de l'API Speech accepte également une vitesse comprise entre 0,25 et 4,0, avec 1.0 par défaut.
Il faut tenir compte de deux limites d'entrée : les limites de référence des points d'extrémité entrée à 4 096 caractères, et la page du modèle Mini TTS indique une limite maximale de 2 000 jetons d'entrée. Les caractères et les tokens ne sont pas mesurés de la même manière. Vérifiez les deux contraintes pour Mini TTS, en particulier avec des textes multilingues, et divisez les scripts volumineux avant de les envoyer.
Choisissez le format de fichier pour sa destination
| Format | Utilisation pratique |
|---|---|
| MP3 | Sortie par défaut : un fichier compressé pratique pour le partage et la lecture sur le Web. |
| Opus | Utile pour les applications de streaming et de communication prenant en charge ce codec. |
| AAC | Demandez-vous dans quels cas votre environnement de lecture ou votre flux de travail multimédia nécessite l'utilisation du format AAC. |
| FLAC | Compression sans perte pour les flux de travail nécessitant de conserver le signal audio. |
| WAV | Un fichier audio non compressé dans un format courant, facilitant le montage et le traitement. |
| PCM | Échantillons bruts à 24 kHz, 16 bits, signés, en format « little-endian », sans en-tête de fichier ; votre lecteur doit être configuré ainsi. |
Commencez par le format MP3 si vous souhaitez obtenir un lien de téléchargement ou utiliser un simple lecteur audio. Choisissez le format WAV si l'étape suivante consiste à modifier le fichier. Ne sélectionnez le format PCM brut que si votre application est capable de l'interpréter ; pour modifier le nom d'un fichier, passez de .pcm à .wav ne crée pas d'en-tête WAV.
Combien coûte l'API de reconnaissance vocale OpenAI ?
D'après les informations vérifiées le 28 septembre 2026, OpenAI répertorie le GPT-4o Mini TTS à $0,60 par million de tokens de texte saisi plus $12 par million de jetons de sortie audio. Coûts du TTS-1 $15 par million de caractères, et le prix du TTS-1 HD est de $30 par million de caractères. Calculez chaque modèle dans ses propres unités.
Tarification de l'API Speech : ne pas mélanger les unités
OpenAI facture son nouveau modèle de synthèse vocale à la base et ses deux modèles précédents à la lettre. GlobalGPT facture ses prestations de synthèse vocale en crédits.
| Itinéraire et modèle | Taux | Exemple |
|---|---|---|
| OpenAI · GPT-4o Mini TTS | $0,60 / 1 million de jetons de saisie de texte $12 / 1M jetons de sortie audio | $0.0606 pour 1 000 tokens d'entrée textuelle + 5 000 tokens de sortie audio |
| OpenAI · TTS-1 | $15 / 1 million de caractères | $0,015 pour 1 000 caractères |
| OpenAI · TTS-1 HD | $30 / 1 million de caractères | $0,030 pour 1 000 caractères |
| GlobalGPT · Eleven v3, Eleven Multilingual v2 ou Qwen Audio 3.0 TTS Flash | 330 crédits / 1 000 caractères | 330 crédits au tarif indiqué de 1 000 caractères ; demandez un devis avant de valider votre commande |
Il s'agit d'exemples de tarification, et non des tarifs correspondant aux extraits audio ci-dessous. Les jetons, les caractères, les minutes et les crédits sont des unités différentes. L'estimation de la tâche GlobalGPT indique le nombre de crédits applicable ; le tableau ne convertit pas les crédits en dollars.
Taux vérifiés le 28 septembre 2026. Sources : Tarification de l'API OpenAI et Documentation de l'API GlobalGPT.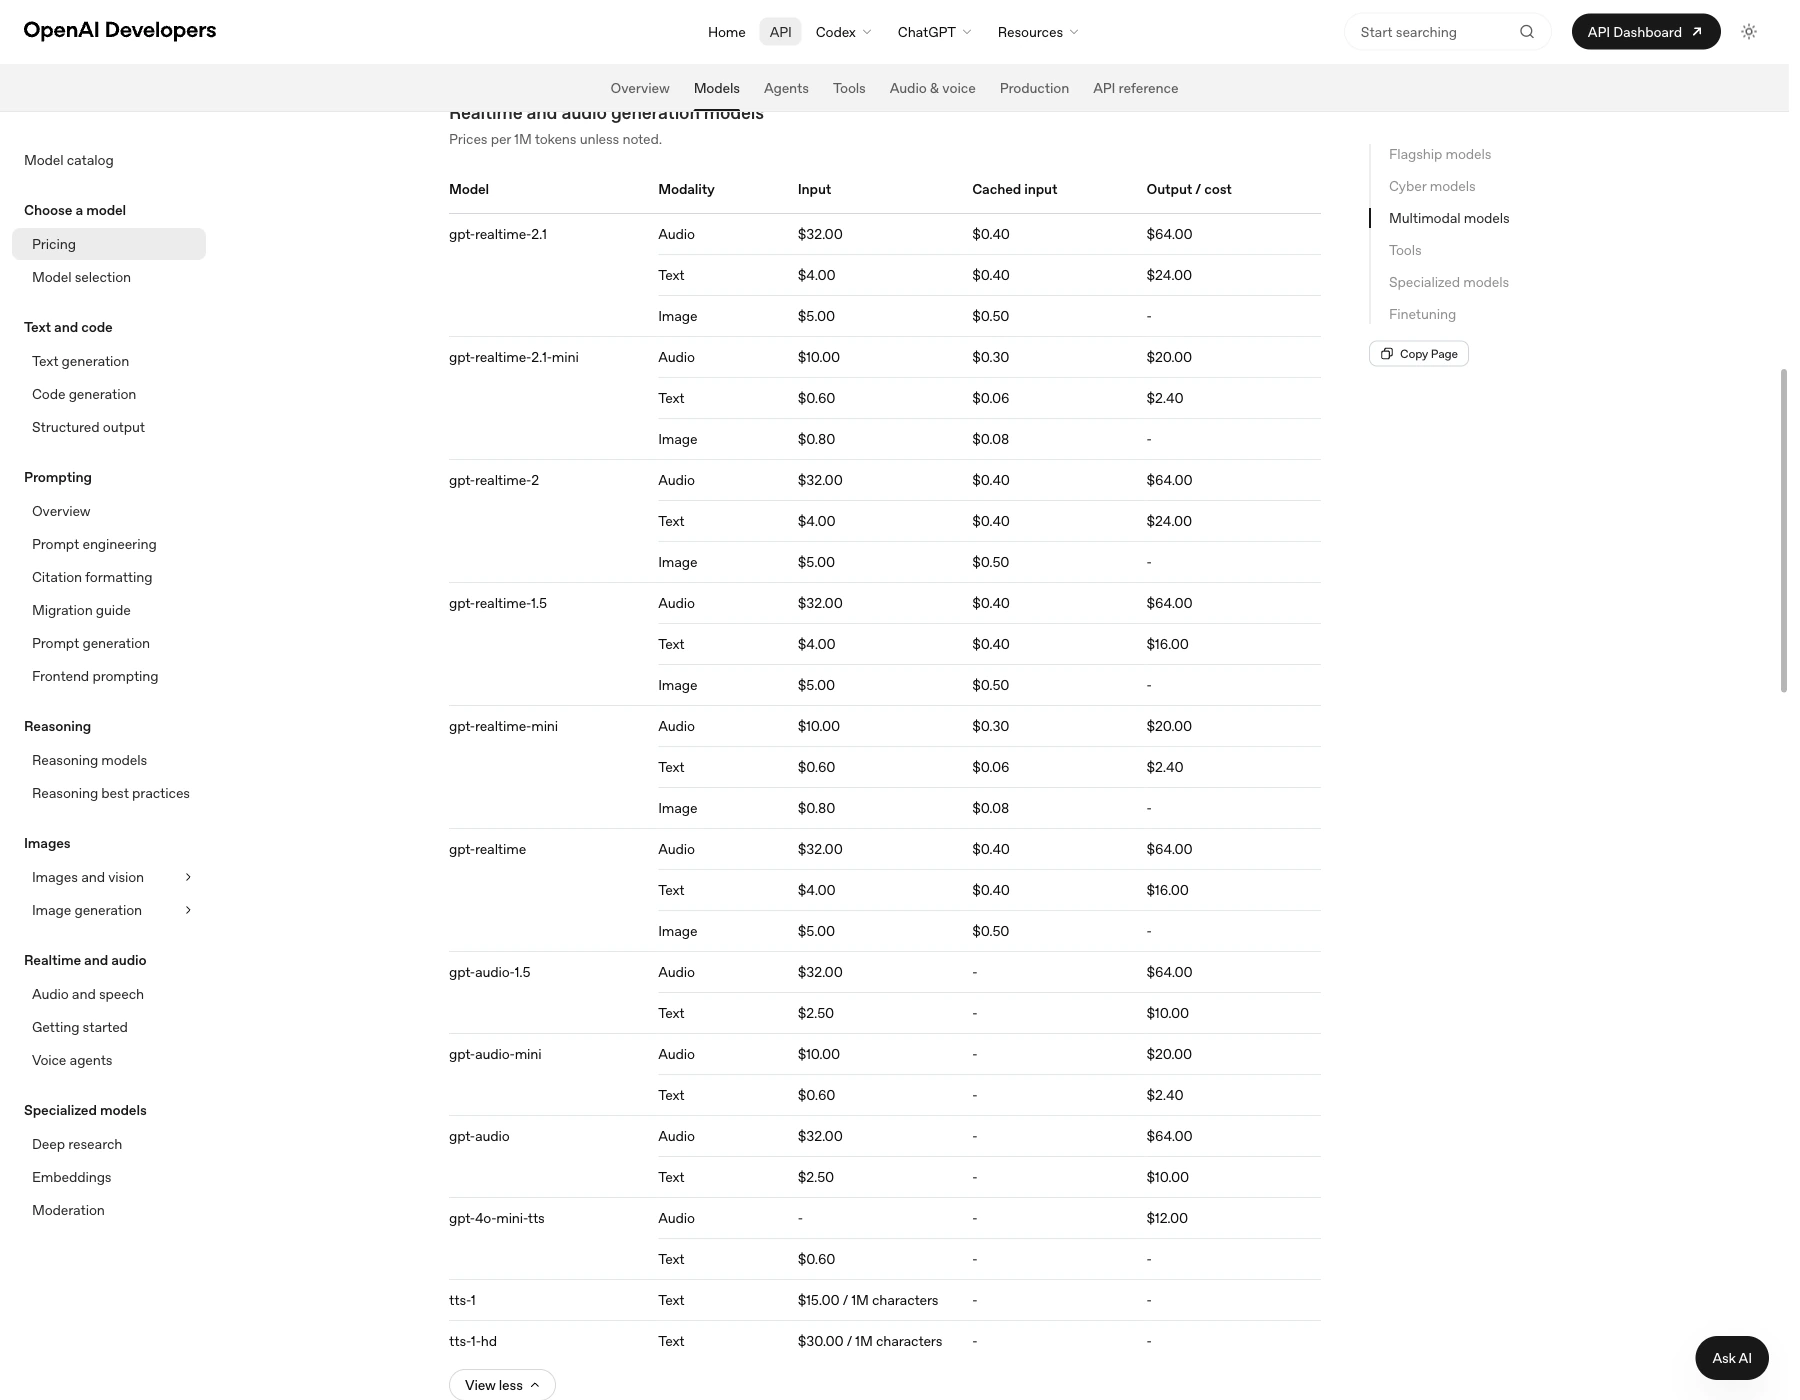
Par exemple, 100 scripts de 1 000 caractères chacun totalisent 100 000 caractères. Aux tarifs indiqués, cela représente $1.50 avec TTS-1 ou $3.00 avec TTS-1 HD, avant les autres coûts liés à l'application. Ce nombre de caractères ne suffit pas pour calculer avec précision le coût de Mini TTS : il faut connaître le nombre de jetons de saisie de texte et de sortie audio.
Estimez le coût de la génération de la parole
Saisissez les unités de facturation de l'itinéraire que vous avez choisi. Il n'y a pas de conversion automatique des caractères en jetons ni des minutes en jetons.
Formule : nombre de caractères × $15 ÷ 1 000 000. Le volume total de texte peut s'étendre sur plusieurs requêtes API.
Tarifs vérifiés le 28 septembre 2026 : OpenAI · GlobalGPT. Ne comprend pas le stockage, l'hébergement, les taxes et les autres éléments de votre application.
Pour la planification, saisissez les chiffres d'utilisation réels ou des hypothèses explicites dans le calculateur. Considérez le champ « Mini TTS audio-token » comme une donnée budgétaire jusqu'à ce que vous ayez mesuré l'utilisation. Ne transformez pas un chiffre approximatif par minute en un prix garanti pour chaque voix, rythme de parole ou langue.
Le catalogue du modèle GlobalGPT indique les prix du service TTS en crédits, et son point de terminaison d'estimation fournit un devis pour la requête que vous comptez envoyer. Veillez à distinguer l'utilisation des crédits API de votre abonnement à un espace de travail multimodèle destiné à vos tâches quotidiennes de rédaction et de traitement multimédia. Cela vous permettra de mieux suivre votre budget sans supposer que ces deux produits partagent le même plafond de facturation.
Créer un workflow de synthèse vocale avec l'API GlobalGPT
Pour un flux de travail reproductible allant du script à la voix puis à la vidéo, Créer un discours dans GlobalGPT et conserver le reste du projet dans le même espace de travail. Le API GlobalGPT présente la création de contenus médiatiques comme une série de tâches, tandis que le GlobalGPT CLI des connexions compatibles avec votre terminal et vos outils de développement.
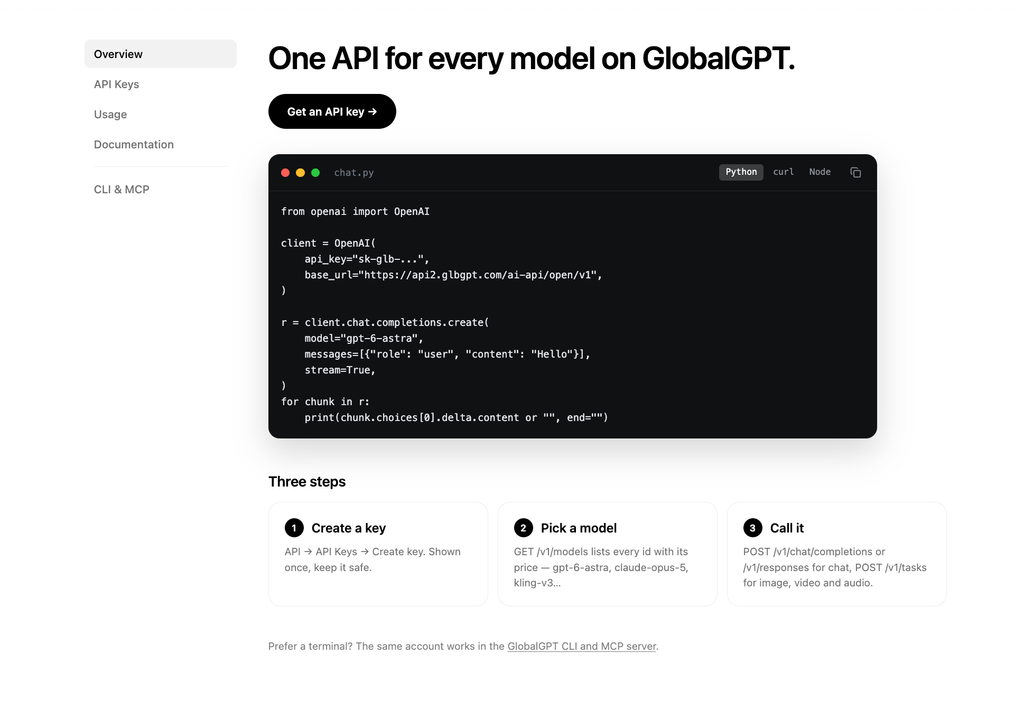
Utilisez l'URL de base publique https://api2.glbgpt.com/ai-api/open/v1. Envoyer les requêtes TTS à POST /tasks, requête GET /tasks/{id}, et télécharger output.url une fois la tâche réussie. Le champ de texte est rapide. Mettez directement en œuvre ce contrat de tâche ; il diffère de la réponse audio immédiate de OpenAI.
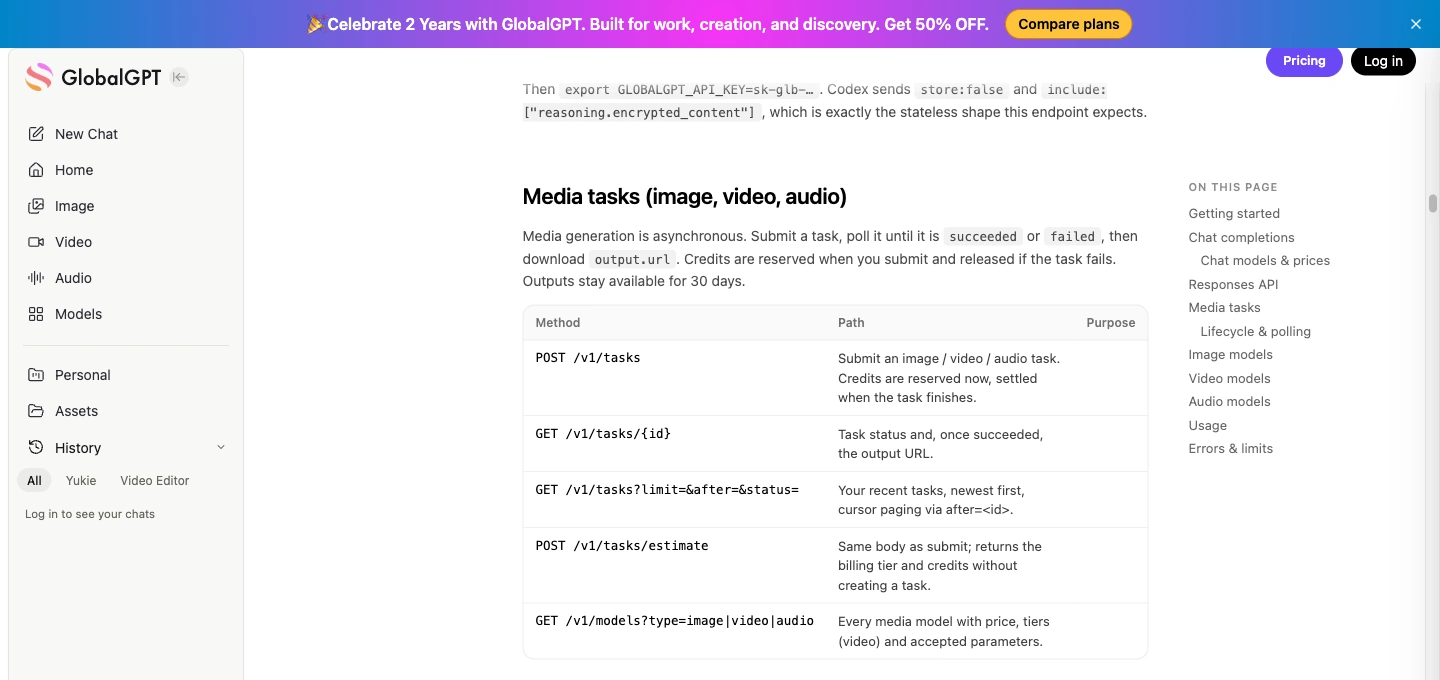
Choisissez un modèle TTS GlobalGPT dont les spécifications sont documentées
| Référence du modèle | Entrées et sorties | Distinction utile |
|---|---|---|
eleven-v3 | Jusqu'à 5 000 caractères ; MP3 | Prend en charge les balises audio expressives. |
eleven-multilingue-v2 | Jusqu'à 10 000 caractères ; MP3 | 29 langues ; les balises audio sont lues sous forme de texte. |
qwen-audio-3.0-tts-flash | Jusqu'à 4 096 caractères ; WAV | 49 voix ; les commandes vocales et linguistiques utilisent des champs spécifiques à Qwen. |
Liste des trois entrées 330 crédits pour 1 000 caractères. Utiliser POST /tasks/estimate avec le corps de requête prévu pour le devis concerné ; selon la documentation, cela ne crée aucune tâche et ne réserve aucun crédit. L'accès à l'API publique utilise des crédits payants.
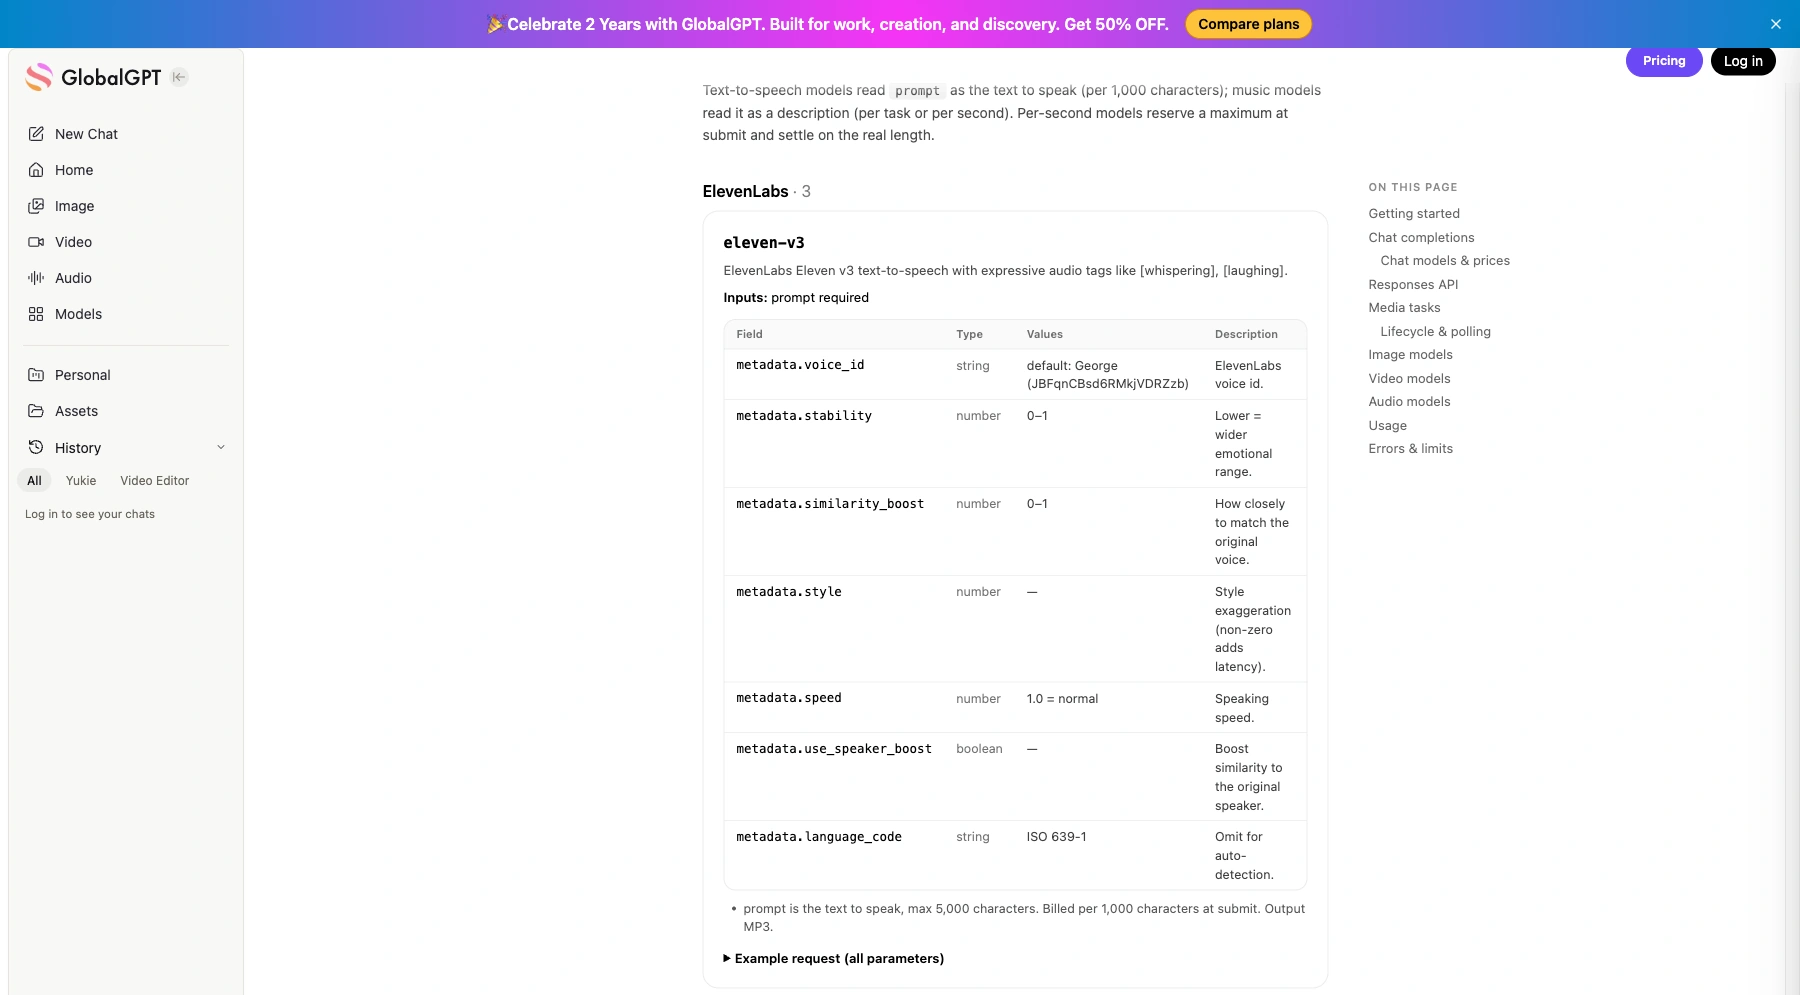
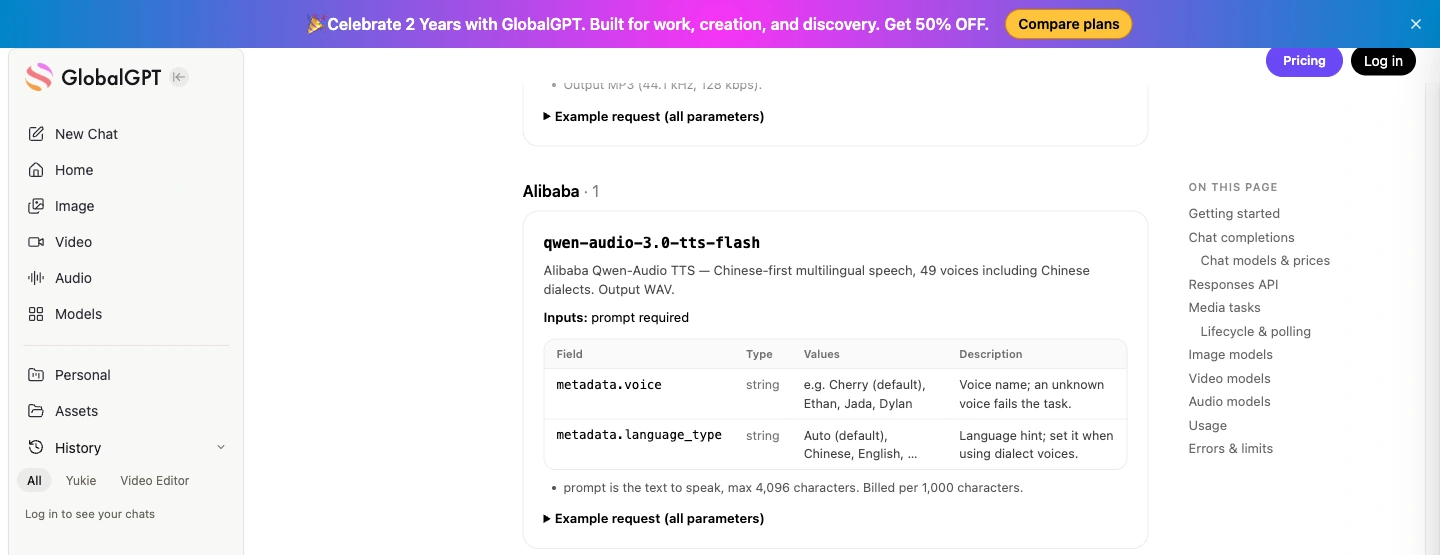
Pour en savoir plus sur le processus de création dans son ensemble, consultez Workflows de synthèse vocale dans GlobalGPT. Si vous effectuez des recherches sur la gamme open source Qwen3-TTS, qui porte un nom distinct, consultez Modèles Qwen3-TTS et options API; ne considérez pas l'identifiant de modèle « Qwen-Audio » ci-dessus comme un déploiement « Qwen3-TTS » interchangeable.
Établir un devis, le soumettre une seule fois, puis consulter la tâche enregistrée
Installer demandes avec python -m pip install requests et définir GLOBALGPT_API_KEY sur le serveur. L'exemple ci-dessous utilise Eleven v3, sélectionne un identifiant vocal public répertorié et définit un plafond indicatif de 500 crédits. Modifiez ce plafond en fonction de votre budget avant de lancer l'opération.
API publique GlobalGPT pour les tâches de synthèse vocale (TTS) · Python
"""Installe requests ; définit la variable GLOBALGPT_API_KEY. Utilise l'API publique de tâches de GlobalGPT."""
import json
import os
import time
import uuid
from pathlib import Path
import requests

BASE = "https://api2.glbgpt.com/ai-api/open/v1"
STATE = Path("globalgpt-tts-job.json")
OUTPUT = Path("globalgpt-product-tour.mp3")
MAX_CREDITS = 500  # Votre plafond par tâche ; modifiez cette valeur avant l'exécution.

payload = {
    "model": "eleven-v3",
    "prompt": (
 "Bienvenue dans la visite guidée du produit Acorn Studio. En trois étapes, vous pouvez transformer "
 " un court script en guide audio. Tout d’abord, rédigez le message. Ensuite, "
 " choisissez une voix. Enfin, enregistrez le fichier audio et testez la lecture sur votre téléphone. "
    ),
    "metadata": {
 "voice_id": "JBFqnCBsd6RMkjVDRZzb",
 "stability": 0.5,
 "language_code": "en",
    },
}

api = requests.Session()
api.headers["Authorization"] = "Bearer " + os.environ["GLOBALGPT_API_KEY"]

if STATE.exists():
    job = json.loads(STATE.read_text())
    if job["payload"] != payload:
    raise RuntimeError("Cette tâche correspond à une autre entrée. Utilisez un nouveau nom de fichier d'état.")
else:
    estimate = api.post(BASE + "/tasks/estimate", json=payload, timeout=30)
    estimate.raise_for_status()
    quote = estimate.json()
    print("Crédits estimés :", quote["credits"])
    si quote["credits"] > MAX_CREDITS :
  raise RuntimeError("L'estimation dépasse votre plafond par tâche.")
    job = {"payload": payload, "idempotency_key": str(uuid.uuid4())}
    STATE.write_text(json.dumps(job, indent=2))

si " task_id " n’est pas dans job :
    # La clé persistante conserve une nouvelle tentative de transport liée à cette requête précise.
    submitted = api.post(
 BASE + "/tasks", json=payload,
 headers={"Idempotency-Key": job["idempotency_key"]}, timeout=60,
    )
    submitted.raise_for_status()
    task = submitted.json()
    job["task_id"] = task["id"]
    STATE.write_text(json.dumps(job, indent=2))
    if task.get("ignored_parameters"):
 print("Paramètres ignorés :", task["ignored_parameters"])

print("Tâche :", job["task_id"])
deadline = time.monotonic() + 600
while time.monotonic() < deadline :
    checked = api.get(BASE + "/tasks/" + str(job["task_id"]), timeout=30)
    checked.raise_for_status()
    task = checked.json()
    if task.get("ignored_parameters"):
 print("Paramètres ignorés :", task["ignored_parameters"])
    si task["status"] == "failed" :
  raise RuntimeError("Échec de la génération : " + json.dumps(task.get("error", {})))
    si task["status"] == "succeeded" :
        # Utiliser une nouvelle requête : ne pas envoyer la clé API à l’hébergeur multimédia.
 audio = requests.get(task["output"]["url"], timeout=60)
 audio.raise_for_status()
        OUTPUT.write_bytes(audio.content)
 print("Enregistré :", OUTPUT)
 break
    time.sleep(10)
else:
    raise TimeoutError("Tâche toujours en attente. Relancez la tâche pour interroger l'ID de la tâche enregistrée.")
Le fichier de tâche enregistre la requête exacte, une clé d'idempotence et l'identifiant de la tâche. En cas de coupure de connexion, relancez la même tâche afin que le code puisse reprendre la tâche en cours. Pour générer intentionnellement un fichier audio différent, utilisez un nouveau nom de fichier de tâche. Veillez à ce que le fichier de tâche reste confidentiel si son script contient des informations confidentielles.
Vérifier paramètres_ignorés Ainsi, un paramètre non pris en charge ne devient pas automatiquement votre configuration par défaut. Les commandes ElevenLabs telles que voice_id diffèrent de ceux de Qwen voix et type_de_langue champs. Effectuer une interrogation toutes les 5 à 10 secondes, gérer un a échoué état, et enregistrez rapidement les fichiers traités avec succès : la durée de conservation des résultats indiquée est de 30 jours.
Écoutez deux exemples de présentation de produit
Ces deux échantillons générés par IA utilisent le même script de présentation du produit de 216 caractères avec Eleven v3 et Qwen Audio 3.0 TTS Flash. Chacun correspond au premier résultat obtenu à partir d’une requête, avec les paramètres vocaux par défaut. Ils vous fournissent deux fichiers courts à examiner et à écouter ; il ne s’agit pas d’une comparaison contrôlée de voix appariées ni d’un test de performance de la voix OpenAI.
Eleven v3 : audio de la présentation du produit
eleven-v3 · Exemple de présentation du produit
- Sortie
- MP3 · mono · 44,1 kHz
- Longueur
- Environ 15,6 secondes
- Génération
- Première sortie · 1 requête
Paramètres : le texte exact ci-dessous, la voix par défaut et d'autres paramètres ; aucune modification de la voix ni instruction de prononciation. L'identité vocale par défaut n'a pas été enregistrée.
État d'avancement et calendrier : La génération a abouti. Les horodatages du serveur indiquent un délai de 13 secondes entre l'envoi de la requête et son exécution ; il s'agit d'une seule requête, et non d'un test de latence.
Remarque concernant le fichier : Le fichier MP3 contient un flux mono à 44,1 kHz et pèse environ 251 ko. Ses trames peuvent être lues jusqu'à la fin du fichier.
Référence tarifaire : Le tarif du catalogue public est de 330 crédits pour 1 000 caractères. Utilisez une estimation du travail pour toute nouvelle demande ; ce tarif ne correspond pas à une facture pour l'échantillon.
Utilisation pratique : Un fichier MP3 compact permettant d'écouter une brève présentation du produit. Vérifiez le texte complet et la lecture sur votre appareil cible avant de l'utiliser dans une version finale.
Lire la saisie exacte · 216 caractères
Bienvenue dans la présentation des fonctionnalités d'Acorn Studio. En trois étapes, vous pouvez transformer un court script en audioguide. Tout d'abord, rédigez le message. Ensuite, choisissez une voix. Enfin, enregistrez le fichier audio et testez sa lecture sur votre téléphone.
Qwen Audio 3.0 TTS Flash : présentation audio du produit
qwen-audio-3.0-tts-flash · Exemple de présentation du produit
- Sortie
- WAV · mono · 24 kHz
- Longueur
- 15,52 secondes de données PCM
- Génération
- Première sortie · 1 requête
Paramètres : le texte exact ci-dessous, la voix par défaut et d'autres paramètres ; aucune modification de la voix ni instruction de prononciation. L'identité vocale par défaut n'a pas été enregistrée.
État d'avancement et calendrier : La génération a abouti. Les horodatages du serveur indiquent un délai de 17 secondes entre l'envoi de la requête et son exécution ; il s'agit ici d'une seule requête, et non d'un test de latence.
Remarque concernant le fichier : Le fichier WAV contient un signal PCM mono de 16 bits à 24 kHz et pèse environ 745 ko. Son en-tête indique un volume de données supérieur à celui que contient réellement le fichier ; la sortie d'origine est conservée ici.
Référence tarifaire : Le tarif du catalogue public est de 330 crédits pour 1 000 caractères. Utilisez une estimation du travail pour toute nouvelle demande ; ce tarif ne correspond pas à une facture pour l'échantillon.
Utilisation pratique : Un échantillon au format WAV permettant d'évaluer le processus de narration. Corrigez les incohérences de longueur d'en-tête dans votre pipeline de production et vérifiez la lecture complète avant la diffusion.
Lire la saisie exacte · 216 caractères
Bienvenue dans la présentation des fonctionnalités d'Acorn Studio. En trois étapes, vous pouvez transformer un court script en audioguide. Tout d'abord, rédigez le message. Ensuite, choisissez une voix. Enfin, enregistrez le fichier audio et testez sa lecture sur votre téléphone.
L'échantillon Qwen est environ trois fois plus volumineux que l'échantillon Eleven pour une durée similaire, ce qui s'explique par les différences entre les formats WAV et MP3. Son en-tête WAV indique également un volume de données supérieur à celui que le fichier contient physiquement. Il s'agit là d'un problème lié au conditionnement du fichier qu'il convient de vérifier dans votre lecteur cible ; cela ne permet pas en soi de tirer des conclusions sur la qualité de la voix enregistrée.
Résoudre les problèmes courants liés à la synthèse vocale
| Symptôme | Ce qu'il faut vérifier en premier |
|---|---|
| Le fichier MP3 enregistré ne s'ouvre pas | Vérifiez le statut HTTP et le type de réponse. Il se peut qu'une erreur d'API ait été enregistrée avec une extension audio. |
| La requête rejette une commande vocale ou une instruction | Faites correspondre la voix et les champs facultatifs au modèle sélectionné. Les anciens modèles de synthèse vocale OpenAI n'acceptent pas les instructions. |
| Un scénario trop long est rejeté | Vérifiez la limite de caractères de l'itinéraire et la limite de jetons Mini TTS, puis divisez le texte aux points de rupture naturels. |
| Une réponse 401 ou 429 s'affiche | Vérifiez la clé/le compte pour le code 401. Pour le code 429, distinguez les limites de débit d'un quota insuffisant avant de réessayer. |
| Une demande GlobalGPT est toujours en attente | Récupérez l'identifiant de la tâche enregistrée et vérifiez son statut ; un délai d'expiration ne justifie pas l'envoi d'une tâche en double. |
| La voix ne correspond pas aux paramètres demandés. | Vérifiez les métadonnées spécifiques au modèle et la liste `ignored_parameters` avant de considérer que le paramétrage a bien été appliqué. |
| La durée d'un fichier audio ou la barre de défilement semble incorrecte | Comparez les métadonnées du fichier avec le contenu multimédia réel et testez le fichier dans son intégralité dans votre lecteur cible. |
En cas d'erreur OpenAI, commencez par vérifier son Guide des codes d'erreur. Pour une tâche de type GlobalGPT, enregistrez l'identifiant de la tâche et les détails de l'erreur renvoyée. Pendant le développement, distinguez clairement les échecs de transport, les échecs de facturation et les enregistrements vocaux non conformes : chacun nécessite une solution différente.
Avant d'envoyer la narration, écoutez l'intégralité de l'enregistrement sur l'appareil que votre public utilisera. Vérifiez l'introduction, les noms et les chiffres, les transitions et la phrase de conclusion. Ajoutez une mention indiquant l'utilisation d'une voix générée par IA au début de la lecture, et conservez une copie du texte exact ainsi que des paramètres du modèle afin de pouvoir régénérer le script modifié de manière ciblée.
Foire aux questions
Qu'est-ce que le point de terminaison de l'API Audio Speech OpenAI ?
Utilisez l'https://api.openai.com/v1/audio/speech POST. Les champs obligatoires sont « model », « input » et « voice ». La réponse est un fichier audio généré ; le format par défaut est le MP3.
L'API OpenAI Speech est-elle gratuite ?
L'API Speech propose une tarification basée sur l'utilisation. Établissez votre budget en vous basant sur les tarifs actuels de l'API plutôt qu'en partant du principe qu'un contingent gratuit est inclus : le service GPT-4o Mini TTS est facturé en fonction des jetons de saisie de texte et de sortie audio, tandis que les services TTS-1 et TTS-1 HD sont facturés au caractère.
Puis-je choisir la voix et le style d'expression ?
Choisissez une voix prise en charge par votre modèle. GPT-4o Mini TTS accepte également des instructions concernant le ton de la lecture, comme un ton chaleureux ou calme. Le champ « Instructions » ne fonctionne pas avec les modèles TTS-1 ou TTS-1 HD.
L'API Speech prend-elle en charge la diffusion en continu ?
Oui. Il est possible de diffuser le son généré par tranches. Votre application doit toutefois prendre en charge la lecture ; la diffusion de la synthèse vocale ne suffit pas à elle seule à permettre une conversation vocale en direct complète.
Puis-je utiliser GlobalGPT en modifiant l'URL de base de OpenAI ?
Utilisez le workflow de tâches multimédia documenté de GlobalGPT pour la synthèse vocale (TTS) : envoyez la requête POST à /tasks, interrogez la requête GET à /tasks/{id}, puis téléchargez le fichier output.url une fois l'opération réussie. Son catalogue de synthèse vocale documenté comprend les modèles ElevenLabs et Qwen, chacun doté de son propre identifiant et de ses propres paramètres.
Par quel format audio devrais-je commencer ?
Commencez par le format MP3 pour un téléchargement simple ou une lecture en ligne. Le format WAV est utile lorsque l'étape suivante consiste à effectuer des modifications. Le format PCM brut nécessite un lecteur configuré pour sa fréquence d'échantillonnage et sa profondeur de bits, car il ne comporte pas d'en-tête de fichier.
Commencez par un script court, une voix et un fichier enregistré. Une fois que la lecture et les coûts sont prévisibles, ajoutez le découpage en segments, les tentatives de reprise et le reste de votre flux de travail multimédia. Veillez à regrouper dans votre implémentation le format de requête, les unités de facturation et la gestion des résultats de l’API choisie.
Donnez une voix à votre prochain scénario
Rédigez un bref guide de présentation du produit, créez une voix off avec ElevenLabs ou Qwen, puis poursuivez avec des images et des vidéos dans l'espace de travail multimodèle de GlobalGPT.
Créer un fichier audio vocal avec GlobalGPT








