Mis à jour le 18 septembre 2026.
Notre verdict : GPT-6 Astra a fourni des réponses exploitables lors de nos trois tests : le rapprochement des commandes, une fonction d’agrégation en Python et la recherche d’une politique comportant 500 notes. Il a géré correctement les valeurs manquantes et les règles contradictoires, et la fonction qu’il a générée a passé avec succès 10 contrôles hors ligne. Cela en fait une option à envisager pour des travaux d’analyse minutieux — mais trois petits tests ne suffisent pas à établir sa fiabilité en production ni sa supériorité par rapport à d’autres modèles.
Nous avons appelé gpt-6-astra via le service de modèles basé sur l'interface en ligne de commande (CLI) de GlobalGPT, en utilisant des données d'entrée synthétiques et en enregistrant les réponses brutes. Il ne s'agissait ni d'un test direct de l'API OpenAI, ni d'un test d'abonnement ChatGPT. Dans ce lot, les appels de bout en bout ont duré entre 4,87 et 9,07 secondes, et le solde du compte a diminué de 391,08 crédits.
Ce comparatif présente les critères que nous avons évalués, les résultats fournis par l'Astra, les éléments qui ont satisfait aux critères et les limites des données disponibles. Les caractéristiques techniques officielles et les prix figurent dans un encadré distinct de nos mesures.

Sommaire
- Résultats des essais pratiques du GPT-6 Astra
- Comment nous avons testé Astra via l'API
- Test n° 1 : Astra est-il capable de harmoniser des données de commande incohérentes ?
- Test n° 2 : le code généré fonctionne-t-il réellement ?
- Test n° 3 : Est-il capable de résoudre les conflits entre règles dans un paquet de grande taille ?
- Coût de ces tests d'API et d'itinéraires
- Le GPT-6 Astra est-il disponible ?
- Caractéristiques techniques de l'Astra GPT-6
- Tarifs de l'API GPT-6 Astra
- Quelles sont les véritables nouveautés de GPT-6 Astra ?
- Pourquoi Astra influence la décision d'achat
- Ce qu’en disent les premiers critiques
- Limites initiales et questions en suspens
- À qui s'adresse GPT-6 Astra ?
- Choisissez l'Astra ou un modèle plus petit en fonction de la tâche à accomplir
- Ce que cette étude ne prouve toujours pas
- Foire aux questions
Résultats des essais pratiques du GPT-6 Astra
| Test | Résultat observé | Durée du trajet | Jetons d'entrée / de sortie | Crédits de grand livre |
|---|---|---|---|---|
| Rapprochement des commandes | 5/5 vérifications de réponses réussies | 5,663 s | 2,171 / 144 | 67 |
| Fonction d'agrégation en Python | 10 cas hors ligne sur 10 ont été traités avec succès | 9,065 s | 2,091 / 486 | 105 |
| Dossier de politique comprenant 500 notes | 6 réponses correctes sur 6 ; sources requises fournies pour les six | 4,868 s | 17,445 / 160 | 219 |
Il s'agit de trois tâches distinctes, chacune impliquant un seul appel de modèle ; il ne s'agit ni d'essais répétés ni d'un taux de réussite mesuré de 100%. Le temps mesuré couvre l'intégralité de la requête CLI/fournisseur jusqu'à la retour du résultat ; nous n'avons pas mesuré le temps nécessaire pour obtenir le premier jeton. Le registre affiche les crédits entiers, tandis que la variation du solde inclut les fractions.
Comment nous avons testé Astra via l'API
Nous avons utilisé le même compte GlobalGPT existant pour les trois appels. Chacun d'entre eux constituait une nouvelle requête sans état, la tâche étant fournie sous forme de fichier texte. L'étiquette du modèle demandée et renvoyée était gpt-6-astra. Le service a renvoyé un texte de réponse, des informations sur l'utilisation des jetons d'entrée/sortie et un champ d'erreur ; aucun de ces trois résultats n'a signalé d'erreur. L'étiquetage par le fournisseur ne constitue pas un audit indépendant du parcours du modèle en amont.
Nous avons préparé le corrigé des ordres et les réponses aux paquets de règles avant les essais. Nous avons ensuite validé le code généré en local à l’aide de 10 cas élaborés après sa réception ; il ne s’agissait pas d’un benchmark de codage préenregistré. Nous avons demandé un format JSON dans la consigne et vérifié s’il était correctement analysé, plutôt que d’activer un schéma natif de sortie structurée.
Toutes les données d'entrée ont été inventées. Aucun dossier client, dossier d'entreprise, secret comptable ni donnée personnelle n'a été transmis. Nous n'avons fourni aucun outil de navigation ni de contrôle de l'ordinateur pour ces tâches, et nous n'avons pas réessayé de répondre à une question afin d'améliorer son score. L'interface CLI n'a pas révélé le paramètre d'effort de raisonnement ni la répartition des jetons mis en cache pour ces exécutions.
Test n° 1 : Astra est-il capable de harmoniser des données de commande incohérentes ?
Les exercices et le corrigé
Le fichier CSV de huit lignes comprenait un doublon plus ancien, un remplacement plus récent, une commande en attente, des remboursements et une commande sans montant brut. Les règles consistaient à conserver la version la plus récente de chaque commande, à exclure les paiements en attente, à soustraire les remboursements et à traiter les recettes manquantes comme « inconnues ».
Le chiffre d'affaires net prévu, tel qu'il était connu, s'élevait à $275: Recherche $170, e-mail $75 et réseau social $30. La lettre A nécessitait une déduplication, la lettre C une exclusion, et la lettre F devait rester inconnue. Un total correct ne suffisait pas à lui seul pour satisfaire aux cinq vérifications.
Ce qu'Astra a rendu
{"known_net_usd":275,"channel_known_net_usd":{"Recherche":170,"E-mail":75,"Réseaux sociaux":30},"unknown_order_ids":["F"],"excluded_order_ids":["C"],"replaced_order_ids":["A"]}
Les cinq vérifications ont toutes été validées. Plus important encore, la conclusion indiquait : “ Le chiffre d'affaires net total reste inconnu, car le chiffre d'affaires brut de la commande F n'est pas renseigné. ” Il a correctement désigné Search comme le plus grand connu sous-total, sans considérer que la commande par e-mail manquante avait une valeur nulle.
Notre avis : C'était un bon résultat pour une tâche de rapprochement de petite envergure. Le modèle a respecté les règles comptables et a pris en compte les incertitudes. Il ne s'agissait pas de tester une connexion à une feuille de calcul en temps réel, des milliers de transactions, la conformité fiscale ou des décisions financières autonomes.
Test n° 2 : le code généré fonctionne-t-il réellement ?
Remplacer un calcul de recettes erroné
Nous avons fourni le modèle défectueux sum(float(r.get('gross_usd') or 0) for r in records) et a demandé une fonction entièrement en Python capable de gérer les mises à jour de doublons, le statut des paiements, les remboursements, les valeurs manquantes, les listes d'identifiants triées et les entrées vides. Elle devait utiliser des centimes sous forme d'entiers en interne et ne pas modifier les enregistrements d'entrée.
Astra a renvoyé une fonction qui utilise Décimal pour convertir les montants en centimes, conserve la dernière valeur enregistrée par commande et ignore les montants bruts inconnus au lieu d'insérer un zéro. Nous avons décodé les séquences d'échappement de saut de ligne dans la chaîne de code renvoyée, examiné ses importations et ses opérations, puis l'avons exécuté localement sans modifier sa logique.
Dix contrôles hors ligne
| Cas | Résultat |
|---|---|
| Rapprochement original à huit lignes | Passer |
| Champ de saisie vide | Passer |
| L'enregistrement le plus récent apparaît avant l'enregistrement le plus ancien | Passer |
| La dernière mise à jour a modifié un ordre, qui est désormais en attente | Passer |
| Montants bruts vides ou nuls | Passer |
| Si le montant du remboursement n'est pas indiqué, la valeur par défaut est zéro. | Passer |
| Calcul de 0,10 + 0,20 cent | Passer |
| Remboursements intégraux et partiels | Passer |
| Une chaîne dont les recettes sont entièrement inconnues | Passer |
| Identifiants inconnus triés et exclus | Passer |
L'immuabilité des données d'entrée a également été respectée dans les 10 cas. Notre avis : la fonction était utilisable dans le cadre du contrat défini, et son exécution locale constituait une preuve plus solide qu’un simple exemple de code plausible. Nous n’avons pas testé les horodatages erronés, les devises multiples, le déploiement, un dépôt réel, les transactions de base de données ni les performances à grande échelle.
Test n° 3 : Est-il capable de résoudre les conflits entre règles dans un paquet de grande taille ?
Cinq notes pertinentes parmi 500
Nous avons constitué un ensemble de 73 252 caractères comprenant 500 notes numérotées. Les faits pertinents étaient répartis entre les notes 037, 114, 261, 398 et 477 : une ancienne règle de remboursement sous 30 jours, une règle standard plus récente de 14 jours, une exception d’entreprise de 30 jours, un changement de propriétaire, la comparaison entre les tarifs annuels et mensuels, ainsi qu’une question pour laquelle les éléments de preuve faisaient défaut.
La requête complète a été transmise 17 445 jetons d'entrée. Il s'agit d'un test modeste portant sur des documents volumineux, bien en deçà de la capacité annoncée par Astra, qui est de 1,05 million de tokens. Les notes contextuelles n'étaient que de simples éléments de distraction ; la tâche s'est donc avérée plus facile qu'avec un ensemble de documents réels, souvent désordonnés.
Règles, prix et incertitude
| Question | La réponse d'Astra | Pièces justificatives requises |
|---|---|---|
| Période standard de remboursement dans le Nord | 14 jours | 114 |
| Période de remboursement pour les entreprises du Nord | 30 jours | 477 |
| Actuel propriétaire de North | Lin | 114 |
| Paiement annuel Atlas | $129.60 | 261 |
| Équivalent mensuel Atlas | $10.80 | 261 |
| Droit au remboursement en espèces dans le Sud | null / inconnu | 398 |
Les six réponses étaient toutes correctes et comprenaient les notes justificatives requises. Pour la réponse standard relative au remboursement, elle mentionnait en outre la note d'exception « entreprise », qui constituait un contexte pertinent. Elle a renvoyé les identifiants des notes sous forme de chaînes de caractères ; aucun schéma d'identifiant numérique n'avait été exigé.
Notre avis : Astra a correctement traité la révision et l'exception, sans inventer le droit manquant. Il s'agit là d'un élément de preuve utile pour la synthèse de politiques bornées. Cela ne valide toutefois pas la recherche en temps réel, les documents juridiques arbitraires, la recherche d'éléments spécifiques parmi près d'un million de jetons, ni la résistance aux instructions malveillantes intégrées dans les sources.
Coût de ces tests d'API et d'itinéraires
Les trois courses signalées 21 707 jetons d'entrée et 790 jetons de sortie. Le grand livre de GlobalGPT affichait 67, 105 et 219 crédits ; le solde du compte est passé de 15 477,71 à 15 086,63 crédits, soit une baisse de 391,08 crédits. Nous ne convertissons pas ces crédits en une charge de trésorerie fictive.
À titre d'exemple de calcul budgétaire distinct, l'application des tarifs standard de OpenAI pour les contextes courts — à savoir $10 par million de jetons d'entrée non mis en cache et $50 par million de jetons de sortie — aux chiffres indiqués donne environ $0.2566: $0,0289 pour les commandes, $0,0452 pour le code et $0,1825 pour le paquet. Ces chiffres supposent que les données d'entrée ne sont pas mises en cache et qu'il n'y a pas de frais supplémentaires. Il ne s'agit pas de la facture relative à nos appels GlobalGPT ni d'un coût direct mesuré de type OpenAI.
Dans ce lot, l'exécution par paquets s'est avérée plus rapide que celle du code, malgré un nombre plus élevé de tokens en entrée. Une seule exécution par tâche ne permet pas d'établir un classement en termes de latence : la longueur de la sortie, le routage, les conditions de mise en file d'attente et de traitement peuvent tous varier. Nous n'avons pas effectué de comparaison avec un concurrent équivalent.
Le GPT-6 Astra est-il disponible ?
Oui. Astra figure dans le catalogue de GlobalGPT, et les trois nouvelles requêtes ont toutes renvoyé un résultat intitulé « gpt-6-astra ». OpenAI publie également une documentation sur les modèles API ; les accès à Chat, Work et Codex correspondent à des droits d'utilisation distincts pour chaque produit.
Les captures d'écran ci-dessous, datées du 4 septembre, remontent à la période de lancement. Le libellé utilisé lors de leur mise en ligne est obsolète et ne prouve en rien que l'entrée GlobalGPT ne soit plus disponible aujourd'hui.
Caractéristiques techniques de l'Astra GPT-6
Astra accepte des entrées sous forme de texte et d’images et génère des sorties textuelles. Sa fenêtre de contexte de 1,05 million de tokens correspond à l’échelle requise pour les grands référentiels, les collections de documents ou les longs historiques d’agents, tandis que son plafond de sortie de 128 000 tokens lui laisse suffisamment de marge pour traiter des codes ou des rapports volumineux.
La capacité n'est pas synonyme de qualité. Une fenêtre d'un million de jetons ne garantit pas que chaque détail sera mémorisé avec la même précision, et l'envoi d'un maximum de contexte peut augmenter à la fois le coût et le bruit. Pour les travaux pratiques impliquant un contexte étendu, récupérez d'abord les fichiers les plus pertinents et veillez à ce que les instructions de la tâche soient explicites.
Si vous souhaitez avoir un point de référence sur la manière dont la génération précédente traitait les requêtes volumineuses, consultez le Guide des tarifs et du contexte du GPT-5.5. Pour une vision plus globale axée sur les tâches, le guide des cas d'utilisation du GPT-5.5 permet d'identifier les charges de travail susceptibles de justifier l'utilisation d'un modèle haut de gamme.
Tarifs de l'API GPT-6 Astra
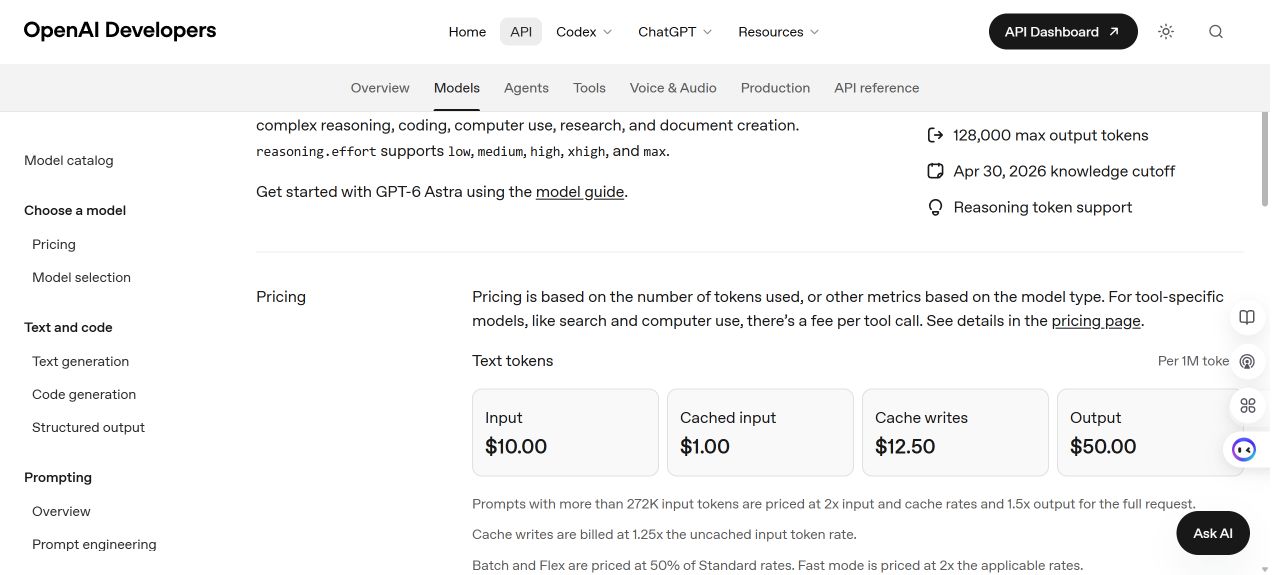
Le document OpenAI répertorie les taux de traitement standard suivants pour les requêtes comportant jusqu'à 272 000 tokens d'entrée :
Taux vérifiés à nouveau le 18 septembre 2026 par rapport à Tarification de l'API OpenAI. Il s'agit des tarifs standard des jetons API, et non des prix d'abonnement ChatGPT ni des frais de crédit GlobalGPT.
| Catégorie de jeton | Prix pour 1 million de jetons | Ce que cela signifie |
|---|---|---|
| Entrée | $10.00 | Nouveau contenu de la demande, historique, documents récupérés et autres éléments facturables. |
| Entrée mise en cache | $1.00 | Les entrées répétées éligibles sont fournies grâce à la mise en cache des invites. |
| Écriture dans le cache | $12.50 | Les données écrites dans le cache sont facturées selon la tarification applicable à l'écriture dans le cache. |
| Sortie | $50.00 | Réponse générée et justification facturable. |
Dès qu'une requête dépasse 272 000 jetons d'entrée, OpenAI applique un Multiplicateur x2 pour les débits d'entrée et d'entrée mise en cache et un Multiplicateur de 1,5 pour les taux de production pour la requête complète. Aux tarifs standard indiqués, cela correspond à $20 par million de jetons d'entrée et à $75 par million de jetons de sortie.
Limite tarifaire :
Il s'agit des tarifs des jetons API OpenAI, et non des prix mensuels d'abonnement ChatGPT ni des crédits GlobalGPT. Les frais liés aux outils, les paliers de traitement, les paramètres régionaux et d'autres frais peuvent modifier le coût final.
Pour connaître l'évolution historique des tarifs, voir Tarification GPT-5.6 et les tarifs du GPT-5.4. Comparez la charge de travail dans son ensemble, et pas seulement le tarif à l'entrée : la longueur de la sortie, le comportement du cache, l'utilisation des outils, ainsi que les taux d'échec ou de nouvelle tentative peuvent avoir plus d'importance que le prix affiché.
Quelles sont les véritables nouveautés de GPT-6 Astra ?
L'équipe d'OpenAI Guide des derniers modèles met l'accent sur un ensemble de fonctionnalités destinées à l'exécution de tâches interactives de longue durée par des agents.
Appel asynchrone d'outils
Astra peut continuer à progresser alors que des outils plus lents sont encore en cours d'exécution, au lieu de considérer chaque appel d'outil comme un arrêt complet. Cela peut faciliter la recherche, le développement et les tâches opérationnelles qui combinent plusieurs systèmes externes présentant des temps de réponse différents.
Instructions en cours de tâche
Les utilisateurs peuvent apporter des précisions pendant qu'une tâche est en cours d'exécution. Cela s'avère utile lorsqu'un agent est globalement sur la bonne voie, mais qu'il a besoin d'une nouvelle contrainte, d'un changement de priorité ou d'un périmètre plus restreint. Cela devrait permettre d'éviter d'avoir à annuler une tâche en cours et à tout recommencer.
Effort de raisonnement dynamique
Astra peut ajuster le niveau de raisonnement qu'elle met en œuvre lors d'une tâche. En principe, cela lui permet de consacrer davantage d'efforts aux étapes difficiles et moins aux étapes routinières. Les équipes doivent toutefois vérifier si le gain de qualité justifie le surcoût en jetons de sortie pour leur propre charge de travail.
Utilisation de l'ordinateur et continuité des tâches de longue durée
La version OpenAI positionne Astra pour une interaction informatique et des tâches s’étalant sur plusieurs étapes. La question pratique n’est pas de savoir si le système est capable de parcourir une démo en cliquant, mais s’il est capable de se remettre d’états inattendus, de préserver l’intention de l’utilisateur et d’expliquer ce qu’il a modifié. Ce sont là les aspects que les premiers utilisateurs devraient évaluer.
Les lecteurs intéressés par l'évolution des conversations délibératives vers des systèmes utilisant des outils peuvent également consulter GPT-5.4 Réflexion et ce guide d'utilisation de l'agent ChatGPT.
Pourquoi Astra influence la décision d'achat
Le changement majeur réside dans le fait de ne plus évaluer une IA en fonction de la qualité d'une seule réponse, mais de déterminer si elle est capable de mener à bien une tâche dans son intégralité. Un agent utile peut être amené à examiner des fichiers, utiliser des logiciels, attendre la mise à disposition d'outils, corriger des erreurs, appliquer une modification, effectuer des vérifications et expliquer le résultat. La réponse finale ne constitue qu'une étape de cette séquence.
Cela modifie également la question du coût. Les tarifs des jetons d’Astra sont élevés, mais le prix du jeton à lui seul ne permet pas de déterminer si la solution est rentable. Une meilleure comparaison consiste à coût par tâche menée à bien: les coûts liés au modèle et aux outils, les nouvelles tentatives, le temps écoulé, la supervision humaine et le nettoyage, tout cela compte. Un modèle moins cher peut s’avérer plus coûteux au final s’il nécessite des corrections répétées ; une exécution coûteuse reste un gaspillage si elle s’égare ou produit un résultat qui doit être refait.
Indicateur pratique :
Suivez le coût total, le taux d'achèvement, le nombre de minutes-homme, les nouvelles tentatives et les défauts pour une même tâche représentative. Ne comparez pas les modèles en vous basant uniquement sur les tarifs à l'unité ou sur une seule démo soignée.
Une plus grande autonomie impose également des exigences plus strictes en matière de contrôles. Selon les dernières recommandations du modèle OpenAI, Astra fait l’objet d’une surveillance asynchrone des désalignements. Les équipes doivent toujours n’accorder à un agent que les autorisations minimales dont il a besoin, exiger une confirmation avant toute action ayant des conséquences importantes, conserver un historique des actions et mettre en place des points de contrôle permettant de revenir sur les modifications. Une utilisation intensive de l'informatique n'a de valeur que lorsque le système environnant limite les risques de défaillance.
Ce qu’en disent les premiers critiques
Expérience précoce attribuée
Matt Shumer’s Première critique de l'Astra C'est l'un des comptes rendus publics les plus détaillés disponibles au moment du lancement. Il décrit le modèle comme performant en matière d'ingénierie backend, d'utilisation de l'ordinateur, de compréhension des requêtes insuffisamment précisées, de présentation claire de son travail et de maintien de la cohérence tout au long de longues conversations.
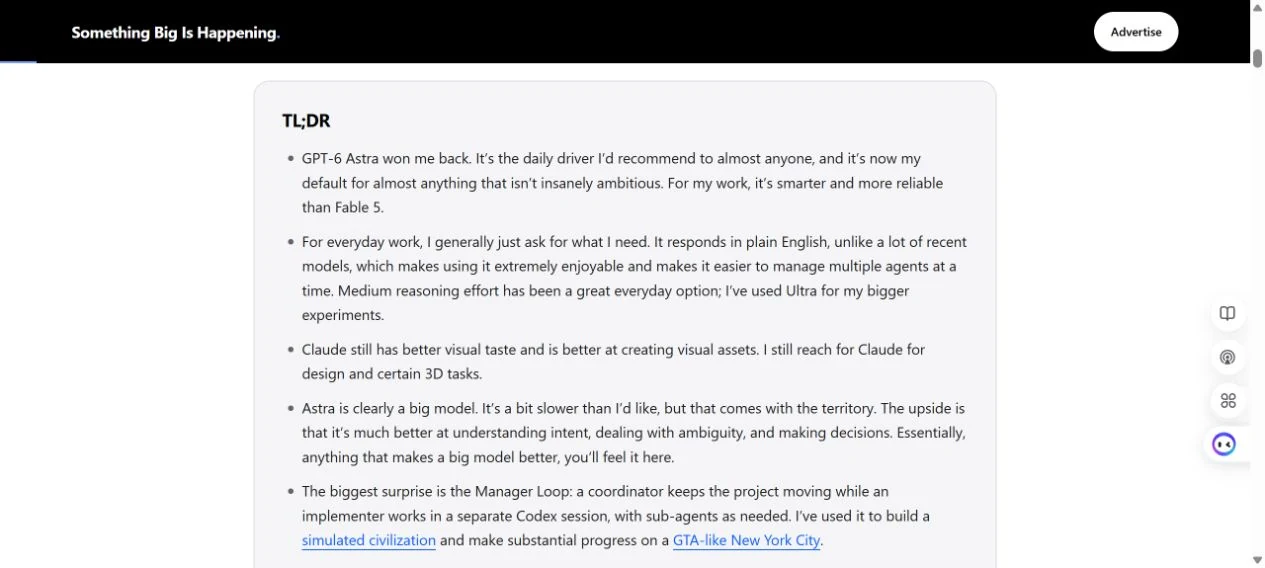
Ingénierie backend
Cette analyse met en évidence les performances utiles du modèle dans le cadre de travaux de mise en œuvre complexes, en particulier lorsque celui-ci doit comprendre un système dans son ensemble plutôt que de produire un petit extrait isolé.
Utilisation de l'ordinateur
Astra serait capable de gérer des tâches de type navigateur et bureau en tenant davantage compte de l'objectif global, même si cela ne supprime pas la nécessité d'autorisations et de vérifications.
Intention ambiguë
Ce modèle est présenté comme plus performant pour déduire ce qu'un utilisateur cherche à faire à partir d'instructions incomplètes.
Continuité et rapports
L'étude reconnaît à Astra le mérite de conserver le contexte tout au long de longues sessions et de fournir des comptes rendus plus clairs de ce qu'elle a accompli.
Il s'agit là d'observations qualitatives formulées par un autre évaluateur. Elles permettent d'identifier les fonctionnalités qu'il convient de tester, mais elles ne constituent pas nos propres mesures et ne permettent pas d'établir la fiabilité générale du produit.
Limites initiales et questions en suspens
Cette même analyse soulève également des préoccupations importantes. Astra peut se montrer lent, consommer de grandes quantités de jetons et avoir tendance à se perdre dans les détails lors de longues sessions de travail en autonomie. Shumer signale également que ses résultats en matière de conception visuelle peuvent être inférieurs à ceux de Claude, même lorsque son fonctionnement en arrière-plan est performant.
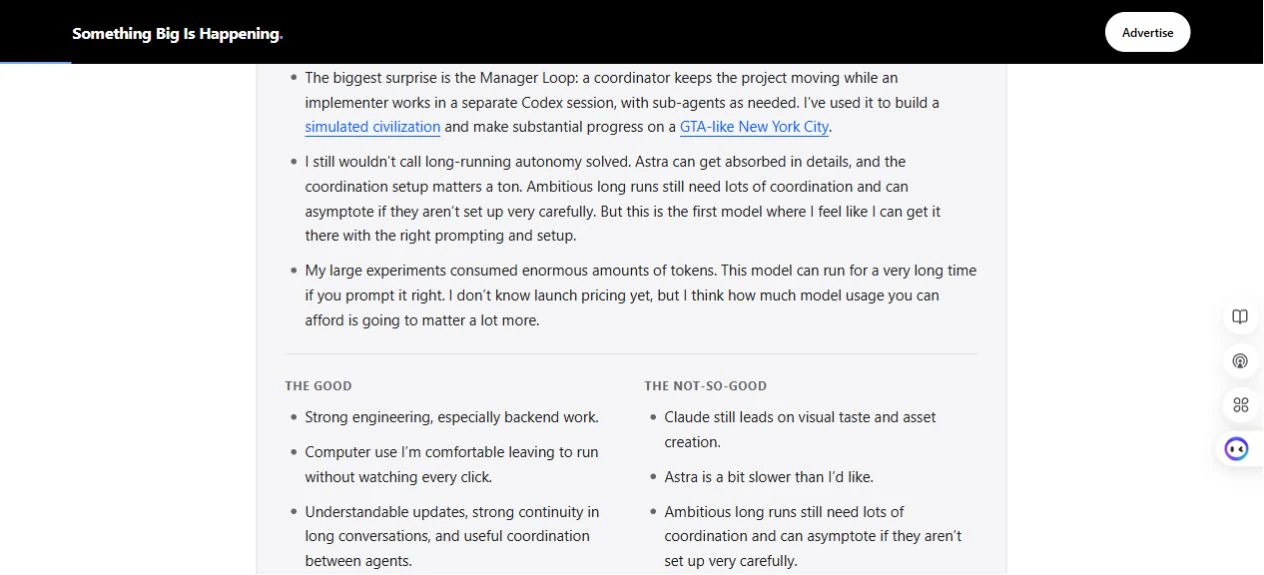
- Vitesse : Un modèle capable de raisonner, d'utiliser des outils et de vérifier son travail peut prendre plus de temps qu'un modèle de chat allégé.
- Autonomie : Le fait qu’il fonctionne de manière autonome ne signifie pas pour autant qu’il ne nécessite aucune surveillance. L’évaluateur a tout de même relevé des moments où le modèle avait besoin d’être coordonné ou réorienté.
- Utilisation des jetons : Un contexte volumineux et un raisonnement approfondi peuvent rapidement devenir coûteux, en particulier au-delà du seuil des 272 000 caractères.
- Conception graphique : Une excellente maîtrise du codage ne garantit pas automatiquement une interface esthétique optimale.
- Niveau de preuve : Il n'existe pas encore suffisamment d'essais indépendants et comparatifs pour émettre des conclusions générales quant à la fiabilité ou à la supériorité de ces produits.
Le critère essentiel pour évaluer l'adoption d'un système est donc son efficacité, et non ses capacités maximales. Il faut mesurer la fréquence à laquelle Astra mène à bien l'intégralité de la tâche, le niveau de supervision dont elle a besoin, le nombre de jetons qu'elle utilise et le volume de nettoyage restant à effectuer. Une exécution plus lente et plus coûteuse peut tout de même s'avérer rentable si elle permet d'économiser des heures de travail d'expert, mais ce n'est pas le cas si elle s'égare à plusieurs reprises.
À qui s'adresse GPT-6 Astra ?
| Compatibilité potentielle | Pourquoi Astra pourrait vous aider | Ce qu'il faut vérifier en premier lieu |
|---|---|---|
| Travail sur une base de code volumineuse | Contexte étendu, utilisation d'outils et continuité lors de modifications portant sur plusieurs fichiers | Taux de régression, discipline de test, durée de révision et coût des jetons |
| Recherche et synthèse | Peut coordonner la collecte, l'analyse et la production de contenus détaillés | Précision des citations, exhaustivité des sources et déductions non étayées |
| Agents liés à l'utilisation de l'ordinateur | Conçu pour une interaction en plusieurs étapes avec un logiciel | Limites des autorisations, restauration après des modifications de l'interface utilisateur et journaux d'actions |
| Analyse de documents volumineux | Un contexte de 1,05 M peut contenir une quantité importante de données sources | Rappel dans l'ensemble du contexte et vérification du coût de la récupération |
| Opérations de longue durée | La gestion en cours d'exécution et les outils asynchrones peuvent réduire le nombre de redémarrages | Comportement d'escalade, points de contrôle et retour en arrière sécurisé |
Astra n'est généralement pas le meilleur choix par défaut pour les réécritures courtes, la classification de routine, l'extraction simple ou les tâches à grand volume, pour lesquelles un modèle plus petit répond déjà aux critères de qualité. Le Test du GPT-5.4 et du Nano montre pourquoi le routage par tâche peut s'avérer plus économique que d'envoyer toutes les données vers le modèle phare.
Une liste de contrôle pratique pour l'évaluation
- Choisissez trois tâches concrètes assorties de critères de réussite clairs.
- Appliquez les mêmes données d'entrée et contraintes à Astra et à votre modèle actuel.
- Enregistrez la durée totale écoulée, les jetons d'entrée et de sortie, les tentatives de réessai et les corrections effectuées par l'utilisateur.
- Évaluez la réalisation de la tâche finale indépendamment du style rédactionnel ou de la présentation.
- Interruption du test, réorientation en cours de tâche et reprise après une défaillance délibérée d'un outil.
- N'adoptez Astra que si l'amélioration est reproductible et justifie le surcoût.
Choisissez l'Astra ou un modèle plus petit en fonction de la tâche à accomplir
Utilisez Astra pour les synthèses complexes et les tâches où la précision prime sur le prix unitaire le plus bas. Un modèle plus petit peut suffire pour une extraction courante ou une brève réécriture. Comparez le taux de réussite, la supervision et le coût total pour les mêmes données d'entrée.
Pour un flux de travail multimodèle, GPT-6 Astra, les modèles Claude Opus 5, Claude Sonnet 5 et Gemini 3.8 Flash figurent dans le catalogue actuel de GlobalGPT. L’abonnement à GlobalGPT est un abonnement distinct ; il n’active pas le compte payant d’un autre fournisseur.
Le Page du plan annuel GlobalGPT Les tarifs indiqués sont les suivants : « Basic » à $5,80 par mois, « Pro » à $10,80 par mois et « Unlimited » à $25 par mois en cas de facturation annuelle, selon les informations vérifiées le 18 septembre 2026. Comparez l'engagement initial et l'utilisation du modèle incluse, et pas seulement le montant mensuel équivalent, plus faible.
Ce que cette étude ne prouve toujours pas
Une tentative Astra antérieure via le même itinéraire CLI s'était soldée par un échec. Nous conservons cet échec dans les archives de test ; il ne s'agissait pas d'un score de qualité. Les trois appels réussis présentés ici montrent que l'itinéraire a fonctionné pour ce lot, mais ne signifient pas pour autant que l'échec antérieur ne puisse pas se reproduire.
Nous n'avons pas testé l'utilisation d'un ordinateur, l'appel asynchrone d'outils, le réajustement en cours de tâche, la mémorisation d'un million de tokens, l'accès natif au plan ChatGPT, ni le travail de production en mode autonome. Il n’y a ici aucune base permettant d’affirmer qu’Astra surpasse les modèles Claude, Gemini ou un modèle plus petit tel que le OpenAI. Ces comparaisons nécessitent des tâches équivalentes et des essais répétés.
Recommandation d'achat : Testez Astra sur des tâches où la vérification des règles, des valeurs manquantes et des exceptions est cruciale. Privilégiez un modèle plus simple pour les tâches courantes qui répondent déjà à vos exigences de qualité. Évaluez le surcoût en fonction de la réduction du nombre de corrections et de la quantité de travail final exploitable, et non pas uniquement en fonction du nom du modèle.
Foire aux questions
S'agissait-il d'un test direct de l'API OpenAI ?
Non. Nous avons utilisé le service de modèle basé sur l'interface CLI de GlobalGPT avec gpt-6-astra. Les nombres de tokens et les crédits indiqués correspondent à cette formule tarifaire ; le calcul en dollars de OpenAI est un exemple tiré d'une grille tarifaire distincte.
Le GPT-6 Astra est-il disponible sur le GlobalGPT ?
Oui. Cette évaluation porte sur trois appels gpt-6-astra réussis via le service de modélisation de GlobalGPT. L'abonnement à cette plateforme est distinct de la facturation de l'API de OpenAI et des forfaits de ChatGPT.
Qu'est-ce que la fenêtre de contexte ?
OpenAI prend en charge 1 050 000 tokens de contexte, avec un maximum de 922 000 tokens en entrée et 128 000 tokens en sortie.
La version Plus intègre-t-elle GPT-6 Pro dans la fonctionnalité de chat ?
Selon les recommandations du 10 septembre, le GPT-6 Pro est inclus dans les formules Chat Pro, Business et Enterprise éligibles. De plus, Astra est inclus dans les formules Work et Codex ; il s'agit là de droits d'accès distincts.
Comment fonctionne la tarification en fonction de la longueur des données saisies ?
La page officielle du modèle applique des tarifs plus élevés à la requête complète dès que le nombre de tokens d'entrée dépasse 272 000 : les tarifs d'entrée et de mise en cache sont multipliés par 2, et les tarifs de sortie par 1,5.
Le nouveau test portait-il sur l'utilisation de l'ordinateur ?
Non. Nous avons testé l'analyse d'ordres synthétiques, la génération de code avec exécution locale et un paquet de texte de 500 notes. L'utilisation d'un ordinateur, les outils asynchrones et la fiabilité sur un million de tokens n'ont pas été testés.
Dois-je remplacer tous les modèles par l'Astra ?
Non. Comparez la qualité des résultats, la vérification manuelle, la latence et le coût pour vos propres tâches. Un petit modèle peut s'avérer être le meilleur choix s'il fournit de manière fiable la même réponse exploitable.