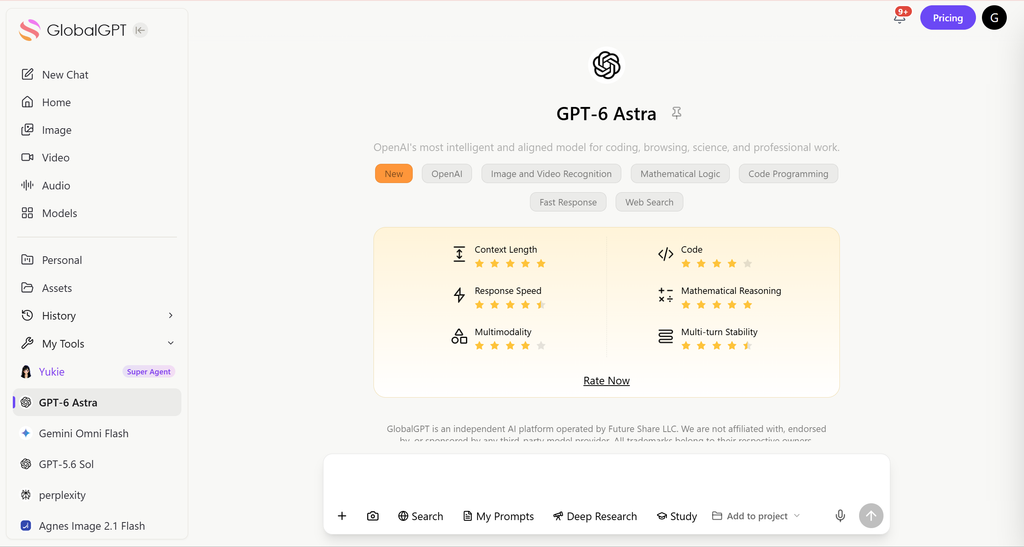
Situation actuelle, vérifiée le 24 septembre 2026 : Les modèles ChatGPT 5.1 et Grok 4.1 constituent des références historiques et ne correspondent pas aux choix de modèles par défaut actuels. Documentation relative aux modèles actuels de xAI présente le modèle Grok 4.6 comme son modèle général phare, avec un contexte de 500 000 tokens et une configuration de $2 en entrée / $6 en sortie par million de tokens. Le modèle OpenAI catalogue des modèles actuels a dépassé le stade de GPT-5.1, tandis que GlobalGPT propose actuellement le GPT-6 Astra et Grok 4,6. Les sections consacrées aux tests de performance ci-dessous conservent leur champ d'application pour 2025 ; veuillez ne pas réutiliser d'anciens scores, chiffres de latence ou tarifs d'abonnement comme données actuelles sur les produits.
Le choix entre le ChatGPT 5.1 et le Grok 4.1 dépend en fin de compte de ce que vous privilégiez : la résonance émotionnelle ou la précision technique. Le Grok 4.1 excelle dans les tâches créatives et axées sur la personnalité, avec un score record de 1 586 sur EQ-Bench et une politique tarifaire très agressive. En revanche, le ChatGPT 5.1 reste la référence absolue pour les environnements d’entreprise, tirant parti de modèles spécialisés de “ réflexion ” pour offrir une fiabilité supérieure dans les tests de codage complexes et de raisonnement logique tels que SWE-bench Verified. .
Le paysage de l'IA en 2025 crée un clivage marqué entre les “ agents créatifs ” et les “ professionnels d'entreprise ”, obligeant les utilisateurs à choisir entre une personnalité sans filtre et une sécurité de niveau professionnel. Cette fragmentation laisse beaucoup de personnes tiraillées entre une authenticité brute et une fiabilité éprouvée.
Heureusement, GlobalGPT permet d'accéder aux deux principaux systèmes d'IA tout en évitant d’avoir à faire de compromis entre l’esprit de Grok et la précision de ChatGPT. En regroupant des modèles tels que GPT-6 Astra, Grok 4.1, Claude 4.5, Sora 2, Veo 3.1, Unikorn et Kling en une seule plateforme, les utilisateurs peuvent déployer l'outil idéal pour chaque tâche spécifique sans avoir à gérer plusieurs abonnements.
Le changement de philosophie fondamental : “ la sécurité de l'entreprise ” contre “ la personnalité sans filtre ”
La différence fondamentale entre ces deux modèles réside dans leur philosophie de conception : OpenAI privilégie une utilité prévisible de niveau entreprise, tandis que xAI optimise l'engagement et l'authenticité brute.

- ChatGPT 5.1 – Le “ professionnel adaptatif ”: Conçu pour offrir une grande stabilité, ce modèle intègre un système de routage dynamique qui bascule automatiquement entre des chemins “ instantanés ” pour les tâches simples et des chemins plus profonds “Modèles ” de réflexion » pour la logique complexe. Il est conçu pour minimiser la responsabilité, en respectant des directives de sécurité strictes qui l'empêchent de s'engager lorsqu'il s'agit de sujets sensibles ou “ délicats ”, ce qui en fait le choix privilégié pour les environnements d'entreprise.
- Grok 4.1 – “ L'agent rebelle ”: xAI a conçu Grok pour qu'il agisse comme un agent à “ curiosité maximale ” qui s'oppose activement à la censure “ woke ” ou aux réponses aseptisées. Il s'appuie sur une architecture en essaim massivement parallèle pour débattre en interne d'hypothèses, ce qui donne lieu à des réponses qui semblent plus humaines, pleines d'esprit et parfois controversées, ciblant spécifiquement les utilisateurs qui se sentent limités par les garde-fous habituels de l'IA.
- La fin de l'ère du “ modèle unique ”: En 2025, le marché s'est fragmenté ; les utilisateurs ne recherchent plus une seule IA “ la plus intelligente ”, mais font plutôt leur choix en fonction de l“” ambiance » et de l'utilité spécifique requise pour la tâche à accomplir. Vous devez en effet choisir entre un employé poli et hautement compétent (ChatGPT) et un partenaire créatif brillant mais excentrique (Grok).
Analyse de l'architecture technique : sous le capot
La comparaison des spécifications techniques révèle à quel point les priorités techniques d'OpenAI et de xAI sont différentes.
| Fonctionnalité | ChatGPT 5.1 (OpenAI) | Grok 4.1 (xAI) |
| Stratégie relative à la fenêtre contextuelle | 128 ko Mémoire active et profonde (Donne la priorité à la précision de la recherche plutôt qu'à la longueur brute) | 2 millions de jetons (échelonnés) (Raisonnement “ chaud ” 128k + récupération “ tiède ”) |
| Architecture centrale | Routage dynamique (Bascule entre les chemins “ Instantané ” et “ Réflexion ”) | Essaims d'agents parallèles (Génère plusieurs agents internes pour débattre des réponses) |
| Latence voix/réponse | ~550 ms (Optimisé pour la vitesse de conversation) | ~1200 ms+ (Latence plus élevée en raison du traitement en essaim) |
| Source de connaissances | Pré-entraîné + Recherche sur le Web (Utilise la recherche pour vérifier les faits) | Flux en temps réel X (Twitter) (Accès natif aux données sociales en direct) |
- Contexte : La guerre des fenêtres: Grok 4.1 affiche un nombre impressionnant de 2 millions fenêtre contextuelle du jeton, en utilisant un système à plusieurs niveaux où les 128k premiers tokens sont “ chauds ” (raisonnement actif) et où les autres servent de mémoire de récupération “ tiède ”. En revanche, ChatGPT 5.1 s'appuie généralement sur une couche Deep Memory RAG avec une limite de contexte actif plus stricte (souvent comprise entre 128 000 et 196 000), privilégiant la précision de la recherche à la longueur brute du contexte.
- Architecture du raisonnement: OpenAI utilise un processus de réflexion de type “ Système 2 ”, dans lequel le modèle marque une pause pour enchaîner ses pensées avant de répondre, ce qui réduit considérablement les taux d'hallucinations sur Tâches mathématiques et de codage. La version Grok 4.1 utilise des “ essaims d'agents parallèles ”, qui génèrent plusieurs agents internes chargés d'analyser et d'affiner les réponses en temps réel, ce qui s'avère particulièrement efficace pour les workflows complexes impliquant plusieurs étapes et faisant appel à des agents.
- Latence et vitesse: Pour des interactions rapides, le mode ’ Instant “ de ChatGPT 5.1 est optimisé pour des réponses en moins d'une seconde, ce qui le rend idéal pour les requêtes rapides. Le modèle Grok 4.1 Fast est conçu pour trouver un équilibre entre vitesse et utilisation des outils, mais son recours à la recherche de données X (Twitter) en temps réel peut entraîner une latence variable par rapport à la base de connaissances pré-entraînée du modèle ChatGPT.

Comparatifs directs : ce que révèlent les données officielles
Alors que le battage publicitaire bat son plein, les résultats officiels des tests de performance donnent une image claire des domaines dans lesquels chaque modèle domine réellement.
- Intelligence émotionnelle (EQ): Grok 4.1 a obtenu un score record de 1586 au classement EQ-Bench, surpassant largement ses concurrents grâce à sa capacité à comprendre les nuances, le sarcasme et le sous-entendu(). Ce QE élevé le rend supérieur pour les tâches nécessitant de l'empathie, telles que la rédaction d'e-mails difficiles ou la narration créative, où les réponses robotiques peuvent sembler aliénantes.

- Raisonnement scientifique: Sur le benchmark GPQA Diamond (questions scientifiques de niveau doctorat), dans l’aperçu de 2025, Gemini 3 s’est imposé comme une option de premier plan, mais GPT-5.1 (Pro/Thinking) le talonne de près avec des scores compris entre 81 et 87%, démontrant ainsi une fiabilité exceptionnelle pour la recherche universitaire. Grok 4.1 affiche des performances admirables, mais se place généralement légèrement derrière les modèles dédiés au “ raisonnement ” en termes de précision scientifique pure.
- Réalité et hallucinations: Grok 4.1 a réduit son taux d'hallucination à environ 4,221 TP3T en tirant parti d'outils de vérification de recherche en temps réel. ChatGPT 5.1 utilise son “Mode ” Réflexion » pour vérifier les faits, dans le but d'obtenir des réductions similaires des taux d'erreur, en particulier dans les domaines de “ haut ” niveau de compétence tels que la biologie et la chimie.

Codage et développement : précision ou flux de travail agentique
Pour les développeurs, le choix dépend de la nécessité d'effectuer des modifications chirurgicales du code ou d'utiliser un agent autonome full-stack.
- Pour les développeurs – GPT-5.1: ChatGPT 5.1 excelle dans le maintien de l'intégrité des référentiels à l'aide du
appliquer_le_patchoutil qui lui permet d'apporter des modifications chirurgicales aux bases de code existantes sans réécrire des fichiers entiers. Il obtient un score élevé sur SWE-bench Verified (environ 74,91 TP3T), ce qui en fait le choix le plus sûr pour l'intégration dans des pipelines d'entreprise établis où les changements radicaux sont inacceptables.

- Pour les agents Full-Stack – Grok 4.1: Grok excelle dans les flux de travail agentiques grâce à son “ API Agent Tools ”, qui lui permet d’enchaîner plusieurs actions — telles que la recherche de documentation, l’écriture de code et son exécution — dans une boucle. Il est optimisé pour le “ vibe coding ”, une méthode dans laquelle un développeur décrit un objectif général, et Grok prototypent rapidement une solution fonctionnelle en s’appuyant sur sa fenêtre contextuelle très étendue pour appréhender l’ensemble du projet.
- Résultats vérifiés par SWE-bench: Alors que GPT-5.1 affiche un score vérifié d'environ 74,91 TP3T, Grok 4.1 revendique des performances compétitives dans la même catégorie (791 TP3T selon certaines comparaisons), grâce à sa capacité à s'auto-corriger à l'aide d'essaims d'agents parallèles.

Si vous souhaitez comparer ces capacités de codage côte à côte sur votre propre base de code, GlobalGPT fournit un environnement unifié permettant d'exécuter les deux modèles à partir de la même invite.
“ Évaluation de l'ambiance ” en conditions réelles en 9 étapes : tests d'ergonomie
Au-delà des benchmarks, comment ces modèles se comportent-ils dans l'utilisation quotidienne ? Les tests révèlent des personnalités distinctes.

- Création littéraire: Lors de tests à l'aveugle, les utilisateurs ont préféré la production créative de Grok 4.1 dans 64% des cas, car elle crée du suspense, utilise des détails sensoriels et évite la ’ voix d'IA “ clichée courante dans ChatGPT. Le modèle Grok est prêt à prendre des risques narratifs, tandis que le modèle ChatGPT 5.1 se rabat souvent sur des dénouements sans risque, à la ” Disney “.

- Logique et pièges: Lorsqu’on lui soumet des énigmes linguistiques (par exemple : “ 17 moutons, tous meurent sauf 9 ”), Grok 4.1 identifie correctement le piège linguistique et explique pourquoi C'est un piège. ChatGPT 5.1 résout correctement le calcul, mais passe souvent à côté des nuances conversationnelles, en traitant le problème comme un simple exercice de logique.
- Humour et ton: Grok 4.1 excelle dans l’humour de type “ roast ” et la comédie noire, en générant des sketches de stand-up à la fois audacieux et humains. ChatGPT 5.1 peine dans ce domaine, produisant souvent des “ blagues sans risque ” ou des blagues de papa qui manquent du mordant nécessaire à une véritable comédie, en raison de son alignement strict sur les critères de sécurité.
Capacités multimodales : vision, voix et vidéo
La capacité à voir, entendre et générer des médias est un enjeu crucial.

- Génération vidéo: ChatGPT 5.1 s'intègre nativement avec Sora 2, permettant aux utilisateurs de générer des vidéos physiquement précises des extraits vidéo (d'une durée maximale de 25 secondes) directement depuis l'interface de discussion. Dans la comparaison de 2025, le modèle Grok 4.1 ne disposait pas d'un modèle de génération vidéo natif de ce calibre ; il s'appuyait plutôt sur des modèles de génération d'images tels qu'Aurora ou Flux, ce qui le plaçait en retard dans les flux de travail vidéo.
- Latence en mode vocal: Pour une interaction vocale en temps réel, la latence est un facteur crucial. Le mode vocal du GPT-5.1 affiche une latence d’environ 550 ms, offrant ainsi une expérience fluide et conversationnelle. Le traitement audio de Grok 4.1 est plus lent, avec des latences dépassant souvent les 1 200 ms, ce qui donne davantage l’impression d’un échange par talkie-walkie que d’une conversation naturelle.
- Analyse d'images: GPT-5.1 (en particulier avec la fonction Thinking activée) excelle dans l'analyse des figures et graphiques scientifiques, obtenant un score élevé au benchmark CharXiv. Grok 4.1 exploite ses capacités de vision principalement pour analyser les images et mèmes des réseaux sociaux provenant de X, ce qui lui confère un avantage culturel mais un désavantage scientifique.
Sécurité, censure et taux de refus
Le débat autour du “ woke ” occupe une place centrale dans la stratégie marketing de ces modèles.

- Le débat sur le “ woke ”: Le modèle Grok 4.1 prône une attitude de “ curiosité maximale ”, avec un taux de refus inférieur à 1% pour les sujets sensibles, ce qui le rend disposé à aborder des questions politiques ou sociales controversées que d’autres modèles évitent.
- Conformité d'entreprise: ChatGPT 5.1 affiche un taux de rejet d’environ 4,5% pour les utilisateurs grand public, mais propose des “ niveaux de confiance ” aux entreprises, garantissant ainsi que les contenus générés restent adaptés au milieu professionnel (filtres NSFW, conformité juridique)()()()(). Cela en fait le seul choix viable pour les entreprises du classement Fortune 500 qui ne peuvent se permettre de courir le risque d’un désastre en matière de relations publiques.
- Gestion des conseils médicaux/juridiques: Malgré son image de “ rebelle ”, Grok 4.1 se montre étonnamment prudent en matière de conseils médicaux, s'en remettant souvent strictement aux professionnels afin d'éviter toute responsabilité. ChatGPT 5.1, amélioré grâce à l’évaluation HealthBench, s’efforce d’être un “ partenaire de réflexion ” utile tout en continuant à signaler les risques, en fournissant un contexte médical plus détaillé que Grok()()()().
L'économie des jetons : aperçu des prix en 2025 (données historiques)
C'est au niveau des prix que Grok 4.1 porte son coup le plus dur à la concurrence.

- API Choc des prix: xAI a fixé un prix très agressif pour Grok 4.1 Fast à $0,20 par million de jetons entrés, soit environ 84% moins cher que les $1,25 par million de jetons d'entrée de ChatGPT 5.1. Pour les développeurs qui créent des applications à fort volume, cette différence de prix est un facteur déterminant.
- Le “ piège de l'abonnement ”: Pour accéder à la meilleure version de Grok (non-API), les utilisateurs doivent s'abonner à X Premium+ ($16/mois). Pour tirer le meilleur parti de ChatGPT, vous devez ChatGPT Plus ($20/mois). Le coût annuel des deux abonnements s'élève à plus de $400, ce qui entraîne une “ lassitude face aux abonnements ” considérable.”
- Économies pour les développeurs: Pour une application traitant 100 millions de jetons par mois, l'utilisation de Grok 4.1 au lieu de GPT-5.1 pourrait permettre à une start-up d'économiser plus de 1 000 dollars par mois en coûts bruts d'API (1 200 dollars contre 1 250 dollars ou plus).
Le “ flux de travail hybride ” : optimiser l'efficacité
Au lieu d'en choisir un seul, les utilisateurs expérimentés les plus efficaces en 2025 combinent les deux modèles afin de tirer parti de leurs atouts respectifs.

- Phase 1 : Idéation et recherche (Grok 4.1)Commencez avec Grok 4.1 pour trouver des idées, rédiger du contenu créatif ou rechercher des actualités en temps réel grâce à son intégration X. Son QE élevé et son faible taux de refus en font l'outil idéal pour générer des concepts bruts et non filtrés.
- Phase 2 : Structure et codage (ChatGPT 5.1): Transférez le brouillon ou le concept brut vers ChatGPT 5.1 pour affiner la structure, vérifier la logique ou convertir l'idée en code prêt à être produit à l'aide de la fonction
appliquer_le_patchl'outil. - Phase 3 : Vérification visuelle (Gemini 3)Si le projet implique des données visuelles complexes ou des graphiques scientifiques, utilisez Gemini 3 pour vérifier les éléments visuels, car il est actuellement en tête des benchmarks de raisonnement visuel().
La solution unifiée : accès à tous les modèles via GlobalGPT
La gestion de trois abonnements distincts et de clés API est inefficace et coûteuse.


- Résoudre la lassitude liée aux abonnements: GlobalGPT intègre GPT-6 Astra, Grok 4,6, et Gémeaux 3 dans une interface unique, permettant aux utilisateurs pour accéder à plus de 100 modèles haut de gamme à partir de à $10,8 par mois en cas de facturation annuelle. Cela évite d'avoir à payer chaque mois $50+ pour des abonnements distincts à X Premium+, ChatGPT Plus et Google One.

- Comparaison côte à côte des résultats: La plateforme permet de passer d'un modèle à l'autre en toute transparence, ce qui permet aux utilisateurs d'exécuter instantanément la même invite sur Grok et GPT-5.1 afin de comparer les résultats sans avoir à changer d'onglet ou à se connecter à différents comptes.
- Suppression des verrous régionauxGlobalGPT donne accès à des modèles soumis à des restrictions régionales (comme Claude 4.5 ou Grok dans l'UE) sans nécessiter de configurations VPN complexes ou de vérifications de numéros de téléphone étrangers.
Verdict final : quel modèle choisir ?
- Le choix des développeurs (référence historique GPT-5.1)Si vous avez besoin d'une génération de code fiable et structurée ainsi que d'une sécurité de niveau entreprise, ChatGPT 5.1 est incontournable. Son
appliquer_le_patchoutil et ses scores SWE-bench élevés en font la référence dans le secteur. - Le choix du Créateur (référence historique Grok 4.1)Si vous avez besoin d'un partenaire d'écriture doté de personnalité, d'humour et dépourvu de filtres moralisateurs, Grok 4.1 est le meilleur choix. Son faible coût et son QE élevé en font le meilleur outil pour la génération de contenu().
- Le choix du chercheur (Gemini 3): Pour la découverte scientifique pure et l'analyse de données visuelles complexes, Gemini 3 reste le spécialiste incontesté, surpassant les modèles généralistes dans les tâches de raisonnement approfondi.
Pour un nouveau projet en 2026 : Utilisez GPT-6 Astra ou une autre offre OpenAI actuelle pour les tâches structurées, et Grok 4.6 lorsque vous avez besoin du modèle général actuel d'xAI et des outils de recherche optionnels. Utilisez l'ancien tableau comparatif ci-dessous pour comprendre le compromis initial, et non comme un tableau actualisé des prix ou de la disponibilité.
Foire aux questions (FAQ)
- Grok 4.1 peut-il analyser les fichiers PDF aussi bien que ChatGPT ?
- Oui, la version Grok 4.1 prend désormais en charge le téléchargement de fichiers et permet d'extraire des informations à partir de documents via l'API Agent Tools, à l'instar des fonctionnalités d'analyse de la version ChatGPT.
- Le logiciel GlobalGPT prend-il en charge les versions “ Pro ” de ces modèles ?
- Oui, GlobalGPT donne accès à des modèles haut de gamme tels que Sora 2 Pro et GPT-5.1, qui sont généralement verrouillés derrière des niveaux coûteux sur les plateformes officielles.
- ChatGPT 5.1 est-il plus rapide que Grok 4.1 pour les requêtes simples ?
- Oui, grâce à son mode “ Instant ”, le ChatGPT 5.1 répond généralement aux requêtes simples en moins d'une seconde (environ 550 ms), tandis que le Grok 4.1 peut prendre plus de temps en raison de la surcharge liée au traitement en essaim.
Que devrais-je choisir pour un nouveau projet en 2026 ?
Commencez par tester GPT-6 Astra et Grok 4.6 avec les mêmes consignes, fichiers, outils et critères d'acceptation. GPT-6 Astra correspond à la voie de planification GlobalGPT actuellement recommandée pour les tâches structurées ; Grok 4.6 est le modèle général phare actuel de xAI.
Quel est le cours actuel du contrat à terme Grok 4,6 API ?
La documentation actuelle de xAI indique un coût de Grok 4,6, soit $2 par million de tokens en entrée et $6 par million de tokens en sortie, pour un contexte de 500 000 tokens. Ce coût est indépendant du prix de l'abonnement grand public.
Les chiffres de référence ChatGPT 5,1 et Grok 4,1 sont-ils toujours d'actualité ?
Non. Les scores, les estimations de latence, les limites des modèles et les tarifs d'abonnement figurant dans la comparaison initiale se rapportent à la période de test de 2025. Considérez-les comme des données historiques et refaites les tests avec les identifiants des modèles actuels avant de prendre une décision d'achat ou d'intégration.