Les meilleures consignes pour Claude facilitent la compréhension de la tâche : définissez un objectif pour Claude, les données qu’il doit utiliser, les contraintes pertinentes et un moyen de vérifier le résultat. Pour la rédaction, veillez à préserver les faits et l’action suivante du lecteur. Pour la recherche, reliez les affirmations aux sources. Pour le codage, définissez le comportement correct et effectuez des tests.
Commencez par choisir ci-dessous la tâche qui vous intéresse : rédiger un e-mail, analyser un dossier de sources ou corriger une fonction Python. Choisissez parmi 12 modèles adaptables, puis découvrez trois exemples détaillés testés avec la session Claude lors de la session GlobalGPT. Chaque exemple comprend l'énoncé complet et la réponse, ce qui vous permet de voir ce qu'il faut copier, ce qu'il faut modifier et ce qu'il faut vérifier dans votre propre travail.
Si votre travail passe de la recherche à la rédaction, puis à la programmation, GlobalGPT réunit Claude et d’autres modèles de pointe, ainsi que de nombreux outils d’IA, au sein d’un seul abonnement abordable et d’un tableau de bord unique. Vous pouvez ainsi centraliser l’ensemble de votre flux de travail et choisir le modèle ou la fonctionnalité la mieux adaptée à l’étape suivante.
Sur cette page
Aperçu des meilleures consignes pour le Claude
Choisissez le modèle en fonction de la décision ou du livrable dont vous avez besoin. Remplacez les champs entre crochets avant de l'envoyer. Les modèles de rédaction et de recherche fonctionnent avec du texte collé ; les consignes de programmation qui nécessitent l'accès à un fichier ou son exécution requièrent un outil capable d'effectuer ces actions.
Un modèle de départ réutilisable suffit pour de nombreuses tâches. Présentation générale de l’ingénierie de Anthropic commence par les critères de réussite et une méthode pour les tester. Il n'est pas nécessaire de se baser sur un profil d'expert très élaboré pour définir ce qu'une réponse utile doit contenir.
Un petit modèle de départ
Aidez-moi à [TÂCHE] pour [PUBLIC OU OBJECTIF].
Utilisez ces éléments : [COLLER LES ÉLÉMENTS].
Respectez ces contraintes : [FAITS, PORTÉE, LONGUEUR OU RÈGLES].
Renvoyez [FORMAT DE SORTIE].
Un résultat satisfaisant doit [EXIGENCES VÉRIFIABLES].
Si un détail nécessaire manque, posez la question précise qui bloque la tâche.
Utilisez des titres ou des balises lorsque cela permet de mieux structurer un brief complexe. Recommandations actuelles de Anthropic en matière d'invites recommande de fournir des instructions claires, des exemples utiles et des balises XML descriptives pour les contenus mixtes. Les balises permettent d'organiser le texte ; elles ne constituent pas des preuves, ne donnent pas accès à des outils et ne garantissent pas l'exactitude d'une réponse.
Claude : idées pour l'écriture
En rédaction, le plus difficile est souvent de conserver l’essentiel tout en modifiant la formulation. Précisez ce que le lecteur doit faire et quels sont les éléments immuables. Une phrase fluide ne sert à rien si elle ajoute subrepticement une promesse.
1. Rédigez un e-mail à partir d'un résumé factuel
Une invitation, une mise à jour ou un e-mail client clair, dont les informations doivent être exactes. À apporter : Résumé des faits, public visé, mesures de réponse et nombre maximal de mots.
W1 · Exemple de tâche testée ci-dessous
Rédigez l'e-mail demandé dans le brief. Considérez les faits confirmés comme immuables. Faites la distinction entre les demandes et les confirmations. Respectez le format et la longueur indiqués. N'utilisez que les informations fournies.


Public cible : [QUI LIRAS CE COURRIEL]
Objectif : [CE QUE LE COURRIEL DOIT PERMETTRE D'ACCOMPLIR]
Faits confirmés : [DATES, HORAIRES, PRIX, LIMITES ET AUTRES DÉTAILS]
Informations inconnues ou non validées : [CE QUE VOUS NE POUVEZ PAS PROMETTRE]
Action attendue du lecteur : [PROCHAINE ÉTAPE PRÉCISE]
Ton : [TON]
Résultat attendu : un objet et un corps de [NOMBRE DE MOTS] mots.
Vérifiez le résultat : Vérifiez chaque date, chaque chiffre, chaque promesse et chaque action à entreprendre par rapport au dossier. Une simple phrase en plus, même formulée de manière amicale, peut tout de même créer une obligation.
2. Adaptez votre style d'écriture à celui de vos propres textes
Un bref projet qui semble s'inscrire dans la lignée de vos travaux antérieurs. À apporter : Deux ou trois extraits que vous avez rédigés et les éléments factuels pour le nouvel article.
W2 · Modèle adaptable
Utilisez mes exemples d'écriture pour identifier trois caractéristiques stylistiques observables : le rythme des phrases, le niveau de formalité et la manière dont j'explique mes idées. Appliquez ces caractéristiques à un nouveau [FORMAT] destiné à [PUBLIC].

Utilisez les extraits uniquement pour le style. Utilisez le nouveau brief pour les faits. Indiquez les trois traits de style, puis rédigez le brouillon en [NOMBRE DE MOTS].


[COLLER VOTRE PROPRE TEXTE]


[SUJET, OBJECTIF, FAITS CONFIRMÉS ET ACTION REQUISE DE LA PART DU LECTEUR]
Vérifiez le résultat : Prêtez attention au rythme des phrases et à la précision, puis vérifiez que les exemples cités ne se sont pas glissés dans la nouvelle version.
Choisissez des exemples dont vous souhaitez conserver le style. Une liste d'adjectifs tels que “ convivial, perspicace, professionnel ” laisse davantage de place à l'interprétation que quelques exemples concrets. Le nouveau brief doit rester la source des détails factuels.
3. Identifiez les modifications qui auraient le plus d'impact
Un brouillon qui semble peu convaincant, sans pour autant nécessiter une réécriture complète. À apporter : Votre brouillon, le public visé, l'objectif et les passages à conserver.
W3 · Modèle adaptable
Relisez ce brouillon destiné à [PUBLIC] qui a besoin de [OBJECTIF DU LECTEUR]. Identifiez jusqu’à trois modifications qui amélioreraient le plus la clarté ou l’utilité du texte. S’il en faut moins de trois, précisez-le.

Pour chaque modification, citez le passage original, expliquez le problème rencontré par le lecteur et proposez une formulation de remplacement. Conservez le sens factuel ainsi que les éléments suivants : [À CONSERVER]. Ne réécrivez pas l'intégralité du brouillon.


[COLLER LE BROUILLON]
Vérifiez le résultat : Rejetez les résultats qui ne permettent pas d'identifier un passage concret ou un problème significatif pour le lecteur.
4. Réutiliser un contenu pour deux publics différents
Transformer une mise à jour validée en note interne et en message destiné aux clients. À apporter : Une source validée et deux fiches d'information destinées au public.
W4 · Modèle adaptable
Adaptez le texte source approuvé en deux versions courtes :
A. [FORMAT, PUBLIC, OBJECTIF, LIMITE DE MOTS]
B. [FORMAT, PUBLIC, OBJECTIF, LIMITE DE MOTS]

Veillez à la cohérence des dates, des chiffres, de la disponibilité des fonctionnalités et des engagements. Adaptez les explications et les points d’accentuation en fonction de chaque public. Si un public a besoin d’une précision que le texte source ne contient pas, indiquez cette lacune à la fin des ébauches.


[COLLER LE TEXTE SOURCE]
Vérifiez le résultat : Comparez les deux versions en vous basant sur la même liste de faits ; le fait d'avoir un nouveau public ne justifie pas l'ajout de nouvelles fonctionnalités ou promesses.
Essayez ces exercices dans GlobalGPT
Transformez un brief en e-mail, un dossier de sources en recommandation et un rapport de bug en correction.
Nous avons utilisé Claude Sonnet 5 dans GlobalGPT pour les trois tâches. Les brouillons d'e-mails conservaient les détails clés de l'événement, les résultats de la recherche identifiaient les raisons de reporter le déploiement, et les deux correctifs Python ont passé avec succès les 24 vérifications lorsque nous les avons exécutés séparément. Ce sont des points de départ utiles pour le travail que vous pouvez intégrer dans le même tableau de bord.
Pour l'essayer vous-même, choisissez un modèle ci-dessous et remplacez le contenu d'exemple par le vôtre. GlobalGPT regroupe des outils de rédaction, de recherche, de programmation et d'intelligence artificielle au sein d'un seul abonnement abordable, ce qui vous permet de passer de la compréhension d'un problème à la rédaction du prochain livrable sans avoir à jongler entre différents services.
Comment nous avons comparé les consignes
Le 14 septembre 2026, chaque tâche a reçu deux consignes basées sur le même support fictif et les mêmes exigences : une instruction succincte et une version plus structurée. Nous avons conservé la première réponse complète de chacune, soit six réponses au total. La recherche s'est appuyée sur les passages fournis ; le code Python généré a été vérifié séparément, sans être exécuté par le modèle au cours de la conversation.
Ces exemples couvrent trois tâches, à raison d'une par version. Les données d'entrée et les réponses complètes figurent ci-dessous, accompagnées des modifications ou des vérifications à apporter à chaque résultat. Les 12 modèles réutilisables n'ont pas tous été testés séparément.
Comparaison des premiers résultats · W
Rédigez un e-mail concernant l'événement en y incluant les informations essentielles.
| Vérifier | Instructions simples | Enseignement structuré |
|---|---|---|
| Éléments clés et vérifications des mesures à prendre | 8 / 9 | 8 / 9 |
| Longueur du sujet et du corps | Passer · 126 mots | Passer · 128 mots |
| Promesse de suivi non approuvée | Présent | Présent |
Les deux versions ont conservé la date, les horaires, la capacité d’accueil, le prix, les remarques, ainsi que la distinction entre la demande et la confirmation d’une réservation. Vous disposez ainsi d’un brouillon à modifier plutôt que d’une page blanche. Avant l’envoi, supprimez la promesse de suivi que ni l’un ni l’autre des briefs n’autorisait ; la version simple qualifiait également les sessions d“” identiques » sans justification. Pour votre propre e-mail, dressez la liste des éléments factuels à conserver et des engagements que vous êtes autorisé à prendre.
Les huit contrôles portent sur la date ; les deux horaires et l'UTC ; la durée ; la capacité par session ; la participation gratuite ; les notes téléchargeables ; l'interdiction d'enregistrer ; et le fait de demander une réservation plutôt que de la confirmer. Le neuvième contrôle porte sur la présence de faits ou d'engagements inventés. Le nombre de mots ne tient pas compte du sujet.
Temps écoulé : 9,73 s / 7,02 s. Nombre de jetons d'entrée et de sortie signalés : 400 + 617 / 468 + 299. Une réponse pour chacun ; aucune nouvelle tentative.
Instructions simples — consignes complètes et documents de référence
Rédigez l'e-mail demandé dans le brief ci-dessous.

EXERCICE DE SIMULATION. Il s'agit de détails fictifs concernant un atelier, et non d'une offre réelle.

Vous rédigez un e-mail d'invitation pour un atelier communautaire fictif intitulé « Clear Notes ».
Public cible : les chefs de projet de petites équipes qui souhaitent clarifier leurs comptes-rendus de réunion.
Objectif : inviter le lecteur à répondre « MATIN » ou « APRÈS-MIDI » pour demander une place. Une réponse permet de demander une place ; elle ne confirme pas une réservation.
Informations confirmées :
- Date : 8 octobre 2026.
- Deux sessions distinctes débutent à 09 h 00 UTC et 16 h 00 UTC.
- Chaque session dure 40 minutes.
- Chaque session dispose de 25 places.
- La participation est gratuite.
- Les participants recevront des comptes rendus téléchargeables.
- Aucun enregistrement ne sera mis à disposition.
- Aucune date limite d'inscription n'a été fixée.
Résultat attendu : un objet d'e-mail et un corps de message de 100 à 140 mots. Un anglais simple et convivial ; pas de ton exagérément enthousiaste. Incluez la date, les deux heures de début ainsi que le fuseau horaire, la durée, la capacité d'accueil par session, le prix, les notes téléchargeables, l'absence d'enregistrement et l'action à effectuer en réponse. N’inventez pas de lien, de date limite, de réservation confirmée, d’intervenant ou de lieu. Vous pouvez omettre de mentionner l’absence de date limite d’inscription.
Instructions simples — réponse originale complète
**Objet : Atelier « Clear Notes » – 8 octobre 2026 – Répondez pour réserver votre place**

Bonjour,

Nous invitons les chefs de projet qui souhaitent disposer de comptes-rendus de réunion plus clairs et plus utiles à participer à « Clear Notes », un atelier communautaire gratuit qui se tiendra le 8 octobre 2026.

Deux sessions identiques sont proposées, d’une durée de 40 minutes chacune : l’une commence à 09h00 UTC et l’autre à 16h00 UTC. Chaque session dispose de 25 places.

La participation est gratuite, et chaque participant recevra des notes téléchargeables à conserver. Veuillez noter qu’aucun enregistrement ne sera mis à disposition ; la participation en direct est donc la seule façon de prendre part à l’événement.

Pour demander une place, il vous suffit de répondre à cet e-mail en indiquant « MORNING » ou « AFTERNOON », selon la session qui vous convient le mieux. Le fait de répondre constitue une demande de place ; cela ne confirme pas votre inscription. Nous vous communiquerons bientôt plus de détails.

Merci, et nous espérons vous y voir.
Enseignement structuré — consignes complètes et supports pédagogiques
Rédigez l'e-mail d'invitation demandé dans le brief. Considérez les faits confirmés comme immuables. Faites la distinction entre une demande de place et une réservation confirmée. Respectez le format et la longueur indiqués. N'utilisez que les informations fournies.


EXEMPLE FICTIF. Il s'agit de détails d'atelier inventés, et non d'une offre réelle.

Vous rédigez un e-mail d’invitation pour un atelier communautaire fictif intitulé « Clear Notes ».
Public cible : les chefs de projet de petites équipes qui souhaitent disposer de comptes-rendus de réunion plus clairs.
Objectif : inviter le lecteur à répondre « MATIN » ou « APRÈS-MIDI » pour demander une place. Une réponse constitue une demande de place ; elle ne confirme pas une réservation.
Faits avérés :
- Date : 8 octobre 2026.
- Deux sessions distinctes débutent à 09 h 00 UTC et 16 h 00 UTC.
- Chaque session dure 40 minutes.
- Chaque session dispose de 25 places.
- La participation est gratuite.
- Les participants recevront des notes téléchargeables.
- Aucun enregistrement ne sera mis à disposition.
- Aucune date limite d’inscription n’a été fixée.
Résultat attendu : un objet d’e-mail et un corps de message de 100 à 140 mots. Un anglais simple et convivial ; pas de ton exagérément enthousiaste. Indiquez la date, les deux heures de début ainsi que le fuseau horaire, la durée, le nombre de places par session, le prix, la disponibilité de notes téléchargeables, l’absence d’enregistrement et l’action à entreprendre en réponse. N’inventez pas de lien, de date limite, de réservation confirmée, d’intervenant ou de lieu. Vous pouvez ne pas mentionner l’absence de date limite d’inscription.
Enseignement structuré — réponse originale complète
Objet : Vous êtes invité(e) : Atelier Clear Notes – 8 octobre 2026

Bonjour,

Si vous êtes chef de projet et que vous souhaitez améliorer la clarté de vos comptes-rendus de réunion, nous serions ravis de vous accueillir à l'atelier Clear Notes le 8 octobre 2026.

Deux sessions sont proposées, d’une durée de 40 minutes chacune : l’une à 09 h 00 UTC et l’autre à 16 h 00 UTC. Chaque session dispose de 25 places et la participation est entièrement gratuite.

Tous les participants recevront des notes téléchargeables qu’ils pourront conserver et consulter ultérieurement. Veuillez noter qu’aucun enregistrement ne sera fourni ; la participation en direct est donc la seule façon de prendre part à l’événement.

Pour demander une place, il vous suffit de répondre par « MORNING » ou « AFTERNOON », selon la session qui vous convient le mieux. Votre réponse constitue une demande de place ; elle ne confirme pas votre réservation. Nous vous communiquerons prochainement de plus amples informations.

Nous espérons vous y voir nombreux.

Cordialement,
L'équipe Clear Notes
Claude : pistes de recherche
Les demandes de recherche doivent respecter des limites en matière de preuves. Indiquez les numéros d'identification des sources correspondantes pour les passages concernés, ou utilisez un outil permettant de les retrouver effectivement. Une URL à elle seule ne constitue pas une preuve que Claude a consulté une page. Ces modèles permettent de distinguer ce que disent les sources de ce que vous pouvez en conclure.
5. Synthétiser les sources sans occulter les divergences
Répondre à une question de décision à partir de documents que vous pouvez consulter. À apporter : Les extraits identifiés, leurs dates, la question faisant l'objet de la décision et, le cas échéant, les éléments à vérifier.
R1 · Tâche représentative testée ci-dessous
Répondez à la [QUESTION DE DÉCISION] en vous appuyant uniquement sur le paquet source ci-dessous. Comparez les définitions, les populations et les dénominateurs avant de considérer les différences numériques comme des preuves d’amélioration. Faites la distinction entre une affirmation préliminaire et une mesure. Associez chaque conclusion à une citation exacte de la source qui la corrobore réellement, et ne mentionnez pas les preuves manquantes.

Résultat : une recommandation de [LIMITE] mots au maximum ; un tableau comprenant l’affirmation, le verdict, l’identifiant de la source et la citation exacte à l’appui ; ainsi que les trois mesures manquantes nécessaires à une comparaison équitable. N’utilisez les mentions « Étayée », « Partiellement étayée », « Non étayée » ou « Contredite » que lorsque les preuves justifient cette qualification. Vérifiez ces affirmations : [AFFIRMATIONS].


[IDENTIFIANTS DES SOURCES, DATES ET EXTRAITS COMPLETS PERTINENTS]
Vérifiez le résultat : Vérifiez le texte cité, l'affirmation qu'il étaye, ainsi que le fait que les quantités utilisent bien la même définition et le même dénominateur.
6. Vérifier la validité d'une affirmation par rapport à sa source
Examiner un projet avant qu'une citation ne soit utilisée comme élément de preuve. À apporter : La citation exacte et le passage d'origine, pas seulement une URL.
R2 · Modèle personnalisable
Vérifiez chaque affirmation par rapport au texte source fourni. Pour chacune d’entre elles, indiquez : l’affirmation, l’identifiant de la source, la citation exacte pertinente, le verdict et, si nécessaire, une version corrigée.

Utilisez « Confirmée » lorsque la source corrobore l’intégralité de l’affirmation ; « Partiellement corroborée » lorsque la source ne la corrobore que partiellement ; « Non corroborée » lorsque les preuves sont absentes ou insuffisantes ; et « Contredite » lorsque la source est en contradiction directe avec l'affirmation. Si le texte source est manquant, indiquez que vous ne pouvez pas évaluer la corroboration. Ne déduisez pas le contenu de la source à partir de son titre ou de son URL.

[COLLER LES PAIRE AFFIRMATION–SOURCE]
Vérifiez le résultat : Même une source fiable peut ne pas étayer cette affirmation. L'absence de preuve n'est pas une contradiction.
“ Non étayé ” signifie que les éléments fournis ne permettent pas d'étayer l'affirmation. “ Contredit ” signifie que les éléments fournis sont en contradiction avec celle-ci. Cette distinction est importante lorsqu'une source n'indique encore aucun résultat : elle n'a montré ni amélioration ni détérioration.
7. Comparez les options proposées à votre dossier de décision
Choisir entre plusieurs options pour lesquelles les données disponibles sont inégales. À apporter : Vos critères, vos contraintes et des informations fiables sur chaque option.
R3 · Modèle personnalisable
Comparez les [OPTIONS] pour la [DÉCISION]. Utilisez ces critères dans l'ordre de priorité suivant : [CRITÈRES]. Contraintes strictes : [CONTRAINTES]. Utilisez uniquement les informations sur les options fournies ci-dessous.

Fournissez un tableau comparatif, le choix le mieux étayé et le fait manquant le plus susceptible de modifier ce choix. Indiquez les valeurs manquantes comme « inconnues ». Séparez les faits des jugements. N’inventez pas de prix, de scores ou de pondérations numériques. Si aucune option ne peut être sélectionnée à partir des éléments disponibles, expliquez le compromis spécifique non résolu.


[COLLEZ LES INFORMATIONS VÉRIFIÉES AVEC LEURS RÉFÉRENCES]
Vérifiez le résultat : Vérifiez si une recommandation dépend d'une valeur inconnue ou de pondérations que vous n'avez jamais choisies.
8. Transformer un sujet général en projet de recherche
Commencer ses recherches avant de disposer de suffisamment de sources pour y répondre. À apporter : Une décision, un public cible, un champ d'application et une date limite.
R4 · Modèle personnalisable
Élaborez un plan de recherche sur [QUESTION] afin d’aider [PUBLIC] à prendre la [DÉCISION]. Portée : [RÉGION, PÉRIODE ET EXCLUSIONS]. Temps disponible : [DURÉE].

Proposez cinq sous-questions ciblées. Pour chacune d’elles, fournissez les éléments de preuve nécessaires, le type de source primaire privilégié, des suggestions de termes de recherche et un résultat susceptible de modifier la décision. Terminez par les deux recherches les plus prioritaires. N’inventez pas d’études et ne prétendez pas avoir lu des sources. Si vous utilisez des outils de navigation, indiquez séparément les pages effectivement consultées et ce que chacune d’elles apporte.
Vérifiez le résultat : Le résultat est un plan. Considérez les recherches proposées et les sources potentielles comme des pistes, et non comme des recherches achevées.
Comparaison des premiers résultats · R
L'absence d'un résultat ne signifie pas que l'hypothèse a été réfutée.
| Vérifier | Instructions simples | Enseignement structuré |
|---|---|---|
| Contrôles prédéfinis pour la recherche | 6 / 8 | 7 / 8 |
| Étiquette de preuve de conservation | Contradiction · trop fort | Non pris en charge · approprié |
| Comptes invités vs début de processus d'intégration | Ce n'est pas expliqué explicitement | Ce n'est pas expliqué explicitement |
Les deux réponses ont rejeté l'idée d'un déploiement à grande échelle et ont reconnu que les projets pilotes utilisaient des définitions d'activation et des populations différentes. La version structurée a correctement qualifié l'allégation relative à la fidélisation de “ non étayée ”. La version simplifiée indiquait “ contredite ”, alors que la citation ne faisait que démontrer l'absence de résultats en matière de fidélisation. Aucune des deux réponses n'a explicitement souligné la différence entre les dénominateurs.
Les taux étaient de 40/50 comptes invités (80%) et de 54/60 démarrages de parcours d’intégration (90%). Le calcul est correct ; les mesures ne sont pas interchangeables. La réponse structurée a ajouté une vérification distincte visant à déterminer si le terme “ activation ” avait la même signification. Il s'agissait d'une question analytique supplémentaire, et non d'une quatrième affirmation formulée dans la note de déploiement.
| Réclamation relative à une note de service | Ce que prend en charge la source fournie | Traitement adapté |
|---|---|---|
| B a augmenté le taux d'activation de 10 points de pourcentage | Différents taux, définitions, dénominateurs et populations | Ne considérez pas cet écart comme une amélioration due à une cause précise |
| B : meilleure rétention | S3 : aucun résultat de rétention sur 30 jours n'est encore disponible | Non étayé ; non réfuté |
| B a réduit le délai d'intervention à six heures | S3 : médiane globale, sans ventilation par projet pilote | Aucune réduction démontrée |
Voir les huit vérifications scientifiques
1. A : 40/50 = 80%, en utilisant les comptes invités. Les deux sont valides.
2. B : 54/60 = 90%, en utilisant les débuts d’intégration. Les deux sont valides ; les citations sources contiennent les dénominateurs.
3. Signaler explicitement à la fois les différentes définitions de l’activation et les différents dénominateurs. Les deux échouent sur la partie relative au dénominateur.
4. Ne pas considérer l’absence de résultats de rétention comme une preuve d’amélioration. Les deux expliquent l’absence de données.
5. Ne pas considérer une médiane de soutien agrégée comme une diminution avérée. Les deux sont valides.
6. Ne pas déduire un bénéfice causal ni justifier un déploiement à grande échelle à partir de ces projets pilotes. Les deux répondent correctement.
7. Faire correspondre chaque affirmation et chaque étiquette de preuve à ce que la citation mentionnée vient étayer. La réponse « simple » échoue sur « Contredite » ; la réponse « structurée » répond correctement.
8. Identifier trois mesures manquantes spécifiques. Les deux répondent correctement.
L’étiquette incorrecte de la réponse « simple » est comptée une fois, lors de la vérification n° 7.
Temps écoulé : 31,35 s / 31,07 s. Nombre de jetons d'entrée et de sortie signalés : 743 + 2 822 / 832 + 2 837. Une réponse pour chaque opération ; aucune nouvelle tentative.
Instructions simples — consignes complètes et documents de référence
Répondez à l'exercice figurant à la fin de ce dossier de documentation.

# Dossier de recherche fictif

Toutes les organisations, données, citations et documents ci-dessous sont inventés dans le cadre d'un test reproductible. Les références de source ne concernent que ce dossier ; il ne s'agit pas d'études publiques.

## S1 — Clôture du projet pilote A, 2 septembre 2026

" Le projet pilote A a invité 50 comptes ; 40 ont finalisé leur activation dans les sept jours. "
" L’activation consistait à créer un espace de travail et à inviter au moins un collègue. "
" Les comptes étaient ceux de clients existants sélectionnés par l’équipe chargée de la réussite client. "
" Le projet pilote a utilisé une intégration guidée. "

## S2 — Note du tableau de bord du projet pilote B, 3 septembre 2026

" Le projet pilote B a enregistré 60 démarrages d'intégration ; 54 comptes ont créé un espace de travail dans les sept jours. "
" Ce tableau de bord considère la création d’un espace de travail comme une activation ; elle ne nécessite pas l’invitation d’un coéquipier. "
" Le nombre d’invitations n’a pas été recensé. "
" Les comptes correspondaient à de nouvelles inscriptions en libre-service à l’aide d’une liste de contrôle. "

## S3 — Analyse de l’analyste, 4 septembre 2026

" Les projets pilotes n’ont pas fait l’objet d’une répartition aléatoire et ont porté sur des populations de comptes différentes. "
" Le temps de réponse médian du service d’assistance était de six heures pour l’ensemble des deux projets pilotes ; il n’a pas été ventilé par projet. "
" Aucun résultat concernant la fidélisation à 30 jours ou le chiffre d’affaires n’est encore disponible. "

## S4 — Projet de note de déploiement, 5 septembre 2026

" Le projet pilote B a augmenté le taux d’activation de 10 points de pourcentage, amélioré la fidélisation et réduit le temps de réponse du support à six heures. Déployez la liste de contrôle auprès de tous les comptes. "
Il s’agit d’un projet de proposition, et non d’une source de données supplémentaire. Ses affirmations doivent être vérifiées par rapport aux sources S1 à S3.

## Exercice commun aux deux versions de la consigne

Réponse : Ce dossier justifie-t-il le déploiement du projet pilote B auprès de tous les comptes ?
Utilisez uniquement les sources S1 à S4. Produisez (1) une recommandation de 120 mots maximum, (2) un tableau comportant les colonnes « Affirmation », « Verdict », « ID de la source » et « Citation exacte à l’appui », et (3) les trois mesures manquantes nécessaires à une comparaison équitable.
Vérifiez les trois allégations empiriques contenues dans la note de déploiement : l’augmentation du taux d’activation, l’amélioration de la fidélisation et la réduction du temps d’assistance. Utilisez les verdicts « Étayé », « Partiellement étayé », « Non étayé » ou « Contredit », accompagnés d’une brève explication si nécessaire. Incluez les taux numériques et leurs dénominateurs dans la recommandation ou le tableau. N’inventez pas de citations, d’URL, d’effets causaux ou de conclusions qui ne figurent pas dans le dossier.
Instructions simples — réponse originale complète
## Recommandation (≤ 120 mots)

Ne lancez pas encore le projet pilote B. Le taux d’activation brut du projet pilote B (54/60 = 90%) est supérieur de 10 points de pourcentage à celui du projet pilote A (40/50 = 80%), mais les deux projets pilotes ont mesuré l"" activation " différemment (le projet B ne nécessite pas d’invitation d’un coéquipier), ont porté sur des populations différentes (nouvelles inscriptions en libre-service vs clients existants) et n’ont pas fait l’objet d’un échantillonnage aléatoire (S3) — cet écart ne peut donc pas être attribué à la liste de contrôle. L’affirmation concernant la fidélisation n’est pas étayée : S3 indique explicitement qu’il n’existe pas encore de données de fidélisation sur 30 jours. Le chiffre de " six heures " pour le temps d’assistance correspond à une médiane combinée des deux pilotes, et non à une ventilation par pilote ; aucune réduction spécifique au pilote B n’est donc démontrée. Une comparaison contrôlée, appariée et définie de manière cohérente est nécessaire avant le déploiement.

## Tableau d’audit des allégations

| Allégation | Verdict | ID source | Citation exacte à l’appui |
|---|---|---|---|
| " Le projet pilote B a augmenté le taux d’activation de 10 points de pourcentage " | Partiellement étayée — les taux bruts diffèrent de 10 points de pourcentage (54/60 = 90% contre 40/50 = 80%), mais les définitions, les populations et la conception diffèrent ; la différence n’est donc pas imputable à la liste de contrôle | S1 | " Le projet pilote A a invité 50 comptes ; 40 ont finalisé leur activation dans les sept jours. " |
| (même affirmation, suite) | | S2 | " Le projet pilote B a enregistré 60 débuts d’intégration ; 54 comptes ont créé un espace de travail dans les sept jours. " / " cela ne nécessite pas d’invitation d’un collègue " |
| (même affirmation, suite) | | S3 | " Les projets pilotes n’étaient pas randomisés et utilisaient des populations de comptes différentes. " |
| " amélioration de la fidélisation " | Contredit — aucune donnée de fidélisation n’existe pour étayer cette affirmation | S3 | " Aucun résultat concernant la fidélisation à 30 jours ou le chiffre d’affaires n’est encore disponible. " |
| " Réduction du temps de réponse du support à six heures " | Non étayé — le chiffre est une médiane combinée, non attribuée au pilote B ni présentée comme une réduction | S3 | " Le temps de réponse médian du support était de six heures pour les deux pilotes combinés ; il n’a pas été ventilé par pilote. » |

## Trois mesures manquantes sont nécessaires pour une comparaison équitable

1. Taux d’activation pour les deux projets pilotes selon une définition identique (par exemple, création d’un espace de travail *et* invitation d’au moins un collègue).
2. Temps de réponse du support technique communiqués séparément pour le projet pilote A et le projet pilote B (et non sous forme de médiane combinée), idéalement avec une référence pré-pilote.
3. Résultats en matière de fidélisation sur 30 jours (et de chiffre d’affaires) pour les deux projets pilotes, recueillis auprès de populations de comptes comparables, idéalement randomisées ou appariées.
Enseignement structuré — consignes complètes et supports pédagogiques
Répondez à cet exercice en vous appuyant uniquement sur ce dossier de documentation. Comparez les définitions, les populations et les dénominateurs avant de considérer ces deux taux comme des preuves d’amélioration. Faites la distinction entre une hypothèse préliminaire et une mesure. Appuyez chaque conclusion sur une citation exacte tirée d’une source qui la corrobore réellement, et ne mentionnez pas les éléments de preuve manquants.


# Dossier de recherche fictif

Toutes les organisations, données, citations et documents ci-dessous sont inventés dans le cadre d’un test reproductible. Les identifiants des sources se réfèrent uniquement à ce dossier ; il ne s’agit pas d’études publiques.

## S1 — Bilan du projet pilote A, 2 septembre 2026

" Le projet pilote A a invité 50 comptes ; 40 ont finalisé leur activation dans les sept jours. "
" L’activation consistait à créer un espace de travail et à inviter au moins un collègue. "
" Les comptes étaient ceux de clients existants sélectionnés par l’équipe chargée de la réussite client. "
" Le projet pilote a utilisé une intégration guidée. "

## S2 — Note du tableau de bord du pilote B, 3 septembre 2026

" Le pilote B a enregistré 60 débuts d’intégration ; 54 comptes ont créé un espace de travail dans les sept jours. "
" Ce tableau de bord considère la création d’un espace de travail comme une activation ; elle ne nécessite pas l’invitation d’un coéquipier. "
" Le nombre d’invitations n’a pas été recensé. "
" Les comptes correspondaient à de nouvelles inscriptions en libre-service réalisées à l’aide d’une liste de contrôle. "

## S3 — Analyse de l’analyste, 4 septembre 2026

" Les projets pilotes n’étaient pas randomisés et portaient sur des populations de comptes différentes. "
" Le temps de réponse médian du service d’assistance était de six heures pour les deux projets pilotes combinés ; il n’a pas été ventilé par projet. "
" Aucun résultat concernant la fidélisation à 30 jours ou le chiffre d’affaires n’est encore disponible. "

## S4 — Projet de note de déploiement, 5 septembre 2026

" Le projet pilote B a augmenté le taux d’activation de 10 points de pourcentage, amélioré la fidélisation et réduit le temps de réponse du support à six heures. Déployez la liste de contrôle sur tous les comptes. "
Il s’agit d’un projet de proposition, et non d’une source de données supplémentaire. Ses affirmations doivent être vérifiées par rapport aux documents S1 à S3.

## Exercice commun aux deux versions de la consigne

Réponse : Ce dossier justifie-t-il le déploiement du projet pilote B à tous les comptes ?
Utilisez uniquement les sources S1 à S4. Produisez (1) une recommandation de 120 mots maximum, (2) un tableau comportant les colonnes « Affirmation », « Verdict », « ID de la source » et « Citation exacte à l’appui », ainsi que (3) les trois mesures manquantes nécessaires à une comparaison équitable.
Vérifiez les trois affirmations empiriques contenues dans la note de déploiement : l’augmentation du taux d’activation, l’amélioration de la fidélisation et la réduction du temps d’assistance. Utilisez les verdicts « Confirmé », « Partiellement confirmé », « Non confirmé » ou « Contredit », accompagnés d’une brève explication si nécessaire. Incluez les taux numériques et leurs dénominateurs dans la recommandation ou le tableau. N’inventez pas de citations, d’URL, d’effets causaux ou de conclusions absentes du dossier.
Enseignement structuré — réponse originale complète
## Recommandation (≤ 120 mots)

Non — le dossier ne justifie pas le déploiement complet du projet pilote B. Projet pilote A : 40 comptes sur 50 (80%) ont atteint le stade de l"" activation ", définie comme la création d’un espace de travail *et* l’invitation d’un collègue, parmi les clients existants. Projet pilote B : 54 comptes sur 60 (90%) ont créé un espace de travail dans les sept jours, sans obligation d’invitation, parmi les nouvelles inscriptions en libre-service. L’écart brut de 10 points (90% − 80%) mélange différentes définitions, différentes populations et ne repose sur aucune randomisation (S3) ; il ne peut donc pas être interprété comme indiquant que la liste de contrôle " augmente " le taux d’activation. Il n’existe pas encore de données sur la rétention à 30 jours ni sur le chiffre d’affaires (S3) ; l’affirmation selon laquelle la " rétention s’est améliorée " n’est donc pas étayée. Le chiffre de six heures pour l’assistance correspond à une médiane *combinée* des deux pilotes, et non ventilée par pilote ; l’affirmation selon laquelle " le temps d’assistance a été réduit " ne repose donc sur aucune référence ni sur des données spécifiques à un pilote.

## Tableau

| Allégation | Verdict | ID de la source | Citation exacte à l’appui |
|---|---|---|---|
| " Le projet pilote B a augmenté le taux d’activation de 10 points de pourcentage " | Partiellement étayée — l’écart arithmétique existe (54/60 = 90% contre 40/50 = 80%), mais la comparaison est biaisée et ne peut étayer une affirmation causale de " hausse " | S1, S2, S3 | S1 : " Le pilote A a invité 50 comptes ; 40 ont finalisé leur activation dans les sept jours. " / S2 : " Le pilote B a enregistré 60 démarrages d’intégration ; 54 comptes ont créé un espace de travail dans les sept jours. " / S3 : " Les pilotes n’étaient pas randomisés et utilisaient des populations de comptes différentes. " |
| L’activation a été mesurée de la même manière dans les deux pilotes | Contradiction | S1, S2 | S1 : " L’activation consistait à créer un espace de travail et à inviter au moins un coéquipier. " / S2 : " Ce tableau de bord considère la création d’un espace de travail comme une activation ; cela ne nécessite pas d’inviter un coéquipier. " |
| " amélioration de la fidélisation " | Non étayé | S3 | " Aucun résultat concernant la fidélisation à 30 jours ou le chiffre d’affaires n’est encore disponible. " |
| " réduction du temps de réponse du support à six heures " | Non étayé | S3 | " Le temps médian de réponse du support était de six heures pour les deux projets pilotes combinés ; il n’a pas été ventilé par projet. " |

## Trois mesures manquantes nécessaires à une comparaison équitable

1. Les temps de réponse du support spécifiques à chaque projet pilote (et non regroupés), avant et après la mise en place de la liste de contrôle, afin de pouvoir isoler tout changement attribuable au projet pilote B.
2. Les chiffres de fidélisation sur 30 jours (et de chiffre d’affaires) pour les deux projets pilotes, puisqu’aucun n’existe actuellement (" Aucun résultat concernant la fidélisation sur 30 jours ou le chiffre d’affaires n’est encore disponible », S3).
3. Une définition unique et commune de l’activation (par exemple, création d’un espace de travail *et* invitation d’un coéquipier) appliquée à des populations de comptes comparables, idéalement randomisées, dans les deux projets pilotes, plutôt que de mélanger les clients existants (S1) avec les nouvelles inscriptions en libre-service (S2).
Lorsqu'un travail de recherche donne lieu à un premier jet, joignez le dossier de documentation au cahier des charges rédactionnel. L'espace de travail multimodèle de GlobalGPT vous permet de passer de la recherche à la rédaction et au développement dans un seul et même tableau de bord. Conservez les éléments probants ainsi que le résumé, afin que l'étape suivante dispose de toutes les informations nécessaires.

Claude : suggestions de codage
Une demande d'aide au codage utile décrit le comportement, l'environnement et ce qui est considéré comme fixe. Dans un chat, collez le code concerné et le message d'erreur. Dans le code Claude, faites référence à des fichiers accessibles et indiquez un critère de vérification concret. Le simple fait de copier ce texte ne transforme pas un chat en terminal.
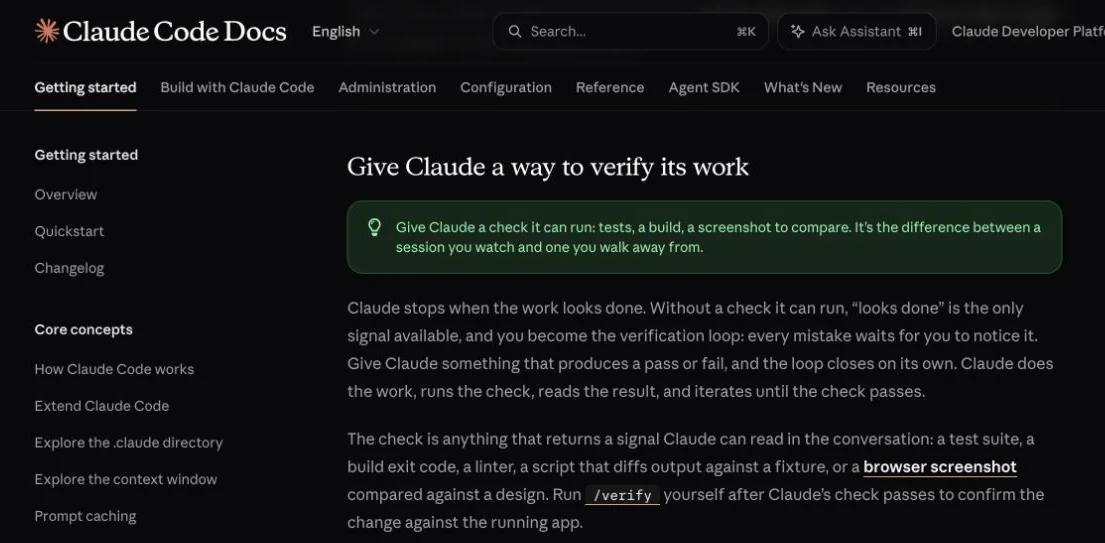
Guide d'utilisation du code Anthropic à Claude recommande de confier à l'assistant des tâches qu'il est capable d'exécuter, telles que des tests ou une compilation. Son bibliothèque officielle de messages d'invite considère les consignes comme des points de départ à adapter, avec un résultat attendu, des documents de référence et un moyen de vérifier le travail.
9. Effectuer un débogage en tenant compte des comportements explicites et des cas limites
Créer une petite fonction dont vous pouvez définir le comportement. À apporter : Code, comportement attendu, erreur ou cas d'échec, exécution et contraintes.
C1 · Exercice représentatif présenté ci-dessous
Corrigez le code conformément à la spécification complète. Vérifiez la validation avant les retours anticipés, les limites inclusives ou exclusives, ainsi que les règles qui doivent continuer à s'appliquer lorsqu'une exception est déclenchée. Conservez [PUBLIC INTERFACE]. Ne modifiez que ce que la spécification exige.


[ENTRÉES VALIDES, COMPORTEMENT EN CAS D’ENTRÉE INVALIDE, RÈGLES MÉTIER ET SORTIES ATTENDUES]


[COLLER LE CODE]


[ENVIRONNEMENT D'EXÉCUTION, DÉPENDANCES ET DISPONIBILITÉ DES OUTILS D'EXÉCUTION]


Renvoyez le code corrigé accompagné d’une brève explication. Ne mentionnez que les vérifications que vous avez effectivement effectuées. Si l’exécution n’est pas possible, indiquez-le et précisez les vérifications que je dois effectuer.
Vérifiez le résultat : Exécutez des cas de test indépendants. Une explication convaincante ne se résume pas à un programme qui s'exécute correctement.
10. Rédiger des tests à partir d'un cahier des charges
Identifier les cas manquants avant de se fier à une implémentation. À apporter : Exigences comportementales et cadre de test du projet.
C2 · Modèle personnalisable
Rédigez des tests pour [FONCTION OU COMPOSANT] à l’aide de [CADRE DE TEST]. Considérez la spécification ci-dessous comme le contrat. Couvrez le cas normal, chaque limite indiquée, les entrées non valides et les interactions entre les règles lorsque cela s’avère pertinent.

Pour chaque test, identifiez l'exigence qu'il vérifie et son résultat attendu. Conservez les exigences existantes telles quelles. Si la spécification est ambiguë, identifiez la question bloquante plutôt que de faire des suppositions. À l'aide d'outils d'exécution, exécutez les tests pertinents et consignez la commande et le résultat réels ; sinon, indiquez qu'ils n'ont pas été exécutés.


[INSÉRER LA SPÉCIFICATION]


[INSÉRER LE CODE OU RÉFÉRENCER UN FICHIER ACCESSIBLE]
Vérifiez le résultat : Les tests doivent vérifier le respect de la spécification, et non reproduire un bug présent dans l'implémentation actuelle.
Dans la mesure du possible, veillez à ce que les tests restent indépendants de l'implémentation. Pour un calculateur de frais de port, testez les seuils de poids exacts ainsi qu'une entrée non valide qui, autrement, déclencherait la livraison gratuite. Les exemples de scénarios idéaux ne suffisent pas à eux seuls à mettre en évidence les interactions entre les règles.
11. Refactoriser sans alourdir la tâche
Améliorer un petit bout de code tout en conservant son comportement. À apporter : Le code, le problème de maintenance spécifique et les exigences de compatibilité.
C3 · Modèle personnalisable
Refactorisez [CODE OU FICHIER ACCESSIBLE] afin d’améliorer [UN PROBLÈME DE MAINTENANCE SPÉCIFIQUE]. Préservez [L’API PUBLIQUE, LES TYPES DE RETOUR, LE COMPORTEMENT EN CAS D’ERREUR ET LES AUTRES CONTRATS]. Utilisez uniquement les dépendances existantes. N’ajoutez pas de fonctionnalités sans rapport et ne redessinez pas les modules adjacents.

Proposez la modification utile la plus minime possible, expliquez tout comportement que vous n’avez pas pu préserver et identifiez les tests nécessaires pour vérifier la compatibilité. Si des outils sont disponibles, exécutez ces vérifications et présentez les résultats ; sinon, indiquez les vérifications proposées et précisez qu’elles n’ont pas été exécutées.

[COLLER LE CODE ET LES TESTS PERTINENTS]
Vérifiez le résultat : Vérifiez le fichier « diff » pour repérer les modifications ne relevant pas du périmètre demandé, puis relancez les tests concernés.
12. Expliquer un code inconnu à l’aide d’une entrée concrète
Comprendre une fonction avant de la modifier. À apporter : Le code proprement dit et un exemple d'entrée représentatif.
C4 · Modèle personnalisable
Expliquez ce code à un développeur qui connaît [CONTEXTE] mais qui débute avec [LANGAGE OU PROJET]. Prenez comme exemple l'entrée suivante : [ENTRÉE]. Décrivez l'entrée, les branches pertinentes, les changements d'état et la sortie attendue.

Mettez en évidence les noms de fonctions et les expressions réels. Faites la distinction entre ce que le code montre et les hypothèses concernant les dépendances manquantes. Terminez par un cas limite qui mérite d'être testé. Ne réécrivez pas le code et n'inventez pas de comportement pour les fonctions dont les définitions sont absentes.


[COLLER LE CODE]
Vérifiez le résultat : Vérifiez la branche décrite et la valeur renvoyée par rapport au code ; signalez les dépendances manquantes comme « inconnues ».
Comparaison des premiers résultats · C
Les deux fonctions renvoyées ont réussi les 24 cas.
| Vérifier | Instructions simples | Enseignement structuré |
|---|---|---|
| Cas locaux isolés | 24 / 24 | 24 / 24 |
| Modifications apportées à la fonction « small » | Oui | Oui |
| Argument en faveur des tests basés sur des outils | Aucune affirmation de ce genre | Indique explicitement qu'aucune exécution n'aura lieu |
Les versions « simple » et « structurée » ont toutes deux géré les seuils de poids, la livraison gratuite, le supplément pour livraison en zone isolée et les entrées non valides conformément à notre cahier des charges. La réponse « structurée » indiquait explicitement qu'elle n'avait pas exécuté de tests. Nous avons ensuite testé nous-mêmes les deux fonctions ; la réponse « simple » n'avait pas non plus mentionné d'exécution.
Afficher les 24 données d'entrée et les résultats réels (réussite/échec)
| [grammes, sous-total en centimes, à distance] | Valeur attendue en cents ou exception | Nature | Structuré |
|---|---|---|---|
| [1, 0, false] | 500 | Passer | Passer |
| [1000, 0, false] | 500 | Passer | Passer |
| [1001, 0, false] | 900 | Passer | Passer |
| [5000, 0, false] | 900 | Passer | Passer |
| [5001, 0, false] | 1500 | Passer | Passer |
| [1, 9999, false] | 500 | Passer | Passer |
| [1, 10 000, false] | 0 | Passer | Passer |
| [1000, 10000, true] | 300 | Passer | Passer |
| [5001, 0, true] | 1800 | Passer | Passer |
| [1001, 9999, vrai] | 1200 | Passer | Passer |
| [5001, 10001, false] | 0 | Passer | Passer |
| [0, 0, false] | ValueError | Passer | Passer |
| [-1, 0, false] | ValueError | Passer | Passer |
| [1,0, 0, false] | ValueError | Passer | Passer |
| ["1000", 0, false] | ValueError | Passer | Passer |
| [vrai, 0, faux] | ValueError | Passer | Passer |
| [null, 0, false] | ValueError | Passer | Passer |
| [1, -1, faux] | ValueError | Passer | Passer |
| [1, faux, faux] | ValueError | Passer | Passer |
| [1, 1,5, faux] | ValueError | Passer | Passer |
| [1, " 0 ", false] | ValueError | Passer | Passer |
| [1, 0, 1] | ValueError | Passer | Passer |
| [1, 0, null] | ValueError | Passer | Passer |
| [0, 10000, false] | ValueError | Passer | Passer |
Les entrées et les résultats attendus ont été définis avant la génération. Les valeurs renvoyées devaient être des entiers exacts ; les entrées non valides devaient déclencher une exception `ValueError`. Les deux fonctions ont été vérifiées, puis exécutées dans un processus local dont l'accès au réseau, la lecture de fichiers utilisateur et l'écriture de fichiers étaient désactivés. Le fait de réussir ces tests constitue une preuve de la validité de cette fonction et de sa spécification, mais ne signifie pas pour autant qu'elle soit prête pour la production.
Temps écoulé : 12,58 s / 13,30 s. Nombre de jetons d'entrée et de sortie signalés : 553 + 735 / 621 + 1 015. Une réponse pour chaque opération ; aucune nouvelle tentative.
Instructions simples — consignes complètes et documents de référence
Modifiez la fonction conformément au cahier des charges ci-dessous et fournissez le livrable demandé.

# Calculateur fictif de frais de port

Python 3. Pas de réseau ni de modules externes. Modifiez la fonction `shipping_cents(weight_grams, subtotal_cents, remote=False)` dans le code ci-dessous.

Spécifications :
- weight_grams est un entier positif. subtotal_cents est un entier non négatif. Les valeurs booléennes Python ne sont pas des entiers valides pour ces deux entrées.
- remote doit être une valeur booléenne.
- Déclenchez une exception ValueError pour toute entrée non valide, même lorsque la commande est éligible à la livraison de base gratuite.
- Les frais de port de base s’élèvent à 500 cents pour 1 à 1 000 grammes, à 900 cents pour 1 001 à 5 000 grammes et à 1 500 cents au-delà de 5 000 grammes.
- Un sous-total d’au moins 10 000 centimes permet de bénéficier uniquement de la gratuité des frais de port de base.
- La livraison à distance ajoute 300 centimes, y compris pour les commandes bénéficiant de la gratuité des frais de port de base.
- Renvoie un entier. Préservez la signature de la fonction. Ne modifiez pas les données d’entrée, n’effectuez pas d’opérations d’E/S et n’importez pas de paquets.

Code comportant des erreurs :
```python
def shipping_cents(weight_grams, subtotal_cents, remote=False):
    if subtotal_cents >= 10 000:
 return 0
    if weight_grams < 1 000:
 fee = 500
    elif poids_grammes < 5000 :
 frais = 900
    else :
 frais = 1500
    if distant :
 frais += 300
    return frais
```

Livrable : un bloc Python « fenced » contenant la fonction corrigée, suivi d’une brève explication des modifications apportées. Ne prétendez pas avoir exécuté le code à moins de disposer effectivement des outils d’exécution. L’évaluateur testera des cas couvrant les seuils, la règle de livraison gratuite, le supplément pour livraison à distance et toutes les catégories d’entrées non valides décrites dans cette spécification.
Instructions simples — réponse originale complète
```python
def frais_de_port_en_cents(poids_en_grammes, sous-total_en_cents, distant=False) :
    if isinstance(poids_en_grammes, bool) or not isinstance(poids_en_grammes, int) :
    raise ValueError("poids_en_grammes doit être un nombre entier")
    si poids_grammes <= 0 :
  raise ValueError("poids_grammes doit être positif")
    si isinstance(sous-total_centimes, bool) ou si isinstance(sous-total_centimes, int) :
        raise ValueError("subtotal_cents doit être un entier")
    si subtotal_cents < 0 :
 raise ValueError("subtotal_cents doit être non négatif")
    si not isinstance(remote, bool) :
        raise ValueError("remote doit être un booléen")

 si weight_grams <= 1000 :
 fee = 500
    sinon si weight_grams = 10000:
 fee = 0

 if remote:
 fee += 300

 return fee
```

Modifications apportées :
1. **Validation des données d'entrée ajoutée** : Vérifie que `poids_en_grammes` et `sous-total_en_centimes` sont de type `int` (à l'exclusion de `bool`, puisque `bool` est une sous-classe de `int`), que `poids_en_grammes` est positif, que `sous-total_en_centimes` est non négatif et que `livraison_à_distance` est de type `bool`. Sinon, une exception `ValueError` est levée, même si la commande remplirait les conditions pour bénéficier de la livraison gratuite.
2. **Correction des seuils de poids** : Remplacement de `< 1000` et `< 5000` par `<= 1000` et `<= 5000` afin que les limites (1 000 g, 5 000 g) s’inscrivent dans la tranche correcte conformément au cahier des charges (" 1 à 1 000 grammes ", " 1 001 à 5 000 grammes ", " plus de 5 000 grammes ").
3. **Correction de la logique de calcul de la livraison gratuite** : le code d’origine renvoyait immédiatement `0` lorsque le sous-total remplissait les conditions pour la livraison gratuite, omettant ainsi complètement le supplément pour livraison à distance. Désormais, les frais de base sont d’abord calculés, puis remis à zéro si le sous-total remplit les conditions, et *ensuite* le supplément pour livraison éloignée est ajouté — ce qui garantit que la livraison éloignée ajoute toujours 300 centimes, même avec la livraison de base gratuite.
4. **Type de retour** : toutes les valeurs des frais restent des entiers simples, respectant ainsi l’exigence de retour de type `int`.
Enseignement structuré — consignes complètes et supports pédagogiques
Corrigez la fonction conformément au cahier des charges complet. Appliquez une validation des entrées avant tout retour anticipé, respectez les seuils inclusifs et séparez les frais de base du supplément pour livraison à distance. Fournissez la fonction demandée ainsi qu’une explication. Ne mentionnez que les vérifications que vous avez effectivement effectuées.


# Calculateur de frais de port fictif

Python 3. Pas de réseau ni de bibliothèques externes. Corrigez la fonction shipping_cents(weight_grams, subtotal_cents, remote=False) dans le code ci-dessous.

Spécifications :
- weight_grams est un entier positif. subtotal_cents est un entier non négatif. Les valeurs booléennes Python ne sont pas des entiers valides pour ces deux entrées.
- remote doit être une valeur booléenne.
- Déclenchez une exception ValueError pour toute entrée non valide, même lorsque la commande donne droit à la livraison de base gratuite.
- Les frais de port de base s’élèvent à 500 centimes pour 1 à 1 000 grammes, à 900 centimes pour 1 001 à 5 000 grammes et à 1 500 centimes au-delà de 5 000 grammes.
- Un sous-total d’au moins 10 000 cents donne droit à la gratuité des frais de port de base uniquement.
- La livraison à distance ajoute 300 cents, y compris pour les commandes bénéficiant de la gratuité des frais de port de base.
- Renvoie un entier. Préserve la signature de la fonction. Ne modifie pas les données d’entrée, n’effectue pas d’opérations d’E/S et n’importe pas de modules.

Code comportant des erreurs :
```python
def shipping_cents(weight_grams, subtotal_cents, remote=False):
    if subtotal_cents >= 10000:
 return 0
    if weight_grams < 1000:
 fee = 500
    elif poids_grammes < 5000:
 frais = 900
    else:
 frais = 1500
    if distant:
 frais += 300
    return frais
```

Livrable : un bloc Python « fenced » contenant la fonction corrigée, suivi d'une brève explication des modifications apportées. Ne prétendez pas avoir exécuté le code à moins de disposer réellement des outils d'exécution. L'évaluateur testera des cas couvrant les seuils, la règle de livraison gratuite, le supplément pour livraison à distance et toutes les catégories d'entrées non valides mentionnées dans cette spécification.
Enseignement structuré — réponse originale complète
```python
def frais_de_port_en_cents(poids_en_grammes, sous-total_en_cents, distant=False) :
    if isinstance(poids_en_grammes, bool) or not isinstance(poids_en_grammes, int) :
        raise ValueError("weight_grams doit être un entier (et non une valeur booléenne)")
    if weight_grams <= 0:
 raise ValueError("weight_grams doit être positif")
    si isinstance(subtotal_cents, bool) ou si isinstance(subtotal_cents, int) = False :
  raise ValueError("subtotal_cents doit être un entier (et non une valeur booléenne)")
    si subtotal_cents < 0 :
  lève une exception ValueError("subtotal_cents doit être non négatif")
    si isinstance(remote, bool) n'est pas vrai :
  lève une exception ValueError("remote doit être de type booléen")

    si weight_grams <= 1000 :
 base_fee = 500
    sinon si weight_grams = 10000 :
 base_fee = 0

 surcharge = 300 si remote sinon 0

 return base_fee + surcharge
```

Explication des modifications :

1. **La validation des entrées a été déplacée avant tout retour anticipé.** Le code d’origine renvoyait `0` pour `subtotal_cents >= 10000` sans valider au préalable aucune entrée. Désormais, toutes les validations (vérifications de type pour `weight_grams`, `subtotal_cents` et `remote`, y compris l’exclusion explicite du type `bool` pour les deux champs entiers, puisque `bool` est une sous-classe de `int` en Python) s’effectuent avant toute logique de calcul des frais ou instruction de retour ; ainsi, les entrées non valides déclenchent toujours une exception `ValueError`, même lorsque la commande serait par ailleurs éligible à la livraison de base gratuite.

2. **Correction des seuils inclusifs.** Le code d’origine utilisait `< 1 000` et `< 5 000`, ce qui excluait les valeurs limites (1 000 et 5 000) de la tranche inférieure, contrairement aux plages spécifiées " 1–1 000 grammes " et " 1 001 à 5 000 grammes " inclus. Remplacés par `<= 1 000` et `= 10 000`, ce qui omettait à tort la majoration pour livraison à distance pour les commandes bénéficiant de la livraison gratuite. Désormais, `base_fee` et `surcharge` sont calculés indépendamment : `base_fee` est défini à `0` lorsque le seuil du sous-total est atteint, mais `surcharge` (300 centimes si `remote`) est toujours ajouté en plus, ce qui respecte la règle " La livraison à distance ajoute 300 centimes, y compris pour les commandes avec livraison de base gratuite ".

4. **Type de retour.** Tous les composants des frais sont des entiers simples, et la somme `base_fee + surcharge` est renvoyée sous forme d’`int`, ce qui correspond à la signature et au type de retour requis.

**Vérification effectivement effectuée :** Aucune — je ne dispose pas d’outils d’exécution de code dans cet environnement, je n’ai donc pas exécuté ce code. Ce qui précède repose uniquement sur une lecture manuelle de la spécification et un suivi manuel de la logique ; je n’ai pas exécuté de cas de test sur ce code.
Pour les tâches qui combinent du code avec du texte, des images ou des vidéos, vous pouvez Relier l'interface CLI du GlobalGPT au code du Claude et intégrer le modèle et les fonctionnalités multimédias de la plateforme dans un flux de travail terminal. Commencez par définir une tâche précise et les vérifications que vous utiliserez pour valider le résultat.
Qu'est-ce qui a changé lorsque nous avons précisé les consignes ?
Une structure plus détaillée a facilité une décision de recherche lors de cette itération. Elle n’a pas supprimé la promesse supplémentaire contenue dans l’e-mail ni amélioré la fonctionnalité d’expédition, qui était déjà correcte. Comme les deux versions ont reçu un cahier des charges complet, cette comparaison constitue un rappel utile : la qualité du cahier des charges est primordiale avant de commencer à ajouter des instructions supplémentaires.
Résultats des exemples appariés
Chaque tâche nécessite des vérifications spécifiques.
| Mesure spécifique à une tâche | Instructions simples | Enseignement structuré | Que faire du résultat ? |
|---|---|---|---|
| Consigner les faits et les engagements | 8 sur 9 | 8 sur 9 | Supprimer les promesses de suivi inventées de toutes pièces |
| Vérification des données issues de la recherche | 6 sur 8 | 7 sur 8 | Corrigez l'étiquette de l'élément de preuve et comparez les dénominateurs |
| Cas de comportement en Python | 24 sur 24 | 24 sur 24 | Veillez à disposer d'un cahier des charges exécutable et de tests indépendants |
Il s'agit de chiffres issus de différentes listes de contrôle, et non de pourcentages comparables ni d'un score global du modèle. Les consignes complètes, les réponses originales et les détails du test figurent sous chaque exemple. Le temps d'exécution par passe et le nombre de tokens décrivent ces requêtes ; ils ne permettent pas de déterminer un avantage en termes de vitesse ou de coût.
Utilisez une consigne concise lorsque la mission et les documents de référence sont déjà clairs. Ajoutez une structure lorsque les instructions, les documents, les exemples ou les exigences contradictoires deviennent difficiles à distinguer les uns des autres. Les recommandations de Anthropic distinguent également les comportements spécifiques à chaque modèle, c'est pourquoi une vieille habitude consistant à exiger des vérifications personnelles répétées ne devrait pas devenir un élément systématique de chaque demande.
Comment corriger une consigne qui donne une réponse peu convaincante
Modifiez la partie qui a posé problème. Si la réponse a fixé un délai, “ améliorez ceci ” est trop vague. Signalez le détail non étayé, précisez les limites et demandez une correction ciblée. Conservez la réponse d'origine si vous comparez différentes versions de la consigne, plutôt que de la remplacer sans le signaler.
| Qu'est-ce qui a mal tourné ? | Éléments à fournir ou à modifier | Un suivi utile |
|---|---|---|
| La réponse est générique | Un livre, une activité concrète et du matériel réel | Réécrivez ce texte à l'intention de [public] en vous basant uniquement sur ces informations : [résumé]. |
| Cette voix ne me semble pas normale | Un extrait d'un texte que vous avez rédigé | Adaptez le rythme et le degré de formalité de votre texte à ceux de cet exemple ; conservez les faits exposés dans le nouveau mémoire. |
| Cela ajoute une promesse | Une limite clairement définie et la phrase incriminée | Supprimer l'engagement de suivi. La source ne l'autorise pas. |
| Cette citation semble plausible | Le passage cité | Ce passage corrobore-t-il l'affirmation dans son intégralité, seulement en partie, ou pas du tout ? |
| Ces deux pourcentages semblent comparables | Définitions, dénominateurs, populations, période | Précisez par quel nombre chaque pourcentage est divisé avant de comparer les taux. |
| Le code semble correct, mais il ne fonctionne pas. | Une entrée défaillante reproductible et le résultat attendu | Cette entrée devrait renvoyer [valeur], mais renvoie [valeur]. Corrigez la règle et exécutez ce cas. |
Lorsqu'il s'agit d'une exigence réellement manquante, demandez à Claude de poser une question ciblée. Pour une tâche courante disposant d'un contexte suffisant, un entretien obligatoire de vingt questions ne fait que retarder le travail. De même, demandez une explication concise, des preuves ou des résultats de tests plutôt qu'un compte rendu détaillé d'un raisonnement interne.
Enregistrez les indications utiles ainsi que le format de saisie et les vérifications qui ont permis de détecter les erreurs. Si la tâche devient un processus de travail standardisable, Utilisation de Claude via une API vous permet de gérer les versions des invites et de conserver l'historique des requêtes. Vérifiez à nouveau vos propres exemples lorsque le modèle ou les exigences de la tâche changent.
FAQ
Que doit contenir une bonne consigne Claude ?
Précisez la tâche à accomplir, le contexte ou les sources pertinentes, les contraintes importantes, le résultat attendu et les critères permettant de vérifier si la tâche a été menée à bien. Pour une demande simple, une seule phrase peut couvrir plusieurs de ces éléments. Adoptez une structure plus détaillée lorsque vous combinez des documents, des exemples ou des règles qui, sans cela, pourraient prêter à confusion.
Les invites Claude nécessitent-elles des balises XML ?
Non. Un langage clair et simple constitue un bon point de départ. Les balises XML peuvent aider à distinguer les instructions, les exemples et le texte source dans une consigne complexe. Utilisez des libellés descriptifs qui facilitent la compréhension des différentes parties. Les balises ne garantissent pas l'exactitude des faits, et leur simple présence ne suffit pas à établir qu'une consigne est meilleure qu'une autre.
Le Claude peut-il vérifier les sources qu'il ne parvient pas à ouvrir ?
Il peut analyser le texte que vous lui fournissez, mais le titre ou l'URL d'une source ne suffisent pas à déterminer le contenu d'une page. Collez le passage concerné ou utilisez les outils de navigation disponibles pour le retrouver. Vérifiez ensuite à la fois la citation et si celle-ci étaye bien l'affirmation qui y est associée.
Puis-je utiliser la même commande dans le chat Claude et dans Claude Code ?
Vous pouvez réutiliser la tâche et les contraintes, mais adaptez la demande aux outils disponibles. Dans le chat, fournissez le code et le contexte pertinent. Dans Claude Code, vous pouvez faire référence aux fichiers de projet accessibles et demander leur exécution. Une invite indiquant “ exécuter les tests ” ne constitue pas une preuve que les tests ont effectivement été exécutés.
Les meilleurs modèles Claude sont ceux que vous pouvez adapter et vérifier. Commencez par une tâche récurrente, remplacez l’exemple par le vôtre et utilisez les points de contrôle indiqués à côté du modèle avant de vous fier à la réponse. Essayez le workflow dans la version GlobalGPT lorsque l'étape suivante nécessite un autre modèle ou un autre outil d'IA dans le même espace de travail.
Sources et date du test : Les consignes officielles et la documentation relative au code Claude ont été vérifiées le 14 septembre 2026. Les exemples appariés ont été générés à cette date à l'aide de Claude dans GlobalGPT, à partir de données fictives. Consultez l'intégralité des consignes et des réponses ci-dessus, puis adaptez un modèle à votre propre tâche.