
Le modèle « Lunar Foundation Model » de la NASA et d'IBM est un modèle d'intelligence artificielle ouvert destiné à l'analyse des observations lunaires. Annoncé le 10 septembre 2026, cet outil peut être adapté pour détecter des cratères, mettre en évidence des formations volcaniques et prédire des tendances sur une carte de prospection glaciaire. Les avancées rapportées concernent des critères de référence spécifiques à la recherche : le résultat phare concernant la glace est une réduction de l’erreur de prédiction, et non la découverte de 22% davantage d’eau sur la Lune.
Pour les étudiants et les chercheurs, les points de départ utiles sont les suivants : fiche officielle du modèle, le rapport technique et le code mis à disposition. Ensemble, ces documents expliquent ce que le modèle a appris, quelles tâches ont été évaluées et ce dont vous auriez besoin pour mettre en place votre propre expérience.
Si votre première tâche consiste à comprendre les résultats de la recherche, GlobalGPT réunit la recherche de sources, l'analyse de documents, le raisonnement et la rédaction au sein d'un seul et même espace de travail multimodèle. Il offre un moyen abordable de passer de termes scientifiques peu familiers à un cahier des charges de recherche clair, le tout grâce à un seul abonnement.

Qu'est-ce que le modèle de base lunaire NASA-IBM ?
L'annonce de la NASA présente ce projet comme un modèle de base pour la science lunaire, développé en collaboration avec IBM. Un modèle de base apprend des schémas réutilisables à partir d'un vaste ensemble de données ; les chercheurs adaptent ensuite ces schémas à une tâche plus spécifique. Ici, les données concernées sont issues de la télédétection lunaire, et non du langage courant.
Le LFM de la NASA et d'IBM utilise un encodeur et un décodeur de type « vision transformer », dotés d'une architecture ViT-B. Ses données d'entrée comprennent des images et d'autres produits d'observation à différentes résolutions spatiales. Un scientifique peut adapter la représentation obtenue à la détection, à la segmentation ou à la régression — trois méthodes permettant de repérer des objets, de délimiter des régions et de prédire des valeurs numériques.
Cette version s'avère donc utile aux équipes travaillant sur des cartes lunaires ainsi qu'aux étudiants qui se consacrent à l'apprentissage automatique appliqué à l'astronomie. La lecture de ce projet est également intéressante pour quiconque souhaite comprendre comment un modèle d'IA scientifique est évalué. L'utilisation de son « checkpoint », cependant, relève davantage d'un processus de calcul scientifique que d'une conversation par chat.
À partir de quelles données apprend-il ?
Le fiche de modèle décrit les données d'entraînement de SomBench : 963 609 ensembles de tuiles provenant de caméras grand angle (WAC) et 1 000 113 ensembles provenant de caméras à angle étroit (NAC). L'échelle de la WAC est d'environ 100 mètres par pixel ; celle de la NAC est d'environ 1 mètre par pixel. Cela permet au modèle de disposer à la fois d'un contexte topographique plus large et de détails de surface beaucoup plus fins, sur environ deux millions de lots de tuiles.
IBM décrit l'ensemble des ressources de données composé de plus de 30 couches alignées provenant de neuf instruments répartis sur quatre missions. La fiche du modèle précise 11 modalités d'entrée. Ces figures décrivent les différentes étapes du pipeline de données : couches sources, exemples d'entraînement regroupés et types d'entrées que le modèle encode.
Un projet, trois unités de comptage différentes
IBM décrit une base de données constituée à partir des données fournies par neuf instruments utilisés dans le cadre de quatre missions.
Les 963 609 kits WAC et les 1 000 113 kits NAC offrent deux niveaux de supports pédagogiques.
Le modèle intègre différents types d'observations, notamment des images et des données topographiques.
Les couches de sources, les ensembles de tuiles et les modalités d'entrée prennent en compte des éléments différents. Sources : Description du jeu de données d'IBM et le fiche officielle du modèle.
L'éclairage fait également partie intégrante de la conception. Le modèle reçoit des données géométriques d'observation, notamment les angles d'éclairage, sous forme de contexte explicite. Cela permet de distinguer l'aspect d'une surface sous un éclairage donné des motifs du terrain sous-jacents qu'il est en train d'apprendre.
Un pixel correspondant à environ 100 mètres de terrain ne peut pas révéler les mêmes détails qu'un pixel correspondant à environ 1 mètre. C'est pourquoi les résultats concernant les cratères obtenus par le WAC et le NAC méritent une attention particulière. Un gain observé sur des images à grande échelle ne signifie pas pour autant un gain équivalent sur les petites caractéristiques de surface.
Ce projet s'inscrit dans la lignée de l'approche de pré-entraînement de TerraMind, mais s'appuie dès le départ sur des données lunaires. Il convient donc de le considérer comme un modèle conçu pour les observations lunaires, et non comme une version rebaptisée d'un modèle destiné à l'observation de la Terre. La question qui se pose est de savoir en quoi la représentation qu'il a apprise contribue à une tâche lunaire spécifique.
Trois tâches qu'il peut prendre en charge
Les évaluations publiées portent sur trois familles de tâches. Chacune d'entre elles donne lieu à un type de réponse différent ; la notion de “ meilleur ” varie donc en fonction de la tâche.
| Tâche | Sortie | Ce que ce résultat permet de mettre en évidence |
|---|---|---|
| Détection des cratères | Rectangles de délimitation autour des cratères sur les images WAC ou NAC | Comparaison de l'efficacité d'un détecteur à repérer et à localiser des cratères marqués. |
| Segmentation irrégulière de la tache de la jument | Une représentation au niveau du pixel des caractéristiques de la surface volcanique | Étudier dans quelle mesure les régions prédites correspondent aux limites des caractéristiques étiquetées. |
| Régression de la prospectivité des glaces polaires | Prévision continue d'une carte de prospective fondée sur les connaissances | Comparaison des résultats avec un modèle de référence pour des conditions pouvant être liées à la présence de glace. |
La détection des cratères et la segmentation des caractéristiques volcaniques peuvent aider les chercheurs à organiser et à analyser les images. Leur utilité dépend des étiquettes, de l'échelle et de la zone d'évaluation. Un modèle qui donne de bons résultats sur un ensemble de test défini doit tout de même être évalué au regard des données et de la problématique scientifique d'un nouveau projet.
La prospectivité glaciaire nécessite une interprétation des plus minutieuses. L'objectif est d'établir une carte, fondée sur les connaissances, des zones où la présence de glace serait plausible, et non de mesurer directement les gisements de glace. Une meilleure concordance avec cette carte peut faciliter la recherche sur les tendances et les régions susceptibles d'en abriter. Cela ne signifie pas pour autant qu'une quantité supplémentaire d'eau ait été découverte.
Que signifient les résultats des tests de performance ?
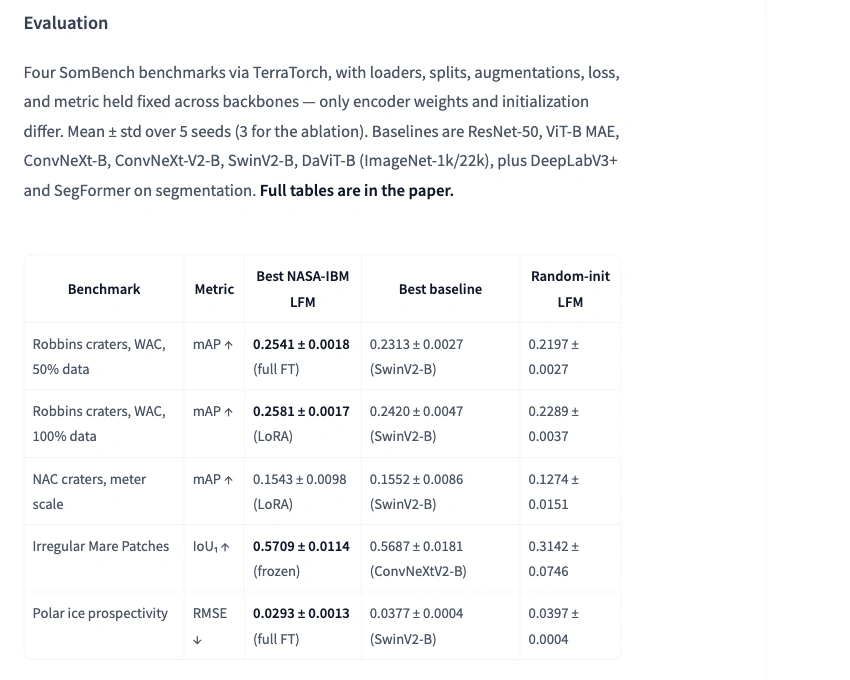
Le rapport technique fournit les moyennes et les écarts-types obtenus à partir de cinq graines aléatoires. Ses résultats comparent des configurations adaptées du modèle lunaire à des références désignées du modèle de vision. Nous avons vérifié les tableaux publiés ; nous n'avons pas reproduit les expériences relatives au modèle lunaire.
Ces indicateurs permettent de répondre à différentes questions. La précision moyenne (mAP) évalue la détection des objets ; l'intersection sur l'union (IoU) mesure le chevauchement entre les régions prédites et celles étiquetées ; l'erreur quadratique moyenne (RMSE) mesure l'erreur de prédiction numérique. Plus les valeurs de mAP et d'IoU sont élevées, mieux c'est, tandis qu'une RMSE faible est préférable. Ces indicateurs ne doivent pas être combinés en un seul score de précision.
Erreur de prospectivité glaciaire : le gain le plus net jamais signalé
L'erreur quadratique moyenne (RMSE) a diminué, passant de de 0,0377 à 0,0293 contre SwinV2-B, un 22,31 TP40T : réduction relative. Plus la valeur RMSE est faible, plus la concordance avec la carte de prospectivité glaciaire de référence est étroite.
RMSE : plus la valeur est faible, mieux c'est. Les barres partent de zéro. Moyenne ± écart-type sur cinq échantillons. L'objectif est une carte de prospectivité modélisée, et non une mesure de la glace.
| Tâche et données | Système métrique ↑ | Modèle lunaire | Une base solide |
|---|---|---|---|
| Cratères WAC · Données d'entraînement 50% | mAP | 0,2541 ± 0,0018 réglage précis complet | 0,2313 ± 0,0027 SwinV2-B |
| Cratères WAC · Données d'entraînement 100% | mAP | 0,2581 ± 0,0017 LoRA | 0,2420 ± 0,0047 SwinV2-B |
| Cratères du NAC · Données d'entraînement 100% | mAP | 0,1543 ± 0,0098 LoRA | 0,1552 ± 0,0086 SwinV2-B |
| Taches irrégulières sur la jument | IoU1 | 0,5709 ± 0,0114 encodeur bloqué | 0,5687 ± 0,0181 ConvNeXtV2-B |
Les auteurs décrivent les résultats concernant les cratères et les formations volcaniques à l'échelle du mètre comme étant comparables à des références fiables. Leurs légères différences doivent être considérées à la lumière des variations d'une série à l'autre.
Source : Rapport technique NASA-IBM, tableaux 4 à 7, pages 16 et 18. Il s'agit des résultats des auteurs, et non d'une reproduction indépendante.
Le résultat « 22% ice » correspond à une réduction de l'erreur
En ce qui concerne le potentiel de présence de glace, la configuration lunaire la plus performante présente une erreur quadratique moyenne (RMSE) de 0,0293, contre 0,0377 pour SwinV2-B. Le calcul est le suivant : (0,0377 − 0,0293) ÷ 0,0377 × 100 = 22,31 TP40T. Le RMSE mesure l'erreur de prédiction par rapport à la carte de référence ; plus il est faible, mieux c'est. Ce pourcentage ne correspond ni à un score de précision, ni à une variation de la quantité de glace lunaire.
Les résultats relatifs aux cratères dépendent de la métrique et de l'échelle des données
Avec 50% de données d'entraînement WAC, le modèle « lunar » enregistre un mAP de 0,2541 contre 0,2313 pour SwinV2-B. Ce même résultat du modèle lunaire dépasse également la valeur de référence de 0,2420 obtenue avec 1 001 TP40T de données d'entraînement. La première comparaison utilise des fractions de données égales ; la seconde démontre l'efficacité de l'étiquetage dans cette expérience particulière.
L'amélioration d'environ 191 TP40T constatée par IBM peut être mise en regard avec les valeurs AP@75 du rapport pour un ensemble de données d'entraînement de 501 TP40T : 0,2213 contre 0,1862, soit une augmentation relative de 18,91 TP40T. L'AP@75 évalue les détections à un seuil de chevauchement donné. Il ne faut pas l'interpréter comme une augmentation de 19% de la métrique mAP du tableau.
À l'échelle NAC plus fine, le mAP du modèle lunaire est de 0,1543 et celui de la méthode de référence de 0,1552. Pour les « Irregular Mare Patches », les valeurs d’IoU de premier plan rapportées sont respectivement de 0,5709 et 0,5687 par rapport à ConvNeXtV2-B. Les auteurs décrivent ces tâches comme comparables à des références solides. Ces légères différences, associées à la variation rapportée entre les exécutions, ne permettent pas d’affirmer que le modèle lunaire l’emporte sur tous les plans.
Où se le procurer et quels sont les frais d'accès ?
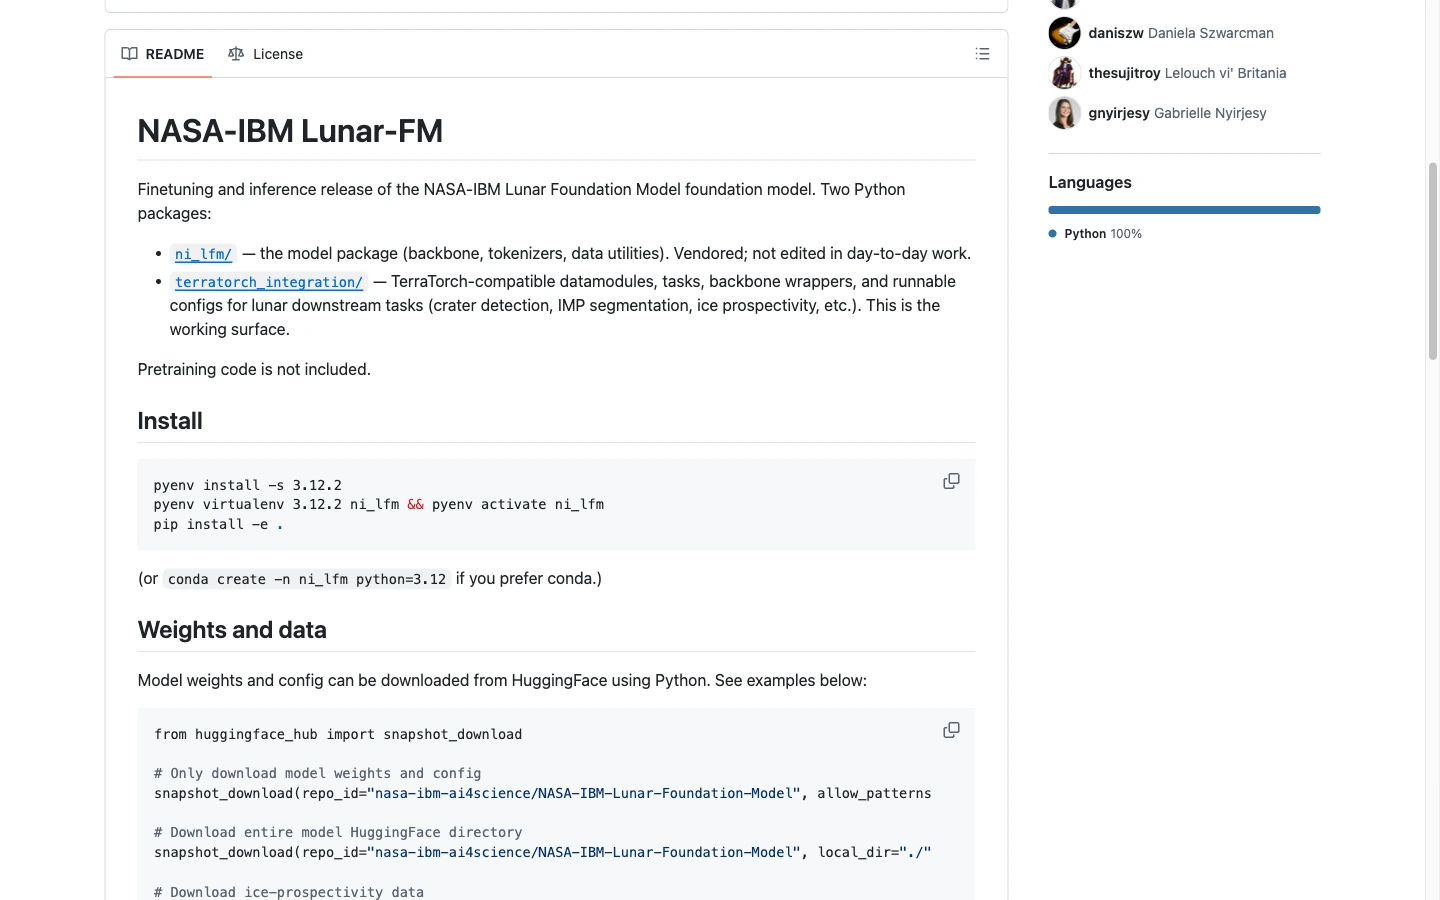
Commencez par consulter les ressources officielles ci-dessous. Les poids du modèle et le code sont soumis à une licence Apache 2.0, et le point de contrôle est accessible au public. Le dépôt décrit plus précisément un Mise à jour concernant l'ajustement et l'inférence; il exclut explicitement le code de pré-entraînement.
Choisissez la ressource qui vous permettra de passer à l'étape suivante
Commencez par les utilisations prévues, les données d'entrée, les conditions d'utilisation et les restrictions.
L'onglet « Fichiers » contient le point de contrôle publié et les fichiers associés.
Utilisez le fichier README et les configurations de tâches TerraTorch pour planifier une expérience.
Suivez la collection officielle pour accéder aux modèles et ensembles de données en aval associés.
Les tableaux 4 à 7 présentent les résultats des tâches, les paramètres et les variations d'un essai à l'autre.
Découvrez la version de démonstration du projet. Nous n'avons pas procédé à une génération dans le cadre de cette évaluation.
Lors d'une vérification effectuée le 28 septembre 2026, la fiche du modèle n'indiquait aucun fournisseur d'inférence Hugging Face déployé. Un point de contrôle téléchargeable et une page de démonstration constituent des voies d'accès distinctes.
Si vous souhaitez adapter le modèle, sélectionnez la tâche en aval avant de configurer l'expérience. Le référentiel fournit des composants et des configurations compatibles avec TerraTorch qui relient le point de contrôle, la tâche et les données. TerraTorch est le framework logiciel utilisé pour organiser ce workflow d'entraînement et d'évaluation.
- Lisez la fiche du modèle et le fichier README, puis choisissez entre la détection, la segmentation ou la régression en fonction de la question scientifique posée.
- Récupérez les données correspondantes et le point de contrôle officiel, puis examinez la configuration des tâches et les instructions relatives à l'environnement du référentiel.
- Préparez les données pour cette configuration et exécutez le workflow de réglage fin ou d'inférence correspondant.
- Évaluer par rapport à une référence appropriée et conserver la répartition des données, les paramètres et les résultats afin de pouvoir vérifier le résultat.
L'accès libre supprime l'achat d'une licence de modèle dès le début du processus, mais la réalisation d'une expérience engendre tout de même des coûts. Il faut disposer de ressources de calcul, d'espace de stockage, de moyens pour la préparation des données, ainsi que du temps nécessaire à l'évaluation. Un point de contrôle publié n'est pas automatiquement accompagné d'une API hébergée ni d'un temps de GPU gratuit, et les sources ne définissent pas de configuration minimale universelle en matière de GPU pour chaque tâche en aval.
| Votre objectif | Ressource ou coût à prévoir |
|---|---|
| Lire et évaluer le communiqué | Communiqués, fiche de modèle, rapport et référentiel. |
| Exécuter ou adapter le modèle scientifique | Ressources informatiques et de stockage adaptées, données pertinentes, configuration de l'environnement et travaux d'évaluation. |
| Comprendre des articles et rédiger une synthèse de recherche | Un espace de travail pour assistant de recherche tel que GlobalGPT, offrant un accès aux modèles et aux outils de gestion de documents dans le cadre d'un seul abonnement. |
Utiliser l'IA pour comprendre la recherche
Une première question pertinente doit être ciblée : “ Que mesure réellement l’amélioration de 22% mentionnée ? ” Pour y répondre, il faut un objectif, un indicateur, une valeur de référence et un calcul. Demander ces quatre éléments est plus utile que de demander à un assistant si le modèle est impressionnant.
GlobalGPT vous permet de mener à bien ce travail de lecture, depuis la recherche de sources jusqu'à l'explication des documents et à la rédaction, sans avoir à passer d'un outil à l'autre à chaque étape. Pour une méthode reproductible, élaborer une note de synthèse dont les sources ont été vérifiées en fournissant une brève liste de sources et des questions précises avant de demander un résumé abouti.
Des sources officielles à une note d'information utile
- Récupérez la matière première. Commencez par l'annonce de la NASA, puis ajoutez la fiche technique, le rapport technique et le fichier README. Vous pouvez recherche avec Perplexity sur GlobalGPT pour trouver des sources à l'appui.
- Posez des questions précises. Demandez à un assistant de vous expliquer séparément les notions de mAP, d'IoU et de RMSE, puis d'énumérer la cible, la référence et le cadre d'évaluation correspondant à chaque affirmation.
- Vérifie et écris. Rouvrez le tableau mentionné, vérifiez chaque chiffre et transformez les notes vérifiées en un compte rendu qui respecte les limites scientifiques.
Nous avons testé une version allégée de ce workflow avec GPT-5.6 Sol. Le système a reçu un ensemble d’informations issues des quatre sources officielles et devait produire un bref compte-rendu, classer six allégations, calculer la réduction de l’erreur quadratique moyenne (RMSE) et proposer des mesures concrètes à prendre. La tâche s’appuyait sur le texte fourni ; le système n’a pas recherché de nouveaux éléments d’information.
Un test de synthèse à partir de sources
Nous avons fourni à GPT-5.6 Sol un petit ensemble de données tirées du communiqué de la NASA, de la fiche technique officielle, du rapport technique et du fichier README de GitHub. Il devait rédiger un compte-rendu, vérifier six affirmations et expliquer le calcul de l'erreur quadratique moyenne (RMSE).
- Espace de travail et date
- GlobalGPT · 28 septembre 2026
- Appliquer la politique
- Une seule épreuve ; une seule réponse complète ; pas de deuxième tentative
- Entrée
- Dossier source de 355 mots comprenant quatre identifiants de source
- Champ d'application
- Lecture et synthèse ; pas de recherche en temps réel ni d'exécution du modèle lunaire
- Paramètres de réponse
- Limite du nombre de jetons de sortie : 4 096 ; tous les autres paramètres de contrôle d'échantillonnage restent aux valeurs par défaut du service
- Utilisation et coût
- 2 154 jetons au total ont été déclarés ; la réponse ne mentionnait aucun montant
La première réponse a su rester dans le cadre des affirmations scientifiques
La réponse a donné lieu à une note d'information de 112 mots, qui réfutait l'affirmation selon laquelle le modèle avait découvert 22% de glace réelle supplémentaire, et maintenait les restrictions concernant la certification des sites d'atterrissage et l'accès au code de pré-entraînement. Ses trois étapes suivantes renvoyaient à la fiche officielle du modèle, au point de contrôle et aux ressources de TerraTorch.
Il s'agissait d'un exercice de lecture à partir de documents fournis. Le dossier de référence indiquait déjà les principales contraintes. Le résultat ne permet pas d'évaluer les performances en matière de recherche autonome ou de déduction par télédétection lunaire.
Consultez l'invite exacte et le paquet source
SYSTÈME
Vous êtes un rédacteur scientifique rigoureux travaillant pour un étudiant universitaire. Utilisez uniquement le dossier de sources fourni. Ne faites pas de recherches supplémentaires. Faites la distinction entre les mesures de référence rapportées et les mesures scientifiques réelles. Citez les identifiants des sources entre crochets. Si une affirmation n'est pas étayée, indiquez-le clairement. N’inventez pas de citations, de prix, de configuration matérielle requise ou de résultats expérimentaux. Fournissez la réponse demandée, sans exposer de raisonnement sous-jacent.

UTILISATEUR
Transformez le dossier de sources en une note de recherche pratique. Rendez : (1) un résumé en langage clair de 100 à 130 mots ; (2) un tableau de vérification des affirmations sur six lignes utilisant exclusivement les mentions « Étayée » ou « Non étayée », un identifiant de source et une explication en une phrase pour chaque affirmation fournie ; (3) la réduction relative de l’erreur quadratique moyenne (RMSE) calculée de 0,0377 à 0,0293, arrondie à une décimale, accompagnée d’une formule et d’une phrase expliquant ce qu’elle ne mesure pas ; (4) trois prochaines étapes concrètes pour un étudiant souhaitant examiner ou adapter le modèle publié. La réponse doit comporter moins de 500 mots.

Allégations à vérifier :
1. La NASA et IBM ont annoncé publiquement le modèle le 10 septembre 2026.
2. L’erreur quadratique moyenne (RMSE) relative au potentiel de glace est passée de 0,0377 pour SwinV2-B à 0,0293 pour le modèle lunaire entièrement affiné.
3. Le modèle a permis de découvrir 22% de glace d’eau supplémentaire sur la Lune.
4. La NASA a validé ce modèle pour la certification des sites d’atterrissage et l’évaluation des risques.
5. La publication sur GitHub inclut le code de pré-entraînement.
6. Un point de contrôle ouvert garantit que le calcul sur GPU et l’inférence hébergée sont gratuits.

Source :
[S1] Communiqué de la NASA, 10 septembre 2026.
Titre : La NASA et IBM lancent un modèle de base d’IA pour la science lunaire.
URL : https://science.nasa.gov/science-research/artificial-intelligence-lunar-foundation-model/
La NASA a annoncé un modèle de base dédié à la science lunaire développé en collaboration avec IBM. Il est hébergé publiquement sur Hugging Face, et son code est disponible sur GitHub. Il peut être adapté à la cartographie des cratères, à l’identification des formations volcaniques et à la recherche sur les glaces polaires.

[S2] Fiche officielle du modèle NASA-IBM et rapport technique, consultés le 28 septembre 2026.
URL de la fiche du modèle : https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
URL du rapport technique : https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model/blob/main/NI_LFM_Technical_Report.pdf
Le tableau 7 du rapport (page 18) présente l’erreur quadratique moyenne (RMSE) sur l’ensemble de test pour la régression de la prospectivité glaciaire. Plus la valeur est faible, meilleur est le résultat. Moyenne ± écart-type sur cinq graines aléatoires : modèle LFM NASA-IBM avec ajustement complet, 0,0293 ± 0,0013 ; SwinV2-B pré-entraîné sur ImageNet, 0,0377 ± 0,0004. L’objectif est d’obtenir une carte de la prospectivité de la glace fondée sur les connaissances. Il s’agit de résultats de référence communiqués par les auteurs, et non d’une reproduction indépendante ni d’une mesure directe de la glace d’eau.
Tableau 4 (page 16), cratères WAC avec des données d’entraînement 50% : le mAP des boîtes englobantes est de 0,2541 ± 0,0018 pour LFM entièrement affiné et de 0,2313 ± 0,0027 pour SwinV2-B. Dans les mêmes lignes, l’AP@75 est respectivement de 0,2213 ± 0,0028 et 0,1862 ± 0,0041. Ces métriques ne doivent pas être interverties.

[S3] Fiche technique officielle du modèle, Utilisation prévue / Hors champ d’application / Limites.
URL : https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
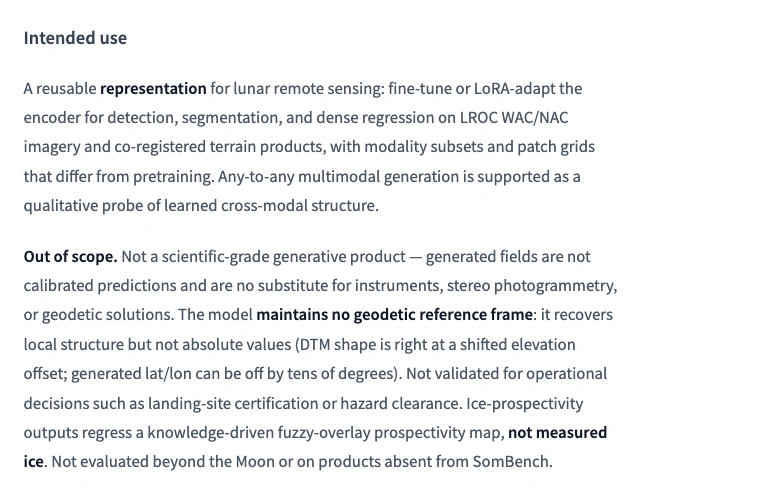
L’utilisation prévue est la télédétection lunaire par ajustement fin ou adaptation LoRA pour la détection, la segmentation et la régression dense. Le modèle n’est pas validé pour la certification des sites d’atterrissage ni pour l’évaluation des risques. Les résultats relatifs à la prospectivité glaciaire correspondent à une carte fondée sur des connaissances, et non à des mesures réelles de la glace. Les champs générés constituent des indicateurs qualitatifs, et non des prévisions scientifiques calibrées. Le modèle ne dispose pas d’un référentiel géodésique absolu. Il n’a pas été évalué au-delà de la Lune. La licence indiquée est Apache-2.0. La page ne fait état d’aucun déploiement via Inference Provider. Ce pack ne promet pas de calcul GPU gratuit ni d’inférence hébergée gratuite, et ne précise pas de configuration matérielle minimale ni de prix pour l’API hébergée.

[S4] Fichier README officiel sur GitHub, consulté le 28 septembre 2026.
URL : https://github.com/NASA-IMPACT/NASA-IBM-Lunar-Foundation-Model
Le dépôt décrit une version dédiée au réglage fin et à l’inférence. Le code de pré-entraînement n’est pas inclus. Les poids et la configuration peuvent être téléchargés depuis le dépôt officiel de modèles Hugging Face. Des modules de données, des tâches, des wrappers de backbone et des configurations de tâches compatibles avec TerraTorch sont fournis. L’ajustement fin et les tests nécessitent les données, le point de contrôle et la configuration de tâche correspondants. Le fichier README mentionne une licence Apache 2.0.
Consulter la première réponse dans son intégralité
## 1. Présentation

La NASA et IBM ont annoncé le Lunar Foundation Model le 10 septembre 2026. La version publique fournit des poids sur Hugging Face ainsi que du code de fin-ajustement et d’inférence sur GitHub, destiné à des tâches de télédétection lunaire telles que la cartographie des cratères, l’identification des formations volcaniques et la recherche sur la glace polaire. Selon les résultats communiqués, son benchmark de prospection de glace améliore le RMSE par rapport à un modèle SwinV2-B pré-entraîné sur ImageNet, mais l’objectif est une carte basée sur les connaissances, et non une mesure directe de la glace lunaire. Le résultat est rapporté par les auteurs sur cinq graines aléatoires et ne constitue pas une reproduction indépendante. Le modèle est destiné à être adapté par un affinage complet ou via LoRA, mais n’est pas validé pour la certification de sites d’atterrissage ni pour l’évaluation des risques. Le code de pré-entraînement est absent, et la publication ne promet ni calcul GPU gratuit ni inférence hébergée. [S1][S2][S3][S4]

## 2. Tableau de vérification des allégations

| Allégation | Verdict | Source | Explication |
|---|---|---|---|
| 1 | Confirmée | [S1] | L’annonce de la NASA est datée du 10 septembre 2026 et identifie le modèle comme un projet NASA–IBM. |
| 2 | Confirmée | [S2] | Le tableau 7 indique des valeurs de RMSE de 0,0377 pour SwinV2-B et de 0,0293 pour le modèle lunaire entièrement affiné. |
| 3 | Non pris en charge | [S2] | Les chiffres correspondent à des erreurs de référence par rapport à une carte de prospectivité basée sur les connaissances, et non à des mesures réelles de glace d’eau lunaire. |
| 4 | Non pris en charge | [S3] | La fiche du modèle indique explicitement que celui-ci n’est pas validé pour la certification des sites d’atterrissage ni pour l’évaluation des risques. |
| 5 | Non pris en charge | [S4] | Le dépôt GitHub fournit des ressources de réglage fin et d’inférence, mais exclut le code de pré-entraînement. |
| 6 | Non pris en charge | [S3] | Le dossier ne promet aucune capacité de calcul GPU gratuite ni aucune inférence hébergée, et ne signale aucun déploiement par un fournisseur d’inférence. |

## 3. Réduction relative de l’erreur quadratique moyenne (RMSE)

\[
\frac{0,0377 - 0,0293}{0,0377} \times 100 = 22,3\%
\]

Il s’agit d’une **réduction relative de 22,3% de la RMSE du benchmark rapportée par les auteurs** ; elle ne mesure pas la découverte de glace d’eau supplémentaire ni les performances scientifiques validées de manière indépendante. [S2]

## 4. Prochaines étapes pratiques

1. Lisez les utilisations prévues, les limites et la licence Apache-2.0 de la fiche de modèle avant de sélectionner une tâche de détection, de segmentation ou de régression. [S3]
2. Téléchargez le checkpoint officiel et la configuration depuis Hugging Face, puis examinez les wrappers backbone et les configurations de tâches sur GitHub. [S4]
3. Procurez-vous le jeu de données lunaire pertinent et utilisez les composants compatibles TerraTorch fournis pour affiner le modèle et le tester, en notant que le code de pré-entraînement n’est pas disponible et que les résultats des tests de performance doivent faire l’objet d’une évaluation indépendante. [S2][S4]
Le résultat utile a été la préservation des distinctions : erreur de référence par opposition à glace détectée, utilisation à des fins de recherche par opposition à certification de atterrissage, et code d’adaptation publié par opposition à code de pré-entraînement absent. Ces limites figurant déjà dans le paquet source, cela témoigne de la réussite de la tâche de lecture et de synthèse, et non du fait qu’un assistant aurait pu identifier de manière indépendante toutes les réserves.
Pour un projet de plus grande envergure, organiser une session de recherche plus approfondie assistée par l'IA autour de questions distinctes concernant les données, les méthodes, l'évaluation et les limites. Gardez le tableau source à côté de votre brouillon et revérifiez chaque chiffre après chaque modification. Cette habitude est plus importante que la fluidité du premier résumé.
Les limites qui comptent dans la pratique
La fiche technique précise que le modèle lunaire n'a pas été validé pour des décisions opérationnelles telles que la certification d'un site d'atterrissage ou la vérification de l'absence de dangers. Un modèle scientifique peut aider à analyser des observations sans pour autant permettre de certifier qu'un engin spatial peut atterrir en toute sécurité à un endroit donné. Ces utilisations nécessitent un niveau de validation différent.
Les champs générés doivent également être considérés avec prudence. Le modèle ne conserve pas de référentiel géodésique absolu, et les valeurs générées peuvent s'écarter des valeurs physiques. Les auteurs décrivent cette génération comme un outil d'analyse qualitative plutôt que comme une prévision scientifique calibrée. Une carte de terrain ou d'observation qui semble plausible ne doit pas être considérée comme un produit issu de mesures.
Ce point de contrôle n'a pas été évalué au-delà de la Lune. Même dans le cadre de la recherche lunaire, le bilan est mitigé : des progrès évidents pour certaines tâches et des résultats comparables pour d'autres. La leçon à retenir est qu'il faut évaluer le modèle par rapport à la cible, à l'échelle, aux données et à la base de référence qui correspondent à votre expérience.
Foire aux questions
L'utilisation du modèle « Lunar Foundation Model » développé par la NASA et IBM est-elle gratuite ?
La fiche officielle du modèle et le référentiel de code mentionnent une licence Apache 2.0, et le point de contrôle est accessible au public. La réalisation d'expériences nécessite toutefois des ressources informatiques adaptées, une préparation des données et une évaluation spécifique à chaque tâche. L'accès libre au modèle ne garantit pas la gratuité des ressources de calcul GPU ni de l'inférence hébergée.
Le « Lunar Foundation Model » de la NASA et d'IBM est-il un chatbot ?
Il s'agit d'un modèle de base destiné à la télédétection lunaire, conçu pour traiter des images, des produits topographiques et des données d'observation associées. Les chercheurs l'adaptent à des tâches de détection, de segmentation et de régression. Un assistant de chat peut aider à expliquer la documentation, mais l'interaction avec un chatbot ne relève pas du même processus de travail que l'exécution de ce modèle.
Le modèle a-t-il permis de découvrir davantage de glace d'eau sur la Lune ?
Le résultat rapporté concernant la présence de glace mesure dans quelle mesure les prévisions correspondent à une carte de prospectivité glaciaire fondée sur les connaissances. La meilleure valeur de RMSE rapportée passe de 0,0377 à 0,0293 par rapport à la référence citée, soit une réduction relative d’environ 22%. Il s’agit d’une amélioration par rapport à la référence ; ce n’est pas une mesure de la quantité supplémentaire de glace découverte.
Puis-je découvrir le projet sans écrire de code ?
Vous pouvez consulter le communiqué de la NASA, examiner la fiche de modèle, explorer les tableaux de référence publiés et visiter la page de démonstration officielle sans avoir à mettre en place un pipeline d’entraînement. L’adaptation du point de contrôle publié à une tâche scientifique s’effectue à l’aide du code, des données et des configurations TerraTorch du référentiel, puis fait l’objet d’une validation spécifique à la tâche.
Quel est le lien entre le modèle lunaire et Prithvi et Surya ?
Ils s'inscrivent dans le cadre plus large de la collaboration entre la NASA et IBM sur les modèles de base destinés à la science. La NASA décrit les modèles « Prithvi » pour l'observation de la Terre et les applications météorologiques, « Surya » pour l'héliophysique, et le modèle lunaire pour l'observation de la Lune. Leurs domaines d'application et les tâches auxquelles ils sont destinés diffèrent ; le modèle lunaire n'a pas encore fait l'objet d'évaluations au-delà de la Lune.
Le modèle « Lunar Foundation Model » développé conjointement par la NASA et IBM offre un point de départ réutilisable pour la recherche en télédétection lunaire. Utilisez les tableaux officiels pour comprendre ses atouts, la fiche descriptive du modèle pour définir ses limites, et les ressources mises à disposition pour planifier une expérience adaptée à une tâche spécifique. Si votre objectif immédiat est d'apprendre ou de rédiger un document, commencez par transformer ces sources en un dossier d'information validé.
Transformez un article technique en une note d'information pratique
Importez vos sources officielles dans GlobalGPT, approfondissez les concepts qui vous sont peu familiers et transformez les résultats validés en notes claires ou en un projet finalisé, le tout au sein d'un seul et même espace de travail multimodèle.
Découvrez les travaux de recherche sur le GlobalGPT








