Para crear un vídeo largo generado por IA con un personaje coherente, constrúyelo como una sucesión de planos cortos en lugar de utilizar una sola indicación demasiado extensa. Dale al personaje una identidad visual definida, haz que cada clip cumpla una función clara y revisa el montaje antes de pasar a la siguiente escena.
Por eso yo empezaría por Vídeo GlobalGPT. Puedes crear la imagen de referencia, pasar a una secuencia de vídeo como Seedance o Veo y mantener el texto breve junto a los clips, en lugar de volver a crear la configuración en sitios distintos. Tu editor habitual se encarga, como siempre, del montaje final.
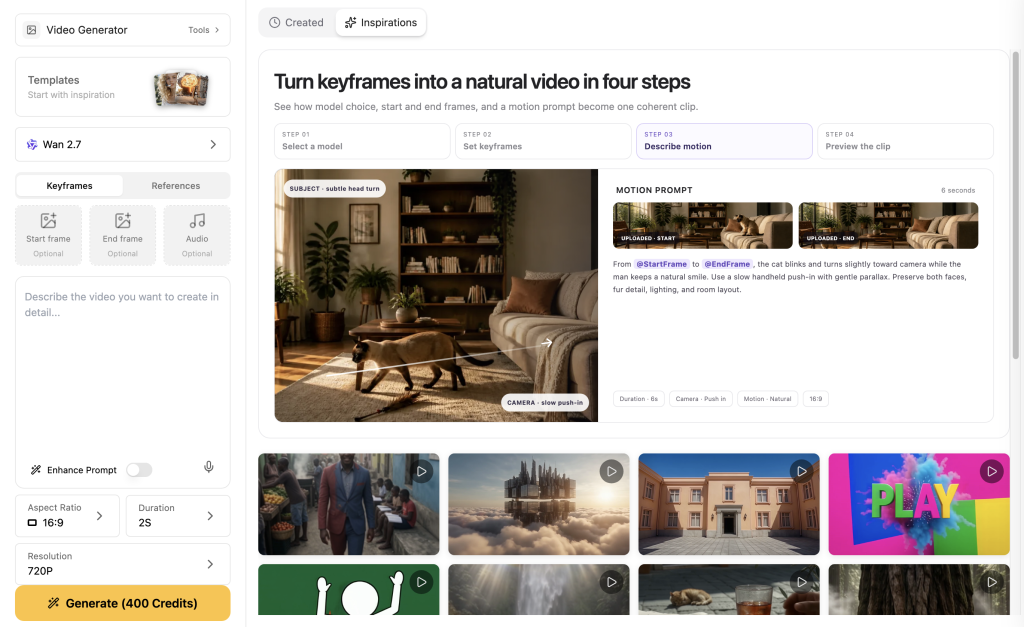
Cómo crear una secuencia más larga en GlobalGPT
Abrir Vídeo GlobalGPT y ve de izquierda a derecha: crea el recurso del personaje, redacta un guion de tomas, genera clips cortos y, a continuación, comprueba el montaje entre cada par. No escribas la historia completa en la primera indicación.
Paso 1: Crea una imagen de referencia en Image
Utilice el Imagen Espacio de trabajo para crear una referencia clara del personaje. Pide una vista frontal o de tres cuartos, de cuerpo entero si es posible, y los elementos visuales fijos que necesites más adelante. Guarda la primera imagen más impactante como imagen maestra del personaje.
Paso 2: Redacta una ficha de personaje de una página
Divide el paquete en debe permanecer, puede cambiar, y debe aparecer en esta toma. Una cartera puede aparecer en la imagen, pero puede desaparecer si el encuadre de la cámara es demasiado ajustado.
Paso 3: Ve a «Vídeo» y elige una toma corta
Elige una ruta de vídeo disponible, como Seedance o Veo. Añade la imagen de referencia cuando la ruta muestre un control de referencia de imagen; en caso contrario, pega el paquete fijo completo al principio de cada indicación. Genera primero una toma de referencia sencilla.
Paso 4: Generar la siguiente toma a partir del mismo paquete
Reproduce exactamente la frase con los personajes fijos. Cambia únicamente la ubicación, la acción y la cámara. Añade un requisito de continuidad visible, como “bolsa de color crema en el hombro izquierdo”.”
Paso 5: Revisa la unión y, a continuación, edita los clips aprobados
Compara el último segundo del clip anterior con el primer segundo del siguiente. Corrige únicamente el clip defectuoso o suprime el corte con un plano de detalle; a continuación, monta los clips aprobados en tu editor habitual.
Crea una secuencia, no una indicación enorme
Un vídeo largo generado por IA tiene dos funciones: debe crear un plano y debe recordar al personaje del plano anterior. Una unidad de producción más eficaz es un clip corto con un estado inicial claro y una sola acción.
Prepara un paquete de personajes antes de crear el vídeo
- Corregido: silueta, paleta de colores, prendas características y atrezo.
- Flexible: el tiempo, la ubicación, el ángulo de la cámara y la acción.
- Requisitos por toma: Indica los datos fijos que deben aparecer.
Convierte la historia en un registro de tomas
Antes de empezar a crear, divide una idea de 60 segundos en pequeñas secciones. El registro permite corregir cualquier fallo de continuidad: basta con retocar una toma en lugar de volver a empezar toda la historia.
Lo que mostraban los cuatro primeros fragmentos de vídeo
Se trata de los primeros resultados válidos generados por un conjunto fijo de caracteres, no de una prueba de rendimiento. La cámara puede ocultar indicios de identidad incluso cuando la indicación los repite.
Prueba 01: Toma de ancla
KITE-07 camina por una pasarela mojada de un invernadero situado en una azotea y, a continuación, se detiene para examinar un tornillo de latón suelto de un conducto de ventilación. Plano secuencia medio.- Itinerario: Seedance 2.0 a través de Anywhere
- Salida: primer archivo MP4 válido, 5,054 segundos descodificados; 16:9, 480p, 24 fps
- Lo que se mantuvo: cuerpo de color verde azulado, lente ámbar y bufanda roja.
- Límite: El encuadre cercano ocultaba la mochila y la mayoría de los arañazos en el hombro.
Prueba 02: El mismo personaje, una nueva escena
El mismo KITE-07 está sentado en el banco de un taller, abre la bolsa de herramientas de color crema y ajusta el mecanismo de un reloj de bolsillo de latón. Plano medio cercano.- Itinerario: Seedance 2.0 a través de Anywhere
- Salida: primer archivo MP4 válido, 5,054 segundos descodificados; 16:9, 480p, 24 fps
- Lo que se mantuvo: Con un jersey verde azulado y una bufanda roja, se dirigió al lugar de la reparación.
- Toma: Incluye un accesorio imprescindible en la escena, no solo en la descripción.
Prueba 03: Cambio de cámara
El mismo KITE-07 atraviesa un pasillo de baldosas bañado por la luz del sol, llevando la misma cartera de color crema. Plano bajo con desplazamiento lateral.- Itinerario: Seedance 2.0 a través de Anywhere
- Salida: primer archivo MP4 válido, 5,054 segundos descodificados; 16:9, 480p, 24 fps
- Lo que se mantuvo: gafas, bufanda, bolso de mano y motivo de rascarse el hombro.
- Toma: Las tomas con un encuadre más amplio permiten demostrar la continuidad con mayor claridad.
Prueba 04: Segunda ruta de vídeo
El mismo KITE-07 se gira desde una ventana del estudio salpicada por la lluvia y introduce un engranaje de latón en la cartera de color crema. Primer plano lento.- Itinerario: Veo 3.1 Rápido desde cualquier lugar
- Salida: primer archivo MP4 válido; el reproductor del navegador mostraba 8 segundos.
- Lo que se mantuvo: cuerpo de color verde azulado, cristales de color ámbar, arañazos, bolso tipo cartera y bufanda.
- Límite: Comprobación del flujo de trabajo, no una comparación de rendimiento.
Ensambla la secuencia más larga sin ocultar los puntos de ruptura
Compara el último fotograma de un clip con el primer fotograma del siguiente. Realiza un corte a un primer plano, añade una toma de transición o regenera únicamente el clip que no cumple con los criterios.
El papel de GlobalGPT
Empezar en Vídeo GlobalGPT Para crear la imagen de referencia, genera clips utilizando una ruta de vídeo disponible y guarda el paquete de indicaciones junto a los resultados. Lee un Flujo de trabajo con imágenes de referencia para lograr personajes coherentes o un Guía de extensión Sora 2 para la tarea siguiente.
PREGUNTAS FRECUENTES
¿Puede la IA crear un vídeo largo con el mismo personaje?
Sí, pero créalo como una secuencia de clips cortos en lugar de una sola generación enorme. Fija primero el paquete de personajes, asigna una acción a cada clip y utiliza el final de un plano como punto de partida para el siguiente.
¿Qué detalles deben mantenerse fijos en cada indicación?
Mantén fijos los elementos más reconocibles de la identidad: el rostro o la silueta, la paleta de colores, la ropa o el accesorio característico y un atrezo. Reproduce esos detalles en el mismo orden cada vez y, a continuación, añade únicamente la nueva ubicación, la acción y la indicación de cámara.
¿Necesito una imagen de referencia para cada toma?
Utiliza siempre la misma imagen de referencia aprobada cuando la ruta seleccionada lo permita, sobre todo en el caso de un plano recurrente. No obstante, conviene repetir la toma tal y como está descrita, ya que un encuadre muy cerrado puede ocultar un detalle que sí aparece en la imagen de referencia.
¿Cuánto debe durar cada clip de vídeo generado por IA?
Cada clip debe ser lo suficientemente breve como para incluir una acción clara y un cambio de toma legible. Un fragmento de entre cinco y diez segundos suele ser más fácil de revisar y corregir que una secuencia larga con múltiples localizaciones o acciones.
¿Puedo cambiar el fondo sin cambiar el personaje?
Sí. Mantén el conjunto de elementos identificativos tal y como está, describe el nuevo entorno en una frase aparte y haz que se vea una prenda o un accesorio característico en la nueva composición. Cambia una variable principal cada vez cuando pruebes un nuevo escenario.
¿Por qué mi personaje de IA se cambia de ropa o pierde un accesorio?
Un atrezo puede pasar desapercibido porque desentona con la escena o porque la cámara nunca lo muestra. Incorpora los objetos importantes en la propia acción, por ejemplo, “sostiene la bolsa de nata mientras la abre”, y especifica el encuadre en el que deben aparecer.