Actualizado el 18 de septiembre de 2026.
Nuestro veredicto: GPT-6 Astra proporcionó respuestas útiles en las tres pruebas que realizamos: conciliación de pedidos, una función de agregación en Python y una consulta de políticas con 500 notas. Gestionó correctamente los valores que faltaban y las reglas contradictorias, y la función que generó superó 10 comprobaciones fuera de línea. Esto hace que merezca la pena tenerlo en cuenta para trabajos analíticos minuciosos, pero tres pequeñas pruebas no bastan para determinar su fiabilidad en entornos de producción ni su superioridad frente a otros modelos.
Llamamos gpt-6-astra a través del servicio de modelos basado en la CLI de GlobalGPT, utilizando datos de entrada sintéticos y guardando las respuestas sin procesar. No se trataba de una prueba directa de la API OpenAI ni de una prueba de suscripción a ChatGPT. Las llamadas de extremo a extremo tardaron entre 4,87 y 9,07 segundos en este lote, y el saldo de la cuenta se redujo en 391,08 créditos.
Este análisis muestra lo que pedimos, lo que nos proporcionó Astra, lo que superó las pruebas y hasta dónde llegan los datos. Las especificaciones oficiales y los precios aparecen por separado de nuestras mediciones.

Índice
- Resultados prácticos del GPT-6 Astra
- Cómo probamos Astra a través de la API
- Prueba 1: ¿Es capaz Astra de conciliar datos de pedidos desordenados?
- Prueba 2: ¿Funciona realmente el código generado?
- Prueba 3: ¿Es capaz de resolver conflictos entre reglas en un paquete largo?
- Cuánto cuestan estas pruebas de rutas de API
- ¿Está disponible GPT-6 Astra?
- Especificaciones del GPT-6 Astra
- Precios de la API de GPT-6 Astra
- ¿Qué novedades presenta realmente GPT-6 Astra?
- Por qué Astra influye en la decisión de compra
- Lo que dicen los primeros críticos
- Limitaciones iniciales y cuestiones pendientes
- ¿Quién debería utilizar GPT-6 Astra?
- Elige el Astra o un modelo más pequeño en función de la tarea
- Lo que este análisis aún no demuestra
- Preguntas frecuentes
Resultados prácticos del GPT-6 Astra
| Prueba | Resultado observado | Duración del trayecto | Tokens de entrada/salida | Abonos en el libro mayor |
|---|---|---|---|---|
| Conciliación de pedidos | 5/5 comprobaciones de respuestas superadas | 5,663 s | 2,171 / 144 | 67 |
| Función de agregación de Python | Se han superado los 10 de 10 casos sin conexión | 9,065 s | 2,091 / 486 | 105 |
| Paquete de políticas de 500 notas | 6/6 respuestas correctas; se incluyen las fuentes requeridas para las seis respuestas | 4,868 s | 17,445 / 160 | 219 |
Se trata de tres tareas diferentes, cada una con una llamada al modelo; no son ensayos repetidos ni una tasa de éxito medida de 100%. El tiempo abarca desde la solicitud completa a la CLI/al proveedor hasta que se devuelve el resultado; no hemos medido el tiempo hasta el primer token. El registro muestra los créditos en números enteros, mientras que la variación del saldo incluye las fracciones.
Cómo probamos Astra a través de la API
Utilizamos la misma cuenta GlobalGPT ya existente para las tres llamadas. Cada una de ellas fue una solicitud nueva y sin estado, en la que la tarea se proporcionó en forma de archivo de texto. La etiqueta del modelo solicitada y devuelta fue gpt-6-astra. El servicio devolvió el texto de la respuesta, el uso de tokens de entrada/salida y un campo de error; ninguno de los tres resultados indicó ningún error. El etiquetado del proveedor no constituye una auditoría independiente de la ruta del modelo anterior.
Preparamos la clave de respuestas de los pedidos y las respuestas del paquete de políticas antes de las llamadas. A continuación, validamos el código generado localmente con 10 casos creados tras recibirlo; estos no formaban parte de un conjunto de pruebas de codificación preestablecido. Solicitamos JSON en la instrucción y comprobamos si se analizaba correctamente, en lugar de habilitar un esquema nativo de salida estructurada.
Todos los datos introducidos fueron inventados. No se enviaron registros de clientes, archivos de la empresa, secretos contables ni datos personales. No utilizamos herramientas de navegación ni de control informático para realizar las tareas, y no volvimos a intentar dar una respuesta para mejorar su puntuación. La CLI no reveló la configuración del esfuerzo de razonamiento ni el desglose de los tokens almacenados en caché para estas ejecuciones.
Prueba 1: ¿Es capaz Astra de conciliar datos de pedidos desordenados?
Las preguntas y las respuestas
El archivo CSV de ocho filas incluía un duplicado antiguo, un sustituto más reciente, un pedido pendiente, devoluciones y un pedido sin importe bruto. Las reglas consistían en conservar la versión más reciente de cada pedido, excluir los pagos pendientes, restar las devoluciones y mantener los ingresos que faltaban como «desconocidos».
Los ingresos netos previstos y conocidos ascendían a $275: Búsqueda $170, correo electrónico $75 y red social $30. La opción A requería una deduplicación, la C una exclusión y la F debía quedar sin determinar. No bastaba con que el total fuera correcto para superar las cinco comprobaciones.
Lo que devolvió Astra
{"known_net_usd":275,"channel_known_net_usd":{"Búsqueda":170,"Correo electrónico":75,"Redes sociales": 30},"unknown_order_ids":["F"],"excluded_order_ids":["C"],"replaced_order_ids":["A"]}
Las cinco comprobaciones se superaron. Y lo que es más útil aún, en su conclusión se decía: “Los ingresos netos totales siguen sin conocerse porque faltan los ingresos brutos del pedido F”.” Se denominó correctamente «Search», el mayor conocido subtotal, sin alegar que el pedido por correo electrónico que faltaba tenía un valor nulo.
Nuestra valoración: Este fue un buen resultado para una tarea de conciliación sencilla. El modelo siguió las normas contables y tuvo en cuenta la incertidumbre. No se trataba de una prueba de conexión en tiempo real con una hoja de cálculo, ni de miles de transacciones, ni de cumplimiento fiscal, ni de decisiones financieras autónomas.
Prueba 2: ¿Funciona realmente el código generado?
Corregir un cálculo erróneo de los ingresos
Hemos suministrado el patrón defectuoso sum(float(r.get('gross_usd') or 0) for r in records) y pidió una función escrita íntegramente en Python que gestionara las actualizaciones con duplicados, el estado de los pagos, los reembolsos, los valores que faltaban, las listas de ID ordenadas y los datos de entrada vacíos. Tenía que utilizar céntimos enteros internamente y dejar los registros de entrada sin modificar.
Astra devolvió una función que utiliza Decimal para convertir importes a céntimos, guarda el último registro por pedido y omite los importes brutos desconocidos en lugar de introducir un cero. Descodificamos los caracteres de escape de salto de línea en la cadena de código devuelta, revisamos sus importaciones y operaciones, y la ejecutamos localmente sin modificar su lógica.
Diez comprobaciones sin conexión
| Caso | Resultado |
|---|---|
| Conciliación original de ocho filas | Pasar |
| Entrada vacía | Pasar |
| El registro más reciente aparece antes que el más antiguo | Pasar |
| La última actualización cambia un pedido a «pendiente» | Pasar |
| Importes brutos en blanco y nulos | Pasar |
| Si no se indica el importe del reembolso, se toma por defecto el valor cero. | Pasar |
| Cálculo aritmético de 0,10 + 0,20 céntimos | Pasar |
| Reembolsos totales y parciales | Pasar |
| Un canal cuyos ingresos se desconocen | Pasar |
| Identificadores desconocidos y excluidos ordenados | Pasar |
La inmutabilidad de las entradas también se mantuvo en los 10 casos. Nuestra valoración: La función resultaba apta para el contrato especificado, y la ejecución local aportó pruebas más sólidas que un simple ejemplo de código verosímil. No se realizaron pruebas con marcas de tiempo mal formadas, múltiples divisas, implementación, un repositorio real, transacciones de base de datos ni rendimiento a gran escala.
Prueba 3: ¿Es capaz de resolver conflictos entre reglas en un paquete largo?
Cinco notas relevantes entre 500
Creamos un paquete de 73 252 caracteres con 500 notas numeradas. Los datos relevantes se distribuían entre las notas 037, 114, 261, 398 y 477: una antigua norma de reembolso de 30 días, una norma estándar más reciente de 14 días, una excepción empresarial de 30 días, un cambio de propietario, precios anuales frente a equivalentes mensuales y una cuestión para la que faltaban pruebas.
Se ha registrado la solicitud completa 17 445 tokens de entrada. Se trata de una comprobación modesta de un documento extenso, muy por debajo de la capacidad de 1,05 millones de tokens anunciada por Astra. Las notas de contexto eran simples elementos de distracción, por lo que resultó más sencillo que una colección desordenada de documentos del mundo real.
Normas correctas, precios e incertidumbre
| Pregunta | La respuesta de Astra | Documentación necesaria |
|---|---|---|
| Plazo estándar de devolución en el norte | 14 días | 114 |
| Ventanilla de devolución de North Enterprise | 30 días | 477 |
| Actual propietario de North | Lin | 114 |
| Pago anual de Atlas | $129.60 | 261 |
| Equivalente mensual de Atlas | $10.80 | 261 |
| Derecho a la devolución de dinero en el sur | nulo / desconocido | 398 |
Las seis respuestas eran correctas e incluían las notas justificativas requeridas. En el caso de la respuesta estándar sobre la devolución, se citaba además la nota sobre la excepción empresarial, que aportaba un contexto relevante. Devolvía los identificadores de las notas como cadenas de caracteres; no se había requerido ningún esquema de identificadores numéricos.
Nuestra valoración: Astra resolvió correctamente la revisión y la excepción, y no inventó el derecho que faltaba. Esto constituye una prueba útil para la síntesis de políticas acotadas. No valida la investigación en tiempo real, los documentos jurídicos arbitrarios, la búsqueda de elementos concretos entre casi un millón de tokens ni la resistencia a instrucciones maliciosas incrustadas en las fuentes.
Cuánto cuestan estas pruebas de rutas de API
Las tres carreras registradas 21 707 tokens de entrada y 790 tokens de salida. El libro mayor de GlobalGPT mostraba 67, 105 y 219 créditos; el saldo de la cuenta pasó de 15.477,71 a 15.086,63 créditos, lo que supone una disminución de 391,08 créditos. No convertimos esos créditos en un cargo en efectivo ficticio.
A modo de ejemplo presupuestario independiente, al aplicar las tarifas estándar de contexto corto de OpenAI —$10 por cada millón de tokens de entrada no almacenados en caché y $50 por cada millón de tokens de salida— a las cifras comunicadas, se obtiene aproximadamente $0.2566: $0,0289 para los pedidos, $0,0452 para el código y $0,1825 para el paquete. Esto supone que los datos de entrada no están almacenados en caché y que no hay cargos adicionales. No se trata de la factura de nuestras llamadas GlobalGPT ni de un coste OpenAI directo medido.
En esta tanda, la ejecución del paquete fue más rápida que la del código, a pesar de que había más tokens de entrada. Una sola ejecución por tarea no permite establecer una clasificación de latencia: la longitud de la salida, el enrutamiento, las colas y las condiciones de procesamiento pueden variar. No realizamos una comparación con un competidor equivalente.
¿Está disponible GPT-6 Astra?
Sí. Astra aparece en el catálogo de GlobalGPT, y las tres nuevas consultas devolvieron un resultado denominado «gpt-6-astra». OpenAI también publica documentación sobre los modelos de la API; el acceso a Chat, Work y Codex son derechos de producto independientes.
Las capturas de pantalla del 4 de septiembre que se muestran a continuación corresponden al periodo de lanzamiento. El texto que acompaña a su publicación es histórico y no constituye una prueba de que la entrada GlobalGPT de hoy no esté disponible.
Especificaciones del GPT-6 Astra
Astra admite entradas de texto e imágenes y genera resultados en forma de texto. Su ventana de contexto de 1,05 millones de tokens se adapta a la escala necesaria para grandes repositorios, colecciones de documentos o historiales extensos de agentes, mientras que el límite máximo de salida de 128 000 le permite generar código o informes de gran volumen.
La capacidad no es lo mismo que la calidad. Una ventana de un millón de tokens no garantiza que cada detalle se recuerde igual de bien, y enviar la máxima cantidad de contexto puede aumentar tanto el coste como el ruido. Para trabajar de forma práctica con contextos largos, recupera primero los archivos más relevantes y mantén las instrucciones de la tarea de forma explícita.
Si quieres tener una referencia sobre cómo gestionaba la generación anterior las solicitudes de gran tamaño, consulta el Guía de precios y contexto de GPT-5.5. Para obtener una visión más amplia y orientada a las tareas, la guía de casos de uso de GPT-5.5 ayuda a identificar las cargas de trabajo que podrían justificar la elección de un modelo insignia.
Precios de la API de GPT-6 Astra
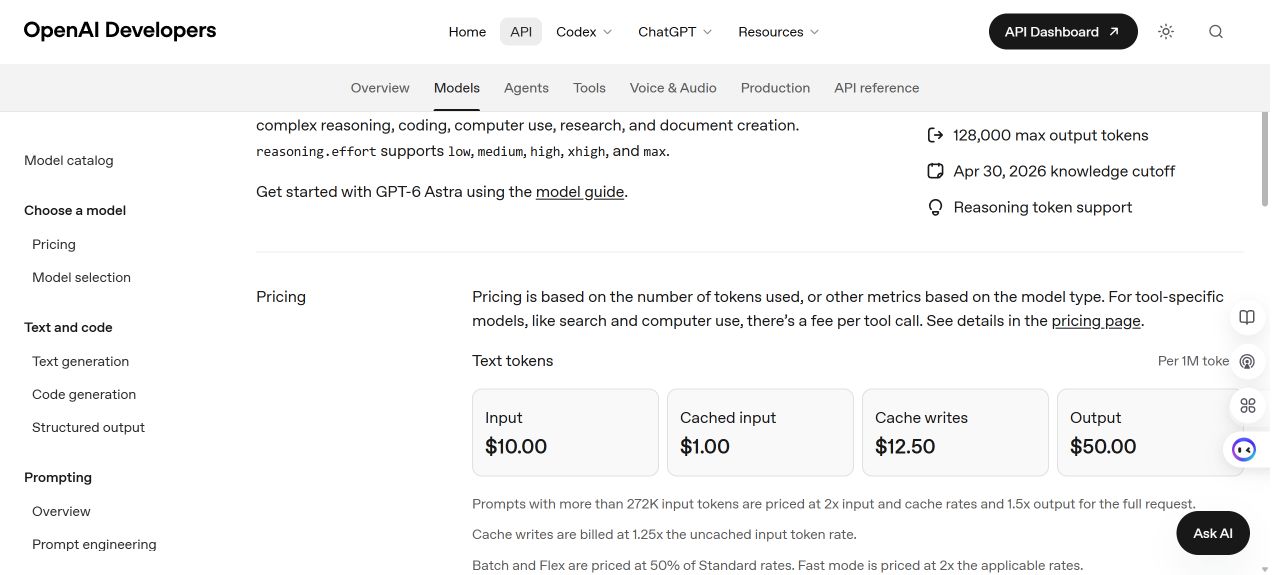
En el documento OpenAI se enumeran las siguientes tarifas de procesamiento estándar para solicitudes de hasta 272 000 tokens de entrada:
Las tarifas se volvieron a comprobar el 18 de septiembre de 2026 comparándolas con Precios de la API OpenAI. Se trata de las tarifas estándar de los tokens de la API, no de los precios de la suscripción a ChatGPT ni de los cargos por crédito de GlobalGPT.
| Categoría de token | Precio por 1 millón de tokens | Qué significa |
|---|---|---|
| Entrada | $10.00 | Nuevo contenido de las indicaciones, historial, material recuperado y otros datos facturables. |
| Entrada almacenada en caché | $1.00 | Entrada repetida válida servida mediante el almacenamiento en caché de las indicaciones. |
| Escritura en caché | $12.50 | Los datos introducidos en la caché se facturan según la tarifa de escritura en caché correspondiente. |
| Salida | $50.00 | Respuesta generada y exposición de los motivos facturables. |
Cuando una solicitud supera los 272 000 tokens de entrada, OpenAI aplica un Multiplicador de 2x para las velocidades de entrada y de entrada almacenada en caché y un Multiplicador de 1,5 veces para las tarifas de salida para la solicitud completa. Según las tarifas estándar indicadas, eso supone $20 por cada millón de tokens de entrada y $75 por cada millón de tokens de salida.
Límite de precios:
Estas son las tarifas de los tokens API OpenAI, no los precios mensuales de la suscripción ChatGPT ni los créditos GlobalGPT. Los cargos por herramientas, los niveles de procesamiento, la configuración regional y otras comisiones pueden modificar el coste final.
Para conocer el contexto histórico de la tarifa, véase Precios de GPT-5.6 y los precios de GPT-5.4. Compara la carga de trabajo completa, no solo la tarifa por entrada: la longitud de la salida, el comportamiento de la caché, el uso de herramientas y las tasas de error o de reintentos pueden ser más importantes que el precio que aparece en el titular.
¿Qué novedades presenta realmente GPT-6 Astra?
OpenAI Guía de los últimos modelos destaca un conjunto de características orientadas al trabajo interactivo y de larga duración de los agentes.
Llamada asíncrona a herramientas
Astra puede seguir avanzando mientras las herramientas más lentas siguen en ejecución, en lugar de considerar cada llamada a una herramienta como una parada definitiva. Esto puede resultar útil para la investigación, la programación y las tareas operativas que combinan varios sistemas externos con diferentes tiempos de respuesta.
Instrucciones durante la tarea
Los usuarios pueden añadir instrucciones mientras una tarea está en curso. Esto resulta útil cuando un agente va, en general, por buen camino, pero necesita una nueva restricción, un cambio de prioridad o un alcance más concreto. Debería reducir la necesidad de cancelar una tarea de larga duración y empezar de nuevo.
Esfuerzo de razonamiento dinámico
Astra puede ajustar el nivel de razonamiento que aplica durante una tarea. En principio, esto le permite dedicar más esfuerzo a los pasos difíciles y menos a los rutinarios. No obstante, los equipos deberían comprobar si la mejora en la calidad compensa el coste adicional en tokens de salida para su propia carga de trabajo.
El uso del ordenador y la continuidad en tareas prolongadas
OpenAI posiciona a Astra para la interacción con el ordenador y para tareas que se desarrollan a lo largo de múltiples pasos. La cuestión práctica no es si es capaz de navegar por una demostración haciendo clic, sino si puede recuperarse de situaciones inesperadas, mantener la intención del usuario y explicar qué ha cambiado. Esas son las áreas que deberían evaluar los primeros usuarios.
Los lectores interesados en la evolución desde el diálogo deliberativo hasta los sistemas que utilizan herramientas también pueden consultar GPT-5.4 Pensar y esta guía de uso de ChatGPT Agent.
Por qué Astra influye en la decisión de compra
El cambio importante consiste en pasar de evaluar una IA en función de la calidad de una sola respuesta a evaluar si es capaz de llevar a cabo una tarea completa. Un agente útil puede tener que revisar archivos, manejar programas informáticos, esperar a que estén disponibles las herramientas, recuperarse de los errores, aplicar un cambio, realizar comprobaciones y explicar el resultado. La respuesta final es solo una parte de esa secuencia.
Eso también cambia la cuestión del coste. Las tarifas por token de Astra son elevadas, pero el precio del token por sí solo no permite determinar si resulta económico. Una comparación más adecuada es coste por tarea completada con éxito: los costes del modelo y de las herramientas, los reintentos, el tiempo transcurrido, la supervisión humana y la limpieza son factores que hay que tener en cuenta. Un modelo más barato puede acabar saliendo más caro en total si requiere correcciones repetidas; una ejecución cara sigue siendo un derroche si se desvía del objetivo o genera resultados que hay que volver a hacer.
Indicador práctico:
Realiza un seguimiento del coste total, la tasa de finalización, los minutos de trabajo, los reintentos y los defectos de una misma tarea representativa. No compares los modelos basándote únicamente en las tarifas por token o en una única demostración bien pulida.
Una mayor autonomía también eleva el nivel de exigencia en materia de controles. Las directrices del último modelo de OpenAI indican que Astra está sujeta a una supervisión asíncrona de la desalineación. Los equipos deben seguir otorgando al agente los permisos mínimos que necesite, exigir confirmación antes de realizar acciones con consecuencias importantes, mantener un registro de acciones y crear puntos de control que permitan revertir los cambios. Un uso intensivo de la informática solo resulta valioso cuando el sistema circundante limita lo que puede salir mal.
Lo que dicen los primeros críticos
Experiencia inicial atribuida
De Matt Shumer Primera reseña del Astra Es uno de los análisis públicos más detallados disponibles en el momento del lanzamiento. Describe el modelo como eficaz en ingeniería de backend, uso de ordenadores, comprensión de solicitudes poco específicas, presentación clara de su trabajo y mantenimiento de la continuidad a lo largo de conversaciones prolongadas.
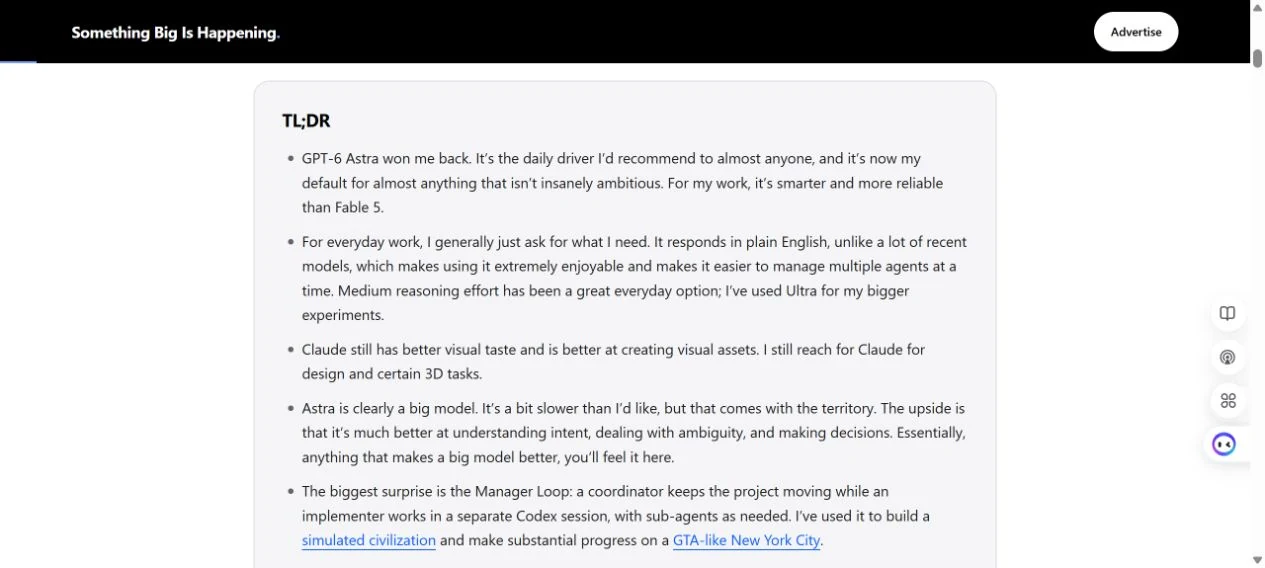
Ingeniería de backend
La reseña destaca el buen rendimiento en tareas de implementación complejas, especialmente cuando el modelo debe comprender un sistema en su conjunto, en lugar de generar un pequeño fragmento aislado.
Uso del ordenador
Según se informa, Astra gestiona tareas propias de navegadores y de escritorio teniendo más en cuenta el objetivo general, aunque eso no elimina la necesidad de permisos y verificaciones.
Intención ambigua
Se dice que este modelo es más eficaz a la hora de deducir lo que un usuario pretende hacer a partir de instrucciones incompletas.
Continuidad y presentación de informes
La reseña destaca que Astra es capaz de conservar el contexto durante sesiones prolongadas y de ofrecer una descripción más clara de lo que ha hecho.
Se trata de observaciones cualitativas de otro revisor. Ayudan a identificar capacidades que merece la pena probar, pero no son nuestras mediciones y no establecen una fiabilidad general.
Limitaciones iniciales y cuestiones pendientes
Esa misma reseña también plantea algunas cuestiones importantes. Astra puede ser lenta, consumir grandes cantidades de tokens y, aun así, perderse en los detalles durante largos periodos de trabajo autónomo. Shumer también señala que los resultados de su diseño visual pueden quedar por detrás de los de Claude, incluso cuando su rendimiento en segundo plano es sólido.
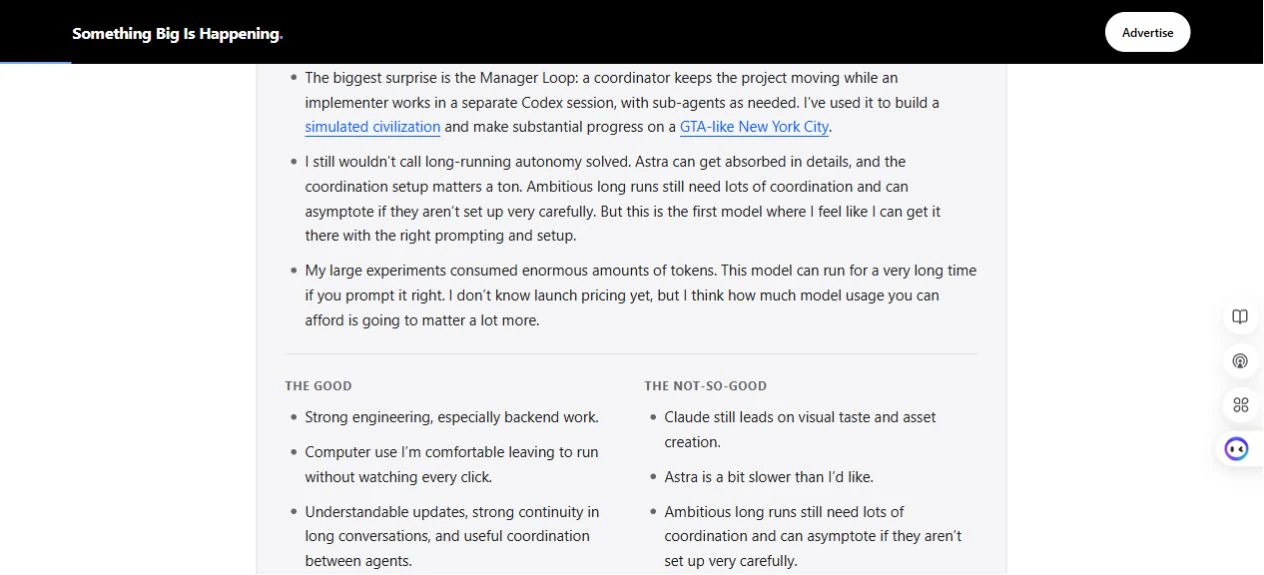
- Velocidad: Un modelo que razona, utiliza herramientas y comprueba su trabajo puede tardar más que un modelo de chat ligero.
- Autonomía: Que funcione durante mucho tiempo no significa que no requiera supervisión. El revisor siguió detectando momentos en los que el modelo necesitaba coordinación o reorientación.
- Uso del token: Un contexto amplio y un razonamiento extenso pueden resultar muy costosos rápidamente, sobre todo por encima del umbral de 272K.
- Diseño visual: Un buen rendimiento en la programación no garantiza automáticamente que la interfaz tenga el mejor diseño.
- Nivel de evidencia: Aún no hay suficientes ensayos independientes y comparativos para hacer afirmaciones generales sobre la fiabilidad o la superioridad.
Por lo tanto, la prueba clave para su adopción es la eficiencia, no la capacidad máxima. Mide con qué frecuencia Astra completa toda la tarea correctamente, cuánta supervisión necesita, cuántos tokens utiliza y cuánto trabajo de limpieza queda por hacer. Una ejecución más lenta y costosa puede merecer la pena si sustituye horas de trabajo de un experto, pero no si se desvía repetidamente.
¿Quién debería utilizar GPT-6 Astra?
| Compatibilidad potencial | Por qué Astra podría ser de ayuda | Lo primero que hay que comprobar |
|---|---|---|
| Trabajo con un código fuente extenso | Contexto amplio, uso de herramientas y continuidad en los cambios que afectan a varios archivos | Tasa de regresión, disciplina de pruebas, tiempo de revisión y coste por token |
| Investigación y síntesis | Puede coordinar la recopilación, el análisis y la elaboración de informes detallados | Precisión de las citas, cobertura de las fuentes e inferencias sin fundamento |
| Agentes de uso de ordenadores | Diseñado para una interacción en varias etapas con el software | Límites de permisos, recuperación tras cambios en la interfaz de usuario y registros de acciones |
| Análisis de documentos de gran tamaño | Un contexto de 1,05 M puede contener una cantidad considerable de material original | Recuperación en todo el contexto y si la recuperación resulta más económica |
| Operaciones de larga duración | La gestión de tareas en curso y las herramientas asíncronas pueden reducir los reinicios | Comportamiento de escalado, puntos de control y reversión segura |
Es poco probable que Astra sea la opción predeterminada adecuada para reescrituras breves, clasificaciones rutinarias, extracciones sencillas o trabajos de gran volumen en los que un modelo más pequeño ya cumple con los requisitos de calidad. El Reseña de GPT-5.4 y Nano muestra por qué el enrutamiento por tareas puede resultar más económico que enviarlo todo al modelo principal.
Una lista de comprobación práctica para la evaluación
- Elige tres tareas reales con criterios de éxito claros.
- Aplica los mismos datos de entrada y restricciones tanto a Astra como a tu modelo actual.
- Registra el tiempo total transcurrido, los tokens de entrada y salida, los reintentos y las correcciones realizadas por personas.
- Califica la realización de la tarea final de forma independiente del estilo de redacción o la presentación.
- Interrupción de la prueba, control durante la ejecución de la tarea y recuperación tras un fallo deliberado de una herramienta.
- Adopta Astra solo cuando la mejora sea repetible y merezca la pena el coste adicional.
Elige el Astra o un modelo más pequeño en función de la tarea
Utiliza Astra para síntesis complejas y tareas en las que la precisión sea más importante que el precio más bajo por token. Un modelo más pequeño puede ser suficiente para una extracción rutinaria o una reescritura breve. Compara la finalización con éxito, la supervisión y el coste total con las mismas entradas.
En el caso de un flujo de trabajo multimodelo, GPT-6 Astra, Claude Opus 5, Claude Sonnet 5 y Gemini 3.8 Flash figuran en el catálogo actual de GlobalGPT. GlobalGPT es una suscripción independiente; no activa la cuenta de pago de otro proveedor.
En Página del plan anual GlobalGPT Indica que el plan «Basic» cuesta $5,80 al mes, el «Pro» $10,80 al mes y el «Unlimited» $25 al mes con facturación anual, según se comprobó el 18 de septiembre de 2026. Compara el compromiso inicial y el uso del modelo incluido, no solo el equivalente mensual más bajo.
Lo que este análisis aún no demuestra
Un intento anterior de Astra a través de la misma ruta CLI no obtuvo respuesta. Conservamos ese fallo en el archivo de pruebas; no se trataba de una puntuación de calidad. Las tres llamadas que se han realizado con éxito en este caso demuestran que la ruta funcionó para este lote, pero no que el fallo anterior no pueda volver a producirse.
No hemos evaluado el uso del ordenador, la activación asíncrona de herramientas, el cambio de rumbo a mitad de una tarea, la recuperación de un millón de tokens, el acceso nativo al plan ChatGPT ni el trabajo de producción sin supervisión. No hay motivos para afirmar que Astra supere a Claude, Gemini o a un modelo más pequeño como OpenAI. Esas comparaciones requieren tareas equivalentes y ensayos repetidos.
Recomendación de compra: Prueba Astra en trabajos en los que sea importante comprobar las reglas, los valores que faltan y las excepciones. Mantén un modelo más pequeño para las tareas rutinarias que ya cumplen tu objetivo de calidad. Evalúa el coste adicional en función del menor número de correcciones y del trabajo final utilizable, no solo por el nombre del modelo.
Preguntas frecuentes
¿Se trataba de una prueba directa de la API OpenAI?
No. Hemos utilizado el servicio de modelos basado en la CLI de GlobalGPT con gpt-6-astra. Los recuentos de tokens y los créditos indicados corresponden a esa ruta; el cálculo en dólares de OpenAI es un ejemplo independiente de la tarifa.
¿Está disponible GPT-6 Astra en GlobalGPT?
Sí. Esta reseña incluye tres llamadas exitosas a gpt-6-astra a través del servicio modelo de GlobalGPT. La suscripción a esa plataforma es independiente de la facturación de la API de OpenAI y de los planes de ChatGPT.
¿Qué es la ventana de contexto?
OpenAI admite 1.050.000 tokens de contexto, con un máximo de 922.000 tokens de entrada y 128.000 tokens de salida.
¿Incluye Plus el GPT-6 Pro en el chat?
Según las directrices del modelo del 10 de septiembre, GPT-6 Pro se incluye en los planes Chat Pro, Business y Enterprise que cumplen los requisitos. Además, se incluye Astra en Work y Codex; se trata de derechos de producto independientes.
¿Cómo funciona la fijación de precios basada en entradas largas?
La página oficial del modelo aplica tarifas más elevadas a las solicitudes completas que superen los 272 000 tokens de entrada: el doble de las tarifas de entrada y de caché, y 1,5 veces las tarifas de salida.
¿La nueva prueba incluía el uso del ordenador?
No. Hemos probado el análisis de órdenes sintéticas, la generación de código con ejecución local y un paquete de texto de 500 notas. No se han probado el uso de ordenadores, las herramientas asíncronas ni la fiabilidad con un millón de tokens.
¿Debería sustituir todos los modelos por el Astra?
No. Compara la calidad de los resultados, la verificación manual, la latencia y el coste en tus propias tareas. Un modelo pequeño puede ser la mejor opción cuando ofrece de forma fiable la misma respuesta útil.