
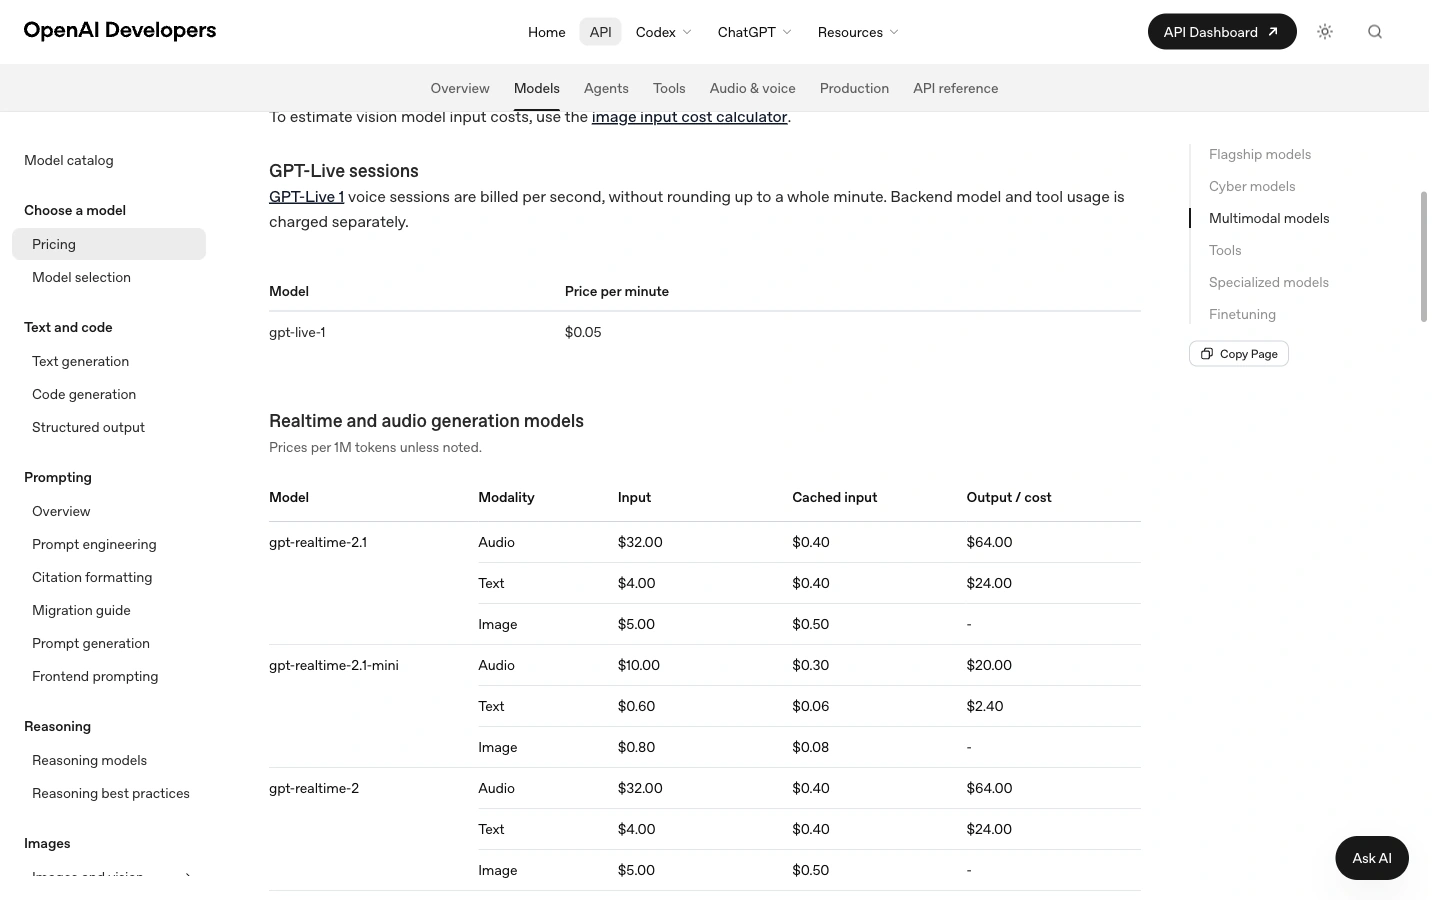
Si te estás preguntando: “¿Cuánto cuesta GPT-Live 1?”, la respuesta oficial de la API es $0,05 por minuto de llamada. OpenAI factura la sesión de voz por segundos, por lo que una sesión de 90 segundos cuesta $0,075 en lugar de redondearse al alza a $0,10. La tarifa de voz es solo una de las partidas de la factura: el modelo de backend y el uso de herramientas se cobran por separado.
Esa distinción es importante a la hora de diseñar un agente de voz real. Explora los flujos de trabajo de IA con GlobalGPT Si tu trabajo abarca la investigación de modelos, la redacción, el audio, las imágenes, el vídeo y las tareas relacionadas con las API, utiliza las páginas oficiales de GPT-Live como fuente de referencia para el transporte Live y su tarifa.

¿Qué es GPT-Live 1?
GPT-Live 1 es el modelo de voz full-duplex de OpenAI. Es capaz de escuchar y hablar al mismo tiempo, lo cual es el comportamiento que la gente espera de una conversación natural en directo, en lugar de un proceso en el que se reproducen archivos de audio por turnos. La página del modelo incluye gpt-live-1 como ID del modelo, con audio y texto como modalidades tanto de entrada como de salida.
El detalle arquitectónico más importante es la delegación. GPT-Live 1 se encarga de la interacción oral, mientras que un agente del backend puede razonar, buscar información, utilizar herramientas o completar una tarea. La aplicación sigue siendo la responsable de los permisos, los pasos de confirmación, el acceso a los sistemas de la empresa y el registro de lo que realmente ha ocurrido. Una respuesta oral no es, por sí sola, prueba de que se haya completado un pedido, un reembolso o un cambio en la cuenta.
Para los desarrolladores, la ruta «Live» es independiente de las rutas normales de chat y respuesta. La página del modelo de OpenAI indica que el punto final de la sesión «Live» es v1/en directo/sesiones; comprueba siempre de nuevo la documentación actual antes de implementar una conexión en producción.
Resumen de los precios de GPT-Live 1
La respuesta breve
- Modelo: GPT-Live 1 (
gpt-live-1) - Sesión de voz: $0,05 por minuto
- Medidor: segundos reales de la sesión; sin redondear al minuto completo
- Cargos por separado: Uso de modelos de backend y uso de herramientas
La tarifa oficial ofrece una cifra clara para la capa de voz en directo. No proporciona un total universal para el “agente de voz”, ya que el modelo de backend, las funciones, las bases de datos, el proveedor de telefonía y el resto de la infraestructura dependen de tu aplicación.
| Tiempo de llamadas facturado | Matemáticas de la capa de voz | Coste de las llamadas | En esta ilustración se incluye |
|---|---|---|---|
| 90 segundos | 90 ÷ 60 × $0,05 | $0.075 | Solo sesión de voz |
| 100 minutos | 100 × $0,05 | $5.00 | Solo sesión de voz |
| 1.000 minutos | 1.000 × $0,05 | $50.00 | Solo sesión de voz |
| 10 000 minutos | 10 000 × $0,05 | $500.00 | Solo sesión de voz |
Resumen de precios: Las cifras anteriores se basan en la documentación OpenAI consultada el 28 de septiembre de 2026. Se trata de ejemplos aritméticos, no de una promesa sobre el importe de la factura mensual. El coste total incluye las capas de backend y de herramientas.
Qué cubre la tarifa $0.05 y qué queda excluido
Piensa en una implementación de GPT-Live como una cadena con contadores independientes. El número $0.05 se utiliza para pagar la capa de voz en directo. El trabajo que hace que la conversación resulte útil puede generar un consumo adicional.
Separa los contadores antes de hacer la previsión
- Sesión de voz: GPT-Live 1 escucha y habla. Se factura en función de los segundos reales consumidos, a $0,05 por minuto.
- Razonamiento del backend: Un agente propiedad del cliente o un backend alojado en OpenAI puede analizar la solicitud. El uso del modelo se rige por la tabla de tarifas propia de dicho modelo.
- Herramientas y sistemas: Las búsquedas, las bases de datos, las llamadas a funciones, el almacenamiento, la observabilidad y cualquier servicio de telefonía o de operador añaden sus propios costes.
La aplicación se encarga de comprobar los permisos, solicitar la confirmación del usuario y registrar si una herramienta ha devuelto una acción completada. Mantén esos controles en tu flujo de trabajo, incluso cuando la respuesta de voz suene segura.
Esta visión por capas evita un error habitual en la elaboración de presupuestos: multiplicar $0,05 por el tiempo de conversación y considerar que el resultado es el coste de una llamada de atención al cliente completada. La tarifa modelo es fácil de calcular; el resto del flujo de trabajo requiere datos de consumo medidos.
Calculadora de costes de GPT-Live 1
Utiliza la calculadora para hacer un primer cálculo del presupuesto. Introduce la duración de la sesión de voz en segundos o minutos y, a continuación, añade tu propia estimación efectiva del backend y cualquier presupuesto mensual destinado a herramientas o infraestructura. El campo del backend es tu presupuesto, no es un precio de GPT-Live OpenAI.
Calcula el coste del GPT-Live 1 cargado
La calculadora se ejecuta en tu navegador. No envía ninguna solicitud ni utiliza datos de la cuenta.
Escenarios analizados: capa de voz frente a presupuesto asignado
| Escenario | Capa de voz | Estimación del backend | Herramientas | Total cargado |
|---|---|---|---|---|
| 100 minutos, solo voz | $5 | $0 | $0 | $5 |
| 1.000 minutos + $0,04/min de backend | $50 | $40 | $0 | $90 |
| 10 000 minutos + 1 TP41T0,04/min de backend + 1 TP41T25 de herramientas | $500 | $400 | $25 | $925 |
Solo la primera columna de estos cálculos se basa en la tarifa oficial de GPT-Live. La cifra de $0,04 corresponde a una hipótesis de planificación aportada por un lector y se utiliza para mostrar cómo se suman las capas; no se trata de una cotización de OpenAI.
GPT-Live 1 frente a la API en tiempo real frente a TTS
Estos nombres aparecen muy próximos entre sí en los resultados de búsqueda, pero se refieren a elementos básicos distintos. Mantener la unidad de facturación asociada a la ruta correcta evita que se produzca una comparación engañosa.
| Ruta | Para qué sirve | Cómo leer la factura | Buen ajuste |
|---|---|---|---|
| GPT-Live 1 | Conversación de voz en dúplex completo con delegación al backend | $0,05 por minuto de llamada, facturado por segundos reales; el backend y las herramientas se facturan por separado | Interacción oral en directo en la que el usuario puede interrumpir y seguir hablando |
| API en tiempo real | Una ruta independiente para sesiones de audio y texto en tiempo real | Utiliza la lista de tarifas actual de Realtime para el modelo y la modalidad concretos; no la sustituyas por la tarifa de sesión de GPT-Live. | Aplicaciones ya diseñadas en torno al contrato de la API en tiempo real |
| Sintetizador de voz | Convierte texto en audio generado | Utiliza la unidad de punto final actual del modelo de voz seleccionado; no se trata de un cargo por conversación en dúplex completo. | Narración, reproducción, locución y archivos de audio generados |
| Capa de teléfono o de operador | Conecta una llamada a una red telefónica | Los costes de operador, SIP, minutos, grabación y cumplimiento normativo son independientes de la sesión modelo. | Telefonía de producción una vez que el flujo de trabajo de la aplicación esté listo |
Si necesitas conocer la diferencia conceptual entre el discurso generado y la transcripción, consulta en qué se diferencia la conversión de texto a voz de la transcripción. Esa lectura ayuda en el flujo de trabajo de audio, pero no es la fuente del precio de GPT-Live.
Cómo elaborar un presupuesto para un flujo de trabajo de grabación de voz real
- Mide los segundos, no las llamadas. Tener en cuenta la duración de la sesión y tratar las interrupciones breves de la misma forma que las llamadas largas.
- Elige el backend con cuidado. Un backend ligero puede responder a consultas sencillas; un modelo de razonamiento más complejo puede consumir más recursos por minuto. Registra el uso real de entrada y salida que devuelve ese modelo.
- Enumera todos los límites de las herramientas. Incluye búsquedas, bases de datos, llamadas a funciones, almacenamiento, supervisión, telefonía y cualquier proceso de intervención humana por el que tu aplicación tenga que pagar.
- Registra el valor por separado de la duración. Una conversación de diez minutos consume más tiempo de llamada que una de dos minutos, aunque ambas tengan el mismo resultado comercial.
Para ver un ejemplo de elaboración de presupuestos con el modelo textual, puedes Comparar los componentes de coste de la API del modelo de texto. Mantén la fórmula del token de ese modelo separada de la fórmula de la sesión de voz de GPT-Live; los dos precios nunca deben sustituirse entre sí.
Dónde encaja GlobalGPT en el flujo de trabajo
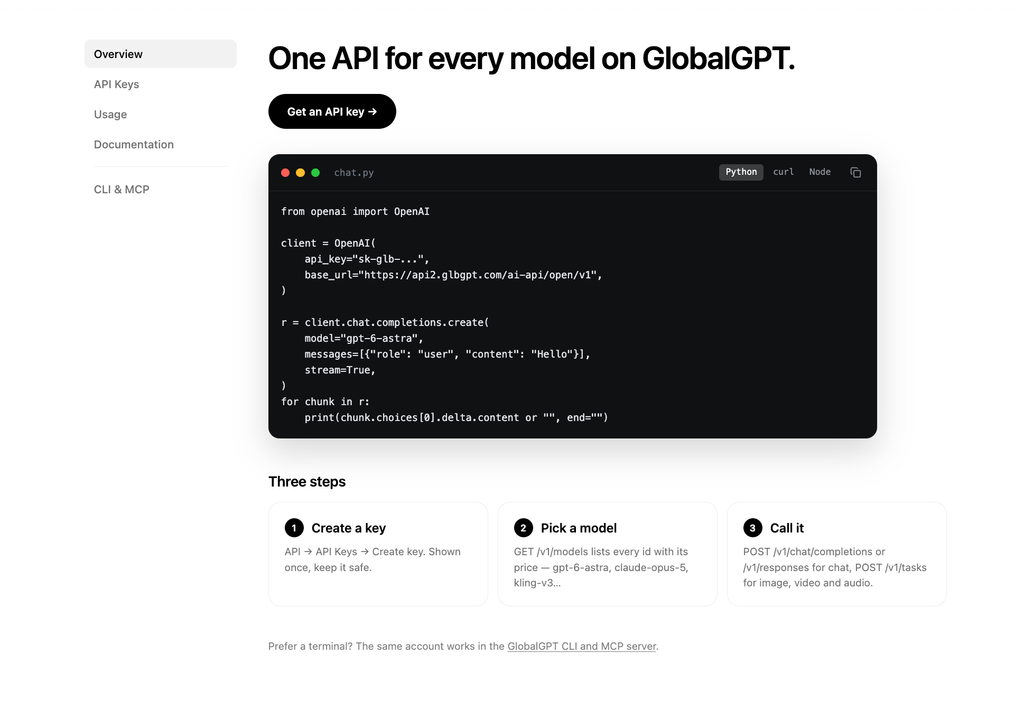
GlobalGPT resulta útil cuando el trabajo relacionado con un proyecto de voz abarca más de un modelo o modalidad. Su documentación pública describe un punto de acceso a la API para tareas de chat y de medios asíncronos, mientras que el espacio de trabajo más amplio reúne las tareas relacionadas con texto, audio, imágenes y vídeo en un único panel de control. Esto puede acortar el proceso desde la investigación de un flujo de trabajo de voz hasta la redacción de indicaciones, la preparación del audio de apoyo y la comparación con otros modelos.
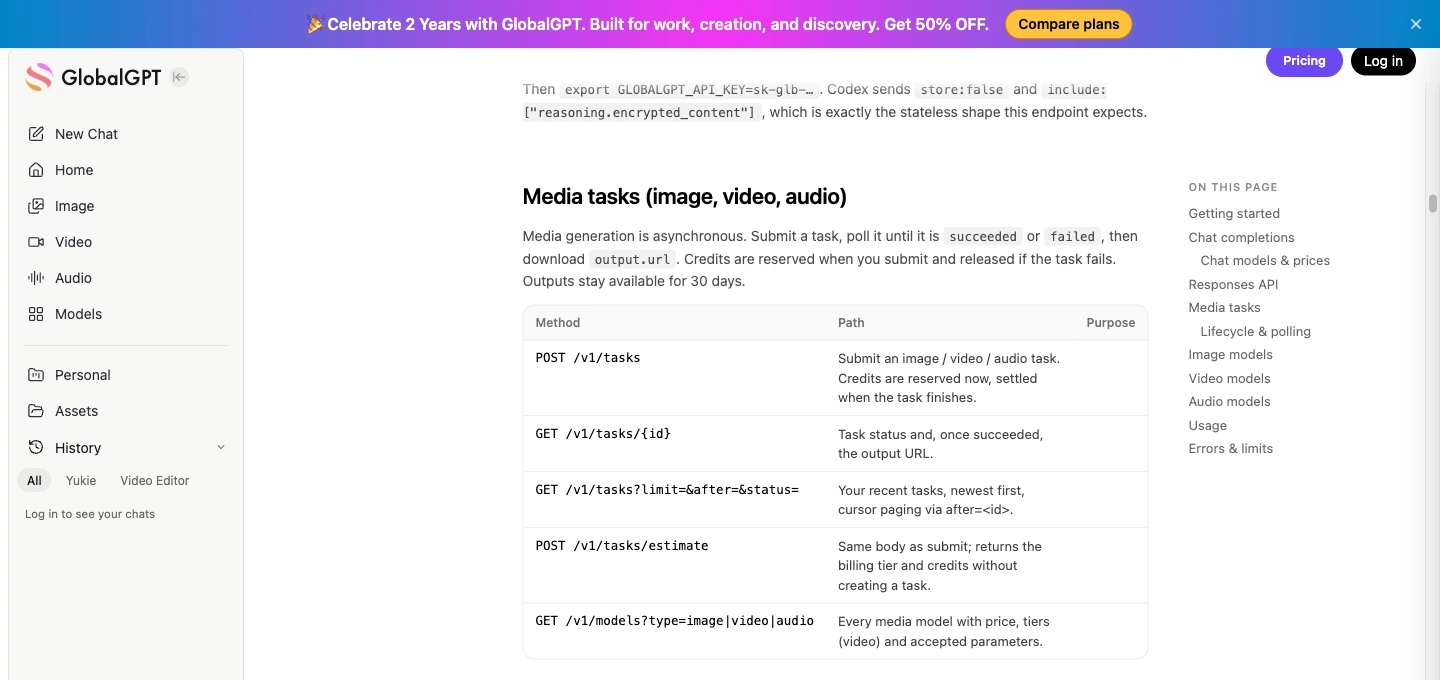
El propio GPT-Live 1 cuenta con un contrato específico para sesiones en directo y una tarifa oficial específica. Considera las páginas de modelos y precios de OpenAI como la referencia para ese transporte. Utiliza GlobalGPT como espacio de trabajo multimodal y flujo de trabajo de la API, y confirma la ruta exacta del modelo que se muestra en la documentación actual del producto antes de prometer una conexión directa con GPT-Live.
Explora los flujos de trabajo de IA con GlobalGPT cuando buscas un único lugar desde el que pasar de la investigación de modelos a un flujo de trabajo más amplio de contenido o audio.
Preguntas frecuentes sobre los precios de GPT-Live 1
¿Cuál es el precio oficial de la API de GPT-Live 1?
OpenAI incluye sesiones de voz de GPT-Live 1 a un precio de $0,05 por minuto. La sesión se factura por segundos reales, y el uso del modelo y de las herramientas de backend se factura por separado.
¿GPT-Live 1 redondea una llamada corta a un minuto completo?
No. En la página oficial de tarifas se indica que la duración se factura por segundos, sin redondear al minuto completo. Por lo tanto, noventa segundos equivalen a 1,5 minutos facturables, es decir, $0,075 para la capa de voz.
¿Incluye la tarifa $0.05 el modelo de razonamiento?
No. La sesión de voz y el modelo de backend son capas independientes. Suma el consumo real del modelo de backend a la estimación de la capa de voz y, a continuación, añade los costes de las herramientas y la infraestructura.
¿GPT-Live 1 es lo mismo que la API en tiempo real?
No. Son rutas independientes en la documentación de audio de OpenAI. GPT-Live 1 utiliza la tarifa de duración de sesión de voz publicada; una implementación en tiempo real debe utilizar el modelo actual de tiempo real y la tarifa por modalidad.
¿GPT-Live 1 es lo mismo que la función de conversión de texto a voz?
No. La función de «texto a voz» genera audio a partir de texto. GPT-Live 1 es una capa de conversación full-duplex capaz de escuchar y hablar mientras se ejecutan las tareas delegadas en el backend.
¿Cómo puedo calcular el presupuesto mensual para GPT-Live 1?
Empieza con los segundos reales ÷ 60 × $0,05. Añade una estimación del backend por minuto y una línea mensual independiente para herramientas, telefonía, almacenamiento, supervisión y otras infraestructuras. La calculadora anterior mantiene visibles esas capas.
¿Puedo considerar GlobalGPT como un medio de transporte GPT-Live directamente compatible?
No des por sentado nada a partir de una descripción general del espacio de trabajo multimodelo. Consulta el modelo GlobalGPT actual y la documentación de la API para conocer la ruta exacta que necesitas, y utiliza la documentación de GPT-Live de OpenAI para el contrato de la sesión en directo.
Conclusión práctica
Los precios de GPT-Live 1 empiezan en $0,05 por minuto de llamada, medido en segundos reales. Se trata de un coste claro de la capa de voz, no de la factura completa del agente de voz. Realiza una previsión del backend, las herramientas y la infraestructura telefónica o empresarial como partidas separadas y, a continuación, utiliza datos reales de sesiones y uso para sustituir las hipótesis de planificación.
Referencias oficiales: Página del modelo GPT-Live 1, Precios de la API de OpenAI, y Primeros pasos con GPT-Live.









