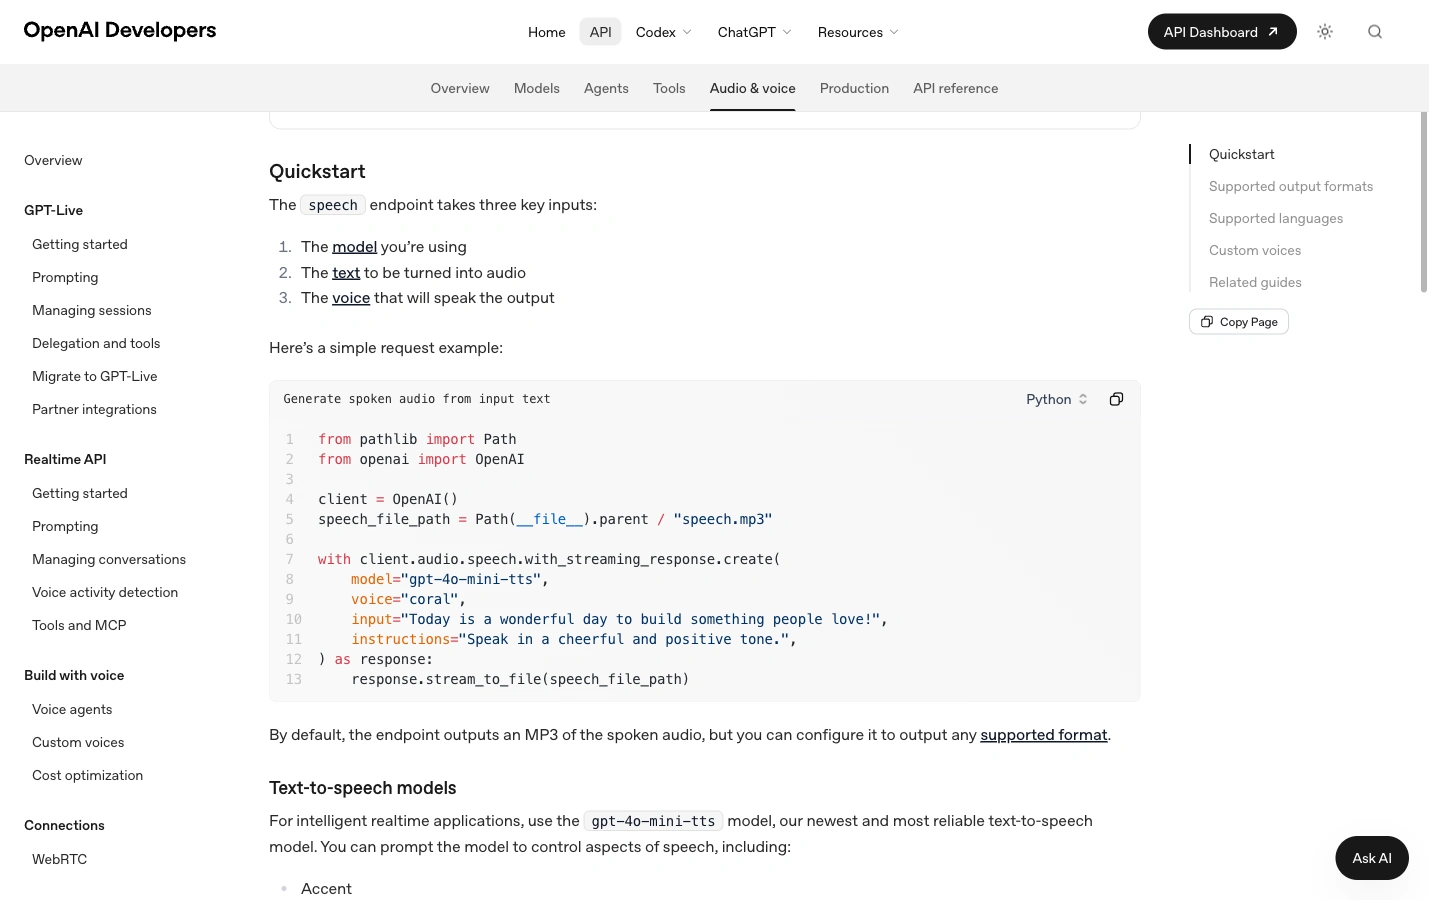
En API de voz y audio OpenAI convierte el texto en audio hablado a través de PUBLICACIÓN https://api.openai.com/v1/audio/speech. Envía un modelo, tu texto de entrada y una voz; guarda la respuesta como MP3 o en otro formato de audio compatible. Para una nueva integración que requiera instrucciones sobre el tono y la forma de expresarse, empieza por gpt-4o-mini-tts.
Una solicitud de trabajo es solo el primer paso. También necesitas la unidad de facturación adecuada, un archivo de salida reproducible y un plan para guiones largos. El modelo TTS más reciente de OpenAI utiliza tokens de texto y de audio para el cálculo de precios; sus modelos TTS más antiguos utilizan caracteres. Esa diferencia es importante a la hora de calcular el coste de un mes de narración.
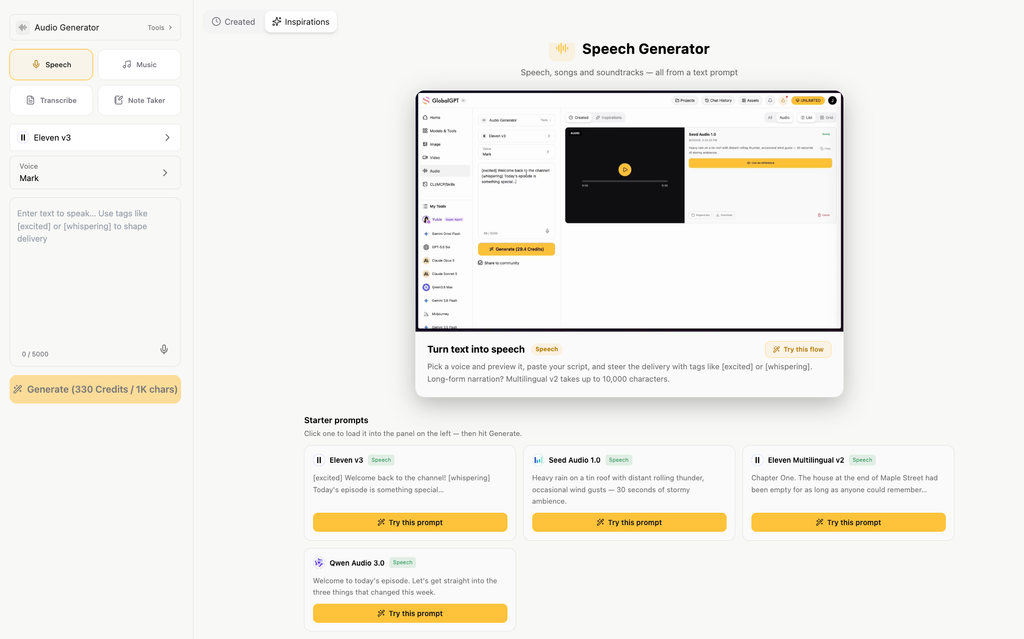
Si tu trabajo también consiste en escribir el guion, crear los elementos visuales y montar un vídeo, El espacio de trabajo de audio de GlobalGPT ofrece la generación de voz en una plataforma de suscripción multimodelo asequible. Puedes trabajar con texto, voz, imágenes y vídeo desde un único panel de control, y luego utilizar su API y su CLI para tareas de producción repetibles. Su API pública de TTS utiliza un flujo de trabajo independiente, que se explica a continuación.
¿Para qué sirve la API de voz y audio OpenAI?
La API de voz es un punto de conexión de conversión de texto a voz: tu aplicación proporciona palabras escritas y recibe la voz generada. Entre sus usos habituales se incluyen las guías de productos, la narración para accesibilidad, el material didáctico y las locuciones breves. Tú controlas el texto antes de que se pronuncie, lo que resulta útil cuando la redacción debe seguir un guion aprobado.
En el caso de la transcripción, el proceso se invierte: se introduce el audio grabado y se obtiene el texto. Un asistente de voz en directo añade otro requisito: escuchar y responder a través de una conversación. OpenAI’s documentación de audio Separa estos flujos de trabajo. Elige el punto final de voz cuando ya tengas el texto que quieres que se lea en voz alta.
La generación de voz admite la transmisión en continuo, por lo que una aplicación puede recibir audio por fragmentos. Guardar esa transmisión en un archivo no implica que se reproduzca automáticamente en un navegador ni que se cree un agente conversacional; tu aplicación sigue encargándose de la reproducción y de cualquier lógica conversacional. OpenAI también exige que se informe claramente a los oyentes de que la voz ha sido generada por IA.
Crea tu primer archivo de audio con la API de voz OpenAI
Ejecuta la solicitud en un servidor o en tu equipo de desarrollo, con una clave API OpenAI almacenada en el OPENAI_API_KEY variable de entorno. No incluyas la clave en el JavaScript del navegador. Los siguientes ejemplos utilizan el mismo script breve de recorrido por el producto y guardan el resultado como openai-product-tour.mp3.
Opción 1: realizar una solicitud con curl
API de voz OpenAI · curl
#!/bin/sh
# Configura primero la variable OPENAI_API_KEY en el entorno de tu servidor.
curl --fail-with-body --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "Bienvenido al recorrido por los productos de Acorn Studio. En tres pasos, puedes convertir un guion breve en una audioguía. Primero, escribe el mensaje. A continuación, elige una voz. Por último, guarda el archivo de audio y prueba la reproducción en tu teléfono.",
    "voice": "coral",
    "instructions": "Habla con claridad, en un tono cálido y coloquial.",
    "response_format": "mp3"
  }' \
  --output openai-product-tour.mp3
La respuesta contiene fragmentos de audio, así que guárdala en un archivo en lugar de intentar analizarla como JSON. El --fail-with-body Esta opción hace que `curl` devuelva un código de salida de error en caso de error HTTP. Comprueba ese código de estado antes de abrir el archivo: una respuesta de error puede dejar datos JSON en el archivo denominado .mp3.
Opción 2: utilizar el SDK de Python
Instala el paquete OpenAI con python -m pip install openai. El SDK lee la clave de API del entorno. En este ejemplo, la respuesta se va escribiendo a medida que se recibe, lo que evita tener que cargar toda la respuesta de audio en tu propio búfer de Python.
API de voz OpenAI · Python
"""Instalación: python -m pip install openai. Configura OPENAI_API_KEY en el servidor."""
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
script = (
    "Bienvenido al recorrido por los productos de Acorn Studio. En tres pasos, puedes convertir "
    "un guion breve en una audioguía. Primero, escribe el mensaje. A continuación, "
    "elige una voz. Por último, guarda el archivo de audio y prueba la reproducción en tu teléfono."
)

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=script,
    instructions="Habla con claridad, en un tono cálido y coloquial.",
    response_format="mp3",
) as response:
    response.stream_to_file(Path("openai-product-tour.mp3"))

print("Se ha guardado openai-product-tour.mp3")
Los tres campos esenciales son: modelo, entrada, y voz. Aquí, instrucciones requiere una forma de expresión cálida y coloquial; guía la voz en lugar de añadir palabras al guion hablado. Este campo funciona con GPT-4o Mini TTS y no es compatible con tts-1 y tts-1-hd.
Si se trata de un documento más extenso, divide el texto por frases o párrafos, numera los segmentos y guarda cada archivo resultante con ese número. Mantén el mismo tono y las mismas instrucciones en todos los segmentos. Deja suficiente contexto para que la expresión resulte natural y escucha atentamente las uniones antes de distribuir la grabación final.
Elige un modelo, una voz y un formato de salida
| Modelo | Cómo elegir | Instrucciones de entrega |
|---|---|---|
gpt-4o-mini-tts | Un punto de partida para una narración y una expresión oral controladas. | Admite instrucciones en cuanto al tono, el estilo y el ritmo. |
tts-1 | OpenAI permite que este modelo genere voz con menor latencia. | Utiliza los controles de voz y de velocidad compatibles; omite instrucciones. |
tts-1-hd | OpenAI hace que este modelo ofrezca una voz de mayor calidad que el TTS-1. | Utiliza los controles de voz y de velocidad compatibles; omite instrucciones. |
En Página del modelo GPT-4o Mini TTS asigna el alias del modelo al gpt-4o-mini-tts-15-12-2025 instantánea. Si la reproducibilidad del comportamiento es importante para tu aplicación, elige deliberadamente una instantánea documentada y guárdala junto con tus scripts guardados.
Voces integradas y límites de entrada
La referencia de la API de voz enumera 13 voces integradas para GPT-4o Mini TTS: aleación, ceniza, balada, coral, eco, fábula, ónix, nova, salvia, brillo, verso, marino y cedro. OpenAI recomienda Marín o cedro para obtener la mejor calidad. Esa es la recomendación de OpenAI: elige tu voz de producción escuchando tus propios nombres, números y estructuras sintácticas.
Los modelos anteriores de TTS admiten un conjunto más reducido: alloy, ash, coral, echo, fable, onyx, nova, sage y shimmer. No des por sentado que todas las voces funcionan con todos los modelos. El Referencia de la API de voz también admite una velocidad comprendida entre 0,25 y 4,0, con 1.0 como opción predeterminada.
Hay que tener en cuenta dos límites de entrada: los límites de referencia de los puntos finales entrada a 4.096 caracteres, y en la página del modelo Mini TTS se especifica un máximo de 2.000 tokens de entrada. Los caracteres y los tokens son unidades de medida diferentes. Comprueba ambas restricciones para Mini TTS, sobre todo con textos multilingües, y divide los guiones extensos antes de enviarlos.
Elige el formato de archivo para su destino
| Formato | Uso práctico |
|---|---|
| MP3 | Formato predeterminado: un archivo comprimido muy práctico para compartir y reproducir en la web. |
| Opus | Útil para aplicaciones de streaming y comunicación que sean compatibles con este códec. |
| AAC | Ten en cuenta cuándo tu entorno de reproducción o tu flujo de trabajo multimedia requieren el formato AAC. |
| FLAC | Compresión sin pérdidas para flujos de trabajo en los que es necesario conservar la señal de audio. |
| WAV | Audio sin comprimir en un formato habitual para su edición y procesamiento. |
| PCM | Muestras sin procesar a 24 kHz y 16 bits, con signo y en formato «little-endian», sin encabezado de archivo; tu reproductor necesita esa configuración. |
Empieza con MP3 si necesitas un enlace de descarga o un reproductor de audio sencillo. Elige WAV cuando el siguiente paso sea la edición. Selecciona PCM sin procesar solo si tu aplicación sabe cómo interpretarlo; cambiar el nombre de un archivo de .pcm a .wav No crea un encabezado WAV.
¿Cuánto cuesta la API de voz OpenAI?
Según se ha comprobado el 28 de septiembre de 2026, OpenAI incluye el GPT-4o Mini TTS en $0,60 por cada millón de tokens de texto introducidos más $12 por cada millón de tokens de salida de audio. El TTS-1 cuesta $15 por cada millón de caracteres, y el TTS-1 HD cuesta $30 por cada millón de caracteres. Calcula cada modelo en sus propias unidades.
Precios de la API de voz: mantén las unidades separadas
OpenAI cobra por su modelo de síntesis de voz (TTS) más reciente por tokens, y por sus dos modelos anteriores de TTS por caracteres. GlobalGPT factura sus tareas de síntesis de voz (TTS) en créditos.
| Ruta y modelo | Tasa | Ejemplo |
|---|---|---|
| OpenAI · GPT-4o Mini TTS | $0,60 / 1 millón de tokens de entrada de texto $12 / 1M fichas de salida de audio | $0.0606 por cada 1.000 tokens de entrada de texto + 5.000 tokens de salida de audio |
| OpenAI · TTS-1 | $15 / 1M caracteres | $0,015 por cada 1.000 caracteres |
| OpenAI · TTS-1 HD | $30 / 1M caracteres | $0,030 por cada 1.000 caracteres |
| GlobalGPT · Eleven v3, Eleven Multilingual v2 o Qwen Audio 3.0 TTS Flash | 330 créditos / 1.000 caracteres | 330 créditos a la tarifa indicada de 1.000 caracteres; solicita un presupuesto antes de enviar el texto |
Estos son ejemplos de precios, no tarifas correspondientes a las muestras de audio que aparecen a continuación. Los tokens, los caracteres, los minutos y los créditos son unidades diferentes. La estimación de la tarea GlobalGPT indica la cantidad de créditos aplicable; la tabla no convierte los créditos en dólares.
Tipos de interés consultados el 28 de septiembre de 2026. Fuentes: Precios de la API OpenAI y Documentación de la API de GlobalGPT.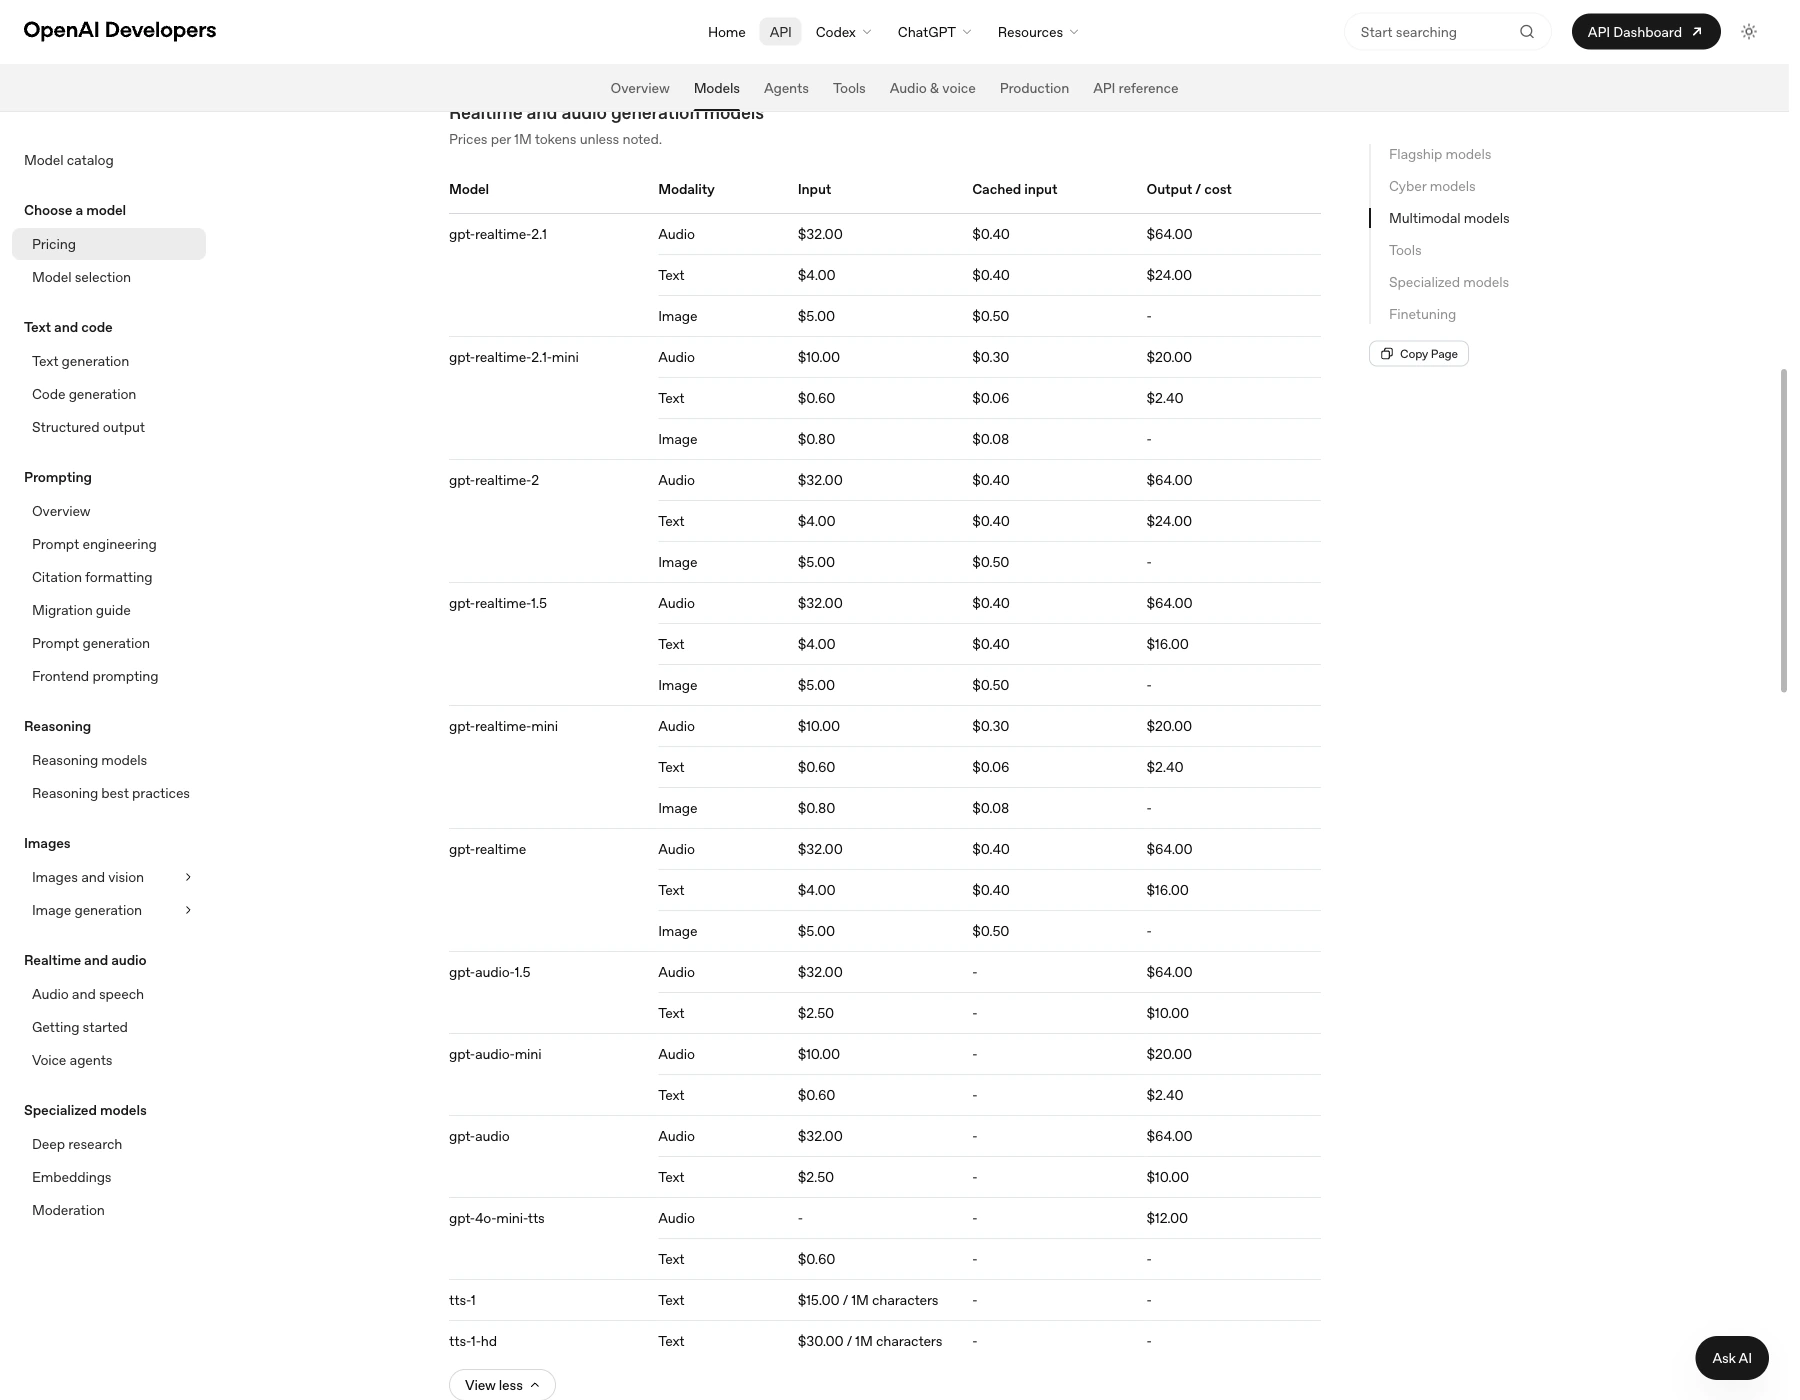
Por ejemplo, 100 guiones de 1.000 caracteres cada uno suman un total de 100.000 caracteres. Según las tarifas indicadas, eso supone $1.50 con TTS-1 o $3.00 con TTS-1 HD, antes de otros costes de la aplicación. Ese mismo recuento de caracteres no basta para calcular con exactitud el Mini TTS: se necesitan las cantidades de tokens de entrada de texto y de salida de audio.
Calcula el coste de la generación de voz
Introduce las unidades en las que se factura la ruta que hayas elegido. No hay conversión automática de caracteres a tokens ni de minutos a tokens.
Fórmula: caracteres × $15 ÷ 1 000 000. El texto total puede abarcar varias solicitudes de API.
Tarifas consultadas el 28 de septiembre de 2026: OpenAI · GlobalGPT. No incluye el almacenamiento, el alojamiento web, los impuestos ni otros componentes de tu aplicación.
A efectos de planificación, introduce en la calculadora las cifras de uso real o las hipótesis explícitas. Considera el campo «Mini TTS audio-token» como un dato presupuestario hasta que hayas medido el uso. No conviertas una cifra aproximada por minuto en un precio garantizado para cada voz, ritmo de habla o idioma.
El catálogo del modelo GlobalGPT expresa los precios de TTS en créditos, y su función de estimación ofrece un presupuesto para la solicitud que pretendes enviar. Mantén el gasto en créditos de la API separado de la suscripción a un espacio de trabajo multimodelo para las tareas diarias de redacción y gestión de contenidos multimedia. De este modo, resulta más fácil controlar el presupuesto sin dar por sentado que ambos productos comparten un mismo límite de facturación.
Crear un flujo de trabajo de TTS con la API GlobalGPT
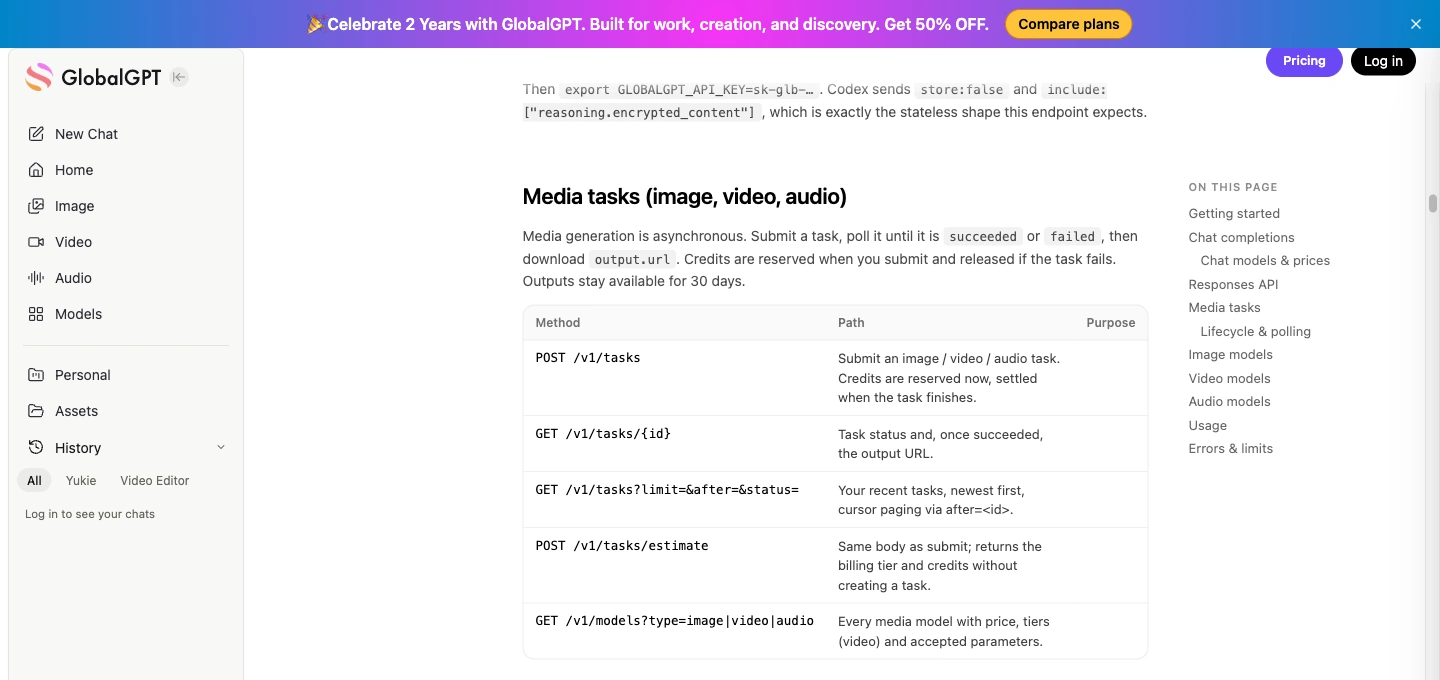
Para un flujo de trabajo repetible que vaya del guion a la voz y al vídeo, crear un discurso en GlobalGPT y mantener el resto del proyecto en el mismo espacio de trabajo. El API GlobalGPT revela que la generación de contenidos multimedia se reduce a tareas, mientras que el GlobalGPT CLI conexiones compatibles con tu terminal y tus herramientas de desarrollo.
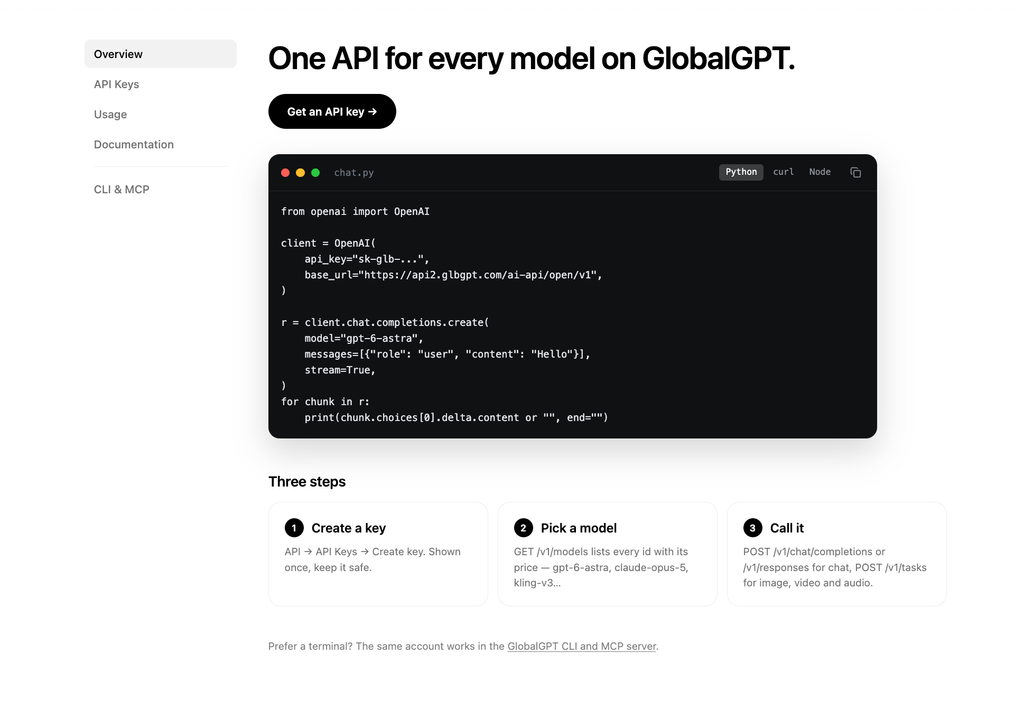
Utiliza la URL base pública https://api2.glbgpt.com/ai-api/open/v1. Envía las solicitudes de TTS a POST /tasks, consulta GET /tasks/{id}, y descargar output.url una vez que la tarea se haya completado con éxito. El campo de texto es consulte. Implementa este contrato de tarea directamente; difiere de la respuesta de audio inmediata de OpenAI.
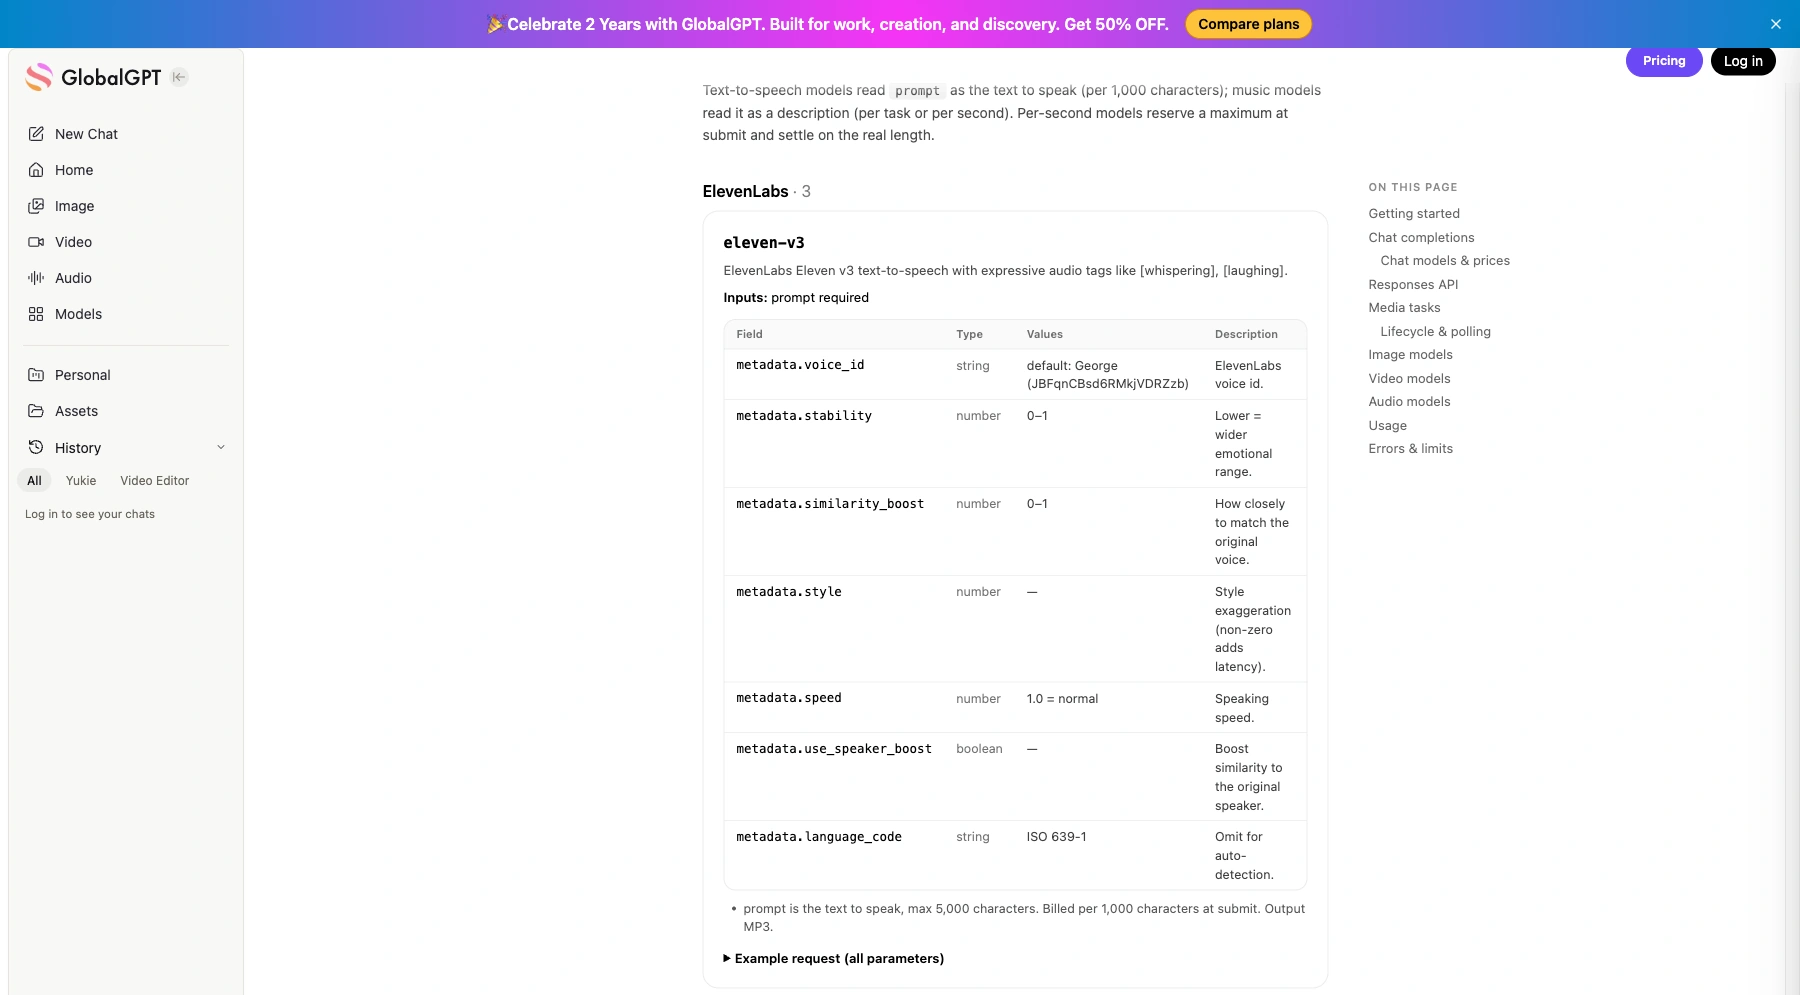
Elige un modelo TTS GlobalGPT documentado
| ID del modelo | Entrada y salida | Distinción útil |
|---|---|---|
eleven-v3 | Hasta 5.000 caracteres; MP3 | Admite etiquetas de audio expresivas. |
once-multilingüe-v2 | Hasta 10 000 caracteres; MP3 | 29 idiomas; las etiquetas de audio se leen como texto. |
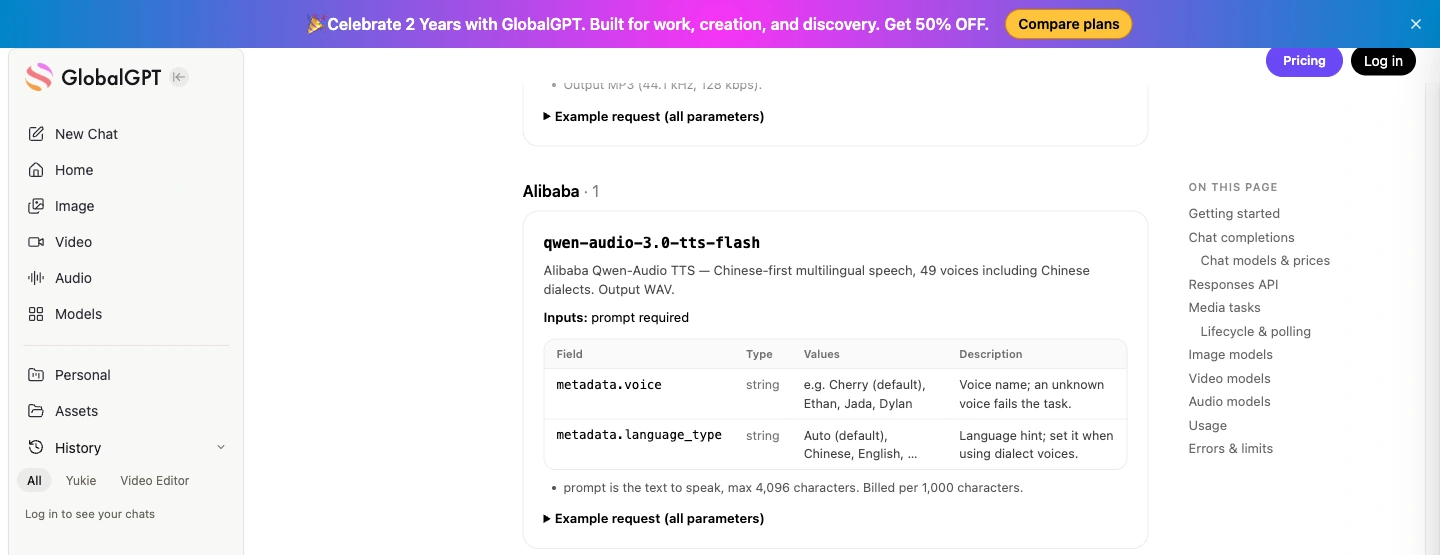
qwen-audio-3.0-tts-flash | Hasta 4.096 caracteres; WAV | 49 voces; los controles de voz y lenguaje utilizan campos específicos de Qwen. |
Lista de las tres entradas 330 créditos por cada 1.000 caracteres. Utilice POST /tasks/estimate con el cuerpo de la solicitud previsto para el presupuesto correspondiente; según la documentación, esto no crea ninguna tarea ni reserva créditos. El acceso a la API pública utiliza créditos de pago.
Para obtener más información sobre el flujo de trabajo de creación en general, consulta Flujos de trabajo de conversión de texto a voz en GlobalGPT. Si estás investigando sobre la familia de código abierto Qwen3-TTS, que tiene un nombre distinto, lee Modelos Qwen3-TTS y opciones de API; no consideres el ID de modelo Qwen-Audio anterior como una implementación intercambiable de Qwen3-TTS.
Realiza el presupuesto, envíalo una vez y, a continuación, consulta la tarea guardada
Instale solicitudes con python -m pip install requests y establecer GLOBALGPT_API_KEY en el servidor. El ejemplo que aparece a continuación utiliza Eleven v3, selecciona un identificador de voz público documentado y establece un límite máximo ilustrativo de 500 créditos. Modifica ese límite para que se ajuste a tu propio presupuesto antes de ejecutarlo.
API pública de tareas TTS GlobalGPT · Python
"""Instala requests; configura GLOBALGPT_API_KEY. Utiliza la API pública de tareas de GlobalGPT."""
import json
import os
import time
import uuid
from pathlib import Path
import requests

BASE = "https://api2.glbgpt.com/ai-api/open/v1"
STATE = Path("globalgpt-tts-job.json")
OUTPUT = Path("globalgpt-product-tour.mp3")
MAX_CREDITS = 500  # Tu límite máximo por tarea; modifícalo antes de ejecutarlo.

payload = {
    "model": "eleven-v3",
    "prompt": (
 "Bienvenido al recorrido por el producto de Acorn Studio. En tres pasos, puedes convertir "
"un guion breve en una audioguía. Primero, escribe el mensaje. A continuación, "
"elige una voz. Por último, guarda el archivo de audio y prueba la reproducción en tu teléfono."
    ),
    "metadata": {
 "voice_id": "JBFqnCBsd6RMkjVDRZzb",
 "stability": 0.5,
 "language_code": "en",
    },
}

api = requests.Session()
api.headers["Authorization"] = "Bearer " + os.environ["GLOBALGPT_API_KEY"]

if STATE.exists():
    job = json.loads(STATE.read_text())
    if job["payload"] != payload:
 raise RuntimeError("Este trabajo corresponde a una entrada diferente. Utiliza un nuevo nombre de archivo de estado.")
else:
    estimate = api.post(BASE + "/tasks/estimate", json=payload, timeout=30)
    estimate.raise_for_status()
    quote = estimate.json()
    print("Créditos estimados:", quote["credits"])
    si quote["credits"] > MAX_CREDITS:
  raise RuntimeError("El presupuesto supera tu límite máximo por trabajo.")
  job = {"payload": payload, "idempotency_key": str(uuid.uuid4())}
    STATE.write_text(json.dumps(job, indent=2))

si "task_id" no está en job:
    # La clave persistida mantiene un reintento de transporte vinculado a esta solicitud concreta.
    submitted = api.post(
 BASE + "/tasks", json=payload,
 headers={"Idempotency-Key": job["idempotency_key"]}, timeout=60,
    )
    submitted.raise_for_status()
    task = submitted.json()
    job["task_id"] = task["id"]
    STATE.write_text(json.dumps(job, indent=2))
    if task.get("ignored_parameters"):
 print("Parámetros ignorados:", task["ignored_parameters"])

print("Tarea:", job["task_id"])
deadline = time.monotonic() + 600
while time.monotonic() < deadline:
    checked = api.get(BASE + "/tasks/" + str(job["task_id"]), timeout=30)
    checked.raise_for_status()
    task = checked.json()
    if task.get("ignored_parameters"):
 print("Parámetros ignorados:", task["ignored_parameters"])
    si task["status"] == "failed":
  raise RuntimeError("Error en la generación: " + json.dumps(task.get("error", {})))
    si task["status"] == "succeeded":
        # Utiliza una nueva solicitud: no envíes la clave de API al servidor multimedia.
 audio = requests.get(task["output"]["url"], timeout=60)
 audio.raise_for_status()
        OUTPUT.write_bytes(audio.content)
 print("Guardado:", OUTPUT)
 break
    time.sleep(10)
else:
    raise TimeoutError("Tarea aún pendiente. Vuelve a ejecutarla para consultar el ID de la tarea guardada.")
El archivo de trabajo guarda la solicitud exacta, una clave de idempotencia y el ID de la tarea. Si se interrumpe la conexión, vuelve a ejecutar el mismo trabajo para que el código pueda reanudar la tarea existente. Para generar intencionadamente un audio diferente, utiliza un nuevo nombre de archivo de trabajo. Mantén el archivo de trabajo en privado si su script contiene información confidencial.
Consulte parámetros_ignorados De este modo, un ajuste no compatible no se convierte automáticamente en tu configuración predeterminada. Los controles ElevenLabs como voice_id difieren de los de Qwen voz y tipo_de_idioma campos. Realizar una consulta cada 5-10 segundos, gestionar un falló estado y guardar inmediatamente los archivos que se hayan guardado correctamente: el tiempo de conservación de los resultados documentado es de 30 días.
Escucha dos ejemplos de presentaciones de productos
Estas dos muestras generadas por IA utilizan el mismo guion de presentación del producto, de 216 caracteres, con Eleven v3 y Qwen Audio 3.0 TTS Flash. Cada una es el primer resultado de una solicitud, con la configuración de voz predeterminada. Te ofrecen dos archivos cortos para que los revises y escuches; no se trata de una comparación controlada de voces coincidentes ni de una evaluación comparativa de la voz OpenAI.
Eleven v3: audio de la presentación del producto
eleven-v3 · ejemplo de recorrido por el producto
- Salida
- MP3 · mono · 44,1 kHz
- Longitud
- Unos 15,6 segundos
- Generación
- Primera salida · 1 solicitud
Configuración: el texto exacto que figura a continuación, la voz predeterminada y otros ajustes; sin modificación de la voz ni instrucciones de interpretación. No se grabó la identidad de la voz predeterminada.
Estado y plazos: La generación se realizó con éxito. Las marcas de tiempo del servidor de la tarea indican que transcurrieron 13 segundos desde el envío hasta la finalización; se trata de una sola solicitud, no de una prueba de latencia.
Observación sobre el archivo: El archivo MP3 contiene una secuencia de audio mono a 44,1 kHz y ocupa aproximadamente 251 kB. Sus tramas pueden leerse hasta el final del archivo.
Referencia de costes: La tarifa del catálogo público es de 330 créditos por cada 1.000 caracteres. Utiliza un presupuesto de trabajo para una nueva solicitud; esta tarifa no corresponde a la factura de la muestra.
Uso práctico: Un archivo MP3 compacto para escuchar una breve presentación del producto. Comprueba el texto completo y la reproducción en el dispositivo de destino antes de utilizarlo en un lanzamiento.
Lee la entrada exacta · 216 caracteres
Bienvenido al recorrido por los productos de Acorn Studio. En tres pasos, podrás convertir un guion breve en una audioguía. Primero, escribe el mensaje. A continuación, elige una voz. Por último, guarda el archivo de audio y comprueba la reproducción en tu móvil.
Qwen Audio 3.0 TTS Flash: audio de la presentación del producto
qwen-audio-3.0-tts-flash · Ejemplo de presentación del producto
- Salida
- WAV · mono · 24 kHz
- Longitud
- 15,52 segundos de datos PCM
- Generación
- Primera salida · 1 solicitud
Configuración: el texto exacto que figura a continuación, la voz predeterminada y otros ajustes; sin modificación de la voz ni instrucciones de interpretación. No se grabó la identidad de la voz predeterminada.
Estado y plazos: La generación se ha realizado correctamente. Las marcas de tiempo del servidor de la tarea indican que han transcurrido 17 segundos desde el envío hasta la finalización; se trata de una sola solicitud, no de una prueba de latencia.
Observación sobre el archivo: El archivo WAV contiene audio PCM mono de 16 bits a 24 kHz y ocupa aproximadamente 745 kB. Su encabezado indica más datos de los que contiene el archivo; aquí se conserva la salida original.
Referencia de costes: La tarifa del catálogo público es de 330 créditos por cada 1.000 caracteres. Utiliza un presupuesto de trabajo para una nueva solicitud; esta tarifa no corresponde a la factura de la muestra.
Uso práctico: Una muestra WAV para evaluar el flujo de trabajo de una narración. Soluciona la inconsistencia en la duración de la cabecera en tu proceso de producción y comprueba que la reproducción sea completa antes de la distribución.
Lee la entrada exacta · 216 caracteres
Bienvenido al recorrido por los productos de Acorn Studio. En tres pasos, podrás convertir un guion breve en una audioguía. Primero, escribe el mensaje. A continuación, elige una voz. Por último, guarda el archivo de audio y comprueba la reproducción en tu móvil.
La muestra Qwen tiene aproximadamente el triple de tamaño que la muestra Eleven con una duración similar, lo que refleja las diferencias entre los formatos WAV y MP3. Además, su encabezado WAV indica más datos de los que el archivo contiene físicamente. Se trata de un problema de empaquetado del archivo que conviene comprobar en el reproductor de destino; por sí solo, no dice nada sobre la calidad de la voz hablada.
Solucionar problemas habituales en la generación de voz
| Síntoma | Qué hay que comprobar en primer lugar |
|---|---|
| El archivo MP3 guardado no se reproduce | Comprueba el estado HTTP y el tipo de respuesta. Es posible que se haya guardado un error de la API con una extensión de audio. |
| La solicitud rechaza una voz o una instrucción | Asigna la voz y los campos opcionales al modelo seleccionado. Los modelos TTS OpenAI más antiguos no admiten instrucciones. |
| Se rechaza un guion muy extenso | Comprueba el límite de caracteres de la ruta y el límite de tokens de Mini TTS, y luego divídela en puntos de separación naturales. |
| Aparece una respuesta 401 o 429 | Comprueba la clave/cuenta para el código 401. Para el código 429, distingue entre los límites de frecuencia y la cuota insuficiente antes de volver a intentarlo. |
| Una solicitud GlobalGPT sigue pendiente | Consulta el ID de la tarea guardada y comprueba su estado; un tiempo de espera agotado no es motivo para enviar un trabajo duplicado. |
| La voz no se ajusta a la configuración solicitada. | Comprueba los metadatos específicos del modelo y los parámetros ignorados antes de dar por hecho que se ha aplicado la configuración. |
| La barra de duración o de desplazamiento del audio parece que no funciona bien | Compara los metadatos del archivo con el contenido multimedia real y prueba el archivo completo en el reproductor de destino. |
En caso de un error OpenAI, empieza por su Guía sobre códigos de error. En el caso de una tarea GlobalGPT, guarda el ID de la tarea y los detalles del error devuelto. Durante el desarrollo, mantén separados los fallos de transporte, los fallos de facturación y las grabaciones de voz insatisfactorias: cada uno requiere una solución diferente.
Antes de enviar la narración, escucha la grabación completa en el dispositivo que utilizará tu público. Comprueba la introducción, los nombres y los números, las transiciones y la frase final. Incluye un aviso sobre el uso de voz generada por IA al inicio de la reproducción y guarda una copia del texto exacto y de la configuración del modelo para que se pueda volver a generar el guion editado de forma precisa.
Preguntas frecuentes
¿Qué es el punto final de la API de voz OpenAI?
Utiliza el método POST en https://api.openai.com/v1/audio/speech. Los campos obligatorios son «model», «input» y «voice». La respuesta es un archivo de audio generado; el formato predeterminado es MP3.
¿Es gratuita la API de voz OpenAI?
La API de voz tiene un modelo de precios basado en el uso. Calcula tu presupuesto teniendo en cuenta las tarifas actuales de la API, en lugar de dar por hecho que hay una asignación gratuita: el servicio GPT-4o Mini TTS se factura por tokens de entrada de texto y salida de audio, mientras que los servicios TTS-1 y TTS-1 HD se facturan por caracteres.
¿Puedo controlar la voz y el estilo al hablar?
Elige una voz compatible con tu modelo. GPT-4o Mini TTS también admite instrucciones sobre el tono de voz, como «cálido» o «tranquilo». El campo de instrucciones no funciona con TTS-1 ni con TTS-1 HD.
¿Admite la API de voz la transmisión en streaming?
Sí. Puede transmitir el audio generado por fragmentos. Tu aplicación debe encargarse de la reproducción; la transmisión de la conversión de texto a voz por sí sola no basta para mantener una conversación de voz en directo completa.
¿Puedo utilizar GlobalGPT cambiando la URL base de OpenAI?
Utiliza el flujo de trabajo documentado de GlobalGPT para tareas multimedia relacionadas con la síntesis de voz (TTS): envía la solicitud a POST /tasks, consulta GET /tasks/{id} y descarga output.url una vez completada la operación con éxito. Su catálogo documentado de TTS incluye los modelos ElevenLabs y Qwen, cada uno con su propio identificador y parámetros.
¿Por qué formato de audio debería empezar?
Empieza con el formato MP3 si lo que quieres es una descarga sencilla o reproducirlo en un reproductor web. El formato WAV resulta útil cuando el siguiente paso es la edición. El formato PCM sin procesar requiere un reproductor configurado para su frecuencia de muestreo y profundidad de bits, ya que carece de encabezado de archivo.
Empieza con un guion breve, una voz y un archivo guardado. Una vez que la reproducción y los costes sean predecibles, añade la segmentación, los reintentos y el resto de tu flujo de trabajo multimedia. Mantén el formato de solicitud, las unidades de facturación y la gestión de resultados de la API elegida de forma coherente en tu implementación.
Dale voz a tu próximo guión
Elabora un breve recorrido por el producto, crea una voz en off con ElevenLabs o Qwen y continúa con imágenes y vídeo en el espacio de trabajo multimodelo de GlobalGPT.
Crear audio de voz con GlobalGPT