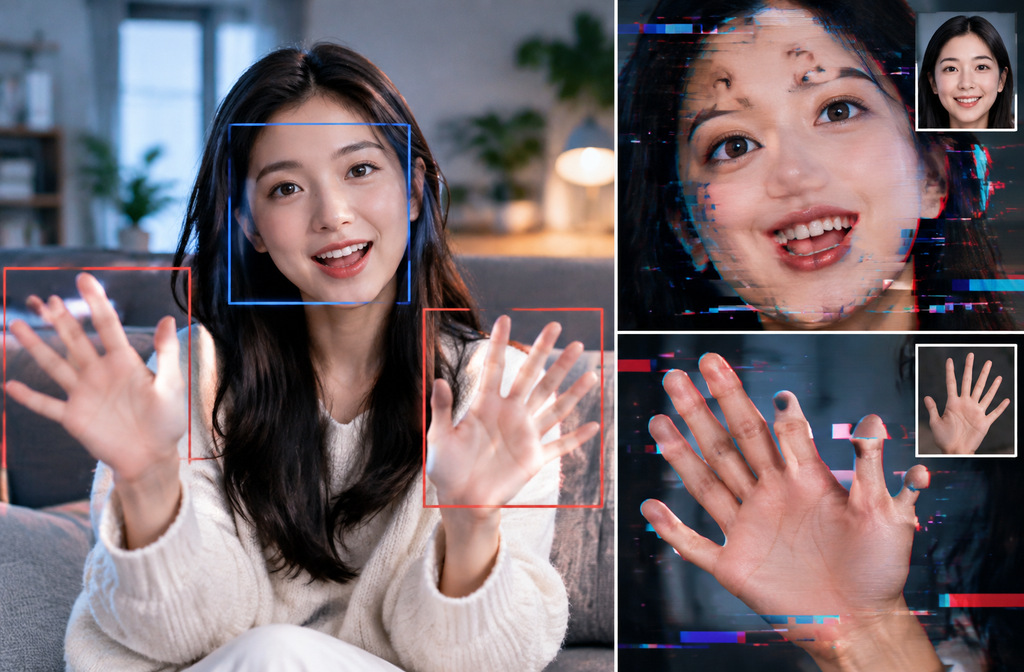
Bei KI-Videos mit Händen und Gesichtern treten Fehler auf, weil ein Modell Anatomie, Identität, Beleuchtung, Körperhaltung und Bewegung über viele Einzelbilder hinweg konsistent halten muss und nicht nur ein einziges überzeugendes Bild zeichnen darf. Eine Hand, die in Bild 20 noch annehmbar aussieht, kann in Bild 24 das Gesicht überqueren, in Bild 26 den Fingerabstand verändern und in Bild 28 mit den Haaren verschmelzen. Das Modell muss dann mehrere unklare Bereiche gleichzeitig korrigieren.
Wir haben über die GlobalGPT-Befehlszeilenschnittstelle eine kurze, freundliche Eingabeanweisung mit einer deutlich stärker eingeschränkten Eingabeanweisung mit offener Handfläche verglichen. Die eingeschränkte Version erzeugte ruhigere Bewegungen und eine besser erkennbare Handhaltung. Die Identität der Quellperson, ihre Kleidung, das Mikrofon und der Raum wurden dabei nicht beibehalten. Dieses gemischte Ergebnis ist nützlicher als eine perfekte Demonstration, da es zeigt, was sich durch Prompt-Einschränkungen steuern lässt und was nicht.
Warum Hände im Laufe der Zeit versagen
Hände sind bewegliche Objekte mit vielen kleinen Teilen, häufigen Selbstüberdeckungen und schnellen Veränderungen ihrer Kontur. Eine winkende Hand dreht sich, die Finger überlappen sich, Bewegungsunschärfe lässt die Kanten verschwimmen und die Handfläche bewegt sich relativ zum Gesicht. Der Generator muss aus jeder neuen Ansicht eine konsistente 3D-Struktur ableiten und dabei das vorherige Bild beibehalten.
Die Probleme äußern sich in Form von zusätzlichen Fingern, zusammengewachsenen Fingern, veränderten Nagelpositionen, gummiartigen Handgelenken oder einer Hand, die die Seite wechselt. Im weiteren Sinne KI-gestützte Videofehlerdiagnose hilft dabei, anatomische Fehler von Fehlern in Bezug auf Kameraführung, Physik und Kontinuität zu unterscheiden.
Warum Gesichter verzerrt wirken, auch wenn ein einzelnes Bild gut aussieht
Ein Gesicht reagiert empfindlich auf winzige Veränderungen des Augenabstands, der Augenform, der Mundwinkel, der Nasenbreite und des Haaransatzes. Durch Sprache und Mimik verschieben sich diese Orientierungspunkte ständig. Wenn das Gesicht kleiner wird, sich abwendet, in einen Schatten gerät oder teilweise von einer Hand verdeckt wird, stehen dem Modell weniger Anhaltspunkte zur Verfügung, und es kann die Identität neu bestimmen.
Deshalb Workflow zur Sicherstellung der Konsistenz bei KI-Videos betrachtet die Stabilität der Figur als ein Problem der Abfolge. Ein starker erster Bildausschnitt ist hilfreich, aber auch die Eingabeaufforderung, die Kamera, die Dauer und die Bewegung müssen das Identitätssignal schützen.
Unser Basistest und unser Test unter bestimmten Bedingungen
Bei beiden Durchläufen wurde dasselbe Ausgangsbild und die Route „Grok Imagine“ bei einer Auflösung von 1280×720 für etwa fünf Sekunden verwendet. Bei der Basisversion wurde die Frau gebeten, sich zur Kamera zu drehen und zu winken. Die eingeschränkte Anweisung nannte die rechte Hand, verlangte fünf gespreizte Finger, schrieb vor, die Hand neben der Schulter zu halten, verbot die Verdeckung des Gesichts, schränkte Kopfbewegungen ein und fixierte die Kamera.
Jede Aufgabe kostete 500 Credits. Es handelt sich hierbei um eine A/B-Beobachtung mit einem Durchlauf pro Aufforderung, nicht um ein statistisch kontrolliertes Experiment. Wir haben festgelegte Zeitabschnitte als Stichproben entnommen und die Videos in normaler Geschwindigkeit gesichtet.
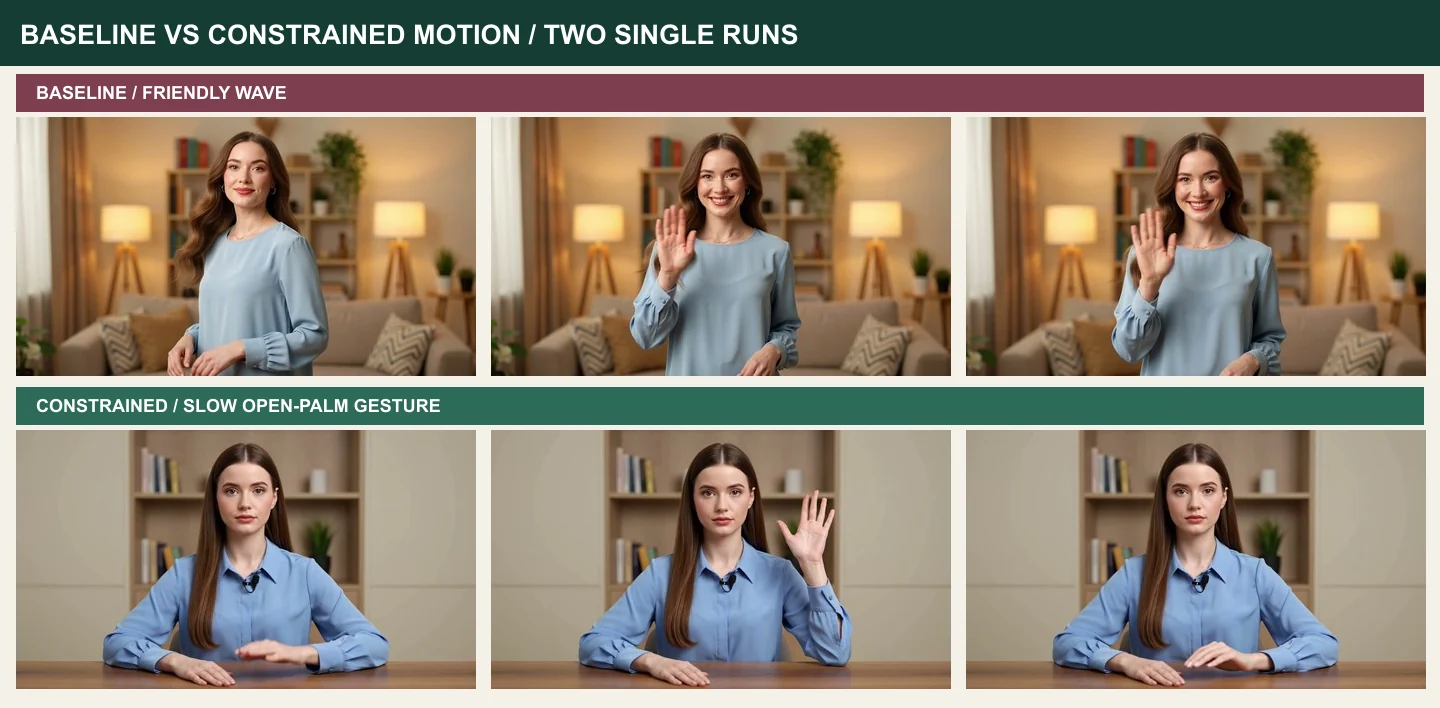
Basis-Ergebnis: Lebhafte Bewegung, erhebliche Identitätsabweichung
Die Ausgangssequenz erzeugte ein freundliches, energiegeladenes Winken. Die offene Hand blieb in den gesampelten Einzelbildern erkennbar, doch in der Ausgabe wurde die ursprüngliche Darstellerin durch eine anders aussehende Frau in einem anderen Raum und mit anderer Kleidung ersetzt. Die Bildkomposition änderte sich, noch bevor das Winken überhaupt zur Hauptaktion wurde.
Dieses Ergebnis zeigt, warum eine optisch ansprechende Benutzeroberfläche allein nicht ausreicht. Wenn die Stelle einen regelmäßig auftretenden Moderator erfordert, sind Identität und Umfeld strenge Akzeptanzkriterien. Die Aus einem Foto einen einheitlichen Charakter entwickeln befasst sich mit Entscheidungen bezüglich des Quellbildes, die die Ausgangsreferenz verbessern können, doch unser Ergebnis zeigt, dass eine Quelle allein keine Kontinuität garantiert.
Ergebnis unter Einschränkungen: Bessere Pose, Identität weiterhin nicht erkannt
Die kontrollierte Bewegung verlief langsamer, die Hand blieb neben dem Kopf und nahm eine klarere Haltung mit offener Handfläche ein. Die Hand strich nicht über das Gesicht. Diese Unterschiede machten es einfacher, die Geste zu analysieren, und würden die Bearbeitung vereinfachen.
Dennoch haben sich die Person, die Kleidung, das Mikrofon und der Raum immer noch erheblich verändert. Die Vorgabe sah eine exakte Wiedergabe vor, doch das Modell hat dies nicht erfüllt. Man kann sagen, dass der eingeschränkte Lauf die Lesbarkeit der Bewegungen bei diesem Paar verbessert hat. Man kann jedoch nicht behaupten, dass dadurch die Anatomie durchweg korrigiert oder die Identität gewahrt wurde.
Schreibanregungen zum Thema Sichtbarkeit und Bewegung
Eine nützliche Handanweisung nennt ein Glied, eine Bewegung, eine Position und eine Dauer. “Die rechte Hand heben, die offene Handfläche neben der Schulter zeigen, eine Sekunde lang halten, senken” ist überprüfbar. “Beim aufgeregten Sprechen natürlich gestikulieren” lässt viele Gelenke, Geschwindigkeiten und Okklusionen unbestimmt.
Auch die Kameraführung spielt eine Rolle. Fixieren Sie die Kamera, halten Sie die gesamte Hand im Bildausschnitt und vermeiden Sie aggressive Zooms während der Geste. Die Steuerelemente für Kamera und Bewegungsaufforderungen bietet einen größeren Wortschatz für Kamera- und Bewegungssteuerung, während Veo-Techniken zur Bewegungsauslösung ergänzt um Veo-spezifische Prompt-Techniken.
Schützen Sie das Gesicht, bevor Sie die Leistung steigern
Das Gesicht sollte groß genug sein, um es gut erkennen zu können. Vermeiden Sie Kopfdrehungen, extreme Mimik und gekreuzte Hände in entscheidenden Momenten. Achten Sie auf dezentes Blinzeln und kleine Mundbewegungen, bevor Sie Dialog, Requisiten und Kamerabewegungen kombinieren. Fügen Sie erst dann komplexere Elemente hinzu, wenn die einfachste Einstellung funktioniert.
Bei langen Sequenzen sollten Sie die Darbietung in einzelne Einstellungen mit stabilen Start- und Endbildern unterteilen. Die Konsistenz der Charaktere in Langform-Videos erklärt, warum es mit zunehmender Anzahl von Clips schwieriger wird, die Kontinuität der Figuren zu wahren, und wie Anker bei Schnittstellen helfen.
Einen besseren Quellrahmen erstellen
Verwenden Sie ein scharfes, gleichmäßig ausgeleuchtetes Bild, auf dem beide Augen zu sehen sind, die Haarsilhouette klar erkennbar ist und die Hände entweder vollständig sichtbar sind oder sich komplett außerhalb des Bildausschnitts befinden. Vermeiden Sie Finger, die vom Bildrand abgeschnitten sind, starke Schönheitsfilter, starke Bewegungsunschärfe und gemusterte Hintergründe, die den Körper durchschneiden.
Ein Ausgangsbild sollte zudem zur beabsichtigten Videokomposition passen. Wenn man aus einem Nahaufnahmeporträt eine Aufnahme bis zur Taille machen will, muss das Modell gleichzeitig Arme, Hände, Kleidung und Raumdetails erfinden. Erstellen oder fotografieren Sie den benötigten Bildausschnitt vor der Animation.
Fehler bei der Triage statt alles neu zu schreiben
- Wenn sich die Finger berühren, verlangsamen Sie die Geste und entfernen Sie die Hand vom Gesicht oder Körper.
- Wenn die Identität abweicht, reduzieren Sie die Kopfdrehung, den Ausdrucksumfang und die Clip-Dauer.
- Wenn sich das Handgelenk ungewöhnlich beugt, vereinfachen Sie die Handbewegung und vermeiden Sie die Interaktion mit Requisiten.
- Sollte sich der Hintergrund ändern, fixieren Sie die Kamera und beschreiben Sie feste Szenenankerpunkte.
- Sollten mehrere Fehler gleichzeitig auftreten, kehren Sie zu einem fehlerfreien Quellframe zurück.
Häufige Fehler bei KI-Videos listet häufige Planungsfehler auf, die oft zu diesen sich verstärkenden Fehlschlägen führen.
Kopierbare Basis- und eingeschränkte Eingabeaufforderungen
Führen Sie zunächst die kurze Basislinie aus, damit Sie sehen können, welche Entscheidung das Modell ohne Hilfe trifft. Ändern Sie anschließend nur die Bewegungsbeschränkungen. Behalten Sie Modell, Quelle, Dauer und Seitenverhältnis bei. Dadurch lässt sich der Vergleich leichter interpretieren, auch wenn zwei einzelne Stichproben keinen Kausalzusammenhang belegen können.
Bild für Bild ansehen, dann in normaler Geschwindigkeit
Bei der Wiedergabe in Normalgeschwindigkeit lässt sich erkennen, ob die Bewegung natürlich wirkt. Beim Frame-Stepping wird deutlich, wann die Anatomie oder die Identität der Figur abweichen. Überprüfen Sie den Startpunkt, den Höhepunkt der Geste, den Okklusionspunkt und die Rückkehrpose. Achten Sie auf beide Hände, nicht nur auf die winkende, und vergleichen Sie die Augenform und die Mundwinkel mit dem Ausgangsmaterial.
Notieren Sie sich das früheste fehlerhafte Bild. So können Sie entscheiden, ob Sie die Quelle ändern, die Einstellung verkürzen oder einen bestimmten Übergang einschränken sollten. Eine vage Anmerkung wie “sieht komisch aus” lässt sich nur schwer in eine konkrete Anweisung umsetzen.
Behandeln Sie Okklusion als Produktionsrisiko
Eine Okklusion tritt auf, wenn ein Objekt ein anderes verdeckt: Finger verdecken das Gesicht, Haare verdecken ein Auge, ein Requisit verdeckt das Handgelenk oder der Körper dreht sich von der Kamera weg. Die verdeckte Struktur muss dennoch erschlossen werden, und das Modell kann sie möglicherweise in einer anderen Form wiederherstellen. Schnelle Bewegungen erschweren diese Schlussfolgerung, da benachbarte Einzelbilder weniger verlässliche Anhaltspunkte liefern.
Inszenieren Sie die Handlung so, dass wichtige anatomische Merkmale sichtbar bleiben. Platzieren Sie die Hand neben dem Gesicht und nicht davor. Halten Sie Requisiten von den Fingergelenken fern. Wenn ein Kontakt unvermeidbar ist, unterteilen Sie die Handlung in Aufnahmen der Annäherung, des Kontakts und des Loslassens und schneiden Sie diese anschließend zusammen. Dadurch wird die Anzahl der abrupten Übergänge reduziert, die eine Generierung bewältigen muss.
Wiederholen Sie den Test, bevor Sie eine allgemeine Schlussfolgerung ziehen.
Unsere beiden Clips liefern nützliche Erkenntnisse, doch ein einzelner Startwert kann eine Eingabe entweder begünstigen oder benachteiligen. Für eine tatsächliche Modellauswahl sollten Sie jede Eingabe mehrmals mit derselben Quelle und denselben Einstellungen wiederholen. Bewerten Sie die Lesbarkeit, die Identität, den Hintergrund, die Kamera und die Vollständigkeit der Handlung separat. Speichern Sie abgelehnte Ergebnisse im Protokoll.
Ein wiederholter Test kann Aufschluss darüber geben, ob die eingeschränkte Eingabeaufforderung die Wahrscheinlichkeit einer brauchbaren Pose erhöht oder lediglich ein glückliches Ergebnis hervorgebracht hat. Er kann auch einen Kompromiss aufzeigen: Eine stärkere Bewegungssteuerung kann den Ausdruck einschränken oder zu einer steiferen Darstellung führen. Wählen Sie die Balance, die zur Einstellung passt, anstatt einem einzelnen perfekten Bild nachjagen.
Wissen, wann man bearbeiten und wann man neu generieren sollte
Bearbeiten Sie kurze Fehlerstellen heraus, wenn Identität, Handlung und Kameraführung ansonsten überzeugend sind. Ein kurzer Schnitt kann ein Zusammenfallen des Fingers über zwei Einzelbilder hinweg verbergen; ein strafferer Schnitt kann eine misslungene Rückkehrpose entfernen. Erstellen Sie die Szene neu, wenn sich das Gesicht durchgehend verändert, die falsche Hand die Handlung ausführt, sich der Hintergrund verändert oder die Anatomie über viele Einzelbilder hinweg nicht stimmt.
Verbringen Sie keine Stunde damit, einen Clip zu überarbeiten, der gegen die Kernvorgaben verstößt. Umgekehrt sollten Sie eine hervorragende Leistung nicht wegen eines winzigen Problems verwerfen, das sich durch einen normalen Schnitt kaschieren lässt. Die Abnahme-Checkliste sollte bereits vor Beginn der Überprüfung zwischen schwerwiegenden Fehlern und behebbaren Unvollkommenheiten unterscheiden.
Verwenden Sie eine Checkliste zur Akzeptanz menschlicher Bewegungen
Bewerten Sie bei jeder Aufnahme fünf Bereiche unabhängig voneinander: Identität, Anatomie, Handlung, Kamera und Szene. Der Bereich „Identität“ umfasst Gesichtsproportionen, Haare und Kleidung. Der Bereich „Anatomie“ umfasst Finger, Handgelenke, Ellbogen, Zähne und Augenbewegungen. Im Bereich „Handlung“ wird geprüft, ob die gewünschte Bewegung korrekt beginnt, ihren Höhepunkt erreicht und endet. Der Bereich „Kamera“ umfasst den Bildausschnitt und unerwünschte Bewegungen. Der Bereich „Szene“ umfasst Requisiten, Hintergrund und die Kontinuität der Beleuchtung.
Kennzeichnen Sie jeden Bereich als „bestanden“, „reparierbar“ oder „ausgeschieden“. Ein „reparierbares“ Ergebnis kann einen kurzen fehlerhaften Bildausschnitt enthalten, der ohne Bedeutungsveränderung herausgeschnitten werden kann. Ein „ausgeschiedenes“ Ergebnis weist eine anhaltende Identitätsabweichung, wiederholtes Zusammenfallen der Hand oder eine fehlende Handlung auf. Diese Klassifizierung verhindert, dass ein optisch ansprechender Clip mit einem schwerwiegenden Kontinuitätsfehler durchrutscht.
Überprüfen Sie den Ton separat, auch wenn sich der Artikel auf Gesichter und Hände konzentriert. Unerwartete Geräusche, Sprachartefakte oder eine fehlende Tonspur können eine visuell akzeptable Aufnahme unbrauchbar machen. Die endgültige Aufnahme ist die Datei, die alle Auslieferungsspezifikationen erfüllt, nicht das Standbild, das auf einem Kontaktabzug am besten aussieht.
Das praktische Fazit
Unsere eingeschränkte Eingabe führte zu einer ruhigeren, besser lesbaren Handgeste als bei der Basisvariante, doch bei beiden Ergebnissen änderte sich die Identität drastisch. Durch das Prompt-Engineering wurde zwar eine Dimension verbessert, das gesamte Kontinuitätsproblem wurde jedoch nicht gelöst.
Eine produktionsreife Methode umfasst eine gut eingerahmte Quelle, eine kontrollierte Handlung, eine stabile Kamera, wiederholte Aufnahmen und eine schriftliche Abnahme-Checkliste. Wenn die Person sprechen oder mit einem Requisit umgehen muss, sollten diese Handlungen zunächst in separaten kurzen Aufnahmen einstudiert werden, bevor sie kombiniert werden. Komplexität sollte erst nach erfolgreichen Tests eingeführt werden.
Beurteilen Sie die Handbewegungen nicht allein anhand des letzten Bildes. Beobachten Sie den gesamten Bewegungsablauf der Geste von Anfang bis Ende und vergleichen Sie dann das Gesicht mit der Vorlage. Eine saubere Handfläche kann nicht über eine andere Person hinwegtäuschen, und ein stabiles Gesicht kann nicht über ein Handgelenk hinwegtäuschen, das während der Bewegung nachgibt.
Vergleichen Sie Videorouten in GlobalGPT Wenn eine Aufnahme misslingt, ändern Sie jeweils nur eine Variable und notieren Sie sich die Quelle, die Einstellungen und den Grund für die Ablehnung. Bessere Darstellungen von Händen und Gesichtern entstehen dadurch, dass man die Unsicherheit über die gesamte Sequenz hinweg verringert, und nicht dadurch, dass man einer überladenen Eingabeaufforderung “perfekte Anatomie” hinzufügt.
Wiederholen Sie für den nächsten Test beide Anweisungen mehrmals mit derselben Quelle und bewerten Sie Identität, Anatomie, Handlung, Kamera und Szene separat. Diese kleine Stichprobe wird zeigen, ob die eingeschränkte Anweisung die Verwertungsquote verbessert oder lediglich zu einem glücklichen Ergebnis geführt hat. Halten Sie die Bewegung kurz und deutlich sichtbar, bis die Kerngeste stabil ist. Fügen Sie dann nacheinander Sprache, Requisiten oder Kamerabewegungen hinzu und bewahren Sie dabei eine saubere Version jeder Phase auf, die die Überprüfung bestanden hat.
Häufig gestellte Fragen
Warum haben KI-Videohände zusätzliche Finger?
Schnelle Gelenkbewegungen, Selbstüberlappung, Bewegungsunschärfe und wechselnde Blickwinkel führen dazu, dass die Fingerstruktur von Bild zu Bild unklar ist. Das Modell zeichnet die Hand möglicherweise bei jeder Bewegung anders nach.
Warum verändert sich ein Gesicht in einem KI-Video?
Kleine Gesichter, Kopfdrehungen, Mimik, Schatten und Verdeckungen schwächen die Identitätsmerkmale. Der Generator baut die Gesichtsmerkmale daraufhin neu auf, anstatt sie exakt beizubehalten.
Kann eine bessere Eingabeaufforderung die Probleme der KI beheben?
Eine eingeschränkte Eingabeaufforderung kann Bewegungen und Verdeckungen reduzieren, was in unserem einzelnen Test die Lesbarkeit verbessert hat. Sie kann jedoch nicht gewährleisten, dass die Anatomie bei jedem Modell oder Durchlauf korrekt ist.
Garantiert ein Referenzbild die Konsistenz der Identität?
Nein. Eine starke Lichtquelle ist zwar hilfreich, aber das Videomodell kann die Person, die Kleidung, den Raum oder die Kamerakomposition während der Bewegung dennoch verändern.
Welche Kamerabewegung ist für Gesichter und Hände am sichersten?
Eine feststehende Kamera mit einer Bildkomposition, die den Mittelteil oder den Oberkörper zeigt, ist der sicherste Ausgangspunkt. Fügen Sie Schwenks, Zooms oder Umlaufbewegungen erst hinzu, nachdem die einfache Geste vorbei ist.
Kann ich das Modell wechseln, wenn eine Aufnahme immer wieder misslingt?
Ja. Mit GlobalGPT können Sie die verfügbaren Videorouten vergleichen. Halten Sie die Quelle und die Akzeptanzkriterien konstant, damit Sie beurteilen können, ob die Modelländerung tatsächlich einen Vorteil bringt.