Evidenzbasierte Überprüfung · August 2026
Offene Gewichte, gehostete APIs und die Namenslücke – übersichtlich dargestellt.
Beweisgrenze: Es wird kein Hörergebnis aus erster Hand für Qwen3-TTS angegeben.
Ein aussagekräftiger Testbericht zu Qwen3-TTS muss vor der Bewertung der Stimmen eine grundlegendere Frage klären: Um welche Qwen3-TTS-Version geht es eigentlich? Im Jahr 2026 umfasst dieser Name herunterladbare Checkpoints mit 0,6B und 1,7B, auf Alibaba Cloud gehostete Qwen3-TTS-APIs sowie einen Markt, auf dem auch die separate Qwen-Audio 3.0-TTS-Produktfamilie empfohlen wird. Wer diese Produkte als ein Ganzes betrachtet, kommt zu irreführenden Aussagen hinsichtlich Geschwindigkeit, Sprachen und Preisen.
Die kurze Antwort lautet: Qwen3-TTS ist einer der flexibelsten offenen Sprach-Stacks des Jahres 2026. Er bietet zehn Sprachen, aufgabenspezifische Checkpoints, Sprachklonung in etwa drei Sekunden, Sprachdesign in natürlicher Sprache, Streaming-Unterstützung und eine Apache-2.0-Lizenz. Allerdings enthält dieser Testbericht keine Bewertung der Sprachwiedergabequalität: Die verfügbare Testumgebung stellte keinen echten Qwen3-TTS-Endpunkt zur Verfügung, und die lokale 2-GB-GPU war für einen repräsentativen Vergleich zwischen den Versionen 0,6B und 1,7B nicht geeignet.
Status von Qwen3-TTS im Jahr 2026
Qwen hat am 22. Januar 2026 die offenen Qwen3-TTS-Gewichtungen veröffentlicht. Die offizielles Qwen3-TTS-Repository listet fünf veröffentlichte 12-Hz-Checkpoints auf: 1,7B VoiceDesign, 1,7B CustomVoice, 1,7B Base, 0,6B CustomVoice und 0,6B Base. Die dazugehörigen Hugging Face-Sammlung umfasst auch den Tokenizer. Dies sind die Modelle, die Entwickler im Rahmen der veröffentlichten Lizenz einsehen, herunterladen und ausführen können.
Alibaba Cloud bietet separat die Produktfamilien „Qwen3-TTS Flash“, „Instruct“, „Voice-Cloning“ und „Voice-Design“ über Nicht-Echtzeit- und Echtzeit-Schnittstellen an. Das aktuelle Angebot Katalog der Sprachsynthesemodelle sollte als maßgebliche Quelle für gehostete Aliase, Regionen, Sprachen und Schnittstellen angesehen werden, da sich diese Angaben ändern können, ohne dass sich die Namen der offenen Checkpoints ändern.
Es gibt noch eine weitere Besonderheit bei der Benennung. Die Leitlinien von Alibaba Cloud zur Modellauswahl für 2026 verweisen Nutzer für verschiedene gehostete Aufträge ebenfalls auf „Qwen-Audio 3.0 TTS“. „Qwen-Audio 3.0 TTS“ ist kein umbenannter 0.6B- oder 1.7B-Checkpoint der Qwen3-TTS-Reihe. Wenn Sie bereits mit der breiter gefassten Qwen-Familie vertraut sind, ist unsere Qwen 3.8 – Technische Daten und Testbericht zeigt, warum die genaue Modellbezeichnung bei den Qwen-Produkten von Bedeutung ist.
Verwenden Sie den Namen des offenen Checkpoints für die lokale Inferenz, die genaue Alibaba Cloud-Modell-ID für das API-Verhalten und „Qwen-Audio 3.0 TTS“ ausschließlich als separate Alternative. Dadurch bleiben alle Angaben zu Qualität, Latenz und Preis dem Produkt zugeordnet, aus dem sie stammen.
Kurzfazit: leistungsstark, offen und evidenzorientiert
Kurzfazit
Offene Bereitstellung, Forschung, Klonen und Charakterstimmen.
Fünf aufgabenspezifische Kontrollpunkte in zwei Größen.
Die Geschwindigkeit des Anbieters ist umgebungsabhängig; die Qualität wird hier nicht bewertet.
„Hosted Qwen3-TTS“ und „Qwen-Audio 3.0“ sind separate Routen.
Qwen3-TTS ist besonders interessant für Teams, die Kontrolle und Flexibilität bei der Bereitstellung wünschen. Die „Base“-Checkpoints unterstützen das Klonen, „CustomVoice“ bietet benannte voreingestellte Sprecher mit Anweisungssteuerung, und „VoiceDesign“ kann anhand einer schriftlichen Beschreibung eine Stimme erstellen. Dank der Unterstützung von zehn Sprachen ist das Paket weitaus nützlicher als eine ausschließlich englischsprachige offene Demo, während die 0.6B-Versionen Entwicklern einen kompakteren Einstieg bieten.
Die wichtigste Einschränkung betrifft die Qualität der Daten. Qwen weist in einer optimierten internen Umgebung starke Benchmark-Ergebnisse und eine geringe Latenz beim ersten Paket auf. Diese Zahlen geben jedoch keinen Aufschluss über Kaltstarts von Laptops, den verfügbaren VRAM-Spielraum in Containern oder die Aussprache Ihrer Produktnamen. Die Angabe „Universal 97 ms“ lässt die Benchmark-Bedingungen außer Acht.
Für einen selbst gehosteten Prototyp gehört Qwen3-TTS zu den Top-Kandidaten auf der Auswahlliste. Bei einer Produktions-API sollten Sie die gehostete Qwen3-TTS-Lösung mit den neueren Qwen-Audio-Empfehlungen, dem operativen Support, der regionalen Verfügbarkeit und den Kosten für die Verwaltung geklonter Stimmen vergleichen. Wenn Ihr Ziel über Sprache hinausgeht und auch Soundeffekte oder Musik umfasst, bietet die umfassendere Seed Audio 1.0 – Tests mit Sprachaufnahmen, Soundeffekten und Musik einen anderen, stärker multimodalen Audio-Workflow abdecken.
Fazit: Qwen3-TTS schneidet in Bezug auf Architektur, Offenheit und Funktionsumfang hervorragend ab. Die tatsächliche Produktionsreife hängt jedoch weiterhin vom jeweiligen Checkpoint oder Endpoint, Ihrer Hardware, Ihrer Sprache sowie einer vereinbarten Referenzstimme ab, die mit Ihren eigenen Skripten getestet wurde.
Was ist Qwen3-TTS?
Qwen3-TTS ist eine Familie von Sprachgenerierungsmodellen, die auf einem diskreten Sprachtokenizer basiert, der mit 12,5 Frames pro Sekunde arbeitet. Laut der Technischer Bericht Qwen3-TTS, wurde das System mit mehr als fünf Millionen Stunden Sprachmaterial in zehn Sprachen trainiert. Die geringe Token-Rate ist ein zentraler Aspekt des Designs: Weniger akustische Token können den Dekodierungsaufwand verringern und das Streaming praktikabler machen, während das Modell dennoch Klangfarbe, Aussprache und Prosodie beibehalten muss.
Drei Ebenen, drei Beweisregeln
0,6 Mrd. / 1,7 Mrd.
Base, CustomVoice und 1.7B VoiceDesign. Zur Verwendung für lokale Modellansprüche.
Flash / Anleitung / VC / VD
Geben Sie das genaue API-Modell, die Schnittstelle, die Region und das Datum an.
Qwen-Audio 3.0 TTS
Eine aktuelle gehostete Alternative, kein umbenannter „Open Checkpoint“.
Die fünf veröffentlichten Meilensteine sind auf bestimmte Aufgaben ausgerichtet und stellen keine Abfolge dar, bei der jedes größere Modell alle Aufgaben erfüllt:
| Checkpoint freigegeben | Größe | Am besten passende Stelle | Wichtige Grenze |
|---|---|---|---|
| Qwen3-TTS-12Hz-0,6B-Base | 0,6 Mrd. | Kleinere Klonierungs- und Forschungsabläufe | Kein voreingestellter CustomVoice-Katalog |
| Qwen3-TTS-12Hz-1,7B-Base | 1,7 Mrd. | Klonierungs- und Weiterentwicklungsarbeiten in größerem Umfang | Benötigt mehr Speicher und Rechenleistung |
| Qwen3-TTS-12Hz-0,6B-CustomVoice | 0,6 Mrd. | Voreingestellte Stimmen mit Befehlssteuerung | Verwendet das bereits erhältliche Lautsprecherset |
| Qwen3-TTS-12Hz-1,7B-CustomVoice | 1,7 Mrd. | Stimmsynthese mit voreingestellten Stimmen und höherer Kapazität | Nicht der VoiceDesign-Prüfpunkt |
| Qwen3-TTS-12Hz-1,7B-VoiceDesign | 1,7 Mrd. | Erstellung eines Klangs anhand einer Textbeschreibung | Es wurde kein VoiceDesign-Peer der Version 0.6B veröffentlicht |
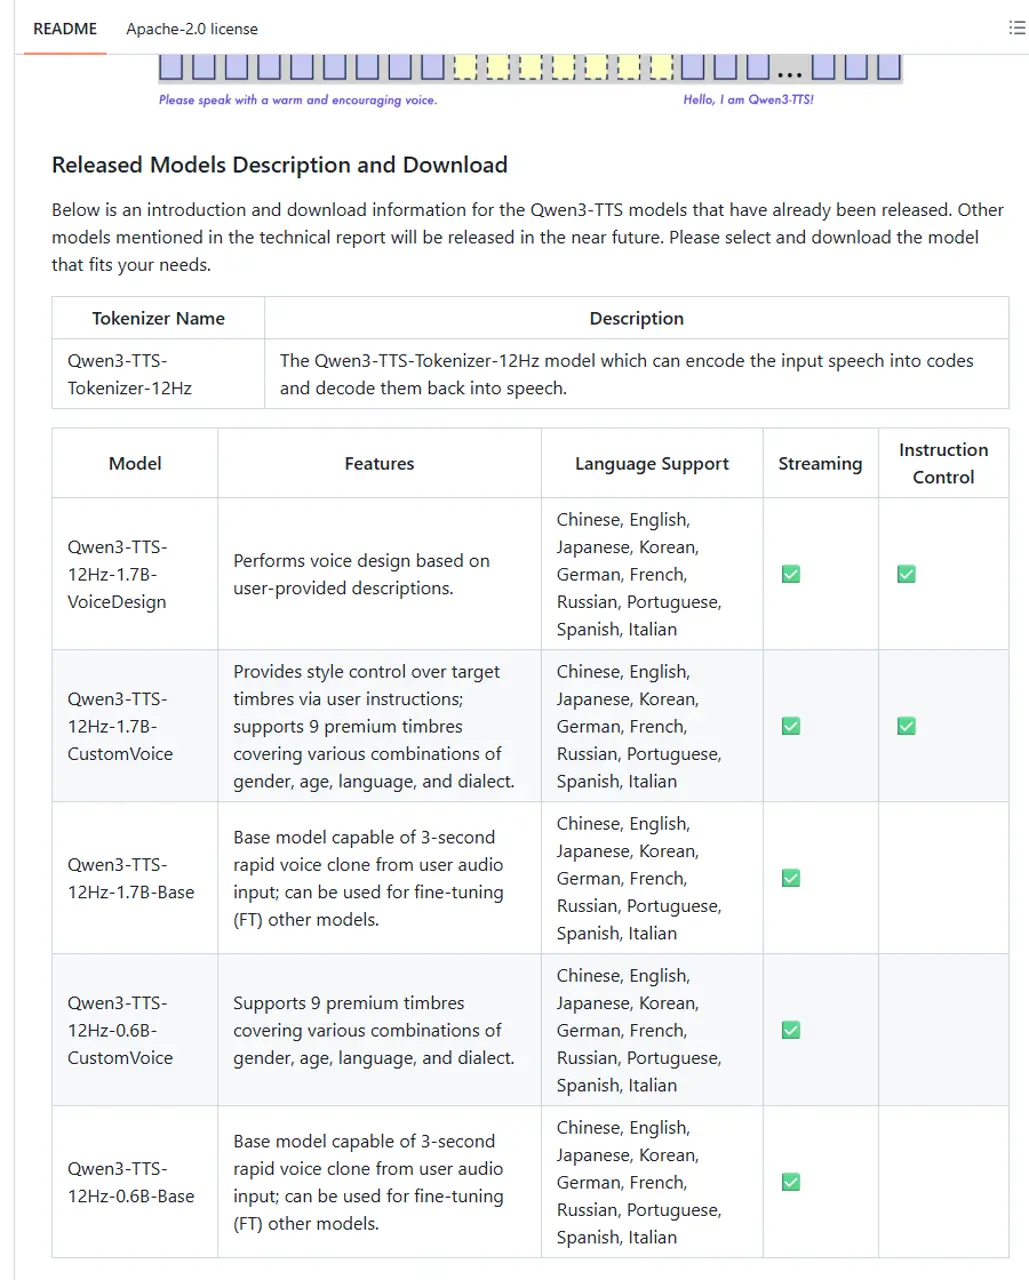
“Base” ist die richtige Wahl, wenn Sie über einen Referenzsprecher verfügen und die Erlaubnis haben, dessen Stimme zu verwenden. „CustomVoice“ ist der einfachere Weg, wenn eine der von Qwen veröffentlichten voreingestellten Klangfarben zum Projekt passt. „VoiceDesign“ eignet sich für Charakterbeschreibungen wie „ein ruhiger, reifer Erzähler mit einer sanften tiefen Stimme“, bei denen keine Referenzaufnahme erforderlich ist.
Ein Produkt-Tutorial muss nicht geklont werden, wenn ein voreingestellter Sprecher ausreicht, und für eine fiktive Figur ist möglicherweise keine Aufnahme einer realen Person erforderlich, wenn VoiceDesign eine passende Identität erstellt. Bewerten Sie jede Aufgabe anhand des entsprechenden Prüfpunkts.
So wurde dieser Testbericht zum Qwen3-TTS erstellt
Die Bewertung stützt sich auf vier Ebenen von Belegen: offizielle Unterlagen, den technischen Bericht zu Qwen, eine lokale Hardware-Prüfung sowie einen kontrollierten Test eines separat gehosteten Audio-Wrappers. Offizielle Quellen untermauern die Produktangaben und die vom Anbieter gemeldeten Benchmark-Ergebnisse. Der Wrapper-Test bestätigt lediglich das beobachtete Verhalten, nicht jedoch eine Bewertung der Sprachqualität gemäß Qwen3-TTS.
Die aufgeführten verfügbaren Aufgabenumgebungen qwen-audio-3.0-tts-flash, nicht ein qwen3-tts-* Modell.
Erstellen Sie eine klare Sprachaufnahme in Englisch. Lesen Sie genau folgenden Satz vor: 'Bei Sonnenaufgang überprüfte das Forschungsteam jedes Signal zweimal, bevor es das Ergebnis bekannt gab.' Verwenden Sie eine warme, ruhige Erwachsenenstimme, ein natürliches Sprechtempo, klare Konsonanten und eine kurze Pause nach 'Sonnenaufgang'. Fügen Sie keine Musik, keine Soundeffekte, keine Einleitung und keine Wörter hinzu, die nicht im zitierten Satz enthalten sind.In unserem Test lieferte diese Eingabe eine MP3-Datei mit einer Länge von 21,263673 Sekunden und sprach die Wegbeschreibung laut vor. Das Testergebnis zeigte, dass der Wrapper die gesamte Eingabe als Sprechtext behandelte.
Bei Sonnenaufgang überprüfte das Forschungsteam jedes Signal zweimal, bevor es das Ergebnis bekanntgab.Wir haben den Test mit ausschließlich dem Zielsatz wiederholt. In unserem Test ergab sich eine MP3-Datei mit einer Länge von 6,086531 Sekunden, einer Samplingfrequenz von 22.050 Hz, einer Bitrate von 128 kbps und Mono-Ton. Sie entsprach Wort für Wort dem Zielsatz und enthielt keine zusätzlichen Anweisungen.
Der Nutzer hat sich beide Dateien angehört und die unten aufgeführten Bewertungen bestätigt. Hierbei handelt es sich um eine praktische Überprüfung durch einen einzelnen Hörer, nicht um eine MOS-Studie oder ein Hörpanel.
| Dimension „Zuhören“ | Befehlsgesteuerte Steuerung | Klartext-Steuerelement |
|---|---|---|
| Natürlichkeit | 4/5 | 5/5 |
| Verständlichkeit | 5/5 | 5/5 |
| Aussprache | 5/5 | 5/5 |
| Prosodie | 4/5 | 5/5 |
| Texttreue | 1/5 | 5/5 |
| Einhaltung der Stilrichtlinien | Nicht gewertet | 5/5 |
| Fehlen eines Artefakts | 5/5 | 5/5 |
| Benutzerfreundlichkeit in der Produktion | 1/5 | 5/5 |
Das Beispiel mit den Anweisungen klang klar und größtenteils natürlich, doch das Vorlesen der Anweisungen beeinträchtigte die Texttreue und die Praxistauglichkeit der Ausgabe. Das Beispiel im Klartext klang natürlich, folgte dem Satz genau und erforderte keine inhaltliche Bereinigung. Diese Bewertungen beziehen sich nur auf die beiden qwen-audio-3.0-tts-flash Wrapper-Steuerelemente; es handelt sich dabei nicht um eine Bewertung der Sprachqualität anhand des Qwen3-TTS-Checkpoints.
Gehen Sie niemals davon aus, dass Stilvorgaben und Erzähltext zum selben Bereich gehören. Unser Leitfaden zu Wie man von KI verfasste Reden menschlicher klingen lässt verbessert das Skript, aber die Endpunktfelder entscheiden darüber, ob die Befehle die Stimme steuern oder die Aufnahme starten.
Bei einer lokalen Überprüfung wurde eine NVIDIA GeForce MX450 mit 2 GB VRAM und etwa 16,9 GB Systemspeicher festgestellt. Dies ist keine geeignete Plattform für die geplante Matrix mit 0,6B gegen 1,7B. Die CPU-Entlastung könnte sich als Startwert erweisen und ist nicht repräsentativ für die tatsächliche Geschwindigkeit. Die Sprachqualität von Qwen3-TTS, die lokale RTF, die Ähnlichkeit bei der Klonung und die sprachübergreifende Konsistenz bleiben daher unbewertet.
Qwen3-TTS-Sprachqualität: Was die Fakten belegen
Der offizielle Bericht zeigt überzeugende Qwen3-TTS-Ergebnisse in den Bereichen Verständlichkeit, Sprecherähnlichkeit, Befolgung von Anweisungen, mehrsprachige Generierung, Langform-Sprache und Streaming. Diese Ergebnisse liefern nützliche Vergleichswerte, sind jedoch nach wie vor von Qwen gemeldete Referenzwerte und keine hier erstellten Aufnahmen.
Ein Sprachtest für Produktionszwecke sollte folgende Aspekte abdecken: Aussprache, Störgeräusche, Sprechtempo, Emotionalität, Wiederholbarkeit, Bearbeitungsaufwand, Abkürzungen, Datumsangaben, Währungen, URLs, Namen, Sprachwechsel und lange Sätze.
Kombinieren Sie das Anhören mit Transkripten und Metadaten; die ChatGPT-Workflow für die Audio-Transkription sorgt dafür, dass die Textprüfung wiederholbar ist.
Das Qwen3-TTS sieht vielversprechend aus, doch dieser Testbericht enthält keine Checkpoint-Ergebnisse aus erster Hand. Testen Sie das Gerät vor dem Versand mit verschiedenen Gerätegenerationen, den mitgelieferten Kopfhörern sowie den Lautsprechern des Telefons.
Worauf externe Rezensenten den Schwerpunkt legten
Die Social-Media-Demo von Qwen hebt verschiedene Klangfarben, Sprachen und Dialekte hervor. Der unabhängige Entwickler Bijan Bowen legte den Schwerpunkt auf die lokale Umsetzung und das Klonen von Stimmen; Jeff Geerling bezeichnete die Veröffentlichung als starke Open-Source-Konkurrenz für verwaltete TTS-Plattformen. Hierbei handelt es sich um die Sichtweisen der Rezensenten, nicht um Benchmark-Ergebnisse oder den Nachweis eines marktweiten Konsenses.
Qwen3-TTS: Geschwindigkeit und Latenz
Latenz des ersten Pakets
0.288 / 0.313
0,6 Mrd. / 1,7 Mrd. bei einer Parallelität von 1.
Optimierte interne vLLM-Umgebung – keine Garantie für die Nutzung auf einem Laptop.
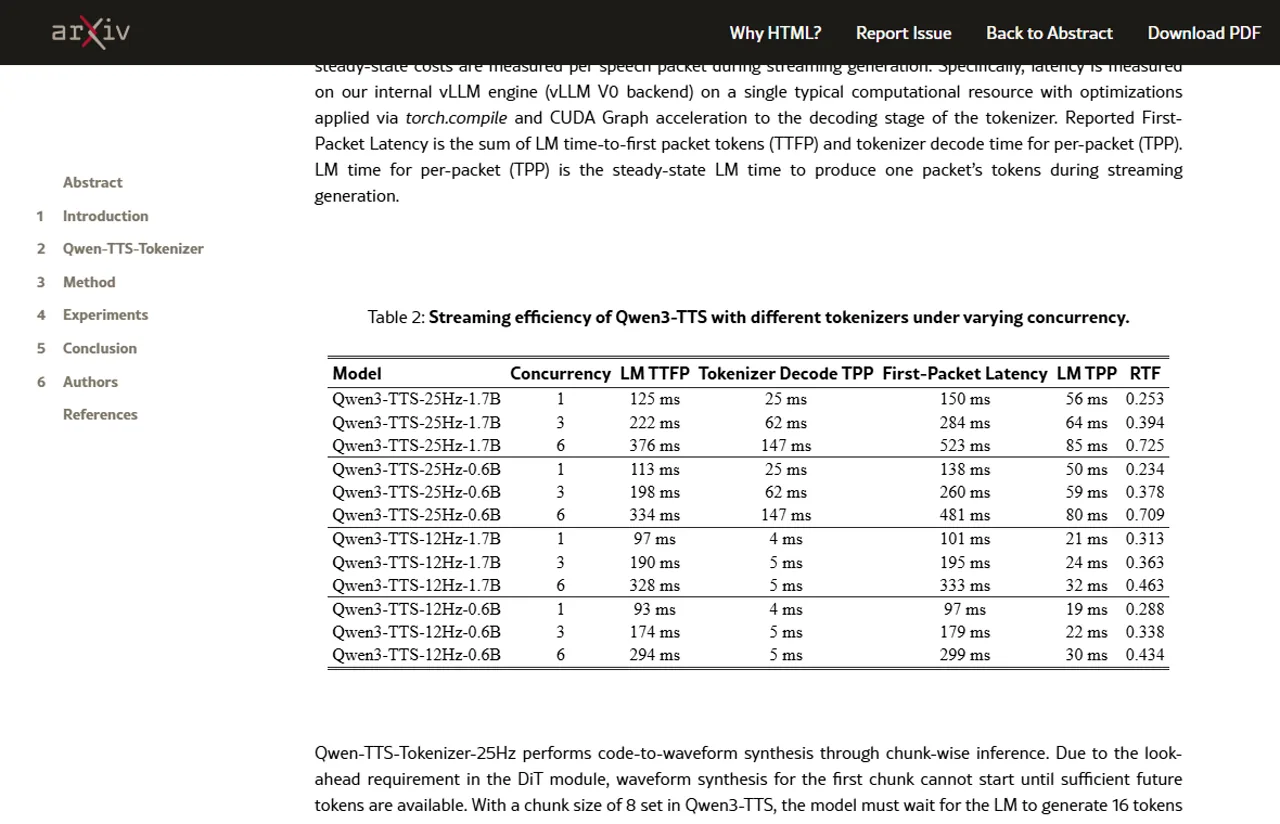
Der angegebene Geschwindigkeitswert beträgt 97 ms Latenzzeit bis zum ersten Paket für das 0,6B-12-Hz-Modell. In derselben Tabelle des technischen Berichts sind für das 1,7B-12-Hz-Modell bei einer Parallelität von 1 101 ms angegeben. Die angegebenen Echtzeitfaktoren (RTF) betrugen 0,288 bzw. 0,313. Einfach ausgedrückt bedeutet ein RTF unter 1, dass die Synthese in dieser Umgebung schneller ablief als die Dauer des generierten Audiosignals.
Diese Ergebnisse stammen aus der optimierten internen vLLM-Konfiguration von Qwen. Es handelt sich dabei nicht um allgemeine Angaben zur „Time-to-First-Audio“ für einen Windows-Laptop, einen kaltgestarteten serverlosen Container oder eine gemeinsam genutzte API-Region. Der Bericht zeigt außerdem, dass die Parallelität die Latenz beeinflusst. Das Laden des Modells, die Verarbeitung des Referenzaudios, die Netzwerkübertragung, die Warteschlangen, die Audio-Paketierung und die Wiedergabe auf dem Client können alle außerhalb der Anzahl der Kern-Decoder liegen.
Ein aussagekräftiger Benchmark-Bericht sollte Folgendes enthalten:
- Hardware, Präzision, Modellüberarbeitung und Backend-Betreuung.
- Kalt- oder Warmzustand, Parallelität, Zeitpunkt des ersten Audiosignals, Gesamtdauer, maximale VRAM-Auslastung, Ausgabedauer und RTF.
- Für eine API: Region, Verbindungstyp, Anforderungs-ID, Warteschlange und Wiederholungsversuche.
Das 0,6B-Modell dürfte die sicherere Wahl sein, wenn Speicher und Parallelität wichtiger sind als die maximale Kapazität. Das 1,7B-Modell ist die sinnvollere Wahl in puncto Qualität, wenn die Maschine über ausreichende Leistungsreserven verfügt. Ohne Verwendung derselben Eingabeaufforderung, desselben Sprechers, derselben Sampling-Einstellungen und desselben Warmzustands lässt sich der tatsächliche Latenzunterschied jedoch nicht allein anhand der Modellgröße bestimmen.
Qwen3-TTS – Sprachen und Aussprache
Die offenen Qwen3-TTS-Checkpoints unterstützen zehn Sprachen: Chinesisch, Englisch, Japanisch, Koreanisch, Deutsch, Französisch, Russisch, Portugiesisch, Spanisch und Italienisch. Diese Liste stammt aus dem aktuellen Repository und den veröffentlichten Modellmaterialien. Fügen Sie Thai, Indonesisch, Malaiisch oder Vietnamesisch nicht einfach stillschweigend hinzu, nur weil ein anderes Qwen-Audioprodukt diese Sprachen unterstützt.
| Sprache | Offizielle Unterstützung für Open-Source-Projekte | Priorität der Produktionsüberprüfung |
|---|---|---|
| Chinesisch | Ja | Töne, Namen, Zahlenaussprache, regionaler Schreibstil |
| Englisch | Ja | Stress, Abkürzungen, Markennamen, lange Sätze |
| Japanisch | Ja | Tonhöhenakzent, Partikel, Namen, gemischter lateinischer Text |
| Koreanisch | Ja | Zeilenabstände, Lehnwörter, Satzenden |
| Deutsch | Ja | Zusammengesetzte Wörter, Zahlen, Konsonantengruppen |
| Französisch | Ja | Verbindungen, Abkürzungen, entlehnte Namen |
| Russisch | Ja | Betonung, Substantive, Zahlen, lateinische Einfügungen |
| Portugiesisch | Ja | Bitte geben Sie den gewünschten regionalen Akzent und die Schreibweise an |
| Spanisch | Ja | Regionalen Akzent und Eigennamen überprüfen |
| Italienisch | Ja | Betonung, Gemination, fremdsprachige Namen |
“Unterstützt” bedeutet, dass das Modell die Sprache synthetisieren kann; es bedeutet jedoch nicht, dass jede Stimme in jeder Region gleichermaßen muttersprachlich klingt. Allein im Portugiesischen und Spanischen gibt es wichtige regionale Unterschiede. Bei einer kommerziellen Einführung sollte die Zielregion festgelegt, muttersprachliche Prüfer hinzugezogen und ein Regressionsdatensatz für die Aussprache von Namen, Maßeinheiten, Adressen und juristischen Formulierungen erstellt werden.
Der Sprachwechsel erfordert einen eigenen Test. Ein Satz wie “Öffnen Sie die Qwen3-TTS-API in São Paulo um 9:30 Uhr” vereint einen englischen Satzrahmen, einen Modellnamen, portugiesische Aussprache, Zeichensetzung und eine Uhrzeit. Das kommt echten App-Texten viel näher als ein sauberer, einsprachiger Demosatz. Bei der Videovertonung muss die Aussprache zudem zum Timing passen; unsere Veo 3.1 Arbeitsablauf für Dialoge, Audio und Lippensynchronisation behandelt das damit verbundene Synchronisationsproblem.
Stimmklonung, CustomVoice und VoiceDesign
Die „Base“-Checkpoints ermöglichen ein schnelles Klonen von Stimmen anhand von etwa drei Sekunden Referenzaudio. Das ist eine beeindruckende Mindestanforderung, jedoch kein Versprechen, dass drei Sekunden immer die optimale Länge für ein Produktionsbeispiel sind. Bei kurzen Referenzaufnahmen können Tonumfang, Sprechtempo, Vokalabdeckung, Emotionalität und Mikrofonkonsistenz zu kurz kommen.
Die Anleitung zur Registrierung bei Alibaba Cloud ist konservativer: Sie verlangt mindestens drei Sekunden ununterbrochene, klare Sprache, lässt längere Sprachproben zu und empfiehlt für das praktische Klonen eine klarere, längere Aufnahme. Befolgen Sie die aktuellen Dokumentation zur Stimmklonung für Regeln bezüglich Format, Abtastrate, Kanal, Dauer und Region, anstatt die dreisekündige Demonstration in der Veröffentlichung als Upload-Spezifikation zu betrachten.
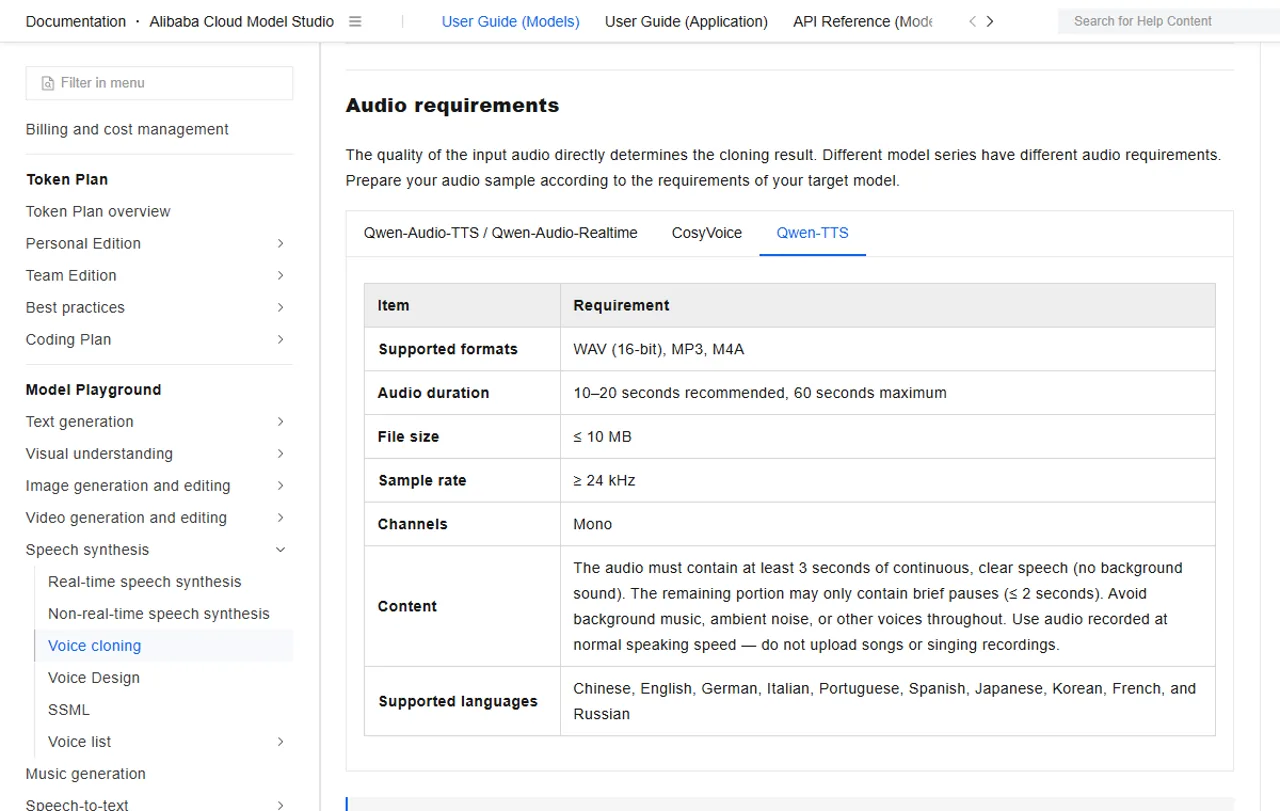
CustomVoice vermeidet es, eine reale Person nachzubilden. Die Open-Version umfasst neun Premium-Stimmen für verschiedene Sprachen oder Stile, was sie besonders attraktiv macht, wenn eine voreingestellte Identität und die Steuerung von Anweisungen ausreichen.
VoiceDesign erzeugt anhand einer Beschreibung in natürlicher Sprache eine Klangfarbe. Der gehostete Dokumentation zu Voice Design zeigt den separaten Erstellungsablauf. Er eignet sich für fiktive Figuren und synthetische Markenstimmen, doch die Beschreibungen müssen dennoch hinsichtlich des wahrgenommenen Alters, des Akzents und kultureller Vorurteile getestet werden.
Risikomatrix zur Stimmidentität
Halten Sie den Redner, den Umfang, die Laufzeit und den Ausstiegsweg fest.
Verschlüsseln Sie Verweise und löschen Sie abgeleitete Stimmen zusammen mit der Quelle.
Schädliche Identitätsbehauptungen blockieren und eine Meldefunktion hinzufügen.
Kennzeichnen Sie synthetische Sprache, wenn Zuhörer sie möglicherweise mit einer echten Person verwechseln könnten.
Das Klonen erfordert ausdrückliche Rechte und eine Einwilligung nach Aufklärung. Bewahren Sie die ursprüngliche Einwilligungserklärung auf, legen Sie die zulässigen Verwendungszwecke fest, verhindern Sie eine nachgelagerte erneute Registrierung und richten Sie ein Löschverfahren ein. Die Risiken sind nicht nur theoretischer Natur; die Analyse zum Datenschutz und zur Einwilligung bei der Gesichtserkennung und Spracherkennung erläutert, warum Maßnahmen zum Schutz der Identität, biometrische Daten und Vorkehrungen gegen Identitätsbetrug Teil des Produktdesigns sein sollten und nicht nur in einer Fußnote erwähnt werden dürfen.
Qwen3-TTS 0,6B vs. 1,7B: Welche Variante sollten Sie verwenden?
Wählen Sie 0,6B, wenn Ihr Hauptkriterium die Bereitstellung ist. Diese Größe eignet sich besser für kleinere GPUs, höhere Parallelität, schnellere Experimente und kostensensitives Self-Hosting. Sowohl „Base“ als auch „CustomVoice“ sind in dieser Größe verfügbar, sodass Sie das Klonen oder voreingestellte Sprecher testen können, ohne mit dem größten Checkpoint beginnen zu müssen.
Entscheiden Sie sich für 1,7B, wenn Ihnen Qualitätsreserven und Funktionsumfang wichtiger sind. Dies ist die einzige veröffentlichte Größe mit VoiceDesign und die sinnvollere Wahl für Teams, die bereit sind, Speicherplatz und Durchsatz zugunsten der Kapazität einzubüßen. Die Zahlen zur Parallelität-1 im technischen Bericht zeigen bei der optimierten Konfiguration von Qwen einen geringen Unterschied bei der Erstpaketübertragung und der RTF, doch Ihre eigene Hardware kann diesen Abstand vergrößern oder verringern.
| Entscheidungsfaktor | Beginnen Sie mit 0,6 B | Beginnen Sie mit 1,7 Mrd. |
|---|---|---|
| Der GPU-Speicher ist knapp | Bessere Passform | Erhöhtes Risiko einer Entlastung oder geringer Parallelität |
| Ich brauche VoiceDesign | Nicht im veröffentlichten Set enthalten | Erforderlich |
| Klonierung der Need-Basis | Verfügbar | Mit größerer Kapazität erhältlich |
| Ich brauche CustomVoice | Verfügbar | Mit größerer Kapazität erhältlich |
| Ich brauche einen schnellen Machbarkeitstest | Der beste Ausgangspunkt | Nutzung nach Abschluss der Arbeiten an der Pipeline |
| Endgültige Produktionsentscheidung erforderlich | Beide vergleichen | Beide vergleichen |
Die Anzahl der Parameter sagt nichts über den VRAM-Bedarf aus. Präzision, die Umsetzung der Aufmerksamkeit, der Cache, die Referenzlänge, die Batchgröße und der Framework-Overhead spielen ebenfalls eine Rolle. Ein Modell, das sich kaum laden lässt, ist kein zuverlässiger Produktionsdienst.
Für die im Rahmen dieses Tests untersuchte 2-GB-MX450 bietet keine der beiden Größen einen repräsentativen GPU-Benchmark-Pfad. Ein neuerer CUDA-Stack und eine geeignete GPU oder ein offizieller gehosteter Endpunkt sind der nächste praktische Schritt. “Es lief mit CPU-Offload” wäre eher ein Hinweis auf die Kompatibilität als ein aussagekräftiges Urteil zur Geschwindigkeit.
Qwen3-TTS-API: HTTP, Streaming und Modell-IDs
Wählen Sie die Transportart entsprechend den Anforderungen der Wiedergabe aus
Der einfachste Weg für die Stapel-Einlesung und vollständige Dateien.
Schrittweise Bereitstellung; bitte prüfen Sie dennoch, wann die Audiodatei abgespielt werden kann.
Ideal für Gespräche und die fortlaufende Wiedergabe.
Alibaba Cloud bietet sowohl Nicht-Echtzeit-HTTP-Generierung als auch Echtzeit-WebSocket-Modelle an. Verwenden Sie die Nicht-Echtzeit-Synthese, wenn Sie auf ein vollständiges Ergebnis warten können und den einfachsten Anforderungsablauf wünschen. Verwenden Sie WebSocket-Streaming, wenn es auf die Latenz bei der Kommunikation oder auf eine progressive Wiedergabe ankommt. HTTP-Streaming oder „Server-Sent Events“ können inkrementelle Daten zurückgeben, sollten jedoch nicht mit der speziellen Modellfamilie für Echtzeitanwendungen mit geringer Latenz verwechselt werden.
Zu den derzeit verfügbaren Familien gehören Qwen3-TTS Flash für integrierte Stimmen, Instruct Flash für die Steuerung der Wiedergabe in natürlicher Sprache, VC für geklonte Stimmen und VD für eigens entwickelte Stimmen. Modell-IDs und datierte Snapshots unterscheiden sich zwischen Nicht-Echtzeit- und Echtzeit-Routen; kopieren Sie diese daher aus der aktuellen Dokumentation, anstatt Namen analog abzuleiten.
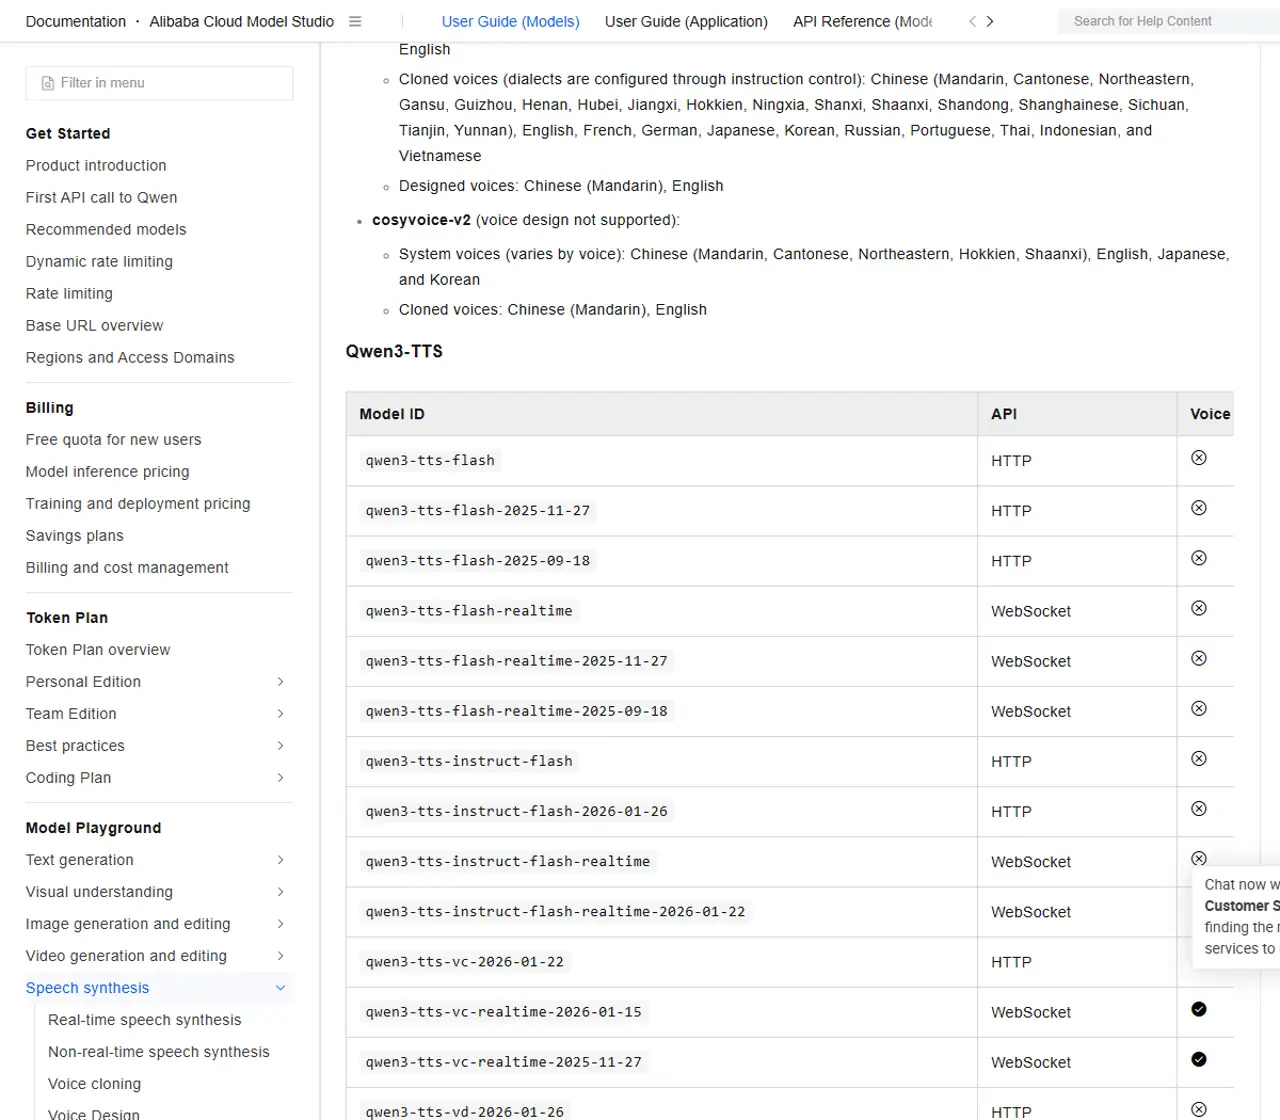
Der aktuelle Qwen-TTS API-Dokumentation begrenzt die Eingabe auf 512 Tokens pro Anfrage. Dies ist die für diese Produktfamilie relevante Begrenzung; eine separate, für andere TTS-Modelle dokumentierte Regel mit 600 Zeichen sollte nicht in eine Qwen3-TTS-Integration übernommen werden. Complete-Audio-URLs bleiben 24 Stunden lang gültig, daher sollten Produktionssysteme die benötigten Dateien auf einen dauerhaften Speicher verschieben, anstatt die Antwort-URL als permanenten Speicherort zu verwenden.
import os
import dashscope

dashscope.base_http_api_url = "https://dashscope-intl.aliyuncs.com/api/v1"

response = dashscope.MultiModalConversation.call(
    model="qwen3-tts-flash",
    api_key=os.environ["DASHSCOPE_API_KEY"],
    text="Ihre Bestellung steht um 16:30 Uhr zur Abholung bereit.",
    voice="Cherry",
    language_type="English",
)

print(response)
Der API-Schlüssel und die Endpunkt-Region müssen übereinstimmen. Bei Bereitstellungen in Peking und Singapur kommen unterschiedliche Anmeldedaten und Basis-URLs zum Einsatz, während die Verfügbarkeit der Modelle je nach Region variieren kann. Betten Sie den Schlüssel niemals in WordPress, clientseitiges JavaScript oder eine mobile Binärdatei ein. Senden Sie Syntheseanfragen über einen Server, den Sie kontrollieren, protokollieren Sie Anforderungs-IDs, ohne sensible Eingaben zu protokollieren, und legen Sie eine Lebenszyklusrichtlinie für generierte Audiodaten fest.
Bei langen Dokumenten sollten Sie an semantischen Grenzen unterteilen, den Kontext beibehalten, Zahlen normalisieren und bei jeder Verknüpfung genau hinhören. Gültige Ausschnitte können sich dennoch wie separate Aufnahmen anhören, wenn sich das Tempo oder die Energie zwischen den Anrufen ändert.
Preise für Qwen3-TTS im internationalen Raum
Überblick über die Preisgestaltung in den verschiedenen Regionen weltweit
Blitzlicht
$0.10
pro 10.000 EingabezeichenAnweisung / VC / VD
$0.115
pro 10.000 EingabezeichenFlash / VC
$0.13
pro 10.000 EingabezeichenAnweisen
$0.143
pro 10.000 EingabezeichenVD
$0.143353
pro 10.000 EingabezeichenStimmgestaltung: $0.01 pro Anmeldung · $0.20 pro konzipierter Stimme.
Alibaba Clouds Preisseite von Model Studio Bei der Überprüfung am 11. August 2026 wurden die folgenden Preise für internationale Regionen angezeigt. Für diese Zeilen werden Eingabezeichen in Rechnung gestellt, während die Ausgabe kostenlos ist. Preise, kostenlose Kontingente, Aliase und die regionale Verfügbarkeit können sich ändern. Überprüfen Sie daher die ausgewählte Bereitstellung vor der Ausführung eines großen Stapels.
| Route | Modellfamilie | Preis pro 10.000 eingegebene Zeichen |
|---|---|---|
| Nicht in Echtzeit | Qwen3-TTS Flash | $0.10 |
| Nicht in Echtzeit | Instruct, VC oder VD | $0.115 |
| Echtzeit | Flash oder aktuelles VC | $0.13 |
| Echtzeit | Anweisen | $0.143 |
| Echtzeit | VD | $0.143353 |
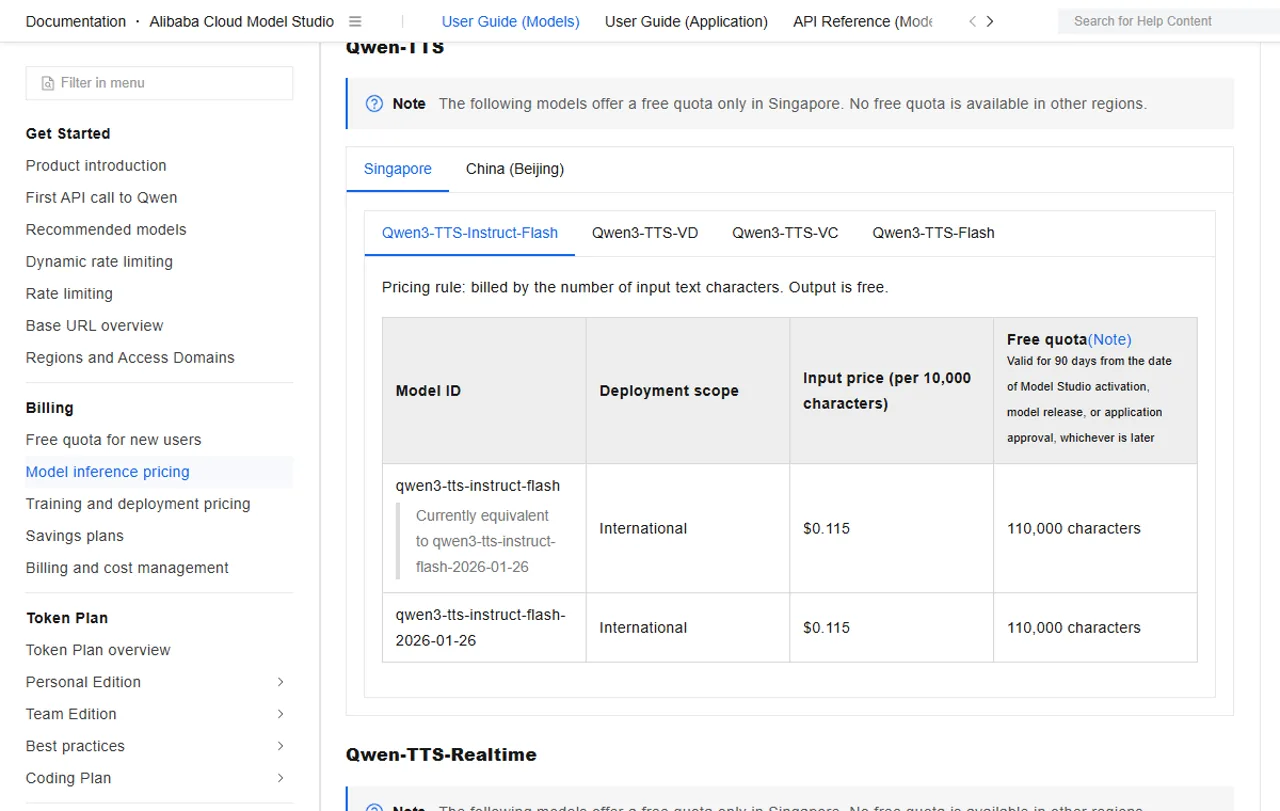
Die Stimmerstellung wird getrennt von der Synthese abgerechnet. In derselben internationalen Preisliste ist die Stimmregistrierung „Qwen“ mit $0,01 pro Klon und das Stimmdesign mit $0,20 pro entworfener Stimme aufgeführt. Für eine geklonte oder entworfene Stimme können bei ihrer Verwendung die entsprechenden Synthesegebühren pro Zeichen anfallen.
Kosten für die Stimmgestaltung, die Synthese von Charakteren, die Infrastruktur und die Neugenerierung sollten separat veranschlagt werden. Die Bearbeitungszeit und die Anzahl der Wiederholungsaufnahmen bestimmen oft die tatsächlichen Produktionskosten.
Die API-Preise entsprechen nicht den lokalen Kosten. Offene Checkpoints machen die Abrechnung nach Zeichen durch den Anbieter überflüssig, verursachen jedoch zusätzliche Kosten für GPU-Zeit, Bereitstellung, Überwachung, Speicherung, Skalierung und die Reaktion auf Störungen. Ein eigener Betrieb ist dann vorteilhaft, wenn Kontrolle, Umfang, Datenlokalität oder Anpassungsmöglichkeiten diesen betrieblichen Aufwand rechtfertigen.
Alternativen und der GlobalGPT-Audio-Pfad
Qwen3-TTS ist nicht automatisch die beste Option für jeden Audioauftrag. ElevenLabs ist eine ausgereiftere, verwaltete Sprachplattform für Teams, die Wert auf ein ausgefeiltes Dashboard, umfangreiche Produktionswerkzeuge und einen geringeren Infrastrukturaufwand legen. Die Sprachmodelle von OpenAI eignen sich möglicherweise für Entwickler, die bereits auf ein API-Ökosystem standardisieren. Qwen-Audio 3.0 TTS ist die neuere gehostete Qwen-Lösung, die man in Betracht ziehen sollte, wenn man den aktuellen Empfehlungen von Alibaba Cloud folgt.
Musik und Soundeffekte gehören in einen anderen Vergleich. Die ElevenLabs, Lyria 3 Pro und Mureka im Klangvergleich Dies hilft dabei, Sprachausgabe-Tools von der vollständigen Musikgenerierung abzugrenzen. Ein Text-to-Speech-Modell sollte keine Punkte einbüßen, weil es keinen fertig produzierten Song erzeugen kann, und ein Musikmodell sollte nicht als API für Sprachausgabe mit geringer Latenz ausgewählt werden.
GlobalGPT verfügt derzeit über eine verifizierte Audio-Generator-Route in der aufgeführt ist qwen-audio-3.0-tts-flash und Seed Audio 1.0. Auf der überprüften Seite war Qwen3-TTS nicht aufgeführt. Damit ist GlobalGPT praktisch ein eigenständiger Audio-Arbeitsbereich, was jedoch kein Hinweis darauf ist, dass die offenen Qwen3-TTS-Checkpoints dort verfügbar sind.
Wenn es sich bei Ihrem Endprodukt um ein Video handelt, entscheiden Sie, ob Sie einen separaten Sprecher, generierte Dialoge, Soundeffekte oder ein Modell benötigen, das den Ton passend zum Bildmaterial erzeugt. Unsere Antwort auf Ob Veo 3.1 über Ton verfügt Diese Entscheidung lässt sich weiter aufschlüsseln. Der klügste Ansatz besteht oft darin, auf eine kleine Auswahl spezialisierter Tools zurückzugreifen, anstatt ein einziges Modell zu zwingen, alle Audioaufgaben zu übernehmen.
Lizenz, Einwilligung, Datenschutz und kommerzielle Nutzung
Das Repository „Qwen3-TTS“ und die veröffentlichten Modellkarten unterliegen der Apache-2.0-Lizenz. Diese Lizenz ist für die kommerzielle Entwicklung, Änderung und Verbreitung geeignet, gewährt jedoch keine Rechte an der Stimme, der Darbietung, dem Skript, der Marke oder den personenbezogenen Daten Dritter. Die Modelllizenz und die Rechte an den Inhalten sind voneinander getrennte Ebenen.
Durch lokale Auswertung erhalten Sie mehr Kontrolle und tragen mehr Verantwortung für die Sicherheit. Verschlüsseln Sie Referenzaufzeichnungen, beschränken Sie den Zugriff, minimieren Sie die Aufbewahrungsdauer, dokumentieren Sie Ableitungen und leiten Sie die Löschung auf registrierte Stimmen und zwischengespeicherte Ausgaben weiter.
Prüfen Sie bei gehosteten Synthese-Diensten die Nutzungsbedingungen, die regionale Datenverarbeitung, die Aufbewahrungsfristen und die unternehmensinternen Kontrollmechanismen, bevor Sie vertrauliche Skripte oder Sprachproben übermitteln.
Jede öffentlich zugängliche geklonte Stimme sollte einen Eigentümer, eine Einwilligungserklärung, Richtlinien zur zulässigen Nutzung sowie Maßnahmen zur Reaktion auf Missbrauch aufweisen. Es sollte ein Hinweis hinzugefügt werden, wenn eine synthetische Stimme vernünftigerweise mit einer realen Person verwechselt werden könnte. Die Nachahmung von Privatpersonen und besonders gefährdeten Persönlichkeiten des öffentlichen Lebens sollte unterbunden werden, und es sollte eine Möglichkeit zur Meldung schädlicher Audioinhalte bereitgestellt werden.
Für wen ist Qwen3-TTS geeignet?
Welche Route passt?
Pipeline-Prüfung, strengerer Speicher, „Base“ oder „CustomVoice“.
VoiceDesign oder Vergleich von Qualität und Kapazität unter Berücksichtigung der GPU-Reserven.
Schnellere Abläufe, wenn Region, Datenschutz und Preisgestaltung passen.
Studio ohne Einrichtungsaufwand, lizenzierter Marktplatz oder Unterstützung durch bestehende Anbieter.
Qwen3-TTS eignet sich für Forscher, Entwickler, Spieleteams und Lokalisierungsgruppen, die offene Gewichte, Wahlmöglichkeiten bei der Bereitstellung, Klonen oder durch Text beschriebene Charakterstimmen benötigen.
Beginnen Sie mit 0,6B, wenn Sie die Pipeline testen, begrenzte Speicherressourcen verwalten oder prüfen möchten, ob „Base“ und „CustomVoice“ den Produktanforderungen entsprechen. Beginnen Sie mit 1,7B, wenn Sie VoiceDesign benötigen oder über ausreichend Hardware verfügen, um Qualität und Durchsatz angemessen zu vergleichen. Nutzen Sie die gehostete API, wenn die Infrastruktur den Engpass darstellt und regionale Verfügbarkeit, Anmeldedaten sowie der Umgang mit Daten zu Ihrem Projekt passen.
Wählen Sie eine andere Lösung, wenn Sie ein Bearbeitungsstudio ohne Einrichtungsaufwand, einen großen Marktplatz für lizenzierte Stimmen oder bestehenden Unternehmenssupport von einem anderen Anbieter benötigen. Klonen Sie niemals ohne dokumentierte Zustimmung.
Verwenden Sie fünf echte Skripte, drei Wiederholungen, eine Liste mit schwer auszusprechenden Namen, einen langen Absatz und einen Wiederherstellungstest. Messen Sie Latenz und Aufwand und fragen Sie anschließend muttersprachliche Hörer, ob das Ergebnis ohne Nachbesserung akzeptabel ist. Nachbearbeitungen können einen Sieg im Benchmark zunichte machen.
Qwen3-TTS – Häufig gestellte Fragen
Ist Qwen3-TTS kostenlos?
Die veröffentlichten Qwen3-TTS-Checkpoints stehen unter der Apache-2.0-Lizenz zur Verfügung, sodass Sie sie ohne eine pro Zeichen berechnete Modellgebühr herunterladen und ausführen können. Das eigene Hosting verursacht jedoch weiterhin Kosten für Rechenleistung, Speicherplatz, Entwicklung und Überwachung. Die von Alibaba Cloud gehosteten Qwen3-TTS-APIs sind kostenpflichtige Dienste mit regionsspezifischen Preisen und Kontingenten.
Kann Qwen3-TTS kommerziell genutzt werden?
Die Apache-2.0-Lizenz erlaubt die kommerzielle Nutzung des veröffentlichten Codes und der Modellgewichte, gewährt Ihnen jedoch kein Recht, die Stimme einer Person zu klonen oder geschützte Skripte und Marken zu verwenden. Für kommerzielle Projekte sind weiterhin die Zustimmung der Sprecher, die Rechte an den Inhalten, Datenschutzmaßnahmen sowie die Einhaltung der lokalen Gesetze und der Plattformbedingungen erforderlich.
Welche Sprachen unterstützt Qwen3-TTS?
Die offene Version Qwen3-TTS unterstützt Chinesisch, Englisch, Japanisch, Koreanisch, Deutsch, Französisch, Russisch, Portugiesisch, Spanisch und Italienisch. Der Sprachumfang der gehosteten Modelle kann je nach Endpunkt und Stimme variieren. Überprüfen Sie daher die genaue Alibaba Cloud-Modell-ID und die Region, bevor Sie ein mehrsprachiges Produkt entwickeln.
Ist der Qwen3-TTS wirklich in der Lage, eine Latenz von 97 ms zu erreichen?
Qwen meldete in einer optimierten internen vLLM-Umgebung eine Latenz bis zum ersten Paket von 97 ms für das Modell 0,6B 12 Hz bei einer Parallelität von 1. Dabei handelt es sich um einen gültigen Hersteller-Benchmark, nicht um eine allgemeingültige Geräteangabe. Kaltstarts, Hardware, Genauigkeit, Netzwerkdurchlauf, Warteschlangen und Client-Pufferung können die beobachtete Latenz erhöhen.
Wie viel VRAM benötigt das Modell Qwen3-TTS?
Es gibt keinen einheitlichen, verlässlichen VRAM-Wert, der für jede Konfiguration gilt. Modellgröße, Genauigkeit, Attention-Backend, Batchgröße, Cache, Referenzlänge und Framework-Overhead spielen alle eine Rolle. Die getestete MX450 mit 2 GB war für repräsentative Benchmark-Tests nicht geeignet; testen Sie den ausgewählten Checkpoint mit produktionsähnlicher Parallelität und lassen Sie dabei einen operativen Spielraum.
Wie viel Audiomaterial wird für das Klonen von Stimmen mit Qwen3-TTS benötigt?
Die Beispielmaterialien zeigen eine schnelle Klonung ab etwa drei Sekunden, während die Anleitungen zur Registrierung auf der Plattform klare, zusammenhängende Sprache bevorzugen und längere Sprachproben zulassen. Betrachten Sie drei Sekunden als Mindestanforderung und nicht als automatisches Qualitätsziel. Verwenden Sie einhörige, rauschfreie Audioaufnahmen, die den normalen Stimmumfang des Sprechers und die beabsichtigte Sprache abdecken.
Wie hoch ist das Eingabelimits der Qwen3-TTS-API?
Die aktuelle Qwen-TTS-API-Dokumentation gibt eine maximale Eingabe von 512 Tokens für Qwen-TTS-Modelle an. Complete-Audio-URLs sind 24 Stunden lang gültig. Teilen Sie lange Skripte an semantischen Grenzen in Abschnitte auf und kopieren Sie die benötigten Ausgaben in einen dauerhaften Speicher, anstatt die zurückgegebene URL als dauerhaften Speicherort zu betrachten.
Kann ich Qwen3-TTS auf GlobalGPT verwenden?
Der aufgeführte Audio-Generator GlobalGPT mit Karomuster qwen-audio-3.0-tts-flash und Seed Audio 1.0, nicht Qwen3-TTS. Sie können diesen Weg als separaten Audio-Workflow nutzen, er sollte jedoch nicht als Zugriff auf die offenen Checkpoints 0.6B oder 1.7B von Qwen3-TTS beschrieben werden.
Endgültiges Urteil
Dieser Testbericht zum Qwen3-TTS besticht durch seine außergewöhnliche Bandbreite: offene Checkpoints mit 0,6B und 1,7B, zehn Sprachen, voreingestellte Stimmen, schnelles Klonen, VoiceDesign, Streaming-Architektur, eine großzügige Lizenz und gehostete APIs.
Ebenso wichtig ist die ehrliche Einschränkung: In der verfügbaren Testumgebung wurde kein echtes Qwen3-TTS-Audio generiert, und die getestete 2-GB-GPU konnte keinen repräsentativen lokalen Vergleich unterstützen. Aus diesem Grund wird in diesem Artikel weder eine Bewertung der Sprachqualität vergeben noch eine allgemeine Leistung von 97 ms behauptet.
Wenn Sie Wert auf offene Gewichte und Kontrolle legen, testen Sie zunächst den 0,6B-Checkpoint und vergleichen Sie ihn anschließend mit dem 1,7B-Checkpoint anhand derselben Skripte und derselben Hardware. Wenn Ihnen eine schnelle Produktionsbereitstellung wichtig ist, testen Sie genau die Alibaba Cloud-Lösung, die Sie erwerben möchten, und vergleichen Sie diese mit der separat positionierten Qwen-Audio 3.0 TTS-Produktfamilie. Tragen Sie den Modellnamen, den Endpunkt, die Region, die Einwilligungsdaten, die Latenz und die Gesamtbearbeitungskosten in dasselbe Entscheidungsblatt ein.
Qwen3-TTS ist einen Test wert. Man sollte nicht so tun, als könne die Dokumentation allein für einen sprechen. Der erfolgreiche Weg ist der, der Ihre Namen, Ihre Sprache, Ihre Hardware, Ihre Datenschutzanforderungen und Ihre Produktionsfristen übersteht.