
PERPLEXITY-API · PYTHON-ANLEITUNG · 2026
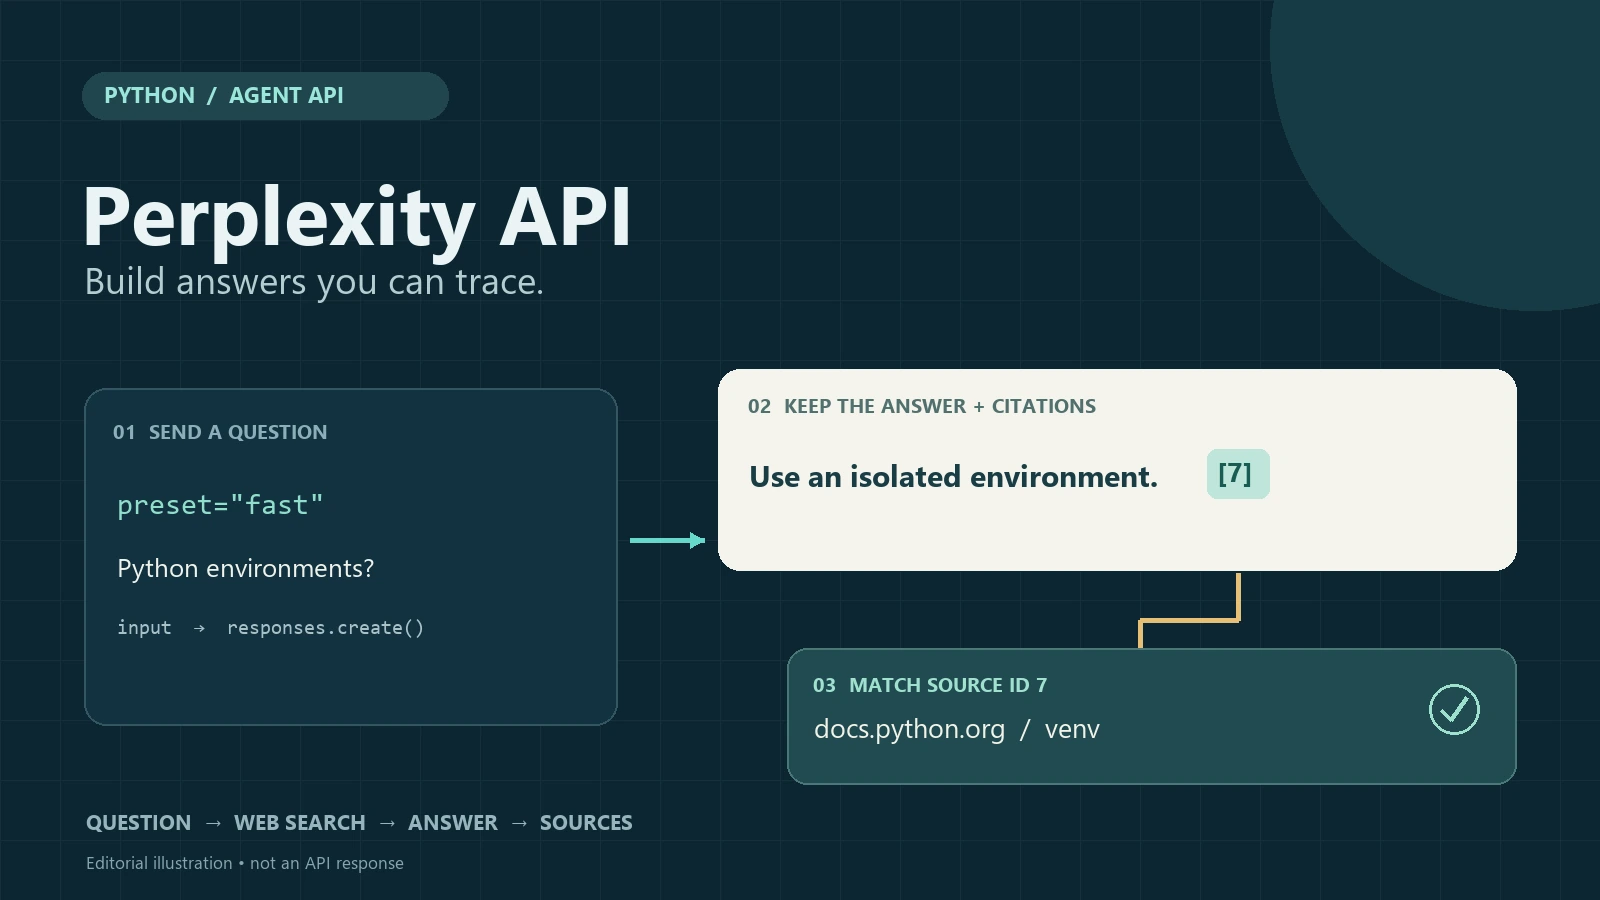
Dieses Tutorial zur Perplexity-API zeigt Ihnen, wie Sie ein Python-Skript erstellen, das eine Antwort mit anklickbaren Webquellen zurückgibt. Verwenden Sie die Agent-API, um eine Frage zu senden, die Antwort auszulesen, deren Zitiermarkierungen den Quellen-IDs zuzuordnen und eine Markdown-Datei zu exportieren, die Sie überprüfen können.
Wir werden uns dabei durchgehend auf eine Frage konzentrieren: Wie sollte ein kleines Python-Projekt virtuelle Umgebungen nutzen und Abhängigkeiten verwalten? Beginnen Sie mit einer einfachen Anfrage und fügen Sie anschließend die Quelldatenanalyse und Domänenfilter hinzu. Sie benötigen grundlegende Python-Kenntnisse sowie ein Perplexity-Entwicklerkonto mit aktivierter API-Abrechnung.
Wenn auch Sie KI für Ihre tägliche Recherche und beim Schreiben nutzen, Perplexity auf GlobalGPT bietet Zugriff innerhalb einer All-in-One-KI-Arbeitsumgebung, wodurch das Wechseln zwischen verschiedenen Tools entfällt. Dieser Workflow für Endnutzer ist unabhängig von dem hier verwendeten Entwickler-Schlüssel und der API-Abrechnung.
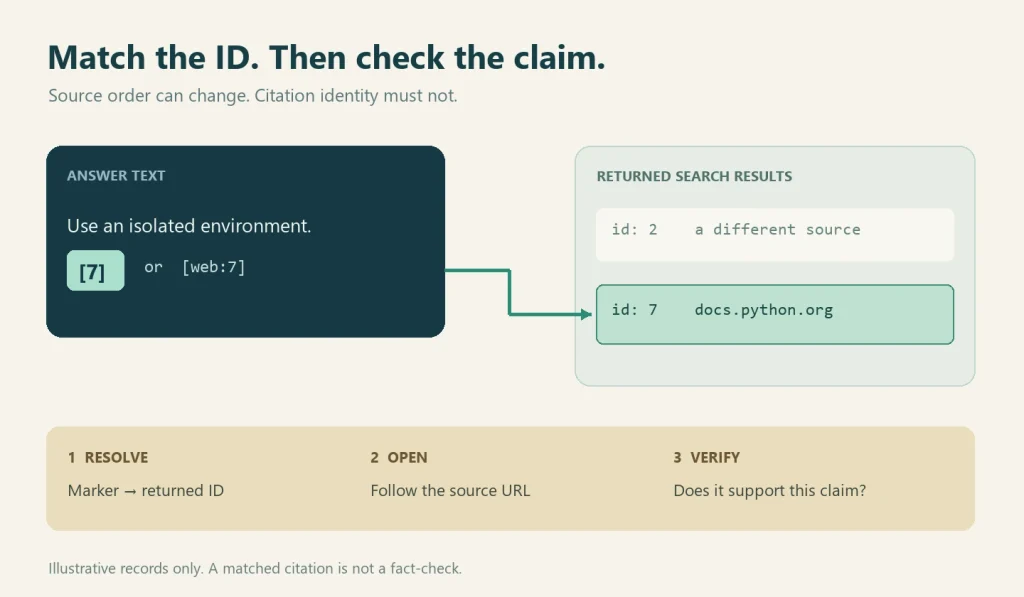
Kurze Antwort: Verwenden Sie die schnell Agent-Voreinstellung für eine erste, auf der Web-Basis basierende Antwort, lesen response.output_text für die Antwort und lies den Suchergebnisse Eintrag in response.output für Quellen. Ordne jede Inline-Markierung anhand des zurückgegebenen Werts einer Quelle zu id. Ein Verweis bedeutet, dass “die Antwort auf dieses Ergebnis hinweist”; er garantiert nicht, dass die Seite jede Behauptung belegt.
Beispielstatus: Die Syntax der Anfrage entspricht der offiziellen Dokumentation, die am 28. September 2026 überprüft wurde. Der Zitierassistent wurde anhand von Offline-Beispieldaten getestet; für dieses Tutorial wurde keine kostenpflichtige API-Anfrage ausgeführt. Die in der Abbildung gezeigten Quelldatensätze dienen lediglich der Veranschaulichung.
- Welche Perplexity-API sollten Sie verwenden?
- Schritt 1: API-Schlüssel anfordern und Python einrichten
- Schritt 2: Senden Sie Ihre erste Anfrage mit geerdeter Quelle
- Schritt 3: Die Antwort herausarbeiten und die Quellen zuordnen
- Schritt 4: Verfeinern Sie das Ergebnis mithilfe von Suchfiltern
- Schritt 5: Speichern Sie eine vollständige Antwort mit anklickbaren Quellen
- Streaming und strukturierte Ausgabe
- Kosten und häufige Fehler
- Umstieg von einem älteren Sonar-Tutorial
- Häufig gestellte Fragen
Perplexity-API-Tutorial: Die richtige API auswählen
Dies sind Entwickler-Schnittstellen. Das Chat-Produkt bietet ähnliche Funktionen möglicherweise in anderer Form an; unsere Übersicht über Funktionen von Perplexity beschreibt die Benutzererfahrung.
Perplexity’s Schnellstart für die offizielle API gruppiert seine Entwicklerprodukte nach den Aufgaben, die Sie erledigen müssen. Wählen Sie die kleinste Oberfläche, die die Daten liefert, die Ihre Anwendung tatsächlich benötigt.
| API | Beste Passform | Was Ihr Code erhält |
|---|---|---|
| Agent | Eine fertige Antwort, die auf einer Websuche oder anderen Tools basiert | Ausgabeposten, Antworttext und Suchergebnisdatensätze |
| Suche | Ihre Anwendung wird die Ergebnisse selbst sortieren, filtern oder zusammenfassen. | Suchergebnisse, ohne Perplexity zu bitten, die endgültige Antwort zu schreiben |
| Router | Anfragen an ein geeignetes Modell weiterleiten | Eine über den Router ausgewählte Musterantwort |
| Einbettungen | Semantische Suche und ein RAG-Index | Vektordaten für Ihre eigene Suchebene |
In diesem Tutorial wird „Agent“ ausgewählt, da das gewünschte Ergebnis eine fertige Antwort samt Quellenangaben ist. Informationen zum allgemeinen Recherche-Workflow finden Sie in unserem Leitfaden zu Einsatz von Perplexity für Forschungszwecke.
Über Sonar: Der aktuelle Übersicht über die Migration Es heißt, dass „Sonar Chat Completions“ weiterhin unterstützt wird, und für alle neuen Projekte wird „Agent“ empfohlen. In diesem Tutorial wird daher „Agent“ verwendet. Leiten Sie aus einem in einem älteren Tutorial genannten Stichtag nicht ab, dass eine alte Integration nicht mehr funktioniert.
Schritt 1: API-Schlüssel anfordern und Python einrichten
Schlüssel erstellen und Abrechnung vorbereiten
Öffnen Sie die Perplexity-API-Konsole, wählen Sie das gewünschte Projekt aus oder erstellen Sie eines, konfigurieren Sie die API-Abrechnung und erstellen Sie einen Schlüssel. Speichern Sie diesen serverseitig. Die Entwickler-APIs werden getrennt von den Verbraucher-Abonnements abgerechnet; überprüfen Sie Ihr Projektguthaben, bevor Sie Anfragen stellen.
Installieren Sie das offizielle SDK
python -m venv .venv

# macOS/Linux: Wählen Sie diesen Aktivierungsbefehl
source .venv/bin/activate

# Windows PowerShell: Verwenden Sie stattdessen diesen Befehl
.venv\Scripts\Activate.ps1

python -m pip install --upgrade perplexityai
Verwenden Sie für den folgenden Code Python 3.10 oder eine neuere Version. Aktivieren Sie die Umgebung mit dem für Ihr Betriebssystem geeigneten Befehl und installieren Sie anschließend das SDK. Falls PowerShell die Aktivierung blockiert, verwenden Sie .venv\Scripts\python.exe anstelle von Python für die Installation und die Ausführung von Skripten.
Der Name des Pakets lautet perplexityai, während der Python-Import lautet Ratlosigkeit. Verwenden Sie eine virtuelle Umgebung, damit die Abhängigkeiten dieses Tutorials kein anderes Projekt beeinflussen.
In diesem Beispiel wird eine Frage zur Programmierung verwendet, da sich die darin enthaltenen Aussagen anhand der gepflegten Dokumentation überprüfen lassen. Unser Leitfaden zu Perplexity zur Codierung erläutert, welchen Stellenwert die Unterstützung durch die Forschung im Vergleich zum eigenständigen Testen von Code einnimmt.
Legen Sie den API-Schlüssel als Umgebungsvariable fest
# macOS/Linux
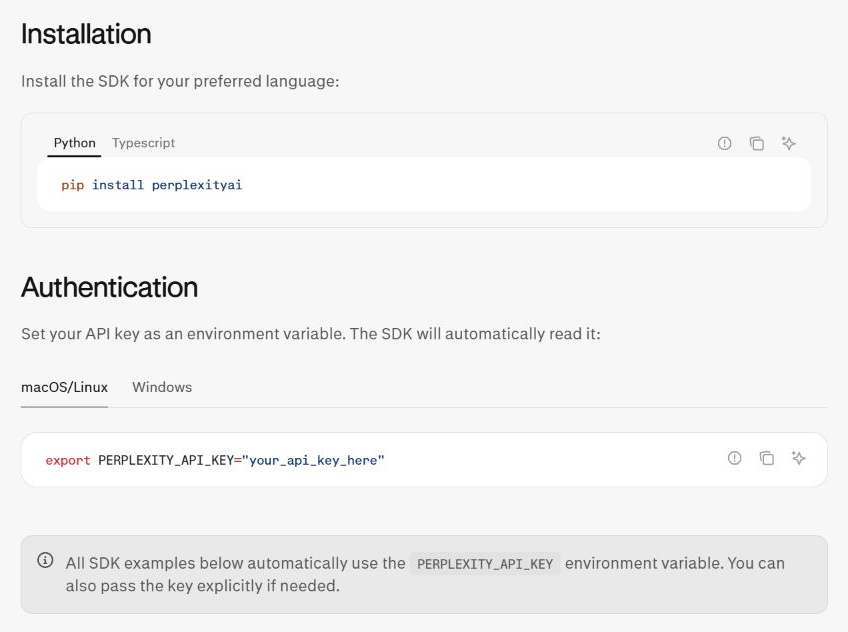
export PERPLEXITY_API_KEY="Ihr-Schlüssel-hier"

# Windows PowerShell
$env:PERPLEXITY_API_KEY = "Ihr-Schlüssel-hier"
Das SDK liest PERPLEXITY_API_SCHLÜSSEL beim Erstellen des Clients. Fügen Sie den Schlüssel nicht in ein Notizbuch ein, übertragen Sie ihn nicht in Git und senden Sie ihn nicht an einen Browser. Wenn Sie lokal eine .env-Datei verwenden, halten Sie diese Datei aus der Versionskontrolle heraus und laden Sie sie mit der von Ihnen gewählten Bibliothek für Umgebungsvariablen.
Schritt 2: Senden Sie Ihre erste Anfrage mit geerdeter Quelle
Schnellstart für die Agent-API Dokumente POST-https://api.perplexity.ai/v1/agent. Sein Python-Client umschließt die Anfrage mit client.responses.create(). Das schnell Die Voreinstellung aktiviert standardmäßig die Websuche, wodurch das erste Beispiel überschaubar bleibt.
from perplexity import Perplexity

client = Perplexity()

question = (
    "Wie sollte ein kleines Python-Projekt virtuelle Umgebungen nutzen "
    "und Abhängigkeiten verwalten?"
)

response = client.responses.create(
    preset="fast",
    input=question,
)

print(response.output_text)
Speichere den Codeausschnitt unter dem Namen first_request.py, dann führen Sie Folgendes aus python first_request.py in demselben Terminal, in dem Sie den Schlüssel festgelegt haben. Bei einem erfolgreichen Aufruf sollte ein nicht leerer Antworttext ausgegeben werden. Wenn Sie einen Nachweis für das Ergebnis benötigen, fahren Sie mit dem Schritt zur Quellenextraktion fort; der Text allein stellt noch keine abgeschlossene Überprüfung dar.
Die Komfort-Eigenschaft Ausgabetext liefert Ihnen den endgültigen Antworttext. Behalten Sie auch das gesamte Antwortobjekt bei: Quelldatensätze und Nutzungsdetails sind in der getippten Ausgabe enthalten, nicht nur im gedruckten Absatz.
Die gleiche Anfrage mit cURL
curl https://api.perplexity.ai/v1/agent \
  -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "preset": "fast",
    "input": "Wie sollte ein kleines Python-Projekt virtuelle Umgebungen nutzen und Abhängigkeiten verwalten?"
  }'
Dieses cURL-Beispiel verwendet die Bash-Syntax für macOS/Linux oder eine Bash-kompatible Shell. Bei jeder Ausführung wird eine weitere abrechnungspflichtige Anfrage gestellt. Verwenden Sie es nur, wenn Sie ein Endpunktproblem von einem Python-Problem unterscheiden müssen; führen Sie nicht jede Version aus, nur um dem Beispiel zu folgen.
Entsprechung in serverseitigem JavaScript
Node.js 18+ enthält holen, daher benötigt ein serverseitiger Smoke-Test keine zusätzliche Bibliothek. Lesen Sie den Rohtext Ausgabe Elemente in der JSON-Antwort; das Python-SDK bietet die praktische Ausgabetext Zubehörteil.
const res = await fetch("https://api.perplexity.ai/v1/agent", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.PERPLEXITY_API_KEY}`,
    "Content-Type": "application/json"
  },
  body: JSON.stringify({
    preset: "fast",
    input: "Wie sollte ein kleines Python-Projekt virtuelle Umgebungen nutzen und Abhängigkeiten verwalten?"
  })
});
if (!res.ok) throw new Error(`Perplexity HTTP ${res.status}`);
console.log(await res.json());
Schritt 3: Die Antwort herausarbeiten und die Quellen zuordnen
Die offiziellen Richtlinien zur Quellenangabe unterscheidet die Prosa von ihren Beweisunterlagen. Die Quellen treffen in einem Ausgabe Element vom Typ Suchergebnisse. Lies den Artikel dazu Ergebnisse und ordne jede Quellenangabe dem entsprechenden Ergebnis zu id. Ein Ergebnis verfügt über einen Titel und eine URL; fehlende Werte sollten vor der Anzeige berücksichtigt werden.
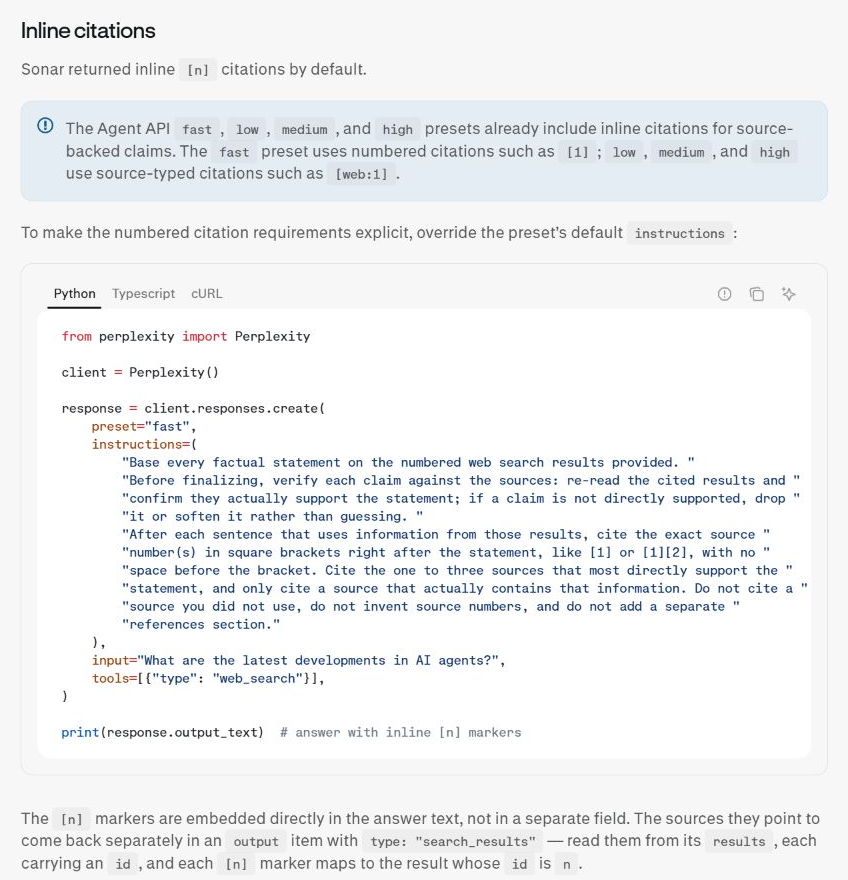
Dieses letzte Detail ist wichtig. Gehen Sie nicht davon aus, dass “Zitat 1” immer das erste Element in einem Array ist, nachdem ein anderes Tool einen Eintrag hinzugefügt hat. Erstellen Sie eine Suche nach ID und ermitteln Sie dann die Marker, die tatsächlich in der Antwort erscheinen.
def field(obj, name, default=None):
    return obj.get(name, default), falls obj ein Wörterbuch ist, andernfalls getattr(obj, name, default)

def source_index(output):
    sources = {}
    for item in output or []:
    if field(item, "type") != "search_results":
        continue
    for result in field(item, "results", []) or []:
            sid, url = field(result, "id"), field(result, "url")
 if sid is None:
 continue
 key = str(sid)
 if key in sources and field(sources[key], "url") != url:
                raise ValueError(f"Konflikte bei den URLs für die Quellen-ID {key}")
 sources[key] = result
    return sources

sources = source_index(response.output)
print(sources.get("7"))  # Eine Quellen-ID, nicht die Array-Position 7
Das folgende vollständige Skript erkennt [1] und [web:1], die dokumentierten Zitierformen für die gängigen Voreinstellungen. Die oben genannte Hilfsfunktion verarbeitet sowohl SDK-Objekte als auch Wörterbücher und lehnt widersprüchliche URLs ab, die derselben ID zugewiesen sind. Sie nummeriert die Ergebnisse nicht neu und versucht auch nicht, eine fehlende Quelle zu erraten.
Eine ausführlichere Erörterung der Zitierqualität finden Sie in unserem Leitfaden zur Zitiergenauigkeit bei Perplexity. Ein Verweis ist ein Nachverfolgungspfad; Ihre Anwendung benötigt weiterhin Richtlinien für veraltete Seiten, doppelte URLs und nicht unterstützte Angaben.
Wenn das zurückgegebene Array beispielsweise die ID 2 gefolgt von der ID 7 enthält, lautet die Markierung [7] muss auf ID 7 verweisen. Wenn dieselbe URL unter den IDs 7 und 9 erscheint, kannst du diese URL einmal anzeigen und dabei beide IDs beibehalten. Wenn ID 8 nie eintrifft, behalte [8] sichtbar machen und als nicht zugeordnet kennzeichnen.
Schritt 4: Verfeinern Sie das Ergebnis mithilfe von Suchfiltern
Sobald die grundlegende Abfrage funktioniert, schränken Sie die Suche ein, wenn Ihre Frage eine klare Abgrenzung hinsichtlich der Zuständigkeit aufweist. Für Python-Pakete sind die Sprachdokumentation und der Leitfaden zur Paketierung bessere Ausgangspunkte als ein beliebiges Tutorial.
response = client.responses.create(
    preset="fast",
    input=(
 "Wie sollte ein kleines Python-Projekt virtuelle Umgebungen nutzen "
 "und Abhängigkeiten verwalten? Geben Sie die von Ihnen verwendeten Leitlinien an."
    ),
    tools=[
 {
 "type": "web_search",
 "filters": {
 "search_domain_filter": [
 "docs.python.org",
                    "packaging.python.org",
 ]
 },
 }
    ],
)
Der Filter gehört in die Konfiguration des Web-Suchtools. In der Migrationsdokumentation wird außerdem beschrieben, search_recency_filter bei zeitkritischen Fragen. Nutzen Sie den Aktualitätsfaktor, wenn die Frage von aktuellen Veröffentlichungen oder Nachrichten abhängt; eine sehr enge Kombination aus Fachgebiet und Datum kann dazu führen, dass Ihnen zu wenig Belege zur Verfügung stehen.
Für eine Frage zu Veröffentlichungen im vergangenen Monat füge Folgendes hinzu: "search_recency_filter": "Monat" neben search_domain_filter. Lassen Sie dies im Beispiel zur virtuellen Umgebung weg: Die Dokumentation in der stabilen Version kann ein älteres Veröffentlichungsdatum aufweisen. Wenn Sie von einem voreingestellten zu einem direkt ausgewählten Modell wechseln, fügen Sie das Web-Such-Tool ausdrücklich hinzu.
Vergleichen Sie während der Entwicklung die gefilterten und ungefilterten Ergebnisse. Wenn sich die Antwort ändert, halten Sie den Grund dafür fest: Ein Filter kann nützlichen Kontext entfernen oder Seiten mit geringer Autorität aussortieren, die das Modell abgelenkt haben. Dies ist eine Qualitätsentscheidung und keine Garantie dafür, dass jede verbleibende Seite korrekt ist.
Wenn Ihre Anwendung lediglich gerangierte Links und Ausschnitte benötigt, rufen Sie die Such-API und führen Sie die Synthese selbst durch. Diese Trennung kann die Überprüfung und das Zwischenspeichern erleichtern. Einen umfassenderen Vergleich mit Google finden Sie unter Inwiefern sich Perplexity von Google unterscheidet.
Schritt 5: Speichern Sie eine vollständige Antwort mit anklickbaren Quellen
Speichern Sie Folgendes unter dem Namen perplexity_tutorial.py. Es ist in sich geschlossen: Es enthält den Quellcode-Helper, wendet den Python-Dokumentations-Domänenfilter an, wandelt übereinstimmende Zitationsmarkierungen in Links um, gruppiert doppelte URLs, ohne dabei die IDs zu verlieren, und speichert die vollständige SDK-Antwort zusammen mit dem Markdown.
from pathlib import Path
from collections import defaultdict
from urllib.parse import urlsplit
import json
import re

QUESTION = (
    "How should a small Python project use virtual environments "
    "and manage dependencies?"
)
# Supports the documented [1] and [web:1] forms in prose answers.
CITATION_RE = re.compile(r"(?<!!)\[(?:web:)?(\d+)\](?!\()")

def field(obj, name, default=None):
    return obj.get(name, default) if isinstance(obj, dict) else getattr(obj, name, default)

def source_index(output):
    sources = {}
    for item in output or []:
        if field(item, "type") != "search_results":
            continue
        for result in field(item, "results", []) or []:
            sid, url = field(result, "id"), field(result, "url")
            if sid is None:
                continue
            key = str(sid)
            if key in sources and field(sources[key], "url") != url:
                raise ValueError(f"Conflicting URLs for source ID {key}")
            sources[key] = result
    return sources

def safe_url(value):
    if not isinstance(value, str):
        return None
    parsed = urlsplit(value)
    if parsed.scheme not in ("http", "https") or not parsed.netloc:
        return None
    # Protect a Markdown angle-bracket destination.
    return value.replace("<", "%3C").replace(">", "%3E").replace(" ", "%20")

def md_label(value):
    return re.sub(r"([\\\[\]<>])", r"\\\1", str(value).replace("\n", " "))

def export_markdown(answer, output, question=QUESTION):
    sources = source_index(output)
    cited = list(dict.fromkeys(CITATION_RE.findall(answer)))
    missing = [
        sid for sid in cited
        if sid not in sources or not safe_url(field(sources[sid], "url"))
    ]
    def link(match):
        sid = match.group(1)
        url = safe_url(field(sources.get(sid, {}), "url"))
        return f"[{match.group(0)[1:-1]}](<{url}>)" if url else match.group(0)

    # Keep every ID when the same URL appears under different IDs.
    grouped = defaultdict(list)
    titles = {}
    for sid in cited:
        source = sources.get(sid, {})
        url = safe_url(field(source, "url"))
        if url:
            grouped[url].append(sid)
            titles.setdefault(url, field(source, "title") or url)

    lines = ["# Source-grounded answer", "", question, "",
             CITATION_RE.sub(link, answer), "", "## Cited sources", ""]
    for url, ids in grouped.items():
        lines.append(f"- IDs {', '.join(ids)}: [{md_label(titles[url])}](<{url}>)")
    if missing:
        lines.append("- Unmatched or unusable source IDs: " + ", ".join(missing))
    if not cited:
        lines.append("- No recognized inline citations; evidence not verified.")
    lines.extend(["", "Source links require review; matching IDs does not verify claims."])
    return "\n".join(lines) + "\n"

def main():
    from perplexity import Perplexity
    response = Perplexity().responses.create(
        preset="fast",
        input=QUESTION,
        tools=[{"type": "web_search", "filters": {
            "search_domain_filter": ["docs.python.org", "packaging.python.org"]
        }}],
    )
    answer = response.output_text or ""
    if not answer.strip():
        raise RuntimeError("No answer text returned; inspect response status and errors.")
    Path("perplexity-response.json").write_text(
        response.model_dump_json(indent=2), encoding="utf-8"
    )
    Path("perplexity-answer.md").write_text(
        export_markdown(answer, response.output), encoding="utf-8"
    )
    print("Saved perplexity-answer.md and perplexity-response.json")

if __name__ == "__main__":
    main()
Ausführen python perplexity_tutorial.py aus Ihrem Projektverzeichnis. Es schreibt perplexity-answer.md und perplexity-response.json Dort werden frühere Dateien mit diesen Namen ersetzt. Die Markdown-Datei enthält die Frage, die verlinkte Antwort, die zitierten Quellen sowie etwaige nicht zugeordnete IDs. Die JSON-Datei speichert die zurückgegebene Ausgabe und die Nutzungsdaten zu Diagnosezwecken.
Der Parser ist auf die dokumentierten Formen mit einem einzigen Marker in Prosa ausgerichtet. Es handelt sich nicht um einen vollständigen Markdown-Parser: Wenn Ihre Anwendung beliebiges Markdown, Code-Beispiele oder Zitate wie beispielsweise [1,2], füge einen syntaxsensitiven Renderer sowie Tests für dieses Format hinzu. Unbekannte Marker dürfen nicht stillschweigend neu interpretiert werden.
Überprüfen Sie, ob die verlinkte Seite die Antwort bestätigt.
Prüfen Sie in diesem Beispiel, ob die zitierte Dokumentation tatsächlich die Isolierung der Umgebung und die Installation von Abhängigkeiten erläutert. Ein Link zur Python-Homepage ist weniger hilfreich als der entsprechende Abschnitt in der Dokumentation. Wenn in einer Antwort ein bestimmter Befehl empfohlen wird, überprüfen Sie vor der Ausführung das Betriebssystem und die Python-Version. Mark behauptet, dass der zitierte Text den Status „ungelöst“ nicht stützt.
Fügen Sie bei Bedarf eine Streaming- oder strukturierte Ausgabe hinzu
Streaming
Durch Streaming lässt sich die wahrgenommene Latenz bei einer Chat-Oberfläche verbessern. Im Leitfaden zur Agentenmigration werden Text-Delta-Ereignisse wie beispielsweise response.output_text.delta. Gib diese Deltas sofort nach ihrem Eintreffen wieder, sammle aber auch die endgültigen Antwortelemente, damit deine Benutzeroberfläche die Quellen anzeigen kann, sobald die Antwort vollständig ist. Ein reiner Textstrom ist noch keine Quellenliste.
Der folgende Text dient lediglich zur Veranschaulichung. Behalten Sie den Export ohne Streaming für Ihren ersten vollständigen Quelldatensatz bei; eine Streaming-Implementierung im Produktivbetrieb muss zudem die Tool-/Ausgabeereignisse erfassen und unterbrochene oder fehlgeschlagene Läufe behandeln.
stream = client.responses.create(
    preset="fast", input=question, stream=True
)
for event in stream:
    if event.type == "response.output_text.delta":
 print(event.delta, end="", flush=True)
Strukturierte Ausgabe
Verwenden Sie eine strukturierte Antwort, wenn der nachgelagerte Code Felder wie beispielsweise Antwort, Vertrauenshinweis und Folgefragen. Behalten Sie die Quell-IDs als separates Feld bei oder bewahren Sie die ursprüngliche Agent-Ausgabe bei, damit Ihr Schema die Nachweise nicht verdeckt. Überprüfen Sie das Schema anhand Ihrer eigenen Testfälle, bevor Sie es in einem Workflow einsetzen.
Die Migrationsreferenz behält Antwortformat mit Typ: "json_schema" für strukturierte Ausgaben. Definieren Sie Pflichtfelder und unterbinden Sie gegebenenfalls unerwartete Eigenschaften. Schema-Gültigkeitsprüfungen beziehen sich auf die Form, nicht auf den Wahrheitsgehalt: Quell-IDs müssen weiterhin zu tatsächlich zurückgegebenen Datensätzen führen, und eine vom Modell generierte Konfidenzkennzeichnung ist kein Maß für die Genauigkeit.
Kosten der Perplexity-API und häufige Fehler
Die offizielle Preisseite von Perplexity, Stand: 28. September 2026, trennt Agent-Modell-Token von Tool-Aufrufen. Im Folgenden sind die USD-Gebühren für Tools und Suchanfragen aufgeführt. Die schnell Agent-Voreinstellung und search_type: "fast" Es gibt verschiedene Konfigurationsmöglichkeiten; leiten Sie die Suchrate nicht aus dem Namen der Voreinstellung ab.
| Abrechnungsfähige Maßnahme | USD pro Aktie | USD pro 1.000 |
|---|---|---|
| Standard-Websuche des Agenten | $0.0025 | $2.50 |
| Aufruf der Agent-Schnellsuche | $0.001 | $1.00 |
| Agent-URL abrufen | $0.0005 | $0.50 |
| Suche über die API – Anfrage erfolgreich | $0.005 | $5.00 |
| Such-API mit Fast Search | $0.001 | $1.00 |
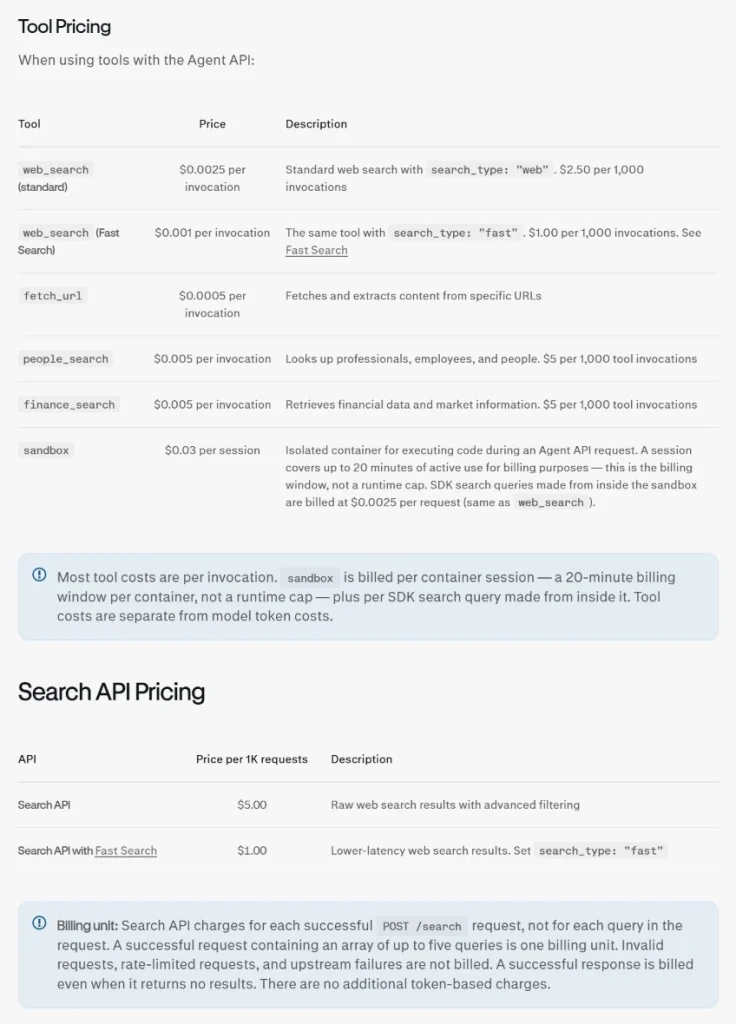
Beispiel: 1.000 Standard-Websuchen sowie 1.000 URL-Abrufe kosten $3.00 an Werkzeugkosten ($2.50 + $0.50), vor Modell-Tokens oder anderen Gebühren. Dabei handelt es sich um eine geschätzte Arbeitslast und nicht um die tatsächlich gemessenen Kosten für das Tutorial. Eine einzelne Agent-Anfrage kann mehrere Tools aufrufen. Sofern verfügbar, überprüfen Sie Nutzung.Kosten.Gesamtkosten auf der ausgefüllten Antwort.
| Symptom | Was Sie zuerst überprüfen sollten |
|---|---|
| 401 oder 403 | Name der Umgebungsvariable, Gültigkeit des Schlüssels, Kontozugriff und ob die Anfrage den aktuellen Endpunkt erreicht. |
| Fehler bei der Abrechnung oder beim Kontingent | API-Guthaben, Zahlungseinstellungen, Modell-/Tool-Gebühren und Kontolimits. Ein Perplexity-Privatkunden-Tarif beinhaltet nicht automatisch API-Guthaben. |
| 429 | Ratenbegrenzungen und Wiederholungsverhalten. Verwenden Sie einen begrenzten exponentiellen Backoff und vermeiden Sie es, eine bereits bearbeitete Anfrage blindlings erneut zu senden. |
| Zeitüberschreitung | Einstellungen für Netzwerkpfad, Eingabeaufforderungsgröße, Anzahl der Werkzeuge und Client-Timeout. Protokollieren Sie eine Anforderungs-ID, falls das SDK eine bereitstellt, protokollieren Sie jedoch niemals den Schlüssel. |
| Für die Antwort gibt es keine passenden Quellen. | Die Rohware prüfen response.output, Zitierweise und Quellen-IDs; kennzeichnen Sie die Antwort als „unverifiziert“, anstatt Links zu erfinden. |
Die Such-API berechnet erfolgreiche Anfragen, einschließlich solcher, die keine Ergebnisse liefern; für die Anfrage fallen keine zusätzlichen Token-Kosten an. Die Kosten für Agenten hängen von den Modell-Tokens und den Tools ab. Beachten Sie diese unterschiedlichen Abrechnungseinheiten, wenn Sie einen Antwort-Workflow mit einem reinen Such-Workflow vergleichen.
Für einen Vergleich der API-Kosten bietet unsere Perplexity – Kostenübersicht für die API liefert zusätzliche Hintergrundinformationen, während die offizielle Preisseite weiterhin als maßgebliche Quelle für die aktuellen Preise gilt.
Umstieg von einem älteren Sonar-Tutorial
In vielen Suchergebnissen wird nach wie vor die ältere Form „Chat Completions“ angezeigt. Der Leitfaden zur Migration für Agenten verwendet eine direkte konzeptionelle Zuordnung. Wenn Sie die Bezeichnungen des Verbrauchermodells mit den API-Voreinstellungen vergleichen möchten, finden Sie in unserer Erklärung zu was LLM Perplexity verwendet bietet Hintergrundinformationen, ersetzt jedoch nicht die Dokumentation zur Agent-API.
| Älteres Sonar-Muster | Agent-API-Muster |
|---|---|
Nachrichten | Eingabe |
Modell | Voreinstellung |
choices[0].message.content | Ausgabetext |
| Ältere Annahmen bezüglich Zitiermatrizen | Suchergebnisse Ausgabeposten und ID-basierter Abgleich |
| Suchparameter in der Anfrage | tools=[{"type":"web_search","filters":{...}}] |
Lies den Live-Bericht Übersicht über die Migration und Details zur Migration bevor Sie den Produktionscode ändern. Die voreingestellten Zuordnungen dienen als Ausgangspunkt und stellen keine Garantie dafür dar, dass alte und neue Modelle identische Qualität, Latenz oder Kosten liefern.
Häufig gestellte Fragen
Ist die Perplexity-API kostenlos?
Die APIs werden gemäß der aktuellen Schnellstart- und Preisdokumentation nach tatsächlicher Nutzung abgerechnet. Gehen Sie nicht davon aus, dass ein Consumer-Abonnement, eine Testversion oder ein Aktionsguthaben jede API-Anfrage kostenlos macht.
Benötige ich Perplexity Pro, um die API zu nutzen?
Der API-Zugang und der „Consumer Pro“-Tarif sind separate Produkte. Erstellen Sie API-Zugangsdaten und überprüfen Sie die API-Abrechnung für das Entwicklerkonto, das Sie verwenden möchten.
Sollte ich die Agent-API oder die Such-API verwenden?
Wählen Sie „Agent“, wenn Sie eine fertige, fundierte Antwort mit Quellenangaben wünschen. Wählen Sie „Suche“, wenn Ihre Anwendung selbst für die Rangfolge, Filterung und Zusammenfassung zuständig sein soll. Sie können „Suche“ mit Ihrem eigenen Modell kombinieren, wenn Sie eine strenge Kontrolle über jeden Generierungsschritt benötigen.
Kann ich Perplexity von JavaScript aus aufrufen?
Ja. Verwenden Sie das oben genannte serverseitige Node.js-Beispiel oder das offizielle JavaScript-SDK. Speichern Sie den Schlüssel auf dem Server. Wenn Sie Roh-JSON einlesen, überprüfen Sie die typisierten Ausgabeelemente und wenden Sie dieselben Regeln für die Zuordnung der Quell-IDs an.
Ist die Richtigkeit der Perplexity-Zitate garantiert?
Nein. Ein Verweis gibt an, auf welches Suchergebnis sich die Antwort bezieht. Ihre Anwendung oder der Prüfer muss dennoch die Aktualität und die Zuverlässigkeit überprüfen und sicherstellen, dass die Seite genau diese Aussage stützt.
Warum hat mein Parser keine Quellen gefunden?
Überprüfen Sie die Typen der Rohausgabe, vergewissern Sie sich, dass die Websuche durchgeführt wurde, und prüfen Sie, ob Ihr regulärer Ausdruck mit der Zitierform der Voreinstellung übereinstimmt. Wenn keine Markierung angezeigt wird, speichern Sie die Antwort als „unbestätigt“ und gehen Sie der Anfrage nach, anstatt einen vermuteten Link hinzuzufügen.
Kann ein GlobalGPT-Schlüssel einen Perplexity-API-Schlüssel ersetzen?
GlobalGPT ist eine All-in-One-KI-Arbeitsumgebung für den alltäglichen Einsatz von KI. Das Abonnement und der Zugriff auf Modelle sind unabhängig vom Perplexity-Entwicklerkonto, dem API-Schlüssel und den API-Guthaben; in diesem Python-Tutorial wird das Entwicklerkonto verwendet.
Eine praktische Checkliste für die Markteinführung
- Erstellen Sie einen serverseitigen Schlüssel und bestätigen Sie die API-Abrechnung.
- Führen Sie die Minimalversion aus
schnellAnfrage vor dem Hinzufügen von Filtern oder dem Streaming. - Speichern Sie die vollständige Antwort, nicht nur den sichtbaren Antworttext.
- Ordne Zitiermarker den zurückgegebenen Quellen-IDs zu und kennzeichne nicht zugeordnete Marker.
- Überprüfen Sie die zitierten Seiten auf Belegung der Aussagen, Aktualität und doppelte URLs.
- Überprüfen Sie vor der Bereitstellung noch einmal die Dokumentation zu Live Agent, den Preisen und der Migration.
Sie verfügen nun über das Grundmuster für eine zuverlässige Perplexity-API-Integration: Stellen Sie eine gezielte Frage, lassen Sie die Agent-API die Suche durchführen, halten Sie die Antwort und die Belege zusammen und sorgen Sie dafür, dass jede Quellenangabe nachvollziehbar ist. Bauen Sie darauf auf und fügen Sie Caching, Wiederholungsversuche und Ihre eigenen Überprüfungsregeln rund um denselben Workflow mit der Quellen-ID hinzu.









