
Die OpenAI Audio-Sprach-API wandelt Text in gesprochene Audiodateien um, und zwar durch POST-https://api.openai.com/v1/audio/speech. Senden Sie ein Modell, Ihren Eingabetext und eine Stimme; speichern Sie die Antwort als MP3 oder in einem anderen unterstützten Audioformat. Bei einer neuen Integration, für die Anweisungen zum Tonfall und zur Vortragsweise erforderlich sind, beginnen Sie mit gpt-4o-mini-tts.
Eine Arbeitsanfrage ist nur der erste Schritt. Sie benötigen außerdem die richtige Abrechnungseinheit, eine abspielbare Ausgabedatei und einen Plan für lange Skripte. Das neuere TTS-Modell von OpenAI verwendet Text- und Audio-Token für die Preisberechnung; die älteren TTS-Modelle basieren auf Zeichen. Dieser Unterschied spielt eine Rolle, wenn Sie den Aufwand für einen Monat Sprachaufnahme abschätzen.
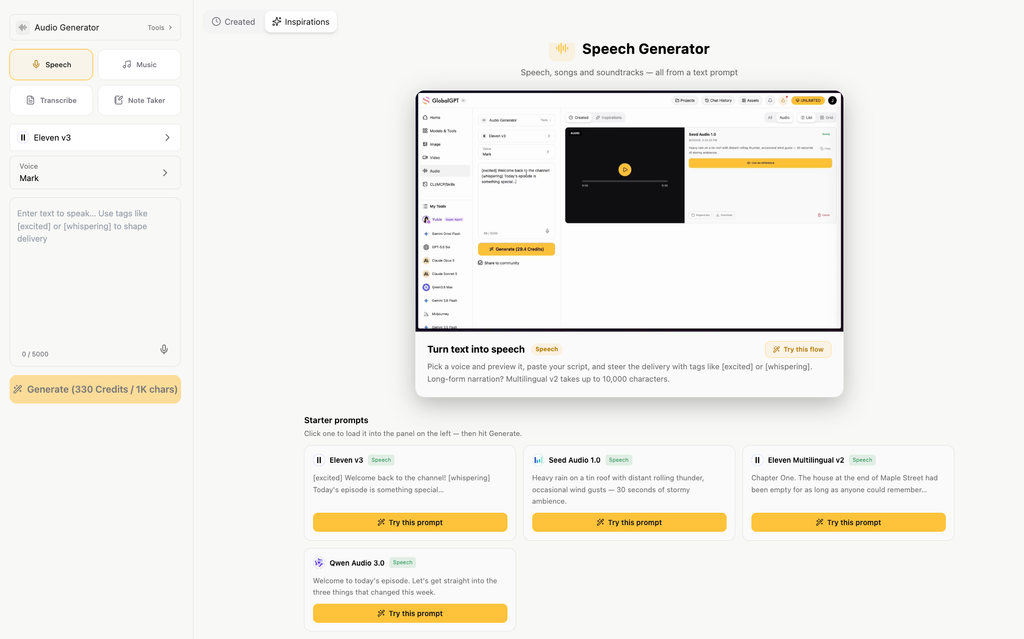
Wenn zu Ihren Aufgaben auch das Verfassen des Drehbuchs, die Erstellung von Bildmaterial und der Schnitt eines Videos gehören, Der Audio-Arbeitsbereich von GlobalGPT macht die Sprachgenerierung zu einem erschwinglichen Bestandteil einer Multi-Modell-Abonnementplattform. Sie können in einem einzigen Dashboard mit Text, Sprache, Bildern und Videos arbeiten und anschließend die API und die CLI für wiederholbare Produktionsaufgaben nutzen. Die öffentliche TTS-API verwendet einen separaten Aufgaben-Workflow, der im Folgenden erläutert wird.
Was leistet die OpenAI Audio Speech API?
Die Speech-API ist ein Endpunkt für die Text-zu-Sprache-Umwandlung: Ihre Anwendung liefert schriftliche Texte und erhält die generierte Sprachausgabe. Zu den typischen Anwendungsbereichen zählen Produktvorführungen, Barrierefreiheitskommentare, Lernmaterialien und kurze Voiceovers. Sie können den Text vor der Aussprache überprüfen, was besonders dann nützlich ist, wenn der Wortlaut einem genehmigten Skript entsprechen muss.
Bei der Transkription ist der Ablauf umgekehrt: Es wird eine Audioaufnahme eingegeben und Text ausgegeben. Ein Live-Sprachassistent stellt eine weitere Anforderung: Zuhören und Reagieren im Rahmen eines Gesprächs. OpenAI’s Audiodokumentation trennt diese Arbeitsabläufe voneinander. Wählen Sie den Sprach-Endpunkt, wenn Sie den Text, der vorgelesen werden soll, bereits haben.
Die Sprachausgabe unterstützt Streaming, sodass eine Anwendung Audiodaten in Teilmengen empfangen kann. Das Speichern dieses Streams in einer Datei führt nicht automatisch zur Wiedergabe im Browser oder zur Erstellung eines Dialogagenten; Ihre Anwendung ist weiterhin für die Wiedergabe und die gesamte Dialoglogik zuständig. OpenAI verlangt außerdem, dass den Zuhörern klar mitgeteilt wird, dass die Stimme von einer KI generiert wurde.
Erstellen Sie Ihre erste Audiodatei mit der OpenAI Speech API
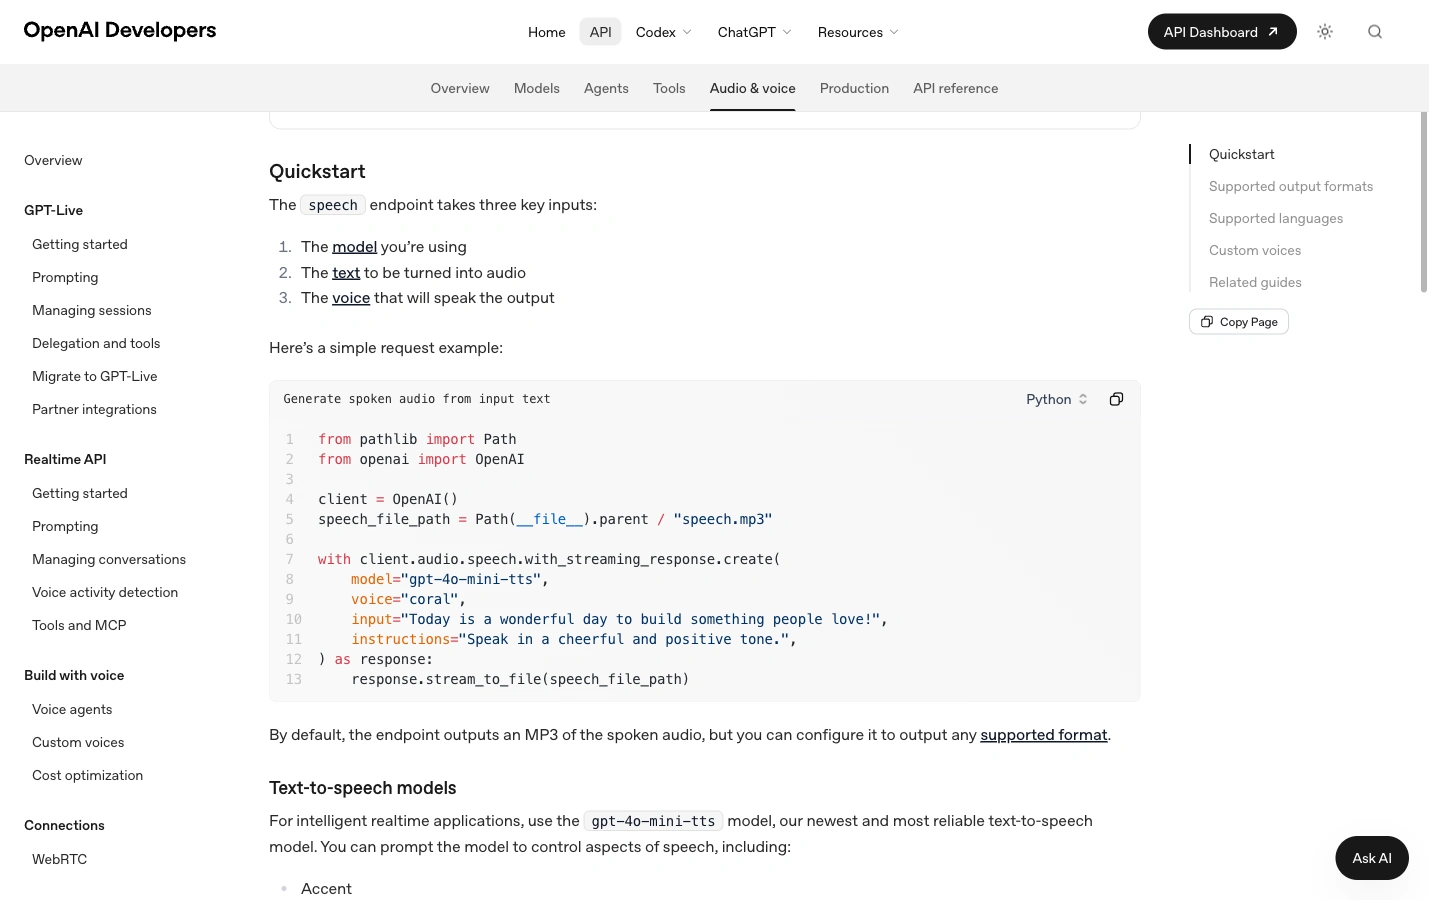
Führen Sie die Anfrage auf einem Server oder Ihrem Entwicklungsrechner aus, wobei ein OpenAI-API-Schlüssel in der OPENAI_API_KEY Umgebungsvariable. Halten Sie den Schlüssel aus dem Browser-JavaScript heraus. In den folgenden Beispielen wird dasselbe kurze Skript für die Produkttour verwendet und das Ergebnis als openai-product-tour.mp3.
Option 1: Eine Curl-Anfrage senden
OpenAI Speech API · curl
#!/bin/sh
# Legen Sie zunächst OPENAI_API_KEY in Ihrer Serverumgebung fest.
curl --fail-with-body --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "Willkommen zur Produkt-Tour von Acorn Studio. In drei Schritten können Sie ein kurzes Skript in einen Audioguide verwandeln. Schreiben Sie zunächst die Nachricht. Wählen Sie als Nächstes eine Stimme aus. Speichern Sie schließlich die Audiodatei und testen Sie die Wiedergabe auf Ihrem Smartphone.",
    "voice": "coral",
    "instructions": "Sprechen Sie deutlich in einem warmen, gesprächigen Ton.",
    "response_format": "mp3"
  }' \
  --output openai-product-tour.mp3
Die Antwort enthält Audio-Bytes, speichern Sie sie daher in einer Datei, anstatt zu versuchen, sie als JSON zu analysieren. Die --fail-with-body Diese Option gibt bei einem HTTP-Fehler einen negativen Exit-Status an curl zurück. Überprüfen Sie diesen Status, bevor Sie die Datei öffnen: Auch bei einer Fehlerantwort kann JSON in der Datei mit dem Namen .mp3.
Option 2: Verwenden Sie das Python-SDK
Installieren Sie das Paket „OpenAI“ mit dem Befehl python -m pip install openai. Das SDK liest den API-Schlüssel aus der Umgebung aus. In diesem Beispiel wird die Antwort sofort nach ihrem Eintreffen geschrieben, wodurch vermieden wird, dass die gesamte Audioantwort in Ihren eigenen Python-Puffer geladen wird.
OpenAI Speech API · Python
"""Installation: python -m pip install openai. Setzen Sie OPENAI_API_KEY auf dem Server."""
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
script = (
    "Willkommen zur Produkttour von Acorn Studio. In drei Schritten können Sie "
    "ein kurzes Skript in einen Audioguide verwandeln. Schreiben Sie zunächst die Nachricht. Wählen Sie als Nächstes "
    "eine Stimme aus. Speichern Sie schließlich die Audiodatei und testen Sie die Wiedergabe auf Ihrem Smartphone."
)

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=script,
    instructions="Sprechen Sie deutlich in einem freundlichen, gesprächigen Ton.",
    response_format="mp3",
) as response:
    response.stream_to_file(Path("openai-product-tour.mp3"))

print("openai-product-tour.mp3 wurde gespeichert")
Die drei wesentlichen Bereiche sind Modell, Eingabe, und Stimme. Hier, Anleitung erfordert eine warme, gesprächige Vortragsweise; es lenkt die Stimme, anstatt dem gesprochenen Text weitere Wörter hinzuzufügen. Dieses Feld funktioniert mit GPT-4o Mini TTS und wird von tts-1 und tts-1-hd.
Bei längeren Dokumenten sollten Sie den Text an Satz- oder Absatzgrenzen aufteilen, die Abschnitte nummerieren und jede Ausgabe unter dieser Nummer speichern. Achten Sie darauf, dass der Stil und die Anweisungen in allen Abschnitten einheitlich bleiben. Lassen Sie genügend Kontext für eine natürliche Formulierung und hören Sie sich die Übergänge an, bevor Sie die zusammengestellte Aufnahme weitergeben.
Wählen Sie ein Modell, eine Stimme und ein Ausgabeformat aus
| Modell | So wählen Sie aus | Lieferhinweise |
|---|---|---|
gpt-4o-mini-tts | Ein Ausgangspunkt für eine kontrollierte Erzählweise und einen kontrollierten Sprachfluss. | Unterstützt Anleitung hinsichtlich Tonfall, Stil und Tempo. |
tts-1 | OpenAI ist ein Modell für die Sprachgenerierung mit geringer Latenz. | Nutzen Sie die unterstützten Sprach- und Geschwindigkeitssteuerungen; weglassen Anleitung. |
tts-1-hd | OpenAI sorgt dafür, dass dieses Modell eine höhere Sprachqualität liefert als TTS-1. | Nutzen Sie die unterstützten Sprach- und Geschwindigkeitssteuerungen; weglassen Anleitung. |
Die GPT-4o Mini TTS – Modellseite ordnet den Modellalias dem gpt-4o-mini-tts-15.12.2025 Snapshot. Wenn reproduzierbares Verhalten für Ihre Anwendung wichtig ist, wählen Sie bewusst einen dokumentierten Snapshot aus und speichern Sie ihn zusammen mit Ihren Skripten.
Integrierte Stimmen und Eingangsbegrenzungen
In der Speech-API-Referenz sind 13 integrierte Stimmen für GPT-4o Mini TTS aufgeführt: Legierung, Esche, Ballade, Koralle, Echo, Fabel, Onyx, Nova, Salbei, Schimmer, Vers, Marin und Zeder. OpenAI empfiehlt Marin oder Zeder für beste Qualität. Das ist die Empfehlung von OpenAI: Wählen Sie Ihre Sprechstimme aus, indem Sie sich Ihre eigenen Namen, Zahlen und Satzmuster anhören.
Die früheren TTS-Modelle unterstützen eine kleinere Auswahl: „Alloy“, „Ash“, „Coral“, „Echo“, „Fable“, „Onyx“, „Nova“, „Sage“ und „Shimmer“. Gehen Sie nicht davon aus, dass jede Stimme mit jedem Modell kompatibel ist. Die Referenz zur Speech-API akzeptiert auch eine Geschwindigkeit zwischen 0,25 und 4,0, mit 1.0 als Standard.
Es sind zwei Eingabegrenzwerte zu berücksichtigen: die Referenzgrenzwerte der Endpunkte Eingabe zu 4.096 Zeichen, und auf der Modellseite des Mini TTS wird ein Höchstwert von 2.000 Eingabetoken. Zeichen und Tokens sind unterschiedliche Maßeinheiten. Überprüfen Sie beide Beschränkungen für Mini TTS, insbesondere bei mehrsprachigen Texten, und teilen Sie umfangreiche Skripte auf, bevor Sie sie einreichen.
Wählen Sie das Dateiformat für den Zielort aus
| Format | Praktische Anwendung |
|---|---|
| MP3 | Standardausgabe: eine praktische komprimierte Datei zum Teilen und zur Wiedergabe im Internet. |
| Opus | Nützlich für Streaming- und Kommunikationsanwendungen, die diesen Codec unterstützen. |
| AAC | Überlegen Sie, in welchen Fällen Ihre Wiedergabeumgebung oder Ihr Medien-Workflow die Verwendung von AAC erfordert. |
| FLAC | Verlustfreie Komprimierung für Arbeitsabläufe, bei denen das Audiosignal erhalten bleiben muss. |
| WAV | Unkomprimierte Audiodaten in einem vertrauten Format für die Bearbeitung und Verarbeitung. |
| PCM | Rohdaten mit 24 kHz, 16 Bit, vorzeichenbehaftet, Little-Endian, ohne Dateikopf; Ihr Player benötigt diese Einstellungen. |
Beginnen Sie mit MP3, wenn Sie einen Download-Link oder einen einfachen Audio-Player benötigen. Wählen Sie WAV, wenn im nächsten Schritt eine Bearbeitung erfolgen soll. Wählen Sie „Raw PCM“ nur dann aus, wenn Ihre Anwendung dieses Format interpretieren kann; das Ändern eines Dateinamens von .pcm zu .wav Erzeugt keinen WAV-Header.
Was kostet die OpenAI Speech API?
Nach dem Stand vom 28. September 2026 listet OpenAI den GPT-4o Mini TTS unter $0,60 pro Million Text-Eingabetoken plus $12 pro Million Audio-Ausgabe-Token. Die Kosten für TTS-1 betragen $15 pro Million Zeichen, und der TTS-1 HD kostet $30 pro Million Zeichen. Berechnen Sie jedes Modell in seinen eigenen Einheiten.
Preise für die Speech-API: Einheiten getrennt halten
OpenAI berechnet sein neueres TTS-Modell nach Tokens und seine beiden früheren TTS-Modelle nach Zeichen. GlobalGPT gibt seine TTS-Aufträge in Credits an.
| Route und Modell | Zinssatz | Beispiel |
|---|---|---|
| OpenAI · GPT-4o Mini TTS | $0,60 / 1 Mio. Texteingabe-Token $12 / 1M Audioausgangstoken | $0.0606 für 1.000 Text-Eingabetoken + 5.000 Audio-Ausgabetoken |
| OpenAI · TTS-1 | $15 / 1M Zeichen | $0.015 für 1.000 Zeichen |
| OpenAI · TTS-1 HD | $30 / 1 Mio. Zeichen | $0.030 für 1.000 Zeichen |
| GlobalGPT · Eleven v3, Eleven Multilingual v2 oder Qwen Audio 3.0 TTS Flash | 330 Credits / 1.000 Zeichen | 330 Credits zum angegebenen Preis pro 1.000 Zeichen; bitte vor der Übermittlung einen Kostenvoranschlag anfordern |
Dies sind Preisbeispiele, keine Abrechnungsbeträge für die unten stehenden Hörbeispiele. Tokens, Zeichen, Minuten und Credits sind unterschiedliche Einheiten. Die Aufwandsschätzung für die Aufgabe „GlobalGPT“ gibt die entsprechende Credit-Anzahl an; in der Tabelle werden Credits nicht in Dollar umgerechnet.
Preise geprüft am 28. September 2026. Quellen: Preise für die OpenAI-API und GlobalGPT-API-Dokumentation.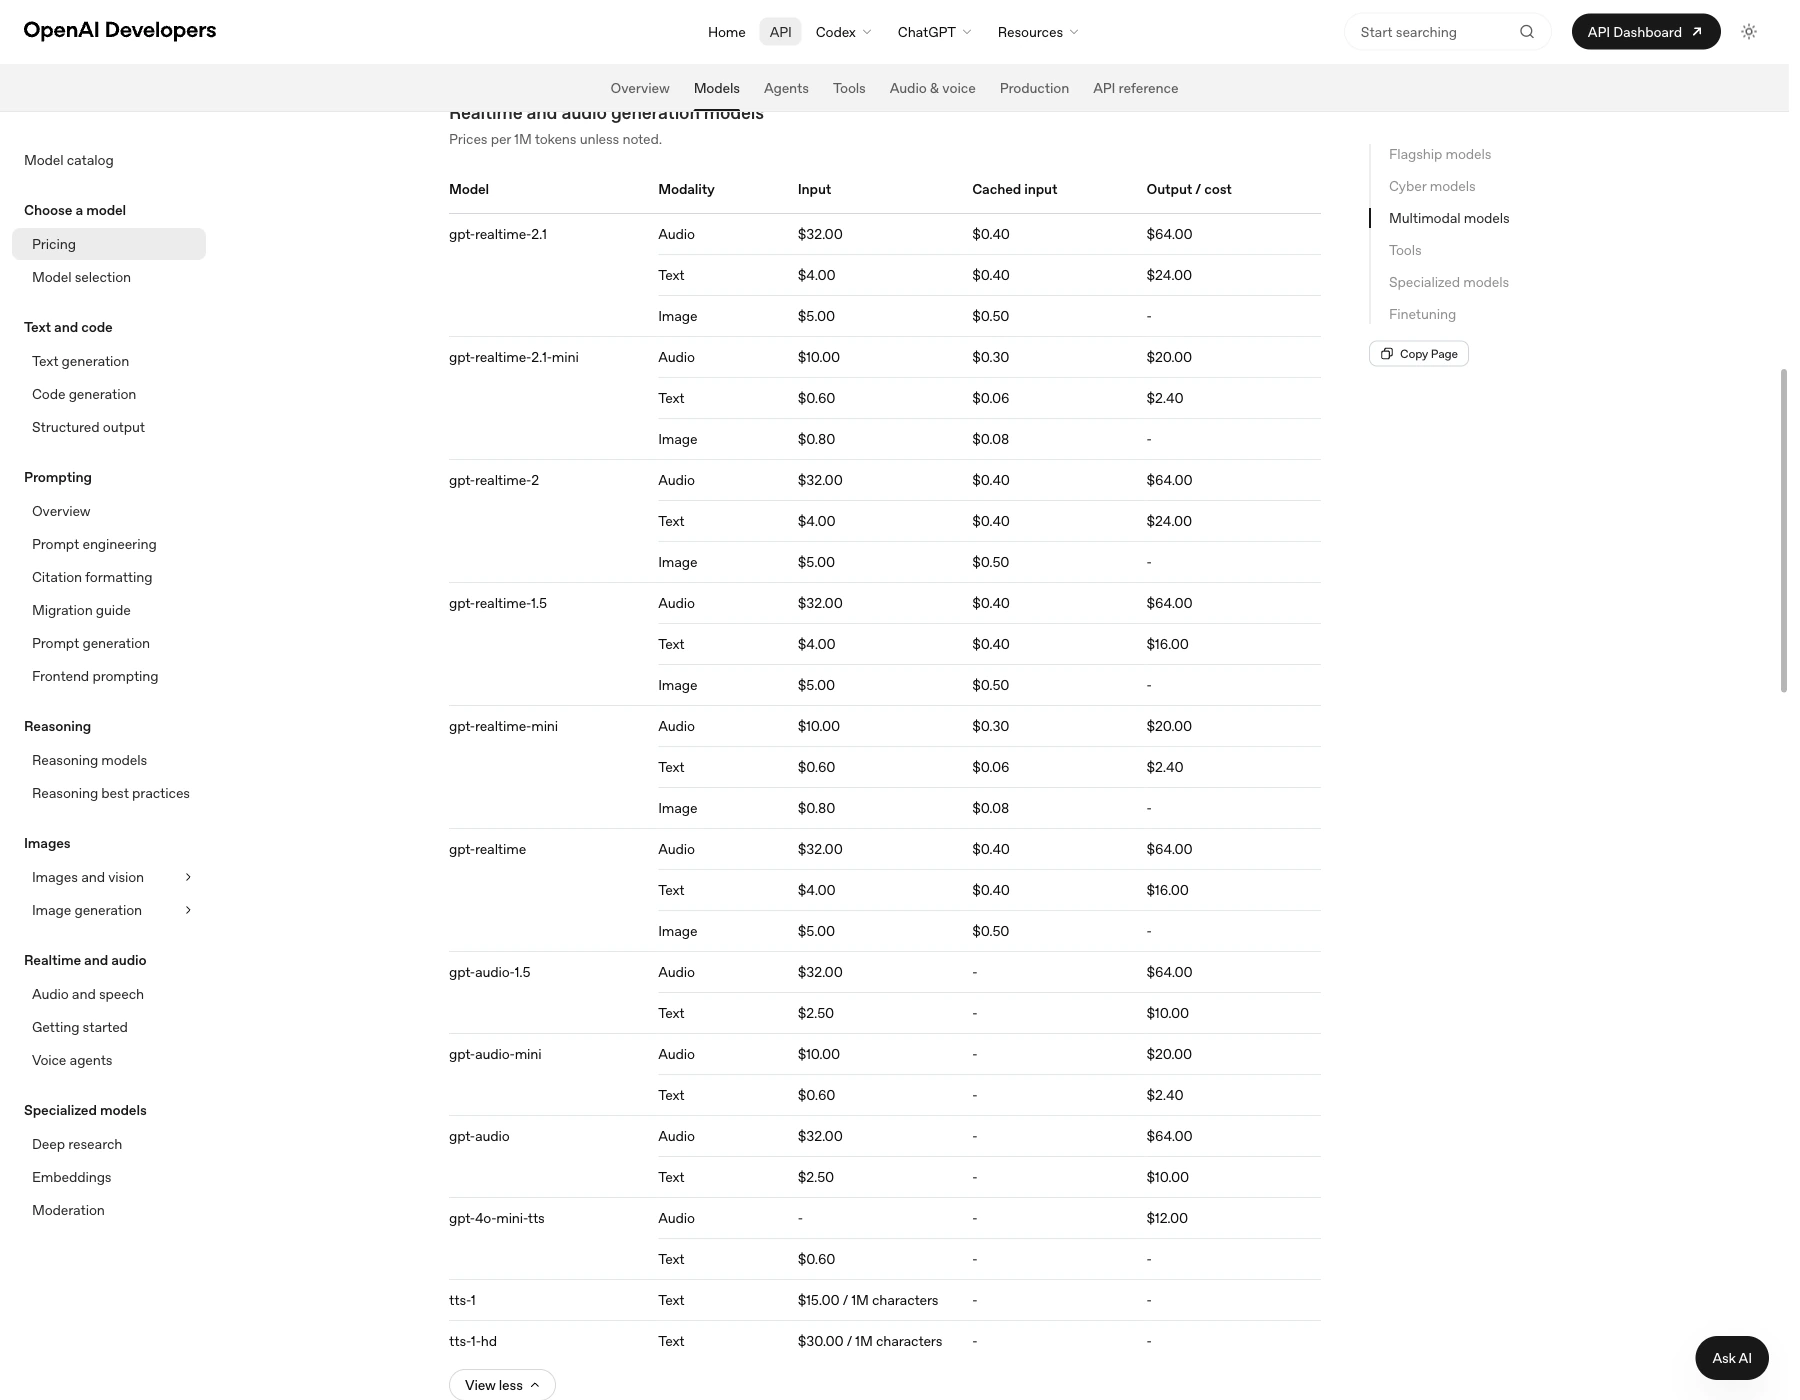
Beispielsweise ergeben 100 Skripte mit jeweils 1.000 Zeichen insgesamt 100.000 Zeichen. Zu den angegebenen Tarifen sind das $1.50 mit TTS-1 oder $3.00 mit TTS-1 HD, vor anderen Anwendungskosten. Die gleiche Zeichenanzahl reicht nicht aus, um Mini TTS exakt zu berechnen: Sie benötigen die Anzahl der Token für die Texteingabe und die Audioausgabe.
Schätzen Sie Ihre Kosten für die Sprachgenerierung
Geben Sie die Einheiten ein, nach denen die von Ihnen gewählte Route abgerechnet wird. Es findet keine automatische Umrechnung von Zeichen in Token oder von Minuten in Token statt.
Formel: Zeichen × $15 ÷ 1.000.000. Die Gesamtzeichenanzahl eines Textes kann sich über mehrere API-Anfragen erstrecken.
Preise Stand: 28. September 2026: OpenAI · GlobalGPT. Ausgenommen sind Speicherplatz, Hosting, Steuern und andere Bestandteile Ihrer Anwendung.
Geben Sie zur Planung die tatsächlichen Nutzungszahlen oder konkrete Annahmen in den Rechner ein. Behandeln Sie das Feld „Mini TTS Audio-Token“ als Budgetangabe, bis Sie die Nutzung gemessen haben. Wandeln Sie einen ungefähren Minutenpreis nicht in einen garantierten Preis für jede Stimme, jedes Sprechtempo oder jede Sprache um.
Im Modellkatalog „GlobalGPT“ werden die TTS-Preise in Credits angegeben, und der Schätzungsendpunkt liefert ein Angebot für die Anfrage, die Sie senden möchten. Trennen Sie die Verwendung von API-Credits von der Wahl eines Multi-Model-Workspace-Abonnements für alltägliche Schreib- und Medienarbeiten. So lässt sich das Budget leichter im Blick behalten, ohne davon auszugehen, dass sich beide Produkte ein gemeinsames Abrechnungskontingent teilen.
Erstellen Sie einen TTS-Workflow mit der GlobalGPT-API
Für einen wiederholbaren Arbeitsablauf von Skript über Sprache bis hin zum Video, Sprache in GlobalGPT erstellen und den Rest des Projekts im selben Arbeitsbereich belassen. Das GlobalGPT-API stellt die Medienerzeugung als Aufgaben dar, während die GlobalGPT-Befehlszeilenschnittstelle Verbindungen, die mit Ihrem Terminal und Ihren Entwicklungstools kompatibel sind.
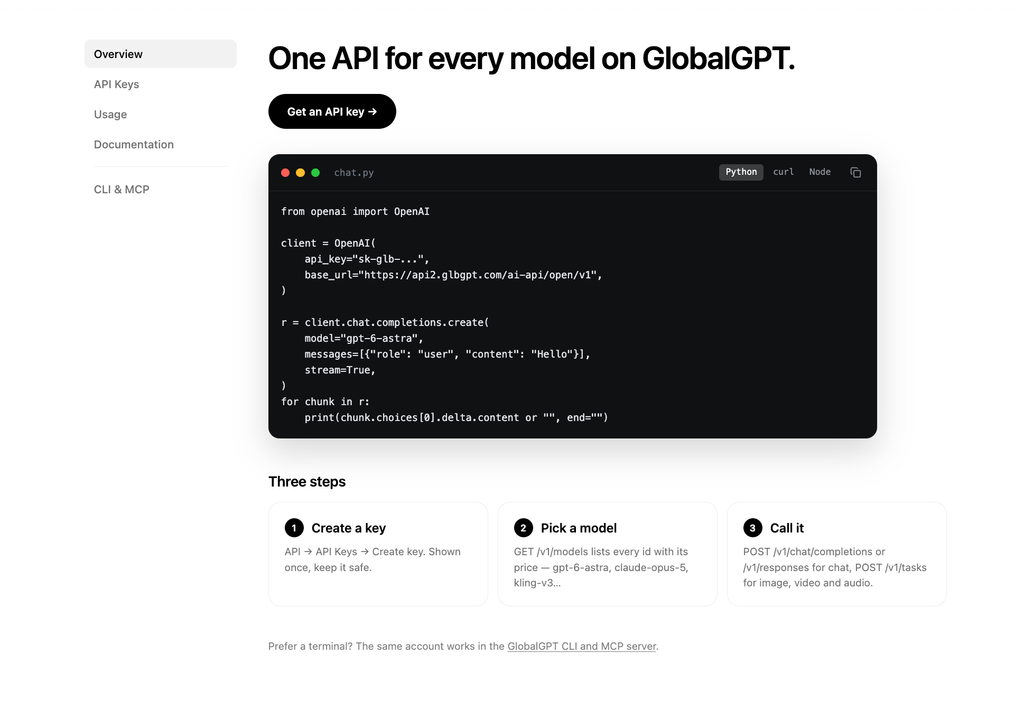
Verwenden Sie die öffentliche Basis-URL https://api2.glbgpt.com/ai-api/open/v1. Senden Sie TTS-Anfragen an POST /tasks, Abfrage GET /tasks/{id}, und herunterladen output.url nachdem die Aufgabe erfolgreich abgeschlossen wurde. Das Textfeld lautet Aufforderung. Setzen Sie diesen Aufgabenvertrag direkt um; er unterscheidet sich von der sofortigen Audioantwort von OpenAI.
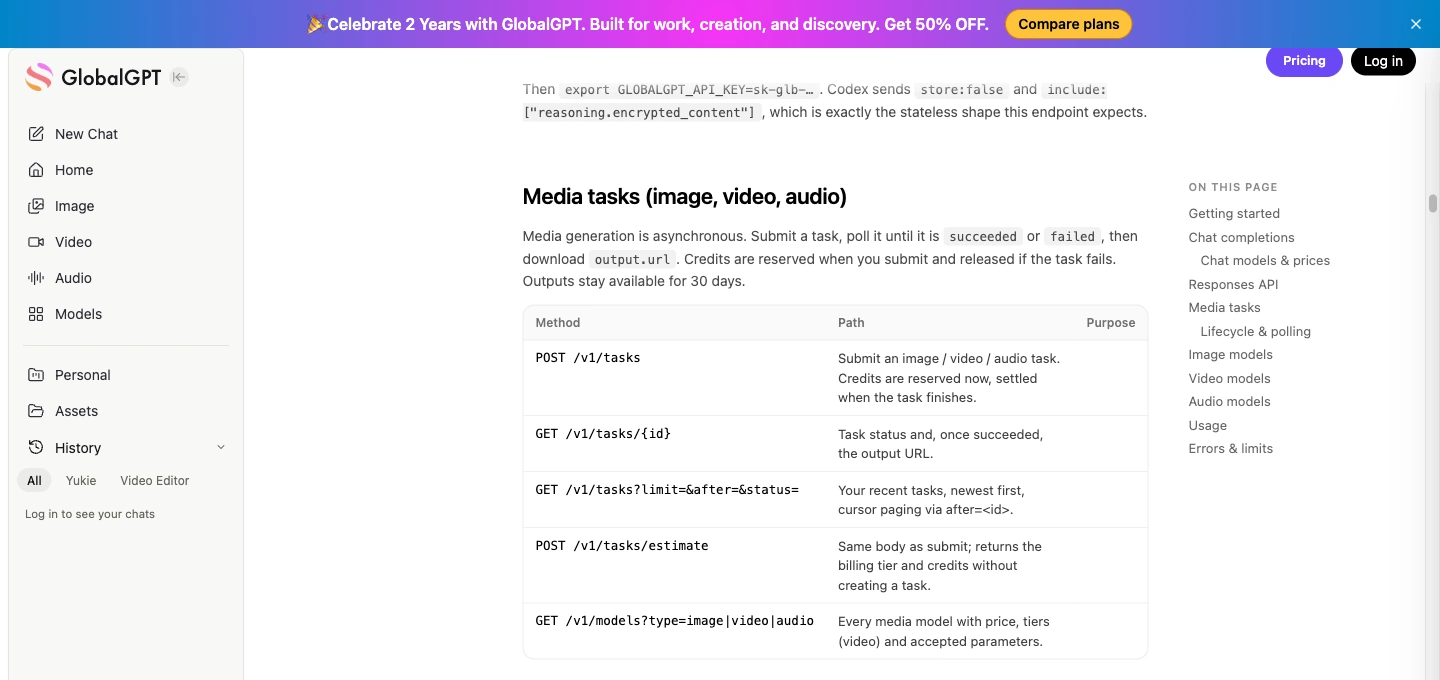
Wählen Sie ein dokumentiertes GlobalGPT-TTS-Modell aus
| Modell-ID | Eingabe und Ausgabe | Nützliche Unterscheidung |
|---|---|---|
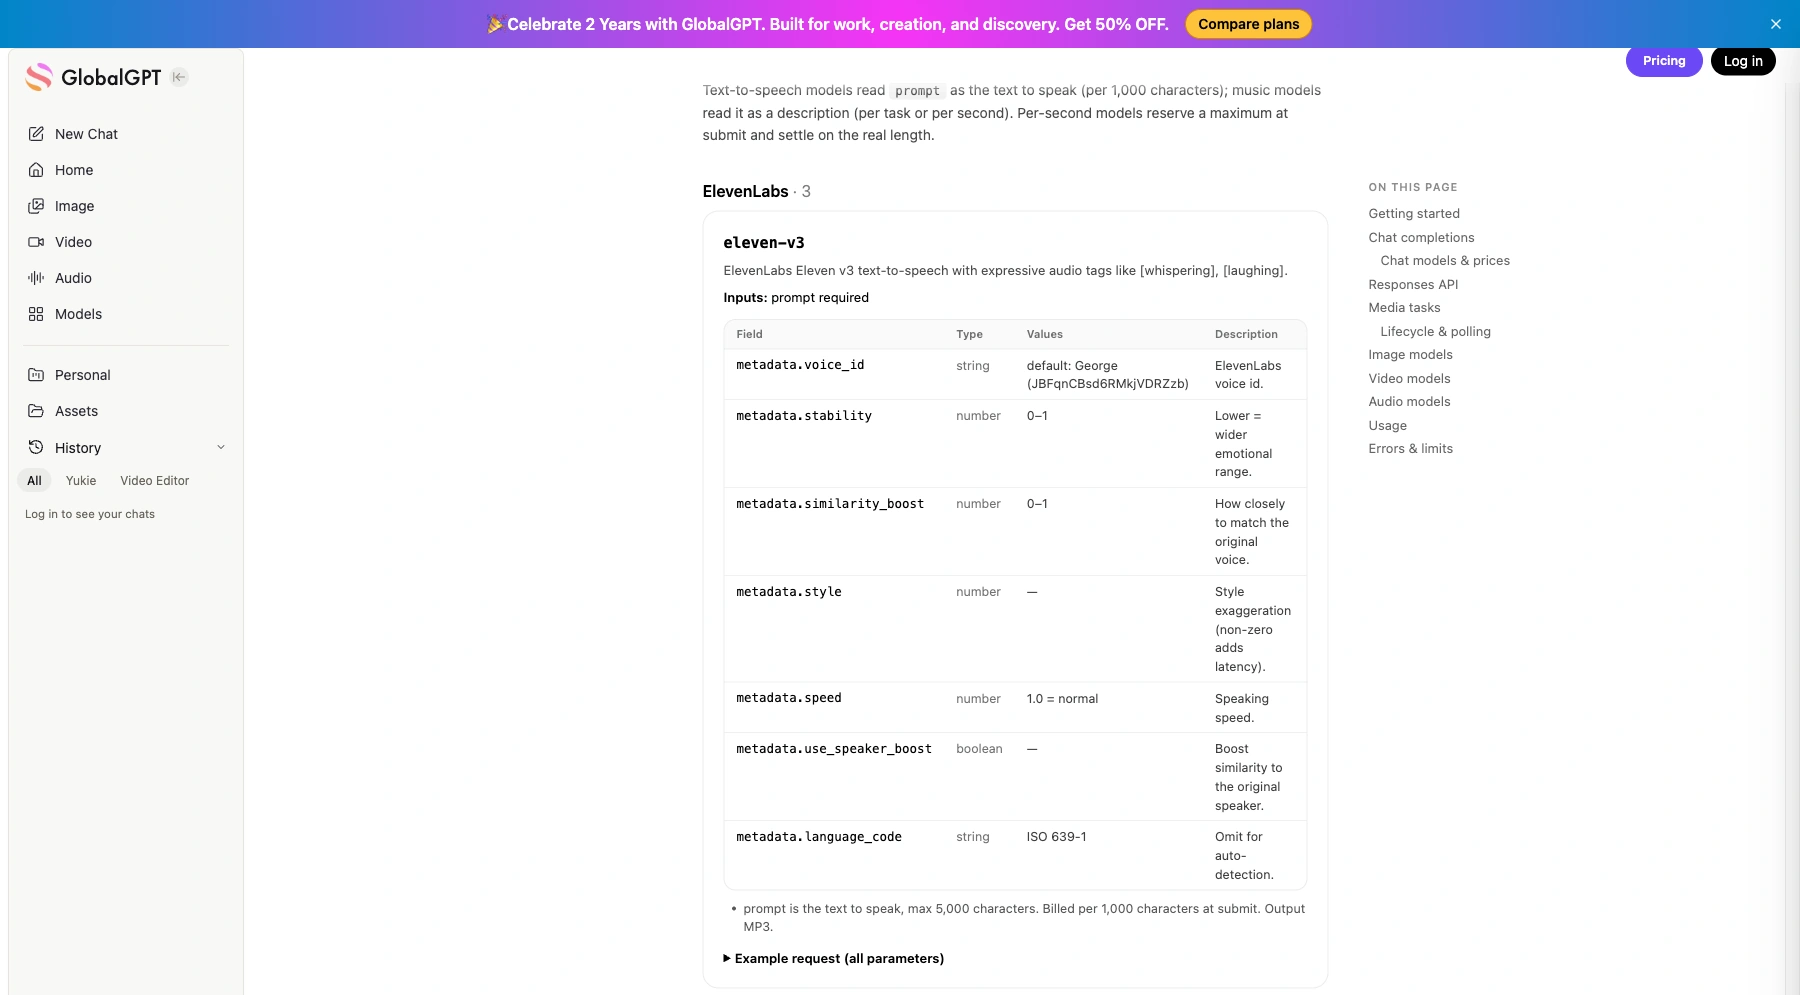
eleven-v3 | Bis zu 5.000 Zeichen; MP3 | Unterstützt Expressive-Audio-Tags. |
eleven-multilingual-v2 | Bis zu 10.000 Zeichen; MP3 | 29 Sprachen; Audio-Tags werden als Text vorgelesen. |
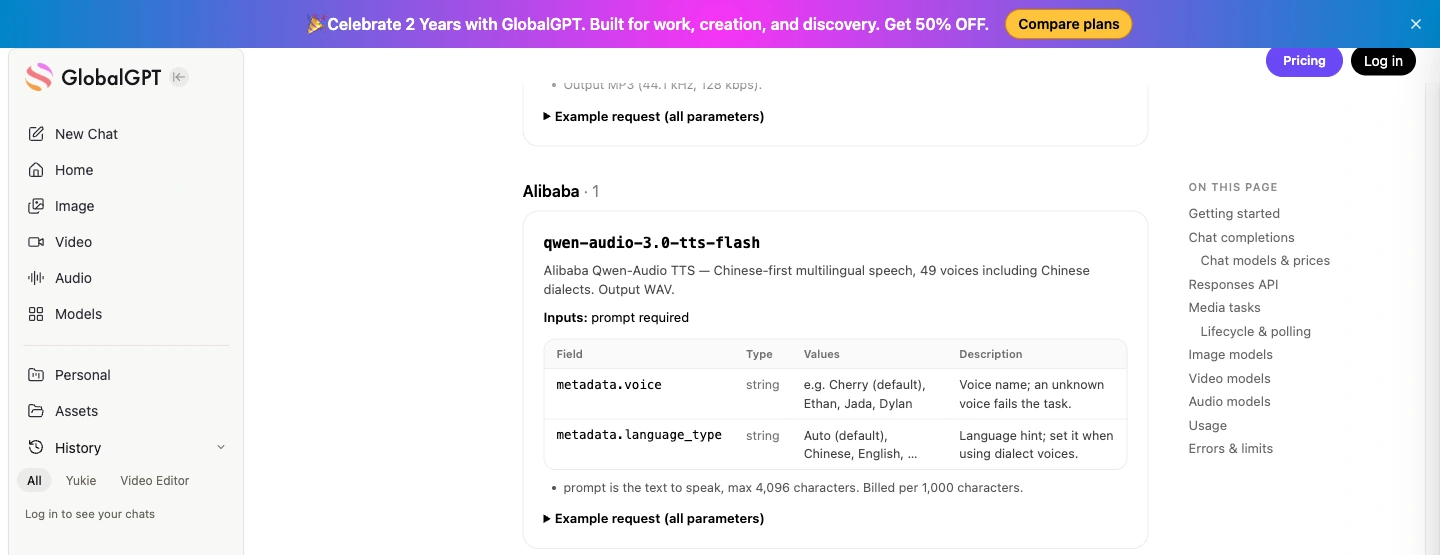
qwen-audio-3.0-tts-flash | Bis zu 4.096 Zeichen; WAV | 49 Stimmen; für die Sprach- und Sprachsteuerung werden Qwen-spezifische Felder verwendet. |
Liste aller drei Einträge 330 Credits pro 1.000 Zeichen. Verwenden Sie POST /tasks/estimate mit dem vorgesehenen Anfragetext für den entsprechenden Kostenvoranschlag; laut Dokumentation wird dadurch keine Aufgabe erstellt und es werden keine Guthaben reserviert. Der Zugriff über die öffentliche API erfolgt über bezahlte Guthaben.
Informationen zum gesamten Erstellungsworkflow finden Sie unter Text-to-Speech-Workflows in GlobalGPT. Wenn Sie sich mit der separat benannten Open-Source-Familie Qwen3-TTS beschäftigen, lesen Sie Qwen3-TTS-Modelle und API-Optionen; betrachten Sie die oben genannte Modell-ID „Qwen-Audio“ nicht als austauschbare Qwen3-TTS-Bereitstellung.
Kostenvoranschlag erstellen, einmal einreichen, dann den gespeicherten Auftrag abfragen
Installieren Sie Anfragen mit python -m pip install requests und festlegen GLOBALGPT_API_KEY auf dem Server. Im folgenden Beispiel wird „Eleven v3“ verwendet, eine dokumentierte öffentliche Sprach-ID ausgewählt und ein illustratives Limit von 500 Credits festgelegt. Passen Sie dieses Limit vor der Ausführung an Ihr eigenes Budget an.
GlobalGPT – Öffentliche TTS-Task-API · Python
"""Installiere requests; setze GLOBALGPT_API_KEY. Verwendet die öffentliche Task-API von GlobalGPT."""
import json
import os
import time
import uuid
from pathlib import Path
import requests

BASE = "https://api2.glbgpt.com/ai-api/open/v1"
STATE = Path("globalgpt-tts-job.json")
OUTPUT = Path("globalgpt-product-tour.mp3")
MAX_CREDITS = 500  # Ihr Limit pro Auftrag; vor der Ausführung bearbeiten.

payload = {
    "model": "eleven-v3",
    "prompt": (
 "Willkommen zur Produkt-Tour von Acorn Studio. In drei Schritten können Sie "
"ein kurzes Skript in einen Audio-Leitfaden verwandeln. Schreiben Sie zunächst die Nachricht. Wählen Sie als Nächstes "
"eine Stimme aus. Speichern Sie schließlich die Audiodatei und testen Sie die Wiedergabe auf Ihrem Smartphone."
    ),
    "metadata": {
 "voice_id": "JBFqnCBsd6RMkjVDRZzb",
 "stability": 0.5,
 "language_code": "en",
    },
}

api = requests.Session()
api.headers["Authorization"] = "Bearer " + os.environ["GLOBALGPT_API_KEY"]

if STATE.exists():
    job = json.loads(STATE.read_text())
    if job["payload"] != payload:
 raise RuntimeError("Dieser Auftrag gehört zu einer anderen Eingabe. Verwende einen neuen Dateinamen für den Status.")
else:
    estimate = api.post(BASE + "/tasks/estimate", json=payload, timeout=30)
    estimate.raise_for_status()
    quote = estimate.json()
    print("Geschätzte Credits:", quote["credits"])
    if quote["credits"] > MAX_CREDITS:
 raise RuntimeError("Die Schätzung überschreitet Ihr Limit pro Auftrag.")
    job = {"payload": payload, "idempotency_key": str(uuid.uuid4())}
    STATE.write_text(json.dumps(job, indent=2))

if "task_id" not in job:
    # Der persistierte Schlüssel verknüpft einen Transport-Wiederholungsversuch mit genau dieser Anfrage.
    submitted = api.post(
 BASE + "/tasks", json=payload,
 headers={"Idempotency-Key": job["idempotency_key"]}, timeout=60,
    )
    submitted.raise_for_status()
    task = submitted.json()
    job["task_id"] = task["id"]
    STATE.write_text(json.dumps(job, indent=2))
    if task.get("ignored_parameters"):
 print("Ignorierte Parameter:", task["ignored_parameters"])

print("Aufgabe:", job["task_id"])
deadline = time.monotonic() + 600
while time.monotonic() < deadline:
    checked = api.get(BASE + "/tasks/" + str(job["task_id"]), timeout=30)
    checked.raise_for_status()
    task = checked.json()
    if task.get("ignored_parameters"):
    print("Ignorierte Parameter:", task["ignored_parameters"])
    if task["status"] == "failed":
 raise RuntimeError("Generierung fehlgeschlagen: " + json.dumps(task.get("error", {})))
    if task["status"] == "succeeded":
        # Eine neue Anfrage verwenden: Den API-Schlüssel nicht an den Medienhost senden.
 audio = requests.get(task["output"]["url"], timeout=60)
 audio.raise_for_status()
        OUTPUT.write_bytes(audio.content)
 print("Gespeichert:", OUTPUT)
 break
    time.sleep(10)
else:
    raise TimeoutError("Aufgabe noch ausstehend. Erneut ausführen, um die gespeicherte Aufgaben-ID abzufragen.")
Die Jobdatei speichert die genaue Anfrage, einen Idempotenzschlüssel und die Aufgaben-ID. Sollte die Verbindung unterbrochen werden, führen Sie denselben Job erneut aus, damit der Code die bestehende Aufgabe fortsetzen kann. Um bewusst andere Audiodaten zu erzeugen, verwenden Sie einen neuen Jobdateinamen. Behalten Sie die Jobdatei für sich, falls das Skript vertrauliche Informationen enthält.
Siehe ignorierte_Parameter So wird eine nicht unterstützte Einstellung nicht stillschweigend zu Ihrer Standardkonfiguration. ElevenLabs-Steuerelemente wie voice_id sich von denen von Qwen unterscheiden Stimme und Sprachtyp Felder. Alle 5–10 Sekunden abfragen, eine fehlgeschlagen Status und speichern Sie erfolgreiche Dateien umgehend: Die dokumentierte Aufbewahrungsdauer der Ergebnisse beträgt 30 Tage.
Hören Sie sich zwei Beispiele für Produktrundgänge an
Diese beiden KI-generierten Beispiele basieren auf demselben 216 Zeichen langen Skript für eine Produktführung und wurden mit Eleven v3 sowie Qwen Audio 3.0 TTS Flash erstellt. Bei beiden handelt es sich um die erste Ausgabe einer Anfrage mit den Standard-Stimmeinstellungen. Sie erhalten zwei kurze Dateien zum Prüfen und Anhören; es handelt sich dabei weder um einen kontrollierten Vergleich gleichartiger Stimmen noch um einen OpenAI-Stimmen-Benchmark.
Eleven v3: Audio zur Produkttour
eleven-v3 · Beispiel für eine Produkttour
- Ausgabe
- MP3 · Mono · 44,1 kHz
- Länge
- Etwa 15,6 Sekunden
- Generation
- Erste Ausgabe · 1 Anfrage
Einstellungen: der untenstehende genaue Text, die Standardstimme und weitere Einstellungen; keine Übersteuerung der Stimme oder Vortragsanweisungen. Die Standardstimme wurde nicht aufgenommen.
Status und Zeitplan: Die Generierung war erfolgreich. Die Server-Zeitstempel der Aufgabe zeigen 13 Sekunden von der Übermittlung bis zum Abschluss an; hierbei handelt es sich um eine einzelne Anfrage und nicht um einen Latenz-Benchmark.
Dateibemerkung: Die MP3-Datei enthält einen Mono-Stream mit 44,1 kHz und ist etwa 251 kB groß. Ihre Frames können bis zum Ende der Datei gelesen werden.
Kostenangabe: Der öffentliche Katalogtarif beträgt 330 Credits pro 1.000 Zeichen. Verwenden Sie für eine neue Anfrage eine Aufwandsschätzung; dieser Tarif gilt nicht für die Rechnung über das Muster.
Praktische Anwendung: Eine kompakte MP3-Datei zum Anhören einer kurzen Produkttour. Überprüfen Sie den vollständigen Text und die Wiedergabe auf Ihrem Zielgerät, bevor Sie die Datei in einer Veröffentlichung verwenden.
Die genaue Eingabe lesen · 216 Zeichen
Willkommen zur Produkttour von Acorn Studio. In drei Schritten können Sie ein kurzes Skript in einen Audioguide verwandeln. Schreiben Sie zunächst den Text. Wählen Sie als Nächstes eine Stimme aus. Speichern Sie abschließend die Audiodatei und testen Sie die Wiedergabe auf Ihrem Smartphone.
Qwen Audio 3.0 TTS Flash: Audio zur Produktvorstellung
qwen-audio-3.0-tts-flash · Beispiel für eine Produkttour
- Ausgabe
- WAV · Mono · 24 kHz
- Länge
- 15,52 Sekunden PCM-Daten
- Generation
- Erste Ausgabe · 1 Anfrage
Einstellungen: der untenstehende genaue Text, die Standardstimme und weitere Einstellungen; keine Übersteuerung der Stimme oder Vortragsanweisungen. Die Standardstimme wurde nicht aufgenommen.
Status und Zeitplan: Die Generierung war erfolgreich. Die Server-Zeitstempel der Aufgabe zeigen 17 Sekunden von der Übermittlung bis zum Abschluss an; hierbei handelt es sich um eine einzelne Anfrage und nicht um einen Latenz-Benchmark.
Dateibemerkung: Die WAV-Datei enthält Mono-PCM mit 16 Bit bei 24 kHz und ist etwa 745 kB groß. Im Header sind mehr Daten angegeben, als die Datei tatsächlich enthält; die ursprüngliche Ausgabe wurde hier beibehalten.
Kostenangabe: Der öffentliche Katalogtarif beträgt 330 Credits pro 1.000 Zeichen. Verwenden Sie für eine neue Anfrage eine Aufwandsschätzung; dieser Tarif gilt nicht für die Rechnung über das Muster.
Praktische Anwendung: Ein WAV-Beispiel zur Bewertung eines Workflows für Sprachaufnahmen. Beheben Sie die Unstimmigkeiten bei der Header-Länge in Ihrer Produktionspipeline und überprüfen Sie die vollständige Wiedergabe vor der Veröffentlichung.
Die genaue Eingabe lesen · 216 Zeichen
Willkommen zur Produkttour von Acorn Studio. In drei Schritten können Sie ein kurzes Skript in einen Audioguide verwandeln. Schreiben Sie zunächst den Text. Wählen Sie als Nächstes eine Stimme aus. Speichern Sie abschließend die Audiodatei und testen Sie die Wiedergabe auf Ihrem Smartphone.
Das Qwen-Beispiel ist bei ähnlicher Dauer etwa dreimal so groß wie das Eleven-Beispiel, was auf die unterschiedlichen Formate WAV und MP3 zurückzuführen ist. Der WAV-Header gibt zudem mehr Daten an, als die Datei physisch enthält. Dies ist ein Problem bei der Dateiverpackung, das Sie in Ihrem Zielplayer überprüfen sollten; es sagt an sich nichts über die Qualität der gesprochenen Stimme aus.
Häufige Probleme bei der Sprachgenerierung beheben
| Symptom | Was Sie zuerst überprüfen sollten |
|---|---|
| Die gespeicherte MP3-Datei lässt sich nicht abspielen | Überprüfen Sie den HTTP-Status und den Antworttyp. Möglicherweise wurde ein API-Fehler mit einer Audio-Erweiterung gespeichert. |
| Der Befehl lehnt eine Sprachansage oder eine Anweisung ab | Ordnen Sie die Stimme und die optionalen Felder dem ausgewählten Modell zu. Ältere OpenAI-TTS-Modelle akzeptieren keine Anweisungen. |
| Ein langes Skript wird abgelehnt | Überprüfe die Zeichenbegrenzung der Route und das Limit für Mini-TTS-Token und teile den Text anschließend an natürlichen Trennstellen auf. |
| Es wird eine 401- oder 429-Antwort angezeigt | Überprüfen Sie den Schlüssel/das Konto auf den Status 401. Bei Status 429 sollten Sie vor einem erneuten Versuch zwischen Ratenbegrenzungen und unzureichendem Kontingent unterscheiden. |
| Ein GlobalGPT-Antrag ist noch offen | Die ID der gespeicherten Aufgabe abfragen und den Status prüfen; ein Timeout ist kein Grund, einen doppelten Auftrag einzureichen. |
| Die Stimme entspricht nicht den gewünschten Einstellungen. | Überprüfen Sie die modellspezifischen Metadaten und die „ignored_parameters“, bevor Sie davon ausgehen, dass die Einstellung übernommen wurde. |
| Die Audiolaufzeit oder der Suchbalken sieht falsch aus | Vergleichen Sie die Dateimetadaten mit den tatsächlichen Mediendaten und testen Sie die gesamte Datei in Ihrem Ziel-Player. |
Bei einem OpenAI-Fehler sollten Sie zunächst mit dessen Hinweise zu Fehlercodes. Speichern Sie bei einer GlobalGPT-Aufgabe die Aufgaben-ID und die Details des zurückgegebenen Fehlers. Trennen Sie während der Entwicklung Transportfehler, Abrechnungsfehler und eine nicht zufriedenstellende Sprachaufnahme voneinander: Für jeden dieser Fälle ist eine andere Lösung erforderlich.
Bevor Sie die Sprachausgabe versenden, hören Sie sich die gesamte Aufnahme auf dem Gerät an, das Ihre Zielgruppe verwenden wird. Überprüfen Sie den Einstieg, Namen und Zahlen, Übergänge sowie den Schlusssatz. Fügen Sie kurz vor dem Abspielen einen Hinweis auf die KI-Stimme ein und bewahren Sie eine Kopie des genauen Textes sowie der Modelleinstellungen auf, damit ein bearbeitetes Skript gezielt neu generiert werden kann.
Häufig gestellte Fragen
Was ist der Endpunkt der OpenAI Audio Speech API?
Verwenden Sie den POST-https://api.openai.com/v1/audio/speech. Die Pflichtfelder sind „model“, „input“ und „voice“. Die Antwort ist eine generierte Audiodatei; das Standardformat ist MP3.
Ist die OpenAI Speech API kostenlos?
Für die Speech-API gilt eine nutzungsabhängige Abrechnung. Planen Sie Ihr Budget anhand der aktuellen API-Tarife ein, anstatt von einem kostenlosen Kontingent auszugehen: GPT-4o Mini TTS wird nach Text- und Audio-Tokens abgerechnet, während TTS-1 und TTS-1 HD nach Zeichen abgerechnet werden.
Kann ich die Stimme und den Sprachstil beeinflussen?
Wählen Sie eine von Ihrem Modell unterstützte Stimme aus. GPT-4o Mini TTS akzeptiert auch Anweisungen zur Sprachausgabe, wie beispielsweise einen warmen oder ruhigen Tonfall. Das Feld für Anweisungen funktioniert nicht mit TTS-1 oder TTS-1 HD.
Unterstützt die Speech-API Streaming?
Ja. Es kann generierte Audiodaten in Blöcken streamen. Ihre Anwendung muss die Wiedergabe weiterhin übernehmen; das Streamen von Text-to-Speech allein reicht nicht aus, um ein vollständiges Live-Gespräch zu ermöglichen.
Kann ich GlobalGPT verwenden, indem ich die Basis-URL von OpenAI ändere?
Verwenden Sie den dokumentierten Medienaufgaben-Workflow von GlobalGPT für TTS: Senden Sie die Anfrage an POST /tasks, fragen Sie den Status mit GET /tasks/{id} ab und laden Sie nach erfolgreichem Abschluss die Datei unter output.url herunter. Der dokumentierte TTS-Katalog umfasst die Modelle ElevenLabs und Qwen mit ihren eigenen Modell-IDs und Parametern.
Mit welchem Audioformat sollte ich anfangen?
Beginnen Sie mit MP3, wenn Sie die Datei einfach herunterladen oder im Webplayer abspielen möchten. WAV eignet sich gut, wenn im nächsten Schritt eine Bearbeitung erfolgen soll. Für Raw-PCM benötigen Sie einen Player, der auf die jeweilige Abtastrate und Bittiefe eingestellt ist, da diese Dateien keinen Dateikopf haben.
Beginnen Sie mit einem kurzen Skript, einer Stimme und einer gespeicherten Datei. Sobald die Wiedergabe und die Kosten vorhersehbar sind, fügen Sie die Aufteilung in Abschnitte, Wiederholungsversuche und den Rest Ihres Medien-Workflows hinzu. Halten Sie das Anfrageformat, die Abrechnungseinheiten und die Ausgabeverarbeitung der gewählten API in Ihrer Implementierung einheitlich.
Verleihen Sie Ihrem nächsten Drehbuch eine Stimme
Entwerfen Sie eine kurze Produkttour, erstellen Sie einen Voiceover-Kommentar mit ElevenLabs oder Qwen und fahren Sie anschließend mit Bildern und Videos im Multi-Modell-Arbeitsbereich von GlobalGPT fort.
Sprachaudio mit GlobalGPT erstellen








