
Das NASA-IBM Lunar Foundation Model ist ein offenes KI-Modell zur Analyse von Mondbeobachtungen. Wie am 10. September 2026 bekannt gegeben wurde, lässt sich das Verfahren so anpassen, dass es Krater erkennt, vulkanische Strukturen umreißt und Muster in einer Karte zur Eisvorkommenswahrscheinlichkeit vorhersagt. Die gemeldeten Fortschritte beziehen sich auf spezifische Forschungsmaßstäbe: Das wichtigste Ergebnis in Bezug auf Eis ist ein geringerer Vorhersagefehler, nicht die Entdeckung von 22% mehr Wasser auf dem Mond.
Für Studierende und Forscher sind die folgenden Punkte nützliche Anhaltspunkte: offizielle Modellkarte, den technischen Bericht und den veröffentlichten Code. Zusammen erläutern sie, was das Modell gelernt hat, welche Aufgaben bewertet wurden und was Sie benötigen, um Ihr eigenes Experiment durchzuführen.
Wenn es bei Ihrer ersten Aufgabe darum geht, die Forschungsergebnisse zu verstehen, GlobalGPT vereint die Suche nach Quellen, die Analyse von Dokumenten, das logische Schlussfolgern und das Verfassen von Texten in einem einzigen, multimodalen Arbeitsbereich. Es bietet eine kostengünstige Möglichkeit, mit einem einzigen Abonnement von unbekannten wissenschaftlichen Begriffen zu einem klaren Forschungsauftrag zu gelangen.

Was ist das „Lunar Foundation Model“ der NASA und IBM?
Die Ankündigung der NASA stellt das Projekt als ein gemeinsam mit IBM entwickeltes Grundmodell für die Mondforschung vor. Ein Grundmodell lernt wiederverwendbare Muster aus einer umfangreichen Datensammlung; Forscher passen diese Muster anschließend an eine spezifischere Aufgabe an. In diesem Fall handelt es sich bei dem Material nicht um Alltagssprache, sondern um Fernerkundungsdaten vom Mond.
Das LFM-System der NASA und IBM nutzt einen Vision-Transformer-Encoder und -Decoder mit einer ViT-B-Architektur. Zu seinen Eingaben gehören Bilddaten und andere Beobachtungsprodukte mit unterschiedlichen räumlichen Auflösungen. Wissenschaftler können die daraus resultierende Darstellung für die Erkennung, Segmentierung oder Regression anpassen – drei Methoden zum Auffinden von Objekten, zum Umreißen von Bereichen und zum Vorhersagen numerischer Werte.
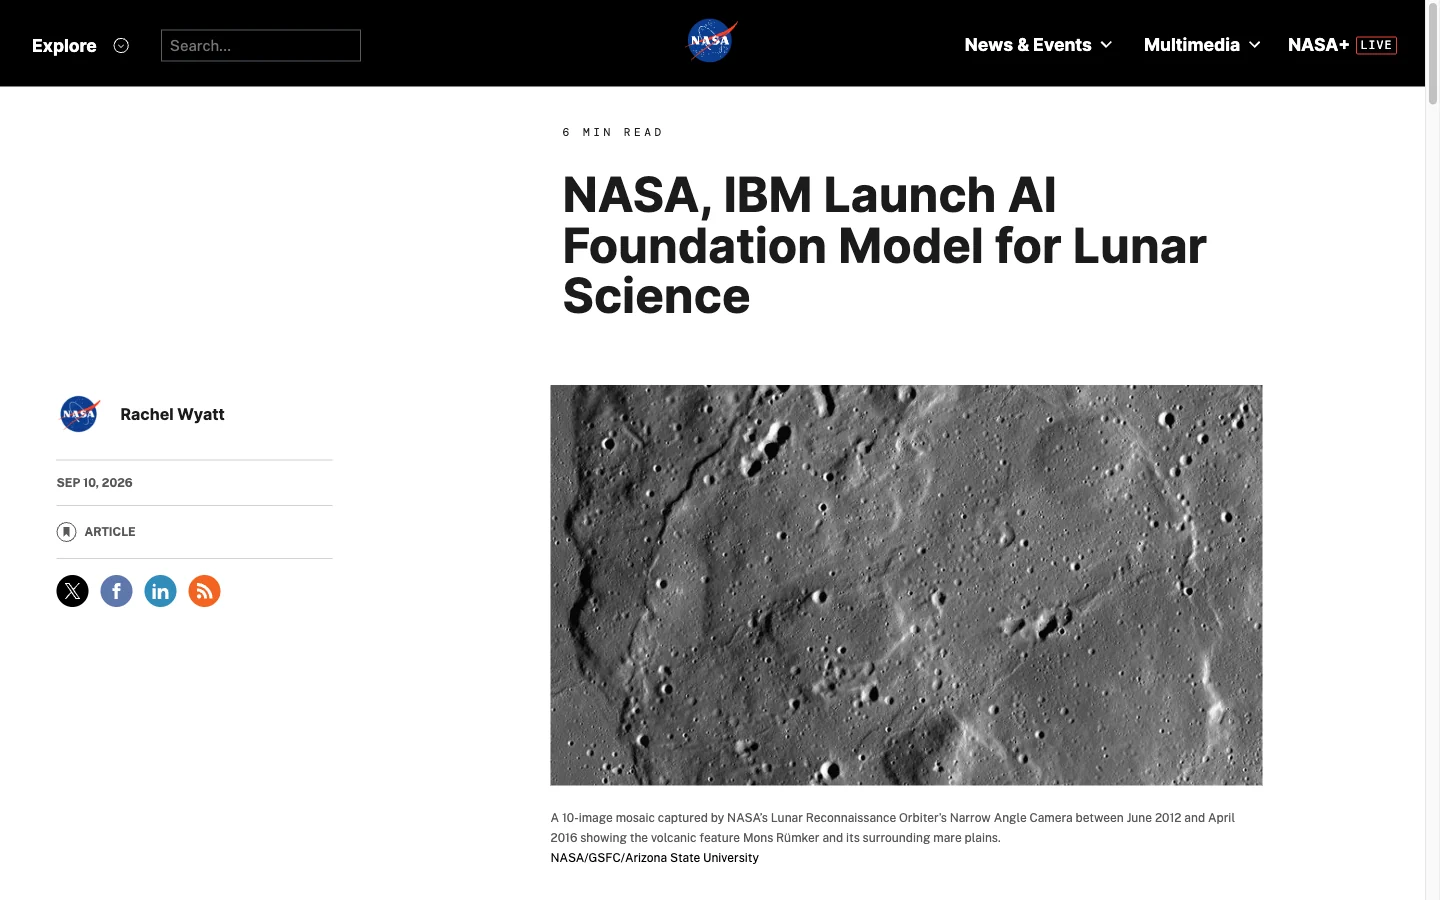
Dadurch ist diese Veröffentlichung für Teams, die mit Mondkarten arbeiten, sowie für Studierende, die sich mit maschinellem Lernen im Bereich der Planetenforschung beschäftigen, von Nutzen. Auch für alle, die verstehen möchten, wie ein wissenschaftliches KI-Modell evaluiert wird, lohnt es sich, das Projekt zu lesen. Die Verwendung des Checkpoints ist jedoch eher ein Forschungs-Computing-Workflow als eine Chat-Konversation.
Aus welchen Daten lernt es?
Die Modellkarte beschreibt die SomBench-Trainingsdaten: 963.609 Kachelbündel der Weitwinkelkamera (WAC) und 1.000.113 Kachelbündel der Schmalwinkelkamera (NAC). Der Maßstab der WAC-Bilder beträgt etwa 100 Meter pro Pixel; der Maßstab der NAC-Bilder beträgt etwa 1 Meter pro Pixel. Dadurch erhält das Modell anhand von rund zwei Millionen Bildbündeln sowohl einen umfassenderen Geländekontext als auch wesentlich feinere Oberflächendetails.
IBM beschreibt die umfassendere Datenressource als mehr als 30 abgeglichene Ebenen aus neun Instrumenten im Rahmen von vier Missionen. Die Modellkarte gibt 11 Eingabemodalitäten an. Diese Abbildungen beschreiben verschiedene Phasen der Datenpipeline: Quell-Ebenen, gepackte Trainingsbeispiele und die Arten von Eingaben, die das Modell kodiert.
Ein Projekt, drei verschiedene Zähleinheiten
IBM beschreibt eine Datenquelle, die aus den Daten von neun Instrumenten aus vier Missionen zusammengestellt wurde.
963.609 WAC-Pakete und 1.000.113 NAC-Pakete bieten Schulungsmaterial in zwei Umfangsstufen.
Das Modell berücksichtigt verschiedene Arten von Beobachtungsdaten, darunter Bilddaten und Geländedaten.
Quell-Ebenen, Kachelbündel und Eingabemodalitäten beziehen sich auf unterschiedliche Dinge. Quellen: Beschreibung des IBM-Datensatzes und die offizielle Modellkarte.
Auch die Beleuchtung ist Teil des Designs. Das Modell erhält Beobachtungsgeometrien, einschließlich Beleuchtungswinkeln, als expliziten Kontext. Dies hilft dabei, das Aussehen einer Oberfläche unter bestimmten Lichtverhältnissen von den zugrunde liegenden Geländemustern, die es lernt, zu unterscheiden.
Ein Pixel, das etwa 100 Meter Gelände darstellt, kann nicht dieselben Details wiedergeben wie ein Pixel, das etwa 1 Meter darstellt. Aus diesem Grund verdienen die Ergebnisse der WAC- und NAC-Kameras gesonderte Beachtung. Ein Gewinn bei großflächigen Aufnahmen bedeutet nicht zwangsläufig denselben Gewinn bei kleinen Oberflächenmerkmalen.
Das Projekt folgt dem TerraMind-Vortrainingsansatz, trainiert jedoch von Grund auf mit Monddaten. Es sollte daher als ein speziell für Mondbeobachtungen entwickeltes Modell verstanden werden und nicht als ein unter neuem Namen firmierender Checkpoint für die Erdbeobachtung. Die entscheidende Frage ist, inwiefern die erlernte Repräsentation bei einer bestimmten Mondaufgabe hilft.
Drei Aufgaben, bei denen es helfen kann
Die veröffentlichten Auswertungen decken drei Aufgabengruppen ab. Jede davon liefert eine andere Art von Antwort, sodass sich die Bedeutung von “besser” je nach Aufgabe ändert.
| Aufgabe | Ausgabe | Was das Ergebnis leisten kann |
|---|---|---|
| Kratererkennung | Begrenzungsrahmen um Krater in WAC- oder NAC-Aufnahmen | Vergleich, wie gut ein Detektor markierte Krater erkennt und lokalisiert. |
| Unregelmäßige Segmentierung des „Mare Patch“ | Eine auf Pixelebene detaillierte Darstellung der Oberflächenmerkmale von Vulkanen | Untersuchung, inwieweit die vorhergesagten Bereiche mit den beschrifteten Merkmalsgrenzen übereinstimmen. |
| Regression der Eisprospektivität in den Polarregionen | Eine kontinuierliche Vorhersage einer wissensbasierten Prospektivitätskarte | Untersuchung der Übereinstimmung mit einem modellierten Zielwert für mögliche eisbedingte Bedingungen. |
Die Erkennung von Kratern und die Segmentierung vulkanischer Merkmale können Forschern dabei helfen, Bildmaterial zu ordnen und zu analysieren. Ihr Nutzen hängt von den Klassifikationen, dem Maßstab und dem Untersuchungsgebiet ab. Ein Modell, das bei einem definierten Testdatensatz gute Ergebnisse liefert, muss dennoch anhand der Daten und der wissenschaftlichen Fragestellung eines neuen Projekts überprüft werden.
Die Eisprospektivität erfordert eine äußerst sorgfältige Interpretation. Das Ziel ist eine wissensbasierte Karte, die aufzeigt, wo Eis wahrscheinlich vorkommt, und keine direkte Messung von Eisvorkommen. Eine bessere Übereinstimmung mit dieser Karte kann die Erforschung von Mustern und in Frage kommenden Regionen unterstützen. Sie sagt uns jedoch nicht, dass eine zusätzliche Wassermenge gefunden wurde.
Was die Benchmark-Ergebnisse bedeuten
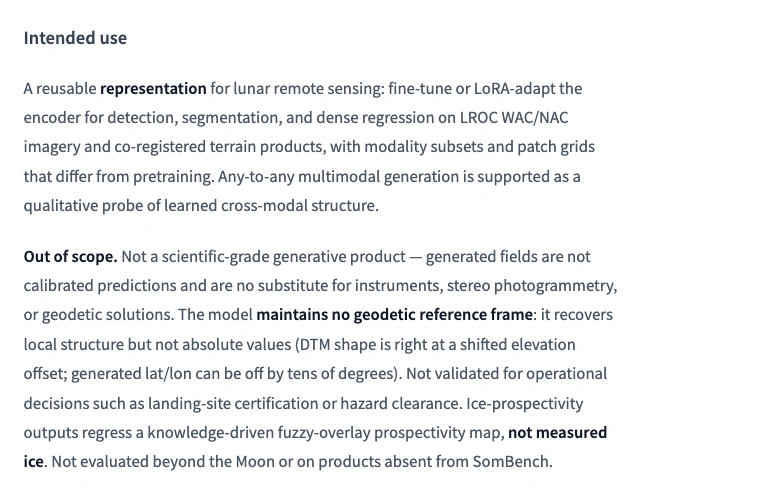
Die Technischer Bericht liefert Mittelwerte und Standardabweichungen für fünf zufällige Startwerte. Die Ergebnisse vergleichen angepasste Konfigurationen des Mondmodells mit benannten Basislinien des Sehmodells. Wir haben die veröffentlichten Tabellen überprüft; die Mond-Experimente haben wir nicht reproduziert.
Die Metriken beantworten unterschiedliche Fragen. Die mittlere durchschnittliche Präzision (mAP) bewertet die Objekterkennung; die Intersection over Union (IoU) misst die Überlappung zwischen vorhergesagten und beschrifteten Bereichen; der quadratische Mittelwertfehler (RMSE) misst den numerischen Vorhersagefehler. Höhere mAP- und IoU-Werte sind besser, während ein niedrigerer RMSE-Wert besser ist. Sie sollten nicht zu einem einzigen Genauigkeitswert zusammengefasst werden.
Fehler bei der Eisprospektivität: der deutlichste gemeldete Zuwachs
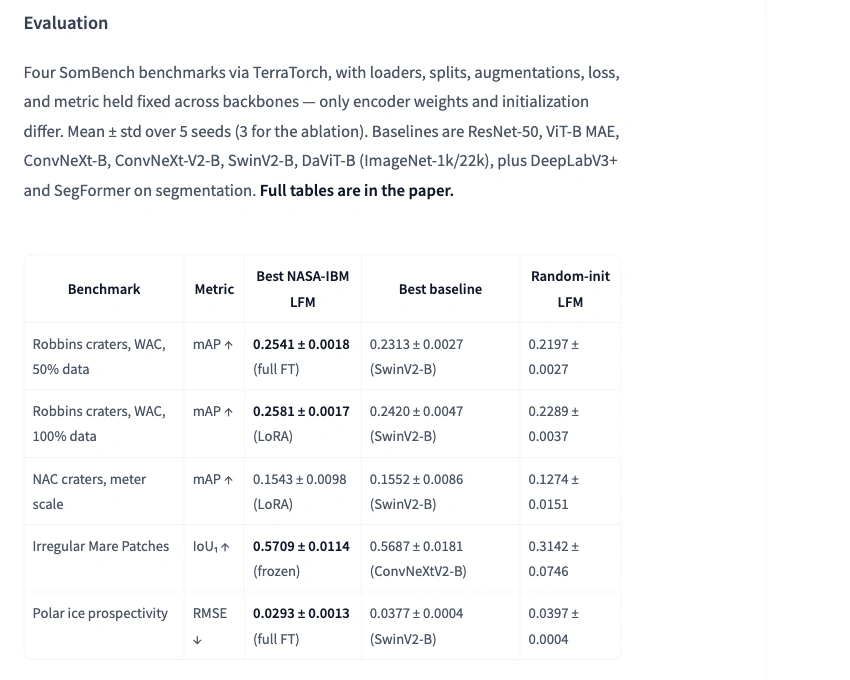
Der RMSE sank von 0,0377 bis 0,0293 gegen SwinV2-B, ein 22,31 TP40T relative Reduktion. Ein niedrigerer RMSE-Wert bedeutet eine bessere Übereinstimmung mit der Eisprospektivitätskarte des Referenzmodells.
RMSE: Je niedriger, desto besser. Die Balken beginnen bei Null. Mittelwert ± Standardabweichung über fünf Seeds. Das Ziel ist eine modellierte Prospektivitätskarte, keine Eismessung.
| Aufgabe und Daten | Metrisch ↑ | Mondmodell | Solide Ausgangsbasis |
|---|---|---|---|
| WAC-Krater · 50%-Trainingsdaten | mAP | 0,2541 ± 0,0018 vollständige Feinabstimmung | 0,2313 ± 0,0027 SwinV2-B |
| WAC-Krater · 100%-Trainingsdaten | mAP | 0,2581 ± 0,0017 LoRA | 0,2420 ± 0,0047 SwinV2-B |
| NAC-Krater · 100%-Trainingsdaten | mAP | 0,1543 ± 0,0098 LoRA | 0,1552 ± 0,0086 SwinV2-B |
| Unregelmäßige Flecken bei Stuten | IoU1 | 0,5709 ± 0,0114 eingefrorener Encoder | 0,5687 ± 0,0181 ConvNeXtV2-B |
Die Autoren beschreiben die Ergebnisse zu Kratern und vulkanischen Formationen im Meterbereich als mit soliden Referenzwerten vergleichbar. Die geringen Abweichungen sollten im Zusammenhang mit den Schwankungen zwischen den einzelnen Messdurchläufen betrachtet werden.
Quelle: Technischer Bericht der NASA und IBM, Tabellen 4–7, Seiten 16 und 18. Hierbei handelt es sich um die Ergebnisse der Autoren, nicht um eine unabhängige Reproduktion.
Das Ergebnis „22% ice“ bedeutet eine Verringerung des Fehlers
Was das Eisvorkommen betrifft, weist die stärkste gemeldete Mondkonfiguration einen RMSE von 0,0293 auf, gegenüber 0,0377 bei SwinV2-B. Die Berechnung lautet wie folgt: (0,0377 − 0,0293) ÷ 0,0377 × 100 = 22,3%. Der RMSE misst den Vorhersagefehler im Vergleich zur Zielkarte; je niedriger, desto besser. Dieser Prozentsatz ist weder ein Genauigkeitswert noch eine Angabe zur Veränderung der Menge an Mond-Eis.
Die Ergebnisse der Krateranalyse hängen von der Metrik und der Datenskala ab
Mit 50% der WAC-Trainingsdaten erreicht das Mondmodell einen mAP-Wert von 0,2541 gegenüber 0,2313 für SwinV2-B. Dasselbe Ergebnis des Mondmodells übertrifft auch den Wert von 0,2420 der Basislinie bei 100% Trainingsdaten. Der erste Vergleich verwendet gleiche Datenanteile; der zweite belegt die Effizienz der Klassifizierung in diesem speziellen Experiment.
Die Verbesserung von IBM um etwa 191 TP40T lässt sich mit den AP@75-Werten des Berichts bei 501 TP40T Trainingsdaten in Einklang bringen: 0,2213 gegenüber 0,1862, was einem relativen Anstieg von 18,91 TP40T entspricht. AP@75 bewertet Erkennungen bei einem bestimmten Überlappungsschwellenwert. Dies sollte nicht fälschlicherweise als Anstieg um 19% bei der mAP-Metrik in der Tabelle ausgewiesen werden.
Auf der feineren NAC-Skala beträgt der mAP des Mondmodells 0,1543 und der des Basismodells 0,1552. Bei „Irregular Mare Patches“ liegen die angegebenen IoU-Werte im Vordergrund bei 0,5709 bzw. 0,5687 im Vergleich zu ConvNeXtV2-B. Die Autoren beschreiben diese Aufgaben als vergleichbar mit starken Baseline-Modellen. Geringe Unterschiede sowie die angegebenen Schwankungen zwischen den Durchläufen stützen nicht die Behauptung, dass das Mondmodell in allen Fällen besser abschneidet.
Wo ist es erhältlich und wie hoch sind die Zugangsgebühren?
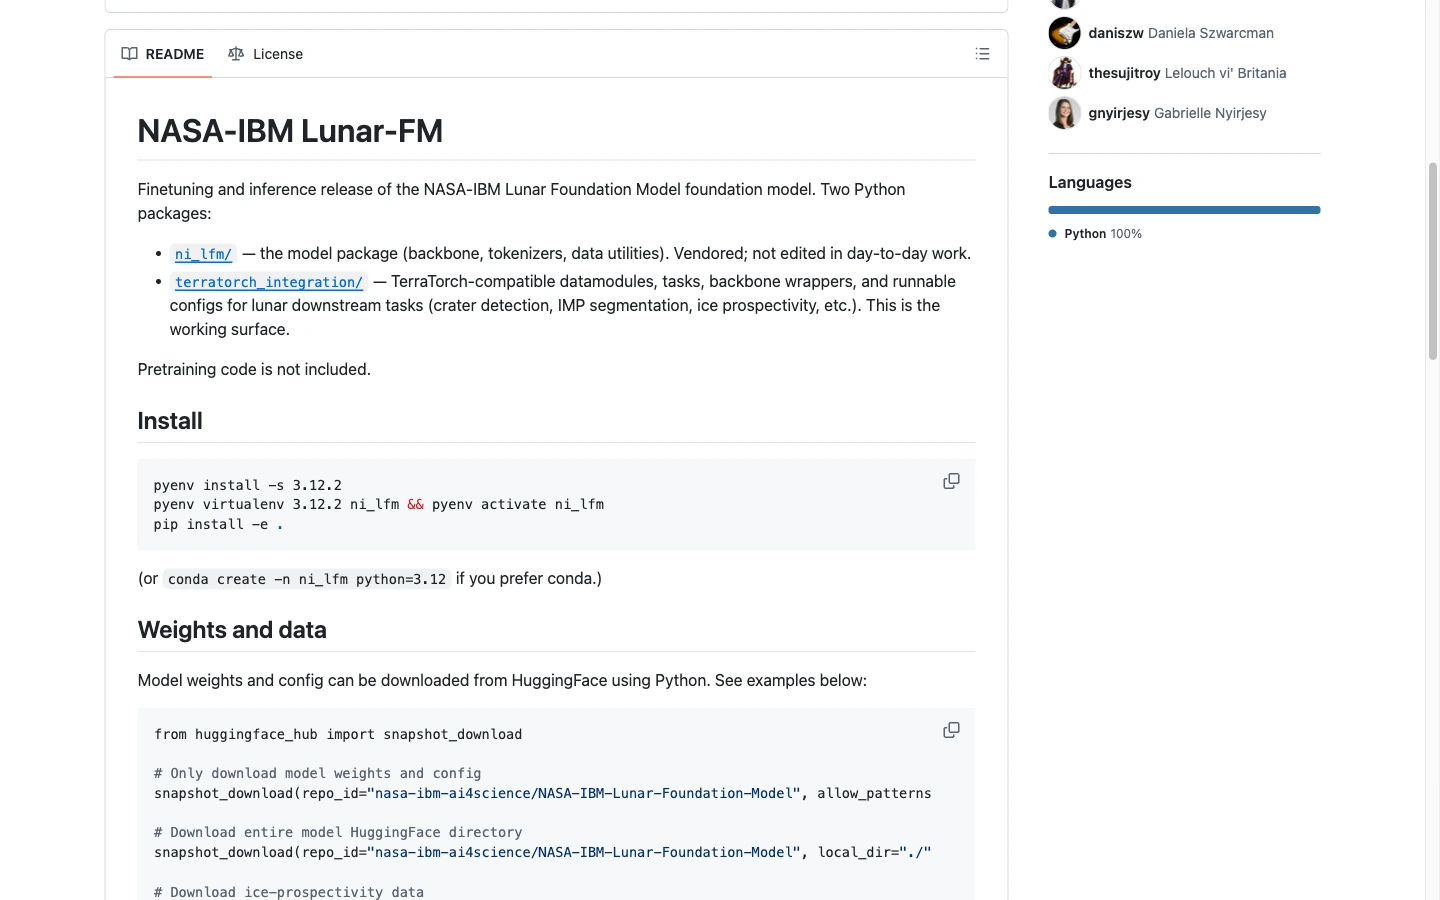
Beginnen Sie mit den unten aufgeführten offiziellen Ressourcen. Die Modellgewichte und der Code unterliegen der Apache-2.0-Lizenz, und der Checkpoint ist öffentlich zugänglich. Im Repository wird insbesondere ein Veröffentlichung der Feinabstimmung und der Inferenz; Vortrainingscode ist ausdrücklich ausgeschlossen.
Wählen Sie die Ressource für Ihren nächsten Schritt aus
Beginnen Sie mit den Verwendungszwecken, den Eingabedaten, den Lizenzbedingungen und den Einschränkungen.
Die Registerkarte „Dateien“ enthält den freigegebenen Prüfpunkt und die zugehörigen Dateien.
Nutzen Sie die README-Datei und die TerraTorch-Aufgabenkonfigurationen, um ein Experiment zu planen.
Folgen Sie der offiziellen Sammlung zu den zugehörigen nachgelagerten Modellen und Datensätzen.
Die Tabellen 4–7 enthalten die Ergebnisse der Aufgaben, die Einstellungen und die Schwankungen zwischen den Durchläufen.
Sehen Sie sich den Demo-Beitrag des Projekts an. Im Rahmen dieser Überprüfung haben wir keine Generierung durchgeführt.
Bei einer Überprüfung am 28. September 26 wurde festgestellt, dass in der Modellkarte kein bereitgestellter Hugging Face Inference Provider aufgeführt war. Ein herunterladbarer Checkpoint und eine Demonstrationsseite sind separate Zugriffsmöglichkeiten.
Wenn Sie das Modell anpassen möchten, wählen Sie die nachgelagerte Aufgabe aus, bevor Sie das Experiment einrichten. Das Repository stellt TerraTorch-kompatible Komponenten und Konfigurationen bereit, die den Checkpoint, die Aufgabe und die Daten miteinander verbinden. TerraTorch ist das Software-Framework, mit dem dieser Trainings- und Auswertungs-Workflow organisiert wird.
- Lesen Sie die Modellkarte und die README-Datei und wählen Sie dann je nach wissenschaftlicher Fragestellung zwischen Erkennung, Segmentierung oder Regression.
- Rufen Sie die entsprechenden Daten und den offiziellen Checkpoint ab und überprüfen Sie die Aufgabenkonfiguration sowie die Umgebungsanweisungen des Repositorys.
- Bereiten Sie die Daten für diese Konfiguration vor und führen Sie den entsprechenden Workflow zur Feinabstimmung oder zur Inferenz aus.
- Führen Sie eine Bewertung anhand einer geeigneten Referenz durch und speichern Sie die Datenaufteilung, die Einstellungen und die Ergebnisse, damit das Ergebnis überprüft werden kann.
Open Access macht den Kauf einer Modelllizenz überflüssig, doch die Durchführung eines Experiments ist nach wie vor mit Kosten verbunden. Man benötigt Rechenleistung, Speicherplatz, Datenaufbereitung und Zeit für die Auswertung. Ein veröffentlichter Checkpoint beinhaltet nicht automatisch eine gehostete API oder kostenlose GPU-Zeit, und die Quellen legen keine universelle Mindest-GPU-Leistung für jede nachgelagerte Aufgabe fest.
| Dein Ziel | Zu planende Ressourcen oder Kosten |
|---|---|
| Die Pressemitteilung lesen und bewerten | Öffentliche Bekanntmachungen, Modellkarte, Bericht und Archiv. |
| Das wissenschaftliche Modell ausführen oder anpassen | Geeignete Rechen- und Speicherressourcen, relevante Daten, Einrichtung der Umgebung und Auswertungsarbeiten. |
| Wissenschaftliche Artikel verstehen und einen Forschungsbericht verfassen | Ein Arbeitsbereich für wissenschaftliche Mitarbeiter wie beispielsweise GlobalGPT, der Modellzugriff und Dokumententools in einem Abonnement vereint. |
Nutzen Sie KI, um die Forschungsergebnisse zu verstehen
Eine konstruktive erste Frage ist konkret formuliert: “Was wird mit der angegebenen Verbesserung von 22% eigentlich gemessen?” Um diese Frage zu beantworten, braucht man ein Ziel, eine Kennzahl, einen Ausgangswert und eine Berechnung. Nach diesen vier Punkten zu fragen ist sinnvoller, als einen Assistenten zu fragen, ob das Modell beeindruckend ist.
Mit GlobalGPT können Sie Ihre Leseaufgaben – von der Quellenrecherche über die Erläuterung von Dokumenten bis hin zum Verfassen von Texten – durchführen, ohne bei jedem Schritt zwischen verschiedenen Tools wechseln zu müssen. Für eine wiederholbare Vorgehensweise, Erstellen Sie einen Forschungsbericht mit Quellenangaben mit einer kurzen Quellenliste und konkreten Fragen, bevor Sie eine ausgefeilte Zusammenfassung anfordern.
Von offiziellen Quellen zu einer nützlichen Zusammenfassung
- Sammeln Sie das Ausgangsmaterial. Beginnen Sie mit der Ankündigung der NASA und fügen Sie dann die Modellkarte, den technischen Bericht und die README-Datei hinzu. Sie können Untersuchung mit Perplexity an GlobalGPT um entsprechende Quellen zu finden.
- Stellen Sie gezielte Fragen. Lassen Sie einen Assistenten mAP, IoU und RMSE jeweils separat erklären und listen Sie anschließend hinter jeder Aussage das Ziel, die Basislinie und die Bewertungskonfiguration auf.
- Prüfen und aufschreiben. Öffnen Sie die angeführte Tabelle erneut, überprüfen Sie jede Zahl und fassen Sie die geprüften Notizen zu einem Bericht zusammen, der die wissenschaftlichen Grenzen berücksichtigt.
Wir haben eine vereinfachte Version dieses Arbeitsablaufs mit GPT-5.6 Sol getestet. Das System erhielt ein aus den vier offiziellen Quellen zusammengestelltes Datenpaket und sollte daraufhin eine kurze Zusammenfassung erstellen, sechs Behauptungen einordnen, die RMSE-Reduktion berechnen und praktische nächste Schritte vorschlagen. Die Aufgabe stützte sich auf den bereitgestellten Text; es wurde nicht nach neuen Belegen gesucht.
Ein quellenbasierter Briefing-Test
Wir haben GPT-5.6 Sol ein kurzes Paket mit Informationen aus der Ankündigung der NASA, der offiziellen Modellkarte, dem technischen Bericht und der GitHub-README-Datei zur Verfügung gestellt. Es sollte eine Zusammenfassung verfassen, sechs Aussagen überprüfen und die Berechnung des RMSE erläutern.
- Arbeitsbereich und Datum
- GlobalGPT · 28. September 2026
- Richtlinie ausführen
- Eine Aufgabe; erste vollständige Antwort; keine Wiederholungsversuche
- Eingabe
- Quellpaket mit 355 Wörtern und vier Quellen-IDs
- Umfang
- Auslesen und Synthese; keine Live-Suche oder Ausführung des Mondmodells
- Antwort-Einstellungen
- Obergrenze für Ausgabetoken: 4.096; alle anderen Abtaststeuerungen bleiben auf den Standardwerten des Dienstes
- Nutzung und Kosten
- Insgesamt wurden 2.154 Token gemeldet; die Antwort enthielt keine Angabe zum Wert.
In der ersten Antwort wurden die wissenschaftlichen Behauptungen im Rahmen gehalten
Die Antwort ergab einen 112 Wörter umfassenden Bericht, in dem die Behauptung zurückgewiesen wurde, das Modell habe 22% mehr echtes Eis entdeckt, und in dem die Einschränkungen hinsichtlich der Zertifizierung von Landeplätzen und des Zugriffs auf den Vortrainingscode beibehalten wurden. Die drei nächsten Schritte verwiesen zurück auf die offizielle Modellkarte, den Checkpoint und die TerraTorch-Ressourcen.
Hierbei handelte es sich um eine Leseaufgabe unter Verwendung von bereitgestelltem Material. Die wichtigsten Einschränkungen waren bereits im Quellenpaket angegeben. Das Ergebnis sagt nichts über die Leistung bei eigenständiger Recherche oder bei Schlussfolgerungen aus der Fernerkundung des Mondes aus.
Die genaue Eingabeaufforderung und das Quellpaket anzeigen
SYSTEM
Sie sind ein sorgfältiger wissenschaftlicher Redakteur, der für einen Studenten schreibt. Verwenden Sie ausschließlich das bereitgestellte Quellenpaket. Recherchieren Sie nicht zusätzlich. Unterscheiden Sie zwischen gemeldeten Benchmark-Messwerten und tatsächlichen wissenschaftlichen Messungen. Geben Sie Quellen-IDs in eckigen Klammern an. Wenn eine Behauptung nicht belegt ist, weisen Sie klar darauf hin. Erfinden Sie keine Zitate, Preise, Hardwareanforderungen oder Versuchsergebnisse. Geben Sie die gewünschte Antwort, keine versteckten Überlegungen.

BENUTZER
Verwandeln Sie das Quellenpaket in einen praktischen Forschungsbericht. Liefern Sie Folgendes: (1) eine in leicht verständlichem Englisch verfasste Zusammenfassung von 100–130 Wörtern; (2) eine sechszeilige Tabelle zur Überprüfung der Behauptungen, in der für jede angegebene Behauptung genau „belegt“ oder „nicht belegt“ angegeben wird, zusammen mit einer Quellen-ID und einer einzeiligen Erklärung; (3) die relative RMSE-Reduktion, berechnet von 0,0377 auf 0,0293, gerundet auf eine Dezimalstelle, mit einer Formel und einem Satz, der erklärt, was damit nicht gemessen wird; (4) drei praktische nächste Schritte für einen Studenten, der das veröffentlichte Modell untersuchen oder anpassen möchte. Die gesamte Antwort sollte weniger als 500 Wörter umfassen.

Zu prüfende Behauptungen:
1. Die NASA und IBM haben das Modell am 10. September 2026 öffentlich vorgestellt.
2. Der angegebene RMSE für die Eisprospektivität sank von 0,0377 für SwinV2-B auf 0,0293 für das vollständig feinabgestimmte Mondmodell.
3. Das Modell entdeckte 22% mehr echtes Wassereis auf dem Mond.
4. Die NASA hat dieses Modell für die Zertifizierung von Landeplätzen und die Gefahrenfreigabe validiert.
5. Die GitHub-Veröffentlichung enthält den Code für das Vortraining.
6. Ein offener Checkpoint garantiert, dass GPU-Rechenleistung und gehostete Inferenz kostenlos sind.

Quellpaket:
[S1] NASA-Mitteilung, 10. September 2026.
Titel: NASA und IBM stellen KI-Grundmodell für die Mondforschung vor.
URL: https://science.nasa.gov/science-research/artificial-intelligence-lunar-foundation-model/
Die NASA kündigte ein gemeinsam mit IBM entwickeltes Basismodell für die Mondforschung an. Es wird öffentlich auf Hugging Face gehostet, der Code ist auf GitHub verfügbar. Es lässt sich für die Kartierung von Kratern, die Identifizierung vulkanischer Merkmale und die Erforschung des Polareises anpassen.

[S2] Offizielle Modellkarte und technischer Bericht der NASA und IBM, abgerufen am 28. September 2026.
URL der Modellkarte: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
URL des technischen Berichts: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model/blob/main/NI_LFM_Technical_Report.pdf
Tabelle 7 des Berichts (Seite 18) enthält den Root Mean Squared Error (RMSE) des Testdatensatzes für die Regression der Eisprospektivität. Je niedriger, desto besser. Mittelwert plus/minus Standardabweichung über fünf zufällige Startwerte: NASA-IBM LFM mit vollständiger Feinabstimmung, 0,0293 ± 0,0013; ImageNet-vortrainiertes SwinV2-B, 0,0377 ± 0,0004. Das Ziel ist eine wissensbasierte Karte der Eisprospektivität. Hierbei handelt es sich um von den Autoren angegebene Benchmark-Ergebnisse, nicht um eine unabhängige Reproduktion oder eine direkte Messung von Wassereis.
Tabelle 4 (Seite 16), WAC-Krater mit 50%-Trainingsdaten: Der mAP für Bounding-Boxen beträgt 0,2541 ± 0,0018 für das vollständig feinabgestimmte LFM und 0,2313 ± 0,0027 für SwinV2-B. In denselben Zeilen beträgt AP@75 0,2213 ± 0,0028 bzw. 0,1862 ± 0,0041. Diese Metriken dürfen nicht vertauscht werden.

[S3] Offizielle Modellkarte, Verwendungszweck / Nicht im Anwendungsbereich / Einschränkungen.
URL: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
Der Verwendungszweck ist die Fernerkundung des Mondes durch Feinabstimmung oder LoRA-Anpassung für Erkennung, Segmentierung und dichte Regression. Das Modell ist nicht für die Zertifizierung von Landeplätzen oder die Gefahrenabklärung validiert. Die Ergebnisse zur Eisprospektivität bilden eine wissensbasierte Karte ab, nicht gemessene Eismengen. Die generierten Felder sind qualitative Anhaltspunkte, keine kalibrierten wissenschaftlichen Vorhersagen. Das Modell verwendet keinen absoluten geodätischen Referenzrahmen. Es wurde nicht über den Mond hinaus evaluiert. Die angegebene Lizenz ist Apache-2.0. Auf der Seite wird kein Einsatz eines Inferenz-Providers angegeben. Dieses Paket beinhaltet keine Zusage für kostenlose GPU-Rechenleistung oder kostenlos gehostete Inferenz sowie keine Angaben zu Mindesthardwareanforderungen oder Preisen für gehostete APIs.

[S4] Offizielles GitHub-README, geprüft am 28. September 2026.
URL: https://github.com/NASA-IMPACT/NASA-IBM-Lunar-Foundation-Model
Das Repository beschreibt eine Version für Feinabstimmung und Inferenz. Code für das Vortraining ist nicht enthalten. Gewichte und Konfiguration können aus dem offiziellen Hugging-Face-Modell-Repository heruntergeladen werden. Es werden TerraTorch-kompatible Datenmodule, Tasks, Backbone-Wrapper und Task-Konfigurationen bereitgestellt. Für das Fine-Tuning und das Testen sind die entsprechenden Daten, Checkpoints und Task-Konfigurationen erforderlich. Die README-Datei führt eine Apache-2.0-Lizenz auf.
Die vollständige erste Antwort anzeigen
## 1. Hintergrundinformationen

Die NASA und IBM haben am 10. September 2026 das „Lunar Foundation Model“ vorgestellt. Die öffentliche Veröffentlichung umfasst Gewichte auf Hugging Face sowie Code für das Fine-Tuning und die Inferenz auf GitHub und zielt auf Fernerkundungsaufgaben auf dem Mond ab, wie beispielsweise die Kartierung von Kratern, die Identifizierung vulkanischer Merkmale und die Erforschung des Polareises. Der angegebene Benchmark für die Eisprospektivität verbessert den RMSE gegenüber einem mit ImageNet vortrainierten SwinV2-B, doch das Ziel ist eine wissensbasierte Karte und nicht direkt gemessenes Mond-Eis. Das Ergebnis wurde von den Autoren über fünf zufällige Startwerte berichtet und ist keine unabhängige Replikation. Das Modell ist für die Anpassung durch vollständiges Feinabstimmen oder LoRA vorgesehen, wurde jedoch nicht für die Zertifizierung von Landeplätzen oder die Gefahrenabklärung validiert. Vortrainierungscode fehlt, und die Veröffentlichung verspricht weder kostenlose GPU-Rechenleistung noch gehostete Inferenz. [S1][S2][S3][S4]

## 2. Tabelle zur Überprüfung der Behauptungen

| Behauptung | Urteil | Quelle | Erläuterung |
|---|---|---|---|
| 1 | Bestätigt | [S1] | Die Ankündigung der NASA stammt vom 10. September 2026 und identifiziert das Modell als ein NASA-IBM-Projekt. |
| 2 | Bestätigt | [S2] | Tabelle 7 gibt RMSE-Werte von 0,0377 für SwinV2-B und 0,0293 für das vollständig feinabgestimmte Mondmodell an. |
| 3 | Nicht unterstützt | [S2] | Bei den Zahlen handelt es sich um Benchmark-Fehler im Vergleich zu einer wissensbasierten Prospektivitätskarte, nicht um Messungen von echtem Wassereis auf dem Mond. |
| 4 | Nicht unterstützt | [S3] | In der Modellbeschreibung wird ausdrücklich darauf hingewiesen, dass das Modell nicht für die Zertifizierung von Landeplätzen oder die Gefahrenabklärung validiert ist. |
| 5 | Nicht unterstützt | [S4] | Das GitHub-Repository stellt Ressourcen für die Feinabstimmung und Inferenz bereit, enthält jedoch keinen Code für das Vortraining. |
| 6 | Nicht unterstützt | [S3] | Das Paket verspricht keine kostenlose GPU-Rechenleistung oder gehostete Inferenz und gibt keine Bereitstellung durch einen Inferenzanbieter an. |

## 3. Relative RMSE-Reduktion

\[
\frac{0,0377-0,0293}{0,0377}\times 100 = 22,3\%
\]

Dies entspricht einer **relativen Reduzierung des von den Autoren angegebenen Benchmark-RMSE um 22,3%**; dabei werden weder zusätzlich entdeckte echte Wassereisvorkommen noch unabhängig validierte wissenschaftliche Leistungen berücksichtigt. [S2]

## 4. Praktische nächste Schritte

1. Lesen Sie die vorgesehenen Verwendungszwecke, Einschränkungen und die Apache-2.0-Lizenz der Modellkarte, bevor Sie eine Erkennungs-, Segmentierungs- oder Regressionsaufgabe auswählen. [S3]
2. Laden Sie den offiziellen Checkpoint und die Konfiguration von Hugging Face herunter und prüfen Sie anschließend die GitHub-Backbone-Wrapper und Aufgabenkonfigurationen. [S4]
3. Besorgen Sie sich den entsprechenden Monddatensatz und nutzen Sie die bereitgestellten TerraTorch-kompatiblen Komponenten zur Feinabstimmung und zum Testen. Dokumentieren Sie dabei, dass kein Vortrainingscode verfügbar ist und die Benchmark-Ergebnisse einer unabhängigen Bewertung bedürfen. [S2][S4]
Das nützliche Ergebnis war die Beibehaltung der Unterscheidungen: Benchmark-Fehler gegenüber entdecktem Eis, Forschungszwecke gegenüber Landegenehmigung sowie freigegebener Anpassungscode gegenüber fehlendem Vortrainingscode. Da diese Einschränkungen bereits im Quellpaket enthalten waren, ist dies ein Beleg für eine erfolgreiche Lese- und Syntheseaufgabe, jedoch kein Beweis dafür, dass ein Assistent jede Einschränkung eigenständig aufdecken würde.
Bei einem größeren Projekt, eine intensivere, KI-gestützte Forschungssitzung planen Beziehen Sie sich dabei auf einzelne Fragen zu Daten, Methoden, Auswertung und Einschränkungen. Legen Sie die Quelltabelle neben den Entwurf und überprüfen Sie jede Zahl nach der Bearbeitung noch einmal. Diese Gewohnheit ist wichtiger als die Frage, wie flüssig die erste Zusammenfassung klingt.
Grenzwerte, die in der Praxis von Bedeutung sind
Auf der Modellkarte heißt es, dass das Mondmodell nicht für operative Entscheidungen wie die Zertifizierung von Landeplätzen oder die Gefahrenfreigabe validiert wurde. Ein wissenschaftliches Modell kann dabei helfen, Beobachtungen zu untersuchen, ohne dass bereits bestätigt werden kann, dass ein Raumfahrzeug an einem bestimmten Ort sicher landen kann. Für solche Anwendungen ist ein anderes Validierungsniveau erforderlich.
Auch bei generierten Feldern ist Vorsicht geboten. Das Modell verwendet keinen absoluten geodätischen Bezugsrahmen, und die generierten Werte können von den physikalischen Werten abweichen. Die Autoren beschreiben die Generierung eher als qualitative Untersuchung denn als kalibrierte wissenschaftliche Vorhersage. Eine plausibel erscheinende Gelände- oder Beobachtungskarte sollte nicht als vermessenes Produkt interpretiert werden.
Der Checkpoint wurde über den Mond hinaus noch nicht evaluiert. Selbst innerhalb der Mondforschung ist die Bilanz gemischt: deutliche Verbesserungen bei einigen Aufgaben und vergleichbare Ergebnisse bei anderen. Die berechtigte Schlussfolgerung lautet, das Modell anhand des Ziels, des Maßstabs, der Daten und der Basislinie zu bewerten, die Ihrem Experiment entsprechen.
Häufig gestellte Fragen
Ist das „Lunar Foundation Model“ von NASA und IBM kostenlos nutzbar?
Die offizielle Modellkarte und das Code-Repository verweisen auf eine Apache-2.0-Lizenz, und der Checkpoint ist öffentlich zugänglich. Die Durchführung von Experimenten erfordert jedoch weiterhin geeignete Rechenressourcen, Datenaufbereitung und eine aufgabenspezifische Auswertung. Der offene Zugang zum Modell bietet keine Garantie für kostenlose GPU-Rechenleistung oder gehostete Inferenz.
Ist das „Lunar Foundation Model“ von NASA und IBM ein Chatbot?
Es handelt sich um ein Basismodell für die Fernerkundung des Mondes, das für die Verarbeitung von Bildmaterial, Geländedaten und zugehörigen Beobachtungsdaten entwickelt wurde. Forscher passen es für Erkennungs-, Segmentierungs- und Regressionsaufgaben an. Ein Chat-Assistent kann bei der Erläuterung der Dokumentation helfen, doch die Interaktion mit einem Chatbot ist ein anderer Arbeitsablauf als die Ausführung dieses Modells.
Hat das Modell weiteres Wassereis auf dem Mond entdeckt?
Das angegebene Eisergebnis misst, wie gut die Vorhersagen mit einer wissensbasierten Karte zur Eisvorkommenwahrscheinlichkeit übereinstimmen. Der beste gemeldete RMSE sinkt im Vergleich zur zitierten Basislinie von 0,0377 auf 0,0293, was einer relativen Verringerung von etwa 22% entspricht. Dies ist eine Verbesserung des Benchmark-Werts; es handelt sich nicht um eine Messung zusätzlich entdeckter Eisvorkommen.
Kann ich mich mit dem Projekt vertraut machen, ohne Code zu schreiben?
Sie können die Ankündigung der NASA lesen, die Modellkarte einsehen, die veröffentlichten Benchmark-Tabellen erkunden und die offizielle Demonstrationsseite besuchen, ohne eine Trainingspipeline aufbauen zu müssen. Zur Anpassung des veröffentlichten Checkpoints an eine wissenschaftliche Aufgabe werden der Code, die Daten und die TerraTorch-Konfigurationen aus dem Repository verwendet, gefolgt von einer aufgabenspezifischen Validierung.
In welcher Beziehung steht das Mondmodell zu Prithvi und Surya?
Sie sind Teil der umfassenderen Zusammenarbeit zwischen der NASA und IBM im Bereich der Grundmodelle für die Wissenschaft. Die NASA beschreibt die Prithvi-Modelle für Erdbeobachtungen und Wetteranwendungen, Surya für die Heliophysik und das Mondmodell für Mondbeobachtungen. Ihre Anwendungsbereiche und vorgesehenen Aufgaben unterscheiden sich; der Mond-Checkpoint wurde bislang nicht über den Mond hinaus evaluiert.
Das „NASA-IBM Lunar Foundation Model“ bietet einen wiederverwendbaren Ausgangspunkt für die Forschung im Bereich der Fernerkundung des Mondes. Nutzen Sie die offiziellen Tabellen, um die Stärken des Modells zu verstehen, die Modellkarte, um seine Grenzen zu definieren, und die veröffentlichten Ressourcen, um ein auf Ihre Aufgabe zugeschnittenes Experiment zu planen. Wenn Ihr unmittelbares Ziel das Lernen oder das Verfassen eines Textes ist, beginnen Sie damit, diese Quellen in eine geprüfte Zusammenfassung umzuwandeln.
Verwandeln Sie einen Fachartikel in ein Briefing, das Sie nutzen können
Bringen Sie Ihre offiziellen Quellen in GlobalGPT ein, setzen Sie sich mit unbekannten Konzepten auseinander und verarbeiten Sie die geprüften Ergebnisse zu übersichtlichen Notizen oder einem fertigen Entwurf – alles in einem einzigen, modellübergreifenden Arbeitsbereich.
Entdecken Sie die Forschung mit GlobalGPT








