Aktualisiert am 18. September 2026.
Unser Fazit: GPT-6 Astra lieferte bei allen drei unserer Testanfragen brauchbare Antworten: Auftragsabgleich, eine Python-Aggregationsfunktion und eine Suche nach Richtlinien für 500 Notizen. Es ging korrekt mit fehlenden Werten und widersprüchlichen Regeln um, und die von ihm generierte Funktion bestand 10 Offline-Prüfungen. Damit ist das Modell für sorgfältige analytische Arbeiten eine Überlegung wert – allerdings lassen drei kleine Tests noch keine Rückschlüsse auf die Zuverlässigkeit im Produktiveinsatz oder die Überlegenheit gegenüber anderen Modellen zu.
Wir haben angerufen gpt-6-astra über den CLI-gestützten Modelldienst von GlobalGPT, wobei synthetische Eingaben verwendet und die Rohantworten gespeichert wurden. Es handelte sich hierbei weder um einen direkten OpenAI-API-Test noch um einen ChatGPT-Abonnementtest. Die End-to-End-Aufrufe dauerten in diesem Durchlauf 4,87–9,07 Sekunden, und der Kontostand verringerte sich um 391,08 Credits.
Dieser Testbericht zeigt, was wir abgefragt haben, welche Ergebnisse Astra geliefert hat, was die Anforderungen erfüllt hat und wo die Nachweise enden. Die offiziellen technischen Daten und Preise werden getrennt von unseren Messwerten aufgeführt.

Inhaltsverzeichnis
- Erfahrungsberichte zum GPT-6 Astra
- Wie wir Astra über die API getestet haben
- Test 1: Kann Astra unübersichtliche Bestelldaten abgleichen?
- Test 2: Funktioniert der generierte Code tatsächlich?
- Test 3: Kann das System widersprüchliche Regeln in einem langen Paket auflösen?
- Was diese API-Routen-Tests kosten
- Ist GPT-6 Astra verfügbar?
- Technische Daten des GPT-6 Astra
- Preise für die GPT-6 Astra-API
- Was ist eigentlich neu bei GPT-6 Astra?
- Warum Astra die Kaufentscheidung beeinflusst
- Was erste Rezensenten sagen
- Anfängliche Einschränkungen und offene Fragen
- Für wen ist GPT-6 Astra geeignet?
- Wählen Sie je nach Einsatzzweck den Astra oder ein kleineres Modell
- Was diese Untersuchung nach wie vor nicht belegt
- Häufig gestellte Fragen
Erfahrungsberichte zum GPT-6 Astra
| Test | Beobachtetes Ergebnis | Fahrzeit | Eingabe-/Ausgabe-Token | Gutschriften im Hauptbuch |
|---|---|---|---|---|
| Auftragsabgleich | 5 von 5 Antwortprüfungen bestanden | 5,663 s | 2,171 / 144 | 67 |
| Aggregationsfunktion in Python | 10 von 10 Offline-Fällen bestanden | 9,065 s | 2,091 / 486 | 105 |
| Paket mit 500 Merkblättern | 6 von 6 Antworten richtig; für alle sechs sind die erforderlichen Quellen angegeben | 4,868 s | 17,445 / 160 | 219 |
Es handelt sich um drei verschiedene Aufgaben mit jeweils einem Modellaufruf – nicht um wiederholte Versuche oder eine gemessene Erfolgsquote von 100%. Die Zeitmessung umfasst den gesamten CLI-/Provider-Aufruf bis zur Rückgabe des Ergebnisses; die Zeit bis zum ersten Token wurde nicht gemessen. Im Ledger werden ganze Guthaben angezeigt, während die Saldenänderung auch Bruchteile berücksichtigt.
Wie wir Astra über die API getestet haben
Wir haben für alle drei Aufrufe dasselbe bestehende GlobalGPT-Konto verwendet. Bei jedem Aufruf handelte es sich um eine neue, zustandslose Anfrage, wobei die Aufgabe als Textdatei bereitgestellt wurde. Die angeforderte und zurückgegebene Modellbezeichnung lautete gpt-6-astra. Der Dienst gab einen Antworttext, Angaben zur Verwendung von Eingabe-/Ausgabe-Token sowie ein Fehlerfeld zurück; bei keinem der drei Ergebnisse wurde ein Fehler gemeldet. Die Kennzeichnung durch den Anbieter stellt keine unabhängige Prüfung der vorgelagerten Modellroute dar.
Wir haben vor den Anrufen den Antwortschlüssel für die Aufträge und die Antworten für die Richtlinienpakete vorbereitet. Anschließend haben wir den generierten Code lokal anhand von 10 Fällen validiert, die wir nach Erhalt des Codes erstellt hatten; dabei handelte es sich nicht um einen vorab registrierten Kodierungs-Benchmark. Wir haben in der Eingabeaufforderung JSON angefordert und geprüft, ob dieser geparst wurde, anstatt ein natives Schema für strukturierte Ausgaben zu aktivieren.
Alle Eingaben wurden erfunden. Es wurden keine Kundendaten, Unternehmensunterlagen, Kontogeheimnisse oder personenbezogene Daten übermittelt. Wir haben für die Aufgaben keine Tools zum Durchsuchen oder zur Computersteuerung bereitgestellt und haben keine Antworten wiederholt, um deren Punktzahl zu verbessern. Die CLI hat für diese Durchläufe weder die Einstellung für den Denkaufwand noch die Aufschlüsselung der zwischengespeicherten Token offengelegt.
Test 1: Kann Astra unübersichtliche Bestelldaten abgleichen?
Die Aufgaben und der Lösungsschlüssel
Die achtzeilige CSV-Datei enthielt ein älteres Duplikat, einen neueren Ersatz, eine ausstehende Bestellung, Rückerstattungen und eine Bestellung ohne Bruttobetrag. Die Regeln lauteten, jeweils die neueste Version jeder Bestellung beizubehalten, ausstehende Zahlungen auszuschließen, Rückerstattungen abzuziehen und fehlende Umsätze als „unbekannt“ zu belassen.
Der erwartete bekannte Nettoumsatz betrug $275: Suche $170, E-Mail $75 und Soziales $30. Bei A war eine Duplikatsbereinigung erforderlich, bei C ein Ausschluss und bei F musste das Feld unbekannt bleiben. Eine korrekte Gesamtsumme allein reichte nicht aus, um alle fünf Prüfungen zu bestehen.
Was Astra zurückgab
{"known_net_usd":275,"channel_known_net_usd":{"Suche":170,"E-Mail":75,"Social": 30},"unknown_order_ids":["F"],"excluded_order_ids":["C"],"replaced_order_ids":["A"]}
Alle fünf Prüfungen wurden bestanden. Noch aussagekräftiger war jedoch die Schlussfolgerung: “Der Gesamtnettoumsatz ist weiterhin unbekannt, da bei Auftrag F der Bruttoumsatz fehlt.” Es hat „Search“ zu Recht als das größte bezeichnet bekannt Zwischensumme, ohne zu behaupten, dass die fehlende E-Mail-Bestellung keinen Wert hatte.
Unsere Einschätzung: Für eine überschaubare Abstimmungsaufgabe war dies ein gutes Ergebnis. Das Modell hielt sich an die Rechnungslegungsvorschriften und berücksichtigte die Unsicherheiten. Es handelte sich dabei nicht um einen Test einer Live-Verbindung zu einer Tabellenkalkulation, von Tausenden von Transaktionen, der Einhaltung steuerlicher Vorschriften oder autonomer Finanzentscheidungen.
Test 2: Funktioniert der generierte Code tatsächlich?
Eine fehlerhafte Umsatzberechnung ersetzen
Wir haben das fehlerhafte Muster geliefert. sum(float(r.get('gross_usd') or 0) for r in records) und bat um eine reine Python-Funktion, die doppelte Aktualisierungen, Zahlungsstatus, Rückerstattungen, fehlende Werte, sortierte ID-Listen und leere Eingaben verarbeitet. Die Funktion musste intern ganze Cent-Beträge verwenden und die Eingabedatensätze unverändert lassen.
Astra gab eine Funktion zurück, die Folgendes verwendet: Dezimal um Beträge in Cent umzurechnen, den aktuellsten Wert pro Bestellung zu speichern und unbekannte Bruttobeträge zu überspringen, anstatt eine Null einzufügen. Wir haben die Zeilenumbruch-Escape-Sequenzen in der zurückgegebenen Code-Zeichenkette entschlüsselt, die Importe und Operationen überprüft und den Code lokal ausgeführt, ohne seine Logik zu verändern.
Zehn Offline-Prüfungen
| Fall | Ergebnis |
|---|---|
| Ursprüngliche Abgleichung in acht Zeilen | Weiter |
| Leere Eingabe | Weiter |
| Ein neuerer Datensatz erscheint vor einem älteren Datensatz | Weiter |
| Durch das letzte Update wurde ein Auftrag in den Status „Ausstehend“ geändert | Weiter |
| Leere und null Bruttobeträge | Weiter |
| Fehlt eine Rückerstattung, wird standardmäßig der Wert Null gesetzt | Weiter |
| 0,10 + 0,20 Cent – Rechenaufgabe | Weiter |
| Vollständige und teilweise Rückerstattungen | Weiter |
| Ein Kanal, dessen Einnahmen ausschließlich unbekannt sind | Weiter |
| Unbekannte und ausgeschlossene IDs sortiert | Weiter |
Auch die Unveränderlichkeit der Eingaben war in allen 10 Fällen gegeben. Unsere Einschätzung: Die Funktion war für den angegebenen Vertrag einsetzbar, und die lokale Ausführung lieferte überzeugendere Beweise als ein plausibles Codebeispiel allein. Wir haben keine fehlerhaften Zeitstempel, mehrere Währungen, die Bereitstellung, ein echtes Repository, Datenbanktransaktionen oder die Leistung im großen Maßstab getestet.
Test 3: Kann das System widersprüchliche Regeln in einem langen Paket auflösen?
Fünf relevante Notizen unter 500
Wir haben ein Paket mit 73.252 Zeichen und 500 nummerierten Notizen erstellt. Die relevanten Fakten verteilten sich auf die Notizen 037, 114, 261, 398 und 477 verteilt: eine alte 30-Tage-Rückerstattungsregel, eine neuere 14-Tage-Standardregel, eine 30-Tage-Ausnahme für Unternehmen, ein Eigentümerwechsel, die Preisgestaltung auf Jahres- gegenüber Monatsbasis sowie eine Frage, für die keine Belege vorlagen.
Die vollständige Anfrage wurde gemeldet 17.445 Eingabe-Token. Es handelt sich hierbei um eine überschaubare Überprüfung umfangreicher Dokumente, die weit unter der von Astra angegebenen Kapazität von 1,05 Millionen Token liegt. Die Hintergrundinformationen stellten lediglich einfache Ablenkungselemente dar, sodass die Aufgabe einfacher war als die Bearbeitung einer unübersichtlichen Sammlung von Dokumenten aus der Praxis.
Korrekte Regeln, Preise und Unsicherheit
| Frage | Astras Antwort | Erforderliche Nachweise |
|---|---|---|
| Standard-Rückerstattungszeitraum im Norden | 14 Tage | 114 |
| Rückerstattungszeitraum für Unternehmen im Norden | 30 Tage | 477 |
| Derzeitiger Eigentümer von North | Lin | 114 |
| Atlas-Jahreszahlung | $129.60 | 261 |
| Atlas-Monatsäquivalent | $10.80 | 261 |
| Anspruch auf Barerstattungen im Süden | null / unbekannt | 398 |
Alle sechs Antworten waren korrekt und enthielten die erforderlichen Begleitvermerke. Bei der Standardantwort zur Rückerstattung wurde zusätzlich der Vermerk zur Unternehmensausnahme angeführt, der den relevanten Kontext darstellte. Die Vermerk-Identifikatoren wurden als Zeichenfolgen zurückgegeben; ein Schema für numerische IDs war nicht erforderlich gewesen.
Unsere Einschätzung: Astra hat die Überarbeitung und die Ausnahme korrekt gelöst und den fehlenden Anspruch nicht einfach erfunden. Das ist ein nützlicher Beleg für eine begrenzte Regelsynthese. Es bestätigt jedoch weder laufende Forschungsarbeiten, willkürliche Rechtsdokumente, das Auffinden von Nadel im Heuhaufen unter fast einer Million Tokens noch die Widerstandsfähigkeit gegenüber böswilligen Anweisungen, die in Quellen eingebettet sind.
Was diese API-Routen-Tests kosten
Die drei gemeldeten Läufe 21.707 Eingabe-Token und 790 Ausgabe-Token. Das Konto von GlobalGPT wies 67, 105 und 219 Credits auf; der Kontostand veränderte sich von 15.477,71 auf 15.086,63 Credits, was einem Rückgang von 391,08 Credits. Wir wandeln diese Gutschriften nicht in eine fiktive Barabrechnung um.
Als separates Beispiel für die Budgetierung ergibt sich bei Anwendung der Standardtarife von OpenAI für kurze Kontexte – nämlich $10 pro Million nicht zwischengespeicherter Eingabetoken und $50 pro Million Ausgabetoken – auf die angegebenen Zahlen ein Wert von ungefähr $0.2566: $0,0289 für Aufträge, $0,0452 für Code und $0,1825 für das Paket. Dabei wird von nicht zwischengespeicherten Eingaben und ohne zusätzliche Kosten ausgegangen. Es handelt sich hierbei nicht um die Rechnung für unsere GlobalGPT-Anrufe oder um die gemessenen Kosten für OpenAI-Direktverbindungen.
Der Paketdurchlauf war in diesem Durchlauf schneller als der Code-Durchlauf, obwohl mehr Eingabetoken vorhanden waren. Ein einziger Durchlauf pro Aufgabe reicht nicht aus, um eine Rangfolge hinsichtlich der Latenz zu erstellen: Ausgabelänge, Routing, Warteschlangen und Verarbeitungsbedingungen können sich alle unterscheiden. Wir haben keinen Vergleich mit einem gleichwertigen Konkurrenten durchgeführt.
Ist GPT-6 Astra verfügbar?
Ja. Astra ist im Katalog von GlobalGPT aufgeführt, und alle drei neuen Abfragen lieferten ein Ergebnis mit der Bezeichnung „gpt-6-astra“. OpenAI veröffentlicht zudem eine Dokumentation zu den API-Modellen; der Zugriff auf Chat, Work und Codex erfolgt über separate Produktlizenzen.
Die untenstehenden Screenshots vom 4. September stammen aus der Einführungsphase. Der dort verwendete Wortlaut bezieht sich auf die Vergangenheit und ist kein Hinweis darauf, dass der heutige Eintrag „GlobalGPT“ nicht verfügbar ist.
Technische Daten des GPT-6 Astra
Astra akzeptiert Text- und Bildeingaben und erzeugt Textausgaben. Sein Kontextfenster mit einer Größe von 1,05 Millionen Token entspricht dem Umfang, der für große Repositorien, Dokumentensammlungen oder lange Agentenverläufe erforderlich ist, während die Obergrenze von 128.000 Token für die Ausgabe ausreichend Platz für umfangreiche Codeabschnitte oder Berichte bietet.
Kapazität ist nicht gleichbedeutend mit Qualität. Ein Fenster mit einer Million Tokens garantiert nicht, dass jedes Detail gleichermaßen gut abgerufen wird, und die Übermittlung der maximalen Kontextmenge kann sowohl den Aufwand als auch das Rauschen erhöhen. Für die praktische Arbeit mit langen Kontexten sollten Sie zunächst die relevantesten Dateien abrufen und die Aufgabenanweisungen klar und eindeutig formulieren.
Wenn Sie einen Anhaltspunkt dafür suchen, wie die vorherige Generation mit umfangreichen Eingaben umgegangen ist, sehen Sie sich die Leitfaden zu Preisen und Hintergründen für GPT-5.5. Für einen umfassenderen, aufgabenorientierten Überblick hilft der Leitfaden zu den GPT-5.5-Anwendungsfällen dabei, Workloads zu identifizieren, die den Einsatz eines Flaggschiff-Modells rechtfertigen könnten.
Preise für die GPT-6 Astra-API
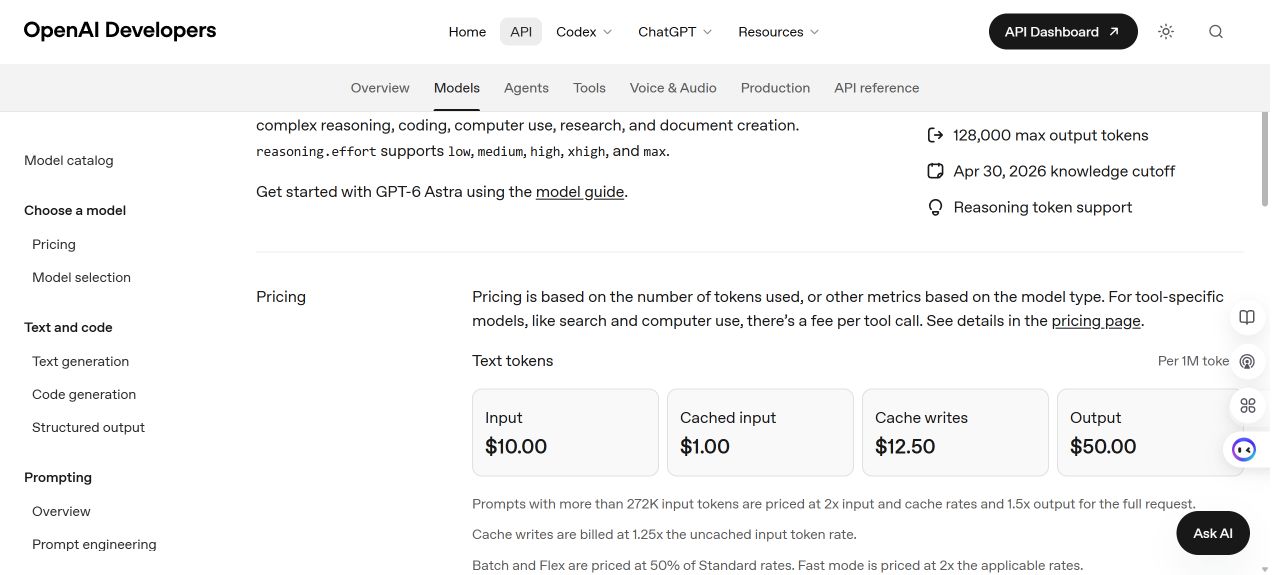
In OpenAI sind die folgenden Standard-Verarbeitungsraten für Eingabeaufforderungen mit bis zu 272.000 Eingabetoken aufgeführt:
Die Kurse wurden am 18. September 2026 erneut anhand von Preise für die OpenAI-API. Hierbei handelt es sich um die Standardtarife für API-Token, nicht um die Abonnementpreise für ChatGPT oder die Kreditgebühren für GlobalGPT.
| Token-Kategorie | Preis pro 1 Mio. Token | Was das bedeutet |
|---|---|---|
| Eingabe | $10.00 | Neue Eingabeinhalte, Verlauf, abgerufene Materialien und sonstige abrechnungsfähige Leistungen. |
| Zwischengespeicherte Eingabe | $1.00 | Gültige wiederholte Eingaben, die über das Prompt-Caching bereitgestellt werden. |
| Cache-Schreibvorgang | $12.50 | Die Eingaben werden gemäß den geltenden Tarifen für Cache-Schreibvorgänge in den Cache geschrieben. |
| Ausgabe | $50.00 | Generierte Antwort und abrechnungsrelevante Begründung. |
Sobald eine Anfrage 272.000 Eingabetoken überschreitet, wendet OpenAI eine 2-facher Multiplikator für die Eingangs- und Cache-Eingangsraten und eine 1,5-facher Multiplikator für die Ausgabegeschwindigkeiten für die gesamte Anfrage. Zu den angegebenen Standardtarifen bedeutet dies $20 pro Million Eingabetoken und $75 pro Million Ausgabetoken.
Preisgrenze:
Es handelt sich hierbei um die Preise für OpenAI-API-Token, nicht um die monatlichen Preise für ein ChatGPT-Abonnement und auch nicht um GlobalGPT-Guthaben. Tool-Gebühren, Abrechnungsstufen, regionale Einstellungen und sonstige Gebühren können die endgültigen Kosten beeinflussen.
Zum historischen Kontext der Preisliste siehe Preise für GPT-5.6 sowie die Preise für GPT-5.4. Vergleichen Sie die gesamte Arbeitslast und nicht nur die Eingaberate: Die Ausgabelänge, das Cache-Verhalten, der Einsatz von Tools sowie Fehler- und Wiederholungsraten können wichtiger sein als der angegebene Preis.
Was ist eigentlich neu bei GPT-6 Astra?
OpenAIs Leitfaden zu den neuesten Modellen hebt eine Reihe von Funktionen hervor, die auf lang andauernde, interaktive Agentenarbeit ausgerichtet sind.
Asynchrones Aufrufen von Tools
Astra kann weiterhin Fortschritte erzielen, während langsamere Tools noch laufen, anstatt jeden Tool-Aufruf als zwingenden Stopp zu behandeln. Das kann bei Forschungs-, Programmier- und Betriebsaufgaben hilfreich sein, bei denen mehrere externe Systeme mit unterschiedlichen Reaktionszeiten kombiniert werden.
Anweisungen während der Aufgabe
Benutzer können während der Bearbeitung einer Aufgabe Anweisungen hinzufügen. Dies ist besonders nützlich, wenn ein Bearbeiter zwar im Großen und Ganzen auf dem richtigen Weg ist, jedoch eine neue Vorgabe, eine Änderung der Priorität oder einen enger gefassten Umfang benötigt. Dadurch sollte sich die Notwendigkeit verringern, einen bereits weit fortgeschrittenen Vorgang abzubrechen und von vorne zu beginnen.
Aufwand für dynamisches Schlussfolgern
Astra kann einstellen, in welchem Umfang es bei einer Aufgabe logische Schlussfolgerungen anwendet. Im Prinzip ermöglicht dies, mehr Aufwand für schwierige Schritte und weniger für Routineschritte aufzuwenden. Teams sollten dennoch prüfen, ob der Qualitätsgewinn die zusätzlichen Kosten in Form von Output-Token für ihre eigene Arbeitslast rechtfertigt.
Computernutzung und Kontinuität bei lang andauernden Aufgaben
OpenAI positioniert Astra für die Interaktion mit Computern und für Arbeitsabläufe, die sich über viele Schritte erstrecken. Die praktische Frage lautet nicht, ob es sich durch eine Demo klicken kann, sondern ob es sich von unerwarteten Zuständen erholen, die Absicht des Benutzers beibehalten und erklären kann, was es geändert hat. Das sind die Bereiche, die Early Adopters bewerten sollten.
Leser, die sich für die Entwicklung vom deliberativen Chat hin zu werkzeugnutzenden Systemen interessieren, können auch folgende Quelle einsehen: GPT-5.4 Denken sowie diese Anleitung zur Verwendung von ChatGPT Agent.
Warum Astra die Kaufentscheidung beeinflusst
Der entscheidende Wandel besteht darin, dass eine KI nicht mehr anhand der Qualität einer einzelnen Antwort bewertet wird, sondern danach, ob sie eine gesamte Aufgabe erfüllen kann. Ein nützlicher Agent muss möglicherweise Dateien prüfen, Software bedienen, auf Werkzeuge warten, Fehler beheben, eine Änderung vornehmen, Überprüfungen durchführen und das Ergebnis erläutern. Die endgültige Antwort ist nur ein Teil dieser Abfolge.
Das wirft auch die Frage nach den Kosten auf. Die Token-Gebühren bei Astra sind hoch, aber der Token-Preis allein sagt noch nichts darüber aus, ob es wirtschaftlich ist. Ein besserer Vergleich ist Kosten pro erfolgreich abgeschlossener Aufgabe: Modell- und Tool-Kosten, Wiederholungsläufe, die verstrichene Zeit, manuelle Überwachung und Aufräumarbeiten spielen allesamt eine Rolle. Ein günstigeres Modell kann insgesamt teurer sein, wenn es wiederholt korrigiert werden muss; ein teurer Lauf ist dennoch Verschwendung, wenn er vom Kurs abweicht oder Ergebnisse liefert, die nachbearbeitet werden müssen.
Praktische Kennzahl:
Erfassen Sie die Gesamtkosten, die Fertigstellungsquote, den Personalaufwand, die Anzahl der Wiederholungsversuche und die Fehlerquote für dieselbe repräsentative Aufgabe. Vergleichen Sie Modelle nicht allein anhand der Token-Preise oder einer einzigen ausgefeilten Demo.
Mehr Autonomie erhöht auch die Anforderungen an die Kontrollmechanismen. Laut den neuesten Leitlinien von OpenAI unterliegt Astra einer asynchronen Überwachung auf Fehlausrichtungen. Teams sollten einem Agenten weiterhin nur die minimal erforderlichen Berechtigungen erteilen, vor folgenreichen Aktionen eine Bestätigung verlangen, ein Aktionsprotokoll führen und Kontrollpunkte einrichten, die Änderungen rückgängig machen können. Ein intensiver Computereinsatz ist nur dann sinnvoll, wenn das umgebende System die Möglichkeiten für Fehlfunktionen begrenzt.
Was erste Rezensenten sagen
Zugeschriebene frühe Erfahrungen
Matt Shumers Erster Testbericht zum Astra ist einer der ausführlicheren öffentlichen Berichte, die zum Zeitpunkt der Markteinführung verfügbar waren. Er beschreibt das Modell als besonders stark in den Bereichen Backend-Entwicklung, Computernutzung, dem Verständnis ungenauer Anfragen, der klaren Darstellung seiner Arbeit sowie der Aufrechterhaltung der Kontinuität über lange Gespräche hinweg.
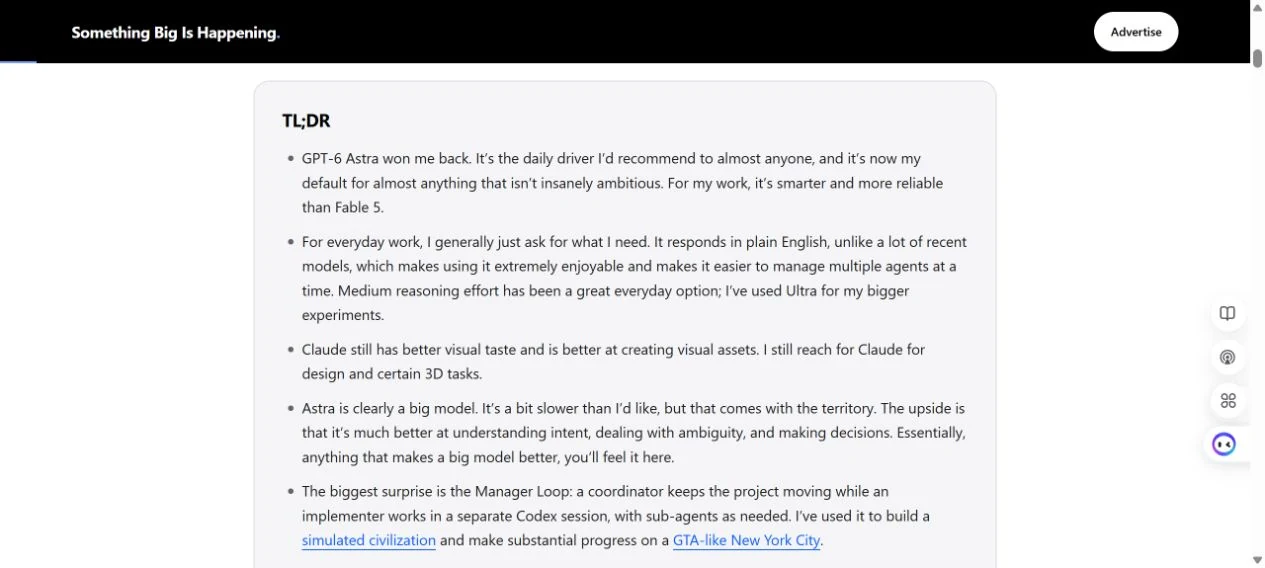
Backend-Entwicklung
Die Untersuchung hebt die gute Leistungsfähigkeit bei komplexen Implementierungsaufgaben hervor, insbesondere wenn das Modell ein System verstehen muss, anstatt nur einen kleinen, isolierten Codeausschnitt zu erzeugen.
Computernutzung
Astra soll Aufgaben im Browser- und Desktop-Umfeld angeblich mit einem besseren Blick für das übergeordnete Ziel bewältigen, was jedoch die Notwendigkeit von Berechtigungen und Verifizierungen nicht beseitigt.
Mehrdeutige Absicht
Das Modell soll besser darin sein, aus unvollständigen Anweisungen abzuleiten, was ein Nutzer erreichen möchte.
Kontinuität und Berichterstattung
In der Rezension wird Astra dafür gelobt, dass es den Kontext auch über lange Spielsitzungen hinweg beibehält und die eigenen Aktionen klarer darstellt.
Dies sind qualitative Beobachtungen eines anderen Gutachters. Sie helfen dabei, Funktionen zu identifizieren, die es wert sind, getestet zu werden, stellen jedoch keine eigenen Messungen dar und begründen keine allgemeine Zuverlässigkeit.
Anfängliche Einschränkungen und offene Fragen
Der gleiche Testbericht wirft jedoch auch wichtige Bedenken auf. Astra kann langsam sein, große Mengen an Token verbrauchen und sich bei lang andauernder autonomer Arbeit dennoch in Details verlieren. Shumer berichtet zudem, dass die Qualität der visuellen Ergebnisse möglicherweise hinter denen von Claude zurückbleibt, selbst wenn die Backend-Leistung gut ist.
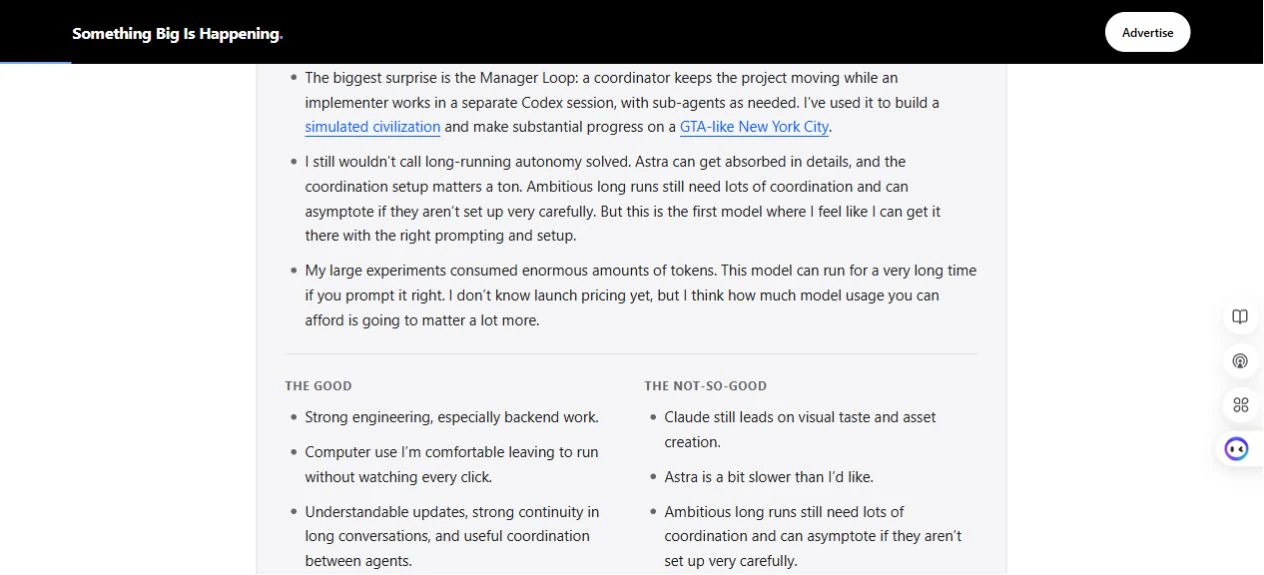
- Geschwindigkeit: Ein Modell, das logisch argumentiert, Werkzeuge einsetzt und seine Arbeit überprüft, benötigt möglicherweise mehr Zeit als ein schlankes Chat-Modell.
- Autonomie: „Langfristig“ bedeutet nicht „ohne Aufsicht“. Der Prüfer stellte dennoch Momente fest, in denen das Modell koordiniert oder umgelenkt werden musste.
- Verwendung des Tokens: Große Kontexte und umfangreiche Schlussfolgerungen können schnell zu einer hohen Rechenlast führen, insbesondere oberhalb der 272K-Schwelle.
- Visuelle Gestaltung: Eine hervorragende Programmierleistung führt nicht automatisch zu einer optimalen Ästhetik der Benutzeroberfläche.
- Tiefe der Evidenz: Es gibt noch nicht genügend unabhängige, vergleichbare Tests, um allgemeine Aussagen über die Zuverlässigkeit oder Überlegenheit zu treffen.
Der entscheidende Test für die Einführung ist daher die Effizienz, nicht die maximale Leistungsfähigkeit. Messen Sie, wie oft Astra die gesamte Aufgabe korrekt ausführt, wie viel Überwachung erforderlich ist, wie viele Token es verbraucht und wie viel Nacharbeit noch anfällt. Ein langsamerer, aufwendigerer Durchlauf kann sich dennoch lohnen, wenn er stundenlange Facharbeit ersetzt – nicht jedoch, wenn er wiederholt vom Kurs abweicht.
Für wen ist GPT-6 Astra geeignet?
| Mögliche Passform | Warum Astra helfen könnte | Was sollte man zuerst überprüfen? |
|---|---|---|
| Arbeit an einem umfangreichen Code-Bestand | Langer Kontext, Werkzeuggebrauch und Kontinuität bei Änderungen in mehreren Dateien | Regressionsrate, Testdisziplin, Überprüfungszeit und Token-Kosten |
| Forschung und Synthese | Kann die Erfassung, Analyse und Erstellung umfangreicher Auswertungen koordinieren | Genauigkeit der Quellenangaben, Abdeckung der Quellen und unbegründete Schlussfolgerungen |
| Agenten für die Computernutzung | Entwickelt für mehrstufige Interaktion mit Software | Berechtigungsgrenzen, Wiederherstellung nach Änderungen an der Benutzeroberfläche und Aktionsprotokolle |
| Analyse umfangreicher Dokumente | Ein 1,05-M-Kontext kann umfangreiches Quellmaterial enthalten | Rückruf im gesamten Kontext und ob der Abruf weniger aufwendig ist |
| Lang andauernde Vorgänge | Steuerung während der Ausführung und asynchrone Tools können Neustarts reduzieren | Eskalationsverhalten, Kontrollpunkte und sicheres Zurücksetzen |
Astra ist wahrscheinlich nicht die richtige Standardwahl für kurze Umformulierungen, routinemäßige Klassifizierung, einfache Extraktion oder Aufgaben mit hohem Durchsatz, bei denen bereits ein kleineres Modell die Qualitätsanforderungen erfüllt. Das Testbericht zu GPT-5.4 und Nano zeigt, warum eine aufgabenbasierte Modellzuordnung wirtschaftlicher sein kann, als alles an das Flaggschiff-Modell weiterzuleiten.
Eine praktische Checkliste zur Bewertung
- Wählen Sie drei konkrete Aufgaben mit klaren Erfolgskriterien aus.
- Führen Sie dieselben Eingaben und Einschränkungen auf Astra und Ihrem aktuellen Modell aus.
- Erfassen Sie die Gesamtdauer, die Eingabe- und Ausgabetoken, die Wiederholungsversuche und die manuellen Korrekturen.
- Die Erledigung der letzten Aufgabe ist getrennt vom Schreibstil oder der Darstellung zu bewerten.
- Testunterbrechung, Steuerung während der Aufgabenausführung und Wiederherstellung nach einem absichtlichen Werkzeugausfall.
- Setzen Sie Astra nur dort ein, wo die Verbesserung reproduzierbar ist und die zusätzlichen Kosten rechtfertigt.
Wählen Sie je nach Einsatzzweck den Astra oder ein kleineres Modell
Verwenden Sie Astra für anspruchsvolle Synthesen und Aufgaben, bei denen Korrektheit wichtiger ist als der niedrigste Token-Preis. Für routinemäßige Extraktionen oder kurze Umschreibungen reicht möglicherweise ein kleineres Modell aus. Vergleichen Sie die erfolgreiche Fertigstellung, die Überwachung und die Gesamtkosten bei denselben Eingaben.
Bei einem Workflow mit mehreren Modellen gilt:, GPT-6 Astra, Claude Opus 5, Claude Sonnet 5 und Gemini 3.8 Flash sind im aktuellen Katalog von GlobalGPT aufgeführt. GlobalGPT ist ein eigenständiges Abonnement; es aktiviert kein kostenpflichtiges Konto eines anderen Anbieters.
Die Seite zum Jahresplan GlobalGPT Gibt „Basic“ mit $5,80/Monat, „Pro“ mit $10,80/Monat und „Unlimited“ mit $25/Monat bei jährlicher Abrechnung an, Stand: 18. September 2026. Vergleichen Sie die anfängliche Vertragslaufzeit und die darin enthaltene Modellnutzung, nicht nur den geringeren monatlichen Gegenwert.
Was diese Untersuchung nach wie vor nicht belegt
Ein früherer Versuch mit Astra über dieselbe CLI-Route wurde ohne Antwort abgebrochen. Wir haben diesen Fehlversuch im Testarchiv gespeichert; es handelte sich dabei nicht um eine Qualitätsbewertung. Die drei erfolgreichen Aufrufe hier zeigen, dass die Route für diesen Durchlauf funktioniert hat, nicht jedoch, dass sich der frühere Fehlversuch nicht wiederholen kann.
Wir haben weder die Computernutzung noch den asynchronen Aufruf von Werkzeugen, die Steuerung während der Aufgabenausführung, das Abrufen von einer Million Tokens, den nativen Zugriff auf den ChatGPT-Plan noch unbeaufsichtigte Produktionsarbeit getestet. Es gibt hier keine Grundlage für die Behauptung, dass Astra Claude, Gemini oder ein kleineres OpenAI-Modell übertrifft. Für solche Vergleiche sind aufeinander abgestimmte Aufgaben und wiederholte Versuche erforderlich.
Kaufempfehlung: Testen Sie Astra bei Aufgaben, bei denen die Überprüfung von Regeln, fehlenden Werten und Ausnahmen eine wichtige Rolle spielt. Behalten Sie für Routineaufgaben, die Ihr Qualitätsziel bereits erfüllen, ein kleineres Modell bei. Beurteilen Sie die zusätzlichen Kosten anhand der geringeren Anzahl an Korrekturen und der verwertbaren Endergebnisse – nicht allein anhand des Modellnamens.
Häufig gestellte Fragen
Handelte es sich hierbei um einen direkten OpenAI-API-Test?
Nein. Wir haben den CLI-gestützten Modelldienst von GlobalGPT mit gpt-6-astra genutzt. Die angegebenen Token-Anzahlen und Gutschriften beziehen sich auf diesen Weg; die Dollar-Berechnung für OpenAI ist ein separates Beispiel aus der Preisliste.
Ist GPT-6 Astra auf GlobalGPT verfügbar?
Ja. Dieser Bericht umfasst drei erfolgreiche gpt-6-astra-Aufrufe über den Modelldienst von GlobalGPT. Das Abonnement für diese Plattform ist unabhängig von der API-Abrechnung von OpenAI und den Tarifen von ChatGPT.
Was ist das Kontextfenster?
OpenAI listet 1.050.000 Kontext-Token auf, wobei maximal 922.000 Eingabe-Token und 128.000 Ausgabe-Token zulässig sind.
Verfügt Plus über GPT-6 Pro im Chat?
Gemäß den Modellrichtlinien vom 10. September ist GPT-6 Pro in den berechtigten Chat-Tarifen „Pro“, „Business“ und „Enterprise“ enthalten. „Plus“ umfasst zudem „Astra“ in „Work“ und „Codex“; dabei handelt es sich um separate Produktberechtigungen.
Wie funktioniert die Preisgestaltung bei langen Eingaben?
Auf der offiziellen Modellseite gelten für die gesamte Anfrage ab 272.000 Eingabetoken höhere Tarife: das Zweifache der Eingabe- und Cache-Tarife sowie das 1,5-Fache der Ausgabetarife.
Wurde bei dem neuen Test die Computernutzung berücksichtigt?
Nein. Wir haben die Analyse synthetischer Befehle, die Codegenerierung mit lokaler Ausführung sowie ein Textpaket mit 500 Notizen getestet. Die Computernutzung, asynchrone Tools und die Zuverlässigkeit bei einer Million Token wurden nicht getestet.
Sollte ich jedes Modell durch den Astra ersetzen?
Nein. Vergleichen Sie die Qualität der Ergebnisse, den manuellen Prüfungsaufwand, die Latenz und die Kosten für Ihre eigenen Aufgaben. Ein kleines Modell kann die bessere Wahl sein, wenn es zuverlässig dieselbe brauchbare Antwort liefert.