
Claude Sonnet 5.5 ist ein leistungsstarkes Modell für den Arbeitsalltag: Es ist leistungsfähig genug für eine schwierige Fehlerbehebung oder ein umfangreiches Dokument und hat dabei einen niedrigeren Token-Preis als Opus 5.5. Sein Reiz wird besonders deutlich, wenn man definieren kann, wie eine gute Antwort aussieht. Bei offenen strategischen Fragestellungen oder einem ungewohnten Problem mit vielen Variablen verdient Opus dennoch einen Platz in Ihrem Arbeitsablauf.
In unseren GlobalGPT-Tests verfasste Sonnet 5.5 E-Mails an Kunden, reparierte eine Funktion zur Mittelzuweisung, die 43 Prüfungen bestand, und stimmte einen Satz von Rechnungsdatensätzen mit 13.078 Wörtern korrekt ab. Die E-Mail enthielt zudem eine kleine Prozessannahme, die überprüft werden musste. Die interessantere Frage ist, wann sich Geschwindigkeit und Preis in einem besseren Arbeitstag niederschlagen – und wann zusätzliches logisches Denken mehr kostet, als es einspart.
Sie können verwenden Claude Sonnet 5,5 auf GlobalGPT neben anderen führenden Modellen für Text, Programmierung, Forschung, Bilder und Videos. Mit einem einzigen Multi-Modell-Abonnement können Sie ein Projekt vom ersten Entwurf bis zum fertigen Ergebnis kostengünstig umsetzen, ohne für jeden Schritt ein separates Abonnement verwalten zu müssen.
Claude Sonnet 5.5: Das kurze Fazit
Ein praktischer Standard für klar definierte Aufgaben
Beginnen Sie mit Sonnet, wenn es um eine kurze Beschreibung, einen Fehler, ein Dokument oder eine erste Implementierung geht. Geben Sie dem Programm das Ausgangsmaterial, die Rahmenbedingungen und die Abnahmekriterien vor. Wechseln Sie zu Opus, wenn die schwierigste Aufgabe darin besteht, zu entscheiden, worin das Problem eigentlich besteht.
Was uns beeindruckt hat: kontrollierte Formatierung, robuster Code und korrekte Dokumentenabgleichung.
Was man sich ansehen sollte: Selbst in einem ausgefeilten Text können sich kleine Annahmen einschleichen; Argumentationen verursachen zusätzliche Kosten; ein langer Kontext garantiert nicht, dass man sich daran erinnert.
Dies ist ein Testbericht zu einem neu erschienenen Modell, keine monatelange Produktionsstudie. Wir kombinieren die technischen Daten von Anthropic, veröffentlichte Bewertungen und drei praktische Aufgaben, die am 1. Oktober 2026 durchgeführt wurden. Die Schreibaufgabe wurde zweimal wiederholt; die Code- und Dokumentenaufgaben wurden jeweils einmal ausgeführt. Die folgenden Ergebnisse berücksichtigen diese kleine Stichprobe.
Was ist neu in Claude Sonnet 5.5?
Anthropic brachte am 28. September 2026 Sonnet 5.5 als schnellere und kostengünstigere Ergänzung zu Opus 5.5 auf den Markt. Als Stärken werden die Bewältigung alltäglicher Aufgaben in angemessenem Umfang, die Behebung von Fehlern sowie die Erstellung ansprechender Dokumente, Präsentationen und Tabellen genannt. Diese Positionierung ist entscheidend: Man benötigt nicht für jede Bearbeitung, jede Support-Antwort oder jede Implementierungsaufgabe das teuerste Modell.
Was ist neu in Claude Sonnet 5.5?
| Merkmal | Sonnet 5.5 | Was das in der Praxis bedeutet |
|---|---|---|
| Eingabe und Ausgabe | Text und Bilder einfügen; Text entfernen | Fragen Sie nach einer Grafik oder einem Screenshot und wandeln Sie die Antwort anschließend in einen Entwurf oder Plan um. |
| API-Kontextfenster | 1 Million Token | Platz für umfangreiches Quellenmaterial; ordnen Sie es sorgfältig und beschriften Sie es. |
| Maximale Ausgabeleistung der Standard-API | 128K Token | Ein Richtwert, keine empfohlene Länge für jede Antwort. |
| Begründung | Adaptives Denken | Der Aufwand kann sowohl die Bearbeitungszeit als auch den Gesamtverbrauch an Token beeinflussen. |
| Wissensabgrenzung | Juni 2026 | Nutzen Sie aktuelle Quellen oder Suchwerkzeuge, um Fakten zu überprüfen. |
Diese Kontext- und Ausgabebeschränkungen beziehen sich auf die Claude-API. Die Menge, die Sie in einer bestimmten App hochladen oder empfangen können, hängt zudem von der Schnittstelle des jeweiligen Produkts ab. Ebenso ist ein Modell, das ein Bild versteht, kein Bildgenerator. Sonnet kann ein Bild bewerten oder ein Produktionskonzept verfassen; ein Bild- oder Videomodell erstellt hingegen die fertigen Medien.
Der praktische Vorteil besteht in der Kombination aus einer effizienteren Aufgabenausführung und einer schnelleren Iteration. Sie können einen ersten Entwurf anfordern, die Schwachstellen prüfen und eine gezielte Überarbeitung verlangen. Eine gute Eingabevorgabe gibt dabei die Richtung vor: “Behalte alle Abbildungen unverändert bei, kürze den Text auf 200 Wörter und liste alles auf, was in der Quelle nicht erwähnt wird.”
Claude Sonnet 5.5 Preisgestaltung: Token-Sätze und tatsächliche Kosten
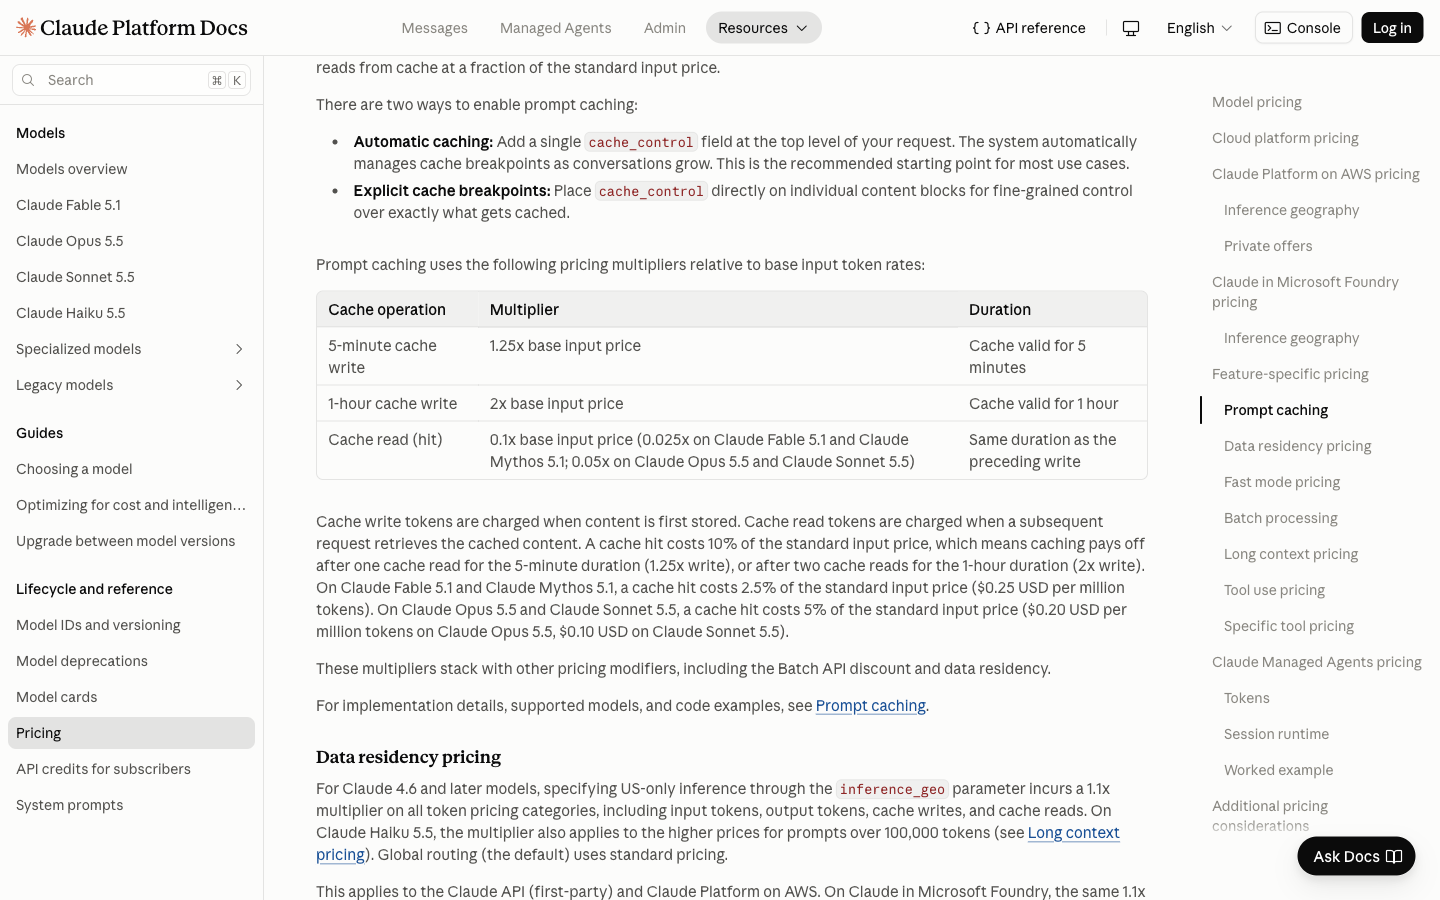
Kosten für Sonnet 5.5 $2 pro Million Eingabetoken und $10 pro Million Ausgabetoken zu den Standard-API-Tarifen von Anthropic. Dies sind dieselben Stückpreise wie bei Sonnet 5. Im Vergleich zu den Eingabe- und Ausgabesätzen von $4 bzw. $20 bei Opus 5.5 kostet Sonnet pro Eingabe- oder Ausgabetoken nur die Hälfte – allerdings kann eine abgeschlossene Aufgabe eine unterschiedliche Anzahl von Token verbrauchen.
Claude Sonnet 5.5 Preisgestaltung: Token-Sätze und tatsächliche Kosten
| API-Abrechnungskategorie | Preis pro Million Token |
|---|---|
| Nicht zwischengespeicherte Eingabe | $2.00 |
| Ausgabe, einschließlich abgerechneter Thinking-Token | $10.00 |
| Cache-Lesezugriff / Aktualisierung | $0.10 |
| Cache-Schreibvorgang, 5 Minuten | $2.50 |
| Cache-Schreibvorgang, 1 Stunde | $4.00 |
Bei einer nicht zwischengespeicherten Anfrage multiplizieren Sie die Eingabetoken mit $2 pro Million und die Ausgabetoken mit $10 pro Million. Eine Eingabe von 10.000 Token mit 2.000 Ausgabetoken kostet $0,04. Eine Eingabe von 100.000 Token mit 10.000 Ausgabetoken kostet $0,30. Hierbei handelt es sich um berechnete API-Beispiele, nicht um eine GlobalGPT-Rechnung; Tools, Cache-Vorgänge, Service-Stufen und andere preisbeeinflussende Faktoren können den Gesamtbetrag verändern.
Was eine Anfrage kosten kann
Beispielhafte Standard-API-Kosten pro Anfrage. Nur nicht zwischengespeicherte Ein- und Ausgabedaten.
Formel: (Eingabe-Token × $2 + Ausgabe-Token × $10) ÷ 1.000.000. Abgerechnete Rechenleistung wird zur Ausgabe hinzugerechnet. Hierbei handelt es sich um Beispiele, nicht um Abonnementpreise oder konkrete Rechnungen.
Die Behauptung von Anthropic, dass “pro Aufgabe bis zu 30% weniger” anfallen, beruht darauf, dass bestimmte Arbeiten mit weniger Token erledigt werden. Es handelt sich nicht um eine Preissenkung um 30%. Am anderen Ende des Spektrums, Bewertung der Markteinführung von „Artificial Analysis“ Bei maximaler Anstrengung lag der Wert bei etwa $7,60 pro Aufgabe des Intelligenzindexes, was in diesem Test etwa 50% über Sonnet 5 liegt. Diese anspruchsvollen Benchmark-Aufgaben sind keine gewöhnlichen Chat-Nachrichten, aber sie zeigen, warum eine maximale Steigerung der Denkleistung einen scheinbaren Vorteil zunichte machen kann.
API-Abrechnung, Claude-Abonnements und GlobalGPT sind verschiedene Optionen
Die Privatkunden-Tarife von Claude basieren auf einem Abonnementmodell: „Free“ kostet $0, „Pro“ kostet $20 pro Monat oder $200 bei jährlicher Abrechnung, und „Max“ beginnt bei $100 pro Monat, zuzüglich anfallender Steuern. Die App-Nutzung unterliegt den jeweiligen Tarifbeschränkungen. Anthropic gibt außerdem $100 oder $200 an monatlichen API-Guthaben für die entsprechenden „Max“-Stufen an; die Tarife „Free“ und „Pro“ beinhalten keine monatlichen API-Guthaben. Vergleichen Sie bei der Auswahl eines Tarifs den App-Zugriff und die API-Kontingente separat. Eine Multi-Modell-Plattform eignet sich für Nutzer, deren Arbeit regelmäßig verschiedene Modellfamilien und Medientypen umfasst.
Wenn zu Ihren täglichen Aufgaben das Erstellen einer Startseite, das Überprüfen von Code und das Entwerfen von Kampagnenbildern gehören, GlobalGPT vereint diese Tools unter einem Dach. Der Vorteil liegt in der umfassenden Abdeckung des gesamten Arbeitsablaufs in einem einzigen Abonnement – statt mehrere Einzelprodukte zu erwerben, nur um ein einziges Projekt abzuschließen. Wählen Sie den Tarif, der zu den Aufgaben passt, die Sie tatsächlich erledigen.
Benchmarks: bei einigen Aufgaben fast auf dem Niveau von Opus, jedoch nicht bei allen Aufgaben
Die Ergebnisse der Markteinführung zeigen einen erheblichen Fortschritt gegenüber Sonnet 5. Sie verdeutlichen zudem, warum eine einzelne Gesamtbewertung nicht ausreicht, um eine Modellwahl zu treffen. Sonnet 5.5 liegt im berichteten Terminal-Bench-Vergleich an der Spitze, während Opus 5.5 bei FrontierCode und CursorBench weiterhin die Nase vorn hat. Die nahezu gleichwertigen Bewertungen bei der Wissensverarbeitung sind vielversprechend, machen die Modelle jedoch nicht austauschbar.
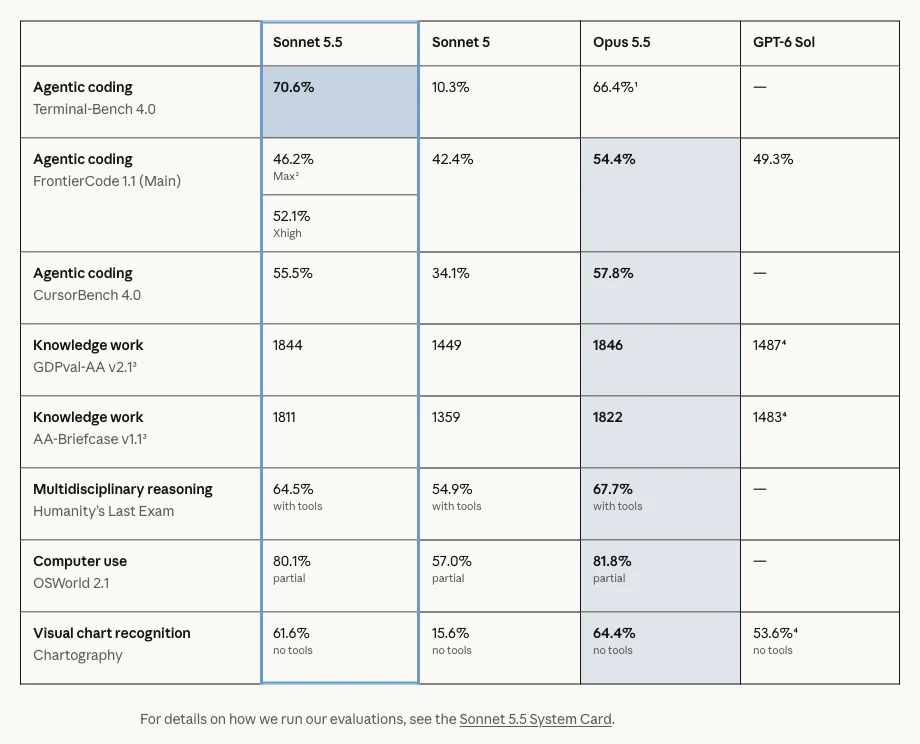
Benchmarks: bei einigen Aufgaben fast auf dem Niveau von Opus, jedoch nicht bei allen Aufgaben
| Bewertung in der Einführungstabelle von Anthropic | Sonnet 5.5 | Sonett 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66,41 TP40T (Xhigh) | - |
| FrontierCode 1.1 – Hauptseite | 52,11 TP40T (Xhigh); 46,21 TP40T (Max) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | - |
| GDPval-AA v2.1 | 1844 Elo | 1449 Elo | 1846 Elo | 1487 |
| AA-Aktentasche v1.1 | 1811 Elo | 1359 Elo | 1822 Elo | 1483 |
| Die letzte Prüfung der Menschheit | 64.5% mit Werkzeugen | 54,91 TP40T mit Werkzeugen | 67,71 TP40T mit Werkzeugen | - |
| OSWorld 2.1 | 80.1% teilweise | 57.0% teilweise | 81,81 TP40T teilweise | - |
| Kartografie | 61,61 TP40T, keine Werkzeuge | 15,61 TP40T, keine Werkzeuge | 64,41 TP40T, keine Werkzeuge | 53,61 TP40T, keine Werkzeuge |
Hierbei handelt es sich um veröffentlichte Benchmark-Ergebnisse, die unabhängig von unseren GlobalGPT-Tests sind. Die Bewertungen basieren auf unterschiedlichen Umgebungen und Aufwandsstufen; Elo-Werte entsprechen nicht der prozentualen Genauigkeit. Die GPT-6-Sol-Werte sind in der veröffentlichten Vergleichstabelle von Anthropic aufgeführt, wobei ein Strich bedeutet, dass für diese Bewertung kein Wert gemeldet wurde. Anthropic weist außerdem darauf hin, dass bei den ersten GDPval-AA- und AA-Briefcase-Läufen eine Vorabversion mit einem Fehler bei der strukturierten Ausgabe verwendet wurde, der später behoben wurde. Betrachten Sie die Tabelle als eine Momentaufnahme dieser Bewertungen und nicht als Garantie für Ihre eigene Arbeitslast.
Das Ergebnis von FrontierCode ist besonders aufschlussreich: Sonnet schnitt bei „Xhigh“ besser ab als bei „Max“. Anthropic führt den Rückgang bei „Max“ auf zusätzliche Überprüfungsdurchläufe, Zeitüberschreitungen und Änderungen außerhalb des geforderten Umfangs zurück. Mehr Nachdenken kann zu mehr Arbeit führen, ohne dass dadurch eine bessere Antwort entsteht. Beginnen Sie mit einer klaren Aufgabe und steigern Sie den Aufwand erst, wenn Sie einen konkreten Grund dafür haben.
Unabhängige Ergebnisse liefern zusätzliche Einblicke. Artificial Analysis meldete bei seiner „Max/default-fallback“-Konfiguration einen Intelligenzindex-Wert von 56 sowie eine ungewöhnlich hohe Anzahl an Ausgabe-Token. A CodeRabbit-Bewertung – Bewertung der Pipeline Es wurden 6 von 13 schwierigen Signalfällen gefunden, die von Sonnet 5.5 erkannt wurden, gegenüber 4 von 13 durch Sonnet 5, bei einer geringeren mittleren Laufzeit. Es handelt sich hierbei um eine kleine Anbieter-Studie, die keinen Beweis dafür liefert, dass sich jede Code-Review verbessern wird, aber sie ist ein nützliches Beispiel dafür, eine Aufgabe in ihrer Gesamtheit zu bewerten und nicht nur anhand einer Punktzahl.
Wie schnell ist der Claude Sonnet 5.5?
Anthropic generiert Ergebnisse mehr als 30% schneller als Sonnet 5. Die Generierung der Ergebnisse ist jedoch nur ein Aspekt beim Warten auf eine Antwort: Auch die Eingabeverarbeitung, die Schlussfolgerung, die Netzwerkzeit und die Auslastung des Dienstes spielen eine Rolle. Ein Modell kann nach dem Start schnell schreiben und dennoch Zeit mit der Bearbeitung verbringen, bevor die endgültige Antwort eintrifft.
Unsere drei Wiederholungen derselben Kunden-E-Mail-Abfrage wurden in 11,60, 12,16 und 11,78 Sekunden, mit einem Medianwert von 11,78 Sekunden. Die Code-Aufgabe dauerte 19,08 Sekunden und die Dokument-Aufgabe 16,42 Sekunden. Wir haben die gesamte Antwortzeit gemessen, einschließlich Service- und Netzwerk-Overhead. Da wir weder die Latenz bis zum ersten Token gemessen noch einen Sonnet 5-Kontrolllauf durchgeführt haben, belegen diese Zeitmessungen keine Verbesserung im 30%-Bereich.
Für den täglichen Gebrauch lohnt es sich daher, das Modell bei Aufgaben auszuprobieren, die Sie in kurzen Zyklen überarbeiten. Fragen Sie zunächst nach dem fertigen Ergebnis, halten Sie den Umfang begrenzt und vermeiden Sie es, eine ausführliche Erklärung zu verlangen, wenn Sie lediglich eine korrigierte Funktion oder eine kurze Antwort benötigen. Wenn die Einstellungsmöglichkeiten für den Aufwand sichtbar sind, prüfen Sie zunächst die weniger aufwendigen Einstellungen, bevor Sie standardmäßig „Max“ wählen.
Leistung in der Praxis: drei GlobalGPT-Tests
Wir haben praktische Aufgaben verwendet, deren Lösungen wir überprüfen konnten. Alle Anfragen wurden mit Claude Sonnet 5.5 durchgeführt, wobei die Obergrenze für die Ausgabe bei 6.000 Token lag und keine externen Tools zum Einsatz kamen. Die Einstellungen für Sampling und Reasoning ließen wir auf den Standardwerten des Dienstes. Wir behielten die erste vollständige Ausgabe für jede Aufgabe bei; die beiden zusätzlichen Schreibdurchläufe dienen als separate Konsistenzprüfung. Alle fünf Aufrufe wurden ohne Wiederholungsversuch abgeschlossen.
Schreiben: Eine Antwort an einen Kunden, bei der die Versprechen im Griff bleiben
Die Vorgabe sah eine E-Mail an Maya mit 90 bis 120 Wörtern bezüglich einer verspäteten blauen Lampe vor, genau drei Aufzählungspunkte, eine Einreichungsfrist bis zum 4. Oktober sowie die Option, mit “Rückerstattung” zu antworten, um eine vollständige Rückerstattung auf die ursprüngliche Zahlungsmethode zu erhalten. Ausdrücklich untersagt waren erfundene Gründe, Liefergarantien, Rabatte oder das Versprechen einer sofortigen Rückerstattung.
Die erste Antwort umfasste 110 Wörter mit genau drei Aufzählungspunkten und behielt die Versandfrist sowie die Rückerstattungsbedingungen unverändert bei. Es wurden weder ein Liefertermin noch ein Grund für die Verzögerung noch ein zusätzlicher Vorteil erfunden. Allerdings wurde für Kunden, die die Bestellung behalten, der Hinweis “Sie müssen nicht antworten” hinzugefügt – ein Verfahrensdetail, das in der Aufgabenstellung fehlte. Das macht den Entwurf zwar nützlich, erfüllt aber nicht vollständig die strenge Vorgabe, sich ausschließlich auf Fakten zu beschränken.
Die Wiederholungen umfassten 101 bzw. 97 Wörter und entsprachen zwar den Formatierungsregeln, gingen jedoch beide von derselben Annahme aus, dass keine Maßnahmen ergriffen werden sollten. Die dritte Antwort verwendete zusätzlich zwei Aufzählungspunkte für im Wesentlichen dieselbe Option “die Bestellung behalten und abwarten”. Bevor Sie eine Antwort an den Kunden senden, sollten Sie die operativen Details überprüfen und Redundanzen entfernen.
Schreibtest: Format bestanden, eine Prozessannahme
Erste Antwort: 110 Wörter, 3 Aufzählungspunkte, 11,60 Sekunden. Die Versand- und Rückerstattungsbedingungen waren korrekt. Die Anweisung, die Bestellung ohne Antwort zu behalten, war im Briefing nicht enthalten und muss bestätigt werden. Wiederholungen: 101 und 97 Wörter; in beiden Fällen wurde diese Annahme wiederholt.
Claude Sonnet 5,5 · GlobalGPT · 1. Oktober 2026 · Obergrenze von 6.000 Token · keine Tools · Sampling und Aufwand auf den Standardeinstellungen des Dienstes belassen. Mit „Zeit“ ist die vollständige Antwort gemeint, nicht der erste Token.
Aufgabenanleitung
Verfassen Sie eine E-Mail auf Englisch an Maya im Kundenservice bezüglich der Bestellung R-418, einer blauen Lampe, deren Versand sich verzögert hat. Die gesamte E-Mail muss 90 bis einschließlich 120 Wörter umfassen und genau drei Aufzählungspunkte enthalten. Fügen Sie eine Entschuldigung ein, erklären Sie den nächsten Schritt klar und deutlich und verwenden Sie ausschließlich folgende Fakten: Die Lampe wird bis zum 4. Oktober versandt; alternativ kann Maya mit dem Wort “refund” antworten, um eine vollständige Rückerstattung auf die ursprüngliche Zahlungsmethode zu beantragen. Versprechen Sie weder ein Liefer- oder Ankunftsdatum, eine sofortige Rückerstattung, einen Rabatt, eine Entschädigung noch sonstige nicht vorgesehene Vorteile. Erfinde keinen Grund für die Verzögerung. Die Frist bezieht sich auf den Versand, nicht auf die Zustellung. Füge eine Anrede und eine Schlussformel ein. Sende nur die E-Mail zurück. Für diese Aufgabe gilt: Ein Wort ist ein durch Leerzeichen getrenntes Token, wobei eigenständige Aufzählungszeichen nicht zählen.
Vollständige erste Ausgabe
Betreff: Aktueller Stand zu Ihrer Bestellung R-418

Hallo Maya,

es tut mir leid, dass sich der Versand Ihrer blauen Lampe (Bestellung R-418) verzögert hat. Ich weiß, dass das ärgerlich ist, und entschuldige mich für die Unannehmlichkeiten.

Hier ist der aktuelle Stand und was Sie als Nächstes tun können:

- Ihre Lampe wird bis zum 4. Oktober versandt.
- Wenn Sie Ihre Bestellung behalten möchten, brauchen Sie nicht zu antworten.
- Wenn du lieber nicht warten möchtest, antworte auf diese E-Mail mit dem Wort "Rückerstattung", und wir werden dir den vollen Betrag über deine ursprüngliche Zahlungsmethode zurückerstatten.

Vielen Dank für deine Geduld und dein Verständnis. Bitte antworte, falls du Fragen zu deiner Bestellung hast.

Mit freundlichen Grüßen,
das Kundenservice-Team
Schreiben Wiederholung 2 · vollständige Ausgabe
Liebe Maya,

es tut mir leid, dass sich der Versand Ihrer Bestellung R-418, der blauen Lampe, verzögert hat. Ich verstehe, dass dies frustrierend ist, und entschuldige mich für die Unannehmlichkeiten.

So geht es nun weiter:

- Ihre blaue Lampe wird bis zum 4. Oktober versandt.
- Wenn du warten möchtest, musst du nichts weiter tun.
- Wenn du lieber nicht warten möchtest, antworte einfach mit "Rückerstattung" auf diese E-Mail, um eine vollständige Rückerstattung auf deine ursprüngliche Zahlungsmethode zu beantragen.

Bitte beachte, dass der 4. Oktober unsere Versandfrist ist, nicht der Liefertermin.

Vielen Dank für deine Geduld und dein Verständnis.

Mit freundlichen Grüßen,
das Kundenservice-Team
Schreiben, Wiederholung 3 · vollständige Ausgabe
Betreff: Aktueller Stand zu Ihrer Bestellung R-418

Hallo Maya,

es tut mir leid, dass sich der Versand Ihrer blauen Lampe (Bestellung R-418) verzögert hat. Ich entschuldige mich für die Unannehmlichkeiten und danke Ihnen für Ihre Geduld.

Hier sind Ihre Optionen:

- Auf den Versand warten: Ihre Lampe wird bis zum 4. Oktober versandt.
- Eine Rückerstattung beantragen: Antworten Sie mit dem Wort "Rückerstattung", und wir werden eine vollständige Rückerstattung auf Ihre ursprüngliche Zahlungsmethode vornehmen.
- Die Bestellung behalten: Wenn Sie gerne warten möchten, sind keine weiteren Maßnahmen erforderlich.

Bitte beachten Sie, dass der 4. Oktober unser Versandtermin ist, nicht das Lieferdatum.

Mit freundlichen Grüßen,
das Kundenservice-Team
Ihre Lampe wird bis zum 4. Oktober versandt. … Wenn Sie lieber nicht warten möchten, antworten Sie auf diese E-Mail mit dem Wort “Rückerstattung”, und wir werden Ihnen den vollen Betrag über Ihre ursprüngliche Zahlungsmethode zurückerstatten.
Auszug aus der ersten GlobalGPT-Schreibprüfung; ein dazwischenliegender Aufzählungspunkt wurde weggelassen.
Dies ist ein nützliches Schema für die Kundenkommunikation und das Verfassen geschäftlicher Texte: Geben Sie die genehmigten Fakten an, legen Sie den Ton fest und nennen Sie die Versprechen, die nicht vorkommen dürfen. Sonnet kann Ihnen dann bei der Formulierung helfen, ohne dass Sie das Unternehmen bitten müssen, Ihre Richtlinien zu entwerfen.
Programmierung: Die Rundungslogik korrigieren und anschließend die Summen überprüfen
Unsere fehlerhafte Python-Funktion teilte den Geldbetrag mithilfe von Gleitkommazahlen auf und rundete jeden Anteil separat. Dadurch können Centbeträge hinzukommen oder verloren gehen. Wir haben Sonnet gebeten, diese Funktion durch eine auf dem Dezimalsystem basierende Zuweisung nach dem Prinzip des größten Restes zu ersetzen, den Gesamtbetrag beizubehalten, bei Gleichstand anhand des ursprünglichen Index zu entscheiden und ungültige Eingaben zurückzuweisen.
Die erste zurückgegebene Funktion übergab 43 von 43 Prüfungen, wobei Nullbeträge, Bruchgewichte, deterministische Gleichstände, fehlerhafte Eingaben, große Werte und Genauigkeitsgrenzen berücksichtigt wurden. Es analysierte Dezimalzeichenfolgen, wandelte sie in exakte Ganzzahlwerte um und ordnete die verbleibenden Cent in einer stabilen Reihenfolge zu. Das nützliche Ergebnis war nicht nur plausibel aussehender Code: Die Anteile ergaben tatsächlich die richtige Summe.
Dies spricht dafür, Sonnet für eine gezielte Implementierung mit expliziten Akzeptanzkriterien einzusetzen. Es handelte sich hierbei um einen eigenständigen Funktionstest, nicht um eine eigenständige Repository-Reparatur oder ein Sicherheitsaudit. Für Produktionscode sollten Sie eigene Integrationstests hinzufügen und die Fehlerbehandlung in der umgebenden Anwendung überprüfen.
Codierungstest: 43 Prüfungen bestanden
Erste Antwort: 19,08 Sekunden. Alle 43 Prüfungen hinsichtlich korrekter Zuweisung, stabiler Verknüpfungen, Eingabevalidierung und Genauigkeit bestanden. Die Bewertung erfolgte als eigenständige Funktion, nicht als autonome Repository-Reparatur.
Claude Sonnet 5,5 · GlobalGPT · 1. Oktober 2026 · Obergrenze von 6.000 Token · keine Tools · Sampling und Aufwand auf den Standardeinstellungen des Dienstes belassen. Mit „Zeit“ ist die vollständige Antwort gemeint, nicht der erste Token.
Aufgabenanleitung
Ersetzen Sie die fehlerhafte Python-Funktion unten durch eine korrekte Implementierung von `allocate_cents(total: str, weights: list[str]) -> list[int]`. Geben Sie ausschließlich ausführbaren Python-Quellcode zurück, ohne Markdown-Fences oder Erläuterungen.

Anforderungen:
1. `total` ist ein nichtnegativer, endlicher USD-Betrag, der als Zeichenkette angegeben wird und null, eine oder zwei Dezimalstellen enthält, z. B. "0", "12.3" oder "12.34". Es sind ASCII-Dezimalziffern mit einem optionalen einzelnen Dezimalpunkt zulässig. Verwerfe Vorzeichen, Exponentialschreibweise, Leerzeichen, NaN/Infinity, eine leere Zeichenkette, einen nachgestellten Dezimalpunkt, einen vorangestellten Dezimalpunkt sowie mehr als zwei Dezimalstellen, einschließlich "1.000". Vorangestellte Nullen sind zulässig. Verwerfe Eingaben, die keine Zeichenkette sind, mit einem `ValueError`.
2. `weights` ist eine nicht leere Liste von Zeichenketten. Jede Zeichenkette besteht aus ASCII-Dezimalziffern, optional mit einem Dezimalpunkt und einer oder mehreren Ziffern dahinter. Es müssen endliche, nicht-negative Werte mit mindestens einem streng positiven Gewicht angegeben werden. Ungültige Zeichenfolgen, Vorzeichen, Exponentialschreibweise, Leerzeichen, Eingaben, die keine Zeichenfolgen sind, oder eine Eingabe für „weights“, die keine Liste ist, werden mit einem „ValueError“ zurückgewiesen. Führende Nullen sind zulässig.
3. Verwende „Decimal“, um die angegebenen Dezimalbeträge exakt zu analysieren und beizubehalten. Wandle Dollar in ganzzahlige Cent um. Weise ganzzahlige Cent proportional zu den Gewichten zu, wobei die Methode des größten Restes verwendet wird: Nimm den ganzzahligen Teil jeder exakten Quote und weise die verbleibenden Cent den größten Bruchresten zu. Bei Gleichstand entscheide anhand des niedrigeren ursprünglichen Index. Die zurückgegebene Liste muss die Eingabereihenfolge beibehalten und sich exakt auf die Gesamtzahl der Cent summieren.
4. Bei sehr großen gültigen Werten oder sehr ungleichen Gewichten darf die Genauigkeit nicht stillschweigend verloren gehen. Die Gewichte dürfen nicht verändert werden. Falls Importe erforderlich sind, dürfen diese nur aus „decimal“ oder „math“ stammen. Keine Datei-, Netzwerk-, Umgebungs-, Prozess- oder Ein-/Ausgabeoperationen.

Fehlerhafte Implementierung:
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    cents = round(float(total) * 100)
    values = [float(w) for w in weights]
    return [round(cents * w / sum(values)) for w in values]
Vollständige erste Ausgabe
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    from decimal import Decimal

 DIGITS = frozenset("0123456789")

    def valid(s, max_frac):
 if not isinstance(s, str) or not s:
 return False
 parts = s.split(".")
 if len(parts) > 2:
            return False
 if not parts[0] or not all(c in DIGITS for c in parts[0]):
 return False
 if len(parts) == 2:
 frac = parts[1]
 if not frac or not all(c in DIGITS for c in frac):
                return False
 if max_frac is not None and len(frac) > max_frac:
 return False
 return True

 def digits_to_int(digs):
 s = "".join(map(str, digs))
 value = 0
        step = 1000
 for i in range(0, len(s), step):
 chunk = s[i:i + step]
 value = value * (10 ** len(chunk)) + int(chunk)
        return value

 def to_scaled(s):
 # gibt (ganzzahlige Mantisse, Exponent) zurück, wobei value = Mantisse * 10**Exponent gilt
 d = Decimal(s)
 sign, digs, exp = d.as_tuple()
        return digits_to_int(digs), exp

 if not valid(total, 2):
 raise ValueError("ungültige Gesamtsumme")
    if not isinstance(weights, list) or len(weights) == 0:
 raise ValueError("ungültige Gewichte")
    for w in weights:
 if not valid(w, None):
 raise ValueError("ungültiges Gewicht")

 mant, exp = to_scaled(total)
    if exp >= -2:
 cents = mant * 10 ** (exp + 2)
    sonst:
 cents = mant // 10 ** (-exp - 2)  # bei gültiger Eingabe nicht erreichbar

 parsed = [to_scaled(w) for w in weights]
    min_exp = min(e for _, e in parsed)
    ints = [m * 10 ** (e - min_exp) for m, e in parsed]
    W = sum(ints)
    if W <= 0:
        raise ValueError("Mindestens ein Gewicht muss positiv sein")

 result = []
    rems = []
    for i, w in enumerate(ints):
 q, r = divmod(cents * w, W)
 result.append(q)
        rems.append((-r, i))

 remaining = cents - sum(result)
    rems.sort()
    for k in range(remaining):
 result[rems[k][1]] += 1
    return result
Dokumente: Die richtigen Datensätze nach Korrekturen und Duplikaten finden
Die dritte Aufgabe umfasste ein synthetisches Rechnungsbündel mit 13.078 Wörtern: 120 Basisdatensätze, acht Korrekturen und vier Archivkopien. Sonnet musste ausschließlich genehmigte Atlas-Rechnungen mit Datum im September 2026 auswählen, jeweils die höchste Version jedes Datensatzes verwenden und ein streng formatiertes JSON-Format mit der Gesamtsumme sowie drei sinnvollen Folgeprüfungen zurückgeben.
Es wurden alle ausgewählt 16 korrekte Rechnungs-IDs, gab genau das $15,305.66 insgesamt und hielt dabei die JSON-Struktur ein. Die nachfolgenden Schritte umfassten den Abgleich mit dem Hauptbuch, Belege für Korrekturen sowie die Überprüfung auf Duplikate und Stichtagsgrenzen. Eine alte Archivkopie wurde nicht als neue Rechnung gezählt.
Genau solche Details sind bei der Arbeit mit Dokumenten entscheidend: Die neueste Korrektur muss Vorrang haben, selbst wenn eine ältere Fassung später im Dokumentensatz auftaucht. Das Ergebnis ist vielversprechend für die Extraktion aus begrenzten Dokumenten. Es handelt sich jedoch noch um eine synthetische Übung, die weitaus kleiner ist als das angekündigte Kontextfenster mit einer Million Token; für wichtige Finanzanwendungen ist eine unabhängige Berechnung erforderlich.
Dokumententest: 16 Datensätze, genaue Gesamtzahl
Erste Antwort: 16,42 Sekunden. Alle 16 Rechnungs-IDs und der Gesamtbetrag von $15.305,66 stimmten mit der unabhängigen Referenz überein; auch das strikte JSON und drei Folgeabfragen waren korrekt.
Claude Sonnet 5,5 · GlobalGPT · 1. Oktober 2026 · Obergrenze von 6.000 Token · keine Tools · Sampling und Aufwand auf den Standardeinstellungen des Dienstes belassen. Mit „Zeit“ ist die vollständige Antwort gemeint, nicht der erste Token.
Das bereitgestellte synthetische Paket enthielt 120 Basisdatensätze, acht Korrekturen und vier Archivkopien (13.078 Wörter). Die Felder waren ID, Version, Projekt, Datum, Status, Betrag und beschreibende Anmerkungen. Die nachstehende Anleitung ist vollständig; das umfangreiche Quellpaket wird hier zusammengefasst.
Aufgabenanleitung
Überprüfen Sie die folgenden fiktiven Projektrechnungsdatensätze. Verwenden Sie für jede ID nur die höchste Version; identische doppelte Datensätze erzeugen keine zusätzlichen Rechnungen. Die höchste Version kann vor einer älteren Archivkopie erscheinen. Wählen Sie nur Datensätze aus, deren Endprojekt "Atlas" ist, deren Endstatus "genehmigt" lautet und deren Enddatum im September 2026 liegt. Die Beträge sind in USD angegeben. Geben Sie striktes JSON mit genau diesen Schlüsseln zurück: "ids" (eindeutige ausgewählte IDs, aufsteigend sortiert), „total_usd“ (eine Zeichenkette mit genau zwei Dezimalstellen) und „action_items“ (genau drei prägnante Zeichenketten, die sinnvolle nächste Buchhaltungsprüfungen angeben). Fügen Sie keine Markdown-Fences oder erklärenden Text hinzu. Ignorieren Sie beschreibende Anmerkungen bei der Filterung; alle Buchhaltungsfelder sind strukturiert. Berücksichtigen Sie keine Datensätze aus anderen Monaten, Entwürfe, Orion-Datensätze, alte Versionen oder doppelte Kopien.
Vollständige erste Ausgabe
{"ids":["INV-003","INV-008","INV-020","INV-032","INV-038","INV-044","INV-050","INV-056", "INV-062", "INV-068", "INV-074", "INV-086","INV-092","INV-098","INV-104","INV-116"],"total_usd":"15305,66","action_items":["Die 16 ausgewählten Rechnungen und den Gesamtbetrag von 15.305,66 USD mit dem Atlas-Hauptbuch und dem Nebenbuch für Verbindlichkeiten vom September 2026 abgleichen.","Überprüfen Sie die durch Korrekturen geänderten Datensätze (INV-003, INV-008, INV-020, INV-050 sowie die ausgeschlossenen INV-002, INV-014 und INV-026) auf Genehmigungsnachweise und Belege.","Vergewissern Sie sich, dass doppelte Archivkopien nicht als separate Rechnungen verbucht wurden, und prüfen Sie korrigierte Rechnungen, deren Datum nahe am Monatsende liegt, auf Abgrenzungs- oder Stichtagsprobleme."]}Sonnet 5.5 vs. Opus 5.5: Was sollten Sie verwenden?
Wählen Sie je nach Art der Aufgabe. Sonnet ist eine sinnvolle erste Wahl, wenn die Vorgaben und das Ziel klar sind. Opus ist die bessere Ausgangsbasis, wenn die Aufgabe ein kontinuierliches Urteilsvermögen erfordert, fehlende Annahmen aufgedeckt werden müssen oder eine lange Kette von Entscheidungen koordiniert werden muss. Lesen Sie unseren Claude Opus 5.5 – Testbericht um sich dieses Modell genauer anzusehen.
Sonnet 5.5 vs. Opus 5.5: Was sollten Sie verwenden?
| Deine Aufgabe | Empfohlener Einstiegspunkt | Warum |
|---|---|---|
| Eine kurze Kundenansprache umformulieren, einen Entwurf erstellen, Datensätze extrahieren | Sonnet 5.5 | Durch klare Vorgaben lässt sich die Qualität leichter überprüfen. |
| Einen Fehler im jeweiligen Bereich beheben oder eine bestimmte Funktion implementieren | Sonnet 5.5 | Starke Aufgabenausführung bei einer niedrigeren Ein- und Ausgabetokenrate. |
| Festlegung der Architektur bei unvollständigen Anforderungen | Opus 5.5 | Das Schwierige daran ist, ein beständiges Urteilsvermögen zu bewahren, nicht nur die Umsetzung. |
| Eine Kampagne mit Text, Bildern und Videos abschließen | GlobalGPT-Workflow für mehrere Modelle | Verwenden Sie Sonnet für die Kurzbeschreibungen und die speziellen Modelle der Vermögenswerte. |
Ein sinnvoller Arbeitsablauf besteht darin, ein leistungsfähigeres Schlussfolgerungsmodell zu beauftragen, einen schwierigen Plan zu bewerten, und anschließend Sonnet die vereinbarte Spezifikation sowie konkrete Prüfungen zu übergeben. Die Wahl des Modells kann sich von Phase zu Phase ändern. Sie müssen nicht jede kleine Überarbeitung zu Ihrer aufwendigsten Schlussfolgerungsaufgabe machen.
Setzen Sie Sonnet 5.5 für GlobalGPT ein
Dank GlobalGPT lässt sich das Modell sinnvoll in einen umfassenderen Arbeitsablauf integrieren. Öffnen Sie Claude Sonnet 5.5 für die Texterstellung oder Analyse und wechseln Sie dann zu einem anderen Modell, wenn das Projekt andere Schwerpunkte erfordert. Sie können ein Kampagnenkonzept entwickeln, den Text verfeinern, Bildmaterial erstellen und Videos produzieren, ohne den Arbeitsablauf über mehrere Abonnements hinweg neu aufbauen zu müssen.
Um ein besseres erstes Ergebnis zu erzielen, senden Sie bitte das Ausgangsmaterial zusammen mit einer kurzen Liste von Akzeptanzkriterien ein. Geben Sie bei Texten die Zielgruppe, die Länge, den Tonfall und die Fakten an, die unverändert bleiben müssen. Bei Code geben Sie bitte das Beispiel an, bei dem ein Fehler auftritt, sowie das erwartete Verhalten. Bei Dokumenten kennzeichnen Sie bitte die Quellabschnitte und geben Sie an, wie mit widersprüchlichen Versionen umgegangen werden soll. Diese Anregungen zum Schreiben, Recherchieren und Programmieren Ihnen wiederverwendbare Ausgangspunkte bieten.
Entwickler können ihren Terminal-Workflow außerdem über GlobalGPT CLI mit Claude-Code. Nutzen Sie die Website für das übergeordnete Projekt und die CLI, wo immer es in den Entwicklungsprozess passt. Der Vorteil liegt in einem vernetzten Werkzeugsatz, bei dem die Wahl des Modells von der jeweils nächsten Aufgabe bestimmt wird.
Wissenswerte Einschränkungen und Details zum Upgrade
Hoher Einsatz ist eine Entscheidung, keine Qualitätsgarantie. Sonnet kann ein eng gefasstes Problem übermäßig bearbeiten oder über die angeforderten Änderungen hinausgehen. Weisen Sie das Programm an, den Umfang beizubehalten, die entsprechenden Prüfungen durchzuführen und den Vorgang zu beenden, sobald die Abnahmekriterien erfüllt sind. Wenn das Produkt Möglichkeiten zur Aufwandssteuerung bietet, vergleichen Sie die Qualität und die Kosten der abgeschlossenen Aufgaben, bevor Sie diese erhöhen.
Aktuelle Fakten erfordern nach wie vor aktuelle Quellen. Der Wissensstand des Modells vom Juni 2026 umfasst nicht die aktuellen Informationen zu allen Preisen, Richtlinien oder Veröffentlichungen. Stellen Sie das aktuelle Dokument bereit oder nutzen Sie einen Workflow mit Suchwerkzeugen. Bei sensiblen Inhalten überprüfen Sie bitte die Datenschutz- und Aufbewahrungsbedingungen des von Ihnen tatsächlich genutzten Dienstes und Kontos; der Name des Modells hat keinen Einfluss auf diese Einstellungen.
API-Migrationen erfordern mehr als nur einen Austausch des Modellnamens. Sonnet 5.5 ändert einige ältere Anforderungsmuster. Die direkte Claude-API lehnt nicht standardmäßige Einstellungen für Temperatur, top_p und top_k ab, und veraltete Denkweisen oder erzwungene Tool-Konfigurationen müssen möglicherweise aktualisiert werden. Adaptives Denken ist die Standardeinstellung; der dokumentierte „between_tools“-Modus entfallen das Vorab-Denken bei hohem Aufwand oder darunter. Die aktuelle Übersicht dokumentiert außerdem, dass die erzwungene Werkzeugnutzung einen Fehler zurückgibt, ältere computergestützte Werkzeuge bei der Claude-API und in Google Cloud nicht akzeptiert werden und Text zwischen Werkzeugaufrufen in Denkblöcken ankommen kann. Überprüfen Sie die Offizieller Migrationsleitfaden bevor eine Anwendung verschoben wird. Unsere Claude-API-Handbuch behandelt die allgemeinen Konzepte zur Einrichtung und Abrechnung.
Anthropic wendet außerdem Sicherheitsvorkehrungen auf Anfragen im Bereich Cybersicherheit und Biologie an, die ein höheres Risiko bergen. Die routinemäßige Softwareentwicklung bleibt weiterhin Teil des vorgesehenen Verwendungszwecks des Modells. Wenn eine Aufgabe legitim, aber sensibel ist, beschreiben Sie den Umfang und die Berechtigungen klar und deutlich, anstatt davon auszugehen, dass jede Ablehnung eine allgemeine Einschränkung der Programmiermöglichkeiten darstellt.
Fazit: Ein gutes Modell, das sich gut in Ihren täglichen Arbeitsablauf integrieren lässt
Sonnet 5.5 verdient sich seinen Platz durch praktische, überprüfbare Arbeit. Die wichtigsten Argumente für den Einsatz sind leistungsfähige, in den Geltungsbereich begrenzte Programmierung und nützliche Dokumentenverarbeitung zu einem niedrigeren API-Token-Preis als bei Opus. Auch das Verfassen von Texten eignet sich gut, mit einer abschließenden Überprüfung auf plausible Details, die nie im Auftrag enthalten waren. Unser kleiner Testsatz untermauert diese Positionierung für den Arbeitsalltag; er belegt jedoch keinen universellen Vorsprung in Bezug auf Geschwindigkeit, Kosten oder komplexe Schlussfolgerungen.
Beginnen Sie mit einer konkreten Aufgabe, deren Ergebnis Sie beurteilen können. Legen Sie die Rahmenbedingungen klar fest, prüfen Sie die wichtigen Details und wechseln Sie zu einem anderen Modell, wenn sich das Problem ändert. Versuche es mit Sonnet 5.5 auf GlobalGPT um das Schreiben, das Programmieren, die Analyse und den nächsten kreativen Schritt in einem multimodalen Arbeitsablauf zu vereinen.
Häufig gestellte Fragen
Was ist Claude Sonnet 5.5?
Claude Sonnet 5.5 ist ein Anthropic-Modell, das am 28. September 2026 auf den Markt kam. Es unterstützt die Eingabe von Text und Bildern sowie die Ausgabe von Text und ist für schnelles Programmieren im Alltag, das Verfassen von Texten, die Arbeit mit Dokumenten und werkzeuggestützte Arbeitsabläufe konzipiert.
Wie viel kostet Claude Sonnet 5.5?
Der Standardpreis für die API von Anthropic beträgt $2 pro Million Eingabe-Token und $10 pro Million Ausgabe-Token. Cache-Lesevorgänge kosten $0,10 pro Million Token. Claude-App-Abonnements und GlobalGPT-Tarife sind von diesen API-Tarifen getrennt.
Ist Claude Sonnet 5,5 schneller als Sonnet 5?
Anthropic generiert Ausgaben um mehr als 30% schneller als Sonnet 5. In unserem GlobalGPT-Schreibtest dauerten drei vollständige Antworten 11,60–12,16 Sekunden. Da wir das Sonnet 5 nicht als Kontrollgerät getestet haben, lässt sich anhand unseres Tests keine Geschwindigkeitssteigerung von einer Generation zur nächsten messen.
Ist Sonnet 5.5 besser als Opus 5.5?
Wählen Sie Sonnet 5.5 für klar definierte Aufgaben und einen niedrigeren Preis pro Eingabe-/Ausgabe-Token. Opus 5.5 ist die bessere Ausgangsbasis für komplexe, offen gestaltete Aufgaben, die ein kontinuierliches Urteilsvermögen erfordern. Sonnet liegt in einigen veröffentlichten Bewertungen an der Spitze, doch gibt es keinen eindeutigen Sieger.
Kann Claude Sonnet 5.5 auch umfangreiche Dokumente verarbeiten?
Die Claude-API sieht ein Kontextfenster von einer Million Token vor. In unserem kleineren Test mit einem synthetischen Dokument von 13.078 Wörtern wählte Sonnet alle 16 in Frage kommenden Datensätze aus und berechnete die richtige Gesamtsumme. Dieses Ergebnis sagt jedoch nichts über die Genauigkeit über das gesamte angegebene Kontextfenster aus.
Kann ich Claude Sonnet 5.5 auf GlobalGPT verwenden?
Ja. GlobalGPT bietet neben anderen KI-Modellen auch Claude Sonnet 5.5 an, sodass Sie auf einer einzigen Plattform Entwürfe erstellen, programmieren, Dokumente analysieren und anschließend mit der Bild- oder Videobearbeitung fortfahren können.
Quellen und Testnotizen
Die technischen Daten und Preise zum Markteintritt wurden am 13. Oktober 2026 überprüft; die folgenden Praxistests fanden am 1. Oktober 2026 statt. Wichtigste Quellen: Ankündigung der Markteinführung von Anthropic, Modellreferenz Sonnet 5.5, API-Preise, und Claude Abonnementpreise. Unabhängige Informationen stammen aus „Artificial Analysis“ und der oben verlinkten CodeRabbit-Studie.
Bei den GlobalGPT-Tests wurde die erste vollständige Antwort bei drei Aufgaben sowie bei zwei Wiederholungsaufgaben im schriftlichen Teil herangezogen. Es wurden keine externen Tools aktiviert. Die Zeitangaben beziehen sich auf vollständige Antworten, einschließlich Netzwerk- und Service-Overhead; es wurde kein Wert für den Denk-Aufwand ausgewählt. Das Rechnungs-Paket war synthetisch und enthielt keine Kundendaten. Die Abbildung der Kopfzeile wurde für diesen Test erstellt; die anderen Bilder sind Screenshots der genannten Websites.









