

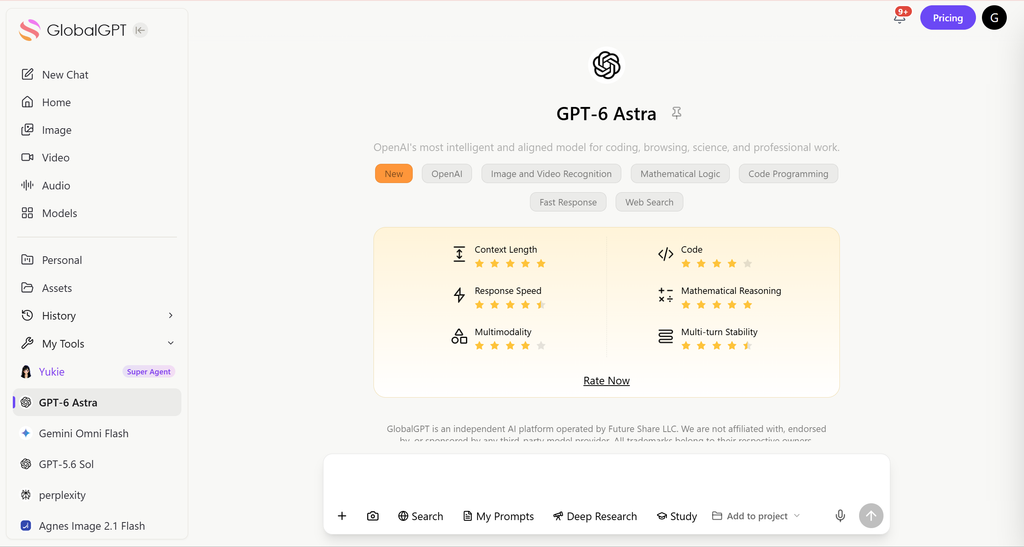
Aktueller Stand, Stand: 24. September 2026: ChatGPT 5.1 und Grok 4.1 sind historische Vergleichswerte und nicht die aktuellen Standardmodelle. Die aktuelle Modelldokumentation von xAI führt das Modell Grok 4.6 als sein Flaggschiff-Allzweckmodell mit einem Kontextumfang von 500.000 Token und einer Eingangsleistung von $2 bzw. einer Ausgangsleistung von $6 pro 1 Mio. Token auf. Das Modell OpenAI Aktueller Modellkatalog ist über GPT-5.1 hinausgegangen, während GlobalGPT listet derzeit GPT-6 Astra auf und Grok 4,6. Die folgenden Abschnitte zum Leistungsvergleich behalten ihren für das Jahr 2025 geltenden Umfang bei; verwenden Sie keine alten Ergebnisse, Latenzwerte oder Abonnementpreise als aktuelle Produktangaben.
Die Wahl zwischen ChatGPT 5.1 und Grok 4.1 hängt letztendlich davon ab, ob Sie emotionalen Ausdruck oder technische Präzision in den Vordergrund stellen. Grok 4.1 dominiert bei kreativen und persönlichkeitsorientierten Aufgaben mit einer rekordverdächtigen Punktzahl von 1586 im EQ-Bench und einer äußerst aggressiven Preisgestaltung. Im Gegensatz dazu bleibt ChatGPT 5.1 der Goldstandard für Unternehmensumgebungen und nutzt spezialisierte “Thinking”-Modelle, um überragende Zuverlässigkeit bei komplexen Benchmarks für Programmierung und logisches Denken wie SWE-bench Verified zu erzielen. .
Die KI-Landschaft des Jahres 2025 führt zu einer scharfen Trennung zwischen “kreativen Akteuren” und “Unternehmensfachleuten” und zwingt die Nutzer dazu, sich zwischen ungefilterter Persönlichkeit und Sicherheit auf Unternehmensniveau zu entscheiden. Diese Fragmentierung lässt viele zwischen unverfälschter Authentizität und bewährter Zuverlässigkeit hin- und hergerissen zurück.
Zum Glück, GlobalGPT ermöglicht den Zugriff auf beide führenden KI-Systeme. Gleichzeitig entfällt die Notwendigkeit, Kompromisse zwischen dem Witz von Grok und der Präzision von ChatGPT einzugehen. Durch die Zusammenführung von Modellen wie GPT-6 Astra, Grok 4.1, Claude 4.5, Sora 2, Veo 3.1, Durch die Zusammenführung von Unikorn und Kling zu einer einzigen Plattform können Nutzer für jede spezifische Aufgabe das ideale Tool einsetzen, ohne mehrere Abonnements verwalten zu müssen.
Der grundlegende Philosophiewechsel: “Unternehmenssicherheit” vs. “ungefilterte Persönlichkeit”
Der grundlegende Unterschied zwischen diesen beiden Modellen liegt in ihrer Designphilosophie: OpenAI legt den Schwerpunkt auf vorhersehbare Unternehmensfunktionalität, während xAI auf Interaktion und unverfälschte Authentizität optimiert ist.

- ChatGPT 5.1 – Der “adaptive Fachmann”: Dieses auf Stabilität ausgelegte Modell nutzt ein dynamisches Routing-System, das automatisch zwischen “Instant”-Routen für einfache Aufgaben und tiefen “Denk”-Modelle für komplexe Logik. Es wurde entwickelt, um die Haftung zu minimieren, und hält sich an strenge Sicherheitsrichtlinien, die verhindern, dass es bei heiklen oder “sensiblen” Themen, was es zur bevorzugten Wahl für Unternehmensumgebungen macht.
- Grok 4.1 – Der “Rebellenagent”: xAI hat Grok so entwickelt, dass es als Agent mit “maximaler Neugier” fungiert, der sich aktiv gegen “woke”-Zensur oder bereinigte Antworten wehrt. Es nutzt eine massive parallele Schwarmarchitektur, um Hypothesen intern zu diskutieren, was zu Antworten führt, die menschlicher, witziger und gelegentlich kontrovers wirken und sich speziell an Nutzer richten, die sich durch die üblichen KI-Sicherheitsvorkehrungen eingeschränkt fühlen.
- Das Ende der Ära des “Einheitsmodells”: Im Jahr 2025 hat sich der Markt zersplittert; die Nutzer suchen nicht mehr nach einer einzigen “intelligentesten” KI, sondern treffen ihre Wahl vielmehr anhand der “Ausstrahlung” und des spezifischen Nutzens, der für die jeweilige Aufgabe erforderlich ist. Man muss sich praktisch zwischen einem höflichen, äußerst kompetenten Mitarbeiter (ChatGPT) und einem brillanten, aber unberechenbaren kreativen Partner (Grok) entscheiden.
Technische Architektur im Detail: Ein Blick hinter die Kulissen
Ein Vergleich der technischen Spezifikationen zeigt, wie unterschiedlich die technischen Prioritäten von OpenAI und xAI sind.
| Merkmal | ChatGPT 5.1 (OpenAI) | Grok 4.1 (xAI) |
| Kontextfenster-Strategie | 128k Aktiv + Tiefes Gedächtnis (Priorisiert die Genauigkeit der Suche gegenüber der Rohdatenlänge) | 2 Millionen Token (gestaffelt) (128k “Heißes” Denken + “Warmes” Abrufen) |
| Kernarchitektur | Dynamische Routenplanung (Wechselt zwischen den Pfaden “Sofort” und “Nachdenken”) | Parallele Agenten-Schwärme (Erzeugt mehrere interne Agenten, um Antworten zu diskutieren) |
| Sprach-/Antwortverzögerung | ~550 ms (Für Gesprächsgeschwindigkeit optimiert) | ~1200 ms+ (Höhere Latenz aufgrund von Schwarmverarbeitung) |
| Wissensquelle | Vortrainiert + Websuche (Verwendet die Suche, um Fakten zu überprüfen) | Echtzeit-X (Twitter)-Stream (Nativer Zugriff auf Live-Social-Daten) |
- Kontextfenster-KriegGrok 4.1 verfügt über beeindruckende 2 Millionen Token-Kontextfenster, Dabei kommt ein mehrstufiges System zum Einsatz, bei dem die ersten 128k Token als “heiß” (aktives Schlussfolgern) gelten und der Rest als “warmer” Abrufspeicher dient. Im Gegensatz dazu stützt sich ChatGPT 5.1 in der Regel auf eine Deep-Memory-RAG-Schicht mit einer strengeren Begrenzung des aktiven Kontexts (häufig etwa 128.000–196.000), wobei die Genauigkeit des Abrufs Vorrang vor der reinen Kontextlänge hat.
- Argumentationsarchitektur: OpenAI nutzt einen Denkprozess nach dem “System 2”-Ansatz, bei dem das Modell vor der Antwort eine Pause einlegt, um Gedanken miteinander zu verknüpfen, wodurch die Halluzinationsrate bei Mathematik- und Programmieraufgaben. Grok 4.1 nutzt “Parallel Agentic Swarms” und generiert dabei mehrere interne Agenten, die Antworten in Echtzeit bewerten und verfeinern, was sich besonders bei komplexen, mehrstufigen agentenbasierten Arbeitsabläufen als effektiv erweist.
- Latenz & Geschwindigkeit: Für schnelle Interaktionen ist der ’Instant“-Modus von ChatGPT 5.1 auf Reaktionszeiten im Subsekundenbereich optimiert und eignet sich daher ideal für schnelle Abfragen. Grok 4.1 Fast wurde entwickelt, um Geschwindigkeit und Tool-Nutzung in Einklang zu bringen, doch da es auf die Abfrage von Echtzeit-X-Daten (Twitter) angewiesen ist, kann es im Vergleich zur vortrainierten Wissensdatenbank von ChatGPT zu variablen Latenzzeiten kommen.

Direkte Vergleiche: Was offizielle Daten sagen
Während der Marketing-Hype lautstark ist, zeichnen die offiziellen Benchmark-Ergebnisse ein klares Bild davon, wo jedes Modell tatsächlich dominiert.
- Emotionale Intelligenz (EQ)Grok 4.1 erzielte mit 1586 Punkten einen Rekordwert in der EQ-Bench-Rangliste und übertraf seine Konkurrenten deutlich durch sein Verständnis für Nuancen, Sarkasmus und Subtext(). Dank seines hohen EQs eignet es sich hervorragend für Aufgaben, die Einfühlungsvermögen erfordern, wie das Verfassen schwieriger E-Mails oder kreatives Storytelling, bei denen roboterhafte Antworten befremdlich wirken würden.

- Wissenschaftliches Denken: Beim GPQA-Diamond-Benchmark (wissenschaftliche Fragen auf Doktoranden-Niveau) wurde im Snapshot von 2025 Gemini 3 als führende Option präsentiert, doch GPT-5.1 (Pro/Thinking) folgt dicht dahinter mit Werten um 81–87% und beweist damit extreme Zuverlässigkeit für die akademische Forschung. Grok 4.1 schneidet hervorragend ab, bleibt jedoch in Bezug auf die rein wissenschaftliche Genauigkeit im Allgemeinen etwas hinter den speziellen “Reasoning”-Modellen zurück.
- Faktizität & HalluzinationenGrok 4.1 hat seine Halluzinationsrate durch den Einsatz von Echtzeit-Suchverifizierungs-Tools auf etwa 4,22% reduziert. ChatGPT 5.1 nutzt seine “Denkmodus” zur Gegenprüfung von Fakten, mit dem Ziel, ähnliche Senkungen der Fehlerquoten zu erreichen, insbesondere in Fachbereichen mit “hohem” Schwierigkeitsgrad wie Biologie und Chemie.

Codierung und Entwicklung: Präzision vs. agentenbasierter Workflow
Für Entwickler hängt die Wahl davon ab, ob Sie präzise Code-Änderungen oder einen autonomen Full-Stack-Agenten benötigen.
- Für Entwickler – GPT-5.1ChatGPT 5.1 zeichnet sich durch die Aufrechterhaltung der Repository-Integrität mithilfe des
Patch anwendenTool, mit dem chirurgische Änderungen an bestehenden Codebasen vorgenommen werden können, ohne ganze Dateien neu schreiben zu müssen. Es erzielt eine hohe Punktzahl bei SWE-bench Verified (ca. 74,91 TP3T) und ist damit die sicherere Wahl für die Integration in etablierte Unternehmenspipelines, in denen grundlegende Änderungen nicht akzeptabel sind.

- Für Full-Stack-Agenten – Grok 4.1: Grok überzeugt in agentenbasierten Arbeitsabläufen durch seine “Agent Tools API”, die es ermöglicht, mehrere Aktionen – wie das Durchsuchen von Dokumentation, das Schreiben von Code und dessen Ausführung – in einer Schleife miteinander zu verknüpfen. Es ist für “Vibe-Coding” optimiert, bei dem ein Entwickler ein übergeordnetes Ziel beschreibt und Grok mithilfe seines umfangreichen Kontextfensters, das den gesamten Projektumfang erfasst, rasch einen funktionsfähigen Prototyp einer Lösung erstellt.
- SWE-Bench Verifizierte ErgebnisseWährend GPT-5.1 eine verifizierte Punktzahl von ~74,91 TP3T aufweist, behauptet Grok 4.1 eine wettbewerbsfähige Leistung in derselben Kategorie (791 TP3T laut einigen Vergleichen), die auf seiner Fähigkeit zur Selbstkorrektur mithilfe paralleler Agentenschwärme beruht.

Wenn Sie diese Codierungsfunktionen anhand Ihrer eigenen Codebasis miteinander vergleichen möchten, bietet GlobalGPT eine einheitliche Umgebung, in der beide Modelle mit derselben Eingabeaufforderung ausgeführt werden können.
9-runder “Vibe Check” unter realen Bedingungen: Usability-Tests
Wie bewähren sich diese Modelle im täglichen Gebrauch, abgesehen von Benchmarks? Tests zeigen unterschiedliche Eigenschaften.

- Kreatives Schreiben: In Blindtests bevorzugten die Nutzer in 641 von 400 Fällen die kreativen Ergebnisse von Grok, da diese Spannung erzeugen, sensorische Details nutzen und die bei ChatGPT häufig anzutreffende klischeehafte ’KI-Stimme“ vermeiden. Grok ist bereit, erzählerische Risiken einzugehen, während ChatGPT 5,1 oft auf sichere, ”disneyfierte“ Lösungen zurückgreift.

- Logik & Fallen: Bei sprachlichen Fangfragen (z. B. “17 Schafe, alle bis auf 9 sterben”) erkennt Grok 4.1 die sprachliche Falle korrekt und erklärt warum Das ist ein Trick. ChatGPT 5.1 löst die rechnerische Aufgabe zwar korrekt, übersieht dabei aber oft die sprachlichen Nuancen und behandelt sie als rein logisches Problem.
- Humor & Tonfall: Grok 4.1 zeichnet sich durch Humor im “Roast”-Stil und schwarze Komödie aus und erzeugt Stand-up-Sketche, die provokant und menschlich wirken. ChatGPT 5.1 tut sich hier schwer und produziert aufgrund seiner strengen Ausrichtung auf Sicherheit oft “harmlose Witze” oder „Vaterwitze“, denen der für echte Komik erforderliche Biss fehlt.
Multimodale Funktionen: Bild, Sprache und Video
Die Fähigkeit, Medien zu sehen, zu hören und zu generieren, ist ein entscheidender Wettbewerbsfaktor.

- VideogenerierungChatGPT 5.1 lässt sich nativ integrieren mit Sora 2, wodurch Benutzer physikalisch korrekte Videos erzeugen Clips (bis zu 25 Sekunden) direkt in der Chat-Oberfläche. Im Vergleich von 2025 verfügte Grok 4.1 nicht über ein natives Modell zur Videogenerierung dieses Kalibers, sondern stützte sich stattdessen auf Bildgenerierungsmodelle wie Aurora oder Flux, wodurch es bei Video-Workflows ins Hintertreffen geriet.
- Latenz im Sprachmodus: Bei der Sprachinteraktion in Echtzeit ist die Latenz entscheidend. Der Sprachmodus von GPT-5.1 liegt bei etwa 550 ms und sorgt so für ein flüssiges, dialogorientiertes Erlebnis. Die Audioverarbeitung von Grok 4.1 ist langsamer, wobei die Latenzzeiten oft 1200 ms überschreiten, was eher an einen Walkie-Talkie-Austausch als an ein natürliches Gespräch erinnert.
- BildanalyseGPT-5.1 (insbesondere mit aktivierter Denkfunktion) zeichnet sich durch seine Fähigkeit zur Analyse wissenschaftlicher Abbildungen und Diagramme aus und erzielt beim CharXiv-Benchmark hohe Punktzahlen. Grok 4.1 nutzt seine visuellen Fähigkeiten in erster Linie zur Analyse von Bildern und Memes aus sozialen Medien von X, was ihm einen kulturellen Vorteil, aber einen wissenschaftlichen Nachteil verschafft.
Sicherheit, Zensur und Ablehnungsquoten
Die “Woke”-Debatte spielt bei der Vermarktung dieser Modelle eine zentrale Rolle.

- Die “Woke”-Debatte: Grok 4.1 fördert eine Haltung der “maximalen Neugier” mit einer Ablehnungsrate von weniger als 1% bei sensiblen Themen, wodurch es bereit ist, kontroverse politische oder gesellschaftliche Themen zu diskutieren, die andere Modelle meiden.
- Unternehmenskonformität: ChatGPT 5.1 weist bei allgemeinen Nutzern eine Ablehnungsrate von etwa 4,5% auf, bietet jedoch für Unternehmenskunden “Vertrauensstufen” an, die gewährleisten, dass Unternehmensinhalte arbeitsplatztauglich bleiben (NSFW-Filter, Einhaltung gesetzlicher Vorschriften)()()()(). Damit ist es die einzige praktikable Wahl für Fortune-500-Unternehmen, die keine PR-Katastrophen riskieren können.
- Umgang mit medizinischer/rechtlicher Beratung: Trotz seines “rebellischen” Images ist Grok 4.1 bei medizinischen Ratschlägen überraschend konservativ und überlässt die Entscheidung oft ausschließlich Fachleuten, um Haftungsrisiken zu vermeiden. ChatGPT 5.1, das durch die HealthBench-Bewertung verbessert wurde, versucht, ein hilfreicher “Denkpartner” zu sein und gleichzeitig auf Risiken hinzuweisen, wobei es detailliertere medizinische Hintergründe liefert als Grok()()()().
Die Token-Ökonomie: Preisübersicht 2025 (historisch)
Bei der Preisgestaltung versetzt Grok 4.1 der Konkurrenz den größten Schlag.

- API PreisschockxAI hat Grok 4.1 Fast zu einem aggressiven Preis von $0,20 pro Million eingegebene Token, was ungefähr 84% günstiger als die $1,25 pro Million Eingabetoken bei ChatGPT 5.1. Für Entwickler, die Anwendungen mit hohem Datenvolumen erstellen, ist dieser Preisunterschied ein entscheidender Faktor.
- Die “Abonnementfalle”Um auf die beste Version von Grok (ohne API) zugreifen zu können, müssen Benutzer ein Abonnement abschließen. X Premium+ ($16/Monat). Um das Beste aus ChatGPT herauszuholen, benötigen Sie ChatGPT Plus ($20/Monat). Die Aufrechterhaltung beider Abonnements kostet über $400/Jahr, was zu einer erheblichen “Abonnement-Müdigkeit” führt.”
- Entwickler-EinsparungenFür eine App, die monatlich 100 Millionen Tokens verarbeitet, könnte die Verwendung von Grok 4.1 anstelle von GPT-5.1 einem Start-up über $1.000 pro Monat an API-Kosten einsparen ($20 gegenüber $125+).
Der “hybride Arbeitsablauf”: Effizienz maximieren
Anstatt sich für eines zu entscheiden, kombinieren die effektivsten Power-User im Jahr 2025 beide Modelle, um ihre jeweiligen Stärken zu nutzen.

- Phase 1: Ideenfindung und Recherche (Grok 4.1)Beginnen Sie mit Grok 4.1, um Ideen zu sammeln, kreative Inhalte zu entwerfen oder mithilfe der X-Integration Echtzeit-Nachrichtenereignisse zu recherchieren. Dank seines hohen EQ und seiner geringen Ablehnungsrate eignet es sich perfekt für die Generierung von rohen, ungefilterten Konzepten.
- Phase 2: Struktur & Codierung (ChatGPT 5.1): Nehmen Sie den Rohentwurf oder das Konzept und übergeben Sie es an ChatGPT 5.1, um die Struktur zu verfeinern, die Logik zu überprüfen oder die Idee mithilfe der
Patch anwendenWerkzeug. - Phase 3: Visuelle Überprüfung (Gemini 3)Wenn das Projekt komplexe visuelle Daten oder wissenschaftliche Diagramme umfasst, verwenden Sie Gemini 3 zur Überprüfung der visuellen Elemente, da es derzeit in Benchmarks zum visuellen Denken führend ist().
Die einheitliche Lösung: Zugriff auf alle Modelle über GlobalGPT
Die Verwaltung von drei separaten Abonnements und API-Schlüsseln ist ineffizient und kostspielig.


- Lösung für AbonnementmüdigkeitGlobalGPT integriert GPT-6 Astra, Grok 4.6 und Zwillinge 3 in einer einzigen Schnittstelle, die es Benutzern ermöglicht, Zugang zu über 100 Top-Modellen ab bei $10,8/Monat bei jährlicher Abrechnung. Dadurch entfällt die Notwendigkeit, monatlich $50+ für separate Abonnements von X Premium+, ChatGPT Plus und Google One zu zahlen.

- Ausgaben nebeneinander vergleichenDie Plattform ermöglicht einen nahtlosen Modellwechsel, sodass Benutzer denselben Befehl sofort sowohl für Grok als auch für GPT-5.1 ausführen können, um die Ergebnisse zu vergleichen, ohne zwischen Registerkarten wechseln oder sich bei verschiedenen Konten anmelden zu müssen.
- Regionssperren aufhebenGlobalGPT bietet Zugriff auf regional beschränkte Modelle (wie Claude 4.5 oder Grok in der EU), ohne dass komplexe VPN-Einrichtungen oder die Überprüfung ausländischer Telefonnummern erforderlich sind.
Endgültiges Urteil: Welches Modell sollten Sie wählen?
- Die Wahl der Entwickler (historische GPT-5.1-Basislinie)Wenn Sie zuverlässige, strukturierte Codegenerierung und Sicherheit auf Unternehmensniveau benötigen, ist ChatGPT 5.1 unverzichtbar. Seine
Patch anwendenWerkzeug und hohe SWE-Benchmark-Ergebnisse machen es zum Industriestandard. - Die Wahl des Schöpfers (historische Grok 4.1-Basislinie)Wenn Sie einen Schreibpartner mit Persönlichkeit, Humor und ohne moralische Filter suchen, ist Grok 4.1 die beste Wahl. Dank seiner geringen Kosten und seiner hohen EQ ist es das beste Tool für die Erstellung von Inhalten.
- Die Wahl des Forschers (Gemini 3)Für reine wissenschaftliche Entdeckungen und die Analyse komplexer visueller Daten bleibt Gemini 3 der unangefochtene Spezialist und übertrifft allgemeine Modelle bei tiefgreifenden Denkaufgaben.
Für ein neues Projekt im Jahr 2026: Verwenden Sie GPT-6 Astra oder eine andere aktuelle OpenAI-Route für strukturierte Aufgaben und Grok 4.6, wenn Sie das aktuelle allgemeine Modell von xAI sowie optionale Suchwerkzeuge benötigen. Nutzen Sie den unten aufgeführten älteren Benchmark, um den ursprünglichen Kompromiss zu verstehen – nicht als aktuelle Preis- oder Verfügbarkeitstabelle.
Häufig gestellte Fragen (FAQ)
- Kann Grok 4.1 PDF-Dateien genauso gut analysieren wie ChatGPT?
- Ja, Grok 4.1 unterstützt nun das Hochladen von Dateien und kann über die Agent Tools-API Informationen aus Dokumenten abrufen, ähnlich wie die Analysefunktionen von ChatGPT.
- Unterstützt GlobalGPT die “Pro”-Versionen dieser Modelle?
- Ja, GlobalGPT bietet Zugriff auf High-End-Modelle wie Sora 2 Pro und GPT-5.1, die normalerweise hinter teuren Abonnements auf offiziellen Plattformen versteckt sind.
- Ist ChatGPT 5.1 bei einfachen Abfragen schneller als Grok 4.1?
- Ja, dank seines “Instant”-Modus beantwortet ChatGPT 5.1 einfache Abfragen in der Regel in weniger als einer Sekunde (ca. 550 ms), während Grok 4.1 aufgrund des durch die Schwarmverarbeitung verursachten Overheads länger brauchen kann.
Was sollte ich für ein neues Projekt im Jahr 2026 verwenden?
Testen Sie zunächst GPT-6 Astra und Grok 4.6 anhand derselben Eingabeaufforderungen, Dateien, Tools und Akzeptanzkriterien. GPT-6 Astra ist der derzeitige GlobalGPT-Planungsansatz für strukturierte Aufgaben; Grok 4.6 ist das aktuelle Flaggschiff-Allgemeinmodell von xAI.
Wie hoch ist der aktuelle Preis für Grok 4.6 API?
In der aktuellen Dokumentation von xAI wird Grok 4.6 mit $2 pro 1 Million Eingabetoken und $6 pro 1 Million Ausgabetoken bei einem Kontextumfang von 500.000 Token angegeben. Dies ist unabhängig von etwaigen Abonnementpreisen für Endkunden.
Sind die Benchmark-Werte ChatGPT 5,1 und Grok 4,1 noch aktuell?
Nein. Die Bewertungen, Latenzschätzungen, Modellgrenzen und Abonnementpreise im ursprünglichen Vergleich beziehen sich auf den Testzeitraum 2025. Betrachten Sie diese als historischen Kontext und führen Sie die Tests mit den aktuellen Modell-IDs erneut durch, bevor Sie eine Kauf- oder Integrationsentscheidung treffen.



