
Kurze Antwort: GPT-6 Sol hat die getestete, aus fünf Abschnitten bestehende Aufgabenstellung unter einer Ausgabebegrenzung von 2.400 Token abgeschlossen; Claude Opus 5.5 lieferte bei unserer kurzen Code-Review-Aufgabe die präzisere Diagnose. Keines der beiden Ergebnisse lässt einen dauerhaften Gesamtsieger erkennen.
Der aussagekräftige Vergleich geht über eine reine Punktzahl hinaus. Claude Opus 5.5 und GPT-6 Sol unterscheiden sich darin, wie sie mit dem Verfassen von Texten, der Zusammenfassung von Forschungsergebnissen, der Code-Prüfung, strukturierten Antworten, Zugriffswegen und dem täglichen Arbeitsablauf umgehen. Die unten aufgeführten Aufgaben-Ergebnisse zeigen, wo diese Unterschiede ins Gewicht fallen.
GlobalGPT bietet Ihnen beide Modelle in einem kostengünstigen Multi-Modell-Abonnement, zusammen mit weiteren Modellen und KI-Funktionen. Über ein einziges Dashboard lässt sich ein Projekt von der Recherche und dem Verfassen von Texten bis hin zur Programmierung, Bildbearbeitung und Videoproduktion begleiten, während die Befehlszeilenschnittstelle (CLI) denselben Arbeitskontext mit Terminal- und Produktionswerkzeugen verbindet.
Kurze Antwort
Wählen Sie GPT-6 Sol Zunächst zum hier getesteten Workflow für das Schreiben unter Vorgaben: Er hat alle fünf Abschnitte innerhalb der festgelegten Obergrenze von 2.400 Token abgeschlossen. Wählen Sie Claude Opus 5,5 wenn Diagnose, explizite Risikoanalyse und striktes JSON eine größere Rolle spielen. Verwenden Sie beides, wenn sich die Arbeitsabläufe im Laufe des Tages ändern.
Was die einzelnen Modelle besonders gut können
Claude Opus 5,5 eignet sich für bewusste Arbeit: das Überprüfen einer Codeänderung, das Entwirren einer unübersichtlichen Anforderung, das Benennen von Risiken und die Einhaltung eines strengen Output-Vertrags. Anthropic konzentriert sich dabei auf das Programmieren, den Umgang mit Computern, Wissensarbeit, Sicherheit und eine natürlichere Kommunikation während langer Sitzungen. Siehe die Claude Opus 5.5 – Testbericht für eine separate, modellorientierte Betrachtung. Dies ist die naheliegende Wahl, wenn eine sorgfältige zweite Durchsicht mehr wert ist als eine kürzere erste Antwort.
GPT-6 Sol passt den Durchsatz an die Vorgaben an: ein umfangreiches Briefing, ein Entscheidungsmemo, ein strukturierter Plan oder ein Entwurf, der viele geforderte Abschnitte enthalten muss. OpenAI wird als kostengünstigeres GPT-6-Modell für professionelle Arbeit, Sachlichkeit, Programmierung, Computernutzung und Zusammenarbeit beschrieben. Das Testbericht zum GPT-6 Sol befasst sich eigenständig mit dem Modell; in der hier vorgestellten Langform-Aufgabe hat es den Vertrag bereits in der ersten Ausgabe erfüllt, was nützlich ist, wenn die Kosten für einen fehlenden Abschnitt hoch sind.
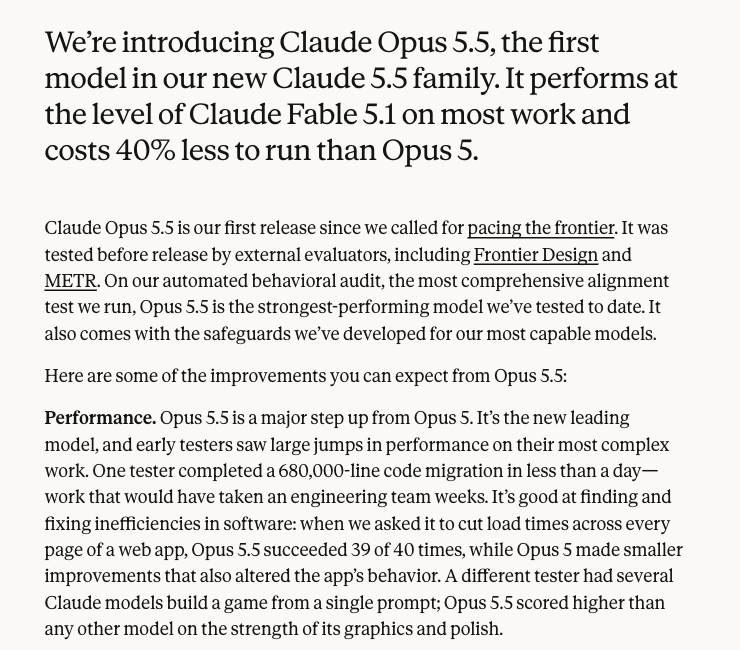
Dies ist der Bericht von Anthropic selbst über die Veröffentlichung, einschließlich Beispielen von frühen Testern. Er untermauert die beabsichtigte Ausrichtung des Produkts; er liefert jedoch kein direktes Vergleichsergebnis gegenüber GPT-6 Sol. Unsere unten aufgeführten, aufeinander abgestimmten Eingabeaufforderungen befassen sich mit der enger gefassten Frage, welche Ergebnisse die einzelnen Modelle bei diesem Durchlauf geliefert haben.
Vergleich der Funktionen und Leistungsmerkmale
Claude Opus 5.5 vs. GPT-6 Sol: Leistungsübersicht
| Entscheidungsbereich | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Langform-Texte | Stärke bei sorgfältiger, differenzierter Formulierung und ausdrücklichen Vorbehalten | Kann ein umfangreiches, von zahlreichen Vorgaben geprägtes Projekt in einem Durchgang erfolgreich abschließen |
| Forschungssynthese | Detaillierte Abstimmung und Erläuterung der Risiken | Zusammenfassung mit einer klaren Empfehlung |
| Programmierung und Überprüfung | Präzise Diagnose und strukturierte Risikoberichterstattung | Nützliche Minimal-Patches; Erklärungen zu Randfällen überprüfen |
| Strukturierte Ausgabe | Zuverlässiges, striktes JSON in der getesteten Aufgabe | Gültiges JSON mit allen angeforderten Schlüsseln in der getesteten Aufgabe |
| Multimodal und Werkzeuge | Überprüfen Sie den Pfad und die Zugriffsrechte für die jeweilige Aufgabe | Überprüfen Sie den Pfad und die Zugriffsrechte für die jeweilige Aufgabe |
| Der beste Arbeitsstil | Sorgfältige Prüfung, komplexe Argumentation und risikobewusste Arbeitsweise | Die geprüfte, an Vorgaben gebundene Aufgabenstellung wurde unter Einhaltung der festgelegten Obergrenze für das Ergebnis fertiggestellt |
So lesen Sie diesen Text: Dies sind Tendenzen im Arbeitsablauf, keine allgemeingültige Rangliste. Die richtige Wahl hängt davon ab, ob Sie Wert auf eine sorgfältige Überprüfung legen oder darauf, diesen umfangreichen Auftrag unter Einhaltung derselben Obergrenze für das Arbeitsergebnis abzuschließen.
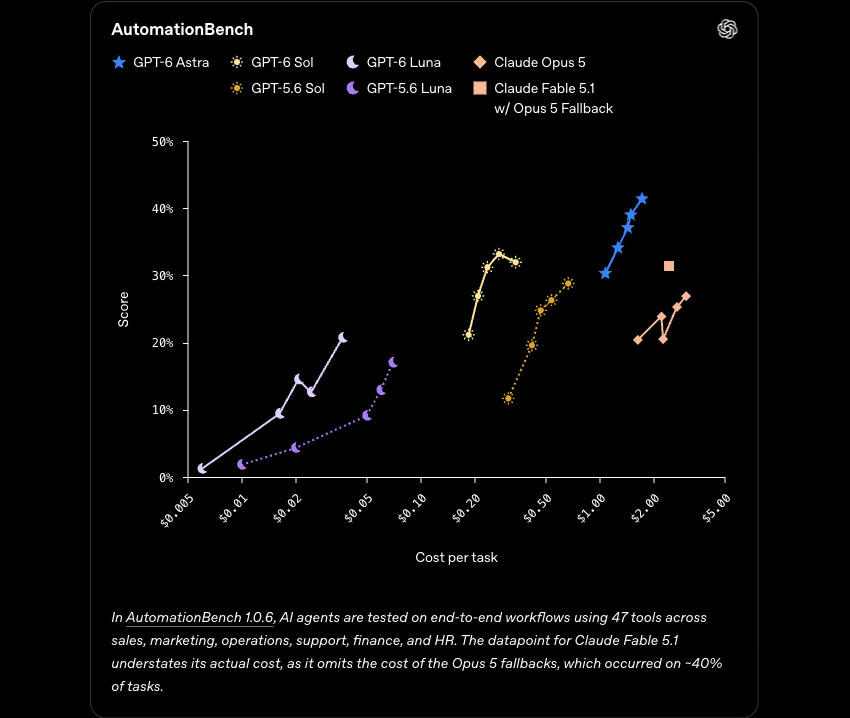
Beide Achsen sind zu beachten: Eine Bewegung nach oben steht für eine höhere Punktzahl, während eine Bewegung nach links auf niedrigere Kosten pro Aufgabe hinweist. Bei der hier dargestellten Claude-Serie handelt es sich um Opus 5, nicht um Opus 5.5. Diese vom Herausgeber bereitgestellte Grafik hilft dabei, die Positionierung von Sol hinsichtlich der Kosteneffizienz zu erklären; sie kann jedoch den Vergleich in diesem Artikel nicht endgültig klären. In der Fußnote heißt es außerdem, dass bei den Datenpunkten zu „Fable“ einige Fallback-Kosten nicht berücksichtigt wurden.
Schreiben, umfangreiche Dokumente und Zusammenfassung von Forschungsergebnissen
Beim Schreiben unterscheidet dieser Test zwischen der Fertigstellung unter einer festgelegten Ausgabebegrenzung und der Qualität der redaktionellen Überprüfung. GPT-6 Sol schnitt bei der Erstellung langer Texte besser ab. Claude Opus 5.5 schnitt besser ab, wenn es darum ging, zu diagnostizieren, zu bewerten und zu erklären. Bei Forschungsnotizen kamen beide Modelle zu demselben praktischen Ergebnis, sodass die Qualität des Quellenmaterials und des Überprüfungsprozesses nach wie vor wichtiger sind als ein klarer Sieger.
- Verwenden Sie GPT-6 Sol für einen ersten Entwurf mit vielen Vorgaben, ein Entscheidungsmemo oder einen strukturierten Inhaltsplan.
- Nutzen Sie Claude Opus 5.5, um Annahmen zu hinterfragen, Risiken aufzudecken und einen Entwurf zu optimieren, bevor er an einen Kunden oder in ein Produktionssystem gelangt.
- Wenn es auf Fakten ankommt, geben Sie beiden Modellen das Ausgangsmaterial und behalten Sie einen Schritt der menschlichen Überprüfung bei.
Programmierung, strukturierte Ausgabe und werkzeugfähige Arbeit
Beide Modelle lieferten gültiges JSON mit allen angeforderten Schlüsseln und demselben minimalen Patch. Claude beschrieb den vorhandenen Filter korrekt; GPT-6 Sol gab fälschlicherweise an, dass ein „None“-Element einen Fehler auslösen würde. Dies spricht für den Einsatz von Claude bei der Diagnose in dieser speziellen Aufgabe. Da der Typ des „risk“-Feldes in der Eingabeaufforderung nicht angegeben war, stellt die „risk“-Zeichenkette von Sol keinen Vertragsverstoß dar.
Um die Daten für die automatisierte Verarbeitung vorzubereiten, sollten Sie prüfen, welche Anforderungen der Ausgabevertrag tatsächlich erfüllen muss: gültiges JSON-Format, vollständige Felder, reproduzierbare Befehle und ein Patch, der ohne weitere Interpretation angewendet werden kann. Beide Modelle können Teil dieser Pipeline sein, wobei Tests und Überprüfungen in den Prozess eingebunden bleiben.
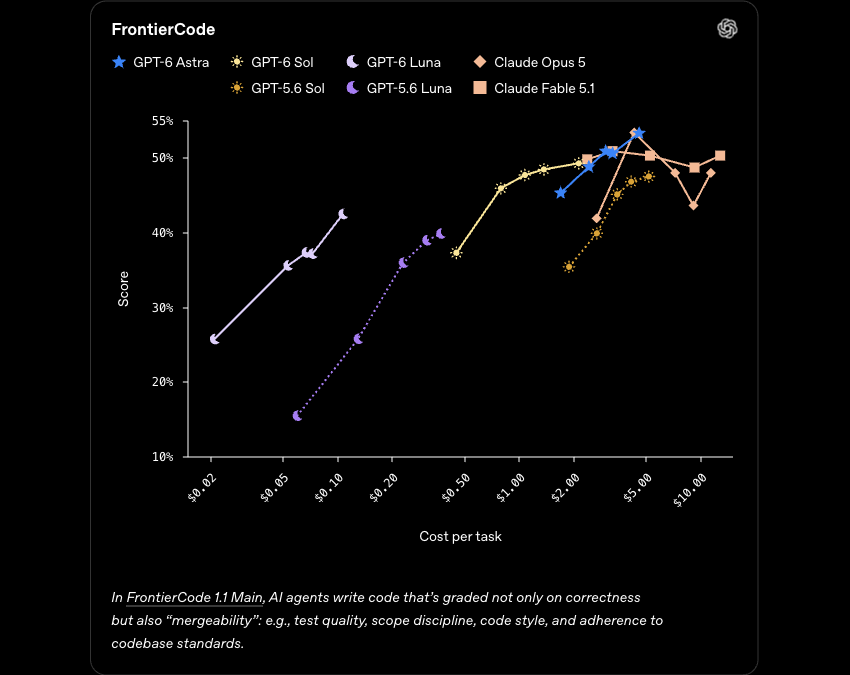
Dieser Benchmark deckt einen breiteren Bereich der agentischen Kodierung ab als unsere kurze Code-Review-Aufgabe. Sein Claude-Vergleichsmaß ist Opus 5, sodass er eher als Kontext für die Positionierung von Sol in der Kodierung dient und nicht als Beweis dafür, dass Sol Opus 5.5 übertrifft. In unserer eigenen Aufgabe waren beide Patches korrekt; der entscheidende Unterschied lag in der Genauigkeit der Diagnose.
Preis und Zugang
Preis und Erreichbarkeit: Vergleichen Sie die Route, nicht nur das Modell
| Route | Wofür Sie bezahlen | Wenn es sinnvoll ist |
|---|---|---|
| Claude Opus 5.5 API | Auf der Veröffentlichungsseite vom 22. September 2026 gibt Anthropic folgende Werte an: $4 pro Million Eingabe-Token, $20 pro Million Ausgabe-Token und $0,20 pro Million Cache-Lese-Token. | Sie entwickeln ein Produkt oder eine automatisierte Pipeline und möchten eine direkte Abrechnung über Tokens nutzen |
| GPT-6 Sol-API | OpenAI umfasst $2 pro Million Eingabe-Token und $10 pro Million Ausgabe-Token, mit einer Reduzierung um 50% gegenüber dem Aktionspreis von GPT-5.6 Sol; für zwischengespeicherte Eingabe-Lesevorgänge gilt ein Rabatt von 90%. | Sie benötigen einen direkten API-Vertrag mit einem Anbieter und möchten die nutzungsabhängigen Kosten für kontinuierliche Aufträge senken |
| GlobalGPT | Ein günstiges Abonnement mit beiden Modellen sowie vielen weiteren Modellen und KI-Funktionen | Sie möchten Recherche, Texterstellung, Programmierung sowie Bild- und Videobearbeitung in einem Dashboard vereinen |
Bei diesen Zahlen handelt es sich um API-Token-Tarife, nicht um Abonnementpreise. OpenAI positioniert GPT-6 Sol als das kostengünstigere Mitglied der GPT-6-Familie für professionelle Arbeit, Faktenprüfung, Programmierung, Computernutzung und Zusammenarbeit, während Anthropic Claude Opus 5.5 in den Bereichen Programmierung, Computernutzung, Wissensarbeit, Sicherheit und Kommunikation positioniert. GlobalGPT stellt beide Modelle sowie den Rest der Toolchain über ein einziges, erschwingliches Abonnement zur Verfügung, während seine CLI diesen Zugriff mit einem Terminal, Entwicklungs-Workflows und bestehenden Produktionswerkzeugen verbindet.
Primärquellen: Die Anthropic-Seite zur Version Claude Opus 5.5 und Die Seite von OpenAI zur Veröffentlichung von GPT-6 Sol und Luna.
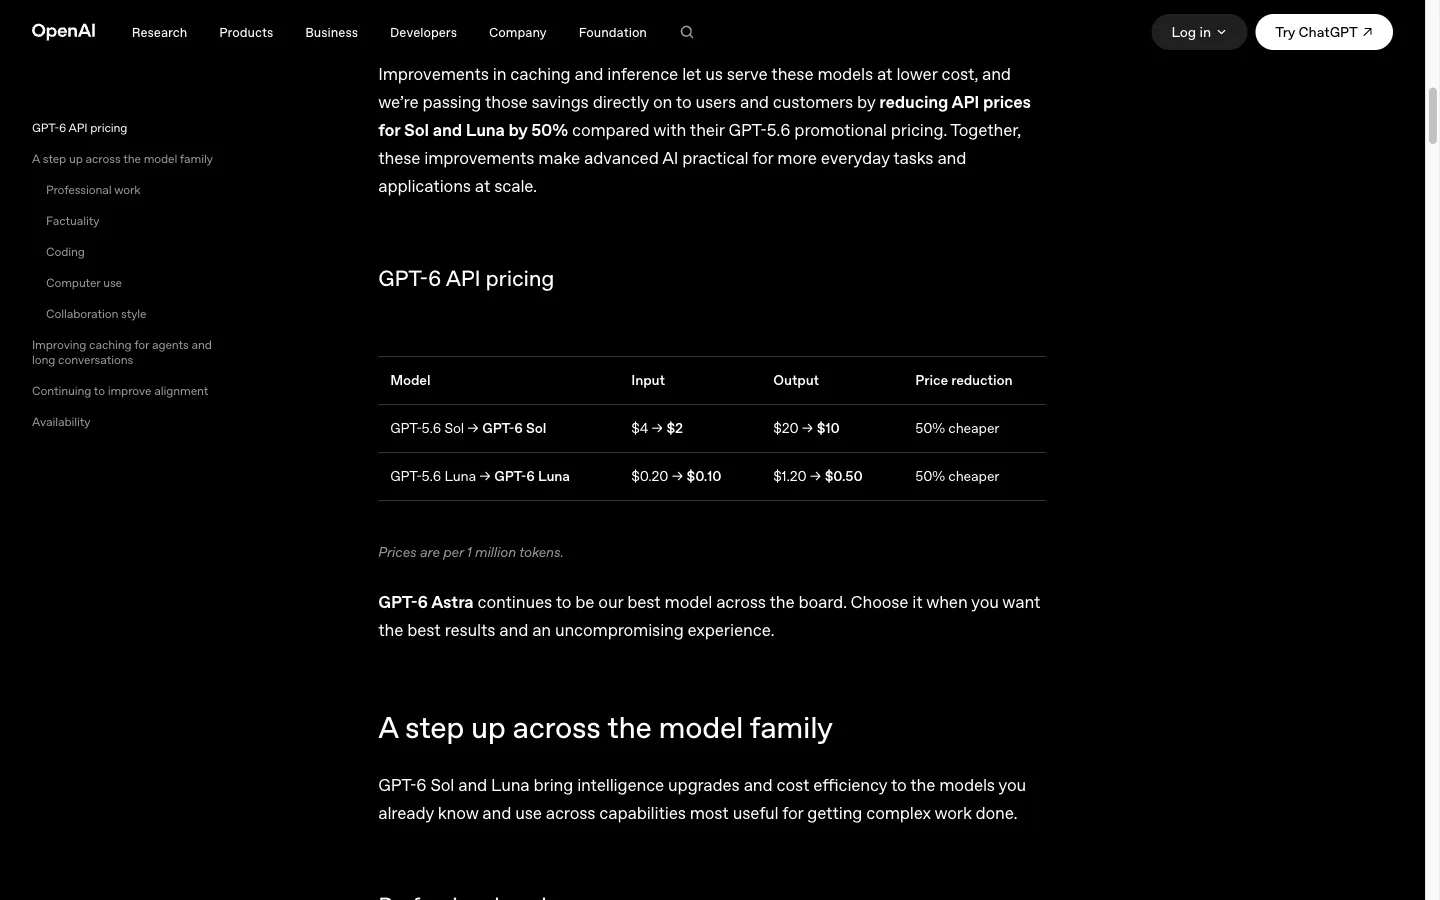
Diese Tarife gelten für API-Token. Sie beziehen sich nicht auf ein monatliches Verbraucherabonnement oder einen GlobalGPT-Tarif.
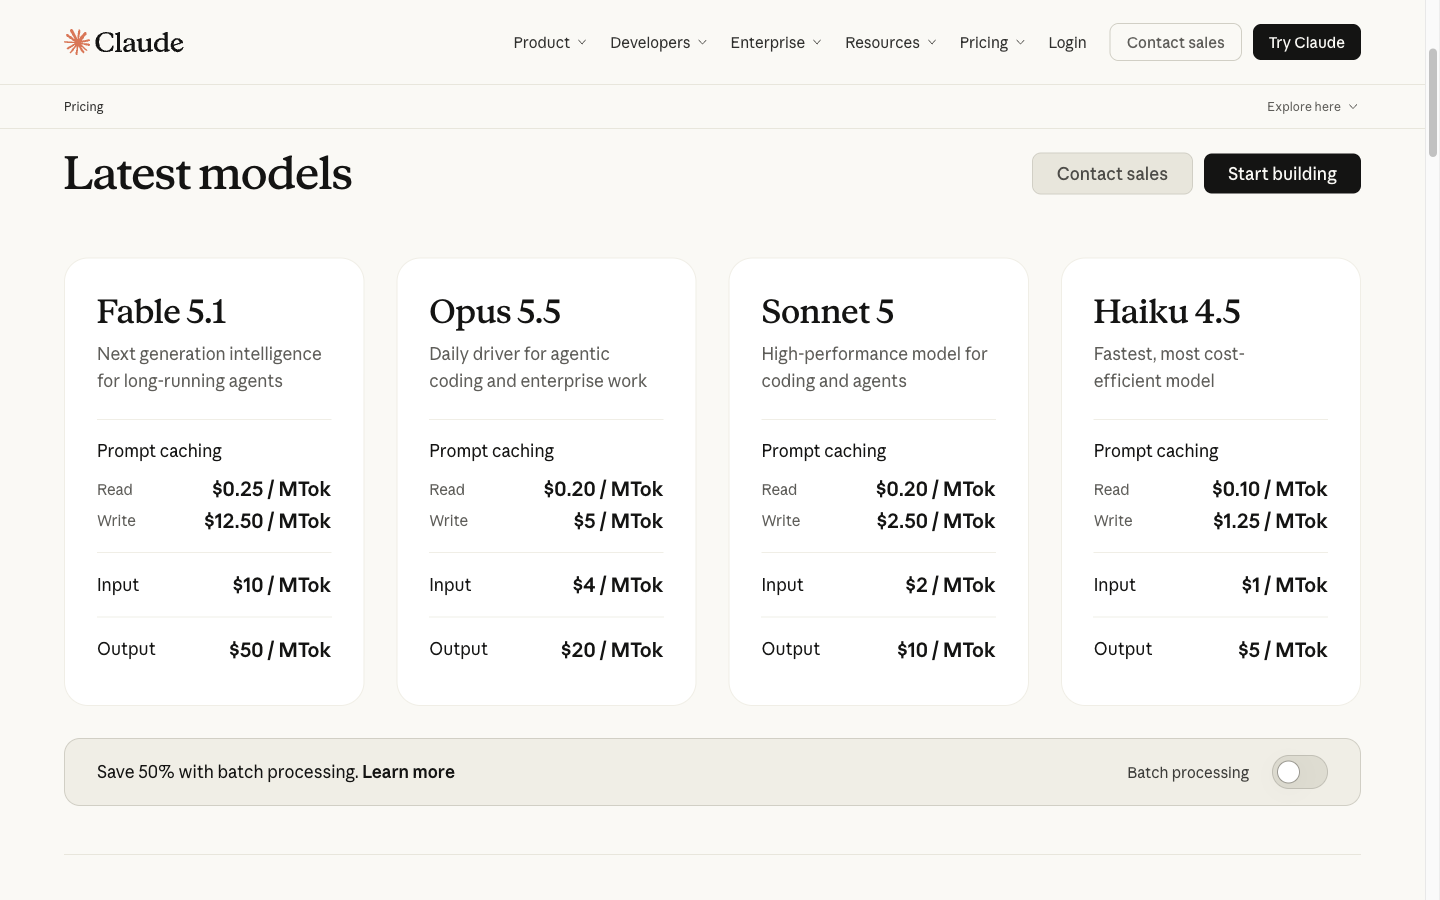
Die Standard-Ein- und Ausgaberaten von Opus 5.5 sind doppelt so hoch wie die von Sol, während beide veröffentlichten Cached-Read-Raten bei $0.20/M liegen. Ein stark zwischengespeicherter Workflow kann daher eine andere Kostenlücke aufweisen als ein nicht zwischengespeicherter; vergleichen Sie daher die gleiche Token-Zusammensetzung, bevor Sie sich für einen Preis entscheiden.
Was der Leistungsunterschied bei gleicher Arbeitslast bedeutet
Rechenbeispiel: 1 Million nicht zwischengespeicherte Eingabetoken + 100.000 Ausgabetoken, Standard-API-Sätze. „Teal“ steht für die Inputkosten, „Rust“ für die Outputkosten.
Bei dieser identischen Token-Zusammensetzung kostet Sol nur halb so viel. Das ist eine Berechnung auf Basis der Preisliste und keine Behauptung, dass jede abgeschlossene Aufgabe nur halb so viel kostet: Wiederholungsversuche, Ausgabelänge, Cache-Treffer, Werkzeugkosten und Einstellungsoptionen können die Rechnung beeinflussen.
Quellen: Preise für die Anthropic-API und Preise für die Version OpenAI, abgerufen am 25. September 2026.Direkte API-Kosten schätzen
API-Kostenrechner
Geben Sie die Token ein, die Sie voraussichtlich senden und empfangen werden. Die Schätzung basiert auf den oben genannten verifizierten API-Raten: Claude Opus 5,5 bei einer Eingabe von $4/M und einer Ausgabe von $20/M; GPT-6 Sol bei einer Eingabe von $2/M und einer Ausgabe von $10/M.
| Modell | Eingaberate | Ausgangsrate | Geschätzte Kosten |
|---|---|---|---|
| Claude Opus 5,5 | $4 / M | $20 / M | $9.00 |
| GPT-6 Sol | $2 / M | $10 / M | $4.50 |
Dies ist eine vorläufige Abrechnungsschätzung für die direkte API-Nutzung. Dabei werden weder die Kosten für ein Verbraucherabonnement noch die Preise des GlobalGPT-Tarifs berücksichtigt, und Cache-Rabatte, Tools, Steuern sowie sonstige anbieterspezifische Gebühren sind nicht enthalten.
Wer sollte sich für welches Modell entscheiden?
Für welches Modell sollten Sie sich entscheiden?
| Ihre Priorität | Zuerst auswählen | Warum |
|---|---|---|
| Ein ausgefeiltes, langes Memo mit vielen Einschränkungen | GPT-6 Sol | Die überarbeitete Langform-Aufgabe erreichte die gewünschte Entscheidungsregel in einer einzigen Ausgabe |
| Code-Diagnose, striktes JSON und explizite Risiken | Claude Opus 5,5 | Die Kodierungsaufgabe führte zu einer genaueren Diagnose und einer genaueren Risikobewertung. |
| Forschungsnotizen, die abgeglichen werden müssen | Entweder | Bei der Aufgabe zur kontrollierten Quellsynthese gab es ein Unentschieden |
| Ein gemischter wöchentlicher Arbeitsablauf | GlobalGPT mit beidem | Fassen Sie Modellauswahl, Texterstellung, Programmierung, Bilder und Videos in einem Dashboard zusammen; nutzen Sie die Befehlszeilenschnittstelle (CLI), wenn die Arbeit im Terminal stattfindet |
Verwenden Sie beide Modelle in einem durchgängigen Arbeitsablauf
Ein praktischer GlobalGPT-Workflow
- Beginnen Sie mit einem Forschungsauftrag und bitten Sie ein Modell, Annahmen offenzulegen.
- Übertragen Sie den bereinigten Entwurf in das andere Modell, um ihn zu überarbeiten oder eine zweite Meinung einzuholen.
- Verwenden Sie den leistungsfähigeren Programmieransatz für die Implementierung, die Überprüfung und die strukturierte Ausgabe.
- Speichern Sie das Ergebnis im selben Dashboard und verwenden Sie dann die GlobalGPT-CLI-Workflow wenn es in ein Terminal oder ein Produktionswerkzeug eingespeist werden muss.
Dieser Arbeitsablauf ist der Hauptvorteil des Zugriffs auf beide Modelle: Sie können die Aufgabe weiterleiten, anstatt Ihren Prozess an ein einzelnes Modell anzupassen.

Wie der Vergleich durchgeführt wurde
Beide Modelle erhielten dieselbe Systemmeldung, dieselben Aufgabenvorgaben und dasselbe Ausgangsmaterial; es wurden weder Tools noch Suchvorgänge verwendet. Bei jedem Ergebnis wurde die erste zurückgegebene Ausgabe beibehalten, einschließlich der durch die Ausgabebegrenzung bedingten Kürzung. Hierbei handelt es sich um einen praktischen Vergleich zur Auswahl eines Arbeitsablaufs und nicht um eine allgemeine Rangliste aller Funktionen.
Vergleichsverfahren
Wie dieser Vergleich durchgeführt wurde
| Zustand | Vergleichsregel |
|---|---|
| Modelle | Claude Opus 5.5 und GPT-6 Sol, genaue IDs im Live-Modellverzeichnis bestätigt |
| Prompt-Parität | Gleiche Systemmeldung, Aufgabenaufforderung, Ausgangsmaterial, keine Werkzeuge und kein Stöbern |
| Aufgaben | T01 Grenzwertprüfung, T01R expliziter Langformvergleich, T02 Quellsynthese, T03 Code/JSON |
| Wiederholungsversuche | Nur Fehler bei Transport, Kapazität und leeren Umschlägen; gültige schwache Ausgabe bleibt erhalten |
| Punktestand | 10 Punkte pro erfüllter Aufgabe: Vertragsziel 4, Nachvollziehbarkeit 3, Nutzen 2, Format 1 |
Die erste Aufgabe prüft, ob ein Modell auch dann Vorhersagen trifft, wenn wichtige Kontextinformationen fehlen; daher wird sie getrennt von der Gewinnerberechnung behandelt. Beim direkten Vergleich werden beide Modelle genannt und erhalten denselben Auftrag. Es wurden keine Stabilitätswiederholungen durchgeführt.
Warum bei der ersten Ausschreibung kein Gewinner ermittelt wurde
Umgang mit Kontexten
Warum bei der ersten Ausschreibung kein Gewinner ermittelt wurde
Beide Modelle weigerten sich, Modellidentitäten zu erfinden, da sie in der ursprünglichen Eingabeaufforderung nicht namentlich genannt wurden. Das ist zwar die richtige Reaktion auf fehlenden Kontext, sagt aber nichts darüber aus, welches Modell die eigentliche Aufgabe besser bewältigt.
Claude Opus 5,5 · voller Eingang
Sie vergleichen zwei KI-Modelle für einen praktischen Einkaufsratgeber. Verfassen Sie ausschließlich auf der Grundlage des untenstehenden Quellpakets einen Text mit 700–900 Wörtern und genau diesen Überschriften: Entscheidung, Belege, Vorbehalte, Nächster Schritt. Halten Sie diese Fakten genau ein: Projekt North hat eine Frist von 12 Wochen; das Migrationsbudget beträgt $48.000; die Sicherheitsüberprüfung ist nicht terminiert. Wenn eine Tatsache ungeklärt ist, weisen Sie ausdrücklich darauf hin. Erfinden Sie keine Preise, Benchmarks oder Produktfunktionen.

QUELLENMATERIAL:
„Project North“ ist eine 12-wöchige Migration für ein 40-köpfiges Team. Das genehmigte Migrationsbudget beträgt $48.000. Der Zeitpunkt für die Sicherheitsüberprüfung wurde noch nicht festgelegt. Das Team wünscht sich eine Modellempfehlung für Recherche, Texterstellung und Code-Review. In einer Anmerkung eines Stakeholders heißt es, der aktuelle Entwurf sei zu lang, es wird jedoch keine Wortzahl angegeben.

Liefern Sie nur den Leitfaden zurück.
Claude Opus 5,5 · volle Leistung
## Entscheidung

Anhand des bereitgestellten Quellpakets lässt sich keine Empfehlung zwischen den beiden Modellen aussprechen. Das Paket nennt weder ein Modell noch enthält es Angaben zu Preisen, Benchmark-Ergebnissen oder Produktfunktionen. Sich jetzt für ein Modell zu entscheiden, hieße, die Belege zu erfinden, auf die sich dieser Leitfaden eigentlich stützen soll.

Die praktische Entscheidung lautet daher, die Modellauswahl zurückzustellen. Die nächste Phase ist als strukturierte Bewertung zu betrachten, die drei festen Rahmenbedingungen unterliegt:

- Das Projekt "North" hat eine Frist von 12 Wochen.
- Das Migrationsbudget beträgt $48.000.
- Die Sicherheitsüberprüfung ist noch nicht terminiert.

Jedes Modell, das in die nächste Runde geht, muss innerhalb der 12-wöchigen Frist und des Migrationsbudgets von $48.000 bleiben. Außerdem muss es eine Sicherheitsüberprüfung bestehen, die noch nicht im Kalender vorgesehen ist. Solange die beiden Modelle nicht identifiziert und anhand der drei vom Team genannten Anwendungszwecke (Recherche, Schreiben und Code-Review) bewertet wurden, bleibt die Auswahl unentschieden. Dieser Leitfaden formuliert dies klar und deutlich, anstatt eine Präferenz anzugeben, die durch die Fakten nicht gestützt werden kann.

## Faktenlage

Das Quellenpaket enthält die folgenden Fakten, und ausschließlich diese Fakten bilden die Grundlage für diesen Leitfaden:

- **Umfang und Zeitplan:** Projekt North ist eine 12-wöchige Migration.
- **Teamgröße:** Die Migration dient einem 40-köpfigen Team.
- **Budget:** Das genehmigte Budget für die Migration beträgt $48.000.
- **Sicherheit:** Ein Termin für die Sicherheitsüberprüfung wurde noch nicht festgelegt.
- **Anwendungsfälle:** Das Team wünscht sich eine Modellempfehlung für Recherche, Dokumentation und Code-Review.
- **Feedback der Stakeholder:** In einer Anmerkung der Stakeholder heißt es, der aktuelle Entwurf sei zu lang, es wird jedoch keine Wortzahl angegeben.

Das Paket enthält mehrere Informationen nicht, auf denen ein Vergleich normalerweise beruhen würde. Die beiden zu vergleichenden Modelle werden nicht benannt. Es werden weder Preise pro Arbeitsplatz, pro Token noch Abonnementpreise für eine der beiden Optionen angegeben. Es enthält keine Benchmark-Ergebnisse und keine Ergebnisse aus internen Tests. Es wird nicht beschrieben, was die beiden Modelle für Recherche, das Verfassen von Texten oder die Codeüberprüfung leisten können oder nicht. Es enthält keine Angaben zu Bedingungen für den Umgang mit Daten, Bereitstellungsoptionen oder Integrationsanforderungen.

Da keiner dieser Punkte in den Unterlagen erscheint, enthält dieser Leitfaden keine Schätzungen dazu. Ob eines der beiden Modelle in das Budget von $48.000 für ein 40-köpfiges Team passt, ist unbekannt. Ob eines der beiden Modelle bei Recherche, Texterstellung oder Code-Review bessere Leistungen erbringt, ist ebenfalls unbekannt. Jede hier hinzugefügte Zahl oder Leistungsangabe wäre frei erfunden.

## Vorbehalte

Mehrere ungeklärte Fragen beeinflussen die Interpretation dieser Entscheidung.

**Die Identität der Modelle ist ungeklärt.** Der Vergleich betrifft zwei KI-Modelle, doch das Paket gibt nicht an, um welche es sich handelt. Jede weitere Beurteilung hängt davon ab, dass diese Frage zuerst geklärt wird.

**Der Umfang des Budgets ist ungeklärt.** In den Unterlagen wird der Betrag von $48.000 als „genehmigtes Migrationsbudget“ bezeichnet. Es wird nicht angegeben, ob dieser Betrag die Modelllizenz- oder Nutzungsgebühren abdecken soll. Möglicherweise deckt er stattdessen nur Migrationsarbeiten wie Personalzeit, Tools oder Dienstleistungen ab. Sollten die Modellkosten aus denselben $48.000 bestritten werden müssen, ist der Kostenspielraum für beide Modelle geringer, als die Schlagzeilenzahl vermuten lässt. Dies bedarf einer Bestätigung.

**Der Zeitpunkt der Sicherheitsüberprüfung ist ungeklärt und stellt ein Terminrisiko dar.** Die Sicherheitsüberprüfung ist nicht terminiert. Angesichts einer Frist von 12 Wochen stellt eine nicht geplante Überprüfung ein echtes Risiko für den Zeitplan dar. Aus den Unterlagen geht nicht hervor, wie lange eine Überprüfung dauert oder ob eine nicht bestandene Überprüfung einen Wechsel zum anderen Modell erzwingen würde. Beide Szenarien könnten einen erheblichen Teil der 12 Wochen in Anspruch nehmen. Kein Modell sollte als genehmigt betrachtet werden, bis die Überprüfung abgeschlossen ist.

**Die Gewichtung der Anwendungsfälle ist ungeklärt.** Das Team nannte drei Anwendungsfälle: Recherche, Schreiben und Code-Review. Aus den Unterlagen geht nicht hervor, ob diese gleich wichtig sind oder ob einer davon dominiert. Ein Modell, das in einem Bereich stärker ist, könnte in einem anderen schwächer sein, und ohne Gewichtung gibt es keine Grundlage für einen Abwägungsprozess.

**Das Nutzungsvolumen ist ungeklärt.** Das Team besteht aus 40 Personen, aber in den Unterlagen wird nicht angegeben, wie viele das Modell nutzen werden und in welchem Umfang. Das Nutzungsvolumen könnte bei bestimmten Preisstrukturen die Kosten stark beeinflussen. Ohne Preisdaten und Nutzungsschätzungen lässt sich dies nicht beurteilen.

**Die Anleitung zur Dauer con
GPT-6 Sol · vollständige Eingabe
Sie vergleichen zwei KI-Modelle für einen praktischen Einkaufsratgeber. Verfassen Sie ausschließlich auf der Grundlage des untenstehenden Quellpakets einen Text mit 700–900 Wörtern und genau diesen Überschriften: Entscheidung, Belege, Vorbehalte, Nächster Schritt. Halten Sie diese Fakten genau ein: Projekt North hat eine Frist von 12 Wochen; das Migrationsbudget beträgt $48.000; die Sicherheitsüberprüfung ist nicht terminiert. Wenn eine Tatsache ungeklärt ist, weisen Sie ausdrücklich darauf hin. Erfinden Sie keine Preise, Benchmarks oder Produktfunktionen.

QUELLENMATERIAL:
„Project North“ ist eine 12-wöchige Migration für ein 40-köpfiges Team. Das genehmigte Migrationsbudget beträgt $48.000. Der Zeitpunkt für die Sicherheitsüberprüfung wurde noch nicht festgelegt. Das Team wünscht sich eine Modellempfehlung für Recherche, Texterstellung und Code-Review. In einer Anmerkung eines Stakeholders heißt es, der aktuelle Entwurf sei zu lang, es wird jedoch keine Wortzahl angegeben.

Liefern Sie nur den Leitfaden zurück.
GPT-6 Sol · vollständige Ausgabe
## Entscheidung

Nennen Sie noch kein Gewinnermodell. Das Quellpaket bittet um eine Empfehlung zwischen zwei KI-Modellen, identifiziert jedoch weder eines der Modelle noch liefert es Ergebnisse für Forschung, Texterstellung oder Code-Review. Die Behauptung, eines sei besser, wäre daher unbegründet. Die praktische Empfehlung lautet, die beiden Kandidaten anhand der eigenen Arbeit des Teams zu vergleichen, bevor eine Auswahl getroffen wird.

Das Projekt “North” hat eine Frist von 12 Wochen. Das Budget für die Migration beträgt $48.000. Der Termin für die Sicherheitsüberprüfung steht noch nicht fest. Diese Fakten machen die Entscheidung zeitkritisch, rechtfertigen jedoch keine Spekulationen. Eine sinnvolle Entscheidung muss berücksichtigen, ob ein Modell dem 40-köpfigen Team hilft, seine tatsächlichen Aufgaben zu erfüllen, wie sich dessen Einsatz in das genehmigte Budget einfügt und was ungewiss bleibt, bis der Zeitpunkt der Sicherheitsüberprüfung bekannt ist.

Behandeln Sie die Empfehlung als bedingt: Wählen Sie das Modell, das bei repräsentativen Aufgaben bessere Leistungen erbringt, im Rahmen des genehmigten Migrationsbudgets genutzt werden kann und alle für den vorgesehenen Einsatz erforderlichen Prüfungen besteht. Wenn keiner der Kandidaten diese Bedingungen erfüllt, sollte der Leitfaden besagen, dass noch keiner empfohlen werden kann. Das verfügbare Material belegt nicht, dass eine der Bedingungen erfüllt ist.

## Beleglage

Das Team wünscht eine Modellempfehlung für drei Arbeitsbereiche: Recherche, Texterstellung und Code-Review. Dies sind die geeigneten Vergleichskategorien, da sie sich aus dem angegebenen Bedarf ergeben und nicht aus angenommenen Produktstärken. Das Paket enthält weder Beispiele für die Ergebnisse der beiden Modelle noch Bewertungsergebnisse oder eine Beschreibung dessen, was die beiden Kandidaten bieten. Es enthält auch keine Preise oder Benchmarks. Folglich fehlt eine Beweisgrundlage für eine Einstufung der Modelle hinsichtlich Genauigkeit, Geschwindigkeit, Qualität, Kosten oder Eignung.

Der Projektkontext liefert jedoch nützliche Entscheidungskriterien. Bei “Project North” handelt es sich um eine Migration für ein 40-köpfiges Team; daher sollte ein Vergleich die Aufgaben widerspiegeln, die die Mitarbeiter dieses Teams tatsächlich ausführen würden. Das genehmigte Migrationsbudget beträgt $48.000; jeder vorgeschlagene Einsatz eines Modells muss anhand dieses Betrags bewertet werden und nicht anhand eines fiktiven Budgets für KI-Tools. Die Sicherheitsüberprüfung ist nicht terminiert, wodurch der Zeitpunkt einer Überprüfung – und deren Auswirkungen auf die Einführung – ungeklärt bleiben.

Ein Stakeholder hat angemerkt, der aktuelle Entwurf sei zu lang, hat jedoch keine Wortzahl angegeben. Dies ist ein Hinweis auf den Wunsch nach Prägnanz, nicht auf eine messbare Begrenzung der Modellausgabe. Beim Vergleich von Schreibproben können Prüfer beurteilen, ob jeder Kandidat der Aufforderung zur Prägnanz folgt und wesentliche Fakten beibehält. Sie sollten nicht behaupten, dass eines der Modelle eine von den Beteiligten festgelegte Wortbegrenzung einhält, da keine angegeben wurde.

Für Forschungszwecke wäre es ein nützlicher Anhaltspunkt, ob jeder Kandidat vorgegebene Fakten von offenen Fragen unterscheidet und unbegründete Schlussfolgerungen vermeidet. Im Bereich des Schreibens wäre es entscheidend, ob jeder Kandidat einen klaren, angemessen kurzen Entwurf erstellt, ohne dabei Vorgaben außer Acht zu lassen. Bei der Code-Überprüfung wäre es wichtig, ob jeder Kandidat Probleme in einem bereitgestellten Beispiel identifiziert und diese so erklärt, dass ein Prüfer sie nachvollziehen kann. Dies sind vorgeschlagene Tests, keine Feststellungen zu den einzelnen Modellen.

## Vorbehalte

Der größte Vorbehalt besteht darin, dass die Kandidaten selbst noch unbestimmt sind: In den Unterlagen werden sie nicht namentlich genannt. Es wird auch nicht angegeben, wie das Team auf sie zugreifen würde, was sie kosten oder ob eines der beiden Modelle für die beabsichtigte Arbeit verfügbar ist. Aus dem Begriff “KI-Modelle” sollten keine Rückschlüsse auf Produktfunktionen gezogen werden. Selbst ein gut konzipierter Vergleich kann keine Produktempfehlung liefern, solange die Kandidaten und die Bewertungsnachweise nicht bekannt sind.

Das Migrationsbudget ist genehmigt, aber in den Unterlagen wird kein Teil davon für die Nutzung oder das Testen von Modellen vorgesehen. Behandeln Sie $48.000 nicht als KI-Einkaufsbudget. Ebenso legt eine Frist von 12 Wochen keinen Termin fest, bis zu dem die Sicherheitsüberprüfung stattfinden wird. Da die Sicherheitsüberprüfung nicht terminiert ist, bleibt ungeklärt, ob und wann ein Kandidat gemäß den Anforderungen des Teams eingesetzt werden könnte.

Die drei angeforderten Einsatzzwecke können zudem zu unterschiedlichen Ergebnissen führen. Ein Kandidat könnte für eine Aufgabe vorteilhaft sein, für eine andere jedoch nicht; das Paket bietet keine Grundlage für die Annahme, dass es einen einzigen Gewinner für die Bereiche Recherche, Texterstellung und Code-Review gibt. Eine Empfehlung sollte solche Abwägungen sichtbar machen, anstatt sie unter einem pauschalen Begriff zu verbergen. Wenn das Team entscheidet, dass eine Kategorie wichtiger ist als die anderen, sollte diese Priorität von den Stakeholdern festgelegt werden, nicht von diesem Leitfaden.

Schließlich sollte die Anmerkung, dass der Entwurf zu lang sei, nicht als Beweis für die Modellleistung missverstanden werden. Sie beschreibt Feedback zu einem aktuellen Entwurf, ohne dessen Verfasser zu nennen oder eine Ziellänge anzugeben. Sie kann Aufschluss darüber geben, wie die endgültige Empfehlung präsentiert wird, kann aber den Vergleich nicht entscheiden.

## Nächster Schritt

Identifizieren Sie die beiden Kandidaten und bitten Sie das Team um repräsentative Aufgaben in den Bereichen Recherche, Schreiben und Code-Review. Geben Sie jedem Modell für jede Aufgabe die gleichen Materialien und Anweisungen, einschließlich der Anweisung, Unsicherheiten zu kennzeichnen und das Hinzufügen von Fakten zu vermeiden. Lassen Sie die Prüfer festhalten, was jede Antwort richtig macht, was sie übersieht und welche Aussagen einer Überprüfung bedürfen. Halten Sie aufgabenspezifische Beobachtungen getrennt, damit eine überzeugende Schreibprobe nicht als Beleg für die Code-Review herangezogen wird.

Vergewissern Sie sich vor der Auswahl, ob die Kosten für den vorgesehenen Einsatz im Rahmen des Migrationsbudgets von $48.000 liegen, und legen Sie fest, wann die Sicherheitsüberprüfung stattfinden kann. Keine der beiden Antworten ist im Paket enthalten. Wenn diese Fragen nicht rechtzeitig für eine Entscheidung geklärt werden können, weisen Sie deutlich auf diese Einschränkung hin, anstatt eine vorläufige Präferenz als genehmigte Wahl darzustellen.

Die abschließende Kaufempfehlung kann dann kurz und nachvollziehbar sein: Nennen Sie die Kandidaten, führen Sie die Belege für jede der drei Verwendungszwecke an, erläutern Sie etwaige Kompromisse und weisen Sie auf noch offene Genehmigungs- oder Budgetfragen hin. Solange diese Informationen nicht vorliegen, lautet die ehrliche Antwort für das Projekt „North“ nicht „Modell A“ oder „Modell B“. Sie lautet vielmehr, dass der Vergleich noch nicht durch Belege untermauert wurde.
Betrachten Sie dies als eine Überprüfung der Kontextbehandlung und nicht als Qualitätsbewertung.
Langform-Texte
Fertigstellung unter Beibehaltung der gleichen Obergrenze von 2.400 Token
Die gleiche Aufgabenstellung umfasste fünf Abschnitte. Für beide Modelle galt ein Ausgabelimite von 2.400 Token; die zurückgegebenen Metadaten erklären den sichtbaren Unterschied.
Claude hat vor der Entscheidungsregel die konfigurierte Ausgabegrenze erreicht. Sol hat den Auftrag innerhalb dieser Grenze abgeschlossen. Dies spricht für eine Empfehlung für diesen Lauf unter den gegebenen Einschränkungen, nicht jedoch für eine allgemeine Einstufung der maximalen Schreibfähigkeit oder -geschwindigkeit. Der vollständige ausgegebene Text, einschließlich der gekürzten Antwort, ist im Folgenden wiedergegeben.
Umfangreiche Aufgabe
Langformtexte: GPT-6 Sol hat den Auftrag abgeschlossen
Dies ist die erste Aufgabe zum direkten Vergleich. In der Aufgabenstellung wurde ausdrücklich genannt, Claude Opus 5,5 und GPT-6 Sol, händigte beiden das gleiche Informationspaket zum Projekt „North“ aus und verlangte ein Memorandum zur bedingten Entscheidung.
| Maß | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Sichtbare Länge | 648 Wörter; finish_reason=Länge | 1.065 Wörter; finish_reason=stop |
| Pflichtfelder | 4 von 5; Entscheidungsregel fehlt nach dem Abschneiden | 5 von 5 |
| Vierreihige Wertetabelle | Gegenwärtig und symmetrisch | Gegenwärtig und symmetrisch |
| Pilotprüfungen / Stoppbedingung | Begonnen, aber vor der Fertigstellung abgebrochen | Drei Prüfungen und eine Stoppbedingung |
| Punktzahl | 7.0 / 10 | 10.0 / 10 |
Mitnehmen: Bei derselben Ausgabegrenze von 2.400 Token lieferte GPT-6 Sol alle fünf Abschnitte, während Claude Opus 5.5 bereits vor der „Decision“-Regel die Obergrenze erreichte. Dies zeigt die Vollständigkeit unter dieser Konfiguration; es sagt jedoch nichts über die maximale Schreibfähigkeit oder die allgemeine Geschwindigkeit der beiden Modelle aus.
Gemeinsamer vollständiger Eingabe
Sie verfassen ein Entscheidungsmemorandum für ein Team, das zwischen Claude Opus 5.5 und GPT-6 Sol wählen muss. Die Modellbezeichnungen sind festgelegt und müssen genau wie angegeben erscheinen. Verfassen Sie unter ausschließlicher Verwendung des unten stehenden Belegmaterials einen Text von 900–1100 Wörtern mit genau folgenden Abschnitten: Empfehlung der Geschäftsleitung; Was die Belege stützen; Wo Belege fehlen; 30-Tage-Pilotprojekt; Entscheidungsregel.

Anforderungen: (1) Vergleichen Sie Claude Opus 5.5 und GPT-6 Sol symmetrisch; (2) trennen Sie beobachtete Belege, Annahmen und Unbekannte; (3) Behalten Sie die genauen Daten, das Budget, die Teamgröße und den ungeklärten Sicherheitsstatus bei; (4) Fügen Sie eine kompakte, vierzeilige Scorecard ein, die die Forschungszusammenfassung, das Verfassen eines ausführlichen Textes, die Codeüberprüfung und strukturiertes JSON abdeckt; (5) Geben Sie eine bedingte Empfehlung ab, anstatt einen Gewinner zu erfinden; (6) drei messbare Pilotprüfungen und eine Abbruchbedingung auflisten; (7) keine Preise, Benchmarks, Kontextgrenzen oder Produktfunktionen erfinden.

BEWEISMATERIAL
- Projekt North ist eine 12-wöchige Migration für ein 40-köpfiges Team.
- Das genehmigte Migrationsbudget beträgt $48.000. Aus dem Paket geht nicht hervor, ob die Modellnutzung in diesem Budget enthalten ist.
- Der Zeitplan für die Sicherheitsüberprüfung steht noch nicht fest.
- Das Team benötigt Forschungszusammenfassungen, ausführliche Texte, Code-Reviews und strukturierte JSON-Extraktion.
- Ein Stakeholder hält den aktuellen Entwurf für zu lang, es wurde jedoch keine Zielwortzahl genehmigt.
- Es liegen noch keine kontrollierten Ergebnisse von Claude Opus 5.5 oder GPT-6 Sol vor.
- Das Team wünscht eine überprüfbare Auswahl und kann einen 30-tägigen Pilotversuch mit identischen Eingabeaufforderungen und menschlicher Überprüfung durchführen.

Geben Sie nur das Memo zurück. Behaupten Sie nicht, dass das Beweismaterialpaket belegt, dass eines der Modelle besser ist.
Claude Opus 5,5 · vollständige Rückgabe der Ausgabe
## Empfehlung der Geschäftsleitung

Wählen Sie noch nicht zwischen Claude Opus 5.5 und GPT-6 Sol. Das Evidenzpaket enthält keine kontrollierten Ausgaben von einem der beiden Modelle. Es gibt daher keine beobachtbare Grundlage, um eines der beiden Modelle bei einer der vier erforderlichen Arbeitslasten als besser einzustufen.

Die Empfehlung ist an Bedingungen geknüpft. Führen Sie einen 30-tägigen Pilotversuch durch, bei dem beide Modelle identische Eingabeaufforderungen erhalten und derselben menschlichen Überprüfung unterzogen werden. Wählen Sie anschließend das Modell aus, das die vor Beginn des Pilotversuchs vereinbarten Schwellenwerte erfüllt, sofern die unten aufgeführten Sicherheits- und Budgetfragen zuvor geklärt sind. Es gibt drei mögliche Ergebnisse:

- **Ein Modell erfüllt die Schwellenwerte:** Wählen Sie dieses Modell aus.
- **Beide erfüllen die Schwellenwerte:** Wenden Sie die Entscheidungskriterien bei Gleichstand in der Entscheidungsregel an.
- **Keines erfüllt die Schwellenwerte:** Setzen Sie keines der Modelle ein.

Dieser Ansatz bietet dem Team die nachprüfbare Entscheidungsgrundlage, um die es gebeten hat.

Die feststehenden Projektdaten lauten:

- Projekt "North" ist eine 12-wöchige Migration für ein 40-köpfiges Team.
- Das genehmigte Migrationsbudget beträgt $48.000. Aus den Unterlagen geht nicht hervor, ob die Nutzung der Modelle in diesem Budget enthalten ist.
- Ein Termin für die Sicherheitsprüfung ist nicht festgelegt.
- Die Unterlagen enthalten keine Kalenderdaten (kein Projektstartdatum, kein Enddatum und kein Pilotzeitfenster), daher werden in diesem Memo auch keine festgelegt.

## Was die Fakten belegen

**Festgestellte Fakten.** Dies sind Fakten, die direkt in den Unterlagen genannt werden:

- Projekt „North“ ist eine 12-wöchige Migration für ein 40-köpfiges Team.
- Das genehmigte Migrationsbudget beträgt $48.000, und es ist nicht angegeben, inwieweit die Modellnutzung darin enthalten ist.
- Ein Zeitplan für die Sicherheitsüberprüfung ist nicht festgelegt.
- Die erforderlichen Arbeitsaufgaben sind Forschungssynthese, Verfassen langer Texte, Code-Review und strukturierte JSON-Extraktion.
- Ein Stakeholder sagt, der aktuelle Entwurf sei zu lang, aber es wurde keine Zielwortzahl genehmigt.
- Es wurden keine kontrollierten Ergebnisse von Claude Opus 5.5 oder GPT-6 Sol vorgelegt.
- Das Team wünscht sich eine überprüfbare Auswahlmöglichkeit und kann einen 30-tägigen Pilotversuch mit identischen Eingabeaufforderungen und menschlicher Überprüfung durchführen.

**Was dies untermauert.** Die Evidenz definiert, was wie bewertet werden muss, nicht jedoch, welches Modell gewinnt. Sie rechtfertigt einen strukturierten, direkten Vergleich im Rahmen eines Pilotversuchs. Sie rechtfertigt keine Aussagen über Qualität, Geschwindigkeit, Kosten, Kontextverarbeitung oder die Verfügbarkeit von Funktionen für eines der beiden Modelle.

**Bewertungsübersicht (aktueller Stand der Erkenntnisse)**

| Arbeitsaufwand | Claude Opus 5.5 | GPT-6 Sol | Pilot-Maßnahme |
|---|---|---|---|
| Forschungssynthese | Keine kontrollierte Ausgabe bereitgestellt | Keine kontrollierte Ausgabe bereitgestellt | Bewertung durch blinden Gutachter anhand einer Rubrik |
| Langformtexte | Keine kontrollierte Ausgabe bereitgestellt | Keine kontrollierte Ausgabe bereitgestellt | Bewertung anhand einer Rubrik sowie Einhaltung eines genehmigten Längenziels |
| Code-Review | Keine kontrollierte Ausgabe bereitgestellt | Keine kontrollierte Ausgabe bereitgestellt | Anteil der identifizierten bekannten Probleme |
| Strukturiertes JSON | Keine kontrollierte Ausgabe bereitgestellt | Keine kontrollierte Ausgabe bereitgestellt | Erfolgsquote bei der Schema-Validierung |

Alle Zellen sind für beide Modelle identisch, da das Paket sie gleich behandelt. Derzeit spricht keine Zeile für eines der beiden Modelle.

## Wo die Belege fehlen

**Unbekannte Faktoren.** Das Paket enthält zu folgenden Punkten keine Angaben:

- Ob die Kosten für die Modellnutzung innerhalb des Migrationsbudgets von $48.000 liegen oder eine separate Finanzierung erfordern.
- Wann die Sicherheitsüberprüfung stattfinden wird, was sie abdeckt und ob eines der beiden Modelle im Rahmen dieser Überprüfung akzeptabel ist. Der Sicherheitsstatus ist für beide Modelle ungeklärt.
- Zeitplan für die 12-wöchige Migration und den 30-tägigen Pilotversuch.
- Eine genehmigte Zielwortzahl für längere Texte. Ohne diese kann die Bemerkung der Beteiligten, der Text sei „zu lang“, nicht bewertet werden.
- Preise, Benchmark-Ergebnisse, Kontextbeschränkungen und Produktfunktionen für Claude Opus 5.5 und GPT-6 Sol. Es werden keine Angaben gemacht, und dieses Memo geht von keinen aus.
- Wer die menschlichen Prüfer sind, wie viele es gibt und wie Meinungsverschiedenheiten zwischen ihnen gelöst werden.
- Welche Daten im Pilotprojekt verwendet werden dürfen, bevor die Sicherheitsüberprüfung abgeschlossen ist.

**Annahmen.** Hierbei handelt es sich um Vorschläge aus diesem Memo, nicht um Fakten aus den Unterlagen, und jeder davon bedarf der Zustimmung des Teams:

- Das Pilotprojekt kann nicht sensible oder synthetische Daten verwenden, bis die Sicherheitsprüfung die Verwendung realer Daten freigibt.
- Den Prüfern darf nicht bekannt sein, welches Modell die einzelnen Ergebnisse erzeugt hat.
- Das Team kann für jede Arbeitslast einen festen Satz von Eingabeaufforderungen zusammenstellen, der die tatsächlichen Aufgaben von „Project North“ widerspiegelt.
- Die unten vorgeschlagenen Bestehenschwellenwerte sind Ausgangspunkte, die das Team vor Beginn des Pilotprojekts ändern kann, jedoch nicht währenddessen.

## 30-tägiges Pilotprojekt

**Konzeption**

1.
GPT-6 Sol · vollständige Ausgabe
## Empfehlung der Geschäftsleitung

Wählen Sie noch nicht Claude Opus 5.5 oder GPT-6 Sol aus. Projekt North ist eine 12-wöchige Migration für ein 40-köpfiges Team, und das Paket liefert keine kontrollierten Ergebnisse aus einem der beiden Modelle. Es dient daher als Grundlage für einen Vergleichsplan, nicht für eine Leistungsbewertung. Führen Sie den verfügbaren 30-tägigen Pilotversuch mit identischen Eingabeaufforderungen und menschlicher Überprüfung durch und treffen Sie dann eine überprüfbare Entscheidung anhand der vereinbarten Kriterien, bevor die Ergebnisse ausgewertet werden. Entscheiden Sie sich nur dann für eines der Modelle, wenn dessen geprüfte Ergebnisse den Anforderungen des Teams entsprechen, dessen Einsatz im Rahmen der genehmigten finanziellen Vereinbarung liegt und die noch ausstehende Sicherheitsüberprüfung die Einführung zulässt. Sind diese Bedingungen nicht erfüllt, verschieben Sie die Auswahl, anstatt einen unvollständigen Vergleich als Erfolg zu werten.

Das genehmigte Migrationsbudget beträgt $48.000. Aus den Unterlagen geht nicht hervor, ob die Nutzung des Modells innerhalb dieses Budgets liegt. Der Zeitpunkt der Sicherheitsüberprüfung ist nicht festgelegt. Dies sind Entscheidungsbeschränkungen, die sowohl für Claude Opus 5.5 als auch für GPT-6 Sol gelten, und keine Argumente für die Bevorzugung eines der beiden Modelle.

## Was die Fakten belegen

**Beobachtet:** Das Team benötigt Forschungssynthese, das Verfassen längerer Texte, Code-Reviews und die strukturierte Extraktion von JSON-Daten. Es wünscht sich eine überprüfbare Lösung und kann einen 30-tägigen Pilotversuch mit identischen Eingabeaufforderungen und manueller Überprüfung durchführen. Ein Stakeholder bemängelt, der aktuelle Entwurf sei zu lang, doch eine Zielwortzahl wurde nicht festgelegt. Dieses Feedback weist auf ein Problem hin, das bei den schriftlichen Ergebnissen getestet werden muss; es legt jedoch weder ein bevorzugtes Modell noch eine akzeptable Länge fest.

Die aktuelle, aufgabenbezogene Scorecard ist bewusst nicht nach Rangfolge sortiert:

| Arbeitsbereich | Claude Opus 5,5 | GPT-6 Sol | Zu erhebende Pilotdaten |
|---|---|---|---|
| Forschungszusammenfassung | Noch nicht getestet | Noch nicht getestet | Von Prüfern bewertete Genauigkeit, Abdeckung und Nachvollziehbarkeit |
| Langform-Schreiben | Noch nicht getestet | Noch nicht getestet | Von Gutachtern bewertete Nützlichkeit, Klarheit und Prägnanz |
| Code-Review | Noch nicht getestet | Noch nicht getestet | Von Gutachtern verifizierte Ergebnisse und unbegründete Behauptungen |
| Strukturiertes JSON | Noch nicht getestet | Noch nicht getestet | Gültige Ergebnisse und korrekte Feld-Extraktion |

**Annahme für die Planung, kein beobachtetes Ergebnis:** Vergleichbare Arbeitsproben und eine gemeinsame Bewertungsrubrik können Unterschiede aufzeigen, die für das Projekt North relevant sind. Der Pilotversuch sollte diese Annahme überprüfen. Identische Eingabeaufforderungen allein machen die Auswahl noch nicht nachvollziehbar: Das Team muss auch die Eingaben, beide Ausgaben, die Bewertungskriterien, die Beurteilungen der Prüfer sowie die Gründe für etwaige Ausschlüsse oder Wiederholungen aufbewahren. Bei der manuellen Überprüfung sollte für jedes Modell derselbe Maßstab angelegt werden.

Bei längeren Texten sollten die Prüfer zwischen “zu lang” und “nicht nützlich” unterscheiden. Eine kürzere Antwort könnte notwendiges Material auslassen; eine längere Antwort könnte dennoch klar und brauchbar sein. Da keine Zielwortzahl festgelegt ist, kann das Pilotprojekt die Länge und die Urteile der Prüfer erfassen, sollte jedoch nicht nachträglich eine willkürliche Wortzahl zum Akzeptanzstandard erklären. Die gleiche Vorgehensweise gilt auch für die anderen Aufgaben: Es sollte festgehalten werden, was die Prüfer beobachtet haben, anstatt Präferenzen in Aussagen über die allgemeine Leistungsfähigkeit des Modells umzuwandeln.

## Wo die Belege fehlen

**Unbekannt:** Das Paket enthält keine kontrollierten Ausgaben von Claude Opus 5.5 oder GPT-6 Sol. Es liefert keine Angaben zur relativen Qualität, Zuverlässigkeit oder Eignung für einen der vier Arbeitsstränge. Es enthält zudem keine Preise, Kontextbeschränkungen, Benchmarks oder Informationen zur Produktfähigkeit. Folglich kann dieses Memo weder die Nutzungskosten abschätzen noch ableiten, welches Modell bei den Materialien von Project North eine bessere Leistung erbringen würde.

Die Budgetgrenzen müssen vor einer Kaufentscheidung geklärt werden. Die 48.000 $ stellen das genehmigte *Migrations*budget dar; ob die Nutzung des Modells daraus bezahlt werden muss, ist nicht angegeben. Eine Behandlung als entweder inbegriffen oder zusätzlich würde eine finanzielle Annahme schaffen, die das Paket nicht stützt. Das Team sollte die Antwort und den geltenden Genehmigungsweg dokumentieren, bevor es sich zu einer dauerhaften Nutzung verpflichtet.

Auch die Sicherheitsaspekte sind für beide Kandidaten ungeklärt. Ein Termin für die Sicherheitsüberprüfung ist nicht festgelegt, und die Unterlagen enthalten keine Angaben zum Sicherheitsergebnis. Selbst ein überzeugendes Ergebnis des Pilotprojekts würde diesen Status nicht aufheben. Das Team sollte klären, wer die Überprüfung planen und darüber entscheiden kann, welche Informationen der Prüfer benötigt und ob die Pilotaktivität selbst gemäß den geltenden Vorschriften zulässig ist; die Unterlagen geben auf diese Fragen keine Antwort. Da keine kalendarischen Start- oder Endtermine für die Migration, den Pilotversuch oder die Sicherheitsüberprüfung angegeben sind, sollte das Team nicht unterstellen, dass eine Sicherheitsentscheidung innerhalb des 30-tägigen Pilotversuchs oder der 12-wöchigen Migration getroffen wird.

## 30-tägiger Pilotversuch

Vor dem ersten Vergleich sollte das Team repräsentative Eingabeaufforderungen für alle vier Arbeitsstränge auswählen, die erwartete Form jeder Antwort definieren und sich auf eine Bewertungsrubrik für die manuelle Überprüfung einigen. Beide Modelle sollten identische Eingabeaufforderungen und die gleichen Überprüfungsanweisungen erhalten. Die Prüfer sollten ihre Beurteilungen anhand der Arbeit selbst und nicht anhand des Rufs eines Modells vornehmen. Die Eingabeaufforderung, die Ausgabe, die Bewertung und etwaige Korrekturwünsche sollten aufbewahrt werden, damit ein späterer Leser jede Beurteilung nachvollziehen kann. Abweichungen vom üblichen Prozess sollten dokumentiert werden, anstatt schwierige Fälle stillschweigend auszulassen.

Verwenden Sie drei messbare Prüfkriterien:

1. **Qualität der bewerteten Aufgabe:** Zählen Sie bei Forschungssynthesen, Langtexten und Code-Reviews den Anteil der Ausgaben, die die Prüfer für die angegebene Aufgabe akzeptieren. Erfassen Sie außerdem die Ablehnungsgründe separat – zum Beispiel fehlende Abdeckung, unklare Formulierung oder ein nicht verifiziertes Ergebnis des Code-Reviews. Berichten Sie die Ergebnisse nach Arbeitsbereich und Modell, nicht nur als eine zusammengefasste Gesamtpunktzahl.
2. **Zuverlässigkeit der strukturierten JSON-Daten:** Zählen Sie die Ergebnisse, die der vereinbarten Struktur entsprechen, sowie diejenigen, deren extrahierte Felder von einem Prüfer als korrekt bestätigt werden. Geben Sie beide Quoten für Claude Opus 5.5 und GPT-6 Sol an; eine strukturell gültige Antwort sollte nicht allein deshalb als korrekt gewertet werden, weil sie parset.
3. **Prüfaufwand und Nachvollziehbarkeit:** Erfassen Sie den Zeitaufwand, der erforderlich ist, um jede Ausgabe zu überprüfen und gegebenenfalls zu korrigieren. Zählen Sie Fälle mit, in denen nicht genügend Belege vorliegen, um die Entscheidung des Prüfers zu begründen. Vergleichen Sie diese Kennzahlen anhand desselben Prompt-Satzes, einschließlich der Fälle, in denen keine der beiden Ausgaben akzeptabel ist.

Einigen Sie sich vor der Sichtung der Pilotergebnisse auf Akzeptanzkriterien und den Umgang mit Gleichständen; das Paket enthält keine Benchmark, aus der sich numerische Schwellenwerte ableiten lassen. Veröffentlichen Sie nach Ablauf von 30 Tagen die Bewertungsrubrik, die Zahlenangaben, die Begründungen der Prüfer sowie ungelöste Fragen. **Abbruchbedingung:** Setzen Sie die Einführung aus, wenn die Sicherheitsanforderungen für das Pilotprojekt oder die anschließende Nutzung nicht erfüllt werden können oder wenn das Team keinen gültigen Budget- und Genehmigungsweg festlegen kann. Ersetzen Sie keine der beiden Genehmigungen durch positive Qualitätsbewertungen.

## Entscheidungsregel

Wählen Sie Claude Opus 5.5, wenn dessen Pilotnachweise die vorab vereinbarten Standards erfüllen, in den vom Team priorisierten Arbeitsströmen wesentlich überzeugender sind und die Sicherheits- sowie Finanzbedingungen geklärt sind. Wenden Sie genau dieselbe Regel auf GPT-6 Sol an. Wenn beide die Standards ohne wesentliche, relevante Unterschiede erfüllen, treffen Sie die Entscheidung anhand dokumentierter Projektprioritäten und geklärter Einschränkungen, anstatt einen Leistungssieger zu benennen. Wenn sich keines der Modelle qualifiziert – oder die Budgetgrenzen bzw. der Sicherheitsstatus weiterhin ungeklärt sind –, treffen Sie noch keine Modellauswahl. Dieses Ergebnis gewährleistet eine nachvollziehbare Entscheidung für das 40-köpfige Team, ohne mehr zu behaupten, als die Nachweise stützen können.
Metadaten: Claude — HTTP 200 · 25,98 s · finish_reason=length · prompt_tokens=598 · completion_tokens=2400
GPT — HTTP 200 · 27,763 s · finish_reason=stop · prompt_tokens=386 · completion_tokens=1695
Quellensynthese
Forschungsaufgabe
Quellensynthese: ein Unentschieden
Beide Modelle haben den Terminkonflikt auf den 15. Oktober gelöst, das vereinbarte Budget von $12.000 beibehalten und die Aussage “immer genau” als unbegründete Behauptung des Managers gewertet. Das Ergebnis ist ein Unentschieden bei dieser Aufgabe.
| Maß | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Punktzahl | 9.5 / 10 | 9.5 / 10 |
| Umgang mit Konflikten | S2 legt die Frist fest | S2 legt die Frist fest |
| Unbegründete Behauptung | Als „nicht unterstützt“ markiert | Als „nicht unterstützt“ markiert |
| Praktischer Unterschied | Ausführlichere Erläuterung der Risiken | Kompaktere Empfehlung |
Gemeinsamer vollständiger Eingabe
Stimmen Sie die unten aufgeführten Quellenangaben ab. Geben Sie (1) eine Markdown-Tabelle mit den Spalten “Behauptung”, „Maßgebliche Quelle“, „Status“ und „Begründung“ sowie (2) eine Empfehlung von etwa 250 Wörtern zurück. Verwenden Sie die später datierte Richtlinie ausschließlich zur Klärung des Terminkonflikts. Kennzeichnen Sie unbegründete Behauptungen als „unbegründet“. Fügen Sie keine Fakten hinzu.

[S1 01.09.2026] Das Pilotprojekt endet am 30. September. Das Budget beträgt $12.000.
[S2 03.09.2026] Das Pilotprojekt endet am 15. Oktober. Das Budget bleibt bei $12.000.
[S3 02.09.2026] Die Rechtsabteilung hat die Weitergabe externer Daten nicht genehmigt.
[S4 04.09.2026] Ein Manager sagt, das Modell sei „immer genau“; es sind keine Testnachweise beigefügt.
[S5 04.09.2026] Das Pilotprojekt-Team besteht aus 8 Mitgliedern.
[S6 05.09.2026] Das Entscheidungsmemorandum muss ungelöste Risiken auflisten.

Reichen Sie nur die Tabelle und die Empfehlung ein.
Claude Opus 5,5 · Gesamtleistung
| Angabe | Maßgebliche Quelle | Status | Grund |
|---|---|---|---|
| Pilotphase endet am 30. September | S2 (03.09.2026) | Ersetzt | Steht im Widerspruch zu S2. Die später datierte Notiz hat bei Terminkonflikten Vorrang. |
| Das Pilotprojekt endet am 15. Oktober | S2 (03.09.2026) | Bestätigt (maßgebend) | Dies ist die später datierte Notiz zum Terminkonflikt, daher hat sie Vorrang vor S1. |
| Das Budget beträgt $12.000 | S1 und S2 | Unterstützt | Beide Quellen stimmen überein, und S2 besagt, dass das Budget "weiterhin" $12.000 beträgt. Es besteht kein Konflikt. |
| Die Rechtsabteilung hat die Weitergabe externer Daten nicht genehmigt | S3 | Bestätigt | Wird direkt angegeben und von keiner anderen Quelle widerlegt. |
| Das Modell ist "immer genau" | S4 | Nicht bestätigt | Dies ist die Behauptung eines Managers, der keine Prüfnachweise vorlegt. |
| Das Pilotteam besteht aus 8 Mitgliedern | S5 | Bestätigt | Dies wird direkt angegeben und nicht widerlegt. Die Angabe stammt aus einer einzigen Quelle. |
| Das Entscheidungsmemo muss ungelöste Risiken auflisten | S6 | Bestätigt | Dies ist eine festgelegte Anforderung an das Memo und wird nicht widerlegt. |

**Empfehlung**

Im Entscheidungsmemo sollte der 15. Oktober als Enddatum des Pilotprojekts angegeben werden. S2 ist die später datierte Notiz und löst den Terminkonflikt, wodurch das Datum 30. September in S1 außer Kraft gesetzt wird. Die Regel des späteren Datums gilt nur für diesen Konflikt. Die anderen Aussagen wurden anhand ihrer jeweiligen Beleglage bewertet.

Das Budget sollte mit $12.000 erfasst werden. S1 und S2 stimmen in dieser Zahl überein, sodass keine Abstimmung erforderlich ist. Die Teamgröße von acht Mitgliedern kann ebenfalls berücksichtigt werden. Dies stützt sich ausschließlich auf S5, wird jedoch von keiner Quelle widerlegt.

S6 verlangt, dass in dem Memo ungelöste Risiken aufgeführt werden, und die Notizen belegen mindestens zwei davon.

- **Externer Datenaustausch:** Die Rechtsabteilung hat dies nicht genehmigt (S3). Das Memo sollte dies klar zum Ausdruck bringen. Es sollte nicht den Eindruck erwecken, dass der externe Datenaustausch während der Pilotphase zulässig ist.
- **Modellgenauigkeit:** Die Behauptung, das Modell sei "immer genau", ist nicht belegt. In S4 wird angemerkt, dass keine Testnachweise beigefügt sind, und die Behauptung wird lediglich als Aussage eines Managers vermerkt. Das Memo sollte dies nicht als Ergebnis darstellen oder sich darauf stützen, um Entscheidungen zu begründen. Die Modellgenauigkeit sollte als unbestätigt aufgeführt werden, bis entsprechende Nachweise vorgelegt werden.

Schließlich sollte das Memo kurz darauf hinweisen, dass sich das Enddatum des Pilotprojekts zwischen S1 und S2 geändert hat. Leser könnten an anderer Stelle auf das frühere Datum 30. September stoßen, und dieser Hinweis würde erklären, warum der 15. Oktober verwendet wird. Das Memo sollte keine Erläuterungen zu der Änderung, zu Testergebnissen oder zu Aktualisierungen des rechtlichen Status enthalten, da diese in den Quellnotizen nicht vorkommen.
GPT-6 Sol · vollständige Ausgabe
| Angabe | Maßgebliche Quelle | Status | Grund |
|---|---|---|---|
| Das Pilotprojekt endet am 30. September. | S2 (03.09.2026) | Ersetzt | Die später datierte Notiz löst den Terminkonflikt auf und gibt den 15. Oktober an. |
| Das Pilotprojekt endet am 15. Oktober. | S2 (03.09.2026) | Bestätigt | S2 liefert die maßgebliche Frist. |
| Das Budget beträgt $12.000. | S1 und S2 | Bestätigt | Beide Notizen geben denselben Betrag an. |
| Die Rechtsabteilung hat die Weitergabe externer Daten nicht genehmigt. | S3 | Bestätigt | S3 gibt dies direkt an; kein späterer Vermerk befasst sich mit dieser Genehmigung. |
| Das Modell ist “immer genau”. | S4 | Nicht bestätigt | Ein Manager erhebt diese Behauptung, es sind jedoch keine Testnachweise beigefügt. |
| Das Pilotteam besteht aus 8 Mitgliedern. | S5 | Unterstützt | S5 gibt die Teamgröße an. |
| Das Entscheidungsmemo muss ungelöste Risiken auflisten. | S6 | Unterstützt | S6 nennt diese Anforderung. |

**Empfehlung:** Verwenden Sie den 15. Oktober als Enddatum des Pilotprojekts im Entscheidungsmemo. S2 ist später als S1 und löst den Terminkonflikt zwischen beiden. Behalten Sie das Budget bei $12.000 bei: Die Notizen stimmen in diesem Betrag überein, sodass die Terminänderung keinen Grund für eine Änderung darstellt. Halten Sie die Größe des Pilotteams gemäß S5 mit 8 Mitgliedern fest.

Führen Sie ungelöste Risiken ausdrücklich auf, wie in S6 gefordert. In der Entscheidungsnotiz sollte angegeben werden, dass die Rechtsabteilung die Weitergabe externer Daten nicht genehmigt hat, ohne dabei zu implizieren, dass die Genehmigung inzwischen erteilt wurde oder dass die Weitergabe zulässig ist. Außerdem sollte die Aussage des Managers zur Genauigkeit von einer festgestellten Erkenntnis unterschieden werden. In S4 ist die Aussage festgehalten, dass das Modell “stets genau” sei, es werden jedoch keine Testnachweise vorgelegt. Diese Aussage darf nicht als verifiziertes Ergebnis dargestellt werden.

Halten Sie die Abstimmung eng gefasst. S2 regelt die widersprüchlichen Enddaten; es ersetzt nicht die separaten Notizen zu den rechtlichen Aspekten, der Genauigkeit, der Teamgröße oder den Anforderungen an das Memo. Wenn die Anmerkungen kein Ergebnis belegen, lassen Sie die Frage offen, anstatt eine Annahme zu treffen. Insbesondere stützt die Aufzeichnung weder die Behauptung, dass die Weitergabe externer Daten genehmigt wurde, noch die Behauptung, dass die Genauigkeit des Modells nachgewiesen wurde.

Das daraus resultierende Memo kann daher die Frist vom 15. Oktober und das Budget von $12.000 verwenden und gleichzeitig die beiden in diesen Anmerkungen offensichtlichen Beweis-Lücken aufzeigen: die ausstehende rechtliche Genehmigung für den externen Datenaustausch und das Fehlen von Testnachweisen für die Behauptung zur Genauigkeit.
Metadaten: Claude — HTTP 200 · 12,846 s · finish_reason=stop · prompt_tokens=338 · completion_tokens=1193
GPT — HTTP 200 · 12,322 s · finish_reason=stop · prompt_tokens=230 · completion_tokens=714
Codierung und strukturierte Ausgabe
Der Unterschied in der Kodierung lag in der Erläuterung
Ursprüngliche Filterbedingung: Wenn t
Ein „None“-Element gilt als „falsy“, daher wird es von diesem Filter bereits übersprungen.
Beide Modelle lieferten gültiges JSON mit den vier angeforderten Schlüsseln und demselben minimalen Patch. Claude beschrieb den vorhandenen Filter korrekt; GPT-6 Sol gab fälschlicherweise an, dass ein „None“-Element einen Fehler verursachen würde. Dieser spezifische Diagnosefehler ist von Bedeutung, wenn ein Prüfer entscheidet, ob ein Patch den tatsächlichen Fehler behebt.
Claude lieferte eine Risikoliste, während Sol eine kurze Risikobeschreibung lieferte. Da in der Aufgabenstellung kein bestimmter Typ für dieses Feld vorgeschrieben war, stellt dieser Unterschied keinen Vertragsverstoß dar. Die Aufgabenpunktzahl von Sol beträgt nach Korrektur des zuvor ungerechtfertigten Abzugs von einem halben Punkt 9,0/10; der Abzug wegen mangelnder sachlicher Richtigkeit bleibt bestehen.
Codierungsaufgabe
Kodierung und strukturierte Ausgabe: Claude Opus 5.5 war präziser
Beide Modelle lieferten gültiges JSON mit den angeforderten Schlüsseln und demselben minimalen Patch zurück. Claude erklärte zutreffend, dass der ursprüngliche Filter bereits einen Keine Element. GPT-6 Sol gab fälschlicherweise an, dass ein Keine Das Element würde einen Fehler verursachen. In der Eingabeaufforderung wurde kein bestimmter Typ für das Feld „risks“ verlangt.
| Maß | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Punktzahl | 10.0 / 10 | 9.0 / 10 |
| Patch | Korrekt und minimalistisch | Korrekt und minimalistisch |
| Diagnose | Isoliert beide Fehler korrekt | Übertreibt den Fehler des „None“-Elements |
| Angeforderter JSON-Vertrag | Gültiges JSON; alle vier Schlüssel sind vorhanden | Gültiges JSON; alle vier Schlüssel sind vorhanden |
Gemeinsamer vollständiger Eingabe
Gib ausschließlich striktes JSON mit den Schlüsseln 'diagnosis', 'patch', 'tests' und 'risks' zurück. Analysiere diese Python-Funktion und passe sie so geringfügig an, dass alle drei Fälle erfolgreich sind. Der Patch muss die Funktionssignatur beibehalten.

def normalize_tags(tags):
    return ','.join(sorted(set(t.strip().lower() for t in tags if t)))

Fälle:
1) [' AI ', 'ai', 'Code'] -> 'ai,code'
2) None -> ''
3) ['  ', None, 'SEO'] -> 'seo'

Führe keinen Code aus und füge keine Markdown-Fences oder Prosa außerhalb des JSON ein.
Claude Opus 5,5 · Gesamtleistung
{"diagnosis":"Zwei Fehler, die beim Lesen des Codes (ohne Ausführung) festgestellt wurden. (a) Fall 2: Wenn 'tags' den Wert 'None' hat, durchläuft der Generator 'None' und löst einen 'TypeError' aus, anstatt '' zurückzugeben. (b) Fall 3: Der Filter 'if t' wird vor dem Entfernen der Leerzeichen ausgeführt. Das nur aus Leerzeichen bestehende Tag ' ' ist wahrwertig, wird daher durchgelassen und zu '' umgewandelt. Das Ergebnis ist sorted(['', 'seo']), was zu ',seo' statt zu 'seo' verknüpft wird. Das None-Element in Fall 3 wird bereits durch 'if t' verworfen. Fall 1 funktioniert bereits: 'AI', 'ai' und "Code" werden zu {"ai", 'code'} normalisiert, was "ai,code" ergibt.","patch':'def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))','tests':['assert normalize_tags([' AI ', 'ai', 'Code']) == "ai,code" # traced: {'ai','code'} -> "ai,code"','assert normalize_tags(None) == '' # traced: (None or []) -> [] -> ''','assert normalize_tags([' ', None, 'SEO']) == "seo" # traced: " " scheitert an t.strip(), None scheitert an t, "SEO" -> 'seo''],'Risiken':['Nicht-Zeichenfolgen-Elemente wie 123 lösen bei .strip() einen AttributeError aus. Dies entspricht dem ursprünglichen Verhalten.",""tags oder []" behandelt jede falsy-Eingabe (zum Beispiel '' oder ein leeres Tupel) als leer. Dies steht im Einklang mit dem erforderlichen Verhalten None -> ''.","Wenn anstelle einer iterierbaren Struktur von Tags eine einzelne Zeichenkette übergeben wird, wird diese Zeichen für Zeichen durchlaufen. Dies entspricht dem ursprünglichen Verhalten.","Interne Leerzeichen werden nicht zusammengefasst, sodass ‚machine learning‘ und ‚machine learning‘ als unterschiedliche Tags erhalten bleiben.“,”Die Tests wurden ausschließlich durch manuelles Nachverfolgen abgeleitet und gemäß den Anweisungen nicht ausgeführt.“]}GPT-6 Sol · vollständige Ausgabe
{"diagnosis":"Die Funktion löst einen Fehler aus, wenn `tags` den Wert `None` hat oder `None` enthält, und behält Einträge bei, die nach dem Entfernen der Leerzeichen leer werden.","patch":"def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":[{"input":[" AI ",ai","Code"],"expected":"ai,code"},{"input":null,"expected":""},{"input":[" ",null,"SEO"],"expected":"seo"}],"risks":"Wird nicht ausgeführt. Einträge, die nicht `None` sind, werden als Zeichenketten angenommen."}Metadaten: Claude — HTTP 200 · 10,832 s · finish_reason=stop · prompt_tokens=244 · completion_tokens=965
GPT — HTTP 200 · 7,71 s · finish_reason=stop · prompt_tokens=146 · completion_tokens=305
Endgültiges Urteil
Praktische Wahl
Welches Modell passt zu Ihrer Arbeit?
GPT-6 Sol führt diese kleine erste Ausgabegruppe an, da es den überarbeiteten Langformvertrag fertiggestellt hat, während Claude Opus 5.5 die gemeinsame Obergrenze von 2.400 Token erreicht hat. Bei der Diagnosepräzision führt Claude Opus 5.5 die Code-/JSON-Aufgabe an. Bei der Quellcode-Synthese liegt ein Gleichstand vor.
Wählen Sie GPT-6 Sol wenn es vorrangig darum geht, ein langes Entscheidungsdokument mit zahlreichen Einschränkungen in einem Durchgang fertigzustellen. Wählen Sie Claude Opus 5,5 wenn eine Code- oder Structured-Output-Überprüfung von einer expliziteren Diagnose und einer detaillierteren Risikoerfassung profitiert. Wenn Ihre Arbeit beides umfasst, ordnen Sie jede Aufgabe dem Modell zu, das am besten dazu passt, anstatt einen einzigen universellen „Gewinner“ zu erzwingen.
Mit GlobalGPT haben Sie eine praktische Möglichkeit, sowohl Modelle als auch den Rest Ihres KI-Workflows in einem Dashboard zu bündeln. Recherche, Texterstellung, Programmierung, Bilder, Videos und über die Befehlszeile (CLI) gesteuerte Produktionsaufgaben können so in derselben Arbeitsumgebung verbleiben.
Häufig gestellte Fragen
Welches Modell hat den Vergleich gewonnen?
GPT-6 Sol führte in der kleinen ersten Ausgabegruppe mit 28,5 zu 26,5, nachdem die ursprüngliche Begrenzungsaufgabe ausgeschlossen und die Ableitung des JSON-Vertrags korrigiert worden war. Dieser Vorsprung ergab sich aus der Fertigstellung des überarbeiteten Langform-Vertrags unter derselben Ausgabebegrenzung von 2.400 Token; Claude Opus 5.5 führte bei der Code- und strukturierten-Ausgabe-Aufgabe, während es bei der Quellcode-Synthese zu einem Gleichstand kam.
Warum wurde der erste Langformtest ausgeschlossen?
In der ursprünglichen Aufgabenstellung wurden keine der beiden Modelle namentlich genannt. Beide Modelle haben sich zu Recht geweigert, die fehlenden Identitäten zu erraten, sodass diese Antwort prüft, ob ein Modell nach fehlendem Kontext fragt, anstatt so zu tun, als wüsste es die Antwort.
Ist Claude Opus 5.5 besser zum Programmieren geeignet?
Bei dieser Code- und JSON-Aufgabe lieferte Claude Opus 5.5 die präzisere Diagnose und eine strukturierte Risikoliste. Eine einzige Aufgabe reicht nicht aus, um eine allgemeingültige Rangliste der Kodierungen zu erstellen.
Ist GPT-6 Sol besser zum Schreiben geeignet?
GPT-6 Sol hat das überarbeitete, ausführliche Memo bereits in der ersten Ausgabe innerhalb des gewünschten Rahmens fertiggestellt. Das Ergebnis untermauert diese Empfehlung für den Arbeitsablauf im Rahmen dieses Tests, stellt jedoch keine allgemeine Aussage über jede Schreibaufgabe dar.
Kann ich beide Modelle testen, ohne die Plattform zu wechseln?
GlobalGPT ist als Multi-Modell-KI-Abonnement konzipiert, das mehrere KI-Funktionen in einem Dashboard vereint. Es eignet sich besonders dazu, dasselbe Paket aus Recherche-, Schreib- und Programmier-Prompts modellübergreifend zu nutzen und den gesamten Arbeitsablauf an einem Ort zu bündeln.
GlobalGPT So können Sie sowohl die Modelle als auch den restlichen AI-Workflow an einem Ort zusammenfassen. Beginnen Sie mit dem Modell, das für die aktuelle Aufgabe am besten geeignet ist, und führen Sie die Arbeit dann durch die einzelnen Schritte – Recherche, Texterstellung, Programmierung, Bildbearbeitung, Videobearbeitung oder CLI-gestützte Produktionsschritte –, ohne für jeden Teil einen separaten Dienst öffnen zu müssen.









