ابدأ بالصوت الذي تريد إصداره. اختر «Pick Eleven Music v2» للأغاني والمقطوعات الموسيقية المنظمة، و«Qwen Audio 3.0 TTS Flash» للتعليق الصوتي والأصوات التعبيرية، و«Seed Audio 1.0» عندما ترغب في دمج الكلام والمؤثرات الصوتية والأجواء في مشهد واحد متكامل.
لست بحاجة إلى العثور على نموذج صوتي ‘أفضل’ واحد. فالمبدع الذي يُنتج موسيقى خلفية يحتاج إلى شيء مختلف عما يحتاجه المسوق الذي يسجل تعليقًا صوتيًا أو المخرج الذي يصور مشهدًا في محطة قطار. لقد قمنا باختبار هذه المهام الفعلية — وليس مجرد قوائم الميزات — ويمكنك الاستماع إلى جميع النتائج العشر الأولى أدناه.
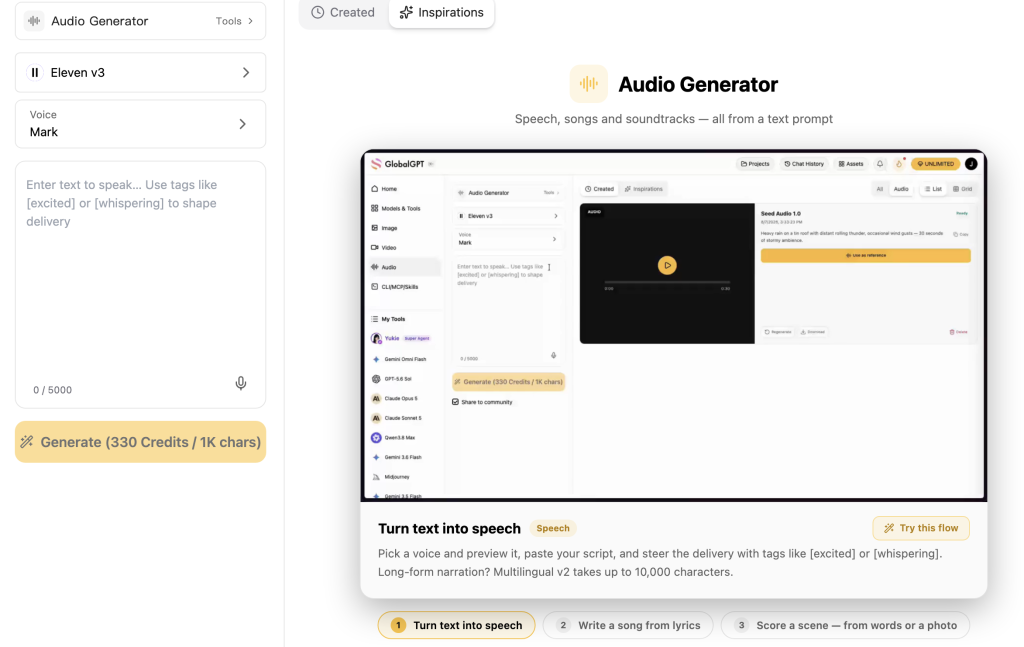
إذا كنت ترغب في تجربة الفكرة نفسها باستخدام موجه خاص بك،, جلوبال جي بي تي تي يوفر لك مكانًا واحدًا للتبديل بين النماذج الثلاثة جميعها. كما أنه يمثل مساحة عمل متعددة النماذج أكثر شمولاً: يمكنك استخدام نماذج مثل GPT-5.6 Sol وClaude Opus 4.8 وGemini 3.1 Pro للكتابة والبحث، ثم الانتقال إلى GPT Image 2 أو Seedance 2.0 عندما يحتاج المشروع إلى صور أو مقاطع فيديو. وهذا يعني أنه يمكنك صياغة النص، وإنشاء الصوت، ومواصلة بناء بقية المشروع دون الحاجة إلى ربط مجموعة من الأدوات المنفصلة معًا. يختلف الوصول إلى النماذج حسب الخطة.
ابدأ بما تريد صنعه
هذه مجرد نقاط انطلاق، وليست تصنيفاً شاملاً.
إجابة سريعة: أي طراز يناسب أي مهمة صوتية؟
إليك الطريقة البسيطة لاتخاذ القرار: اختر بناءً على الناتج النهائي، وليس بناءً على العلامة التجارية. يُعد «Eleven» نقطة الانطلاق الطبيعية عندما يكون الناتج النهائي هو الموسيقى؛ بينما يناسب «Qwen TTS Flash» السرد والصوت التعبيري؛ أما «Seed» فيناسب المشاهد التي تتطلب الجمع بين الكلام والمؤثرات الصوتية المحيطة والمؤثرات الخاصة. تُظهر مهامنا العملية الستة المجالات التي برزت فيها كل خيار بشكل أكبر، وتتيح لك المشغلات العشرة أدناه سماع المزايا والعيوب بنفسك.
| نموذج | ابدأ من هنا عندما… | ما قمنا بتجربته | يرجى مراعاة ما يلي |
|---|---|---|---|
| Eleven Music الإصدار 2 | أنت بحاجة إلى أغنية أو مقطوعة موسيقية منظمة | مباراتان موسيقيتان وعرض واحد للأغاني الغنائية | لم نستخدمه في السرد |
| Qwen Audio 3.0 TTS Flash | أنت بحاجة إلى سرد أو صوت معبر | مناظرتان | تنطبق هذه النتائج على إصدار Flash الذي تم اختباره |
| Seed Audio 1.0 | أنت بحاجة إلى مشهد كامل يتضمن عدة أنواع من الأصوات | موسيقى، وخطاب، ومشهد في محطة قطار | لا يعكس الإخراج المرن كل سمة من السمات الموجودة في المرحلة السابقة |
أولاً، هذه ثلاثة أنواع مختلفة من نماذج الصوت
Eleven Music الإصدار 2: مسار عمل مخصص للموسيقى
يصف ElevenLabs إيليفن ميوزيك من النص إلى الموسيقى مع إمكانية التحكم في النوع الموسيقي والأسلوب والبنية. كما تُظهر الوثائق النتائج الصوتية أو الآلية، والتوليد متعدد اللغات، والتحرير حسب المقاطع أو على مستوى الأغنية بأكملها. هذه الميزات تجعلها أكثر مسارات العمل المخصصة للموسيقى وضوحًا هنا؛ لكنها لا تعني أنها تنتمي إلى نفس مسار تحويل النص إلى كلام (TTS) الذي يتبعه Qwen.

Qwen Audio 3.0 TTS Flash: مسار الكلام الذي تم اختباره هنا
Qwen Audio 3.0 TTS Flash — المسار الدقيق لـ «Anywhere» هو qwen-audio-3.0-tts-flash—هو مسار الكلام المستخدم في المستويين B1 وB2. وثائق «أليبابا كلاود» الخاصة بتوليف الكلام تدرج هذا الاسم المحدد لـ«فلاش» في سياق الصوت المخصص الخاص بها. ولا تنقل هذه المقالة أي معلومات تتعلق بالمدة أو التنسيق أو ادعاءات الصوت المدمج من صفوف أو متغيرات أخرى في Qwen.

Seed Audio 1.0: سير عمل أكثر شمولاً في مجال الصوت
وظائف في شركة ByteDance Seed Audio 1.0 لتوليد مشاهد صوتية كاملة تشمل الأداء الصوتي والمؤثرات الصوتية والأجواء الصوتية والتوزيع الموسيقي الموحد. وهذا ما يجعلها الخيار الطبيعي عندما يتعين على مخرج صوتي واحد تنسيق عدة أنواع من الأصوات. ولا تشير الصورة الملتقطة بشكل واضح إلى وجود موسيقى، لذا فإن الملاحظات المتعلقة بالموسيقى الواردة في هذا المقال مستمدة من اختباراتنا العملية وليس من تلك الصورة.

المنفصل صفحة واجهة برمجة تطبيقات BytePlus يحدد seed-audio-1.0 كمسار لا يعتمد على البث المباشر، مع مدخلات صوتية أو مرئية مرجعية، والتحكم في التوقيت، ومدة إخراج تصل إلى 120 ثانية. هذه هي الحقائق المتعلقة بالمسار، والتي تُفصل عن البيان الأوسع نطاقاً المتعلق بوضع النموذج.

كيف قمنا باختبار مسارات العمل الصوتية الثلاثة
قمنا بتجميد المطالبات قبل عملية التوليد، وأرسلنا عشر مهام بالتتابع، واحتفظنا بأول ناتج صالح من كل مهمة. نجحت جميع الطلبات العشرة دون الحاجة إلى أي محاولات إعادة. تم استبعاد مقاطع الاستعداد؛ والمقطع الصوتي التجريبي أدناه هو المقطع الأول الصالح في صيغته الأولية.
- أدلة رسمية: وثائق المنتج أو واجهة برمجة التطبيقات (API) الخاصة بالشركة نفسها.
- الأدلة الملاحظة على المسار: التنسيق، والمدة، والتكلفة، وفك التشفير، وفحوصات الإشارة الخاصة بهذه الجلسة.
- أدلة الاستماع: التفضيلات الزوجية العمياء لمستخدم واحد تجاه A1 وA2 وB1 وB2، بالإضافة إلى المراجعة الدلالية لـ C1 وC3.
- الحدود: لم يتم تشغيل وظيفة «الاستقرار»؛ ولم يتم نسخ B1 وB2 أو مراجعتهما تلقائيًّا كلمةً بكلمة.
بلغ إجمالي الرسوم المسجلة $0.4819752667 مقابل عشرة مخرجات. ويُعد هذا الرقم وصفًا لهذه الجلسة ولا يمثل تعهدًا رسميًا بالسعر.
اختبارات الموسيقى: Eleven Music الإصدار 2 مقابل Seed Audio الإصدار 1.0
A1: الموسيقى التصويرية للوثائقي
A1: موسيقى خلفية وثائقية
موسيقى تصويرية لمدة 30 ثانية لفيلم وثائقي عن السفر، تتميز بتصعيد تدريجي لطيف ونهاية حاسمة.
اعرض النص الدقيق للموجه المجمد
قم بتأليف موسيقى خلفية آلية مدتها 30 ثانية لفيلم وثائقي قصير عن السفر. ابدأ بنغمات هادئة من الجيتار الأكوستيكي المعزوف بالأصابع ونغمات دافئة من البيانو، ثم أضف إيقاعات خفيفة باليد بعد مرور الثلث الأول من المقطوعة، وقم ببناء المقطوعة تدريجيًّا برفق، واختتمها بإيقاع نهائي واضح ومتكامل. يجب أن تكون الموسيقى تبعث على الأمل والتأمل. لا غناء، ولا كلام، ولا مؤثرات صوتية.
| نموذج | المسار الدقيق | الحالة | المدة الفعلية | التنسيق | التكلفة الملحوظة |
|---|---|---|---|---|---|
| Eleven Music الإصدار 2 | eleven-music-v2 | أول تاريخ صالح | 30.041 ثانية | MP3، 44.1 كيلوهرتز، صوت ستيريو | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | أول تاريخ صالح | 30.000s | PCM WAV، 40 كيلوهرتز، صوت ستيريو | $0.0700000 |
- الفحوصات الموضوعية
- تم فك تشفير الملفين بشكل صحيح، ولم يظهر أي تقطيع تقريبًا، وانتهيا بتلاشي واضح. ولم يتم تسجيل التوافق الكامل مع معايير الأجهزة.
- تقييم المستمع
- فضل المستمع الإصدار الثاني من «Eleven Music» لأن الانتقال من الإيقاع الخفيف إلى الإيقاع الثقيل بدا أكثر طبيعية، كما أن التنسيق بين الآلات الموسيقية بدا أكثر انسجامًا.
- نتيجة المهمة
- تم اختيار «إيليفن» لتنفيذ هذه المهمة الأولى.
- القيود
- ناتج صحيح واحد لكل نموذج؛ لم يتم إجراء اختبار الاستقرار.
اختبار الاستماع A1
استمع إلى المخرجات الأولى من A1
استخدم أي من البطاقتين لمقارنة النموذجين مباشرةً.
Eleven Music الإصدار 2
eleven-music-v2تم إنشاؤها عبر مسار «Anywhere» الذي خضع للاختبار في 6 أغسطس 2026. ناتج صالح واحد؛ لم يتم إجراء اختبار الاستقرار.
Seed Audio 1.0
seed-audio-1.0تم إنشاؤها عبر مسار «Anywhere» الذي خضع للاختبار في 6 أغسطس 2026. ناتج صالح واحد؛ لم يتم إجراء اختبار الاستقرار.
بالنسبة إلى A1، اختار المستمع الإصدار الأول لـ«إيليفن» باعتباره يوفر انتقالًا أكثر طبيعية من النغمات الخفيفة إلى الثقيلة، بالإضافة إلى تنسيق آلي أكثر انسجامًا.
A2: إشارة منظمة لإطلاق المنتج
ج 2: إشارة منظمة لإطلاق المنتج
مقطوعة موسيقية آلية مدتها 30 ثانية مقسمة إلى ثلاثة أجزاء: إيقاع بسيط، مع إضافة أصوات الطبول وزيادة في الطاقة، ثم خاتمة مشرقة.
اعرض النص الدقيق للموجه المجمد
قم بتأليف مقطوعة موسيقية آلية مدتها 30 ثانية لإطلاق منتج، مقسمة إلى ثلاثة أقسام واضحة: من 0 إلى 8 ثوانٍ، نبضة إيقاعية بسيطة من آلة السينثيسايزر؛ من 8 إلى 22 ثانية، أضف إيقاعات إلكترونية نقية وطاقة توافقية متصاعدة؛ من 22 إلى 30 ثانية، قدم ارتفاعًا نهائيًا مشرقًا وخاتمةً نقية. موسيقى عصرية وواثقة، لكن دون أن تكون عدوانية. لا تضم أي غناء أو كلام أو أصوات بيئية.
| نموذج | المسار الدقيق | الحالة | المدة الفعلية | التنسيق | التكلفة الملحوظة |
|---|---|---|---|---|---|
| Eleven Music الإصدار 2 | eleven-music-v2 | أول تاريخ صالح | 30.041 ثانية | MP3، 44.1 كيلوهرتز، صوت ستيريو | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | أول تاريخ صالح | 27.704 ثانية | PCM WAV، 40 كيلوهرتز، صوت ستيريو | $0.0646436 |
- الفحوصات الموضوعية
- تم فك تشفير الملفين بشكل صحيح دون أي اقتطاع يذكر. وأظهرت قيمة «Seed» 27.704 ثانية لطلب مدته 30 ثانية؛ وهذا سلوك طبيعي للمسار، وليس انخفاضًا في الجودة.
- تقييم المستمع
- فضل المستمع «Seed Audio 1.0» لكون مقدمتها أكثر وضوحًا وطبقاتها الموسيقية أكثر ثراءً؛ أما مقدمة «Eleven» فقد كان من الصعب سماعها.
- نتيجة المهمة
- تم اختيار «Seed» لتنفيذ هذه المهمة الأولى؛ أما الاختباران الموسيقيان فقد تم تقسيمهما.
- القيود
- لم يتم التحقق بشكل شامل من التوقيت الدقيق للمقطع؛ ولم يتم إجراء اختبار الاستقرار.
اختبار الاستماع A2
استمع إلى المخرجات الأولى لـ A2
استخدم أي من البطاقتين لمقارنة النموذجين مباشرةً.
Eleven Music الإصدار 2
eleven-music-v2تم إنشاؤها عبر مسار «Anywhere» الذي خضع للاختبار في 6 أغسطس 2026. ناتج صالح واحد؛ لم يتم إجراء اختبار الاستقرار.
Seed Audio 1.0
seed-audio-1.0تم إنشاؤها عبر مسار «Anywhere» الذي خضع للاختبار في 6 أغسطس 2026. ناتج صالح واحد؛ لم يتم إجراء اختبار الاستقرار.
بالنسبة لـ A2، حازت النتيجة الأولى التي قدمها «Seed» على تفضيل المستمعين لأن المقدمة كانت أوضح والطبقات الموسيقية بدت أكثر ثراءً. سجل مسار «Seed» مدة 27.704 ثانية لطلب مدته 30 ثانية؛ ونحن نسجل هذا الاختلاف بشكل منفصل، ولا نعتبره انخفاضًا في الجودة. وبما أن كل نموذج تفوق في مهمة موسيقية واحدة، فلا يوجد فائز في فئة الموسيقى.
اختبارات النطق: Qwen TTS Flash مقابل Seed Audio 1.0
B1: السرد الوثائقي المحايد
B1: السرد الوثائقي المحايد
نفس أسلوب السرد الإنجليزي الخاص بالميناء، بأسلوب هادئ ومحايد، ووتيرة معتدلة، وفترات توقف طبيعية.
اعرض النص الدقيق للموجه المجمد
كل صباح، يستيقظ الميناء قبل المدينة. تعبر العبّارات المياه، وتُضاء أضواء المتاجر، ويخطو أول المسافرين إلى الرصيف. وبحلول الساعة السابعة، يصبح الشاطئ الهادئ مركز النشاط اليومي. سرد وثائقي هادئ بلغة إنجليزية واضحة ومحايدة. استخدم وتيرة معتدلة ووقفات طبيعية. لا موسيقى، ولا أصوات محيطة، ولا مؤثرات صوتية.
| نموذج | المسار الدقيق | الحالة | المدة الفعلية | التنسيق | التكلفة الملحوظة |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | أول تاريخ صالح | 27.507 ثانية | MP3، 22.05 كيلوهرتز، صوت أحادي | $0.0051300 |
| Seed Audio 1.0 | seed-audio-1.0 | أول تاريخ صالح | 18.780 ثانية | PCM WAV، 40 كيلوهرتز ستيريو (قنوات متطابقة) | $0.0438200 |
- الفحوصات الموضوعية
- تم فك تشفير الملفين بشكل صحيح، وتضمن كلاهما نشاطًا يشبه الكلام وفترات توقف. ولم يبلغ المستخدم عن أي مشكلة واضحة في النص.
- تقييم المستمع
- فضل المستمع الصوت «Qwen» باعتباره أكثر طبيعيةً وشبهًا بالأسلوب الوثائقي؛ أما الصوت «Seed» فقد بدا جامدًا، كأنه تذكير قبل الامتحان.
- نتيجة المهمة
- يُفضل استخدام Qwen في هذه المهمة ذات المخرجات الأولى.
- القيود
- لم يتم التحقق من دقة النص حرفياً؛ ولم يتم إجراء اختبار الاستقرار.
اختبار الاستماع للمستوى B1
استمع إلى المخرجات الأولى من المستوى B1
استخدم أي من البطاقتين لمقارنة النموذجين مباشرةً.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flashتم إنشاؤها عبر مسار «Anywhere» الذي خضع للاختبار في 6 أغسطس 2026. ناتج صالح واحد؛ لم يتم إجراء اختبار الاستقرار.
Seed Audio 1.0
seed-audio-1.0تم إنشاؤها عبر مسار «Anywhere» الذي خضع للاختبار في 6 أغسطس 2026. ناتج صالح واحد؛ لم يتم إجراء اختبار الاستقرار.
بدا الصوت الناتج عن Qwen أكثر طبيعية وشبهًا بالصوت الوثائقي؛ أما صوت Seed فقد بدا جامدًا للمستمع. إذا كان التحقق من النصوص المكتوبة جزءًا أساسيًا من سير عملك، فإن هذا الدليل المنفصل يشرح كيف يمكن لـ ChatGPT تحويل الصوت إلى نص. لم نستخدم النص المكتوب للتحقق من النص B1 كلمة بكلمة.
B2: التطور العاطفي
B2: التطور العاطفي
صوت أنثوي يتحول من همسة متوترة إلى سرد محايد ثم إلى حماس مصحوب بالارتياح.
اعرض النص الدقيق للموجه المجمد
“لقد نجحنا”، همست مايا. ثم عادت الأضواء. “حسنًا... الآن يمكننا الاحتفال!” استخدمي صوتًا واحدًا متسقًا لامرأة بالغة. قومي بإلقاء الجملة الأولى بهدوء وتوتر، والجملة الوسطى بنبرة سردية محايدة، والجملة الأخيرة بحماس مصحوب بالارتياح. احرصي على أن تكون التغيرات العاطفية واضحة دون أن تكون مسرحية. لا تستخدمي موسيقى أو مؤثرات صوتية.
| نموذج | المسار الدقيق | الحالة | المدة الفعلية | التنسيق | التكلفة الملحوظة |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | أول تاريخ صالح | 25.913 ثانية | MP3، 22.05 كيلوهرتز، صوت أحادي | $0.0052950 |
| Seed Audio 1.0 | seed-audio-1.0 | أول تاريخ صالح | 9.180 ثانية | PCM WAV، 40 كيلوهرتز ستيريو (قنوات متطابقة) | $0.0214200 |
- الفحوصات الموضوعية
- تم فك تشفير الملفين بشكل صحيح؛ ووجدت فيهما مناطق كلام متعددة. ولم يتم احتساب الاختلافات في المدة ضمن معايير الجودة.
- تقييم المستمع
- فضل المستمع نموذج Qwen لما يتميز به من جودة صوت أكثر هدوءًا وإحساسًا أكثر إقناعًا عند سرد القصص.
- نتيجة المهمة
- يُفضل استخدام Qwen في هذه المهمة ذات المخرجات الأولى.
- القيود
- لم يتم التحقق من دقة النص حرفياً؛ ولم يتم إجراء اختبار الاستقرار.
اختبار الاستماع للمستوى B2
استمع إلى المخرجات الأولى لـ B2
استخدم أي من البطاقتين لمقارنة النموذجين مباشرةً.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flashتم إنشاؤها عبر مسار «Anywhere» الذي خضع للاختبار في 6 أغسطس 2026. ناتج صالح واحد؛ لم يتم إجراء اختبار الاستقرار.
Seed Audio 1.0
seed-audio-1.0تم إنشاؤها عبر مسار «Anywhere» الذي خضع للاختبار في 6 أغسطس 2026. ناتج صالح واحد؛ لم يتم إجراء اختبار الاستقرار.
كان الناتج الأول لـ Qwen يتميز بطابع «الهمس» الأكثر قوة وبإحساس أقوى بالسرد القصصي. لم يلاحظ المستخدم أي مشكلة واضحة في النص في B1 أو B2، لكن دقة الكلمات بالضبط لا تزال غير مؤكدة.
عرض نماذج سير العمل أحادية النموذج
C1: أغنية «Eleven Music v2» ذات الأغنية الصوتية المنظمة
C1: أغنية غنائية منظمة
أغنية من نوع «إندي-بوب» مدتها 30 ثانية، ذات آلات موسيقية وبنية ثابتة، وتتضمن سطرين إلهاميين إلزاميين.
اعرض النص الدقيق للموجه المجمد
قم بتأليف أغنية إندي-بوب مبهجة مدتها 30 ثانية، تضم مغنية رئيسية واحدة، مع صوت جيتار مشرق، وباس، وتصفيق بالأيدي. البنية: مقدمة موسيقية مدتها أربع ثوانٍ، مقطع غنائي قصير، مقطع كورس، ونهاية واضحة. استخدم كل سطر من هذه الأبيات مرة واحدة: المقطع: ‘الصباح على النافذة، والخطط تحلق عاليًا’. الكورس: ‘ابدأ من حيث أنت، واجعل اللحظة مشرقة’. لا تضمّن أي سرد صوتي أو مؤثرات صوتية.
| نموذج | المسار الدقيق | الحالة | المدة الفعلية | التنسيق | التكلفة الملحوظة |
|---|---|---|---|---|---|
| Eleven Music الإصدار 2 | eleven-music-v2 | أول تاريخ صالح | 30.041 ثانية | MP3، 44.1 كيلوهرتز، صوت ستيريو | $0.0750000 |
- الفحوصات الموضوعية
- تم فك تشفير ملف MP3 بشكل صحيح. تم الكشف عن عينة منفردة ضئيلة جدًّا عند مستوى الصوت الأقصى، دون حدوث أي تشويه واسع النطاق.
- تقييم المستمع
- وقد اعتبر المستمع أن المعيار قد تم استيفاؤه جزئيًا: فقد بدا الصوت غير طبيعي إلى حد ما، وكان مصحوبًا بضوضاء كهربائية.
- نتيجة المهمة
- تم تحقيق هذا الناتج الأول جزئيًا.
- القيود
- تنطبق هذه الملاحظة على هذا الناتج الأول فقط؛ لم يتم إجراء اختبار الاستقرار.
اختبار الاستماع C1
استمع إلى الناتج الأول لـ C1
قم بتشغيل أول مخرجات صالحة من عرض النموذج الفردي هذا.
Eleven Music الإصدار 2
eleven-music-v2تم إنشاؤها عبر مسار «Anywhere» الذي خضع للاختبار في 6 أغسطس 2026. ناتج صالح واحد؛ لم يتم إجراء اختبار الاستقرار.
لقد نفذت شركة C1 جزءًا من العقد. ووجد المستمع أن الصوت غير طبيعي إلى حد ما، وسمع فيه ضوضاء كهربائية. وهذه ملاحظة تتعلق بعينة محددة، وليست ادعاءً بوجود عيب عام.
C3: مشهد محطة القطار الكامل من Seed Audio 1.0
C3: مشهد محطة السكك الحديدية الكامل
مشهد مدته 20 ثانية في محطة ساحلية يجمع بين أصوات المحيط، وقطار متحرك، ورنين الجرس، وإعلان دقيق.
اعرض النص الدقيق للموجه المجمد
قم بإنشاء مشهد كامل لمحطة قطار ساحلية مدته 20 ثانية عند الفجر. ابدأ بنسيم بحري هادئ وأصوات طيور النورس البعيدة. يقترب قطار من اليسار ويكبح عند الرصيف. تقول مذيعة المحطة بهدوء وبصوت واضح: ‘القطار الساحلي الساعة 7:15 يصل الآن إلى الرصيف الثاني’. أضف نغمة موسيقية قصيرة وهادئة قبل الإعلان، ثم دع صوت القطار والأجواء المحيطة تتلاشى بشكل طبيعي. احرص على أن يكون الكلام واضحًا وأن يكون المشهد متماسكًا من الناحية المكانية.
| نموذج | المسار الدقيق | الحالة | المدة الفعلية | التنسيق | التكلفة الملحوظة |
|---|---|---|---|---|---|
| Seed Audio 1.0 | seed-audio-1.0 | أول تاريخ صالح | 20.000s | PCM WAV، 40 كيلوهرتز، صوت ستيريو | $0.0466667 |
- الفحوصات الموضوعية
- تم فك تشفير ملف WAV بشكل صحيح، ولم يكن به أي تشويش تقريبًا، واحتوى على بنية المشهد متعددة الأجزاء المطلوبة من الناحية الفنية.
- تقييم المستمع
- وقد اعتبر المستمع أن هذا المعيار قد تم استيفاؤه جزئيًا، لأن أصوات فرملة القطار وتوقفه بدت مصطنعة إلى حد ما.
- نتيجة المهمة
- تم تحقيق هذا الناتج الأول جزئيًا.
- القيود
- لم يتم تدوين نص الإعلان بالضبط من مصدر مستقل؛ ولم يتم إجراء اختبار الاستقرار.
اختبار الاستماع C3
استمع إلى الإصدار الأول من C3
قم بتشغيل أول مخرجات صالحة من عرض النموذج الفردي هذا.
Seed Audio 1.0
seed-audio-1.0تم إنشاؤها عبر مسار «Anywhere» الذي خضع للاختبار في 6 أغسطس 2026. ناتج صالح واحد؛ لم يتم إجراء اختبار الاستقرار.
كما أن C3 قد أوفت جزئيًا بشروط العقد: فقد وجد المستمع أن أصوات فرملة القطار وتوقفه تبدو مصطنعة إلى حد ما. وقد يواجه صانعو الفيديو الذين يجمعون بين الكلام المولد والمرئيات نفس المشكلة أيضًا دليل الحوار والصوت ومزامنة الشفاه مفيد، على الرغم من أن مزامنة الشفاه لم تُختبر هنا.
التكلفة، وطول الناتج، وسلوك المسار
الشحنة المقاسة ومدة الإخراج الفعلية
نتيجة صالحة واحدة لكل مهمة عبر «Anywhere» في 6 أغسطس 2026. الرسوم المذكورة هي رسوم جلسات المراقبة، وليست قائمة أسعار رسمية. يستخدم كل من المقياسين المصغرين مقياسًا بصريًّا منفصلاً؛ ولا يتم استخدام محور مزدوج أو درجة مجمعة.
تتراوح التكاليف المسجلة بين $0.00513 لـ Qwen B1 و$0.075 لكل مخرج من مخرجات Eleven. وتتراوح المدة الفعلية بين 9.180 ثانية لـ Seed B2 و30.041 ثانية لمخرجات الموسيقى في Eleven. وهذه نتائج قياسات الجلسات، وليست أسعارًا قائمة أو درجات جودة.
لماذا تجرب هذه النماذج الصوتية على GlobalGPT؟
يُعد توليد الموسيقى، وتحويل النص إلى كلام (TTS) التعبيري، والمشاهد الصوتية الكاملة مهام مختلفة، ولهذا السبب لا يوجد نموذج واحد فائز ومفيد في هذا المجال. يُجعل نموذج GlobalGPT هذا التمييز عمليًّا: يمكنك البدء باستخدام Eleven Music لتسجيل مقطوعة موسيقية، ثم التبديل إلى Qwen Audio للتعليق الصوتي، أو استخدام Seed Audio لإنشاء مشهد مُركَّب دون الحاجة إلى الاحتفاظ بمنصة منفصلة لكل مسار عمل صوتي.
نظرًا لأن GlobalGPT عبارة عن مساحة عمل متعددة النماذج وليست أداة مخصصة للصوت فقط، فإن العمل لا يجب أن ينتهي بملف صوتي. يمكنك استخدام نماذج الذكاء الاصطناعي الأخرى المتوفرة على المنصة لصياغة مسودة نص أو صقله، أو البحث في موضوع ما، أو إنشاء صور داعمة، أو تطوير مواد فيديو حول المقطع الصوتي النهائي.
في 10 أغسطس 2026، صفحة أسعار GlobalGPT أظهرت المعادلات الشهرية $5.8 لخطة BASIC، و$10.8 لخطة PRO، و$25.0 لخطة UNLIMITED مع عرض خيار «التحديد السنوي» و«الفوترة السنوية». هذه هي أرقام الفوترة السنوية للصفحة؛ ويختلف الوصول إلى النماذج حسب الخطة.

أي طراز يجب أن تختار؟
مصفوفة نتائج المخرجات الأولى المكونة من ست مهام
| سير العمل | الطرازات التي خضعت للاختبار | النتيجة | السبب الملحوظ | نوع الدليل | الحدود |
|---|---|---|---|---|---|
| A1 · الموسيقى | إيليفن ضد سيد | أحد عشر مفضلاً | تطور أكثر طبيعية وتناغمًا في التوزيع الموسيقي | تفضيلات المستمعين المكفوفين | ناتج واحد لكل منها |
| A2 · الموسيقى | إيليفن ضد سيد | يفضل استخدام البذور | مقدمة أوضح وطبقات أكثر ثراءً | تفضيلات المستمعين المكفوفين | أظهرت عملية «Seed» زمنًا قدره 27.704 ثانية |
| B1 · المحادثة | Qwen ضد Seed | يفضل Qwen | أسلوب سرد وثائقي أكثر طبيعية | تفضيلات المستمعين المكفوفين | لم يتم مراجعة النص كلمة بكلمة |
| B2 · المحادثة | Qwen ضد Seed | يفضل Qwen | إحساس أقوى بالهمس وسرد القصص | تفضيلات المستمعين المكفوفين | لم يتم مراجعة النص كلمة بكلمة |
| C1 · أغنية غنائية | أحد عشر فقط | تم الوفاء به جزئيًا | كان الصوت غير طبيعي ويشبه الضجيج الكهربائي | المراجعة الدلالية للمستخدم | ملاحظة خاصة بالعينة |
| C3 · المشهد الصوتي | البذور فقط | تم الوفاء به جزئيًا | بدا صوت كبح القطار وتوقفه مصطنعًا | المراجعة الدلالية للمستخدم | لم يتم تدوين نص الإعلان |
لا يتم تحويل أي صف إلى نتيجة إجمالية أو فائز عام.
- اختر Eleven Music الإصدار 2 عندما يكون العمل متعلقاً بالموسيقى في جوهره: مقطوعات موسيقية منظمة، أو أغاني، أو تحرير موسيقي على مستوى المقاطع.
- اختر Qwen Audio 3.0 TTS Flash عندما تكون المهمة عبارة عن سرد أو خطاب تعبيري منظم.
- اختر Seed Audio 1.0 عندما يتعين أن يكون الناتج بمثابة مشهد متكامل يجمع بين الأجواء والمؤثرات الصوتية والكلام.
تلخص هذه التوصيات مدى ملاءمة سير العمل بالإضافة إلى ستة تقييمات للنتائج الأولية. وهي لا تحدد فائزًا واحدًا بشكل عام.
محدودية هذه المقارنة
- نتيجة صحيحة واحدة لكل نموذج ومهمة؛ ولا توجد تكرارات في الاستقرار.
- لم يتم نسخ النصين B1 وB2 أو مراجعتهما حرفياً.
- تعتبر أحكام الاستماع ذاتية وتختلف باختلاف العينة.
- مسار «Anywhere» لا يمثل المنتج الكامل في المرحلة الأولية.
- لا توجد أي قائمة تصنيف مستقلة عادلة تغطي هذه المسارات الثلاثة بالضبط في إطار طريقة واحدة.
- لم يتم تقييم تنسيق الملف، ومعدل العينات، والقنوات، وحجم الملف، ومستوى صوت التشغيل كمعايير للجودة.
الأسئلة الشائعة
01هل «Eleven Music v2» و«Qwen Audio 3.0» و«Seed Audio 1.0» من نفس النوع من النماذج؟
برنامج «No. Eleven Music v2» هو نظام مخصص لسير عمل الموسيقى، أما «Qwen Audio 3.0 TTS Flash» فهو مسار الكلام الذي تم اختباره هنا، في حين أن «Seed Audio 1.0» مصمم لتوليد الصوت للمشاهد الكاملة. ولذلك، فإن هذه المقارنة تقدم توصيات حسب المهمة بدلاً من فرض ترتيب شامل واحد.
02ما هو النموذج المصمم لتوليد الموسيقى باستخدام الذكاء الاصطناعي؟
يُعد برنامج «Eleven Music v2» الخيار الأكثر وضوحًا والمخصص للموسيقى في هذه المقارنة. وتصف وثائقه الرسمية إمكانية التحكم في النوع الموسيقي والأسلوب والبنية والإخراج الصوتي أو الآلي، بالإضافة إلى دعم لغات متعددة، والتحرير على مستوى المقاطع أو على مستوى الأغنية بأكملها.
03أي المسارات التي تم اختبارها تناسب السرد والكلام التعبيري؟
برنامج Qwen Audio 3.0 TTS Flash، المُعرف هنا بالمسار الدقيق «qwen-audio-3.0-tts-flash» في Anywhere، كان الأفضل في اختباري السرد والكلام التعبيري. وقد فضل المستمع الناتج الأول لهذا البرنامج في كل من B1 وB2، لكن لم يتم اختبار الاستقرار ودقة الكلمات بالضبط.
04ما هو الطراز الذي يمكنه إنشاء مشهد صوتي متكامل يتضمن الكلام والمؤثرات الصوتية؟
يُعد برنامج Seed Audio 1.0 الحل الأمثل لتنفيذ سير العمل الخاص بتأليف المشهد الصوتي. ويشمل نطاق استخدامه الرسمي الأصوات والمؤثرات الصوتية والأجواء الصوتية والتوزيع الموسيقي الموحد، في حين جمع اختبار C3 بين إعلان المحطة وحركة القطار ونغمة الجرس والأجواء الساحلية في مخرجات واحدة.
05هل يمكنني استخدام الثلاثة جميعًا عبر GlobalGPT؟
نعم. يمكنك تجربة «Eleven Music» للموسيقى، و«Seed Audio 1.0» للمشاهد الصوتية الكاملة، و«Qwen Audio 3.0» للكلام ضمن مساحة عمل الصوت في GlobalGPT. كما يدمج GlobalGPT سير عمل الكتابة والبحث والصور والفيديو في نفس المنصة متعددة النماذج. تختلف النماذج المتاحة حسب الخطة.
06هل تحدد هذه المقارنة فائزًا نهائيًّا؟
لا. تخدم النماذج مسارات عمل مختلفة، وتشمل الأدلة العملية ناتجًا أول صحيحًا واحدًا لكل نموذج ومهمة دون تكرارات للتأكد من الاستقرار. والاستنتاج المفيد مشروط: «Eleven» للموسيقى المخصصة، و«Qwen TTS Flash» للكلام، و«Seed» للمشاهد الصوتية الكاملة.
جرب أسلوب العمل الخاص بك في مجال الصوت
أحضر معك موجز الموسيقى الخاص بك، أو نص السرد، أو فكرة المشهد الصوتي إلى مولد الصوت GlobalGPT وقارن النتيجة مع المهمة التي تحتاج فعليًّا إلى إنجازها. انتبه إلى البنية الموسيقية، وأسلوب الأداء الصوتي، وتماسك المشهد، والالتزام بالتعليمات، بدلاً من اختيار عارضة بناءً على اسمها فقط.
بمجرد أن يعمل اتجاه الصوت بشكل صحيح، يمكنك متابعة المشروع باستخدام نماذج الذكاء الاصطناعي الأخرى الخاصة بـ GlobalGPT لتطوير النصوص، والبحث، والصور الداعمة، ومفاهيم الفيديو. وهذا يحول الاختبار إلى سير عمل عملي لإنتاج المحتوى بدلاً من أن يكون مجرد عرض صوتي منفصل؛ ولا تكرر النتائج إلا عندما تحتاج إلى دليل على الاستقرار.