Wählen Sie „Eleven v4“ für eine fertige Erzählung; wählen Sie „Eleven v4 Turbo“, wenn die Stimme im Verlauf eines Gesprächs reagieren soll. Beide gehören zur ’ElevenLabs“-Familie der Expressive-v4-Produkte. Der entscheidende Unterschied liegt im Bereitstellungsablauf: eine ausgefeilte Audiodatei für ein Video oder ein Hörbuch im Gegensatz zu gestreamter Sprache für einen Assistenten, der den Zuhörer nicht warten lassen darf.
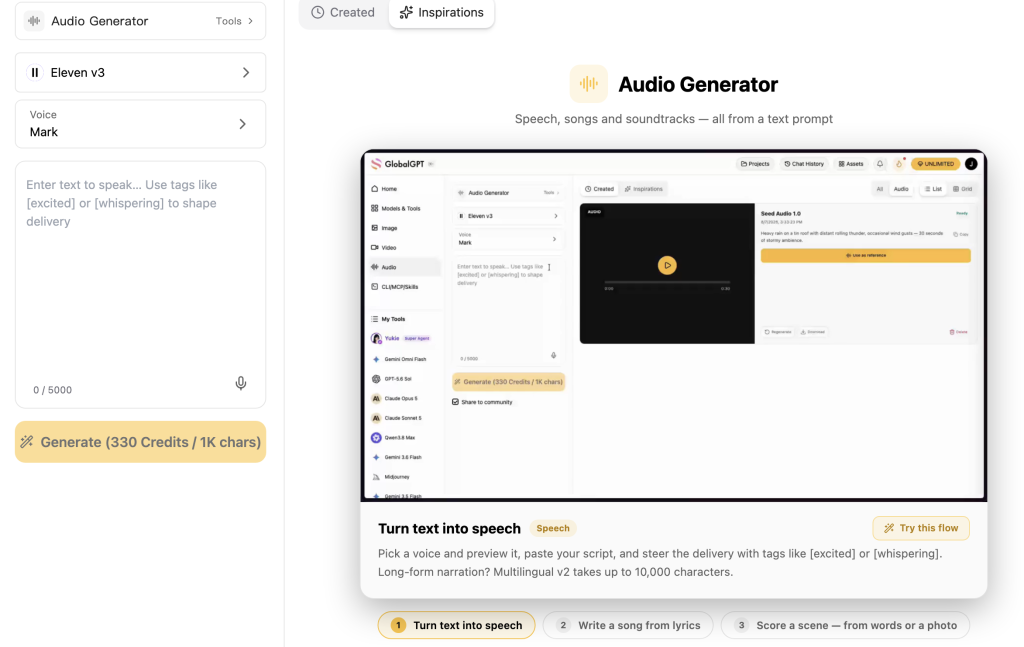
Für Kreative, die mehr als nur Audioinhalte produzieren, GlobalGPT bringt die Sprachgenerierung in denselben Abonnement-Arbeitsbereich wie Drehbuchschreiben, Bilder und Videos. Damit ist es ein praktischer und kostengünstiger Ausgangspunkt für eine komplette Kampagne. Wir haben mit jedem Modell in GlobalGPT zwei erste Eingabeaufforderungen und ein überarbeitetes Folgedrehbuch generiert. Die sechs folgenden Audiodateien zeigen sowohl einen häufigen Fehler bei der Eingabeaufforderung als auch die praktische Lösung.
Eleven v4 vs. v4 Turbo auf einen Blick
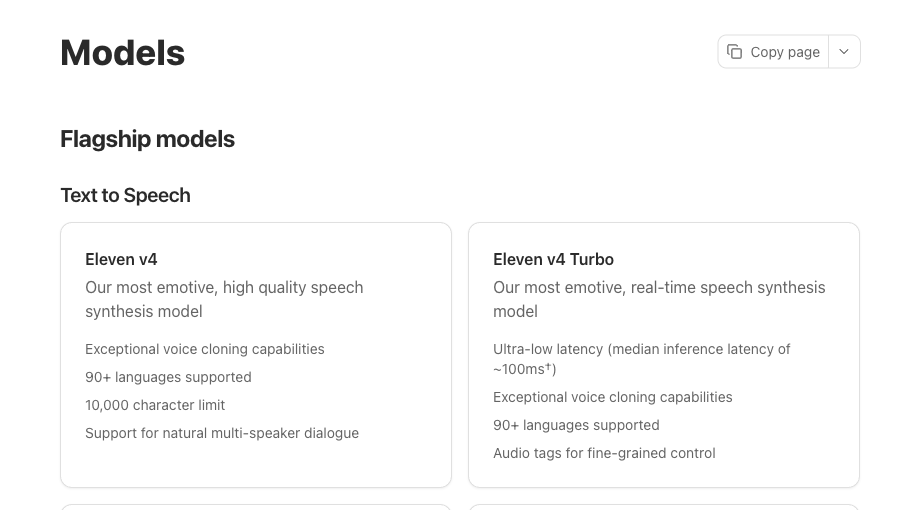
ElevenLabs positioniert v4 im Bereich emotionaler Ausdruckskraft und hoher Qualität der fertigen Inhalte und v4 Turbo im Bereich ausdrucksstarker Echtzeit-Sprache. Turbo ist nicht einfach nur das Versprechen, dass jede heruntergeladene MP3-Datei schneller verfügbar ist. Um die Vorteile des Streamings nutzen zu können, muss die Anwendung die Audiodaten tatsächlich in Blöcken übertragen und wiedergeben.
| Entscheidung | Eleven v4 | Eleven v4 Turbo |
|---|---|---|
| Hauptpassform | Sprecher, Hörbücher, ausdrucksstarke fertige Inhalte | Echtzeit-Gesprächsrede |
| Offizielle Modell-ID | eleven_v4 | eleven_v4_turbo |
| Sprachförderung in der Familie | Über 90 Sprachen | Über 90 Sprachen |
| Lieferrichtung | Anweisungen in natürlicher Sprache und Inline-Ausdrucks-Tags | Ausdrucksstarke Wiedergabe in einem Streaming-Workflow |
| Zu untersuchender API-Pfad | REST: Text in Dialog umwandeln | Echtzeit-Text-zu-Dialog-WebSocket |
| Unterscheidung zwischen „Voice“ und „Count“ in den aktuellen Dialoghinweisen | Bis zu 10 individuelle Stimmen bei der Eingabe von REST-Dialogen | Genau eine registrierte Stimme im Echtzeit-Guide |
| Veröffentlichte Latenzmessung | Hier wurde keine vergleichbare Zahl verwendet | Medianwert der Inferenzzeit: ca. 100 ms; Medianwert der Zeit bis zur ersten Sprachausgabe im Startbericht: ca. 150 ms |
Offizielle Dokumentation und Informationen zur Markteinführung, Stand: 13. Oktober 2026. Die Sprachunterstützung ist eine Familienspezifikation; die Anzahl der Stimmen hängt vom API-Weg ab.
Sprachqualität, Emotionalität und Sprachunterstützung
Bei einer aufgezeichneten Erzählung hat die Stimme Zeit, sich in einen Satz einzufinden: Pausen, Betonungen und emotionale Veränderungen können wichtiger sein als eine kurze Verzögerung bei der Sprachausgabe. Das ist die Aufgabe, die ElevenLabs der Version 4 zuweist. Ein Dialogagent unterliegt anderen Einschränkungen. Selbst eine überzeugende Antwort wirkt unnatürlich, wenn sie zu spät einsetzt; daher legt Turbo den Schwerpunkt darauf, ausdrucksstarke Sprache schnell zu erzeugen.
Mit der Einführung von Version 4 gibt es nun Anweisungen in natürlicher Sprache sowie Inline-Tags für den sprachlichen Ausdruck und Geräusche. Eine Anweisung wie “ruhiger Einstieg, gefolgt von einem begeisterten Schlusssatz” ist hilfreicher als die vage Forderung nach einer „besseren“ Stimme. Halten Sie das gesprochene Skript und die Anweisungen zur Darbietung getrennt, sofern die Benutzeroberfläche separate Felder dafür bereitstellt. Andernfalls kann ein einfaches Textfeld eine Anweisung in gesprochene Worte umwandeln.
- Für die Produktbeschreibung: Beurteilen Sie den Produktnamen, achten Sie auf Pausen bei den wichtigsten Vorteilen und prüfen Sie, ob der letzte Satz natürlich klingt.
- Für Szenen mit Figuren: Verwenden Sie eine Route mit expliziter Sprachzuordnung; die Nennung von Sprechernamen in einer Textansage allein garantiert noch keine getrennten Stimmen.
- Zur Lokalisierung: Beide Modelle unterstützen über 90 Sprachen, aber testen Sie die jeweilige Sprache, den Akzent, die Namen und die Abkürzungen in Ihrem Skript.
- Für geklonte Stimmen: Verwenden Sie eine Stimme, deren Eigentümer Sie sind oder für deren Vervielfältigung Sie die Erlaubnis haben, und bestätigen Sie das entsprechende Konto sowie den Zugriff auf die Stimmklonierung.
Die Produktfamilie umfasst Funktionen zum Klonen von Stimmen, doch die Unterstützung durch ein Modell unterscheidet sich von den im Abonnement enthaltenen Berechtigungen für ein bestimmtes Klon-Tool. Wählen Sie zunächst die Stimme und den Zugriffsweg aus und vergleichen Sie dann die Bereitstellung. Wenn Sie bereits ein älteres Sprachausgabemodell verwenden, ist unser Eleven Multilingual v2 – Testbericht bietet einen weiteren Anhaltspunkt für eine Migrationsentscheidung.
Was “schneller” für den v4 Turbo bedeutet
In der Modelldokumentation heißt es sinngemäß Median der Inferenzlatenz: 100 ms für den v4 Turbo. Der Beitrag zur Markteinführung zitiert sinngemäß 150 ms – Medianwert der Zeit bis zur ersten Äußerung. Diese beschreiben verschiedene Abschnitte der Sprachverarbeitungskette, und keiner von beiden garantiert, dass eine vollständige Voiceover-Datei in einem Bruchteil einer Sekunde heruntergeladen wird.
Unsere GlobalGPT-Beispiele erfassten die Gesamtdurchlaufzeit bis zum Abschluss der Aufgabe, einschließlich der Wartezeit auf die generierte Datei. Die Latenz bis zum ersten Ton oder eine WebSocket-Kommunikation wurden dabei nicht gemessen. Die Ergebnisse zeigen, warum ein Test zur Dateierzeugung allein eine ungeeignete Methode ist, um die Reaktionsfähigkeit im Dialog zu bewerten: Turbo war in keinem der beiden ursprünglichen Paare der schneller abgeschlossene Auftrag, schloss jedoch die Folgeaufgabe mit dem sauberen Skript schneller ab. Diese Schwankungen über drei kleine Paare hinweg stellen keine stabile Geschwindigkeitsrangliste dar.
Sechs GlobalGPT-Audiobeispiele: Die ersten Aufnahmen und eine praktische Lösung
Wir haben am 13. Oktober 2026 jeweils einmal zwei erste Eingabeaufforderungen an jedes Modell gesendet und anschließend nach Überprüfung des gesprochenen Textes jeweils ein Paar aus sauberem Skript und Aufnahme hinzugefügt. Alle sechs Anfragen lieferten abspielbare MP3-Dateien; keine Aufnahme wurde durch eine Neuaufnahme ersetzt. Die Eingabeaufforderungen stimmten innerhalb jedes Paares überein, eine gemeinsame Stimm-ID wurde jedoch nicht festgelegt. Wir haben die Dateidauer überprüft und eine lokale automatische Transkription verwendet, um die gesprochenen Wörter zu vergleichen. Dabei wird der Inhalt überprüft, nicht die Natürlichkeit oder die emotionale Qualität.
Beispiel 1: Eine kurze Produktvorstellung
Bei der ersten Anweisung wurden die Sprechanweisungen mit dem Werbetextskript vermischt. Beide Transkripte enthalten die einleitende Anweisung: “Lies diese kurze Produktvorstellung mit einem ruhigen Einstieg und einem begeisterten Schlusssatz vor.” Daher eignen sich diese ersten Aufnahmen nicht als fertige Werbespots. Trage die Wörter, die gesprochen werden sollen, in das Feld für den reinen Sprechtext ein; füge die Anweisungen zur Darbietung in ein separates Steuer- oder Anweisungsfeld ein.
Beispiel 2: Eine inszenierte Miniszene
Die zweite Eingabeaufforderung enthält Anweisungen für die Sprecher sowie einen Hinweis zum Lachen. Beide Transkripte enthalten die Angaben “Sprecher eins, herzlich” und “Sprecher zwei, mit ruhiger Selbstsicherheit”. Das Einfügen dieser Angaben in eine reine Text-Eingabeaufforderung führte nicht zu einer klaren Charakterszene. Verwenden Sie für einen Produktionsdialog eine unterstützte Schnittstelle mit expliziter Sprecherzuordnung und trennen Sie die gesprochenen Zeilen von den Regieanweisungen.
Beispiel 3: Behalten Sie nur die Wörter bei, die ausgesprochen werden sollen
Für den nächsten Schritt haben wir die Einleitung entfernt und nur das Werbeskript eingereicht. Beide automatischen Transkripte stimmten in der Wortfolge mit dem Skript überein, ohne die unerwünschte Anweisung. Die resultierenden Dateien waren etwa 11 Sekunden lang. Dies ist der sinnvollere Ausgangspunkt für ein kurzes Produktvideo.
Eine sauberere Eingabe führt zu einem brauchbaren Sprachscript
Willkommen bei Acorn Studio. Beginnen Sie mit einem klaren Plan und erstellen Sie dann den ersten brauchbaren Entwurf. Heute können Ihre Ideen von einem leeren Blatt Papier zu einem ausgefeilten Ergebnis werden.
- Generation
- GlobalGPT · 13. Oktober 2026 · eine Folgeanfrage pro Modell, Standard-Stimmeinstellungen
- Bearbeitungszeit bis zur Fertigstellung der Aufgabe
- v4: 15,832 s · Turbo: 9,439 s
- Ausgabe
- Beides fertiggestellt; MP3, Mono, 44,1 kHz
- Inhaltsprüfung
- Beide automatischen Transkripte stimmen mit der angegebenen Wortfolge überein, ohne zusätzliche Eröffnungsanweisung.
- Nächster Schritt
- Wählen Sie die gewünschte Sprechweise aus, überprüfen Sie die Aussprache mithilfe der Audio-Wiedergabe und synchronisieren Sie die Aufnahme mit dem Bildmaterial.
Die Verbesserung besteht in einer konkreten Übung zum Verfassen von Beiträgen. Was die Natürlichkeit der Stimme und den emotionalen Ausdruck angeht, ist weiterhin ein genaues Hinhören erforderlich; es handelt sich hier nicht um eine Rangliste der Stimmqualität.
Preisgestaltung: Vergleichen Sie den gesamten Arbeitsablauf, nicht nur einen Modellnamen
ElevenLabs verkauft Abonnements mit Guthaben; GlobalGPT bietet einen Abonnement-Arbeitsbereich für verschiedene Modelle. Das sind unterschiedliche Kaufentscheidungen. Ein spezielles Team für die Sprachproduktion benötigt möglicherweise die Sprachtools und Kontofunktionen von ElevenLabs. Ein Creator, der auch Text, Bilder und Videos benötigt, kann mit einem GlobalGPT-Arbeitsbereich einen umfassenderen Workflow abdecken.
| ElevenLabs-Plan | Regulärer Monatspreis | Monatliche Gutschriften |
|---|---|---|
| Kostenlos | $0 | 10,000 |
| Vorspeise | $6 | 30,000 |
| Schöpfer | $22 | 121,000 |
| Pro | $99 | 600,000 |
| Maßstab | $299 | 1,800,000 |
Quelle: Preise für ElevenLabs, Stand: 13. Oktober 2026; ohne Steuern. Angebote für den ersten Monat und Rabatte bei jährlicher Abrechnung gelten unabhängig von diesen regulären monatlichen Preisen. Die Kreditnutzung hängt vom jeweiligen Produkt und Modell ab.
Rechnen Sie die Gesamtanzahl der Credits eines Tarifs nicht direkt in einen v4-Turbo-Dollar-Satz um, ohne den entsprechenden Credit-Multiplikator zu berücksichtigen. In den FAQ zur Preisgestaltung wird für Modelle höchster Qualität ein Zeichen pro Credit und als Richtwert etwa 1.000 Zeichen pro Minute angegeben. Ihre tatsächliche Dauer hängt von der Sprache, dem Sprechtempo und dem Skript ab. Die modellspezifische Nutzung und etwaige Zusatzguthaben-Sätze müssen mit dem ausgewählten Tarif übereinstimmen.
Ein realistisches Budget für Sprachaufnahmen umfasst auch Überarbeitungen. Bei einem Skript mit 1.200 Zeichen ergeben drei vollständige Aufnahmen 3.600 generierte Zeichen, bevor Sie kürzere Nachaufnahmen machen. Eine vorherige Überarbeitung des Skripts kann mehr Arbeit sparen als die wiederholte Neugenerierung eines schwachen Entwurfs. In GlobalGPT, können Sie dieses Skript mithilfe eines Schreibmodells verfeinern und anschließend im selben Arbeitsbereich mit der Audio- und Videoproduktion fortfahren.
API-Routen, Sprachanzahl und Längenbeschränkungen
Wenn Sie eine Anwendung entwickeln, beginnen Sie mit dem Übertragungsweg. Der REST-Endpunkt „Text to Dialogue“ akzeptiert ein Eingabe-Array, das Text- und Sprach-IDs enthält, und gibt Audiodaten zurück. Der Echtzeit-WebSocket „Text to Dialogue“ nimmt eingehenden Text entgegen und gibt Audio-Chunks aus. Ein Modellname allein reicht nicht aus, um einer Nicht-Streaming-Anwendung ein Live-Gefühl zu verleihen.
- Fertiger Dialog: Der REST-Leitfaden unterstützt bis zu 10 eindeutige Sprach-IDs. In den Endpunkt-Richtlinien wird empfohlen, die Gesamtlänge des eingegebenen Textes pro Anfrage auf maximal 2.000 Zeichen zu beschränken.
- Realtime Turbo: Der Echtzeit-Guide registriert genau eine Stimme. Die Generierung beginnt nach einem Textpuffer von etwa 40 Zeichen und acht Wörtern; eine Flush-Meldung kann ein kürzeres Segment auslösen.
- Langfassung v4: In der Modelltabelle ist eine Obergrenze von 10.000 Zeichen angegeben, was etwa zehn Minuten entspricht. Dieser Wert auf Modellebene sollte jedoch keine geringere Empfehlung für einen bestimmten Endpunkt außer Kraft setzen.
- Live-Interaktion: Der Verbindungsaufbau, die Netzwerkübertragung, die Textpufferung und der Audio-Player beeinflussen alle die wahrgenommene Latenz.
Verwenden Sie die REST-Dialog-Referenz für eine fertige mehrstimmige Datei und die Anleitung für den Echtzeit-Dialog für den Turbo-Streaming-Pfad. Passen Sie die Modellunterstützung und die Spracheinstellungen an den Endpunkt an, bevor Sie einen Batch skalieren. Bei der Arbeit als Creator können Sie sich dank des Audio-Workflows von GlobalGPT auf das Skript und das fertige Asset konzentrieren, anstatt einen Streaming-Client zu entwickeln.
Ein praktischer Workflow für Voiceover in GlobalGPT
Beginnen Sie mit dem Endergebnis: einem 15-Sekunden-Werbespot, einem einminütigen Erklärvideo oder einem Sprecherbeitrag. Verfassen Sie den Sprechtext so, dass er zu dieser Dauer passt, bevor Sie das Sprachmodell bitten, ihn vorzutragen. Ein prägnantes Skript lässt sich leichter vergleichen, überarbeiten und synchronisieren als ein langer erster Entwurf.
- Entwerfen Sie das Skript in GlobalGPT. Geben Sie die Zielgruppe, die angestrebte Dauer, Hinweise zur Aussprache und einen klaren Aufruf zum Handeln an.
- Wählen Sie das in Ihrem Arbeitsbereich verfügbare Audiomodell und die Spracheinstellungen aus. Überprüfen Sie die angezeigten Generierungskosten, bevor Sie den Auftrag absenden.
- Nehmen Sie eine kurze erste Aufnahme auf. Achten Sie dabei auf fehlende Wörter, ungewollte gesprochene Anweisungen, Namen, das Sprechtempo und den Schluss.
- Überarbeiten Sie den schwächsten Satz, anstatt alle Anweisungen auf einmal zu ändern. Bewahren Sie die genehmigte Fassung zum Vergleich auf.
- Laden Sie die ausgewählte Audiodatei herunter und fügen Sie sie in Ihre Bildmaterialien ein. Falls die Kampagne mehrere miteinander verknüpfte Elemente erfordert, GlobalGPT Leinwand trägt dazu bei, den gesamten kreativen Arbeitsablauf zu organisieren.
Welches sollten Sie wählen?
Für eine ausgefeilte Sprachaufnahme, die Sie anschließend überprüfen und bearbeiten können, beginnen Sie mit Eleven v4. Der offizielle Schwerpunkt liegt auf Erzählung, Charakterentwicklung und ausdrucksstarken, fertigen Inhalten. Wenn Sie einen Assistenten suchen, der im Verlauf eines Gesprächs mitredet, beginnen Sie mit v4 Turbo und testen Sie es über den Streaming-Weg, den Ihre Anwendung tatsächlich nutzen wird.
Für einen Kreativen, der ein komplettes Werk erstellt, ist oft der Workflow die bessere Wahl, mit dem Drehbuch, Vertonung und Bildmaterial gemeinsam fertiggestellt werden können. Probieren Sie den Audio-Workflow in GlobalGPT aus, fangen Sie mit einem kurzen Skript an und wählen Sie die endgültige Aufnahme aus, indem Sie sie in dem Kontext anhören, in dem sie verwendet werden soll.
Häufig gestellte Fragen
Ist Eleven v4 besser als v4 Turbo?
Eleven v4 ist der ideale Ausgangspunkt für ausdrucksstarke, fertige Sprachaufnahmen. v4 Turbo legt den Schwerpunkt auf reaktionsschnelle Echtzeit-Sprache. Entscheiden Sie sich je nachdem, ob Sie eine überarbeitete Audiodatei oder ein Live-Gespräch benötigen, und testen Sie anschließend Ihr Skript und Ihre Stimme.
Wie schnell ist Eleven v4 Turbo?
ElevenLabs gibt in seiner Modelldokumentation eine mittlere Inferenzlatenz von etwa 100 ms und in seinem Einführungsbericht eine mittlere Zeit bis zur ersten Sprachausgabe von etwa 150 ms an. Dabei handelt es sich um unterschiedliche Messungen. Netzwerk, Pufferung und Wiedergabe tragen zusätzlich zu der Verzögerung bei, die ein Nutzer wahrnimmt.
Unterstützen beide Modelle dieselben Sprachen?
In ElevenLabs wird beschrieben, dass die v4-Familie mehr als 90 Sprachen unterstützt. Testen Sie die Namen, die Aussprache und die Sprachausgabe in der jeweiligen Sprache, in der Sie veröffentlichen möchten.
Kann v4 Turbo Dialoge mit mehreren Sprechern erstellen?
Überprüfen Sie die Schnittstelle, anstatt sich allein auf die Beschreibung der Familie zu verlassen. Der „Realtime v4 Turbo“-Leitfaden registriert genau eine Stimme, während die REST-Dialogreferenz bis zu zehn eindeutige Stimmen-IDs akzeptiert. Sprecherangaben innerhalb einer einfachen Eingabeaufforderung sind nicht gleichbedeutend mit einer expliziten Stimmenzuweisung.
Gibt es eine kostenlose Möglichkeit, ElevenLabs auszuprobieren?
ElevenLabs bietet einen kostenlosen Tarif mit 10.000 Credits pro Monat an. Der Zugriff auf Modelle, die Nutzungsbedingungen und die kommerziellen Rechte hängen vom jeweiligen Tarif ab. Ein kostenloses Credit-Guthaben ist keine Garantie dafür, dass alle v4-Funktionen enthalten sind.
Kann ich GlobalGPT für den gesamten Workflow bei der Vertonung von Videos verwenden?
Ja. GlobalGPT vereint Text-, Audio-, Bild- und Videomodelle in einem einzigen Abonnement-Arbeitsbereich, sodass Sie das Skript und die dazugehörigen Elemente gemeinsam entwickeln können. Überprüfen Sie vor der Veröffentlichung den ausgewählten Sprechertext und Ihren endgültigen Schnitt.