เลือก Eleven v4 สำหรับการบรรยายที่เสร็จสมบูรณ์; เลือก Eleven v4 Turbo เมื่อต้องการให้เสียงตอบสนองตามการสนทนาที่กำลังดำเนินไป. ทั้งสองล้วนเป็นส่วนหนึ่งของตระกูล v4 ที่มีความสามารถในการแสดงออกของ ElevenLabs จุดแตกต่างที่สำคัญคือกระบวนการส่งมอบ: ไฟล์เสียงที่ผ่านการปรับแต่งอย่างละเอียดสำหรับวิดีโอหรือหนังสือเสียง เทียบกับเสียงที่สตรีมแบบเรียลไทม์สำหรับผู้ช่วยอัจฉริยะ ซึ่งไม่สามารถทำให้ผู้ฟังต้องรอได้.
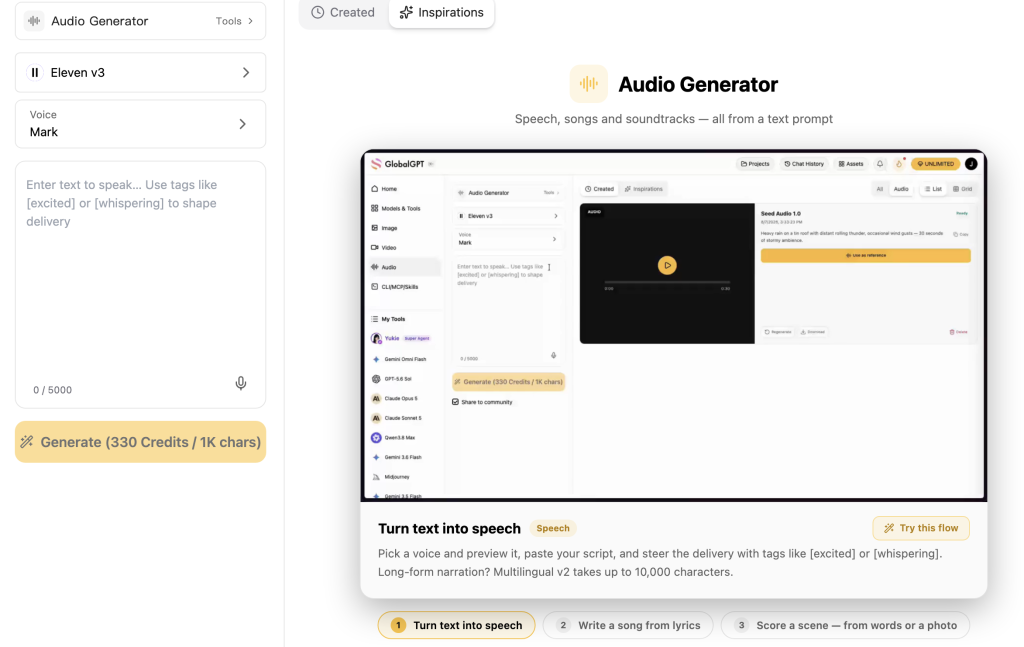
สำหรับผู้สร้างเนื้อหาที่ไม่จำกัดเพียงเสียงเท่านั้น, โกลบอลจีพีที นำการสร้างเสียงเข้ามาในพื้นที่ทำงานแบบสมัครสมาชิกเดียวกันกับงานเขียนบท ภาพ และวิดีโอ ซึ่งทำให้มันเป็นจุดเริ่มต้นที่ใช้งานได้จริงและราคาไม่แพงสำหรับแคมเปญที่ครบถ้วน เราได้สร้างคำสั่งเริ่มต้นสองข้อและบทติดตามที่ชัดเจนขึ้นด้วยแต่ละโมเดลใน GlobalGPT ไฟล์เสียงหกไฟล์ด้านล่างนี้แสดงทั้งข้อผิดพลาดทั่วไปในการให้คำสั่งและวิธีแก้ไขที่ใช้งานได้จริง.
Eleven v4 vs v4 Turbo: เปรียบเทียบแบบสรุป
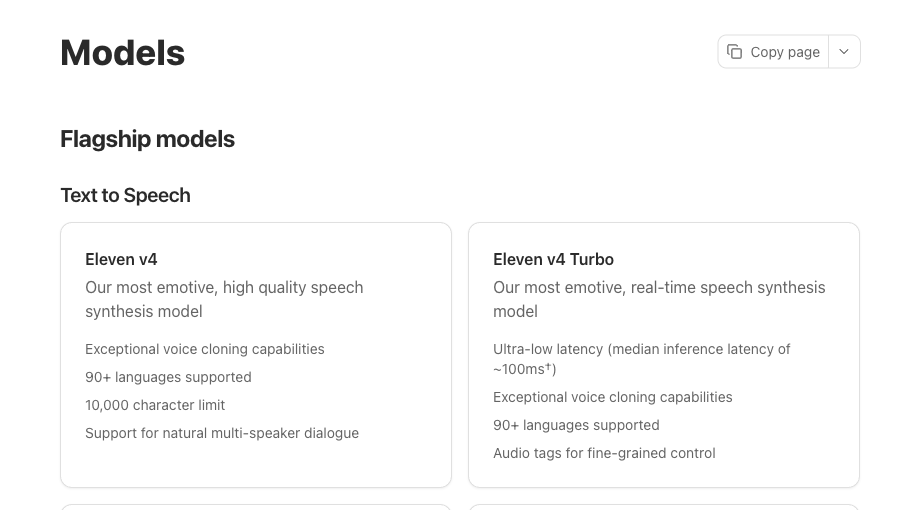
ElevenLabs เน้น v4 ที่ความอุดมสมบูรณ์ทางอารมณ์และคุณภาพเนื้อหาที่สมบูรณ์ ส่วน v4 Turbo เน้นการพูดแบบเรียลไทม์ที่แสดงออกได้อย่างชัดเจน Turbo ไม่ใช่เพียงคำสัญญาว่าไฟล์ MP3 ทุกไฟล์ที่ดาวน์โหลดมาจะถึงมือผู้ใช้เร็วขึ้นเท่านั้น แต่เพื่อจะได้รับประโยชน์จากการสตรีมมิ่ง แอปพลิเคชันต้องส่งและเล่นเสียงเป็นชิ้นๆ ได้จริง.
| การตัดสินใจ | Eleven v4 | Eleven v4 Turbo |
|---|---|---|
| การสวมใส่หลัก | การบรรยาย, หนังสือเสียง, เนื้อหาที่เสร็จสมบูรณ์และมีการแสดงออกอย่างชัดเจน | เสียงสนทนาแบบเรียลไทม์ |
| รหัสแบบอย่างเป็นทางการ | eleven_v4 | eleven_v4_turbo |
| การสนับสนุนด้านภาษาในครอบครัว | กว่า 90 ภาษา | กว่า 90 ภาษา |
| ทิศทางการจัดส่ง | คำสั่งด้วยภาษาธรรมชาติและแท็กแสดงผลในตัวข้อความ | การส่งข้อมูลแบบมีข้อมูลเพิ่มเติมในกระบวนการสตรีมมิ่ง |
| เส้นทาง API ที่ต้องตรวจสอบ | REST: แปลงข้อความเป็นบทสนทนา | WebSocket สำหรับแปลงข้อความเป็นบทสนทนาแบบเรียลไทม์ |
| การแยกแยะระหว่างเสียงและจำนวนในระบบแนะนำการสนทนาปัจจุบัน | รองรับเสียงที่ไม่ซ้ำกันสูงสุด 10 เสียงในการป้อนข้อมูลแบบสนทนาผ่าน REST | มีเสียงที่ลงทะเบียนไว้เพียงหนึ่งเสียงเท่านั้นในคู่มือแบบเรียลไทม์ |
| ค่าความล่าช้าที่เผยแพร่ | ไม่มีตัวเลขที่เทียบเคียงได้ที่ใช้ในที่นี้ | เวลาการวิเคราะห์ค่ามัธยฐานประมาณ 100 มิลลิวินาที; เวลาค่ามัธยฐานจนถึงเสียงพูดครั้งแรกในรายงานการเปิดตัวประมาณ 150 มิลลิวินาที |
เอกสารอย่างเป็นทางการและข้อมูลการเปิดตัวได้รับการตรวจสอบเมื่อวันที่ 13 ตุลาคม 2026 การสนับสนุนภาษาเป็นข้อกำหนดของตระกูลผลิตภัณฑ์ ส่วนจำนวนเสียงขึ้นอยู่กับเส้นทาง API.
คุณภาพเสียง อารมณ์ และการสนับสนุนภาษา
สำหรับเรื่องราวที่บันทึกไว้ เสียงมีเวลาที่จะปรับตัวให้เข้ากับประโยค: การหยุดพัก การเน้นย้ำ และการเปลี่ยนแปลงทางอารมณ์ อาจมีความสำคัญมากกว่าความล่าช้าในการสร้างเสียงเพียงเล็กน้อย นั่นคือหน้าที่ที่ ElevenLabs มอบหมายให้ v4 ส่วนเอเจนต์สนทนา มีข้อจำกัดที่ต่างออกไป แม้คำตอบที่น่าเชื่อถือก็อาจรู้สึกไม่ธรรมชาติหากเริ่มช้าเกินไป ดังนั้น Turbo จึงเน้นการผลิตคำพูดที่แสดงอารมณ์ได้อย่างรวดเร็ว.
การเปิดตัวเวอร์ชัน v4 นำมาซึ่งคำแนะนำการส่งเสียงด้วยภาษาธรรมชาติ และแท็กในบรรทัดสำหรับการแสดงออกทางเสียงและเสียงต่างๆ คำแนะนำเช่นการเริ่มต้นด้วยน้ำเสียงที่สงบ ตามด้วยประโยคสุดท้ายที่เต็มไปด้วยความตื่นเต้น จะมีประโยชน์มากกว่าการขอให้ใช้เสียงที่ “ดีกว่า” อย่างคลุมเครือ ให้แยกบทพูดและคำแนะนำการแสดงออกให้ชัดเจนทุกครั้งที่อินเทอร์เฟซมีช่องกรอกข้อมูลแยกกัน มิฉะนั้น ช่องข้อความธรรมดาอาจทำให้คำสั่งกลายเป็นคำพูดได้.
- สำหรับคำบรรยายผลิตภัณฑ์: ประเมินชื่อผลิตภัณฑ์ หยุดชั่วคราวเมื่อกล่าวถึงจุดเด่นหลัก และตรวจสอบว่าประโยคสุดท้ายฟังดูเป็นธรรมชาติหรือไม่.
- สำหรับฉากที่มีตัวละคร: ใช้เส้นทางที่มีการกำหนดเสียงอย่างชัดเจน; การระบุชื่อผู้พูดในข้อความแจ้งเตือนเพียงอย่างเดียว ไม่รับประกันว่าจะมีเสียงที่แยกกัน.
- สำหรับการแปลภาษาท้องถิ่น: ทั้งสองรุ่นรองรับภาษาได้มากกว่า 90 ภาษา แต่ควรทดสอบภาษาที่ถูกต้อง สำเนียง ชื่อ และคำย่อในสคริปต์ของคุณ.
- สำหรับเสียงที่คัดลอก: ใช้เสียงของคุณเองหรือเสียงที่ได้รับอนุญาตให้ใช้ซ้ำ และยืนยันบัญชีที่เกี่ยวข้องและสิทธิ์การเข้าถึงการคัดลอกเสียง.
ชุดผลิตภัณฑ์นี้มีความสามารถในการคัดลอกเสียง แต่การสนับสนุนของโมเดลนั้นแตกต่างจากสิทธิ์ในการใช้เครื่องมือคัดลอกเสียงเฉพาะที่รวมอยู่ในแพ็กเกจสมัครสมาชิก ให้เลือกเสียงและวิธีการเข้าถึงก่อน แล้วจึงเปรียบเทียบวิธีการให้บริการ หากคุณกำลังใช้โมเดลการบรรยายรุ่นเก่าอยู่แล้ว บริการของเรา รีวิว Eleven Multilingual v2 เป็นจุดอ้างอิงอีกหนึ่งสำหรับการตัดสินใจเรื่องการย้ายถิ่นฐาน.
ความหมายของคำว่า “เร็วขึ้น” สำหรับ v4 Turbo
เอกสารอธิบายแบบจำลองได้อ้างอิงไว้โดยประมาณว่า ค่ามัธยฐานของความล่าช้าในการอนุมาน 100 มิลลิวินาที สำหรับ v4 Turbo. โพสต์ประกาศเปิดตัวระบุว่าโดยประมาณ เวลา median 150 ms จนถึงเสียงพูดครั้งแรก. สิ่งเหล่านี้อธิบายส่วนต่าง ๆ ของกระบวนการประมวลผลเสียง และไม่มีส่วนใดที่รับประกันได้ว่าไฟล์เสียงบรรยายที่สมบูรณ์จะดาวน์โหลดได้ภายในเวลาเพียงเศษส่วนของวินาที.
ตัวอย่าง GlobalGPT ของเราวัดเวลาที่ใช้ในการเสร็จสิ้นงานทั้งหมด รวมถึงเวลารอไฟล์ที่สร้างขึ้น แต่ไม่วัดความล่าช้าของเสียงครั้งแรกหรือการสนทนาผ่าน WebSocket ผลลัพธ์แสดงให้เห็นว่าทำไมการทดสอบการสร้างไฟล์เพียงอย่างเดียวจึงเป็นวิธีที่ไม่เหมาะสมในการจัดอันดับความตอบสนองในการสนทนา: Turbo ไม่ใช่งานที่เสร็จสิ้นเร็วกว่าในคู่ต้นฉบับทั้งสอง แต่กลับเสร็จสิ้นงานติดตามผลด้วยสคริปต์ที่สะอาดได้เร็วกว่า ความแตกต่างนี้ในสามคู่ขนาดเล็กไม่ถือเป็นอันดับความเร็วที่เสถียร.
ตัวอย่างเสียง GlobalGPT 6 ตัวอย่าง: การบันทึกครั้งแรกและวิธีแก้ไขในทางปฏิบัติ
เราได้ส่งคำสั่งเริ่มต้นสองชุดไปยังแต่ละโมเดลครั้งเดียวเมื่อวันที่ 13 ตุลาคม 2026 จากนั้นได้เพิ่มคู่สคริปต์ที่ผ่านการตรวจสอบแล้วหนึ่งคู่ หลังจากตรวจสอบข้อความที่พูดออกมาแล้ว คำขอทั้งหกชุดล้วนให้ผลลัพธ์เป็นไฟล์ MP3 ที่สามารถเล่นได้; ไม่มีเทคใดที่ถูกแทนที่ด้วยการบันทึกใหม่ คำสั่งในคู่แต่ละคู่ตรงกัน แต่ ID เสียงที่ใช้ร่วมกันไม่ได้ถูกล็อกไว้ เราได้ตรวจสอบระยะเวลาของไฟล์และใช้ระบบถอดเสียงอัตโนมัติในเครื่องเพื่อเปรียบเทียบคำที่พูด ซึ่งการตรวจสอบนี้มุ่งเน้นที่เนื้อหา ไม่ใช่ความธรรมชาติหรือคุณภาพทางอารมณ์.
ตัวอย่าง 1: คำแนะนำผลิตภัณฑ์สั้นๆ
คำสั่งแรกได้ผสมผสานทิศทางการส่งเสียงกับบทโฆษณาเข้าด้วยกัน ทั้งสองฉบับของบทบันทึกเสียงล้วนมีคำสั่งเปิดต้นเรื่องว่า “อ่านคำแนะนำผลิตภัณฑ์สั้นๆ นี้ด้วยน้ำเสียงที่สงบในส่วนต้น และประโยคสุดท้ายที่เต็มไปด้วยความตื่นเต้น” ซึ่งทำให้การบันทึกเสียงครั้งแรกเหล่านี้ไม่เหมาะสมที่จะใช้เป็นโฆษณาที่เสร็จสมบูรณ์ ในช่องข้อความพูดธรรมดา ให้เขียนคำที่คุณต้องการให้พูด; ส่วนคำแนะนำเกี่ยวกับการแสดงให้ใส่ไว้ในช่องควบคุมหรือช่องทิศทางที่รองรับ.
ตัวอย่าง 2: ฉากสั้นที่มีทิศทาง
คำสั่งที่สองรวมถึงคำแนะนำสำหรับผู้พูดและสัญญาณให้หัวเราะ ทั้งสองบทสนทนาต่างมีข้อความว่า “ผู้พูดที่หนึ่ง, ด้วยน้ำเสียงอบอุ่น” และ “ผู้พูดที่สอง, ด้วยความมั่นใจอย่างสงบ” การเขียนคำอธิบายเหล่านั้นลงในคำสั่งแบบข้อความธรรมดาไม่ได้สร้างฉากตัวละครที่ชัดเจน สำหรับบทสนทนาในผลงานโปรดใช้ส่วนติดต่อผู้ใช้ที่มีการสนับสนุน พร้อมกับการกำหนดเสียงที่ชัดเจน และแยกบทพูดออกจากคำแนะนำบนเวที.
ตัวอย่างที่ 3: เก็บไว้เฉพาะคำที่คุณต้องการให้พูด
ในการทดสอบครั้งต่อไป เราได้ลบส่วนที่ระบุทิศทางการเปิดออก และส่งเพียงสคริปต์โฆษณาเท่านั้น ทั้งสองระบบสร้างข้อความอัตโนมัติได้ตรงกับคำในสคริปต์ตามลำดับ โดยไม่มีคำสั่งที่ไม่ต้องการ ไฟล์ที่ได้มีความยาวประมาณ 11 วินาที ซึ่งถือเป็นจุดเริ่มต้นที่มีประโยชน์มากขึ้นสำหรับวิดีโอผลิตภัณฑ์สั้นๆ.
ข้อมูลต้นทางที่สะอาดขึ้นจะให้ผลลัพธ์เป็นบทพูดที่ใช้งานได้
ยินดีต้อนรับสู่ Acorn Studio เริ่มต้นด้วยแผนที่ชัดเจน แล้วสร้างร่างแรกที่มีประโยชน์ วันนี้ ความคิดของคุณสามารถเปลี่ยนจากหน้ากระดาษว่างเปล่าเป็นผลงานที่สมบูรณ์แบบได้.
- เจเนอเรชั่น
- GlobalGPT · 13 ตุลาคม 2026 · หนึ่งการติดตามต่อแต่ละโมเดล, การตั้งค่าเสียงตามค่าเริ่มต้น
- ระยะเวลาการดำเนินการจนเสร็จสิ้นงาน
- v4: 15.832 วินาที · Turbo: 9.439 วินาที
- ผลลัพธ์
- ทั้งสองไฟล์เสร็จแล้ว; MP3, โมโน, 44.1 kHz
- ตรวจสอบเนื้อหา
- ทั้งสองข้อความถอดเสียงอัตโนมัติตรงกับลำดับคำที่ให้มา โดยไม่มีคำสั่งเปิดเพิ่มเติม.
- ขั้นตอนต่อไป
- เลือกวิธีนำเสนอที่คุณชอบ ตรวจสอบการออกเสียงโดยฟัง และปรับให้คำพูดสอดคล้องกับภาพ.
การปรับปรุงครั้งนี้เป็นบทเรียนการเขียนข้อความด้วยเสียงที่เป็นรูปธรรม ความเป็นธรรมชาติของเสียงและการถ่ายทอดอารมณ์ยังคงต้องอาศัยการฟัง; นี่ไม่ใช่การ xếpอันดับคุณภาพเสียงที่เหมือนกัน.
ราคา: เปรียบเทียบกระบวนการทำงานทั้งหมด ไม่ใช่เพียงชื่อโมเดลเท่านั้น
ElevenLabs ขายแพ็กเกจสมัครสมาชิกที่มาพร้อมเครดิต; GlobalGPT ให้บริการพื้นที่ทำงานแบบสมัครสมาชิกที่รองรับหลายรูปแบบ นี่เป็นการตัดสินใจซื้อที่แตกต่างกัน ทีมผลิตเสียงเฉพาะทางอาจต้องการเครื่องมือเสียงและคุณสมบัติบัญชีของ ElevenLabs ส่วนผู้สร้างเนื้อหาที่ยังต้องการเครื่องมือเขียนข้อความ รูปภาพ และวิดีโอ สามารถจัดการงานได้อย่างครอบคลุมมากขึ้นด้วยพื้นที่ทำงานเดียวของ GlobalGPT.
| แผน ElevenLabs | ราคาปกติรายเดือน | เครดิตรายเดือน |
|---|---|---|
| ฟรี | $0 | 10,000 |
| อาหารเรียกน้ำย่อย | $6 | 30,000 |
| ผู้สร้าง | $22 | 121,000 |
| ข้อดี | $99 | 600,000 |
| ขนาด | $299 | 1,800,000 |
แหล่งที่มา: ราคา ElevenLabs, ตรวจสอบเมื่อวันที่ 13 ตุลาคม 2026; ไม่รวมภาษี ข้อเสนอสำหรับเดือนแรกและส่วนลดสำหรับการชำระรายปีเป็นสิ่งที่แยกต่างหากจากราคาเดือนปกติเหล่านี้ การใช้เครดิตขึ้นอยู่กับผลิตภัณฑ์และรุ่น.
อย่าแปลงจำนวนเครดิตของแผนโดยตรงเป็นอัตราค่าบริการ v4 Turbo ในดอลลาร์ โดยไม่ใช้ตัวคูณเครดิตที่เหมาะสม คำถามที่พบบ่อยเกี่ยวกับราคาอธิบายว่า สำหรับโมเดลคุณภาพสูงสุด จะใช้ 1 ตัวอักษรต่อเครดิต และประมาณ 1,000 ตัวอักษรต่อนาที เป็นค่าประมาณ ระยะเวลาจริงของคุณขึ้นอยู่กับภาษา ความเร็วในการพูด และบทพูด การใช้งานตามแบบจำลองเฉพาะและอัตราเครดิตเพิ่มเติมใด ๆ ต้องสอดคล้องกับแพ็กเกจที่เลือก.
งบประมาณการบันทึกเสียงที่สมจริงยังรวมถึงการแก้ไขด้วย สำหรับบทพูด 1,200 ตัวอักษร การบันทึกเสียงครบ 3 ครั้ง จะให้ผลรวม 3,600 ตัวอักษร ก่อนที่จะมีการบันทึกเพิ่มเติมเพื่อตัดให้สั้นลง การปรับปรุงบทพูดก่อนจะช่วยประหยัดงานได้มากกว่าการสร้างร่างที่ยังไม่ดีซ้ำแล้วซ้ำเล่า ใน โกลบอลจีพีที, คุณสามารถปรับปรุงบทนั้นด้วยโมเดลการเขียน และจากนั้นย้ายไปสู่ขั้นตอนการผลิตเสียงและภาพในพื้นที่ทำงานเดียวกัน.
เส้นทาง API, จำนวนคำพูด และขีดจำกัดความยาว
หากคุณกำลังพัฒนาแอปพลิเคชัน ให้เริ่มจากเส้นทางส่งข้อมูลก่อน จุดปลายทาง REST Text to Dialogue รับอาร์เรย์ข้อมูลเข้าที่ประกอบด้วยข้อความและรหัสเสียง (voice IDs) และส่งเสียงกลับมา ส่วน WebSocket Text to Dialogue แบบเรียลไทม์ รับข้อความที่ส่งเข้ามาและส่งชิ้นส่วนเสียงออกไป ชื่อโมเดลเพียงอย่างเดียวไม่สามารถทำให้แอปพลิเคชันที่ไม่ใช้การสตรีมรู้สึกเหมือนกำลังทำงานแบบเรียลไทม์ได้.
- บทสนทนาที่เสร็จสิ้นแล้ว: คู่มือ REST รองรับได้สูงสุด 10 รหัสเสียงที่ไม่ซ้ำกัน ส่วนคำแนะนำเกี่ยวกับจุดปลายทาง (endpoint) แนะนำให้จำกัดความยาวของข้อความที่ป้อนรวมกันไว้ไม่เกิน 2,000 ตัวอักษรต่อคำขอ.
- Realtime Turbo: คู่มือแบบเรียลไทม์จะบันทึกเสียงเพียงหนึ่งเสียงเท่านั้น การสร้างเสียงจะเริ่มขึ้นหลังจากมีบัฟเฟอร์ข้อความประมาณ 40 ตัวอักษรและ 8 คำ; ข้อความ flush สามารถกระตุ้นให้สร้างส่วนที่สั้นกว่าได้.
- เวอร์ชันยาว v4: ตารางแบบจำลองระบุว่ามีขีดจำกัด 10,000 ตัวอักษร ซึ่งประมาณ 10 นาที ตัวเลขระดับแบบจำลองนี้ไม่ควรมีผลเหนือกว่าคำแนะนำที่มีค่าต่ำกว่าสำหรับจุดปลายทางเฉพาะ.
- การโต้ตอบแบบเรียลไทม์: การตั้งค่าการเชื่อมต่อ การเคลื่อนที่ในเครือข่าย การบัฟเฟอร์ข้อความ และเครื่องเล่นเสียง ล้วนส่งผลต่อความล่าช้าที่ผู้ใช้รู้สึกได้.
ใช้ คู่มือการสนทนา REST สำหรับไฟล์หลายเสียงที่เสร็จสมบูรณ์และ คู่มือการสนทนาแบบเรียลไทม์ สำหรับเส้นทางสตรีมมิ่ง Turbo ให้ปรับการสนับสนุนโมเดลและการตั้งค่าเสียงให้สอดคล้องกับจุดปลายทางก่อนที่จะขยายขนาดชุดงาน สำหรับงานของผู้สร้างเนื้อหา กระบวนการทำงานด้านเสียงของ GlobalGPT ช่วยให้คุณมุ่งเน้นไปที่บทสนทนาและสินทรัพย์ที่เสร็จสมบูรณ์ แทนที่จะต้องสร้างไคลเอนต์สตรีมมิ่ง.
ขั้นตอนการทำงานเสียงบรรยายที่ใช้งานได้จริงใน GlobalGPT
เริ่มจากผลลัพธ์ที่ต้องการ: โฆษณา 15 วินาที, วิดีโออธิบาย 1 นาที หรือส่วนบรรยาย เขียนบทพูดให้เหมาะสมกับระยะเวลาดังกล่าว ก่อนที่จะขอให้โมเดลเสียงแสดงบทนั้น บทพูดที่สั้นกระชับจะง่ายต่อการเปรียบเทียบ แก้ไข และปรับให้สอดคล้องกันมากกว่าการเขียนบทแรกที่ยาวเกินไป.
- เขียนบทใน GlobalGPT โดยระบุกลุ่มผู้ชม ระยะเวลาเป้าหมาย คำแนะนำการออกเสียง และคำเรียกร้องให้ดำเนินการที่ชัดเจนหนึ่งข้อ.
- เลือกแบบเสียงและตั้งค่าเสียงที่มีอยู่ในพื้นที่ทำงานของคุณ ตรวจสอบค่าใช้จ่ายในการสร้างที่แสดงขึ้นก่อนที่จะส่ง.
- สร้างเวอร์ชันแรกที่สั้นๆ ฟังดูว่ามีคำที่ขาดไป คำแนะนำที่ไม่จำเป็น ชื่อ จังหวะการพูด และส่วนท้ายหรือไม่.
- ควรแก้ไขประโยคที่อ่อนที่สุดก่อน แทนที่จะเปลี่ยนทุกคำสั่งพร้อมกัน เก็บเวอร์ชันที่ได้รับการอนุมัติไว้เพื่อเปรียบเทียบ.
- ดาวน์โหลดไฟล์เสียงที่เลือกไว้และนำมารวมกับภาพของคุณ หากแคมเปญนี้ต้องการทรัพยากรหลายชิ้นที่เชื่อมโยงกัน, GlobalGPT แคนวาส ช่วยจัดระเบียบกระบวนการทำงานด้านสร้างสรรค์โดยรวม.
คุณควรเลือกอันไหน?
หากต้องการเสียงบรรยายที่สมบูรณ์แบบ ซึ่งคุณจะได้ตรวจสอบและแก้ไข ให้เริ่มด้วย Eleven v4. จุดเน้นอย่างเป็นทางการของระบบนี้อยู่ที่การเล่าเรื่อง การพัฒนาตัวละคร และเนื้อหาที่เสร็จสมบูรณ์และแสดงออกได้อย่างชัดเจน สำหรับผู้ช่วยที่พูดไปพร้อมกับการพัฒนาบทสนทนา ให้เริ่มด้วย v4 Turbo และทดสอบมันผ่านช่องทางสตรีมมิ่งที่แอปพลิเคชันของคุณจะใช้จริง.
สำหรับผู้สร้างเนื้อหาที่พัฒนาเนื้อหาทั้งชิ้น การเลือกซื้อระบบที่ช่วยให้สามารถเสร็จสิ้นบทพูด เสียง และภาพพร้อมกัน มักจะเป็นตัวเลือกที่ดีกว่า. ลองใช้กระบวนการทำงานด้านเสียงใน GlobalGPT, เริ่มด้วยบทพูดสั้นๆ แล้วเลือกฉากสุดท้ายโดยฟังในบริบทที่จะนำไปใช้.
คำถามที่พบบ่อย
Eleven v4 ดีกว่า v4 Turbo หรือไม่?
Eleven v4 เป็นจุดเริ่มต้นที่เหมาะสมที่สุดสำหรับการสร้างเสียงบรรยายที่สมบูรณ์และเต็มไปด้วยอารมณ์ ส่วน v4 Turbo เน้นการตอบสนองเสียงแบบเรียลไทม์อย่างรวดเร็ว ให้เลือกตามความต้องการของคุณว่าต้องการไฟล์เสียงที่ผ่านการตรวจสอบแล้วหรือการสนทนาแบบสด จากนั้นลองทดสอบบทพูดและเสียงของคุณ.
Eleven v4 Turbo เร็วแค่ไหน?
ElevenLabs ระบุในเอกสารอธิบายโมเดลว่าค่าความล่าช้าในการอนุมานมีค่ามัธยฐานประมาณ 100 ms และในรายงานการเปิดตัวระบุว่าเวลาจนถึงเสียงแรกมีค่ามัธยฐานประมาณ 150 ms นี่เป็นการวัดค่าที่แตกต่างกัน การส่งข้อมูลผ่านเครือข่าย การบัฟเฟอร์ และการเล่นเสียง ล้วนเพิ่มเข้าไปในความล่าช้าที่ผู้ใช้ได้รับ.
ทั้งสองรุ่นนี้รองรับภาษาเดียวกันหรือไม่?
ElevenLabs ระบุว่าตระกูล v4 รองรับภาษามากกว่า 90 ภาษา โปรดทดสอบชื่อ คำเน้นเสียง และวิธีการพูดในภาษาที่คุณวางแผนจะเผยแพร่.
v4 Turbo สามารถสร้างบทสนทนาที่มีหลายตัวละครได้หรือไม่?
ควรตรวจสอบอินเทอร์เฟซแทนที่จะพึ่งพาคำอธิบายของตระกูลเพียงอย่างเดียว คู่มือ Real-time v4 Turbo กำหนดให้ใช้เสียงเพียงหนึ่งเสียงเท่านั้น ในขณะที่เอกสารอ้างอิง REST สำหรับการสนทนาสามารถรับได้สูงสุดถึงสิบ ID เสียงที่ไม่ซ้ำกัน การระบุทิศทางของผู้พูดภายในคำสั่งแบบธรรมดาไม่เท่ากับการกำหนดเสียงอย่างชัดเจน.
มีวิธีใดที่สามารถทดลองใช้ ElevenLabs ได้ฟรีหรือไม่?
ElevenLabs มีแพ็กเกจฟรีที่ให้เครดิต 10,000 เครดิตต่อเดือน การเข้าถึงโมเดล กฎการใช้งาน และสิทธิทางการค้าขึ้นอยู่กับแพ็กเกจที่ใช้อยู่ ยอดเครดิตฟรีไม่รับประกันว่าทุกคุณสมบัติของ v4 จะถูกรวมอยู่ด้วย.
ผมสามารถใช้ GlobalGPT สำหรับกระบวนการบันทึกเสียงบรรยายวิดีโอทั้งหมดได้หรือไม่?
ใช่ครับ GlobalGPT รวมโมเดลการเขียน ข้อความเสียง ภาพ และวิดีโอไว้ในพื้นที่ทำงานแบบสมัครสมาชิกเดียว ทำให้คุณสามารถพัฒนาบทและทรัพยากรสนับสนุนได้พร้อมกัน ตรวจสอบเสียงบรรยายที่เลือกไว้และฉบับแก้ไขสุดท้ายก่อนเผยแพร่.