A página atual da API do OpenAI indica que, para o contexto curto, o GPT-5.6 Sol é de $4 por milhão de tokens de entrada e de $20 por milhão de tokens de saída. As taxas de contexto longo são $8/M na entrada e $30/M na saída. A entrada em cache é de $0,40/M no contexto curto ou $0,80/M no contexto longo, e as gravações em cache são de $5/M ou $10/M, respectivamente.
A mesma página indica o GPT-5.6 Cyber com entrada de $12,50/M e saída de $75/M, para contextualização breve. O OpenAI informa que o preço promocional do GPT-5.6 Sol estará disponível pelo menos até 21 de novembro de 2026. Essas são tarifas da API; um plano ChatGPT ou crédito Codex é uma compra diferente.
Para trabalhos interativos que envolvam modelos, programação e funções criativas, GlobalGPT oferece a você um espaço de trabalho por assinatura voltado para a tarefa. A questão relevante é se você precisa de uma chamada de produção com cobrança por uso, um fluxo de trabalho para desenvolvedores ou um ambiente de menor custo para comparar e concluir o trabalho antes de comprometer o orçamento da API.
- Visão geral dos preços do GPT-5.6
- Taxas do Sol e da Cyber API para GPT-5.6
- Estimativas do token GPT-5.6 já trabalhadas
- Entrada armazenada em cache e contexto extenso
- Os planos ChatGPT e os créditos do Codex são diferentes dos preços da API
- Escolhendo uma API, uma CLI ou um espaço de trabalho multimodelo
- O acesso ao plano ChatGPT é um orçamento separado
- Escolha o caminho modelo para realizar a tarefa
- Um teste repetível de uso de tokens
- Quando vale a pena arcar com os custos adicionais da API para fazer uma atualização
- Da chamada de API até um fluxo de trabalho completo para desenvolvedores
- PERGUNTAS FREQUENTES
Visão geral dos preços do GPT-5.6
| Modelo / modo | Entrada curta | Saída curta | Texto longo | Saída longa |
|---|---|---|---|---|
| GPT-5.6 Sol | $4.00/M | $20,00/M | $8.00/M | $30,00/M |
| GPT-5.6 Cyber | $12,50/M | $75,00/M | — | — |
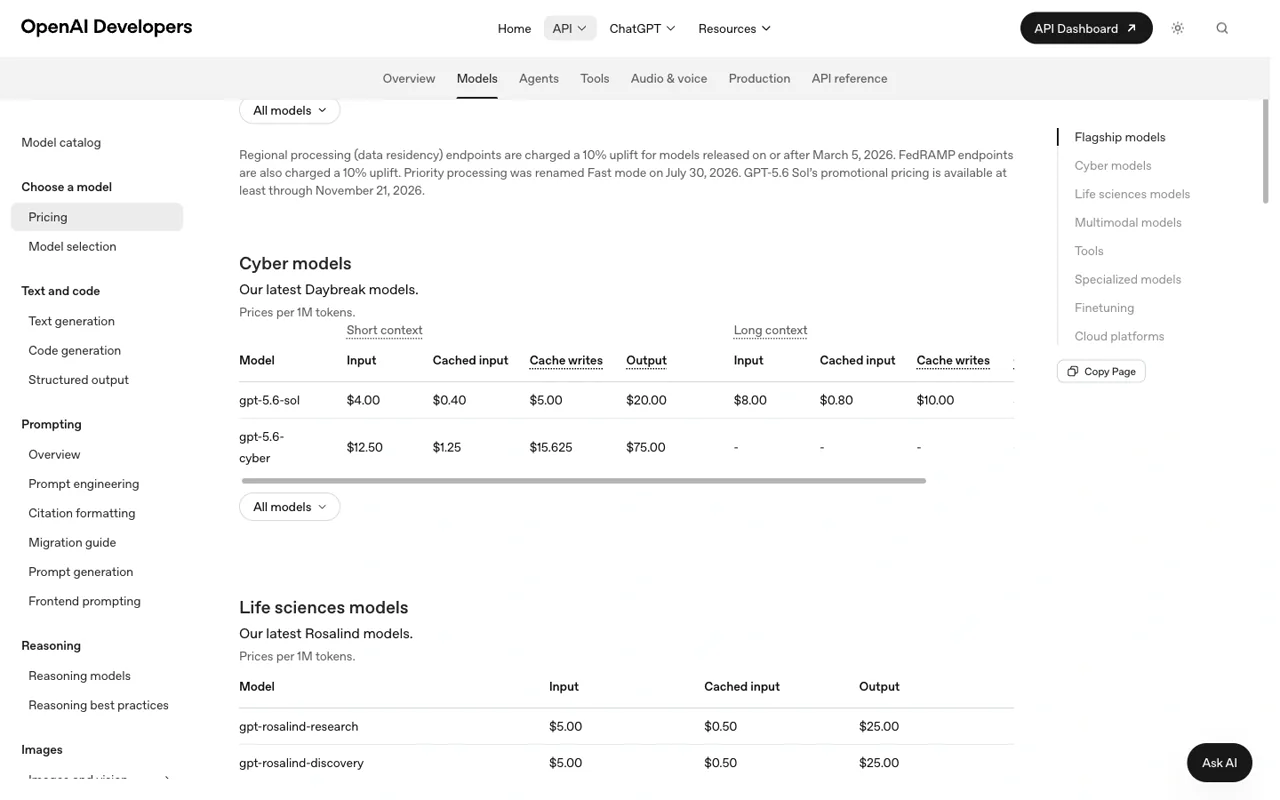
Leia a tabela de tarifas por unidade de cobrança: entrada, entrada em cache, gravações em cache e saída são linhas separadas, enquanto as solicitações de contexto longo utilizam um nível diferente.
As entradas em cache e as gravações em cache têm suas próprias taxas. A página da API do OpenAI também distingue as colunas “Standard”, “Batch” e “Flex”; escolha um modo que sua aplicação possa realmente utilizar antes de aplicar um desconto a uma previsão.
Taxas do Sol e da Cyber API para GPT-5.6
| Taxa por 1 milhão de tokens | GPT-5.6 Venda a descoberto | GPT-5.6 Posição comprada na Sol | GPT-5.6 Calça curta Cyber |
|---|---|---|---|
| Entrada | $4.00 | $8.00 | $12.50 |
| Entrada em cache | $0.40 | $0.80 | $1.25 |
| Gravações no cache | $5.00 | $10.00 | $15.625 |
| Saída | $20.00 | $30.00 | $75.00 |
O GPT-5.6 Cyber é posicionado como um modelo específico para segurança cibernética, e não como um substituto geral do Sol. Utilize-o quando a tarefa se beneficiar especificamente dessa abordagem; não compare apenas o preço final e considere isso uma atualização universal.
Estimativas do token GPT-5.6 já trabalhadas
Utilize os tokens ÷ 1.000.000 × a taxa aplicável. Esses exemplos utilizam o contexto curto GPT-5.6 Sol e excluem impostos, taxas de ferramentas, diferenças entre Batch e Flex e taxas do plano.
| Cenário | Entrada | Saída | Estimativa |
|---|---|---|---|
| Pequena alteração | 20.000 × $4/M = $0,08 | 3.000 × $20/M = $0,06 | $0.14 |
| Revisão do código | 250.000 × $8/M = $2,00 (longo) | 20.000 × $30/M = $0,60 | $2.60 |
| Lote grande com contexto curto | 1M × $4/M = $4,00 | 100 mil × $20/M = $2,00 | $6.00 |
custo estimado da API = tokens de entrada / 1.000.000 × taxa de entrada + entrada em cache / 1.000.000 × taxa de cache + tokens de saída / 1.000.000 × taxa de saída + taxas da ferramenta
Entrada armazenada em cache e contexto extenso
A entrada em cache é útil quando um prefixo repetido — como um resumo do sistema ou um contexto de repositório — se qualifica para o armazenamento em cache. Isso não torna todas as solicitações repetidas mais econômicas. Use os dados de uso de faturamento para confirmar os acertos no cache e acrescente os custos de gravação no cache ou de armazenamento nos casos em que o provedor os indicar.
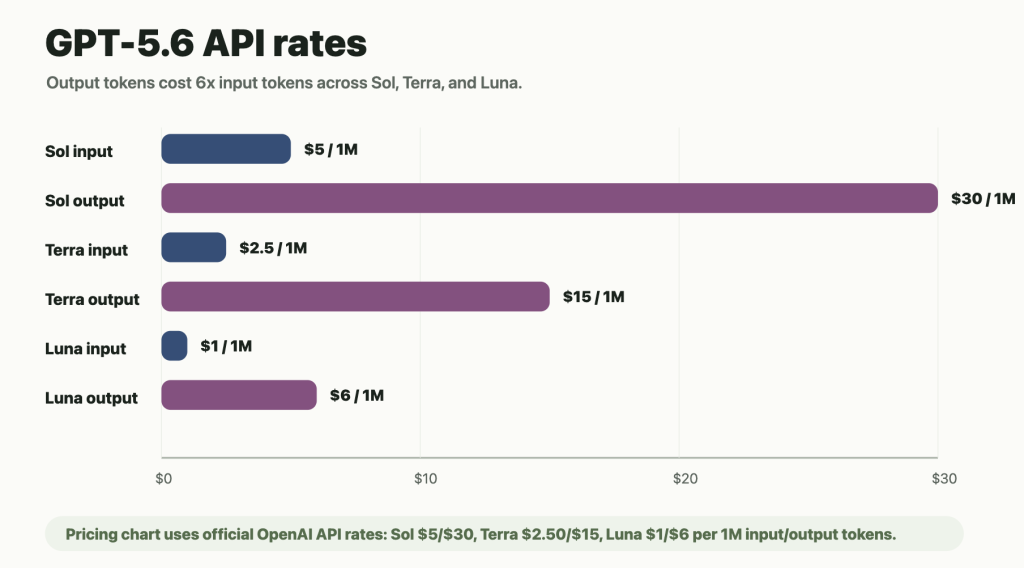
O contexto longo também altera a faixa de tarifa. Se a solicitação ultrapassar o limite de contexto longo do provedor, utilize os preços de entrada e saída do contexto longo para essa solicitação, em vez de aplicar a tarifa de curto prazo à fatura inteira.
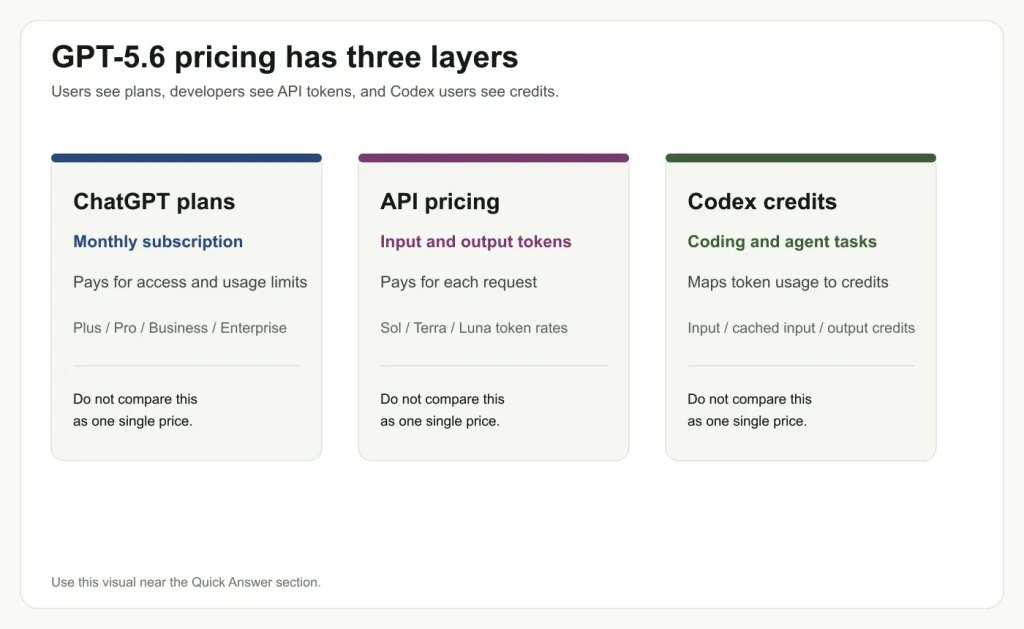
Os planos ChatGPT e os créditos do Codex são diferentes dos preços da API
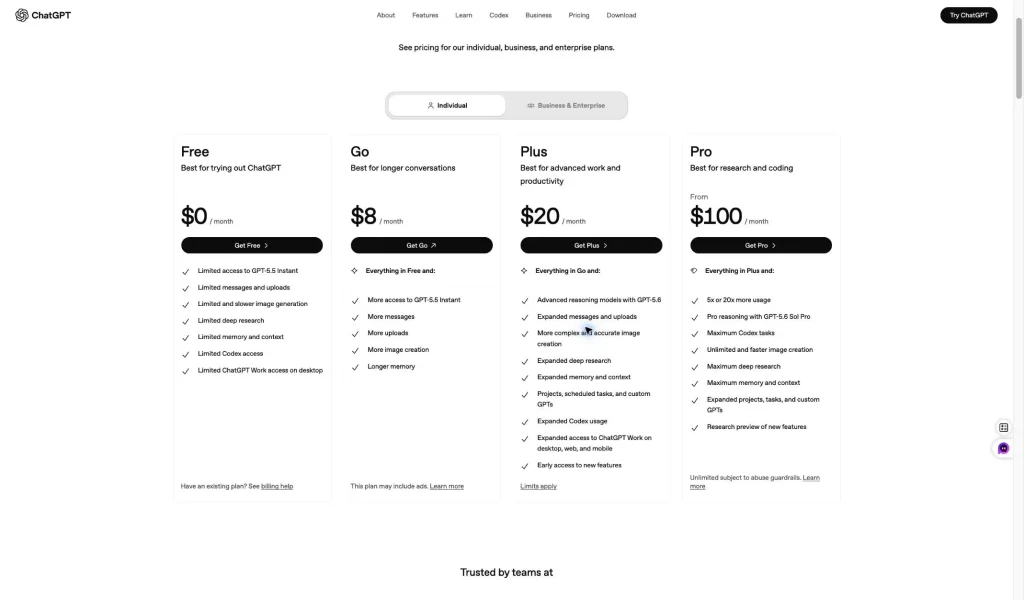
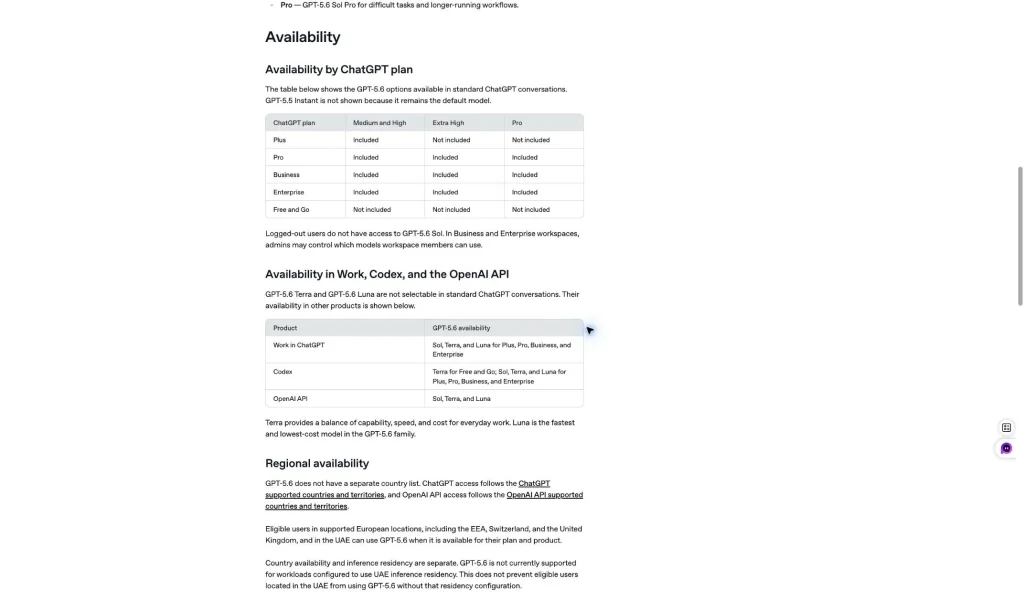
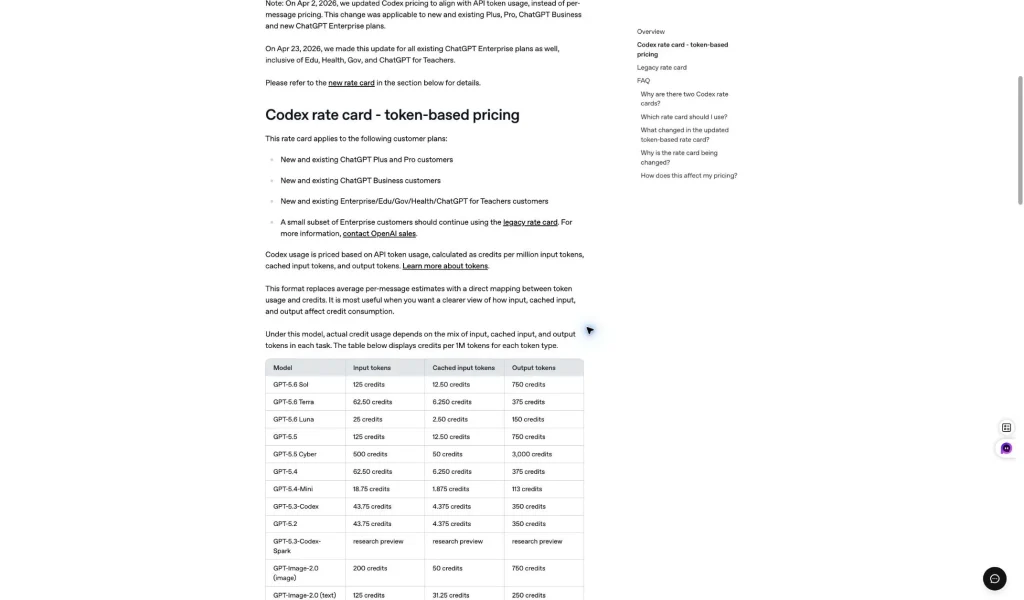
As assinaturas ChatGPT incluem acesso a aplicativos e recursos. Os créditos do Codex representam o uso dentro de uma interface de produto. As chamadas de API são contabilizadas por projeto de desenvolvedor. Mantenha esses três orçamentos separados ao comparar os “preços do GPT-5.6”.”
Escolhendo uma API, uma CLI ou um espaço de trabalho multimodelo

Utilize a API para tráfego de produção programável e contabilidade no nível do token. Utilize a CLI quando o modelo precisar estar integrado a um terminal e a um repositório. Utilize o MCP quando o fluxo de trabalho depender de ferramentas aprovadas. Utilize um agente Yukie quando a tarefa abranger planejamento, uso de ferramentas e transferências de responsabilidade.
GlobalGPT se encaixa na camada de comparação interativa e entrega: experimente diferentes modelos, avance para a programação ou outras funções de IA e mantenha a decisão sobre a assinatura separada da fatura da API da OpenAI. Seu custo geral mais baixo do fluxo de trabalho é uma proposta de valor, não uma alegação de que altera as tarifas da OpenAI.
O acesso ao plano ChatGPT é um orçamento separado
Uma assinatura ChatGPT dá acesso a uma interface de produto. A API cobra de um projeto de desenvolvedor por token, e os créditos do Codex representam o uso dentro do fluxo de trabalho de um produto. Esses registros podem estar relacionados à mesma família de modelos, mesmo sendo compras diferentes.
| Rota | O que você paga | A melhor pergunta a se fazer |
|---|---|---|
| Plano do ChatGPT | Acesso ao aplicativo interativo e recursos do plano | O plano apresenta o modelo e as ferramentas de que preciso? |
| API da OpenAI | Entrada, entrada armazenada em cache, gravações no cache, saída e custos da ferramenta | Quanto custará essa carga de trabalho com base no volume real de tokens? |
| Créditos do Codex | Utilização na superfície do produto Codex | Qual é a extensão do trabalho relacionado a repositórios ou programação coberto pelo orçamento de crédito? |
| Espaço de trabalho do GlobalGPT | Um fluxo de trabalho de assinatura mais abrangente, que engloba diversos modelos e ferramentas | Posso concluir a tarefa sem precisar pagar por vários produtos separados? |
Não utilize o preço do plano ChatGPT como previsão de API, nem utilize uma taxa de API para descrever o acesso por assinatura. Uma comparação clara começa pela identificação da rota que realmente levará seu trabalho ao destino.
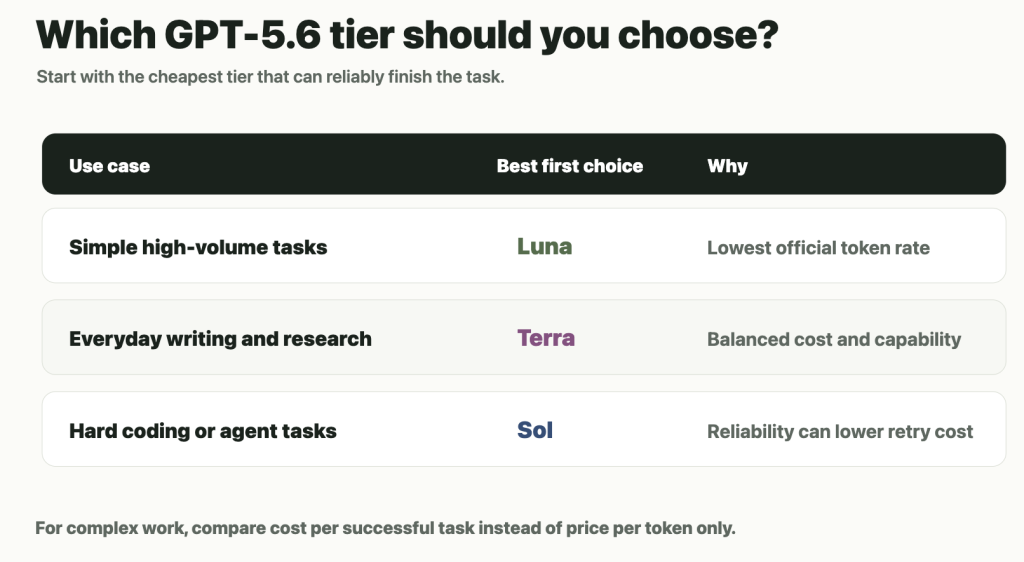
Escolha o caminho modelo para realizar a tarefa
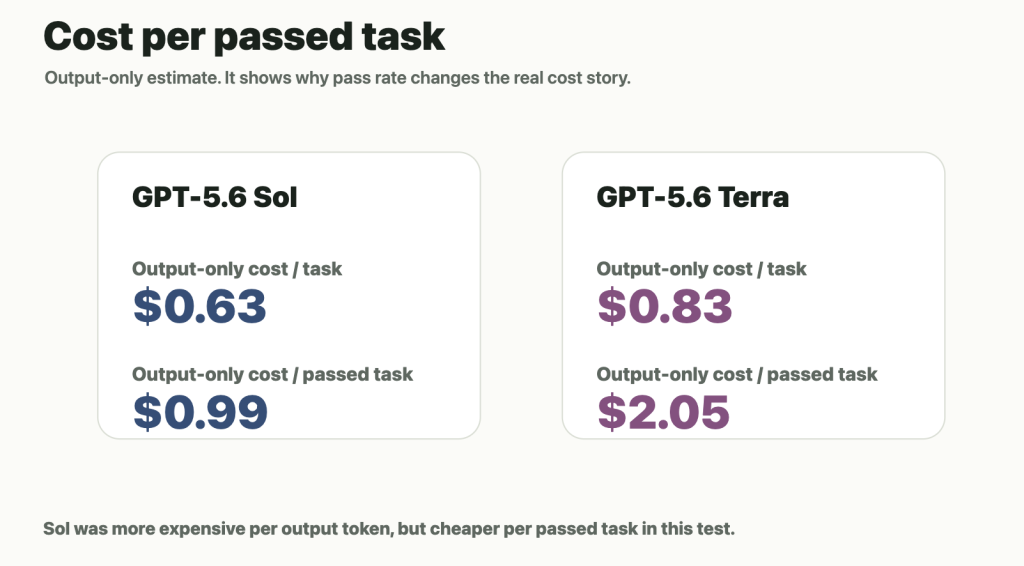
A linha mais barata não é necessariamente a tarefa concluída mais barata. Uma edição curta pode ser barata em um modelo geral, enquanto um contexto de repositório extenso pode fazer com que o nível de contexto e o comprimento da saída tenham maior importância. Para uma chamada em produção, registre separadamente os tokens de entrada, a entrada em cache, os tokens de saída e quaisquer chamadas de ferramentas.
| Padrão de trabalho | Sinal orçamentário | Bom hábito operacional |
|---|---|---|
| Transformação de textos curtos | A produção costuma permanecer baixa | Defina um formato de saída claro e uma condição de parada. |
| Revisão de código extenso ou de documentos | Pode ser aplicada a camada de contexto longo | Meça o tamanho do prompt antes de enviar o repositório completo. |
| Contexto repetido do sistema ou do repositório | Os dados de entrada armazenados em cache podem ser importantes | Confirme o número real de acessos em cache nos dados de uso. |
| Fluxo de trabalho autônomo de ferramentas | Chamadas de ferramentas aumentam o uso | Registre o custo do modelo, da ferramenta e da produção em conjunto. |
Utilize o seletor de modelos atual e a tabela de preços para obter os nomes exatos dos modelos e as condições de acesso. Caso a denominação de um modelo seja alterada, o método de orçamento permanece o mesmo: associe a tarefa à rota e, em seguida, multiplique as unidades reais.
Um teste repetível de uso de tokens
Para estimar uma tarefa real, use o mesmo prompt, a mesma entrada e a mesma saída esperada em duas execuções. Registre os tokens de entrada, os tokens de saída, o status do cache e se foi feita uma chamada à ferramenta. Em seguida, compare o custo de um resultado bem-sucedido, em vez de comparar isoladamente um preço de referência.
- Utilize um código pequeno e representativo ou uma tarefa de redação.
- Mantenha o formato de saída fixo para que a comparação seja justa.
- Anote o primeiro resultado e o resultado final após qualquer nova tentativa.
- Separe os erros dos prestadores, os limites de taxa e a qualidade do modelo do cálculo do preço.
- Anote a data, pois os preços promocionais e a disponibilidade dos modelos podem mudar.
Isso transforma a pergunta “qual modelo é mais barato?” em uma questão operacional útil: qual abordagem conclui a tarefa com o menor gasto previsível e o menor volume de retrabalho?
Quando vale a pena arcar com os custos adicionais da API para fazer uma atualização
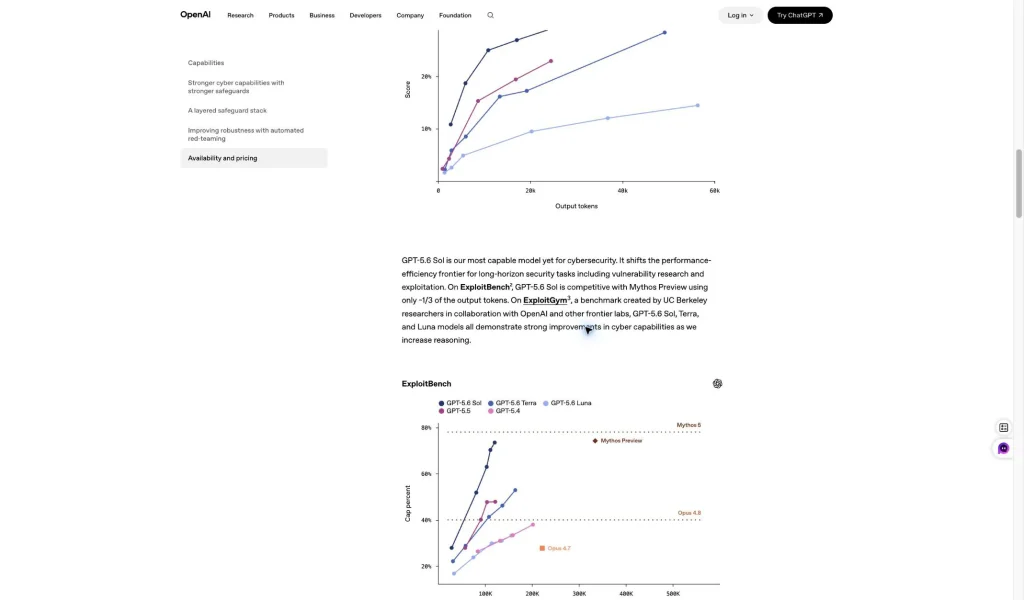
Um modelo mais recente justifica seu custo mais alto quando reduz um modo de falha real: correções repetidas, chamadas de ferramentas não atendidas, código frágil ou um prompt longo que a opção mais barata não consegue lidar de forma confiável. Se a saída já estiver correta e curta, um modelo mais caro pode ser um desperdício.
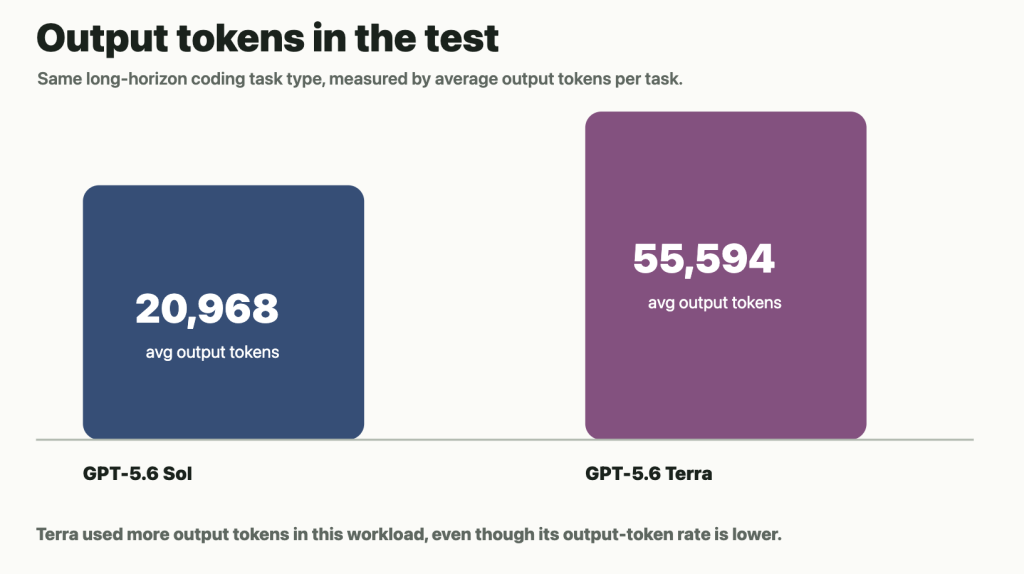
Para uma equipe, compare três indicadores relativos ao mesmo conjunto de tarefas: conclusões bem-sucedidas, média de tokens gerados e tempo de correção humana. O modelo com o menor custo por token nem sempre representa o menor custo total do projeto.
Da chamada de API até um fluxo de trabalho completo para desenvolvedores
Use o Rota da API GlobalGPT para chamadas programáveis, CLI quando o modelo precisa estar integrado a um terminal e a um repositório, e o MCP quando o fluxo de trabalho depende de ferramentas aprovadas. Um agente Yukie pode coordenar o planejamento, o uso de ferramentas e as transferências de tarefas. Para trabalhos interativos, Acesso ao espaço de trabalho GlobalGPT e GPT-5.6 permite que você teste a tarefa antes de se comprometer com um caminho de produção com cota.
A vantagem prática está na sequência: esclarecer a tarefa, comparar um modelo adequado, executar o menor teste útil possível e, em seguida, migrar o prompt funcional para a API, a CLI ou o MCP. Isso mantém separados os gastos com experimentação e com produção.
PERGUNTAS FREQUENTES
Qual é o preço da API GPT-5.6 Sol?
O OpenAI lista a entrada $4/M e a saída $20/M para contexto curto, e a entrada $8/M e a saída $30/M para contexto longo. A entrada em cache e as gravações no cache utilizam taxas distintas.
O GPT-5.6 Cyber é mais caro?
Suas taxas de contexto curto publicadas são $12,50/M de entrada e $75/M de saída; portanto, trata-se de uma decisão orçamentária diferente e deve ser escolhida para uma tarefa que exija essa rota específica.
O plano ChatGPT Plus inclui créditos de API?
Não presuma isso. As assinaturas do ChatGPT e os projetos de API são unidades de cobrança distintas.
O que são créditos do Codex?
São créditos de uso do produto cujo consumo efetivo depende do modelo e do uso de tokens. Mantenha-os separados da previsão de um projeto de API.
Qual é a maneira mais barata de usar o GPT-5.6?
Para trabalhos interativos com vários modelos, compare um plano atual do espaço de trabalho. Para software de produção, compare as estimativas de tokens, os acertos no cache, o nível de contexto e a taxa de conclusão do modelo escolhido.
Comece pela unidade de cobrança: As taxas de tokens respondem à questão sobre a API; o acesso ao plano, os créditos e o valor do fluxo de trabalho respondem à questão sobre o produto.