The API Audio Speech OpenAI mengubah teks menjadi audio yang diucapkan melalui POST https://api.openai.com/v1/audio/speech. Kirimkan model, teks masukan Anda, dan rekaman suara; simpan responsnya dalam format MP3 atau format audio lain yang didukung. Untuk integrasi baru yang memerlukan petunjuk mengenai nada dan cara penyampaian, mulailah dengan gpt-4o-mini-tts.
Permintaan kerja hanyalah langkah pertama. Anda juga memerlukan satuan penagihan yang tepat, berkas keluaran yang dapat diputar, dan rencana untuk naskah yang panjang. Model TTS terbaru dari OpenAI menggunakan token teks dan audio sebagai dasar penetapan harga; sedangkan model TTS lamanya menggunakan karakter. Perbedaan tersebut penting diperhatikan saat Anda memperkirakan biaya narasi untuk satu bulan.
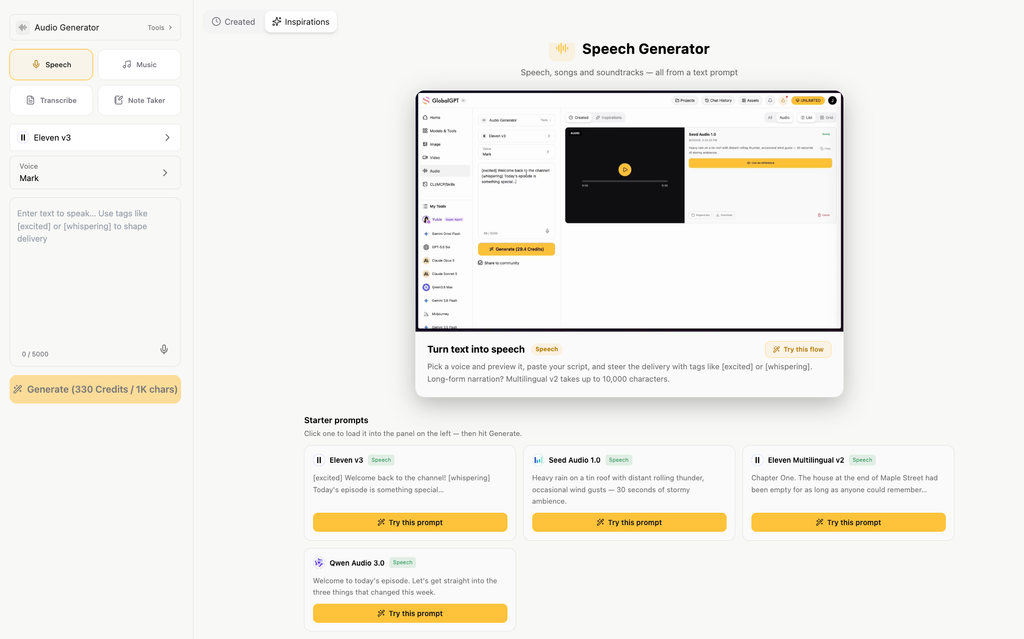
Jika pekerjaan Anda juga mencakup penulisan naskah, pembuatan visual, dan penyuntingan video, Ruang kerja audio GlobalGPT menghadirkan fitur pembuatan ucapan ke dalam platform berlangganan multi-model yang terjangkau. Anda dapat mengerjakan teks, suara, gambar, dan video dalam satu dasbor, lalu menggunakan API dan CLI-nya untuk pekerjaan produksi yang dapat diulang. API TTS publiknya menggunakan alur kerja tugas terpisah, yang akan dibahas di bawah ini.
Apa fungsi API Audio Speech OpenAI?
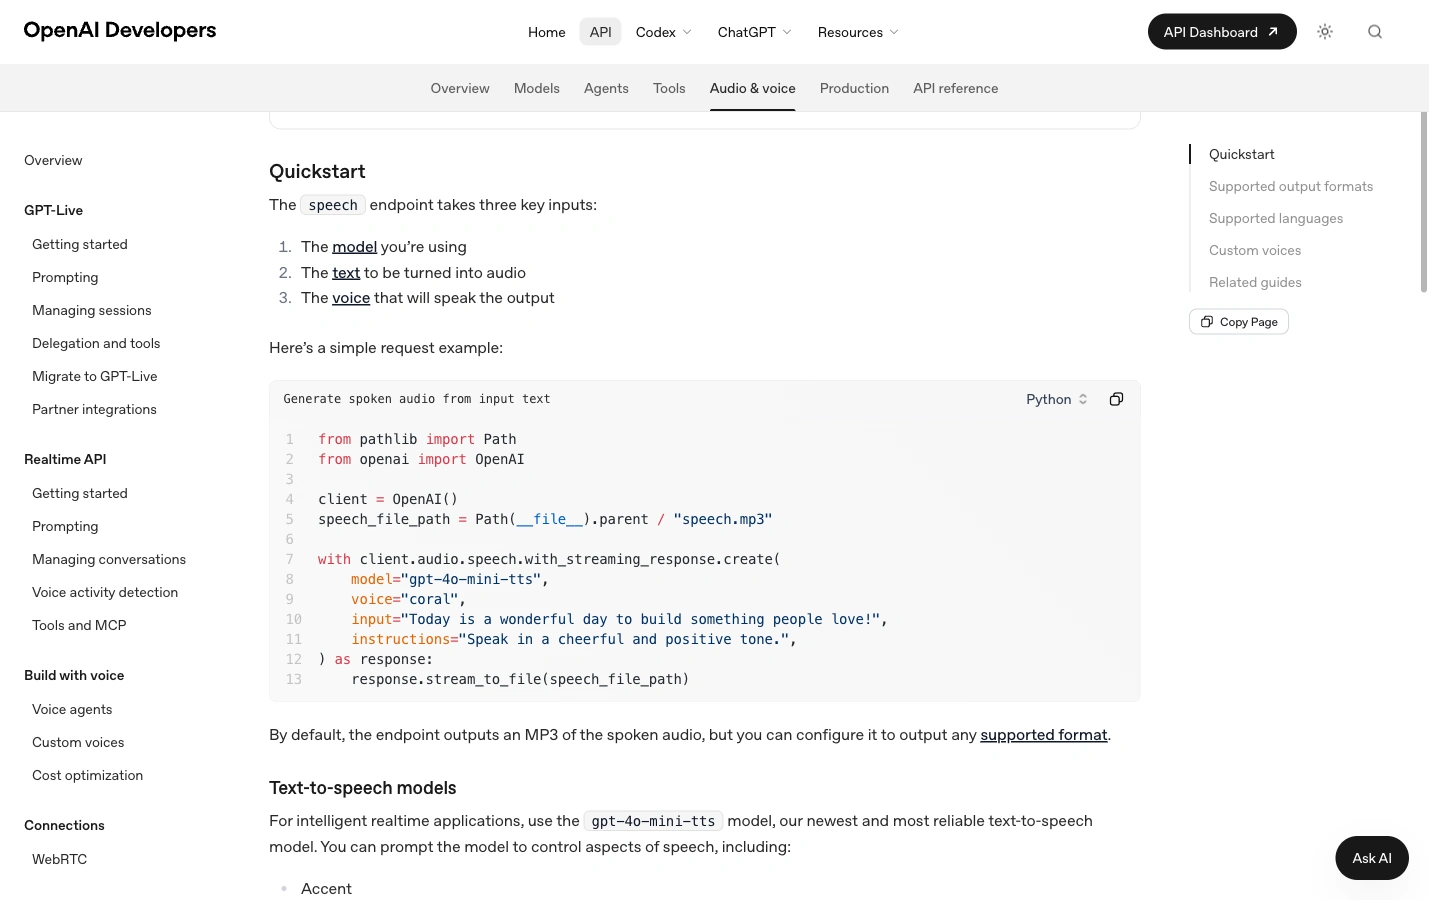
API Speech adalah titik akhir (endpoint) teks-ke-suara: aplikasi Anda memasukkan teks tertulis dan menerima hasil suara yang dihasilkan. Penggunaan umumnya meliputi panduan produk, narasi aksesibilitas, materi pembelajaran, dan sulih suara singkat. Anda dapat mengontrol teks sebelum diucapkan, sehingga fitur ini berguna ketika redaksinya harus mengikuti naskah yang telah disetujui.
Dalam proses transkripsi, urutannya terbalik: rekaman audio dimasukkan, lalu dihasilkan teks. Asisten suara langsung menambahkan persyaratan lain—mendengarkan dan merespons melalui percakapan. OpenAI’s dokumentasi audio memisahkan alur kerja ini. Pilih titik akhir Speech jika Anda sudah memiliki teks yang ingin dibacakan.
Fitur pembuatan ucapan mendukung streaming, sehingga aplikasi dapat menerima audio secara bertahap. Menyimpan aliran tersebut ke dalam berkas tidak secara otomatis memutarnya di peramban atau membuat agen percakapan; aplikasi Anda tetap harus menangani pemutaran dan logika percakapan apa pun. OpenAI juga mewajibkan adanya pengungkapan yang jelas kepada pendengar bahwa suara tersebut dihasilkan oleh AI.
Buat file audio pertama Anda dengan OpenAI Speech API
Jalankan permintaan tersebut di server atau di mesin pengembangan Anda, dengan kunci API OpenAI yang disimpan di OPENAI_API_KEY variabel lingkungan. Jaga agar kunci tersebut tidak dimasukkan ke dalam skrip JavaScript browser. Contoh-contoh berikut menggunakan skrip tur produk singkat yang sama dan menyimpan hasilnya sebagai openai-product-tour.mp3.
Opsi 1: melakukan permintaan curl
API Suara OpenAI · curl
#!/bin/sh
# Atur OPENAI_API_KEY di lingkungan server Anda terlebih dahulu.
curl --fail-with-body --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "Selamat datang di tur produk Acorn Studio. Dalam tiga langkah, Anda dapat mengubah skrip pendek menjadi panduan audio. Pertama, tulis pesan. Selanjutnya, pilih suara. Terakhir, simpan berkas audio dan uji pemutaran di ponsel Anda.",
    "voice": "coral",
    "instructions": "Bicaralah dengan jelas menggunakan nada yang hangat dan santai.",
    "response_format": "mp3"
  }' \
  --output openai-product-tour.mp3
Respons tersebut berisi byte audio, jadi simpanlah ke dalam berkas daripada mencoba menganalisisnya sebagai JSON. The --gagal-dengan-isi Opsi ini membuat curl mengembalikan status keluar gagal jika terjadi kesalahan HTTP. Periksa status tersebut sebelum membuka berkas: respons kesalahan tetap dapat meninggalkan data JSON di berkas bernama .mp3.
Opsi 2: gunakan SDK Python
Instal paket OpenAI dengan perintah berikut: python -m pip install openai. SDK membaca kunci API dari variabel lingkungan. Contoh ini menulis respons begitu respons tersebut diterima, sehingga tidak perlu memuat seluruh respons audio ke dalam buffer Python Anda sendiri.
API Suara OpenAI · Python
"""Instal: python -m pip install openai. Atur OPENAI_API_KEY di server."""
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
script = (
    "Selamat datang di tur produk Acorn Studio. Dalam tiga langkah, Anda dapat mengubah "
    "skrip pendek menjadi panduan audio. Pertama, tulis pesan. Selanjutnya, "
    "pilih suara. Terakhir, simpan berkas audio dan uji pemutarannya di ponsel Anda."
)

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=script,
    instructions="Bicaralah dengan jelas menggunakan nada yang hangat dan seperti sedang bercakap-cakap.",
    response_format="mp3",
) as response:
    response.stream_to_file(Path("openai-product-tour.mp3"))

print("Saved openai-product-tour.mp3")
Tiga bidang utama tersebut adalah model, masukan, dan suara. Di sini, petunjuk menuntut penyampaian yang hangat dan santai; fitur ini membimbing intonasi suara alih-alih menambahkan kata-kata ke naskah yang diucapkan. Bidang ini kompatibel dengan GPT-4o Mini TTS dan tidak didukung oleh tts-1 dan tts-1-hd.
Untuk dokumen yang lebih panjang, pisahkan teks berdasarkan batas kalimat atau paragraf, beri nomor pada setiap segmen, dan simpan setiap hasil dengan nomor tersebut. Pertahankan gaya bahasa dan instruksi yang konsisten di seluruh segmen. Sediakan konteks yang cukup agar susunan kalimat terdengar alami, dan dengarkan kembali bagian-bagian yang disambung sebelum mendistribusikan rekaman yang telah disatukan.
Pilih model, suara, dan format keluaran
| Model | Bagaimana cara memilih | Petunjuk pengiriman |
|---|---|---|
gpt-4o-mini-tts | Titik awal untuk narasi dan penyampaian lisan yang dapat dikendalikan. | Mendukung petunjuk dalam hal nada, gaya, dan tempo. |
tts-1 | OpenAI dirancang untuk menghasilkan ucapan dengan latensi yang lebih rendah. | Gunakan fitur kontrol suara dan kecepatan yang didukung; lewati petunjuk. |
tts-1-hd | Model OpenAI dirancang untuk menghasilkan ucapan dengan kualitas yang lebih tinggi daripada TTS-1. | Gunakan fitur kontrol suara dan kecepatan yang didukung; lewati petunjuk. |
The Halaman model GPT-4o Mini TTS memetakan alias model ke gpt-4o-mini-tts-15-Desember-2025 snapshot. Jika perilaku yang dapat direproduksi penting bagi aplikasi Anda, pilihlah snapshot yang telah didokumentasikan dengan cermat dan simpanlah bersama skrip yang telah Anda simpan.
Suara bawaan dan batasan input
Referensi API Speech mencantumkan 13 suara bawaan untuk GPT-4o Mini TTS: paduan logam, abu, balada, karang, gema, dongeng, oniks, nova, bijak, kilau, bait puisi, marin, dan cedar. OpenAI merekomendasikan marin atau cedar untuk hasil terbaik. Itulah rekomendasi dari OpenAI; tentukan suara yang akan digunakan dalam produksi dengan mendengarkan nama, angka, dan pola kalimat Anda sendiri.
Model TTS yang lebih lama hanya mendukung pilihan warna suara yang lebih sedikit: alloy, ash, coral, echo, fable, onyx, nova, sage, dan shimmer. Jangan berasumsi bahwa setiap suara kompatibel dengan setiap model. The Referensi API Ucapan juga mendukung kecepatan antara 0,25 dan 4,0, dengan 1.0 sebagai pengaturan bawaan.
Ada dua batas masukan yang perlu diperhatikan: batas referensi titik akhir masukan untuk 4.096 karakter, dan halaman model Mini TTS menyebutkan batas maksimum sebesar 2.000 token masukan. Karakter dan token adalah satuan pengukuran yang berbeda. Periksa kedua batasan tersebut untuk Mini TTS, terutama jika menggunakan teks multibahasa, dan pisahkan naskah yang panjang sebelum mengirimkannya.
Pilih format file untuk tujuan penyimpanannya
| Format | Penerapan praktis |
|---|---|
| MP3 | Output default; berkas terkompresi yang praktis untuk dibagikan dan diputar di web. |
| Opus | Berguna untuk aplikasi streaming dan komunikasi yang mendukung codec tersebut. |
| AAC | Pertimbangkanlah kapan lingkungan pemutaran atau alur kerja media Anda memerlukan format AAC. |
| FLAC | Kompresi tanpa kehilangan kualitas untuk alur kerja yang perlu mempertahankan sinyal audio. |
| WAV | Audio tanpa kompresi dalam format yang sudah dikenal untuk pengeditan dan pemrosesan. |
| PCM | Sampel mentah 24 kHz, 16-bit bertanda little-endian tanpa header file; pemutar Anda memerlukan pengaturan tersebut. |
Mulailah dengan format MP3 jika Anda membutuhkan tautan unduhan atau pemutar audio sederhana. Pilih format WAV jika langkah selanjutnya adalah pengeditan. Pilih format PCM mentah hanya jika aplikasi Anda mampu menginterpretasikannya; mengubah nama file dari .pcm untuk .wav tidak membuat header WAV.
Berapa biaya API Suara OpenAI?
Berdasarkan data per 28 September 2026, OpenAI mencantumkan GPT-4o Mini TTS pada $0,60 per juta token masukan teks ditambah $12 per juta token keluaran audio. Biaya TTS-1 $15 per juta karakter, dan harga TTS-1 HD $30 per juta karakter. Hitunglah setiap model dalam satuan masing-masing.
Harga API Speech: pisahkan satuan-satunya
OpenAI menetapkan tarif untuk model TTS terbarunya berdasarkan token, sedangkan dua model TTS sebelumnya dihitung berdasarkan karakter. GlobalGPT mencantumkan tarif tugas TTS-nya dalam bentuk kredit.
| Rute dan model | Tarif | Contoh |
|---|---|---|
| OpenAI · GPT-4o Mini TTS | $0,60 / 1 juta token masukan teks $12 / 1M token keluaran audio | $0.0606 untuk 1.000 token masukan teks + 5.000 token keluaran audio |
| OpenAI · TTS-1 | $15 / 1M karakter | $0.015 untuk 1.000 karakter |
| OpenAI · TTS-1 HD | $30 / 1 juta karakter | $0.030 untuk 1.000 karakter |
| GlobalGPT · Eleven v3, Eleven Multilingual v2, atau Qwen Audio 3.0 TTS Flash | 330 kredit / 1.000 karakter | 330 kredit dengan tarif 1.000 karakter seperti yang tercantum; mintalah perkiraan biaya sebelum mengirimkan |
Ini adalah contoh harga, bukan biaya yang tercantum pada contoh audio di bawah ini. Token, karakter, menit, dan kredit adalah satuan yang berbeda. Perkiraan tugas GlobalGPT mencantumkan jumlah kredit yang berlaku; tabel tersebut tidak mengonversi kredit menjadi dolar.
Tarif diperiksa pada tanggal 28 September 2026. Sumber: Harga API OpenAI dan Dokumentasi API GlobalGPT.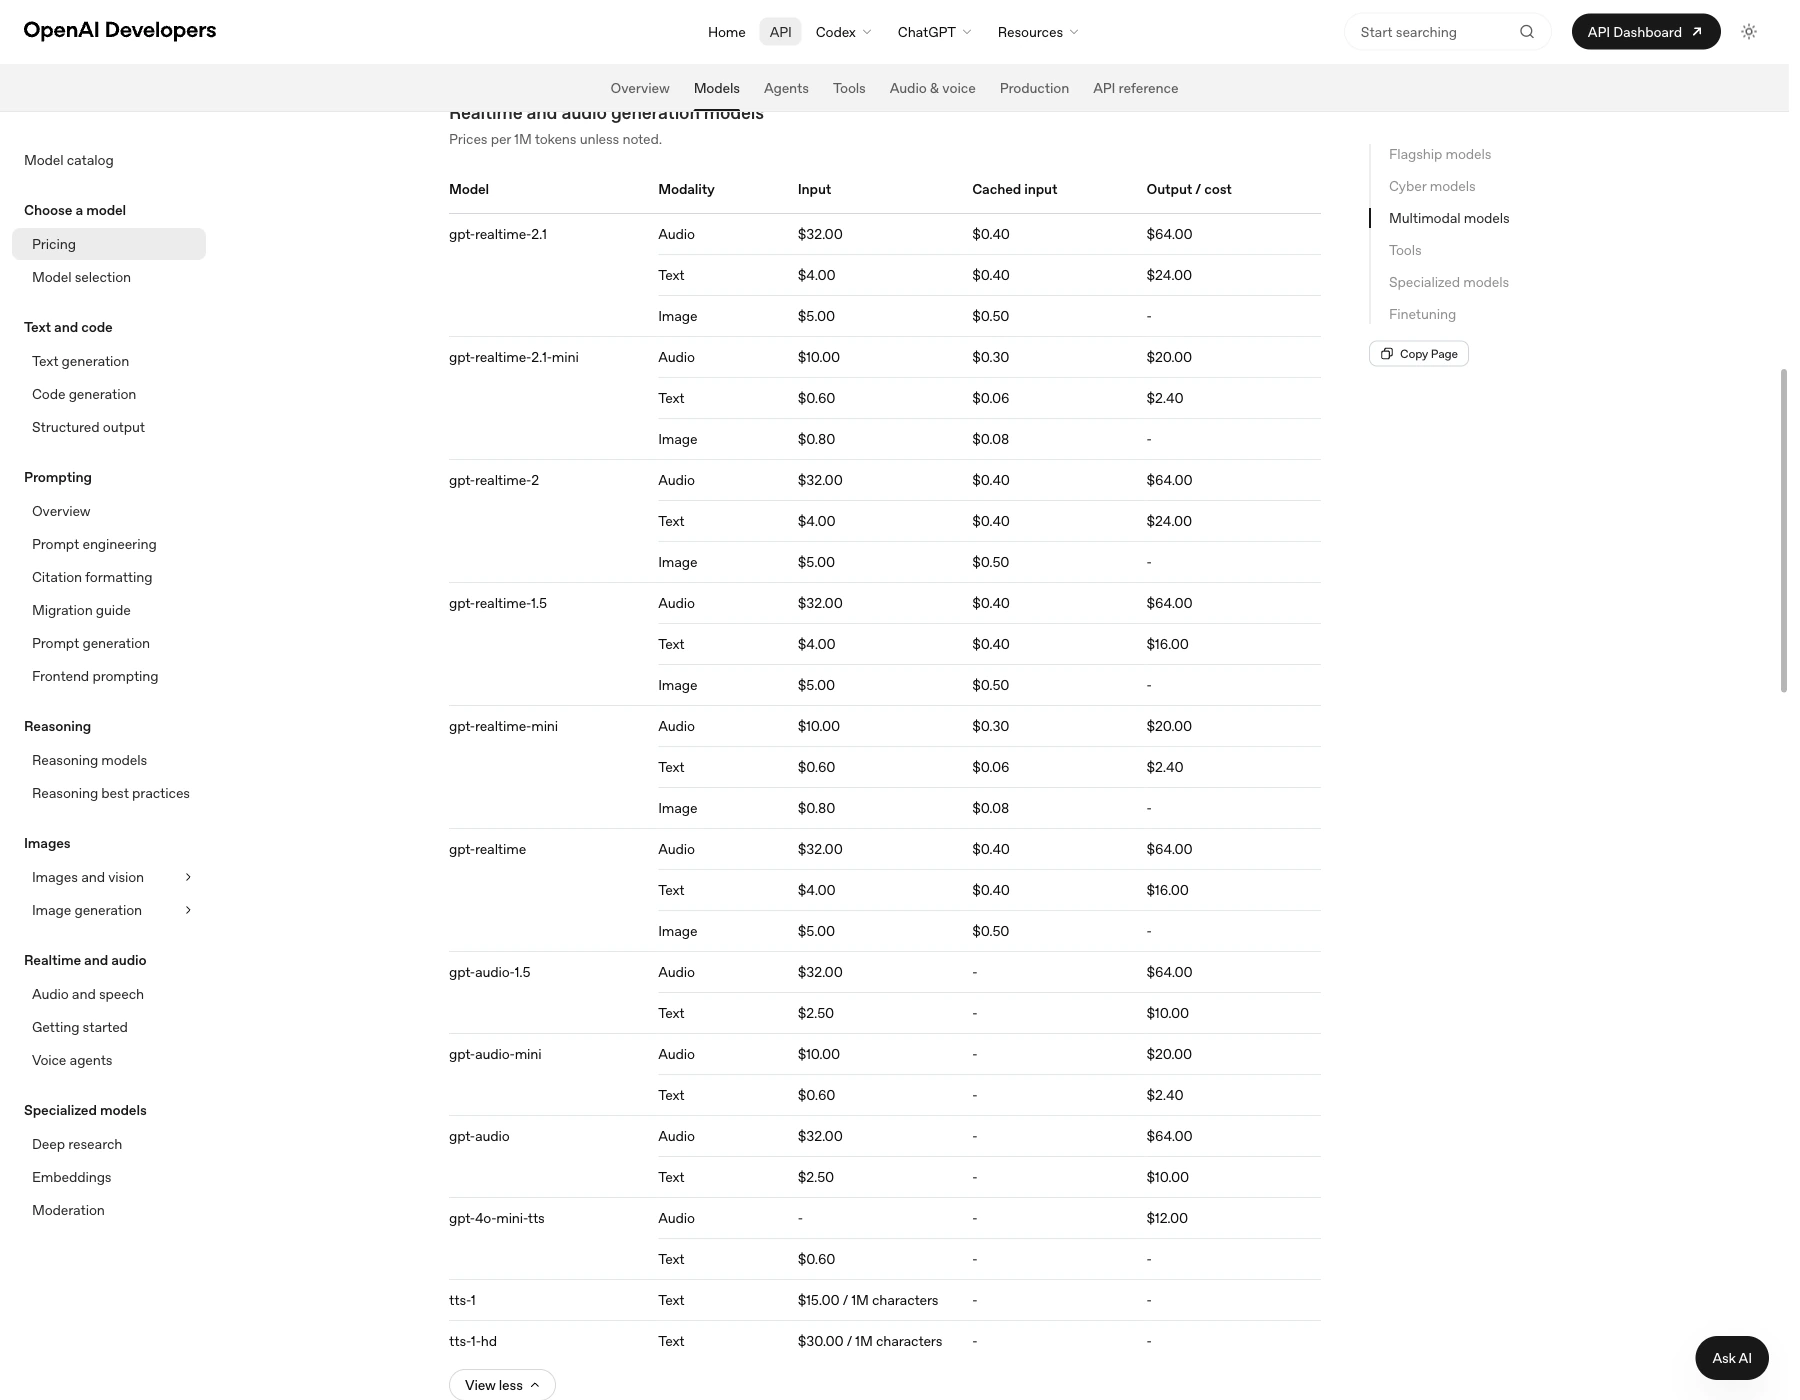
Misalnya, 100 naskah yang masing-masing berisi 1.000 karakter berjumlah total 100.000 karakter. Berdasarkan tarif yang tercantum, jumlah tersebut adalah $1.50 dengan TTS-1 atau $3.00 dengan TTS-1 HD, sebelum biaya aplikasi lainnya. Jumlah karakter yang sama tidak cukup untuk menghitung Mini TTS secara tepat: Anda memerlukan jumlah token masukan teks dan keluaran audio.
Perkirakan biaya pembuatan naskah pidato Anda
Masukkan satuan yang digunakan untuk penagihan pada rute yang Anda pilih. Tidak ada konversi otomatis dari karakter ke token atau dari menit ke token.
Rumus: jumlah karakter × $15 ÷ 1.000.000. Jumlah teks keseluruhan dapat mencakup beberapa permintaan API.
Tarif diperiksa pada 28 September 2026: OpenAI · GlobalGPT. Tidak termasuk biaya penyimpanan, hosting, pajak, dan komponen lain dari aplikasi Anda.
Untuk perencanaan, masukkan jumlah penggunaan aktual atau asumsi yang jelas ke dalam kalkulator. Perlakukan kolom “Mini TTS audio-token” sebagai masukan anggaran sampai Anda telah mengukur penggunaannya. Jangan jadikan angka perkiraan per menit sebagai harga yang dijamin untuk setiap suara, kecepatan bicara, atau bahasa.
Katalog model GlobalGPT mencantumkan harga TTS dalam bentuk kredit, dan hasil perkiraan akhirnya memberikan penawaran harga untuk permintaan yang akan Anda kirimkan. Pisahkan penggunaan kredit API dari langganan ruang kerja multi-model yang Anda pilih untuk kegiatan penulisan dan pengolahan media sehari-hari. Hal ini memudahkan pemantauan anggaran tanpa menganggap bahwa kedua produk tersebut berbagi kuota penagihan yang sama.
Buat alur kerja TTS menggunakan API GlobalGPT
Untuk alur kerja yang dapat diulang dari skrip ke suara hingga video, membuat ucapan di GlobalGPT dan simpan sisa proyek di ruang kerja yang sama. Hal ini API GlobalGPT mengungkap generasi media sebagai serangkaian tugas, sementara GlobalGPT CLI koneksi yang kompatibel dengan terminal dan alat pengembangan Anda.
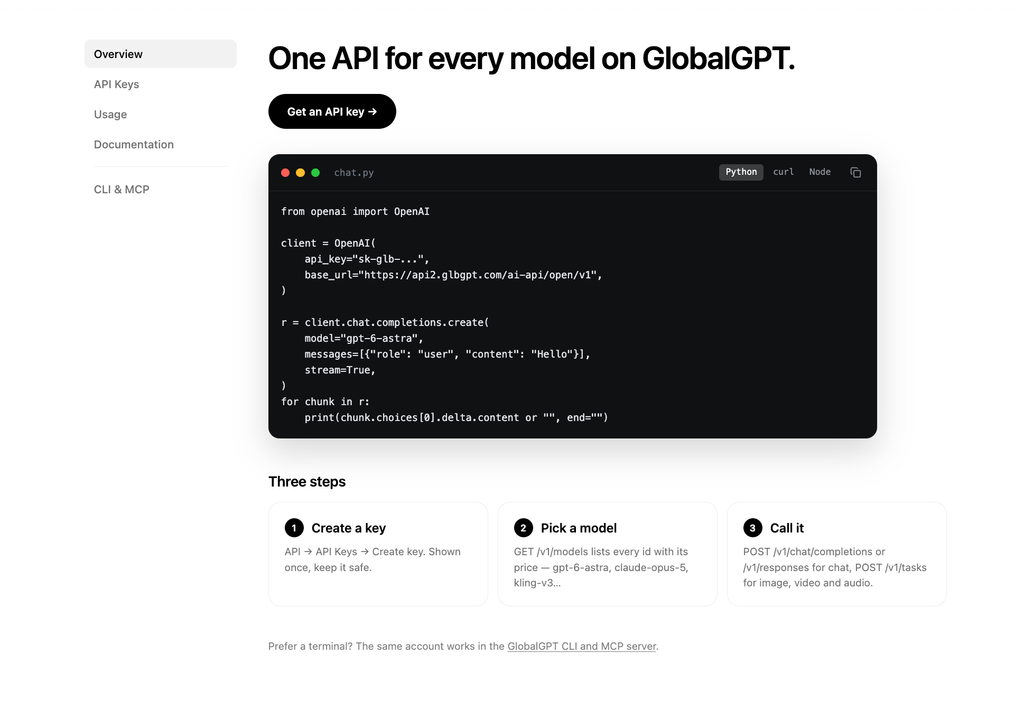
Gunakan URL dasar publik https://api2.glbgpt.com/ai-api/open/v1. Kirim permintaan TTS ke POST /tugas, kueri GET /tugas/{id}, dan unduh output.url setelah tugas berhasil diselesaikan. Kolom teks tersebut adalah perintah. Terapkan kontrak tugas ini secara langsung; hal ini berbeda dengan respons audio instan dari OpenAI.
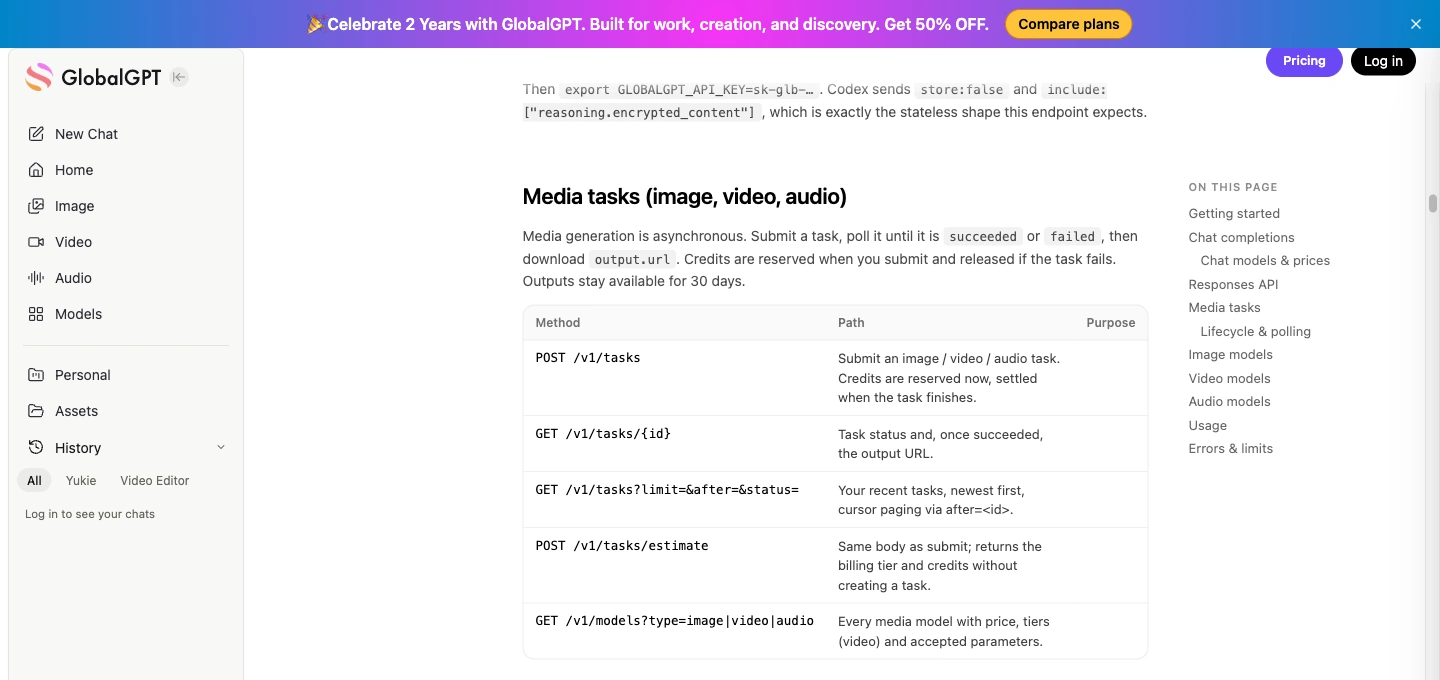
Pilih model TTS GlobalGPT yang telah didokumentasikan
| ID Model | Masukan dan keluaran | Perbedaan yang berguna |
|---|---|---|
eleven-v3 | Maksimal 5.000 karakter; MP3 | Mendukung tag audio yang ekspresif. |
sebelas-multibahasa-v2 | Maksimal 10.000 karakter; MP3 | 29 bahasa; tag audio dibacakan sebagai teks. |
qwen-audio-3.0-tts-flash | Maksimal 4.096 karakter; WAV | 49 suara; kontrol suara dan bahasa menggunakan bidang-bidang khusus Qwen. |
Daftar ketiga entri tersebut 330 kredit per 1.000 karakter. Gunakan POST /tasks/estimate bersama dengan isi permintaan yang dimaksud untuk perkiraan yang bersangkutan; menurut dokumentasi, hal ini tidak akan membuat tugas apa pun dan tidak akan memesan kredit apa pun. Akses API Publik menggunakan kredit berbayar.
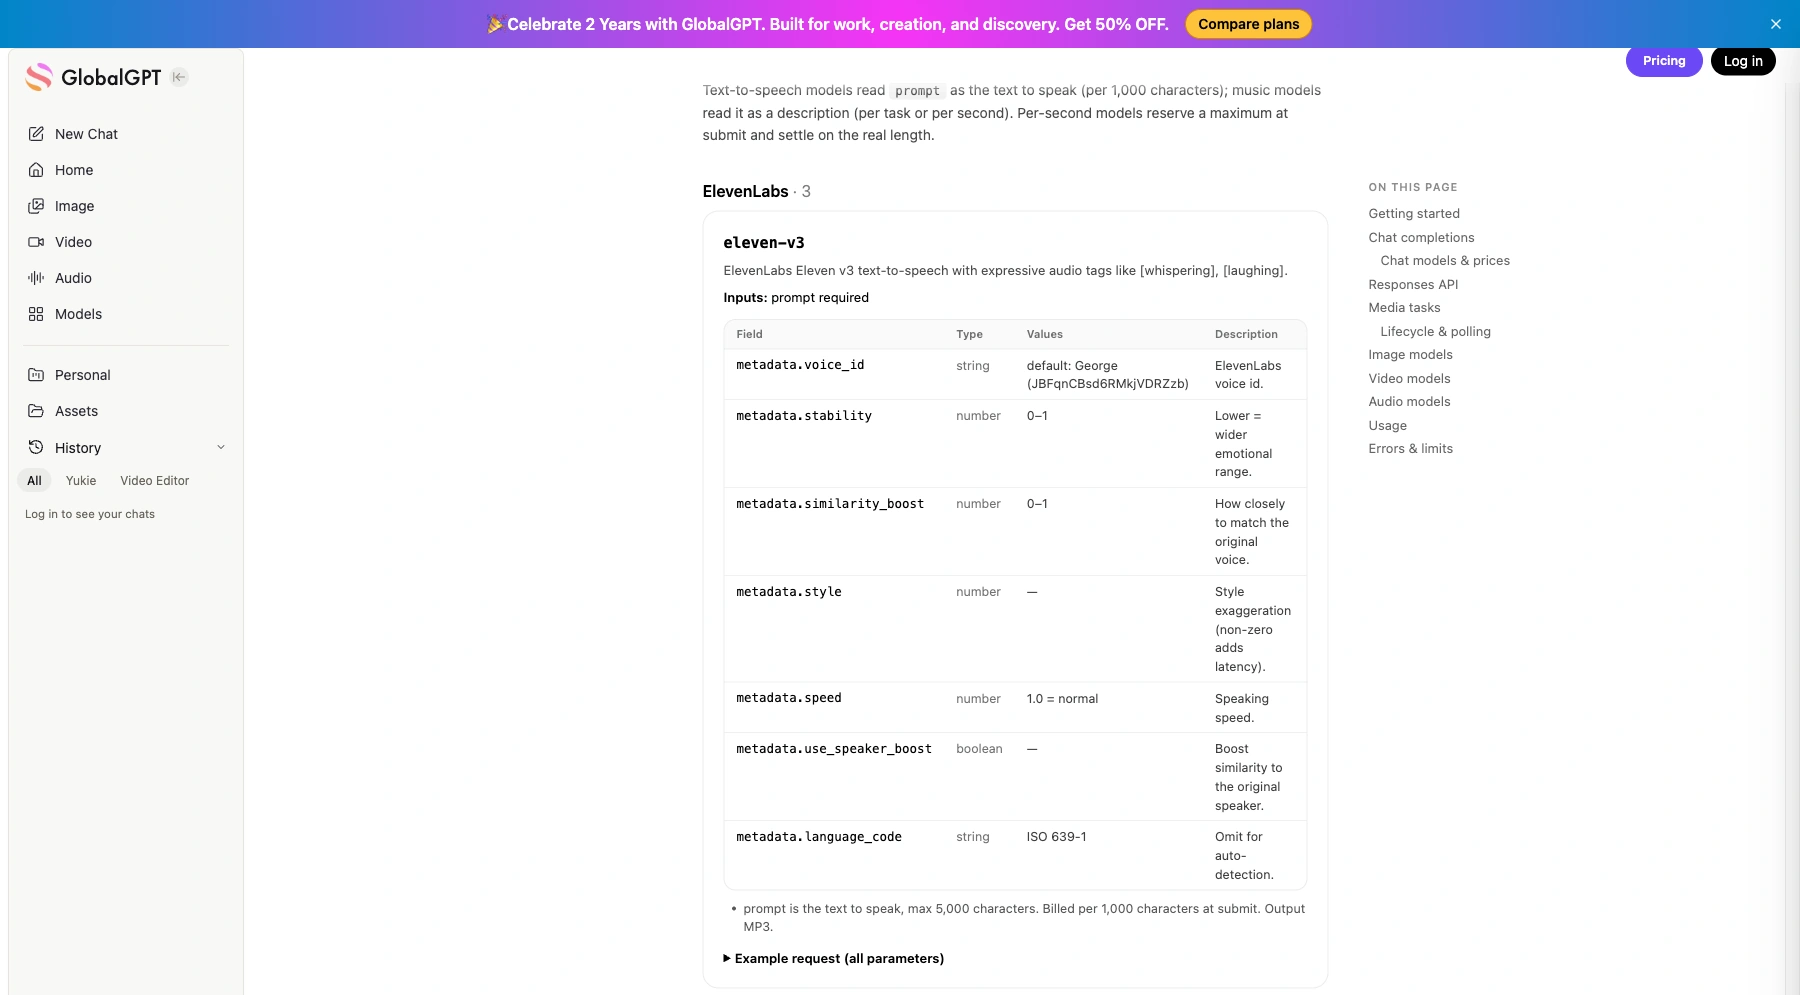
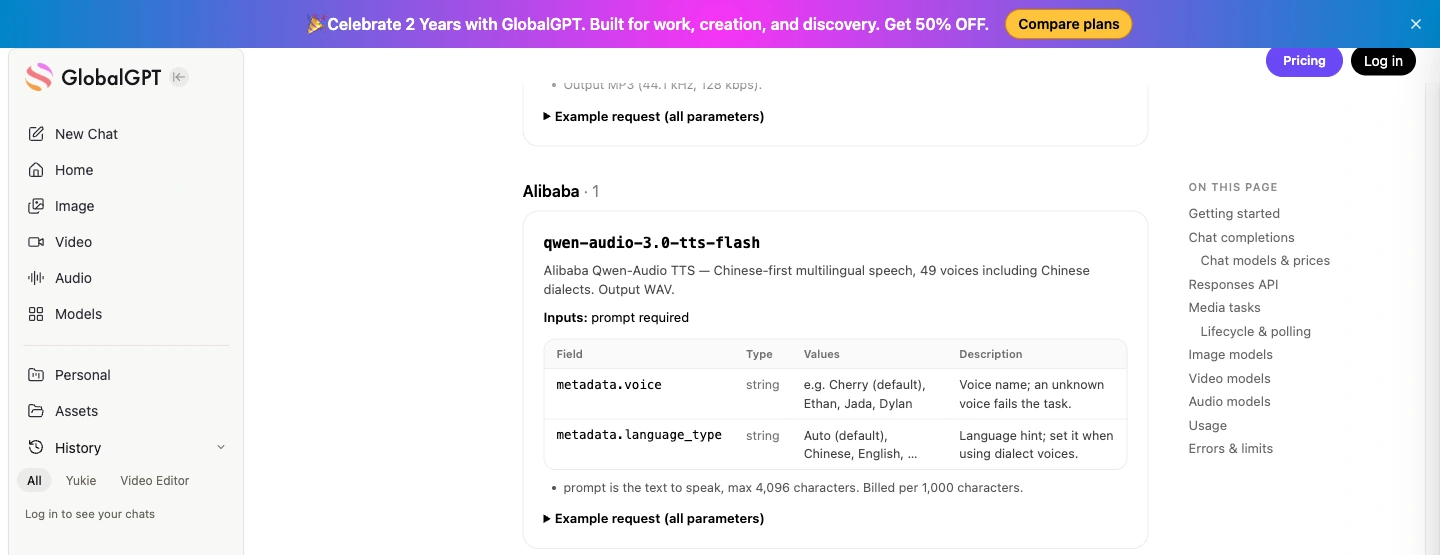
Untuk alur kerja pembuatan yang lebih luas, lihat alur kerja text-to-speech di GlobalGPT. Jika Anda sedang meneliti keluarga perangkat lunak sumber terbuka Qwen3-TTS yang memiliki nama terpisah, bacalah Model Qwen3-TTS dan opsi API; jangan menganggap ID model Qwen-Audio di atas sebagai implementasi Qwen3-TTS yang dapat digunakan secara bergantian.
Buat perkiraan, kirimkan sekali, lalu periksa status tugas yang telah disimpan
Pasang permintaan dengan python -m pip install requests dan atur GLOBALGPT_API_KEY di server. Contoh di bawah ini menggunakan Eleven v3, memilih ID suara publik yang tercantum dalam dokumentasi, dan menetapkan batas maksimum ilustratif sebesar 500 kredit. Sesuaikan batas maksimum tersebut agar sesuai dengan anggaran Anda sebelum menjalankannya.
API Tugas TTS Publik GlobalGPT · Python
"""Instal requests; atur GLOBALGPT_API_KEY. Menggunakan API tugas publik GlobalGPT."""
import json
import os
import time
import uuid
from pathlib import Path
import requests

BASE = "https://api2.glbgpt.com/ai-api/open/v1"
STATE = Path("globalgpt-tts-job.json")
OUTPUT = Path("globalgpt-product-tour.mp3")
MAX_CREDITS = 500  # Batas maksimum per tugas; edit sebelum dijalankan.

payload = {
    "model": "eleven-v3",
    "prompt": (
 "Selamat datang di tur produk Acorn Studio. Dalam tiga langkah, Anda dapat mengubah "
 "skrip pendek menjadi panduan audio. Pertama, tulis pesannya. Selanjutnya, "
 "pilih suara. Terakhir, simpan berkas audio dan uji pemutarannya di ponsel Anda."
    ),
    "metadata": {
 "voice_id": "JBFqnCBsd6RMkjVDRZzb",
 "stability": 0.5,
 "language_code": "en",
    },
}

api = requests.Session()
api.headers["Authorization"] = "Bearer " + os.environ["GLOBALGPT_API_KEY"]

if STATE.exists():
    job = json.loads(STATE.read_text())
    if job["payload"] != payload:
 raise RuntimeError("Pekerjaan ini terkait dengan masukan yang berbeda. Gunakan nama file status yang baru.")
else:
    estimate = api.post(BASE + "/tasks/estimate", json=payload, timeout=30)
    estimate.raise_for_status()
    quote = estimate.json()
    print("Perkiraan kredit:", quote["credits"])
    jika quote["credits"] > MAX_CREDITS:
  raise RuntimeError("Perkiraan melebihi batas maksimum per pekerjaan.")
    job = {"payload": payload, "idempotency_key": str(uuid.uuid4())}
    STATE.write_text(json.dumps(job, indent=2))

if "task_id" not in job:
    # Kunci yang disimpan secara permanen mengaitkan upaya pengiriman ulang dengan permintaan ini secara spesifik.
    submitted = api.post(
 BASE + "/tasks", json=payload,
 headers={"Idempotency-Key": job["idempotency_key"]}, timeout=60,
    )
    submitted.raise_for_status()
    task = submitted.json()
    job["task_id"] = task["id"]
    STATE.write_text(json.dumps(job, indent=2))
    if task.get("ignored_parameters"):
 print("Parameter yang diabaikan:", task["ignored_parameters"])

print("Tugas:", job["task_id"])
deadline = time.monotonic() + 600
selama time.monotonic() < deadline:
    checked = api.get(BASE + "/tasks/" + str(job["task_id"]), timeout=30)
    checked.raise_for_status()
    task = checked.json()
    if task.get("ignored_parameters"):
 print("Parameter yang diabaikan:", task["ignored_parameters"])
    jika task["status"] == "failed":
  raise RuntimeError("Pembuatan gagal: " + json.dumps(task.get("error", {})))
    jika task["status"] == "succeeded":
        # Gunakan permintaan baru: jangan kirim kunci API ke host media.
 audio = requests.get(task["output"]["url"], timeout=60)
 audio.raise_for_status()
        OUTPUT.write_bytes(audio.content)
 print("Tersimpan:", OUTPUT)
 break
    time.sleep(10)
else:
    raise TimeoutError("Tugas masih tertunda. Jalankan ulang untuk memeriksa ID tugas yang tersimpan.")
Berkas pekerjaan menyimpan permintaan yang persis sama, kunci idempotensi, dan ID tugas. Jika koneksi Anda terputus, jalankan kembali pekerjaan yang sama agar kode dapat melanjutkan tugas yang sudah ada. Untuk secara sengaja menghasilkan audio yang berbeda, gunakan nama berkas pekerjaan yang baru. Jaga kerahasiaan berkas pekerjaan jika skripnya berisi informasi rahasia.
Periksa parameter_yang_diabaikan sehingga pengaturan yang tidak didukung tidak akan secara diam-diam menjadi konfigurasi yang diasumsikan. Kontrol ElevenLabs seperti voice_id berbeda dari Qwen suara dan jenis_bahasa bidang. Lakukan polling setiap 5–10 detik, tangani sebuah gagal status, dan segera simpan berkas yang berhasil: masa penyimpanan hasil yang tercatat adalah 30 hari.
Dengarkan dua contoh tur produk
Kedua contoh yang dihasilkan oleh AI ini menggunakan naskah tur produk yang sama, berisikan 216 karakter, dengan Eleven v3 dan Qwen Audio 3.0 TTS Flash. Masing-masing merupakan hasil pertama dari satu permintaan, dengan pengaturan suara default. Keduanya memberikan dua file pendek untuk Anda periksa dan dengarkan; keduanya bukanlah perbandingan terkontrol antara suara yang serupa atau tolok ukur suara OpenAI.
Eleven v3: audio tur produk
eleven-v3 · contoh tur produk
- Output
- MP3 · mono · 44,1 kHz
- Panjang
- Sekitar 15,6 detik
- Generasi
- Hasil pertama · 1 permintaan
Pengaturan: Teks persis seperti di bawah ini, suara bawaan, dan pengaturan lainnya; tanpa penggantian suara atau instruksi penyampaian. Identitas suara bawaan tidak direkam.
Status dan jadwal: Proses tersebut berhasil. Stempel waktu server pada tugas tersebut menunjukkan selang waktu 13 detik dari pengiriman hingga penyelesaian; ini merupakan satu permintaan, bukan pengukuran latensi.
Catatan berkas: Berkas MP3 tersebut berisi aliran mono dengan frekuensi 44,1 kHz dan berukuran sekitar 251 kB. Frame-frame dalam berkas tersebut dapat dibaca hingga akhir berkas.
Referensi biaya: Tarif katalog umum adalah 330 kredit per 1.000 karakter. Gunakan perkiraan biaya untuk permintaan baru; tarif ini bukanlah tagihan untuk contoh tersebut.
Penerapan praktis: File MP3 berukuran ringkas untuk mendengarkan cuplikan tur produk singkat. Pastikan untuk memeriksa teks lengkapnya dan memutarnya di perangkat target Anda sebelum menggunakannya dalam rilis.
Baca input yang tepat · 216 karakter
Selamat datang di tur produk Acorn Studio. Hanya dalam tiga langkah, Anda bisa mengubah naskah pendek menjadi panduan audio. Pertama, tulis pesannya. Selanjutnya, pilih suara. Terakhir, simpan berkas audio dan uji pemutarannya di ponsel Anda.
Qwen Audio 3.0 TTS Flash: audio tur produk
qwen-audio-3.0-tts-flash · contoh tur produk
- Output
- WAV · mono · 24 kHz
- Panjang
- 15,52 detik data PCM
- Generasi
- Hasil pertama · 1 permintaan
Pengaturan: Teks persis seperti di bawah ini, suara bawaan, dan pengaturan lainnya; tanpa penggantian suara atau instruksi penyampaian. Identitas suara bawaan tidak direkam.
Status dan jadwal: Proses tersebut berhasil. Stempel waktu server pada tugas tersebut menunjukkan selang waktu 17 detik dari pengiriman hingga penyelesaian; ini merupakan satu permintaan, bukan pengukuran latensi.
Catatan berkas: Berkas WAV ini berisi data PCM mono 16-bit pada frekuensi 24 kHz dan berukuran sekitar 745 kB. Header-nya menyatakan jumlah data yang lebih besar daripada yang sebenarnya terdapat dalam berkas; hasil keluaran aslinya dipertahankan di sini.
Referensi biaya: Tarif katalog umum adalah 330 kredit per 1.000 karakter. Gunakan perkiraan biaya untuk permintaan baru; tarif ini bukanlah tagihan untuk contoh tersebut.
Penerapan praktis: Contoh berkas WAV untuk mengevaluasi alur kerja narasi. Atasi ketidaksesuaian panjang header dalam alur kerja produksi Anda dan pastikan pemutaran berjalan lancar sebelum didistribusikan.
Baca input yang tepat · 216 karakter
Selamat datang di tur produk Acorn Studio. Hanya dalam tiga langkah, Anda bisa mengubah naskah pendek menjadi panduan audio. Pertama, tulis pesannya. Selanjutnya, pilih suara. Terakhir, simpan berkas audio dan uji pemutarannya di ponsel Anda.
Ukuran sampel Qwen sekitar tiga kali lipat dari ukuran sampel Eleven dengan durasi yang serupa, yang mencerminkan perbedaan antara format WAV dan MP3. Header WAV-nya juga menyatakan jumlah data yang lebih besar daripada yang sebenarnya terkandung dalam file tersebut. Itu merupakan masalah pengemasan file yang perlu diperiksa pada pemutar target Anda; hal tersebut sendiri tidak menunjukkan apa pun mengenai kualitas suara yang diucapkan.
Atasi masalah umum dalam pembuatan ucapan
| Gejala | Hal yang perlu diperiksa terlebih dahulu |
|---|---|
| File MP3 yang telah disimpan tidak dapat diputar | Periksa status HTTP dan jenis responsnya. Mungkin ada kesalahan API yang disimpan dengan ekstensi audio. |
| Permintaan tersebut menolak suara atau instruksi | Sesuaikan kolom "suara" dan kolom opsional dengan model yang dipilih. Model TTS OpenAI versi lama tidak mendukung perintah. |
| Naskah yang panjang ditolak | Periksa batas jumlah karakter rute dan batas token Mini TTS, lalu pisahkan pada titik-titik pemisahan yang wajar. |
| Muncul respons 401 atau 429 | Periksa kunci/akun untuk kode 401. Untuk kode 429, bedakan antara batasan laju (rate limits) dan kuota yang tidak mencukupi sebelum mencoba lagi. |
| Permintaan GlobalGPT masih dalam status tertunda | Periksa ID tugas yang telah disimpan dan periksa statusnya; waktu tunggu yang habis bukanlah alasan untuk mengirimkan pekerjaan duplikat. |
| Suara tersebut tidak sesuai dengan pengaturan yang diminta | Periksa metadata khusus model dan `ignored_parameters` sebelum berasumsi bahwa pengaturan tersebut telah diterapkan. |
| Durasi audio atau bilah pencarian tampak tidak benar | Bandingkan metadata berkas dengan isi media yang sebenarnya, lalu uji berkas tersebut secara keseluruhan di pemutar target Anda. |
Untuk kesalahan OpenAI, mulailah dengan panduan kode kesalahan. Untuk tugas GlobalGPT, simpan ID tugas dan rincian kesalahan yang ditampilkan. Selama proses pengembangan, pisahkan kegagalan pengiriman, kegagalan penagihan, dan rekaman suara yang tidak memuaskan: masing-masing memerlukan solusi yang berbeda.
Sebelum mengirimkan narasi, dengarkan seluruh rekaman di perangkat yang akan digunakan oleh pendengar Anda. Periksa bagian pembuka, nama dan angka, transisi, serta kalimat penutup. Sertakan pernyataan mengenai penggunaan suara AI di awal pemutaran, dan simpan salinan teks yang persis sama serta pengaturan modelnya agar naskah yang telah diedit dapat dihasilkan kembali sesuai keinginan.
Pertanyaan yang Sering Diajukan
Apa itu titik akhir API Audio Speech OpenAI?
Gunakan POST https://api.openai.com/v1/audio/speech. Kolom yang wajib diisi adalah model, input, dan voice. Responsnya berupa file audio; format defaultnya adalah MP3.
Apakah API Suara OpenAI gratis?
API Speech menerapkan sistem penetapan harga berdasarkan penggunaan. Buatlah perkiraan anggaran berdasarkan tarif API saat ini, jangan mengandalkan kuota gratis: layanan GPT-4o Mini TTS ditagih berdasarkan token masukan teks dan keluaran audio, sedangkan TTS-1 dan TTS-1 HD ditagih berdasarkan jumlah karakter.
Apakah saya bisa mengatur suara dan gaya bicara?
Pilih suara yang didukung oleh model Anda. GPT-4o Mini TTS juga menerima instruksi terkait cara penyampaian, seperti nada yang hangat atau tenang. Kolom instruksi tidak berfungsi pada TTS-1 atau TTS-1 HD.
Apakah Speech API mendukung streaming?
Ya. Fitur ini dapat mengalirkan audio yang dihasilkan secara bertahap. Aplikasi Anda tetap harus menangani pemutaran; streaming teks-ke-suara saja tidak cukup untuk menghadirkan percakapan suara langsung yang lengkap.
Apakah saya bisa menggunakan GlobalGPT dengan mengubah URL dasar OpenAI?
Gunakan alur kerja tugas media yang terdokumentasi dari GlobalGPT untuk TTS: kirimkan permintaan ke POST /tasks, lakukan polling dengan GET /tasks/{id}, dan unduh output.url setelah berhasil. Katalog TTS yang terdokumentasi mencakup model ElevenLabs dan Qwen beserta ID model dan parameternya masing-masing.
Format audio mana yang sebaiknya saya pilih untuk memulai?
Mulailah dengan format MP3 untuk pengunduhan sederhana atau pemutar web. Format WAV berguna jika langkah selanjutnya adalah pengeditan. Format PCM mentah memerlukan pemutar yang dikonfigurasi sesuai laju sampel dan kedalaman bitnya karena tidak memiliki header file.
Mulailah dengan satu naskah pendek, satu suara, dan satu berkas yang telah disimpan. Setelah pemutaran dan biayanya dapat diprediksi, tambahkan pemecahan menjadi bagian-bagian, upaya ulang, dan alur kerja media Anda yang lainnya. Pastikan format permintaan, satuan penagihan, dan penanganan hasil dari API yang dipilih tetap terintegrasi dalam implementasi Anda.
Berikan suara pada naskah Anda berikutnya
Buatlah panduan singkat tentang produk, buat narasi suara menggunakan ElevenLabs atau Qwen, lalu lanjutkan dengan gambar dan video di ruang kerja multi-model GlobalGPT.
Buat rekaman suara dengan GlobalGPT