Pilih Eleven v4 untuk narasi yang sudah jadi; pilih Eleven v4 Turbo jika suara tersebut perlu merespons seiring berjalannya percakapan. Keduanya termasuk dalam keluarga v4 ’ekspresif" dari ElevenLabs. Perbedaan yang penting terletak pada alur kerja penyampaiannya: berkas audio yang telah disempurnakan untuk video atau buku audio, dibandingkan dengan ucapan yang disiarkan secara streaming untuk asisten yang tidak boleh membuat pendengar menunggu.
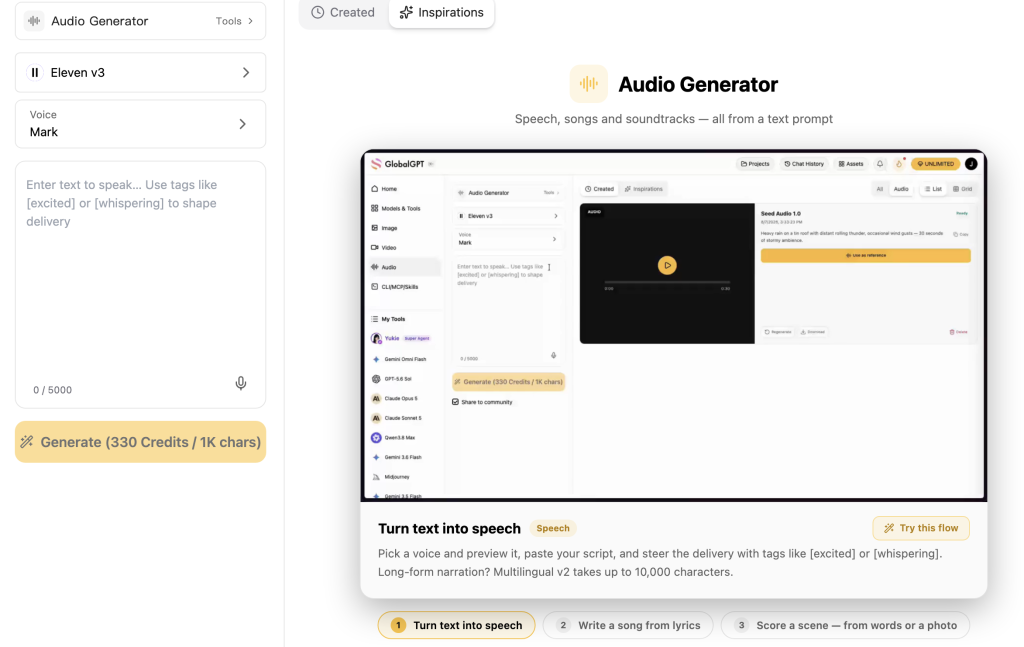
Bagi para kreator yang tidak hanya membuat konten audio, GlobalGPT Fitur ini menggabungkan pembuatan suara ke dalam ruang kerja berlangganan yang sama dengan penulisan naskah, gambar, dan video. Hal ini menjadikannya titik awal yang praktis dan terjangkau untuk sebuah kampanye yang lengkap. Kami menghasilkan dua prompt awal dan naskah lanjutan yang lebih rapi menggunakan masing-masing model dalam GlobalGPT. Enam berkas audio di bawah ini memperlihatkan kesalahan umum dalam pembuatan prompt serta solusinya yang praktis.
Sekilas Perbandingan Eleven v4 vs v4 Turbo
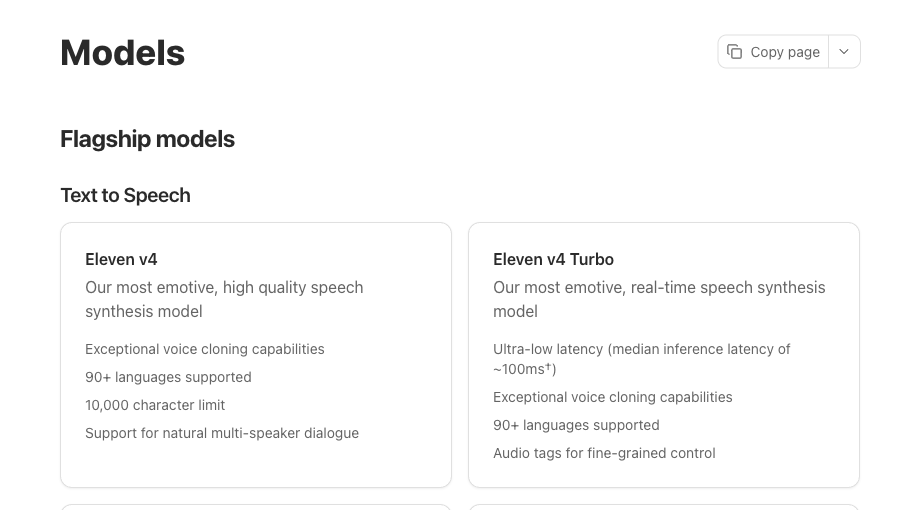
ElevenLabs memposisikan v4 berdasarkan kekayaan emosional dan kualitas konten akhir, serta v4 Turbo berdasarkan ucapan real-time yang ekspresif. Turbo bukan sekadar janji bahwa setiap file MP3 yang diunduh akan tiba lebih cepat. Agar dapat memanfaatkan streaming, aplikasi tersebut harus benar-benar mengirimkan dan memutar audio secara bertahap.
| Keputusan | Eleven v4 | Eleven v4 Turbo |
|---|---|---|
| Ukuran utama | Narasi, buku audio, konten jadi yang penuh ekspresi | Percakapan lisan secara real-time |
| ID model resmi | eleven_v4 | eleven_v4_turbo |
| Dukungan bahasa bagi keluarga | Lebih dari 90 bahasa | Lebih dari 90 bahasa |
| Arah pengiriman | Petunjuk dalam bahasa alami dan tag ekspresif dalam teks | Penyampaian yang ekspresif dalam alur kerja streaming |
| Rute API yang perlu diselidiki | REST: Teks ke Percakapan | WebSocket Teks ke Percakapan Secara Real-time |
| Perbedaan antara hitungan suara dan hitungan kata dalam panduan dialog saat ini | Hingga 10 suara unik dalam masukan dialog REST | Tepatnya satu suara yang terdaftar dalam panduan waktu nyata |
| Ukuran latensi yang dipublikasikan | Tidak ada angka yang sebanding yang digunakan di sini | Waktu inferensi median sekitar 100 ms; waktu median hingga ucapan pertama sekitar 150 ms, menurut laporan peluncuran |
Dokumentasi resmi dan informasi peluncuran telah diverifikasi pada tanggal 13 Oktober 2026. Dukungan bahasa merupakan spesifikasi keluarga; jumlah suara bergantung pada rute API.
Kualitas Suara, Emosi, dan Dukungan Bahasa
Untuk cerita yang direkam, suara memiliki waktu untuk menyesuaikan diri dengan kalimat: jeda, penekanan, dan perubahan emosi bisa lebih penting daripada penundaan generasi yang singkat. Itulah tugas yang diberikan ElevenLabs kepada v4. Agen percakapan memiliki batasan yang berbeda. Bahkan jawaban yang meyakinkan pun terasa canggung jika dimulai terlalu terlambat, sehingga Turbo menekankan pada produksi ucapan yang ekspresif secara cepat.
Peluncuran v4 memperkenalkan petunjuk penyampaian dalam bahasa alami serta tag inline untuk ekspresi vokal dan suara. Petunjuk seperti pembukaan yang tenang diikuti kalimat penutup yang bersemangat lebih berguna daripada sekadar meminta suara yang secara samar-samar “lebih baik”. Pastikan naskah lisan dan instruksi penampilan tetap terpisah di mana pun antarmuka menyediakan kolom terpisah. Jika tidak, kotak teks biasa dapat mengubah arahan menjadi kata-kata yang diucapkan.
- Untuk deskripsi produk: menilai nama produk, memberi jeda pada bagian-bagian yang menekankan manfaat utama, dan apakah kalimat terakhir terdengar alami.
- Untuk adegan yang menonjolkan karakter: Gunakan rute dengan penetapan suara yang eksplisit; nama-nama pembicara dalam petunjuk teks saja tidak menjamin adanya suara yang berbeda-beda.
- Untuk pelokalan: Kedua model tersebut mendukung lebih dari 90 bahasa, tetapi pastikan untuk menguji bahasa, aksen, nama, dan singkatan yang tepat dalam naskah Anda.
- Untuk suara hasil kloning: Gunakan suara milik Anda sendiri atau suara yang Anda miliki izin untuk mereproduksinya, serta pastikan akun yang bersangkutan dan akses kloning suara telah dikonfirmasi.
Rangkaian produk ini mencakup fitur kloning suara, namun dukungan yang diberikan oleh suatu model berbeda dengan hak akses yang diperoleh melalui langganan terhadap alat kloning tertentu. Pilihlah suara dan metode aksesnya terlebih dahulu, lalu bandingkan cara penyampaiannya. Jika Anda sudah menggunakan model narasi versi lama, kami Ulasan Eleven Multilingual v2 menjadi pertimbangan lain dalam pengambilan keputusan terkait migrasi.
Apa Arti “Lebih Cepat” bagi v4 Turbo
Dokumentasi model tersebut mengutip kira-kira sebagai berikut Latensi inferensi median 100 ms untuk v4 Turbo. Postingan peluncurannya mengutip kira-kira Waktu median hingga ucapan pertama: 150 ms. Keduanya menjelaskan bagian-bagian berbeda dari alur kerja pengolahan suara, dan tidak ada satupun yang menjamin bahwa file sulih suara yang lengkap akan terunduh dalam sekejap.
Contoh GlobalGPT kami mengukur waktu penyelesaian tugas secara keseluruhan, termasuk waktu tunggu untuk file yang dihasilkan. Contoh-contoh tersebut tidak mengukur latensi audio pertama atau percakapan WebSocket. Hasilnya menunjukkan mengapa pengujian pembuatan file saja bukanlah cara yang tepat untuk menilai responsivitas percakapan: Turbo bukanlah yang menyelesaikan tugas lebih cepat pada kedua pasangan asli tersebut, tetapi Turbo menyelesaikan tindak lanjut skrip bersih lebih cepat. Variasi tersebut pada tiga pasangan kecil bukanlah peringkat kecepatan yang stabil.
Enam Contoh Audio GlobalGPT: Rekaman Pertama dan Solusi Praktis
Kami mengirimkan dua prompt awal masing-masing sekali ke setiap model pada tanggal 13 Oktober 2026, lalu menambahkan satu pasangan naskah bersih setelah memeriksa teks yang diucapkan. Keenam permintaan tersebut menghasilkan berkas MP3 yang dapat diputar; tidak ada rekaman yang diganti dengan rekaman ulang. Prompt dalam setiap pasangan memang cocok, tetapi ID suara yang sama tidak dikunci. Kami memeriksa durasi file dan menggunakan transkripsi otomatis lokal untuk membandingkan kata-kata yang diucapkan. Pemeriksaan ini hanya mencakup isi, bukan kealamian atau kualitas emosional.
Contoh 1: Pengenalan Singkat tentang Produk
Petunjuk pertama mencampurkan arahan penyampaian dengan naskah iklan. Kedua transkrip tersebut memuat instruksi pembuka, “Bacalah pengenalan produk singkat ini dengan nada tenang di awal dan kalimat penutup yang penuh antusiasme.” Hal itu membuat rekaman pertama ini tidak cocok digunakan sebagai iklan jadi. Di kolom teks ucapan biasa, tuliskan kata-kata yang ingin Anda ucapkan; letakkan panduan penampilan di kolom kontrol atau arahan yang disediakan.
Contoh 2: Adegan Pendek yang Disutradarai
Prompt kedua mencakup petunjuk bagi pembicara dan isyarat tawa. Kedua transkrip tersebut berisi “Pembicara satu, dengan hangat” dan “Pembicara dua, dengan keyakinan yang tenang.” Menuliskan label-label tersebut ke dalam prompt teks biasa tidak menghasilkan adegan karakter yang rapi. Untuk dialog produksi, gunakan antarmuka yang mendukung dengan penugasan suara yang eksplisit, serta pisahkan dialog yang diucapkan dari petunjuk panggung.
Contoh 3: Simpan Hanya Kata-kata yang Ingin Anda Ucapkan
Untuk tahap selanjutnya, kami menghapus petunjuk pembuka dan hanya mengirimkan naskah iklan. Kedua transkrip otomatis tersebut sesuai dengan urutan kata-katanya, tanpa petunjuk yang tidak diinginkan. Durasi file yang dihasilkan sekitar 11 detik. Ini merupakan titik awal yang lebih berguna untuk video produk pendek.
Masukan yang lebih rapi menghasilkan naskah dialog yang dapat digunakan
Selamat datang di Acorn Studio. Mulailah dengan rencana yang jelas, lalu buatlah draf awal yang bermanfaat. Hari ini, ide-ide Anda dapat diwujudkan dari halaman kosong menjadi hasil akhir yang sempurna.
- Generasi
- GlobalGPT · 13 Oktober 2026 · satu pertanyaan lanjutan per model, pengaturan suara default
- Waktu penyelesaian tugas
- v4: 15,832 detik · Turbo: 9,439 detik
- Output
- Keduanya sudah selesai; MP3, mono, 44,1 kHz
- Pemeriksaan konten
- Kedua transkrip otomatis tersebut sesuai dengan urutan kata yang diberikan, tanpa petunjuk arah tambahan.
- Langkah selanjutnya
- Pilih cara penyampaian yang Anda inginkan, periksa pengucapannya dengan mendengarkan, dan sesuaikan rekaman tersebut dengan gambar yang ditampilkan.
Peningkatan ini merupakan pelajaran konkret dalam penulisan naskah. Kealami-an suara dan penyampaian emosi masih memerlukan pendengaran; ini bukanlah peringkat kualitas suara yang seragam.
Penetapan Harga: Bandingkan Seluruh Alur Kerja, Bukan Hanya Nama Model
ElevenLabs menjual langganan dengan kuota kredit; GlobalGPT menawarkan ruang kerja langganan multi-model. Keduanya merupakan keputusan pembelian yang berbeda. Tim produksi suara khusus mungkin memerlukan alat suara dan fitur akun dari ElevenLabs. Seorang kreator yang juga membutuhkan fitur penulisan, gambar, dan video dapat memperoleh cakupan alur kerja yang lebih luas dari satu ruang kerja GlobalGPT.
| Rencana ElevenLabs | Harga bulanan reguler | Kredit bulanan |
|---|---|---|
| Gratis | $0 | 10,000 |
| Starter | $6 | 30,000 |
| Pencipta | $22 | 121,000 |
| Pro | $99 | 600,000 |
| Skala | $299 | 1,800,000 |
Sumber: Harga ElevenLabs, diperiksa pada 13 Oktober 2026; belum termasuk pajak. Penawaran bulan pertama dan diskon tagihan tahunan tidak termasuk dalam harga bulanan reguler ini. Penggunaan kredit bergantung pada produk dan modelnya.
Jangan langsung mengonversi total kredit suatu paket ke tarif dolar v4 Turbo tanpa menggunakan faktor pengali kredit yang berlaku. Bagian FAQ mengenai penetapan harga menyebutkan satu karakter per kredit untuk model dengan kualitas tertinggi dan sekitar 1.000 karakter per menit sebagai perkiraan. Durasi aktual Anda bergantung pada bahasa, kecepatan bicara, dan naskah. Penggunaan khusus model dan tarif kredit tambahan harus sesuai dengan paket yang dipilih.
Anggaran sulih suara yang realistis juga mencakup proses revisi. Untuk naskah berpanjang 1.200 karakter, tiga pengambilan suara lengkap berarti menghasilkan 3.600 karakter sebelum Anda melakukan pengambilan suara tambahan yang lebih singkat. Memperbaiki naskah terlebih dahulu dapat menghemat lebih banyak pekerjaan daripada terus-menerus membuat ulang draf yang kurang baik. Dalam GlobalGPT, Anda dapat menyempurnakan naskah tersebut dengan menggunakan model penulisan, lalu melanjutkan ke tahap produksi audio dan visual di ruang kerja yang sama.
Rute API, Jumlah Panggilan Suara, dan Batas Panjang
Jika Anda sedang mengembangkan sebuah aplikasi, mulailah dengan jalur pengiriman. Titik akhir REST Text to Dialogue menerima array input yang berisi teks dan ID suara, serta mengembalikan audio. WebSocket Text to Dialogue real-time menerima teks yang masuk dan mengirimkan potongan-potongan audio. Nama model saja tidak cukup untuk membuat aplikasi non-streaming terasa seperti aplikasi real-time.
- Dialog yang sudah selesai: Panduan REST ini mendukung hingga 10 ID suara unik. Panduan titik akhir (endpoint)nya merekomendasikan agar panjang teks masukan gabungan tidak melebihi 2.000 karakter per permintaan.
- Realtime Turbo: Panduan real-time ini merekam tepat satu suara. Proses pembangkitan dimulai setelah buffer teks berisi sekitar 40 karakter dan delapan kata; pesan flush dapat memicu segmen yang lebih pendek.
- Versi panjang v4: Tabel model mencantumkan batas 10.000 karakter, yang kira-kira setara dengan sepuluh menit. Angka pada tingkat model tersebut tidak boleh mengesampingkan rekomendasi yang lebih rendah untuk titik akhir tertentu.
- Interaksi langsung: Pengaturan koneksi, perambatan jaringan, penyimpanan sementara teks, dan pemutar audio semuanya memengaruhi latensi yang dirasakan.
Gunakan Referensi dialog REST untuk berkas multi-suara yang sudah jadi dan panduan percakapan secara real-time untuk jalur streaming Turbo. Sesuaikan dukungan model dan pengaturan suara dengan titik akhir sebelum melakukan penskalaan batch. Untuk pekerjaan kreator, alur kerja audio GlobalGPT memungkinkan Anda fokus pada naskah dan aset jadi, alih-alih membangun klien streaming.
Alur Kerja Voiceover yang Praktis di GlobalGPT
Mulailah dengan hasil akhir yang diinginkan: iklan berdurasi 15 detik, video penjelasan berdurasi satu menit, atau segmen narasi. Tulis naskah dialog yang sesuai dengan durasi tersebut sebelum meminta model suara untuk membacakannya. Naskah yang ringkas lebih mudah untuk dibandingkan, direvisi, dan disinkronkan daripada naskah awal yang panjang.
- Buatlah naskah dalam format GlobalGPT. Cantumkan audiens, durasi yang ditargetkan, catatan pengucapan, dan satu ajakan bertindak yang jelas.
- Pilih model audio dan pengaturan suara yang tersedia di ruang kerja Anda. Periksa biaya pembuatannya yang ditampilkan sebelum mengirimkan.
- Buatlah rekaman pertama yang singkat. Perhatikan apakah ada kata-kata yang terlewat, arahan lisan yang tidak diinginkan, nama-nama, kecepatan bicara, dan bagian penutupnya.
- Perbaiki kalimat yang paling lemah, daripada mengubah semua petunjuk sekaligus. Simpan versi yang sudah disetujui untuk dijadikan acuan.
- Unduh audio yang telah dipilih, lalu gabungkan dengan materi visual Anda. Jika kampanye tersebut membutuhkan beberapa aset yang saling terkait, GlobalGPT Kanvas membantu mengatur alur kerja kreatif secara keseluruhan.
Mana yang Harus Anda Pilih?
Untuk narasi yang rapi yang nantinya akan Anda periksa dan sunting, mulailah dengan Eleven v4. Fokus resminya mencakup narasi, pengembangan karakter, dan konten akhir yang ekspresif. Untuk asisten yang berbicara saat percakapan berlangsung, mulailah dengan v4 Turbo dan ujilah melalui jalur streaming yang akan benar-benar digunakan oleh aplikasi Anda.
Bagi seorang kreator yang sedang membuat sebuah karya konten secara utuh, pilihan yang lebih baik biasanya adalah alur kerja yang memungkinkan naskah, suara, dan visual diselesaikan secara bersamaan. Cobalah alur kerja audio di GlobalGPT, mulailah dengan naskah singkat, lalu pilih hasil rekaman akhir Anda dengan mendengarkannya dalam konteks di mana rekaman tersebut akan digunakan.
Pertanyaan yang Sering Diajukan
Apakah Eleven v4 lebih baik daripada v4 Turbo?
Eleven v4 adalah titik awal yang tepat untuk menghasilkan narasi yang ekspresif dan sempurna. v4 Turbo mengutamakan ucapan real-time yang responsif. Pilihlah sesuai dengan kebutuhan Anda: apakah Anda memerlukan file audio yang telah direvisi atau percakapan langsung, lalu uji naskah dan suara Anda.
Seberapa cepat Eleven v4 Turbo?
ElevenLabs melaporkan latensi inferensi median sekitar 100 ms dalam dokumentasi modelnya dan waktu median hingga ucapan pertama sekitar 150 ms dalam laporan peluncurannya. Kedua pengukuran ini berbeda. Jaringan, penyimpanan sementara, dan pemutaran turut menambah penundaan yang dialami pengguna.
Apakah kedua model tersebut mendukung bahasa yang sama?
ElevenLabs menyebutkan bahwa rangkaian v4 mendukung lebih dari 90 bahasa. Uji nama, aksen, dan cara penyampaiannya dalam bahasa tertentu yang akan Anda gunakan untuk penerbitan.
Apakah v4 Turbo bisa menghasilkan dialog yang melibatkan beberapa pembicara?
Periksa antarmuka, jangan hanya mengandalkan deskripsi keluarga saja. Panduan Realtime v4 Turbo hanya mendaftarkan satu suara, sedangkan referensi dialog REST dapat menerima hingga sepuluh ID suara yang berbeda. Petunjuk pembicara dalam prompt biasa tidak sama dengan penetapan suara secara eksplisit.
Apakah ada cara gratis untuk mencoba ElevenLabs?
ElevenLabs menawarkan paket gratis dengan 10.000 kredit per bulan. Akses ke model, aturan penggunaan, dan hak komersial bergantung pada paket yang sedang berlaku. Saldo kredit gratis tidak menjamin bahwa semua fitur v4 tersedia.
Apakah saya bisa menggunakan GlobalGPT untuk seluruh alur kerja sulih suara video?
Ya. GlobalGPT menggabungkan model penulisan, audio, gambar, dan video ke dalam satu ruang kerja berlangganan, sehingga Anda dapat mengembangkan naskah dan aset pendukungnya secara bersamaan. Periksa sulih suara yang dipilih dan hasil edit akhir Anda sebelum dipublikasikan.