
The OpenAI API สำหรับเสียงและคำพูด แปลงข้อความเป็นเสียงพูดผ่าน โพสต์https://api.openai.com/v1/audio/speech. ส่งโมเดล ข้อความต้นทาง และเสียงของคุณ; บันทึกคำตอบเป็นไฟล์ MP3 หรือรูปแบบเสียงอื่นที่รองรับ สำหรับการผสานระบบใหม่ที่ต้องการคำแนะนำเกี่ยวกับน้ำเสียงและวิธีการพูด ให้เริ่มด้วย gpt-4o-mini-tts.
คำขอทำงานเป็นเพียงขั้นตอนแรกเท่านั้น คุณยังจำเป็นต้องมีหน่วยคิดค่าบริการที่เหมาะสม ไฟล์ผลลัพธ์ที่สามารถเล่นได้ และแผนการจัดการสำหรับสคริปต์ที่ยาว โมเดล TTS รุ่นใหม่ของ OpenAI ใช้โทเคนข้อความและโทเคนเสียงในการกำหนดราคา ส่วนโมเดล TTS รุ่นเก่าใช้ตัวอักษร ความแตกต่างนี้มีความสำคัญเมื่อคุณประมาณการค่าใช้จ่ายสำหรับการบรรยายเสียงในหนึ่งเดือน.
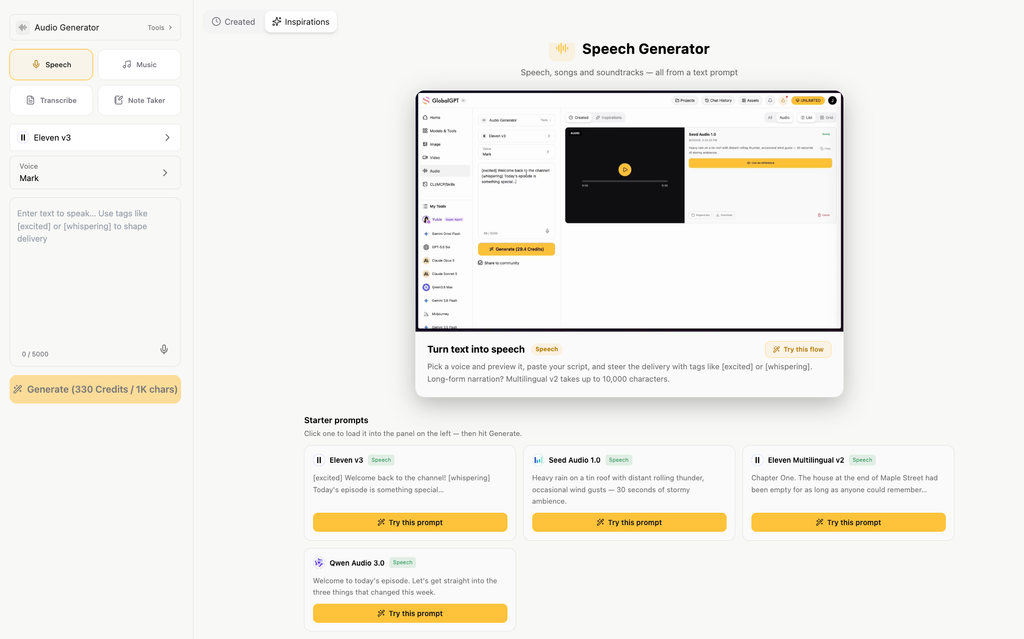
หากงานของคุณยังรวมถึงการเขียนบท การสร้างภาพ และการตัดต่อวิดีโอด้วย, พื้นที่ทำงานด้านเสียงของ GlobalGPT นำระบบสร้างเสียงพูดมาสู่แพลตฟอร์มสมัครสมาชิกแบบหลายโมเดลที่มีราคาไม่แพง คุณสามารถทำงานกับข้อความ เสียง ภาพ และวิดีโอได้ทั้งหมดในแดชบอร์ดเดียว จากนั้นใช้ API และ CLI ของแพลตฟอร์มนี้เพื่อทำงานผลิตซ้ำได้อย่างมีประสิทธิภาพ API TTS สาธารณะของแพลตฟอร์มนี้ใช้กระบวนการทำงานแบบแยกต่างหาก ซึ่งจะอธิบายไว้ด้านล่าง.
API เสียงและคำพูด OpenAI มีหน้าที่อะไร?
Speech API เป็นจุดปลายทางสำหรับการแปลงข้อความเป็นเสียงพูด: แอปพลิเคชันของคุณจะส่งข้อความที่เขียนไว้ และรับเสียงพูดที่สร้างขึ้น การใช้งานทั่วไป ได้แก่ การแนะนำผลิตภัณฑ์ การบรรยายเพื่อความสะดวกในการเข้าถึง เนื้อหาการเรียนรู้ และเสียงบรรยายสั้นๆ คุณสามารถควบคุมข้อความก่อนที่จะถูกอ่านออกเสียง ซึ่งทำให้มีประโยชน์เมื่อข้อความต้องเป็นไปตามบทที่ได้รับการอนุมัติ.
สำหรับการแปลงเสียงเป็นข้อความ ทิศทางจะกลับกัน: เสียงที่บันทึกไว้ถูกป้อนเข้า และข้อความถูกส่งออก ผู้ช่วยเสียงแบบเรียลไทม์เพิ่มข้อกำหนดอีกข้อหนึ่ง—การฟังและตอบกลับผ่านการสนทนา OpenAI’s เอกสารเสียง แยกกระบวนการทำงานเหล่านี้ออกจากกัน ให้เลือกจุดปลายทาง Speech เมื่อคุณมีข้อความที่ต้องการให้อ่านออกเสียงแล้ว.
ระบบสร้างเสียงสนับสนุนการสตรีมมิ่ง ดังนั้นแอปพลิเคชันจึงสามารถรับเสียงเป็นชิ้นๆ ได้ การบันทึกสตรีมดังกล่าวลงในไฟล์จะไม่ทำให้เสียงนั้นเล่นอัตโนมัติในเบราว์เซอร์หรือสร้างเอเจนต์สนทนาได้ แอปพลิเคชันของคุณยังคงต้องจัดการการเล่นเสียงและตรรกะการสนทนาทั้งหมดเอง OpenAI ยังกำหนดให้ต้องแจ้งให้ผู้ฟังทราบอย่างชัดเจนว่าเสียงดังกล่าวถูกสร้างขึ้นโดย AI.
สร้างไฟล์เสียงแรกของคุณด้วย OpenAI Speech API
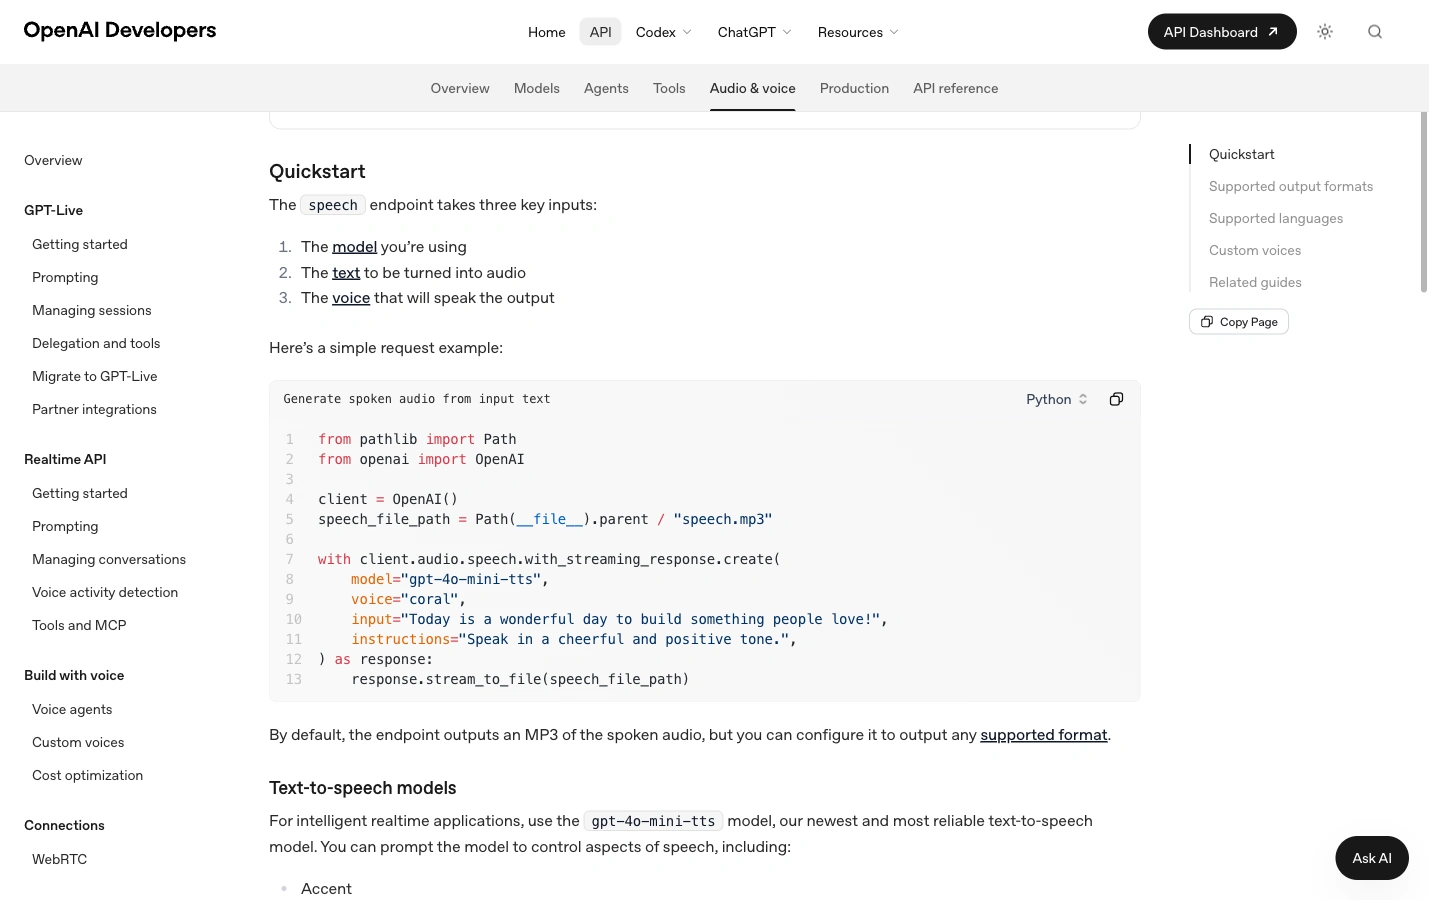
เรียกใช้คำขอนี้บนเซิร์ฟเวอร์หรือเครื่องพัฒนาของคุณ โดยใช้กุญแจ API OpenAI ที่เก็บไว้ใน OPENAI_API_KEY ตัวแปรสภาพแวดล้อม ให้หลีกเลี่ยงการใช้คีย์ใน JavaScript ของเบราว์เซอร์ ตัวอย่างต่อไปนี้ใช้สคริปต์สั้นๆ เดียวกันสำหรับการแนะนำผลิตภัณฑ์ และบันทึกผลลัพธ์เป็น openai-product-tour.mp3.
ตัวเลือก 1: ส่งคำขอแบบ curl
OpenAI Speech API · curl
#!/bin/sh
# ตั้งค่า OPENAI_API_KEY ในสภาพแวดล้อมเซิร์ฟเวอร์ของคุณก่อน
curl --fail-with-body --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "ยินดีต้อนรับสู่การทัวร์ผลิตภัณฑ์ Acorn Studio ในสามขั้นตอน คุณสามารถเปลี่ยนสคริปต์สั้นๆ ให้เป็นคู่มือเสียงได้ ขั้นแรก เขียนข้อความ ขั้นต่อไป เลือกเสียง และสุดท้าย บันทึกไฟล์เสียงและทดสอบการเล่นบนโทรศัพท์ของคุณ",
    "voice": "coral",
    "instructions": "พูดอย่างชัดเจนด้วยน้ำเสียงที่อบอุ่นและเป็นกันเอง.",
    "response_format": "mp3"
  }' \
  --output openai-product-tour.mp3
คำตอบนี้มีไบต์เสียงอยู่ ดังนั้นควรบันทึกมันลงในไฟล์แทนที่จะพยายามวิเคราะห์มันเป็น JSON. The --fail-with-body ตัวเลือกนี้ทำให้ curl ส่งสถานะการออกที่ล้มเหลวเมื่อเกิดข้อผิดพลาด HTTP ตรวจสอบสถานะนั้นก่อนเปิดไฟล์: การตอบกลับที่ผิดพลาดอาจยังคงทิ้งข้อมูล JSON ไว้ในไฟล์ที่มีชื่อว่า .mp3.
ตัวเลือก 2: ใช้ Python SDK
ติดตั้งแพ็กเกจ OpenAI ด้วย python -m pip install openai. SDK จะอ่าน API key จากสภาพแวดล้อม ตัวอย่างนี้เขียนคำตอบลงทันทีที่รับมา ซึ่งช่วยหลีกเลี่ยงการโหลดคำตอบเสียงทั้งหมดเข้าสู่บัฟเฟอร์ Python ของคุณ.
OpenAI Speech API · Python
"""ติดตั้ง: python -m pip install openai. ตั้งค่า OPENAI_API_KEY บนเซิร์ฟเวอร์."""
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
script = (
    "ยินดีต้อนรับสู่การทัวร์ผลิตภัณฑ์ Acorn Studio ในสามขั้นตอน คุณสามารถเปลี่ยน "
    "บทสคริปต์สั้นๆ ให้กลายเป็นคู่มือเสียงได้ ขั้นแรก เขียนข้อความ ขั้นต่อไป "
    "เลือกเสียง และขั้นสุดท้าย บันทึกไฟล์เสียงและทดสอบการเล่นบนโทรศัพท์ของคุณ"
)

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=script,
    instructions="พูดอย่างชัดเจนด้วยน้ำเสียงที่อบอุ่นและเป็นกันเอง.",
    response_format="mp3",
) as response:
    response.stream_to_file(Path("openai-product-tour.mp3"))

print("Saved openai-product-tour.mp3")
สามสนามหลักคือ แบบจำลอง, ข้อมูลเข้า, และ เสียง. ที่นี่, คำแนะนำ ต้องการการส่งเสียงที่อบอุ่นและเป็นธรรมชาติเหมือนการสนทนา; มันช่วยนำทางเสียงแทนที่จะเพิ่มคำเข้าไปในบทพูด ระบบนี้ทำงานร่วมกับ GPT-4o Mini TTS และไม่ได้รับการสนับสนุนจาก tts-1 และ tts-1-hd.
สำหรับเอกสารที่ยาวกว่า ให้แบ่งข้อความตามจุดแบ่งของประโยคหรือย่อหน้า กำหนดหมายเลขให้กับแต่ละส่วน และบันทึกแต่ละส่วนด้วยหมายเลขนั้น รักษาสไตล์การพูดและคำสั่งให้สอดคล้องกันในทุกส่วน ให้มีบริบทเพียงพอเพื่อให้การพูดฟังดูเป็นธรรมชาติ และตรวจสอบการเชื่อมต่อระหว่างส่วนต่าง ๆ ก่อนที่จะแจกจ่ายไฟล์บันทึกที่รวมไว้.
เลือกรุ่น เสียง และรูปแบบผลลัพธ์
| แบบจำลอง | วิธีเลือก | คำแนะนำในการจัดส่ง |
|---|---|---|
gpt-4o-mini-tts | จุดเริ่มต้นสำหรับการเล่าเรื่องและการพูดที่สามารถควบคุมได้. | สนับสนุน คำแนะนำ ในด้านน้ำเสียง สไตล์ และจังหวะ. |
tts-1 | OpenAI ออกแบบโมเดลนี้เพื่อสร้างเสียงพูดที่มีความล่าช้าต่ำ. | ใช้ฟังก์ชันควบคุมด้วยเสียงและความเร็วที่ระบบรองรับ; ละเว้น คำแนะนำ. |
tts-1-hd | OpenAI ทำให้รุ่นนี้มีคุณภาพเสียงที่ดีกว่า TTS-1. | ใช้ฟังก์ชันควบคุมด้วยเสียงและความเร็วที่ระบบรองรับ; ละเว้น คำแนะนำ. |
The หน้าแบบ Mini TTS GPT-4o กำหนด alias ของโมเดลไปยัง gpt-4o-mini-tts-2025-12-15 snapshot. หากพฤติกรรมที่สามารถทำซ้ำได้มีความสำคัญต่อแอปพลิเคชันของคุณ ให้เลือก snapshot ที่มีเอกสารบันทึกไว้อย่างตั้งใจ และบันทึกมันไว้พร้อมกับสคริปต์ที่เก็บไว้.
เสียงที่ติดตั้งมาพร้อมเครื่องและขีดจำกัดการป้อนข้อมูล
คู่มืออ้างอิงของ Speech API ระบุว่ามีเสียงในตัว 13 เสียงสำหรับ GPT-4o Mini TTS: อัลลอย, แอช, บัลลาด, คอรัล, เอคโค่, ฟาเบิล, ออนิกซ์, โนวา, เซจ, ชิมเมอร์, เวอร์ส, มาริน, และ ซีดาร์. OpenAI แนะนำว่า มาริน หรือ ซีดาร์ เพื่อคุณภาพที่ดีที่สุด นี่คือคำแนะนำจาก OpenAI: ให้เลือกเสียงในการผลิตโดยฟังชื่อ ตัวเลข และรูปแบบประโยคของคุณเอง.
รุ่น TTS ที่ออกมาก่อนหน้านั้นรองรับชุดเสียงที่น้อยกว่า ได้แก่ alloy, ash, coral, echo, fable, onyx, nova, sage และ shimmer อย่าคิดว่าเสียงทุกเสียงจะใช้งานได้กับทุกรุ่น คู่มือ API Speech ยังรับค่าความเร็วในช่วงระหว่าง 0.25 และ 4.0, พร้อมด้วย 1.0 เป็นค่าเริ่มต้น.
มีสองขีดจำกัดการป้อนข้อมูลที่ต้องพิจารณา: ขีดจำกัดอ้างอิงของจุดสิ้นสุด ข้อมูลเข้า ถึง 4,096 ตัวอักษร, และหน้าข้อมูลรุ่น Mini TTS ระบุไว้ว่าสูงสุดคือ 2,000 โทเคนข้อมูลเข้า. ตัวอักษรและโทเคนมีหน่วยวัดที่แตกต่างกัน โปรดตรวจสอบข้อจำกัดทั้งสองของ Mini TTS โดยเฉพาะอย่างยิ่งเมื่อใช้ข้อความหลายภาษา และแบ่งสคริปต์ที่มีขนาดใหญ่ก่อนส่ง.
เลือกรูปแบบไฟล์สำหรับจุดหมายปลายทาง
| รูปแบบ | การใช้งานจริง |
|---|---|
| MP3 | ผลลัพธ์ตามค่าเริ่มต้น; ไฟล์ที่ถูกบีบอัดอย่างสะดวกสำหรับการแบ่งปันและเล่นบนเว็บ. |
| โอปัส | มีประโยชน์สำหรับแอปพลิเคชันสตรีมมิ่งและการสื่อสารที่รองรับโค้ดนี้. |
| AAC | พิจารณาว่าเมื่อใดที่สภาพแวดล้อมการเล่นหรือกระบวนการทำงานกับสื่อของคุณต้องการใช้ AAC. |
| FLAC | การบีบอัดแบบไม่สูญเสียข้อมูล สำหรับกระบวนการทำงานที่จำเป็นต้องรักษาสัญญาณเสียงไว้. |
| WAV | ไฟล์เสียงที่ไม่ถูกบีบอัด ในรูปแบบไฟล์ที่คุ้นเคย เพื่อการแก้ไขและประมวลผล. |
| PCM | ตัวอย่างเสียงแบบดิบ 24 kHz, 16 บิต แบบมีเครื่องหมาย (signed) และจัดเรียงแบบ little-endian โดยไม่มีส่วนหัวไฟล์; เครื่องเล่นของคุณจำเป็นต้องใช้การตั้งค่าดังกล่าว. |
เริ่มด้วย MP3 หากต้องการลิงก์ดาวน์โหลดหรือเครื่องเล่นเสียงแบบง่ายๆ ให้เลือก WAV เมื่อขั้นตอนต่อไปคือการแก้ไข ให้เลือก PCM แบบดิบเฉพาะเมื่อโปรแกรมของคุณสามารถตีความได้; การเปลี่ยนชื่อไฟล์จาก .pcm ถึง .wav ไม่สร้างส่วนหัว WAV.
ค่าบริการของ API เสียง OpenAI เป็นเท่าใด?
ตามข้อมูลที่ตรวจสอบเมื่อวันที่ 28 กันยายน 2569 OpenAI ได้ระบุ GPT-4o Mini TTS ไว้ที่ $0.60 ต่อหนึ่งล้านโทเคนข้อความที่ป้อนเข้า บวก $12 ต่อหนึ่งล้านโทเคนสัญญาณเสียง. ราคาของ TTS-1 $15 ต่อหนึ่งล้านตัวอักษร, และ TTS-1 HD มีราคา $30 ต่อหนึ่งล้านตัวอักษร. คำนวณแต่ละโมเดลด้วยหน่วยวัดของตัวเอง.
ราคาของ Speech API: ให้แยกหน่วยวัดไว้ต่างกัน
OpenAI คำนวณค่าบริการสำหรับรุ่น TTS ที่ใหม่กว่าตามจำนวนโทเคน ส่วนรุ่น TTS สองรุ่นก่อนหน้าคำนวณตามจำนวนตัวอักษร ส่วน GlobalGPT ระบุจำนวนเครดิตสำหรับงาน TTS.
| เส้นทางและรุ่น | ให้คะแนน | ตัวอย่าง |
|---|---|---|
| OpenAI · GPT-4o Mini TTS | $0.60 / 1M โทเคนข้อมูลข้อความ $12 / โทเคนสัญญาณเสียง 1M | $0.0606 สำหรับ 1,000 โทเคนข้อมูลเข้าแบบข้อความ + 5,000 โทเคนข้อมูลออกแบบเสียง |
| OpenAI · TTS-1 | $15 / 1M ตัวอักษร | $0.015 สำหรับ 1,000 ตัวอักษร |
| OpenAI · TTS-1 HD | $30 / 1M ตัวอักษร | $0.030 สำหรับ 1,000 ตัวอักษร |
| GlobalGPT · Eleven v3, Eleven Multilingual v2 หรือ Qwen Audio 3.0 TTS Flash | 330 เครดิต / 1,000 ตัวอักษร | 330 เครดิต ตามอัตรา 1,000 ตัวอักษรที่ระบุไว้; ขอรับการประเมินราคาก่อนส่ง |
นี่เป็นตัวอย่างราคาเท่านั้น ไม่ใช่ค่าบริการจากตัวอย่างเสียงด้านล่าง โทเคน ตัวอักษร นาที และเครดิต เป็นหน่วยวัดที่แตกต่างกัน การประมาณการงาน GlobalGPT ระบุจำนวนเครดิตที่จำเป็น; ตารางนี้ไม่แปลงเครดิตเป็นดอลลาร์.
ราคาตรวจสอบเมื่อวันที่ 28 กันยายน 2569 แหล่งข้อมูล: ราคา API OpenAI และ เอกสาร API ของ GlobalGPT.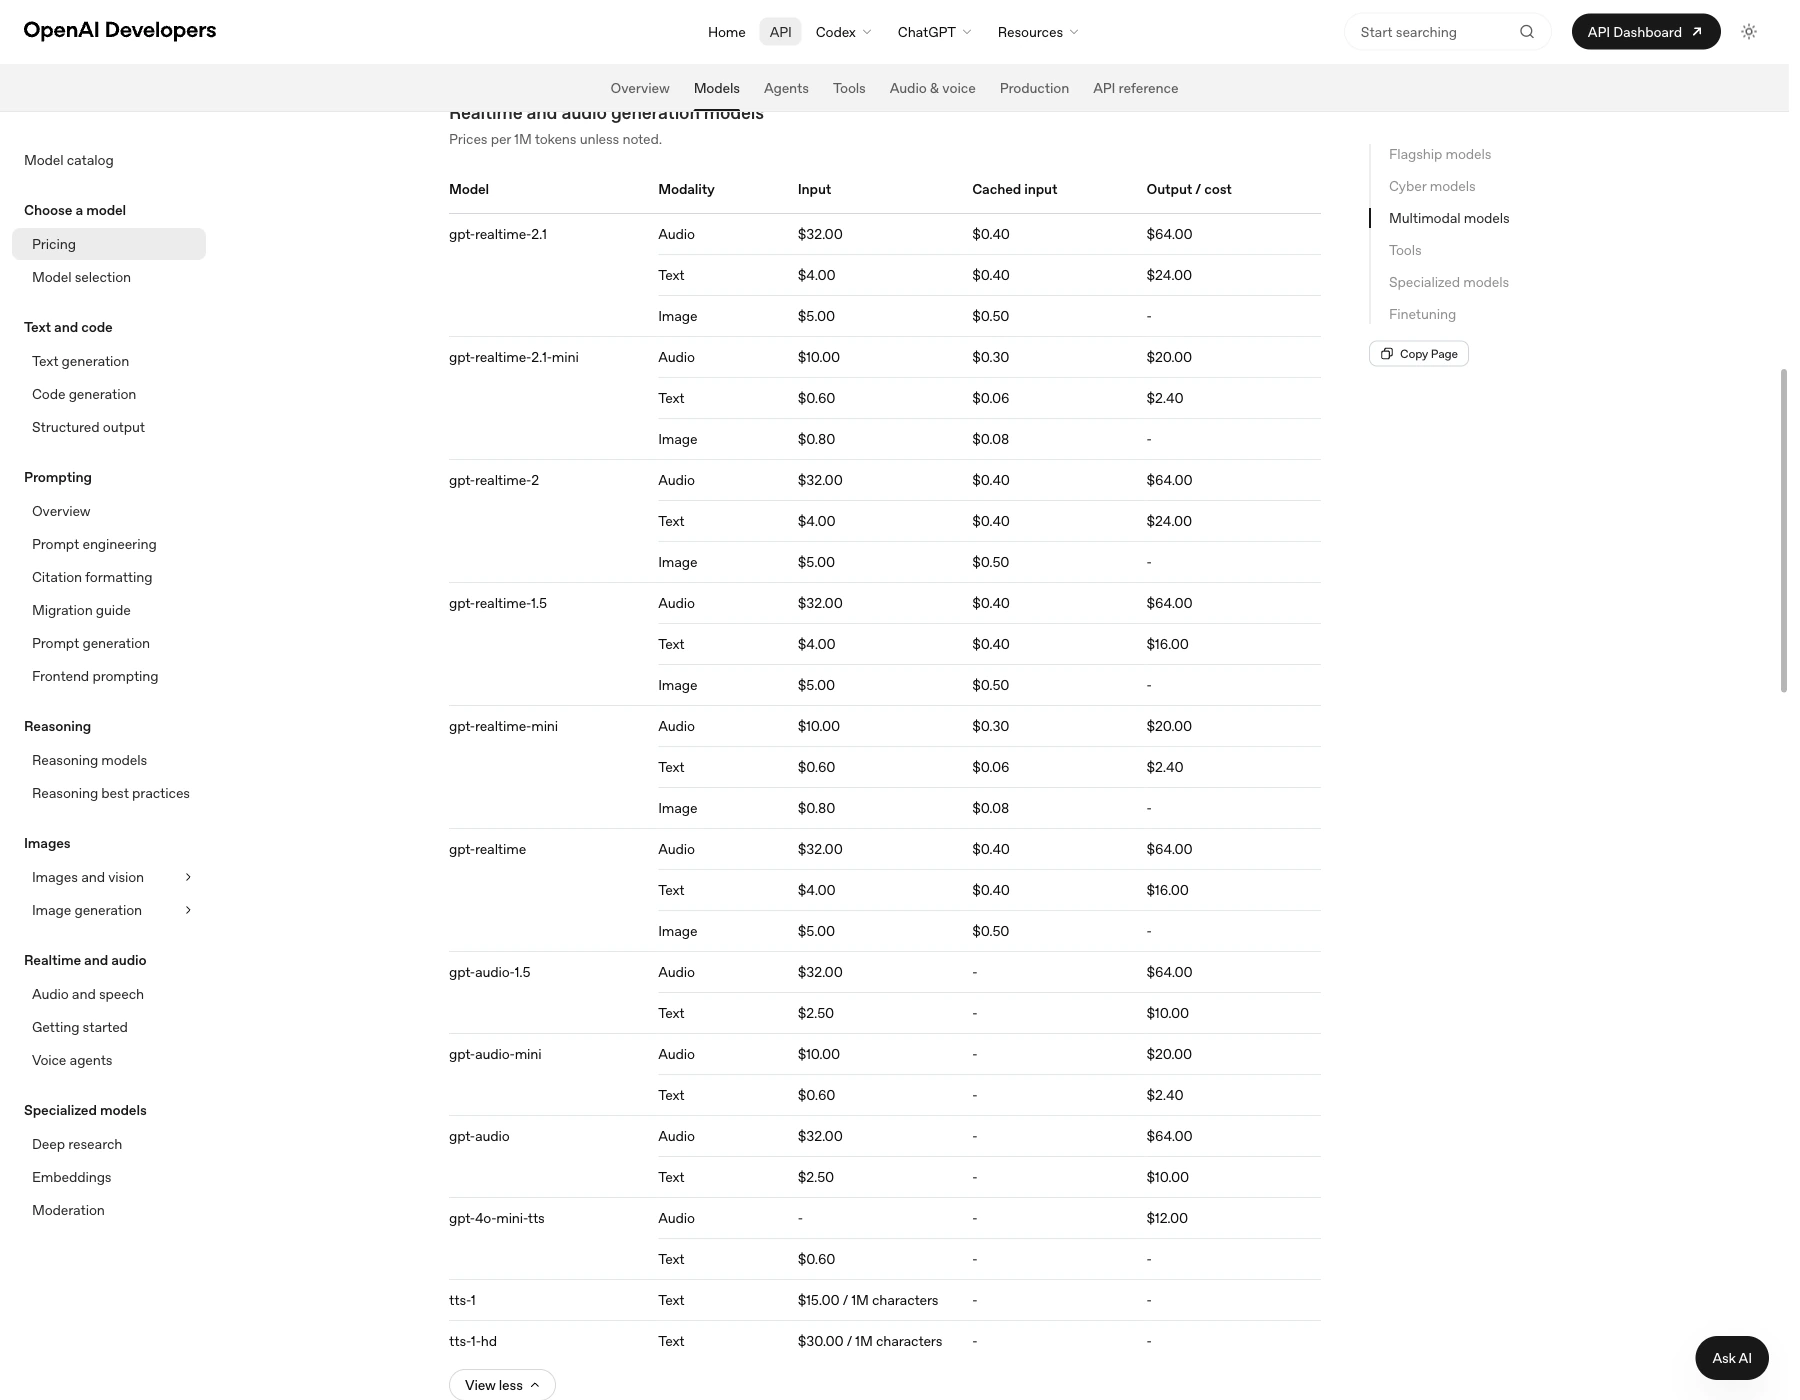
ตัวอย่างเช่น สคริปต์ 100 ฉบับ แต่ละฉบับมี 1,000 ตัวอักษร รวมเป็น 100,000 ตัวอักษร ตามอัตราที่ระบุไว้ นั่นคือ $1.50 พร้อม TTS-1 หรือ $3.00 พร้อม TTS-1 HD, ก่อนค่าใช้จ่ายอื่นๆ ของแอปพลิเคชัน จำนวนตัวอักษรเท่ากันนี้ไม่เพียงพอที่จะคำนวณ Mini TTS ได้อย่างแม่นยำ: คุณจำเป็นต้องมีจำนวนโทเคนของข้อความที่ป้อนเข้าและจำนวนโทเคนของเสียงที่ออก.
ประมาณค่าใช้จ่ายในการสร้างเสียงพูด
ป้อนหน่วยที่เส้นทางที่คุณเลือกใช้คิดค่าบริการ ไม่มีการแปลงอัตโนมัติจากตัวอักษรเป็นโทเคน หรือจากนาทีเป็นโทเคน.
สูตร: จำนวนตัวอักษร × $15 ÷ 1,000,000. ปริมาณข้อความรวมอาจครอบคลุมหลายคำขอ API.
ราคาที่ตรวจสอบเมื่อวันที่ 28 กันยายน 2569: โอเพ่นเอไอ · โกลบอลจีพีที. ไม่รวมค่าเก็บข้อมูล ค่าบริการโฮสติ้ง ภาษี และส่วนอื่นๆ ของแอปพลิเคชันของคุณ.
เพื่อวางแผน ให้ป้อนจำนวนการใช้งานจริงหรือสมมติฐานที่ชัดเจนลงในเครื่องคำนวณ ให้ถือว่าช่อง Mini TTS audio-token เป็นข้อมูลป้อนเข้าสำหรับงบประมาณ จนกว่าจะมีการวัดปริมาณการใช้งานแล้ว อย่าใช้ตัวเลขประมาณการต่อนาทีมาแทนที่ราคาที่รับประกันสำหรับทุกเสียง ความเร็วการพูด หรือภาษา.
แคตตาล็อกรุ่น GlobalGPT แสดงราคา TTS ในรูปเครดิต และจุดสิ้นสุดการประมาณการจะให้ราคาเสนอสำหรับคำขอที่คุณตั้งใจจะส่ง โปรดแยกการใช้เครดิต API ออกจาก việcเลือกการสมัครสมาชิกพื้นที่ทำงานแบบหลายโมเดล สำหรับงานเขียนและงานสื่อประจำวัน สิ่งนี้ช่วยให้การติดตามงบประมาณง่ายขึ้น โดยไม่ต้องสมมติว่าผลิตภัณฑ์ทั้งสองใช้โควตาการเรียกเก็บเงินร่วมกัน.
สร้างกระบวนการทำงาน TTS ด้วย API GlobalGPT
เพื่อสร้างกระบวนการทำงานที่สามารถทำซ้ำได้ตั้งแต่สคริปต์ ไปสู่เสียง และสู่วิดีโอ, สร้างข้อความใน GlobalGPT และเก็บส่วนที่เหลือของโครงการไว้ในพื้นที่ทำงานเดียวกัน ส่วน API GlobalGPT แสดงให้เห็นว่าสื่อมวลชนถูกมองเป็นเพียงงาน ในขณะที่ GlobalGPT CLI การเชื่อมต่อที่ทำงานร่วมกับเทอร์มินัลและเครื่องมือพัฒนาของคุณ.
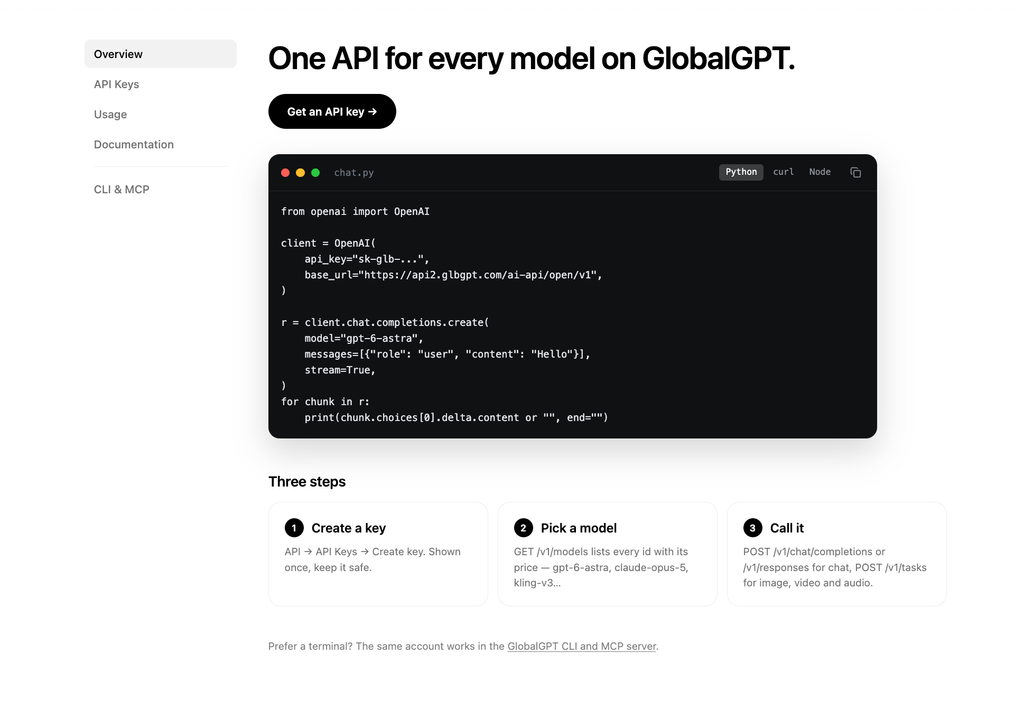
ใช้ URL ฐานข้อมูลสาธารณะ https://api2.glbgpt.com/ai-api/open/v1. ส่งคำขอ TTS ไปที่ POST /tasks, สอบถาม GET /tasks/{id}, และดาวน์โหลด output.url หลังจากที่งานเสร็จสิ้นแล้ว ช่องข้อความคือ คำสั่ง. ดำเนินการตามสัญญาการทำงานนี้โดยตรง; ซึ่งแตกต่างจากระบบตอบสนองเสียงทันทีของ OpenAI.
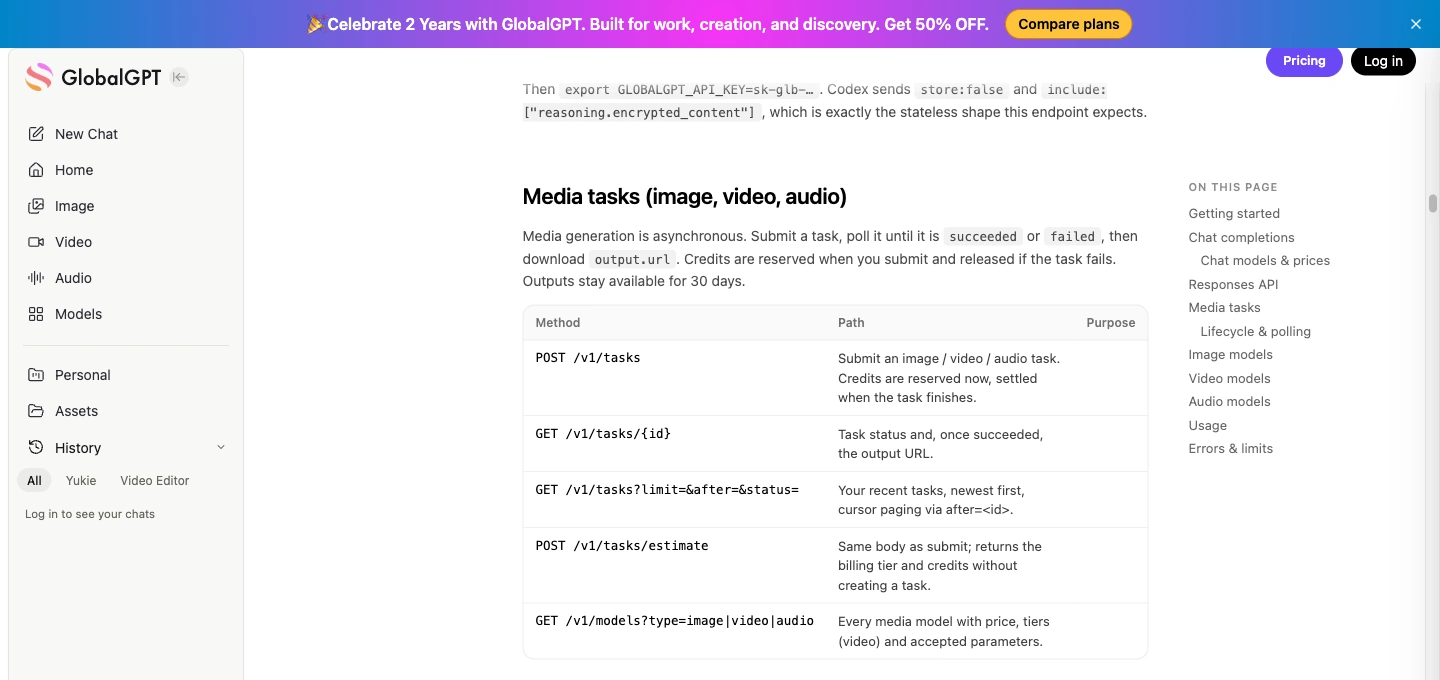
เลือกโมเดล TTS GlobalGPT ที่มีเอกสารประกอบ
| รหัสแบบ | ข้อมูลเข้าและข้อมูลออก | การแบ่งประเภทที่มีประโยชน์ |
|---|---|---|
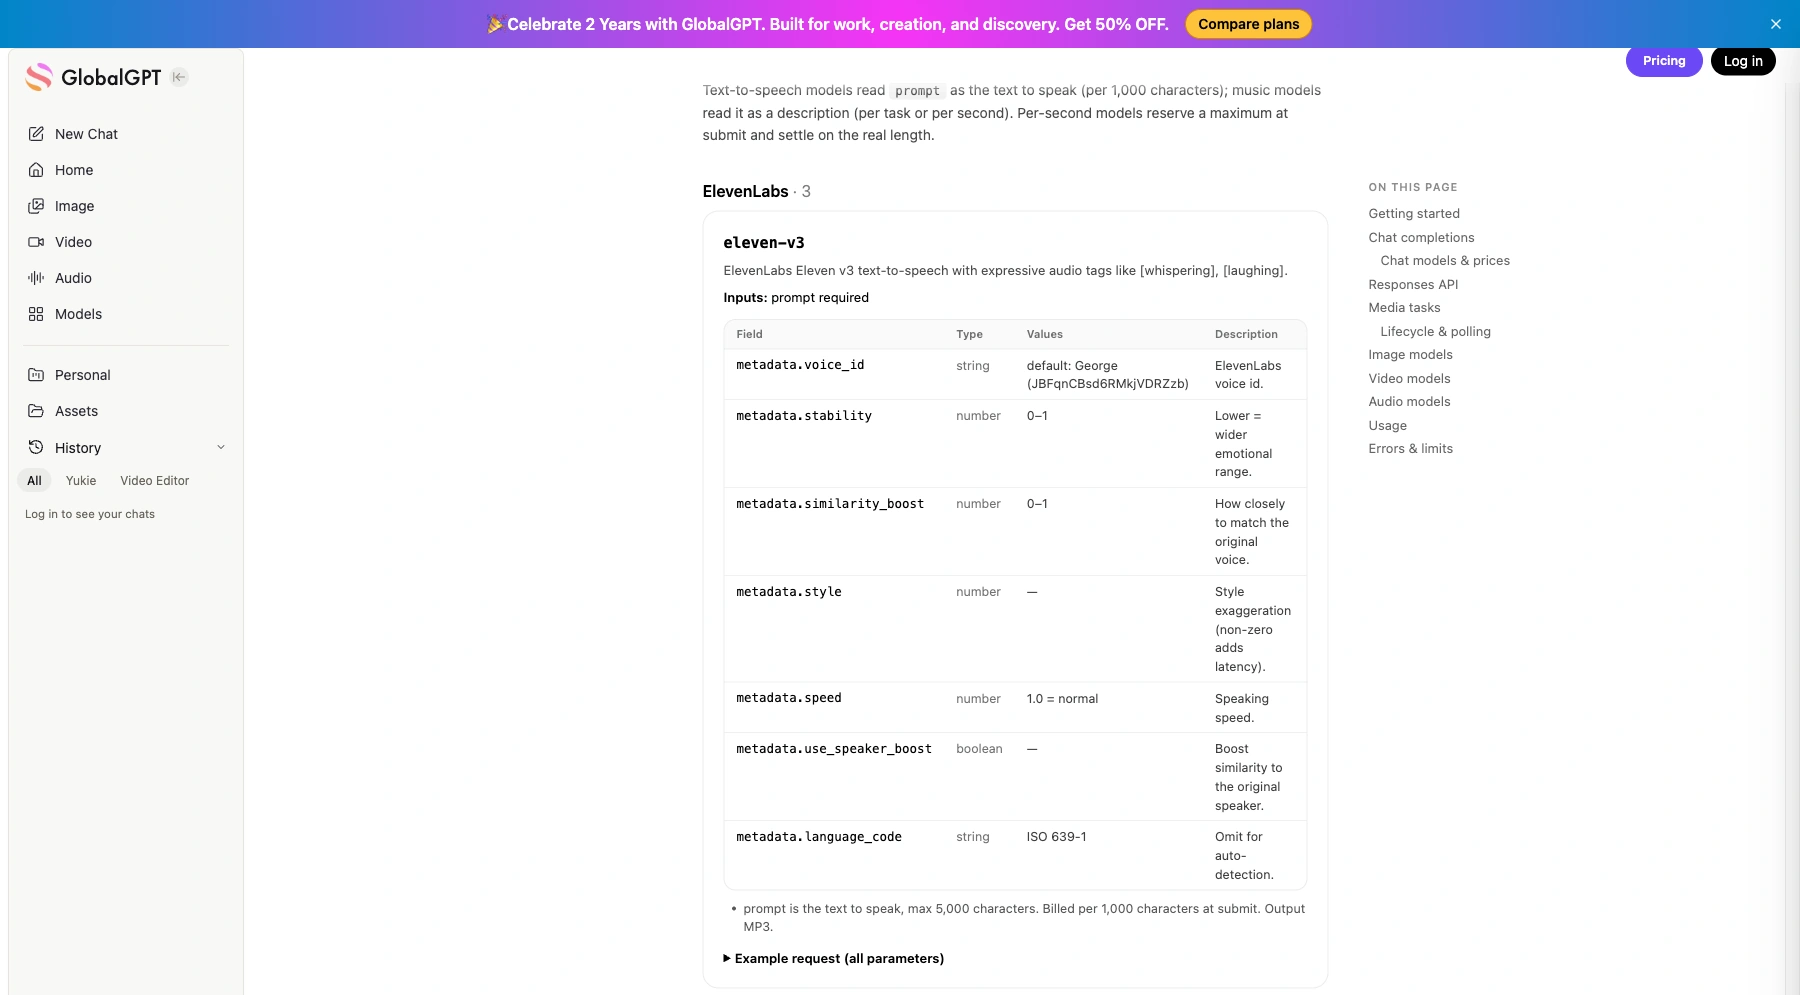
eleven-v3 | สูงสุด 5,000 ตัวอักษร; MP3 | รองรับแท็กเสียงที่แสดงอารมณ์ได้. |
eleven-multilingual-v2 | สูงสุด 10,000 ตัวอักษร; MP3 | 29 ภาษา; แท็กเสียงจะถูกอ่านเป็นข้อความ. |
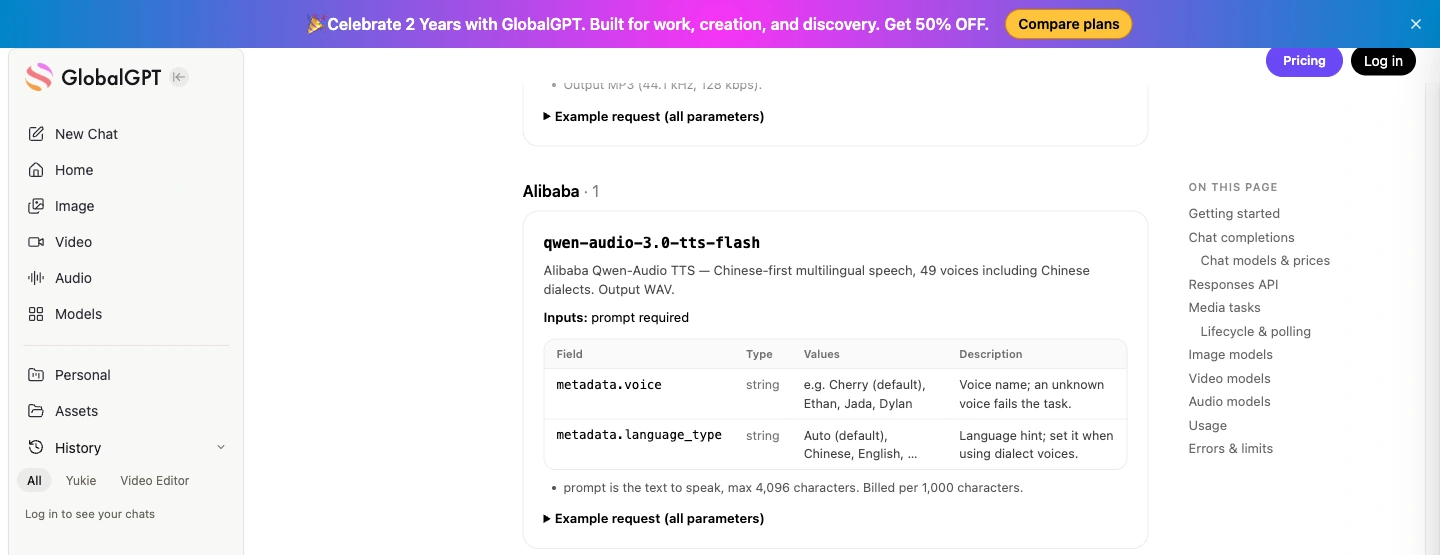
qwen-audio-3.0-tts-flash | สูงสุด 4,096 ตัวอักษร; WAV | 49 เสียง; การควบคุมด้วยเสียงและภาษาใช้ฟิลด์ที่เฉพาะสำหรับ Qwen. |
รายการทั้งสามรายการ 330 เครดิตต่อ 1,000 ตัวอักษร. ใช้ POST /tasks/estimate พร้อมด้วยเนื้อหาคำขอที่ตั้งใจไว้สำหรับใบประมาณการที่เกี่ยวข้อง; เอกสารระบุว่าสิ่งนี้ไม่สร้างงานและไม่สำรองเครดิตไว้ การเข้าถึง API สาธารณะใช้เครดิตที่ชำระแล้ว.
สำหรับกระบวนการทำงานด้านการสร้างเนื้อหาโดยรวม โปรดดู กระบวนการแปลงข้อความเป็นเสียงใน GlobalGPT. หากท่านกำลังศึกษาตระกูลซอฟต์แวร์โอเพนซอร์ส Qwen3-TTS ที่มีชื่อแยกต่างหาก โปรดอ่าน รุ่น Qwen3-TTS และตัวเลือก API; อย่าถือว่า ID รุ่น Qwen-Audio ข้างต้นเป็นการปรับใช้ Qwen3-TTS ที่สามารถใช้แทนกันได้.
ประมาณการ ส่งครั้งเดียว แล้วตรวจสอบงานที่บันทึกไว้
ติดตั้ง คำขอ กับ python -m pip install requests และตั้งค่า GLOBALGPT_API_KEY บนเซิร์ฟเวอร์ ตัวอย่างด้านล่างนี้ใช้ Eleven v3 เลือก ID เสียงสาธารณะที่มีเอกสารประกอบ และกำหนดขีดจำกัดสูงสุดเพื่อแสดงตัวอย่างไว้ที่ 500 เครดิต โปรดปรับเปลี่ยนขีดจำกัดดังกล่าวให้สอดคล้องกับงบประมาณของคุณก่อนที่จะรันโปรแกรม.
API สำหรับงาน TTS สาธารณะ GlobalGPT · Python
"""ติดตั้ง requests; ตั้งค่า GLOBALGPT_API_KEY ใช้ API งานสาธารณะของ GlobalGPT."""
import json
import os
import time
import uuid
from pathlib import Path
import requests

BASE = "https://api2.glbgpt.com/ai-api/open/v1"
STATE = Path("globalgpt-tts-job.json")
OUTPUT = Path("globalgpt-product-tour.mp3")
MAX_CREDITS = 500  # ขีดจำกัดต่องานของคุณ; แก้ไขก่อนการรัน

payload = {
    "model": "eleven-v3",
    "prompt": (
 "ยินดีต้อนรับสู่การทัวร์ผลิตภัณฑ์ Acorn Studio. ในสามขั้นตอน คุณสามารถเปลี่ยน "
 "บทสคริปต์สั้นๆ ให้กลายเป็นคู่มือเสียงได้ ก่อนอื่น ให้เขียนข้อความ จากนั้น "
 "เลือกเสียง สุดท้าย ให้บันทึกไฟล์เสียงและทดสอบการเล่นบนโทรศัพท์ของคุณ"
    ),
    "metadata": {
 "voice_id": "JBFqnCBsd6RMkjVDRZzb",
 "stability": 0.5,
 "language_code": "en",
    },
}

api = requests.Session()
api.headers["Authorization"] = "Bearer " + os.environ["GLOBALGPT_API_KEY"]

if STATE.exists():
    job = json.loads(STATE.read_text())
    if job["payload"] != payload:
 raise RuntimeError("งานนี้เกี่ยวข้องกับข้อมูลเข้าที่ต่างกัน โปรดใช้ชื่อไฟล์สถานะใหม่")
else:
    estimate = api.post(BASE + "/tasks/estimate", json=payload, timeout=30)
    estimate.raise_for_status()
    quote = estimate.json()
    print("เครดิตที่ประมาณการ:", quote["credits"])
    if quote["credits"] > MAX_CREDITS:
 raise RuntimeError("การประมาณค่าเกินขีดจำกัดต่องานของคุณแล้ว")
    job = {"payload": payload, "idempotency_key": str(uuid.uuid4())}
    STATE.write_text(json.dumps(job, indent=2))

if "task_id" not in job:
    # คีย์ที่เก็บถาวรจะเก็บการลองส่งข้อมูลใหม่ (transport retry) ที่ผูกกับคำขอนี้โดยเฉพาะ
    submitted = api.post(
 BASE + "/tasks", json=payload,
 headers={"Idempotency-Key": job["idempotency_key"]}, timeout=60,
    )
    submitted.raise_for_status()
    task = submitted.json()
    job["task_id"] = task["id"]
    STATE.write_text(json.dumps(job, indent=2))
    if task.get("ignored_parameters"):
 print("พารามิเตอร์ที่ถูกเพิกเฉย:", task["ignored_parameters"])

print("งาน:", job["task_id"])
deadline = time.monotonic() + 600
while time.monotonic() < deadline:
    checked = api.get(BASE + "/tasks/" + str(job["task_id"]), timeout=30)
    checked.raise_for_status()
    task = checked.json()
    if task.get("ignored_parameters"):
 print("พารามิเตอร์ที่ถูกเพิกเฉย:", task["ignored_parameters"])
    if task["status"] == "failed":
 raise RuntimeError("Generation failed: " + json.dumps(task.get("error", {})))
    if task["status"] == "succeeded":
        # ใช้คำขอใหม่: ไม่ส่ง API key ไปยัง media host
 audio = requests.get(task["output"]["url"], timeout=60)
 audio.raise_for_status()
        OUTPUT.write_bytes(audio.content)
 print("บันทึกแล้ว:", OUTPUT)
 break
    time.sleep(10)
else:
    raise TimeoutError("งานยังอยู่ระหว่างดำเนินการ โปรดรันใหม่เพื่อตรวจสอบ ID งานที่บันทึกไว้")
ไฟล์งานจะบันทึกคำขอที่แม่นยำ คีย์ความคงที่ (idempotency key) และ ID ของงาน หากการเชื่อมต่อถูกตัดขาด ให้รันงานเดียวกันอีกครั้ง เพื่อให้โค้ดสามารถดำเนินการต่อจากงานที่มีอยู่ได้ หากต้องการสร้างเสียงที่แตกต่างกันโดยตั้งใจ ให้ใช้ชื่อไฟล์งานใหม่ และควรเก็บไฟล์งานไว้เป็นส่วนตัว หากสคริปต์ในไฟล์นั้นมีข้อมูลลับ.
ตรวจสอบ พารามิเตอร์ที่ถูกเพิกเฉย ดังนั้น การตั้งค่าที่ไม่ได้รับการสนับสนุนจะไม่ถูกกำหนดเป็นการตั้งค่าเริ่มต้นของคุณโดยอัตโนมัติ การควบคุม ElevenLabs เช่น voice_id แตกต่างจากของ Qwen เสียง และ ประเภทภาษา สนามข้อมูล ตรวจสอบทุก 5–10 วินาที จัดการกับ ล้มเหลว สถานะ และบันทึกไฟล์ที่บันทึกสำเร็จทันที: การเก็บรักษาผลลัพธ์ที่บันทึกไว้คือ 30 วัน.
ฟังตัวอย่างการนำชมผลิตภัณฑ์สองตัวอย่าง
ตัวอย่างทั้งสองนี้ที่สร้างขึ้นด้วย AI ใช้สคริปต์การแนะนำผลิตภัณฑ์เดียวกันที่มีความยาว 216 ตัวอักษร โดยใช้ Eleven v3 และ Qwen Audio 3.0 TTS Flash แต่ละตัวอย่างเป็นผลลัพธ์แรกจากการร้องขอครั้งเดียว โดยใช้การตั้งค่าเสียงตามค่าเริ่มต้น คุณจะได้รับไฟล์สั้นสองไฟล์เพื่อตรวจสอบและฟังตัวอย่าง; ตัวอย่างเหล่านี้ไม่ใช่การเปรียบเทียบที่ควบคุมอย่างละเอียดระหว่างเสียงที่ตรงกัน หรือการวัดประสิทธิภาพเสียงของ OpenAI.
Eleven v3: เสียงนำชมผลิตภัณฑ์
eleven-v3 · ตัวอย่างการแนะนำผลิตภัณฑ์
- ผลลัพธ์
- MP3 · โมโน · 44.1 kHz
- ความยาว
- ประมาณ 15.6 วินาที
- เจเนอเรชั่น
- ผลลัพธ์แรก · 1 คำขอ
การตั้งค่า: ข้อความที่ระบุไว้ด้านล่างนี้อย่างถูกต้อง พร้อมด้วยเสียงมาตรฐานและตั้งค่าอื่นๆ; ไม่มีการเปลี่ยนเสียงหรือคำสั่งการส่งข้อความ เสียงมาตรฐานไม่ได้ถูกบันทึกไว้.
สถานะและกำหนดเวลา: การประมวลผลสำเร็จแล้ว ข้อมูลเวลาบนเซิร์ฟเวอร์ของงานแสดงว่าใช้เวลา 13 วินาที ตั้งแต่ส่งคำขอจนถึงเสร็จสิ้น; นี่เป็นคำขอเดียว ไม่ใช่การวัดค่าความล่าช้า.
การสังเกตไฟล์: ไฟล์ MP3 นี้มีสตรีมเสียงโมโนที่ความถี่ 44.1 kHz และมีขนาดประมาณ 251 kB สามารถอ่านเฟรมของไฟล์นี้ได้จนถึงส่วนท้ายของไฟล์.
ข้อมูลอ้างอิงเกี่ยวกับค่าใช้จ่าย: อัตราค่าบริการสำหรับแคตตาล็อกสาธารณะคือ 330 เครดิตต่อ 1,000 ตัวอักษร โปรดใช้การประมาณการงานสำหรับคำขอใหม่; อัตรานี้ไม่ใช่ใบแจ้งหนี้สำหรับตัวอย่าง.
การใช้งานจริง: ไฟล์ MP3 ขนาดเล็ก สำหรับการฟังตัวอย่างวิดีโอแนะนำผลิตภัณฑ์สั้นๆ โปรดตรวจสอบเนื้อหาและคุณภาพเสียงอย่างละเอียดบนอุปกรณ์เป้าหมายก่อนนำไปใช้ในเวอร์ชันที่ปล่อยออกสู่สาธารณะ.
อ่านข้อมูลที่ป้อนเข้ามาอย่างถูกต้อง · 216 ตัวอักษร
ยินดีต้อนรับสู่การทัวร์ผลิตภัณฑ์ Acorn Studio ด้วยเพียงสามขั้นตอน คุณก็สามารถเปลี่ยนบทพูดสั้นๆ ให้กลายเป็นคู่มือเสียงได้ ขั้นแรก ให้เขียนข้อความ ขั้นต่อไป ให้เลือกเสียง และขั้นสุดท้าย ให้บันทึกไฟล์เสียงและทดสอบการเล่นบนโทรศัพท์ของคุณ.
Qwen Audio 3.0 TTS Flash: เสียงแนะนำผลิตภัณฑ์
qwen-audio-3.0-tts-flash · ตัวอย่างการแนะนำผลิตภัณฑ์
- ผลลัพธ์
- WAV · โมโน · 24 kHz
- ความยาว
- ข้อมูล PCM 15.52 วินาที
- เจเนอเรชั่น
- ผลลัพธ์แรก · 1 คำขอ
การตั้งค่า: ข้อความที่ระบุไว้ด้านล่างนี้อย่างถูกต้อง พร้อมด้วยเสียงมาตรฐานและตั้งค่าอื่นๆ; ไม่มีการเปลี่ยนเสียงหรือคำสั่งการส่งข้อความ เสียงมาตรฐานไม่ได้ถูกบันทึกไว้.
สถานะและกำหนดเวลา: การประมวลผลสำเร็จแล้ว ตามข้อมูลเวลาบนเซิร์ฟเวอร์ของงานนี้ แสดงว่าใช้เวลา 17 วินาที ตั้งแต่ส่งคำขอจนถึงเสร็จสิ้น; นี่เป็นคำขอเดียว ไม่ใช่การวัดค่าความล่าช้า.
การสังเกตไฟล์: ไฟล์ WAV นี้มีรูปแบบเสียงโมโน PCM 16 บิต ที่ความถี่ 24 kHz และมีขนาดประมาณ 745 kB ส่วนส่วนหัวของไฟล์ระบุว่ามีข้อมูลมากกว่าที่ไฟล์จริงมีอยู่; ผลลัพธ์ต้นฉบับถูกรักษาไว้ที่นี่.
ข้อมูลอ้างอิงเกี่ยวกับค่าใช้จ่าย: อัตราค่าบริการสำหรับแคตตาล็อกสาธารณะคือ 330 เครดิตต่อ 1,000 ตัวอักษร โปรดใช้การประมาณการงานสำหรับคำขอใหม่; อัตรานี้ไม่ใช่ใบแจ้งหนี้สำหรับตัวอย่าง.
การใช้งานจริง: ตัวอย่างไฟล์ WAV สำหรับการประเมินกระบวนการทำงานของการบรรยาย แก้ไขปัญหาความไม่สอดคล้องกันของความยาวส่วนหัวในกระบวนการผลิต และตรวจสอบการเล่นกลับอย่างครบถ้วนก่อนการแจกจ่าย.
อ่านข้อมูลที่ป้อนเข้ามาอย่างถูกต้อง · 216 ตัวอักษร
ยินดีต้อนรับสู่การทัวร์ผลิตภัณฑ์ Acorn Studio ด้วยเพียงสามขั้นตอน คุณก็สามารถเปลี่ยนบทพูดสั้นๆ ให้กลายเป็นคู่มือเสียงได้ ขั้นแรก ให้เขียนข้อความ ขั้นต่อไป ให้เลือกเสียง และขั้นสุดท้าย ให้บันทึกไฟล์เสียงและทดสอบการเล่นบนโทรศัพท์ของคุณ.
ตัวอย่าง Qwen มีขนาดประมาณสามเท่าของตัวอย่าง Eleven สำหรับความยาวที่คล้ายกัน ซึ่งสะท้อนถึงความแตกต่างระหว่างรูปแบบ WAV และ MP3 นอกจากนี้ ส่วนหัวของไฟล์ WAV ยังระบุข้อมูลมากกว่าปริมาณข้อมูลที่ไฟล์นั้นเก็บไว้จริง นี่เป็นปัญหาด้านการจัดแพ็กเกจไฟล์ที่ควรตรวจสอบในเครื่องเล่นเป้าหมายของคุณ; แต่ปัญหาดังกล่าวเองไม่ได้บ่งชี้อะไรเกี่ยวกับคุณภาพของเสียงพูด.
แก้ไขปัญหาทั่วไปในการสร้างเสียงพูด
| อาการ | สิ่งที่ควรตรวจสอบก่อน |
|---|---|
| ไฟล์ MP3 ที่บันทึกไว้ไม่สามารถเล่นได้ | ตรวจสอบสถานะ HTTP และประเภทการตอบกลับ อาจมีข้อผิดพลาดของ API ที่ถูกบันทึกไว้ด้วยส่วนขยายไฟล์เสียง. |
| คำขอนี้ปฏิเสธเสียงหรือคำสั่ง | ให้จับคู่เสียงและช่องข้อมูลเสริมกับโมเดลที่เลือก โมเดล TTS OpenAI รุ่นเก่าไม่รองรับคำสั่ง. |
| สคริปต์ที่ยาวเกินไปจะถูกปฏิเสธ | ตรวจสอบขีดจำกัดจำนวนตัวอักษรของเส้นทางและขีดจำกัดโทเค็น Mini TTS แล้วแบ่งออกตามจุดแบ่งตามธรรมชาติ. |
| ปรากฏการตอบกลับรหัส 401 หรือ 429 | ตรวจสอบรหัส/บัญชีเพื่อหาข้อผิดพลาด 401 สำหรับข้อผิดพลาด 429 ให้แยกแยะระหว่างข้อจำกัดอัตรา (rate limits) กับโควตาไม่เพียงพอ ก่อนที่จะลองอีกครั้ง. |
| คำขอ GlobalGPT ยังอยู่ระหว่างการพิจารณา | ตรวจสอบ ID ของงานที่บันทึกไว้และตรวจสอบสถานะ; การหมดเวลาไม่ใช่เหตุผลที่จะส่งงานซ้ำ. |
| เสียงไม่ตรงกับตั้งค่าที่ขอไว้ | ตรวจสอบข้อมูลเมตาดาต้าเฉพาะรุ่นและรายการ ignored_parameters ก่อนที่จะสันนิษฐานว่าการตั้งค่าได้ถูกนำไปใช้แล้ว. |
| แถบแสดงระยะเวลาเสียงหรือแถบค้นหาดูผิด | เปรียบเทียบข้อมูลเมตาดาต้าของไฟล์กับเนื้อหาสื่อจริง และทดสอบไฟล์ทั้งหมดในเครื่องเล่นเป้าหมายของคุณ. |
สำหรับข้อผิดพลาด OpenAI ให้เริ่มจาก คู่มือเกี่ยวกับรหัสข้อผิดพลาด. สำหรับงาน GlobalGPT ให้บันทึก ID ของงานและรายละเอียดข้อผิดพลาดที่ระบบส่งกลับมาไว้ ระหว่างการพัฒนา ให้แยกข้อผิดพลาดในการส่งข้อมูล ข้อผิดพลาดในการเรียกเก็บเงิน และคุณภาพเสียงที่ไม่เป็นที่น่าพอใจออกจากกัน: เพราะแต่ละกรณีต้องการวิธีแก้ไขที่แตกต่างกัน.
ก่อนส่งบทบรรยาย ให้ฟังบันทึกเสียงทั้งหมดบนอุปกรณ์ที่ผู้ฟังจะใช้ ตรวจสอบส่วนเปิดต้นเรื่อง ชื่อและตัวเลข การเปลี่ยนผ่านระหว่างส่วนต่าง ๆ และประโยคสุดท้าย ให้ใส่คำแจ้งเตือนเกี่ยวกับเสียง AI ไว้ใกล้จุดเริ่มต้นการเล่น และเก็บสำเนาของข้อความต้นฉบับและการตั้งค่าโมเดลไว้อย่างครบถ้วน เพื่อสามารถสร้างบทบรรยายที่แก้ไขแล้วขึ้นมาใหม่ได้อย่างถูกต้อง.
คำถามที่มักถูกถาม
จุดปลายทางของ API เสียงและคำพูด OpenAI คืออะไร?
ใช้ POST https://api.openai.com/v1/audio/speech. สนามข้อมูลที่จำเป็นคือ model, input และ voice. ผลลัพธ์คือไฟล์เสียงที่สร้างขึ้น; MP3 เป็นรูปแบบมาตรฐาน.
API เสียง OpenAI เป็นบริการฟรีหรือไม่?
API Speech มีระบบการคิดค่าบริการตามการใช้งาน โปรดวางแผนงบประมาณโดยใช้อัตราค่าบริการ API ปัจจุบัน แทนที่จะสมมติว่ามีโควตาฟรี: GPT-4o Mini TTS จะถูกคิดค่าบริการตามโทเคนการป้อนข้อความและโทเคนการส่งออกเสียง ส่วน TTS-1 และ TTS-1 HD จะถูกคิดค่าบริการตามจำนวนตัวอักษร.
ผมสามารถควบคุมเสียงและสไตล์การพูดได้ไหมครับ?
เลือกเสียงที่รองรับโดยโมเดลของคุณ GPT-4o Mini TTS ยังรับคำสั่งเกี่ยวกับวิธีการพูดได้ เช่น น้ำเสียงที่อบอุ่นหรือสงบ อย่างไรก็ตาม ช่องคำสั่งนี้ไม่ทำงานกับ TTS-1 หรือ TTS-1 HD.
API ของ Speech รองรับการสตรีมหรือไม่?
ใช่ครับ มันสามารถสตรีมเสียงที่สร้างขึ้นเป็นส่วนๆ ได้ แต่แอปพลิเคชันของคุณยังต้องจัดการการเล่นเสียงด้วย เพราะการสตรีมการแปลงข้อความเป็นเสียงเพียงอย่างเดียว ยังไม่สามารถสร้างการสนทนาด้วยเสียงแบบสดที่สมบูรณ์ได้.
ผมสามารถใช้ GlobalGPT ได้หรือไม่ โดยเปลี่ยน URL หลักของ OpenAI?
ใช้ขั้นตอนการทำงานของงานสื่อ (media-task workflow) ที่ได้รับการบันทึกไว้ของ GlobalGPT สำหรับ TTS: ส่งข้อมูลไปยัง POST /tasks, ตรวจสอบสถานะด้วย GET /tasks/{id}, และดาวน์โหลด output.url หลังจากดำเนินการสำเร็จแล้ว รายชื่อโมเดล TTS ที่ได้รับการบันทึกไว้ของมันรวมถึงโมเดล ElevenLabs และ Qwen พร้อมด้วย ID และพารามิเตอร์ของโมเดลแต่ละตัว.
ควรเริ่มใช้รูปแบบไฟล์เสียงแบบไหนดี?
เริ่มด้วยไฟล์ MP3 สำหรับการดาวน์โหลดหรือเล่นผ่านเว็บแบบง่ายๆ ไฟล์ WAV มีประโยชน์เมื่อต้องการดำเนินการแก้ไขในขั้นตอนต่อไป ส่วนไฟล์ PCM แบบดิบ (Raw PCM) ต้องใช้โปรแกรมเล่นที่ตั้งค่าให้เหมาะสมกับอัตราการสุ่มตัวอย่างและความลึกของบิต เนื่องจากไฟล์นี้ไม่มีส่วนหัวไฟล์.
เริ่มด้วยสคริปต์สั้นหนึ่งบท เสียงหนึ่งชุด และไฟล์ที่บันทึกไว้หนึ่งไฟล์ เมื่อสามารถคาดการณ์การส่งข้อมูลและค่าใช้จ่ายได้แล้ว ให้เพิ่มการแบ่งเป็นชิ้น (chunking) การลองใหม่ (retries) และขั้นตอนอื่นๆ ในกระบวนการทำงานของสื่อของคุณ ให้รักษาให้รูปแบบคำขอของ API ที่เลือก หน่วยการคิดค่าบริการ และการจัดการผลลัพธ์ไว้เป็นหนึ่งเดียวในการนำไปใช้งาน.
สร้างเสียงให้กับบทภาพยนตร์ชิ้นต่อไปของคุณ
ร่างทัวร์ผลิตภัณฑ์แบบสั้น สร้างเสียงบรรยายด้วย ElevenLabs หรือ Qwen และต่อด้วยภาพและวิดีโอในพื้นที่ทำงานแบบหลายโมเดลของ GlobalGPT.
สร้างไฟล์เสียงด้วย GlobalGPT








