
คำตอบด่วน: GPT-6 Sol ได้เสร็จสิ้นการวิเคราะห์เอกสารสั้น 5 ส่วนที่ผ่านการทดสอบภายใต้ขีดจำกัดผลออก 2,400 โทเคน ส่วน Claude Opus 5.5 ให้ผลการวินิจฉัยที่แม่นยำกว่าในภารกิจตรวจสอบโค้ดสั้นของเรา ทั้งสองผลลัพธ์นี้ยังไม่สามารถกำหนดผู้ชนะโดยรวมอย่างถาวรได้.
การเปรียบเทียบที่มีประโยชน์นี้ไม่จำกัดเพียงคะแนนเท่านั้น Claude Opus 5.5 และ GPT-6 Sol มีความแตกต่างกันในวิธีการจัดการกับการเขียน การสังเคราะห์ผลการวิจัย การตรวจสอบโค้ด การตอบคำถามแบบมีโครงสร้าง ช่องทางการเข้าถึง และกระบวนการทำงานประจำวัน ผลลัพธ์ของงานด้านล่างนี้แสดงให้เห็นว่าความแตกต่างเหล่านั้นมีความสำคัญในด้านใดบ้าง.
โกลบอลจีพีที ให้คุณใช้ทั้งสองโมเดลในแพ็กเกจสมัครสมาชิกแบบหลายโมเดลที่ราคาคุ้มค่า พร้อมด้วยโมเดลอื่น ๆ และความสามารถด้าน AI ทั้งหมดในแพ็กเกจเดียว แดชบอร์ดเดียวสามารถจัดการโครงการได้ตั้งแต่ขั้นตอนการวิจัยและการเขียน ไปจนถึงการเขียนโค้ด การสร้างภาพ และวิดีโอ ส่วน CLI ของมันจะเชื่อมต่อบริบทการทำงานเดียวกันนี้กับเทอร์มินัลและเครื่องมือสำหรับการผลิต.
คำตอบสั้นๆ
เลือก GPT-6 Sol ก่อนอื่น สำหรับกระบวนการเขียนที่มีข้อจำกัดที่ทดสอบในที่นี้; มันได้เสร็จสิ้นทั้งห้าส่วนภายในขีดจำกัดผลออกที่แบ่งปันกันคือ 2,400 โทเคน. เลือก Claude Opus 5.5 เมื่อการวินิจฉัย การวิเคราะห์ความเสี่ยงอย่างชัดเจน และ JSON ที่เคร่งครัดมีความสำคัญมากขึ้น ให้ใช้ทั้งสองอย่างเมื่องานมีการเปลี่ยนแปลงรูปแบบตลอดทั้งวัน.
จุดเด่นของแต่ละรุ่น
Claude Opus 5.5 เหมาะสำหรับงานที่ต้องทำอย่างตั้งใจ: การตรวจสอบการเปลี่ยนแปลงโค้ด การวิเคราะห์ข้อกำหนดที่ซับซ้อน การระบุความเสี่ยง และการรักษาสัญญาผลลัพธ์ที่เคร่งครัด Anthropic เน้นไปที่การเขียนโค้ด การใช้คอมพิวเตอร์ งานด้านความรู้ ความปลอดภัย และการสื่อสารในเซสชันยาวที่เป็นธรรมชาติมากขึ้น ดูเพิ่มเติมที่ รีวิว Claude Opus 5.5 เพื่อดูมุมมองที่เน้นไปที่โมเดลอย่างแยกต่างหาก นี่เป็นตัวเลือกที่เหมาะสมเมื่อการวิเคราะห์อย่างละเอียดในรอบที่สองมีค่ามากกว่าคำตอบแรกที่สั้นๆ.
GPT-6 Sol เหมาะสำหรับงานที่มีข้อจำกัดด้านปริมาณงาน: เอกสารสรุปที่ยาว, บันทึกการตัดสินใจ, แผนงานที่มีโครงสร้างชัดเจน หรือร่างเอกสารที่ต้องรวมส่วนต่าง ๆ ตามที่ขอไว้ OpenAI อธิบายว่านี่เป็นโมเดล GPT-6 ที่มีราคาถูกกว่า สำหรับงานระดับมืออาชีพ ความถูกต้องของข้อมูล การเขียนโค้ด การใช้คอมพิวเตอร์ และการทำงานร่วมกัน รีวิว GPT-6 Sol ครอบคลุมโมเดลนี้ด้วยตัวมันเอง; ในงานแบบยาวนี้ มันได้เสร็จสิ้นสัญญาในผลลัพธ์แรก ซึ่งมีประโยชน์เมื่อค่าใช้จ่ายจากการขาดส่วนใดส่วนหนึ่งนั้นสูง.
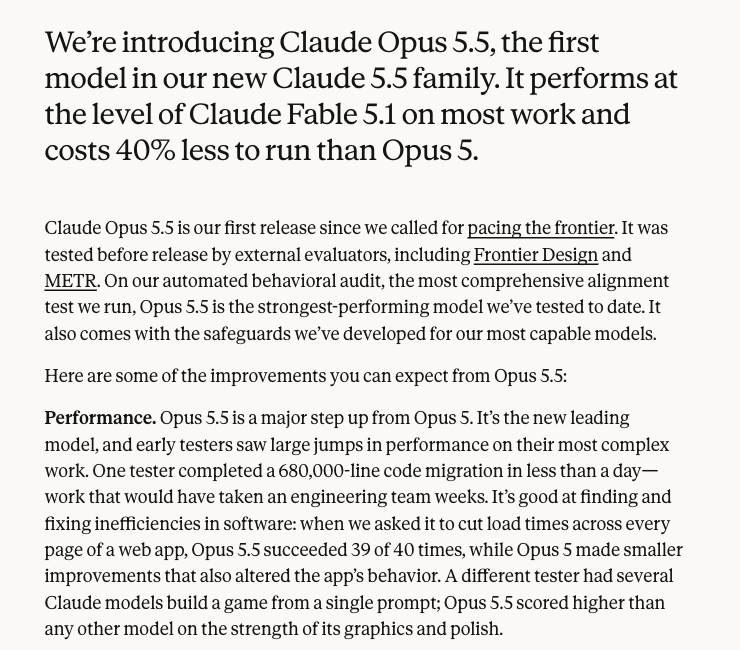
นี่คือรายงานเกี่ยวกับการเปิดตัวจาก Anthropic เอง ซึ่งรวมถึงตัวอย่างจากผู้ทดสอบในช่วงแรก รายงานนี้สนับสนุนทิศทางที่ผลิตภัณฑ์ตั้งไว้ แต่ไม่ได้แสดงผลการเปรียบเทียบโดยตรงกับ GPT-6 Sol คำสั่งที่ปรับให้สอดคล้องกันด้านล่างนี้มุ่งเน้นไปที่คำถามที่แคบกว่า คือผลลัพธ์ที่แต่ละโมเดลส่งกลับมาในการทดสอบครั้งนี้.
การเปรียบเทียบคุณสมบัติและความสามารถ
Claude Opus 5.5 vs GPT-6 Sol: แผนที่ความสามารถ
| พื้นที่การตัดสินใจ | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| การเขียนแบบยาว | มีความเชี่ยวชาญในการร่างเอกสารอย่างระมัดระวังและละเอียดอ่อน พร้อมทั้งระบุข้อจำกัดอย่างชัดเจน | มีความเชี่ยวชาญในการดำเนินการตามข้อกำหนดที่ยาวและมีข้อจำกัดหลายประการให้เสร็จสิ้นในครั้งเดียว |
| การสังเคราะห์งานวิจัย | การปรับยอดอย่างละเอียดและการอธิบายความเสี่ยง | การสรุปแบบกระชับพร้อมคำแนะนำที่ชัดเจน |
| การเขียนโค้ดและการตรวจสอบ | การวินิจฉัยที่แม่นยำและการรายงานความเสี่ยงอย่างเป็นระบบ | แพตช์ที่เรียบง่ายแต่มีประโยชน์; ตรวจสอบความถูกต้องของคำอธิบายสำหรับกรณีพิเศษ |
| ผลลัพธ์ที่มีโครงสร้าง | JSON ที่ถูกต้องและน่าเชื่อถือในภารกิจที่ได้รับการทดสอบ | JSON ที่ถูกต้อง ซึ่งมีคีย์ทั้งหมดที่ร้องขอในงานที่ทดสอบ |
| ระบบหลายรูปแบบและเครื่องมือ | ตรวจสอบเส้นทางและรูปแบบการเข้าถึงสำหรับงานเฉพาะนั้น | ตรวจสอบเส้นทางและรูปแบบการเข้าถึงสำหรับงานเฉพาะนั้น |
| สไตล์การทำงานที่ดีที่สุด | การวิเคราะห์อย่างรอบคอบ การคิดวิเคราะห์ที่ซับซ้อน และงานที่ต้องคำนึงถึงความเสี่ยง | ได้เสร็จสิ้นการเขียนบทสรุปที่ผ่านการทดสอบภายใต้ข้อจำกัดของจำนวนคำที่กำหนดไว้ |
วิธีอ่านข้อความนี้: นี่เป็นแนวโน้มของกระบวนการทำงาน ไม่ใช่ตารางอันดับที่ถือเป็นมาตรฐานสากล การเลือกที่ถูกต้องขึ้นอยู่กับว่าคุณให้ความสำคัญกับการทบทวนอย่างรอบคอบ หรือการเสร็จสิ้นงานตามบรีฟที่ละเอียดนี้ภายใต้ขีดจำกัดผลลัพธ์เดียวกัน.
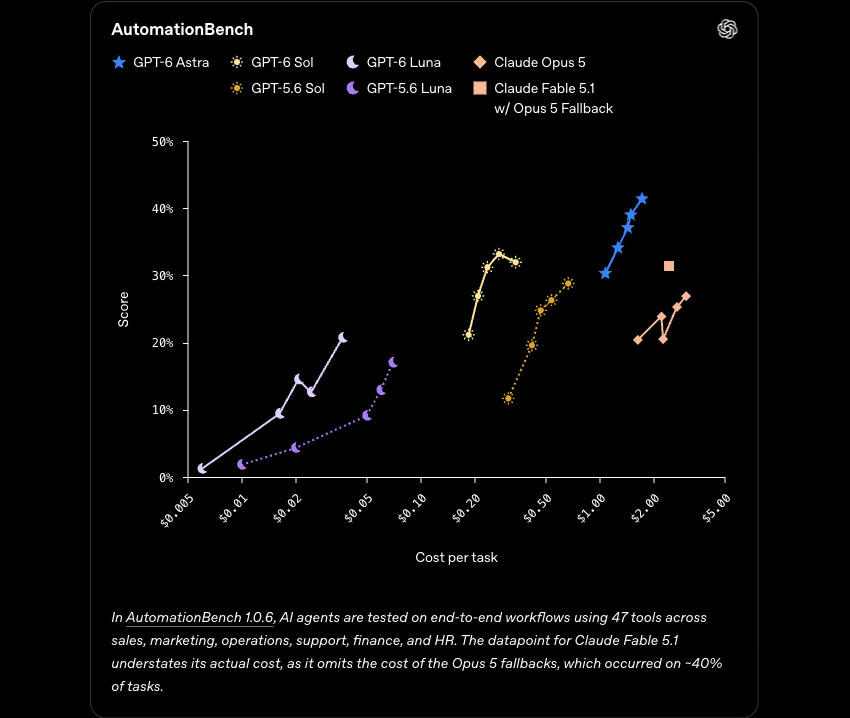
อ่านทั้งสองแกน: การเคลื่อนตัวขึ้นแสดงถึงคะแนนที่สูงขึ้น ส่วนการเคลื่อนตัวไปทางซ้ายแสดงถึงค่าใช้จ่ายต่องานที่ต่ำลง ซีรีส์ Claude ที่กล่าวถึงในที่นี้คือ Opus 5 ไม่ใช่ Opus 5.5 แผนภูมิที่ผู้จัดพิมพ์รายงานนี้ช่วยอธิบายตำแหน่งด้านความคุ้มค่าของ Sol ได้ แต่ไม่สามารถตัดสินการเปรียบเทียบในบทความนี้ได้ หมายเหตุยังระบุว่าข้อมูลของ Fable ไม่ได้รวมค่าใช้จ่ายสำรองบางส่วน.
การเขียน เอกสารยาว และการสังเคราะห์ผลการวิจัย
สำหรับการเขียน การทดสอบนี้แยกความแตกต่างระหว่างการเสร็จสิ้นงานภายใต้ขีดจำกัดปริมาณผลลัพธ์ที่กำหนดไว้ กับคุณภาพของการตรวจสอบและแก้ไขเนื้อหา GPT-6 Sol แสดงผลที่ดีกว่าในสัญญาแบบยาว ส่วน Claude Opus 5.5 แสดงผลที่ดีกว่าเมื่องานคือการวินิจฉัย ตรวจสอบคุณสมบัติ และอธิบาย สำหรับบันทึกการวิจัย ทั้งสองโมเดลได้ผลลัพธ์ที่ใช้งานได้จริงในระดับเดียวกัน ดังนั้นคุณภาพของข้อมูลต้นฉบับและกระบวนการตรวจสอบจึงยังคงมีความสำคัญมากกว่าการเป็นผู้ชนะในหัวข้อข่าว.
- ใช้ GPT-6 Sol เพื่อสร้างฉบับร่างแรกที่มีข้อจำกัดหลายประการ บันทึกการตัดสินใจ หรือแผนเนื้อหาที่มีโครงสร้าง.
- ใช้ Claude Opus 5.5 เพื่อตรวจสอบสมมติฐาน ค้นหาความเสี่ยง และปรับปรุงร่างให้สมบูรณ์ยิ่งขึ้น ก่อนที่จะส่งไปยังลูกค้าหรือระบบผลิต.
- เมื่อข้อมูลจริงมีความสำคัญ ให้ส่งข้อมูลต้นฉบับไปยังทั้งสองโมเดล และรักษาขั้นตอนการตรวจสอบโดยมนุษย์ไว้.
การเขียนโค้ด, ผลลัพธ์ที่มีโครงสร้าง, และงานที่พร้อมใช้กับเครื่องมือ
ทั้งสองโมเดลได้ส่งคืน JSON ที่ถูกต้อง พร้อมด้วยคีย์ทั้งหมดที่ขอมา และแพตช์ขั้นต่ำที่เหมือนกัน Claude อธิบายตัวกรองที่มีอยู่ได้อย่างถูกต้อง ส่วน GPT-6 Sol กลับระบุผิดว่าองค์ประกอบ None จะก่อให้เกิดข้อผิดพลาด ซึ่งสนับสนุนให้ใช้ Claude ในการวินิจฉัยสำหรับงานนี้โดยเฉพาะ ประเภทของสนาม risk ไม่ได้ระบุไว้ในคำสั่ง ดังนั้นข้อความ risk ของ Sol จึงไม่ถือเป็นการละเมิดสัญญา.
สำหรับงานที่พร้อมใช้กับเครื่องมือ ให้ประเมินสัญญาผลลัพธ์ที่คุณต้องการจริง ๆ ได้แก่ รูปแบบ JSON ที่ถูกต้อง, ฟิลด์ที่ครบถ้วน, คำสั่งที่สามารถทำซ้ำได้ และแพตช์ที่สามารถนำไปใช้ได้โดยไม่ต้องตีความ ทั้งสองโมเดลสามารถเป็นส่วนหนึ่งของกระบวนการนั้นได้ โดยมีการทดสอบและการตรวจสอบที่รวมอยู่ในวงจรการทำงาน.
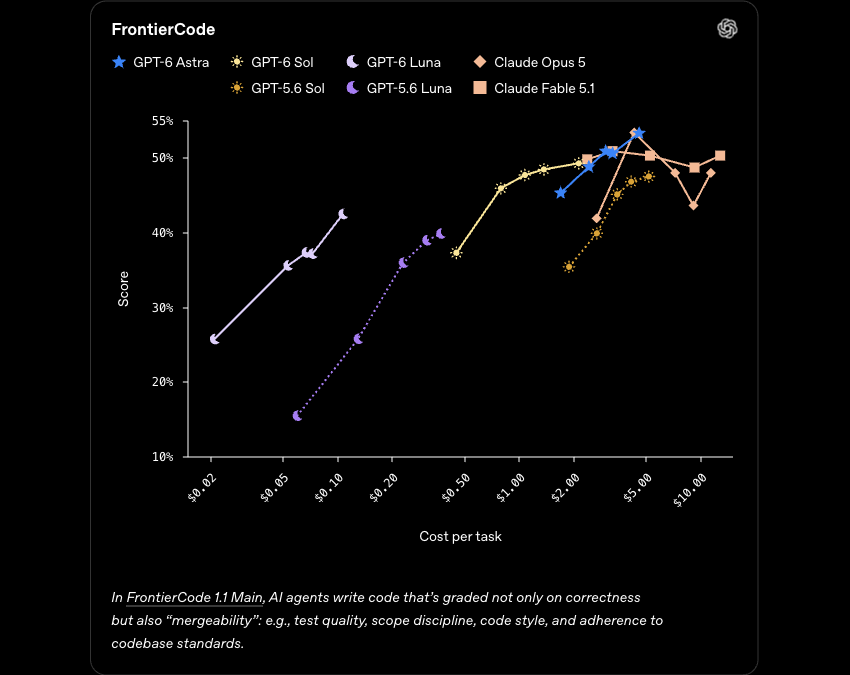
เกณฑ์มาตรฐานนี้ครอบคลุมการเขียนโค้ดแบบเอเจนต์ในขอบเขตที่กว้างกว่าคำสั่งสั้นๆ สำหรับการตรวจสอบโค้ดของเรา ตัวเปรียบเทียบ Claude ของมันคือ Opus 5 ดังนั้นจึงเป็นบริบทสำหรับการประเมินตำแหน่งการเขียนโค้ดของ Sol มากกว่าที่จะเป็นหลักฐานว่า Sol ดีกว่า Opus 5.5 ในงานของเราเอง ทั้งสองแพตช์ล้วนถูกต้อง; ความแตกต่างที่มีประโยชน์คือความแม่นยำในการวินิจฉัย.
ราคาและการเข้าถึง
ราคาและการเข้าถึง: เปรียบเทียบเส้นทาง ไม่ใช่แค่รุ่นรถเท่านั้น
| เส้นทาง | สิ่งที่คุณกำลังจ่ายเงินเพื่อซื้อ | เมื่อเหมาะสม |
|---|---|---|
| Claude Opus 5.5 API | Anthropic ระบุบนหน้าประกาศเวอร์ชันวันที่ 22 กันยายน 2026 ว่า $4 ต่อหนึ่งล้านโทเคนอินพุต, $20 ต่อหนึ่งล้านโทเคนเอาต์พุต และ $0.20 ต่อหนึ่งล้านโทเคนแคชอ่าน | คุณกำลังพัฒนาผลิตภัณฑ์หรือระบบอัตโนมัติ และต้องการระบบการเรียกเก็บเงินด้วยโทเค็นโดยตรง |
| API GPT-6 Sol | OpenAI กำหนดอัตรา $2 ต่อหนึ่งล้านโทเคนเข้า และ $10 ต่อหนึ่งล้านโทเคนออก โดยมีการลดราคา 50% เมื่อเทียบกับราคาโปรโมชั่น GPT-5.6 Sol; การอ่านข้อมูลเข้าที่เก็บไว้ในแคชจะได้รับส่วนลด 90% | คุณต้องการสัญญา API จากผู้ให้บริการโดยตรง และต้องการลดค่าใช้จ่ายตามปริมาณการใช้งานสำหรับงานที่ดำเนินการอย่างต่อเนื่อง |
| โกลบอลจีพีที | แพ็กเกจสมัครสมาชิกราคาประหยัดเพียงหนึ่งเดียว ที่รวมทั้งสองรุ่น พร้อมด้วยรุ่นอื่นๆ อีกมากมาย และฟังก์ชัน AI | คุณต้องการรวมงานวิจัย การเขียน การเขียนโค้ด การจัดการภาพ และวิดีโอไว้ในแดชบอร์ดเดียว |
ตัวเลขเหล่านี้เป็นอัตราค่าโทเคน API ไม่ใช่ราคาการสมัครสมาชิก OpenAI กำหนดให้ GPT-6 Sol เป็นสมาชิกที่มีค่าใช้จ่ายต่ำที่สุดในตระกูล GPT-6 สำหรับงานระดับมืออาชีพ ความถูกต้องของข้อมูล การเขียนโค้ด การใช้คอมพิวเตอร์ และการทำงานร่วมกัน ส่วน Anthropic กำหนดให้ Claude Opus 5.5 เน้นไปที่การเขียนโค้ด การใช้คอมพิวเตอร์ งานด้านความรู้ ความปลอดภัย และการสื่อสาร GlobalGPT ทำให้ทั้งสองโมเดลและส่วนอื่นๆ ของเครื่องมือในห่วงโซ่สามารถใช้งานได้ผ่านแพ็กเกจสมัครสมาชิกราคาประหยัดเพียงหนึ่งเดียว ส่วน CLI ของมันจะเชื่อมต่อสิทธิ์การเข้าถึงดังกล่าวกับเทอร์มินัล กระบวนการพัฒนา และเครื่องมือผลิตที่มีอยู่.
แหล่งข้อมูลหลัก: หน้าประกาศเวอร์ชัน Claude Opus 5.5 ของ Anthropic และ หน้าประกาศการเปิดตัว GPT-6 Sol และ Luna ของ OpenAI.
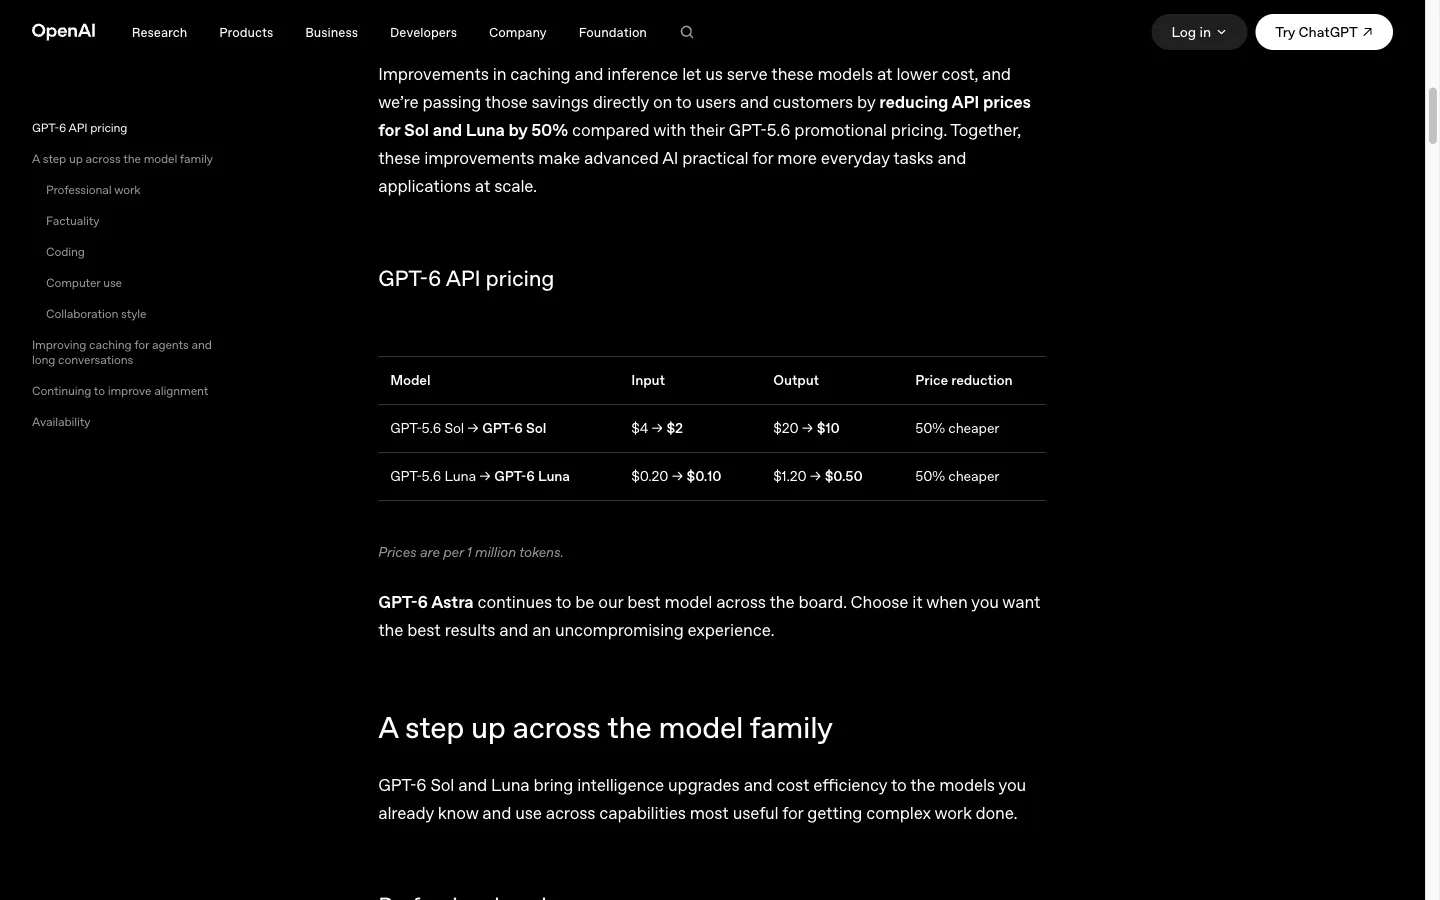
อัตราเหล่านี้ใช้กับโทเค็น API เท่านั้น ไม่รวมถึงค่าสมัครสมาชิกรายเดือนสำหรับผู้บริโภคหรือแพ็กเกจ GlobalGPT.
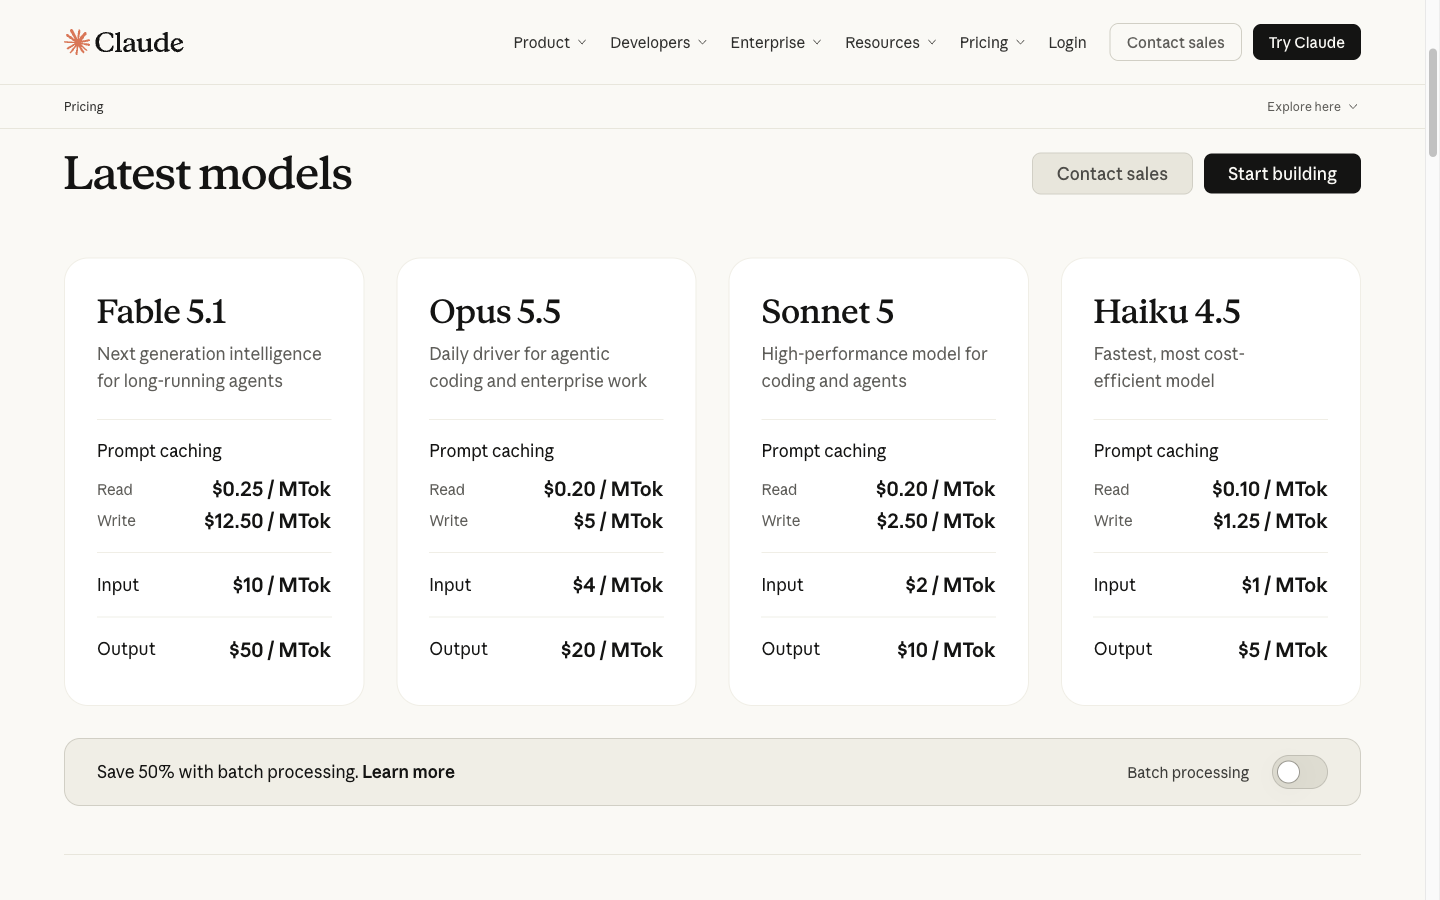
อัตราความเร็วการรับและส่งข้อมูลมาตรฐานของ Opus 5.5 สูงเป็นสองเท่าของ Sol ส่วนอัตราความเร็วการอ่านจากแคชที่ประกาศไว้ทั้งสองตัวมีค่าเท่ากันที่ $0.20/M ดังนั้น กระบวนการทำงานที่ใช้แคชอย่างหนักอาจมีช่องว่างด้านค่าใช้จ่ายที่แตกต่างจากกระบวนการทำงานที่ไม่ใช้แคช; ควรเปรียบเทียบส่วนผสมของโทเคนเดียวกันก่อนตัดสินใจเลือกตามราคา.
ความแตกต่างของอัตราความเร็วมีความหมายอย่างไรสำหรับปริมาณงานที่เท่ากัน
ตัวอย่างการคำนวณ: 1 ล้านโทเคนอินพุตที่ยังไม่ถูกเก็บในแคช + 100,000 โทเคนเอาต์พุต, อัตรา API มาตรฐาน สีเทียล คือต้นทุนด้านข้อมูลเข้า ส่วนสีรัสต์ คือต้นทุนด้านข้อมูลออก.
Sol มีค่าใช้จ่ายเพียงครึ่งหนึ่งสำหรับชุดโทเคนที่เหมือนกันนี้ นี่เป็นการคำนวณตามราคาในตารางราคา ไม่ใช่การอ้างว่าทุกงานที่เสร็จสิ้นจะมีค่าใช้จ่ายเพียงครึ่งหนึ่ง: การลองใหม่ ความยาวของผลลัพธ์ การเข้าถึงแคช ค่าบริการเครื่องมือ และการตั้งค่าการวิเคราะห์ อาจส่งผลให้ค่าใช้จ่ายเปลี่ยนแปลงได้.
แหล่งข้อมูล: ราคา API Anthropic และ ราคาจำหน่ายของ OpenAI, ตรวจสอบเมื่อวันที่ 25 กันยายน 2569.ประมาณการค่าใช้จ่าย API โดยตรง
เครื่องคำนวณค่าใช้จ่าย API
ป้อนโทเคนที่คาดว่าจะส่งและรับ การประมาณการนี้ใช้อัตรา API ที่ได้รับการยืนยันข้างต้น: Claude Opus 5.5 สำหรับข้อมูลเข้า $4/M และข้อมูลออก $20/M; GPT-6 Sol สำหรับข้อมูลเข้า $2/M และข้อมูลออก $10/M.
| แบบจำลอง | อัตราการป้อนข้อมูล | อัตราการผลิต | ประมาณการค่าใช้จ่าย |
|---|---|---|---|
| Claude Opus 5.5 | $4 / M | $20 / M | $9.00 |
| GPT-6 Sol | $2 / M | $10 / M | $4.50 |
นี่เป็นการประมาณการค่าใช้จ่ายตามโทเคนสำหรับการใช้งาน API แบบตรง ไม่รวมการคำนวณราคาสำหรับแพ็กเกจสมัครสมาชิกของผู้ใช้หรือแพ็กเกจ GlobalGPT และไม่รวมส่วนลดจากแคช เครื่องมือ ภาษี และค่าใช้จ่ายอื่นๆ ที่เฉพาะเจาะจงของผู้ให้บริการ.
ใครควรเลือกรุ่นไหน?
คุณควรเลือกรุ่นไหนดี?
| ความสำคัญของคุณ | เลือกก่อน | ทำไม |
|---|---|---|
| จดหมายยาวที่ได้รับการขัดเกลาอย่างดี แต่มีข้อจำกัดหลายประการ | GPT-6 Sol | งานแบบยาวที่ได้รับการปรับปรุงได้บรรลุกฎการตัดสินใจที่ขอไว้ในผลลัพธ์เดียว |
| การวิเคราะห์โค้ด, JSON ที่เคร่งครัด, และความเสี่ยงที่ชัดเจน | Claude Opus 5.5 | งานการเขียนโค้ดได้ให้ผลการวินิจฉัยที่แม่นยำยิ่งขึ้นและรายการประเมินความเสี่ยง |
| บันทึกการวิจัยที่จำเป็นต้องปรับให้สอดคล้องกัน | อย่างใดอย่างหนึ่ง | งานการสังเคราะห์จากแหล่งที่ควบคุมได้มีผลเสมอกัน |
| กระบวนการทำงานรายสัปดาห์แบบผสมผสาน | GlobalGPT พร้อมทั้งสอง | รวมการเลือกโมเดล การเขียน การเขียนโค้ด ภาพ และวิดีโอไว้ในแดชบอร์ดเดียว; ใช้ CLI เมื่องานย้ายไปยังเทอร์มินัล |
ใช้ทั้งสองโมเดลในกระบวนการทำงานที่ครบถ้วนเพียงขั้นตอนเดียว
ขั้นตอนการทำงาน GlobalGPT ที่ใช้งานได้จริง
- เริ่มด้วยบทสรุปการวิจัย และขอให้โมเดลหนึ่งช่วยชี้ให้เห็นสมมติฐานต่าง ๆ.
- นำแบบร่างที่ทำความสะอาดแล้วไปใส่ในแบบร่างอีกแบบหนึ่ง เพื่อร่างแบบหรือขอความเห็นเพิ่มเติม.
- ใช้วิธีการเขียนโค้ดที่เข้มงวดยิ่งขึ้นในการพัฒนา ทบทวน และสร้างผลลัพธ์ที่มีโครงสร้าง.
- เก็บผลงานที่ได้ไว้ในแดชบอร์ดเดียวกัน แล้วใช้ ขั้นตอนการทำงานของ CLI GlobalGPT เมื่อจำเป็นต้องนำเข้าสู่ระบบเทอร์มินัลหรือเครื่องมือผลิต.
กระบวนการทำงานดังกล่าวคือจุดเด่นหลักของการใช้ทั้งสองโมเดล: คุณสามารถจัดสรรงานได้ แทนที่จะต้องปรับกระบวนการทำงานของคุณให้เข้ากับโมเดลใดโมเดลหนึ่ง.

วิธีการดำเนินการเปรียบเทียบ
ทั้งสองโมเดลได้รับข้อความระบบ ข้อมูลป้อนเข้าของงาน และข้อมูลต้นฉบับเดียวกัน โดยไม่มีการใช้เครื่องมือหรือการค้นหาข้อมูล ผลลัพธ์แต่ละรายการเก็บผลลัพธ์แรกที่ส่งกลับมาไว้ รวมถึงการตัดทอนตามขีดจำกัดของผลลัพธ์ นี่เป็นการเปรียบเทียบเชิงปฏิบัติเพื่อเลือกกระบวนการทำงาน ไม่ใช่การจัดอันดับทั่วไปของทุกความสามารถ.
วิธีการเปรียบเทียบ
วิธีการดำเนินการเปรียบเทียบนี้
| สภาพ | กฎการเปรียบเทียบ |
|---|---|
| แบบจำลอง | Claude Opus 5.5 และ GPT-6 Sol, ID ที่ถูกต้องได้รับการยืนยันในไดเรกทอรีของโมเดลที่ใช้งานจริง |
| ความเท่าเทียมของคำสั่ง | ข้อความระบบและคำแจ้งเตือนงานเป็นแบบเดิม วัสดุต้นฉบับไม่มีการใช้เครื่องมือหรือการค้นหา |
| งาน | T01 การตรวจสอบขอบเขต, T01R การเปรียบเทียบแบบยาวอย่างชัดเจน, T02 การสังเคราะห์แหล่งที่มา, T03 โค้ด/JSON |
| ลองใหม่ | เฉพาะกรณีที่เกิดข้อผิดพลาดด้านการขนส่ง/ความจุ/ซองว่างเท่านั้น; ผลลัพธ์ที่ถูกต้องแต่ไม่สมบูรณ์จะยังคงถูกเก็บไว้ |
| การให้คะแนน | 10 คะแนนต่อแต่ละงานที่ผ่านเกณฑ์: สัญญาตามวัตถุประสงค์ 4, ความสามารถในการติดตาม 3, ความมีประโยชน์ 2, รูปแบบ 1 |
คำสั่งแรกใช้เพื่อตรวจสอบว่าโมเดลจะคาดเดาได้หรือไม่เมื่อขาดบริบทสำคัญ ดังนั้นจึงถูกแยกออกจากการคำนวณผู้ชนะ การเปรียบเทียบโดยตรงนี้ระบุชื่อโมเดลทั้งสองและให้คำสั่งเดียวกันแก่ทั้งสองโมเดล ไม่มีการใช้การรันซ้ำเพื่อตรวจสอบความเสถียร.
ทำไมคำสั่งแรกจึงไม่เลือกผู้ชนะ
การจัดการบริบท
ทำไมคำสั่งแรกจึงไม่เลือกผู้ชนะ
ทั้งสองโมเดลต่างปฏิเสธที่จะสร้างอัตลักษณ์ของโมเดล เนื่องจากคำสั่งต้นฉบับไม่ได้ระบุชื่อของพวกมัน นั่นเป็นปฏิกิริยาที่ถูกต้องเมื่อขาดบริบท แต่ไม่สามารถบอกได้ว่าโมเดลใดทำงานได้ดีกว่า.
Claude Opus 5.5 · อินพุตเต็ม
คุณกำลังเปรียบเทียบสองโมเดล AI เพื่อสร้างคู่มือการเลือกซื้อที่ใช้งานได้จริง โดยใช้ข้อมูลจากแพ็กเก็ตต้นฉบับด้านล่างเท่านั้น ให้เขียนบทความยาว 700–900 คำ พร้อมหัวข้อต่อไปนี้อย่างแม่นยำ: การตัดสินใจ, หลักฐาน, ข้อควรระวัง, ขั้นตอนต่อไป ต้องรักษาข้อมูลต่อไปนี้ให้ตรงตามต้นฉบับ: โครงการ North มีกำหนดเวลา 12 สัปดาห์; งบประมาณการย้ายระบบคือ $48,000; การตรวจสอบความปลอดภัยยังไม่มีการกำหนดวัน หากข้อมูลใดยังไม่ชัดเจน ให้ระบุไว้อย่างชัดเจน อย่าสร้างราคา มาตรฐานเปรียบเทียบ หรือความสามารถของผลิตภัณฑ์ขึ้นมาเอง

ข้อมูลต้นฉบับ:
Project North เป็นโครงการย้ายระบบที่ใช้เวลา 12 สัปดาห์ สำหรับทีม 40 คน งบประมาณการย้ายระบบที่ได้รับการอนุมัติคือ $48,000 ยังไม่มีการกำหนดเวลาสำหรับการตรวจสอบความปลอดภัย ทีมต้องการคำแนะนำเกี่ยวกับโมเดลสำหรับการวิจัย การเขียน และการตรวจสอบโค้ด หมายเหตุจากผู้มีส่วนได้ส่วนเสียระบุว่าฉบับร่างปัจจุบันยาวเกินไป แต่ไม่ได้ระบุจำนวนคำ

ส่งคืนเฉพาะคู่มือเท่านั้น.
Claude Opus 5.5 · กำลังออกเต็ม
## การตัดสินใจ

ไม่สามารถให้คำแนะนำในการเลือกระหว่างสองรุ่นได้จากแพ็กเก็ตต้นทางที่ได้รับการส่งมา แพ็กเก็ตดังกล่าวไม่ได้ระบุชื่อรุ่นใดทั้งสิ้น หรือให้ข้อมูลเกี่ยวกับราคา ผลทดสอบประสิทธิภาพ หรือคุณสมบัติของผลิตภัณฑ์ การเลือกรุ่นหนึ่งแทนอีกรุ่นในขณะนี้ จะเท่ากับการสร้างหลักฐานขึ้นมาเอง ซึ่งขัดกับวัตถุประสงค์ของคู่มือนี้ที่ควรอาศัยหลักฐานที่มีอยู่

การตัดสินใจในทางปฏิบัติคือการระงับการเลือกรุ่นไว้ก่อน ให้ถือว่าขั้นตอนต่อไปเป็นการประเมินที่มีโครงสร้างชัดเจน โดยอยู่ภายใต้ข้อจำกัดสามข้อที่กำหนดไว้ล่วงหน้า:

- โครงการ North มีกำหนดเวลา 12 สัปดาห์
- งบประมาณการย้ายระบบคือ $48,000
- การตรวจสอบความปลอดภัยยังไม่ได้กำหนดวัน

รุ่นใดก็ตามที่จะได้รับการคัดเลือกต้องอยู่ในกรอบเวลา 12 สัปดาห์และงบประมาณการย้ายระบบ $48,000 นอกจากนี้ ยังต้องผ่านการตรวจสอบความปลอดภัย ซึ่งการตรวจสอบดังกล่าวยังไม่ถูกกำหนดไว้ในปฏิทิน จนกว่าจะระบุและประเมินโมเดลทั้งสองตามวัตถุประสงค์สามประการที่ทีมได้กำหนดไว้ (การวิจัย การเขียน และการตรวจสอบโค้ด) การเลือกโมเดลจึงยังไม่ได้รับการตัดสิน คู่มือนี้ระบุไว้อย่างชัดเจน แทนที่จะเสนอความชอบที่หลักฐานไม่สามารถสนับสนุนได้

## หลักฐาน

แพ็กเกจข้อมูลต้นทางประกอบด้วยข้อเท็จจริงดังต่อไปนี้ และเพียงข้อเท็จจริงเหล่านี้เท่านั้นที่เป็นพื้นฐานของคู่มือนี้:

- **ขอบเขตและระยะเวลา:** Project North เป็นโครงการย้ายระบบที่ใช้เวลา 12 สัปดาห์
- **ขนาดทีม:** การย้ายระบบนี้ให้บริการทีมที่มีสมาชิก 40 คน
- **งบประมาณ:** งบประมาณการย้ายระบบที่ได้รับการอนุมัติคือ $48,000
- **ความปลอดภัย:** ยังไม่มีการกำหนดเวลาสำหรับการตรวจสอบความปลอดภัย
- **กรณีการใช้งาน:** ทีมต้องการคำแนะนำเกี่ยวกับโมเดลสำหรับการวิจัย การเขียน และการตรวจสอบโค้ด
- **ความคิดเห็นจากผู้เกี่ยวข้อง:** หมายเหตุจากผู้เกี่ยวข้องระบุว่าฉบับร่างปัจจุบันยาวเกินไป แต่ไม่ได้ระบุจำนวนคำ

เอกสารชุดนี้ขาดข้อมูลหลายอย่างที่การเปรียบเทียบปกติจะอาศัยอยู่ มันไม่ได้ระบุชื่อของสองโมเดลที่กำลังถูกเปรียบเทียบ ไม่ระบุราคาต่อที่นั่ง ต่อโทเคน หรือราคาแบบสมัครสมาชิกสำหรับทั้งสองตัวเลือก ไม่ให้คะแนนเกณฑ์มาตรฐานหรือผลการทดสอบภายใน ไม่อธิบายว่าแต่ละโมเดลสามารถหรือไม่สามารถทำอะไรได้บ้างสำหรับการวิจัย การเขียน หรือการตรวจสอบโค้ด ไม่กล่าวถึงเงื่อนไขการจัดการข้อมูล ตัวเลือกการปรับใช้ หรือข้อกำหนดการบูรณาการ

เนื่องจากข้อมูลเหล่านี้ไม่ปรากฏในเอกสารชุดนี้ คู่มือนี้จึงไม่ทำการประมาณการเกี่ยวกับเรื่องดังกล่าว ไม่ทราบว่าโมเดลใดจะอยู่ในงบประมาณ $48,000 สำหรับทีม 40 คนหรือไม่ ไม่ทราบว่าโมเดลใดมีประสิทธิภาพดีกว่าในการวิจัย การเขียน หรือการตรวจสอบโค้ดหรือไม่ การระบุตัวเลขหรือความสามารถใดๆ ที่เพิ่มเข้ามาในที่นี้จะเป็นการแต่งขึ้น

## ข้อควรระวัง

มีคำถามหลายข้อที่ยังไม่ได้รับการแก้ไข ซึ่งส่งผลต่อวิธีการตีความการตัดสินใจนี้

**ตัวตนของโมเดลยังไม่ชัดเจน** การเปรียบเทียบนี้เกี่ยวข้องกับโมเดล AI สองตัว แต่เอกสารไม่ได้ระบุว่าคือโมเดลใด การตัดสินใจในขั้นตอนต่อไปทั้งหมดขึ้นอยู่กับคำตอบของคำถามนี้ก่อน

**ขอบเขตงบประมาณยังไม่ชัดเจน** เอกสารนี้เรียกตัวเลข $48,000 ว่า "งบประมาณการย้ายระบบที่ได้รับการอนุมัติ" แต่ไม่ได้ระบุว่าจำนวนดังกล่าวมีวัตถุประสงค์เพื่อครอบคลุมค่าลิขสิทธิ์หรือค่าธรรมเนียมการใช้งานของโมเดล หรืออาจครอบคลุมเพียงงานการย้ายระบบ เช่น เวลาของพนักงาน เครื่องมือ หรือบริการ หากค่าใช้จ่ายของโมเดลต้องมาจากงบประมาณ $48,000 เดียวกัน งบประมาณสำรองสำหรับค่าใช้จ่ายของโมเดลใดก็ตามจะแคบกว่าที่ตัวเลขหลักแสดงไว้ ซึ่งจำเป็นต้องได้รับการยืนยัน

**เวลาดำเนินการตรวจสอบความปลอดภัยยังไม่ชัดเจน และถือเป็นความเสี่ยงต่อกำหนดการ** การตรวจสอบความปลอดภัยยังไม่มีการกำหนดเวลา ด้วยกำหนดเวลา 12 สัปดาห์ การตรวจสอบที่ยังไม่มีกำหนดการถือเป็นความเสี่ยงที่แท้จริงต่อกำหนดเวลา เอกสารชุดนี้ไม่ได้ระบุว่ากระบวนการตรวจสอบจะใช้เวลาเท่าใด หรือการตรวจสอบที่ไม่ผ่านจะทำให้ต้องเปลี่ยนไปใช้โมเดลอื่นหรือไม่ ทั้งสองผลลัพธ์อาจใช้เวลาส่วนใหญ่ของ 12 สัปดาห์ โมเดลใดก็ตามไม่ควรถือว่าได้รับการอนุมัติจนกว่าการตรวจสอบจะเสร็จสิ้น

**การกำหนดน้ำหนักของกรณีการใช้งานยังไม่ชัดเจน** ทีมได้ระบุกรณีการใช้งานสามอย่าง ได้แก่ การวิจัย การเขียน และการตรวจสอบโค้ด เอกสารนี้ไม่ได้ระบุว่ากรณีการใช้งานเหล่านี้มีความสำคัญเท่ากันหรือมีกรณีใดที่โดดเด่นกว่า โมเดลที่แข็งแกร่งในด้านหนึ่งอาจอ่อนแอในด้านอื่น และหากไม่มีการกำหนดน้ำหนัก ก็ไม่มีพื้นฐานสำหรับการแลกเปลี่ยนระหว่างกรณีการใช้งานเหล่านี้

**ปริมาณการใช้งานยังไม่ได้รับการกำหนด** ทีมมีสมาชิก 40 คน แต่เอกสารไม่ได้ระบุว่าจำนวนผู้ใช้งานโมเดลหรือระดับการใช้งานจะมากน้อยเพียงใด ปริมาณการใช้งานอาจส่งผลต่อค่าใช้จ่ายอย่างมากภายใต้โครงสร้างราคาบางประเภท ซึ่งไม่สามารถประเมินได้หากไม่มีข้อมูลราคาและประมาณการการใช้งาน

**คำแนะนำเกี่ยวกับระยะเวลา...**
GPT-6 Sol · ข้อมูลเข้าทั้งหมด
คุณกำลังเปรียบเทียบสองโมเดล AI เพื่อสร้างคู่มือการเลือกซื้อที่ใช้งานได้จริง โดยใช้ข้อมูลจากแพ็กเก็ตต้นฉบับด้านล่างเท่านั้น ให้เขียนบทความยาว 700–900 คำ พร้อมหัวข้อต่อไปนี้อย่างแม่นยำ: การตัดสินใจ, หลักฐาน, ข้อควรระวัง, ขั้นตอนต่อไป ต้องรักษาข้อมูลต่อไปนี้ให้ตรงตามต้นฉบับ: โครงการ North มีกำหนดเวลา 12 สัปดาห์; งบประมาณการย้ายระบบคือ $48,000; การตรวจสอบความปลอดภัยยังไม่มีการกำหนดวัน หากข้อมูลใดยังไม่ชัดเจน ให้ระบุไว้อย่างชัดเจน อย่าสร้างราคา มาตรฐานเปรียบเทียบ หรือความสามารถของผลิตภัณฑ์ขึ้นมาเอง

ข้อมูลต้นฉบับ:
Project North เป็นโครงการย้ายระบบที่ใช้เวลา 12 สัปดาห์ สำหรับทีม 40 คน งบประมาณการย้ายระบบที่ได้รับการอนุมัติคือ $48,000 ยังไม่มีการกำหนดเวลาสำหรับการตรวจสอบความปลอดภัย ทีมต้องการคำแนะนำเกี่ยวกับโมเดลสำหรับการวิจัย การเขียน และการตรวจสอบโค้ด หมายเหตุจากผู้มีส่วนได้ส่วนเสียระบุว่าฉบับร่างปัจจุบันยาวเกินไป แต่ไม่ได้ระบุจำนวนคำ

ส่งคืนเฉพาะคู่มือเท่านั้น.
GPT-6 Sol · ผลลัพธ์ทั้งหมด
## คำตัดสิน

อย่ากำหนดโมเดลที่ชนะในขณะนี้ แพ็กเก็ตต้นทางขอคำแนะนำระหว่างโมเดล AI สองตัว แต่ไม่ได้ระบุชื่อโมเดลใดทั้งสิ้น หรือให้ผลลัพธ์สำหรับการวิจัย การเขียน หรือการตรวจสอบโค้ด ดังนั้น การอ้างว่าโมเดลหนึ่งดีกว่าอีกตัวจึงไม่มีหลักฐานสนับสนุน คำแนะนำในทางปฏิบัติคือควรเปรียบเทียบทั้งสองตัวเลือกกับงานของทีมเองก่อนที่จะตัดสินใจเลือก

โครงการ North มีกำหนดเวลา 12 สัปดาห์ งบประมาณสำหรับการย้ายระบบคือ $48,000 การตรวจสอบความปลอดภัยยังไม่ได้กำหนดวัน ซึ่งข้อเท็จจริงเหล่านี้ทำให้การตัดสินใจเป็นเรื่องที่เร่งด่วน แต่ไม่ได้เป็นเหตุผลที่เพียงพอสำหรับการคาดเดา การเลือกที่เหมาะสมต้องพิจารณาว่าโมเดลนั้นช่วยทีม 40 คนให้เสร็จสิ้นงานจริงได้หรือไม่ การใช้งานนั้นสอดคล้องกับงบประมาณที่ได้รับการอนุมัติอย่างไร และสิ่งใดที่ยังไม่ชัดเจนจนกว่าจะทราบกำหนดเวลาการตรวจสอบความปลอดภัย

พิจารณาคำแนะนำนี้ในลักษณะเงื่อนไข: เลือกโมเดลที่มีประสิทธิภาพดีกว่าในงานตัวอย่าง สามารถใช้งานได้ภายในงบประมาณการย้ายระบบที่ได้รับการอนุมัติ และผ่านการตรวจสอบที่จำเป็นสำหรับวัตถุประสงค์การใช้งาน หากไม่มีตัวเลือกใดที่ตรงตามเงื่อนไขเหล่านี้ คู่มือควรระบุว่ายังไม่สามารถแนะนำตัวเลือกใดได้ ข้อมูลที่มีอยู่ยังไม่ยืนยันว่าเงื่อนไขใดได้รับการปฏิบัติตาม

## หลักฐาน

ทีมต้องการคำแนะนำเกี่ยวกับโมเดลสำหรับงานสามประเภท: การวิจัย การเขียน และการตรวจสอบโค้ด นี่คือหมวดหมู่การเปรียบเทียบที่เหมาะสม เนื่องจากมาจากความต้องการที่ระบุไว้ ไม่ใช่จากจุดแข็งของผลิตภัณฑ์ที่สมมติขึ้น ชุดข้อมูลนี้ไม่มีตัวอย่างผลลัพธ์ของทั้งสองโมเดล ไม่มีผลการประเมิน และไม่มีคำอธิบายเกี่ยวกับสิ่งที่ผู้สมัครทั้งสองเสนอ นอกจากนี้ยังไม่มีราคาหรือเกณฑ์เปรียบเทียบ ดังนั้น จึงไม่มีหลักฐานที่ชัดเจนสำหรับการจัดอันดับโมเดลตามความแม่นยำ ความเร็ว คุณภาพ ต้นทุน หรือความเหมาะสม

บริบทของโครงการให้เกณฑ์การตัดสินใจที่มีประโยชน์ โครงการ North เป็นการย้ายระบบสำหรับทีมที่มีสมาชิก 40 คน ดังนั้นการเปรียบเทียบควรสะท้อนถึงงานที่สมาชิกในทีมนั้นจะดำเนินการจริง งบประมาณการย้ายระบบที่ได้รับการอนุมัติคือ $48,000; การใช้โมเดลใดก็ตามที่เสนอมาต้องได้รับการประเมินเทียบกับจำนวนดังกล่าว แทนที่จะใช้งบประมาณที่สร้างขึ้นสำหรับเครื่องมือ AI การตรวจสอบด้านความปลอดภัยยังไม่มีกำหนดเวลา ซึ่งทำให้ช่วงเวลาของการตรวจสอบ—และผลกระทบต่อการนำระบบไปใช้—ยังไม่ชัดเจน

ผู้มีส่วนได้ส่วนเสียคนหนึ่งได้กล่าวว่าฉบับร่างปัจจุบันยาวเกินไป แต่ไม่ได้ระบุจำนวนคำ นั่นเป็นหลักฐานที่แสดงถึงความชอบในความกระชับ ไม่ใช่ข้อจำกัดที่วัดได้สำหรับผลลัพธ์ของโมเดล เมื่อเปรียบเทียบตัวอย่างการเขียน ผู้ประเมินสามารถประเมินได้ว่าผู้สมัครแต่ละคนปฏิบัติตามคำขอให้เขียนอย่างกระชับและรักษาข้อเท็จจริงสำคัญไว้หรือไม่ พวกเขาไม่ควรอ้างว่าโมเดลใดโมเดลหนึ่งตรงกับขีดจำกัดจำนวนคำที่ผู้มีส่วนได้ส่วนเสียกำหนดไว้ เพราะไม่มีการกำหนดไว้

สำหรับการวิจัย หลักฐานที่มีประโยชน์คือว่าผู้สมัครแต่ละคนสามารถแยกข้อเท็จจริงที่ให้ไว้จากคำถามที่ยังเปิดอยู่ และหลีกเลี่ยงข้อสรุปที่ไม่มีหลักฐานสนับสนุนได้หรือไม่ สำหรับการเขียน หลักฐานที่มีประโยชน์คือว่าแต่ละผู้สมัครสามารถสร้างร่างที่ชัดเจนและสั้นกระชับอย่างเหมาะสม โดยไม่ละเลยข้อจำกัด สำหรับการตรวจสอบโค้ด หลักฐานที่มีประโยชน์คือว่าแต่ละผู้สมัครสามารถระบุปัญหาในตัวอย่างที่ให้ไว้ และอธิบายปัญหาเหล่านั้นในลักษณะที่ผู้ตรวจสอบสามารถตรวจสอบได้ นี่เป็นการทดสอบที่เสนอขึ้น ไม่ใช่ผลการค้นพบเกี่ยวกับโมเดลใด ๆ

## ข้อควรระวัง

ข้อควรระวังที่สำคัญที่สุดคือตัวผู้สมัครเองยังไม่ได้รับการกำหนด: เอกสารนี้ไม่ได้ระบุชื่อพวกเขา นอกจากนี้ยังไม่ได้ระบุว่าทีมจะเข้าถึงพวกเขาได้อย่างไร ค่าใช้จ่ายเท่าใด หรือว่าผู้สมัครใดพร้อมใช้งานสำหรับงานที่ตั้งใจไว้หรือไม่ ไม่ควรสรุปความสามารถของผลิตภัณฑ์จากวลี “AI models” แม้การเปรียบเทียบที่ออกแบบมาอย่างดีก็ไม่สามารถให้คำแนะนำเกี่ยวกับผลิตภัณฑ์ได้ จนกว่าจะทราบผู้สมัครและหลักฐานการประเมิน

งบประมาณการย้ายระบบได้รับการอนุมัติแล้ว แต่เอกสารนี้ไม่ได้จัดสรรส่วนใดของงบประมาณดังกล่าวไว้สำหรับการใช้งานหรือการทดสอบโมเดล อย่าถือว่า $48,000 เป็นงบประมาณการซื้อ AI เช่นเดียวกัน กำหนดเวลา 12 สัปดาห์ ก็ไม่ได้กำหนดวันที่การตรวจสอบความปลอดภัยจะเกิดขึ้น เนื่องจากการตรวจสอบความปลอดภัยยังไม่ได้รับการกำหนดเวลา จึงยังไม่ชัดเจนว่าผู้สมัครจะสามารถใช้งานได้ตามข้อกำหนดของทีมหรือไม่ และเมื่อใด

การใช้ทั้งสามประเภทที่ขอไว้อาจให้ผลลัพธ์ที่แตกต่างกันได้ ผู้สมัครหนึ่งอาจเหมาะสมกับงานหนึ่งแต่ไม่เหมาะสมกับงานอื่น; เอกสารชุดนี้ไม่มีพื้นฐานใดที่จะสมมติว่าผู้สมัครเดียวจะชนะในทุกด้าน ได้แก่ การวิจัย การเขียน และการตรวจสอบโค้ด คำแนะนำควรทำให้การแลกเปลี่ยนผลประโยชน์ดังกล่าวชัดเจน แทนที่จะซ่อนมันไว้ภายใต้ป้ายกำกับโดยรวม หากทีมตัดสินใจว่าหมวดหมู่หนึ่งมีความสำคัญมากกว่าหมวดหมู่อื่น ๆ ลำดับความสำคัญนั้นควรมาจากผู้มีส่วนได้ส่วนเสีย ไม่ใช่จากคู่มือนี้

สุดท้ายนี้ ข้อสังเกตเกี่ยวกับร่างที่ยาวน่าจะเกินไป ไม่ควรถูกเข้าใจผิดว่าเป็นหลักฐานเกี่ยวกับประสิทธิภาพของโมเดล มันอธิบายถึงคำติชมเกี่ยวกับร่างปัจจุบัน โดยไม่ระบุผู้เขียนหรือกำหนดความยาวเป้าหมาย มันสามารถเป็นข้อมูลอ้างอิงในการนำเสนอคำแนะนำสุดท้ายได้ แต่ไม่สามารถตัดสินการเปรียบเทียบได้

## ขั้นตอนต่อไป

ระบุผู้สมัครสองคนและขอให้ทีมจัดเตรียมงานวิจัย การเขียน และการตรวจสอบโค้ดที่เป็นตัวแทน ให้แต่ละโมเดลได้รับวัสดุและคำแนะนำที่เหมือนกันสำหรับแต่ละงาน รวมถึงคำแนะนำในการระบุความไม่แน่นอนและหลีกเลี่ยงการเพิ่มข้อเท็จจริง ให้ผู้ประเมินบันทึกว่าคำตอบแต่ละข้อถูกต้องในส่วนใด ขาดส่วนใด และข้ออ้างใดที่ต้องการการตรวจสอบ ให้แยกการสังเกตเฉพาะงานไว้ต่างหาก เพื่อไม่ให้ตัวอย่างการเขียนที่ดีถูกใช้แทนหลักฐานเกี่ยวกับการตรวจสอบโค้ด

ก่อนตัดสินใจ ให้ยืนยันค่าใช้จ่ายของการใช้งานที่ตั้งใจไว้เทียบกับงบประมาณการย้ายระบบ $48,000 และกำหนดเวลาที่การตรวจสอบความปลอดภัยสามารถดำเนินการได้ คำตอบทั้งสองข้อนี้ไม่มีอยู่ในชุดข้อมูล หากคำถามเหล่านั้นไม่สามารถแก้ไขได้ทันเวลาสำหรับการตัดสินใจ ให้รายงานข้อจำกัดนั้นอย่างชัดเจน แทนที่จะนำเสนอความชอบชั่วคราวเป็นตัวเลือกที่ได้รับการอนุมัติ

คำแนะนำสุดท้ายสำหรับผู้ซื้อจึงสามารถสั้นและตรวจสอบได้: ระบุชื่อผู้สมัคร, ชี้แจงหลักฐานสำหรับแต่ละการใช้งานทั้งสาม, อธิบายการแลกเปลี่ยนผลประโยชน์ และระบุปัญหาที่ยังไม่ได้รับการอนุมัติหรืองบประมาณที่ยังค้างอยู่ จนกว่าข้อมูลดังกล่าวจะมีอยู่ คำตอบที่ตรงไปตรงมาสำหรับ Project North ไม่ใช่ “Model A” หรือ “Model B” แต่คือการเปรียบเทียบดังกล่าวยังไม่ได้รับการสนับสนุนด้วยหลักฐาน.
ให้ถือว่าการตรวจสอบนี้เป็นการตรวจสอบการจัดการบริบท ไม่ใช่การจัดอันดับคุณภาพ.
การเขียนแบบยาว
การเสร็จสิ้นภายใต้ขีดจำกัดผลผลิต 2,400 โทเคนเดียวกัน
ข้อกำหนดเดียวกันนี้กำหนดให้มี 5 ส่วน ทั้งสองโมเดลมีขีดจำกัดผลผลิตที่ 2,400 โทเคน; ข้อมูลเมตาที่ส่งกลับมาอธิบายถึงความแตกต่างที่เห็นได้ชัด.
Claude ได้ถึงขีดจำกัดผลลัพธ์ที่กำหนดไว้ก่อนถึงกฎการตัดสินใจ Sol ได้เสร็จสิ้นการเขียนบทสรุปภายในขีดจำกัดดังกล่าว สิ่งนี้สนับสนุนการแนะนำสำหรับการทำงานที่มีข้อจำกัดนี้ ไม่ใช่การจัดอันดับทั่วไปเกี่ยวกับความสามารถหรือความเร็วในการเขียนสูงสุด ข้อความที่ส่งกลับมาทั้งหมด รวมถึงส่วนที่ถูกตัดทอน ได้ถูกเก็บไว้ด้านล่างนี้.
งานแบบยาว
การเขียนแบบยาว: GPT-6 Sol ได้เสร็จสิ้นการเขียนตามคำชี้แจง
นี่คือภารกิจเปรียบเทียบโดยตรงครั้งแรก ข้อความคำสั่งได้ระบุชื่ออย่างชัดเจนว่า Claude Opus 5.5 และ GPT-6 Sol, ได้มอบชุดเอกสารชี้แจงโครงการ Project North ที่เหมือนกันให้กับทั้งสองฝ่าย และกำหนดให้ต้องจัดทำบันทึกการตัดสินใจแบบมีเงื่อนไข.
| วัด | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| ความยาวที่มองเห็นได้ | 648 คำ; finish_reason=ความยาว | 1,065 คำ; finish_reason=หยุด |
| ส่วนที่จำเป็น | 4/5; กฎการตัดสินใจหายไปหลังการตัดสั้น | 5/5 |
| บัตรคะแนน 4 แถว | ปัจจุบันและสมมาตร | ปัจจุบันและสมมาตร |
| การตรวจสอบของนักบิน / เงื่อนไขการหยุด | เริ่มแล้วแต่ถูกตัดสั้นก่อนที่จะเสร็จสิ้น | การตรวจสอบสามครั้งและเงื่อนไขหยุด |
| คะแนน | 7.0 / 10 | 10.0 / 10 |
ข้อสรุป: ด้วยขีดจำกัดผลออกที่ 2,400 โทเคน เช่นเดียวกัน GPT-6 Sol ส่งคืนทั้งห้าส่วน ในขณะที่ Claude Opus 5.5 ถึงขีดจำกัดก่อนถึงกฎการตัดสินใจ สิ่งนี้แสดงให้เห็นว่าโมเดลสามารถทำงานจนเสร็จสมบูรณ์ภายใต้การตั้งค่านี้ แต่ไม่ได้กำหนดความสามารถในการเขียนสูงสุดหรือความเร็วโดยทั่วไปของโมเดลใด ๆ.
ข้อมูลเข้าทั้งหมดที่แบ่งปัน
คุณกำลังเขียนบันทึกการตัดสินใจสำหรับทีมที่กำลังเลือกระหว่าง Claude Opus 5.5 และ GPT-6 Sol ชื่อโมเดลเป็นชื่อที่กำหนดไว้แล้วและต้องปรากฏตามตัวอักษรที่เขียนไว้อย่างถูกต้อง โดยใช้ข้อมูลหลักฐานจากชุดข้อมูลด้านล่างเท่านั้น ให้เขียนข้อความยาว 900–1100 คำ พร้อมทั้งส่วนต่อไปนี้อย่างครบถ้วน: คำแนะนำของผู้บริหาร; สิ่งที่หลักฐานสนับสนุน; จุดที่หลักฐานยังขาด; โครงการทดลอง 30 วัน; กฎการตัดสินใจ

ข้อกำหนด: (1) เปรียบเทียบ Claude Opus 5.5 และ GPT-6 Sol อย่างสมดุล; (2) แยกหลักฐานที่สังเกตได้ สมมติฐาน และสิ่งที่ยังไม่ทราบ; (3) รักษาวันที่ งบประมาณ ขนาดทีม และสถานะความปลอดภัยที่ยังไม่ได้รับการแก้ไขให้ตรงตามเดิม; (4) รวมสกอร์การ์ดแบบย่อ 4 แถว ที่ครอบคลุมการสังเคราะห์ผลการวิจัย การเขียนแบบยาว การตรวจสอบโค้ด และ JSON ที่มีโครงสร้าง; (5) ให้คำแนะนำแบบมีเงื่อนไข แทนที่จะกำหนดผู้ชนะ; (6) ระบุการตรวจสอบนำร่องที่วัดได้สามข้อและเงื่อนไขหยุดโครงการ; (7) ไม่ได้กำหนดราคา, จุดอ้างอิง, ข้อจำกัดบริบท หรือความสามารถของผลิตภัณฑ์

ชุดข้อมูลหลักฐาน
- Project North เป็นโครงการย้ายระบบระยะเวลา 12 สัปดาห์ สำหรับทีม 40 คน
- งบประมาณการย้ายระบบที่ได้รับการอนุมัติคือ $48,000 ชุดข้อมูลนี้ไม่ระบุว่าการใช้โมเดลอยู่ในงบประมาณดังกล่าวหรือไม่
- ยังไม่มีการกำหนดเวลาสำหรับการตรวจสอบความปลอดภัย
- ทีมต้องการการสังเคราะห์ผลการวิจัย การเขียนแบบยาว การตรวจสอบโค้ด และการสกัดข้อมูล JSON แบบมีโครงสร้าง
- ผู้มีส่วนได้ส่วนเสียคนหนึ่งระบุว่าฉบับร่างปัจจุบันยาวเกินไป แต่ยังไม่มีจำนวนคำเป้าหมายที่ได้รับการอนุมัติ
- ยังไม่มีผลลัพธ์ที่ควบคุมได้จาก Claude Opus 5.5 หรือ GPT-6 Sol ที่ถูกจัดเตรียมไว้
- ทีมต้องการตัวเลือกที่สามารถตรวจสอบได้ และสามารถดำเนินการทดลองใช้เป็นระยะเวลา 30 วัน ด้วยคำสั่งที่เหมือนกันและการตรวจสอบโดยมนุษย์

ส่งกลับเพียงบันทึกเท่านั้น อย่าอ้างว่าชุดข้อมูลหลักฐานนี้พิสูจน์ได้ว่าโมเดลใดดีกว่า.
Claude Opus 5.5 · ผลลัพธ์ที่ส่งคืนมาอย่างครบถ้วน
## คำแนะนำจากฝ่ายบริหาร

อย่าเลือก Claude Opus 5.5 หรือ GPT-6 Sol ในขณะนี้ เนื่องจากชุดข้อมูลหลักฐานไม่มีผลลัพธ์ที่ได้รับการควบคุมจากทั้งสองโมเดล ดังนั้นจึงไม่มีพื้นฐานที่สังเกตได้เพื่อประกาศว่าโมเดลใดดีกว่าโมเดลอื่นในทั้งสี่งานที่จำเป็น

คำแนะนำนี้มีเงื่อนไข ให้ดำเนินการทดลองใช้ (pilot) เป็นระยะเวลา 30 วัน โดยให้ทั้งสองโมเดลได้รับคำสั่ง (prompts) ที่เหมือนกัน และใช้การตรวจสอบโดยมนุษย์ในลักษณะเดียวกัน หลังจากนั้น ให้เลือกโมเดลที่ผ่านเกณฑ์ที่กำหนดไว้ก่อนเริ่มการทดลองใช้ (pilot) โดยต้องแก้ไขปัญหาด้านความปลอดภัยและงบประมาณที่ระบุไว้ด้านล่างให้เสร็จสิ้นก่อน มีผลลัพธ์ที่เป็นไปได้สามกรณี:

- **โมเดลหนึ่งผ่านเกณฑ์:** เลือกโมเดลนั้น
- **ทั้งสองผ่าน:** ใช้เกณฑ์ตัดสินในกรณีเสมอกันตามกฎการตัดสินใจ
- **ทั้งสองไม่ผ่าน:** ไม่ใช้โมเดลใด

วิธีการนี้ให้ทีมมีตัวเลือกที่สามารถตรวจสอบได้ตามที่ทีมได้ร้องขอ

ข้อมูลโครงการที่กำหนดไว้แล้วคือ:

- โครงการ North เป็นโครงการย้ายระบบระยะเวลา 12 สัปดาห์ สำหรับทีม 40 คน
- งบประมาณการย้ายระบบที่ได้รับการอนุมัติคือ $48,000 เอกสารชุดนี้ไม่ได้ระบุว่าค่าใช้จ่ายในการใช้โมเดลอยู่ในงบประมาณดังกล่าวหรือไม่
- ยังไม่มีการกำหนดเวลาสำหรับการตรวจสอบด้านความปลอดภัย
- เอกสารโครงการไม่ระบุวันที่ในปฏิทิน (ไม่มีวันที่เริ่มโครงการ วันที่สิ้นสุด หรือช่วงเวลาทดลองใช้) ดังนั้นจดหมายนี้จึงไม่กำหนดวันที่ใดๆ

## สิ่งที่หลักฐานสนับสนุน

**หลักฐานที่สังเกตได้** นี่คือข้อเท็จจริงที่ระบุโดยตรงในเอกสารโครงการ:

- โครงการ North เป็นโครงการย้ายระบบระยะเวลา 12 สัปดาห์ สำหรับทีม 40 คน
- งบประมาณการย้ายระบบที่ได้รับการอนุมัติคือ $48,000 และไม่ระบุว่าการใช้งบประมาณนี้ครอบคลุมการใช้โมเดลหรือไม่
- ยังไม่มีการกำหนดเวลาสำหรับการตรวจสอบความปลอดภัย
- งานที่จำเป็น ได้แก่ การสังเคราะห์ผลการวิจัย การเขียนบทความยาว การตรวจสอบโค้ด และการสกัดข้อมูล JSON แบบมีโครงสร้าง
- ผู้มีส่วนได้ส่วนเสียคนหนึ่งระบุว่าฉบับร่างปัจจุบันยาวเกินไป แต่ยังไม่มีจำนวนคำเป้าหมายที่ได้รับการอนุมัติ
- ยังไม่มีผลลัพธ์ที่ผ่านการควบคุมจาก Claude Opus 5.5 หรือ GPT-6 Sol ที่ถูกส่งมา
- ทีมต้องการตัวเลือกที่สามารถตรวจสอบได้ และสามารถดำเนินการทดลองใช้แบบนำร่องเป็นระยะเวลา 30 วัน ด้วยคำสั่งที่เหมือนกันและการตรวจสอบโดยมนุษย์

**สิ่งที่หลักฐานนี้สนับสนุน** หลักฐานนี้กำหนดสิ่งที่ต้องประเมินและวิธีการประเมิน แต่ไม่กำหนดว่าโมเดลใดจะชนะ มันเป็นเหตุผลที่สนับสนุนการทดลองใช้แบบนำร่องที่มีโครงสร้างและเปรียบเทียบแบบคู่ขนาน มันไม่สนับสนุนข้ออ้างใดๆ เกี่ยวกับคุณภาพ ความเร็ว ค่าใช้จ่าย การจัดการบริบท หรือความพร้อมใช้งานของฟีเจอร์สำหรับโมเดลใดก็ตาม

**ตารางคะแนน (สถานะปัจจุบันของหลักฐาน)**

| งาน | Claude Opus 5.5 | GPT-6 Sol | มาตรการทดลอง |
|---|---|---|---|
| การสังเคราะห์งานวิจัย | ไม่มีผลลัพธ์ที่ควบคุม | ไม่มีผลลัพธ์ที่ควบคุม | คะแนนตามเกณฑ์การประเมินของผู้ประเมินแบบไม่เปิดเผย |
| การเขียนแบบยาว | ไม่มีผลลัพธ์ที่ควบคุม | ไม่มีผลลัพธ์ที่ควบคุม | คะแนนตามเกณฑ์การประเมินบวกกับการปฏิบัติตามเป้าหมายความยาวที่ได้รับการอนุมัติ |
| การตรวจสอบโค้ด | ไม่มีผลลัพธ์ที่ควบคุม | ไม่มีผลลัพธ์ที่ควบคุม | สัดส่วนของปัญหาที่ทราบแล้วที่ได้รับการระบุ |
| JSON ที่มีโครงสร้าง | ไม่มีผลลัพธ์ที่ควบคุม | ไม่มีผลลัพธ์ที่ควบคุม | อัตราการผ่านการตรวจสอบความถูกต้องของสคีมา |

ทุกเซลล์สำหรับทั้งสองโมเดลมีค่าเท่ากัน เนื่องจากชุดข้อมูลนี้ปฏิบัติต่อทั้งสองโมเดลอย่างเท่าเทียมกัน ปัจจุบันยังไม่มีแถวใดที่แสดงว่าโมเดลใดดีกว่า |

## จุดที่ขาดข้อมูล

**ข้อไม่ทราบ** แพ็กเก็ตไม่ได้ระบุข้อมูลเกี่ยวกับเรื่องต่อไปนี้:

- ค่าใช้จ่ายในการใช้โมเดลจะอยู่ในงบประมาณการย้ายระบบ $48,000 หรือจำเป็นต้องจัดหาเงินทุนแยกต่างหาก
- เมื่อใดการตรวจสอบความปลอดภัยจะเกิดขึ้น ครอบคลุมเรื่องใด และโมเดลใดจะได้รับการยอมรับตามผลการตรวจสอบนั้น สถานะความปลอดภัยของทั้งสองโมเดลยังไม่ได้รับการแก้ไข
- วันที่ในปฏิทินสำหรับการย้ายระบบ 12 สัปดาห์และโครงการทดลอง 30 วัน
- จำนวนคำเป้าหมายที่ได้รับการอนุมัติสำหรับงานเขียนแบบยาว ไม่สามารถประเมินความคิดเห็น "ยาวเกินไป" ของผู้มีส่วนได้ส่วนเสียได้หากไม่มีข้อมูลนี้
- ราคา ผลลัพธ์การทดสอบประสิทธิภาพ ข้อจำกัดด้านบริบท และความสามารถของผลิตภัณฑ์สำหรับ Claude Opus 5.5 และ GPT-6 Sol ไม่มีข้อมูลใดถูกจัดเตรียมไว้ และบันทึกนี้ไม่สมมติสิ่งใดทั้งสิ้น
- ผู้ตรวจสอบเป็นมนุษย์คือใคร มีจำนวนเท่าใด และจะแก้ไขความเห็นไม่ตรงกันระหว่างพวกเขาอย่างไร
- ข้อมูลใดที่โครงการทดลองสามารถใช้ก่อนที่การตรวจสอบความปลอดภัยจะเสร็จสิ้น

**สมมติฐาน** นี่คือข้อเสนอที่ระบุในบันทึกนี้ ไม่ใช่ข้อเท็จจริงจากเอกสารชุดนี้ และแต่ละข้อต้องได้รับการอนุมัติจากทีม:

- ผู้ทดลองสามารถใช้ข้อมูลที่ไม่เป็นความลับหรือข้อมูลสังเคราะห์ได้จนกว่าการตรวจสอบความปลอดภัยจะอนุมัติให้ใช้ข้อมูลจริง
- ผู้ตรวจสอบสามารถไม่ทราบว่าโมเดลใดสร้างผลลัพธ์แต่ละรายการ
- ทีมสามารถจัดชุดคำสั่งคงที่สำหรับแต่ละภาระงาน ซึ่งสะท้อนงานจริงของ Project North
- เกณฑ์ผ่านที่เสนอไว้ด้านล่างเป็นจุดเริ่มต้นที่ทีมอาจปรับเปลี่ยนก่อนที่โครงการนำร่องจะเริ่ม แต่ไม่สามารถปรับเปลี่ยนได้ระหว่างการดำเนินการ

## โครงการนำร่อง 30 วัน

**การออกแบบ**

1.
GPT-6 Sol · ผลลัพธ์ที่ส่งกลับมาครบถ้วน
## คำแนะนำจากผู้บริหาร

อย่าเลือก Claude Opus 5.5 หรือ GPT-6 Sol ในขณะนี้ Project North เป็นโครงการย้ายระบบระยะเวลา 12 สัปดาห์สำหรับทีม 40 คน และชุดข้อมูลนี้ไม่จัดเตรียมผลลัพธ์ที่ควบคุมได้จากทั้งสองโมเดล ดังนั้น จึงสนับสนุนแผนการเปรียบเทียบ ไม่ใช่การตัดสินประสิทธิภาพ ให้ดำเนินการทดลองใช้ 30 วันที่มีอยู่ด้วยคำสั่งที่เหมือนกันและการตรวจสอบโดยมนุษย์ จากนั้นจึงตัดสินใจอย่างสามารถตรวจสอบได้ตามเกณฑ์ที่ตกลงกันไว้ก่อนที่จะตรวจสอบผลลัพธ์ เลือกใช้โมเดลใดก็ตามก็ต่อเมื่องานที่ได้รับการตรวจสอบแล้วตรงกับความต้องการของทีม การใช้งานสอดคล้องกับข้อตกลงทางการเงินที่ได้รับการอนุมัติ และการตรวจสอบด้านความปลอดภัยที่ยังไม่เสร็จสิ้นอนุญาตให้สามารถนำไปใช้ได้ หากเงื่อนไขดังกล่าวไม่ครบถ้วน ให้เลื่อนการเลือกออกไป แทนที่จะถือว่าการเปรียบเทียบที่ยังไม่สมบูรณ์เป็นความสำเร็จ

งบประมาณการย้ายระบบที่ได้รับการอนุมัติคือ $48,000 แพ็กเกจดังกล่าวไม่ได้ระบุว่าการใช้โมเดลอยู่ภายในงบประมาณนั้นหรือไม่ กำหนดเวลาการตรวจสอบความปลอดภัยยังไม่ได้กำหนด สิ่งเหล่านี้เป็นข้อจำกัดในการตัดสินใจสำหรับทั้ง Claude Opus 5.5 และ GPT-6 Sol ไม่ใช่หลักฐานเพื่อสนับสนุนการเลือกโมเดลใดโมเดลหนึ่ง

## สิ่งที่หลักฐานสนับสนุน

**สิ่งที่สังเกตได้:** ทีมงานต้องการการสังเคราะห์ผลการวิจัย การเขียนแบบยาว การตรวจสอบโค้ด และการสกัดข้อมูล JSON แบบมีโครงสร้าง ทีมงานต้องการตัวเลือกที่สามารถตรวจสอบได้ และสามารถดำเนินการทดลองใช้ 30 วันโดยใช้คำสั่งที่เหมือนกันและการตรวจสอบโดยมนุษย์ ผู้มีส่วนได้ส่วนเสียคนหนึ่งระบุว่าฉบับร่างปัจจุบันยาวเกินไป แต่ยังไม่มีจำนวนคำเป้าหมายที่ได้รับการอนุมัติ ข้อเสนอแนะดังกล่าวระบุถึงปัญหาที่ควรทดสอบในผลลัพธ์การเขียน แต่ไม่ได้กำหนดโมเดลที่ได้รับการชื่นชอบหรือความยาวที่ยอมรับได้

ตารางคะแนนตามงานปัจจุบันถูกออกแบบให้ไม่จัดอันดับโดยเจตนา:

| สายงาน | Claude Opus 5.5 | GPT-6 Sol | หลักฐานจากโครงการทดลองที่ต้องรวบรวม |
|---|---|---|---|
| การสังเคราะห์งานวิจัย | ยังไม่ได้รับการทดสอบ | ยังไม่ได้รับการทดสอบ | ความแม่นยำ ความครอบคลุม และความสามารถในการติดตามที่ผู้ตรวจสอบให้คะแนน |
| การเขียนแบบยาว | ยังไม่ได้รับการทดสอบ | ยังไม่ได้รับการทดสอบ | ความมีประโยชน์ ความชัดเจน และความกระชับที่ผู้ประเมินให้คะแนน |
| การตรวจสอบโค้ด | ยังไม่ได้รับการทดสอบ | ยังไม่ได้รับการทดสอบ | ข้อค้นพบที่ผู้ประเมินยืนยันและข้อกล่าวอ้างที่ไม่มีหลักฐานสนับสนุน |
| JSON ที่มีโครงสร้าง | ยังไม่ได้รับการทดสอบ | ยังไม่ได้รับการทดสอบ | ผลลัพธ์ที่ถูกต้องและการสกัดข้อมูลจากฟิลด์ที่ถูกต้อง |

**สมมติฐานสำหรับการวางแผน ไม่ใช่ผลลัพธ์ที่สังเกตได้:** ตัวอย่างงานที่เทียบเคียงได้และเกณฑ์การประเมินร่วมสามารถเปิดเผยความแตกต่างที่เกี่ยวข้องกับ Project North ได้ การทดลองนำร่องควรทดสอบสมมติฐานดังกล่าว การให้คำสั่งที่เหมือนกันเพียงอย่างเดียวจะไม่ทำให้การเลือกสามารถตรวจสอบได้: ทีมต้องเก็บรักษาข้อมูลนำเข้า ผลลัพธ์ทั้งสอง เกณฑ์การตรวจสอบ คำตัดสินของผู้ตรวจสอบ และเหตุผลสำหรับการยกเว้นหรือการดำเนินการซ้ำด้วย การตรวจสอบโดยมนุษย์ควรใช้มาตรฐานเดียวกันกับทุกโมเดล

สำหรับการเขียนแบบยาว ผู้ประเมินควรแยกแยะระหว่าง “ยาวเกินไป” กับ “ไม่มีประโยชน์” คำตอบที่สั้นกว่าอาจละเว้นเนื้อหาที่จำเป็น ส่วนคำตอบที่ยาวกว่าอาจยังคงชัดเจนและใช้งานได้ เนื่องจากไม่มีการกำหนดจำนวนคำเป้าหมายที่ได้รับการอนุมัติ โครงการนำร่องสามารถบันทึกความยาวและคำตัดสินของผู้ประเมินได้ แต่ไม่ควรกำหนดจำนวนคำตามอำเภอใจย้อนหลังให้เป็นมาตรฐานการยอมรับ หลักการเดียวกันนี้ใช้กับงานอื่นๆ ด้วย: บันทึกสิ่งที่ผู้ประเมินสังเกตเห็น แทนที่จะแปลงความชอบส่วนตัวเป็นข้ออ้างเกี่ยวกับความสามารถทั่วไปของโมเดล

## ในกรณีที่ขาดหลักฐาน

**ไม่ทราบ:** ชุดข้อมูลนี้ไม่รวมผลลัพธ์ที่ได้รับการควบคุมจาก Claude Opus 5.5 หรือ GPT-6 Sol จึงไม่สามารถกำหนดคุณภาพ ความน่าเชื่อถือ หรือความเหมาะสมแบบสัมพัทธ์สำหรับงานทั้งสี่สายได้ นอกจากนี้ ยังไม่ระบุราคา ข้อจำกัดด้านบริบท มาตรฐานเปรียบเทียบ หรือข้อมูลเกี่ยวกับความสามารถของผลิตภัณฑ์ ดังนั้น เอกสารนี้จึงไม่สามารถประมาณการค่าใช้จ่ายในการใช้งาน หรือสรุปได้ว่าโมเดลใดจะทำงานได้ดีกว่ากับเนื้อหาของ Project North

ต้องชี้แจงขอบเขตงบประมาณให้ชัดเจนก่อนตัดสินใจซื้อ $48,000 เป็นงบประมาณ *การย้ายระบบ* ที่ได้รับการอนุมัติแล้ว; แต่ไม่มีการระบุว่าการใช้งานโมเดลต้องจ่ายจากงบประมาณนี้หรือไม่ การถือว่าค่าใช้จ่ายนี้รวมอยู่ในงบประมาณหรือเป็นค่าใช้จ่ายเพิ่มเติม จะก่อให้เกิดสมมติฐานทางการเงินที่เอกสารชุดนี้ไม่สนับสนุน ทีมควรบันทึกคำตอบและขั้นตอนการอนุมัติที่เกี่ยวข้องก่อนที่จะตัดสินใจใช้งานอย่างต่อเนื่อง

เรื่องความปลอดภัยของทั้งสองรุ่นที่เสนอมา ก็ยังไม่ได้รับการแก้ไขเช่นกัน ยังไม่มีกำหนดเวลาสำหรับการตรวจสอบความปลอดภัย และเอกสารชุดนี้ไม่ได้ให้ผลลัพธ์ด้านความปลอดภัยใดๆ ผลลัพธ์การทดลองที่แข็งแกร่งก็ไม่สามารถแก้ไขสถานะดังกล่าวได้ ทีมควรระบุให้ชัดเจนว่าใครเป็นผู้กำหนดเวลาและตัดสินใจในการตรวจสอบ ข้อมูลใดที่ผู้ตรวจสอบต้องการ และกิจกรรมทดลองนั้นเองได้รับอนุญาตตามกฎระเบียบที่เกี่ยวข้องหรือไม่; เอกสารชุดนี้ไม่ได้ตอบคำถามเหล่านั้น ไม่มีการระบุวันที่เริ่มต้นหรือสิ้นสุดในปฏิทินสำหรับการย้ายระบบ การทดลองใช้ หรือการตรวจสอบความปลอดภัย ดังนั้นทีมไม่ควรให้เข้าใจว่า การตัดสินใจด้านความปลอดภัยจะเกิดขึ้นภายในระยะเวลาทดลองใช้ 30 วัน หรือการย้ายระบบ 12 สัปดาห์

## การทดลอง 30 วัน

ก่อนการเปรียบเทียบครั้งแรก ทีมควรเลือกคำสั่งที่เป็นตัวแทนสำหรับทั้งสี่สายงาน กำหนดรูปแบบที่คาดหวังของแต่ละคำตอบ และตกลงกันเกี่ยวกับเกณฑ์การประเมินโดยมนุษย์ ทั้งสองโมเดลควรได้รับคำสั่งที่เหมือนกันและคำแนะนำการประเมินที่เหมือนกัน ผู้ประเมินควรบันทึกการตัดสินของตนโดยอิงจากงานที่ประเมิน ไม่ใช่จากชื่อเสียงของโมเดล ให้เก็บรักษาคำสั่งป้อนข้อมูล ผลลัพธ์ การประเมิน และการแก้ไขที่ร้องขอไว้ เพื่อให้ผู้อ่านในภายหลังสามารถสร้างการตัดสินแต่ละข้อขึ้นมาใหม่ได้ ให้บันทึกการเบี่ยงเบนจากกระบวนการทั่วไป แทนที่จะละเว้นกรณีที่ยากโดยไม่แจ้งให้ทราบ

ใช้การตรวจสอบสามประการที่สามารถวัดได้:

1. **คุณภาพงานที่ได้รับการตรวจสอบ:** สำหรับการสังเคราะห์งานวิจัย การเขียนแบบยาว และการตรวจสอบโค้ด ให้คำนวณสัดส่วนของผลลัพธ์ที่ผู้ตรวจสอบยอมรับสำหรับงานที่กำหนดไว้ นอกจากนี้ ให้บันทึกเหตุผลการปฏิเสธแยกต่างหาก — เช่น การครอบคลุมไม่ครบถ้วน การเขียนไม่ชัดเจน หรือผลการตรวจสอบโค้ดที่ยังไม่ได้รับการยืนยัน ให้รายงานผลตามสายงานและโมเดล ไม่ใช่เพียงคะแนนรวมเดียว
2. **ความน่าเชื่อถือของ JSON ที่มีโครงสร้าง:** นับผลลัพธ์ที่ตรงกับโครงสร้างที่ตกลงกันไว้ และผลลัพธ์ที่ผู้ตรวจสอบยืนยันว่าฟิลด์ที่สกัดออกมาถูกต้อง รายงานอัตราทั้งสองสำหรับ Claude Opus 5.5 และ GPT-6 Sol; คำตอบที่มีโครงสร้างถูกต้องไม่ควรถูกนับว่าแม่นยำเพียงเพราะสามารถวิเคราะห์ได้
3. **ความพยายามในการตรวจสอบและความสามารถในการติดตาม:** บันทึกเวลาที่มนุษย์ใช้ในการตรวจสอบและแก้ไขผลลัพธ์แต่ละรายการตามความจำเป็น นับกรณีที่ไม่มีหลักฐานที่เก็บไว้เพียงพอเพื่ออธิบายการตัดสินใจของผู้ตรวจสอบ เปรียบเทียบมาตรการเหล่านี้บนชุดคำสั่งเดียวกัน รวมถึงกรณีที่ผลลัพธ์ทั้งสองไม่ได้รับการยอมรับ

ตกลงกันเกี่ยวกับมาตรฐานการยอมรับและวิธีการจัดการกรณีที่คะแนนเท่ากันก่อนที่จะดูผลการทดลอง; ชุดข้อมูลนี้ไม่จัดเตรียมเกณฑ์อ้างอิงใด ๆ สำหรับการกำหนดค่าเกณฑ์เชิงตัวเลข เมื่อครบ 30 วัน ให้เผยแพร่เกณฑ์การประเมิน จำนวนกรณี เหตุผลของผู้ตรวจสอบ และคำถามที่ยังไม่ได้รับการแก้ไข **เงื่อนไขการหยุด:** หยุดการนำระบบไปใช้หากไม่สามารถปฏิบัติตามข้อกำหนดด้านความปลอดภัยสำหรับโครงการนำร่องหรือการใช้งานในขั้นต่อไปได้ หรือหากทีมไม่สามารถกำหนดงบประมาณและขั้นตอนการอนุมัติที่ถูกต้องได้ อย่าใช้คะแนนคุณภาพที่ดีเป็นข้ออ้างแทนการอนุมัติทั้งสองกรณี

## กฎการตัดสินใจ

เลือก Claude Opus 5.5 หากหลักฐานจากโครงการนำร่องของมันตรงกับมาตรฐานที่ตกลงกันไว้ล่วงหน้า มีความแข็งแกร่งกว่าอย่างมีนัยสำคัญในสายงานที่ทีมให้ความสำคัญ และเงื่อนไขด้านความปลอดภัยและทางการเงินได้รับการแก้ไขแล้ว ใช้กฎเดียวกันนี้กับ GPT-6 Sol หากทั้งสองรุ่นตรงตามมาตรฐานโดยไม่มีข้อแตกต่างที่สำคัญและเกี่ยวข้อง ให้ตัดสินใจโดยใช้ลำดับความสำคัญของโครงการที่บันทึกไว้และข้อจำกัดที่ได้รับการแก้ไข แทนที่จะอ้างว่าฝ่ายใดมีประสิทธิภาพดีกว่า หากไม่มีรุ่นใดผ่านเกณฑ์ — หรือขอบเขตงบประมาณหรือสถานะความปลอดภัยยังไม่ได้รับการแก้ไข — ยังไม่ควรเลือกโมเดลในขณะนี้ ผลลัพธ์ดังกล่าวจะรักษาการตัดสินใจที่สามารถตรวจสอบได้สำหรับทีม 40 คน โดยไม่ยืนยันเกินกว่าที่หลักฐานสามารถสนับสนุนได้.
ข้อมูลเมตา: Claude — HTTP 200 · 25.98 วินาที · finish_reason=length · prompt_tokens=598 · completion_tokens=2400
GPT — HTTP 200 · 27.763 วินาที · finish_reason=stop · prompt_tokens=386 · completion_tokens=1695
การสังเคราะห์จากแหล่งต้น
งานวิจัย
การสังเคราะห์จากแหล่งข้อมูล: ผลเสมอ
ทั้งสองโมเดลได้แก้ไขความขัดแย้งเกี่ยวกับวันที่ให้เป็นวันที่ 15 ตุลาคม รักษางบประมาณ $12,000 ที่ตกลงกันไว้ และถือว่าคำกล่าวของผู้จัดการที่ว่า “แม่นยำเสมอ” เป็นคำกล่าวที่ไม่มีหลักฐานสนับสนุน ผลลัพธ์คือทั้งสองโมเดลมีคะแนนเท่ากันในภารกิจนี้.
| วัด | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| คะแนน | 9.5 / 10 | 9.5 / 10 |
| การจัดการความขัดแย้ง | S2 กำหนดกำหนดเวลา | S2 กำหนดกำหนดเวลา |
| ข้อกล่าวอ้างที่ไม่มีหลักฐานสนับสนุน | ถูกทำเครื่องหมายว่าไม่ได้รับการสนับสนุน | ถูกทำเครื่องหมายว่าไม่ได้รับการสนับสนุน |
| ความแตกต่างในทางปฏิบัติ | คำอธิบายเกี่ยวกับความเสี่ยงอย่างละเอียดยิ่งขึ้น | คำแนะนำที่กระชับยิ่งขึ้น |
ข้อมูลเข้าทั้งหมดที่แบ่งปัน
ปรับให้สอดคล้องกับบันทึกแหล่งข้อมูลด้านล่างนี้ ส่งคืน (1) ตาราง Markdown ที่มีคอลัมน์ Claim, Controlling source, Status, Reason และ (2) คำแนะนำประมาณ 250 คำ ให้ใช้บันทึกนโยบายที่มีวันที่ล่าสุดเป็นแหล่งข้อมูลหลักเฉพาะในกรณีที่มีความขัดแย้งเกี่ยวกับกำหนดเวลาเท่านั้น ให้ทำเครื่องหมายว่าข้ออ้างที่ไม่มีหลักฐานสนับสนุนเป็น “ไม่มีหลักฐานสนับสนุน” อย่าเพิ่มข้อเท็จจริงใดๆ

[S1 2026-09-01] โครงการนำร่องสิ้นสุดลงในวันที่ 30 กันยายน งบประมาณคือ $12,000
[S2 2026-09-03] โครงการนำร่องสิ้นสุดลงในวันที่ 15 ตุลาคม งบประมาณยังคงอยู่ที่ $12,000
[S3 2026-09-02] ฝ่ายกฎหมายยังไม่อนุมัติการแบ่งปันข้อมูลกับฝ่ายภายนอก
[S4 2026-09-04] ผู้จัดการคนหนึ่งกล่าวว่าโมเดลนี้ “แม่นยำเสมอ”; ไม่มีหลักฐานการทดสอบแนบมา
[S5 2026-09-04] ทีมโครงการนำร่องมีสมาชิก 8 คน
[S6 2026-09-05] บันทึกการตัดสินใจต้องระบุความเสี่ยงที่ยังไม่ได้รับการแก้ไข
[S7 2026-09-06] ทีมโครงการนำร่องมีสมาชิก 8 คน
[S8 2026-09-07] บันทึกการตัดสินใจต้องระบุความเสี่ยงที่ยังไม่ได้รับการแก้ไข
[S9 2026-09-08] ทีมโครงการนำร่องมีสมาชิก 8 คน
[S10 2026-09-09] บันทึกการตัดสินใจต้องระบุความเสี่ยงที่ยังไม่ได้รับการแก้ไข
[S11 2026-09-10] ทีมโครงการนำร่องมีสมาชิก 8 คน
[S12 2026-09-11] บันทึกการตัดสินใจต้องระบุความเสี่ยงที่ยังไม่ได้รับการแก้ไข
[S13 2026-09-12] ทีมโครงการนำร่องมีสมาชิก 8 คน
[S14 2026-09-13] บันทึกการตัดสินใจต้องระบุความเสี่ยงที่ยังไม่ได้รับการแก้ไข
[S15 2026-09-14] ทีมโครงการนำร่องมีสมาชิก 8 คน
[S
[S5 2026-09-04] ทีมโครงการนำร่องมีสมาชิก 8 คน
[S6 2026-09-05] บันทึกการตัดสินใจต้องระบุความเสี่ยงที่ยังไม่ได้รับการแก้ไข

ส่งกลับเฉพาะตารางและคำแนะนำเท่านั้น.
Claude Opus 5.5 · ผลลัพธ์ครบถ้วน
| ข้อเรียกร้อง | แหล่งข้อมูลหลัก | สถานะ | เหตุผล |
|---|---|---|---|
| โครงการนำร่องสิ้นสุดวันที่ 30 กันยายน | S2 (2026-09-03) | ถูกแทนที่ | ขัดแย้งกับ S2. หมายเหตุที่มีวันที่หลังกว่ามีผลเหนือกว่าในกรณีที่วันกำหนดเวลาขัดแย้งกัน |
| โครงการนำร่องสิ้นสุดวันที่ 15 ตุลาคม | S2 (2026-09-03) | ได้รับการสนับสนุน (มีผลบังคับ) | นี่คือบันทึกที่มีวันที่หลังกว่าเกี่ยวกับความขัดแย้งของกำหนดเวลา ดังนั้นจึงมีผลเหนือกว่า S1 |
| งบประมาณคือ $12,000 | S1 และ S2 | ได้รับการสนับสนุน | ทั้งสองแหล่งข้อมูลเห็นพ้องกัน และ S2 ระบุว่างบประมาณ "ยังคง" อยู่ที่ $12,000 ไม่มีความขัดแย้ง |
| ฝ่ายกฎหมายยังไม่อนุมัติการแบ่งปันข้อมูลกับฝ่ายภายนอก | S3 | มีหลักฐานสนับสนุน | ระบุไว้โดยตรงและไม่มีแหล่งข้อมูลอื่นใดที่ขัดแย้ง |
| แบบจำลองนี้ "แม่นยำเสมอ" | S4 | ไม่มีหลักฐานสนับสนุน | นี่เป็นคำยืนยันของผู้จัดการโดยไม่มีหลักฐานการทดสอบแนบมา |
| ทีมนำร่องมีสมาชิก 8 คน | S5 | มีหลักฐานสนับสนุน | ระบุโดยตรงและไม่มีความขัดแย้ง มาจากแหล่งข้อมูลเดียว |
| บันทึกการตัดสินใจต้องระบุความเสี่ยงที่ยังไม่ได้รับการแก้ไข | S6 | มีหลักฐานสนับสนุน | นี่เป็นข้อกำหนดที่ระบุไว้สำหรับบันทึกการตัดสินใจและไม่มีความขัดแย้ง |

**คำแนะนำ**

บันทึกการตัดสินใจควรใช้วันที่ 15 ตุลาคมเป็นวันที่สิ้นสุดโครงการนำร่อง S2 เป็นบันทึกที่มีวันที่หลังกว่าและแก้ไขความขัดแย้งเกี่ยวกับกำหนดเวลา ซึ่งมีความสำคัญเหนือกว่าวันที่ 30 กันยายนใน S1 กฎวันที่หลังกว่านี้ใช้เฉพาะกับความขัดแย้งนี้เท่านั้น ส่วนข้อกล่าวอ้างอื่น ๆ ได้รับการประเมินตามหลักฐานสนับสนุนของแต่ละข้อ

งบประมาณควรบันทึกเป็น $12,000 S1 และ S2 เห็นพ้องกับตัวเลขนี้ จึงไม่จำเป็นต้องปรับให้สอดคล้องกัน ขนาดทีม 8 คนก็สามารถรวมไว้ได้เช่นกัน ซึ่งอิงจาก S5 เพียงอย่างเดียว แต่ไม่มีแหล่งข้อมูลใดที่ขัดแย้งกับข้อมูลนี้

S6 กำหนดให้บันทึกช่วยจำต้องระบุความเสี่ยงที่ยังไม่ได้รับการแก้ไข และบันทึกช่วยจำมีหลักฐานสนับสนุนอย่างน้อยสองข้อ

- **การแบ่งปันข้อมูลกับฝ่ายภายนอก:** ฝ่ายกฎหมายยังไม่อนุมัติ (S3) บันทึกช่วยจำควรระบุเรื่องนี้อย่างชัดเจน และไม่ควรให้เข้าใจว่า การแบ่งปันข้อมูลกับฝ่ายภายนอกได้รับอนุญาตในช่วงการทดลอง
- **ความแม่นยำของแบบจำลอง:** คำกล่าวอ้างว่าโมเดล "แม่นยำเสมอ" ไม่มีหลักฐานสนับสนุน S4 ระบุว่าไม่มีหลักฐานการทดสอบแนบมา และบันทึกคำกล่าวอ้างนี้เพียงในฐานะคำแถลงของผู้จัดการเท่านั้น บันทึกนี้ไม่ควรนำเสนอคำกล่าวอ้างดังกล่าวเป็นผลการตรวจสอบ หรือใช้มันเป็นเหตุผลในการตัดสินใจ ควรระบุความแม่นยำของโมเดลว่ายังไม่ได้รับการตรวจสอบจนกว่าจะมีหลักฐานสนับสนุน

สุดท้ายนี้ บันทึกควรระบุสั้นๆ ว่าวันที่สิ้นสุดโครงการทดลองได้เปลี่ยนแปลงระหว่าง S1 และ S2 ผู้อ่านอาจพบวันที่ 30 กันยายน ซึ่งเป็นวันที่กำหนดไว้ก่อนหน้านี้ในที่อื่น และหมายเหตุนี้จะอธิบายเหตุผลที่ใช้วันที่ 15 ตุลาคม บันทึกไม่ควรเพิ่มคำอธิบายเกี่ยวกับการเปลี่ยนแปลง ผลการทดสอบ หรือการอัปเดตสถานะทางกฎหมาย เนื่องจากข้อมูลดังกล่าวไม่ปรากฏในหมายเหตุแหล่งที่มา.
GPT-6 Sol · ผลลัพธ์ครบถ้วน
| ข้อเรียกร้อง | แหล่งข้อมูลที่ควบคุม | สถานะ | เหตุผล |
|---|---|---|---|
| โครงการนำร่องจะสิ้นสุดลงในวันที่ 30 กันยายน | S2 (2026-09-03) | ถูกแทนที่ | หมายเหตุที่มีวันที่หลังกว่าจะควบคุมความขัดแย้งเกี่ยวกับกำหนดเวลาและกำหนดวันที่ 15 ตุลาคม |
| โครงการนำร่องสิ้นสุดในวันที่ 15 ตุลาคม | S2 (2026-09-03) | ได้รับการสนับสนุน | S2 กำหนดวันสิ้นสุดที่มีผลบังคับใช้ |
| งบประมาณคือ $12,000 | S1 และ S2 | ได้รับการสนับสนุน | ทั้งสองบันทึกระบุจำนวนเงินที่เท่ากัน | |
| ฝ่ายกฎหมายยังไม่อนุมัติการแบ่งปันข้อมูลกับฝ่ายภายนอก | S3 | ได้รับการสนับสนุน | S3 ระบุเรื่องนี้โดยตรง; ไม่มีบันทึกที่มีวันที่หลังกว่าที่กล่าวถึงการอนุมัตินี้ |
| แบบจำลอง “แม่นยำเสมอ” | S4 | ไม่ได้รับการสนับสนุน | ผู้จัดการได้กล่าวอ้างเช่นนี้ แต่ไม่มีหลักฐานการทดสอบแนบมา |
| ทีมทดลองมีสมาชิก 8 คน | S5 | มีหลักฐานสนับสนุน | S5 ระบุขนาดทีม |
| บันทึกการตัดสินใจต้องระบุความเสี่ยงที่ยังไม่ได้รับการแก้ไข | S6 | มีหลักฐานสนับสนุน | S6 ระบุข้อกำหนดนี้ |

**คำแนะนำ:** ใช้วันที่ 15 ตุลาคม เป็นวันที่สิ้นสุดโครงการนำร่องในบันทึกการตัดสินใจ S2 เกิดขึ้นหลัง S1 และแก้ไขความขัดแย้งเกี่ยวกับกำหนดเวลาของทั้งสองข้อ รักษางบประมาณไว้ที่ $12,000: หมายเหตุต่าง ๆ เห็นพ้องกับจำนวนดังกล่าว ดังนั้น การเปลี่ยนแปลงกำหนดเวลาจึงไม่มีเหตุผลที่จะปรับเปลี่ยนงบประมาณ บันทึกขนาดทีมโครงการนำร่องเป็น 8 คน ตามที่ระบุใน S5

ระบุความเสี่ยงที่ยังไม่ได้รับการแก้ไขอย่างชัดเจน ตามที่ S6 กำหนด บันทึกการตัดสินใจควรระบุว่าฝ่ายกฎหมายยังไม่อนุมัติการแบ่งปันข้อมูลกับฝ่ายภายนอก โดยไม่สื่อเป็นนัยว่ามีการอนุมัติในภายหลังหรือว่าการแบ่งปันข้อมูลนั้นได้รับอนุญาตแล้ว นอกจากนี้ ยังควรแยกแยะคำกล่าวของผู้จัดการเกี่ยวกับความแม่นยำออกจากผลการตรวจสอบที่ได้รับการยืนยันแล้ว S4 บันทึกคำกล่าวว่ารุ่น “แม่นยำเสมอ” แต่ไม่มีหลักฐานการทดสอบสนับสนุน อย่าเสนอคำกล่าวนั้นเป็นผลลัพธ์ที่ได้รับการตรวจสอบแล้ว

ให้กระบวนการปรับให้สอดคล้องกันอยู่ในขอบเขตที่แคบ S2 ควบคุมวันที่สิ้นสุดที่ขัดแย้งกัน แต่ไม่แทนที่บันทึกแยกต่างหากเกี่ยวกับฝ่ายกฎหมาย ความแม่นยำ ขนาดทีม หรือข้อกำหนดของบันทึกช่วยจำ ในกรณีที่หมายเหตุไม่ได้กำหนดผลลัพธ์ ให้ปล่อยไว้โดยไม่แก้ไข แทนที่จะเสนอสมมติฐาน โดยเฉพาะอย่างยิ่ง บันทึกนี้ไม่สนับสนุนทั้งการอ้างว่า การแบ่งปันข้อมูลภายนอกได้รับการอนุมัติแล้ว หรือการอ้างว่า ความแม่นยำของโมเดลได้รับการพิสูจน์แล้ว

ดังนั้น บันทึกที่สร้างขึ้นจึงสามารถใช้กำหนดเวลา 15 ตุลาคม และงบประมาณ $12,000 ได้ พร้อมทั้งระบุช่องว่างหลักฐานสองประการที่ปรากฏในบันทึกเหล่านี้ ได้แก่ การอนุมัติทางกฎหมายสำหรับการแบ่งปันข้อมูลภายนอกที่ยังไม่เสร็จสิ้น และการขาดหลักฐานการทดสอบสำหรับคำยืนยันความแม่นยำ.
ข้อมูลเมตา: Claude — HTTP 200 · 12.846 วินาที · finish_reason=stop · prompt_tokens=338 · completion_tokens=1193
GPT — HTTP 200 · 12.322 วินาที · finish_reason=stop · prompt_tokens=230 · completion_tokens=714
การเขียนโค้ดและผลลัพธ์ที่มีโครงสร้าง
ความแตกต่างในการเขียนโค้ดอยู่ที่ส่วนคำอธิบาย
เงื่อนไขการกรองเดิม: if t
องค์ประกอบ None ถือเป็นค่าเท็จ ดังนั้นตัวกรองนี้จึงข้ามองค์ประกอบดังกล่าวไปแล้ว.
ทั้งสองโมเดลได้ส่งคืน JSON ที่ถูกต้อง พร้อมด้วยสี่คีย์ที่ขอมาและแพตช์ขั้นต่ำที่เหมือนกัน Claude ได้อธิบายตัวกรองที่มีอยู่ได้อย่างถูกต้อง ส่วน GPT-6 Sol กลับระบุผิดว่าองค์ประกอบ None จะก่อให้เกิดข้อผิดพลาด ข้อผิดพลาดในการวินิจฉัยนี้มีความสำคัญเมื่อผู้ตรวจสอบตัดสินใจว่าแพตช์ดังกล่าวแก้ไขข้อผิดพลาดที่แท้จริงได้หรือไม่.
Claude ได้ส่งรายชื่อความเสี่ยงมา ส่วน Sol ได้ส่งข้อความสั้นเกี่ยวกับความเสี่ยงมา ข้อความคำสั่งไม่ได้กำหนดประเภทข้อมูลเฉพาะสำหรับช่องนั้น ดังนั้นความแตกต่างนี้จึงไม่ถือเป็นการละเมิดสัญญา คะแนนงานของ Sol อยู่ที่ 9.0/10 หลังจากแก้ไขการหักครึ่งคะแนนที่ไม่ถูกต้องก่อนหน้านี้แล้ว แต่การหักคะแนนเนื่องจากความถูกต้องของข้อมูลยังคงอยู่.
งานเขียนโค้ด
การเขียนโค้ดและผลลัพธ์ที่มีโครงสร้าง: Claude Opus 5.5 มีความแม่นยำมากขึ้น
ทั้งสองโมเดลได้ส่งคืน JSON ที่ถูกต้อง พร้อมด้วยคีย์ที่ขอไว้และแพตช์ขั้นต่ำที่เหมือนกัน Claude ได้อธิบายอย่างถูกต้องว่าตัวกรองเดิมได้ข้าม ไม่มี องค์ประกอบ GPT-6 Sol ได้กล่าวผิดว่า ไม่มี องค์ประกอบนี้จะก่อให้เกิดข้อผิดพลาด ข้อความแจ้งเตือนไม่ได้กำหนดประเภทข้อมูลเฉพาะสำหรับสนาม risks.
| วัด | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| คะแนน | 10.0 / 10 | 9.0 / 10 |
| แพตช์ | ถูกต้องและเรียบง่าย | ถูกต้องและเรียบง่าย |
| การวินิจฉัย | แยกข้อบกพร่องทั้งสองอย่างถูกต้อง | รายงานความผิดพลาดขององค์ประกอบ None มากเกินไป |
| สัญญา JSON ที่ขอไว้ | JSON ที่ถูกต้อง; มีทั้งสี่คีย์ครบถ้วน | JSON ที่ถูกต้อง; มีทั้งสี่คีย์ครบถ้วน |
ข้อมูลเข้าทั้งหมดที่แบ่งปัน
คืนค่า JSON แบบ strict เท่านั้น โดยมีคีย์ diagnosis, patch, tests, risks. วิเคราะห์และปรับแก้ฟังก์ชัน Python นี้ให้ผ่านทั้งสามกรณี โดยการปรับแก้ต้องรักษาลายเซ็นของฟังก์ชันไว้

def normalize_tags(tags):
    return ','.join(sorted(set(t.strip().lower() for t in tags if t)))

กรณี:
1) [' AI ', 'ai', 'Code'] -> 'ai,code'
2) None -> ''
3) ['  ', None, 'SEO'] -> 'seo'

อย่าดำเนินการโค้ด และอย่ารวม Markdown fences หรือข้อความธรรมดาที่อยู่นอก JSON.
Claude Opus 5.5 · ผลลัพธ์ครบถ้วน
{"diagnosis":"พบข้อผิดพลาด 2 จุด จากการอ่านโค้ด (ไม่ได้รันจริง) (a) กรณี 2: เมื่อ tags เป็น None ตัวสร้างจะวนซ้ำผ่าน None และทำให้เกิด TypeError แทนที่จะคืนค่า ''. (b) กรณี 3: ตัวกรอง 'if t' ทำงานก่อนขั้นตอนการตัดช่องว่าง แท็กที่ประกอบด้วยช่องว่างเท่านั้น ' ' ถือเป็นค่าจริง (truthy) จึงผ่านและกลายเป็น '' ผลลัพธ์คือ sorted(['', 'seo']) ซึ่งถูกต่อเป็น ',seo' แทนที่จะเป็น 'seo' องค์ประกอบ None ในกรณี 3 ถูก 'if t' ทิ้งไปแล้ว กรณี 1 ทำงานได้อยู่แล้ว: ' AI ', 'ai' และ 'Code' ถูกปรับให้เป็น {'ai', 'code'}, ให้ผลลัพธ์เป็น 'ai,code'.","patch":"def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":["assert normalize_tags([' AI ', 'ai', 'Code']) == 'ai,code' # traced: {'ai','code'} -> 'ai,code'","assert normalize_tags(None) == '' # traced: (None or []) -> [] -> ''","assert normalize_tags([' ', None, 'SEO']) == 'seo' # traced: ' ' fails t.strip(), None fails t, 'SEO' -> 'seo'"],"risks":["องค์ประกอบที่ไม่ใช่สตริง เช่น 123 จะทำให้เกิด AttributeError เมื่อใช้ .strip() ซึ่งพฤติกรรมนี้ไม่เปลี่ยนแปลงจากเดิม","'tags หรือ []' จะถือว่าข้อมูลเข้าที่มีค่าเป็นเท็จ (เช่น '' หรือ tuple ที่ว่าง) เป็นค่าว่าง ซึ่งสอดคล้องกับพฤติกรรมที่จำเป็นของ None -> ''.","หากส่งสตริงเดียวแทนที่จะส่ง iterable ของ tags ระบบจะวนซ้ำทีละตัวอักษร ซึ่งไม่เปลี่ยนแปลงจากพฤติกรรมเดิม.","ช่องว่างภายในไม่ถูกรวมเข้าด้วยกัน ดังนั้น 'machine learning' และ 'machine learning' จึงยังคงเป็นแท็กที่แยกกันอยู่.","การทดสอบถูกสร้างขึ้นจากการติดตามด้วยมือเท่านั้น และไม่ได้ถูกดำเนินการ ตามคำสั่ง."]}GPT-6 Sol · ผลลัพธ์ครบถ้วน
{"diagnosis":"ฟังก์ชันนี้จะสร้างข้อผิดพลาดเมื่อ `tags` เป็น `None` หรือมี `None` อยู่ภายใน และจะเก็บรายการที่กลายเป็นว่างหลังจากถูกตัดส่วนที่ไม่จำเป็นออกไป","patch":"def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":[{"input":[" AI ","ai","Code"],"expected":"ai,code"},{"input":null,"expected":""},{"input":[" ",null,"SEO"],"expected":"seo"}],"risks":"ไม่ถูกดำเนินการ รายการที่ไม่ใช่ None จะถูกถือว่าเป็นการแสดงผลแบบสตริง."}ข้อมูลเมตา: Claude — HTTP 200 · 10.832 วินาที · finish_reason=stop · prompt_tokens=244 · completion_tokens=965
GPT — HTTP 200 · 7.71 วินาที · finish_reason=stop · prompt_tokens=146 · completion_tokens=305
คำตัดสินสุดท้าย
ตัวเลือกที่ใช้งานได้จริง
รุ่นไหนเหมาะกับงานของคุณ?
GPT-6 Sol นำหน้าในกลุ่มผลลัพธ์แรกที่มีขนาดเล็กนี้ เนื่องจากมันได้เสร็จสิ้นการเขียนสัญญาแบบยาวที่แก้ไขแล้ว ในขณะที่ Claude Opus 5.5 ถึงขีดจำกัดผลลัพธ์ร่วมกันที่ 2,400 โทเคน Claude Opus 5.5 นำหน้าในภารกิจโค้ด/JSON ด้านความแม่นยำในการวินิจฉัย ส่วนการสังเคราะห์แหล่งข้อมูลนั้นเสมอกัน.
เลือก GPT-6 Sol เมื่อความสำคัญอันดับแรกคือการเสร็จสิ้นเอกสารการตัดสินใจที่ยาวและมีข้อจำกัดหลายประการในครั้งเดียว ให้เลือก Claude Opus 5.5 เมื่อการตรวจสอบโค้ดหรือผลลัพธ์ที่มีโครงสร้างจะได้รับประโยชน์จากการวินิจฉัยที่ชัดเจนยิ่งขึ้นและการระบุความเสี่ยงอย่างละเอียด หากงานของคุณรวมทั้งสองด้านนี้ไว้ ให้จัดแต่ละงานไปยังโมเดลที่เหมาะสมที่สุด แทนที่จะบังคับให้ใช้โมเดลเดียวที่เหมาะกับทุกกรณี.
GlobalGPT ให้คุณมีวิธีที่สะดวกในการจัดการทั้งโมเดลและขั้นตอนการทำงาน AI อื่นๆ ทั้งหมดไว้ในแดชบอร์ดเดียว การวิจัย การเขียน การเขียนโค้ด รูปภาพ วิดีโอ และงานผลิตที่เชื่อมต่อกับ CLI สามารถดำเนินการได้ในสภาพแวดล้อมการทำงานเดียวกัน.
คำถามที่มักถูกถาม
รุ่นไหนที่ชนะในการเปรียบเทียบ?
GPT-6 Sol นำชุดผลลัพธ์แรกขนาดเล็กด้วยคะแนน 28.5 ต่อ 26.5 หลังจากที่งานกำหนดขอบเขตเดิมถูกตัดออกและการอนุมานสัญญา JSON ได้รับการแก้ไข การนำนี้เกิดจากการเสร็จสิ้นสัญญาแบบยาวที่แก้ไขแล้วภายใต้ขีดจำกัดผลลัพธ์ 2,400 โทเคนเดียวกัน; Claude Opus 5.5 นำในภารกิจโค้ดและผลลัพธ์ที่มีโครงสร้าง ส่วนการสังเคราะห์แหล่งข้อมูลมีผลเสมอ.
ทำไมการทดสอบแบบยาวครั้งแรกจึงถูกตัดออก?
คำสั่งต้นฉบับไม่ได้ระบุชื่อของโมเดลใดทั้งสอง โมเดลทั้งสองได้ปฏิเสธอย่างถูกต้องที่จะคาดเดาข้อมูลที่ขาดหายไป ดังนั้นการตอบสนองนี้จึงใช้เพื่อตรวจสอบว่าโมเดลจะขอข้อมูลบริบทที่ขาดหายไปแทนที่จะแสร้งทำเป็นรู้.
Claude Opus 5.5 ดีกว่าสำหรับการเขียนโค้ดหรือไม่?
ในภารกิจด้านการเขียนโค้ดและ JSON นี้ Claude Opus 5.5 ได้ให้ผลการวินิจฉัยที่แม่นยำยิ่งขึ้นและรายชื่อความเสี่ยงที่มีโครงสร้างชัดเจน ภารกิจเพียงหนึ่งครั้งยังไม่เพียงพอที่จะกำหนดอันดับการจัดประเภทโค้ดแบบสากล.
GPT-6 Sol ดีกว่าสำหรับการเขียนหรือไม่?
GPT-6 Sol ได้เสร็จสิ้นการเขียนบันทึกแบบยาวที่แก้ไขแล้วภายในขอบเขตที่ขอไว้ในผลลัพธ์ครั้งแรก ผลลัพธ์นี้สนับสนุนคำแนะนำเกี่ยวกับขั้นตอนการทำงานสำหรับการทดสอบนี้เท่านั้น ไม่ใช่ข้อกล่าวอ้างทั่วไปเกี่ยวกับทุกงานเขียน.
ผมสามารถทดสอบทั้งสองรุ่นได้โดยไม่ต้องเปลี่ยนแพลตฟอร์มหรือไม่?
GlobalGPT ได้รับการออกแบบให้เป็นบริการสมัครสมาชิก AI แบบหลายโมเดล ที่รวมฟังก์ชัน AI หลากหลายไว้ในแดชบอร์ดเดียว ซึ่งช่วยในการใช้ชุดคำสั่ง (prompt pack) ที่เดียวกันสำหรับการวิจัย การเขียน และการเขียนโค้ดบนโมเดลต่าง ๆ พร้อมทั้งรักษาขั้นตอนการทำงานไว้ในที่เดียว.
โกลบอลจีพีที ช่วยให้คุณเก็บทั้งโมเดลและขั้นตอนการทำงาน AI อื่น ๆ ไว้ในที่เดียว เริ่มด้วยโมเดลที่เหมาะกับงานปัจจุบัน แล้วดำเนินการต่อผ่านขั้นตอนการวิจัย การเขียน การเขียนโค้ด การสร้างภาพ วิดีโอ หรือขั้นตอนการผลิตที่เชื่อมต่อกับ CLI โดยไม่ต้องเปิดบริการแยกต่างหากสำหรับแต่ละส่วน.









