Да — Grok 4.6 является официальной моделью xAI, выпущенной 12 августа 2026 года, и она заслуживает серьезного внимания, если ваша работа связана с обработкой обширных массивов данных, программированием, многоэтапным анализом или задачами, основанными на обработке изображений. Благодаря контекстному окну объемом 500K токенов и настраиваемому механизму вывода система способна справляться со сложными проектами, хотя она не всегда является самым быстрым или лучшим выбором для каждого запроса. Настоящий вопрос теперь заключается не в том, существует ли Grok 4.6, а в том, соответствуют ли его сильные стороны той работе, которую вам действительно нужно выполнить.
Если вы хотите ответить на этот вопрос, не привязывая весь свой рабочий процесс к одному поставщику, GlobalGPT — отличное место для начала. Рабочая среда браузера позволяет использовать Grok 4.6 наряду с другими ведущими моделями, запускать одни и те же запросы по исследованию, написанию текстов, анализу или программированию и сравнивать результаты в одном месте. Это практичный и удивительно простой способ понять, в чём Grok 4.6 действительно выделяется — а в чём другая модель лучше подходит для вашей задачи — прежде чем выбрать подходящую для вас конфигурацию или подписку.
Что именно представляет собой Grok 4.6?
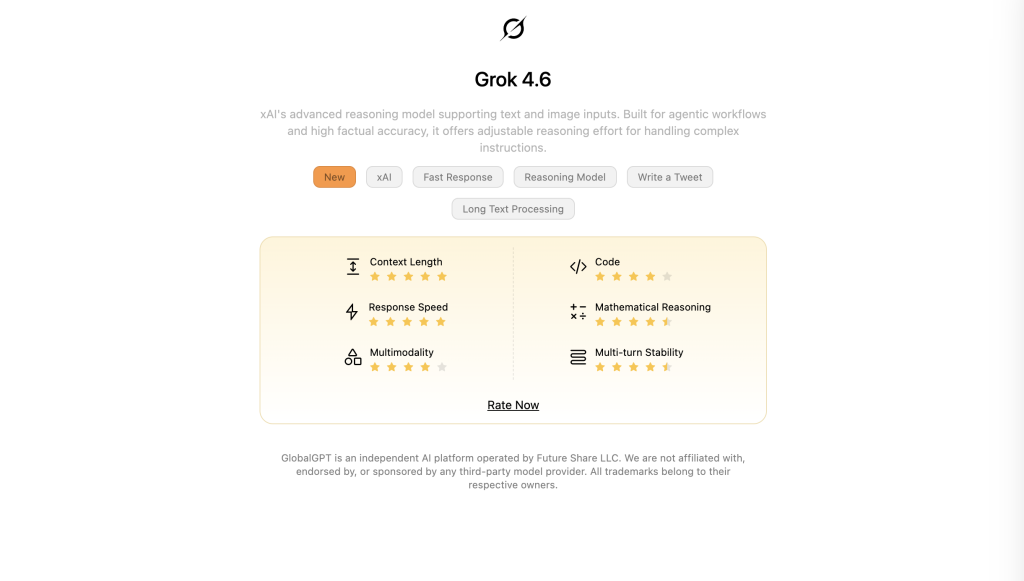
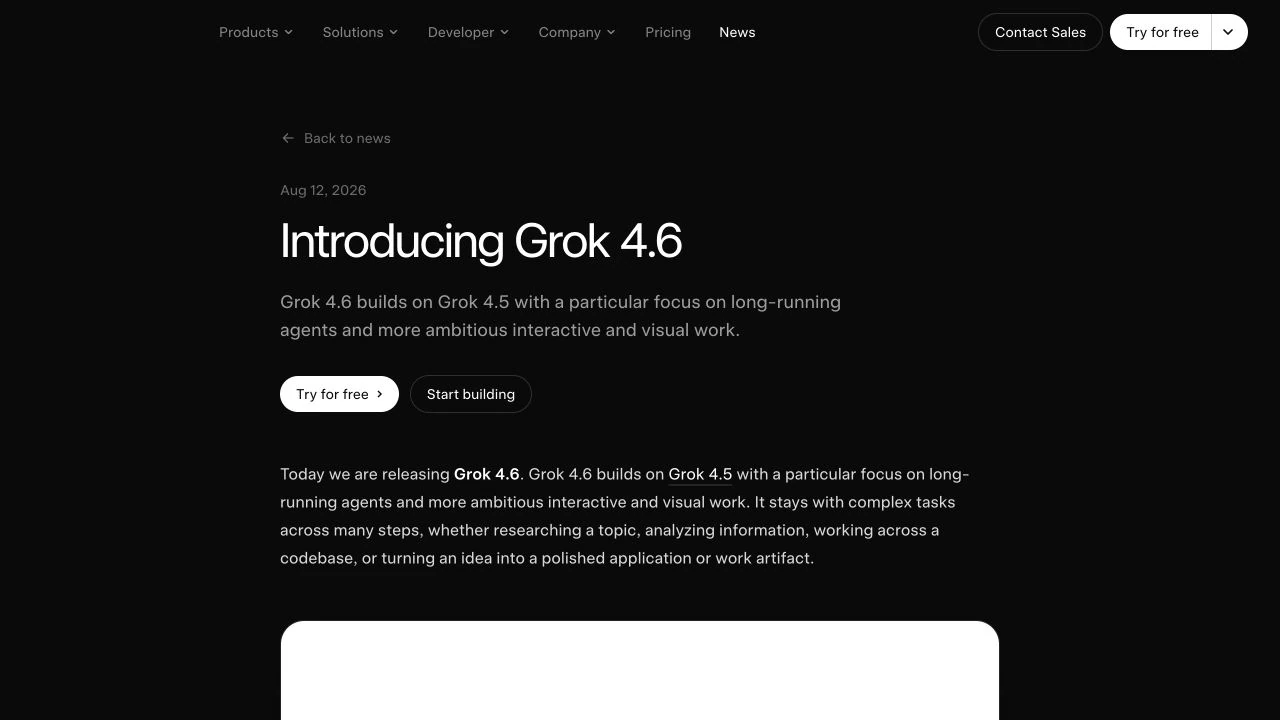
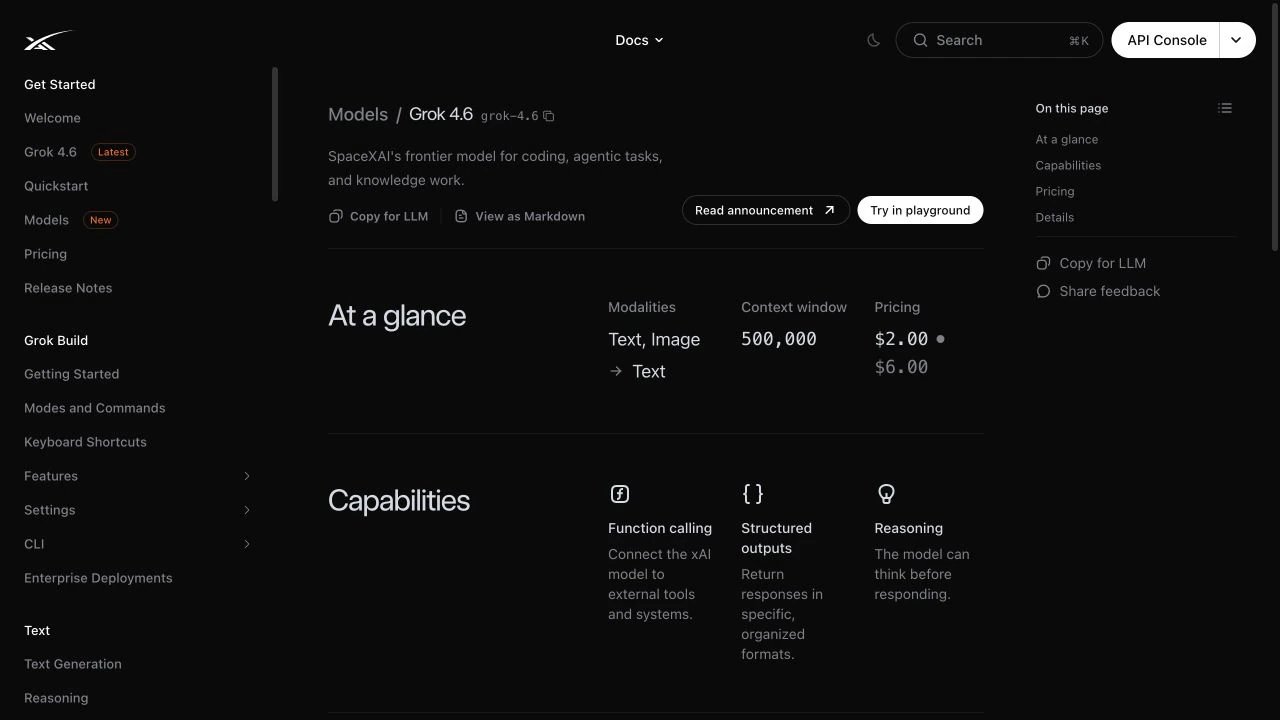
Grok 4.6 — это флагманская модель xAI 2026 года в линейке Grok. На официальной странице модели описаны возможности ввода текста и изображений, вывода текста, настраиваемого логического вывода и контекстного окна объемом 500K токенов. Идентификатор API: grok-4.6; именно это значение разработчики должны указывать в запросе.
Собственный язык релизов xAI имеет специфику: версия Grok 4.6 посвящена долгосрочные агенты а также более сложные интерактивные и визуальные проекты. В официальной документации он позиционируется как инструмент для программирования, выполнения задач, требующих активных действий, и интеллектуальной работы, с возможностью вызова функций и структурированными результатами для рабочих процессов, в которых требуются специальные инструменты или предсказуемые форматы ответов.
В описании модели указан предельный срок предварительного обучения — январь 2026 года. Это важное различие. Окно контекста объемом 500 тыс. символов позволяет использовать очень большой исходный пакет данных, но это не делает модель автоматически инструментом для поиска актуальной информации. Что касается текущих цен, новостей или изменений в политике в отношении продуктов, необходимо найти источники информации и проверить правильность ответа.
Каковы официальные технические характеристики Grok 4.6?
| Спецификация | Значение, зафиксированное официально | Почему это важно |
|---|---|---|
| Дата выхода | 12 августа 2026 года | Подтверждает, что это официальный выпуск xAI. |
| Идентификатор модели API | grok-4.6 | Используйте именно этот слэг в запросах API. |
| Окно контекста | 500 тыс. токенов | Полезно при работе с объемными отчетами, кодовыми базой и исследованиями, в которых широко используются исходные тексты. |
| Ввод / вывод | Ввод текста и изображений; вывод текста | Поддерживает мультимодальные запросы, но не генерацию изображений. |
| Рассуждения | Настраиваемый | Позволяет в рамках рабочего процесса выбрать между скоростью и более глубоким анализом. |
| Вызов функции | Поддерживается | Обеспечивает взаимодействие модели с инструментами и внешними системами. |
| Структурированные выводы | Поддерживается | Полезно для работы с JSON, извлечения данных и построения предсказуемых конвейеров. |
| Пороговое значение перед тренировкой | Январь 2026 года | Не следует считать базовую модель автоматически актуальной. |
Источник: пресс-релиз xAI, документация по модели и описание модели Grok 4.6. Официальные технические характеристики не совпадают с результатами независимых тестов производительности.
На что способен Grok 4.6?
Логическое мышление и структурированный анализ
Благодаря возможности настройки механизма вывода система Grok 4.6 подходит для задач, в которых целесообразно получать продуманный ответ: сравнение доказательств, построение таблиц решений, планирование реализации или проверка вычислений с ограничениями. Более сложный вывод не всегда является лучшим решением для каждого запроса, поэтому при рутинном извлечении и переформулировке следует использовать соответствующие настройки.
Исследовательская работа и работа, требующая тщательного изучения первоисточников
Контекстное окно объемом 500K предоставляет модели достаточно места для работы с объемными отчетами, стенограммами, нормативными документами и пакетами исходных материалов. Наиболее эффективный рабочий процесс заключается в поиске с использованием явных локаторов и правил цитирования, за которым следует открытие исходного документа для проверки.
Кодирование и отладка
Опубликованные результаты оценок в области разработки программного обеспечения, а также наш небольшой тест для отладки подтверждают целесообразность его использования для рецензирования кода, исправления ошибок и выполнения задач структурированных агентов. При этом разработчикам по-прежнему следует запускать тесты локально и проверять патчи перед развертыванием.
Понимание образа
xAI обрабатывает текстовые и графические входные данные с выводом текстовых результатов. Это позволяет интерпретировать скриншоты, анализировать изображения документов и отвечать на вопросы на основе визуальной информации, однако данную функцию не следует путать с генерацией изображений.
Длительное использование агентов и инструментов
Эта возможность наиболее тесно связана с позиционированием xAI на момент запуска. Вызов функций позволяет Grok 4.6 подключаться к внешним инструментам, а структурированные выводы упрощают передачу результата на следующий этап. Такое сочетание подходит для агентов, которые собирают контекст, работают с кодовой базой, вызывают инструмент, проверяют результат и возвращают готовый артефакт. Модели по-прежнему требуется внешняя среда выполнения, разрешения и проверка целей; термин “агентный” не означает, что базовая модель действует независимо.
Интерактивные и визуальные работы
xAI также демонстрирует более сложные интерактивные и визуальные задачи. Хорошим примером для проверки может служить техническое задание с большим количеством скриншотов или отчет, сопровождаемый диаграммами, в котором модель должна соотнести визуальные данные с письменными рекомендациями. Прежде чем считать результат окончательным, проверьте метки, оси, единицы измерения и пропущенные детали.
Чем версия Grok 4.6 отличается от более ранних моделей Grok?
В позиционировании xAI делается акцент на более мощном логическом мышлении, работе с кодирующими агентами и эффективности при обработке длинных контекстов. Практическое усовершенствование заключается не в одной яркой функции, а в сочетании более обширного рабочего пространства, настраиваемого логического мышления и модели, оптимизированной для решения сложных многоэтапных задач.
Это ещё нужно проверить в реальных рабочих условиях. Модель может показать хорошие результаты в тестах, но при этом оказаться неудобной для вашего стиля написания, требований к цитированию или кодовой базы. Модель Grok 4.6 лучше всего оценивать по задачам, которые вы выполняете каждую неделю, а не по одному показателю в рейтинге.
Как Grok 4.6 показывает себя в авторитетных тестах?
В приведенной ниже таблице результаты тестирования модельных карт, полученные самой компанией xAI, отделены от результатов независимых измерений. Это крайне важно, поскольку два показателя Terminal-Bench представляют собой разные версии и их нельзя представлять как результаты прямого сравнения.
| Эксперт по оценке | Задача / показатель | Сообщенный результат | Класс доказательств и сроки давности |
|---|---|---|---|
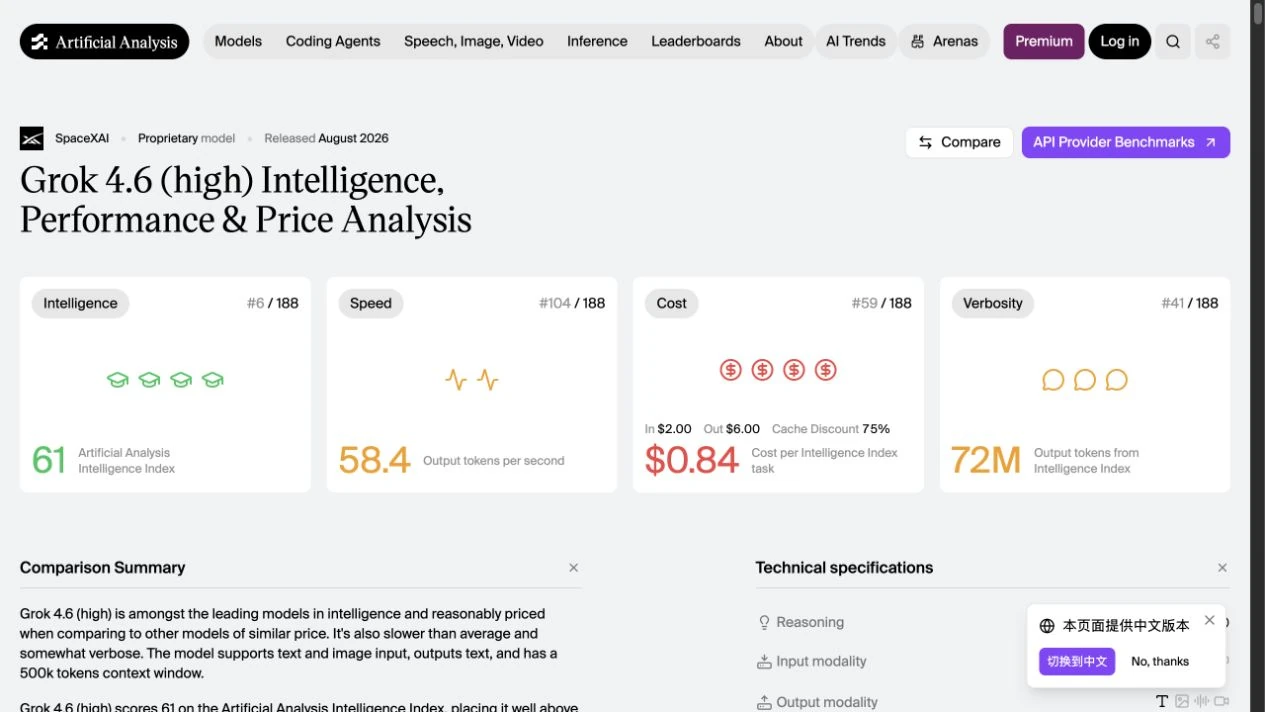
| Искусственный анализ | Индекс интеллекта | 61 (#6 / 188 на момент захвата) | Независимый сводный отчет; использовать методологию и дату агентства AA. |
| Искусственный анализ | Скорость выхода | 58,4 токена в секунду | Независимый снимок скорости; на задержку влияют маршрут и аппаратное обеспечение. |
| Искусственный анализ | Стоимость одного разведывательного задания | $0.84 | Расчет AA с учетом собственного набора задач; это не счет от xAI. |
| Искусственный анализ | GDPval-AA v2 | 1753 | Независимая оценка результатов работы. |
| Искусственный анализ | AA-Портфель | 1577 | Независимая оценка стиля работы, основанной на знаниях. |
| Искусственный анализ | Terminal-Bench v2.1 | 88.4% | Результаты теста Independent v2.1; несопоставимы с результатами Terminal-Bench 3.0. |
| Карточка модели xAI | Terminal-Bench 3.0 | 26% | Официальные результаты по модельной карте для другой версии. |
| Mercor APEX-SWE | Программная инженерия | 56,41 TP40T ± 6,21 TP40T | 200 задач; интервал неопределённости следует сохранить. |
| Агенты Mercor APEX | Задачи агента | 57,51 TP40T ± 3,51 TP40T | 33 миров / 480 задач; оценка конкретного агента. |
| Карточка модели xAI | DeepSearchQA | 81.6% | Условия обеспечения качества исследований, указанные поставщиком. |
| Карточка модели xAI | Показатель частоты галлюцинаций, связанных с реальностью | 1.7% | Условия тестирования по спецификации модели, а не универсальный показатель ошибок. |
Источники: Artificial Analysis, рейтинги Mercor APEX и спецификация модели xAI. Не следует суммировать результаты, полученные на разных наборах данных, в разных версиях, с разными настройками интенсивности обучения или с использованием разных методов оценки.
Модель Grok 4.6 лучше, чем Grok 4.5?
Официальная спецификация модели дает не однозначный ответ, а не простое “да”. Модель Grok 4.6 демонстрирует значительно более высокие результаты в тесте DeepSearchQA, в то время как та же самая модель показывает более высокий уровень «галлюцинаций» в отношении фактов по сравнению с моделью Grok 4.5. Серьёзный обзор не должен превращать один убедительный результат тестирования в утверждение об универсальной надёжности.
| Официальная оценка | Grok 4,6 | Grok 4,5 | Как это интерпретировать |
|---|---|---|---|
| DeepSearchQA | 81.6% | 38.4% | В ходе этой оценки, ориентированной на поиск, был зафиксирован значительный прирост. |
| Показатель частоты галлюцинаций, связанных с реальностью | 1.7% | 0.98% | Чем ниже, тем лучше; при указанных условиях показатель Grok 4,5 является оптимальным. |
Источник: Техническая спецификация модели xAI Grok 4.6. Эти оценки дают ответы на разные вопросы и не позволяют определить единого победителя.
Насколько быстр, надежен и функционален Grok 4.6 в реальных условиях эксплуатации?
Опубликованные данные свидетельствуют о высокой производительности модели, однако “производительность” состоит из нескольких компонентов: качества ответов, задержки, сохранения контекста, выполнения инструкций и восстановления после сбоев. При использовании прямого маршрута запрос на проверку готовности вернул HTTP 200 и ГОТОВО. Первые корректные результаты для остальных задач были успешно возвращены, тогда как один запрос на редактирование с ограничениями привёл к сбою инфраструктуры на стороне клиента.
Artificial Analysis позволяет провести полезную проверку на реалистичность, выходящую за рамки простого анализа заголовков: на снимке страницы указан индекс интеллекта 61, скорость вывода 58,4 токена в секунду и ориентировочная стоимость одной интеллектуальной задачи — $0,84. Такое сочетание характеристик указывает на то, что модель является достаточно мощной, но не сверхбыстрой — она лучше подходит для выполнения содержательной работы, чем для однострочных ответов, не требующих глубокого анализа.
Такой неоднозначный результат оказывается полезным. Grok 4.6 может хорошо справляться со структурированными задачами, однако пользователям в производственной среде следует применять правила повторных попыток, таймауты и резервную модель, а не исходить из того, что все маршруты будут вести себя одинаково.
В каких случаях модель Grok 4.6 покажется наиболее полезной?
Долгосрочная работа над программированием и продуктами
Пример запуска xAI охватывает весь процесс: от исследования темы и анализа информации до работы с кодовой базой и воплощения идеи в готовое приложение или продукт. Поэтому для оценки модели лучше использовать задачу, соответствующую полноценной функции, а не «игрушечный» запрос, ограниченный одной функцией. Предоставьте модели четко сформулированную задачу, соответствующие файлы, тесты и определение готовности.
Обобщение результатов исследований и работа с информацией
Благодаря окну объемом 500K, структурированным выводам и высоким результатам DeepSearchQA версия Grok 4.6 становится идеальным кандидатом для преобразования исходного пакета в краткое изложение, выявления несоответствий или извлечения таблицы решений. Тест проверки исходного материала подтверждает целесообразность такого использования в случаях, когда правила цитирования сформулированы явно.
Объемные отчеты и анализ нескольких документов
Используйте контекстное окно для просмотра годовых отчетов, стенограмм, пакетов документов и истории проектов, которые в противном случае потребовали бы значительного фрагментирования текста. Запрашивайте указатели страниц или разделов, а затем проверяйте ключевые цифры в исходных документах.
Анализ на основе изображений
Ввод текста и изображений удобен для скриншотов, графиков и диаграмм. Это становится особенно полезным, когда визуальные элементы являются частью более обширной задачи по анализу и выводам, например, при рассмотрении панели показателей в совокупности с письменным описанием бизнес-контекста.
Агентные рабочие процессы с четко обозначенными конечными точками
Вызов функций и структурированные выводы поддерживают такие рабочие процессы, как расследование проблемы, запуск инструмента, обновление плана и возвращение результата в машиночитаемом формате. Самым безопасным отправным пунктом является задача с ограниченными правами доступа, чётким условием остановки и механизмом проверки достижения цели.
| Рабочий процесс | Почему модель Grok 4.6 подходит | Лучшее задание для начала |
|---|---|---|
| Кодирование | Позиционирование xAI с учетом данных APEX-SWE и CursorBench | Настоящая ошибка или изменение, влияющее на функциональность, с тестами |
| Исследование | Контекст «500K», структурированный вывод и DeepSearchQA | Брифинг с указанием источников и ссылками на страницы |
| Длинные документы | Большое окно контекста | Годовой отчет или пакет документов, содержащий несколько документов |
| Визуальный анализ | Ввод изображений и позиционирование объектов в xAI Visual-Work | Отчет с большим количеством диаграмм и текстовым сопровождением |
| Агенты | Вызов функций и структурированные выводы | Ограниченное исследование с четким проверяющим |
Может ли модель Grok 4.6 справляться с исследовательской работой и проверкой фактов?
В тесте с исходными пакетами Grok 4.6 предстояло классифицировать шесть утверждений, приводить только утвержденные URL-адреса и отклонить два заманчивых вывода.
(1) подтверждено — в объявлении xAI от 12 августа 2026 года говорится, что в этот день будет выпущена версия Grok 4.6.
(2) подтверждено — в официальной документации xAI по модели указан идентификатор модели grok-4.6.
(3) подтверждено — в официальной документации указано окно контекста размером 500 тыс. символов.
(5) опровергнуто — речь идет о разных версиях Terminal-Bench, и это не один и тот же показатель.
(6) опровергнуто — на странице указана только запись о рабочей среде, а не включение в каждый тарифный план.
Показать полный результат Grok 4.6
| Утверждение | Вывод | Ответ в одном предложении | URL-адрес(ы) источника | Точное ограничение |
|---|---|---|---|---|
| (1) 12 августа 2026 года компания xAI объявила о выпуске Grok 4.6 | подтверждено | В объявлении xAI указана дата 12 августа 2026 года и говорится, что в этот день будет выпущена версия Grok 4.6. | https://x.ai/news/grok-4-6 | В пакете приводятся только дата и строка о выпуске, а не полный текст публикации. |
| (2) официальный идентификатор модели API — grok-4.6 | подтверждено | В официальной документации xAI по модели указано, что идентификатор модели — grok-4.6. | https://docs.x.ai/developers/models/grok-4.6 | В сводке Packet не указаны псевдонимы или другие идентификаторы. |
| (3) официальное окно контекста составляет 500 тыс. токенов | поддерживается | В официальной документации указано окно контекста размером 500 тыс. токенов. | https://docs.x.ai/developers/models/grok-4.6 | В пакете указано “контекст 500 тыс.”, а не явно упомянуто слово “токены”. |
| (4) Компания Artificial Analysis независимо определила индекс интеллекта 61 | поддерживается | AA публикует индекс интеллекта 61 для версии Grok 4.6. | https://artificialanalysis.ai/models/grok-4-6 | В Packet приводится оценка AA, а не результаты отдельного аудита методологии AA. |
| (5) Terminal-Bench 3.0 (26%) и v2.1 (88,4%) напрямую сопоставимы | опровергается | Это разные версии Terminal-Bench, и они не представляют собой одну и ту же метрику. | https://artificialanalysis.ai/models/grok-4-6 ; https://media.x.ai/v1/website/card-4p6-4cd2dc57.pdf | В отчете Packet приводятся оба результата, но нет ни эквивалентности, ни сопоставительной таблицы. |
| (6) страница GlobalGPT Grok 4,6 доказывает, что каждый план включает эту модель | опровергается | На странице показана только запись в рабочей области, а не включение в каждый план. | https://www.glbgpt.com/home/grok-4-6 | В самом пакете указано, что это запись интерфейса, а не каждого плана. |
Заключение обзора: она хорошо соблюдала границы доказательств, когда формат исходного пакета и ответа были явно определены. Это полезно для исследовательских рабочих процессов, однако ответ модели остается лишь вспомогательным инструментом для исследования, а не самим внешним доказательством.
Показать точный текст задания
Используйте только прилагаемый пакет источников. По каждому из шести пунктов формулы изобретения дайте ответ одним предложением (подтверждено, опровергнуто или не установлено), укажите URL-адреса источников и точную формулировку ограничения.
Подходит ли Grok 4.6 для программирования и отладки?
Задача по JavaScript предполагала минимальный дифф, сортировку по числовым значениям, правильную обработку нечетных и четных медиан, неизменяемость и два конкретных условия ошибки.
```diff
--- a/median.js
+++ b/median.js
@@ -1 +1,12 @@
-function median(values) { values.sort(); return values[Math.floor(values.length / 2)]; }
+function median(values) {
+  if (!Array.isArray(values)) throw new TypeError();
+  if (values.length === 0) throw new Error("empty input");
+  const sorted = values.slice().sort((a, b) => a - b);
+  const mid = Math.floor(sorted.length / 2);
+  if (sorted.length % 2 === 0) {
+    return (sorted[mid - 1] + sorted[mid]) / 2;
+  }
+  return sorted[mid];
+}Показать объяснение, возвращаемое функцией Grok 4.6
Исходная функция изменяла свой аргумент и использовала лексикографическую сортировку по умолчанию (sort()), поэтому с помощью slice() создается копия, которая упорядочивается по числу с помощью (a, b) => a - b. После отбраковки немассивов с помощью TypeError и пустых массивов с помощью Error("empty input") результатом с нечётной длиной становится единственный средний элемент, а результатом с чётной длиной — среднее арифметическое двух центральных значений, что соответствует общепринятому понятию медианы.Наилучшее применение: отладка небольших и средних проектов, написание тестов, рецензирование кода и разъяснение принципа работы незнакомой функции. В случае с большим репозиторием используйте эту модель в сочетании с собственным инструментом запуска тестов и проверьте разницу перед слиянием.
Показать область тестирования
Исправить функцию median(values) без изменения её сигнатуры. Не изменять содержимое входных данных; генерировать исключение TypeError для объектов, не являющихся массивами, и Error("empty input") для пустых массивов; возвращать минимальный унифицированный дифф.Помогает ли окно контекста размером 500K при работе с длинными документами?
В запросе на извлечение более 220 тысяч токенов содержались просьбы предоставить семь полей, указатели разделов/страниц, а также объяснение двух версий «Terminal-Bench».
{
  "release_date": {"value": "12 августа 2026 г.", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "locator": "p.2"},
  "context_window": {"value": "500 тыс. токенов", "locator": "p.2"},
  "long_context_input_price": {"value": "$4 за миллион токенов (промпты объемом более 200 тыс. токенов)", "locator": "p.3"},
  "terminal_bench_version": ["3.0", "v2.1"],
  "terminal_bench_score": ["26%", "88.4%"]
}Показать полный вывод JSON для Grok 4.6
{
  "release_date": {"value": "12 августа 2026 г.", "section": "Выпуск xAI", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "section": "API-модель", "locator": "p.2"},
  "context_window": {"value": "500 тыс. токенов", "section": "API-модель", "locator": "p.2"},
  "long_context_input_price": {"value": "$4 за миллион токенов (промпты объемом более 200K токенов)", "section": "pricing", "locator": "p.3"},
  "terminal_bench_version": [{"value": "3.0", "section": "карта тестирования", "locator": "p.4"},{"value": "v2.1", "section": "независимое тестирование", "locator": "p.5"}],
  "terminal_bench_score": [{"value": "26%", "section": "карточка тестирования", "locator": "стр. 4"},{"value": "88,4%", "section": "independent benchmark", "locator": "p.5"}],
  "evidence_limits": {"value": "Эти два результата теста Terminal-Bench нельзя сравнивать, поскольку они относятся к разным версиям теста. Информация о доступности в режиме реального времени не указана.", "section": "независимый тест", "locator": "p.5"}
}
Что это доказывает: модель способна извлекать и систематизировать информацию из большого пакета данных, содержащего помехи, в соответствии со строгой схемой. Чего это не доказывает: что каждый запрос на 500 тысяч токенов будет одинаково быстрым, недорогим и точным при работе с любым документом клиента.
Способен ли Grok 4.6 строго следовать инструкциям и логически обосновывать свои действия?
Для задачи о распределении ресурсов с ограничениями система выдала единственное решение: 7 часов на исследования, 9 часов на программирование и 8 часов на контроль качества.
{"R":7,"C":9,"Q":8,"total":24,"check":"Значения удовлетворяют условию R+C+Q=24, при этом C=R+2 и Q=R+1."}Показать точный текст запроса
Распределите 24 часа между исследованиями (R), программированием (C) и контролем качества (Q). Верните только JSON с целочисленными ключами R, C, Q, total и проверкой в виде одного предложения. Ограничения: R + C + Q = 24; C = R + 2; Q = R + 1. Не указывайте скрытую цепочку рассуждений.
Отдельная задача по переработке текста с ограничениями не вернула ответ API после двух попыток со стороны клиента. Это регистрируется как аномалия инфраструктуры, а не как показатель качества. Из этого следует вывод: при редакционной подготовке материалов следует предусматривать резервный вариант.
Сколько стоит Grok 4.6?
| Вариант | Текущая опубликованная цена | Лучше всего подходит для | Важная граница |
|---|---|---|---|
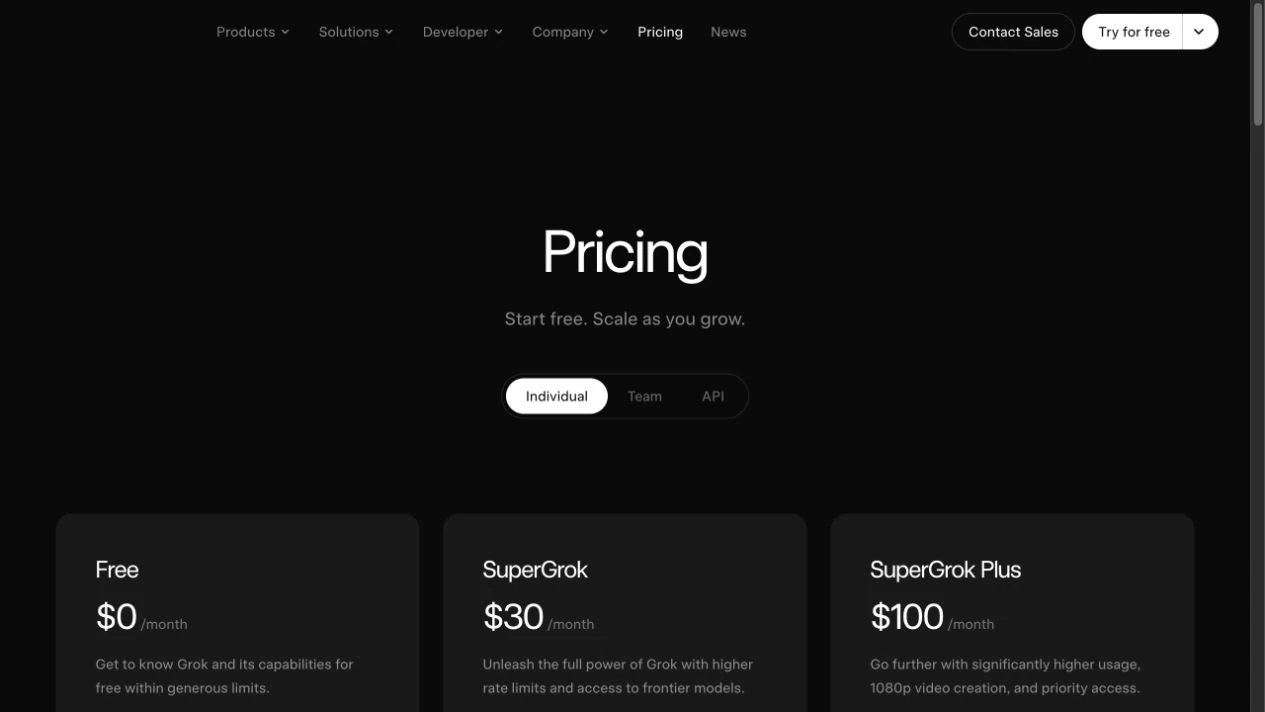
| xAI для потребителей — бесплатно | $0/месяц | Ознакомление с интерфейсом для конечных пользователей. | Условия доступа и ограничения в рамках бесплатной версии могут изменяться. |
| SuperGrok | $30 в месяц | Обычное использование потребителями; на текущей странице указан артикул Grok 4.6. | Перед публикацией проверьте актуальные права. |
| SuperGrok Plus | $100/месяц | Интенсивное использование потребителями; на текущей странице указан вариант Grok 4.6. | Не следует делать выводы о доступе для других планов. |
| Базовый тарифный план xAI API | Вход $2/M; выход $6/M; вход с кэшированием $0.50/M | Разработчики, создающие интеграции на основе использования. | В соответствующих случаях стоимость инструментов оплачивается отдельно. |
| Уровень xAI API с поддержкой длинного контекста | Свыше 200 тыс.: вход $4/M; кэшированный $1/M; выход $12/M | Очень объёмные запросы и документы. | Не используйте базовую цену для запросов объемом более 200K. |
| GlobalGPT | Ознакомьтесь с текущими планами на период GlobalGPT | Сравнение Grok с несколькими ведущими моделями в одном рабочем пространстве. | Не стоит полагать, что каждый план включает Grok 4.6; проверьте страницу с описанием плана. |
Сколько будет стоить запрос по API Grok 4.6?
| Пример запроса | Расчет | Расчетная стоимость одного токена модели |
|---|---|---|
| 50 кОм на входе + 5 кОм на выходе | 50 тыс. × $2/M + 5 тыс. × $6/M | $0.13 |
| 100K на входе + 10K на выходе | 100K × $2/M + 10K × $6/M | $0.26 |
| 250K на входе + 10K на выходе | 250 тыс. × $4/M + 10 тыс. × $12/M | $1.12 |
| 400K на входе + 20K на выходе | 400 тыс. × $4/M + 20 тыс. × $12/M | $1.84 |
Примеры расчетов с использованием цен по прейскуранту xAI. В них не учтены скидки за использование данных из кэша, налоги, плата за вызов оборудования и наценка сторонних поставщиков.
GlobalGPT идеально подходит в тех случаях, когда перед вами стоит вопрос “какая модель лучше всего подойдет для этой задачи?”, а не “как мне объединить все задачи в рамках одного API?”. Вы можете сравнивать задания по написанию текстов, исследованию, программированию и анализу в одном рабочем пространстве, а затем использовать Страница с ценами на GlobalGPT чтобы выбрать тарифный план, соответствующий вашему объему использования. Это рекомендация по выбору тарифного плана с поддержкой нескольких моделей, а не пересчет кредитов GlobalGPT в стоимость токенов xAI.
Как получить доступ к версии Grok 4.6?
Потребители могут начать с доступных на данный момент вариантов подписки xAI Grok. Разработчикам следует руководствоваться официальной документацией по API xAI и указывать точный идентификатор модели grok-4.6. Читатели, желающие сравнить модели без необходимости создания нескольких учетных записей API, могут воспользоваться проверенной записью рабочей области Grok 4.6 в GlobalGPT; доступ к пользовательскому интерфейсу платформы не следует путать со всеми встроенными функциями xAI.
Каковы основные ограничения модели Grok 4.6?
- Текущая информация по-прежнему требует подтверждения: Крайний срок прохождения предварительной подготовки в январе 2026 года не является гарантией владения практическим знанием.
- Заголовки сравнительных обзоров могут вводить в заблуждение: К каждой оценке должны прилагаться версия, имя эксперта, описание процесса рассуждений и набор данных.
- Больший объем текста обходится дороже: Запросы, превышающие 200 тыс. токенов, используют API-уровень с более длинным контекстом.
- Надежность маршрута варьируется: Наш запрос на редактирование с ограничениями завершился сбоем инфраструктуры, хотя другие задачи были выполнены успешно.
- Доступ к платформе не одинаков: Наличие записи в рабочей области GlobalGPT не означает, что доступны все встроенные функции xAI или все права, предусмотренные подпиской.
Что выбрать: Grok 4.6 или другую модель искусственного интеллекта?
Выбирайте модель Grok 4.6, если в работе ключевую роль играют обширный контекст, кодирование и структурированное мышление. Выберите другую модель, если вашим главным приоритетом является конкретная экосистема инструментов, более низкая предсказуемая стоимость, определенный мультимодальный вывод или рабочий процесс, который ваша команда уже хорошо поддерживает. Наиболее объективное сравнение — это использование одного и того же запроса, одного и того же пакета исходных данных и одного и того же средства проверки для всех моделей — и модель GlobalGPT позволяет легко организовать такой процесс.
Кому рекомендуется использовать Grok 4.6?
- Исследователи и аналитики: исходные пакеты данных, таблицы доказательств и объемные судебные документы.
- Разработчики: отладка, рецензирование кода и структурированные планы реализации.
- Авторы и редакторы: подготовка текстов большого объема при наличии четкого технического задания и руководства по стилю.
- Команды, сравнивающие модели: повторяемые оценки с использованием одного и того же запроса в одном рабочем пространстве.
Какие вопросы обычно задают читатели по поводу Grok 4.6?
Версия Grok 4.6 официально выпущена?
Да. Объявление о выпуске xAI датировано 12 августа 2026 года.
Каков официальный идентификатор модели API?
grok-4.6.
Что такое контекстное окно?
xAI использует контекстное окно объемом 500 тысяч токенов.
Поддерживает ли модель Grok 4.6 загрузку изображений?
Да. В официальной документации по модели указаны входные данные в виде изображений и выходные данные в виде текста.
Сколько стоит Grok 4.6?
На текущей странице для потребителей указаны тарифные планы: «Free» — $0 в месяц, «SuperGrok» — $30 в месяц и «SuperGrok Plus» — $100 в месяц. Ценообразование на API зависит от объема использования и предусматривает отдельный тарифный уровень для длинных контекстов при превышении 200K токенов.
Модель Grok 4.6 лучше, чем Grok 4.5?
Он более новый и демонстрирует высокую производительность в ряде упомянутых тестов, однако задачи и версии тестовых наборов различаются. Протестируйте свой собственный повторяющийся рабочий процесс.
Можно ли использовать Grok 4,6 в GlobalGPT?
Для GlobalGPT сформирована запись рабочей области Grok 4.6. Проверьте текущие права на план на странице с ценами.
Является ли Grok 4.6 надежным источником для научных исследований?
Он показал хорошие результаты в тесте с ограниченным количеством исходных пакетов, однако важные утверждения всегда следует сверять с указанным источником.
Стоит ли использовать Grok 4.6 в 2026 году?
Grok 4.6 — это надежная, официально выпущенная модель с полезным контекстным окном объемом 500K, настраиваемым процессом вывода, убедительными опубликованными результатами тестирования и хорошими результатами в первом раунде по задачам структурированного поиска и обработки длинных документов. Ее слабые стороны носят столь же практический характер: результаты тестирования требуют тщательной маркировки версий, факты из реального мира по-прежнему нуждаются в указании источников, а надежность маршрутизации может варьироваться.
Для доступа с помощью нативных приложений или разработки API начните с актуальной документации xAI. Для рабочего процесса, основанного на сравнении, попробуйте Grok 4,6 в GlobalGPT наряду с другими ведущими моделями, выберите план, который подходит именно для вашей работы по написанию текстов, проведению исследований, анализу или программированию.
Первоисточники: Выпуск xAI, Документация по модели xAI, Цены на API xAI, Цены на продукты xAI для конечных пользователей, Искусственный анализ, Mercor APEX-SWE и Карточка модели xAI.