Начните с того звука, который хотите произнести. Используйте Pick Eleven Music v2 для песен и структурированных инструментальных партий, Qwen Audio 3.0 TTS Flash — для дикторского текста и выразительного голоса, а Seed Audio 1.0 — когда вам нужно объединить речь, фоновые звуки и эффекты в одну целостную сцену.
Вам не нужно искать одну ‘лучшую’ аудиомодель. Создателю фоновой музыки требуется нечто иное, чем маркетологу, записывающему закадровый голос, или кинорежиссёру, снимающему сцену на вокзале. Мы протестировали эти реальные задачи — а не просто списки функций — и ниже вы можете прослушать все десять первых результатов.
Если вы хотите попробовать эту же идею с собственным запросом, GlobalGPT позволяет вам в одном месте переключаться между всеми тремя. Кроме того, это более универсальная мультимодельная рабочая среда: вы можете использовать такие модели, как GPT-5.6 Sol, Claude Opus 4.8 и Gemini 3.1 Pro для написания текстов и исследований, а затем переключиться на GPT Image 2 или Seedance 2.0, когда проекту понадобятся изображения или видео. Это означает, что вы можете составить черновик сценария, сгенерировать аудио и продолжить работу над остальной частью проекта, не прибегая к использованию множества отдельных инструментов. Доступ к моделям зависит от тарифного плана.
Начните с того, что вы хотите сделать
Это лишь отправные точки, а не универсальный рейтинг.
Краткий ответ: какая модель подходит для какой задачи в области аудио?
Вот простой способ принять решение: выбирайте исходя из конечного результата, а не по бренду. Eleven — естественный выбор, когда конечным результатом является музыка; Qwen TTS Flash подходит для дикторского текста и выразительного голоса; Seed — для сцен, в которых требуется сочетание речи, фоновых звуков и эффектов. Наши шесть практических заданий показывают, в каких случаях каждый из вариантов показал себя лучше всего, а десять примеров ниже позволят вам самостоятельно оценить все «за» и «против».
| Модель | Начните с этого, если… | Что мы попробовали | Имейте в виду |
|---|---|---|---|
| Eleven Music v2 | Вам нужна песня или инструментальная композиция с четкой структурой | Два музыкальных соревнования и одно выступление с вокальными композициями | Мы не использовали его для повествования |
| Qwen Audio 3.0 TTS Flash | Вам нужен закадровый голос или выразительная интонация | Два словесных поединка | Эти результаты относятся к протестированной версии Flash |
| Seed Audio 1.0 | Вам нужна полноценная сцена с несколькими типами звуков | Музыка, речь и сцена на вокзале | Гибкий выходной формат не воспроизводит все особенности исходного формата |
Во-первых, это три разных типа аудиомоделей
Eleven Music v2: специализированный рабочий процесс для работы с музыкой
В документе ElevenLabs описывается Eleven Music в виде текста, преобразуемого в музыку с возможностью управления жанром, стилем и структурой. В документации также показаны варианты вокального или инструментального исполнения, многоязычное генерация и редактирование как отдельных фрагментов, так и всей композиции целиком. Эти функции делают данный инструмент наиболее очевидным специализированным решением для работы с музыкой среди представленных здесь; при этом они не означают, что речь идет о том же подходе к синтезу речи, что и в случае с Qwen.

Qwen Audio 3.0 TTS Flash: протестированный в данном обзоре вариант синтеза речи
Qwen Audio 3.0 TTS Flash — точный маршрут Anywhere: qwen-audio-3.0-tts-flash— это речевой канал, используемый в B1 и B2. Документация по синтезу речи от Alibaba Cloud указывает именно это имя Flash в контексте пользовательского голоса. В данной статье не переносятся сведения о продолжительности, формате или встроенных голосах из других строк или вариантов Qwen.

Seed Audio 1.0: расширенный рабочий процесс в аудиоиндустрии
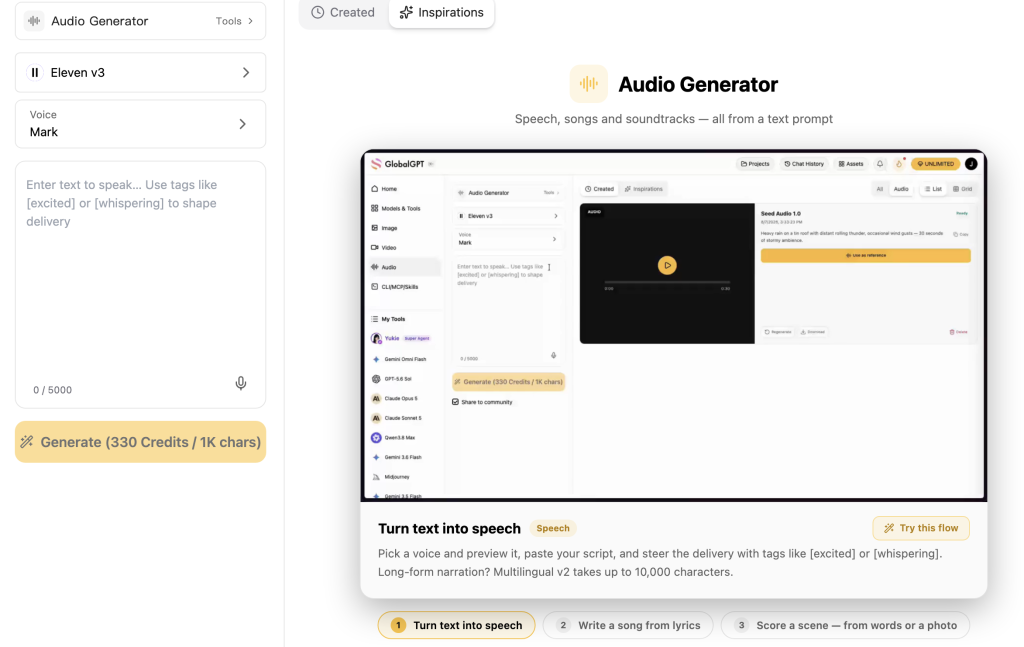
Вакансии в ByteDance Seed Audio 1.0 для генерации полноценной звуковой сцены, включающей голоса, звуковые эффекты, фоновые шумы и единую оркестровку. Это делает данное решение естественным выбором в тех случаях, когда один выходной сигнал должен координировать несколько типов звуков. На представленном снимке не прослеживается явная музыкальная составляющая, поэтому выводы о музыкальной составляющей, приведенные в данной статье, основаны на результатах наших практических тестов, а не на этом изображении.

Отдельный Страница API BytePlus определяет seed-audio-1.0 в качестве маршрута без потоковой передачи с эталонными аудио- или видеовходами, управлением синхронизацией и продолжительностью вывода до 120 секунд. Это сведения о маршруте, которые приводятся отдельно от более общего описания позиционирования модели.

Как мы тестировали три рабочих процесса обработки аудио
Мы зафиксировали промпты перед генерацией, последовательно отправили десять заданий и сохранили первый корректный результат по каждому заданию. Все десять запросов были выполнены успешно без повторных попыток. Фрагменты, не готовые к воспроизведению, были исключены; приведенный ниже тестовый аудиофайл представляет собой исходный материал — первый корректный результат.
- Официальные доказательства: документация по продуктам или API от самого разработчика.
- Данные о проложенном маршруте: формат, продолжительность, стоимость, декодирование и проверки сигнала для данного сеанса.
- Аудиозапись: слепые парные предпочтения одного пользователя в отношении A1, A2, B1 и B2, а также семантическая оценка C1 и C3.
- Ограничения: проверка стабильности не проводилась; B1 и B2 не были автоматически транскрибированы и не проверялись слово за словом.
Общая сумма, зафиксированная по итогам десяти выплат, составила $0.4819752667. Это число характеризует данный сеанс и не является официальным ценовым обязательством.
Музыкальные тесты: Eleven Music v2 против Seed Audio 1.0
A1: Фоновая музыка к документальному фильму
A1: Фоновая музыка к документальному фильму
30-секундная инструментальная музыкальная подложка для документального фильма о путешествиях с плавным нарастанием и завершённым финалом.
Показать точный текст застывшего запроса
Создайте 30-секундную инструментальную фоновую музыку для короткометражного документального фильма о путешествиях. Начните с мягких аккордов акустической гитары, исполняемых пальцами, и теплого звучания фортепиано, добавьте легкую перкуссию руками после первой трети композиции, плавно наращивайте интенсивность и завершите чистой, завершающей каденцией. Мелодия должна быть наполненной надеждой и заставлять задуматься. Без вокала, речи и звуковых эффектов.
| Модель | Точный маршрут | Статус | Фактическая продолжительность | Формат | Фактическая стоимость |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Первый действительный | 30,041 с | MP3, 44,1 кГц, стерео | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | Первый действительный | 30 000-е | PCM WAV, 40 кГц, стерео | $0.0700000 |
- Объективные проверки
- Оба файла были декодированы правильно, в них не наблюдалось почти никаких перегрузок, а в конце был четкий затухающий переход. Данные об исчерпывающей проверке соответствия приборов не были зафиксированы.
- Оценка слушателя
- Слушатель отдал предпочтение версии Eleven Music v2, поскольку переход от лёгких к тяжёлым партиям казался более естественным, а взаимодействие инструментов звучало более гармонично.
- Результат выполнения задачи
- Для выполнения этой задачи по получению первых результатов было выбрано число одиннадцать.
- Ограничения
- По одной первой корректной выходной величине для каждой модели; проверка устойчивости не проводилась.
Тест по аудированию A1
Послушайте первые записи группы A1
Разыграйте любую из этих карт, чтобы напрямую сравнить две модели.
Eleven Music v2
eleven-music-v2Сгенерировано с помощью протестированного маршрута Anywhere 6 августа 2026 года. Получен один первый корректный результат; проверка стабильности не проводилась.
Seed Audio 1.0
seed-audio-1.0Сгенерировано с помощью протестированного маршрута Anywhere 6 августа 2026 года. Получен один первый корректный результат; проверка стабильности не проводилась.
В случае с A1 слушатель отдал предпочтение первому варианту от Eleven из-за более естественного перехода от лёгких к тяжёлым партиям и более гармоничной инструментальной слаженности.
A2: Сигнал о запуске структурированного продукта
A2: Структурированный сигнал к запуску продукта
Трехчастный инструментальный фрагмент продолжительностью 30 секунд с четким ритмом: минималистичный ритм, добавление ударных и нарастание энергии, а затем яркий финальный взлет.
Показать точный текст застывшего запроса
Создайте 30-секундный инструментальный музыкальный фрагмент для презентации продукта, состоящий из трёх чётко разграниченных частей: 0–8 секунд — минималистичный синтезаторный ритм; 8–22 секунд — добавьте чёткую электронную ударную партию и нарастающую гармоническую энергию; 22–30 секунд — завершите композицию ярким финальным взлётом и чистым завершением. Современный и уверенный, но не агрессивный. Без вокала, речи и окружающих звуков.
| Модель | Точный маршрут | Статус | Фактическая продолжительность | Формат | Фактическая стоимость |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Первый действительный | 30,041 с | MP3, 44,1 кГц, стерео | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | Первый действительный | 27,704 с | PCM WAV, 40 кГц, стерео | $0.0646436 |
- Объективные проверки
- Оба файла были декодированы корректно, практически без клиппинга. Время загрузки составило 27,704 секунды при запросе длительностью 30 секунд; это обусловлено особенностями маршрута, а не снижением качества.
- Оценка слушателя
- Слушатель отдал предпочтение Seed Audio 1.0 за более чёткое вступление и более насыщенное звуковое многослойность; вступление в композиции «Eleven» было плохо слышно.
- Результат выполнения задачи
- Для этой задачи с первым результатом предпочтительно использовать Seed; два музыкальных теста разделились.
- Ограничения
- Точное время прохождения участков не было тщательно проверено; тест на устойчивость не проводился.
Тест по аудированию A2
Послушайте первые записи A2
Разыграйте любую из этих карт, чтобы напрямую сравнить две модели.
Eleven Music v2
eleven-music-v2Сгенерировано с помощью протестированного маршрута Anywhere 6 августа 2026 года. Получен один первый корректный результат; проверка стабильности не проводилась.
Seed Audio 1.0
seed-audio-1.0Сгенерировано с помощью протестированного маршрута Anywhere 6 августа 2026 года. Получен один первый корректный результат; проверка стабильности не проводилась.
В задаче A2 первая версия модели Seed завоевала предпочтение слушателей, поскольку вступление прозвучало четче, а звуковая картина показалась более насыщенной. При запросе длиной 30 секунд модель Seed выдала результат длительностью 27,704 секунды; мы фиксируем это отклонение отдельно, не рассматривая его как снижение качества. Поскольку в каждой музыкальной задаче преимущество было за одной из моделей, победителя в категории «Музыка» не определено.
Тесты речи: Qwen TTS Flash против Seed Audio 1.0
B1: Нейтральный документальный стиль повествования
B1: Нейтральный документальный рассказ
Тот же английский голос за кадром, описывающий гавань, с спокойной, нейтральной интонацией, умеренным темпом и естественными паузами.
Показать точный текст застывшего запроса
Каждое утро гавань пробуждается раньше города. Паромы пересекают воду, зажигаются огни в магазинах, и первые пассажиры выходят на причал. К семи часам тихая набережная превращается в центр дневной суеты. Спокойный документальный голос за кадром на чётком, нейтральном английском языке. Говорите в умеренном темпе с естественными паузами. Без музыки, фоновых звуков и звуковых эффектов.
| Модель | Точный маршрут | Статус | Фактическая продолжительность | Формат | Фактическая стоимость |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | Первый действительный | 27,507 с | MP3, 22,05 кГц, моно | $0.0051300 |
| Seed Audio 1.0 | seed-audio-1.0 | Первый действительный | 18,780 с | PCM WAV, 40 кГц, стерео (одинаковые каналы) | $0.0438200 |
- Объективные проверки
- Оба файла были правильно декодированы и содержали звуки, напоминающие речь, а также паузы. Пользователь не сообщил о каких-либо явных проблемах с текстом.
- Оценка слушателя
- Слушатель счел вариант Qwen более естественным и документальным; вариант «Seed» прозвучал скованно, словно напоминание перед экзаменом.
- Результат выполнения задачи
- Для выполнения этой задачи с первым выходом предпочтительно использовать Qwen.
- Ограничения
- Дословность не проверена; проверка стабильности не проводилась.
Тест по аудированию уровня B1
Послушайте первые записи уровня B1
Разыграйте любую из этих карт, чтобы напрямую сравнить две модели.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flashСгенерировано с помощью протестированного маршрута Anywhere 6 августа 2026 года. Получен один первый корректный результат; проверка стабильности не проводилась.
Seed Audio 1.0
seed-audio-1.0Сгенерировано с помощью протестированного маршрута Anywhere 6 августа 2026 года. Получен один первый корректный результат; проверка стабильности не проводилась.
Первый вариант Qwen звучал более естественно и документально; вариант Seed же показался слушателю несколько скованным. Если проверка стенограмм занимает центральное место в вашем рабочем процессе, в этом отдельном руководстве объясняется, Как ChatGPT может транскрибировать аудио. Мы не использовали транскрипцию для дословной проверки текста B1.
B2: Эмоциональное развитие
B2: Эмоциональное развитие
Женский голос, переходящий от напряжённого шепота к нейтральному повествованию и далее к облегчённому волнению.
Показать точный текст застывшего запроса
“Мы справились”, — прошептала Майя. Затем снова зажглись огни. “Ну вот — теперь можно праздновать!” Используйте один и тот же голос взрослой женщины. Первое предложение произнесите тихо и напряжённо, среднее — нейтральным повествовательным тоном, а последнее — с облегчением и воодушевлением. Сделайте эмоциональные переходы чёткими, но не театральными. Без музыки и звуковых эффектов.
| Модель | Точный маршрут | Статус | Фактическая продолжительность | Формат | Фактическая стоимость |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | Первый действительный | 25,913 с | MP3, 22,05 кГц, моно | $0.0052950 |
| Seed Audio 1.0 | seed-audio-1.0 | Первый действительный | 9,180 с | PCM WAV, 40 кГц, стерео (одинаковые каналы) | $0.0214200 |
- Объективные проверки
- Оба файла были правильно декодированы; в них присутствовало несколько речевых фрагментов. Различия в продолжительности не учитывались при оценке качества.
- Оценка слушателя
- Слушатель отдал предпочтение модели Qwen за более выраженный эффект шепота и более убедительное ощущение повествования.
- Результат выполнения задачи
- Для выполнения этой задачи с первым выходом предпочтительно использовать Qwen.
- Ограничения
- Дословность не проверена; проверка стабильности не проводилась.
Тест по аудированию B2
Послушайте первые записи B2
Разыграйте любую из этих карт, чтобы напрямую сравнить две модели.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flashСгенерировано с помощью протестированного маршрута Anywhere 6 августа 2026 года. Получен один первый корректный результат; проверка стабильности не проводилась.
Seed Audio 1.0
seed-audio-1.0Сгенерировано с помощью протестированного маршрута Anywhere 6 августа 2026 года. Получен один первый корректный результат; проверка стабильности не проводилась.
Первый результат модели Qwen отличался более выраженным «шепчущим» характером и более выраженным повествовательным стилем. Пользователь не заметил явных ошибок в тексте ни в варианте B1, ни в B2, однако точность воспроизведения отдельных слов пока не подтверждена.
Примеры рабочих процессов с использованием одной модели
C1: «Eleven Music v2» — песня со структурированным вокалом
C1: Вокальная композиция со структурированной композицией
30-секундная инди-поп-песня с фиксированным составом инструментов, структурой и двумя обязательными строками текста.
Показать точный текст застывшего запроса
Создайте 30-секундную бодрую песню в стиле инди-поп с одной солисткой, ярким гитарным звуком, басом и хлопками в ладоши. Структура: четырёхсекундное инструментальное вступление, короткий куплет, припев и чёткое завершение. Используйте каждую из следующих строк текста по одному разу: Куплет: ‘Утро за окном, планы взлетают’. Припев: ‘Начни с того, где ты есть, и сделай этот момент ярким’. Без голосового повествования и звуковых эффектов.
| Модель | Точный маршрут | Статус | Фактическая продолжительность | Формат | Фактическая стоимость |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Первый действительный | 30,041 с | MP3, 44,1 кГц, стерео | $0.0750000 |
- Объективные проверки
- Файл MP3 был декодирован корректно. Обнаружен незначительный единичный случай перегрузки по полной шкале, при этом широкомасштабного клиппинга не наблюдалось.
- Оценка слушателя
- Слушатель оценил выполнение этого критерия как «частично выполненное»: голос звучал несколько неестественно и имел привкус электрического шума.
- Результат выполнения задачи
- Требование частично выполнено в рамках этого первого результата.
- Ограничения
- Это замечание относится только к первому результату; проверка стабильности не проводилась.
Тест по аудированию C1
Прослушайте первый результат теста C1
Воспроизведите первый допустимый результат из этой демонстрации, посвященной одной модели.
Eleven Music v2
eleven-music-v2Сгенерировано с помощью протестированного маршрута Anywhere 6 августа 2026 года. Получен один первый корректный результат; проверка стабильности не проводилась.
C1 частично выполнил условия контракта. Слушатель счел голос несколько неестественным и заметил присутствие электрических помех. Это замечание относится конкретно к данному образцу и не является заявлением об общем дефекте.
C3: Seed Audio 1.0 — полная сцена на железнодорожной станции
C3: Полная сцена на вокзале
20-секундная сцена на прибрежной станции, в которой сочетаются фоновые звуки, движущийся поезд, звуковой сигнал и точное объявление.
Показать точный текст застывшего запроса
Создайте 20-секундную полную сцену на прибрежной железнодорожной станции на рассвете. Начните с мягкого морского ветра и отдаленных криков чаек. Поезд приближается слева и тормозит у платформы. Спокойный женский голос диктора на станции произносит следующие слова: ‘Поезд № 715, идущий по прибрежному маршруту, прибывает на второй перрон’. Добавьте перед объявлением короткий мягкий музыкальный сигнал, а затем позвольте звукам поезда и окружающей обстановке естественным образом затихать. Сделайте речь разборчивой, а сцену — пространственно целостной.
| Модель | Точный маршрут | Статус | Фактическая продолжительность | Формат | Фактическая стоимость |
|---|---|---|---|---|---|
| Seed Audio 1.0 | seed-audio-1.0 | Первый действительный | 20 000-е | PCM WAV, 40 кГц, стерео | $0.0466667 |
- Объективные проверки
- Файл WAV был декодирован правильно, не содержал признаков клиппинга и с технической точки зрения соответствовал требуемой многочастной структуре сцены.
- Оценка слушателя
- Слушатель оценил этот критерий как «частично выполненный», поскольку звуки торможения и остановки поезда казались несколько искусственными.
- Результат выполнения задачи
- Требование частично выполнено в рамках этого первого результата.
- Ограничения
- Точный текст объявления не был записан из независимых источников; проверка на стабильность не проводилась.
Тест по аудированию C3
Прослушайте первый релиз группы C3
Воспроизведите первый допустимый результат из этой демонстрации, посвященной одной модели.
Seed Audio 1.0
seed-audio-1.0Сгенерировано с помощью протестированного маршрута Anywhere 6 августа 2026 года. Получен один первый корректный результат; проверка стабильности не проводилась.
C3 также частично выполнила условия контракта: слушателю звуки торможения и остановки поезда показались несколько искусственными. Это может заметить и создатели видео, сочетающие синтезированную речь с визуальными эффектами Руководство по диалогам, звуковому сопровождению и синхронизации движения губ полезно, хотя синхронизация звука и изображения здесь не проверялась.
Стоимость, длина трассы и поведение маршрута
Наблюдаемая зарядка и фактическая продолжительность разряда
Один первый действительный результат на каждую задачу через Anywhere 6 августа 2026 года. Указанные цены являются ориентировочными и не являются официальным прейскурантом. Две мини-шкалы используют отдельные визуальные шкалы; двойная ось или комбинированная оценка не применяются.
Наблюдаемые затраты варьируются от $0.00513 для Qwen B1 до $0.075 для каждого выходного сигнала Eleven. Фактическая продолжительность варьируется от 9,180 секунд для Seed B2 до 30,041 секунд для музыкальных выходов Eleven. Это результаты измерений в ходе сеансов, а не цены по прейскуранту или показатели качества.
Почему стоит попробовать эти аудиомодели на GlobalGPT?
Генерация музыки, выразительное преобразование текста в речь и создание полноценных звуковых ландшафтов — это разные задачи, поэтому в данном случае нет универсальной модели, которая бы превосходила все остальные. GlobalGPT позволяет на практике проводить это разграничение: вы можете начать с Eleven Music для создания трека, переключиться на Qwen Audio для озвучивания или использовать Seed Audio для композиции сцены, не поддерживая отдельную платформу для каждого аудио-рабочего процесса.
Поскольку GlobalGPT представляет собой мультимодельную рабочую среду, а не инструмент, предназначенный исключительно для работы со звуком, результат работы не обязательно должен ограничиваться аудиофайлом. Вы можете использовать другие модели искусственного интеллекта на платформе для написания чернового варианта или доработки сценария, исследования темы, создания сопутствующих изображений, а также разработки видеоматериалов на основе готового звукового сопровождения.
10 августа 2026 года Страница с ценами на GlobalGPT Показаны месячные эквиваленты: $5.8 для тарифного плана BASIC, $10.8 для тарифного плана PRO и $25.0 для тарифного плана UNLIMITED при выбранном варианте «Ежегодный выбор» и отображении «Ежегодная оплата». Это данные по годовому выставлению счетов для данной страницы; доступ к моделям зависит от тарифного плана.

Какую модель выбрать?
Матрица результатов первого вывода для шести задач
| Рабочий процесс | Протестированные модели | Результат | Выявленная причина | Тип доказательства | Ограничение |
|---|---|---|---|---|---|
| A1 · Музыка | «Eleven» против «Seed» | Одиннадцать — предпочтительный вариант | Более естественное развитие и гармоничное звучание инструментов | Предпочтения слушателей, не знающих исполнителя | По одному первому результату |
| A2 · Музыка | «Eleven» против «Seed» | Предпочтительно с семенами | Более чёткая вступительная часть и более насыщенное звуковое многослойность | Предпочтения слушателей, не знающих исполнителя | Seed вернул 27,704 с |
| B1 · Устная речь | Qwen против Seed | Предпочтительно Qwen | Более естественная манера повествования в документальном стиле | Предпочтения слушателей, не знающих исполнителя | Текст не проверялся слово за словом |
| B2 · Устная речь | Qwen против Seed | Предпочтительно Qwen | Более выразительный шепот и атмосфера повествования | Предпочтения слушателей, не знающих исполнителя | Текст не проверялся слово за словом |
| C1 · Вокальная песня | Только одиннадцать | Частично выполнено | Голос звучал неестественно, как будто в нем слышались электрические помехи | Семантическая экспертиза пользователя | Наблюдение, характерное для данной выборки |
| C3 · Звуковой ландшафт | Только семена | Частично выполнено | Звуки торможения и остановки поезда звучали неестественно | Семантическая экспертиза пользователя | Текст объявления не приведён |
Ни одна из серий не преобразуется в общий результат или единого победителя.
- Выберите Eleven Music v2 когда речь идет исключительно о музыке: о структурированных инструментальных композициях, песнях или монтаже музыки на уровне отдельных фрагментов.
- Выберите Qwen Audio 3.0 TTS Flash когда речь идет о дикторской работе или о контролируемой экспрессивной речи.
- Выберите Seed Audio 1.0 когда звуковой выход должен восприниматься как целостная сцена, сочетающая в себе фоновый звук, эффекты и речь.
В этих рекомендациях обобщены результаты оценки соответствия рабочим процессам, а также шесть оценок первых результатов. Они не определяют единого абсолютного победителя.
Ограничения данного сравнения
- По одному первому корректному результату для каждой модели и задачи; повторения результатов по показателю устойчивости не допускаются.
- Тексты B1 и B2 не были переписаны и не проверялись слово за словом.
- Оценки, основанные на прослушивании, носят субъективный характер и зависят от конкретной выборки.
- Маршрут «Anywhere» не является полным набором продуктов вышестоящего уровня.
- Ни одна объективная независимая таблица лидеров не учитывает именно эти три маршрута в рамках одного метода.
- Формат файла, частота дискретизации, количество каналов, размер файла и громкость воспроизведения не учитывались при оценке качества.
Часто задаваемые вопросы
01Являются ли Eleven Music v2, Qwen Audio 3.0 и Seed Audio 1.0 моделями одного и того же типа?
No. Eleven Music v2 — это специализированный музыкальный рабочий процесс, Qwen Audio 3.0 TTS Flash — тестируемый в данном обзоре модуль синтеза речи, а Seed Audio 1.0 предназначен для генерации звукового сопровождения целых сцен. Поэтому в данном сравнении даются рекомендации с учетом конкретных задач, а не выдвигается единый универсальный рейтинг.
02Какая модель предназначена для генерации музыки с помощью ИИ?
Eleven Music v2 — это, без сомнения, лучший специализированный музыкальный редактор в этом сравнении. В его официальной документации описаны возможности управления жанром, стилем, структурой, наличием вокала или инструментального сопровождения, поддержка нескольких языков, а также редактирование как отдельных фрагментов, так и всей композиции целиком.
03Какой из рассмотренных способов выражения лучше подходит для повествования и выразительной речи?
Версия Qwen Audio 3.0 TTS Flash, обозначенная здесь точным маршрутом Anywhere qwen-audio-3.0-tts-flash, лучше всего подошла для тестов на дикторскую речь и выразительную речь. Слушатель отдал предпочтение её первому варианту вывода как в группе B1, так и в группе B2, однако стабильность и точность воспроизведения отдельных слов не проверялись.
04Какая модель способна создать полноценный звуковой ландшафт с речью и эффектами?
Seed Audio 1.0 — это оптимальный рабочий процесс для создания композиционного звукового ландшафта. Официально программа предназначена для работы с голосом, звуковыми эффектами, фоновыми звуками и унифицированной оркестровкой, а в тесте C3 в одном выходном файле были объединены объявление на станции, звуки движения поезда, звуковой сигнал и прибрежные фоновые звуки.
05Можно ли использовать все три через GlobalGPT?
Да. В рабочей среде GlobalGPT вы можете попробовать Eleven Music для музыки, Seed Audio 1.0 для полноценных аудиосценок и Qwen Audio 3.0 для речи. Кроме того, GlobalGPT объединяет рабочие процессы по написанию текстов, поиску информации, работе с изображениями и видео в рамках одной мультимодальной платформы. Доступность моделей зависит от тарифного плана.
06Позволяет ли это сравнение определить абсолютного победителя?
Нет. Модели предназначены для разных рабочих процессов, а данные практических испытаний охватывают по одному первому достоверному результату для каждой модели и задачи без повторных прогонов для проверки стабильности. Полезный вывод носит условный характер: «Eleven» — для специализированной музыки, «Qwen TTS Flash» — для речи, а «Seed» — для полноценных аудиосценок.
Попробуйте свой собственный рабочий процесс работы со звуком
Принесите с собой свои музыкальные наброски, сценарий дикторского текста или задание по созданию звукового ландшафта на Аудиогенератор GlobalGPT и сравните полученный результат с тем заданием, которое вам действительно нужно выполнить. Обращайте внимание на музыкальную структуру, манеру исполнения, целостность сцены и точное следование подсказкам, а не выбирайте модель исключительно по имени.
Как только работа со звуком наладится, вы сможете продолжить проект, используя другие модели искусственного интеллекта GlobalGPT для разработки сценария, проведения исследований, подбора иллюстраций и создания концепций видео. Таким образом, тест превращается в практический рабочий процесс по созданию контента, а не в отдельное аудиодемо; повторяйте вывод результатов только в тех случаях, когда вам нужно подтвердить стабильность работы.