
Быстрый ответ: GPT-6 Sol выполнил тестовое задание, состоящее из пяти разделов, с ограничением объема вывода в 2 400 токенов; Claude Opus 5.5 дал более точный диагноз в нашей задаче по краткому анализу кода. Ни один из этих результатов не позволяет определить однозначного абсолютного победителя.
Полезное сравнение выходит за рамки простой оценки. Модели Claude Opus 5.5 и GPT-6 Sol отличаются подходами к написанию текстов, обобщению результатов исследований, рецензированию кода, составлению структурированных ответов, способам доступа к информации и повседневным рабочим процессам. Приведенные ниже результаты выполнения задач показывают, в каких случаях эти различия имеют значение.
GlobalGPT предоставляет вам обе модели в рамках одной доступной подписки на несколько моделей, наряду с другими моделями и возможностями искусственного интеллекта. С помощью одной панели управления можно вести проект от этапа исследования и написания текста до программирования, создания изображений и видео, а интерфейс командной строки (CLI) позволяет интегрировать этот рабочий контекст с терминалом и производственными инструментами.
Краткий ответ
Выберите GPT-6 Sol Во-первых, что касается тестируемого здесь рабочего процесса с ограничениями на написание: система выполнила все пять разделов, не превысив установленный общий лимит вывода в 2 400 токенов. Выберите Claude Opus 5.5 когда диагностика, четкий анализ рисков и строгий формат JSON имеют большее значение. Используйте оба подхода, когда характер работы меняется в течение дня.
В чём преуспевает каждая модель
Claude Opus 5,5 подходит для целенаправленной работы: проверки изменений в коде, разбора запутанных требований, определения рисков и соблюдения строгих соглашений о результатах. Подход «Anthropic» ориентирован на программирование, работу с компьютером, интеллектуальную деятельность, безопасность и более естественное общение в ходе длительных сессий. См. Обзор Claude Opus 5.5 для отдельного представления, ориентированного на модель. Это естественный выбор в тех случаях, когда тщательный повторный анализ ценится выше, чем краткий первоначальный ответ.
GPT-6 Sol подходит для задач с ограничениями: объемного технического задания, служебной записки с обоснованием решения, структурированного плана или черновика, который должен содержать множество требуемых разделов. В OpenAI эта модель описывается как более доступная версия GPT-6 для профессиональной работы, обеспечения достоверности информации, программирования, использования компьютера и совместной работы. Обзор GPT-6 Sol рассматривает эту модель отдельно; в данном задании с развернутым ответом она выполнила условия контракта уже в первом выводе, что полезно в случаях, когда цена отсутствия какого-либо раздела высока.
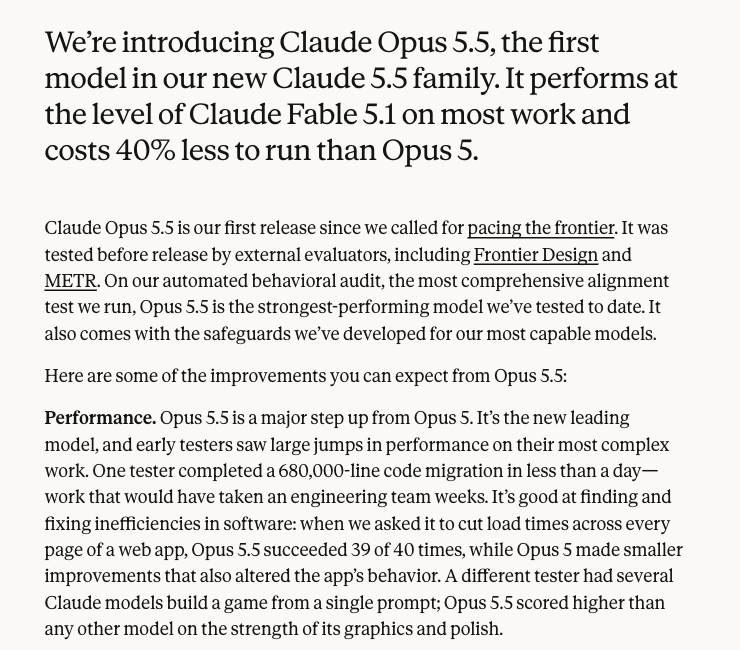
Это собственный отчет Anthropic о выпуске, включающий примеры от первых тестеров. Он подтверждает запланированное направление развития продукта; он не устанавливает результаты прямого сравнения с GPT-6 Sol. Приведенные ниже наши сопоставимые промпты касаются более узкого вопроса о том, какие результаты выдала каждая из моделей в ходе данного тестирования.
Сравнение функций и возможностей
Claude Opus 5.5 против GPT-6 Sol: карта возможностей
| Область принятия решений | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Длинные тексты | Сильная сторона — тщательная и детализированная формулировка текста с четкими оговорками | Умеет качественно выполнять объемные задания с множеством ограничений за один раз |
| Синтез исследований | Подробная сверка и разъяснение рисков | Краткое резюме с четкой рекомендацией |
| Программирование и рецензирование | Точная диагностика и структурированная отчетность о рисках | Полезные минимальные патчи; проверка обоснований для крайних случаев |
| Структурированный вывод | Надежный строгий JSON в тестируемом задании | Допустимый JSON-файл, содержащий все требуемые ключи в тестируемом задании |
| Мультимодальные средства и инструменты | Проверьте маршрут и модель доступа для конкретной задачи | Проверьте маршрут и модель доступа для конкретной задачи |
| Оптимальный стиль работы | Взвешенный анализ, комплексное обоснование и работа с учетом рисков | Завершено выполнение проверенного задания с ограничениями в рамках установленного лимита объема результата |
Как это читать: Это лишь тенденции в рабочем процессе, а не универсальный рейтинг. Правильный выбор зависит от того, что для вас важнее: тщательное рассмотрение задания или выполнение этого объёмного брифа в рамках того же лимита объёма результата.
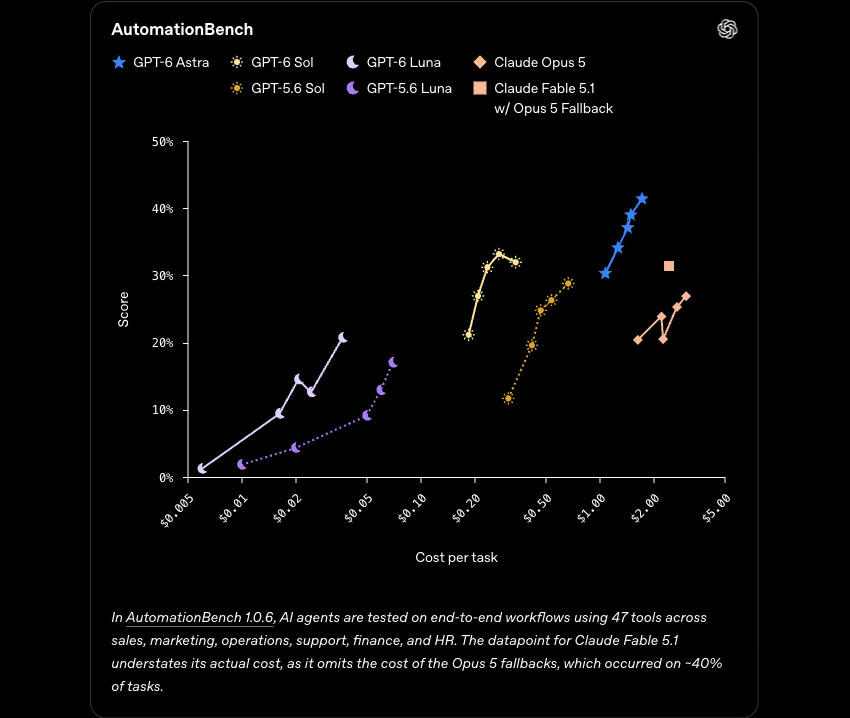
Обратите внимание на обе оси: движение вверх означает более высокий балл, а движение влево — более низкую стоимость выполнения задачи. Серия Claude, представленная здесь, — это Opus 5, а не Opus 5.5. Данная диаграмма, предоставленная издателем, помогает объяснить позиционирование Sol с точки зрения экономической эффективности; однако она не может окончательно решить вопрос о сравнении, рассматриваемом в данной статье. В сноске также указано, что в данных по игре Fable не учтены некоторые резервные затраты.
Письмо, составление объемных документов и обобщение результатов исследований
Что касается написания текстов, этот тест позволяет отличить выполнение задания в рамках фиксированного ограничения по объему от качества редакционной проверки. GPT-6 Sol продемонстрировал лучшие результаты при написании длинных текстов. Claude Opus 5.5 показал лучшие результаты при выполнении задач по диагностике, оценке и объяснению. Что касается исследовательских заметок, обе модели достигли одинакового практического результата, поэтому качество исходного материала и процесса рецензирования по-прежнему имеют большее значение, чем победа в отдельном тесте.
- Используйте GPT-6 Sol для создания первого чернового варианта с множеством ограничений, служебной записки по принятию решения или структурированного плана контента.
- Используйте Claude Opus 5.5, чтобы проверить гипотезы, выявить риски и доработать черновой вариант до того, как он попадёт к клиенту или в производственную среду.
- Если важны факты, предоставьте любой из моделей исходные данные и не отказывайтесь от этапа проверки человеком.
Программирование, структурированный вывод данных и подготовка материалов для использования в инструментах
Обе модели вернули корректный JSON-ответ со всеми запрошенными ключами и одинаковым минимальным патчем. Claude правильно описал существующий фильтр; GPT-6 Sol ошибочно заявил, что элемент None вызовет ошибку. Это свидетельствует в пользу Claude для диагностики в данной конкретной задаче. Тип поля «risk» не был указан в подсказке, поэтому строка «risk» от Sol не является нарушением контракта.
Для работы с готовыми инструментами определите, какой именно выходной контракт вам действительно нужен: корректный формат JSON, заполненные поля, воспроизводимые команды и патч, который можно применить без дополнительных интерпретаций. Обе модели могут быть частью этого конвейера, при этом тестирование и рецензирование должны оставаться неотъемлемой частью процесса.
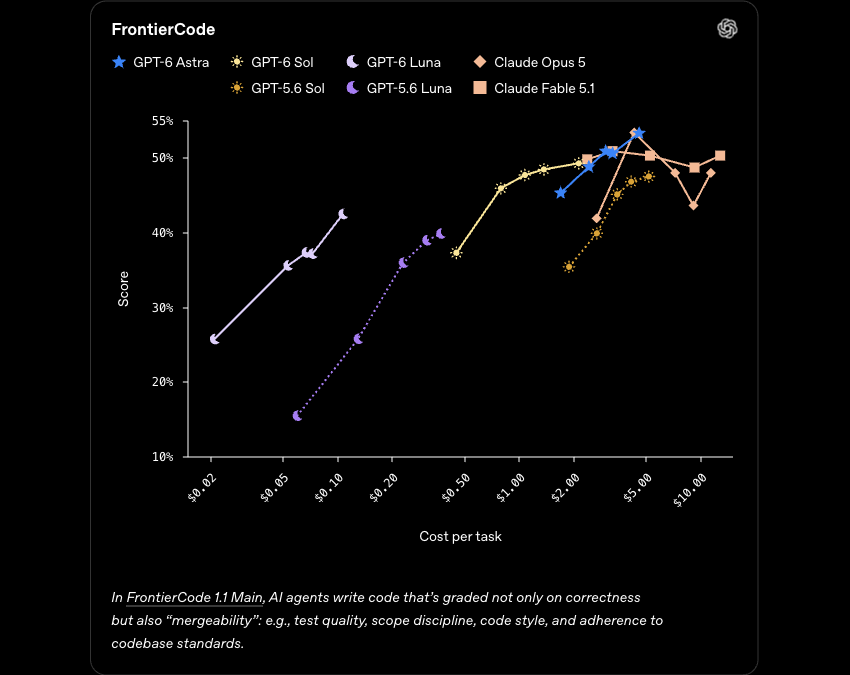
Этот тест охватывает более широкий спектр агентного кодирования, чем наш короткий пробный запрос на анализ кода. В качестве эталона для Claude в нем используется Opus 5, поэтому он служит скорее контекстом для определения места Sol среди систем кодирования, чем доказательством того, что Sol превосходит Opus 5.5. В нашей задаче оба патча оказались правильными; полезным различием стала точность диагностики.
Цена и доступность
Цена и доступность: сравнивайте маршрут, а не только модель
| Маршрут | За что вы платите | Когда это целесообразно |
|---|---|---|
| Claude Opus 5.5 API | На странице выпуска от 22 сентября 2026 года для Anthropic указаны следующие значения: $4 на миллион входных токенов, $20 на миллион выходных токенов и $0,20 на миллион токенов чтения из кэша | Вы разрабатываете продукт или автоматизированный конвейер и хотите воспользоваться прямым выставлением счетов с использованием токенов |
| API GPT-6 Sol | В тарифе OpenAI указаны расценки $2 за миллион входных токенов и $10 за миллион выходных токенов, что на 50% ниже, чем в рамках промо-цены GPT-5.6 Sol; на кэшированные чтения входных данных предоставляется скидка в размере 90% | Вам требуется договор о предоставлении прямого доступа к API, и вы хотите снизить стоимость, рассчитываемую по тарифу за фактическое использование, при длительной работе |
| GlobalGPT | Одна доступная подписка, включающая обе модели, а также множество других моделей и функций искусственного интеллекта | Вам нужны инструменты для проведения исследований, написания текстов, программирования, работы с изображениями и видео — и всё это в одной панели управления |
Эти цифры отражают тарифы на токены API, а не цены на подписку. OpenAI позиционирует GPT-6 Sol как наиболее доступный по цене вариант в семействе GPT-6 для профессиональной работы, проверки фактов, программирования, работы с компьютером и совместной работы, в то время как Anthropic позиционирует Claude Opus 5.5 в сфере программирования, работы с компьютером, интеллектуальной работы, безопасности и коммуникации. GlobalGPT обеспечивает доступ к обеим моделям и остальным компонентам инструментария в рамках одной доступной по цене подписки, а его командная строка (CLI) связывает этот доступ с терминалом, рабочим процессом разработки и существующими производственными инструментами.
Первоисточники: Страница версии Claude Opus 5.5 от Anthropic и Страница OpenAI, посвящённая выпуску GPT-6 Sol и Luna.
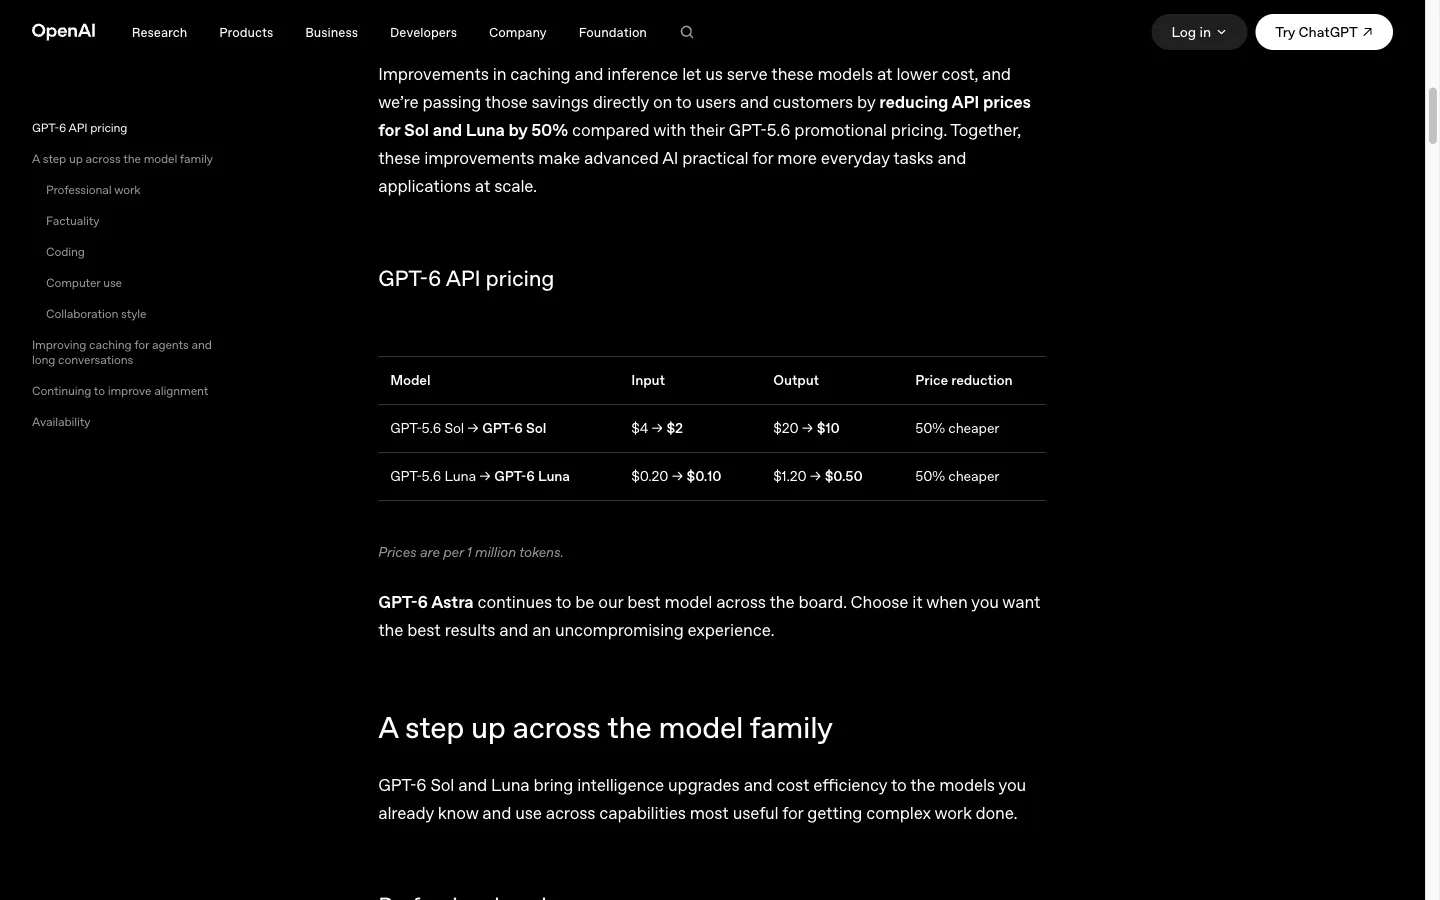
Эти тарифы распространяются на токены API. Они не относятся к ежемесячной потребительской подписке или тарифу GlobalGPT.
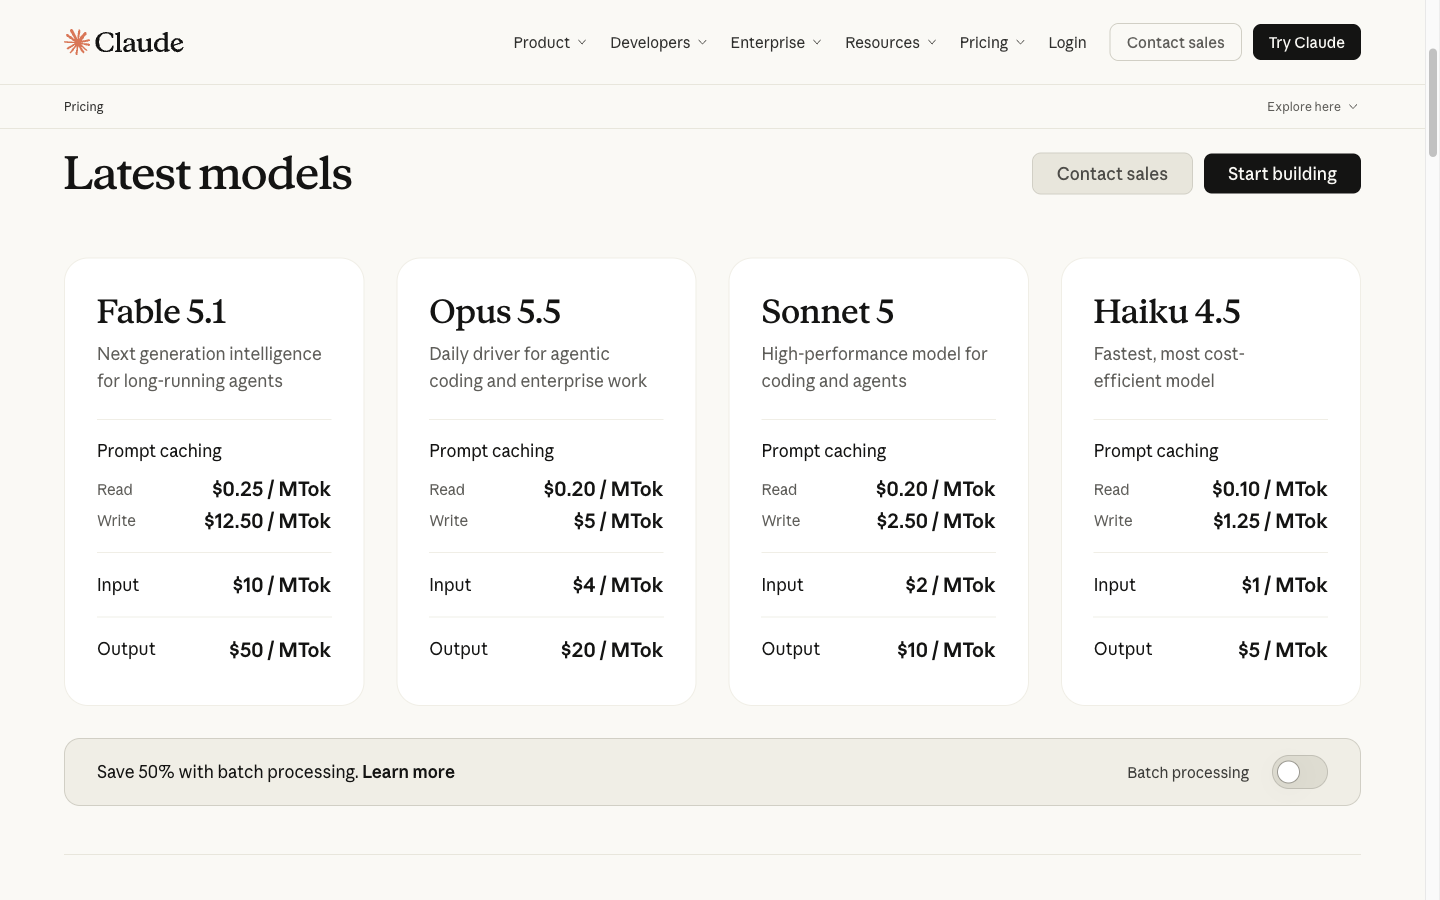
Стандартные скорости ввода и вывода в Opus 5.5 в два раза превышают аналогичные показатели Sol, тогда как обе опубликованные скорости чтения из кэша составляют $0.20/M. Таким образом, рабочий процесс с интенсивным использованием кэша может отличаться по стоимости от рабочего процесса без использования кэша; прежде чем выбирать вариант по цене, сравните набор токенов при одинаковых условиях.
Что означает разница в скорости при одинаковой нагрузке
Пример расчёта: 1 миллион токенов входных данных, не хранящихся в кэше, + 100 000 токенов выходных данных, стандартные тарифы API. Цвет «бирюзовый» обозначает затраты на входные ресурсы; цвет «ржавый» — затраты на выходные ресурсы.
У Sol эта идентичная комбинация токенов обходится в два раза дешевле. Это расчет по прейскуранту, а не утверждение, что каждая выполненная задача стоит в два раза дешевле: на сумму счета могут повлиять повторные попытки, объем вывода, попадания в кэш, плата за использование инструментов и настройки алгоритмов.
Источники: Цены на API Anthropic и Цены на версию OpenAI, проверено 25 сентября 2026 года.Расчет прямых затрат на API
Калькулятор стоимости API
Введите токены, которые вы планируете отправить и получить. В расчёте используются приведённые выше проверенные тарифы API: Claude Opus 5,5 при входных данных $4/M и выходных данных $20/M; GPT-6 Sol при входных данных $2/M и выходных данных $10/M.
| Модель | Скорость ввода | Производительность | Сметная стоимость |
|---|---|---|---|
| Claude Opus 5,5 | $4 / M | $20 / M | $9.00 |
| GPT-6 Sol | $2 / M | $10 / M | $4.50 |
Это ориентировочная оценка стоимости, рассчитанная на основе токенов, для прямого использования API. В ней не учитываются стоимость потребительской подписки или тарифного плана GlobalGPT, а также скидки за использование кэша, стоимость инструментов, налоги и другие сборы, устанавливаемые конкретным провайдером.
Кому следует выбирать ту или иную модель?
Какую модель выбрать?
| Ваш приоритет | Выбери первым | Почему |
|---|---|---|
| Тщательно отредактированная длинная служебная записка с множеством ограничений | GPT-6 Sol | Переработанное задание расширенного формата привело к требуемому правилу принятия решения за один проход |
| Диагностика кода, строгий формат JSON и явные риски | Claude Opus 5,5 | Задача по кодированию позволила составить более точный диагноз и перечень факторов риска |
| Исследовательские записи, требующие сверки | Либо | В задании по синтезу с управляемым источником был зафиксирован ничейный результат |
| Комбинированный еженедельный рабочий процесс | GlobalGPT с обоими | Соберите выбор модели, текстовые материалы, код, изображения и видео в одной панели управления; используйте командную строку, когда работа переходит в терминал |
Используйте обе модели в рамках единого рабочего процесса
Практический алгоритм работы с GlobalGPT
- Начните с краткого описания исследования и попросите одну из моделей раскрыть лежащие в его основе допущения.
- Перенесите отредактированный черновик в другую модель для составления проекта или получения второго мнения.
- Используйте более мощный подход к программированию для реализации, проверки и вывода структурированных данных.
- Сохраните полученный результат в той же панели инструментов, а затем воспользуйтесь Рабочий процесс GlobalGPT CLI когда его необходимо внедрить в терминал или производственное оборудование.
Именно этот рабочий процесс и является главным преимуществом доступа к обеим моделям: вы можете перенаправить задачу, а не перестраивать свой процесс под одну конкретную модель.

Как проводилось сравнение
Обе модели получили одинаковые системные сообщения, входные данные задач и исходный материал; при этом не использовалось никаких инструментов и не производился просмотр информации. Для каждого результата сохранен первый возвращённый вывод, включая усечение в пределах ограничения вывода. Это практическое сравнение, предназначенное для выбора рабочего процесса, а не универсальный рейтинг всех возможностей.
Метод сравнения
Как проводилось это сравнение
| Состояние | Правило сравнения |
|---|---|
| Модели | Claude Opus 5.5 и GPT-6 Sol — точные идентификаторы подтверждены в каталоге рабочих моделей |
| Паритет подсказок | То же системное сообщение, запрос на выполнение задачи, исходный материал, без инструментов и просмотра |
| Задачи | T01 — проверка границ, T01R — явное сравнение в развернутом виде, T02 — синтез исходного кода, T03 — код/JSON |
| Повторные попытки | Только сбои, связанные с транспортом, пропускной способностью или пустыми конвертами; действительные слабые выходы сохраняются |
| Подсчёт очков | 10 баллов за каждое выполненное задание: соответствие условиям контракта — 4, отслеживаемость — 3, полезность — 2, формат — 1 |
Первый тест проверяет, сможет ли модель дать правильный ответ при отсутствии ключевого контекста, поэтому он проводится отдельно от вычисления победителя. При прямом сравнении указываются обе модели, и им дается одинаковое задание. Повторные прогоны для проверки стабильности не проводились.
Почему по первому раунду не удалось определить победителя
Обработка контекста
Почему по первому раунду не удалось определить победителя
Обе модели отказались придумывать вымышленные личности, поскольку в исходном запросе их имена не указывались. Это правильная реакция на отсутствие контекста, но она не позволяет определить, какая из моделей лучше справляется с самой задачей.
Claude Opus 5,5 · полный вход
Вы сравниваете две модели искусственного интеллекта для составления практического руководства для покупателей. Используя только приведенный ниже исходный пакет, напишите текст объемом 700–900 слов с использованием именно следующих заголовков: «Решение», «Доказательства», «Предостережения», «Следующий шаг». Точно сохраните следующие факты: проект «North» имеет срок реализации 12 недель; бюджет на миграцию составляет $48 000; проверка безопасности не запланирована. Если какой-либо факт остался невыясненным, четко укажите это. Не придумывайте цены, тестовые показатели или возможности продукта.

ИСХОДНЫЙ ПАКЕТ:
«Проект North» — это 12-недельная миграция для команды из 40 человек. Утвержденный бюджет на миграцию составляет $48 000. Сроки проведения проверки безопасности не запланированы. Команда хочет получить типовую рекомендацию по исследованию, написанию документации и рецензированию кода. В заметке заинтересованной стороны указано, что текущий черновик слишком длинный, но количество слов не указано.

Верните только руководство.
Claude Opus 5,5 · полная мощность
## Решение

На основании предоставленного исходного пакета невозможно дать рекомендацию в отношении одной из двух моделей. В пакете не указана ни модель, ни цены, ни результаты тестирования, ни технические характеристики продукта. Выбор одной модели вместо другой на данном этапе означал бы выдумывание доказательств, на которые должно опираться данное руководство.

Практическое решение заключается в том, чтобы отложить выбор модели. Следующий этап следует рассматривать как структурированную оценку, подчиняющуюся трём фиксированным ограничениям:

- Срок реализации проекта "Север" составляет 12 недель.
- Бюджет на миграцию составляет $48 000.
- Проверка безопасности не запланирована.

Любая модель, которая будет выбрана, должна укладываться в 12-недельный срок и бюджет на миграцию в размере $48 000. Она также должна пройти проверку безопасности, а эта проверка пока не запланирована. До тех пор, пока не будут определены две модели и не будет проведена их оценка с учетом трех заявленных целей команды (исследование, написание и проверка кода), вопрос выбора останется нерешенным. В данном руководстве это сформулировано прямо, а не в виде предпочтения, которое не подкрепляется фактами.

## Факты

Пакет исходных данных содержит следующие факты, и только эти факты лежат в основе данного руководства:

- **Объем и сроки:** Проект «Север» представляет собой 12-недельную миграцию.
- **Размер команды:** Миграция предназначена для команды из 40 человек.
- **Бюджет:** Утвержденный бюджет миграции составляет $48 000.
- **Безопасность:** Сроки проведения проверки безопасности не запланированы.
- **Сценарии использования:** Команда хочет получить рекомендацию по модели для исследований, написания документации и рецензирования кода.
- **Отзывы заинтересованных сторон:** В заметке одной из заинтересованных сторон указано, что текущий проект документа слишком длинный, однако количество слов не указано.

В пакете документов отсутствуют несколько элементов, на которых обычно основывается сравнение. В нём не указаны две модели, подлежащие сравнению. В нём не указаны цены за рабочее место, за токен или по подписке для любого из вариантов. В нём отсутствуют результаты тестирования и данные внутренних испытаний. В нём не описано, что каждая из моделей может или не может сделать для исследований, написания текстов или рецензирования кода. В нём ничего не говорится об условиях обработки данных, вариантах развёртывания или требованиях к интеграции.

Поскольку ни один из этих пунктов не фигурирует в пакете документов, в данном руководстве не дается их оценка. Неизвестно, укладывается ли какая-либо из моделей в бюджет $48 000 для команды из 40 человек. Также неизвестно, какая из моделей демонстрирует лучшие результаты в области исследований, написания текстов или рецензирования кода. Любые цифры или заявления о возможностях, добавленные здесь, были бы вымышленными.

## Предостережения

На то, как следует интерпретировать это решение, влияют несколько нерешенных вопросов.

**Идентичность моделей не определена.** Сравнение касается двух моделей ИИ, но в пакете документов не указано, каких именно. Любое последующее суждение зависит от ответа на этот вопрос.

**Объем бюджета не определен.** В документе цифра $48 000 называется «утвержденным бюджетом на миграцию». Не указано, предназначена ли эта сумма для покрытия расходов на лицензирование моделей или плату за их использование. Возможно, она покрывает только работы по миграции, такие как затраты рабочего времени персонала, инструментарий или услуги. Если расходы на модели должны покрываться за счет той же суммы $48,000, то финансовый запас для любой из моделей окажется меньше, чем предполагает указанная цифра. Это требует подтверждения.

**Сроки проведения проверки безопасности не определены, что представляет собой риск для графика.** Дата проведения проверки безопасности не назначена. Учитывая 12-недельный срок, отсутствие запланированной проверки представляет реальный риск для графика. В документации не указано, сколько времени займет проверка и приведет ли неудачный результат к необходимости перехода на другую модель. Оба исхода могут занять значительную часть этих 12 недель. Ни одна из моделей не должна считаться утвержденной до завершения проверки.

**Вопрос о весовых коэффициентах сценариев использования остаётся нерешённым.** Команда назвала три сценария: исследования, написание текстов и ревью кода. В документации не указано, имеют ли они одинаковую важность или один из них доминирует. Модель, сильная в одной области, может быть слабее в другой, и без весовых коэффициентов нет оснований для компромисса между ними.

**Вопрос об объеме использования остаётся нерешённым.** В команде 40 человек, но в документации не указано, сколько из них будут использовать модель и насколько интенсивно. Объём использования может существенно повлиять на стоимость при определённых структурах ценообразования. Это невозможно оценить без данных о ценах и оценок объёма использования.

**Продолжительность инструкции...**
GPT-6 Sol · полный ввод
Вы сравниваете две модели искусственного интеллекта для составления практического руководства для покупателей. Используя только приведенный ниже исходный пакет, напишите текст объемом 700–900 слов с использованием именно следующих заголовков: «Решение», «Доказательства», «Предостережения», «Следующий шаг». Точно сохраните следующие факты: проект «North» имеет срок реализации 12 недель; бюджет на миграцию составляет $48 000; проверка безопасности не запланирована. Если какой-либо факт остался невыясненным, четко укажите это. Не придумывайте цены, тестовые показатели или возможности продукта.

ИСХОДНЫЙ ПАКЕТ:
«Проект North» — это 12-недельная миграция для команды из 40 человек. Утвержденный бюджет на миграцию составляет $48 000. Сроки проведения проверки безопасности не запланированы. Команда хочет получить типовую рекомендацию по исследованию, написанию документации и рецензированию кода. В заметке заинтересованной стороны указано, что текущий черновик слишком длинный, но количество слов не указано.

Верните только руководство.
GPT-6 Sol · полный вывод
## Решение

Пока не следует называть модель-победителя. В исходном пакете содержится просьба дать рекомендацию по выбору одной из двух моделей ИИ, однако в нём не указана ни одна из моделей и не приведены результаты исследований, текстов или анализа кода. Поэтому утверждение о превосходстве одной из моделей было бы необоснованным. Практическая рекомендация заключается в том, чтобы перед выбором сравнить обе модели с результатами собственной работы команды.

Срок реализации проекта “North” составляет 12 недель. Бюджет на миграцию составляет $48 000. Проверка безопасности не запланирована. Эти факты делают принятие решения срочным, но не оправдывают догадки. Правильный выбор должен учитывать, поможет ли модель команде из 40 человек выполнить поставленные задачи, как её использование вписывается в утверждённый бюджет и что остаётся неопределённым до тех пор, пока не станет известен срок проведения проверки безопасности.

Рассматривайте рекомендацию как условную: выбирайте ту модель, которая демонстрирует лучшие результаты при выполнении типичных задач, может быть использована в рамках утвержденного бюджета на миграцию и пройдет любую проверку, необходимую для ее предполагаемого использования. Если ни один из кандидатов не соответствует этим условиям, в руководстве следует указать, что пока ни один из них не может быть рекомендован. Имеющиеся материалы не подтверждают, что какое-либо из этих условий было выполнено.

## Доказательства

Команда хочет получить рекомендацию по модели для трех видов работы: исследования, написания текстов и рецензирования кода. Это подходящие категории для сравнения, поскольку они вытекают из заявленной потребности, а не из предполагаемых преимуществ продукта. В пакете документов отсутствуют примеры результатов работы обеих моделей, результаты оценки и описание того, что предлагают оба кандидата. В нём также отсутствуют цены и тестовые показатели. В результате отсутствует доказательная база для ранжирования моделей по точности, скорости, качеству, стоимости или пригодности.

Контекст проекта действительно предоставляет полезные критерии для принятия решения. Проект “North” представляет собой миграцию для команды из 40 человек, поэтому сравнение должно отражать задачи, которые фактически будут выполнять сотрудники этой команды. Утвержденный бюджет миграции составляет $48 000; любое предлагаемое использование модели должно оцениваться с учетом этой суммы, а не вымышленного ассигнования на инструменты ИИ. Проверка безопасности не запланирована, что оставляет нерешенным вопрос о сроках проведения проверки — и её влиянии на внедрение.

Один из заинтересованных лиц заявил, что текущий проект документа слишком длинный, но не указал количество слов. Это свидетельствует о предпочтении лаконичности, а не об измеримом ограничении на объем текста, генерируемого моделью. Сравнивая образцы текстов, рецензенты могут оценить, следует ли каждый кандидат требованию лаконичности и сохраняет ли он существенные факты. Им не следует утверждать, что какая-либо из моделей соответствует указанному заинтересованной стороной ограничению по количеству слов, поскольку такого ограничения не было предоставлено.

Для исследовательских целей полезным критерием будет то, умеет ли каждый кандидат отличать предоставленные факты от открытых вопросов и избегать необоснованных выводов. В случае письменных работ — способность каждого кандидата создавать четкий, достаточно краткий черновик, не нарушая при этом заданных ограничений. При рецензировании кода — способность каждого кандидата выявлять проблемы в предоставленном примере и объяснять их так, чтобы рецензент мог их проверить. Это предлагаемые тесты, а не выводы о какой-либо из моделей.

## Предостережения

Самое важное предостережение заключается в том, что сами кандидаты остаются неопределёнными: в пакете документов их названия не указаны. Также не указано, как команда получит к ним доступ, сколько они стоят и доступны ли они для выполнения предполагаемой работы. Из фразы “модели ИИ” не следует делать выводы о возможностях продукта. Даже хорошо продуманное сравнение не может дать рекомендации по продукту, пока не будут известны кандидаты и данные оценки.

Бюджет на миграцию утвержден, но в пакете документов не выделена никакая его часть на использование или тестирование моделей. Не следует рассматривать сумму $48 000 как бюджет на закупку ИИ. Аналогично, 12-недельный срок не определяет дату, к которой будет проведена проверка безопасности. Поскольку проверка безопасности не запланирована, вопрос о том, можно ли и когда кандидат будет использоваться в соответствии с требованиями команды, остается нерешенным.

Три запрошенных варианта использования также могут дать разные результаты. Один кандидат может быть предпочтительным для одной задачи, но не для другой; пакет документов не дает оснований предполагать, что один и тот же кандидат станет лучшим вариантом для исследования, написания текста и проверки кода. Рекомендация должна четко отражать любой подобный компромисс, а не скрывать его под общим обозначением. Если команда решит, что одна категория имеет большее значение, чем остальные, этот приоритет должен исходить от заинтересованных сторон, а не из данного руководства.

Наконец, замечание о том, что черновик слишком длинный, не следует ошибочно рассматривать как доказательство эффективности модели. В ней описывается обратная связь по текущему черновику без указания его автора или целевого объема. Это может повлиять на то, как будет представлена окончательная рекомендация, но не может решить вопрос о сравнении.

## Следующий шаг

Определите двух кандидатов и попросите команду предоставить типичные задачи по исследованию, написанию текстов и рецензированию кода. Предоставьте каждой модели одинаковые материалы и инструкции для каждой задачи, включая указания по обозначению неопределённости и избеганию добавления фактов. Попросите рецензентов зафиксировать, что в каждом ответе указано верно, что упущено и какие утверждения требуют проверки. Ведите наблюдения по конкретным задачам отдельно, чтобы сильный образец письменной работы не заменял доказательства, касающиеся рецензирования кода.

Перед выбором уточните стоимость предполагаемого использования с учетом бюджета на миграцию в размере $48 000 и определите, когда может быть проведена проверка безопасности. Ни один из ответов не содержится в пакете документов. Если эти вопросы не могут быть решены до момента принятия решения, четко сообщите об этом ограничении, а не представляйте предварительное предпочтение в качестве утвержденного выбора.

В таком случае окончательная рекомендация для заказчика может быть краткой и поддающейся проверке: перечислите кандидатов, приведите доказательства для каждого из трех вариантов использования, объясните возможные компромиссы и укажите нерешенные вопросы, связанные с утверждением или бюджетом. Пока эта информация отсутствует, честный ответ для проекта «Север» — это не «Модель А» и не «Модель Б». Это то, что сравнение пока не подкреплено доказательствами.
Рассматривайте это как проверку на соответствие контексту, а не как оценку качества.
Длинные тексты
Завершение при том же ограничении на выпуск в 2 400 токенов
В этом же техническом задании требовалось пять разделов. Для обеих моделей был установлен лимит вывода в 2 400 токенов; полученные метаданные объясняют заметную разницу.
Claude достиг заданного предельного объема вывода до применения правила «Решение». Sol завершил написание текста в рамках этого предела. Это служит основанием для рекомендации по данному прогону с ограничениями, а не для общего оценки максимальных способностей или скорости написания. Полный текст ответа, включая усеченную часть, приводится ниже.
Расширенное задание
Написание длинных текстов: GPT-6 Sol выполнил задание
Это первое задание по прямому сравнению. В подсказке явно указано Claude Opus 5,5 и GPT-6 Sol, предоставил обоим одинаковый пакет информационных материалов по проекту «Север» и потребовал подготовить служебную записку с условным решением.
| Мера | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Видимая длина | 648 слов; finish_reason=длина | 1 065 слов; finish_reason=stop |
| Обязательные разделы | 4 из 5; после усечения отсутствует правило принятия решения | 5 из 5 |
| Четырёхрядная таблица результатов | Настоящее и симметричное | Настоящее и симметричное |
| Контрольные проверки пилота / условия остановки | Начато, но прервано до завершения | Три проверки и условие остановки |
| Счет | 7.0 / 10 | 10.0 / 10 |
Вывод: При одинаковом ограничении вывода в 2 400 токенов модель GPT-6 Sol выдала все пять разделов, тогда как модель Claude Opus 5.5 достигла этого предела ещё до применения правила «Decision». Это демонстрирует способность модели завершить задачу в данной конфигурации; при этом не устанавливается ни максимальная способность любой из моделей к написанию текста, ни их общая скорость.
Общий полный ввод данных
Вы составляете служебную записку с рекомендациями для команды, выбирающей между моделями Claude Opus 5.5 и GPT-6 Sol. Названия моделей являются фиксированными и должны упоминаться в точности так, как указано. Используя исключительно приведенный ниже пакет доказательств, напишите текст объемом 900–1100 слов, включающий именно следующие разделы: Рекомендации руководству; Что подтверждают данные; Где данных не хватает; 30-дневный пилотный проект; Правило принятия решения.

Требования: (1) сравните Claude Opus 5.5 и GPT-6 Sol на равных условиях; (2) разделите наблюдаемые данные, допущения и неизвестные факторы; (3) сохраните точные даты, бюджет, численность команды и статус безопасности, остающийся нерешенным; (4) включите компактную таблицу оценки из четырёх строк, охватывающую обобщение результатов исследования, написание развёрнутого текста, рецензирование кода и структурированный JSON; (5) дайте условную рекомендацию, а не выдумывайте победителя; (6) перечислить три измеримых пилотных проверки и условие прекращения; (7) не выдумывать цены, эталонные показатели, ограничения контекста или возможности продукта.

ПАКЕТ ДОКАЗАТЕЛЬСТВ
- Проект «North» — это 12-недельная миграция для команды из 40 человек.
- Утвержденный бюджет миграции составляет $48 000. В пакете не указано, входит ли использование модели в этот бюджет.
- Сроки проведения проверки безопасности не запланированы.
- Команде требуются обобщение результатов исследований, написание развернутых текстов, рецензирование кода и структурированное извлечение данных из JSON.
- Один из заинтересованных лиц отмечает, что текущий черновик слишком длинный, однако целевое количество слов не утверждено.
- Пока не предоставлено ни одного контролируемого результата от Claude Opus 5.5 или GPT-6 Sol.
- Команда хочет иметь возможность проверить выбор и может провести 30-дневный пилотный проект с идентичными запросами и проверкой со стороны человека.

Верните только служебную записку. Не утверждайте, что пакет доказательств доказывает превосходство какой-либо из моделей.
Claude Opus 5,5 · полный возвратный выходной сигнал
## Рекомендация руководства

Пока не следует выбирать ни Claude Opus 5.5, ни GPT-6 Sol. В пакете доказательств отсутствуют контролируемые результаты работы любой из этих моделей. Таким образом, нет наблюдаемых оснований для того, чтобы признать одну из них лучшей по сравнению с другой при выполнении любой из четырёх требуемых задач.

Рекомендация носит условный характер. Проведите 30-дневный пилотный проект, в ходе которого обе модели будут получать идентичные запросы и подвергаться одинаковой экспертной оценке. Затем выберите модель, которая соответствует пороговым значениям, согласованным до начала пилотного проекта, при условии, что предварительно будут решены вопросы безопасности и бюджета, указанные ниже. Возможны три исхода:

- **Одна модель преодолевает пороговые значения:** выберите эту модель.
- **Обе преодолевают:** примените критерии, разрешающие равенство голосов, из правила принятия решений.
- **Ни одна не преодолевает:** не принимайте ни одну из них.

Такой подход дает команде возможность сделать поддающийся аудиту выбор, о котором она просила.

Известные факты по проекту:

- Проект "Север" — это 12-недельная миграция для команды из 40 человек.
- Утвержденный бюджет миграции составляет $48 000. В пакете документов не указано, входит ли использование модели в этот бюджет.
- Сроки проведения проверки безопасности не запланированы.
- В пакете документов не указаны календарные даты (ни дата начала проекта, ни дата окончания, ни период пилотного внедрения), поэтому в данной записке они не назначаются.

## Что подтверждают факты

**Наблюдаемые факты.** Это факты, прямо указанные в пакете документов:

- Проект «North» представляет собой 12-недельную миграцию для команды из 40 человек.
- Утвержденный бюджет на миграцию составляет $48 000, и не указано, в какой степени он покрывает использование модели.
- Сроки проведения проверки безопасности не запланированы.
- Требуемые рабочие нагрузки включают обобщение результатов исследований, написание длинных текстов, рецензирование кода и извлечение структурированных данных в формате JSON.
- Один из заинтересованных лиц отмечает, что текущий черновик слишком длинный, но целевое количество слов не утверждено.
- Не было предоставлено никаких контролируемых результатов от Claude Opus 5.5 или GPT-6 Sol.
- Команда хочет иметь возможность выбора, поддающегося аудиту, и может провести 30-дневный пилотный проект с идентичными промптами и проверкой со стороны человека.

**Что это подтверждает.** Доказательства определяют, что и как необходимо оценивать, но не указывают, какая модель выиграет. Они обосновывают проведение структурированного пилотного проекта с параллельным сравнением моделей. Они не обосновывают никаких утверждений о качестве, скорости, стоимости, обработке контекста или доступности функций для любой из моделей.

**Таблица результатов (текущее состояние доказательств)**

| Нагрузка | Claude Opus 5.5 | GPT-6 Sol | Показатель пилотного проекта |
|---|---|---|---|
| Синтез исследований | Контролируемый результат не предоставлен | Контролируемый результат не предоставлен | Оценка по шкале анонимного рецензента |
| Написание длинных текстов | Контролируемый результат не предоставлен | Контролируемый результат не предоставлен | Оценка по шкале плюс соблюдение утверждённого целевого объёма |
| Рецензирование кода | Контролируемый результат не предоставлен | Контролируемый результат не предоставлен | Доля выявленных известных проблем |
| Структурированный JSON | Контролируемый результат не предоставлен | Контролируемый результат не предоставлен | Процент успешной валидации схемы |

Все ячейки для обеих моделей идентичны, поскольку в пакете данных они рассматриваются одинаково. На данный момент ни одна из строк не отдаёт предпочтения какой-либо модели.

## Где отсутствуют данные

**Неизвестные факторы.** В пакете данных ничего не говорится о следующем:

- Вписываются ли затраты на использование моделей в бюджет миграции $48 000 или требуют отдельного финансирования.
- Когда состоится проверка безопасности, что она будет охватывать и будет ли какая-либо из моделей признана приемлемой в её рамках. Статус безопасности для обеих моделей остаётся нерешенным.
- Конкретные даты 12-недельной миграции и 30-дневного пилотного проекта.
- Утверждённый целевой объём текста для написания длинных текстов. Без него невозможно оценить комментарий заинтересованной стороны о том, что текст «слишком длинный».
- Цены, результаты тестирования, ограничения по контексту и возможности продуктов Claude Opus 5.5 и GPT-6 Sol. Ничего из этого не указано, и в данной записке не делается никаких предположений.
- Кто является рецензентами-людьми, сколько их и как будут разрешаться разногласия между ними.
- Какие данные могут использоваться в пилотном проекте до завершения проверки безопасности.

**Предположения.** Это предложения, выдвинутые в данной записке, а не факты из пакета документов, и каждое из них требует одобрения команды:

- В рамках пилотного проекта можно использовать неконфиденциальные или синтетические данные до тех пор, пока в ходе проверки безопасности не будет разрешено использование реальных данных.
- Эксперты могут не знать, какая именно модель сгенерировала тот или иной результат.
- Команда может сформировать фиксированный набор подсказок для каждой рабочей нагрузки, отражающий реальные задачи проекта «North».
- Предлагаемые ниже пороговые значения прохождения являются отправными точками, которые команда может изменить до начала пилотного проекта, но не во время его проведения.

## 30-дневный пилотный проект

**Проект**

1.
GPT-6 Sol · полный вывод результата
## Рекомендация руководства

Пока не выбирайте Claude Opus 5.5 или GPT-6 Sol. Проект “North” представляет собой 12-недельную миграцию для команды из 40 человек, и в пакете данных отсутствуют контролируемые результаты работы обеих моделей. Поэтому он подходит для плана сравнения, а не для вынесения заключения о производительности. Проведите доступный 30-дневный пилотный проект с идентичными запросами и проверкой человеком, а затем примите поддающийся аудиту выбор на основе критериев, согласованных до изучения результатов. Выберите любую из моделей только в том случае, если её проверенные результаты соответствуют потребностям команды, её использование укладывается в утвержденные финансовые рамки, а нерешенные вопросы по результатам проверки безопасности позволяют принять решение о внедрении. Если эти условия не выполняются, отложите выбор, а не считайте неполное сравнение победой.

Утвержденный бюджет на миграцию составляет $48 000. В пакете документов не указано, укладывается ли использование модели в этот бюджет. Сроки проведения проверки безопасности не запланированы. Это ограничения при принятии решения, одинаковые как для Claude Opus 5.5, так и для GPT-6 Sol, а не доказательства в пользу одной из моделей.

## Что подтверждают факты

**Наблюдаемое:** Команде необходимы синтез результатов исследований, написание развернутых текстов, рецензирование кода и структурированное извлечение данных в формате JSON. Ей нужен вариант, поддающийся аудиту, и она готова провести 30-дневный пилотный проект с использованием идентичных запросов и проверки людьми. Один из заинтересованных лиц отмечает, что текущий черновик слишком длинный, но целевое количество слов не утверждено. Эта обратная связь указывает на проблему, которую необходимо проверить в текстовых результатах; она не определяет предпочтительную модель или приемлемую длину.

Текущая таблица оценки по задачам намеренно не содержит ранжирования:

| Направление работы | Claude Opus 5.5 | GPT-6 Sol | Необходимо собрать данные пилотного проекта |
|---|---|---|---|
| Синтез исследований | Ещё не тестировалось | Ещё не тестировалось | Точность, полнота и отслеживаемость по оценке рецензентов |
| Длинные тексты | Ещё не протестировано | Ещё не протестировано | Полезность, ясность и лаконичность по оценке рецензентов |
| Рецензирование кода | Ещё не протестировано | Ещё не протестировано | Проверенные рецензентами выводы и неподтверждённые утверждения |
| Структурированный JSON | Ещё не протестировано | Ещё не протестировано | Допустимые результаты и правильное извлечение полей |

**Предположение для планирования, а не наблюдаемый результат:** сопоставимые образцы работ и единая шкала оценки могут выявить различия, имеющие значение для проекта “North”. Пилотный проект должен проверить это предположение. Одни только идентичные запросы не сделают выбор поддающимся аудиту: команда должна также сохранять входные данные, оба вида выходных данных, критерии оценки, суждения рецензентов и обоснования любых исключений или повторных прогонов. При ручной оценке к каждой модели должны применяться одинаковые стандарты.

В случае длинных текстов эксперты должны различать «слишком длинный» и «неполезный». В более коротком ответе может быть опущен необходимый материал; более длинный ответ может оставаться понятным и пригодным для использования. Поскольку целевое количество слов не утверждено, в ходе пилотного проекта можно фиксировать длину текста и оценки экспертов, но не следует задним числом объявлять произвольное количество слов стандартом приемлемости. Такой же подход применяется и к другим задачам: фиксируйте то, что наблюдали рецензенты, а не преобразуйте личные предпочтения в утверждения об общих возможностях модели.

## Где отсутствуют доказательства

**Неизвестно:** Пакет не содержит контролируемых результатов работы моделей Claude Opus 5.5 или GPT-6 Sol. В нём не установлены относительное качество, надёжность или пригодность для любого из четырёх рабочих направлений. В нём также не указаны цены, ограничения по контексту, эталонные показатели или информация о возможностях продукта. Следовательно, в данной записке невозможно оценить стоимость использования или сделать вывод о том, какая модель будет работать лучше с материалами проекта «North».

Перед принятием решения о закупке необходимо уточнить рамки бюджета. Сумма в $48 000 представляет собой утверждённый бюджет на *миграцию*; не указано, должны ли расходы на использование модели оплачиваться из него. Рассмотрение этих расходов как включённых в бюджет или как дополнительных привело бы к финансовым предположениям, которые не подтверждаются данными пакета документов. Команда должна задокументировать ответ и соответствующий порядок утверждения, прежде чем принимать решение о постоянном использовании.

Вопрос безопасности также остаётся нерешённым для обеих моделей. Сроки проведения проверки безопасности не запланированы, и в пакете документов не приводятся результаты оценки безопасности. Даже успешные результаты пилотного проекта не позволят устранить эту проблему. Команда должна определить, кто может запланировать и принять решение о проведении проверки, какая информация потребуется эксперту, а также разрешена ли сама пилотная деятельность в соответствии с применимыми правилами; пакет документов не даёт ответов на эти вопросы. Не указаны календарные даты начала или окончания миграции, пилотного проекта или проверки безопасности, поэтому команда не должна предполагать, что решение по безопасности будет принято в течение 30-дневного пилотного проекта или 12-недельной миграции.

## 30-дневный пилотный проект

Перед первым сравнением команда должна выбрать репрезентативные запросы для всех четырёх рабочих потоков, определить ожидаемый формат каждого ответа и согласовать критерии экспертной оценки. Обе модели должны получать идентичные запросы и одинаковые инструкции по экспертной оценке. Эксперты должны фиксировать свои оценки, исходя из качества работы, а не из репутации модели. Сохраняйте запрос, результат, отзыв и любые запрошенные исправления, чтобы последующий читатель мог восстановить каждую оценку. Фиксируйте отклонения от общепринятого процесса, а не молчаливо опускайте сложные случаи.

Используйте три измеримых критерия проверки:

1. **Качество оцениваемых задач:** для синтеза исследований, написания длинных текстов и рецензирования кода подсчитайте долю результатов, которые рецензенты признают приемлемыми для заданной задачи. Также отдельно фиксируйте причины отклонения — например, неполный охват темы, неясность изложения или непроверенные выводы по рецензированию кода. Представляйте результаты по рабочим потокам и моделям, а не в виде одного сводного показателя.
2. **Надежность структурированного JSON:** Подсчитайте результаты, соответствующие согласованной структуре, и результаты, извлеченные поля которых рецензент подтвердил как правильные. Отчитывайтесь по обоим показателям для Claude Opus 5.5 и GPT-6 Sol; структурно корректный ответ не следует считать точным только потому, что он проходит синтаксический анализ.
3. **Затраты на рецензирование и отслеживаемость:** фиксируйте время, затраченное рецензентом на проверку и, при необходимости, исправление каждого результата. Учитывайте случаи, в которых отсутствуют достаточные доказательства, объясняющие решение рецензента. Сравнивайте эти показатели по одному и тому же набору запросов, включая случаи, когда ни один из результатов не является приемлемым.

Согласуйте критерии приемлемости и порядок действий в случае равенства оценок до просмотра результатов пилотного тестирования; в пакете материалов не содержится эталонных данных, на основе которых можно было бы определить числовые пороговые значения. По истечении 30 дней опубликуйте критерии оценки, статистику, обоснования рецензентов и нерешенные вопросы. **Условие остановки:** приостановите внедрение, если не могут быть выполнены требования безопасности для пилотного проекта или последующего использования, либо если команда не может определить обоснованный бюджет и порядок утверждения. Не заменяйте ни одно из этих разрешений благоприятными оценками качества.

## Правило принятия решения

Выберите Claude Opus 5.5, если результаты его пилотного тестирования соответствуют заранее согласованным стандартам, являются существенно более убедительными в тех рабочих потоках, которым команда уделяет приоритетное внимание, и если вопросы безопасности и финансирования решены. Примените точно такое же правило к GPT-6 Sol. Если обе модели соответствуют стандартам без существенных и значимых различий, принимайте решение на основе задокументированных приоритетов проекта и устраненных ограничений, а не на основании заявлений о превосходстве по производительности. Если ни одна из моделей не соответствует требованиям — или вопросы бюджетных ограничений или статуса безопасности остаются нерешенными — пока не делайте выбор модели. Такой исход обеспечивает возможность проверки принятого решения для команды из 40 человек, не выдвигая утверждений, выходящих за рамки подтверждаемых доказательствами фактов.
Метаданные: Claude — HTTP 200 · 25,98 с · finish_reason=length · prompt_tokens=598 · completion_tokens=2400
GPT — HTTP 200 · 27,763 с · finish_reason=stop · prompt_tokens=386 · completion_tokens=1695
Синтез исходных данных
Исследовательская задача
Синтез источников: ничья
Обе модели урегулировали конфликт дат, установив дату 15 октября, сохранили согласованный бюджет в размере $12 000 и расценили утверждение “всегда точно” как необоснованное заявление менеджера. В результате по данному заданию зафиксирована ничья.
| Мера | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Счет | 9.5 / 10 | 9.5 / 10 |
| Урегулирование конфликтов | S2 контролирует срок | S2 контролирует срок |
| Необоснованное утверждение | Помечено как «не поддерживается» | Помечено как «не поддерживается» |
| Практическое отличие | Более подробное объяснение рисков | Более лаконичная рекомендация |
Общий полный ввод данных
Сверьте приведенные ниже примечания к источникам. Предоставьте (1) таблицу в формате Markdown со столбцами “Утверждение”, «Ориентир», «Статус», «Причина» и (2) рекомендацию объемом около 250 слов. В качестве ориентира используйте служебную записку с более поздней датой только в случае конфликта сроков. Отметьте необоснованные утверждения как «необоснованные». Не добавляйте факты.

[S1 01.09.2026] Пилотный проект заканчивается 30 сентября. Бюджет составляет $12 000.
[S2 03.09.2026] Пилотный проект заканчивается 15 октября. Бюджет остаётся на уровне $12 000.
[S3 02.09.2026] Юридический отдел не одобрил обмен данными с внешними сторонами.
[S4 04.09.2026] Руководитель заявляет, что модель «всегда точна»; доказательства, подтверждающие это, не прилагаются.
[S5 04.09.2026] В команду пилотного проекта входит 8 человек.
[S6 05.09.2026] В меморандуме о принятом решении должны быть перечислены нерешенные риски.

Верните только таблицу и рекомендацию.
Claude Opus 5,5 · полная мощность
| Заявление | Источник, имеющий преимущественную силу | Статус | Причина |
|---|---|---|---|
| Пилотный проект заканчивается 30 сентября | S2 (03.09.2026) | Заменено | Противоречит S2. Примечание с более поздней датой имеет преимущественную силу в случае конфликта сроков. |
| Пилотный проект заканчивается 15 октября | S2 (03.09.2026) | Подтверждено (имеет приоритет) | Это примечание с более поздней датой, касающееся конфликта сроков, поэтому оно имеет приоритет над S1. |
| Бюджет составляет $12 000 | S1 и S2 | Подтверждается | Оба источника согласуются, а в S2 указано, что бюджет "остаётся" равным $12 000. Конфликта нет. |
| Юридический отдел не одобрил обмен данными с внешними сторонами | S3 | Подтверждено | Указано прямо и не опровергается никаким другим источником. |
| Модель "всегда точна" | S4 | Не подтверждено | Это утверждение руководителя, не подкреплённое доказательствами. |
| В пилотной группе 8 человек | S5 | Подтверждено | Указано прямо и не опровергается. Информация получена из одного источника. |
| В меморандуме о принятии решения должны быть перечислены неустраненные риски | S6 | Подтверждено | Это заявленное требование к меморандуму, и оно не опровергается. |

**Рекомендация**

В меморандуме о принятии решения следует указать 15 октября в качестве даты завершения пилотного проекта. S2 — это записка с более поздней датой, которая разрешает конфликт сроков и имеет приоритет над датой 30 сентября, указанной в S1. Правило "более поздней даты" применяется только к данному конфликту. Остальные утверждения были оценены на основании имеющихся подтверждений.

Бюджет следует указать как $12 000. В документах S1 и S2 приводятся одинаковые цифры, поэтому сверка не требуется. Также можно указать численность команды — восемь человек. Это утверждение основано исключительно на документе S5, но никакие источники ему не противоречат.

В S6 требуется, чтобы в служебной записке были перечислены нерешенные риски, и примечания подтверждают наличие по крайней мере двух из них.

- **Обмен внешними данными:** Юридический отдел не одобрил его (S3). В служебной записке следует четко указать это. Не следует давать понять, что обмен внешними данными разрешен в ходе пилотного проекта.
- **Точность модели:** Утверждение о том, что модель «всегда точна», не подтверждено. В S4 отмечается, что доказательства тестирования не прилагаются, и это утверждение фиксируется лишь как заявление руководителя. В служебной записке не следует представлять его в качестве вывода или опираться на него для обоснования решений. Точность модели следует указывать как непроверенную до тех пор, пока не будут представлены подтверждающие доказательства.

Наконец, в служебной записке следует кратко отметить, что дата окончания пилотного проекта изменилась между версиями S1 и S2. Читатели могут встретить более раннюю дату — 30 сентября — в других источниках, и это примечание объяснит, почему используется дата 15 октября. В служебной записке не следует добавлять объяснений относительно этого изменения, результатов тестирования или обновлений правового статуса, поскольку ничто из этого не фигурирует в исходных примечаниях.
GPT-6 Sol · полный вывод
| Утверждение | Контролирующий источник | Статус | Причина |
|---|---|---|---|
| Пилотный проект заканчивается 30 сентября. | S2 (03.09.2026) | Заменено | Заметка с более поздней датой разрешает конфликт сроков и устанавливает крайний срок на 15 октября. |
| Пилотный проект заканчивается 15 октября. | S2 (03.09.2026) | Подтверждено | S2 указывает определяющий крайний срок. |
| Бюджет составляет $12 000. | S1 и S2 | Подтверждено | Обе заметки указывают одну и ту же сумму. |
| Юридический отдел не одобрил обмен данными с внешними сторонами. | S3 | Подтверждено | S3 прямо указывает на это; ни одна более поздняя заметка не затрагивает вопрос об этом одобрении. |
| Модель “всегда точна”. | S4 | Не подтверждено | Руководитель делает такое утверждение, но доказательства в виде результатов тестирования не прилагаются. |
| В пилотной группе 8 человек. | S5 | Подтверждено | В S5 указан размер группы. |
| В меморандуме о принятии решения должны быть перечислены нерешенные риски. | S6 | Подтверждено | В S6 указано это требование. |

**Рекомендация:** В меморандуме о принятии решения использовать 15 октября в качестве даты окончания пилотного проекта. S2 имеет более позднюю дату, чем S1, и устраняет конфликт сроков между ними. Оставить бюджет на уровне $12 000: в примечаниях согласована именно эта сумма, поэтому изменение срока не дает оснований для её изменения. Укажите численность команды пилотного проекта как 8 человек, как указано в S5.

Четко перечислите нерешенные риски, как того требует S6. В меморандуме должно быть указано, что юридический отдел не одобрил обмен внешними данными, без намека на то, что одобрение было дано позже или что обмен разрешен. В нем также следует провести разграничение между заявлением руководителя о точности и подтвержденным выводом. В S4 зафиксировано утверждение о том, что модель “всегда точна”, но не приводятся доказательства, подтверждающие это. Не следует представлять данное утверждение в качестве проверенного результата.

Ограничьте сферу сверки. S2 регулирует противоречивые даты завершения; он не заменяет отдельные примечания, касающиеся юридического отдела, точности, численности команды или требований к служебной записке. Если примечания не устанавливают окончательного результата, оставьте вопрос нерешенным, а не выдвигайте предположение. В частности, запись не подтверждает ни утверждение о том, что обмен внешними данными был одобрен, ни утверждение о том, что точность модели была доказана.

Поэтому в итоговой служебной записке можно использовать крайний срок 15 октября и бюджет $12 000, одновременно указав на два пробела в доказательствах, очевидных в этих примечаниях: не полученное юридическое одобрение на обмен внешними данными и отсутствие доказательств, подтверждающих утверждение о точности.
Метаданные: Claude — HTTP 200 · 12,846 с · finish_reason=stop · prompt_tokens=338 · completion_tokens=1193
GPT — HTTP 200 · 12,322 с · finish_reason=stop · prompt_tokens=230 · completion_tokens=714
Программирование и структурированный вывод
Разница в кодировании заключалась в пояснении
Исходное условие фильтрации: если t
Элемент None считается ложным, поэтому данный фильтр уже пропускает его.
Обе модели вернули корректный JSON с четырьмя запрошенными ключами и одинаковым минимальным патчем. Claude правильно описал существующий фильтр; GPT-6 Sol ошибочно заявил, что элемент None вызовет ошибку. Эта конкретная ошибка в диагностике имеет значение, когда рецензент решает, устраняет ли патч фактическую неисправность.
Claude предоставил список рисков, а Sol — короткую строку с описанием рисков. В задании не указывался конкретный тип данных для этого поля, поэтому данное расхождение не является нарушением условий контракта. Оценка задания Sol составляет 9,0/10 после исправления ранее необоснованного вычета в полбалла; вычет за неточность фактов остается в силе.
Задача кодирования
Кодирование и структурированный вывод: Claude Opus 5.5 оказался более точным
Обе модели вернули корректный JSON с запрашиваемыми ключами и одинаковым минимальным патчем. Модель Claude правильно пояснила, что исходный фильтр и так пропускает Нет элемент. Модель GPT-6 Sol ошибочно указала, что а Нет этот элемент привёл бы к ошибке. В подсказке не указывался конкретный тип для поля «риски».
| Мера | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Счет | 10.0 / 10 | 9.0 / 10 |
| Патч | Правильно и лаконично | Правильно и лаконично |
| Диагноз | Правильно выявляет оба дефекта | Преувеличивает сбой, связанный с отсутствием элемента |
| Запрашиваемый контракт в формате JSON | Действительный JSON; присутствуют все четыре ключа | Действительный JSON; присутствуют все четыре ключа |
Общий полный ввод данных
Верните строгой JSON, содержащий только ключи diagnosis, patch, tests, risks. Проведите диагностику и внесите минимальные исправления в эту функцию на Python, чтобы все три тестовых случая прошли успешно. Исправления должны сохранять сигнатуру функции.

def normalize_tags(tags):
    return ','.join(sorted(set(t.strip().lower() for t in tags if t)))

Примеры:
1) [' AI ', 'ai', 'Code'] -> 'ai,code'
2) None -> ''
3) ['  ', None, 'SEO'] -> 'seo'

Не выполняйте код и не включайте ограждения Markdown или прозу за пределами JSON.
Claude Opus 5,5 · полная мощность
{"diagnosis":"Два дефекта, выявленных при чтении кода (без выполнения). (a) Случай 2: когда tags равно None, генератор выполняет итерацию по None и генерирует исключение TypeError вместо того, чтобы вернуть ''. (b) Случай 3: фильтр 'if t' выполняется до удаления пробелов. Тег, состоящий только из пробелов, ' ' считается истинным выражением, поэтому он проходит фильтрацию и превращается в ''. Результатом является sorted(['', 'seo']), которое объединяется в ',seo' вместо 'seo'. Элемент None в случае 3 уже отбрасывается условием 'if t'. Случай 1 уже работает: ' AI ', 'ai' и 'Code' нормализуются в {'ai', 'code'}, давая 'ai,code'.","patch":"def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":["assert normalize_tags([' AI ', 'ai', 'Code']) == 'ai,code' # traced: {'ai','code'} -> 'ai,code'","assert normalize_tags(None) == '' # трассировка: (None or []) -> [] -> ''","assert normalize_tags([' ', None, 'SEO']) == 'seo' # трассировка: ' ' вызывает ошибку t.strip(), None вызывает ошибку t, 'SEO' -> 'seo'"],"риски":["Нестроковые элементы, такие как 123, вызовут AttributeError при вызове .strip(). Это поведение не изменилось по сравнению с исходным.","'tags или []' рассматривает любой ложный входной параметр (например, '' или пустую кортежу) как пустой. Это соответствует требуемому поведению None -> ''.","Если вместо итерабеля тегов передается одна строка, она проходит итерацию символ за символом. Это не изменилось по сравнению с исходным поведением.","Внутренние пробелы не объединяются, поэтому 'machine learning' и 'machine learning' остаются отдельными тегами.","Тесты были получены только путём ручной трассировки и не выполнялись, как и было указано."]}GPT-6 Sol · полный вывод
{"diagnosis":"Функция генерирует ошибку, если параметр `tags` равен `None` или содержит значение `None`, а также сохраняет записи, которые становятся пустыми после удаления разделителей.","patch":"def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":[{"input":[" AI ","ai","Code"],"expected":"ai,code"},{"input":null,"expected":""},{"input":[" ",null,"SEO"],"expected":"seo"}],"risks":"Не выполняется. Элементы, отличные от None, считаются строками."}Метаданные: Claude — HTTP 200 · 10,832 с · finish_reason=stop · prompt_tokens=244 · completion_tokens=965
GPT — HTTP 200 · 7,71 с · finish_reason=stop · prompt_tokens=146 · completion_tokens=305
Окончательный вердикт
Практичный выбор
Какая модель подходит для вашей работы?
GPT-6 Sol возглавляет этот небольшой набор первых результатов, поскольку он завершил обработку исправленного контракта в расширенном формате, в то время как Claude Opus 5.5 достиг общего ограничения на вывод в 2 400 токенов. Claude Opus 5.5 лидирует по диагностической точности в задаче «код/JSON». По синтезу исходного кода наблюдается ничья.
Выбрать GPT-6 Sol когда первоочередной задачей является за один раз подготовить объемный документ по принятию решения, учитывающий множество ограничений. Выберите Claude Opus 5,5 когда при проверке кода или структурированного вывода целесообразно провести более четкую диагностику и анализ рисков. Если ваша работа сочетает в себе оба подхода, направляйте каждую задачу к той модели, которая лучше всего ей подходит, вместо того чтобы навязывать один универсальный вариант.
GlobalGPT предоставляет удобный способ объединить как модели, так и остальные этапы вашего рабочего процесса с ИИ в одной панели управления. Исследования, написание текстов, программирование, работа с изображениями и видео, а также производственные задачи с использованием командной строки могут выполняться в одной рабочей среде.
Часто задаваемые вопросы
Какая модель победила в сравнении?
GPT-6 Sol возглавил небольшую группу с первыми результатами со счётом 28,5 против 26,5 после исключения исходной задачи по определению границ и исправления вывода по JSON-контракту. Это преимущество было обеспечено за счёт выполнения переработанного контракта в развернутой форме в рамках того же ограничения на вывод в 2 400 токенов; Claude Opus 5.5 лидировал в задаче по написанию кода и структурированному выводу, а в задаче по синтезу исходного кода произошла ничья.
Почему был исключен первый тест в полном варианте?
В исходном задании не указывалось ни одна из моделей. Обе модели правильно отказались угадывать отсутствующие идентификаторы, поэтому данный ответ позволяет проверить, запрашивает ли модель недостающий контекст, а не делает вид, что знает ответ.
Модель Claude Opus 5.5 лучше подходит для кодирования?
В данном задании, посвящённом кодированию и формату JSON, метод Claude Opus 5.5 позволил поставить более точный диагноз и составить структурированный перечень рисков. Одного задания недостаточно для составления универсального рейтинга методов кодирования.
GPT-6 Sol лучше подходит для написания текстов?
GPT-6 Sol завершил подготовку переработанного подробного меморандума в пределах заданного диапазона уже в первом выводе. Полученный результат подтверждает целесообразность данной рекомендации по организации рабочего процесса именно для данного теста, а не является общим утверждением, применимым ко всем задачам по написанию текстов.
Могу ли я протестировать обе модели, не переключаясь между платформами?
GlobalGPT представляет собой подписку на ИИ с поддержкой нескольких моделей, объединяющую различные функции искусственного интеллекта в одной панели управления. Она удобна для использования одного и того же набора подсказок для исследования, написания текстов и программирования на разных моделях, а также для организации рабочего процесса в одном месте.
GlobalGPT позволяет хранить как модели, так и остальные элементы вашего рабочего процесса с ИИ в одном месте. Начните с модели, подходящей для текущей задачи, а затем продвигайте работу через этапы исследования, написания текста, программирования, работы с изображениями, видео или производственные этапы с подключением через командную строку, не открывая отдельный сервис для каждого этапа.









