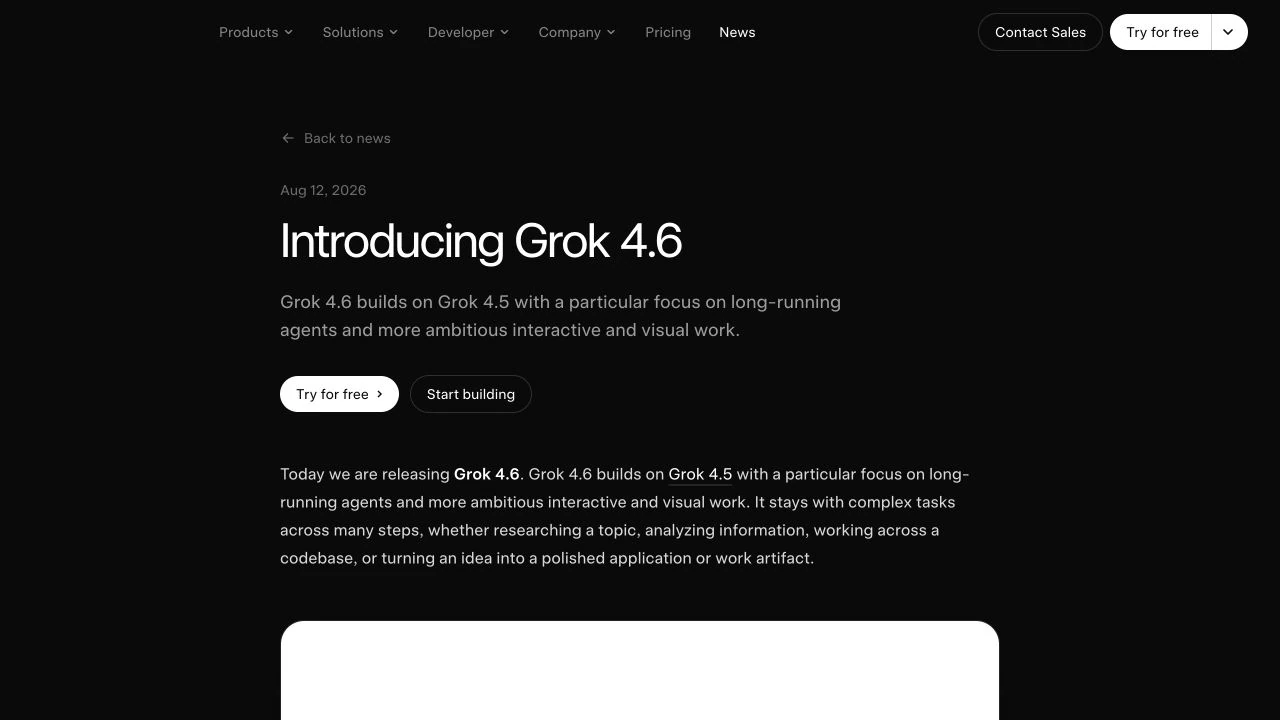
Sim — o Grok 4.6 é um modelo oficial da xAI, lançado em 12 de agosto de 2026, e merece atenção especial se o seu trabalho envolve longas séries de pesquisas, programação, análises em várias etapas ou tarefas baseadas em imagens. Sua janela de contexto de 500 mil tokens e seu raciocínio configurável lhe conferem capacidade para projetos exigentes, embora não seja automaticamente a opção mais rápida ou a melhor para todas as solicitações. A verdadeira questão já não é mais se o Grok 4.6 existe, mas se seus pontos fortes correspondem ao trabalho que você realmente precisa realizar.
Se você quiser responder a essa pergunta sem vincular todo o seu fluxo de trabalho a um único provedor, O GlobalGPT é um excelente ponto de partida. Sua área de trabalho no navegador permite que você use o Grok 4.6 junto com outros modelos líderes, execute a mesma tarefa de pesquisa, redação, análise ou programação e compare os resultados em um único lugar. É uma maneira prática e agradavelmente simples de ver onde o Grok 4.6 realmente se destaca — e onde outro modelo se adapta melhor à sua tarefa — antes de escolher a configuração ou a assinatura mais adequada para você.
O que é exatamente o Grok 4.6?
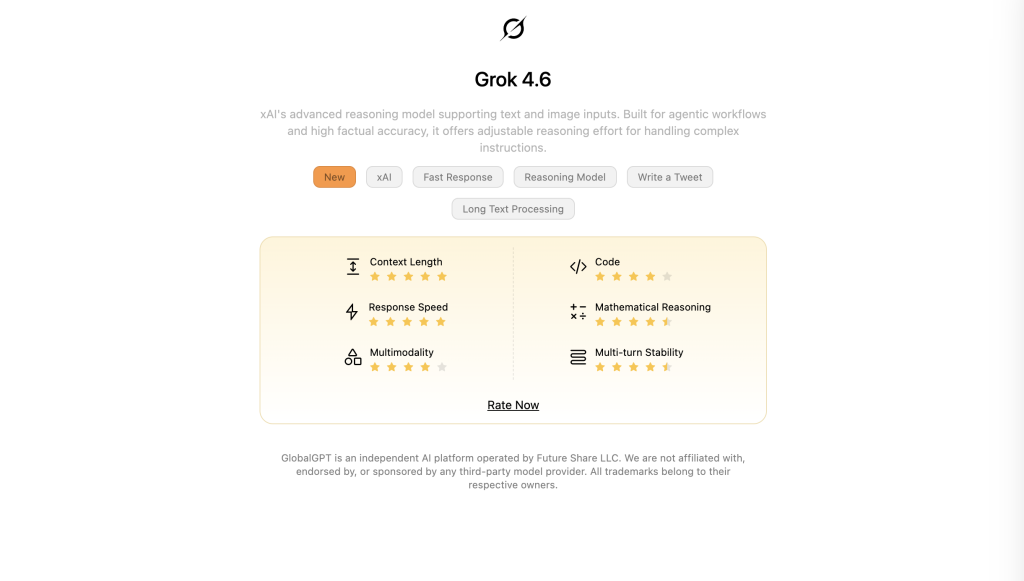
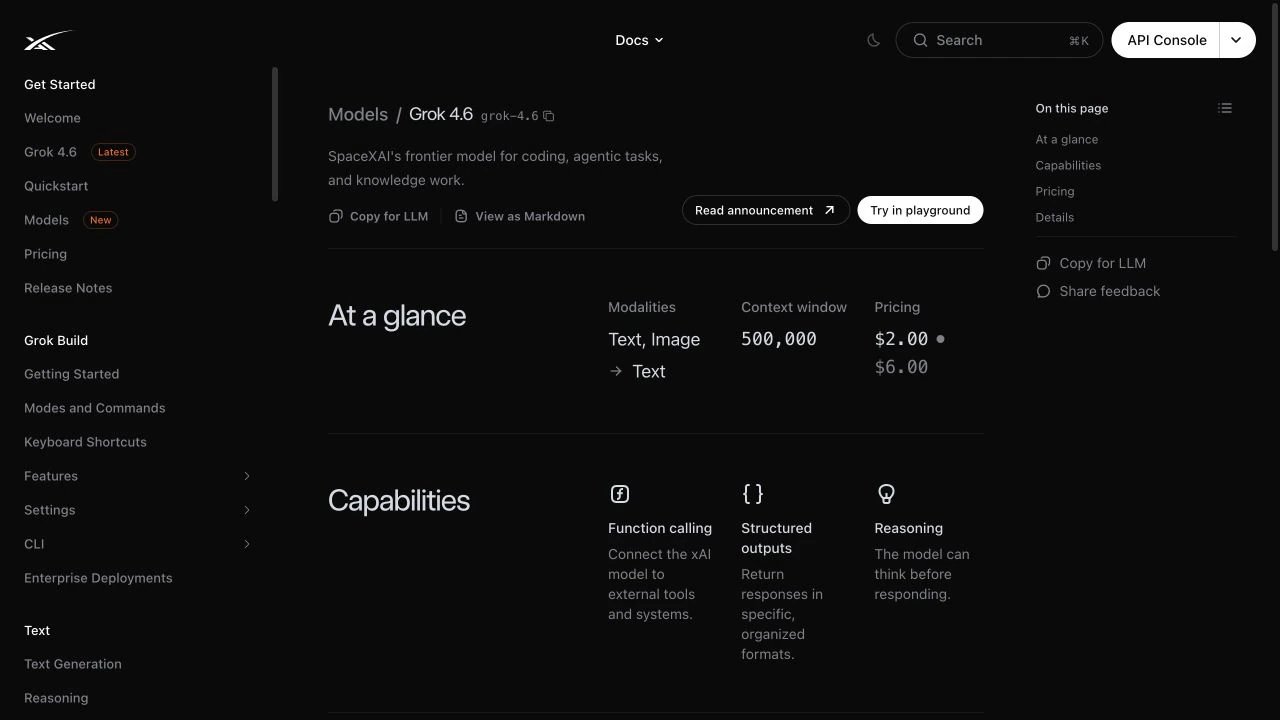
O Grok 4.6 é o modelo principal da xAI para 2026 na linha Grok. A página oficial do modelo descreve a entrada de texto e imagens, a saída de texto, o raciocínio configurável e uma janela de contexto de 500 mil tokens. O identificador da API é grok-4.6; esse é o valor que os desenvolvedores devem usar em uma solicitação.
A descrição oficial da xAI é bem específica: a versão Grok 4.6 se concentra em agentes de longa duração e trabalhos interativos e visuais mais ambiciosos. A documentação oficial o posiciona para programação, tarefas autônomas e trabalho intelectual, com chamadas de função e saídas estruturadas para fluxos de trabalho que exigem ferramentas ou formatos de resposta previsíveis.
O cartão do modelo indica um prazo limite de janeiro de 2026 para o pré-treinamento. Essa distinção é importante. Uma janela de contexto de 500 mil permite fornecer um pacote de dados de origem muito grande, mas isso não transforma automaticamente o modelo em um mecanismo de busca ativo. Para preços atuais, notícias ou mudanças nas políticas de produtos, consulte fontes confiáveis e verifique a resposta.
Quais são as especificações oficiais do Grok 4.6?
| Especificação | Valor oficialmente registrado | Por que é importante |
|---|---|---|
| Data de lançamento | 12 de agosto de 2026 | Confirma que este é um lançamento oficial da xAI. |
| ID do modelo da API | grok-4.6 | Use exatamente esse slug nas solicitações de API. |
| Janela de contexto | 500 mil tokens | Útil para relatórios extensos, bases de código e pesquisas com grande volume de código-fonte. |
| Entrada / saída | Entrada de texto e imagem; saída de texto | Suporta prompts multimodais, mas não a geração de imagens. |
| Raciocínio | Configurável | Permite que um fluxo de trabalho opte pela velocidade em detrimento de uma análise mais aprofundada. |
| Chamada de função | Suportado | Conecta o modelo a ferramentas e sistemas externos. |
| Resultados estruturados | Suportado | Útil para JSON, extração e pipelines previsíveis. |
| Limite para o pré-treinamento | Janeiro de 2026 | Não considere que o modelo básico está automaticamente atualizado. |
Fonte: comunicado da xAI, documentação do modelo e Ficha Técnica do Modelo Grok 4.6. As especificações oficiais não correspondem aos resultados de desempenho obtidos por fontes independentes.
O que o Grok 4.6 pode fazer?
Raciocínio e análise estruturada
O raciocínio configurável torna o Grok 4.6 adequado para tarefas que se beneficiam de uma resposta deliberada: comparar evidências, elaborar tabelas de decisão, planejar uma implementação ou verificar um cálculo sujeito a restrições. Um raciocínio mais aprofundado não é automaticamente melhor para todas as solicitações; portanto, a extração e a reescrita de rotina devem utilizar uma configuração adequada.
Trabalho que envolve muita pesquisa e uso de fontes
A janela de contexto de 500 mil permite que o modelo processe relatórios extensos, transcrições, documentos normativos e pacotes de fontes. O fluxo de trabalho mais eficaz é a recuperação com localizadores explícitos e regras de citação, seguida pela abertura da fonte original para verificação.
Codificação e depuração
Avaliações publicadas sobre engenharia de software e nosso pequeno teste de depuração comprovam sua utilidade para revisão de código, correção de bugs e tarefas estruturadas de agentes. Os desenvolvedores devem, no entanto, continuar executando testes localmente e revisando patches antes da implantação.
Compreensão da imagem
O xAI processa entradas de texto e imagens, gerando saídas de texto. Isso permite a interpretação de capturas de tela, a análise de imagens de documentos e a resposta a perguntas visuais, mas não deve ser confundido com a geração de imagens.
Agentes de execução prolongada e uso de ferramentas
Essa é a capacidade mais intimamente ligada ao posicionamento de lançamento da xAI. A chamada de funções permite que o Grok 4.6 se conecte a ferramentas externas, enquanto as saídas estruturadas facilitam o envio do resultado para outra etapa. Essa combinação é adequada para agentes que coletam contexto, trabalham com uma base de código, chamam uma ferramenta, verificam um resultado e retornam um artefato finalizado. O modelo ainda precisa de um ambiente de execução externo, permissões e verificações de objetivos; “agentic” não significa que o modelo base atue de forma independente.
Trabalho interativo e visual
O xAI também destaca trabalhos interativos e visuais mais ambiciosos. Um teste adequado é um briefing de produto repleto de capturas de tela ou um relatório baseado em gráficos, em que o modelo deve relacionar as evidências visuais a uma recomendação por escrito. Verifique os rótulos, eixos, unidades e detalhes omitidos antes de considerar o resultado como definitivo.
O que mudou no Grok 4.6 em comparação com os modelos anteriores do Grok?
O posicionamento da xAI destaca um raciocínio mais robusto, o trabalho com agentes de programação e o desempenho em contextos extensos. A atualização prática não se resume a um único recurso chamativo; trata-se da combinação de uma área de trabalho mais ampla, raciocínio ajustável e um modelo otimizado para tarefas complexas de várias etapas.
Isso ainda precisa passar por um teste de fluxo de trabalho. Um modelo pode ter um bom desempenho em um teste de benchmark e, mesmo assim, não se adequar ao seu estilo de redação, aos requisitos de citação ou à sua base de código. O Grok 4.6 deve ser avaliado com base nas tarefas que você repete todas as semanas, e não apenas por um único número no ranking.
Como o Grok 4.6 se sai em testes de desempenho reconhecidos?
A tabela abaixo distingue os resultados do “model card” da própria xAI das medições independentes. Isso é essencial porque os dois valores do Terminal-Bench correspondem a versões diferentes e não devem ser apresentados como uma comparação direta entre eles.
| Avaliador | Tarefa / métrica | Resultado divulgado | Classe de evidência e limitação |
|---|---|---|---|
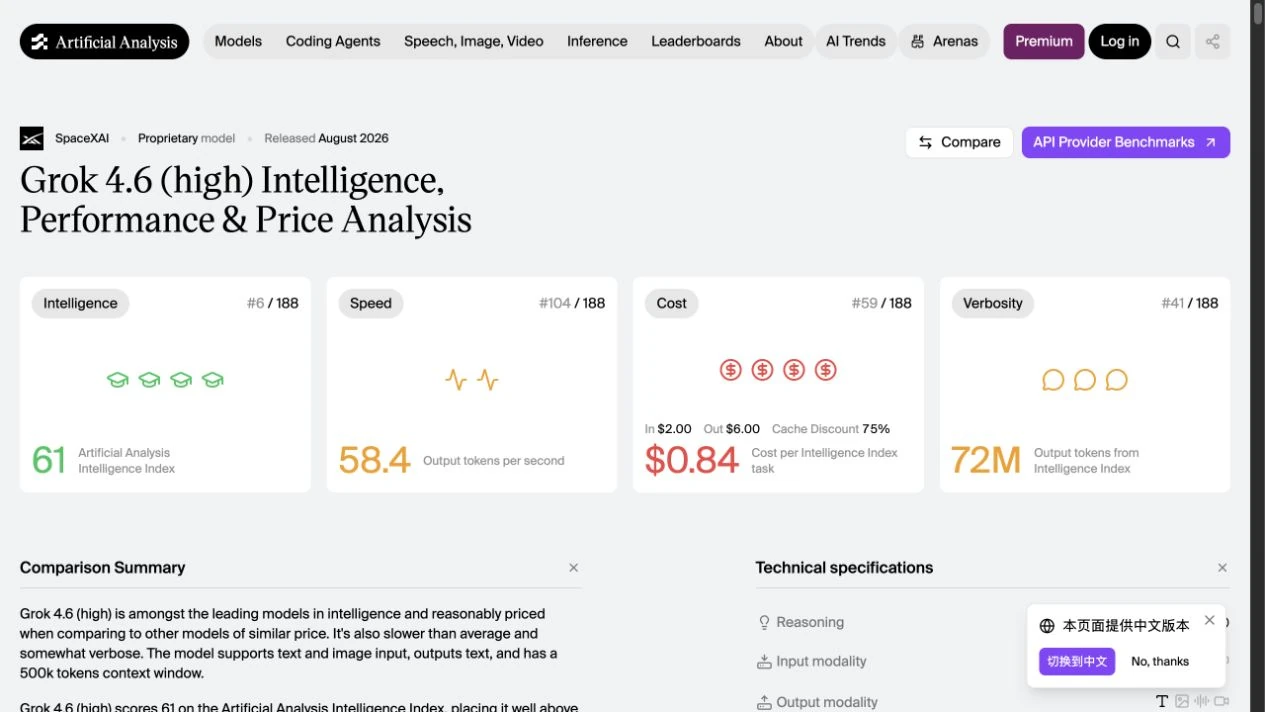
| Análise Artificial | Índice de Inteligência | 61 (#6 / 188 no momento da captura) | Compilado independente; utilize a metodologia e a data da AA. |
| Análise Artificial | Velocidade de saída | 58,4 tokens por segundo | Medida independente da velocidade; o trajeto e o hardware afetam a latência. |
| Análise Artificial | Custo por tarefa de inteligência | $0.84 | Uma estimativa da AA com base em seu próprio conjunto de tarefas; não se trata de uma fatura da xAI. |
| Análise Artificial | GDPval-AA v2 | 1753 | Avaliação independente dos resultados do trabalho. |
| Análise Artificial | AA-Pasta | 1577 | Avaliação independente do estilo de trabalho baseado no conhecimento. |
| Análise Artificial | Terminal-Bench v2.1 | 88.4% | Resultado do Independent v2.1; não é comparável ao Terminal-Bench 3.0. |
| Ficha do modelo xAI | Terminal-Bench 3.0 | 26% | Resultado oficial do cartão do modelo em uma versão diferente. |
| Mercor APEX-SWE | Engenharia de software | 56,41 TP40T ± 6,21 TP40T | 200 tarefas; o intervalo de incerteza deve ser mantido. |
| Agentes Mercor APEX | Tarefas do agente | 57,51 TP40T ± 3,51 TP40T | 33 mundos / 480 tarefas; uma avaliação específica do agente. |
| Ficha do modelo xAI | DeepSearchQA | 81.6% | Condição de garantia de qualidade da pesquisa informada pelo fornecedor. |
| Ficha do modelo xAI | Taxa de alucinações factuais | 1.7% | Condição de teste do cartão-modelo; não se trata de uma taxa de erro universal. |
Fontes: Artificial Analysis, tabelas de classificação do Mercor APEX e xAI Model Card. Não some pontuações de diferentes conjuntos de dados, versões, configurações de esforço ou avaliadores.
O Grok 4.6 é melhor do que o Grok 4.5?
A ficha técnica oficial apresenta uma resposta ambígua, em vez de um simples “sim”. O Grok 4.6 apresenta um resultado no DeepSearchQA significativamente mais alto, enquanto a mesma ficha técnica indica uma taxa de alucinações factuais mais elevada do que a do Grok 4.5. Uma análise séria não deve transformar um único benchmark robusto em uma alegação de confiabilidade universal.
| Avaliação oficial | Grok 4,6 | Grok 4,5 | Como interpretar isso |
|---|---|---|---|
| DeepSearchQA | 81.6% | 38.4% | Foi registrado um grande ganho nessa avaliação voltada para a pesquisa. |
| Taxa de alucinações factuais | 1.7% | 0.98% | Quanto menor, melhor; Grok 4,5 é a melhor opção para essa condição relatada. |
Fonte: Ficha técnica do modelo xAI Grok 4.6. Essas avaliações respondem a diferentes questões e não determinam um vencedor universal.
Qual é o nível de velocidade, confiabilidade e desempenho do Grok 4.6 na prática?
As evidências publicadas sugerem um modelo de alta capacidade, mas o “desempenho” envolve vários aspectos: qualidade da resposta, latência, retenção de contexto, cumprimento de instruções e recuperação em caso de falha. Em nossa rota direta, o teste de prontidão retornou um código HTTP 200 e PRONTO. As primeiras respostas válidas para as outras tarefas foram retornadas com sucesso, enquanto uma solicitação de edição restrita causou uma falha na infraestrutura do lado do cliente.
A Análise Artificial oferece uma avaliação prática útil, que vai além da capacidade de geração de manchetes: a página capturada mostra um Índice de Inteligência de 61, velocidade de saída de 58,4 tokens por segundo e um custo estimado de $0,84 por tarefa de inteligência. Essa combinação aponta para um modelo capaz, mas não ultrarrápido — mais adequado para trabalhos significativos do que para respostas descartáveis de uma única linha.
Esse resultado misto é útil. O Grok 4.6 pode apresentar bom desempenho em trabalhos estruturados, mas os usuários de produção devem manter regras de repetição de tentativa, limites de tempo e um modelo alternativo, em vez de presumir que todas as rotas se comportarão da mesma forma.
Em que contexto o Grok 4.6 parece ser mais útil?
Trabalhos de programação e desenvolvimento de produtos de longa duração
O exemplo de lançamento da xAI abrange a pesquisa de um tópico, a análise de informações, o trabalho em uma base de código e a transformação de uma ideia em um aplicativo ou artefato bem elaborado. Isso faz com que um trabalho do porte de um recurso seja uma avaliação mais adequada do que um prompt simples com apenas uma função. Forneça ao modelo um objetivo delimitado, arquivos relevantes, testes e uma definição de conclusão.
Síntese de pesquisas e trabalho de conhecimento
A janela de 500 mil, as saídas estruturadas e os excelentes resultados do DeepSearchQA tornam o Grok 4.6 um candidato natural para transformar um pacote de fontes em um resumo, identificar divergências ou extrair uma tabela de decisão. O teste de verificação de fontes corrobora esse uso quando as regras de citação são explícitas.
Relatórios extensos e análise de múltiplos documentos
Utilize a janela de contexto para relatórios anuais, históricos escolares, pacotes de políticas e históricos de projetos que, de outra forma, exigiriam uma divisão em partes extensas. Solicite indicadores de página ou seção e, em seguida, verifique os números de maior impacto nos documentos originais.
Análise baseada em imagens
A inserção de texto e imagens é útil para capturas de tela, gráficos e diagramas. Isso se torna valioso quando o elemento visual faz parte de uma tarefa de raciocínio mais ampla, como a análise de um painel de controle em conjunto com o contexto empresarial descrito por escrito.
Fluxos de trabalho orientados a agentes com metas bem definidas
A chamada de funções e as saídas estruturadas oferecem suporte a fluxos de trabalho como investigar um problema, acionar uma ferramenta, atualizar um plano e retornar um resultado legível por máquina. O ponto de partida mais seguro é uma tarefa com permissões limitadas, uma condição clara de encerramento e um verificador de objetivos.
| Fluxo de trabalho | Por que o Grok 4.6 é adequado | Melhor tarefa inicial |
|---|---|---|
| Codificação | Posicionamento da xAI, além das evidências do APEX-SWE e do CursorBench | Uma alteração que se enquadra como um bug ou um recurso, acompanhada de testes |
| Pesquisa | Contexto de 500 mil, saída estruturada e DeepSearchQA | Um resumo baseado em fontes com indicadores de página |
| Documentos longos | Janela grande de contexto oficial | Um relatório anual ou um pacote de documentos sobre políticas |
| Análise visual | Entrada de imagem e posicionamento visual do trabalho com xAI | Um relatório repleto de gráficos, acompanhado de texto explicativo |
| Agentes | Chamadas de função e saídas estruturadas | Uma investigação limitada com um verificador claro |
O Grok 4.6 é capaz de realizar pesquisas e verificações de fatos?
O teste de pacote de origem solicitou que o Grok 4.6 classificasse seis afirmações, citasse apenas URLs aprovados e rejeitasse duas inferências tentadoras.
(1) confirmado — O anúncio da xAI é datado de 12 de agosto de 2026 e informa que o lançamento do Grok 4.6 ocorrerá nesse dia.
(2) confirmado — A documentação oficial do modelo da xAI indica o ID do modelo como grok-4.6.
(3) confirmado — A documentação oficial indica uma janela de contexto de 500 mil.
(5) contradito — Essas são versões diferentes do Terminal-Bench e não se trata da mesma métrica.
(6) contradito — A página mostra apenas uma entrada no espaço de trabalho, não a inclusão em todos os planos.
Mostrar saída completa do Grok 4,6
| Afirmação | Veredicto | Resposta em uma frase | URL(s) da(s) fonte(s) | Limitação exata |
|---|---|---|---|---|
| (1) A xAI anunciou o Grok 4.6 em 12 de agosto de 2026 | confirmado | O anúncio da xAI é datado de 12 de agosto de 2026 e informa que o Grok 4.6 será lançado nesse dia. | https://x.ai/news/grok-4-6 | O pacote cita apenas a data e a linha de lançamento, não a postagem completa. |
| (2) o ID oficial do modelo da API é grok-4.6 | comprovado | A documentação oficial do modelo da xAI lista o ID do modelo como grok-4.6. | https://docs.x.ai/developers/models/grok-4.6 | O resumo da Packet não lista aliases nem outros IDs. |
| (3) a janela de contexto oficial é de 500 mil tokens | compatível | A documentação oficial indica uma janela de contexto de 500 mil tokens. | https://docs.x.ai/developers/models/grok-4.6 | O pacote menciona “500 mil contexto”, sem citar explicitamente “tokens”. |
| (4) A Artificial Analysis mediu independentemente um Índice de Inteligência de 61 | compatível | A AA publica um Índice de Inteligência de 61 para o Grok 4.6. | https://artificialanalysis.ai/models/grok-4-6 | O Packet relata a pontuação da AA, não uma auditoria separada do método da AA. |
| (5) O Terminal-Bench 3.0 26% e o v2.1 88,4% são diretamente comparáveis | contradito | Essas são versões diferentes do Terminal-Bench e não utilizam a mesma métrica. | https://artificialanalysis.ai/models/grok-4-6 ; https://media.x.ai/v1/website/card-4p6-4cd2dc57.pdf | O Packet apresenta ambas as pontuações, sem indicar equivalência ou correspondência. |
| (6) uma página GlobalGPT Grok 4,6 comprova que todos os planos incluem o modelo | contradito | A página mostra apenas uma entrada no espaço de trabalho, não a inclusão em todos os planos. | https://www.glbgpt.com/home/grok-4-6 | O próprio Pacote afirma que se trata de uma entrada de interface, e não de todos os planos. |
Conclusão da avaliação: Ele respeitou bem os limites das evidências quando o pacote de origem e o formato da resposta eram explícitos. Isso é útil para fluxos de trabalho de pesquisa, mas a resposta do modelo continua sendo um auxílio à pesquisa — e não a própria evidência externa.
Mostrar o enunciado exato da prova
Utilize apenas o pacote de fontes anexado. Para cada uma das seis reivindicações, responda com “comprovada”, “contradita” ou “não comprovada”, uma resposta de uma frase, os URLs das fontes e a limitação exata.
O Grok 4.6 é bom para programação e depuração?
A tarefa em JavaScript exigia um diff mínimo, classificação numérica, tratamento correto da mediana para números ímpares e pares, imutabilidade e duas condições exatas de erro.
```diff
--- a/median.js
+++ b/median.js
@@ -1 +1,12 @@
-function median(values) { values.sort(); return values[Math.floor(values.length / 2)]; }
+function median(values) {
+  if (!Array.isArray(values)) throw new TypeError();
+  if (values.length === 0) throw new Error("empty input");
+  const sorted = values.slice().sort((a, b) => a - b);
+  const mid = Math.floor(sorted.length / 2);
+  if (sorted.length % 2 === 0) {
+    return (sorted[mid - 1] + sorted[mid]) / 2;
+  }
+  return sorted[mid];
+}Mostrar a explicação retornada pela função Grok 4.6
A função original alterava seu argumento e utilizava a função de ordenação lexicográfica padrão (sort()), portanto, é feita uma cópia com slice() e ordenada numericamente por meio de (a, b) => a - b. Após rejeitar os elementos que não são matrizes com TypeError e as matrizes vazias com Error("entrada vazia"), um resultado de comprimento ímpar corresponde ao único elemento do meio, e um resultado de comprimento par corresponde à média dos dois valores centrais, que é a mediana convencional.Melhor uso: depuração em projetos de pequeno a médio porte, criação de testes, revisão de código e explicação de uma função desconhecida. No caso de um repositório grande, combine o modelo com seu próprio executor de testes e analise o diff antes de fazer a fusão.
Mostrar o escopo do teste
Corrija a mediana (valores) sem alterar sua assinatura. Não altere a entrada; gere um TypeError para valores que não sejam matrizes e um Error("entrada vazia") para matrizes vazias; retorne um diff unificado mínimo.A janela de contexto de 500 mil ajuda na leitura de documentos longos?
Um sistema de recuperação de mais de 220 mil tokens solicitou sete campos, localizadores de seção/página e uma explicação sobre as duas versões do Terminal-Bench.
{
  "release_date": {"value": "12 de agosto de 2026", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "locator": "p.2"},
  "janela_de_contexto": {"valor": "500 mil tokens", "localizador": "p.2"},
  "long_context_input_price": {"value": "$4 por milhão de tokens (prompts com mais de 200 mil tokens)", "locator": "p.3"},
  "terminal_bench_version": ["3.0", "v2.1"],
  "terminal_bench_score": ["26%", "88,4%"]
}Mostrar a saída JSON completa do Grok 4.6
{
  "release_date": {"value": "12 de agosto de 2026", "section": "lançamento do xAI", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "section": "Modelo de API", "locator": "p.2"},
  "janela_de_contexto": {"valor": "500 mil tokens", "seção": "Modelo de API", "localizador": "p.2"},
  "long_context_input_price": {"value": "$4 por milhão de tokens (prompts com mais de 200 mil tokens)", "section": "preços", "locator": "p.3"},
  "terminal_bench_version": [{"value": "3.0", "section": "cartão de benchmark", "locator": "p.4"},{"value": "v2.1", "section": "benchmark independente", "locator": "p.5"}],
  "terminal_bench_score": [{"value": "26%", "section": "cartão de benchmark", "locator": "p.4"},{"value": "88,4%", "section": "benchmark independente", "locator": "p.5"}],
  "evidence_limits": {"value": "Os dois resultados do Terminal-Bench não podem ser comparados, pois correspondem a versões diferentes do benchmark. A disponibilidade em tempo real não é informada.", "section": "benchmark independente", "locator": "p.5"}
}
O que isso comprova: o modelo é capaz de extrair e estruturar informações de um pacote grande e com ruído, seguindo um esquema rigoroso. O que isso não prova: que toda solicitação de 500 mil tokens será igualmente rápida, econômica ou precisa em relação a um documento arbitrário do cliente.
O Grok 4.6 é capaz de seguir instruções rigorosas e raciocinar de forma transparente?
Para um problema de alocação com restrições, o programa retornou a solução única: 7 horas de pesquisa, 9 horas de programação e 8 horas de controle de qualidade.
{"R":7,"C":9,"Q":8,"total":24,"verificação":"Os valores satisfazem a equação R + C + Q = 24, sendo C = R + 2 e Q = R + 1."}Mostrar o prompt exato
Distribua 24 horas entre Pesquisa (R), Programação (C) e Controle de Qualidade (Q). Retorne apenas JSON com chaves inteiras R, C, Q, total e uma verificação em uma única frase. Restrições: R + C + Q = 24; C = R + 2; Q = R + 1. Não forneça o raciocínio oculto.
A tarefa separada de reescrita restrita não retornou uma resposta da API em duas tentativas do cliente. Isso foi registrado como uma anomalia de infraestrutura, e não como um indicador de qualidade. A lição prática é manter um plano alternativo para a produção editorial.
Quanto custa o Grok 4.6?
| Opção | Preço atual publicado | Ideal para | Limite importante |
|---|---|---|---|
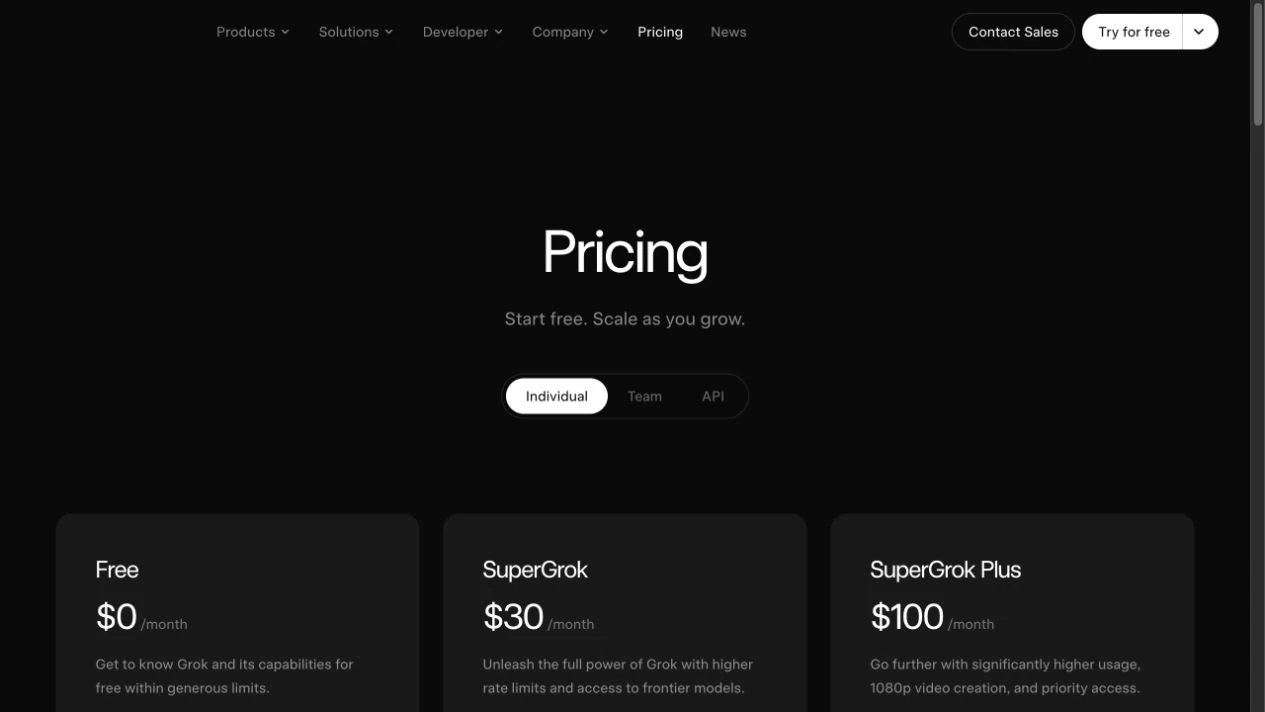
| xAI para consumidores – Grátis | $0/mês | Experimentando a experiência do consumidor nativa. | O acesso e os limites do modelo de plano gratuito podem sofrer alterações. |
| SuperGrok | $30/mês | Uso regular pelo consumidor; a página atual lista o Grok 4.6. | Verifique os direitos atuais antes de publicar. |
| SuperGrok Plus | $100/mês | Uso intenso por parte dos consumidores; a página atual lista Grok 4.6. | Não se deve inferir acesso para outros planos. |
| Nível básico da API xAI | Entrada $2/M; saída $6/M; entrada em cache $0,50/M | Desenvolvedores que criam integrações baseadas no uso. | As ferramentas são cobradas separadamente, quando aplicável. |
| Nível de contexto longo da API xAI | Acima de 200 mil: entrada $4/M; $1/M em cache; saída $12/M | Prompts e documentos muito grandes. | Não utilize o preço base para uma solicitação de mais de 200 mil. |
| GlobalGPT | Veja os planos atuais do GlobalGPT | Comparando o Grok com vários modelos líderes em uma única área de trabalho. | Não presuma que todos os planos incluem o Grok 4.6; verifique a página do plano. |
Quanto custaria uma solicitação de API Grok 4.6?
| Exemplo de solicitação | Cálculo | Custo estimado por token do modelo |
|---|---|---|
| 50K de entrada + 5K de saída | 50 mil × $2/M + 5 mil × $6/M | $0.13 |
| 100 mil de entrada + 10 mil de saída | 100 mil × $2/M + 10 mil × $6/M | $0.26 |
| 250 mil de entrada + 10 mil de saída | 250 mil × $4/M + 10 mil × $12/M | $1.12 |
| 400 mil de entrada + 20 mil de saída | 400 mil × $4/M + 20 mil × $12/M | $1.84 |
Exemplos aritméticos utilizando os preços de tabela da xAI. Eles não incluem descontos por entradas armazenadas em cache, impostos, taxas de utilização de ferramentas e margens de lucro de fornecedores terceirizados.
O GlobalGPT é uma ótima opção quando sua dúvida é “qual modelo funciona melhor para essa tarefa?”, em vez de “como faço para atribuir todas as tarefas a uma única API?”. Você pode comparar instruções relacionadas à redação, pesquisa, programação e análise em um único espaço de trabalho e, em seguida, usar o Página de preços do GlobalGPT para selecionar a assinatura que melhor se adapta ao seu uso. Trata-se de uma recomendação de assinatura com vários modelos, e não de uma conversão dos créditos GlobalGPT em preços de tokens xAI.
Como é possível acessar o Grok 4.6?
Os consumidores podem começar com as opções atuais de assinatura Grok da xAI. Os desenvolvedores devem consultar a documentação oficial da API da xAI e o ID exato do modelo grok-4.6. Os leitores que desejarem comparar modelos sem precisar configurar várias contas de API podem usar a entrada verificada do espaço de trabalho Grok 4.6 em GlobalGPT; o acesso à interface do usuário da plataforma não deve ser confundido com todos os recursos nativos do xAI.
Quais são as principais limitações do Grok 4.6?
- As informações atuais ainda precisam ser comprovadas: O prazo limite para o pré-treinamento em janeiro de 2026 não é garantia de conhecimento prático.
- As manchetes sobre benchmarks podem induzir ao erro: A versão, o avaliador, o esforço de raciocínio e o conjunto de dados devem estar associados a cada pontuação.
- Um contexto mais extenso custa mais: As solicitações com mais de 200 mil tokens utilizam o nível mais alto da API de contexto longo.
- A confiabilidade das rotas varia: Nossa solicitação de edição restrita encontrou uma falha na infraestrutura, embora outras tarefas tenham sido concluídas com sucesso.
- O acesso à plataforma não é idêntico: Uma entrada no Workspace GlobalGPT não implica todos os recursos nativos do xAI nem todos os direitos de assinatura.
Você deve escolher o Grok 4.6 ou outro modelo de IA?
Escolha o Grok 4.6 quando o contexto extenso, a codificação e o raciocínio estruturado forem essenciais para o trabalho. Escolha um modelo diferente quando sua principal prioridade for um ecossistema específico de ferramentas, um custo previsível mais baixo, um resultado multimodal específico ou um fluxo de trabalho com o qual sua equipe já tenha boa familiaridade. A comparação mais justa é feita com o mesmo prompt, o mesmo pacote de dados de origem e o mesmo verificador em todos os modelos — algo que o GlobalGPT facilita organizar.
Quem deve usar o Grok 4.6?
- Pesquisadores e analistas: pacotes de origem, tabelas de provas e longos resumos.
- Desenvolvedores: depuração, revisão de código e planos de implementação estruturados.
- Autores e editores: elaboração de textos extensos, desde que você forneça um briefing claro e um guia de estilo.
- Equipes comparando modelos: avaliações repetíveis com o mesmo prompt em um único espaço de trabalho.
O que os leitores costumam perguntar sobre o Grok 4.6?
A versão Grok 4.6 já foi lançada oficialmente?
Sim. O anúncio do lançamento da xAI está datado de 12 de agosto de 2026.
Qual é o ID oficial do modelo da API?
grok-4.6.
O que é a janela de contexto?
O xAI registra uma janela de contexto de 500 mil tokens.
O Grok 4.6 aceita imagens?
Sim. A documentação oficial do modelo menciona entrada de imagem e saída de texto.
Quanto custa o Grok 4.6?
A página atual para consumidores exibe o plano “Free” a $0 por mês, o “SuperGrok” a $30 por mês e o “SuperGrok Plus” a $100 por mês. A tarifação da API é baseada no uso e possui um nível separado para contextos longos acima de 200 mil tokens.
O Grok 4.6 é melhor do que o Grok 4.5?
É mais recente e apresenta um ótimo desempenho em várias avaliações citadas, mas as tarefas e as versões dos benchmarks diferem. Teste seu próprio fluxo de trabalho recorrente.
Posso usar o Grok 4,6 no GlobalGPT?
O GlobalGPT possui uma entrada de espaço de trabalho Grok 4.6 já gerada. Confirme o direito ao plano atual na página de preços.
O Grok 4.6 é confiável para fins de pesquisa?
O programa apresentou bom desempenho no teste de pacotes de origem restritos, mas afirmações importantes devem sempre ser verificadas com base na fonte citada.
Vale a pena usar o Grok 4.6 em 2026?
O Grok 4.6 é um modelo confiável, lançado oficialmente, com uma janela de contexto útil de 500 mil, raciocínio configurável, evidências sólidas de benchmarks publicados e bons resultados iniciais em tarefas de pesquisa estruturada e de documentos longos. Seus pontos fracos são igualmente práticos: os números dos benchmarks exigem identificações cuidadosas das versões, os fatos em tempo real ainda precisam de fontes e a confiabilidade das rotas pode variar.
Para acesso direto ao consumidor ou desenvolvimento de API, comece consultando a documentação atual da xAI. Para um fluxo de trabalho baseado em comparação, tente Grok 4,6 em GlobalGPT juntamente com outros modelos de referência, escolha o plano que melhor se adapte à sua carga de trabalho de redação, pesquisa, análise ou programação.
Fontes primárias: Lançamento da xAI, Documentação do modelo xAI, Preços da API da xAI, Preços da xAI para o consumidor, Análise Artificial, Mercor APEX-SWE e o Ficha do modelo xAI.