Atualizado em 18 de setembro de 2026.
Nosso veredicto: O GPT-6 Astra forneceu respostas úteis em todas as três chamadas de teste: reconciliação de pedidos, uma função de agregação em Python e uma consulta a uma política com 500 itens. Ele lidou corretamente com valores ausentes e regras conflitantes, e a função gerada por ele passou em 10 verificações offline. Isso faz com que valha a pena considerá-lo para trabalhos analíticos minuciosos — mas três pequenos testes não são suficientes para comprovar a confiabilidade em produção nem a superioridade em relação a outros modelos.
Nós ligamos gpt-6-astra por meio do serviço de modelos baseado em CLI da GlobalGPT, utilizando entradas sintéticas e salvando as respostas brutas. Este não foi um teste direto da API OpenAI nem um teste de assinatura ChatGPT. As chamadas de ponta a ponta levaram de 4,87 a 9,07 segundos neste lote, e o saldo da conta diminuiu em 391,08 créditos.
Esta análise mostra o que solicitamos, o que a Astra apresentou, o que foi aprovado e até onde vão as evidências. As especificações oficiais e os preços são apresentados separadamente de nossas medições.

Índice
- Resultados práticos do GPT-6 Astra
- Como testamos o Astra por meio da API
- Teste 1: O Astra consegue reconciliar dados de pedidos desorganizados?
- Teste 2: O código gerado realmente funciona?
- Teste 3: É possível resolver regras conflitantes em um pacote longo?
- Quanto custam esses testes de rotas de API
- O GPT-6 Astra já está disponível?
- Especificações do GPT-6 Astra
- Preços da API do GPT-6 Astra
- O que há de novo, de fato, no GPT-6 Astra?
- Por que a Astra influencia a decisão de compra
- O que dizem os primeiros críticos
- Limitações iniciais e questões em aberto
- Quem deve usar o GPT-6 Astra?
- Escolha o Astra ou um modelo menor, dependendo da tarefa
- O que esta análise ainda não comprova
- Perguntas frequentes
Resultados práticos do GPT-6 Astra
| Teste | Resultado observado | Tempo de percurso | Tokens de entrada/saída | Créditos no livro-razão |
|---|---|---|---|---|
| Reconciliação de pedidos | 5/5 verificações de respostas aprovadas | 5,663 s | 2,171 / 144 | 67 |
| Função de agregação em Python | 10 de 10 casos offline foram aprovados | 9,065 s | 2,091 / 486 | 105 |
| Pacote de políticas de 500 notas | 6/6 respostas corretas; fontes exigidas presentes para todas as seis | 4,868 s | 17,445 / 160 | 219 |
Trata-se de três tarefas diferentes, cada uma com uma chamada ao modelo; não se trata de tentativas repetidas nem de uma taxa de sucesso medida de 100%. O tempo medido abrange toda a solicitação da CLI/provedor até o retorno do resultado; não medimos o tempo até o primeiro token. O livro-razão exibe créditos inteiros, enquanto a variação no saldo inclui frações.
Como testamos o Astra por meio da API
Utilizamos a mesma conta GlobalGPT já existente para todas as três chamadas. Cada uma delas foi uma solicitação nova e sem estado, com a tarefa fornecida como um arquivo de texto. O rótulo do modelo solicitado e retornado foi gpt-6-astra. O serviço retornou o texto da resposta, o uso de tokens de entrada/saída e um campo de erro; nenhum dos três resultados indicou um erro. A rotulagem do provedor não constitui uma auditoria independente da rota do modelo a montante.
Preparamos o gabarito das ordens e as respostas do pacote de políticas antes das chamadas. Em seguida, validamos o código gerado localmente com 10 casos criados após recebê-lo; esses casos não constituíam um benchmark de codificação pré-registrado. Solicitamos JSON no prompt e verificamos se ele era analisado, em vez de habilitar um esquema nativo de saída estruturada.
Todas as entradas foram inventadas. Nenhum registro de cliente, arquivo da empresa, segredo contábil ou dado pessoal foi enviado. Não fornecemos ferramentas de navegação ou de controle do computador para as tarefas, e não repetimos nenhuma resposta com o objetivo de melhorar sua pontuação. A CLI não expôs a configuração do esforço de raciocínio nem a composição dos tokens em cache para essas execuções.
Teste 1: O Astra consegue reconciliar dados de pedidos desorganizados?
A tarefa e o gabarito
O arquivo CSV de oito linhas incluía uma duplicata mais antiga, uma substituição mais recente, um pedido pendente, reembolsos e um pedido sem valor bruto. As regras eram: manter a versão mais recente de cada pedido, excluir pagamentos pendentes, subtrair os reembolsos e registrar a receita ausente como “desconhecida”.
A receita líquida prevista era de $275: Pesquisa $170, E-mail $75 e Rede social $30. A exigia deduplicação, C exigia exclusão e F precisava permanecer desconhecido. Um total correto, por si só, não era suficiente para ser aprovado em todas as cinco verificações.
O que a Astra devolveu
{"valor_líquido_conhecido_em_usd":275,"canal_valor_líquido_conhecido_em_usd":{"Pesquisa":170,"E-mail":75,"Social": 30},"unknown_order_ids":["F"],"excluded_order_ids":["C"],"replaced_order_ids":["A"]}
Todas as cinco verificações foram aprovadas. E, o que é mais relevante, a conclusão dizia: “A receita líquida total permanece desconhecida porque faltam os dados de receita bruta do pedido F.” Ele corretamente classificou o Search como o maior conhecido subtotal, sem alegar que o valor do pedido por e-mail que faltava era zero.
Nossa avaliação: Esse foi um bom resultado para uma tarefa de reconciliação de pequeno porte. O modelo seguiu as regras contábeis e preservou a incerteza. Não se tratou de um teste de conexão com uma planilha ativa, milhares de transações, conformidade tributária ou decisões financeiras autônomas.
Teste 2: O código gerado realmente funciona?
Substituir um cálculo de receita incorreto
Fornecemos o molde com defeito sum(float(r.get('gross_usd') or 0) for r in records) e solicitou uma função em Python puro que lidasse com atualizações duplicadas, status de pagamento, reembolsos, valores ausentes, listas de IDs ordenadas e entradas vazias. Ela precisava utilizar centavos como números inteiros internamente e deixar os registros de entrada inalterados.
O Astra retornou uma função que utiliza Decimal para converter valores em centavos, mantém o registro mais recente por pedido e ignora valores brutos desconhecidos, em vez de inserir zero. Decodificamos os caracteres de escape de nova linha na string de código retornada, revisamos suas importações e operações e a executamos localmente sem alterar sua lógica.
Dez verificações offline
| Caso | Resultado |
|---|---|
| Reconciliação original de oito linhas | Passe |
| Entrada vazia | Passe |
| O registro mais recente aparece antes do registro mais antigo | Passe |
| A última atualização alterou um pedido para “pendente” | Passe |
| Valores brutos em branco e nulos | Passe |
| Se não houver valor de reembolso, o valor padrão é zero | Passe |
| Cálculo aritmético de 0,10 + 0,20 cent | Passe |
| Reembolsos totais e parciais | Passe |
| Um canal cuja receita é totalmente desconhecida | Passe |
| IDs classificados como “desconhecidos” e “excluídos” | Passe |
A imutabilidade das entradas também se manteve em todos os 10 casos. Nossa avaliação: a função era utilizável para o contrato especificado, e a execução local forneceu evidências mais sólidas do que apenas um exemplo de código plausível. Não testamos carimbos de data e hora inválidos, moedas múltiplas, implantação, um repositório real, transações de banco de dados nem desempenho em escala.
Teste 3: É possível resolver regras conflitantes em um pacote longo?
Cinco anotações relevantes entre 500
Construímos um pacote de 73.252 caracteres com 500 notas numeradas. Os fatos relevantes estavam distribuídos pelas notas 037, 114, 261, 398 e 477: uma regra antiga de reembolso em 30 dias, uma regra padrão mais recente de 14 dias, uma exceção empresarial de 30 dias, uma mudança de proprietário, preços anuais versus equivalentes mensais e uma questão para a qual faltavam provas.
A solicitação completa foi registrada 17.445 tokens de entrada. Trata-se de uma verificação modesta de um documento extenso, bem abaixo da capacidade anunciada pelo Astra de 1,05 milhão de tokens. As notas de contexto eram simples elementos de distração, por isso foi mais fácil do que uma coleção desorganizada de documentos do mundo real.
Regras corretas, preços e incerteza
| Pergunta | A resposta da Astra | Documentação necessária |
|---|---|---|
| Período padrão para reembolso na região Norte | 14 dias | 114 |
| Período para solicitação de reembolso da North Enterprise | 30 dias | 477 |
| Atual proprietário do North | Lin | 114 |
| Pagamento anual do Atlas | $129.60 | 261 |
| Equivalente mensal do Atlas | $10.80 | 261 |
| Direito ao reembolso em dinheiro no Sul | nulo / desconhecido | 398 |
Todas as seis respostas estavam corretas e incluíam as notas de apoio exigidas. No caso da resposta padrão sobre reembolso, ela citou adicionalmente a nota de exceção empresarial, que constituía um contexto relevante. Ela retornou os identificadores das notas como strings; não havia sido exigido nenhum esquema de identificação numérica.
Nossa avaliação: O Astra resolveu a revisão e a exceção corretamente e não inventou o direito que faltava. Essa é uma evidência útil para a síntese de políticas delimitadas. Ela não valida pesquisas em andamento, documentos jurídicos arbitrários, a recuperação de dados específicos em um conjunto de quase um milhão de tokens nem a resistência a instruções maliciosas incorporadas nas fontes.
Quanto custam esses testes de rotas de API
As três corridas registradas 21.707 tokens de entrada e 790 tokens de saída. O livro contábil da GlobalGPT apresentava 67, 105 e 219 créditos; o saldo da conta passou de 15.477,71 para 15.086,63 créditos, uma redução de 391,08 créditos. Não convertemos esses créditos em uma cobrança fictícia em dinheiro.
Para uma ilustração orçamentária separada, ao aplicar as taxas padrão de contexto curto do OpenAI — $10 por milhão de tokens de entrada não armazenados em cache e $50 por milhão de tokens de saída — às contagens relatadas, obtém-se aproximadamente $0.2566: $0.0289 para pedidos, $0.0452 para código e $0.1825 para o pacote. Isso pressupõe que os dados de entrada não estejam em cache e que não haja cobranças adicionais. Não se trata da fatura referente às nossas chamadas GlobalGPT nem de um custo direto medido de OpenAI.
A execução do pacote foi mais rápida do que a do código neste lote, apesar de haver mais tokens de entrada. Uma única execução por tarefa não é suficiente para estabelecer uma classificação de latência: o comprimento da saída, o roteamento, o enfileiramento e as condições de processamento podem variar. Não realizamos uma comparação com concorrentes equivalentes.
O GPT-6 Astra já está disponível?
Sim. O Astra está listado no catálogo do GlobalGPT, e todas as três novas chamadas retornaram um resultado com a denominação “gpt-6-astra”. O OpenAI também publica documentação sobre os modelos da API; os acessos ao Chat, ao Work e ao Codex são direitos de uso de produtos distintos.
As capturas de tela de 4 de setembro abaixo referem-se ao período de lançamento. O texto sobre a disponibilização é histórico e não constitui prova de que a entrada GlobalGPT de hoje esteja indisponível.
Especificações do GPT-6 Astra
O Astra aceita entradas de texto e imagens e gera saídas de texto. Sua janela de contexto de 1,05 milhão de tokens atende à escala necessária para grandes repositórios, coleções de documentos ou longos históricos de agentes, enquanto o limite máximo de saída de 128 mil tokens oferece espaço para códigos ou relatórios extensos.
Capacidade não é sinônimo de qualidade. Uma janela de um milhão de tokens não garante que todos os detalhes sejam lembrados com a mesma precisão, e enviar a quantidade máxima de contexto pode aumentar tanto o custo quanto o ruído. Para trabalhos práticos com contexto extenso, recupere primeiro os arquivos mais relevantes e mantenha as instruções da tarefa explícitas.
Se você quiser ter uma ideia de como a geração anterior lidava com prompts grandes, consulte o Guia de preços e contexto do GPT-5.5. Para uma visão mais ampla e orientada a tarefas, o guia de casos de uso do GPT-5.5 ajuda a identificar cargas de trabalho que possam justificar a adoção de um modelo de ponta.
Preços da API do GPT-6 Astra
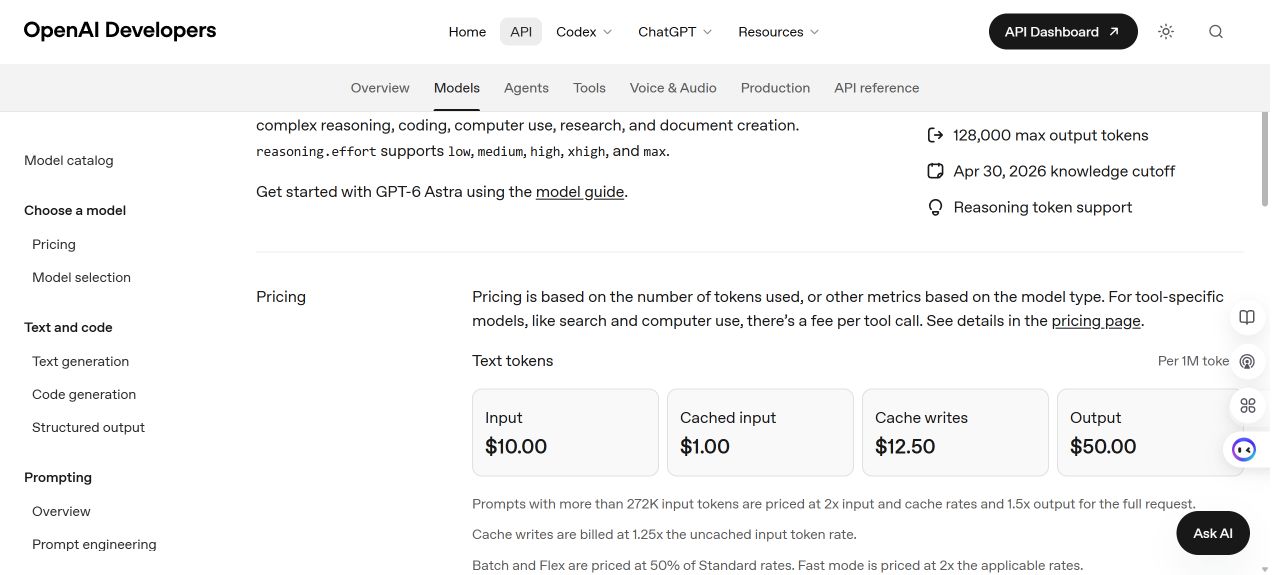
O documento OpenAI lista as seguintes taxas de processamento padrão para prompts com até 272.000 tokens de entrada:
Taxas verificadas novamente em 18 de setembro de 2026 em relação a Preços da API OpenAI. Essas são as tarifas padrão dos tokens da API, e não os preços da assinatura do ChatGPT nem as cobranças de crédito do GlobalGPT.
| Categoria do token | Preço por 1 milhão de tokens | O que isso significa |
|---|---|---|
| Entrada | $10.00 | Novo conteúdo de solicitação, histórico, material recuperado e outras contribuições faturáveis. |
| Entrada em cache | $1.00 | Entradas repetidas elegíveis são fornecidas por meio do armazenamento em cache de prompts. |
| Gravação no cache | $12.50 | Dados gravados no cache de acordo com a tarifa aplicável para gravação no cache. |
| Saída | $50.00 | Resposta gerada e justificativa faturável. |
Quando uma solicitação ultrapassa 272.000 tokens de entrada, o OpenAI aplica um Multiplicador de 2x para as taxas de entrada e de entrada em cache e um Multiplicador de 1,5x para as taxas de produção para a solicitação completa. De acordo com as taxas padrão indicadas, isso significa $20 por milhão de tokens de entrada e $75 por milhão de tokens de saída.
Limite de preço:
Essas são as tarifas do token da API OpenAI, e não os preços mensais da assinatura ChatGPT nem os créditos GlobalGPT. Custos de ferramentas, níveis de processamento, configurações regionais e outras taxas podem alterar o custo final.
Para conhecer o contexto histórico da tabela de preços, consulte Preços do GPT-5.6 e os preços do GPT-5.4. Compare a carga de trabalho completa, não apenas a taxa de entrada: o comprimento da saída, o comportamento do cache, o uso de ferramentas e as taxas de falha ou de repetição podem ser mais importantes do que o preço anunciado.
O que há de novo, de fato, no GPT-6 Astra?
OpenAI guia dos modelos mais recentes destaca um conjunto de recursos voltados para o trabalho interativo de agentes em execução prolongada.
Chamada assíncrona de ferramentas
O Astra consegue continuar avançando enquanto ferramentas mais lentas ainda estão em execução, em vez de tratar cada chamada de ferramenta como uma interrupção total. Isso pode ajudar em pesquisas, programação e tarefas operacionais que combinam vários sistemas externos com tempos de resposta diferentes.
Instruções durante a tarefa
Os usuários podem fornecer orientações enquanto uma tarefa está em andamento. Isso é útil quando um agente está, em geral, no caminho certo, mas precisa de uma nova restrição, uma mudança de prioridade ou um escopo mais restrito. Isso deve reduzir a necessidade de cancelar um processo de longa duração e recomeçar do zero.
Esforço de raciocínio dinâmico
O Astra pode ajustar o nível de raciocínio que aplica durante uma tarefa. Em princípio, isso permite que ele dedique mais esforço às etapas difíceis e menos às rotineiras. As equipes devem, no entanto, verificar se o ganho em qualidade compensa o custo adicional por token de saída para sua própria carga de trabalho.
Uso do computador e continuidade em tarefas longas
O OpenAI posiciona a Astra para a interação com computadores e para tarefas que se desenrolam ao longo de várias etapas. A questão prática não é se ela consegue navegar por uma demonstração clicando nos botões, mas se é capaz de se recuperar de situações inesperadas, preservar a intenção do usuário e explicar o que foi alterado. Essas são as áreas que os primeiros usuários devem avaliar.
Os leitores interessados na evolução do bate-papo deliberativo para sistemas que utilizam ferramentas também podem consultar GPT-5.4 Pensamento e este guia de uso do ChatGPT Agent.
Por que a Astra influencia a decisão de compra
A mudança importante é passar de avaliar uma IA com base na qualidade de uma única resposta para avaliar se ela é capaz de concluir uma tarefa inteira. Um agente útil pode precisar inspecionar arquivos, operar softwares, aguardar ferramentas, recuperar-se de erros, aplicar uma alteração, realizar verificações e explicar o resultado. A resposta final é apenas uma parte dessa sequência.
Isso também muda a questão do custo. As taxas do token da Astra são altas, mas o preço do token por si só não é suficiente para determinar se é econômico. Uma comparação mais adequada é custo por tarefa concluída com sucesso: os custos com modelos e ferramentas, novas tentativas, tempo decorrido, supervisão humana e limpeza — tudo isso conta. Um modelo mais barato pode acabar saindo mais caro no geral se precisar de correções repetidas; uma execução cara ainda é um desperdício se o modelo se desviar do caminho ou produzir resultados que precisem ser refeitos.
Métrica prática:
Acompanhe o custo total, a taxa de conclusão, os minutos de trabalho, as tentativas de repetição e os defeitos para a mesma tarefa representativa. Não compare modelos com base apenas nas taxas por token ou em uma única demonstração bem elaborada.
Maior autonomia também eleva o padrão dos controles. As orientações do modelo mais recente do OpenAI indicam que o Astra está sujeito ao monitoramento assíncrono de desalinhamento. As equipes devem continuar a conceder ao agente apenas as permissões mínimas necessárias, exigir confirmação antes de ações com consequências, manter um registro das ações e criar pontos de verificação que tornem as alterações reversíveis. O uso intensivo de computadores só é valioso quando o sistema circundante limita o que pode dar errado.
O que dizem os primeiros críticos
Experiência inicial atribuída
De Matt Shumer’s primeira avaliação do Astra é um dos relatos públicos mais detalhados disponíveis no momento do lançamento. Ele descreve o modelo como eficiente em engenharia de back-end, uso de computadores, compreensão de solicitações pouco específicas, apresentação clara de seu trabalho e manutenção da continuidade em conversas longas.
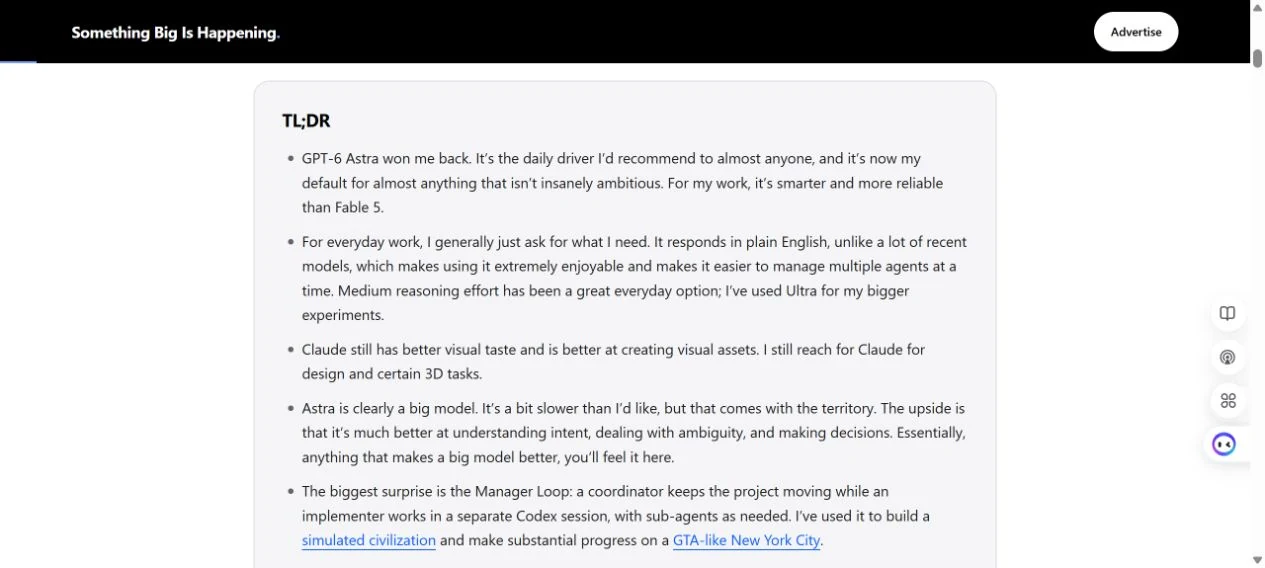
Engenharia de backend
A análise destaca um desempenho útil em trabalhos de implementação complexos, especialmente quando o modelo precisa compreender um sistema, em vez de produzir um pequeno trecho isolado.
Uso do computador
Segundo relatos, o Astra lida com tarefas típicas de navegadores e de computadores de mesa com maior consciência do objetivo geral, embora isso não elimine a necessidade de permissões e verificação.
Intenção ambígua
O modelo é descrito como mais eficaz na inferência do que um usuário está tentando fazer a partir de instruções incompletas.
Continuidade e prestação de contas
A análise reconhece que o Astra mantém o contexto ao longo de sessões prolongadas e oferece relatos mais claros sobre o que foi feito.
Essas são observações qualitativas feitas por outro avaliador. Elas ajudam a identificar recursos que vale a pena testar, mas não são nossas medições e não comprovam a confiabilidade geral.
Limitações iniciais e questões em aberto
A mesma análise também levanta questões importantes. O Astra pode ser lento, consumir grandes quantidades de tokens e ainda se perder nos detalhes durante longos períodos de trabalho autônomo. Shumer também relata que o resultado de seu design visual pode ficar aquém do Claude, mesmo quando seu desempenho no back-end é sólido.
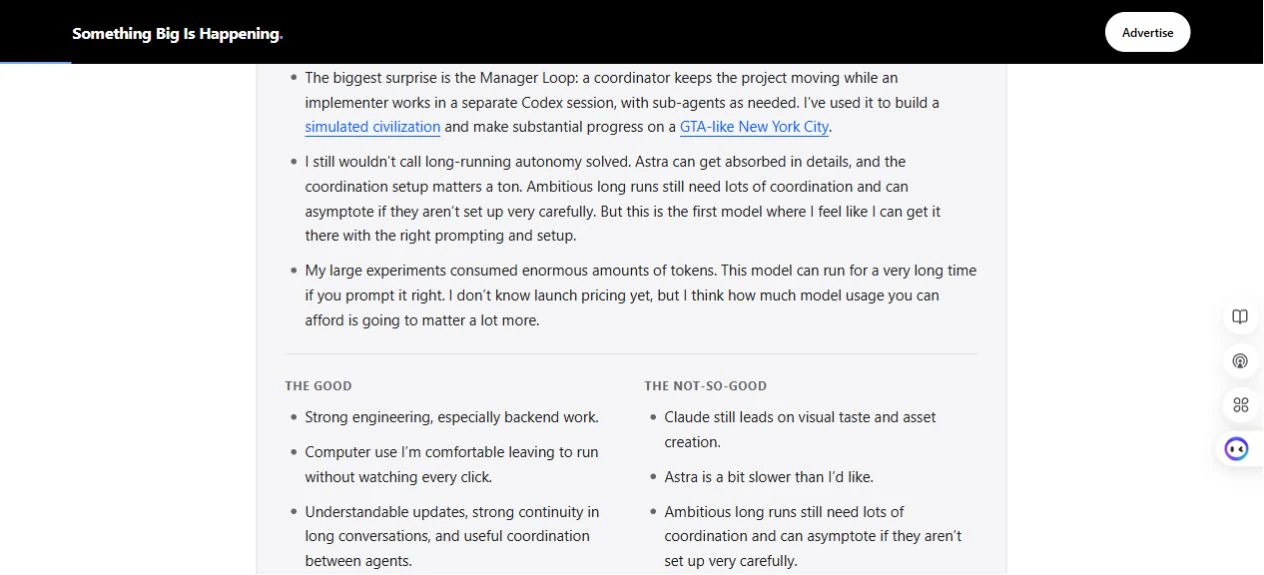
- Velocidade: Um modelo que raciocina, usa ferramentas e verifica seu próprio trabalho pode levar mais tempo do que um modelo de chat leve.
- Autonomia: O fato de funcionar por um longo período não significa que não haja supervisão. O revisor ainda identificou momentos em que o modelo precisava de coordenação ou reorientação.
- Uso do token: Um contexto extenso e um raciocínio mais complexo podem se tornar onerosos rapidamente, especialmente acima do limite de 272 mil.
- Design visual: Um bom desempenho na programação não garante, por si só, a melhor estética da interface.
- Profundidade das evidências: Ainda não há testes independentes e comparativos suficientes para se fazer afirmações gerais sobre confiabilidade ou superioridade.
O principal critério para a adoção é, portanto, a eficiência, e não a capacidade máxima. Avalie com que frequência o Astra conclui toda a tarefa corretamente, quanta supervisão ele requer, quantos tokens ele utiliza e quanto trabalho de limpeza ainda resta. Uma execução mais lenta e dispendiosa ainda pode valer a pena se substituir horas de trabalho de especialistas, mas não se ele se desviar repetidamente do caminho.
Quem deve usar o GPT-6 Astra?
| Possível compatibilidade | Por que o Astra pode ajudar | O que verificar primeiro |
|---|---|---|
| Trabalho com base de código extensa | Contexto extenso, uso de ferramentas e continuidade nas alterações em vários arquivos | Taxa de regressão, disciplina de teste, tempo de revisão e custo por token |
| Pesquisa e síntese | É capaz de coordenar a coleta, a análise e a geração de relatórios detalhados | Precisão das citações, abrangência das fontes e inferências sem fundamento |
| Agentes de uso de computadores | Projetado para interação em várias etapas com software | Limites de permissão, recuperação após alterações na interface do usuário e registros de ações |
| Análise de documentos extensos | Um contexto de 1,05 milhão pode conter uma quantidade considerável de material de origem | Recuperação em todo o contexto e se a recuperação é mais econômica |
| Operações de longa duração | O direcionamento durante a execução de tarefas e as ferramentas assíncronas podem reduzir o número de reinicializações | Comportamento de escalonamento, pontos de verificação e reversão segura |
É menos provável que o Astra seja a melhor opção padrão para reescritas curtas, classificação de rotina, extração simples ou trabalhos de grande volume, nos quais um modelo menor já atinge o padrão de qualidade exigido. O Análise do GPT-5.4 e do Nano mostra por que o roteamento por tarefa pode ser mais econômico do que enviar tudo para o modelo principal.
Uma lista de verificação prática para avaliação
- Escolha três tarefas reais com critérios de sucesso bem definidos.
- Aplique as mesmas entradas e restrições ao Astra e ao seu modelo atual.
- Registre o tempo total decorrido, os tokens de entrada e saída, as tentativas de repetição e as correções feitas manualmente.
- Avalie a conclusão da tarefa final separadamente do estilo de redação ou da apresentação.
- Interrupção do teste, reorientação no meio da tarefa e recuperação após uma falha deliberada da ferramenta.
- Adote o Astra somente nos casos em que a melhoria seja repetível e justifique o custo adicional.
Escolha o Astra ou um modelo menor, dependendo da tarefa
Utilize o Astra para sínteses complexas e trabalhos em que a precisão seja mais importante do que o menor preço por token. Um modelo menor pode ser suficiente para extrações rotineiras ou uma reescrita curta. Compare a conclusão bem-sucedida, a supervisão e o custo total com as mesmas entradas.
Para um fluxo de trabalho multimodelo, GPT-6 Astra, Claude Opus 5, Claude Sonnet 5 e Gemini 3,8 Flash estão listados no catálogo atual do GlobalGPT. O GlobalGPT é uma assinatura independente; ele não ativa a conta paga de outro provedor.
O Página do plano anual GlobalGPT A lista indica o plano Básico por $5,80/mês, o Pro por $10,80/mês e o Ilimitado por $25/mês, com cobrança anual, verificado em 18 de setembro de 2026. Compare o compromisso inicial e o uso do modelo incluído, não apenas o valor mensal equivalente mais baixo.
O que esta análise ainda não comprova
Uma tentativa anterior do Astra pela mesma rota CLI foi encerrada sem resposta. Mantemos essa falha no arquivo de testes; ela não constituiu uma pontuação de qualidade. As três chamadas bem-sucedidas aqui mostram que a rota funcionou para este lote, e não que a falha anterior não possa se repetir.
Não testamos o uso de computadores, a invocação assíncrona de ferramentas, o redirecionamento no meio de uma tarefa, a recuperação de um milhão de tokens, o acesso nativo ao plano ChatGPT nem o trabalho de produção autônomo. Não há fundamento aqui para afirmar que o Astra supera o Claude, o Gemini ou um modelo menor, como o OpenAI. Essas comparações exigem tarefas equivalentes e ensaios repetidos.
Recomendação de compra: Experimente o Astra em trabalhos em que a verificação de regras, valores ausentes e exceções seja importante. Mantenha um modelo menor para tarefas rotineiras que já atendam à sua meta de qualidade. Avalie o custo adicional com base na redução do número de correções e no trabalho finalizável, e não apenas pelo nome do modelo.
Perguntas frequentes
Esse foi um teste direto da API OpenAI?
Não. Utilizamos o serviço de modelo baseado em CLI do GlobalGPT com o gpt-6-astra. As contagens de tokens e os créditos informados referem-se a essa rota; o cálculo em dólares do OpenAI é uma ilustração separada da tabela de preços.
O GPT-6 Astra está disponível no GlobalGPT?
Sim. Esta análise inclui três chamadas bem-sucedidas para o gpt-6-astra por meio do serviço de modelo do GlobalGPT. A assinatura dessa plataforma é independente do faturamento da API do OpenAI e dos planos do ChatGPT.
O que é a janela de contexto?
O OpenAI lista 1.050.000 tokens de contexto, com um máximo de 922.000 tokens de entrada e 128.000 tokens de saída.
O Plus tem o GPT-6 Pro no Chat?
A orientação sobre os modelos de 10 de setembro inclui o GPT-6 Pro nos planos Pro, Business e Enterprise do Chat. Além disso, inclui o Astra nos planos Work e Codex; esses são direitos de uso de produtos distintos.
Como funciona a precificação de entradas longas?
A página oficial do modelo aplica taxas mais altas à solicitação completa acima de 272.000 tokens de entrada: o dobro das taxas de entrada e de cache e 1,5 vez as taxas de saída.
A nova prova abordou o uso do computador?
Não. Testamos a análise de ordens sintéticas, a geração de código com execução local e um pacote de texto com 500 notas. O uso do computador, as ferramentas assíncronas e a confiabilidade com um milhão de tokens não foram testados.
Devo substituir todos os modelos pelo Astra?
Não. Compare a qualidade dos resultados, a verificação manual, a latência e o custo para suas próprias tarefas. Um modelo pequeno pode ser a melhor opção quando produz, de forma confiável, a mesma resposta útil.