Situação atual, verificada em 24 de setembro de 2026: O ChatGPT 5.1 e o Grok 4.1 são pontos de comparação históricos, e não as opções padrão atuais de modelos. Documentação atual do modelo da xAI apresenta o Grok 4.6 como seu modelo geral principal, com um contexto de 500 mil tokens e $2 de entrada / $6 de saída por 1 milhão de tokens. O OpenAI’s catálogo de modelos atuais já ultrapassou o GPT-5.1, enquanto Atualmente, a GlobalGPT lista o GPT-6 Astra e Grok 4,6. As seções de referência a seguir mantêm o escopo de 2025; não reutilize pontuações antigas, valores de latência ou preços de assinatura como dados atuais do produto.
A escolha entre o ChatGPT 5.1 e o Grok 4.1 depende, em última análise, se você prioriza a ressonância emocional ou a precisão técnica. O Grok 4.1 se destaca em tarefas criativas e orientadas à personalidade, com uma pontuação recorde de 1.586 no EQ-Bench e um preço altamente competitivo. Em contrapartida, o ChatGPT 5.1 continua sendo o padrão de referência para ambientes corporativos, utilizando modelos especializados de “Pensamento” para alcançar confiabilidade superior em benchmarks complexos de codificação e raciocínio lógico, como o SWE-bench Verified. .
O panorama da IA em 2025 cria uma divisão nítida entre “agentes criativos” e “profissionais corporativos”, forçando os usuários a escolher entre uma personalidade sem filtros e a segurança de nível empresarial. Essa fragmentação deixa muitos divididos entre a autenticidade crua e a confiabilidade comprovada.
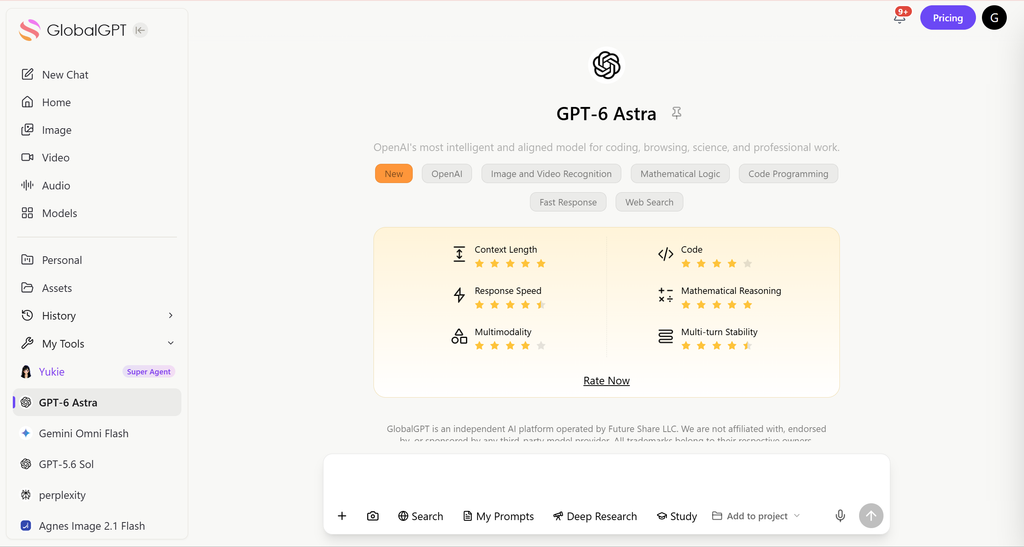
Felizmente, A GlobalGPT permite o acesso aos principais sistemas de IA ao mesmo tempo, eliminando a necessidade de fazer concessões entre a criatividade do Grok e a precisão do ChatGPT. Ao consolidar modelos como GPT-6 Astra, Grok 4.1, Claude 4.5, Sora 2, Veo 3.1, Unikorn e Kling em uma única plataforma, os usuários podem implantar a ferramenta ideal para cada tarefa específica sem precisar gerenciar várias assinaturas.
A mudança na filosofia central: “Segurança corporativa” x “Personalidade sem filtros”
A diferença fundamental entre esses dois modelos reside em sua filosofia de design: a OpenAI prioriza a utilidade previsível de nível empresarial, enquanto a xAI otimiza o engajamento e a autenticidade bruta.

- ChatGPT 5.1 – O “Profissional Adaptável”: Projetado para oferecer estabilidade, este modelo utiliza um sistema de roteamento dinâmico que alterna automaticamente entre caminhos “instantâneos” para tarefas simples e caminhos profundos “Modelos ”de raciocínio” para lógica complexa. Ele foi projetado para minimizar a responsabilidade, seguindo diretrizes de segurança rigorosas que impedem que ele se envolva com temas delicados ou “inadequados”, tornando-o a escolha preferida para ambientes corporativos.
- Grok 4.1 – O “Agente Rebelde”: A xAI desenvolveu o Grok para atuar como um agente de “curiosidade máxima” que se opõe ativamente à censura “politicamente correta” ou a respostas “suavizadas”. Ele utiliza uma arquitetura de enxame paralela em grande escala para debater hipóteses internamente, resultando em respostas que parecem mais humanas, espirituosas e, ocasionalmente, polêmicas, visando especificamente usuários que se sentem limitados pelas restrições padrão da IA.
- O fim da era do “modelo único para todos”: Em 2025, o mercado se fragmentou; os usuários não buscam mais uma única IA “mais inteligente”, mas sim escolhem com base na “vibração” e na utilidade específica necessária para a tarefa em questão. Na prática, você precisa decidir entre um funcionário educado e altamente competente (ChatGPT) e um parceiro criativo brilhante, porém excêntrico (Grok).
Análise da arquitetura técnica: por trás dos bastidores
A comparação das especificações técnicas revela como as prioridades de engenharia da OpenAI e da xAI são diferentes.
| Recurso | ChatGPT 5.1 (OpenAI) | Grok 4.1 (xAI) |
| Estratégia da janela de contexto | 128k Memória ativa + profunda (Prioriza a precisão da recuperação em detrimento do comprimento bruto) | 2 milhões de tokens (por níveis) (128k Raciocínio “quente” + Recuperação “morno”) |
| Arquitetura central | Roteamento dinâmico (Alterna entre os caminhos “Instantâneo” e “Pensativo”) | Enxames de agentes paralelos (Gera vários agentes internos para debater respostas) |
| Latência de voz/resposta | ~550 ms (Otimizado para velocidade de conversação) | ~1200 ms+ (Maior latência devido ao processamento em enxame) |
| Fonte de conhecimento | Pré-treinado + Pesquisa na Web (Utiliza a pesquisa para verificar os fatos) | Transmissão em tempo real X (Twitter) (Acesso nativo a dados sociais em tempo real) |
- Janela de contexto Wars: O Grok 4.1 possui um enorme banco de dados de 2 milhões de janela de contexto do token, utilizando um sistema em camadas, no qual os primeiros 128 mil tokens são “ativos” (raciocínio ativo) e o restante funciona como memória de recuperação “passa-ponto”. Em contrapartida, o ChatGPT 5.1 normalmente se baseia em uma camada Deep Memory RAG com um limite de contexto ativo mais restrito (geralmente em torno de 128 mil a 196 mil), priorizando a precisão da recuperação em detrimento do comprimento bruto do contexto.
- Arquitetura do raciocínio: O OpenAI utiliza um processo de raciocínio do “Sistema 2”, no qual o modelo faz uma pausa para encadear os pensamentos antes de responder, reduzindo significativamente as taxas de alucinação em tarefas de matemática e programação. O Grok 4.1 utiliza “Enxames Agentes Paralelos”, gerando vários agentes internos para avaliar e refinar respostas em tempo real, o que é particularmente eficaz para fluxos de trabalho agentes complexos e com várias etapas.
- Latência e velocidade: Para interações rápidas, o modo ’Instantâneo“ do ChatGPT 5.1 é otimizado para respostas em menos de um segundo, tornando-o ideal para consultas rápidas. O Grok 4.1 Fast foi projetado para equilibrar velocidade e uso da ferramenta, mas sua dependência da consulta de dados do X (Twitter) em tempo real pode introduzir latência variável em comparação com a base de conhecimento pré-treinada do ChatGPT.

Comparativos diretos: o que dizem os dados oficiais
Embora o marketing seja exagerado, os resultados oficiais dos testes de benchmark mostram claramente em que áreas cada modelo realmente se destaca.
- Inteligência Emocional (EQ)O Grok 4.1 alcançou uma pontuação recorde de 1586 no ranking EQ-Bench, superando significativamente os concorrentes por compreender nuances, sarcasmo e subtexto. Esse alto QE o torna superior para tarefas que exigem empatia, como redigir e-mails difíceis ou contar histórias criativas, onde respostas robóticas podem soar alienantes.

- Raciocínio científico: No benchmark GPQA Diamond (questões científicas de nível de doutorado), no instantâneo de 2025, o Gemini 3 foi apresentado como a principal opção, mas o GPT-5.1 (Pro/Thinking) vem logo atrás, com pontuações em torno de 81-87%, demonstrando extrema confiabilidade para pesquisas acadêmicas. O Grok 4.1 apresenta um desempenho admirável, mas, em geral, fica ligeiramente atrás dos modelos dedicados ao “raciocínio” em termos de precisão científica pura.
- Realidade e alucinaçõesO Grok 4.1 reduziu sua taxa de alucinação para aproximadamente 4,22%, aproveitando ferramentas de verificação de pesquisa em tempo real. O ChatGPT 5.1 utiliza seu “Modo ”Reflexão” para verificar os fatos, com o objetivo de alcançar reduções semelhantes nas taxas de erro, especialmente em áreas de “alta” complexidade, como biologia e química.

Codificação e desenvolvimento: precisão versus fluxo de trabalho agênico
Para desenvolvedores, a escolha depende se você precisa de edições cirúrgicas no código ou de um agente autônomo full-stack.
- Para desenvolvedores – GPT-5.1O ChatGPT 5.1 se destaca na manutenção da integridade do repositório usando o
aplicar_patchferramenta que permite fazer edições cirúrgicas em bases de código existentes sem reescrever arquivos inteiros. Ela alcança uma pontuação alta no SWE-bench Verified (aproximadamente 74,91 TP3T), tornando-a a escolha mais segura para integração em pipelines empresariais estabelecidos, onde mudanças radicais são inaceitáveis.

- Para agentes full-stack – Grok 4.1: O Grok se destaca em fluxos de trabalho agênicos por meio de sua “API de Ferramentas de Agente”, que permite encadear várias ações — como pesquisar documentação, escrever código e executá-lo — em um loop. Ele é otimizado para a “programação intuitiva”, na qual um desenvolvedor descreve uma meta de alto nível, e o Grok cria rapidamente um protótipo de uma solução funcional usando sua ampla janela de contexto para compreender todo o escopo do projeto.
- Resultados verificados pelo SWE-benchEmbora o GPT-5.1 tenha uma pontuação verificada de ~74,91 TP3T, o Grok 4.1 afirma ter um desempenho competitivo no mesmo nível (791 TP3T, de acordo com algumas comparações), impulsionado por sua capacidade de autocorreção usando enxames de agentes paralelos.

Se você deseja comparar esses recursos de codificação lado a lado em sua própria base de código, o GlobalGPT oferece um ambiente unificado para executar os dois modelos com o mesmo prompt.
“Avaliação da Experiência” em 9 etapas no mundo real: testes de usabilidade
Além dos benchmarks, como esses modelos se comportam no uso diário? Os testes revelam personalidades distintas.

- Escrita criativa: Em testes cegos, os usuários preferiram a produção criativa do Grok 4.1 em 64% das vezes, pois ela cria tensão, utiliza detalhes sensoriais e evita o clichê da ’voz de IA“ comum no ChatGPT. O Grok está disposto a assumir riscos narrativos, enquanto o ChatGPT 5,1 frequentemente recorre a desfechos seguros e ”à la Disney“.

- Lógica e Armadilhas: Quando confrontado com questões linguísticas capciosas (por exemplo, “17 ovelhas, todas morrem, exceto 9”), o Grok 4.1 identifica corretamente a armadilha linguística e explica por que É um truque. O ChatGPT 5.1 resolve a equação matemática corretamente, mas muitas vezes não percebe as nuances da conversa, tratando-a como um problema puramente lógico.
- Humor e tom: O Grok 4.1 se destaca no humor do tipo “roast” e na comédia negra, produzindo esquetes de stand-up que soam ousados e humanos. O ChatGPT 5.1 tem dificuldades nessa área, frequentemente produzindo “piadas inofensivas” ou piadas de pai que carecem da mordacidade necessária para uma comédia genuína, devido ao seu rigoroso alinhamento com os padrões de segurança.
Recursos multimodais: visão, voz e vídeo
A capacidade de ver, ouvir e gerar mídia é um campo de batalha fundamental.

- Geração de vídeoO ChatGPT 5.1 integra-se nativamente com Sora 2, permitindo aos usuários gerar vídeo fisicamente preciso clipes (de até 25 segundos) diretamente na interface do chat. Na comparação de 2025, o Grok 4.1 não contava com um modelo nativo de geração de vídeo desse nível, recorrendo, em vez disso, a modelos de geração de imagens como o Aurora ou o Flux, o que o deixou em desvantagem nos fluxos de trabalho de vídeo.
- Latência do modo de voz: Para a interação por voz em tempo real, a latência é fundamental. O modo de voz do GPT-5.1 apresenta uma latência de cerca de 550 ms, proporcionando uma sensação ágil e coloquial. O processamento de áudio do Grok 4.1 é mais lento, com latências que frequentemente ultrapassam 1.200 ms, fazendo com que a experiência se pareça mais com uma troca de mensagens por walkie-talkie do que com uma conversa natural.
- Análise de ImagensO GPT-5.1 (especialmente com o Thinking ativado) se destaca na análise de figuras e gráficos científicos, obtendo uma pontuação elevada no benchmark CharXiv. O Grok 4.1 aproveita seus recursos de visão principalmente para analisar imagens e memes de mídia social do X, o que lhe confere uma vantagem cultural, mas uma desvantagem científica.
Segurança, censura e taxas de recusa
O debate sobre o “woke” é fundamental para a estratégia de marketing desses modelos.

- O debate sobre o “woke”: O Grok 4.1 promove uma postura de “Curiosidade Máxima”, com uma taxa de recusa inferior a 1% em relação a temas delicados, o que o torna disposto a discutir questões políticas ou sociais controversas que outros modelos evitam.
- Conformidade empresarial: O ChatGPT 5.1 mantém uma taxa de rejeição de cerca de 4,5% para usuários em geral, mas oferece “Níveis de Confiança” para clientes corporativos, garantindo que os resultados corporativos permaneçam adequados para o ambiente de trabalho (filtros NSFW, conformidade legal)()()()(). Isso a torna a única opção viável para empresas da Fortune 500 que não podem correr o risco de sofrer desastres de relações públicas.
- Tratamento de aconselhamento médico/jurídico: Apesar de sua imagem “rebelde”, o Grok 4.1 é surpreendentemente conservador no que diz respeito a orientações médicas, muitas vezes remetendo estritamente aos profissionais para evitar responsabilidades. O ChatGPT 5.1, aprimorado pela avaliação do HealthBench, procura ser um “parceiro de reflexão” útil, ao mesmo tempo em que sinaliza riscos, fornecendo um contexto médico mais detalhado do que o Grok()()()().
A Economia de Tokens: Panorama dos Preços em 2025 (Histórico)
O preço é onde o Grok 4.1 dá seu maior golpe contra a concorrência.

- API Choque de preços: A xAI definiu um preço agressivo para o Grok 4.1 Fast em $0,20 por milhão de tokens inseridos, que é aproximadamente 84% mais barato do que os $1,25 por milhão de tokens de entrada do ChatGPT 5.1. Para desenvolvedores que criam aplicativos de alto volume, essa diferença de preço é um fator decisivo.
- A “armadilha da assinatura”Para acessar a melhor versão do Grok (não API), os usuários devem se inscrever em X Premium+ ($16/mês). Para aproveitar ao máximo o ChatGPT, você precisa ChatGPT Plus ($20/mês). Manter as duas assinaturas custa mais de $400/ano, o que gera uma significativa “fadiga de assinaturas”.”
- Economias para desenvolvedoresPara um aplicativo que processa 100 milhões de tokens mensalmente, usar o Grok 4.1 em vez do GPT-5.1 pode economizar para uma startup mais de $1.000 por mês em custos brutos de API ($20 contra $125+).
O “fluxo de trabalho híbrido”: maximizando a eficiência
Em vez de escolher um, os usuários avançados mais eficazes em 2025 estão combinando os dois modelos para aproveitar seus pontos fortes exclusivos.

- Fase 1: Ideação e pesquisa (Grok 4.1)Comece com o Grok 4.1 para debater ideias, elaborar conteúdos criativos ou pesquisar notícias em tempo real utilizando a sua integração X. O seu elevado QE e baixa taxa de rejeição tornam-no perfeito para gerar conceitos brutos e não filtrados.
- Fase 2: Estrutura e codificação (ChatGPT 5.1): Leve o rascunho ou conceito bruto para o ChatGPT 5.1 para refinamento estrutural, verificação lógica de fatos ou conversão da ideia em código pronto para produção usando o
aplicar_patchferramenta. - Fase 3: Verificação visual (Gemini 3): Se o projeto envolver dados visuais complexos ou gráficos científicos, use o Gemini 3 para verificar os elementos visuais, pois ele atualmente lidera os benchmarks de raciocínio visual.
A solução unificada: acessando todos os modelos através do GlobalGPT
Gerenciar três assinaturas e chaves API separadas é ineficiente e caro.


- Resolvendo a fadiga da assinatura: O GlobalGPT integra GPT-6 Astra, Grok 4,6 e Gêmeos 3 em uma única interface, permitindo aos usuários para acessar mais de 100 modelos de primeira linha a partir de por $10,8/mês, quando cobrado anualmente. Isso elimina a necessidade de pagar $50+ mensalmente por assinaturas separadas do X Premium+, do ChatGPT Plus e do Google One.

- Comparando resultados lado a ladoA plataforma permite a troca contínua de modelos, possibilitando que os usuários executem o mesmo comando no Grok e no GPT-5.1 instantaneamente para comparar os resultados sem precisar alternar entre abas ou fazer login em contas diferentes.
- Quebrando bloqueios regionaisA GlobalGPT fornece acesso a modelos restritos por região (como Claude 4.5 ou Grok na UE) sem exigir configurações complexas de VPN ou verificações de números de telefone estrangeiros.
Veredicto final: qual modelo você deve escolher?
- A Escolha do Desenvolvedor (linha de base histórica do GPT-5.1)Se você precisa de geração de código confiável e estruturada e segurança de nível empresarial, o ChatGPT 5.1 é imprescindível. Seu
aplicar_patchferramenta e altas pontuações no SWE-bench tornam-no o padrão da indústria. - A Escolha do Criador (linha de base histórica Grok 4.1)Se você precisa de um parceiro de escrita com personalidade, humor e sem filtros moralizantes, o Grok 4.1 é superior. Seu baixo custo e alto QE o tornam a melhor ferramenta para geração de conteúdo.
- A escolha do pesquisador (Gêmeos 3)Para descobertas científicas puras e análise de dados visuais complexos, o Gemini 3 continua sendo o especialista líder, superando os modelos generalistas em tarefas de raciocínio profundo.
Para um novo projeto em 2026: Utilize o GPT-6 Astra ou outra rota OpenAI atual para trabalhos estruturados, e o Grok 4.6 quando precisar do modelo geral atual do xAI e das ferramentas de pesquisa opcionais. Utilize o benchmark mais antigo abaixo para compreender o compromisso original, e não como uma tabela atualizada de preços ou disponibilidade.
Perguntas frequentes (FAQ)
- O Grok 4.1 consegue analisar arquivos PDF tão bem quanto o ChatGPT?
- Sim, o Grok 4.1 agora oferece suporte ao envio de arquivos e pode recuperar informações de documentos por meio da API do Agent Tools, de forma semelhante aos recursos de análise do ChatGPT.
- O GlobalGPT é compatível com as versões “Pro” desses modelos?
- Sim, a GlobalGPT fornece acesso a modelos de ponta, como Sora 2 Pro e GPT-5.1, que normalmente estão bloqueados atrás de níveis caros nas plataformas oficiais.
- O ChatGPT 5.1 é mais rápido que o Grok 4.1 para consultas simples?
- Sim, graças ao seu modo “Instantâneo”, o ChatGPT 5.1 normalmente responde a consultas simples em menos de um segundo (aproximadamente 550 ms), enquanto o Grok 4.1 pode demorar mais devido à sobrecarga de processamento em enxame.
O que devo usar para um novo projeto em 2026?
Comece testando o GPT-6 Astra e o Grok 4.6 com as mesmas instruções, arquivos, ferramentas e critérios de aceitação. O GPT-6 Astra é a rota de planejamento GlobalGPT atualmente listada para trabalhos estruturados; o Grok 4.6 é o modelo geral carro-chefe atual da xAI.
Qual é o preço atual do Grok 4.6 API?
A documentação atual da xAI indica Grok 4.6, com $2 por 1 milhão de tokens de entrada e $6 por 1 milhão de tokens de saída, com um contexto de 500.000 tokens. Esse valor é independente de qualquer preço de assinatura para consumidores.
Os valores de referência ChatGPT 5,1 e Grok 4,1 ainda estão atualizados?
Não. As pontuações, as estimativas de latência, os limites dos modelos e os preços das assinaturas apresentados na comparação original referem-se ao período de teste de 2025. Considere-os como contexto histórico e repita os testes com os IDs dos modelos atuais antes de tomar uma decisão de compra ou integração.