As melhores instruções para o Claude tornam a tarefa fácil de entender: defina para o Claude um objetivo, o material que ele deve usar, as restrições relevantes e uma maneira de verificar o resultado. Ao escrever, proteja os fatos e a próxima ação do leitor. Para pesquisa, relacione as afirmações às fontes. Para programação, defina o comportamento correto e execute testes.
Comece com a tarefa que você precisa abaixo: redigir um e-mail, entender um pacote de fontes ou corrigir uma função em Python. Escolha entre 12 modelos adaptáveis e, em seguida, explore três exemplos resolvidos, testados com a questão Claude na prova GlobalGPT. Cada exemplo inclui a questão completa e a resposta, para que você possa ver o que copiar, o que alterar e o que verificar em seu próprio trabalho.
Se o seu trabalho passa da pesquisa para a redação e, em seguida, para a programação, GlobalGPT reúne o Claude e outros modelos líderes, além de diversas ferramentas de IA, em uma única assinatura acessível e em um único painel. Você pode manter todo o fluxo de trabalho integrado e escolher o modelo ou a função mais adequada para a próxima etapa.
Nesta página
Os melhores prompts do Claude em resumo
Escolha o modelo de acordo com a decisão ou o resultado final que você precisa. Preencha os campos entre colchetes antes de enviá-lo. Os modelos de redação e pesquisa aceitam texto colado; já os prompts de programação que solicitam acesso a arquivos ou execução de comandos exigem uma ferramenta capaz de realizar essas ações.
Um modelo inicial reutilizável é suficiente para muitos trabalhos. Visão geral da engenharia de prompts do Anthropic começa com os critérios de sucesso e uma maneira de testá-los. Não é preciso recorrer a um perfil de especialista complexo para definir o que uma resposta útil deve conter.
Um modelo inicial curto
Ajude-me com [TAREFA] para [PÚBLICO OU OBJETIVO].
Use este material: [COLAR MATERIAL].
Respeite estas restrições: [FATOS, ESCOPO, EXTENSÃO OU REGRAS].
Retorne [FORMATO DE SAÍDA].
Um resultado bem-sucedido deve [REQUISITOS VERIFICÁVEIS].
Se algum detalhe necessário estiver faltando, faça a pergunta específica que está impedindo a realização da tarefa.
Use títulos ou tags quando isso facilitar a organização de um briefing complexo. Orientações atuais do Anthropic sobre prompts recomenda instruções claras, exemplos úteis e tags XML descritivas para materiais mistos. As tags organizam o texto; elas não criam evidências, não concedem acesso a ferramentas nem tornam uma resposta correta.
Claude: sugestões para redação
Na redação, o difícil geralmente é manter o objetivo sem alterar a forma de expressão. Indique o que o leitor precisa fazer e quais detalhes são imutáveis. Uma frase fluida não adianta nada se, sem que se perceba, acrescentar uma promessa.
1. Escreva um e-mail com base em um resumo factual
Um convite, uma atualização ou um e-mail para o cliente com detalhes que devem ser precisos. Traga: Resumo dos fatos, público-alvo, resposta e limite de palavras.
W1 · Tarefa representativa testada a seguir
Escreva o e-mail solicitado no briefing. Considere os fatos confirmados como definitivos. Mantenha as solicitações separadas das confirmações. Siga o formato e o tamanho especificados para o texto final. Utilize apenas os detalhes fornecidos.


Público-alvo: [QUEM VAI LER ISSO]
Objetivo: [O QUE O E-MAIL DEVE ALCANÇAR]
Fatos confirmados: [DATAS, HORÁRIOS, PREÇOS, LIMITES E OUTROS DETALHES]
Detalhes desconhecidos ou não aprovados: [O QUE VOCÊ NÃO PODE PROMETER]
Ação do leitor: [PRÓXIMO PASSO EXATO]
Tom: [TOM]
Resultado: um assunto e um corpo de [NÚMERO DE PALAVRAS] palavras.
Verifique o resultado: Verifique todas as datas, números, promessas e próximas ações em relação ao resumo. Uma frase extra, mesmo que seja amigável, ainda pode criar uma obrigação.
2. Adapte o estilo da sua própria escrita
Um rascunho curto que parece estar em consonância com o seu trabalho atual. Traga: Duas ou três amostras que você escreveu e os fatos para o novo artigo.
W2 · Modelo adaptável
Use minhas amostras de redação para identificar três características observáveis de estilo: ritmo das frases, nível de formalidade e a maneira como explico as ideias. Aplique essas características a um novo [FORMATO] para [PÚBLICO-ALVO].

Use as amostras apenas para avaliar o estilo. Use o novo briefing para os fatos. Indique as três características e, em seguida, apresente o rascunho com [INTERVALO DE PALAVRAS] palavras.


[COLQUE SEU PRÓPRIO TEXTO AQUI]


[TEMA, OBJETIVO, FATOS CONFIRMADOS E AÇÃO DO LEITOR]
Verifique o resultado: Preste atenção ao ritmo das frases e à precisão do texto; em seguida, verifique se os fatos da versão anterior não foram incorporados ao novo rascunho.
Escolha exemplos cujo estilo você queira manter. Uma lista de adjetivos como “simpático, perspicaz, profissional” deixa mais margem para interpretação do que alguns exemplos concretos. O novo briefing deve continuar sendo a fonte dos detalhes factuais.
3. Identifique as alterações que teriam maior impacto
Um rascunho que parece fraco, mas que não exige uma reescrita completa. Traga: Seu rascunho, público-alvo, objetivo e quaisquer trechos que devam ser mantidos.
W3 · Modelo adaptável
Analise este rascunho para [PÚBLICO-ALVO], que precisa [OBJETIVO DO LEITOR]. Identifique até três alterações que mais melhorariam a clareza ou a utilidade do texto. Se forem necessárias menos de três, indique isso.

Para cada alteração, cite a passagem original, explique o problema do leitor e proponha uma substituição. Preserve o significado factual e estes elementos: [A SER MANUTIDO]. Não reescreva todo o rascunho.


[COLAR RASCUNHO]
Verifique o resultado: Rejeite conclusões que não possam apontar para uma passagem real ou para um problema significativo para o leitor.
4. Reutilizar um conteúdo para dois públicos
Transformar uma atualização aprovada em uma nota interna e em uma mensagem ao cliente. Traga: Uma fonte aprovada e dois resumos para o público.
W4 · Modelo adaptável
Adapte o texto-fonte aprovado em duas versões resumidas:
A. [FORMATO, PÚBLICO-ALVO, OBJETIVO, LIMITE DE PALAVRAS]
B. [FORMATO, PÚBLICO-ALVO, OBJETIVO, LIMITE DE PALAVRAS]

Mantenha a consistência das datas, números, disponibilidade de recursos e compromissos. Altere a explicação e a ênfase para se adequar a cada público-alvo. Se um público-alvo precisar de um detalhe que o texto original não contenha, liste essa lacuna após os rascunhos.


[COLAR O TEXTO ORIGINAL]
Verifique o resultado: Compare as duas versões com a mesma lista de fatos; um novo público não justifica novos recursos ou promessas.
Experimente estas tarefas no GlobalGPT
Transforme um briefing em um e-mail, um pacote de fontes em uma recomendação e um relatório de falha em uma correção.
Utilizamos o Claude Sonnet 5 no GlobalGPT para todas as três tarefas. Os rascunhos de e-mail mantiveram os principais detalhes do evento, as respostas da pesquisa identificaram motivos para adiar o lançamento e ambas as correções em Python foram aprovadas em todas as 24 verificações quando as executamos separadamente. Esses são pontos de partida úteis para o trabalho que você pode integrar ao mesmo painel.
Para experimentar você mesmo, escolha um modelo abaixo e substitua o conteúdo de exemplo pelo seu próprio. O GlobalGPT reúne ferramentas de redação, pesquisa, programação e outras ferramentas de IA em uma única assinatura acessível, para que você possa passar da compreensão de um problema à elaboração do próximo produto final sem precisar alternar entre serviços distintos.
Como comparamos as instruções
Em 14 de setembro de 2026, cada tarefa recebeu duas solicitações com o mesmo material de referência fictício e os mesmos requisitos: uma instrução breve e uma versão mais estruturada. Mantivemos a primeira resposta completa de cada uma, totalizando seis respostas. A pesquisa utilizou as passagens fornecidas; o código Python devolvido foi verificado separadamente, sem ser executado pelo modelo durante a conversa.
Esses exemplos abrangem três tarefas, uma por versão. As entradas e respostas completas aparecem abaixo, juntamente com as edições ou verificações necessárias para cada resultado. Os 12 modelos reutilizáveis não foram testados separadamente.
Comparação da primeira saída · W
Elabore um rascunho de e-mail sobre o evento, incluindo os principais detalhes.
| Verificar | Instrução simples | Ensino estruturado |
|---|---|---|
| Principais fatos e verificações de ações | 8 / 9 | 8 / 9 |
| Comprimento do corpo e do tecido | Aprovado · 126 palavras | Aprovado · 128 palavras |
| Promessa de acompanhamento não aprovada | Presente | Presente |
Ambas as versões mantiveram a data, os horários, a capacidade, o preço, as observações e a distinção entre solicitar e confirmar uma reserva. Isso lhe dá um rascunho para editar, em vez de uma página em branco. Antes de enviar, remova a promessa de acompanhamento que nenhum dos dois resumos autorizou; a versão simples também se referiu às sessões como “idênticas” sem fundamentação. Para o seu próprio e-mail, liste tanto os fatos que devem ser mantidos quanto os compromissos que você tem permissão para assumir.
As oito verificações abrangem a data; os horários e o UTC; a duração; a capacidade por sessão; a participação gratuita; as anotações para download; a proibição de gravação; e a solicitação, em vez da confirmação, de uma reserva. A nona verificação detecta fatos ou compromissos inventados. A contagem de palavras não inclui o assunto.
Tempo decorrido: 9,73 s / 7,02 s. Tokens de entrada e saída registrados: 400 + 617 / 468 + 299. Uma resposta para cada; sem tentativas de repetição.
Instruções simples — instruções completas e material de referência
Escreva o e-mail solicitado no briefing abaixo.

EVENTO DE TESTE FICTÍCIO. Estes são detalhes fictícios de um workshop, não uma oferta real.

Você está escrevendo um e-mail de convite para um workshop comunitário fictício chamado “Clear Notes”.
Público-alvo: líderes de projetos de equipes pequenas que desejam notas de reunião mais organizadas.
Objetivo: convidar o leitor a responder “MANHÔ ou “TARDE” para solicitar uma vaga. A resposta serve para solicitar uma vaga; não confirma a reserva.
Fatos confirmados:
- Data: 8 de outubro de 2026.
- Duas sessões separadas começam às 09h00 UTC e às 16h00 UTC.
- Cada sessão tem duração de 40 minutos.
- Cada sessão tem 25 vagas.
- A participação é gratuita.
- Os participantes recebem anotações para download.
- Não haverá gravação disponível.
- Não foi definido prazo final para inscrições.
Entrega: um assunto e um corpo de e-mail com 100 a 140 palavras. Inglês simples e amigável; sem exageros. Inclua a data, os horários de início e o fuso horário, a duração, a capacidade por sessão, o preço, as anotações para download, a ausência de gravação e a ação necessária na resposta. Não invente um link, prazo, reserva confirmada, palestrante ou local do evento. É aceitável não mencionar o prazo de inscrição, caso ele ainda não tenha sido definido.
Instrução simples — resposta original completa
**Assunto: Workshop Clear Notes – 8 de outubro de 2026 – Resposta à solicitação de vaga**

Olá,

Estamos convidando líderes de projeto que desejam notas de reunião mais claras e úteis a participar do Clear Notes, um workshop comunitário gratuito que acontecerá no dia 8 de outubro de 2026.

Haverá duas sessões idênticas, cada uma com duração de 40 minutos: uma começando às 09h00 UTC e outra às 16h00 UTC. Cada sessão tem 25 vagas disponíveis.

A participação é gratuita, e todos os participantes receberão anotações para download. Observe que não haverá gravação disponível; portanto, a participação ao vivo é a única forma de participar.

Para solicitar uma vaga, basta responder a este e-mail com MANHÃ ou TARDE, dependendo de qual sessão for mais conveniente para você. Responder ao e-mail é uma solicitação de vaga; não confirma sua inscrição. Entraremos em contato em breve com mais detalhes.

Obrigado e esperamos vê-lo lá.
Instrução estruturada — orientações completas e material de referência
Escreva o e-mail de convite solicitado no briefing. Considere os fatos confirmados como definitivos. Mantenha uma distinção clara entre o pedido de vaga e a reserva confirmada. Siga o formato e o tamanho de saída indicados. Utilize apenas os detalhes fornecidos.


SITUAÇÃO FICTÍCIA DE TESTE. Estes são detalhes fictícios de um workshop, não uma oferta real.

Você está redigindo um e-mail de convite para um workshop comunitário fictício chamado Clear Notes.
Público-alvo: líderes de projetos de equipes pequenas que desejam anotações de reunião mais claras.
Objetivo: convidar o leitor a responder MANHÃ ou TARDE para solicitar uma vaga. Uma resposta solicita uma vaga; ela não confirma uma reserva.
Fatos confirmados:
- Data: 8 de outubro de 2026.
- Duas sessões separadas começam às 09h00 UTC e às 16h00 UTC.
- Cada sessão dura 40 minutos.
- Cada sessão tem 25 vagas.
- A participação é gratuita.
- Os participantes recebem anotações para download.
- Não haverá gravação disponível.
- Não foi definido prazo final para inscrições.
Entrega: um assunto e um corpo de e-mail com 100 a 140 palavras. Inglês simples e amigável; sem exageros. Inclua a data, os horários de início e o fuso horário, a duração, a capacidade por sessão, o preço, as anotações para download, a ausência de gravação e a ação de resposta. Não invente um link, prazo, reserva confirmada, palestrante ou local do evento. É aceitável não mencionar o prazo de inscrição, caso ele não tenha sido definido.
Instrução estruturada — resposta original completa
Assunto: Você está convidado: Workshop do Clear Notes – 8 de outubro de 2026

Olá,

Se você é um líder de projeto em busca de anotações de reunião mais organizadas, adoraríamos contar com a sua presença no Clear Notes, no dia 8 de outubro de 2026.

Estão disponíveis duas sessões, cada uma com duração de 40 minutos: uma com início às 09h00 UTC e outra às 16h00 UTC. Cada sessão tem 25 vagas, e a participação é totalmente gratuita.

Todos os participantes receberão anotações para download, para guardar e consultar posteriormente. Observe que não haverá gravação disponível; portanto, a participação ao vivo é a única maneira de participar.

Para solicitar uma vaga, basta responder com “MANHÔ ou “TARDE”, dependendo da sessão que for mais conveniente para você. A resposta serve para solicitar uma vaga; não confirma sua inscrição; entraremos em contato em breve com mais detalhes.

Esperamos vê-lo lá.

Atenciosamente,
A equipe do Clear Notes
Claude: sugestões para pesquisa
As solicitações de pesquisa precisam de um limite de evidência. Forneça as passagens relevantes com os IDs das fontes ou utilize uma ferramenta que realmente consiga recuperá-las. Um URL por si só não é prova de que o Claude tenha aberto uma página. Esses modelos separam o que as fontes dizem do que você pode concluir.
5. Sintetizar as fontes sem ignorar as divergências
Responder a uma questão de decisão com base em documentos que você pode consultar. Traga: Trechos identificados, suas datas, a questão da decisão e quaisquer alegações a serem verificadas.
R1 · Tarefa representativa testada a seguir
Responda à [PERGUNTA DE DECISÃO] utilizando apenas o pacote de fontes abaixo. Compare definições, populações e denominadores antes de considerar diferenças numéricas como evidência de melhoria. Distinga uma afirmação preliminar de uma medição. Associe cada conclusão a uma citação exata da fonte que realmente a sustente e não mencione evidências ausentes.

Resultado: uma recomendação com no máximo [LIMITE] palavras; uma tabela com Afirmação, Veredicto, ID da fonte e citação exata de apoio; e três medidas ausentes necessárias para uma comparação justa. Use “Apoiado”, “Parcialmente apoiado”, “Não apoiado” ou “Contradito” somente quando as evidências justificarem essa classificação. Audite estas alegações: [ALEGAÇÕES].


[IDs de fontes, datas e trechos relevantes completos]
Verifique o resultado: Verifique o texto citado, a afirmação que ele sustenta e se as quantidades utilizam a mesma definição e o mesmo denominador.
6. Verifique se uma afirmação está de acordo com a fonte citada
Revisão de um rascunho antes que uma citação seja utilizada como prova. Traga: A afirmação exata e a passagem original, não apenas um URL.
R2 · Modelo adaptável
Verifique cada afirmação em relação ao texto-fonte fornecido junto a ela. Para cada uma, forneça: afirmação, ID da fonte, citação exata relevante, veredicto e uma versão corrigida, se necessário.

Use “Comprovada” quando a fonte corroborar toda a afirmação; “Parcialmente comprovada” quando a fonte corroborar apenas parte dela; “Não comprovada” quando não houver evidências ou estas forem insuficientes; e “Contradita” quando a fonte entrar em conflito direto com a afirmação. Se o texto de origem estiver faltando, indique que não é possível avaliar a comprovação. Não deduza o conteúdo da fonte a partir de seu título ou URL.

[COLAR PARES DE AFIRMAÇÕES E FONTES]
Verifique o resultado: Mesmo uma fonte confiável pode não corroborar a afirmação. A ausência de evidências não constitui uma contradição.
“Sem fundamento” significa que as evidências apresentadas não comprovam a alegação. “Contradita” significa que as evidências entram em conflito com ela. Essa distinção é importante quando uma fonte ainda não relata resultados: ela não demonstrou nem melhora nem piora.
7. Compare as opções com base no seu resumo de decisão
Escolher entre opções com evidências inconsistentes. Traga: Seus critérios, restrições e informações confiáveis sobre cada opção.
R3 · Modelo adaptável
Compare [OPÇÕES] para [DECISÃO]. Utilize estes critérios na seguinte ordem de prioridade: [CRITÉRIOS]. Restrições rígidas: [RESTRIÇÕES]. Utilize apenas as informações sobre as opções apresentadas abaixo.

Apresente uma tabela comparativa, a escolha mais bem fundamentada e o fato ausente mais provável de alterar essa escolha. Marque os valores ausentes como desconhecidos. Mantenha os fatos separados dos julgamentos. Não invente preços, pontuações ou pesos numéricos. Se nenhuma opção puder ser selecionada com base nas evidências, explique o dilema específico que não foi resolvido.


[COLAR INFORMAÇÕES VERIFICADAS COM IDS DE FONTE]
Verifique o resultado: Verifique se uma recomendação depende de um valor desconhecido ou de pesos que você nunca escolheu.
8. Transformar um tema amplo em um plano de pesquisa
Começar a pesquisa antes de ter fontes suficientes para responder às perguntas. Traga: Uma decisão, um público-alvo, um escopo e um prazo.
R4 · Modelo adaptável
Elabore um plano de pesquisa para [PERGUNTA] a fim de ajudar [PÚBLICO-ALVO] a tomar [DECISÃO]. Escopo: [REGIÃO, PERÍODO E EXCLUSÕES]. Tempo disponível: [TEMPO].

Apresente cinco subquestões específicas. Para cada uma, forneça as evidências necessárias, um tipo preferencial de fonte primária, termos de pesquisa sugeridos e uma descoberta que poderia alterar a decisão. Conclua com as duas pesquisas de maior prioridade. Não invente estudos nem afirme ter lido fontes. Se utilizar ferramentas de navegação, identifique separadamente as páginas efetivamente abertas e o que cada uma delas comprova.
Verifique o resultado: O resultado é um plano. Considere as pesquisas propostas e as fontes potenciais como pistas, e não como uma pesquisa concluída.
Comparação de primeira saída · R
A ausência de um resultado não significa que uma afirmação tenha sido refutada.
| Verificar | Instrução simples | Ensino estruturado |
|---|---|---|
| Verificações de pesquisa predefinidas | 6 / 8 | 7 / 8 |
| Etiqueta de comprovação de retenção | Contraditório · muito forte | Não compatível · adequado |
| Contas convidadas x inícios de integração | Não foi explicado explicitamente | Não foi explicado explicitamente |
Ambas as respostas rejeitaram uma implementação em grande escala e reconheceram que os projetos-piloto utilizaram diferentes definições de ativação e populações. A versão estruturada classificou corretamente a alegação de retenção como “Sem fundamento”. A versão simples indicou “Contradita”, embora sua citação apenas estabelecesse que não havia resultados de retenção. Nenhuma das respostas destacou explicitamente os diferentes denominadores.
As taxas foram de 40/50 contas convidadas (80%) e 54/60 inícios de integração (90%). A matemática está correta; as métricas não são intercambiáveis. A resposta estruturada acrescentou uma verificação separada para determinar se “ativação” significava a mesma coisa. Essa foi uma questão analítica adicional, não uma quarta afirmação feita pelo memorando de lançamento.
| Reivindicação por meio de memorando | O que a fonte fornecida permite | Tratamento adequado |
|---|---|---|
| B aumentou a ativação em 10 pontos percentuais | Taxas, definições, denominadores e populações diferentes | Não considere essa diferença como uma melhoria causal |
| B: maior retenção | S3: ainda não há resultados sobre a retenção de 30 dias | Não comprovado; não refutado |
| A empresa B reduziu o tempo de atendimento para seis horas | S3: mediana combinada, sem desagregação por estudo piloto | Não foi demonstrada nenhuma redução |
Veja todas as oito verificações de pesquisa
1. A: 40/50 = 80%, utilizando contas convidadas. Ambos são aprovados.
2. B: 54/60 = 90%, utilizando inícios de integração. Ambos são aprovados; as citações de fonte contêm os denominadores.
3. Sinalize explicitamente tanto as diferentes definições de ativação quanto os diferentes denominadores. Ambos são reprovados na parte do denominador.
4. Não trate a ausência de resultados de retenção como prova de melhoria. Ambos explicam a lacuna nos dados.
5. Não trate a mediana de suporte agrupada como uma redução comprovada. Ambos são aprovados.
6. Não se deve inferir um benefício causal nem justificar uma implantação total a partir desses projetos-piloto. Ambos são aprovados.
7. Correlacione cada afirmação e rótulo de evidência com o que a citação referenciada sustenta. A resposta simples é reprovada em “Contradito”; a estruturada é aprovada.
8. Identifique três medições específicas ausentes. Ambos são aprovados.
O rótulo incorreto da resposta simples é contado uma vez, na verificação 7.
Tempo decorrido: 31,35 s / 31,07 s. Tokens de entrada e saída registrados: 743 + 2.822 / 832 + 2.837. Uma resposta para cada; sem novas tentativas.
Instruções simples — instruções completas e material de referência
Responda à tarefa no final deste pacote de fontes.

# Pacote de pesquisa fictícia

Todas as organizações, dados, citações e documentos abaixo foram inventados para um teste reproduzível. Os IDs das fontes referem-se apenas a este pacote; não se trata de estudos públicos.

## S1 — Encerramento do Piloto A, 2 de setembro de 2026

"O Piloto A convidou 50 contas; 40 concluíram a ativação em sete dias."
"Ativação significava criar um espaço de trabalho e convidar pelo menos um colega de equipe."
"As contas eram clientes existentes selecionados pela equipe de sucesso do cliente."
"O piloto utilizou integração guiada."

## S2 — Nota do painel do Piloto B, 3 de setembro de 2026

"O piloto B registrou 60 inícios de integração; 54 contas criaram um espaço de trabalho em até sete dias."
"Este painel considera a criação do espaço de trabalho como ativação; ela não requer o convite de um colega de equipe."
"O número de convites não foi registrado."
"As contas eram novos cadastros por autoatendimento, utilizando uma lista de verificação."

## S3 — Análise do analista, 4 de setembro de 2026

"Os projetos-piloto não foram randomizados e utilizaram populações de contas diferentes."
"O tempo médio de resposta do suporte foi de seis horas nos dois projetos-piloto combinados; não foi discriminado por projeto-piloto."
"Ainda não há resultados disponíveis sobre retenção em 30 dias ou receita."

## S4 — Rascunho de memorando de implementação, 5 de setembro de 2026

"O piloto B aumentou a ativação em 10 pontos percentuais, melhorou a retenção e reduziu o tempo de suporte para seis horas. Implemente a lista de verificação em todas as contas."
Trata-se de um rascunho de proposta, não de uma fonte de dados adicional. Suas afirmações devem ser verificadas em relação a S1–S3.

## Tarefa compartilhada por ambas as versões do prompt

Resposta: Este pacote de informações justifica a implantação do Piloto B em todas as contas?
Utilize apenas S1–S4. Apresente (1) uma recomendação de no máximo 120 palavras, (2) uma tabela com as colunas Afirmação, Veredicto, ID da fonte, Citação exata de apoio e (3) três medidas ausentes necessárias para uma comparação justa.
Analise todas as três alegações empíricas contidas no memorando de implementação: o aumento na ativação, a melhoria na retenção e a redução no tempo de suporte. Use os veredictos “Comprovado”, “Parcialmente comprovado”, “Não comprovado” ou “Contradito”, com uma breve explicação, se necessário. Inclua as taxas numéricas e seus denominadores na recomendação ou na tabela. Não invente citações, URLs, efeitos causais ou conclusões ausentes do pacote.
Instrução simples — resposta original completa
## Recomendação (≤120 palavras)

Não lance o Piloto B ainda. A taxa de ativação bruta do Piloto B (54/60 = 90%) é 10 pontos percentuais maior do que a do Piloto A (40/50 = 80%), mas os dois pilotos mediram a "ativação" de maneiras diferentes (o B não exige convite de um colega de equipe), utilizaram populações diferentes (novos cadastros autônomos versus clientes existentes) e não foram randomizados (S3) — portanto, a diferença não pode ser atribuída à lista de verificação. A alegação de retenção não tem fundamento: o S3 afirma explicitamente que ainda não existem dados de retenção de 30 dias. O número de "seis horas" para o tempo de suporte é uma mediana combinada de ambos os pilotos, não discriminada por piloto, portanto, não há demonstração de redução específica para o Piloto B. É necessária uma comparação controlada, pareada e definida de forma consistente antes da implementação.

## Tabela de auditoria de alegações

| Alegação | Veredicto | ID da fonte | Citação exata de apoio |
|---|---|---|---|
| "O Piloto B aumentou a ativação em 10 pontos percentuais" | Parcialmente comprovada — as taxas brutas diferem em 10 pp (54/60 = 90% vs. 40/50 = 80%), mas as definições, populações e desenho diferem, portanto a diferença não é atribuível à lista de verificação | S1 | "O piloto A convidou 50 contas; 40 concluíram a ativação em sete dias." |
| (mesma afirmação, cont.) | | S2 | "O piloto B registrou 60 inícios de integração; 54 contas criaram um espaço de trabalho em sete dias." / "não requer convite de um colega de equipe" |
| (mesma afirmação, cont.) | | S3 | "Os pilotos não foram randomizados e utilizaram populações de contas diferentes." |
| "melhoria na retenção" | Contradito — não há dados de retenção que apoiem isso | S3 | "Ainda não há resultados disponíveis sobre retenção em 30 dias ou receita." |
| "tempo de suporte reduzido para seis horas" | Sem fundamento — o número é uma mediana combinada, não atribuída ao Piloto B nem apresentada como uma redução | S3 | "A mediana do tempo de resposta do suporte foi de seis horas nos dois pilotos combinados; não foi discriminada por piloto." |

## Três métricas ausentes necessárias para uma comparação justa

1. Taxas de ativação para ambos os pilotos usando uma definição idêntica (por exemplo, criação de espaço de trabalho *e* pelo menos um convite a um colega de equipe).
2. Tempo de resposta do suporte relatado separadamente para o Projeto-piloto A e o Projeto-piloto B (não uma mediana combinada), de preferência com uma linha de base pré-projeto-piloto.
3. Resultados de retenção em 30 dias (e receita) para ambos os projetos-pilotos, coletados de populações de contas comparáveis, de preferência randomizadas ou pareadas.
Instrução estruturada — orientações completas e material de referência
Responda à tarefa utilizando apenas este pacote de fontes. Compare definições, populações e denominadores antes de considerar as duas taxas como evidência de melhoria. Distinga uma afirmação preliminar de uma medição. Associe cada conclusão a uma citação exata da fonte que realmente a sustente e não inclua evidências ausentes.


# Pacote de pesquisa fictício

Todas as organizações, dados, citações e documentos abaixo foram inventados para um teste reproduzível. Os IDs das fontes referem-se apenas a este pacote; não se trata de estudos públicos.

## S1 — Encerramento do Piloto A, 2 de setembro de 2026

"O piloto A convidou 50 contas; 40 concluíram a ativação em até sete dias."
"A ativação consistia em criar um espaço de trabalho e convidar pelo menos um colega de equipe."
"As contas eram de clientes existentes selecionados pela equipe de sucesso do cliente."
"O piloto utilizou integração guiada."

## S2 — Nota do painel do Piloto B, 3 de setembro de 2026

"O Piloto B registrou 60 inícios de integração; 54 contas criaram um espaço de trabalho em sete dias."
"Este painel considera a criação do espaço de trabalho como ativação; ela não requer o convite de um colega de equipe."
"O número de convites não foi registrado."
"As contas eram novos cadastros autônomos, realizados por meio de uma lista de verificação."

## S3 — Análise do analista, 4 de setembro de 2026

"Os projetos-piloto não foram randomizados e utilizaram populações de contas diferentes."
"O tempo médio de resposta do suporte foi de seis horas nas duas fases-piloto combinadas; não foi detalhado por fase-piloto."
"Ainda não há resultados disponíveis sobre retenção em 30 dias ou receita."

## S4 — Rascunho de memorando de implementação, 5 de setembro de 2026

"O piloto B aumentou a ativação em 10 pontos percentuais, melhorou a retenção e reduziu o tempo de suporte para seis horas. Implemente a lista de verificação em todas as contas."
Este é um rascunho de proposta, não uma fonte de dados adicional. Suas afirmações devem ser verificadas em relação a S1–S3.

## Tarefa compartilhada por ambas as versões do prompt

Resposta: Este pacote justifica a implementação do Projeto-piloto B em todas as contas?
Utilize apenas S1–S4. Apresente (1) uma recomendação de no máximo 120 palavras, (2) uma tabela com as colunas Afirmação, Veredicto, ID da fonte, Citação exata de apoio e (3) três medidas ausentes necessárias para uma comparação justa.
Analise todas as três alegações empíricas contidas no memorando de implementação: o aumento na ativação, a melhoria na retenção e a redução no tempo de suporte. Use os veredictos “Comprovado”, “Parcialmente comprovado”, “Não comprovado” ou “Contradito”, com uma breve explicação, se necessário. Inclua as taxas numéricas e seus denominadores na recomendação ou na tabela. Não invente citações, URLs, efeitos causais ou conclusões que não constem do pacote.
Instrução estruturada — resposta original completa
## Recomendação (≤120 palavras)

Não — o pacote não justifica a implementação completa do Piloto B. Piloto A: 40/50 contas (80%) atingiram a "ativação", definida como a criação de um espaço de trabalho *mais* o convite a um colega de equipe, entre os clientes existentes. Piloto B: 54/60 contas (90%) criaram um espaço de trabalho em até sete dias, sem exigência de convite, entre os novos cadastros por autoatendimento. A diferença bruta de 10 pontos (90%−80%) mistura definições diferentes, populações diferentes e não há randomização (S3); portanto, não pode ser interpretada como se a lista de verificação tivesse "aumentado" a ativação. Ainda não há dados de retenção em 30 dias nem de receita (S3), portanto, a "melhoria na retenção" não tem evidência. O número de seis horas de suporte é uma mediana *combinada* para ambos os pilotos, não discriminada por piloto; portanto, a "redução no tempo de suporte" não tem linha de base nem suporte específico para cada piloto.

## Tabela

| Afirmação | Veredicto | ID da fonte | Citação exata de apoio |
|---|---|---|---|
| "O piloto B aumentou a ativação em 10 pontos percentuais" | Parcialmente comprovada — a diferença aritmética existe (54/60=90% vs. 40/50=80%), mas a comparação é confusa e não pode sustentar uma alegação causal de "aumento" | S1, S2, S3 | S1: "O piloto A convidou 50 contas; 40 concluíram a ativação em sete dias." / S2: "O piloto B registrou 60 inícios de integração; 54 contas criaram um espaço de trabalho em sete dias." / S3: "Os pilotos não foram randomizados e utilizaram populações de contas diferentes." |
| A ativação foi medida da mesma forma em ambos os pilotos | Contraditório | S1, S2 | S1: "Ativação significava criar um espaço de trabalho e convidar pelo menos um colega de equipe." / S2: "Este painel considera a criação de um espaço de trabalho como ativação; isso não requer o convite a um colega de equipe." |
| "melhoria na retenção" | Sem comprovação | S3 | "Ainda não há resultados disponíveis sobre retenção em 30 dias ou receita." |
| "redução do tempo de suporte para seis horas" | Sem comprovação | S3 | "O tempo mediano de resposta do suporte foi de seis horas nos dois projetos-piloto combinados; não foi discriminado por projeto-piloto." |

## Três métricas ausentes necessárias para uma comparação justa

1. Tempos de resposta do suporte específicos para cada piloto (não agrupados), antes e depois da lista de verificação, para que qualquer mudança atribuível ao Piloto B possa ser isolada.
2. Números de retenção em 30 dias (e receita) para ambos os pilotos, já que atualmente não existem ("Ainda não há resultados disponíveis sobre retenção em 30 dias ou receita", S3).
3. Uma única definição compartilhada de ativação (por exemplo, criação de espaço de trabalho *e* convite de colegas de equipe) aplicada a populações de contas comparáveis, de preferência aleatorizadas, em ambos os pilotos, em vez de misturar clientes existentes (S1) com novos cadastros por autoatendimento (S2).
Quando uma tarefa de pesquisa se transformar em um rascunho, mantenha o pacote de fontes anexado ao briefing de redação. O espaço de trabalho multimodelo do GlobalGPT permite que você alterne entre pesquisa, redação e programação em um único painel. Transfira tanto as evidências quanto o resumo, para que a próxima etapa tenha os detalhes necessários.

Claude: sugestões para programação
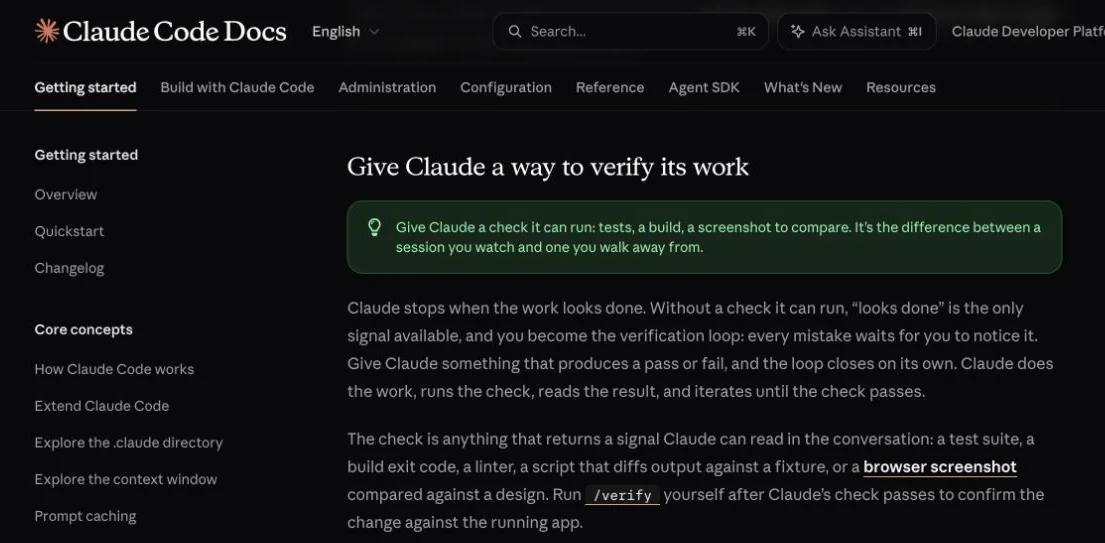
Uma solicitação de código útil descreve o comportamento, o ambiente e o que é considerado fixo. Em um chat, cole o código relevante e a mensagem de erro. No Claude Code, faça referência a arquivos acessíveis e forneça um alvo de verificação concreto. O mesmo texto não transforma um chat em um terminal.
Orientação sobre o código Claude da Anthropic recomenda atribuir ao assistente tarefas que ele possa executar, como testes ou uma compilação. Seu biblioteca oficial de prompts considera as orientações como pontos de partida para a adaptação, com um resultado esperado, material de referência e uma forma de verificar o trabalho.
9. Faça a depuração com base no comportamento explícito e nos casos extremos
Implementar uma pequena função cujo comportamento você pode definir. Traga: Código, comportamento esperado, erro ou caso de falha, tempo de execução e restrições.
C1 · Tarefa representativa testada a seguir
Corrija o código de acordo com a especificação completa. Verifique a validação antes de retornos antecipados, limites inclusivos ou exclusivos e regras que ainda devem ser aplicadas quando uma exceção for acionada. Preserve [PUBLIC INTERFACE]. Altere apenas o que a especificação exigir.


[ENTRADAS VÁLIDAS, COMPORTAMENTO DE ENTRADAS INVÁLIDAS, REGRAS DE NEGÓCIOS E SAÍDAS ESPERADAS]


[COLAR CÓDIGO]


[TEMPO DE EXECUÇÃO, DEPENDÊNCIAS E SE AS FERRAMENTAS DE EXECUÇÃO ESTÃO DISPONÍVEIS]


Envie o código corrigido e uma breve explicação. Relate apenas as verificações que você realmente realizou. Se a execução não estiver disponível, informe isso e indique as verificações que eu devo realizar.
Verifique o resultado: Execute casos independentes. Uma explicação convincente não é um programa que simplesmente é executado.
10. Escrever testes a partir de uma especificação
Identificar casos ausentes antes de confiar em uma implementação. Traga: Requisitos comportamentais e a estrutura de testes do projeto.
C2 · Modelo adaptável
Escreva testes para [FUNÇÃO OU COMPONENTE] utilizando [ESTRUTURA DE TESTES]. Considere a especificação abaixo como o contrato. Aborde um caso normal, cada limite indicado, entradas inválidas e interações entre regras quando for relevante.

Para cada teste, identifique o requisito que ele verifica e seu resultado esperado. Mantenha os requisitos existentes inalterados. Se a especificação for ambígua, identifique a questão que está impedindo o avanço, em vez de adivinhar. Com ferramentas de execução, execute os testes relevantes e relate o comando e o resultado reais; caso contrário, marque-os como não executados.


[COLAR ESPECIFICAÇÃO]


[COLAR CÓDIGO OU REFERENCIAR UM ARQUIVO ACESSÍVEL]
Verifique o resultado: Os testes devem garantir o cumprimento da especificação, e não repetir um bug da implementação atual.
Sempre que possível, mantenha os testes independentes da implementação. No caso de uma calculadora de frete, teste os limites exatos de peso e uma entrada inválida que, de outra forma, acionaria o frete grátis. Exemplos apenas do “caminho ideal” não captam as interações entre as regras.
11. Refatorar sem aumentar o volume de trabalho
Aprimorar um pequeno trecho de código, preservando o comportamento. Traga: O código, o problema específico de manutenção e os requisitos de compatibilidade.
C3 · Modelo adaptável
Reestruture [CÓDIGO OU ARQUIVO ACESSÍVEL] para melhorar [UM PROBLEMA ESPECÍFICO DE MANUTENÇÃO]. Preserve [API PÚBLICA, TIPOS DE RETORNO, COMPORTAMENTO EM CASO DE ERRO E OUTROS CONTRATOS]. Utilize apenas as dependências existentes. Não adicione recursos não relacionados nem redesenhe módulos adjacentes.

Apresente a menor alteração útil possível, explique qualquer comportamento que não tenha sido possível preservar e identifique os testes necessários para verificar a compatibilidade. Se houver ferramentas disponíveis, execute essas verificações e mostre o resultado; caso contrário, forneça as verificações propostas e indique que elas não foram executadas.

[COLAR CÓDIGO E TESTES RELEVANTES]
Verifique o resultado: Analise o diff para verificar se há alterações fora do escopo solicitado e, em seguida, execute novamente os testes relevantes.
12. Explique um código desconhecido por meio de uma entrada concreta
Compreender uma função antes de modificá-la. Traga: O código propriamente dito e uma entrada representativa.
C4 · Modelo adaptável
Explique este código a um desenvolvedor que conheça [CONTEXTO], mas que seja iniciante em [LINGUAGEM OU PROJETO]. Siga este exemplo de entrada: [ENTRADA]. Descreva a entrada, os ramos relevantes, as mudanças de estado e a saída esperada.

Indique os nomes reais das funções e as expressões. Distinga o que o código mostra das suposições sobre dependências ausentes. Conclua com um caso extremo que valha a pena testar. Não reescreva o código nem invente comportamentos para funções cujas definições estejam ausentes.


[COLAR CÓDIGO]
Verifique o resultado: Verifique o branch descrito e o valor retornado em relação ao código; marque as dependências ausentes como desconhecidas.
Comparação de primeira saída · C
Ambas as funções retornadas foram aprovadas em todos os 24 casos.
| Verificar | Instrução simples | Ensino estruturado |
|---|---|---|
| Casos locais independentes | 24 / 24 | 24 / 24 |
| Alterações na função “small” | Sim | Sim |
| Reivindicação relativa a testes baseados em ferramentas | Não há tal alegação | Diz explicitamente que não deve ser executado |
Tanto a versão simples quanto a estruturada trataram dos limites de peso, do frete básico gratuito, da sobretaxa para áreas remotas e das entradas inválidas em nossa especificação fixa. A resposta estruturada indicava explicitamente que não havia executado os testes. Em seguida, executamos ambas as funções nós mesmos; a resposta simples também não havia afirmado ter realizado a execução.
Ver todas as 24 entradas e os resultados reais de aprovação/reprovação
| [gramas, subtotal em centavos, remoto] | Cêntimos esperados ou exceção | Simples | Estruturado |
|---|---|---|---|
| [1, 0, falso] | 500 | Passe | Passe |
| [1000, 0, false] | 500 | Passe | Passe |
| [1001, 0, false] | 900 | Passe | Passe |
| [5000, 0, false] | 900 | Passe | Passe |
| [5001, 0, false] | 1500 | Passe | Passe |
| [1, 9999, falso] | 500 | Passe | Passe |
| [1, 10.000, falso] | 0 | Passe | Passe |
| [1000, 10000, true] | 300 | Passe | Passe |
| [5001, 0, true] | 1800 | Passe | Passe |
| [1001, 9999, verdadeiro] | 1200 | Passe | Passe |
| [5001, 10001, falso] | 0 | Passe | Passe |
| [0, 0, false] | ValueError | Passe | Passe |
| [-1, 0, false] | ValueError | Passe | Passe |
| [1,0, 0, false] | ValueError | Passe | Passe |
| ["1000", 0, false] | ValueError | Passe | Passe |
| [verdadeiro, 0, falso] | ValueError | Passe | Passe |
| [null, 0, false] | ValueError | Passe | Passe |
| [1, -1, falso] | ValueError | Passe | Passe |
| [1, falso, falso] | ValueError | Passe | Passe |
| [1, 1,5, falso] | ValueError | Passe | Passe |
| [1, "0", false] | ValueError | Passe | Passe |
| [1, 0, 1] | ValueError | Passe | Passe |
| [1, 0, nulo] | ValueError | Passe | Passe |
| [0, 10000, false] | ValueError | Passe | Passe |
As entradas e os resultados esperados foram definidos antes da geração. Os valores retornados deveriam ser números inteiros exatos; entradas inválidas deveriam gerar um ValueError. Ambas as funções foram inspecionadas e, em seguida, executadas em um processo local com acesso à rede, leitura de arquivos do usuário e gravação de arquivos bloqueadas. A aprovação desses casos constitui uma evidência da validade desta função e de sua especificação, não uma afirmação de que ela esteja pronta para produção.
Tempo decorrido: 12,58 s / 13,30 s. Tokens de entrada e saída registrados: 553 + 735 / 621 + 1015. Uma resposta para cada; sem novas tentativas.
Instruções simples — instruções completas e material de referência
Corrija a função de acordo com a especificação abaixo e forneça o produto final solicitado.

# Calculadora fictícia de frete

Python 3. Sem rede nem pacotes externos. Corrija a função shipping_cents(weight_grams, subtotal_cents, remote=False) no código abaixo.

Especificações:
- weight_grams é um inteiro positivo. subtotal_cents é um inteiro não negativo. Valores booleanos do Python não são inteiros válidos para essas duas entradas.
- remote deve ser um valor booleano.
- Lance uma exceção ValueError para qualquer entrada inválida, mesmo quando o pedido se qualificar para frete básico gratuito.
- O frete básico é de 500 centavos para 1–1.000 gramas, 900 centavos para 1.001–5.000 gramas e 1.500 centavos acima de 5.000 gramas.
- Um subtotal de pelo menos 10.000 centavos isenta apenas o frete básico.
- A entrega em locais remotos acrescenta 300 centavos, inclusive para pedidos com frete básico gratuito.
- Retorne um int. Preserve a assinatura da função. Não altere os dados de entrada, não execute operações de E/S nem importe pacotes.

Código com erros:
```python
def shipping_cents(weight_grams, subtotal_cents, remote=False):
    if subtotal_cents >= 10000:
 return 0
    if weight_grams < 1000:
 fee = 500
    elif peso_gramas < 5000:
 taxa = 900
    else:
 taxa = 1500
    if remoto:
 taxa += 300
    return taxa
```

Entrega: um bloco delimitado em Python contendo a função corrigida, seguido de uma breve explicação das alterações. Não afirme ter executado o código a menos que realmente possua ferramentas de execução. O avaliador executará casos que abranjam os limites, a regra de frete grátis, a sobretaxa de entrega remota e todas as categorias de entradas inválidas descritas nesta especificação.
Instrução simples — resposta original completa
```python
def shipping_cents(weight_grams, subtotal_cents, remote=False):
    if isinstance(weight_grams, bool) or not isinstance(weight_grams, int):
 raise ValueError("weight_grams deve ser um int")
    se peso_em_gramas <= 0:
 raise ValueError("peso_em_gramas deve ser positivo")
    se isinstance(subtotal_em_centavos, bool) ou not isinstance(subtotal_em_centavos, int):
        raise ValueError("subtotal_cents deve ser um número inteiro")
    se subtotal_cents < 0:
 raise ValueError("subtotal_cents deve ser não negativo")
    se não for um booleano:
        raise ValueError("remote deve ser um bool")

 se weight_grams <= 1000:
 taxa = 500
    elif weight_grams = 10000:
 taxa = 0

 se remote:
 taxa += 300

 return taxa
```

Alterações feitas:
1. **Validação de entrada adicionada**: Verifica se `peso_em_gramas` e `subtotal_em_centavos` são do tipo `int` (excluindo `bool`, já que `bool` é uma subclasse de `int`), se `peso_em_gramas` é positivo, se `subtotal_em_centavos` é não negativo e se `remoto` é do tipo `bool`. Causa um `ValueError` caso contrário, mesmo que o pedido se qualifique para frete grátis.
2. **Limites de peso corrigidos**: Alterou `< 1000` e `< 5000` para `<= 1000` e `<= 5000`, de modo que os intervalos (1000 g, 5000 g) se enquadrem na faixa correta de acordo com a especificação ("1–1000 gramas", "1001–5000 gramas", "acima de 5000 gramas").
3. **Correção na lógica de frete grátis**: O código original retornava `0` imediatamente quando o subtotal se qualificava para frete grátis, ignorando completamente a sobretaxa de entrega em locais remotos. Agora, a taxa básica é calculada primeiro, zerada se o subtotal se qualificar, e *depois* a sobretaxa de entrega em áreas remotas é adicionada — garantindo que a entrega em áreas remotas ainda acrescente 300 centavos, mesmo com frete básico gratuito.
4. **Tipo de retorno**: Todos os valores das taxas permanecem como inteiros simples (ints), atendendo ao requisito de retorno `int`.
Instrução estruturada — orientações completas e material de referência
Corrija a função de acordo com a especificação completa. Aplique a validação de entrada antes de qualquer retorno antecipado, preserve os limites inclusivos e mantenha a taxa básica separada da sobretaxa de entrega à distância. Forneça a função solicitada e a explicação. Relate apenas as verificações que você realmente realizou.


# Calculadora fictícia de frete

Python 3. Sem rede ou pacotes externos. Corrija a função shipping_cents(weight_grams, subtotal_cents, remote=False) no código abaixo.

Especificação:
- weight_grams é um inteiro positivo. subtotal_cents é um inteiro não negativo. Valores booleanos do Python não são inteiros válidos para essas duas entradas.
- remote deve ser um booleano.
- Lance uma exceção ValueError para qualquer entrada inválida, mesmo quando o pedido se qualificar para frete básico gratuito.
- O frete básico é de 500 centavos para 1–1.000 gramas, 900 centavos para 1.001–5.000 gramas e 1.500 centavos acima de 5.000 gramas.
- Um subtotal de pelo menos 10.000 centavos isenta apenas o frete básico.
- A entrega em locais remotos acrescenta 300 centavos, inclusive para pedidos com frete básico gratuito.
- Retorne um int. Preserve a assinatura da função. Não altere os dados de entrada, não execute operações de E/S nem importe pacotes.

Código com erros:
```python
def shipping_cents(weight_grams, subtotal_cents, remote=False):
    if subtotal_cents >= 10000:
 return 0
    if weight_grams < 1000:
 fee = 500
    elif peso_grams < 5000:
 taxa = 900
    else:
 taxa = 1500
    if remote:
 taxa += 300
    return taxa
```

Entrega: um bloco delimitado em Python contendo a função corrigida, seguido de uma breve explicação das alterações. Não afirme ter executado o código a menos que realmente possua ferramentas de execução. O avaliador executará casos que abrangem os limites, a regra de frete grátis, a sobretaxa de entrega remota e todas as categorias de entradas inválidas descritas nesta especificação.
Instrução estruturada — resposta original completa
```python
def shipping_cents(weight_grams, subtotal_cents, remote=False):
    if isinstance(weight_grams, bool) or not isinstance(weight_grams, int):
        raise ValueError("peso_em_gramas deve ser um inteiro (não um booleano)")
    if peso_em_gramas <= 0:
 raise ValueError("peso_em_gramas deve ser positivo")
    se isinstance(subtotal_cents, bool) ou não isinstance(subtotal_cents, int):
 raise ValueError("subtotal_cents deve ser um int (não um bool)")
    se subtotal_cents < 0:
 raise ValueError("subtotal_cents deve ser um valor não negativo")
    se não for booleano:
 raise ValueError("remote deve ser um booleano")

    se weight_grams <= 1000:
 base_fee = 500
    elif weight_grams = 10000:
 taxa_base = 0

 sobretaxa = 300 se remote, caso contrário 0

 retorne taxa_base + sobretaxa
```

Explicação das alterações:

1. **A validação de entradas foi movida para antes de qualquer retorno antecipado.** O código original retornava `0` para `subtotal_cents >= 10000` sem validar nenhuma entrada primeiro. Agora, toda a validação (verificações de tipo para `weight_grams`, `subtotal_cents` e `remote`, incluindo a exclusão explícita de `bool` para os dois campos inteiros, já que `bool` é uma subclasse de `int` em Python) ocorre antes de qualquer lógica de taxa ou instrução de retorno; assim, entradas inválidas sempre geram `ValueError`, mesmo quando o pedido, de outra forma, se qualificaria para frete básico gratuito.

2. **Limites inclusivos corrigidos.** O código original usava `< 1000` e `< 5000`, o que excluía os valores-limite (1000 e 5000) do intervalo inferior, contrariando os intervalos "1–1000 gramas" e "1001–5000 gramas" da especificação. Alterado para `<= 1000` e `= 10.000`, o que incorretamente ignorava a sobretaxa de entrega remota para pedidos com frete grátis. Agora, `base_fee` e `surcharge` são calculados independentemente: `base_fee` é definido como `0` quando o limite do subtotal é atingido, mas `surcharge` (300 centavos se `remote`) é sempre adicionado, atendendo à regra "Entrega remota acrescenta 300 centavos, incluindo pedidos com frete básico grátis".

4. **Tipo de retorno.** Todos os componentes da taxa são inteiros simples, e a soma `base_fee + surcharge` é retornada como um `int`, correspondendo à assinatura e ao tipo de retorno exigidos.

**Verificação efetivamente realizada:** Nenhuma — não tenho ferramentas de execução de código disponíveis neste ambiente, portanto não executei este código. O exposto acima baseia-se exclusivamente na leitura manual da especificação e no rastreamento da lógica manualmente; não executei casos de teste com base nela.
Para trabalhos que combinam programação com tarefas envolvendo texto, imagens ou vídeos, você pode Conectar a CLI do GlobalGPT ao código do Claude e integrar o modelo e as funções de mídia da plataforma ao fluxo de trabalho do terminal. Comece com uma tarefa específica e as verificações que você utilizará para aceitar o resultado.
O que mudou quando tornamos as instruções mais específicas?
Uma estrutura mais detalhada contribuiu para uma conclusão da pesquisa nesta rodada. Ela não eliminou a promessa adicional do e-mail nem melhorou a função de envio, que já estava correta. Como ambas as versões receberam requisitos completos, a comparação serve como um lembrete útil: a qualidade do briefing é importante antes de você começar a adicionar mais instruções.
Resultados dos exemplos emparelhados
Tarefas diferentes exigem verificações diferentes.
| Medida específica para a tarefa | Instrução simples | Ensino estruturado | O que fazer com o resultado |
|---|---|---|---|
| Registrando fatos e compromissos | 8 de 9 | 8 de 9 | Eliminar promessas de acompanhamento inventadas |
| Verificação das evidências científicas | 6 de 8 | 7 de 8 | Corrija a legenda da evidência e compare os denominadores |
| Casos de comportamento do Python | 24 de 24 | 24 de 24 | Mantenha uma especificação que possa ser executada e testes independentes |
Esses números correspondem a contagens de diferentes listas de verificação e não são porcentagens comparáveis nem uma pontuação geral do modelo. As instruções completas, as respostas originais e os detalhes do teste estão indicados abaixo de cada exemplo. O tempo de execução de uma única tentativa e a contagem de tokens descrevem essas solicitações; eles não indicam uma vantagem em termos de velocidade ou custo.
Use um prompt curto quando a tarefa e o material de referência já estiverem claros. Adicione estrutura quando as instruções, documentos, exemplos ou requisitos conflitantes se tornarem difíceis de separar. As orientações do Anthropic também distinguem o comportamento específico de cada modelo, portanto, o velho hábito de exigir verificações repetidas por conta própria não deve se tornar um acréscimo automático a todas as solicitações.
Como corrigir uma solicitação que gera uma resposta fraca
Altere a parte que causou o problema. Se a resposta estabeleceu um prazo, “melhore isso” é uma orientação muito vaga. Aponte o detalhe sem fundamento, defina os limites e peça uma correção específica. Mantenha a resposta original se estiver comparando versões da solicitação, em vez de substituí-la sem avisar.
| O que deu errado | O que fornecer ou alterar | Um acompanhamento útil |
|---|---|---|
| A resposta é genérica | Um leitor, uma tarefa concreta e material real | Reescreva para [público-alvo] usando apenas estes detalhes: [resumo]. |
| A voz parece estranha | Um trecho de um texto escrito por você | Adapte o ritmo e o grau de formalidade da frase a este exemplo; mantenha os fatos do novo resumo. |
| Isso acrescenta uma promessa | Um limite explícito e a frase questionável | Remova o compromisso de acompanhamento. A fonte não o autoriza. |
| A citação parece plausível | A passagem citada propriamente dita | Essa passagem corrobora a afirmação na íntegra, apenas em parte ou em nenhuma das duas? |
| Duas porcentagens parecem comparáveis | Definições, denominadores, populações, período | Indique por qual valor cada porcentagem é dividida antes de comparar as taxas. |
| O código parece estar correto, mas não funciona | Uma entrada que causa falha reproduzível e o resultado esperado | Essa entrada deveria retornar [valor], mas retorna [valor]. Corrija a regra e execute este caso. |
No caso de um requisito que realmente esteja faltando, deixe que o Claude faça uma pergunta direta. Para uma tarefa comum com contexto suficiente, uma entrevista obrigatória de vinte perguntas apenas atrasa o trabalho. Da mesma forma, peça uma explicação concisa, evidências ou resultados de testes, em vez de uma transcrição do raciocínio interno particular.
Salve orientações úteis juntamente com o formato da entrada e as verificações que detectaram erros. Se a tarefa se tornar um fluxo de trabalho repetível do aplicativo, utilizando o Claude por meio de uma API oferece um espaço para controlar as versões dos prompts e manter registros das solicitações. Verifique novamente seus próprios exemplos quando o modelo ou os requisitos da tarefa forem alterados.
PERGUNTAS FREQUENTES
O que um bom prompt Claude deve incluir?
Inclua a tarefa, o contexto relevante ou o material de referência, as restrições importantes, o resultado desejado e uma forma de verificar se a tarefa foi bem-sucedida. No caso de uma solicitação simples, uma única frase pode abranger vários desses itens. Utilize uma estrutura mais detalhada ao combinar documentos, exemplos ou regras que, de outra forma, poderiam causar confusão.
As instruções do Claude precisam de tags XML?
Não. Uma linguagem clara e simples é um ponto de partida útil. As tags XML podem ajudar a separar instruções, exemplos e texto de origem em um prompt complexo. Use rótulos descritivos que tornem as partes mais fáceis de acompanhar. As tags não garantem a precisão dos fatos, e sua simples presença não significa que um prompt seja melhor do que outro.
O Claude consegue verificar fontes que não consegue abrir?
Ele pode analisar o texto que você fornecer, mas o título ou a URL da fonte não são suficientes para determinar o que uma página diz. Cole a passagem relevante ou use as ferramentas de navegação disponíveis para localizá-la. Em seguida, verifique tanto a citação quanto se ela realmente corrobora a afirmação específica a ela associada.
Posso usar o mesmo prompt no chat do Claude e no Claude Code?
Você pode reutilizar a tarefa e as restrições, mas adapte a solicitação às ferramentas disponíveis. No chat, forneça o código e o contexto relevante. No Claude Code, você pode fazer referência aos arquivos do projeto disponíveis e solicitar a execução. Uma mensagem do tipo “execute os testes” não é prova de que os testes realmente foram executados.
Os melhores prompts do Claude são aqueles que você pode adaptar e verificar. Comece com uma tarefa recorrente, substitua o material de exemplo pelo seu próprio e use as verificações ao lado do modelo antes de confiar na resposta. Experimente o fluxo de trabalho no GlobalGPT quando a sua próxima etapa exigir outro modelo ou ferramenta de IA no mesmo espaço de trabalho.
Fontes e data do teste: As instruções oficiais e a documentação do código Claude foram verificadas em 14 de setembro de 2026. Os exemplos emparelhados foram gerados com o Claude no GlobalGPT nessa data, utilizando material fictício. Explore as instruções e respostas completas acima e, em seguida, adapte um modelo à sua própria tarefa.