
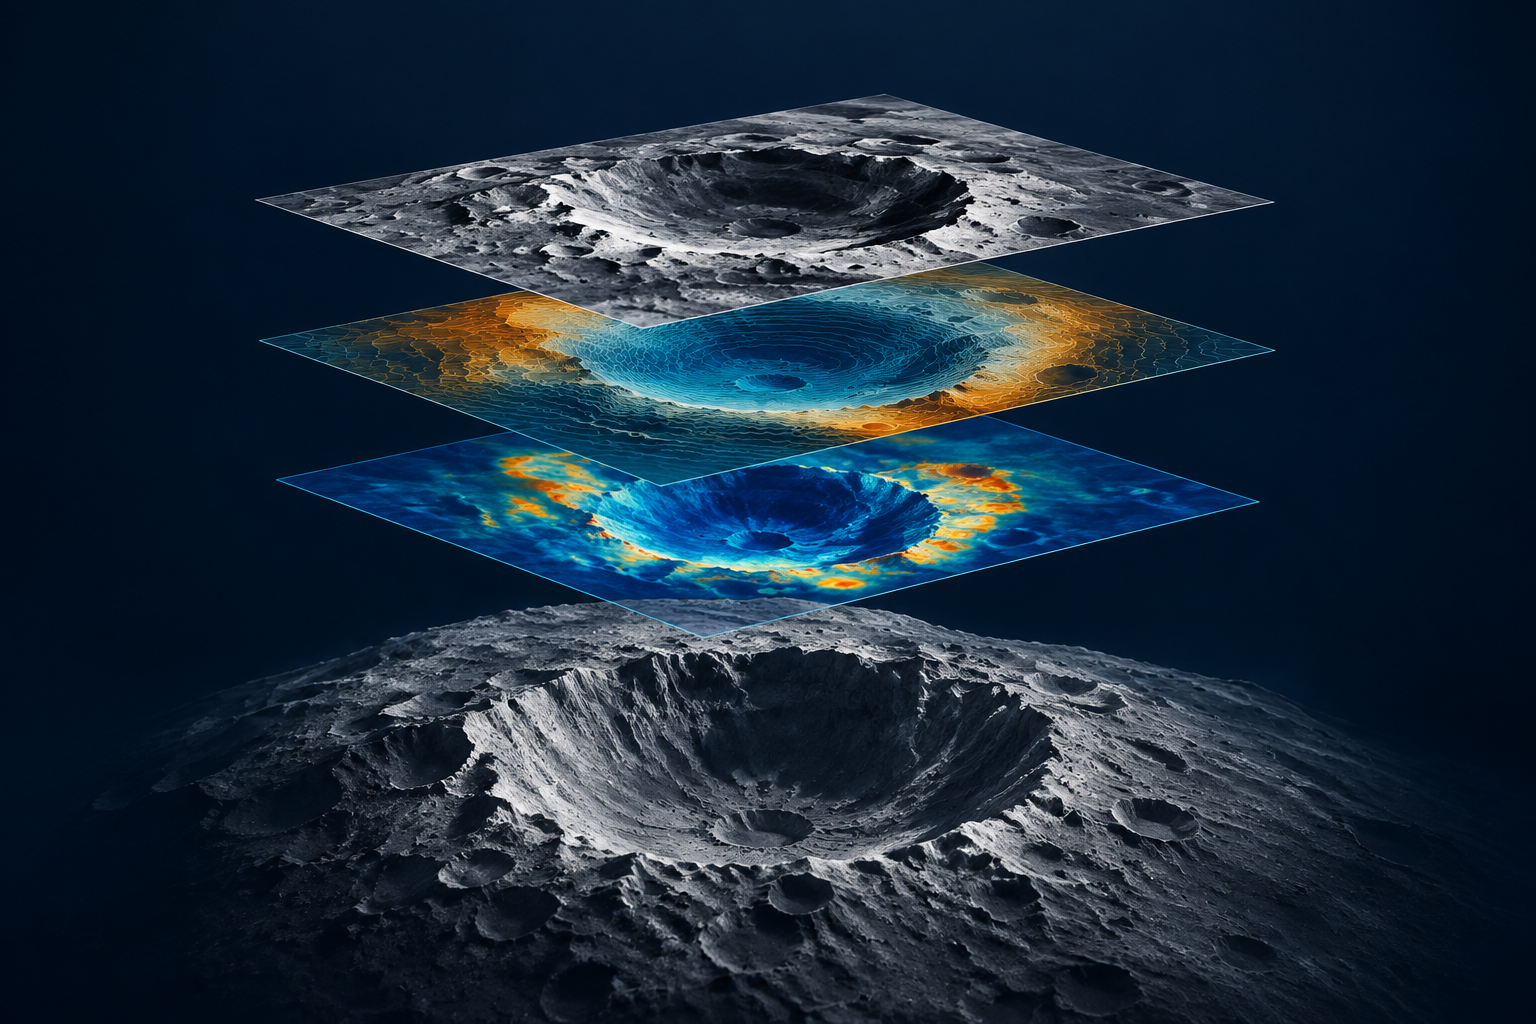
O Modelo Lunar da Fundação NASA-IBM é um modelo de IA aberto para a análise de observações lunares. Anunciado em 10 de setembro de 2026, ele pode ser adaptado para detectar crateras, delinear características vulcânicas e prever padrões em um mapa de prospectividade de gelo. Os ganhos relatados referem-se a parâmetros específicos de pesquisa: o principal resultado em relação ao gelo é um menor erro de previsão, e não a descoberta de mais água na Lua.
Para estudantes e pesquisadores, os pontos de partida úteis são os ficha técnica oficial, o relatório técnico e o código disponibilizado. Juntos, eles explicam o que o modelo aprendeu, quais tarefas foram avaliadas e o que você precisaria para montar seu próprio experimento.
Se a sua primeira tarefa for compreender a pesquisa, GlobalGPT reúne a descoberta de fontes, a análise de documentos, o raciocínio e a redação em um único espaço de trabalho multimodelo. Oferece uma maneira acessível de passar de termos científicos desconhecidos a um resumo de pesquisa claro por meio de uma única assinatura.

O que é o Modelo de Fundação Lunar da NASA-IBM?
Anúncio da NASA apresenta o projeto como um modelo de base para a ciência lunar, desenvolvido em parceria com a IBM. Um modelo de base aprende padrões reutilizáveis a partir de um amplo conjunto de dados; em seguida, os pesquisadores adaptam esses padrões a uma tarefa mais específica. Neste caso, o material consiste em dados de sensoriamento remoto lunar, e não na linguagem cotidiana.
O LFM da NASA-IBM utiliza um codificador e um decodificador do tipo Vision Transformer, com uma arquitetura ViT-B. Suas entradas incluem imagens e outros produtos de observação em diferentes resoluções espaciais. Um cientista pode adaptar a representação resultante para detecção, segmentação ou regressão — três maneiras de localizar objetos, delimitar regiões e prever valores numéricos.
Isso torna o lançamento útil para equipes que trabalham com mapas lunares e para estudantes que se dedicam ao aprendizado de máquina planetário. A leitura do projeto também vale a pena para quem quer entender como um modelo científico de IA é avaliado. O uso de seu ponto de verificação, no entanto, constitui um fluxo de trabalho de computação científica, e não uma conversa por chat.
Com base em quais dados ele aprende?
O ficha técnica descreve os dados de treinamento do SomBench: 963.609 conjuntos de blocos de imagens da câmera de ângulo amplo (WAC) e 1.000.113 conjuntos de blocos de imagens da câmera de ângulo estreito (NAC). A escala da WAC é de cerca de 100 metros por pixel; a escala da NAC é de cerca de 1 metro por pixel. Isso proporciona ao modelo tanto um contexto mais amplo do terreno quanto detalhes de superfície muito mais precisos, em aproximadamente dois milhões de conjuntos.
A IBM descreve o recurso de dados mais abrangente como mais de 30 camadas alinhadas provenientes de nove instrumentos em quatro missões. A ficha do modelo especifica 11 modalidades de entrada. Essas figuras descrevem diferentes etapas do fluxo de dados: camadas de origem, exemplos de treinamento agrupados e tipos de entrada que o modelo codifica.
Um projeto, três unidades de contagem diferentes
A IBM descreve um conjunto de dados compilado a partir de nove instrumentos de quatro missões.
963.609 pacotes WAC e 1.000.113 pacotes NAC oferecem duas escalas de material de treinamento.
O modelo codifica diferentes tipos de observações, incluindo imagens e produtos topográficos.
Camadas de fonte, pacotes de blocos e modalidades de entrada referem-se a conceitos diferentes. Fontes: Descrição do conjunto de dados da IBM e o ficha técnica oficial.
A iluminação também faz parte do projeto. O modelo recebe a geometria de observação, incluindo os ângulos de iluminação, como contexto explícito. Isso ajuda a distinguir a aparência de uma superfície sob uma iluminação específica dos padrões do terreno subjacente que ele está aprendendo.
Um pixel que representa aproximadamente 100 metros de terreno não pode revelar os mesmos detalhes que um pixel que representa aproximadamente 1 metro. É por isso que os resultados relativos às crateras do WAC e do NAC merecem atenção especial. Um ganho em imagens de grande escala não significa necessariamente o mesmo ganho em pequenas características da superfície.
O projeto segue a abordagem de pré-treinamento do TerraMind, mas é treinado a partir do zero com dados lunares. Portanto, deve ser entendido como um modelo desenvolvido para observações lunares, e não como uma versão renomeada do modelo de observação da Terra. A questão relevante é como a representação aprendida por ele contribui para uma determinada tarefa lunar.
Três tarefas que ele pode realizar
As avaliações publicadas abrangem três grupos de tarefas. Cada um deles gera um tipo diferente de resposta; portanto, o significado de “melhor” varia de acordo com a tarefa.
| Tarefa | Saída | O que o resultado pode comprovar |
|---|---|---|
| Detecção de crateras | Caixas delimitadoras em torno de crateras nas imagens do WAC ou do NAC | Comparando a eficácia de um detector em identificar e localizar crateras marcadas. |
| Segmentação irregular da mancha da égua | Um contorno em nível de pixel das características da superfície vulcânica | Analisar o grau de correspondência entre as regiões previstas e os limites das características rotuladas. |
| Regressão da prospectividade do gelo polar | Uma previsão contínua de um mapa de prospectividade baseado no conhecimento | Análise da concordância com um alvo modelado para possíveis condições relacionadas ao gelo. |
A detecção de crateras e a segmentação de características vulcânicas podem ajudar os pesquisadores a organizar e analisar imagens. Sua utilidade depende dos rótulos, da escala e da área de avaliação. Um modelo que apresenta bom desempenho em um conjunto de teste definido ainda precisa ser avaliado com base nos dados e na questão científica de um novo projeto.
A prospectividade do gelo requer uma interpretação extremamente cuidadosa. O objetivo é elaborar um mapa baseado em conhecimentos que indique onde a presença de gelo seria plausível, e não uma medição direta dos depósitos de gelo. Uma maior concordância com esse mapa pode contribuir para pesquisas sobre padrões e regiões candidatas. Isso não significa que tenha sido encontrada uma quantidade adicional de água.
O que significam os resultados dos testes de desempenho
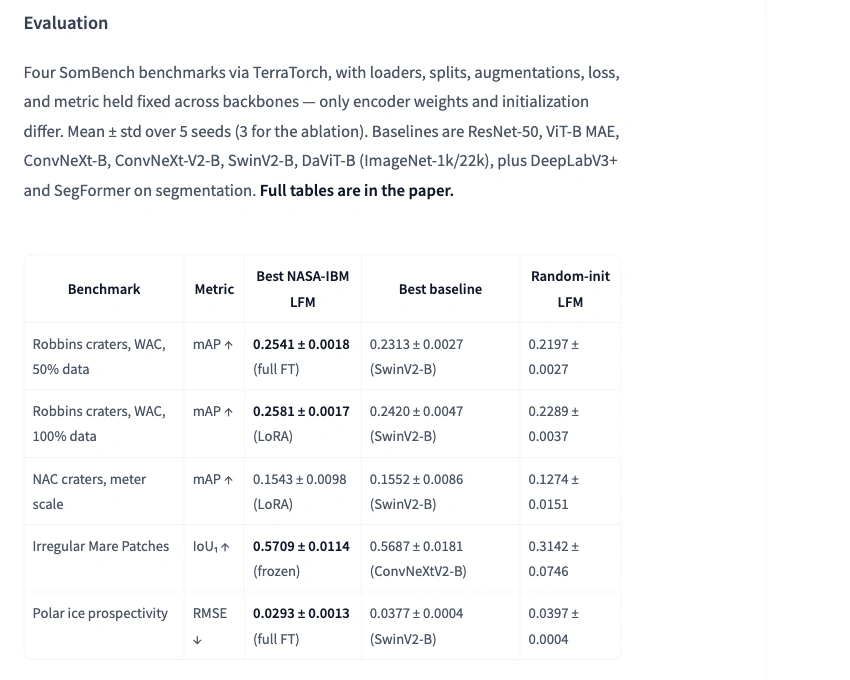
O relatório técnico apresenta médias e desvios-padrão para cinco sementes aleatórias. Seus resultados comparam configurações adaptadas do modelo lunar com linhas de base específicas do modelo de visão. Verificamos as tabelas publicadas; não reproduzimos os experimentos do modelo lunar.
As métricas respondem a diferentes perguntas. A precisão média (mAP) avalia a detecção de objetos; a interseção sobre a união (IoU) mede a sobreposição entre as regiões previstas e as rotuladas; o erro quadrático médio (RMSE) mede o erro numérico de previsão. Valores mais altos de mAP e IoU são melhores, enquanto um RMSE mais baixo é melhor. Elas não devem ser combinadas em uma única pontuação de precisão.
Erro de prospectividade do gelo: o ganho mais evidente relatado
O RMSE caiu de 0,0377 a 0,0293 contra o SwinV2-B, um 22,31 TP40T redução relativa. Um RMSE mais baixo indica uma concordância mais próxima com o mapa de prospectividade de gelo do referencial.
RMSE: quanto menor, melhor. As barras começam em zero. Média ± desvio-padrão em cinco sementes. O objetivo é um mapa de prospectividade modelado, e não uma medição do gelo.
| Tarefa e dados | Métrico ↑ | Modelo lunar | Base sólida |
|---|---|---|---|
| Crateras WAC · Dados de treinamento 50% | mAP | 0,2541 ± 0,0018 ajuste fino completo | 0,2313 ± 0,0027 SwinV2-B |
| Crateras WAC · Dados de treinamento 100% | mAP | 0,2581 ± 0,0017 LoRA | 0,2420 ± 0,0047 SwinV2-B |
| Crateras da NAC · Dados de treinamento 100% | mAP | 0,1543 ± 0,0098 LoRA | 0,1552 ± 0,0086 SwinV2-B |
| Manchas irregulares na égua | IoU1 | 0,5709 ± 0,0114 codificador travado | 0,5687 ± 0,0181 ConvNeXtV2-B |
Os autores descrevem os resultados relativos a crateras e características vulcânicas em escala de metros como comparáveis a referências sólidas. Suas pequenas diferenças devem ser interpretadas em conjunto com a variação entre as execuções.
Fonte: Relatório técnico da NASA e da IBM, Tabelas 4–7, páginas 16 e 18. Esses são os resultados dos autores, e não uma reprodução independente.
O resultado do teste 22% no gelo representa uma redução no erro
Quanto ao potencial de gelo, a configuração lunar mais promissora relatada apresenta um RMSE de 0,0293, contra 0,0377 para o SwinV2-B. O cálculo é o seguinte: (0,0377 − 0,0293) ÷ 0,0377 × 100 = 22,3%. O RMSE mede o erro de previsão em relação ao mapa de referência; quanto menor, melhor. Essa porcentagem não representa nem um índice de precisão nem uma variação na quantidade de gelo lunar.
Os resultados da análise de crateras dependem da métrica e da escala dos dados
Com 50% dos dados de treinamento do WAC, o modelo lunar registra um mAP de 0,2541, contra 0,2313 do SwinV2-B. Esse mesmo resultado do modelo lunar também supera o valor de referência de 0,2420 com 100% dos dados de treinamento. A primeira comparação utiliza frações iguais de dados; a segunda é uma evidência da eficiência do rótulo neste experimento específico.
A melhoria de aproximadamente 19% da IBM pode ser conciliada com os valores de AP@75 do relatório para os dados de treinamento de 50%: 0,2213 contra 0,1862, um aumento relativo de 18,9%. O AP@75 avalia as detecções em um determinado limiar de sobreposição. Ele não deve ser reinterpretado como um aumento de 19% na métrica mAP da tabela.
Na escala NAC mais refinada, o mAP do modelo lunar é de 0,1543 e o da linha de base é de 0,1552. Para “Irregular Mare Patches”, os valores de IoU de primeiro plano relatados são 0,5709 e 0,5687 em comparação com o ConvNeXtV2-B. Os autores descrevem essas tarefas como comparáveis a linhas de base robustas. Pequenas diferenças, juntamente com a variação relatada entre as execuções, não sustentam a afirmação de que o modelo lunar se sai melhor em todos os casos.
Onde adquirir e quais são os custos de acesso
Comece pelos recursos oficiais abaixo. Os pesos do modelo e o código estão sob a licença Apache-2.0, e o ponto de verificação está disponível publicamente. O repositório descreve especificamente um versão de ajuste fino e inferência; exclui explicitamente o código de pré-treinamento.
Escolha o recurso para o seu próximo passo
Comece pelas finalidades de uso, pelos dados de entrada, pelo licenciamento e pelas limitações.
A guia “Arquivos” contém o ponto de verificação liberado e os arquivos associados.
Use o arquivo README e as configurações de tarefas do TerraTorch para planejar um experimento.
Acompanhe a coleção oficial para acessar modelos e conjuntos de dados relacionados.
As Tabelas 4 a 7 apresentam os resultados das tarefas, as configurações e a variação entre as execuções.
Explore a versão de demonstração do projeto. Não realizamos uma geração nesta revisão.
A ficha do modelo não indicava nenhum Provedor de Inferência do Hugging Face implantado quando verificada em 28 de setembro de 2026. Um checkpoint para download e uma página de demonstração são formas distintas de acesso.
Se você quiser adaptar o modelo, selecione a tarefa subsequente antes de configurar o experimento. O repositório fornece componentes e configurações compatíveis com o TerraTorch que conectam o ponto de verificação, a tarefa e os dados. O TerraTorch é a estrutura de software utilizada para organizar esse fluxo de trabalho de treinamento e avaliação.
- Leia a ficha do modelo e o arquivo README e, em seguida, escolha entre detecção, segmentação ou regressão, com base na questão científica.
- Obtenha os dados correspondentes e o ponto de verificação oficial, e verifique a configuração das tarefas e as instruções de ambiente do repositório.
- Prepare os dados para essa configuração e execute o fluxo de trabalho de ajuste fino ou de inferência correspondente.
- Avalie em relação a uma linha de base adequada e mantenha a divisão dos dados, as configurações e os resultados, para que o resultado possa ser verificado.
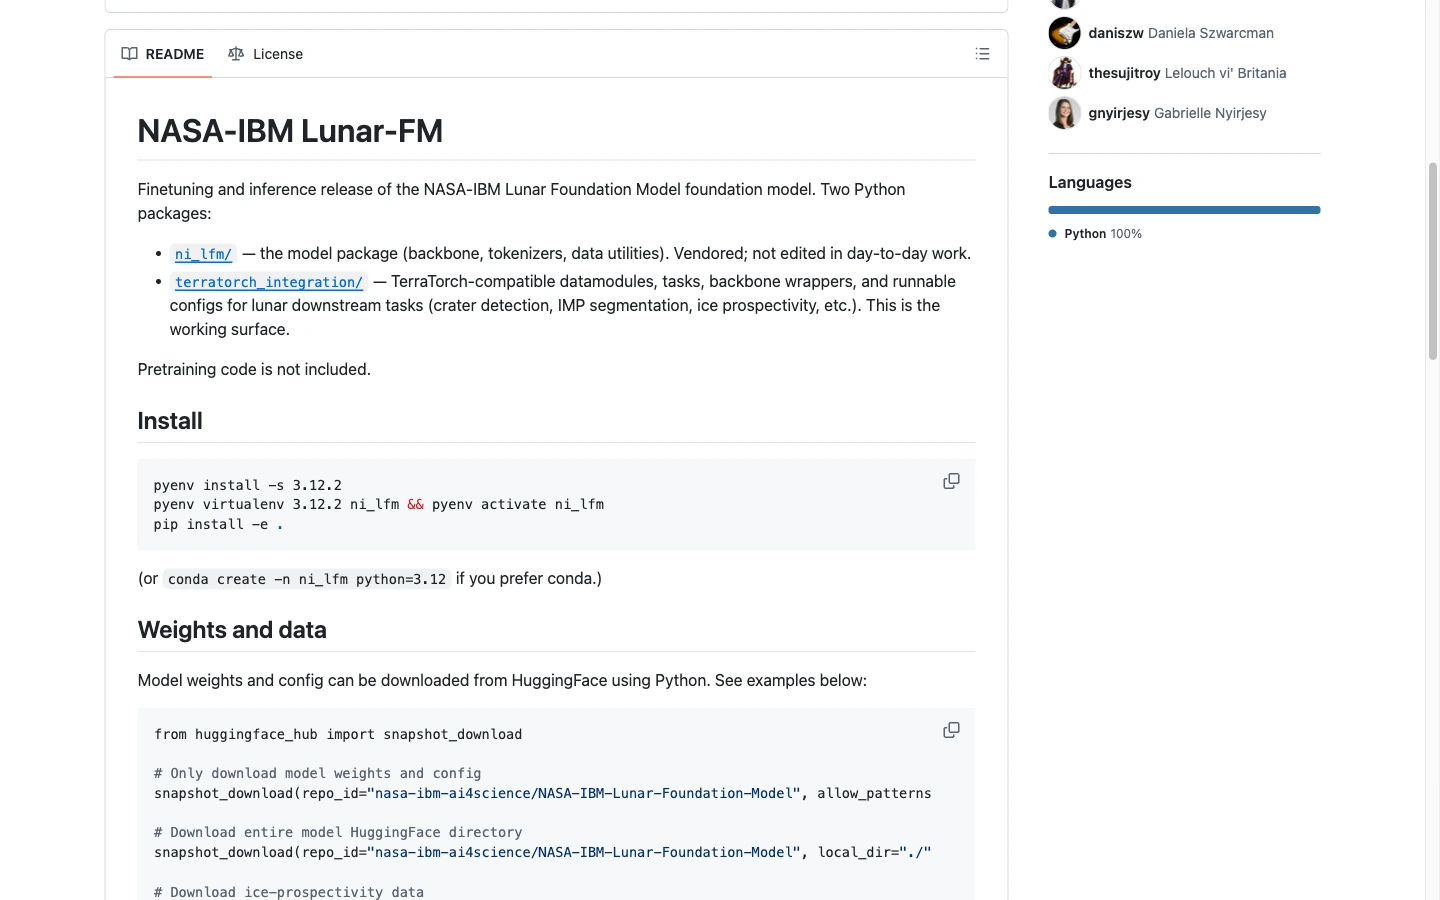
O acesso aberto elimina a necessidade de adquirir uma licença do modelo na fase inicial, mas a execução de um experimento ainda envolve custos. São necessários recursos de computação, armazenamento, preparação de dados e tempo para avaliação. Um ponto de verificação divulgado não vem automaticamente acompanhado de uma API hospedada ou de tempo de GPU gratuito, e as fontes não estabelecem um mínimo universal de GPU para todas as tarefas subsequentes.
| Seu objetivo | Recurso ou custo a ser previsto |
|---|---|
| Leia e avalie o comunicado | Anúncios públicos, ficha técnica, relatório e repositório. |
| Executar ou adaptar o modelo científico | Recursos adequados de computação e armazenamento, dados relevantes, configuração do ambiente e trabalhos de avaliação. |
| Compreender artigos e redigir um resumo de pesquisa | Um ambiente de trabalho para assistentes de pesquisa, como o GlobalGPT, que oferece acesso a modelos e ferramentas de documentos em uma única assinatura. |
Use a IA para compreender a pesquisa
Uma primeira pergunta produtiva deve ser específica: “O que a melhoria de 22% relatada realmente mede?” Responder a essa pergunta requer uma meta, uma métrica, uma linha de base e um cálculo. Perguntar sobre esses quatro itens é mais útil do que perguntar a um assistente se o modelo é impressionante.
O GlobalGPT permite que você conduza esse trabalho de leitura — desde a descoberta de fontes, passando pela explicação de documentos, até a redação — sem precisar alternar entre ferramentas diferentes a cada etapa. Para um método repetível, elaborar um resumo de pesquisa com referência às fontes com uma lista sucinta de fontes e perguntas explícitas antes de solicitar um resumo bem elaborado.
De fontes oficiais a um resumo informativo útil
- Reúna o material primário. Comece com o anúncio da NASA e, em seguida, inclua a ficha técnica do modelo, o relatório técnico e o arquivo README. Você pode pesquisa com Perplexity em GlobalGPT para localizar fontes de referência.
- Faça perguntas específicas. Peça a um assistente para explicar separadamente os conceitos de mAP, IoU e RMSE e, em seguida, liste o alvo, a linha de base e a configuração de avaliação por trás de cada afirmação.
- Verifique e escreva. Reabra a tabela mencionada, verifique cada número e transforme as anotações verificadas em um resumo que respeite os limites científicos.
Testamos uma versão reduzida desse fluxo de trabalho com o GPT-5.6 Sol. Ele recebeu um pacote de dados extraídos das quatro fontes oficiais e teve que produzir um breve resumo, classificar seis alegações, calcular a redução do RMSE e sugerir próximos passos práticos. A tarefa utilizou o texto fornecido; o sistema não procurou novas evidências.
Um teste de resumo com base em fontes
Fornecemos ao GPT-5.6 Sol um pequeno conjunto de informações extraídas do comunicado da NASA, da ficha técnica oficial, do relatório técnico e do arquivo README do GitHub. Ele precisava redigir um resumo, verificar seis afirmações e explicar o cálculo do RMSE.
- Área de trabalho e data
- GlobalGPT · 28 de setembro de 2026
- Executar política
- Uma tarefa; resposta completa na primeira tentativa; sem novas tentativas
- Entrada
- Pacote de fontes com 355 palavras e quatro IDs de fonte
- Âmbito
- Leitura e síntese; sem pesquisa em tempo real nem execução do modelo lunar
- Configurações de resposta
- Limite de tokens de saída: 4.096; todos os demais controles de amostragem mantidos nos padrões do serviço
- Uso e custo
- Foram declarados 2.154 tokens no total; a resposta não incluiu uma cobrança monetária
A primeira resposta manteve as alegações científicas dentro do escopo
A resposta gerou um resumo de 112 palavras, refutou a alegação de que o modelo tivesse descoberto 22% mais gelo real e manteve as restrições à certificação de locais de pouso e ao acesso ao código de pré-treinamento. Suas três etapas seguintes remetiam à ficha técnica oficial do modelo, ao ponto de verificação e aos recursos do TerraTorch.
Essa foi uma tarefa de leitura com base em material fornecido. O pacote de materiais de referência já indicava as principais limitações. O resultado não avalia o desempenho em pesquisa autônoma nem em inferência por sensoriamento remoto lunar.
Visualizar o prompt exato e o pacote de origem
SISTEMA
Você é um editor de pesquisa meticuloso escrevendo para um estudante universitário. Utilize apenas o pacote de fontes fornecido. Não pesquise na internet. Distinga as medições de benchmark relatadas das medições científicas do mundo real. Cite os IDs das fontes entre colchetes. Se uma afirmação não for comprovada, indique isso claramente. Não invente citações, preços, requisitos de hardware ou resultados experimentais. Forneça a resposta solicitada, sem incluir raciocínios ocultos.

USUÁRIO
Transforme o pacote de fontes em uma nota de pesquisa prática. Entregue: (1) um resumo em linguagem simples com 100–130 palavras; (2) uma tabela de verificação de alegações com seis linhas, usando exatamente “Comprovado” ou “Não comprovado”, um ID de fonte e uma explicação de uma frase para cada alegação fornecida; (3) a redução relativa do RMSE calculada de 0,0377 para 0,0293, arredondada para uma casa decimal, com uma fórmula e uma frase explicando o que ela não mede; (4) três próximos passos práticos para um aluno que queira examinar ou adaptar o modelo divulgado. Mantenha toda a resposta com menos de 500 palavras.

Afirmações a serem verificadas:
1. A NASA e a IBM anunciaram publicamente o modelo em 10 de setembro de 2026.
2. O RMSE de prospectividade de gelo relatado caiu de 0,0377 para o SwinV2-B para 0,0293 para o modelo lunar totalmente ajustado.
3. O modelo descobriu 22% a mais de gelo de água real na Lua.
4. A NASA validou esse modelo para certificação de locais de pouso e verificação de riscos.
5. O lançamento no GitHub inclui o código de pré-treinamento.
6. Um ponto de verificação aberto garante que a computação em GPU e a inferência hospedada sejam gratuitas.

Pacote de fontes:
[S1] Anúncio da NASA, 10 de setembro de 2026.
Título: NASA e IBM lançam modelo de base de IA para ciência lunar.
URL: https://science.nasa.gov/science-research/artificial-intelligence-lunar-foundation-model/
A NASA anunciou um modelo de base para ciência lunar desenvolvido em parceria com a IBM. Ele está hospedado publicamente no Hugging Face, com o código disponível no GitHub. Pode ser adaptado para mapeamento de crateras, identificação de características vulcânicas e pesquisa sobre o gelo polar.

[S2] Ficha técnica oficial do modelo NASA-IBM e relatório técnico, consultados em 28 de setembro de 2026.
URL da ficha do modelo: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
URL do relatório técnico: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model/blob/main/NI_LFM_Technical_Report.pdf
A Tabela 7 do relatório (página 18) apresenta o erro quadrático médio (RMSE) do conjunto de teste para a regressão de prospectividade de gelo. Quanto menor, melhor. Média mais/menos desvio padrão em cinco sementes aleatórias: NASA-IBM LFM com ajuste fino completo, 0,0293 ± 0,0013; SwinV2-B pré-treinado no ImageNet, 0,0377 ± 0,0004. O objetivo é um mapa de prospectividade de gelo baseado em conhecimento. Esses são resultados de benchmark relatados pelos autores, não uma replicação independente ou uma medição direta de gelo de água.
Tabela 4 (página 16), crateras WAC com dados de treinamento 50%: o mAP da caixa delimitadora é de 0,2541 ± 0,0018 para o LFM totalmente ajustado e de 0,2313 ± 0,0027 para o SwinV2-B. Nas mesmas linhas, o AP@75 é 0,2213 ± 0,0028 e 0,1862 ± 0,0041, respectivamente. Essas métricas não devem ser trocadas.

[S3] Ficha técnica oficial do modelo, Uso pretendido / Fora do escopo / Limitações.
URL: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
A finalidade de uso é o sensoriamento remoto lunar por meio de ajuste fino ou adaptação LoRA para detecção, segmentação e regressão densa. O modelo não foi validado para certificação de locais de pouso ou verificação de riscos. Os resultados de prospectividade de gelo representam um mapa baseado em conhecimento, não em medições reais de gelo. Os campos gerados são sondagens qualitativas, não previsões científicas calibradas. O modelo não mantém um referencial geodésico absoluto. Ele não foi avaliado fora da Lua. A licença indicada é a Apache-2.0. A página não informa nenhuma implantação do Inference Provider. Este pacote não oferece nenhuma garantia de computação gratuita em GPU ou inferência hospedada gratuita, nem especifica requisitos mínimos de hardware ou preço da API hospedada.

[S4] README oficial do GitHub, verificado em 28 de setembro de 2026.
URL: https://github.com/NASA-IMPACT/NASA-IBM-Lunar-Foundation-Model
O repositório descreve uma versão de ajuste fino e inferência. O código de pré-treinamento não está incluído. Os pesos e a configuração podem ser baixados do repositório oficial de modelos do Hugging Face. São fornecidos módulos de dados, tarefas, wrappers de backbone e configurações de tarefas compatíveis com o TerraTorch. O ajuste fino e os testes exigem os dados, o ponto de verificação e a configuração de tarefa relevantes. O arquivo README indica uma licença Apache 2.0.
Veja a primeira resposta completa
## 1. Resumo

A NASA e a IBM anunciaram o Lunar Foundation Model em 10 de setembro de 2026. O lançamento público disponibiliza pesos no Hugging Face e códigos de ajuste fino e inferência no GitHub, voltados para tarefas de sensoriamento remoto lunar, como mapeamento de crateras, identificação de características vulcânicas e pesquisa sobre gelo polar. Seu benchmark de prospectividade de gelo relatado melhora o RMSE em relação a um SwinV2-B pré-treinado no ImageNet, mas o objetivo é um mapa baseado em conhecimento, e não a medição direta de gelo lunar. O resultado foi relatado pelos autores com base em cinco sementes aleatórias e não constitui uma replicação independente. O modelo destina-se à adaptação por meio de ajuste fino completo ou LoRA, mas não foi validado para certificação de locais de pouso ou verificação de riscos. Não há código de pré-treinamento, e a versão disponibilizada não promete nem computação gratuita em GPU nem inferência hospedada. [S1][S2][S3][S4]

## 2. Tabela de verificação de alegações

| Alegação | Veredicto | Fonte | Explicação |
|---|---|---|---|
| 1 | Comprovada | [S1] | O anúncio da NASA é datado de 10 de setembro de 2026 e identifica o modelo como um projeto da NASA em parceria com a IBM. |
| 2 | Comprovada | [S2] | A Tabela 7 apresenta valores de RMSE de 0,0377 para o SwinV2-B e de 0,0293 para o modelo lunar totalmente ajustado. |
| 3 | Não comprovado | [S2] | Os valores representam erros de benchmark em relação a um mapa de prospectividade baseado em conhecimento, e não medições reais de gelo de água lunar. |
| 4 | Não comprovado | [S3] | A ficha do modelo afirma explicitamente que o modelo não foi validado para certificação de locais de pouso ou avaliação de riscos. |
| 5 | Não suportado | [S4] | O repositório do GitHub fornece recursos de ajuste fino e inferência, mas exclui o código de pré-treinamento. |
| 6 | Não suportado | [S3] | O pacote não promete computação gratuita em GPU nem inferência hospedada, e não relata nenhuma implantação de Provedor de Inferência. |

## 3. Redução relativa do RMSE

\[
\frac{0,0377-0,0293}{0,0377}\times 100 = 22,3\%
\]

Trata-se de uma **redução relativa de 22,3% no RMSE do benchmark relatado pelos autores**; ela não mede o descobrimento adicional de gelo de água real nem o desempenho científico validado de forma independente. [S2]

## 4. Próximos passos práticos

1. Leia os usos pretendidos, as limitações e a licença Apache-2.0 do cartão do modelo antes de selecionar uma tarefa de detecção, segmentação ou regressão. [S3]
2. Baixe o checkpoint oficial e a configuração do Hugging Face e, em seguida, examine os wrappers do backbone do GitHub e as configurações das tarefas. [S4]
3. Obtenha o conjunto de dados lunar relevante e use os componentes compatíveis com o TerraTorch fornecidos para fazer o ajuste fino e os testes, documentando que o código de pré-treinamento não está disponível e que os resultados dos benchmarks exigem avaliação independente. [S2][S4]
O resultado útil foi a preservação das distinções: erro de referência versus gelo detectado, uso para pesquisa versus certificação de pouso e código de adaptação divulgado versus ausência de código de pré-treinamento. Como esses limites já estavam presentes no pacote de origem, isso constitui uma evidência de que a tarefa de leitura e síntese foi bem-sucedida, e não uma prova de que um assistente descobriria, de forma independente, todas as ressalvas.
Para um projeto maior, planejar uma sessão de pesquisa mais aprofundada com o auxílio da IA em torno de questões específicas sobre dados, métodos, avaliação e limitações. Mantenha a tabela de origem ao lado do rascunho e verifique novamente cada número após a edição. Esse hábito é mais importante do que a fluência do primeiro resumo.
Limites que fazem diferença na prática
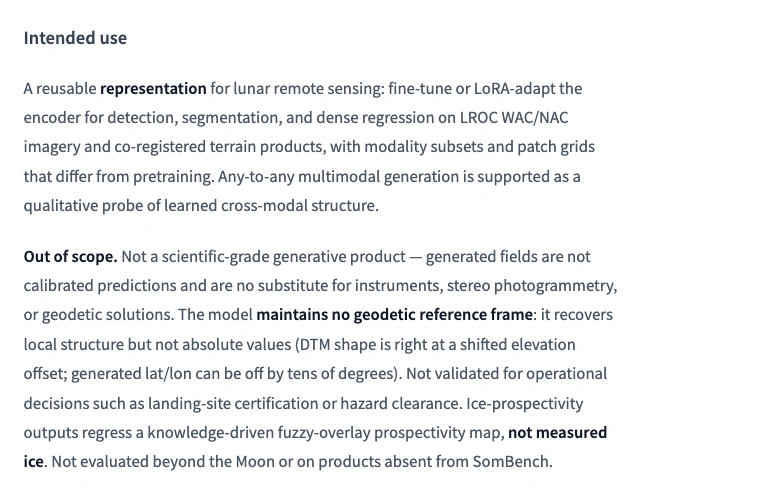
A ficha técnica indica que o modelo lunar ainda não foi validado para decisões operacionais, como a certificação de locais de pouso ou a avaliação de riscos. Um modelo científico pode ajudar a analisar observações sem que se tenha a certeza de que uma espaçonave possa pousar com segurança em algum lugar. Essas aplicações exigem um nível diferente de validação.
Os campos gerados também exigem cautela. O modelo não mantém um referencial geodésico absoluto, e os valores gerados podem se desviar dos valores físicos. Os autores descrevem a geração como uma análise qualitativa, e não como uma previsão científica calibrada. Um mapa de terreno ou de observação que pareça plausível não deve ser interpretado como um produto de medição.
O ponto de verificação ainda não foi avaliado além da Lua. Mesmo no âmbito da pesquisa lunar, o quadro geral é misto: ganhos evidentes em algumas tarefas e resultados comparáveis em outras. A lição que se pode tirar é a de avaliar o modelo em relação à meta, à escala, aos dados e à linha de base que correspondam ao seu experimento.
Perguntas frequentes
O Modelo de Fundação Lunar da NASA-IBM é de uso gratuito?
A ficha técnica oficial do modelo e o repositório de código indicam uma licença Apache-2.0, e o ponto de verificação está disponível publicamente. A realização de experimentos ainda requer recursos computacionais adequados, preparação de dados e avaliação específica para cada tarefa. O acesso aberto ao modelo não oferece garantia de computação gratuita em GPU ou inferência hospedada.
O Modelo de Fundação Lunar da NASA-IBM é um chatbot?
Trata-se de um modelo base para sensoriamento remoto lunar, desenvolvido para trabalhar com imagens, produtos de relevo e dados de observação relacionados. Os pesquisadores o adaptam para tarefas de detecção, segmentação e regressão. Um assistente de chat pode ajudar a explicar a documentação, mas interagir com um chatbot é um fluxo de trabalho diferente da execução desse modelo.
O modelo descobriu mais gelo de água na Lua?
O resultado relatado sobre gelo mede o grau de correspondência entre as previsões e um mapa de prospectividade de gelo baseado em conhecimento. O melhor RMSE relatado cai de 0,0377 para 0,0293 em relação à linha de base citada, uma redução relativa de cerca de 22%. Trata-se de uma melhoria em relação ao benchmark; não é uma medida de gelo adicional descoberto.
Posso explorar o projeto sem escrever código?
Você pode ler o anúncio da NASA, examinar o cartão do modelo, explorar as tabelas de referência publicadas e visitar a página oficial de demonstração sem precisar construir um pipeline de treinamento. A adaptação do checkpoint divulgado a uma tarefa científica utiliza o código, os dados e as configurações do TerraTorch do repositório, seguida de uma validação específica para a tarefa.
Como o modelo lunar se relaciona com Prithvi e Surya?
Eles fazem parte da colaboração mais ampla entre a NASA e a IBM sobre modelos de base para a ciência. A NASA descreve os modelos Prithvi para observações da Terra e aplicações meteorológicas, o Surya para heliofísica e o modelo lunar para observações da Lua. Seus domínios e tarefas previstas diferem; o modelo lunar ainda não foi avaliado fora da Lua.
O Modelo Lunar da Fundação NASA-IBM oferece um ponto de partida reutilizável para pesquisas de sensoriamento remoto lunar. Utilize as tabelas oficiais para compreender seus pontos fortes, o cartão do modelo para definir seus limites e os recursos disponibilizados para planejar um experimento específico para uma determinada tarefa. Se seu objetivo imediato for aprender ou escrever, comece transformando essas fontes em um resumo verificado.
Transforme um artigo técnico em um resumo prático
Traga suas fontes oficiais para o GlobalGPT, analise conceitos desconhecidos e transforme as conclusões verificadas em anotações claras ou em um rascunho finalizado — tudo em um único espaço de trabalho multimodelo.
Explore pesquisas com o GlobalGPT








