
O API de Áudio e Fala OpenAI transforma texto em áudio falado por meio de POST https://api.openai.com/v1/audio/speech. Envie um modelo, seu texto de entrada e uma amostra de voz; salve a resposta como MP3 ou em outro formato de áudio compatível. Para uma nova integração que exija instruções sobre tom e entonação, comece com gpt-4o-mini-tts.
Uma solicitação de trabalho é apenas o primeiro passo. Você também precisa da unidade de cobrança correta, de um arquivo de saída reproduzível e de um plano para roteiros longos. O modelo de TTS mais recente da OpenAI utiliza tokens de texto e áudio para o cálculo do preço; seus modelos de TTS mais antigos utilizam caracteres. Essa diferença é importante na hora de estimar o custo de um mês de narração.
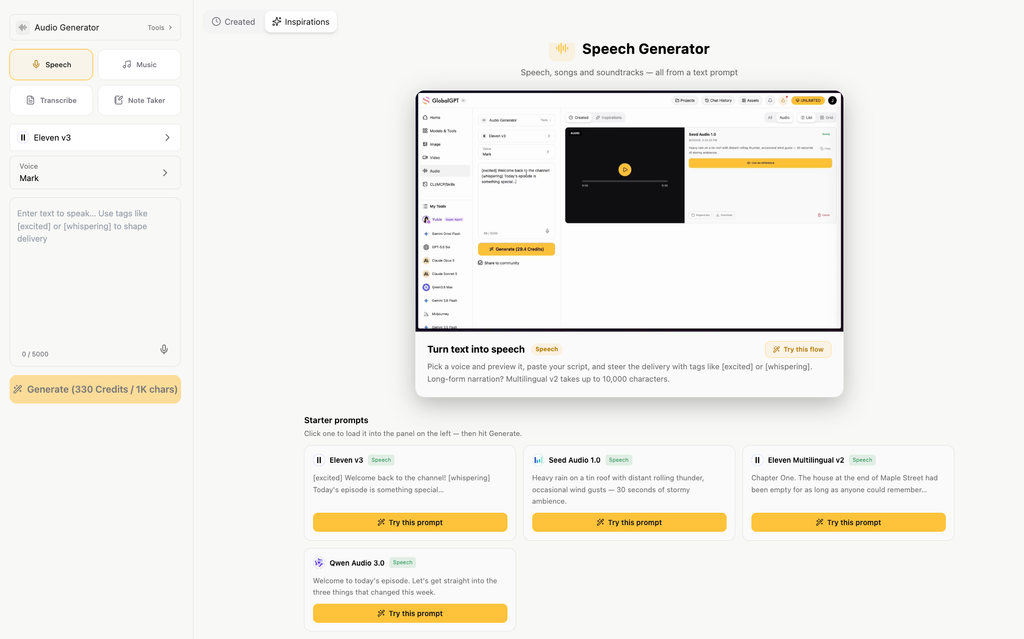
Se o seu trabalho também inclui escrever o roteiro, criar os elementos visuais e montar um vídeo, Espaço de trabalho de áudio do GlobalGPT traz a geração de fala para uma plataforma de assinatura multimodelo acessível. Você pode trabalhar com texto, voz, imagens e vídeo em um único painel e, em seguida, usar sua API e CLI para tarefas de produção padronizadas. Sua API pública de TTS utiliza um fluxo de trabalho de tarefas separado, abordado a seguir.
O que a API de áudio e fala OpenAI faz?
A API de Fala é um ponto de conexão de conversão de texto em fala: seu aplicativo fornece palavras escritas e recebe a fala gerada. Entre os usos típicos estão tutoriais de produtos, narração para acessibilidade, material didático e pequenas narrações. Você controla o texto antes que ele seja lido em voz alta, o que torna essa função útil quando o texto precisa seguir um roteiro aprovado.
Na transcrição, o processo é inverso: o áudio gravado é inserido e o texto é gerado. Um assistente de voz em tempo real acrescenta mais um requisito: ouvir e responder por meio de uma conversa. O OpenAI’s documentação em áudio separa esses fluxos de trabalho. Escolha o endpoint de voz quando já tiver o texto que deseja que seja lido em voz alta.
A geração de fala oferece suporte ao streaming, de modo que um aplicativo pode receber áudio em blocos. Salvar esse fluxo em um arquivo não faz com que ele seja reproduzido automaticamente em um navegador nem cria um agente conversacional; seu aplicativo ainda é responsável pela reprodução e por qualquer lógica de conversação. O OpenAI também exige que seja claramente informado aos ouvintes que a voz é gerada por IA.
Gere seu primeiro arquivo de áudio com a API de voz OpenAI
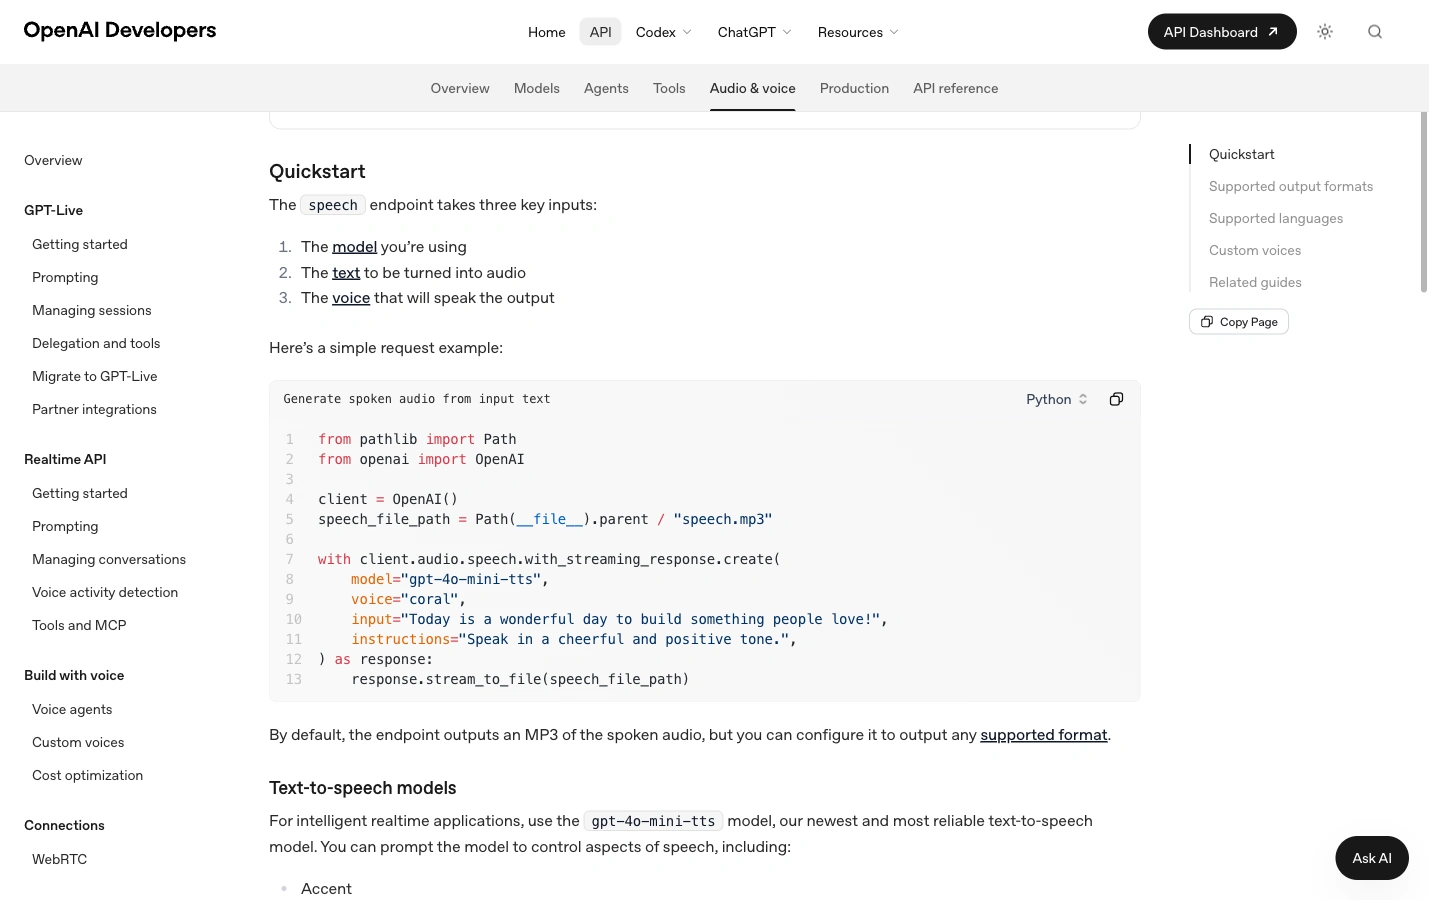
Execute a solicitação em um servidor ou em sua máquina de desenvolvimento, com uma chave de API OpenAI armazenada no OPENAI_API_KEY variável de ambiente. Evite usar a chave no JavaScript do navegador. Os exemplos a seguir utilizam o mesmo script curto de tour do produto e salvam o resultado como openai-product-tour.mp3.
Opção 1: fazer uma solicitação via curl
API de Fala OpenAI · curl
#!/bin/sh
# Defina primeiro a variável OPENAI_API_KEY no ambiente do seu servidor.
curl --fail-with-body --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "Bem-vindo ao tour pelo produto Acorn Studio. Em três etapas, você pode transformar um pequeno roteiro em um guia de áudio. Primeiro, escreva a mensagem. Em seguida, escolha uma voz. Por fim, salve o arquivo de áudio e teste a reprodução no seu celular.",
    "voice": "coral",
    "instructions": "Fale claramente, em um tom acolhedor e coloquial.",
    "response_format": "mp3"
  }' \
  --output openai-product-tour.mp3
A resposta contém bytes de áudio; portanto, salve-a em um arquivo em vez de tentar analisá-la como JSON. O --fail-with-body Essa opção faz com que o curl retorne um código de saída de falha em caso de erro HTTP. Verifique esse código de status antes de abrir o arquivo: uma resposta de erro ainda pode deixar dados JSON no arquivo chamado .mp3.
Opção 2: usar o SDK do Python
Instale o pacote OpenAI com python -m pip install openai. O SDK lê a chave da API do ambiente. Este exemplo grava a resposta à medida que ela chega, o que evita carregar toda a resposta de áudio no seu próprio buffer de Python.
API de Fala OpenAI · Python
"""Instalação: python -m pip install openai. Defina OPENAI_API_KEY no servidor."""
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
script = (
    "Bem-vindo ao tour pelos produtos do Acorn Studio. Em três etapas, você pode transformar "
    "um pequeno roteiro em um guia de áudio. Primeiro, escreva a mensagem. Em seguida, "
    "escolha uma voz. Por fim, salve o arquivo de áudio e teste a reprodução no seu celular."
)

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=script,
    instructions="Fale claramente, em um tom acolhedor e coloquial.",
    response_format="mp3",
) as response:
    response.stream_to_file(Path("openai-product-tour.mp3"))

print("Salvo openai-product-tour.mp3")
Os três campos essenciais são: modelo, entrada, e voz. Aqui, instruções exige uma entonação acolhedora e coloquial; ele orienta a voz, em vez de acrescentar palavras ao roteiro falado. Este campo funciona com o GPT-4o Mini TTS e não é compatível com tts-1 e tts-1-hd.
No caso de um documento mais extenso, divida o texto nos limites das frases ou dos parágrafos, numere os segmentos e salve cada arquivo gerado com esse número. Mantenha o mesmo tom e as mesmas instruções em todos os segmentos. Deixe contexto suficiente para uma formulação natural e ouça as transições entre os segmentos antes de distribuir a gravação final.
Escolha um modelo, uma voz e um formato de saída
| Modelo | Como escolher | Instruções de entrega |
|---|---|---|
gpt-4o-mini-tts | Um ponto de partida para uma narração controlável e uma forma de expressão oral. | Suportes instruções em termos de tom, estilo e ritmo. |
tts-1 | O OpenAI posiciona esse modelo para a geração de fala com menor latência. | Use os controles de voz e velocidade compatíveis; omita instruções. |
tts-1-hd | O OpenAI posiciona esse modelo para oferecer uma qualidade de fala superior à do TTS-1. | Use os controles de voz e velocidade compatíveis; omita instruções. |
O Página do modelo GPT-4o Mini TTS mapeia o alias do modelo para o gpt-4o-mini-tts-15/12/2025 instantâneo. Se a reprodutibilidade do comportamento for importante para sua aplicação, escolha deliberadamente um instantâneo documentado e registre-o junto com seus scripts salvos.
Vozes integradas e limites de entrada
A documentação de referência da API de Fala lista 13 vozes integradas para o GPT-4o Mini TTS: liga, cinza, balada, coral, eco, fábula, ônix, nova, sálvia, brilho, verso, marin e cedro. A OpenAI recomenda marin ou cedro para obter a melhor qualidade. Essa é a recomendação do OpenAI: escolha sua voz de produção ouvindo seus próprios nomes, números e padrões de frases.
Os modelos mais antigos do TTS oferecem um conjunto menor de vozes: alloy, ash, coral, echo, fable, onyx, nova, sage e shimmer. Não presuma que todas as vozes sejam compatíveis com todos os modelos. O Referência da API de voz também aceita uma velocidade entre 0,25 e 4,0, com 1.0 como padrão.
Há dois limites de entrada a serem considerados: os limites de referência dos pontos finais entrada para 4.096 caracteres, e a página do modelo Mini TTS especifica um máximo de 2.000 tokens de entrada. Caracteres e tokens são unidades de medida diferentes. Verifique ambas as restrições do Mini TTS, especialmente em textos multilíngues, e divida scripts grandes antes de enviá-los.
Escolha o formato de arquivo para o destino
| Formato | Aplicação prática |
|---|---|
| MP3 | Saída padrão: um arquivo compactado prático para compartilhamento e reprodução na web. |
| Opus | Útil para aplicativos de streaming e comunicação que suportam esse codec. |
| AAC | Considere em que situações seu ambiente de reprodução ou fluxo de trabalho de mídia exige o uso do AAC. |
| FLAC | Compressão sem perdas para fluxos de trabalho que precisam preservar o sinal de áudio. |
| WAV | Áudio não compactado em um formato conhecido para edição e processamento. |
| PCM | Amostras brutas de 24 kHz e 16 bits, com sinal de sinal e formato little-endian, sem cabeçalho de arquivo; seu reprodutor precisa dessas configurações. |
Comece com o formato MP3 para um link de download ou um reprodutor de áudio simples. Escolha o formato WAV quando a próxima etapa for a edição. Selecione o formato PCM bruto somente se o seu aplicativo souber interpretá-lo; alterar o nome de um arquivo de .pcm para .wav não cria um cabeçalho WAV.
Quanto custa a API de fala OpenAI?
Conforme verificado em 28 de setembro de 2026, o OpenAI lista o GPT-4o Mini TTS em $0,60 por milhão de tokens de entrada de texto mais $12 por milhão de tokens de saída de áudio. Custos do TTS-1 $15 por milhão de caracteres, e os preços do TTS-1 HD $30 por milhão de caracteres. Calcule cada modelo em suas próprias unidades.
Preços da API de Reconhecimento de Fala: mantenha as unidades separadas
O OpenAI cobra pelo seu modelo mais recente de TTS por tokens, enquanto seus dois modelos anteriores de TTS são cobrados por caracteres. O GlobalGPT cobra suas tarefas de TTS por créditos.
| Rota e modelo | Taxa | Exemplo |
|---|---|---|
| OpenAI · GPT-4o Mini TTS | $0,60 / 1 milhão de tokens de entrada de texto $12 / 1M tokens de saída de áudio | $0.0606 para 1.000 tokens de entrada de texto + 5.000 tokens de saída de áudio |
| OpenAI · TTS-1 | $15 / 1 mil caracteres | $0.015 por 1.000 caracteres |
| OpenAI · TTS-1 HD | $30 / 1 milhão de caracteres | $0.030 por 1.000 caracteres |
| GlobalGPT · Eleven v3, Eleven Multilingual v2 ou Qwen Audio 3.0 TTS Flash | 330 créditos / 1.000 caracteres | 330 créditos à taxa indicada de 1.000 caracteres; solicite um orçamento antes de enviar |
Estes são exemplos de preços, e não valores cobrados pelas amostras de áudio abaixo. Tokens, caracteres, minutos e créditos são unidades diferentes. A estimativa da tarefa GlobalGPT indica a quantidade de créditos aplicável; a tabela não converte créditos em dólares.
Taxas verificadas em 28 de setembro de 2026. Fontes: Preços da API OpenAI e Documentação da API GlobalGPT.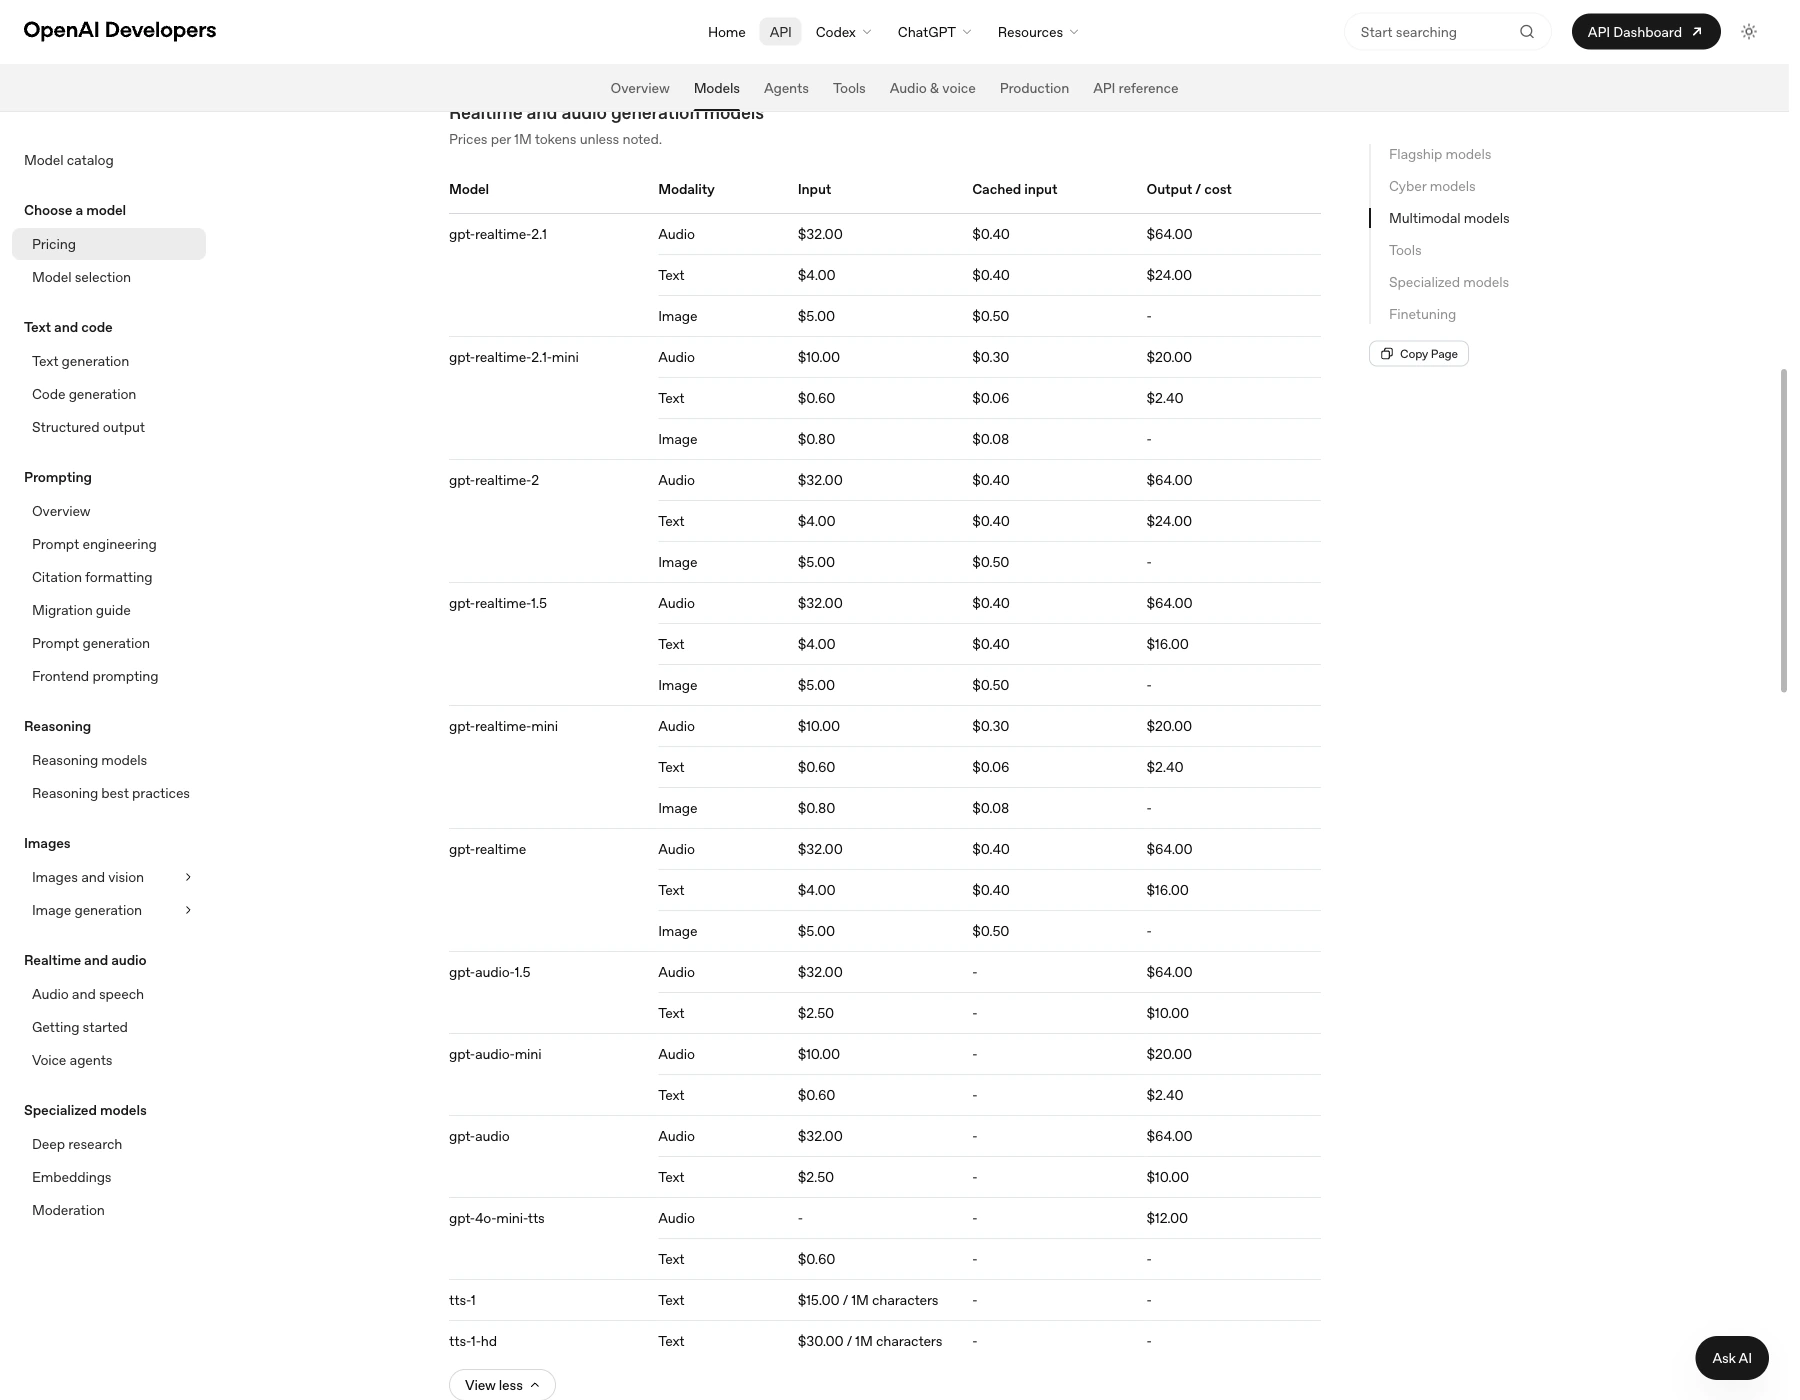
Por exemplo, 100 roteiros com 1.000 caracteres cada totalizam 100.000 caracteres. De acordo com as tarifas indicadas, isso equivale a $1.50 com TTS-1 ou $3.00 com TTS-1 HD, antes de outros custos do aplicativo. Essa mesma contagem de caracteres não é suficiente para calcular o Mini TTS com exatidão: é preciso saber a quantidade de tokens de entrada de texto e de saída de áudio.
Calcule o custo da geração de fala
Insira as unidades de cobrança da rota escolhida. Não há conversão automática de caracteres para tokens nem de minutos para tokens.
Fórmula: caracteres × $15 ÷ 1.000.000. O total de texto pode abranger várias solicitações de API.
Tarifas verificadas em 28 de setembro de 2026: OpenAI · GlobalGPT. Não inclui armazenamento, hospedagem, impostos e outros componentes do seu aplicativo.
Para fins de planejamento, insira na calculadora os números reais de uso ou premissas explícitas. Considere o campo “Mini TTS audio-token” como uma estimativa de orçamento até que você tenha medido o uso. Não transforme um valor aproximado por minuto em um preço garantido para cada voz, ritmo de fala ou idioma.
O catálogo do modelo GlobalGPT apresenta os preços do TTS em créditos, e seu ponto final de estimativa fornece uma cotação para a solicitação que você pretende enviar. Mantenha os gastos com créditos da API separados da escolha de uma assinatura de espaço de trabalho multimodelo para tarefas diárias de redação e trabalho com mídia. Isso facilita o controle do orçamento, sem presumir que os dois produtos compartilhem um mesmo limite de faturamento.
Crie um fluxo de trabalho de TTS com a API GlobalGPT
Para um fluxo de trabalho repetível que vai do roteiro à gravação de voz e ao vídeo, criar discurso em GlobalGPT e manter o restante do projeto no mesmo espaço de trabalho. O API GlobalGPT apresenta a geração de mídia como tarefas, enquanto o GlobalGPT CLI conexões compatíveis com seu terminal e suas ferramentas de desenvolvimento.
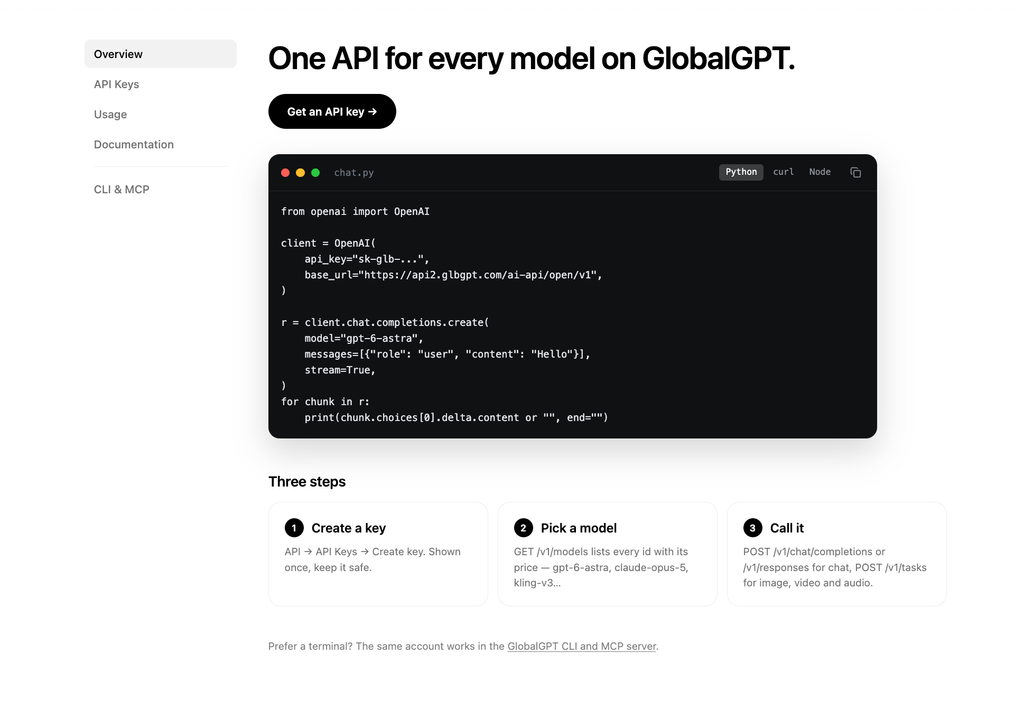
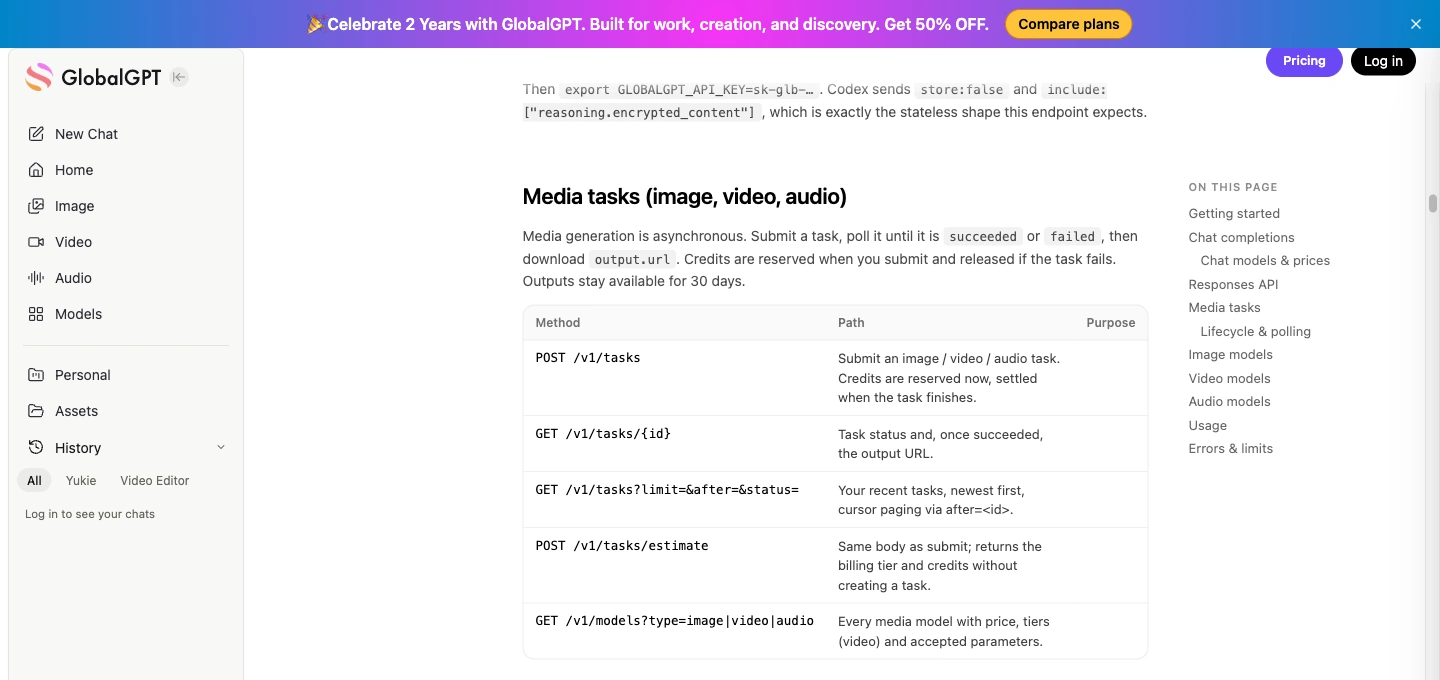
Use a URL base pública https://api2.glbgpt.com/ai-api/open/v1. Envie solicitações de TTS para POST /tasks, consulta GET /tasks/{id}, e baixar output.url após a tarefa ser concluída com sucesso. O campo de texto é prompt. Implemente este contrato de tarefa diretamente; ele difere da resposta de áudio imediata do OpenAI.
Escolha um modelo TTS GlobalGPT documentado
| ID do modelo | Entrada e saída | Distinção útil |
|---|---|---|
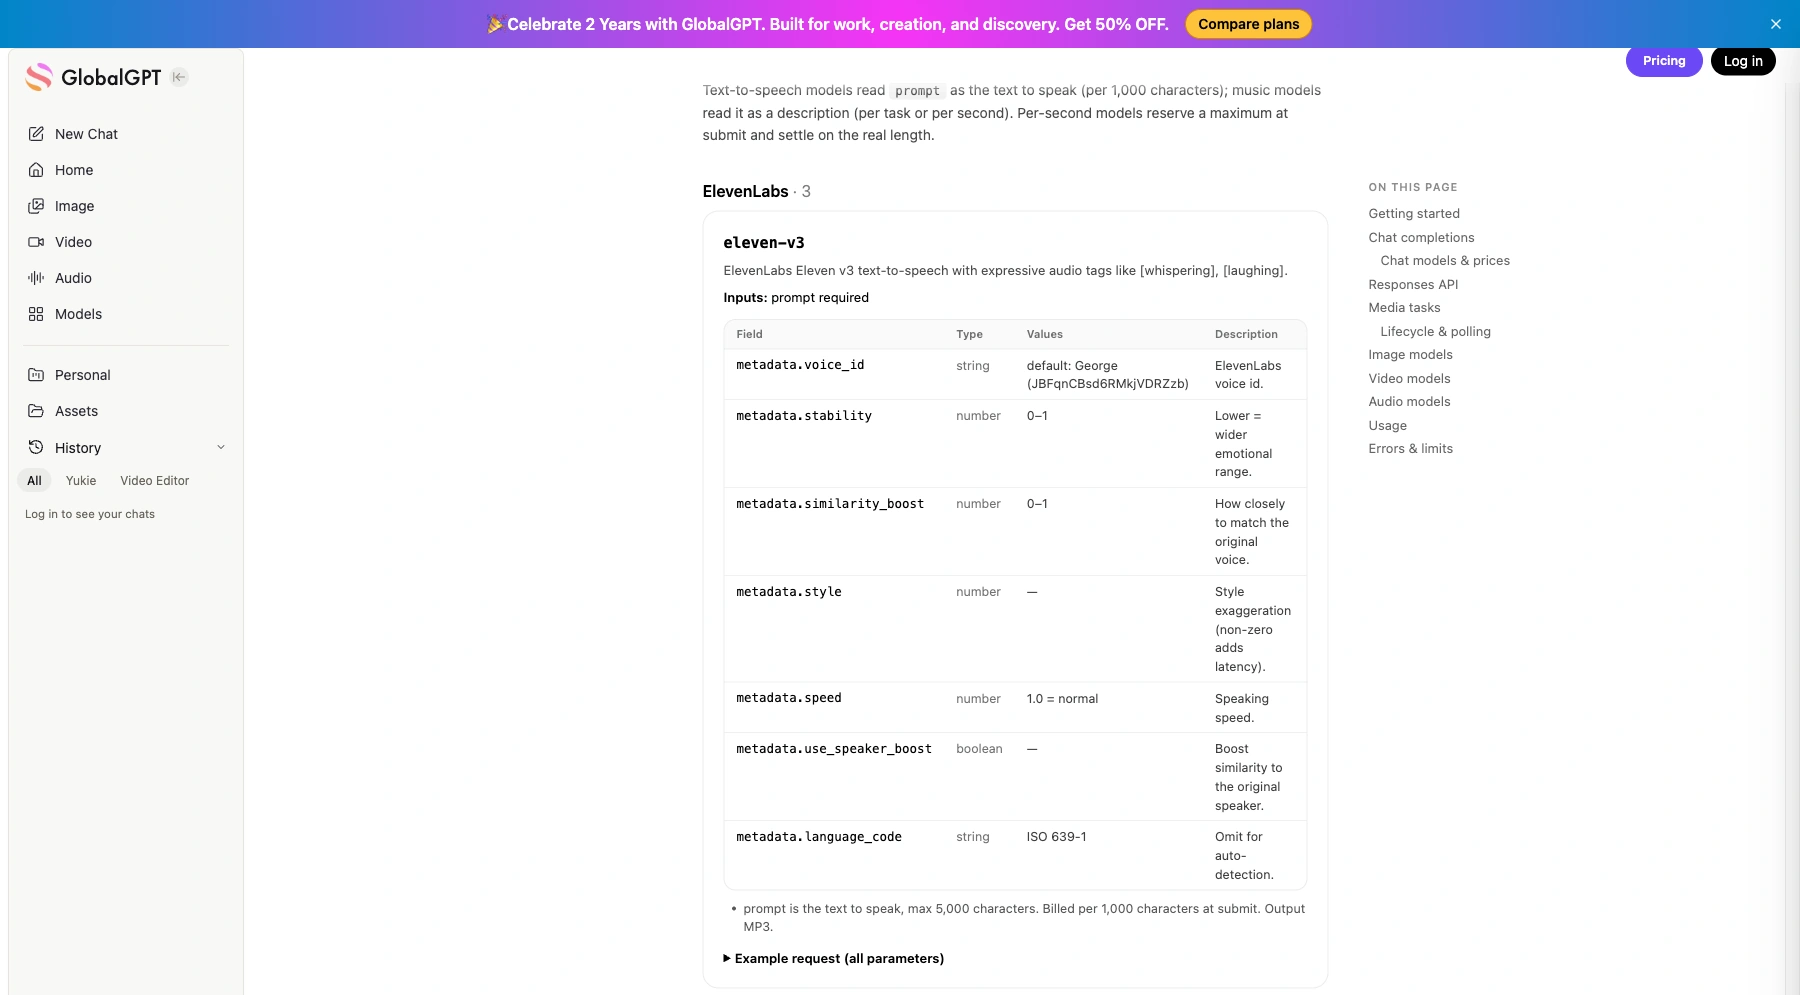
eleven-v3 | Até 5.000 caracteres; MP3 | Suporta tags de áudio expressivas. |
onze-multilíngue-v2 | Até 10.000 caracteres; MP3 | 29 idiomas; as tags de áudio são lidas como texto. |
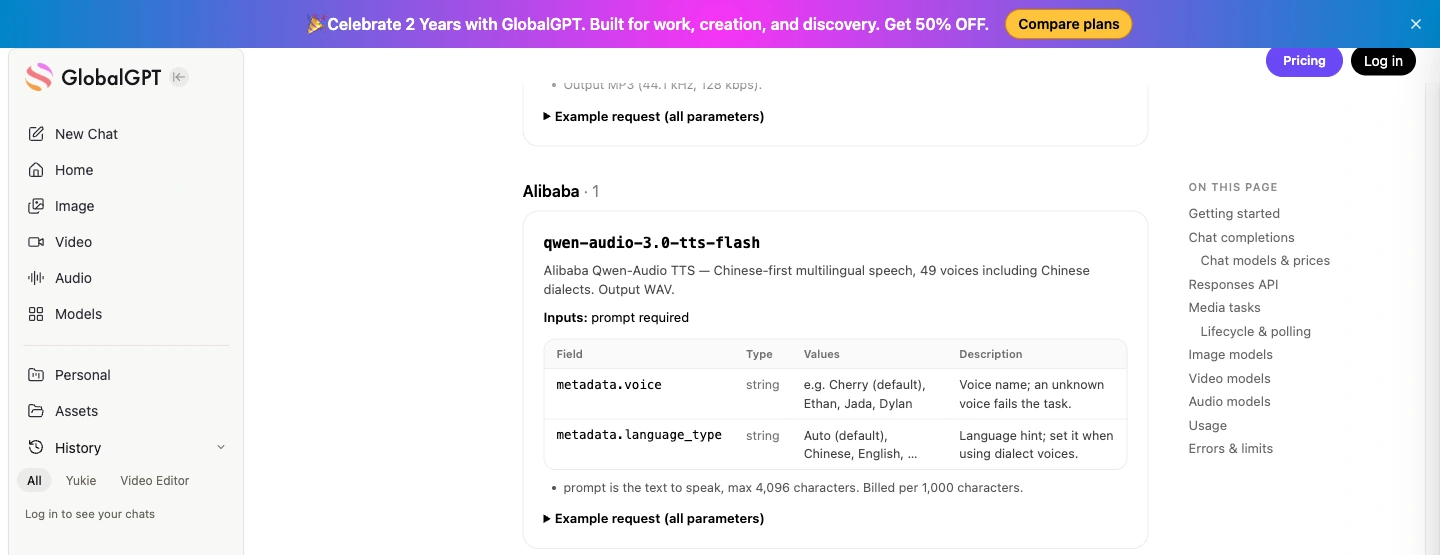
qwen-audio-3.0-tts-flash | Até 4.096 caracteres; WAV | 49 vozes; os controles de voz e idioma utilizam campos específicos do Qwen. |
Lista das três entradas 330 créditos por 1.000 caracteres. Usar POST /tasks/estimate com o corpo da solicitação pretendido para o orçamento em questão; a documentação indica que isso não cria nenhuma tarefa nem reserva créditos. O acesso à API pública utiliza créditos pagos.
Para conhecer o fluxo de trabalho de criação de forma mais abrangente, consulte fluxos de trabalho de conversão de texto em fala no GlobalGPT. Se você estiver pesquisando sobre a família de código aberto Qwen3-TTS, que possui um nome distinto, leia Modelos Qwen3-TTS e opções de API; não considere o ID do modelo Qwen-Audio acima como uma implantação Qwen3-TTS intercambiável.
Faça a estimativa, envie uma vez e, em seguida, consulte a tarefa salva
Instalar solicitações com python -m pip install requests e definir GLOBALGPT_API_KEY no servidor. O exemplo abaixo utiliza o Eleven v3, seleciona um ID de voz público documentado e define um limite máximo ilustrativo de 500 créditos. Altere esse limite para que corresponda ao seu próprio orçamento antes de executá-lo.
API pública da tarefa TTS GlobalGPT · Python
"""Instala o requests; define GLOBALGPT_API_KEY. Utiliza a API pública de tarefas do GlobalGPT."""
import json
import os
import time
import uuid
from pathlib import Path
import requests

BASE = "https://api2.glbgpt.com/ai-api/open/v1"
STATE = Path("globalgpt-tts-job.json")
OUTPUT = Path("globalgpt-product-tour.mp3")
MAX_CREDITS = 500  # Seu limite por tarefa; edite antes de executar.

payload = {
    "model": "eleven-v3",
    "prompt": (
 "Bem-vindo ao tour pelo produto do Acorn Studio. Em três etapas, você pode transformar "
 "um pequeno roteiro em um guia de áudio. Primeiro, escreva a mensagem. Em seguida, "
 "escolha uma voz. Por fim, salve o arquivo de áudio e teste a reprodução no seu celular."
    ),
    "metadata": {
 "voice_id": "JBFqnCBsd6RMkjVDRZzb",
 "stability": 0.5,
 "language_code": "en",
    },
}

api = requests.Session()
api.headers["Authorization"] = "Bearer " + os.environ["GLOBALGPT_API_KEY"]

if STATE.exists():
    job = json.loads(STATE.read_text())
    if job["payload"] != payload:
 raise RuntimeError("Este trabalho pertence a uma entrada diferente. Use um novo nome de arquivo de estado.")
else:
    estimate = api.post(BASE + "/tasks/estimate", json=payload, timeout=30)
    estimate.raise_for_status()
    quote = estimate.json()
    print("Créditos estimados:", quote["credits"])
    se quote["credits"] > MAX_CREDITS:
  raise RuntimeError("A estimativa excede seu limite máximo por tarefa.")
  job = {"payload": payload, "idempotency_key": str(uuid.uuid4())}
    STATE.write_text(json.dumps(job, indent=2))

se "task_id" não estiver em job:
    # A chave persistida mantém uma tentativa de retransmissão vinculada a esta solicitação específica.
    submitted = api.post(
 BASE + "/tasks", json=payload,
 headers={"Idempotency-Key": job["idempotency_key"]}, timeout=60,
    )
    submitted.raise_for_status()
    task = submitted.json()
    job["task_id"] = task["id"]
    STATE.write_text(json.dumps(job, indent=2))
    if task.get("ignored_parameters"):
 print("Parâmetros ignorados:", task["ignored_parameters"])

print("Tarefa:", job["task_id"])
deadline = time.monotonic() + 600
enquanto time.monotonic() < prazo:
    verificado = api.get(BASE + "/tasks/" + str(job["task_id"]), timeout=30)
    checked.raise_for_status()
    task = checked.json()
    if task.get("ignored_parameters"):
 print("Parâmetros ignorados:", task["ignored_parameters"])
    se task["status"] == "failed":
 raise RuntimeError("Falha na geração: " + json.dumps(task.get("error", {})))
    se task["status"] == "succeeded":
        # Use uma nova solicitação: não envie a chave da API para o servidor de mídia.
 audio = requests.get(task["output"]["url"], timeout=60)
 audio.raise_for_status()
        OUTPUT.write_bytes(audio.content)
 print("Salvo:", OUTPUT)
 break
    time.sleep(10)
else:
    raise TimeoutError("Tarefa ainda pendente. Execute novamente para consultar o ID da tarefa salva.")
O arquivo de tarefa armazena a solicitação exata, uma chave de idempotência e o ID da tarefa. Se a conexão for interrompida, execute novamente a mesma tarefa para que o código possa retomar a tarefa existente. Para gerar intencionalmente um áudio diferente, use um novo nome de arquivo para a tarefa. Mantenha o arquivo de tarefa privado se o script contiver informações confidenciais.
Verificar parâmetros_ignorados assim, uma configuração não suportada não se torna automaticamente sua configuração padrão. Os controles ElevenLabs, como voice_id diferem dos do Qwen voz e tipo_de_língua campos. Verificar a cada 5–10 segundos, lidar com um falhou status e salvar imediatamente os arquivos processados com sucesso: o tempo de retenção dos resultados documentado é 30 dias.
Ouça dois exemplos de apresentações de produtos
Essas duas amostras geradas por IA utilizam o mesmo roteiro de apresentação do produto, com 216 caracteres, com o Eleven v3 e o Qwen Audio 3.0 TTS Flash. Cada uma é a primeira saída de uma solicitação, com configurações de voz padrão. Elas oferecem dois arquivos curtos para você analisar e ouvir; não se trata de uma comparação controlada de vozes correspondentes nem de um benchmark de voz do OpenAI.
Eleven v3: áudio do tour pelo produto
eleven-v3 · exemplo de tour pelo produto
- Saída
- MP3 · mono · 44,1 kHz
- Comprimento
- Cerca de 15,6 segundos
- Geração
- Primeira saída · 1 solicitação
Configurações: o texto exato abaixo, a voz padrão e outras configurações; sem substituição de voz nem instruções de entonação. A identidade da voz padrão não foi gravada.
Status e cronograma: A geração foi bem-sucedida. Os carimbos de data e hora do servidor da tarefa indicam 13 segundos entre o envio e a conclusão; trata-se de uma única solicitação, e não de um teste de latência.
Observação sobre o arquivo: O arquivo MP3 contém um fluxo mono a 44,1 kHz e tem aproximadamente 251 kB. Seus quadros podem ser lidos até o final do arquivo.
Referência de custo: A tarifa do catálogo público é de 330 créditos por 1.000 caracteres. Utilize uma estimativa de tarefa para uma nova solicitação; essa tarifa não constitui uma fatura para a amostra.
Aplicação prática: Um arquivo MP3 compacto para ouvir uma breve demonstração do produto. Verifique o texto completo e a reprodução no dispositivo de destino antes de utilizá-lo em um lançamento.
Leia a entrada exata · 216 caracteres
Bem-vindo ao tour pelos produtos do Acorn Studio. Em três etapas, você pode transformar um pequeno roteiro em um guia de áudio. Primeiro, escreva a mensagem. Em seguida, escolha uma voz. Por fim, salve o arquivo de áudio e teste a reprodução no seu celular.
Qwen Áudio 3.0 TTS Flash: áudio da apresentação do produto
qwen-audio-3.0-tts-flash · exemplo de apresentação do produto
- Saída
- WAV · mono · 24 kHz
- Comprimento
- 15,52 segundos de dados PCM
- Geração
- Primeira saída · 1 solicitação
Configurações: o texto exato abaixo, a voz padrão e outras configurações; sem substituição de voz nem instruções de entonação. A identidade da voz padrão não foi gravada.
Status e cronograma: A geração foi bem-sucedida. Os carimbos de data e hora do servidor da tarefa indicam 17 segundos entre o envio e a conclusão; trata-se de uma única solicitação, e não de um teste de latência.
Observação sobre o arquivo: O arquivo WAV contém áudio mono em formato PCM de 16 bits a 24 kHz e tem aproximadamente 745 kB. Seu cabeçalho indica uma quantidade de dados maior do que a que o arquivo realmente contém; a saída original foi preservada aqui.
Referência de custo: A tarifa do catálogo público é de 330 créditos por 1.000 caracteres. Utilize uma estimativa de tarefa para uma nova solicitação; essa tarifa não constitui uma fatura para a amostra.
Aplicação prática: Um arquivo WAV de amostra para avaliar o fluxo de trabalho de narração. Resolva a inconsistência no comprimento do cabeçalho em seu pipeline de produção e verifique se a reprodução está completa antes da distribuição.
Leia a entrada exata · 216 caracteres
Bem-vindo ao tour pelos produtos do Acorn Studio. Em três etapas, você pode transformar um pequeno roteiro em um guia de áudio. Primeiro, escreva a mensagem. Em seguida, escolha uma voz. Por fim, salve o arquivo de áudio e teste a reprodução no seu celular.
A amostra Qwen tem cerca de três vezes o tamanho da amostra Eleven, com duração semelhante, o que reflete as diferenças entre os formatos WAV e MP3. Seu cabeçalho WAV também declara mais dados do que o arquivo contém fisicamente. Trata-se de um problema de compactação de arquivo que vale a pena verificar no seu reprodutor de destino; por si só, isso não indica nada sobre a qualidade da voz falada.
Corrigir problemas comuns na geração de fala
| Sintoma | O que verificar primeiro |
|---|---|
| O arquivo MP3 salvo não é reproduzido | Verifique o status HTTP e o tipo de resposta. É possível que um erro da API tenha sido salvo com uma extensão de áudio. |
| A solicitação rejeita uma voz ou uma instrução | Associe a voz e os campos opcionais ao modelo selecionado. Os modelos TTS OpenAI mais antigos não aceitam instruções. |
| Um roteiro muito longo é rejeitado | Verifique o limite de caracteres da rota e o limite de tokens do Mini TTS e, em seguida, divida o texto em pontos de separação naturais. |
| Aparece uma resposta 401 ou 429 | Verifique se a chave/conta apresenta o código 401. No caso do código 429, diferencie os limites de taxa da cota insuficiente antes de tentar novamente. |
| Uma solicitação GlobalGPT continua pendente | Consulte o ID da tarefa salva e verifique o status; um tempo limite esgotado não é motivo para enviar um trabalho duplicado. |
| A voz não corresponde às configurações solicitadas | Verifique os metadados específicos do modelo e os `ignored_parameters` antes de presumir que a configuração foi aplicada. |
| A barra de duração ou de navegação do áudio parece estar errada | Compare os metadados do arquivo com o conteúdo real da mídia e teste o arquivo completo no reprodutor de destino. |
No caso de um erro OpenAI, comece verificando o orientações sobre códigos de erro. Para uma tarefa GlobalGPT, salve o ID da tarefa e os detalhes do erro retornado. Durante o desenvolvimento, mantenha separadas as falhas de transporte, as falhas de faturamento e as gravações de voz insatisfatórias: cada uma delas requer uma solução diferente.
Antes de enviar a narração, ouça a gravação completa no dispositivo que seu público utilizará. Verifique a introdução, os nomes e números, as transições e a frase final. Inclua uma declaração sobre o uso de voz gerada por IA no início da reprodução e mantenha uma cópia do texto exato e das configurações do modelo para que um roteiro editado possa ser regenerado de forma precisa.
Perguntas frequentes
O que é o endpoint da API de áudio e fala OpenAI?
Envie uma solicitação POST para https://api.openai.com/v1/audio/speech. Os campos obrigatórios são model, input e voice. A resposta é um arquivo de áudio gerado; o formato padrão é MP3.
A API de fala OpenAI é gratuita?
A API de Fala possui uma estrutura de preços baseada no uso. Faça seu orçamento com base nas tarifas atuais da API, em vez de partir do pressuposto de que há uma cota gratuita: o serviço GPT-4o Mini TTS é cobrado por tokens de entrada de texto e saída de áudio, enquanto o TTS-1 e o TTS-1 HD são cobrados por caracteres.
Posso controlar a voz e o estilo de fala?
Escolha uma voz compatível com o seu modelo. O GPT-4o Mini TTS também aceita instruções sobre o tom de voz, como um tom caloroso ou calmo. O campo de instruções não funciona com o TTS-1 nem com o TTS-1 HD.
A API de Reconhecimento de Fala oferece suporte a streaming?
Sim. Ele pode transmitir o áudio gerado em blocos. Seu aplicativo ainda precisa cuidar da reprodução; a transmissão da conversão de texto em fala, por si só, não proporciona uma conversa em tempo real completa.
Posso usar o GlobalGPT alterando a URL base do OpenAI?
Utilize o fluxo de trabalho documentado de tarefas de mídia do GlobalGPT para TTS: envie a solicitação POST para /tasks, consulte o GET para /tasks/{id} e baixe o arquivo output.url após a conclusão bem-sucedida. Seu catálogo documentado de TTS inclui os modelos ElevenLabs e Qwen, cada um com seus próprios IDs e parâmetros.
Por qual formato de áudio devo começar?
Comece com o formato MP3 para um download simples ou para reprodução na web. O formato WAV é útil quando o próximo passo for a edição. O PCM bruto requer um reprodutor configurado para sua taxa de amostragem e profundidade de bits, pois não possui cabeçalho de arquivo.
Comece com um script curto, uma voz e um arquivo salvo. Quando a reprodução e os custos estiverem previsíveis, adicione o agrupamento, as tentativas de repetição e o restante do seu fluxo de trabalho de mídia. Mantenha o formato de solicitação, as unidades de cobrança e o tratamento de saída da API escolhida de forma integrada em sua implementação.
Dê voz ao seu próximo roteiro
Elabore um breve tour pelo produto, crie uma narração com o ElevenLabs ou o Qwen e continue com imagens e vídeos no espaço de trabalho multimodelo do GlobalGPT.
Crie áudio de voz com o GlobalGPT








