Op bewijs gebaseerde evaluatie · augustus 2026
Open gewichten, gehoste API’s en de naamgevingskloof – overzichtelijk in kaart gebracht.
Bewijsgrens: Er wordt geen luisterscore uit de eerste hand voor Qwen3-TTS opgegeven.
Een nuttige beoordeling van Qwen3-TTS moet, voordat de stemmen worden beoordeeld, eerst een fundamentele vraag beantwoorden: over welke Qwen3-TTS hebben we het eigenlijk? In 2026 omvat de naam downloadbare 0,6B- en 1,7B-checkpoints, door Alibaba Cloud gehoste Qwen3-TTS-API's en een markt waar ook de afzonderlijke Qwen-Audio 3.0 TTS-familie wordt aanbevolen. Als deze producten als één geheel worden beschouwd, leidt dit tot misleidende beweringen over snelheid, taal en prijzen.
Het korte antwoord is dat Qwen3-TTS een van de meest flexibele open spraakstacks van 2026 is. Het biedt tien talen, taakspecifieke checkpoints, spraakklonen in ongeveer drie seconden, spraakontwerp in natuurlijke taal, ondersteuning voor streaming en een Apache-2.0-release. Deze review bevat echter geen luisterscore: de beschikbare testomgeving stelde geen echt Qwen3-TTS-eindpunt beschikbaar, en de lokale GPU van 2 GB was niet geschikt voor een representatieve benchmark tussen 0,6B en 1,7B.
Status van Qwen3-TTS in 2026
Qwen heeft op 22 januari 2026 de open Qwen3-TTS-gewichten bekendgemaakt. De officiële Qwen3-TTS-repository geeft een overzicht van vijf vrijgegeven 12Hz-checkpoints: 1,7B VoiceDesign, 1,7B CustomVoice, 1,7B Base, 0,6B CustomVoice en 0,6B Base. De bijbehorende Hugging Face-collectie omvat ook de tokenizer. Dit zijn de modellen die ontwikkelaars kunnen bekijken, downloaden en uitvoeren onder de gepubliceerde licentie.
Alibaba Cloud biedt afzonderlijk de productfamilies Qwen3-TTS Flash, Instruct, stemklonen en stemontwerp aan via niet-realtime en realtime interfaces. Het huidige catalogus van spraaksynthesemodellen moet worden beschouwd als de betrouwbare bron voor gehoste aliassen, regio’s, talen en interfaces, aangezien deze gegevens kunnen veranderen zonder dat de namen van de open checkpoints worden gewijzigd.
Er is nog een klein puntje van opmerking met betrekking tot de naamgeving. In de richtlijnen voor modelkeuze van Alibaba Cloud voor 2026 wordt gebruikers voor verschillende gehoste taken ook Qwen-Audio 3.0 TTS aanbevolen. Qwen-Audio 3.0 TTS is geen hernoemd 0.6B- of 1.7B-Qwen3-TTS-checkpoint. Als u de bredere Qwen-familie al volgt, dan is onze Qwen 3.8: Overzicht van maximale specificaties en toegankelijkheid laat zien waarom het belangrijk is om modellen binnen de Qwen-producten een exacte naam te geven.
Gebruik de naam van het open checkpoint voor lokale inferentie, de exacte Alibaba Cloud-model-ID voor API-functionaliteit, en Qwen-Audio 3.0 TTS uitsluitend als afzonderlijk alternatief. Zo blijven alle claims met betrekking tot kwaliteit, latentie en prijs gekoppeld aan het product waarmee ze zijn gegenereerd.
Kort oordeel: krachtig, open en gevoelig voor bewijsmateriaal
Kort oordeel
Open implementatie, onderzoek, klonen en personagestemmen.
Vijf taakgerichte controlepunten, verdeeld over twee maten.
De snelheid van de leverancier is afhankelijk van de omgeving; de kwaliteit wordt hier niet beoordeeld.
De gehoste Qwen3-TTS en Qwen-Audio 3.0 zijn afzonderlijke routes.
Qwen3-TTS is vooral aantrekkelijk voor teams die controle en keuzevrijheid bij de implementatie willen. De Base-checkpoints ondersteunen klonen, CustomVoice biedt vooraf ingestelde sprekers met een eigen naam en instructiebesturing, en VoiceDesign kan een stem creëren op basis van een schriftelijke beschrijving. Dankzij de ondersteuning voor tien talen is de stack veel bruikbaarder dan een open demo die alleen in het Engels beschikbaar is, terwijl de 0.6B-versies ontwikkelaars een kleiner startpunt bieden.
Het belangrijkste punt van aandacht is de kwaliteit van de gegevens. Qwen rapporteert sterke benchmarkresultaten en een lage latentie van het eerste pakket in een geoptimaliseerde interne omgeving. Uit die cijfers blijkt echter niets over het opstarten van laptops vanuit de slaapstand, de beschikbare VRAM-capaciteit in containers of de uitspraak van uw productnamen. Bij de belofte van een universele latentie van 97 ms worden de benchmarkomstandigheden buiten beschouwing gelaten.
Voor een zelfgehost prototype behoort Qwen3-TTS tot de top van de shortlist. Voor een productie-API moet je de gehoste Qwen3-TTS-optie vergelijken met de nieuwere aanbevelingen voor Qwen-Audio, de operationele ondersteuning, de regionale beschikbaarheid en de kosten voor het beheer van gekloonde stemmen. Als uw doel verder reikt dan spraak en zich uitstrekt tot geluidseffecten of muziek, dan is het bredere Seed Audio 1.0: tests met stemmen, geluidseffecten en muziek een andere, meer multimodale audio-workflow behandelen.
Kortom: Qwen3-TTS presteert uitstekend op het gebied van architectuur, openheid en de dekking van functies. De daadwerkelijke productiekwaliteit hangt nog steeds af van het exacte controlepunt of eindpunt, uw hardware, de door u gebruikte taal en een goedgekeurde referentiestem die met uw eigen scripts is getest.
Wat is Qwen3-TTS?
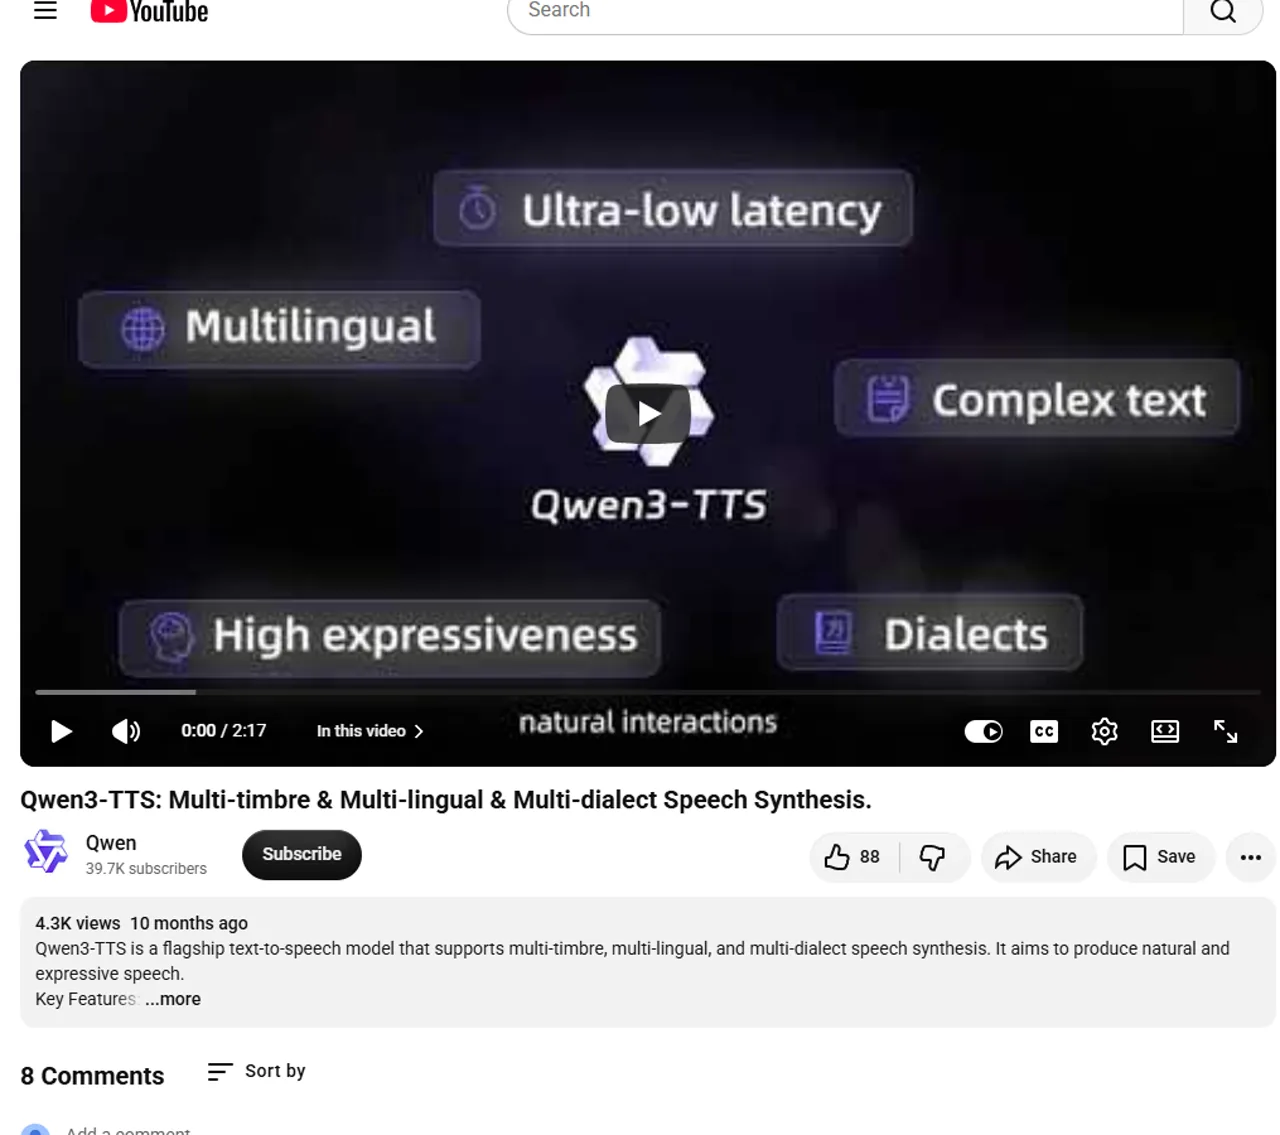
Qwen3-TTS is een reeks modellen voor spraakgeneratie die is gebaseerd op een discrete spraaktokenizer die werkt met een snelheid van 12,5 frames per seconde. Volgens de Technisch rapport Qwen3-TTS, het systeem is getraind op basis van meer dan vijf miljoen uur aan gegevens in tien talen. Het lage aantal tokens staat centraal in het ontwerp: met minder akoestische tokens kan de decoderingsinspanning worden verminderd en wordt streaming praktischer, terwijl het model toch de klankkleur, uitspraak en prosodie moet behouden.
Drie niveaus, drie bewijsregels
0,6 miljard / 1,7 miljard
Base, CustomVoice en 1.7B VoiceDesign. Te gebruiken voor claims op basis van lokale modellen.
Flash / Instruct / VC / VD
Gebruik de exacte API-modelnaam, interface, regio en datum.
Qwen-Audio 3.0 TTS
Een huidig gehost alternatief, geen omgedoopt open checkpoint.
De vijf vrijgegeven checkpoints zijn taakspecifiek en vormen geen ladder waarbij elk groter model alles kan:
| Vrijgegeven controlepunt | Afmetingen | De meest geschikte vacature | Belangrijke grens |
|---|---|---|---|
| Qwen3-TTS-12Hz-0,6B-Base | 0,6 miljard | Kleinere klonerings- en onderzoeksworkflows | Geen vooraf ingestelde CustomVoice-catalogus |
| Qwen3-TTS-12Hz-1,7B-Base | 1,7 miljard | Kloon- en vervolgwerkzaamheden op grotere schaal | Er is meer geheugen en rekenkracht nodig |
| Qwen3-TTS-12Hz-0,6B-CustomVoice | 0,6 miljard | Vooraf ingestelde stemmen met instructiebesturing | Maakt gebruik van de vrijgegeven luidsprekerset |
| Qwen3-TTS-12Hz-1,7B-CustomVoice | 1,7 miljard | Stem-synthese met vooraf ingestelde stemmen en grotere capaciteit | Niet het VoiceDesign-controlepunt |
| Qwen3-TTS-12Hz-1,7B-VoiceDesign | 1,7 miljard | Een klankkleur creëren op basis van een tekstuele beschrijving | Er is geen VoiceDesign-peer 0.6B uitgebracht |
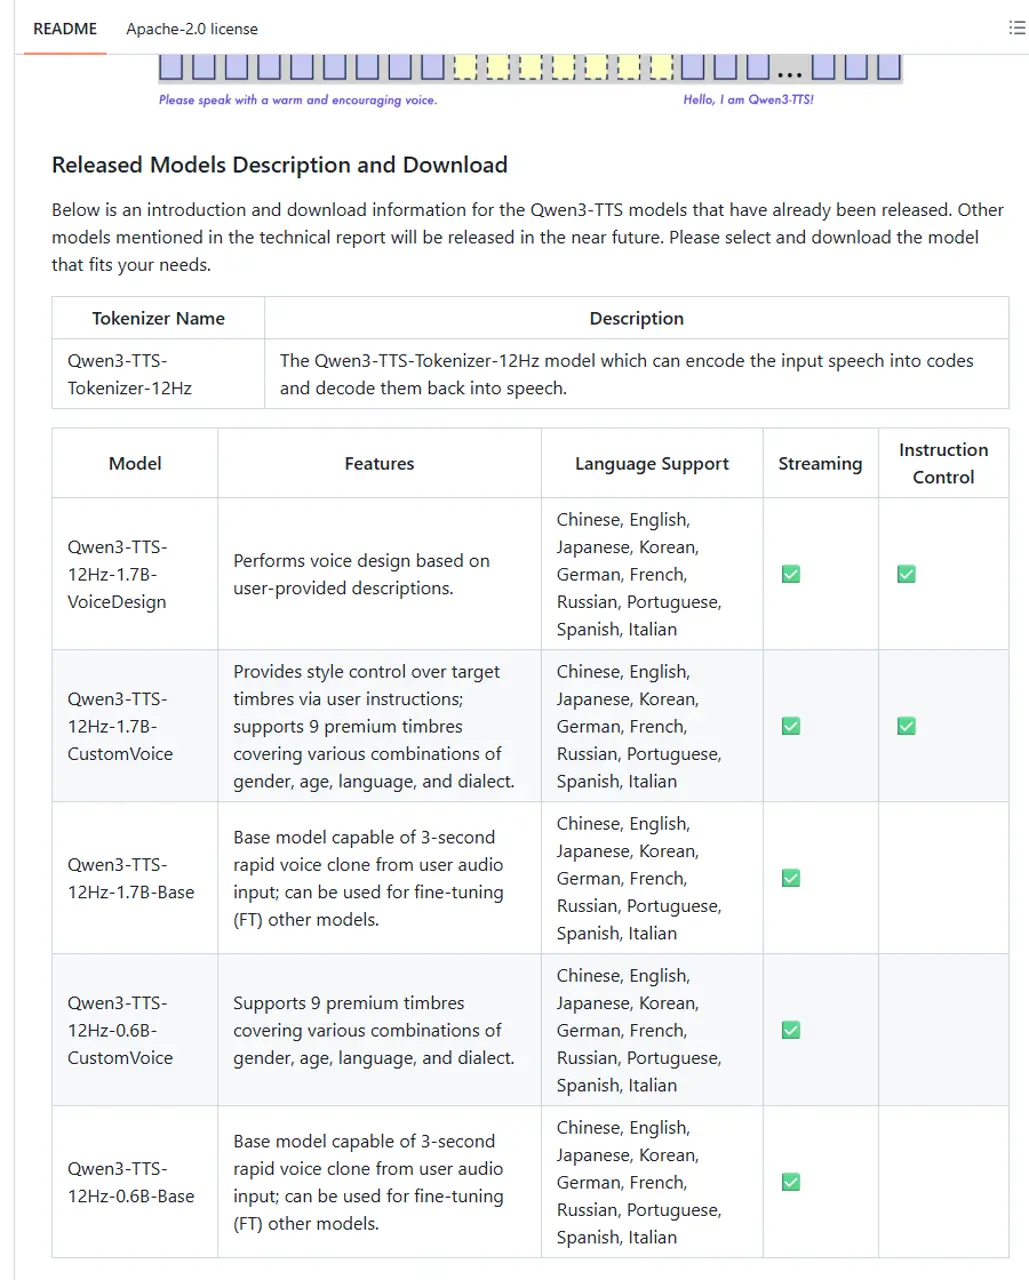
Base is de juiste keuze als je een referentieluidspreker hebt en toestemming om die stem te gebruiken. CustomVoice is de eenvoudigste optie wanneer een van de door Qwen uitgebrachte vooraf ingestelde klankkleuren bij het project past. VoiceDesign is bedoeld voor een karakterbeschrijving zoals “een rustige, volwassen verteller met een zacht laag register”, waarbij geen referentieopname nodig is.
Een producttutorial hoeft niet te worden gekloond als een vooraf ingestelde verteller volstaat, en voor een fictief personage is de opname van een echte persoon wellicht niet nodig als VoiceDesign een passende identiteit creëert. Beoordeel elke taak aan de hand van het bijbehorende controlepunt.
Hoe deze Qwen3-TTS-recensie tot stand is gekomen
Het onderzoek is gebaseerd op vier bewijsbronnen: officiële documentatie, het technische rapport over de Qwen, een inspectie van de lokale hardware en een gecontroleerde test van een afzonderlijke, extern gehoste audio-wrapper. Officiële bronnen ondersteunen de productgegevens en de door de leverancier gerapporteerde benchmarks. De test met de wrapper bevestigt alleen het waargenomen gedrag ervan, en niet een Qwen3-TTS-score voor de spraakkwaliteit.
De beschikbare taakomgevingen in de lijst qwen-audio-3.0-tts-flash, geen qwen3-tts-* model.
Maak een heldere spraakopname in het Engels. Lees precies voor: 'Bij zonsopgang controleerde het onderzoeksteam elk signaal twee keer voordat het de uitslag bekendmaakte.' Gebruik een warme, rustige volwassen vertelstem, een natuurlijk spreektempo, duidelijke medeklinkers en een korte pauze na 'zonsopgang'. Voeg geen muziek, geluidseffecten, een inleiding of woorden toe die niet in de geciteerde zin voorkomen.In onze test leverde deze invoer een MP3-bestand van 21,263673 seconden op en werden de aanwijzingen hardop voorgelezen. Uit het testresultaat bleek dat de wrapper de volledige prompt als spraaktekst behandelde.
Bij zonsopgang controleerde het onderzoeksteam elk signaal twee keer voordat het de uitslag bekendmaakte.We hebben de controleproef herhaald met alleen de doelzin. In onze test leverde dit een MP3-bestand op van 6,086531 seconden, met een frequentie van 22.050 Hz, een bitsnelheid van 128 kbps en in mono. Het kwam woord voor woord overeen met de doelzin en bevatte geen instructies.
De gebruiker heeft beide bestanden beluisterd en de onderstaande beoordelingen bevestigd. Dit is een praktische controle door één luisteraar, geen MOS-onderzoek of luisterpanel.
| Luisterdimensie | Regeling met instructies | Controle van platte tekst |
|---|---|---|
| Natuurlijkheid | 4/5 | 5/5 |
| Verstaanbaarheid | 5/5 | 5/5 |
| Uitspraak | 5/5 | 5/5 |
| Prosodie | 4/5 | 5/5 |
| Tekstgetrouwheid | 1/5 | 5/5 |
| Naleving van de stijlrichtlijnen | Niet gescoord | 5/5 |
| Afwezigheid van artefacten | 5/5 | 5/5 |
| Gebruiksvriendelijkheid van de productie | 1/5 | 5/5 |
Het voorbeeld met instructies klonk helder en over het algemeen natuurlijk, maar het voorlezen van de instructies ging ten koste van de tekstgetrouwheid en de bruikbaarheid voor de productie. Het voorbeeld in platte tekst klonk natuurlijk, volgde de zin precies en hoefde inhoudelijk niet te worden bijgewerkt. Deze scores hebben alleen betrekking op de twee qwen-audio-3.0-tts-flash wrapper-besturingselementen; het gaat hier niet om een beoordeling van de spraakkwaliteit van het Qwen3-TTS-controlepunt.
Ga er nooit vanuit dat stijlanwijzingen en de vertelling tot hetzelfde gebied behoren. Onze gids voor AI-geschreven toespraken menselijker laten klinken verbetert het script, maar de eindpuntvelden bepalen of de aanwijzingen de stem aansturen of de opname starten.
Bij een lokale inspectie werd een NVIDIA GeForce MX450 met 2 GB VRAM en ongeveer 16,9 GB systeemgeheugen aangetroffen. Dat is geen geschikt platform voor de geplande 0,6B-versus-1,7B-matrix. CPU-offload zou een proefversie kunnen zijn en geen representatieve snelheid weergeven. De spraakkwaliteit van Qwen3-TTS, lokale RTF, gelijkenis bij het klonen en consistentie tussen talen blijven daarom onbeoordeeld.
Qwen3-TTS-geluidskwaliteit: wat uit onderzoek blijkt
Uit het officiële rapport blijken sterke resultaten van Qwen3-TTS op het gebied van verstaanbaarheid, gelijkenis met de spreker, het opvolgen van instructies, meertalige generatie, lange spraakfragmenten en streaming. Dit zijn nuttige vergelijkingspunten, maar het blijft bij door Qwen gerapporteerde benchmarks en niet om opnames gaat die hier zijn gegenereerd.
Een spraaktest voor productiedoeleinden moet betrekking hebben op uitspraak, storende geluiden, spreektempo, emotie, herhaalbaarheid, bewerkingsinspanning, afkortingen, datums, valuta’s, URL’s, namen, codewisseling en lange zinnen.
Combineer het luisteren met transcripties en metagegevens; de ChatGPT-workflow voor audiotranscriptie zorgt ervoor dat de tekstcontrole herhaalbaar is.
De Qwen3-TTS ziet er veelbelovend uit, maar deze review bevat geen checkpoint-score uit eigen ervaring. Test het apparaat vóór verzending met verschillende generaties, de ingebouwde luidsprekers, een koptelefoon en de luidsprekers van de telefoon.
Waar externe recensenten de nadruk op legden
De sociale demo van Qwen laat verschillende klankkleuren, talen en dialecten horen. Onafhankelijk ontwikkelaar Bijan Bowen legde de nadruk op lokale implementatie en stemklonen; Jeff Geerling beschreef de release als een sterke open-source-concurrent voor beheerde TTS-platforms. Dit zijn de standpunten van recensenten, geen benchmarkresultaten of bewijs van een marktbrede consensus.
Qwen3-TTS: snelheid en latentie
Latentie van het eerste pakket
0.288 / 0.313
0,6B / 1,7B bij gelijktijdigheid 1.
Geoptimaliseerde interne vLLM-omgeving — geen garantie voor de laptop.
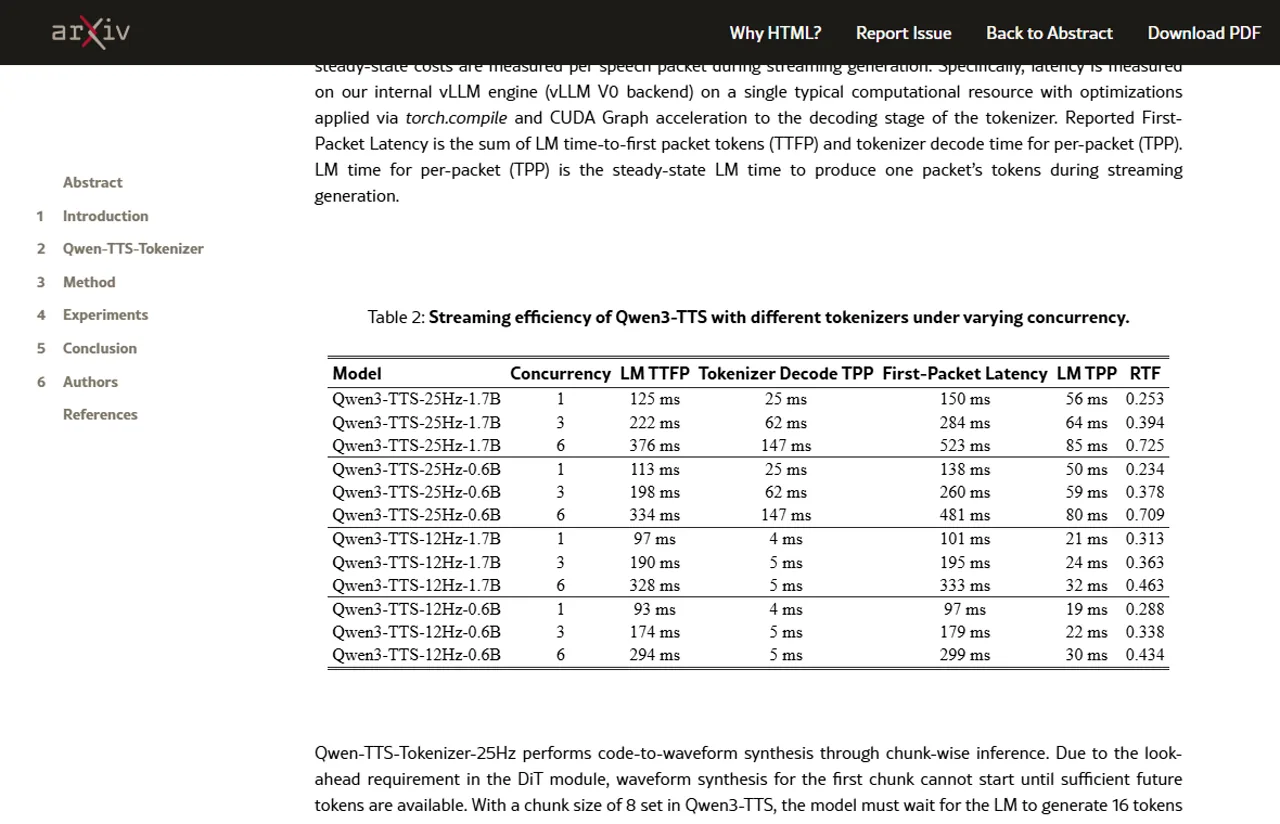
Het opgegeven snelheidscijfer is een latentie van 97 ms voor het eerste pakket bij het 0,6B 12Hz-model. In dezelfde tabel uit het technisch rapport staat 101 ms vermeld voor het 1,7B 12Hz-model bij een gelijktijdigheidsgraad van 1. De gerapporteerde real-time factoren waren respectievelijk 0,288 en 0,313. Eenvoudig gezegd betekent een RTF onder de 1 dat de synthese sneller verliep dan de duur van de gegenereerde audio in die omgeving.
Deze resultaten zijn afkomstig van de geoptimaliseerde interne vLLM-configuratie van Qwen. Het gaat hier niet om algemene beloften inzake de ‘time-to-first-audio’ voor een Windows-laptop, een koud opgestarte serverloze container of een gedeelde API-regio. Het rapport laat ook zien dat gelijktijdigheid de latentie beïnvloedt. Het laden van het model, de verwerking van referentie-audio, de doorgifte via het netwerk, wachtrijen, het verpakken van audio en het afspelen door de client kunnen allemaal buiten het aantal kern-decoders vallen.
Een representatief benchmarkrapport moet het volgende bevatten:
- Hardware, precisie, modelherziening en aandacht voor de backend.
- Koude of warme toestand, gelijktijdigheid, tijd tot eerste geluid, totale tijd, piek-VRAM, uitvoerduur en RTF.
- Voor een API: regio, verbindingstype, verzoek-ID, wachtrij en herhalingspogingen.
Het 0,6B-model is waarschijnlijk de veiligere keuze wanneer geheugen en gelijktijdigheid belangrijker zijn dan maximale capaciteit. Het 1,7B-model is de verstandigere keuze als het gaat om kwaliteit, mits de machine voldoende rekenkracht over heeft. Maar zonder dezelfde prompt, spreker, bemonsteringsinstellingen en opwarmtoestand te gebruiken, kan de modelgrootte op zichzelf geen uitsluitsel geven over het werkelijke verschil in latentie.
Qwen3-TTS: talen en uitspraak
De open Qwen3-TTS-checkpoints ondersteunen tien talen: Chinees, Engels, Japans, Koreaans, Duits, Frans, Russisch, Portugees, Spaans en Italiaans. Deze lijst is afkomstig uit de huidige repository en het vrijgegeven modelmateriaal. Voeg niet stiekem Thais, Indonesisch, Maleis of Vietnamees toe, omdat een ander Qwen-audioproduct deze talen al ondersteunt.
| Taal | Officiële open ondersteuning | Prioriteit bij de productie-evaluatie |
|---|---|---|
| Chinees | Ja | Klanken, namen, het voorlezen van getallen, regionale tekststijl |
| Engels | Ja | Stress, afkortingen, merknamen, lange zinnen |
| Japans | Ja | Toonaccent, partikels, namen, gemengde Latijnse tekst |
| Koreaans | Ja | Spatiëring, leenwoorden, zinsafsluitingen |
| Duits | Ja | Samenstellingen, getallen, medeklinkercombinaties |
| Frans | Ja | Contactpersoon, afkortingen, geleende namen |
| Russisch | Ja | Stress, namen, cijfers, Latijnse invoegingen |
| Portugees | Ja | Controleer of het beoogde regionale accent en de spelling kloppen |
| Spaans | Ja | Controleer of regionale accenten en eigennamen correct zijn weergegeven |
| Italiaans | Ja | Stress, geminatie, buitenlandse namen |
“Met ”ondersteunt“ wordt bedoeld dat het model de taal kan genereren; dit betekent niet dat elke stem in elke regio even natuurlijk klinkt. Alleen al het Portugees en het Spaans kennen belangrijke regionale verschillen. Bij een commerciële implementatie moet de doellocatie worden vastgesteld, moeten moedertaalsprekers worden aangetrokken en moet een regressiedataset voor uitspraak worden samengesteld voor namen, maten, adressen en juridische uitdrukkingen.
Voor code-switching is een aparte test nodig. Een zin als “Open de Qwen3-TTS API in São Paulo om 9.30 uur” combineert een Engelstalige context, een modelnaam, Portugese uitspraak, leestekens en een tijdsaanduiding. Dat komt veel dichter in de buurt van echte app-teksten dan een keurige, eentalige demozin. Bij het nasynchroniseren van video’s moet de uitspraak ook op de timing aansluiten; onze Veo 3.1 Werkstroom voor dialoog, audio en lipsynchronisatie gaat in op het bijbehorende synchronisatieprobleem.
Stemklonen, CustomVoice en VoiceDesign
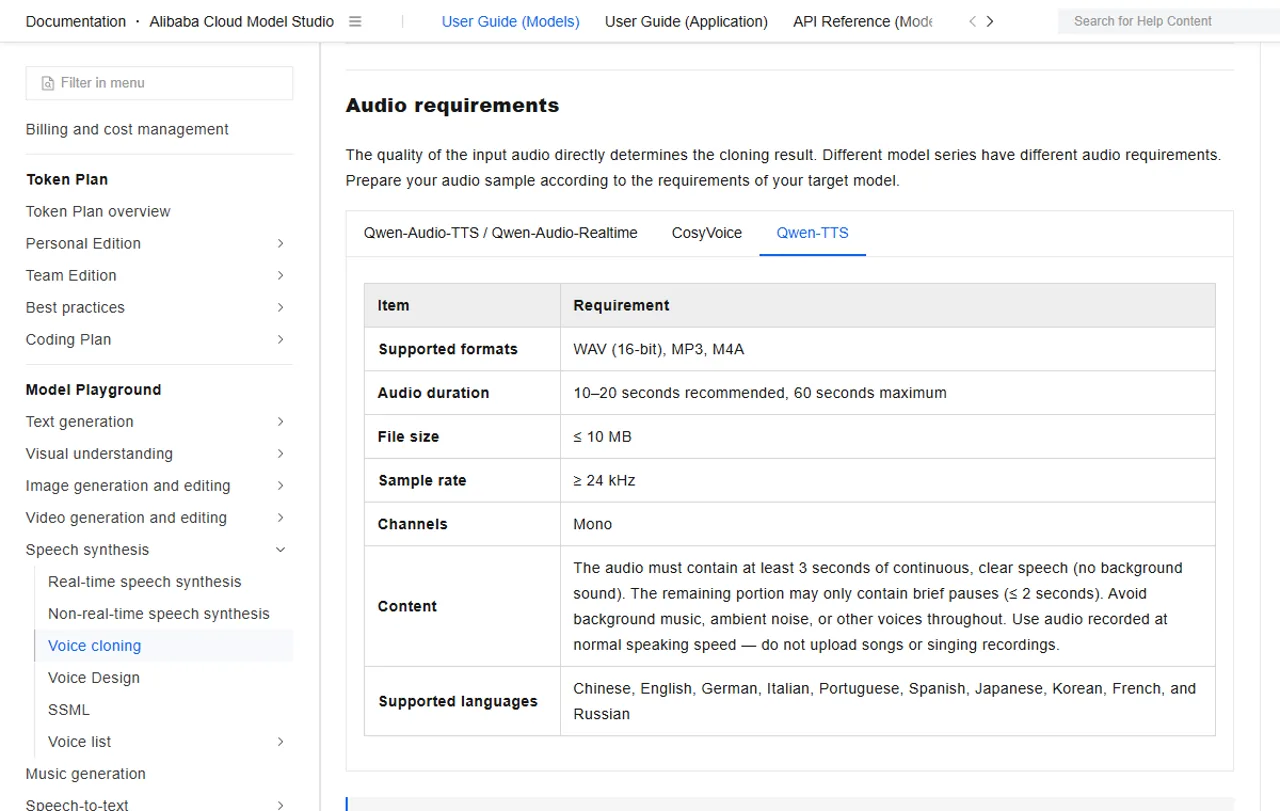
De Base-checkpoints ondersteunen snelle stemkloning op basis van ongeveer drie seconden referentie-audio. Dat is een indrukwekkende minimumnorm, maar geen garantie dat drie seconden altijd het beste productiemateriaal is. Bij korte referenties kunnen het toonbereik, het spreektempo, de dekking van de klinkers, de emotie en de consistentie van de microfoonontvangst ontbreken.
De richtlijnen voor geregistreerde spraak van Alibaba Cloud zijn wat conservatiever: er is minimaal drie seconden ononderbroken, duidelijke spraak vereist, langere opnames zijn toegestaan en voor het klonen in de praktijk wordt een duidelijkere, langere opname aanbevolen. Volg de huidige documentatie over stemklonen voor regels met betrekking tot het formaat, de samplefrequentie, het aantal kanalen, de duur en de regio, in plaats van de demonstratie van drie seconden in het artikel als een uploadspecificatie te beschouwen.
CustomVoice vermijdt het klonen van een echt persoon. De open release bevat negen premium klankkleuren voor verschillende talen of stijlen, wat het aantrekkelijk maakt wanneer een vooraf ingestelde identiteit en instructiebesturing volstaan.
VoiceDesign genereert een klankkleur op basis van een beschrijving in natuurlijke taal. De gehoste Documentatie over Voice Design toont de afzonderlijke creatieworkflow. Deze is geschikt voor fictieve personages en synthetische merkstemmen, maar de beschrijvingen moeten nog steeds worden getest op waargenomen leeftijd, accent en culturele vooringenomenheid.
Risicomatrix voor stemidentiteit
Noteer de spreker, het toepassingsgebied, de looptijd en de opnamemogelijkheden.
Versleutel verwijzingen en verwijder afgeleide stemmen samen met de bron.
Blokkeer schadelijke identiteitsclaims en voeg een meldingsfunctie toe.
Geef synthetische spraak een label wanneer luisteraars deze zouden kunnen verwarren met een mens.
Voor het klonen zijn uitdrukkelijke rechten en geïnformeerde toestemming vereist. Bewaar het originele toestemmingsdocument, leg de toegestane toepassingen vast, voorkom herinschrijving door derden en zorg voor een verwijderingsprocedure. De risico’s zijn niet louter theoretisch; de Analyse van privacy en toestemming bij gezichts-naar-spraak-omzetting legt uit waarom beveiligingsmaatregelen op het gebied van identiteit, biometrische gegevens en identiteitsfraude deel moeten uitmaken van het productontwerp en niet slechts in een voetnoot mogen worden vermeld.
Qwen3-TTS 0,6B versus 1,7B: welke moet je gebruiken?
Kies 0.6B als je belangrijkste beperking de implementatie is. Dit is de betere keuze voor kleinere GPU’s, een hogere gelijktijdigheid, sneller experimenteren en kostenbewuste zelfhosting. Zowel Base als CustomVoice zijn in deze omvang beschikbaar, zodat je het klonen of het gebruik van vooraf ingestelde sprekers kunt evalueren zonder te beginnen met het grootste checkpoint.
Kies 1,7B wanneer er meer waarde wordt gehecht aan kwaliteitsruimte en een breed scala aan functies. Dit is de enige uitgebrachte variant met VoiceDesign, en het is de meest voor de hand liggende keuze voor teams die bereid zijn geheugen en doorvoersnelheid in te ruilen voor capaciteit. De cijfers voor ‘concurrency-1’ in het technische rapport laten een klein verschil zien in de eerste-pakket- en RTF-tijden bij de geoptimaliseerde configuratie van Qwen, maar uw eigen hardware kan dat verschil vergroten of verkleinen.
| Beslissende factor | Begin met 0,6 B | Begin met 1,7 miljard |
|---|---|---|
| Er is te weinig GPU-geheugen | Betere pasvorm | Hoger risico op ontlasting of lage gelijktijdigheid |
| VoiceDesign nodig | Niet beschikbaar in de uitgebrachte set | Vereist |
| Kloon van Need Base nodig | Beschikbaar | Verkrijgbaar met een grotere capaciteit |
| Heb je CustomVoice nodig? | Beschikbaar | Verkrijgbaar met een grotere capaciteit |
| Is er een snelle haalbaarheidstest nodig? | Het beste uitgangspunt | Gebruik na de werkzaamheden aan de pijpleiding |
| Definitieve productiekeuze nodig | Vergelijk beide | Vergelijk beide |
Het aantal parameters is niet bepalend voor de benodigde VRAM. Nauwkeurigheid, de manier waarop aandacht wordt geïmplementeerd, cache, referentielengte, batchgrootte en de overhead van het framework spelen allemaal een rol. Een model dat maar net laadt, is geen betrouwbare productiedienst.
Voor de MX450 met 2 GB die tijdens deze test is onderzocht, biedt geen van beide configuraties een representatief GPU-benchmarktraject. Een nieuwere CUDA-stack en een geschikte GPU of officieel gehost eindpunt vormen de praktische volgende stap. “Het draaide met CPU-offload” zou een opmerking over compatibiliteit zijn, geen zinvolle uitspraak over de snelheid.
Qwen3-TTS API: HTTP, streaming en model-ID’s
Kies het vervoermiddel op basis van de afspeelbehoefte
De eenvoudigste manier om geluidsopnames in batches te maken en bestanden te voltooien.
Stapsgewijze levering; controleer nog steeds wanneer de audio kan worden afgespeeld.
Bij uitstek geschikt voor gesprekken en het afspelen van muziek.
Alibaba Cloud biedt zowel niet-realtime HTTP-generatie als realtime WebSocket-modellen. Gebruik niet-realtime synthese wanneer u op een volledig resultaat kunt wachten en de eenvoudigste verzoekstroom wilt. Gebruik WebSocket-streaming wanneer conversatielatentie of progressieve weergave van belang is. HTTP-streaming of door de server verzonden gebeurtenissen kunnen incrementele gegevens retourneren, maar dit mag niet worden verward met de specifieke reeks realtime-modellen met lage latentie.
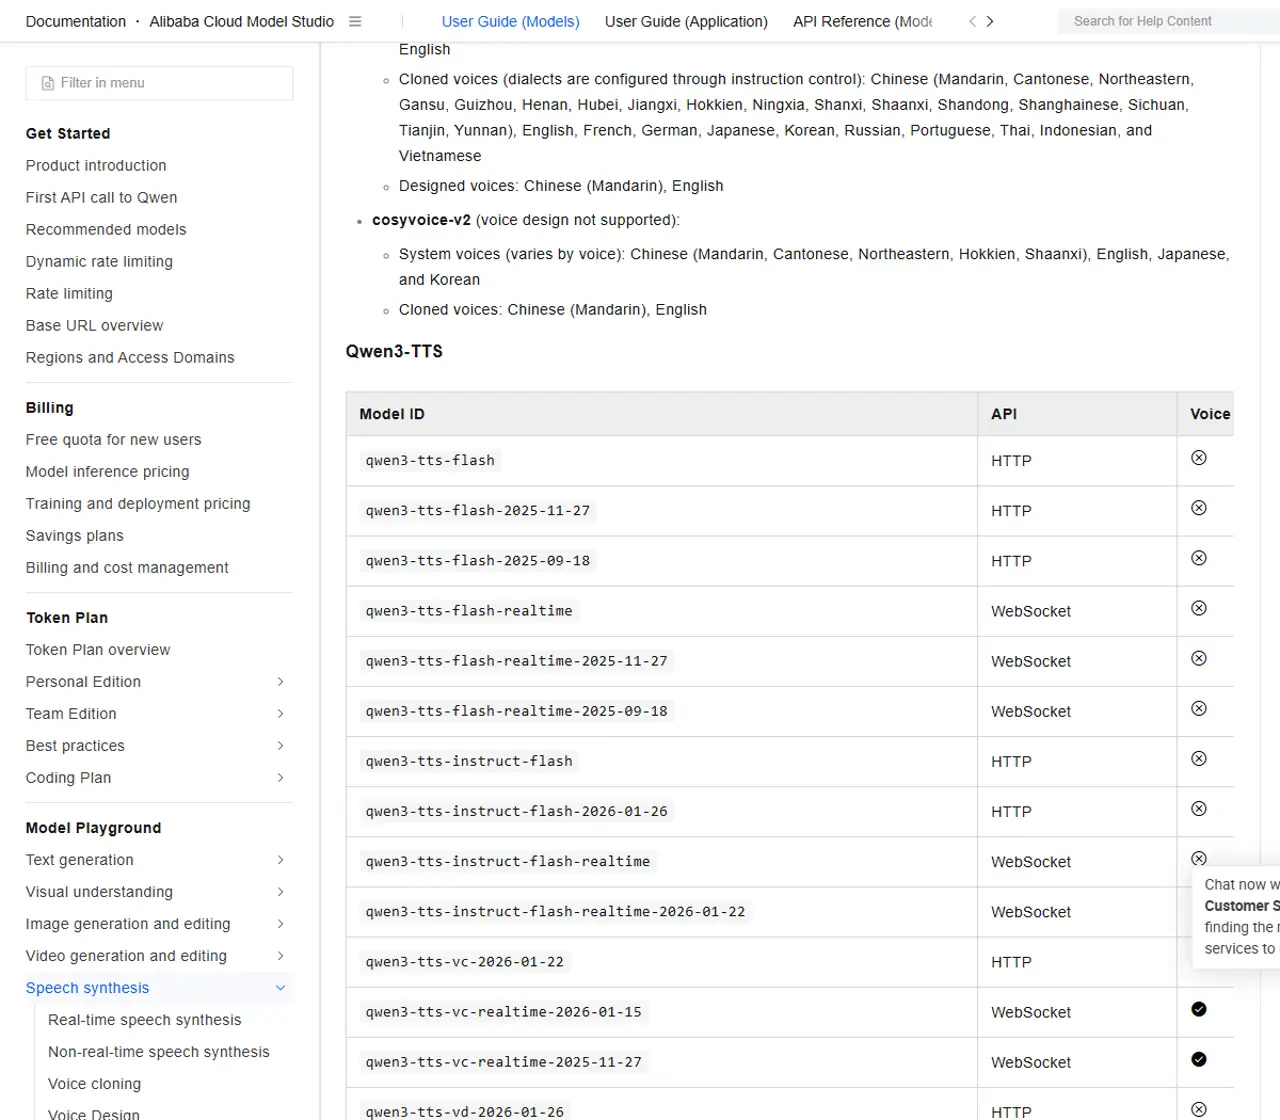
De huidige families omvatten Qwen3-TTS Flash voor ingebouwde stemmen, Instruct Flash voor besturing via natuurlijke taal, VC voor gekloonde stemmen en VD voor ontworpen stemmen. Model-ID's en gedateerde snapshots verschillen tussen niet-realtime- en realtime-routes; kopieer ze daarom uit de huidige documentatie in plaats van namen op basis van analogie samen te stellen.
De huidige Qwen-TTS API-documentatie beperkt de invoer tot 512 tokens per verzoek. Dat is de relevante limiet voor deze familie; een afzonderlijke regel van 600 tekens die voor andere TTS-modellen is gedocumenteerd, mag niet worden overgenomen in een Qwen3-TTS-integratie. Complete-audio-URL’s blijven 24 uur geldig, dus productiesystemen moeten de benodigde bestanden naar duurzame opslag verplaatsen in plaats van de respons-URL als permanente media te gebruiken.
import os
import dashscope

dashscope.base_http_api_url = "https://dashscope-intl.aliyuncs.com/api/v1"

response = dashscope.MultiModalConversation.call(
    model="qwen3-tts-flash",
    api_key=os.environ["DASHSCOPE_API_KEY"],
    text="Uw bestelling staat om 16.30 uur klaar om opgehaald te worden.",
    voice="Cherry",
    language_type="English",
)

print(response)
De API-sleutel en de regio van het eindpunt moeten met elkaar overeenkomen. Voor implementaties in Peking en Singapore gelden andere inloggegevens en basis-URL’s, terwijl de beschikbaarheid van modellen per regio kan verschillen. Sluit de sleutel nooit in WordPress, client-side JavaScript of een mobiele binaire code in. Verzend synthesizerverzoeken via een server waarover u de controle hebt, registreer verzoek-ID’s zonder gevoelige invoergegevens vast te leggen, en stel een levenscyclusbeleid vast voor gegenereerde audio.
Bij lange documenten moet je op semantische scheidingspunten in stukken verdelen, de context behouden, getallen normaliseren en bij elke koppeling goed luisteren. Geldige fragmenten kunnen nog steeds klinken als afzonderlijke opnames wanneer het tempo of de energie tussen gesprekken verandert.
Prijzen voor Qwen3-TTS in de internationale regio
Overzicht van prijzen per internationale regio
Flash
$0.10
per 10.000 ingevoerde tekensInstruct / VC / VD
$0.115
per 10.000 ingevoerde tekensFlash / VC
$0.13
per 10.000 ingevoerde tekensInstructie
$0.143
per 10.000 ingevoerde tekensVD
$0.143353
per 10.000 ingevoerde tekensStemcreatie: $0.01 per inschrijving · $0.20 per ontworpen stem.
Alibaba Cloud’s Prijspagina van Model Studio Op 11 augustus 2026 werden de volgende prijzen voor internationale regio's weergegeven. Voor deze rijen worden invoertekens in rekening gebracht en is uitvoer gratis. Prijzen, gratis quota, aliassen en regionale beschikbaarheid kunnen veranderen; controleer daarom de geselecteerde implementatie voordat u een grote batch verwerkt.
| Route | Model familie | Prijs per 10.000 ingevoerde tekens |
|---|---|---|
| Niet-realtime | Qwen3-TTS Flash | $0.10 |
| Niet-realtime | Instruct, VC of VD | $0.115 |
| Real-time | Flash of huidige VC | $0.13 |
| Real-time | Instructie | $0.143 |
| Real-time | VD | $0.143353 |
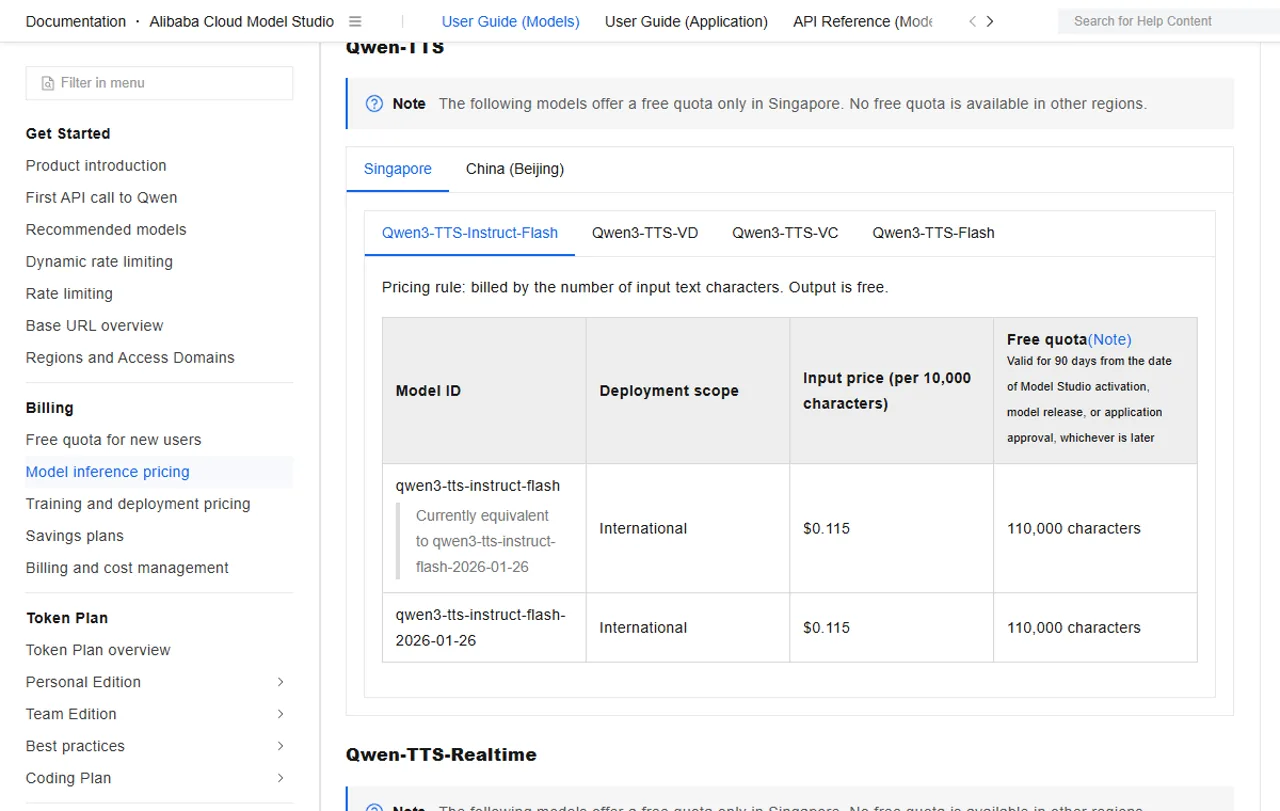
Voor het creëren van stemmen worden aparte kosten in rekening gebracht, los van de synthese. In dezelfde internationale tarieflijst staan de kosten voor stemregistratie (Qwen) vermeld op $0,01 per kloon en voor stemontwerp op $0,20 per ontworpen stem. Bij gebruik van een gekloonde of ontworpen identiteit kunnen vervolgens de relevante synthesekosten per teken in rekening worden gebracht.
Houd bij het opstellen van het budget rekening met de kosten voor stemcreatie, synthesekarakters, infrastructuur en regeneratie afzonderlijk. De bewerkingstijd en het aantal herhalingen zijn vaak bepalend voor de werkelijke productiekosten.
De API-prijzen komen niet overeen met de lokale kosten. Open checkpoints maken een einde aan de facturering per teken door leveranciers, maar brengen daarentegen kosten met zich mee voor GPU-tijd, implementatie, monitoring, opslag, schaalbaarheid en incidentafhandeling. Zelfhosting is de beste keuze wanneer controle, volume, datalocaliteit of maatwerk die operationele last rechtvaardigen.
Alternatieven en de GlobalGPT-audioroute
Qwen3-TTS is niet automatisch de beste keuze voor elke audio-opdracht. ElevenLabs is een meer volwassen, beheerd spraakplatform voor teams die prioriteit geven aan een gestroomlijnd dashboard, uitgebreide productietools en minder infrastructuur. De spraakmodellen van OpenAI zijn wellicht geschikt voor ontwikkelaars die al standaard gebruikmaken van één API-ecosysteem. Qwen-Audio 3.0 TTS is de nieuwere, gehoste Qwen-optie waarmee u rekening moet houden wanneer u de huidige aanbevelingen van Alibaba Cloud volgt.
Muziek en geluidseffecten moeten apart worden bekeken. De ElevenLabs, Lyria 3 Pro en Mureka: geluidsvergelijking dit helpt bij het onderscheiden van tools voor spraakweergave en tools voor het genereren van volledige muziekstukken. Een tekst-naar-spraakmodel mag geen punten verliezen omdat het geen professioneel geproduceerd nummer kan genereren, en een muziekmodel mag niet worden gekozen als API voor commentaar met lage latentie.
GlobalGPT heeft momenteel een geverifieerde route van de audiogenerator waarin wordt vermeld qwen-audio-3.0-tts-flash en Seed Audio 1.0. Op de gecontroleerde pagina stond Qwen3-TTS niet vermeld. Dat maakt van GlobalGPT in feite een aparte audio-werkruimte, maar het is geen bewijs dat de open Qwen3-TTS-controlepunten daar beschikbaar zijn.
Als je eindproduct een video is, bepaal dan of je een aparte verteller, gegenereerde dialogen, geluidseffecten of een model nodig hebt dat geluid produceert in combinatie met de beelden. Ons antwoord op of Veo 3.1 geluid heeft die beslissing in bredere zin onderbouwt. De slimste aanpak is vaak een kleine verzameling gespecialiseerde tools, in plaats van één model te dwingen alle audiotaken uit te voeren.
Licentie, toestemming, privacy en commercieel gebruik
De Qwen3-TTS-repository en de vrijgegeven modelkaarten vallen onder de Apache-2.0-licentie. Deze licentie staat commerciële ontwikkeling, aanpassing en distributie toe, maar verleent geen rechten op de stem, uitvoering, het script, het handelsmerk of de persoonsgegevens van anderen. De modellicentie en de inhoudsrechten vormen afzonderlijke lagen.
Met lokale verwerking krijgt u meer controle en draagt u meer verantwoordelijkheid op het gebied van beveiliging. Versleutel referentieopnames, beperk de toegang, beperk de bewaartermijn tot een minimum, documenteer afgeleide bestanden en zorg ervoor dat verwijderingen ook worden doorgevoerd voor geregistreerde stemmen en in de cache opgeslagen uitvoer.
Controleer bij gehoste synthese de servicevoorwaarden, de regionale gegevensverwerking, de bewaartermijnen en de bedrijfsbeleidsregels voordat u vertrouwelijke scripts of stemmonsters verstuurt.
Elke voor het publiek bestemde gekloonde stem moet een eigenaar hebben, een toestemmingsverklaring, een beleid inzake toegestaan gebruik en een reactie op misbruik. Vermeld dit wanneer een synthetische stem redelijkerwijs kan worden aangezien voor een echte persoon. Blokkeer het zich voordoen als particulieren en publieke figuren met een hoog risico, en zorg voor een manier om schadelijke audio te melden.
Voor wie is Qwen3-TTS bedoeld?
Welke route is geschikt?
Pipeline-bestendig, strakker geheugen, Base of CustomVoice.
VoiceDesign of een vergelijking van kwaliteit en capaciteit met de beschikbare GPU-capaciteit.
Snellere verwerking wanneer de regio, privacyvoorwaarden en prijzen goed aansluiten.
Een studio waarvoor geen installatie nodig is, een marktplaats met licenties of ondersteuning voor bestaande leveranciers.
Qwen3-TTS is geschikt voor onderzoekers, ontwikkelaars, gameteams en lokalisatieteams die behoefte hebben aan open gewichten, keuzevrijheid bij de implementatie, klonen of op tekst gebaseerde stemmen voor personages.
Begin met 0,6B als je de pijplijn aan het testen bent, te maken hebt met beperkt geheugen of wilt controleren of Base en CustomVoice aan de productbehoeften voldoen. Begin met 1,7B als je VoiceDesign nodig hebt of over voldoende hardware beschikt om de kwaliteit en doorvoer goed te kunnen vergelijken. Gebruik de gehoste API als de infrastructuur het knelpunt vormt en de regionale beschikbaarheid, inloggegevens en gegevensverwerking bij het project passen.
Kies een andere oplossing als je een bewerkingsstudio nodig hebt die geen installatie vereist, een groot aanbod aan gelicentieerde stemmen of bestaande zakelijke ondersteuning van een andere leverancier. Maak nooit een kloon zonder schriftelijke toestemming.
Gebruik vijf echte scripts, drie herhalingen, een lijst met moeilijke namen, een lange alinea en één hersteltest. Meet de latentie en de kosten, en vraag vervolgens aan moedertaalsprekers of het resultaat zonder aanpassingen bruikbaar is. Bewerkingen kunnen een overwinning in de benchmark tenietdoen.
Qwen3-TTS Veelgestelde vragen
Is Qwen3-TTS gratis?
De vrijgegeven Qwen3-TTS-checkpoints vallen onder de Apache-2.0-licentie, dus je kunt ze downloaden en gebruiken zonder dat je per teken modelkosten hoeft te betalen. Zelf hosten brengt nog steeds kosten met zich mee voor rekenkracht, opslag, ontwikkeling en monitoring. De door Alibaba Cloud gehoste Qwen3-TTS-API's zijn betaalde diensten met regiospecifieke prijzen en quota.
Kan Qwen3-TTS commercieel worden gebruikt?
Apache-2.0 staat commercieel gebruik van de vrijgegeven code en modelgewichten toe, maar geeft je geen recht om de stem van een persoon te klonen of beschermde scripts en merken te gebruiken. Voor commerciële projecten zijn nog steeds toestemming van de spreker, inhoudsrechten, privacymaatregelen en naleving van de lokale wetgeving en de platformvoorwaarden vereist.
Welke talen ondersteunt Qwen3-TTS?
De openbare versie Qwen3-TTS ondersteunt Chinees, Engels, Japans, Koreaans, Duits, Frans, Russisch, Portugees, Spaans en Italiaans. De taalondersteuning van gehoste modellen kan per eindpunt en stem verschillen; controleer daarom de exacte Alibaba Cloud-model-ID en -regio voordat u een meertalig product ontwikkelt.
Kan de Qwen3-TTS echt een latentie van 97 ms halen?
Qwen rapporteerde een latentie van 97 ms voor het eerste pakket bij het 0,6B 12Hz-model bij een gelijktijdigheidsgraad van 1 in een geoptimaliseerde interne vLLM-omgeving. Dit is een geldige benchmark van de leverancier, geen algemene garantie voor het apparaat. Koude starts, hardware, precisie, netwerktransit, wachtrijen en buffering door de client kunnen de waargenomen latentie verhogen.
Hoeveel VRAM heeft de Qwen3-TTS nodig?
Er bestaat geen eenduidig, betrouwbaar VRAM-cijfer dat voor elke configuratie geldt. De grootte van het model, de precisie, de attention-backend, de batchgrootte, de cache, de referentielengte en de overhead van het framework spelen allemaal een rol. De geteste MX450 met 2 GB was niet geschikt voor representatieve benchmarktests; test het gekozen controlepunt met een concurrentieniveau dat overeenkomt met de praktijk en houd voldoende operationele speling over.
Hoeveel audio is er nodig voor het klonen van een stem met Qwen3-TTS?
De voorbeeldmaterialen laten zien dat het klonen al vanaf ongeveer drie seconden snel verloopt, terwijl de registratie-instructies op de host de voorkeur geven aan heldere, ononderbroken spraak en langere opnames toestaan. Beschouw drie seconden als een minimumvereiste, niet als een automatisch kwaliteitsdoel. Gebruik audio waarvoor toestemming is gegeven en die vrij is van ruis, en die het normale bereik van de spreker en de beoogde taal omvat.
Wat is de invoerlimiet voor de Qwen3-TTS API?
In de huidige API-documentatie van Qwen-TTS staat vermeld dat de maximale invoer voor Qwen-TTS-modellen 512 tokens bedraagt. URL’s voor volledige audiobestanden blijven 24 uur geldig. Splits lange scripts op semantische grenzen en kopieer de benodigde uitvoer naar een duurzame opslag, in plaats van de geretourneerde URL te beschouwen als permanente hosting.
Kan ik Qwen3-TTS gebruiken op GlobalGPT?
De hier vermelde GlobalGPT-audiogenerator met ruitjespatroon qwen-audio-3.0-tts-flash en Seed Audio 1.0, niet Qwen3-TTS. Je kunt die route gebruiken als een afzonderlijke audio-workflow, maar het mag niet worden beschreven als toegang tot de open 0.6B- of 1.7B-controlepunten van Qwen3-TTS.
Eindoordeel
Deze recensie van Qwen3-TTS laat een opvallende veelzijdigheid zien: open 0,6B- en 1,7B-checkpoints, tien talen, vooraf ingestelde stemmen, snelle klonen, VoiceDesign, streamingarchitectuur, een soepele licentie en gehoste API’s.
De eerlijke beperking is even belangrijk. Er werd geen daadwerkelijke Qwen3-TTS-audio gegenereerd in de beschikbare testomgeving, en de geteste GPU van 2 GB kon geen representatieve lokale vergelijking ondersteunen. Om die reden wordt in dit artikel geen score voor de spraakkwaliteit toegekend en wordt er geen claim gedaan op een universele prestatie van 97 ms.
Als je waarde hecht aan open gewichten en controle, test dan eerst het 0,6B-controlepunt en vergelijk dit vervolgens met 1,7B op dezelfde scripts en hardware. Als je waarde hecht aan een snelle ingebruikname, test dan precies de Alibaba Cloud-route die je van plan bent aan te schaffen en vergelijk deze met de afzonderlijk gepositioneerde Qwen-Audio 3.0 TTS-familie. Noteer de modelnaam, het eindpunt, de regio, het toestemmingsrecord, de latentie en de totale bewerkingskosten in hetzelfde beslissingsformulier.
Qwen3-TTS is het proberen waard. Het heeft geen zin te doen alsof documentatie alleen al voor jou een stem kan laten horen. De beste aanpak is degene die bestand is tegen je namen, je taal, je hardware, je privacyvereisten en je productiedeadlines.