
Het NASA-IBM Lunar Foundation Model is een open AI-model voor het analyseren van maanwaarnemingen. Zoals op 10 september 2026 bekendgemaakt, kan het worden aangepast om kraters te detecteren, vulkanische kenmerken in kaart te brengen en patronen te voorspellen in een kaart van de ijsvoorraad. De gerapporteerde voordelen hebben betrekking op specifieke onderzoeksbenchmarks: het belangrijkste resultaat met betrekking tot ijs is een lagere voorspellingsfout, niet de ontdekking van 22% meer water op de maan.
Voor studenten en onderzoekers zijn de volgende punten een goed uitgangspunt: de officiële modelkaart, het technische rapport en de vrijgegeven code. Samen geven deze een toelichting op wat het model heeft geleerd, welke taken zijn geëvalueerd en wat je nodig hebt om je eigen experiment op te zetten.
Als je eerst het onderzoek moet begrijpen, GlobalGPT brengt het zoeken naar bronnen, documentanalyse, redeneren en schrijven samen in één multimodale werkruimte. Het biedt een betaalbare manier om via één enkel abonnement van onbekende wetenschappelijke termen tot een duidelijke onderzoeksopdracht te komen.

Wat is het NASA-IBM Lunar Foundation Model?
De aankondiging van de NASA presenteert het project als een basismodel voor maanwetenschap, dat samen met IBM is ontwikkeld. Een basismodel leert herbruikbare patronen uit een uitgebreide verzameling gegevens; onderzoekers passen die patronen vervolgens aan voor een specifiekere taak. In dit geval gaat het om teledetectiegegevens van de maan in plaats van om alledaagse taal.
De NASA-IBM LFM maakt gebruik van een vision-transformer-encoder en -decoder, met een ViT-B-architectuur. De invoer bestaat onder meer uit beeldmateriaal en andere observatieproducten met verschillende ruimtelijke resoluties. Een wetenschapper kan de resulterende weergave aanpassen voor detectie, segmentatie of regressie – drie manieren om objecten te vinden, gebieden af te bakenen en numerieke waarden te voorspellen.
Daardoor is deze release nuttig voor teams die met maankaarten werken en voor studenten die zich bezighouden met machine learning op het gebied van planeten. Het is ook de moeite waard om het project door te nemen voor iedereen die wil begrijpen hoe een wetenschappelijk AI-model wordt geëvalueerd. Het gebruik van het checkpoint is echter eerder een onderzoeksgerichte computerworkflow dan een chatgesprek.
Uit welke gegevens haalt het zijn kennis?
De modelkaart beschrijft de SomBench-trainingsdata: 963.609 tegeltjesbundels van de groothoekcamera (WAC) en 1.000.113 bundels van de smalhoekcamera (NAC). De schaal van de WAC-bundels is ongeveer 100 meter per pixel; die van de NAC-bundels is ongeveer 1 meter per pixel. Hierdoor beschikt het model over zowel een bredere context van het terrein als veel fijnere oppervlaktedetails, verspreid over ongeveer twee miljoen bundels.
IBM beschrijft de bredere gegevensbron bestaat uit meer dan 30 op elkaar afgestemde lagen afkomstig van negen instrumenten uit vier missies. De modelkaart specificeert 11 invoermodaliteiten. Deze afbeeldingen geven verschillende fasen van de datapijplijn weer: bronlagen, gebundelde trainingsvoorbeelden en soorten invoer die het model codeert.
Eén project, drie verschillende teleenheden
IBM beschrijft een gegevensbron die is samengesteld uit gegevens van negen instrumenten uit vier missies.
963.609 WAC-pakketten en 1.000.113 NAC-pakketten bieden twee niveaus van lesmateriaal.
Het model verwerkt verschillende soorten waarnemingen, waaronder beeldmateriaal en terreingegevens.
Bronlagen, tegelbundels en invoermodaliteiten tellen verschillende zaken mee. Bronnen: Beschrijving van de dataset van IBM en de officiële modelkaart.
Verlichting maakt ook deel uit van het ontwerp. Het model krijgt observatiegeometrie, inclusief verlichtingshoeken, als expliciete context mee. Dit helpt om onderscheid te maken tussen hoe een oppervlak eruitziet onder bepaalde verlichting en de onderliggende terreinpatronen die het leert.
Een pixel die ongeveer 100 meter terrein weergeeft, kan niet dezelfde details weergeven als een pixel die ongeveer 1 meter weergeeft. Daarom verdienen de resultaten van de WAC- en NAC-kraterbeelden aparte aandacht. Een verbetering bij beelden op grote schaal betekent niet automatisch dezelfde verbetering bij kleine oppervlaktekenmerken.
Het project volgt de pretraining-aanpak van TerraMind, maar wordt volledig vanaf nul getraind op maangegevens. Het moet daarom worden gezien als een model dat speciaal is ontwikkeld voor maanwaarnemingen, en niet als een hernoemd model voor aardobservatie. De relevante vraag is hoe de aangeleerde representatie bijdraagt aan een specifieke maantaken.
Drie taken waarbij het kan helpen
De gepubliceerde evaluaties hebben betrekking op drie takenfamilies. Elke familie levert een ander soort antwoord op, waardoor de betekenis van “beter” per taak verschilt.
| Taak | Uitgang | Wat het resultaat kan ondersteunen |
|---|---|---|
| Detectie van kraters | Omkaderingen rond kraters in WAC- of NAC-beelden | Vergelijken hoe goed een detector gemarkeerde kraters opspoort en lokaliseert. |
| Onregelmatige segmentatie van de Mare Patch | Een op pixelniveau weergegeven overzicht van vulkanische oppervlaktekenmerken | Onderzoeken in hoeverre voorspelde gebieden overeenkomen met de grenzen van gelabelde kenmerken. |
| Regressie van de prospectiviteit van poolijs | Een continue voorspelling van een op kennis gebaseerde prospectiviteitskaart | Onderzoek naar de overeenstemming met een gemodelleerd doelbeeld voor mogelijke ijsgerelateerde omstandigheden. |
Het opsporen van kraters en het segmenteren van vulkanische kenmerken kunnen onderzoekers helpen bij het ordenen en analyseren van beeldmateriaal. Het nut hiervan hangt af van de labels, de schaal en het evaluatiegebied. Een model dat goed presteert op een welbepaalde testset, moet nog steeds worden getoetst aan de hand van de gegevens en de wetenschappelijke vraagstelling van een nieuw project.
De prospectiviteit van ijs moet uiterst zorgvuldig worden geïnterpreteerd. Het doel is een op kennis gebaseerde kaart van gebieden waar de aanwezigheid van ijs aannemelijk is, niet een directe meting van ijsafzettingen. Een betere overeenstemming met die kaart kan het onderzoek naar patronen en kandidaatgebieden ondersteunen. Het betekent niet dat er een extra hoeveelheid water is gevonden.
Wat de benchmarkresultaten betekenen
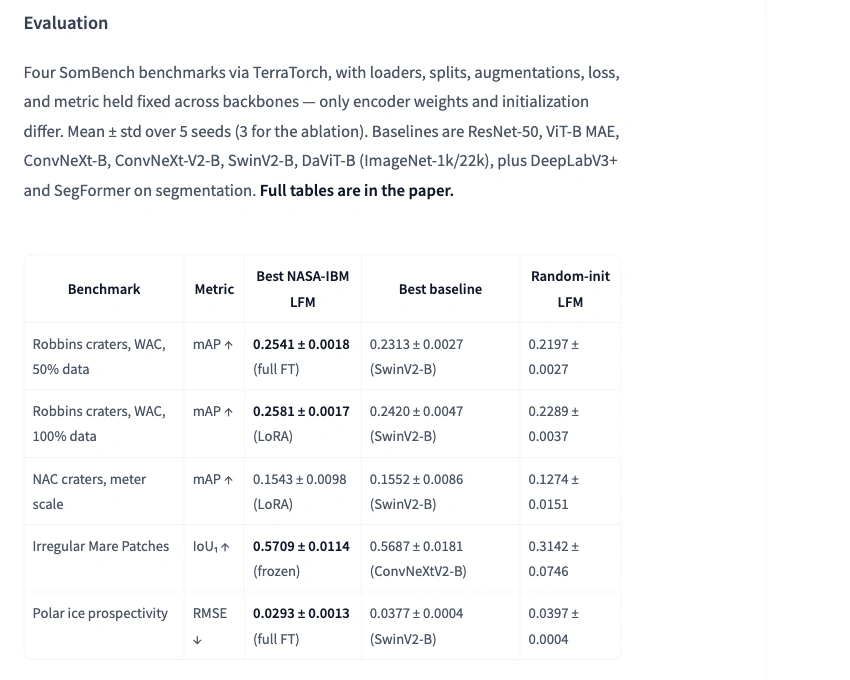
De technisch rapport geeft gemiddelden en standaardafwijkingen weer voor vijf willekeurige startwaarden. De resultaten vergelijken aangepaste configuraties van het maanmodel met bekende referentiemodellen voor het visiemodel. We hebben de gepubliceerde tabellen gecontroleerd; we hebben de maanexperimenten niet herhaald.
De meetwaarden geven antwoord op verschillende vragen. Mean Average Precision (mAP) evalueert objectdetecties; Intersection over Union (IoU) meet de overlap tussen voorspelde en gelabelde gebieden; Root Mean Squared Error (RMSE) meet de numerieke voorspellingsfout. Hogere mAP- en IoU-waarden zijn beter, terwijl een lagere RMSE-waarde beter is. Ze mogen niet worden gecombineerd tot één nauwkeurigheidsscore.
Fout in de ijsprospectiviteit: de duidelijkste gerapporteerde winst
De RMSE daalde van 0,0377 tot 0,0293 tegen SwinV2-B, een 22,31 TP40T relatieve vermindering. Een lagere RMSE duidt op een betere overeenstemming met de kaart van de benchmark die de ijsprospectiviteit weergeeft.
RMSE: hoe lager, hoe beter. De balken beginnen bij nul. Gemiddelde ± standaardafwijking over vijf zaden. Het doel is een gemodelleerde prospectiviteitskaart, niet een meting van ijs.
| Taak en gegevens | Metrisch ↑ | Maanmodel | Sterke uitgangsbasis |
|---|---|---|---|
| WAC-kraters · 50%-trainingsgegevens | mAP | 0,2541 ± 0,0018 volledige afstemming | 0,2313 ± 0,0027 SwinV2-B |
| WAC-kraters · 100%-trainingsgegevens | mAP | 0,2581 ± 0,0017 LoRA | 0,2420 ± 0,0047 SwinV2-B |
| NAC-kraters · 100%-trainingsgegevens | mAP | 0,1543 ± 0,0098 LoRA | 0,1552 ± 0,0086 SwinV2-B |
| Onregelmatige vlekken bij merries | IoU1 | 0,5709 ± 0,0114 bevroren encoder | 0,5687 ± 0,0181 ConvNeXtV2-B |
De auteurs beschrijven de resultaten met betrekking tot kraters en vulkanische kenmerken op meterschaal als vergelijkbaar met betrouwbare referentiewaarden. De kleine verschillen die hierin worden waargenomen, moeten worden gezien in het licht van de variatie tussen afzonderlijke metingen.
Bron: Technisch rapport van NASA en IBM, tabellen 4–7, pagina’s 16 en 18. Dit zijn de resultaten van de auteurs, geen onafhankelijke herhaling van het onderzoek.
Het 22%-ijsresultaat leidt tot een vermindering van de fout
Wat betreft het potentieel voor ijs heeft de sterkste gerapporteerde maanconfiguratie een RMSE van 0,0293, tegenover 0,0377 voor SwinV2-B. De berekening is als volgt: (0,0377 − 0,0293) ÷ 0,0377 × 100 = 22,3%. De RMSE meet de voorspellingsfout ten opzichte van de doelkaart; hoe lager, hoe beter. Dit percentage is noch een nauwkeurigheidsscore, noch een verandering in de hoeveelheid maanijs.
De resultaten van de krateranalyse zijn afhankelijk van de maatstaf en de schaal van de gegevens
Met 50% van de WAC-trainingsgegevens behaalt het maanmodel een mAP van 0,2541, tegenover 0,2313 voor SwinV2-B. Datzelfde resultaat van het maanmodel overtreft ook de 0,2420 van de baseline met 100% aan trainingsgegevens. Bij de eerste vergelijking worden gelijke gegevensfracties gebruikt; de tweede is een bewijs van de label-efficiëntie in dit specifieke experiment.
De verbetering van IBM van ongeveer 19% kan worden vergeleken met de AP@75-waarden uit het rapport bij 50% trainingsgegevens: 0,2213 versus 0,1862, een relatieve stijging van 18,9%. AP@75 evalueert detecties bij een bepaalde overlappingsdrempel. Dit mag niet worden omgezet naar een toename van 19% in de mAP-maatstaf van de tabel.
Op de fijnere NAC-schaal bedraagt de mAP van het maanmodel 0,1543 en die van de baseline 0,1552. Voor ‘Irregular Mare Patches’ bedragen de gerapporteerde IoU-waarden voor de voorgrond 0,5709 en 0,5687 ten opzichte van ConvNeXtV2-B. De auteurs beschrijven deze taken als vergelijkbaar met sterke baselines. Kleine verschillen, in combinatie met de gerapporteerde variatie tussen de runs, ondersteunen niet de bewering dat het maanmodel overal beter presteert.
Waar is het verkrijgbaar en wat zijn de kosten voor toegang?
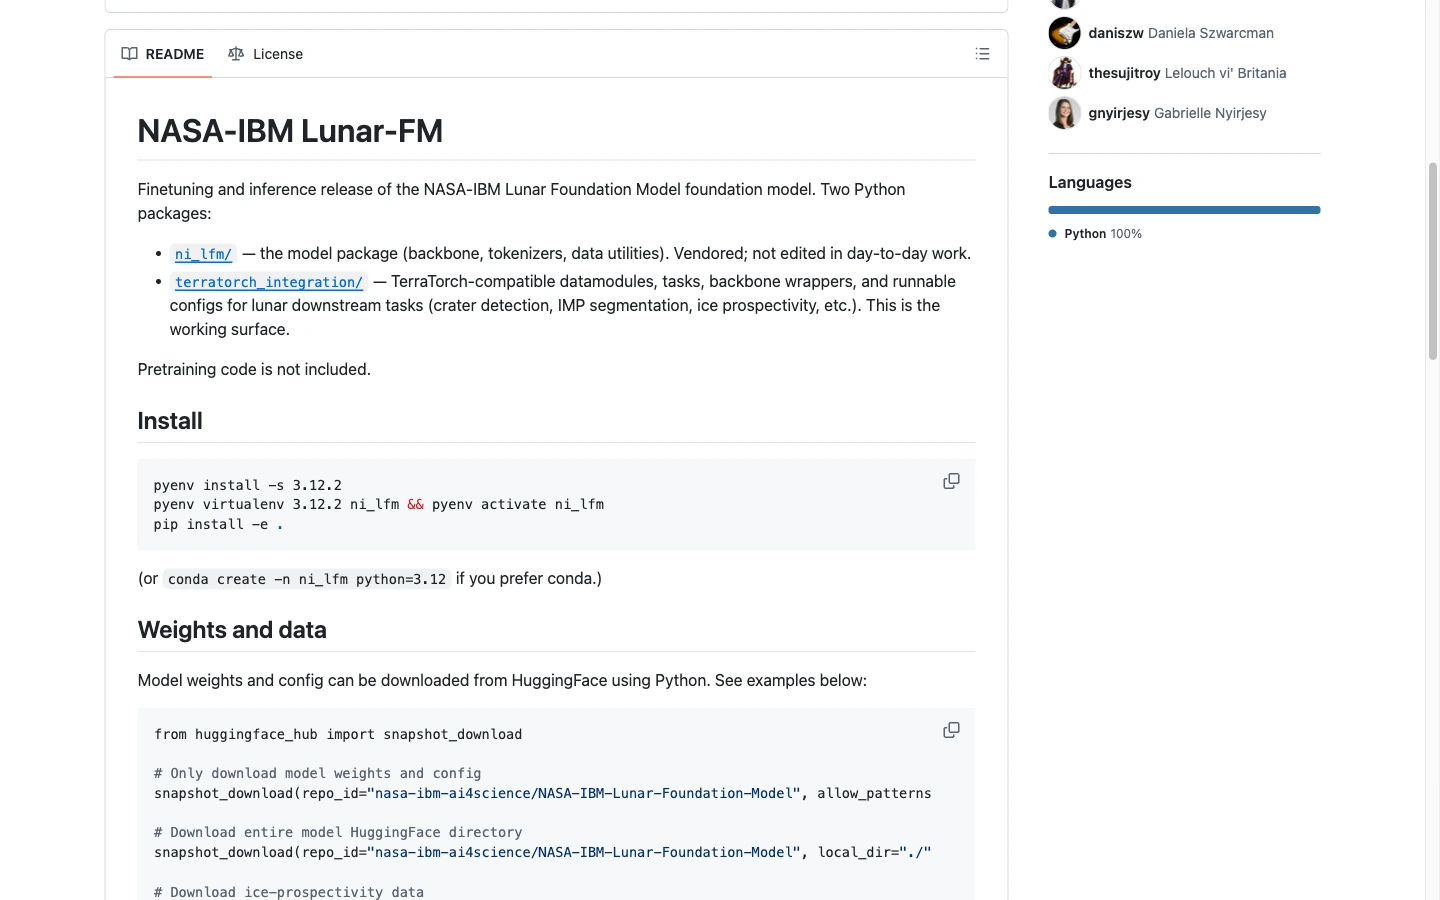
Begin met de onderstaande officiële bronnen. De modelgewichten en de code vallen onder de Apache-2.0-licentie en het checkpoint is openbaar beschikbaar. In de repository wordt specifiek een release met fijnafstemming en inferentie; pretraining-code wordt hier expliciet uitgesloten.
Kies het hulpmiddel voor je volgende stap
Begin met de beoogde toepassingen, de invoergegevens, de licentievoorwaarden en de beperkingen.
Het tabblad Bestanden bevat het vrijgegeven controlepunt en de bijbehorende bestanden.
Gebruik het README-bestand en de TerraTorch-taakconfiguraties om een experiment te plannen.
Volg de officiële verzameling voor gerelateerde afgeleide modellen en datasets.
In de tabellen 4–7 worden de resultaten van de taken, de instellingen en de variatie tussen de verschillende runs weergegeven.
Bekijk de demoversie van het project. We hebben in deze beoordeling geen generatie uitgevoerd.
Toen de modelkaart op 28 september 2026 werd gecontroleerd, stond er geen geïmplementeerde Hugging Face Inference Provider op vermeld. Een downloadbaar checkpoint en een demonstratiepagina zijn afzonderlijke toegangswegen.
Als je het model wilt aanpassen, kies dan de downstream-taak voordat je het experiment opzet. De repository biedt TerraTorch-compatibele componenten en configuraties die het checkpoint, de taak en de gegevens met elkaar verbinden. TerraTorch is het softwareframework dat wordt gebruikt om die trainings- en evaluatieworkflow te organiseren.
- Lees de modelkaart en het README-bestand, en kies vervolgens voor detectie, segmentatie of regressie, afhankelijk van de wetenschappelijke vraag.
- Verzamel de relevante gegevens en het officiële controlepunt, en controleer de taakconfiguratie en de omgevingsinstructies van de repository.
- Bereid de gegevens voor die configuratie voor en voer de betreffende workflow voor fijnafstemming of inferentie uit.
- Evalueer aan de hand van een geschikte referentie en bewaar de gegevensindeling, instellingen en uitvoerresultaten, zodat het resultaat kan worden gecontroleerd.
Open access maakt de aankoop van een model-licentie in het beginstadium overbodig, maar het uitvoeren van een experiment brengt nog steeds kosten met zich mee. Je hebt rekenkracht, opslagruimte, gegevensvoorbereiding en tijd voor evaluatie nodig. Een vrijgegeven checkpoint gaat niet automatisch gepaard met een gehoste API of gratis GPU-tijd, en de bronnen leggen geen universele minimale GPU-vereiste vast voor elke downstream-taak.
| Je doel | Middelen of kosten waarmee rekening moet worden gehouden |
|---|---|
| Lees het persbericht en beoordeel het | Openbare aankondigingen, modelkaart, rapport en opslagplaats. |
| Het wetenschappelijke model uitvoeren of aanpassen | Geschikte reken- en opslagcapaciteit, relevante gegevens, het opzetten van de omgeving en evaluatiewerkzaamheden. |
| Wetenschappelijke artikelen begrijpen en een onderzoeksverslag schrijven | Een werkruimte voor onderzoeksassistenten, zoals GlobalGPT, met toegang tot modellen en documenttools in één abonnement. |
Gebruik AI om het onderzoek te begrijpen
Een vruchtbare eerste vraag is specifiek: “Wat wordt er eigenlijk gemeten met de gerapporteerde verbetering van 22%?” Om deze vraag te beantwoorden, zijn een streefwaarde, een maatstaf, een uitgangssituatie en een berekening nodig. Het is zinvoller om naar deze vier zaken te vragen dan aan een assistent te vragen of het model indrukwekkend is.
Met GlobalGPT kun je dat leeswerk van brononderzoek tot documentuitleg en het schrijven zelf doorlopen zonder dat je voor elke stap tussen verschillende tools hoeft te wisselen. Voor een herhaalbare methode, een onderzoeksrapport opstellen waarin de bronnen zijn gecontroleerd met een korte bronnenlijst en duidelijke vragen, voordat u om een goed uitgewerkte samenvatting vraagt.
Van officiële bronnen tot een nuttige toelichting
- Verzamel het bronmateriaal. Begin met de aankondiging van NASA en voeg vervolgens de modelkaart, het technisch rapport en het README-bestand toe. Je kunt onderzoek met Perplexity op GlobalGPT om ondersteunende bronnen te vinden.
- Stel gerichte vragen. Laat een assistent mAP, IoU en RMSE afzonderlijk uitleggen en vermeld vervolgens achter elke bewering de doelwaarde, de basislijn en de evaluatie-instelling.
- Controleer en schrijf op. Open de genoemde tabel opnieuw, controleer elk cijfer en verwerk de gecontroleerde aantekeningen in een rapport waarin de wetenschappelijke grenzen in acht worden genomen.
We hebben een beperkte versie van deze workflow getest met GPT-5.6 Sol. Het systeem ontving een pakket informatie afkomstig uit de vier officiële bronnen en moest een korte samenvatting opstellen, zes beweringen classificeren, de RMSE-vermindering berekenen en praktische vervolgstappen voorstellen. De taak maakte gebruik van aangeleverde tekst; er werd niet naar nieuw bewijsmateriaal gezocht.
Een op de bron gebaseerde briefingtest
We gaven GPT-5.6 Sol een kort overzicht op basis van de aankondiging van NASA, de officiële modelkaart, het technische rapport en de README op GitHub. Het moest een briefing schrijven, zes beweringen controleren en de berekening van de RMSE toelichten.
- Werkplek en datum
- GlobalGPT · 28 september 2026
- Beleid uitvoeren
- Eén opdracht; eerste volledige antwoord; geen herkansingen
- Invoer
- Bronpakket van 355 woorden met vier bron-ID’s
- Toepassingsgebied
- Lezen en samenvatten; geen live-zoekopdrachten of uitvoering van het maanmodel
- Reactie-instellingen
- Maximaal aantal output-tokens: 4.096; alle overige instellingen voor het bemonsteren blijven op de standaardwaarden van de dienst staan
- Gebruik en kosten
- Er werden in totaal 2.154 tokens gemeld; in het antwoord werd geen geldbedrag genoemd
In het eerste antwoord bleven de wetenschappelijke beweringen binnen de kaders
Het antwoord resulteerde in een toelichting van 112 woorden, waarin de bewering dat het model 22% meer echt ijs had ontdekt, werd weerlegd en waarin de beperkingen op de certificering van landingsplaatsen en de toegang tot de pretraining-code werden gehandhaafd. De drie volgende stappen verwezen terug naar de officiële modelkaart, het controlepunt en de TerraTorch-bronnen.
Dit was een leesopdracht waarbij gebruik werd gemaakt van het verstrekte materiaal. In het bronnenpakket waren de belangrijkste beperkingen al vermeld. Het resultaat zegt niets over de prestaties op het gebied van zelfstandig onderzoek of het trekken van conclusies op basis van teledetectie van de maan.
Bekijk de exacte prompt en het bronpakket
SYSTEEM
Je bent een zorgvuldige wetenschappelijk redacteur die schrijft voor een universiteitsstudent. Gebruik uitsluitend het verstrekte bronnenpakket. Ga niet op internet zoeken. Maak onderscheid tussen gerapporteerde benchmarkmetingen en wetenschappelijke metingen in de praktijk. Vermeld bron-ID’s tussen vierkante haken. Als een bewering niet onderbouwd is, geef dat dan duidelijk aan. Verzin geen citaten, prijzen, hardwarevereisten of experimentele resultaten. Geef het gevraagde antwoord, geen verborgen redenering.

GEBRUIKER
Zet het bronnenpakket om in een praktische onderzoeksnotitie. Lever het volgende in: (1) een toelichting in eenvoudig Engels van 100–130 woorden; (2) een tabel met zes rijen voor het controleren van beweringen, waarin voor elke verstrekte bewering precies ‘Ondersteund’ of ‘Niet ondersteund’ wordt vermeld, samen met een bron-ID en een uitleg van één zin; (3) de relatieve RMSE-vermindering, berekend van 0,0377 tot 0,0293, afgerond op één decimaal, met een formule en één zin waarin wordt uitgelegd wat hiermee niet wordt gemeten; (4) drie praktische vervolgstappen voor een student die het vrijgegeven model wil onderzoeken of aanpassen. Houd het totale antwoord onder de 500 woorden.

Te controleren beweringen:
1. NASA en IBM hebben het model op 10 september 2026 openbaar aangekondigd.
2. De gerapporteerde RMSE voor de kans op ijs daalde van 0,0377 voor SwinV2-B naar 0,0293 voor het volledig verfijnde maanmodel.
3. Het model ontdekte 22% meer echt waterijs op de maan.
4. NASA heeft dit model gevalideerd voor de certificering van landingslocaties en het uitsluiten van gevaren.
5. De GitHub-release bevat de code voor de voortraining.
6. Een open checkpoint garandeert dat GPU-rekenkracht en gehoste inferentie gratis zijn.

Bronpakket:
[S1] Aankondiging van NASA, 10 september 2026.
Titel: NASA en IBM lanceren AI-basismodel voor maanwetenschap.
URL: https://science.nasa.gov/science-research/artificial-intelligence-lunar-foundation-model/
NASA heeft een basismodel voor maanwetenschap aangekondigd dat in samenwerking met IBM is ontwikkeld. Het wordt openbaar gehost op Hugging Face, met de code op GitHub. Het kan worden aangepast voor het in kaart brengen van kraters, het identificeren van vulkanische kenmerken en onderzoek naar poolijs.

[S2] Officiële NASA-IBM-modelkaart en technisch rapport, geraadpleegd op 28 september 2026.
URL modelkaart: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
URL technisch rapport: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model/blob/main/NI_LFM_Technical_Report.pdf
Tabel 7 van het rapport (pagina 18) geeft de RMSE (root mean squared error) van de testset weer voor de regressie van ijsperspectiviteit. Hoe lager, hoe beter. Gemiddelde plus/minus standaardafwijking over vijf willekeurige startwaarden: NASA-IBM LFM met volledige fijnafstemming, 0,0293 ± 0,0013; ImageNet-voorgetrainde SwinV2-B, 0,0377 ± 0,0004. Het doel is een op kennis gebaseerde kaart van de ijsprospectiviteit. Dit zijn door de auteurs gerapporteerde benchmarkresultaten, geen onafhankelijke replicatie of directe meting van waterijs.
Tabel 4 (pagina 16), WAC-kraters met 50%-trainingsgegevens: de mAP voor bounding-box is 0,2541 ± 0,0018 voor volledig verfijnd LFM en 0,2313 ± 0,0027 voor SwinV2-B. In dezelfde rijen is AP@75 respectievelijk 0,2213 +/- 0,0028 en 0,1862 +/- 0,0041. Deze statistieken mogen niet door elkaar worden gehaald.

[S3] Officiële modelkaart, Beoogd gebruik / Buiten het toepassingsgebied / Beperkingen.
URL: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
Het beoogde gebruik is teledetectie van de maan door middel van fijnafstemming of LoRA-aanpassing voor detectie, segmentatie en dichte regressie. Het model is niet gevalideerd voor certificering van landingsplaatsen of het uitsluiten van gevaren. De resultaten met betrekking tot ijsvoorraad zijn een op kennis gebaseerde kaart, geen gemeten ijs. De gegenereerde velden zijn kwalitatieve metingen, geen gekalibreerde wetenschappelijke voorspellingen. Het model hanteert geen absoluut geodetisch referentiekader. Het is niet buiten de maan geëvalueerd. De vermelde licentie is Apache-2.0. Op de pagina wordt geen implementatie van een Inference Provider vermeld. Dit pakket biedt geen garantie voor gratis GPU-rekenkracht of gratis gehoste inferentie, en er worden geen minimale hardware-eisen of prijzen voor de gehoste API vermeld.

[S4] Officiële GitHub README, gecontroleerd op 28 september 2026.
URL: https://github.com/NASA-IMPACT/NASA-IBM-Lunar-Foundation-Model
De repository beschrijft een release voor fine-tuning en inferentie. Code voor pretraining is niet inbegrepen. Gewichten en configuratie kunnen worden gedownload vanuit de officiële Hugging Face-modelrepository. Er worden TerraTorch-compatibele datamodules, taken, backbone-wrappers en taakconfiguraties aangeboden. Voor het verfijnen en testen zijn de relevante gegevens, checkpoint en taakconfiguratie vereist. In de README wordt een Apache 2.0-licentie vermeld.
Bekijk het volledige eerste antwoord
## 1. Toelichting

NASA en IBM hebben op 10 september 2026 het Lunar Foundation Model aangekondigd. De openbare release bevat gewichten op Hugging Face en code voor fine-tuning en inferentie op GitHub, gericht op teledetectietaken op de maan, zoals het in kaart brengen van kraters, het identificeren van vulkanische kenmerken en onderzoek naar poolijs. De gerapporteerde benchmark voor ijsperspectiviteit vertoont een verbetering van de RMSE ten opzichte van een op ImageNet voorgetrainde SwinV2-B, maar het doel is een op kennis gebaseerde kaart, niet direct gemeten maanijs. Het resultaat is door de auteurs gerapporteerd op basis van vijf willekeurige seeds en is geen onafhankelijke replicatie. Het model is bedoeld voor aanpassing via volledige fine-tuning of LoRA, maar is niet gevalideerd voor certificering van landingslocaties of het uitsluiten van gevaren. Er is geen code voor voortraining beschikbaar, en de release belooft noch gratis GPU-rekenkracht, noch gehoste inferentie. [S1][S2][S3][S4]

## 2. Tabel met beweringen en beoordelingen

| Bewering | Oordeel | Bron | Toelichting |
|---|---|---|---|
| 1 | Ondersteund | [S1] | De aankondiging van NASA is gedateerd op 10 september 2026 en identificeert het model als een NASA–IBM-project. |
| 2 | Ondersteund | [S2] | Tabel 7 vermeldt RMSE-waarden van 0,0377 voor SwinV2-B en 0,0293 voor het volledig verfijnde maanmodel. |
| 3 | Niet ondersteund | [S2] | De cijfers zijn benchmarkfouten ten opzichte van een op kennis gebaseerde prospectiviteitskaart, geen metingen van echt maanwaterijs. |
| 4 | Niet ondersteund | [S3] | Op de modelkaart staat expliciet vermeld dat het model niet is gevalideerd voor de certificering van landingslocaties of het uitsluiten van gevaren. |
| 5 | Niet ondersteund | [S4] | De GitHub-repository biedt bronnen voor verfijning en inferentie, maar bevat geen code voor voortraining. |
| 6 | Niet ondersteund | [S3] | Het pakket belooft geen gratis GPU-rekenkracht of gehoste inferentie, en meldt geen implementatie via een Inference Provider. |

## 3. Relatieve RMSE-vermindering

\[
\frac{0,0377-0,0293}{0,0377}\times 100 = 22,3\%
\]

Dit is een **relatieve vermindering van 22,3% ten opzichte van de door de auteurs gerapporteerde benchmark-RMSE**; het meet geen extra ontdekt echt waterijs of onafhankelijk gevalideerde wetenschappelijke prestaties. [S2]

## 4. Praktische volgende stappen

1. Lees de beoogde toepassingen, beperkingen en de Apache-2.0-licentie van de modelkaart voordat je een detectie-, segmentatie- of regressietaak selecteert. [S3]
2. Download het officiële checkpoint en de configuratie van Hugging Face, en bekijk vervolgens de GitHub-backbone-wrappers en taakconfiguraties. [S4]
3. Verkrijg de relevante maandataset en gebruik de meegeleverde TerraTorch-compatibele componenten om te finetunen en te testen, waarbij je documenteert dat er geen pretraining-code beschikbaar is en dat benchmarkresultaten onafhankelijke evaluatie vereisen. [S2][S4]
Het nuttige resultaat was dat de verschillen behouden bleven: benchmarkfout versus ontdekt ijs, gebruik voor onderzoek versus landingscertificering, en vrijgegeven aanpassingscode versus ontbrekende voortrainingscode. Aangezien die beperkingen al in het bronpakket aanwezig waren, is dit een bewijs van een succesvolle lees- en synthesetaak, en geen bewijs dat een assistent elke kanttekening zelfstandig zou ontdekken.
Voor een groter project, een uitgebreidere, door AI ondersteunde onderzoekssessie plannen rondom afzonderlijke vragen over gegevens, methoden, evaluatie en beperkingen. Houd de brontabel naast het concept en controleer elk cijfer nogmaals na het redigeren. Die gewoonte is belangrijker dan hoe vloeiend de eerste samenvatting klinkt.
Grenzen die in de praktijk van belang zijn
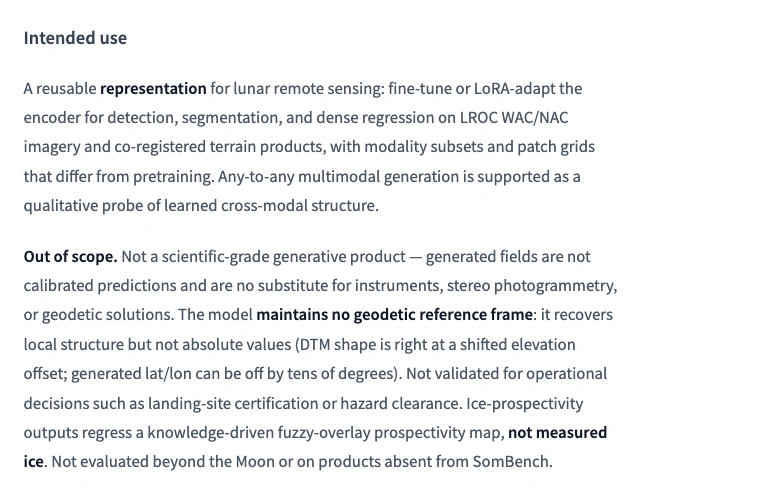
Op de modelkaart staat vermeld dat het maanmodel niet is gevalideerd voor operationele beslissingen, zoals de certificering van landingslocaties of het uitsluiten van gevaren. Een wetenschappelijk model kan helpen bij het onderzoeken van waarnemingen, zonder dat daarmee kan worden gecertificeerd dat een ruimtevaartuig ergens veilig kan landen. Voor dergelijke toepassingen is een ander validatieniveau vereist.
Ook bij gegenereerde velden is voorzichtigheid geboden. Het model hanteert geen absoluut geodetisch referentiekader, waardoor gegenereerde waarden kunnen afwijken van de fysieke waarden. De auteurs beschrijven het genereren van deze gegevens als een kwalitatieve verkenning in plaats van een gekalibreerde wetenschappelijke voorspelling. Een terrein- of observatiekaart die er aannemelijk uitziet, mag niet worden beschouwd als een gemeten product.
Het controlepunt is niet verder dan de Maan geëvalueerd. Zelfs binnen het maanonderzoek is het beeld gemengd: duidelijke vooruitgang bij sommige taken en vergelijkbare resultaten bij andere. De logische conclusie is dat je het model moet beoordelen aan de hand van het doel, de schaal, de gegevens en de uitgangswaarde die bij jouw experiment passen.
Veelgestelde vragen
Is het NASA-IBM Lunar Foundation Model gratis te gebruiken?
Op de officiële modelkaart en in de coderepository wordt een Apache-2.0-licentie vermeld, en het checkpoint is openbaar beschikbaar. Voor het uitvoeren van experimenten zijn nog steeds geschikte rekenmiddelen, gegevensvoorbereiding en taakspecifieke evaluatie nodig. Open toegang tot het model biedt geen garantie op gratis GPU-rekenkracht of gehoste inferentie.
Is het Lunar Foundation Model van NASA en IBM een chatbot?
Het is een basismodel voor teledetectie van de maan, dat is ontwikkeld voor het verwerken van beeldmateriaal, terreingegevens en aanverwante observatiegegevens. Onderzoekers passen het toe voor detectie-, segmentatie- en regressietaken. Een chatassistent kan helpen bij het uitleggen van de documentatie, maar de interactie met een chatbot is een andere werkwijze dan het uitvoeren van dit model.
Heeft het model nog meer waterijs op de maan ontdekt?
Het gerapporteerde ijsresultaat geeft aan in hoeverre de voorspellingen overeenkomen met een op kennis gebaseerde kaart van de ijsvoorraadpotentie. De beste gerapporteerde RMSE daalt van 0,0377 naar 0,0293 ten opzichte van de genoemde referentiewaarde, een relatieve afname van ongeveer 22%. Dat is een verbetering ten opzichte van de benchmark; het is geen maatstaf voor de hoeveelheid extra ontdekt ijs.
Kan ik het project verkennen zonder code te schrijven?
Je kunt de aankondiging van NASA lezen, de modelkaart bekijken, de gepubliceerde benchmarktabellen verkennen en de officiële demonstratiepagina bezoeken zonder een trainingspijplijn op te zetten. Om het vrijgegeven checkpoint aan te passen aan een wetenschappelijke taak, maak je gebruik van de code, gegevens en TerraTorch-configuraties uit de repository, gevolgd door een taakspecifieke validatie.
Hoe verhoudt het maanmodel zich tot Prithvi en Surya?
Ze maken deel uit van de bredere samenwerking tussen NASA en IBM op het gebied van basis modellen voor de wetenschap. NASA beschrijft de Prithvi-modellen voor aardobservaties en weertoepassingen, Surya voor heliofysica en het maanmodel voor maanobservaties. Hun toepassingsgebieden en beoogde taken verschillen; het maanmodel is nog niet buiten de maan geëvalueerd.
Het NASA-IBM Lunar Foundation Model biedt een herbruikbaar uitgangspunt voor onderzoek naar teledetectie van de maan. Gebruik de officiële tabellen om inzicht te krijgen in de sterke punten van het model, de modelkaart om de beperkingen ervan te bepalen en de gepubliceerde bronnen om een taakgericht experiment te plannen. Als je directe doel leren of schrijven is, begin dan met het omzetten van die bronnen in een gecontroleerde samenvatting.
Maak van een technisch artikel een overzicht dat je kunt gebruiken
Breng je officiële bronnen naar GlobalGPT, verdiep je in onbekende concepten en zet de gecontroleerde bevindingen om in duidelijke aantekeningen of een voltooid concept – allemaal in één werkruimte die meerdere modellen ondersteunt.
Ontdek onderzoek met GlobalGPT








