Ja, Grok 4.6 is een officieel xAI-model dat op 12 augustus 2026 is uitgebracht, en het verdient serieuze aandacht als je werk te maken heeft met uitgebreide onderzoekspakketten, programmeren, meerstapsanalyses of op afbeeldingen gebaseerde taken. Dankzij het contextvenster van 500.000 tokens en de configureerbare redenering is het geschikt voor veeleisende projecten, hoewel het niet automatisch de snelste of beste keuze is voor elke prompt. De echte vraag is niet langer of Grok 4.6 bestaat, maar of de sterke punten ervan aansluiten bij het werk dat je daadwerkelijk moet voltooien.
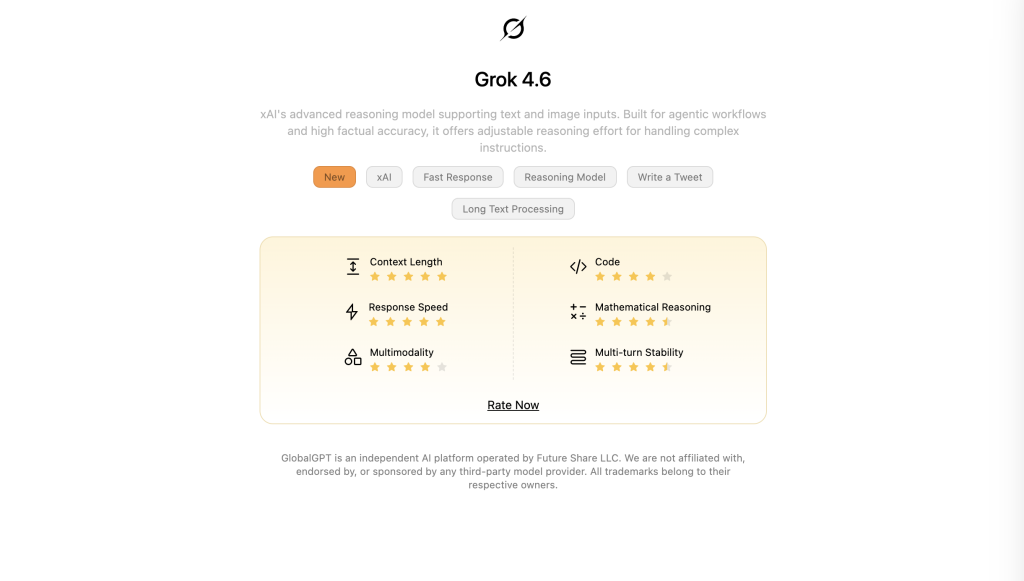
Als je die vraag wilt beantwoorden zonder je hele workflow aan één aanbieder te binden, GlobalGPT is een uitstekend startpunt. Dankzij de browserwerkruimte kun je Grok 4.6 naast andere toonaangevende modellen gebruiken, dezelfde opdracht voor onderzoek, schrijven, analyse of coderen uitvoeren en de resultaten op één plek vergelijken. Het is een praktische, verfrissend eenvoudige manier om te zien waar Grok 4.6 zich echt onderscheidt – en waar een ander model beter bij uw taak past – voordat u de configuratie of het abonnement kiest dat voor u het beste werkt.
Wat is Grok 4.6 precies?
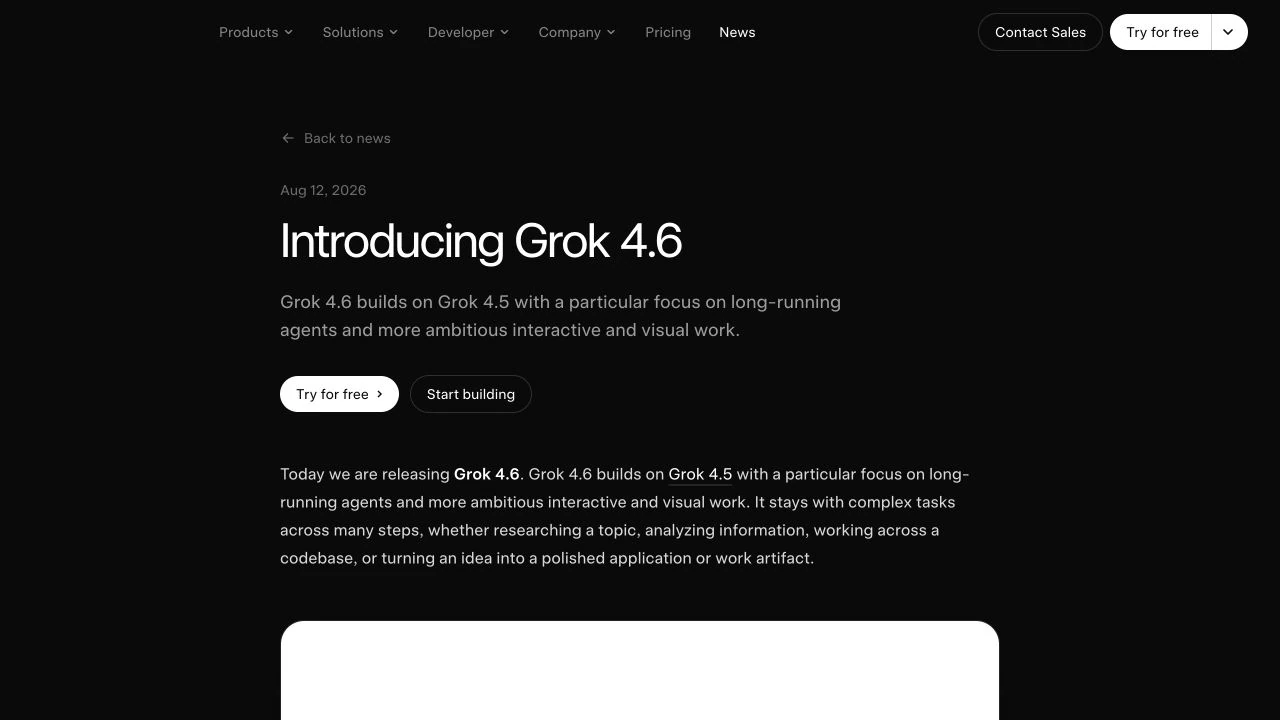
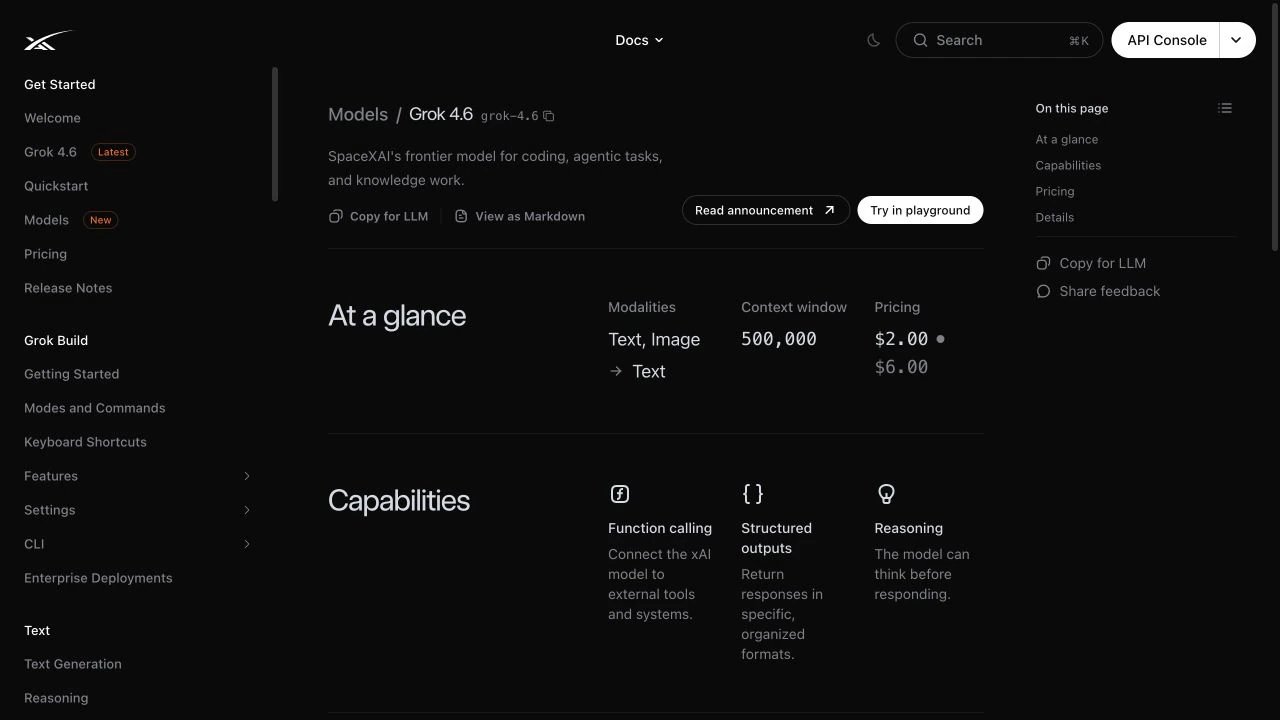
De Grok 4.6 is het vlaggenschipmodel van xAI voor 2026 binnen de Grok-serie. Op de officiële modelpagina worden tekst- en afbeeldingsinvoer, tekstuitvoer, configureerbare redenering en een contextvenster van 500.000 tokens beschreven. De API-identificatie is grok-4.6; dat is de waarde die ontwikkelaars in een verzoek moeten gebruiken.
De eigen release-taal van xAI is heel specifiek: Grok 4.6 richt zich op agenten die al lang actief zijn en ambitieuzere interactieve en visuele projecten. In de officiële documentatie wordt het gepositioneerd voor programmeerwerk, agentgebaseerde taken en kenniswerk, met functieaanroepen en gestructureerde uitvoer voor workflows die gereedschappen of voorspelbare responsformaten vereisen.
Op de modelkaart staat januari 2026 vermeld als uiterste datum voor de pre-training. Dat onderscheid is van belang. Met een contextvenster van 500.000 kun je weliswaar een zeer groot bronpakket aanleveren, maar dat maakt het model nog niet automatisch tot een live zoekmachine. Voor actuele prijzen, nieuws of wijzigingen in het productbeleid moet je bronnen raadplegen en het antwoord verifiëren.
Wat zijn de officiële specificaties van de Grok 4.6?
| Specificatie | Officieel vastgestelde waarde | Waarom het belangrijk is |
|---|---|---|
| Verschijningsdatum | 12 augustus 2026 | Bevestigt dat dit een officiële xAI-release is. |
| API-model-ID | grok-4.6 | Gebruik precies deze slug in API-verzoeken. |
| Contextvenster | 500.000 tokens | Handig voor uitgebreide rapporten, codebases en onderzoek waarin veel broncode een rol speelt. |
| Invoer / uitvoer | Tekst- en afbeeldingsinvoer; tekstuitvoer | Ondersteunt multimodale prompts, maar geen beeldgeneratie. |
| Redenering | Configureerbaar | Hiermee kan een workflow snelheid inruilen voor een grondigere analyse. |
| Functieaanroep | Ondersteund | Koppelt het model aan tools en externe systemen. |
| Gestructureerde uitvoer | Ondersteund | Handig voor JSON, gegevensontsluiting en voorspelbare pijplijnen. |
| Afkappingswaarde vóór de training | Januari 2026 | Ga er niet automatisch vanuit dat het basismodel actueel is. |
Bron: aankondiging van xAI, modeldocumentatie en de Grok 4.6-modelkaart. Officiële specificaties komen niet overeen met onafhankelijke prestatieresultaten.
Wat kan de Grok 4.6?
Redeneren en gestructureerde analyse
Dankzij de configureerbare redenering is Grok 4.6 geschikt voor taken waarbij een weloverwogen antwoord van nut is: het vergelijken van bewijsmateriaal, het opstellen van beslissingstabellen, het plannen van een implementatie of het controleren van een berekening met beperkingen. Meer redenering is niet automatisch beter voor elke aanvraag; daarom moet bij routinematige extractie en herschrijving een passende instelling worden gebruikt.
Onderzoek en werk waarbij veel bronnen worden geraadpleegd
Het contextvenster van 500K biedt het model voldoende ruimte voor omvangrijke rapporten, transcripties, beleidsdocumenten en bronpakketten. De meest effectieve werkwijze is het opzoeken van informatie met behulp van expliciete locators en citatieregels, gevolgd door het openen van de originele bron ter verificatie.
Coderen en debuggen
Uit gepubliceerde evaluaties op het gebied van software-engineering en onze kleinschalige foutopsporingstest blijkt dat het systeem geschikt is voor codereview, het verhelpen van fouten en gestructureerde agenttaken. Ontwikkelaars dienen echter nog steeds lokaal tests uit te voeren en patches te controleren voordat ze worden geïmplementeerd.
Beeldbegrip
xAI verwerkt tekst- en afbeeldingsinput en genereert tekstoutput. Dit maakt het mogelijk om schermafbeeldingen te interpreteren, documentafbeeldingen te analyseren en visuele vragen te beantwoorden, maar het mag niet worden verward met het genereren van afbeeldingen.
Langdurig gebruik van agenten en tools
Dit is de functionaliteit die het nauwst aansluit bij de positionering van xAI bij de lancering. Dankzij het aanroepen van functies kan Grok 4.6 verbinding maken met externe tools, terwijl gestructureerde uitvoer het gemakkelijker maakt om het resultaat door te geven aan een volgende stap. Die combinatie is geschikt voor agents die context verzamelen, een codebase doorlopen, een tool aanroepen, een resultaat controleren en een voltooid artefact teruggeven. Het model heeft nog steeds een externe runtime, machtigingen en doelcontroles nodig; “agentic” betekent niet dat het basismodel zelfstandig handelt.
Interactief en visueel werk
xAI legt ook de nadruk op ambitieuzere interactieve en visuele opdrachten. Een goede testopdracht is bijvoorbeeld een productbeschrijving met veel schermafbeeldingen of een rapport op basis van grafieken, waarbij het model visueel bewijsmateriaal moet koppelen aan een schriftelijke aanbeveling. Controleer labels, assen, eenheden en weggelaten details voordat je het resultaat als definitief beschouwt.
Wat is er veranderd in de Grok 4.6 ten opzichte van eerdere Grok-modellen?
De positionering van xAI legt de nadruk op krachtigere redenering, het werk van programmeeragenten en prestaties bij lange contexten. De praktische verbetering bestaat niet uit één opvallende functie, maar uit de combinatie van een groter werkgebied, aanpasbare redenering en een model dat is afgestemd op complexe taken met meerdere stappen.
Dat moet nog wel in de praktijk worden getest. Een model kan goed scoren in een benchmark, maar toch niet goed aansluiten bij jouw schrijfstijl, citatie-eisen of codebase. Grok 4.6 kun je het beste beoordelen aan de hand van de taken die je elke week uitvoert, en niet op basis van één enkel cijfer op het klassement.
Hoe presteert de Grok 4.6 in toonaangevende benchmarks?
In de onderstaande tabel worden de resultaten van de modelkaarten van xAI zelf gescheiden van onafhankelijke metingen. Dit is van essentieel belang omdat de twee Terminal-Bench-cijfers verschillende versies zijn en niet mogen worden gepresenteerd als een directe vergelijking.
| Beoordelaar | Taak / maatstaf | Gerapporteerd resultaat | Bewijsklasse en verjaringstermijn |
|---|---|---|---|
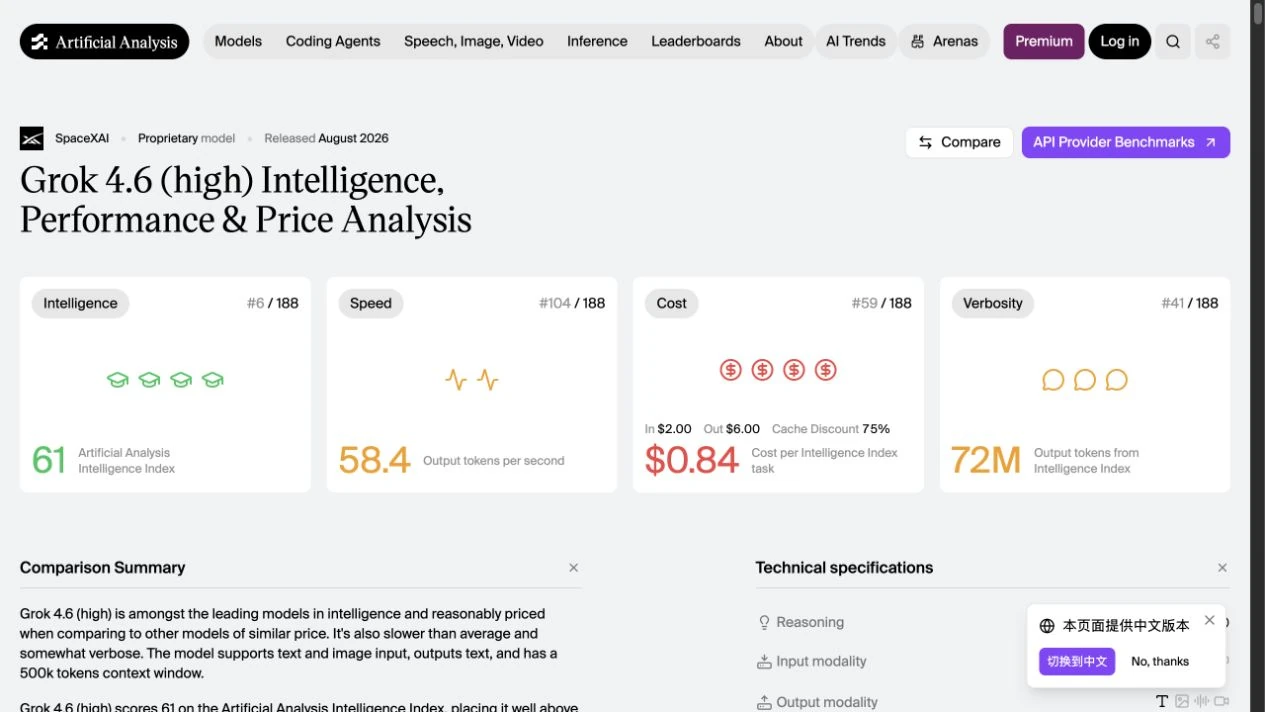
| Kunstmatige analyse | Intelligentie-index | 61 (#6 / 188 bij het vastleggen) | Onafhankelijke samenstelling; gebruik de methodologie en datum van AA. |
| Kunstmatige analyse | Uitvoersnelheid | 58,4 tokens per seconde | Onafhankelijke snelheidsmeting; de route en de hardware beïnvloeden de latentie. |
| Kunstmatige analyse | Kosten per inlichtingenopdracht | $0.84 | Een schatting van AA op basis van haar eigen takenmix; geen factuur van xAI. |
| Kunstmatige analyse | GDPval-AA v2 | 1753 | Onafhankelijke beoordeling van de werkresultaten. |
| Kunstmatige analyse | AA-Aktetas | 1577 | Onafhankelijke evaluatie van de werkstijl bij kenniswerk. |
| Kunstmatige analyse | Terminal-Bench v2.1 | 88.4% | Onafhankelijk resultaat v2.1; niet vergelijkbaar met Terminal-Bench 3.0. |
| xAI-modelkaart | Terminal-Bench 3.0 | 26% | Officieel resultaat van de modelkaart op een andere versie. |
| Mercor APEX-SWE | Softwareontwikkeling | 56,41 TP40T ± 6,21 TP40T | 200 taken; het onzekerheidsinterval moet worden gehandhaafd. |
| Mercor APEX-agenten | Taken van de agent | 57,51 TP40T ± 3,51 TP40T | 33 werelden / 480 taken; een specifieke evaluatie van de agent. |
| xAI-modelkaart | DeepSearchQA | 81.6% | Door de leverancier gerapporteerde kwaliteitscontrolevoorwaarde voor onderzoek. |
| xAI-modelkaart | Percentage hallucinaties over feitelijke gebeurtenissen | 1.7% | Testvoorwaarde voor modelkaarten; geen algemeen foutpercentage. |
Bronnen: Artificial Analysis, Mercor APEX-ranglijsten en xAI Model Card. Voeg scores uit verschillende datasets, versies, inspanningsinstellingen of beoordelaars niet samen.
Is Grok 4.6 beter dan Grok 4.5?
De officiële modelkaart geeft geen eenduidig “ja” als antwoord, maar een gemengd beeld. De Grok 4.6 scoort aanzienlijk hoger op de DeepSearchQA-test, terwijl dezelfde kaart een hoger percentage feitelijke onjuistheden vertoont dan de Grok 4.5. Een serieuze evaluatie mag één sterke benchmark niet omzetten in een bewering van universele betrouwbaarheid.
| Officiële beoordeling | Grok 4,6 | Grok 4,5 | Hoe moet je dit interpreteren? |
|---|---|---|---|
| DeepSearchQA | 81.6% | 38.4% | Er werd een aanzienlijke winst gemeld bij deze op zoekresultaten gerichte evaluatie. |
| Percentage hallucinaties over feitelijke gebeurtenissen | 1.7% | 0.98% | Hoe lager, hoe beter; Grok 4,5 is beter bij deze gerapporteerde toestand. |
Bron: xAI Grok 4.6-modelkaart. Deze evaluaties geven antwoord op verschillende vragen en wijzen niet op één algemene winnaar.
Hoe snel, betrouwbaar en krachtig is de Grok 4.6 in de praktijk?
Uit gepubliceerde gegevens blijkt dat het om een model met hoge capaciteit gaat, maar “prestaties” bestaan uit verschillende onderdelen: de kwaliteit van de antwoorden, de latentie, het onthouden van de context, het opvolgen van instructies en het herstellen na fouten. In onze directe route leverde de gereedheidscontrole een HTTP 200-status op en KLAAR. De eerste geldige uitvoerresultaten voor de andere taken werden succesvol teruggestuurd, terwijl één bewerkingsverzoek met beperkingen een storing in de infrastructuur aan de clientzijde veroorzaakte.
Artificial Analysis biedt een nuttige realiteitscheck die verder gaat dan alleen de prestaties op het gebied van koppen: de vastgelegde pagina toont een intelligentie-index van 61, een uitvoersnelheid van 58,4 tokens per seconde en geschatte kosten van $0,84 per intelligentietaken. Die combinatie wijst op een capabel maar niet ultrasnel model – dat beter geschikt is voor zinvol werk dan voor wegwerpbare antwoorden van één regel.
Dat gemengde resultaat is nuttig. Grok 4.6 kan goed presteren bij gestructureerd werk, maar productiegebruikers moeten herhalingsregels, time-outs en een fallback-model hanteren, in plaats ervan uit te gaan dat elke route zich op dezelfde manier zal gedragen.
Waar lijkt Grok 4.6 het meest nuttig?
Langlopende programmeer- en productwerkzaamheden
Het voorbeeld van xAI bij de lancering omvat het onderzoeken van een onderwerp, het analyseren van informatie, het werken met een codebase en het omzetten van een idee in een afgewerkte applicatie of artefact. Daarom is werk op feature-niveau een betere evaluatie dan een ‘speelgoedprompt’ met slechts één functie. Geef het model een afgebakende doelstelling, relevante bestanden, tests en een definitie van ‘klaar’.
Onderzoekssynthese en kenniswerk
Het 500K-venster, de gestructureerde uitvoer en de sterke DeepSearchQA-resultaten maken Grok 4.6 tot een voor de hand liggende keuze voor het omzetten van een bronpakket in een samenvatting, het in kaart brengen van meningsverschillen of het genereren van een beslissingstabel. De broncontrole-test ondersteunt dit gebruik wanneer de citatieregels expliciet zijn vastgelegd.
Omvangrijke rapporten en analyse van meerdere documenten
Gebruik het contextvenster voor jaarverslagen, transcripties, beleidsdocumenten en projectgeschiedenissen die anders veel werk zouden vergen om in stukken op te splitsen. Vraag om pagina- of paragraafverwijzingen en controleer vervolgens de belangrijke cijfers in de originele documenten.
Op beelden gebaseerde analyse
Het invoeren van tekst en afbeeldingen is handig voor schermafbeeldingen, grafieken en diagrammen. Dit is vooral nuttig wanneer de afbeelding deel uitmaakt van een bredere redeneeropdracht, zoals het bekijken van een dashboard in combinatie met schriftelijke zakelijke context.
Werkprocessen waarbij de verantwoordelijkheid bij de uitvoerder ligt, met duidelijke einddoelen
Het aanroepen van functies en gestructureerde uitvoer ondersteunen workflows zoals het onderzoeken van een probleem, het aanroepen van een tool, het bijwerken van een plan en het retourneren van een machinaal leesbaar resultaat. Het veiligste uitgangspunt is een taak met beperkte rechten, een duidelijke stopvoorwaarde en een objectieve controleur.
| Werkstroom | Waarom de Grok 4.6 geschikt is | De beste eerste opdracht |
|---|---|---|
| Codering | xAI-positionering plus bewijsmateriaal van APEX-SWE en CursorBench | Een echte bug of een wijziging ter grootte van een feature, voorzien van tests |
| Onderzoek | 500K-context, gestructureerde uitvoer en DeepSearchQA | Een door bronnen onderbouwde briefing met paginanummers |
| Lange documenten | Groot officieel contextvenster | Een jaarverslag of een beleidsbundel bestaande uit meerdere documenten |
| Visuele analyse | Beeldinvoer plus xAI-positionering van visueel werk | Een rapport met veel grafieken en schriftelijke toelichting |
| Agenten | Functieaanroepen en gestructureerde uitvoer | Een afgebakend onderzoek met een duidelijke controleur |
Is Grok 4.6 geschikt voor onderzoek en feitencontrole?
In de bronpakkettest moest Grok 4.6 zes beweringen classificeren, uitsluitend goedgekeurde URL’s aanhalen en twee verleidelijke gevolgtrekkingen verwerpen.
(1) bevestigd — De aankondiging van xAI is gedateerd op 12 augustus 2026 en vermeldt dat het die dag Grok 4.6 uitbrengt.
(2) bevestigd — In de officiële xAI-modeldocumentatie wordt de model-ID vermeld als grok-4.6.
(3) bevestigd — In de officiële documentatie wordt een contextvenster van 500.000 vermeld.
(5) tegengesproken — Dat zijn verschillende versies van Terminal-Bench en het gaat niet om dezelfde maatstaf.
(6) tegengesproken — Op de pagina staat alleen een vermelding van de werkruimte, niet dat deze in elk abonnement is inbegrepen.
Volledige Grok 4.6-uitvoer weergeven
| Bewering | Oordeel | Antwoord in één zin | Bron-URL(s) | Exacte beperking |
|---|---|---|---|---|
| (1) xAI kondigde Grok 4.6 aan op 12 augustus 2026 | ondersteund | De aankondiging van xAI is gedateerd op 12 augustus 2026 en vermeldt dat Grok 4.6 die dag wordt uitgebracht. | https://x.ai/news/grok-4-6 | Het bericht citeert alleen de datum en de regel over de release, niet het volledige bericht. |
| (2) de officiële API-model-ID is grok-4.6 | ondersteund | In de officiële documentatie van xAI wordt de model-ID vermeld als grok-4.6. | https://docs.x.ai/developers/models/grok-4.6 | In de samenvatting van Packet worden geen aliassen of andere ID’s vermeld. |
| (3) het officiële contextvenster is 500.000 tokens | ondersteund | In de officiële documentatie wordt een contextvenster van 500.000 tokens vermeld. | https://docs.x.ai/developers/models/grok-4.6 | In het pakket staat “500k context”, zonder expliciete vermelding van “tokens”. |
| (4) Artificial Analysis heeft onafhankelijk een Intelligence-score van 61 gemeten | ondersteund | AA publiceert een Intelligence-index van 61 voor Grok 4.6. | https://artificialanalysis.ai/models/grok-4-6 | Packet rapporteert de score van AA, geen afzonderlijke controle van de methode van AA. |
| (5) Terminal-Bench 3.0 26% en v2.1 88,4% zijn direct vergelijkbaar | tegengesproken | Dit zijn verschillende versies van Terminal-Bench en het betreft niet dezelfde maatstaf. | https://artificialanalysis.ai/models/grok-4-6 ; https://media.x.ai/v1/website/card-4p6-4cd2dc57.pdf | Packet geeft beide scores weer, maar biedt geen equivalentie of koppeling. |
| (6) een pagina met GlobalGPT, Grok en 4,6 bewijst dat elk abonnement het model bevat | tegengesproken | De pagina toont alleen een vermelding in de werkruimte, niet dat het in elk abonnement is opgenomen. | https://www.glbgpt.com/home/grok-4-6 | In het pakket zelf staat dat dit een interface-vermelding is, niet in elk plan. |
Conclusie van de recensie: Het hield zich goed aan de grenzen van het bewijsmateriaal wanneer het formaat van het bronpakket en het antwoord expliciet waren. Dat is nuttig voor onderzoeksworkflows, maar het antwoord van het model blijft een hulpmiddel bij het onderzoek – niet het externe bewijsmateriaal zelf.
Geef de exacte testopdracht weer
Gebruik uitsluitend het bijgevoegde bronpakket. Geef voor elk van de zes conclusies een antwoord van één zin waarin je aangeeft of deze wordt ondersteund, tegengesproken of niet bewezen is, samen met de bron-URL’s en de exacte beperking.
Is de Grok 4.6 geschikt voor het programmeren en debuggen?
De JavaScript-opdracht vereiste een minimale diff, numerieke sortering, correcte verwerking van de mediaan bij oneven en even aantallen, onveranderlijkheid en twee exacte foutcondities.
```diff
--- a/median.js
+++ b/median.js
@@ -1 +1,12 @@
-function median(values) { values.sort(); return values[Math.floor(values.length / 2)]; }
+function median(values) {
+  if (!Array.isArray(values)) throw new TypeError();
+  if (values.length === 0) throw new Error("empty input");
+  const sorted = values.slice().sort((a, b) => a - b);
+  const mid = Math.floor(sorted.length / 2);
+  if (sorted.length % 2 === 0) {
+    return (sorted[mid - 1] + sorted[mid]) / 2;
+  }
+  return sorted[mid];
+}Toon de uitleg die door Grok 4.6 wordt weergegeven
Het origineel paste het argument aan en gebruikte de standaard lexicografische sorteerfunctie `sort()`, dus wordt er met `slice()` een kopie gemaakt en numeriek gesorteerd via `(a, b) => a - b`. Nadat niet-arrays met een TypeError en lege arrays met de foutmelding "empty input" zijn afgewezen, is bij een resultaat met een oneven lengte het middelste element de uitkomst en bij een resultaat met een even lengte het gemiddelde van de twee centrale waarden, wat de conventionele mediaan is.
Aanbevolen gebruik: kleine tot middelgrote foutopsporing, het schrijven van tests, codebeoordeling en het uitleggen van een onbekende functie. Bij een grote repository kun je het model combineren met je eigen testrunner en de diff controleren voordat je de wijzigingen samenvoegt.
Toon het testbereik
Bepaal de mediaan van (waarden) zonder de signatuur ervan te wijzigen. Breng geen wijzigingen aan in de invoer; genereer een TypeError voor niet-arrays en een Error("lege invoer") voor lege arrays; retourneer een minimale, gestandaardiseerde diff.Helpt het contextvenster van 500K bij lange documenten?
Voor een opzoekfunctie met meer dan 220.000 tokens waren zeven velden, sectie-/pagina-referenties en een toelichting op de twee versies van Terminal-Bench vereist.
{
  "release_date": {"value": "12 augustus 2026", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "locator": "p.2"},
  "context_window": {"value": "500.000 tokens", "locator": "p.2"},
  "long_context_input_price": {"value": "$4 per miljoen tokens (prompts van meer dan 200.000 tokens)", "locator": "p.3"},
  "terminal_bench_version": ["3.0", "v2.1"],
  "terminal_bench_score": ["26%", "88,4%"]
}Toon de volledige Grok 4.6 JSON-uitvoer
{
  "release_date": {"value": "12 augustus 2026", "section": "xAI-release", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "section": "API-model", "locator": "p.2"},
  "context_window": {"value": "500k tokens", "section": "API-model", "locator": "p.2"},
  "long_context_input_price": {"value": "$4 per miljoen tokens (prompts van meer dan 200.000 tokens)", "section": "prijzen", "locator": "p.3"},
  "terminal_bench_version": [{"value": "3.0", "section": "benchmarkkaart", "locator": "p.4"},{"value": "v2.1", "section": "onafhankelijke benchmark", "locator": "p.5"}],
  "terminal_bench_score": [{"value": "26%", "section": "benchmarkkaart", "locator": "p.4"},{"value": "88,4%", "section": "independent benchmark", "locator": "p.5"}],
  "evidence_limits": {"value": "De twee Terminal-Bench-resultaten kunnen niet met elkaar worden vergeleken omdat het om verschillende benchmarkversies gaat. Er wordt geen melding gemaakt van de beschikbaarheid in de praktijk.", "section": "onafhankelijke benchmark", "locator": "p.5"}
}
Wat hieruit blijkt: het model kan informatie uit een groot, ruisrijk pakket ophalen en structureren volgens een strikt schema. Wat het niet bewijst: dat elk verzoek om 500.000 tokens even snel, even goedkoop en even nauwkeurig zal zijn voor een willekeurig klantdocument.
Kan Grok 4.6 strikte instructies opvolgen en op een heldere manier redeneren?
Voor een toewijzingspuzzel met beperkingen leverde het de enige juiste oplossing op: 7 uur onderzoek, 9 uur programmeren en 8 uur kwaliteitscontrole.
{"R":7,"C":9,"Q":8,"totaal":24,"controle":"De waarden voldoen aan R+C+Q=24, waarbij C=R+2 en Q=R+1."}Geef de exacte opdracht weer
Verdeel 24 uur over Onderzoek (R), Programmeren (C) en Kwaliteitscontrole (Q). Geef alleen JSON terug met integer-sleutels R, C, Q, total en een controle in één zin. Beperkingen: R + C + Q = 24; C = R + 2; Q = R + 1. Geef geen verborgen redenering weer.
De afzonderlijke taak voor het herschrijven met beperkingen leverde bij twee pogingen van de client geen API-antwoord op. Dit wordt geregistreerd als een infrastructuurafwijking, niet als een kwaliteitsscore. De praktische les hieruit is dat er een alternatief traject moet worden aangehouden voor de redactionele productie.
Hoeveel kost Grok 4.6?
| Optie | Huidige gepubliceerde prijs | Geschikt voor | Belangrijke grens |
|---|---|---|---|
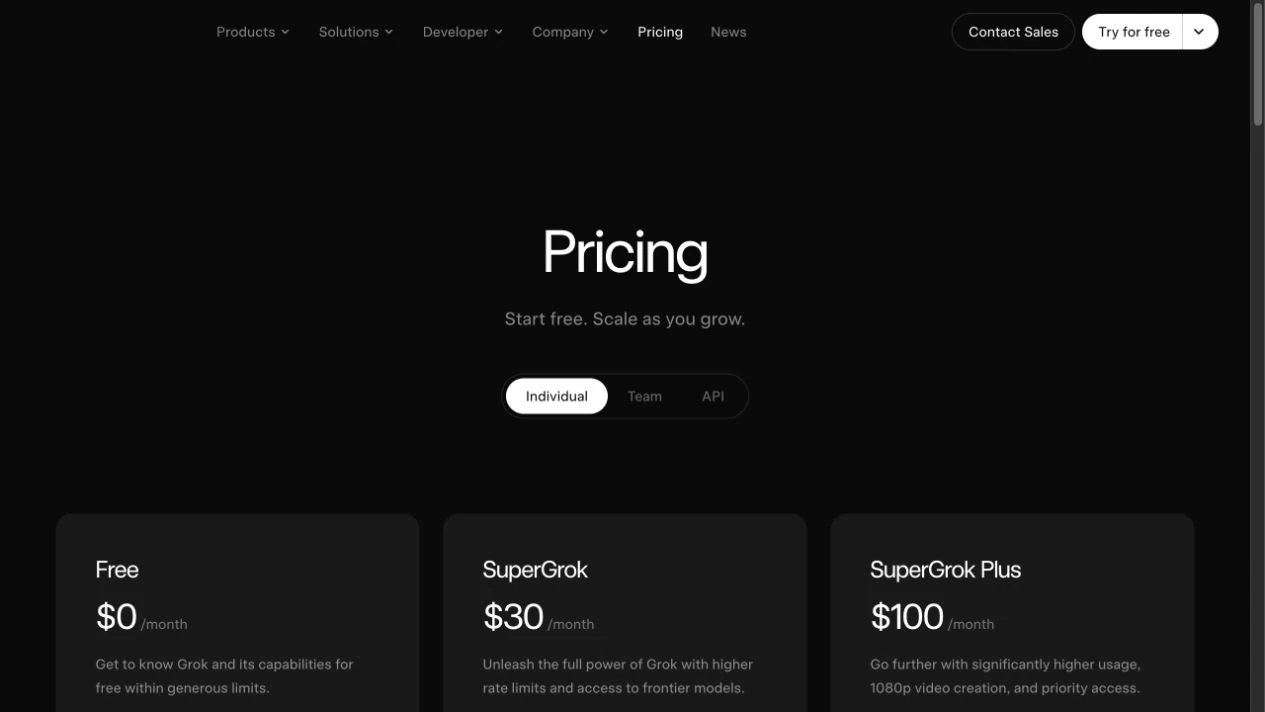
| xAI voor consumenten Gratis | $0/maand | De originele gebruikerservaring uitproberen. | De toegang en limieten van het gratis abonnement kunnen veranderen. |
| SuperGrok | $30/maand | Normaal gebruik door consumenten; op de huidige pagina staat Grok 4.6 vermeld. | Controleer of je hier recht op hebt voordat je iets publiceert. |
| SuperGrok Plus | $100/maand | Intensief gebruik door consumenten; op de huidige pagina staat Grok 4.6 vermeld. | Trek hieruit geen conclusies over de toegang voor andere abonnementen. |
| xAI API-basisabonnement | $2/M-ingang; $6/M-uitgang; $0,50/M-ingang in cache | Ontwikkelaars die op gebruik gebaseerde integraties bouwen. | Gereedschap wordt, indien van toepassing, apart in rekening gebracht. |
| xAI API-niveau voor lange context | Boven 200K: $4/M-invoer; $1/M in cache; $12/M-uitvoer | Zeer omvangrijke prompts en documenten. | Gebruik de basisprijs niet voor een aanvraag van meer dan 200K. |
| GlobalGPT | Bekijk de huidige GlobalGPT-plannen | Grok vergelijken met verschillende toonaangevende modellen in één werkruimte. | Ga er niet zomaar vanuit dat elk abonnement Grok 4.6 bevat; kijk op de pagina van het abonnement. |
Wat zou een Grok 4.6 API-verzoek kosten?
| Voorbeeldverzoek | Berekening | Geschatte kosten per modeltoken |
|---|---|---|
| 50K ingang + 5K uitgang | 50.000 × $2/M + 5.000 × $6/M | $0.13 |
| 100K ingang + 10K uitgang | 100K × $2/M + 10K × $6/M | $0.26 |
| 250K ingang + 10K uitgang | 250.000 × $4/M + 10.000 × $12/M | $1.12 |
| 400K ingang + 20K uitgang | 400.000 × $4/M + 20.000 × $12/M | $1.84 |
Rekenvoorbeelden op basis van de catalogusprijzen van xAI. Hierin zijn kortingen op ingeslagen input, belastingen, kosten voor het inzetten van gereedschap en de opslag van externe leveranciers niet meegerekend.
GlobalGPT is een uitstekende keuze wanneer je je afvraagt: “Welk model werkt het beste voor deze taak?”, in plaats van: “Hoe kan ik elke taak aan één API toewijzen?”. Je kunt opdrachten voor schrijven, onderzoek, programmeren en analyse in één werkruimte vergelijken en vervolgens de Prijspagina van GlobalGPT om het abonnement te kiezen dat bij uw gebruik past. Dit is een aanbeveling voor een abonnement met meerdere modellen, en geen omrekening van GlobalGPT-credits naar xAI-tokenprijzen.
Hoe krijg je toegang tot Grok 4.6?
Consumenten kunnen aan de slag met de huidige Grok-abonnementsopties van xAI. Ontwikkelaars dienen de officiële xAI API-documentatie en de exacte model-ID te gebruiken grok-4.6. Lezers die modellen willen vergelijken zonder meerdere API-accounts aan te maken, kunnen gebruikmaken van de geverifieerde Grok 4.6-werkruimte-invoer in GlobalGPT; de toegang tot de gebruikersinterface van het platform mag niet worden verward met alle native xAI-functies.
Wat zijn de belangrijkste beperkingen van de Grok 4.6?
- De huidige informatie moet nog worden onderbouwd: De uiterste datum voor de voorbereidende training in januari 2026 is geen garantie voor praktische kennis.
- Krantenkoppen over benchmarks kunnen misleidend zijn: De versie, de beoordelaar, de redeneringsinspanning en de dataset moeten aan elke score gekoppeld blijven.
- Een lange context kost meer: prompts met meer dan 200.000 tokens maken gebruik van het hogere API-niveau voor lange context.
- De betrouwbaarheid van de route varieert: Ons verzoek om bewerkingen met beperkingen stuitte op een infrastructuurstoring, hoewel andere taken wel zijn geslaagd.
- De toegang tot het platform is niet overal hetzelfde: Een GlobalGPT-werkruimte-item houdt niet in dat alle native xAI-functies of alle abonnementsrechten inbegrepen zijn.
Moet je kiezen voor Grok 4.6 of een ander AI-model?
Kies Grok 4.6 wanneer een uitgebreide context, codering en gestructureerd redeneren centraal staan in het werk. Kies een ander model wanneer uw belangrijkste prioriteit ligt bij een specifiek tool-ecosysteem, lagere voorspelbare kosten, een bepaalde multimodale output of een workflow die uw team al goed ondersteunt. De eerlijkste vergelijking is dezelfde prompt, hetzelfde bronpakket en dezelfde checker voor alle modellen – iets wat GlobalGPT eenvoudig maakt om te organiseren.
Voor wie is Grok 4.6 bedoeld?
- Onderzoekers en analisten: bronpakketten, bewijstabellen en uitgebreide pleitnota’s.
- Ontwikkelaars: foutopsporing, codebeoordeling en gestructureerde implementatieplannen.
- Makers en redacteuren: het opstellen van lange teksten, mits je een duidelijke opdrachtomschrijving en stijlgids verstrekt.
- Teams die modellen vergelijken: herhaalbare evaluaties met dezelfde prompt binnen één werkruimte.
Wat vragen lezers meestal over Grok 4.6?
Is Grok 4.6 officieel uitgebracht?
Ja. De aankondiging van de lancering van xAI is gedateerd op 12 augustus 2026.
Wat is de officiële API-model-ID?
grok-4.6.
Wat is het contextvenster?
xAI hanteert een contextvenster van 500.000 tokens.
Ondersteunt de Grok 4.6 afbeeldingen?
Ja. In de officiële modeldocumentatie worden afbeeldingen als invoer en tekst als uitvoer vermeld.
Hoeveel is Grok 4,6?
Op de huidige consumentenpagina staan de volgende tarieven vermeld: Free voor $0 per maand, SuperGrok voor $30 per maand en SuperGrok Plus voor $100 per maand. De API-prijzen zijn gebaseerd op het gebruik en er geldt een apart tarief voor lange contexten boven de 200.000 tokens.
Is Grok 4.6 beter dan Grok 4.5?
Het is nieuwer en presteert uitstekend in verschillende genoemde evaluaties, maar de taken en benchmarkversies verschillen. Test je eigen terugkerende workflow.
Kan ik de Grok 4,6 gebruiken in de GlobalGPT?
GlobalGPT heeft een weergegeven Grok 4.6-werkruimte-item. Controleer de huidige planrechten op de prijspagina.
Is Grok 4.6 betrouwbaar voor onderzoek?
Het presteerde goed bij de test met beperkte bronpakketten, maar belangrijke beweringen moeten altijd worden getoetst aan de aangehaalde bron.
Is het de moeite waard om in 2026 Grok 4.6 te gebruiken?
Grok 4.6 is een betrouwbaar, officieel uitgebracht model met een bruikbaar contextvenster van 500K, configureerbare redeneringen, sterke gepubliceerde benchmarkresultaten en goede resultaten in de eerste ronde bij gestructureerd onderzoek en taken met lange documenten. De zwakke punten zijn eveneens van praktische aard: benchmarkcijfers moeten zorgvuldig van versielabels worden voorzien, live-feiten moeten nog steeds worden onderbouwd met bronnen en de betrouwbaarheid van de route kan variëren.
Voor native toegang voor eindgebruikers of API-ontwikkeling kun je het beste beginnen met de huidige documentatie van xAI. Voor een op vergelijkingen gebaseerde workflow, probeer Grok 4,6 in GlobalGPT samen met andere toonaangevende modellen; kies vervolgens het abonnement dat het beste aansluit bij uw eigen werk op het gebied van schrijven, onderzoek, analyse of programmeren.
Primaire bronnen: xAI-release, Documentatie over xAI-modellen, Prijzen voor de xAI-API, xAI-prijzen voor consumenten, Kunstmatige analyse, Mercor APEX-SWE en de xAI-modelkaart.