Begin met het geluid dat je wilt maken. Kies ‘Eleven Music v2’ voor liedjes en gestructureerde instrumentale stukken, ‘Qwen Audio 3.0 TTS Flash’ voor vertelstemmen en expressieve stemmen, en ‘Seed Audio 1.0’ wanneer je spraak, omgevingsgeluiden en effecten wilt combineren tot één complete scène.
Je hoeft niet op zoek te gaan naar één ‘beste’ audiomodel. Een maker van achtergrondmuziek heeft iets anders nodig dan een marketeer die een voice-over opneemt of een filmmaker die een scène in een treinstation in beeld brengt. We hebben deze echte opdrachten getest – niet alleen de lijstjes met functies – en hieronder kun je alle tien eerste resultaten beluisteren.
Als je hetzelfde idee met je eigen prompt wilt uitproberen, GlobalGPT biedt je één plek om tussen alle drie te schakelen. Het is tevens een uitgebreidere werkruimte voor meerdere modellen: je kunt modellen zoals GPT-5.6 Sol, Claude Opus 4.8 en Gemini 3.1 Pro gebruiken voor schrijven en onderzoek, en vervolgens overschakelen naar GPT Image 2 of Seedance 2.0 wanneer het project afbeeldingen of video nodig heeft. Dat betekent dat je het script kunt opstellen, de audio kunt genereren en de rest van het project kunt blijven uitwerken zonder een hele reeks afzonderlijke tools aan elkaar te moeten koppelen. De toegang tot modellen verschilt per abonnement.
Begin met wat je wilt maken
Dit zijn uitgangspunten, geen algemene ranglijst.
Kort antwoord: welk model is geschikt voor welke audiotoepassing?
Hier is een eenvoudige manier om een keuze te maken: kies op basis van het eindresultaat, niet op basis van het merk. Eleven is het logische uitgangspunt wanneer het eindproduct muziek is; Qwen TTS Flash is geschikt voor vertelstemmen en expressieve stemmen; Seed is geschikt voor scènes waarin spraak, omgevingsgeluiden en effecten samen moeten worden gebruikt. Onze zes praktische opdrachten laten zien waar elke keuze het beste tot zijn recht kwam, en met de tien voorbeelden hieronder kun je zelf de afwegingen beluisteren.
| Model | Begin hier als… | Wat we hebben geprobeerd | Houd er rekening mee |
|---|---|---|---|
| Eleven Music v2 | Je hebt een liedje of een gestructureerd instrumentaal stuk nodig | Twee muzikale confrontaties en één showcase met vocale nummers | We hebben het niet gebruikt voor de vertelling |
| Qwen Audio 3.0 TTS Flash | Je hebt een vertelstem of een expressieve stem nodig | Twee debatwedstrijden | Deze resultaten gelden voor de geteste Flash-versie |
| Seed Audio 1.0 | Je hebt een complete scène nodig met verschillende soorten geluiden | Muziek, een toespraak en een scène op een treinstation | Een flexibele uitvoer geeft niet elk kenmerk uit de bovenstroomse fase weer |
Ten eerste zijn dit drie verschillende soorten audiomodellen
Eleven Music v2: een speciale workflow voor muziek
ElevenLabs beschrijft Eleven Music als tekst-naar-muziek met controle over genre, stijl en structuur. De documentatie toont ook voorbeelden van vocale of instrumentale uitvoeringen, meertalige generatie en bewerking per sectie of van een heel nummer. Die functies maken het tot de duidelijkste, speciaal voor muziek ontworpen workflow hier; dit betekent echter niet dat het om hetzelfde soort TTS-aanpak gaat als bij Qwen.

Qwen Audio 3.0 TTS Flash: de hier geteste spraakroute
Qwen Audio 3.0 TTS Flash — de exacte Anywhere-route is qwen-audio-3.0-tts-flash—is de spraakroute die in B1 en B2 wordt gebruikt. Documentatie over spraaksynthese van Alibaba Cloud vermeldt die exacte Flash-naam in de context van de aangepaste stem. Dit artikel neemt geen gegevens over de duur, het formaat of de ingebouwde stemmen uit andere Qwen-rijen of -varianten over.

Seed Audio 1.0: een uitgebreidere workflow voor de audiosector
Functies bij ByteDance Seed Audio 1.0 voor het genereren van complete scènes, van spraak en geluidseffecten tot omgevingsgeluiden en een samenhangende orkestratie. Daardoor is het de logische keuze wanneer één uitvoer verschillende geluidstypen op elkaar moet afstemmen. Het weergegeven overzicht doet geen zichtbare uitspraken over de muziek; de opmerkingen over de muziek in dit artikel zijn dan ook gebaseerd op onze eigen praktijktests en niet op die afbeelding.

De afzonderlijke BytePlus API-pagina identificeert seed-audio-1.0 als een niet-streamingroute met referentie-audio- of -beeldingangen, timingregeling en een uitvoerduur tot 120 seconden. Dit zijn feiten over de route, die los staan van de bredere verklaring over de positionering van het model.

Hoe we de drie audio-workflows hebben getest
We hebben de prompts vóór het genereren bevroren, tien taken achtereenvolgens ingediend en de eerste geldige uitvoer van elke taak bewaard. Alle tien verzoeken zijn geslaagd zonder dat er herhalingspogingen nodig waren. Clips waarin de spraak nog niet klaar was, zijn uitgesloten; de onderstaande testaudio bestaat uit de ruwe, eerste geldige media.
- Officieel bewijs: documentatie over eigen producten of API’s.
- Waargenomen aanwijzingen over de route: formaat, duur, kosten, decodering en signaalcontroles van deze sessie.
- Luisterbewijs: de blinde paarwijze voorkeuren van één gebruiker voor A1, A2, B1 en B2, plus een semantische beoordeling van C1 en C3.
- Beperkingen: de stabiliteitscontrole is niet uitgevoerd; B1 en B2 zijn niet automatisch woord voor woord getranscribeerd of gecontroleerd.
De totale waargenomen kosten bedroegen $0,4819752667 voor tien outputs. Dit getal heeft betrekking op deze sessie en vormt geen officiële prijsgarantie.
Muziektests: Eleven Music v2 versus Seed Audio 1.0
A1: Achtergrondmuziek voor een documentaire
A1: Achtergrondmuziek voor een documentaire
Een instrumentale begeleidingsmuziek van 30 seconden voor een reisdocumentaire, met een geleidelijke opbouw en een afgeronde afsluiting.
Geef de exacte bevroren prompt weer
Maak een instrumentale achtergrondmuziek van 30 seconden voor een korte reisdocumentaire. Begin met zachte fingerpicking op een akoestische gitaar en warme pianoklanken, voeg na het eerste derde deel lichte handpercussie toe, bouw de muziek geleidelijk op en sluit af met een heldere, afgeronde cadens. Hoopvol en bezinnend. Geen zang, geen gesproken tekst en geen geluidseffecten.
| Model | Precieze route | Status | Werkelijke duur | Formaat | Geconstateerde kosten |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Eerste geldige | 30,041 s | MP3, 44,1 kHz stereo | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | Eerste geldige | 30.000-en | PCM WAV, 40 kHz stereo | $0.0700000 |
- Objectieve controles
- Beide bestanden werden correct gedecodeerd, vertoonden vrijwel geen clipping en eindigden met een heldere fade-out. Er werd geen volledige conformiteit van de instrumenten vastgelegd.
- Beoordeling door de luisteraar
- De luisteraar gaf de voorkeur aan Eleven Music v2 omdat de overgang van licht naar zwaar natuurlijker aanvoelde en de instrumentale samenhang harmonischer klonk.
- Resultaat van de taak
- Eleven kreeg de voorkeur voor deze eerste opdracht.
- Beperkingen
- Eén eerste geldige uitvoer per model; stabiliteitscontrole niet uitgevoerd.
A1-luistertoets
Luister naar de eerste opnames van A1
Speel een van beide kaarten om de twee modellen rechtstreeks met elkaar te vergelijken.
Eleven Music v2
eleven-music-v2Gegenereerd via de geteste Anywhere-route op 6 augustus 2026. Eén eerste geldige uitvoer; stabiliteit niet getest.
Seed Audio 1.0
seed-audio-1.0Gegenereerd via de geteste Anywhere-route op 6 augustus 2026. Eén eerste geldige uitvoer; stabiliteit niet getest.
Voor A1 koos de luisteraar voor het eerste nummer van Eleven vanwege de natuurlijkere overgang van licht naar zwaar en de harmonieuzere instrumentale samenhang.
A2: Signaal voor de lancering van een gestructureerd product
A2: Gestructureerde aanwijzing voor productlancering
Een in drie delen opgebouwde instrumentale cue van 30 seconden: een minimalistische puls, aangevuld met drums en toenemende energie, gevolgd door een heldere afsluiting.
Geef de exacte bevroren prompt weer
Maak een instrumentale intro van 30 seconden voor een productlancering, verdeeld in drie duidelijke delen: 0–8 seconden, een minimalistische synthesizerpuls; 8–22 seconden, voeg heldere elektronische drums en toenemende harmonische energie toe; 22–30 seconden, zorg voor een heldere afsluiting en een strak einde. Modern en zelfverzekerd, maar niet agressief. Geen zang, spraak of omgevingsgeluiden.
| Model | Precieze route | Status | Werkelijke duur | Formaat | Geconstateerde kosten |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Eerste geldige | 30,041 s | MP3, 44,1 kHz stereo | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | Eerste geldige | 27,704 s | PCM WAV, 40 kHz stereo | $0.0646436 |
- Objectieve controles
- Beide bestanden zijn correct gedecodeerd, vrijwel zonder clipping. De seed leverde 27,704 seconden op voor een verzoek van 30 seconden; dit is normaal gedrag voor deze route en geen kwaliteitsverlies.
- Beoordeling door de luisteraar
- De luisteraar gaf de voorkeur aan Seed Audio 1.0 vanwege de helderdere intro en de rijkere muzikale gelaagdheid; de opening van Eleven was moeilijk te horen.
- Resultaat van de taak
- Seed kreeg de voorkeur voor deze eerste opdracht; de twee muziektests werden gesplitst.
- Beperkingen
- De exacte timing van de secties is niet grondig gecontroleerd; de stabiliteit is niet getest.
A2-luistertoets
Luister naar de eerste opnames van A2
Speel een van beide kaarten om de twee modellen rechtstreeks met elkaar te vergelijken.
Eleven Music v2
eleven-music-v2Gegenereerd via de geteste Anywhere-route op 6 augustus 2026. Eén eerste geldige uitvoer; stabiliteit niet getest.
Seed Audio 1.0
seed-audio-1.0Gegenereerd via de geteste Anywhere-route op 6 augustus 2026. Eén eerste geldige uitvoer; stabiliteit niet getest.
In de categorie A2 ging de voorkeur van de luisteraars uit naar de eerste output van Seed, omdat de intro duidelijker was en de geluidslagen voller klonken. De Seed-route leverde 27,704 seconden op voor een verzoek van 30 seconden; we registreren dat verschil apart, niet als een kwaliteitsverlies. Aangezien elk model bij één muziektest beter presteerde, is er geen winnaar in de categorie muziek.
Spraaktests: Qwen TTS Flash versus Seed Audio 1.0
B1: Neutrale documentairevertelling
B1: Neutrale documentairevertelling
Dezelfde Engelse havenvertelling, voorgelezen op een rustige, neutrale toon, in een gematigd tempo en met natuurlijke pauzes.
Geef de exacte bevroren prompt weer
Elke ochtend ontwaakt de haven nog voor de stad. Veerboten varen over het water, de lichten van de winkels gaan aan en de eerste forenzen zetten voet op de kade. Tegen zeven uur is de rustige waterkant het middelpunt van de dag geworden. Rustige documentairevertelling in helder, neutraal Engels. Houd een gematigd tempo aan en maak natuurlijke pauzes. Geen muziek, omgevingsgeluiden of geluidseffecten.
| Model | Precieze route | Status | Werkelijke duur | Formaat | Geconstateerde kosten |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | Eerste geldige | 27,507 s | MP3, 22,05 kHz mono | $0.0051300 |
| Seed Audio 1.0 | seed-audio-1.0 | Eerste geldige | 18,780 s | PCM WAV, 40 kHz stereo (identieke kanalen) | $0.0438200 |
- Objectieve controles
- Beide bestanden werden correct gedecodeerd en bevatten spraakachtige activiteit en pauzes. De gebruiker meldde geen duidelijke tekstproblemen.
- Beoordeling door de luisteraar
- De luisteraar gaf de voorkeur aan Qwen omdat die natuurlijker en documentairder klonk; Seed klonk stijf, alsof het een herinnering vlak voor een examen was.
- Resultaat van de taak
- Qwen heeft de voorkeur voor deze eerste uitvoeringstaak.
- Beperkingen
- De woord-voor-woord-nauwkeurigheid is niet gecontroleerd; de stabiliteit is niet getest.
B1-luistertoets
Luister naar de eerste resultaten van B1
Speel een van beide kaarten om de twee modellen rechtstreeks met elkaar te vergelijken.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flashGegenereerd via de geteste Anywhere-route op 6 augustus 2026. Eén eerste geldige uitvoer; stabiliteit niet getest.
Seed Audio 1.0
seed-audio-1.0Gegenereerd via de geteste Anywhere-route op 6 augustus 2026. Eén eerste geldige uitvoer; stabiliteit niet getest.
De eerste uitvoer van Qwen klonk natuurlijker en meer als een documentaire; Seed klonk voor de luisteraar wat stijf. Als het controleren van transcripties een centraal onderdeel van je workflow is, wordt dit in deze aparte handleiding uitgelegd hoe ChatGPT audio kan omzetten in tekst. We hebben geen transcriptie gebruikt om B1 woord voor woord te controleren.
B2: Emotionele ontwikkeling
B2: Emotionele ontwikkeling
Een vrouwenstem die varieert van een gespannen gefluister via een neutrale vertelstem tot opgeluchte opwinding.
Geef de exacte bevroren prompt weer
“Het is ons gelukt,” fluisterde Maya. Toen gingen de lichten weer aan. “Oké – nu kunnen we het vieren!” Gebruik één consistente vrouwelijke volwassensteem. Spreek de eerste zin zacht en gespannen uit, de middelste zin in een neutrale, vertellende toon, en de laatste zin met opgeluchte opwinding. Zorg dat de emotionele veranderingen duidelijk zijn, maar niet theatraal. Geen muziek of geluidseffecten.
| Model | Precieze route | Status | Werkelijke duur | Formaat | Geconstateerde kosten |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | Eerste geldige | 25,913 s | MP3, 22,05 kHz mono | $0.0052950 |
| Seed Audio 1.0 | seed-audio-1.0 | Eerste geldige | 9,180 s | PCM WAV, 40 kHz stereo (identieke kanalen) | $0.0214200 |
- Objectieve controles
- Beide bestanden zijn correct gedecodeerd; er waren meerdere spraaksegmenten aanwezig. Verschillen in duur werden niet meegenomen in de kwaliteitsbeoordeling.
- Beoordeling door de luisteraar
- De luisteraar gaf de voorkeur aan Qwen vanwege de krachtigere fluisterklank en het overtuigender verhaalgevoel.
- Resultaat van de taak
- Qwen heeft de voorkeur voor deze eerste uitvoeringstaak.
- Beperkingen
- De woord-voor-woord-nauwkeurigheid is niet gecontroleerd; de stabiliteit is niet getest.
B2-luistertoets
Luister naar de eerste opnames van de B2
Speel een van beide kaarten om de twee modellen rechtstreeks met elkaar te vergelijken.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flashGegenereerd via de geteste Anywhere-route op 6 augustus 2026. Eén eerste geldige uitvoer; stabiliteit niet getest.
Seed Audio 1.0
seed-audio-1.0Gegenereerd via de geteste Anywhere-route op 6 augustus 2026. Eén eerste geldige uitvoer; stabiliteit niet getest.
De eerste uitvoer van Qwen had een sterker fluisterend karakter en een meer verhalende toon. De gebruiker hoorde geen duidelijke tekstuele fouten in B1 of B2, maar de exacte woordnauwkeurigheid is nog niet geverifieerd.
Voorbeelden van workflows met één model
C1: Eleven Music v2 gestructureerd vocaal nummer
C1: Gestructureerd vocaal lied
Een indiepopnummer van 30 seconden met een vaste bezetting, structuur en twee verplichte tekstregels.
Geef de exacte bevroren prompt weer
Maak een vrolijk indiepopnummer van 30 seconden met één vrouwelijke leadzangeres, heldere gitaar, bas en handgeklap. Opbouw: een instrumentale intro van vier seconden, een kort couplet, een refrein en een strak einde. Gebruik elk van deze tekstregels één keer: Couplet: ‘Morning on the window, plans are taking flight.’ Refrein: ‘Start where you are, and make the moment bright.’ Geen gesproken tekst of geluidseffecten.
| Model | Precieze route | Status | Werkelijke duur | Formaat | Geconstateerde kosten |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Eerste geldige | 30,041 s | MP3, 44,1 kHz stereo | $0.0750000 |
- Objectieve controles
- De MP3-bestand is correct gedecodeerd. Er werd een verwaarloosbaar, op zichzelf staand signaal op volledige schaal gedetecteerd, zonder wijdverspreide clipping.
- Beoordeling door de luisteraar
- De luisteraar oordeelde dat er gedeeltelijk aan de eis was voldaan: de stem klonk enigszins onnatuurlijk en had een soort elektrische ruis.
- Resultaat van de taak
- Voor deze eerste output is hier gedeeltelijk aan voldaan.
- Beperkingen
- Deze opmerking geldt alleen voor deze eerste uitvoer; de stabiliteitstest is niet uitgevoerd.
C1-luistertoets
Luister naar de eerste uitvoer van de C1
Speel de eerste geldige uitvoer van deze showcase met één model af.
Eleven Music v2
eleven-music-v2Gegenereerd via de geteste Anywhere-route op 6 augustus 2026. Eén eerste geldige uitvoer; stabiliteit niet getest.
C1 heeft gedeeltelijk aan de contractuele verplichtingen voldaan. De luisteraar vond de stem enigszins onnatuurlijk en hoorde een soort elektrische ruis. Dit is een opmerking die specifiek betrekking heeft op dit exemplaar, en geen algemene klacht over een defect.
C3: Seed Audio 1.0 – complete stationsscène
C3: Volledige stationsscène
Een scène van 20 seconden op een station aan de kust, waarin omgevingsgeluiden, een rijdende trein, een belgeluid en een exacte omroepmededeling worden gecombineerd.
Geef de exacte bevroren prompt weer
Creëer een complete scène van 20 seconden bij een treinstation aan de kust bij zonsopgang. Begin met een zacht zeebriesje en meeuwen in de verte. Een trein nadert van links en remt af bij het perron. Een rustige vrouwelijke stationsomroepster zegt precies: ‘De kusttrein van zeven vijftien komt nu aan op perron twee.’ Voeg een kort, zacht muzikaal geluidssignaal toe vóór de omroep, en laat de trein en de omgevingsgeluiden daarna op natuurlijke wijze wegsterven. Zorg ervoor dat de spraak verstaanbaar is en dat de scène ruimtelijk samenhangend is.
| Model | Precieze route | Status | Werkelijke duur | Formaat | Geconstateerde kosten |
|---|---|---|---|---|---|
| Seed Audio 1.0 | seed-audio-1.0 | Eerste geldige | 20.000-er jaren | PCM WAV, 40 kHz stereo | $0.0466667 |
- Objectieve controles
- Het WAV-bestand werd correct gedecodeerd, vertoonde vrijwel geen clipping en bevatte op technisch vlak de gevraagde meerdelige scènestructuur.
- Beoordeling door de luisteraar
- De luisteraar oordeelde dat er gedeeltelijk aan de eis was voldaan, omdat de rem- en stopgeluiden van de trein enigszins kunstmatig klonken.
- Resultaat van de taak
- Voor deze eerste output is hier gedeeltelijk aan voldaan.
- Beperkingen
- De exacte aankondiging is niet onafhankelijk uitgeschreven; de stabiliteitstest is niet uitgevoerd.
C3-luistertoets
Luister naar de eerste uitgave van C3
Speel de eerste geldige uitvoer van deze showcase met één model af.
Seed Audio 1.0
seed-audio-1.0Gegenereerd via de geteste Anywhere-route op 6 augustus 2026. Eén eerste geldige uitvoer; stabiliteit niet getest.
Ook C3 voldeed gedeeltelijk aan de afspraken: de luisteraar vond de rem- en stopgeluiden van de trein enigszins kunstmatig. Videomakers die gegenereerde spraak combineren met beeldmateriaal, kunnen dit wellicht ook merken Handleiding voor dialoog, geluid en lipsynchronisatie handig, hoewel de lipsynchronisatie hier niet is getest.
Kosten, uitvoerlengte en routegedrag
Gemeten laadduur en werkelijke ontladingsduur
Eén eerste geldige uitkomst per taak via Anywhere op 6 augustus 2026. De tarieven zijn gebaseerd op sessieobservaties en vormen geen officiële tarieflijst. De twee minibalken maken gebruik van afzonderlijke visuele schalen; er wordt geen gebruik gemaakt van een dubbele as of een gecombineerde score.
De gemeten kosten variëren van $0,00513 voor Qwen B1 tot $0,075 voor elke Eleven-uitvoer. De werkelijke duur varieert van 9,180 seconden voor Seed B2 tot 30,041 seconden voor de muziekuitvoer van Eleven. Dit zijn gemeten sessieresultaten, geen catalogusprijzen of kwaliteitsscores.
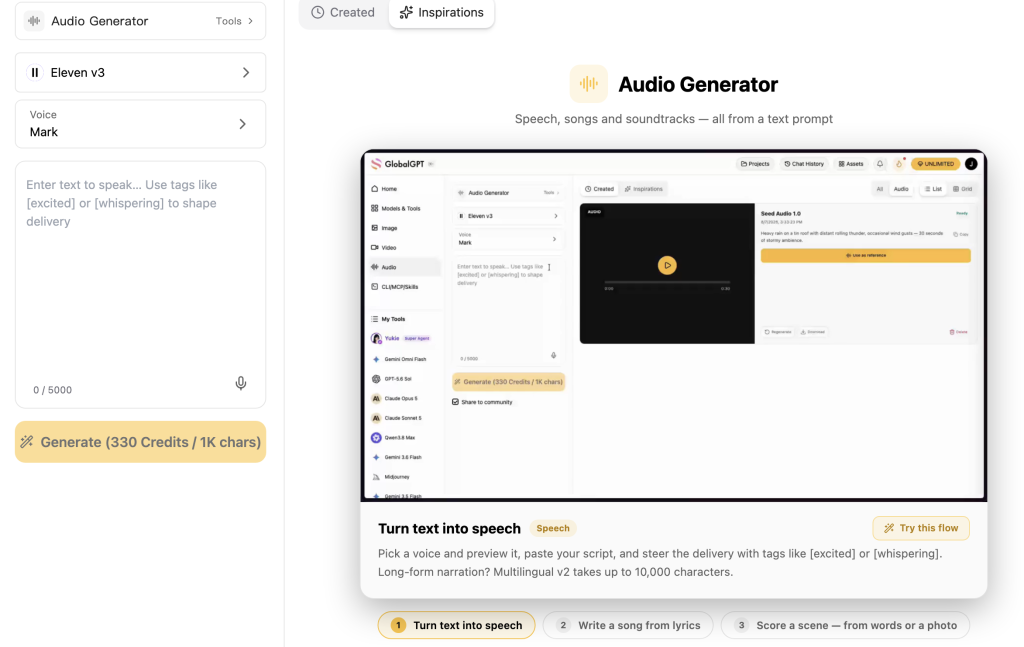
Waarom zou je deze audiomodellen eens uitproberen op de GlobalGPT?
Het genereren van muziek, expressieve TTS en complete geluidslandschappen zijn verschillende taken; daarom is er hier geen eenduidig winnend model. GlobalGPT maakt dat onderscheid praktisch toepasbaar: je kunt beginnen met Eleven Music voor een track, overschakelen naar Qwen Audio voor een vertelling, of Seed Audio gebruiken voor een gecomponeerde scène, zonder dat je voor elke audio-workflow een apart platform hoeft te onderhouden.
Aangezien GlobalGPT een werkruimte voor meerdere modellen is en geen tool die uitsluitend voor audio bedoeld is, hoeft het werk niet per se te eindigen met een audiobestand. Je kunt andere AI-modellen op het platform gebruiken om een script op te stellen of te verfijnen, onderzoek te doen naar een onderwerp, ondersteunende afbeeldingen te maken en videomateriaal te ontwikkelen rondom het voltooide geluidsfragment.
Op 10 augustus 2026 zal de Prijspagina van GlobalGPT toonde maandelijkse equivalenten van $5.8 voor BASIC, $10.8 voor PRO en $25.0 voor UNLIMITED, waarbij de opties ‘Jaarlijks geselecteerd’ en ‘Jaarlijks gefactureerd’ werden weergegeven. Dit zijn de cijfers voor jaarlijkse facturering op deze pagina; de toegang tot modellen verschilt per abonnement.

Welk model moet je kiezen?
Resultaatmatrix met zes taken en eerste uitkomsten
| Werkstroom | Geteste modellen | Resultaat | Geconstateerde reden | Soort bewijs | Beperking |
|---|---|---|---|---|---|
| A1 · Muziek | Eleven tegen Seed | Elf voorkeur | Een meer natuurlijke opbouw en een harmonieuze instrumentatie | Voorkeur van blinde luisteraars | Elk één eerste uitvoer |
| A2 · Muziek | Eleven tegen Seed | Bij voorkeur zaad | Een duidelijkere inleiding en een rijkere gelaagdheid | Voorkeur van blinde luisteraars | Seed leverde 27,704 s op |
| B1 · Spreken | Qwen tegen Seed | Qwen heeft de voorkeur | Een meer natuurlijke manier van presenteren in documentaires | Voorkeur van blinde luisteraars | Tekst niet woord voor woord gecontroleerd |
| B2 · Spreken | Qwen tegen Seed | Qwen heeft de voorkeur | Een krachtiger gevoel van gefluister en verhalen vertellen | Voorkeur van blinde luisteraars | Tekst niet woord voor woord gecontroleerd |
| C1 · Zangnummer | Slechts elf | Gedeeltelijk voldaan | De stem klonk onnatuurlijk en had een soort elektrische ruis | Semantische beoordeling door de gebruiker | Waarneming specifiek voor het monster |
| C3 · Geluidslandschap | Alleen zaad | Gedeeltelijk voldaan | Het remmen en tot stilstand komen van de trein klonk onnatuurlijk | Semantische beoordeling door de gebruiker | Aankondiging niet uitgeschreven |
Er wordt geen enkele rij omgezet in een totaalscore of een algemene winnaar.
- Kies Eleven Music v2 wanneer het werk in wezen om muziek draait: gestructureerde instrumentale stukken, liedjes of het bewerken van muziek op sectieniveau.
- Kies Qwen Audio 3.0 TTS Flash wanneer het gaat om vertelling of gestuurde expressieve spraak.
- Kies Seed Audio 1.0 wanneer de output zich moet gedragen als een complete scène waarin sfeergeluiden, effecten en spraak worden gecombineerd.
Deze aanbevelingen geven een overzicht van de mate waarin de workflow aansluit, plus zes beoordelingen op basis van de eerste resultaten. Ze wijzen niet één algemene winnaar aan.
Beperkingen van deze vergelijking
- Eén eerste geldige uitvoer per model en taak; geen herhalingen vanwege stabiliteit.
- B1 en B2 zijn niet woord voor woord uitgeschreven of gecontroleerd.
- Beoordelingen op basis van luisteren zijn subjectief en afhankelijk van de specifieke steekproef.
- Een Anywhere-route vormt niet het volledige upstream-product.
- Geen enkel eerlijk en onafhankelijk klassement neemt deze drie exacte routes op basis van één methode mee.
- Bestandsformaat, bemonsteringsfrequentie, kanalen, bestandsgrootte en afspeelvolume werden niet als kwaliteitscriteria meegenomen.
Veelgestelde vragen
01Zijn Eleven Music v2, Qwen Audio 3.0 en Seed Audio 1.0 hetzelfde type model?
Nr. Elf Music v2 is een gespecialiseerde muziekworkflow, Qwen Audio 3.0 TTS Flash is de spraakmodule die hier is getest, en Seed Audio 1.0 is bedoeld voor het genereren van geluid voor complete scènes. In deze vergelijking worden daarom aanbevelingen per taak gedaan, in plaats van één universele ranglijst op te stellen.
02Welk model is bedoeld voor het genereren van muziek met behulp van AI?
Eleven Music v2 is in deze vergelijking veruit de beste keuze als het gaat om muziek. In de officiële documentatie wordt beschreven dat het programma mogelijkheden biedt voor het instellen van genre, stijl, structuur, zang- of instrumentale uitvoer, ondersteuning voor meerdere talen en bewerking op sectieniveau of van het hele nummer.
03Welke geteste route past bij vertelling en expressieve spraak?
Qwen Audio 3.0 TTS Flash, hier aangeduid met de exacte Anywhere-route qwen-audio-3.0-tts-flash, voldeed het best aan de tests voor vertelling en expressieve spraak. De luisteraar gaf in zowel B1 als B2 de voorkeur aan de eerste uitvoer, maar de stabiliteit en de exacte woordnauwkeurigheid werden niet getest.
04Welk model kan een compleet geluidslandschap creëren met spraak en geluidseffecten?
Seed Audio 1.0 biedt de meest geschikte workflow voor een gecomponeerde geluidslandschap. De officiële toepassing omvat spraak, geluidseffecten, omgevingsgeluiden en geïntegreerde orkestratie, terwijl de C3-test een stationsomroep, treingeluiden, een belsignaal en omgevingsgeluiden van de kust in één uitkomst combineerde.
05Kan ik ze alle drie via GlobalGPT gebruiken?
Ja. Je kunt Eleven Music gebruiken voor muziek, Seed Audio 1.0 voor complete audioscènes en Qwen Audio 3.0 voor spraak in de audio-werkruimte van GlobalGPT. GlobalGPT brengt ook workflows voor schrijven, onderzoek, afbeeldingen en video samen op hetzelfde multimodale platform. De beschikbaarheid van modellen verschilt per abonnement.
06Komt er uit deze vergelijking een algemene winnaar naar voren?
Nee. De modellen zijn bedoeld voor verschillende workflows, en de praktijkresultaten hebben betrekking op één eerste geldige uitvoer per model en taak, zonder herhalingen om de stabiliteit te controleren. De bruikbare conclusie is voorwaardelijk: Eleven voor specifieke muziek, Qwen TTS Flash voor spraak en Seed voor complete audioscènes.
Probeer je eigen audio-workflow eens uit
Neem je eigen muziekconcept, vertelscript of geluidslandschap-opdracht mee naar de GlobalGPT-audiogenerator en vergelijk het resultaat met de opdracht die je daadwerkelijk moet voltooien. Let op de muzikale structuur, de stemvoering, de samenhang binnen de scène en de mate waarin de aanwijzingen worden opgevolgd, in plaats van een model uitsluitend op basis van de naam te kiezen.
Zodra de audiorichting goed werkt, kun je het project voortzetten met de andere AI-modellen van GlobalGPT voor scriptontwikkeling, onderzoek, ondersteunende afbeeldingen en videoconcepten. Zo wordt de test een praktische content-workflow in plaats van een op zichzelf staande audiodemo; herhaal de uitvoer alleen als je bewijs van stabiliteit nodig hebt.