
Claude Sonnet 5.5 is een krachtig model voor dagelijks gebruik: krachtig genoeg voor het oplossen van een lastige bug of het verwerken van een omvangrijk document, en dat tegen een lagere tokenprijs dan Opus 5.5. De voordelen ervan komen vooral duidelijk naar voren als je kunt bepalen hoe een goed antwoord eruitziet. Voor een open strategie of een onbekend probleem met veel variabelen verdient Opus nog steeds een plek in je workflow.
Tijdens onze GlobalGPT-tests stelde Sonnet 5.5 e-mails voor klanten op, herstelde het een functie voor geldtoewijzing die 43 controles doorstond, en voerde het een correcte afstemming uit van een reeks factuurgegevens van 13.078 woorden. De e-mail bevatte ook een kleine aanname over het proces die moest worden gecontroleerd. De interessantere vraag is wanneer de snelheid en prijs ervan zich vertalen in een betere werkdag – en wanneer extra redeneren meer gaat kosten dan het oplevert.
U kunt Claude Sonnet 5,5 op GlobalGPT naast andere toonaangevende modellen voor schrijven, programmeren, onderzoek, afbeeldingen en video. Met één abonnement voor meerdere modellen kun je op een betaalbare manier een project van het eerste concept tot het eindresultaat begeleiden, zonder dat je voor elke stap een apart abonnement hoeft te beheren.
Claude Sonnet 5.5: het korte oordeel
Een praktische standaardoplossing voor duidelijk omschreven werkzaamheden
Begin met Sonnet voor een korte opdracht, een bug, een document of een eerste implementatie. Geef het het bronmateriaal, de beperkingen en de acceptatiecriteria. Schakel over naar Opus wanneer het moeilijkste deel is om te bepalen wat het probleem nu eigenlijk is.
Wat indruk op ons maakte: gecontroleerde opmaak, robuuste code en correcte afstemming van documenten.
Wat je kunt bekijken: Er kunnen kleine aannames in een verzorgde tekst sluipen; redeneringen brengen extra kosten met zich mee; een uitgebreide context is geen garantie dat de inhoud wordt onthouden.
Dit is een beoordeling van een pas uitgebracht model, geen maandenlang productieonderzoek. We combineren de specificaties van Anthropic, gepubliceerde evaluaties en drie praktische taken die op 1 oktober 2026 zijn uitgevoerd. De schrijftaak werd twee keer herhaald; de code- en documenttaken werden elk één keer uitgevoerd. Bij de onderstaande resultaten wordt rekening gehouden met deze kleine steekproef.
Wat is er nieuw in Claude Sonnet 5.5?
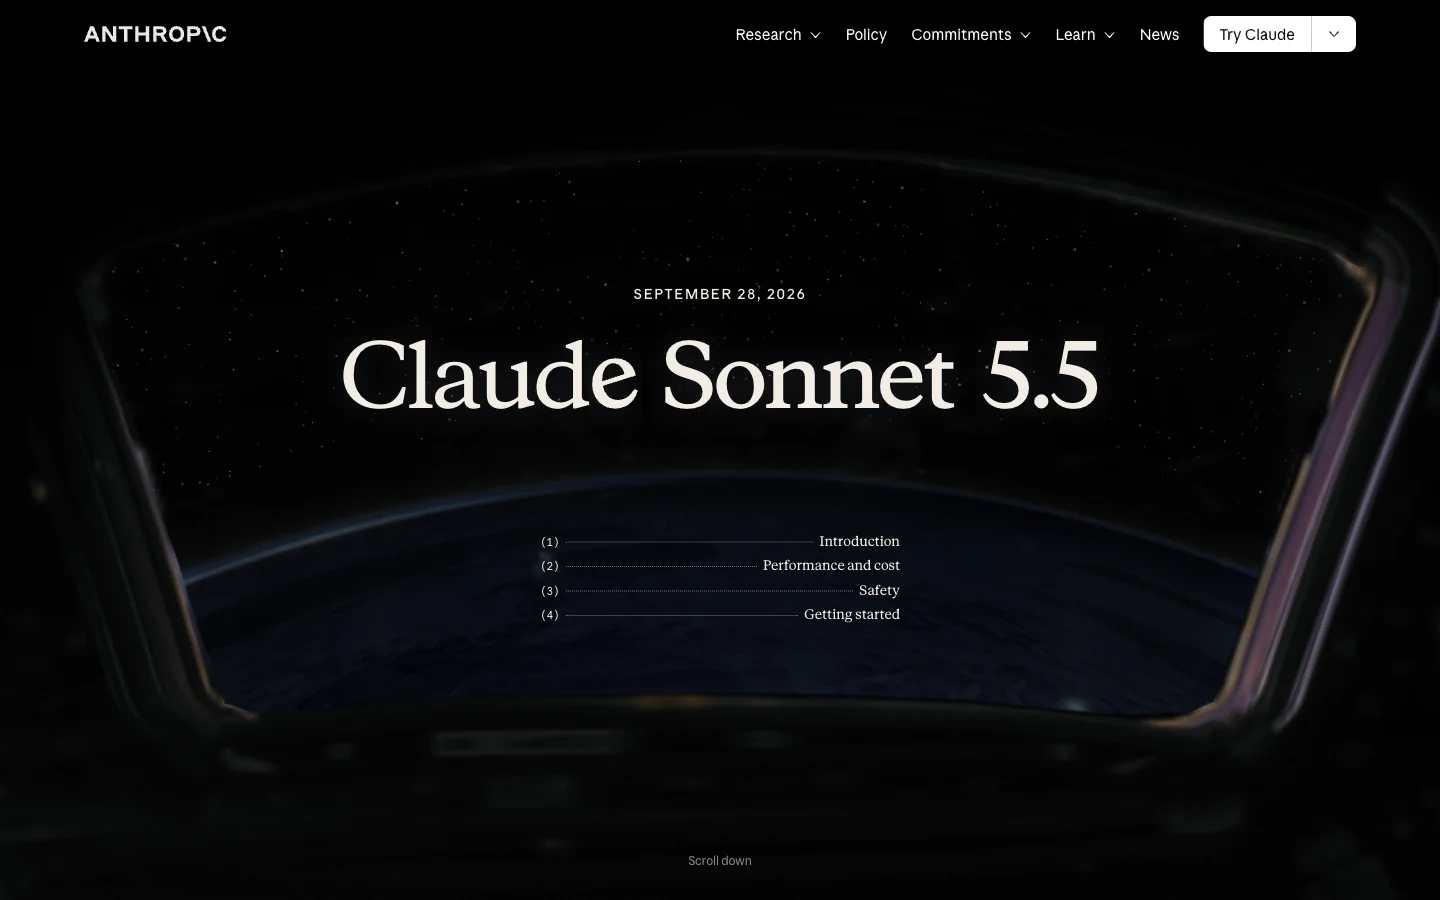
Anthropic bracht op 28 september 2026 Sonnet 5.5 op de markt als een snellere, goedkopere aanvulling op Opus 5.5. De aangegeven sterke punten zijn: alledaagse taken binnen een duidelijk afgebakend kader, het verhelpen van bugs en het produceren van verzorgde documenten, presentaties en spreadsheets. Die positionering is belangrijk: je hebt niet voor elke bewerking, elk antwoord op een supportvraag of elke implementatietaak het duurste model nodig.
Wat is er nieuw in Claude Sonnet 5.5?
| Functie | Sonnet 5.5 | Wat dit in de praktijk betekent |
|---|---|---|
| Invoer en uitvoer | Tekst en afbeeldingen erin; tekst eruit | Vraag om een grafiek of een screenshot en zet het antwoord vervolgens om in een concept of plan. |
| API-contextvenster | 1 miljoen tokens | Ruimte voor uitgebreid bronmateriaal; orden en label het zorgvuldig. |
| Maximale output van de standaard-API | 128K lopers | Een maximale lengte, geen aanbevolen lengte voor elk antwoord. |
| Redenering | Adaptief denken | De inspanning kan zowel de voltooiingstijd als het totale tokenverbruik beïnvloeden. |
| Kennis cutoff | juni 2026 | Gebruik actuele bronnen of zoekinstrumenten om feiten te verifiëren. |
Deze context- en outputlimieten hebben betrekking op de Claude-API. De hoeveelheid die je in een bepaalde app kunt uploaden of ontvangen, hangt ook af van de interface van dat product. Evenzo is een model dat een afbeelding begrijpt, geen afbeeldingsgenerator. Sonnet kan een visueel werk beoordelen of een productieopdracht schrijven; een afbeeldings- of videomodel creëert de voltooide media.
Het voordeel van deze aanpak is de combinatie van een grondigere uitvoering van de opdracht en snellere iteraties. Je kunt om een eerste versie vragen, de zwakke punten bekijken en vervolgens om een gerichte herziening vragen. Een goede opdracht geeft een duidelijk doel aan: “Laat alle afbeeldingen ongewijzigd, kort dit in tot 200 woorden en som alles op wat in de bron niet wordt vermeld.”
Prijzen voor Claude Sonnet 5.5: tokentarieven en werkelijke kosten
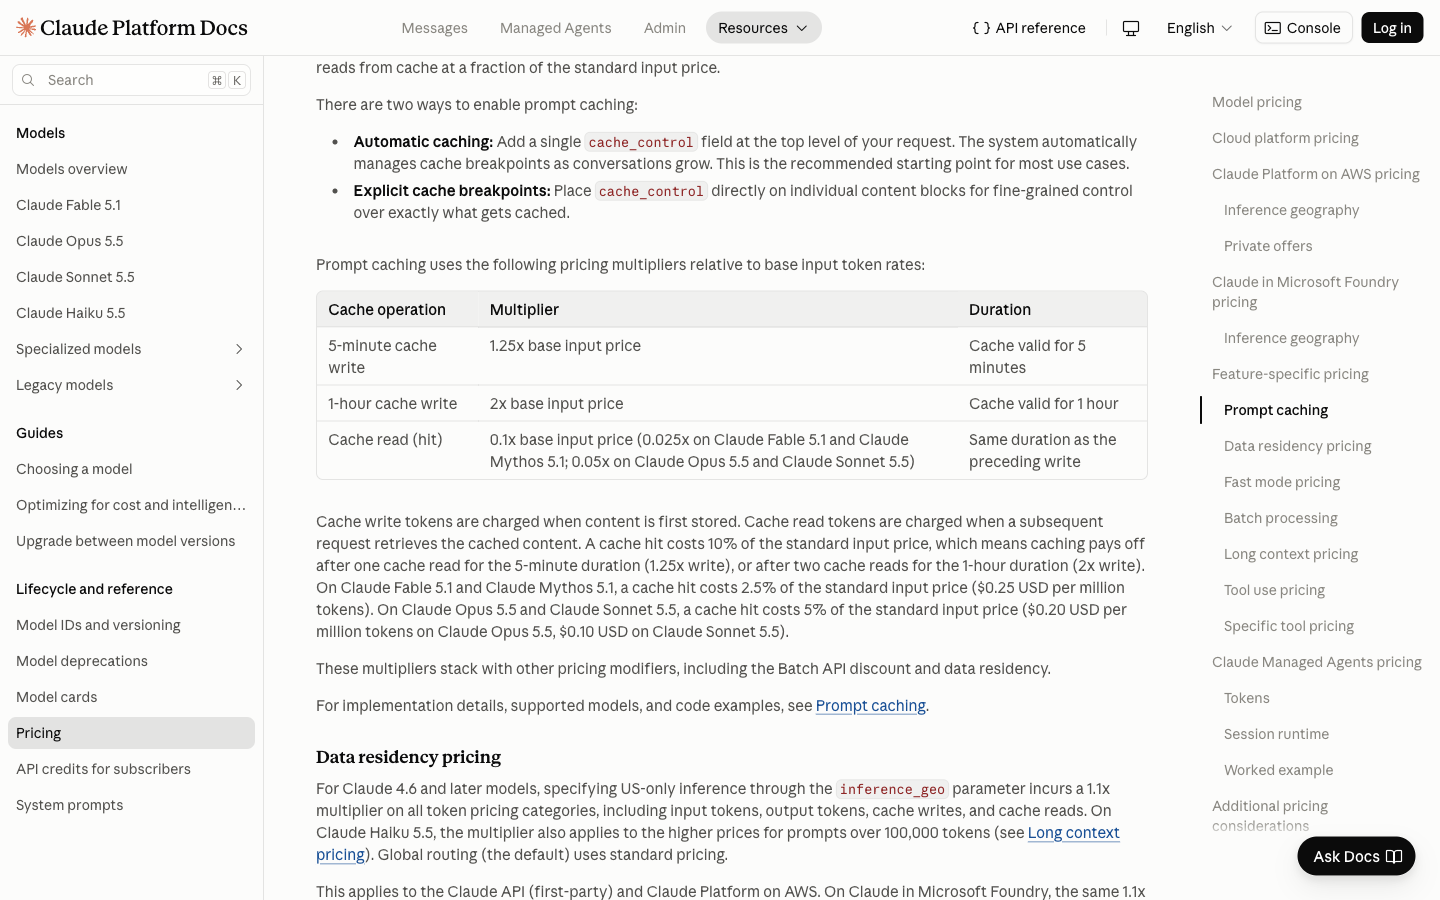
Sonnet 5.5-kosten $2 per miljoen invoertokens en $10 per miljoen uitvoertokens tegen de standaard API-tarieven van Anthropic. Dat zijn dezelfde eenheidsprijzen als bij Sonnet 5. Vergeleken met de $4-invoer- en $20-uitvoertarieven van Opus 5.5 kost Sonnet de helft minder per invoer- of uitvoertoken, maar een voltooide taak kan een ander aantal tokens verbruiken.
Prijzen voor Claude Sonnet 5.5: tokentarieven en werkelijke kosten
| API-factureringscategorie | Prijs per miljoen tokens |
|---|---|
| Niet-gecacheerde invoer | $2.00 |
| Output, inclusief gefactureerde denk-tokens | $10.00 |
| Cache lezen / vernieuwen | $0.10 |
| Cache schrijven, 5 minuten | $2.50 |
| Cache-schrijfbewerking, 1 uur | $4.00 |
Voor een verzoek dat niet in de cache is opgeslagen, vermenigvuldig je het aantal invoertokens met $2 per miljoen en het aantal uitvoertokens met $10 per miljoen. Een invoer van 10.000 tokens met 2.000 uitvoertokens kost $0,04. Een invoer van 100.000 tokens met 10.000 uitvoertokens kost $0,30. Dit zijn rekenvoorbeelden voor de API, geen GlobalGPT-factuur; tools, cachebewerkingen, serviceniveaus en andere prijsbepalende factoren kunnen het totaalbedrag beïnvloeden.
Wat zo’n verzoek kan kosten
Ter illustratie: standaard API-kosten per verzoek. Alleen invoer en uitvoer die niet in de cache zijn opgeslagen.
Formule: (invoer-tokens × $2 + uitvoer-tokens × $10) ÷ 1.000.000. In rekening gebrachte rekenkracht telt mee voor de uitvoer. Dit zijn voorbeelden, geen abonnementsprijzen of daadwerkelijke facturen.
De bewering van Anthropic dat er “tot 30% minder per taak” nodig is, is gebaseerd op het feit dat bepaalde taken met minder tokens worden uitgevoerd. Het gaat hier niet om een prijsverlaging van 30%. Aan het andere uiterste, Evaluatie van de lancering van Artificial Analysis bij maximale inspanning werd ongeveer $7,60 per Intelligence Index-taak gemeten, wat neerkomt op zo’n 50% boven Sonnet 5 in die test. Die veeleisende benchmarktaken zijn geen gewone chatberichten, maar ze laten wel zien waarom het volledig opvoeren van het redeneervermogen een schijnbare voordeel kan tenietdoen.
API-facturering, Claude-abonnementen en GlobalGPT zijn verschillende opties
De consumentenabonnementen van Claude werken met een abonnementsmodel: het gratis abonnement is $0, het Pro-abonnement is $20 per maand of $200 bij jaarlijkse facturering, en het Max-abonnement begint bij $100 per maand, exclusief toepasselijke belastingen. Het app-gebruik is onderworpen aan limieten per abonnement. Anthropic vermeldt ook $100 of $200 aan maandelijkse API-tegoed voor de bijbehorende Max-niveaus; de Free- en Pro-abonnementen bevatten geen maandelijkse API-tegoed. Vergelijk de app-toegang en API-limieten afzonderlijk bij het kiezen van een abonnement. Een platform voor meerdere modellen is geschikt voor mensen die in hun werk regelmatig tussen modelfamilies en mediatypen schakelen.
Als je vandaag onder andere een landingspagina moet schrijven, code moet controleren en afbeeldingen voor een campagne moet maken, GlobalGPT brengt al die tools samen. Het voordeel is de breedte van de workflow binnen één abonnement, in plaats van dat je voor verschillende afzonderlijke producten moet betalen om één project af te ronden. Kies het abonnement dat aansluit bij het werk dat je daadwerkelijk doet.
Benchmarks: bij sommige taken bijna net zo goed als Opus, maar niet bij alle taken
De resultaten van de lancering laten zien dat er een aanzienlijke stap vooruit is gezet ten opzichte van Sonnet 5. Ze laten ook zien waarom één topscore niet voldoende is om een modelkeuze te bepalen. Sonnet 5.5 komt als beste uit de bus in de gerapporteerde Terminal-Bench-vergelijking, terwijl Opus 5.5 nog steeds aan kop gaat op FrontierCode en CursorBench. De vrijwel gelijke beoordelingen op het gebied van kenniswerk zijn veelbelovend, maar maken de modellen nog niet onderling uitwisselbaar.
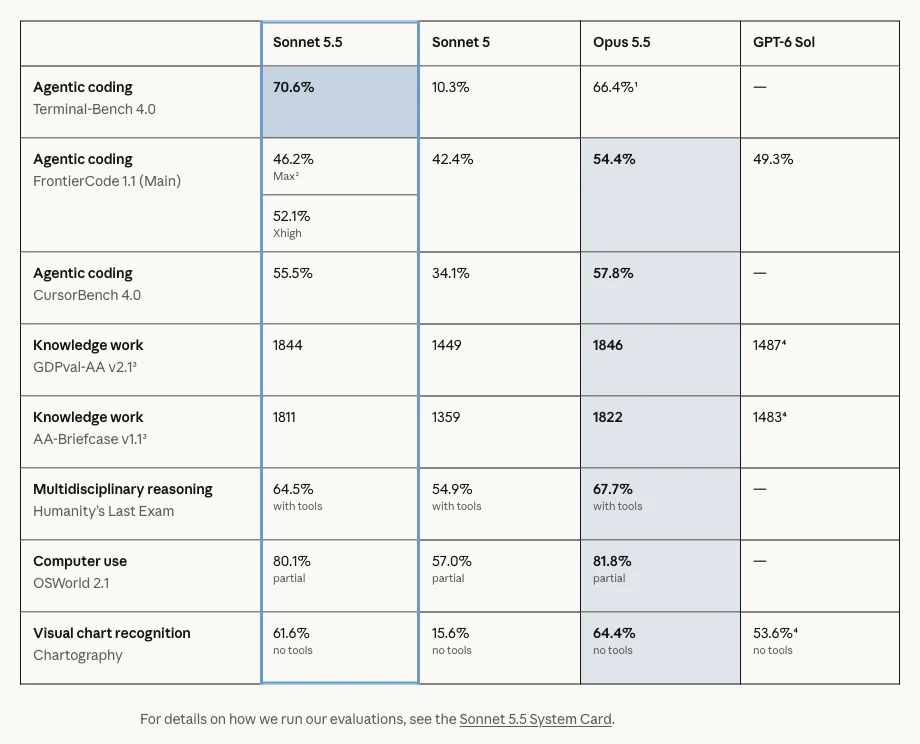
Benchmarks: bij sommige taken bijna net zo goed als Opus, maar niet bij alle taken
| Evaluatie in de lanceringstabel van Anthropic | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66,41 TP40T (Xhigh) | - |
| FrontierCode 1.1 Hoofdpagina | 52,11 TP40T (Xhigh); 46,21 TP40T (Max) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | - |
| GDPval-AA v2.1 | 1844 Elo | 1449 Elo | 1846 Elo | 1487 |
| AA-Aktetas v1.1 | 1811 Elo | 1359 Elo | 1822 Elo | 1483 |
| Het laatste examen van de mensheid | 64.5% met gereedschap | 54.9% inclusief gereedschap | 67,71 TP40T inclusief gereedschap | - |
| OSWorld 2.1 | 80.1% gedeeltelijk | 57.0% gedeeltelijk | 81,81 TP40T gedeeltelijk | - |
| Kartografie | 61,61 TP40T zonder gereedschap | 15,61 TP40T zonder gereedschap | 64,41 TP40T zonder gereedschap | 53,61 TP40T zonder gereedschap |
Dit zijn gepubliceerde benchmarkresultaten, los van onze GlobalGPT-tests. Bij de evaluaties is gebruikgemaakt van verschillende omgevingen en inspanningsniveaus; Elo-ratings geven geen nauwkeurigheid in procenten weer. De GPT-6 Sol-waarden staan vermeld in de gepubliceerde vergelijkingstabel van Anthropic, en een streepje betekent dat de pagina geen waarde voor die evaluatie heeft gerapporteerd. Anthropic merkt ook op dat bij de eerste GDPval-AA- en AA-Briefcase-runs gebruik werd gemaakt van een pre-release-implementatie met een bug in de gestructureerde uitvoer, die later is verholpen. Beschouw de tabel als een momentopname van die evaluaties, niet als een garantie voor uw eigen werklast.
Het resultaat van FrontierCode is bijzonder nuttig: Sonnet scoorde beter bij Xhigh dan bij Max. Anthropic schrijft de daling bij Max toe aan extra beoordelingsrondes, time-outs en wijzigingen buiten de gevraagde reikwijdte. Meer nadenken kan meer werk opleveren zonder dat dit tot een beter antwoord leidt. Begin met een duidelijke opdracht en voer de inspanning op als je daar een specifieke reden voor hebt.
Onafhankelijke resultaten bieden meer context. Artificial Analysis rapporteerde een Intelligentie-indexscore van 56 bij de Max/standaard-fallback-configuratie, in combinatie met een ongewoon intensief gebruik van output-tokens. A Beoordeling van de CodeRabbit-reviewpijplijn 6 van de 13 moeilijke signaalgevallen werden door Sonnet 5.5 gedetecteerd, tegenover 4 van de 13 door Sonnet 5, met een lagere gemiddelde uitvoeringstijd. Dit is een kleinschalig onderzoek van één leverancier, geen bewijs dat elke codereview hierdoor zal verbeteren, maar het is een nuttig voorbeeld van het evalueren van een volledige taak in plaats van alleen een score.
Hoe snel is de Claude Sonnet 5.5?
Anthropic genereert resultaten meer dan 30% sneller dan Sonnet 5. Het genereren van resultaten is slechts één onderdeel van het wachten op een antwoord: ook de verwerking van invoer, het redeneringsproces, de netwerktijd en de belasting van de dienst spelen een rol. Een model kan snel beginnen met schrijven zodra het van start gaat, maar toch nog tijd besteden aan het verwerken van gegevens voordat het definitieve antwoord wordt gegeven.
Onze drie herhalingen van dezelfde opdracht voor een klant-e-mail zijn voltooid in 11,60, 12,16 en 11,78 seconden, met een mediaan van 11,78 seconden. De codetaak duurde 19,08 seconden en de documenttaak 16,42 seconden. We hebben de volledige responstijd gemeten, inclusief service- en netwerkoverhead. We hebben de latentie van het eerste token niet gemeten en ook geen Sonnet 5-controle uitgevoerd, dus deze tijden leveren geen bewijs voor een 30%-verbetering.
Voor dagelijks gebruik is dit model dus zeker het proberen waard bij werkzaamheden die je in korte cycli bijwerkt. Vraag eerst om het eindresultaat, houd de omvang beperkt en vraag niet om een uitgebreide uitleg als je alleen een gecorrigeerde functie of een kort antwoord nodig hebt. Wanneer er instellingen voor de inspanningsgraad beschikbaar zijn, bekijk dan eerst de lagere instellingen voordat je standaard voor ‘Max’ kiest.
Prestaties in de praktijk: drie GlobalGPT-tests
We hebben praktische opdrachten gebruikt waarvan we de antwoorden konden controleren. Alle verzoeken maakten gebruik van Claude Sonnet 5.5 met hetzelfde maximum van 6.000 tokens voor de uitvoer en zonder externe tools. We lieten de instellingen voor steekproeven en redenering op de standaardwaarden van de dienst staan. We hebben voor elke taak de eerste voltooide uitvoer behouden; de twee extra schrijfpogingen dienen als een afzonderlijke consistentiecontrole. Alle vijf verzoeken werden zonder herhalingspoging voltooid.
Schrijven: een antwoord aan een klant waarin de beloften goed in de gaten worden gehouden
In de opdracht werd gevraagd om een e-mail van 90–120 woorden aan Maya over een vertraagde levering van een blauwe lamp, met precies drie opsommingstekens, een inleverdeadline op 4 oktober en de mogelijkheid om met “refund” te antwoorden voor een volledige terugbetaling via de oorspronkelijke betaalmethode. Het was uitdrukkelijk verboden om een verzonnen reden, een leveringsgarantie, korting of een belofte van onmiddellijke terugbetaling te vermelden.
Het eerste antwoord bestond uit 110 woorden met precies drie opsommingstekens, en liet de verzenddeadline en de terugbetalingsvoorwaarden ongewijzigd. Er werd geen leveringsdatum, reden voor vertraging of extra voordeel verzonnen. Er werd echter wel “u hoeft niet te reageren” toegevoegd voor klanten die de bestelling behouden – een procesdetail dat niet in de opdrachtomschrijving stond. Dat maakt het een bruikbaar concept, maar het voldoet niet volledig aan de strikte eis dat het uitsluitend op feiten gebaseerd moet zijn.
De herhalingen bestonden uit 101 en 97 woorden en voldeden ook aan de opmaakregels, maar in beide gevallen werd dezelfde aanname – dat er geen actie nodig was – herhaald. In het derde antwoord werden bovendien twee opsommingstekens gebruikt voor in wezen dezelfde optie: “de bestelling behouden en afwachten”. Controleer de operationele details en verwijder overbodige informatie voordat je een antwoord naar de klant verstuurt.
Schrijftest: indeling goedgekeurd, één aanname met betrekking tot het proces
Eerste antwoord: 110 woorden, 3 opsommingstekens, 11,60 seconden. De verzend- en terugbetalingsvoorwaarden waren correct. De instructie om de bestelling te behouden zonder te reageren stond niet in de opdrachtomschrijving en moet worden bevestigd. Herhalingen: 101 en 97 woorden; in beide gevallen werd die aanname herhaald.
Claude Sonnet 5,5 · GlobalGPT · 1 oktober 2026 · maximum van 6.000 tokens · geen hulpmiddelen · steekproeven en inspanning blijven op de standaardinstellingen van de dienst. Met ‘tijd’ wordt een volledig antwoord bedoeld, niet het eerste token.
Taakinstructie
Schrijf een Engelstalige klantenservice-e-mail aan Maya over bestelling R-418, een blauwe lamp waarvan de verzending vertraging heeft opgelopen. De volledige e-mail moet 90–120 woorden bevatten (inclusief) en precies drie opsommingstekens bevatten. Bied je excuses aan, leg de volgende stap duidelijk uit en gebruik uitsluitend de volgende feiten: de lamp wordt uiterlijk 4 oktober verzonden; als alternatief kan Maya “refund” antwoorden om een volledige terugbetaling via de oorspronkelijke betaalmethode aan te vragen. Beloof geen leverings- of aankomstdatum, geen onmiddellijke terugbetaling, geen korting, geen compensatie of enig ander voordeel dat niet is toegezegd. Verzin geen reden voor de vertraging. De deadline geldt voor de verzending, niet voor de levering. Voeg een begroeting en afsluiting toe. Stuur alleen de e-mail terug. Voor deze opdracht geldt dat een woord een door witruimte gescheiden teken is, met uitzondering van een op zichzelf staand opsommingsteken.
Volledige eerste uitvoer
Onderwerp: Update over je bestelling R-418

Hallo Maya,

Het spijt me dat de verzending van je blauwe lamp, bestelling R-418, vertraging heeft opgelopen. Ik begrijp dat dit frustrerend is en bied mijn excuses aan voor het ongemak.

Dit is de huidige stand van zaken en wat je nu kunt doen:

- Je lamp wordt uiterlijk 4 oktober verzonden.
- Als je je bestelling wilt behouden, hoef je niet te reageren.
- Als je liever niet wilt wachten, beantwoord deze e-mail dan met "terugbetaling", dan zorgen wij voor een volledige terugbetaling via je oorspronkelijke betaalmethode.

Bedankt voor je geduld en begrip. Reageer gerust als je vragen hebt over je bestelling.

Met vriendelijke groet,
Het klantenserviceteam
Schrijven herhalen 2 · volledige uitvoer
Beste Maya,

Het spijt me dat de verzending van je bestelling R-418, de blauwe lamp, vertraging heeft opgelopen. Ik begrijp dat dit frustrerend is en bied mijn excuses aan voor het ongemak.

Dit is wat er nu gaat gebeuren:

- Je blauwe lamp wordt uiterlijk 4 oktober verzonden.
- Als je wilt wachten, hoef je niets te doen.
- Als je liever niet wilt wachten, beantwoord deze e-mail dan met "terugbetaling" om een volledige terugbetaling via je oorspronkelijke betaalmethode aan te vragen.

Houd er rekening mee dat 4 oktober onze uiterste verzenddatum is, niet de leverdatum.

Bedankt voor je geduld en begrip.

Met vriendelijke groet,
Het klantenserviceteam
Schrijven herhalen 3 · volledige uitvoer
Onderwerp: Update over uw bestelling R-418

Hallo Maya,

Het spijt me dat de verzending van je blauwe lamp, bestelling R-418, vertraging heeft opgelopen. Mijn excuses voor het ongemak en bedankt voor je geduld.

Dit zijn je opties:

- Wachten op verzending: je lamp wordt uiterlijk 4 oktober verzonden.
- Een terugbetaling aanvragen: antwoord met het woord "terugbetaling" en wij zullen een volledige terugbetaling verwerken via je oorspronkelijke betaalmethode.
- De bestelling behouden: als je graag wilt wachten, hoef je verder niets te doen.

Houd er rekening mee dat 4 oktober onze uiterste verzenddatum is, niet de leverdatum.

Met vriendelijke groet,
Het klantenserviceteam
Uw lamp wordt uiterlijk op 4 oktober verzonden. … Als u liever niet wilt wachten, beantwoord deze e-mail dan met het woord “terugbetaling”, dan zorgen wij ervoor dat het volledige bedrag wordt teruggestort via de oorspronkelijke betaalmethode.
Fragment uit de eerste GlobalGPT-schrijftoets; een tussengevoegd opsommingsteken is weggelaten.
Dit is een handig stappenplan voor communicatie met klanten en zakelijke correspondentie: geef de vaststaande feiten weer, bepaal de toon en geef aan welke beloften niet mogen worden gedaan. Sonnet kan je vervolgens helpen bij de formulering, zonder dat je het bedrijf vraagt om jouw beleid te bedenken.
Programmeren: corrigeer de afrondingslogica en controleer vervolgens de totalen
Onze foutieve Python-functie verdeelde het geld met behulp van drijvende-kommagetallen en rondde elk aandeel afzonderlijk af. Daardoor kunnen er centen bij komen of verloren gaan. We hebben Sonnet gevraagd om deze functie te vervangen door een op Decimal gebaseerde toewijzing volgens het ‘grootste restgetal’-principe, het totaal te behouden, bij gelijke standen de oorspronkelijke index als doorslag te laten gelden en ongeldige invoer te weigeren.
De eerste teruggegeven functie werd doorgegeven 43 van de 43 controles, waarbij rekening werd gehouden met nulbedragen, gebroken gewichten, deterministische gelijke standen, onjuist ingevoerde waarden, grote getallen en precisiegrenzen. Het programma analyseerde decimale tekenreeksen, zette deze om in exacte gehele getallen en wees de resterende centen in een vaste volgorde toe. Het nuttige resultaat was niet alleen code die er aannemelijk uitzag: de aandelen klopten ook daadwerkelijk.
Dat pleit ervoor om Sonnet te gebruiken voor een gerichte implementatie met expliciete acceptatiecriteria. Dit was een op zichzelf staande functietest, geen zelfstandige reparatie van de repository of een beveiligingsaudit. Voeg voor productiecode je eigen integratietests toe en controleer de foutafhandeling in de omringende applicatie.
Programmeertest: 43 controles geslaagd
Eerste antwoord: 19,08 seconden. Voldaan aan alle 43 controles voor correcte toewijzing, stabiele koppelingen, invoervalidatie en nauwkeurigheid. Beoordeeld als een op zichzelf staande functie, niet als een autonome reparatie van de repository.
Claude Sonnet 5,5 · GlobalGPT · 1 oktober 2026 · maximum van 6.000 tokens · geen hulpmiddelen · steekproeven en inspanning blijven op de standaardinstellingen van de dienst. Met ‘tijd’ wordt een volledig antwoord bedoeld, niet het eerste token.
Taakinstructie
Vervang de onderstaande foutieve Python-functie door een correcte implementatie van `allocate_cents(total: str, weights: list[str]) -> list[int]`. Geef alleen uitvoerbare Python-broncode terug, zonder Markdown-omkaderingen of uitleg.

Vereisten:
1. total is een niet-negatief, eindig bedrag in USD, geschreven als een tekenreeks, met nul, één of twee decimalen, zoals "0", "12.3" of "12.34". Gebruik ASCII-decimale cijfers met een optioneel enkel decimaalteken. Weiger tekens, exponentiële notatie, witruimte, NaN/Infinity, een lege tekenreeks, een decimaalteken aan het einde, een decimaalteken aan het begin en meer dan twee decimalen, inclusief "1.000". Voorloopnullen zijn toegestaan. Weiger invoer die geen tekenreeks is met een ValueError.
2. weights is een niet-lege lijst met tekenreeksen. Elke tekenreeks bestaat uit ASCII-decimale cijfers, optioneel met een decimaalteken en één of meer cijfers erachter. Vereis eindige, niet-negatieve waarden met ten minste één strikt positief gewicht. Weiger ongeldige tekenreeksen, tekens, exponentnotatie, witruimte, niet-tekenreeksinvoer of een invoer van gewichten die geen lijst is met een ValueError. Voorloopnullen zijn toegestaan.
3. Gebruik Decimal om de opgegeven decimale bedragen exact te parseren en te behouden. Zet dollars om naar gehele centen. Wijs gehele centen toe in verhouding tot de gewichten, met behulp van de ‘grootste-rest’-methode: neem de vloer van elk exact quotum en wijs vervolgens de resterende centen toe aan de grootste fractionele resten. Beslis bij gelijke uitkomsten op basis van de laagste oorspronkelijke index. De geretourneerde lijst moet de invoervolgorde behouden en precies op het totale aantal centen uitkomen.
4. Verlies niet stilzwijgend precisie bij lange geldige waarden of zeer ongelijke gewichten. Wijzig de gewichten niet. Importeer alleen uit `decimal` of `math` indien imports nodig zijn. Geen bestands-, netwerk-, omgevings-, proces- of invoer-/uitvoerbewerkingen.

Foutieve implementatie:
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    cents = round(float(total) * 100)
    values = [float(w) for w in weights]
    return [round(cents * w / sum(values)) for w in values]
Volledige eerste uitvoer
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    from decimal import Decimal

 DIGITS = frozenset("0123456789")

    def valid(s, max_frac):
 if not isinstance(s, str) or not s:
 return False
 parts = s.split(".")
 if len(parts) > 2:
            return False
 if not parts[0] or not all(c in DIGITS for c in parts[0]):
 return False
 if len(parts) == 2:
 frac = parts[1]
 if not frac or not all(c in DIGITS for c in frac):
                return False
 if max_frac is not None and len(frac) > max_frac:
 return False
 return True

 def digits_to_int(digs):
 s = "".join(map(str, digs))
 value = 0
        step = 1000
 for i in range(0, len(s), step):
 chunk = s[i:i + step]
 value = value * (10 ** len(chunk)) + int(chunk)
        return value

 def to_scaled(s):
 # retourneert (geheel getal mantisse, exponent) waarbij value = mantisse * 10**exponent
 d = Decimal(s)
 sign, digs, exp = d.as_tuple()
        return digits_to_int(digs), exp

 if not valid(total, 2):
 raise ValueError("ongeldig totaal")
    if not isinstance(weights, list) or len(weights) == 0:
 raise ValueError("ongeldige gewichten")
    for w in weights:
 if not valid(w, None):
 raise ValueError("ongeldig gewicht")

 mant, exp = to_scaled(total)
    if exp >= -2:
 cents = mant * 10 ** (exp + 2)
    anders:
 cents = mant // 10 ** (-exp - 2)  # onbereikbaar voor gevalideerde invoer

 parsed = [to_scaled(w) for w in weights]
    min_exp = min(e for _, e in parsed)
    ints = [m * 10 ** (e - min_exp) for m, e in parsed]
    W = sum(ints)
    if W <= 0:
        raise ValueError("ten minste één gewicht moet positief zijn")

 result = []
    rems = []
    for i, w in enumerate(ints):
 q, r = divmod(cents * w, W)
 result.append(q)
        rems.append((-r, i))

 remaining = cents - sum(result)
    rems.sort()
    for k in range(remaining):
 result[rems[k][1]] += 1
    return result
Documenten: de juiste documenten vinden na correcties en het verwijderen van dubbele exemplaren
De derde opdracht betrof een samengesteld factuurpakket van 13.078 woorden: 120 basisrecords, acht correcties en vier archiefkopieën. Sonnet moest uitsluitend goedgekeurde Atlas-facturen selecteren met een datum in september 2026, de hoogste versie van elk record gebruiken en strikt JSON terugsturen met het totaalbedrag en drie zinvolle vervolgcontroles.
Het selecteerde alles 16 correcte factuurnummers, gaf het exacte resultaat weer $15,305.66 in zijn geheel, en hield zich aan de JSON-structuur. De daaropvolgende stappen hadden betrekking op de afstemming van het grootboek, ondersteunende documenten voor correcties en controles op dubbele of afgeknotte facturen. Een oude archiefkopie werd niet als een nieuwe factuur geteld.
Dit is het soort detail dat er bij het werken met documenten toe doet: de nieuwste correctie moet prevaleren, zelfs als er later in het pakket een oudere versie opduikt. Het resultaat is veelbelovend voor het extraheren van begrensde documentfragmenten. Het gaat hier echter nog steeds om één synthetische oefening, die veel kleiner is dan het aangekondigde contextvenster van één miljoen tokens; voor belangrijk financieel werk is een onafhankelijke berekening nodig.
Documentcontrole: 16 records, exact totaal
Eerste antwoord: 16,42 seconden. Alle 16 factuurnummers en het totaalbedrag van $15.305,66 kwamen overeen met de onafhankelijke referentie; de strikte JSON-controle en de drie vervolgcontroles waren eveneens correct.
Claude Sonnet 5,5 · GlobalGPT · 1 oktober 2026 · maximum van 6.000 tokens · geen hulpmiddelen · steekproeven en inspanning blijven op de standaardinstellingen van de dienst. Met ‘tijd’ wordt een volledig antwoord bedoeld, niet het eerste token.
Het meegeleverde synthetische pakket bevatte 120 basisrecords, acht correcties en vier archiefkopieën (13.078 woorden). De velden waren ID, versie, project, datum, status, bedrag en toelichtingen. De onderstaande instructie is volledig; het uitgebreide bronpakket wordt hier samengevat.
Taakinstructie
Controleer de onderstaande synthetische projectfactuurrecords. Gebruik voor elk ID alleen de hoogste versie; identieke dubbele records leiden niet tot extra facturen. De hoogste versie kan vóór een oudere archiefkopie staan. Selecteer alleen records waarvan het eindproject "Atlas" is, de eindstatus "goedgekeurd" is en de einddatum in september 2026 valt. Bedragen zijn in USD. Lever strikte JSON terug met precies deze sleutels: "ids" (unieke geselecteerde ID's in oplopende volgorde), "total_usd" (een tekenreeks met precies twee decimalen) en "action_items" (precies drie beknopte tekenreeksen die zinvolle volgende boekhoudkundige controles aangeven). Voeg geen Markdown-omkaderingen of verklarende tekst toe. Negeer beschrijvende opmerkingen bij het filteren; alle boekhoudvelden zijn gestructureerd. Tel geen records uit andere maanden, conceptrecords, Orion-records, oude versies of herhaalde kopieën mee.
Volledige eerste uitvoer
{"ids":["INV-003","INV-008","INV-020","INV-032","INV-038","INV-044","INV-050","INV-056","INV-062","INV-068","INV-074","INV-086","INV-092","INV-098","INV-104","INV-116"],"total_usd":"15305,66","action_items":["Breng de 16 geselecteerde facturen en het totaalbedrag van 15.305,66 USD in overeenstemming met het grootboek en het subgrootboek voor crediteuren van Atlas van september 2026.","Controleer de door correcties gewijzigde posten (INV-003, INV-008, INV-020, INV-050, plus de uitgesloten INV-002, INV-014 en INV-026) op goedkeuringsbewijs en ondersteunende documenten.","Controleer of dubbele archiefkopieën niet als afzonderlijke facturen zijn geboekt, en controleer op problemen met betrekking tot periodetoerekening of afsluiting bij gecorrigeerde facturen die rond het einde van de maand zijn gedateerd."]}Sonnet 5.5 versus Opus 5.5: welke moet je kiezen?
Kies op basis van de aard van de opdracht. Sonnet is een verstandige eerste keuze wanneer de instructies en het einddoel duidelijk zijn. Opus is het betere uitgangspunt wanneer de opdracht voortdurend beoordelingsvermogen vereist, het blootleggen van ontbrekende aannames of het coördineren van een lange reeks beslissingen. Lees onze Claude Opus 5.5 recensie om dat model eens van dichtbij te bekijken.
Sonnet 5.5 versus Opus 5.5: welke moet je kiezen?
| Jouw opdracht | Aanbevolen startpunt | Waarom |
|---|---|---|
| Een korte tekst herschrijven, een concepttekst voor klanten opstellen, gegevens opvragen | Sonnet 5.5 | Duidelijke beperkingen maken het gemakkelijker om de kwaliteit te controleren. |
| Een bug in een bepaalde context verhelpen of een opgegeven functie implementeren | Sonnet 5.5 | Sterke taakuitvoering bij een lager aantal input- en output-tokens. |
| De architectuur vaststellen op basis van onvolledige vereisten | Opus 5.5 | Het moeilijkste is om een consistent oordeel te vellen, niet alleen de uitvoering. |
| Maak een campagne af met tekst, afbeeldingen en video | GlobalGPT-workflow voor meerdere modellen | Gebruik Sonnet voor de beknopte en gespecialiseerde modellen voor de activa. |
Een handige werkwijze is om een krachtiger redeneringsmodel te vragen een moeilijk plan te beoordelen, en vervolgens de overeengekomen specificatie en concrete controles aan Sonnet door te geven. De keuze van het model kan per fase verschillen. Je hoeft niet van elke kleine aanpassing meteen je duurste redeneringstaak te maken.
Zet Sonnet 5.5 aan het werk op GlobalGPT
Dankzij GlobalGPT is het model bruikbaar als onderdeel van een bredere werkomgeving. Open Claude Sonnet 5.5 voor de schrijf- of analysestap en schakel vervolgens over naar een ander model wanneer het project een andere aanpak vereist. Je kunt een campagnebriefing opstellen, de teksten bijschaven, beeldmateriaal ontwerpen en video’s produceren zonder dat je de workflow voor verschillende abonnementen opnieuw hoeft op te zetten.
Voor een beter eerste resultaat kunt u het bronmateriaal samen met een aantal acceptatieregels opsturen. Geef bij teksten de doelgroep, de lengte, de toon en de feiten aan die ongewijzigd moeten blijven. Geef bij code het voorbeeld dat niet werkt en het verwachte gedrag. Geef bij documenten de bronsecties aan en vermeld hoe er met conflicterende versies moet worden omgegaan. Deze opdrachten voor schrijven, onderzoek en programmeren je herbruikbare uitgangspunten bieden.
Ontwikkelaars kunnen hun terminalworkflow ook koppelen via GlobalGPT CLI met Claude-code. Maak gebruik van de website voor het bredere project en de CLI waar dat in het ontwikkelingsproces van pas komt. De meerwaarde ligt in een samenhangend geheel van hulpmiddelen, waarbij de keuze voor een model wordt bepaald door de volgende taak.
Beperkingen en belangrijke informatie over upgrades
Grote inzet is een keuze, geen garantie voor kwaliteit. Sonnet kan zich te veel verdiepen in een specifiek probleem of verder gaan dan de gevraagde wijzigingen. Vraag het om binnen de scope te blijven, de relevante controles uit te voeren en te stoppen zodra aan de acceptatiecriteria is voldaan. Als het product middelenbeheer ondersteunt, vergelijk dan de kwaliteit en kosten van voltooide taken voordat je deze verhoogt.
Ook voor actuele feiten zijn actuele bronnen nodig. De kennisupdate van het model van juni 2026 omvat niet de actuele informatie over elke prijs, elk beleid of elke publicatie. Raadpleeg het actuele document of maak gebruik van een workflow met zoekfuncties. Controleer voor gevoelige informatie de privacy- en bewaartermijnen van de dienst en het account die u daadwerkelijk gebruikt; de naam van het model is niet bepalend voor deze instellingen.
Bij API-migraties is meer nodig dan alleen het vervangen van de modelnaam. Sonnet 5.5 brengt wijzigingen aan in enkele oudere verzoekpatronen. De directe Claude-API wijst niet-standaard instellingen voor temperatuur, top_p en top_k af, en verouderde denkwijzen of configuraties met gedwongen toolgebruik moeten mogelijk worden bijgewerkt. Adaptief denken is de standaardinstelling; de gedocumenteerde between_tools-modus elimineert voorafgaand denken bij een inspanningsniveau van ‘High’ of lager. Het huidige overzicht vermeldt ook dat het geforceerde gebruik van tools een foutmelding oplevert, dat oudere computergebaseerde tools niet worden geaccepteerd op de Claude-API en Google Cloud, en dat tekst tussen toolaanroepen in denkblokken kan worden weergegeven. Bekijk de officiële migratiegids voordat je een applicatie verplaatst. Onze Claude API-handleiding behandelt de algemene opzet en factureringsconcepten.
Anthropic past ook veiligheidsmaatregelen toe op verzoeken op het gebied van cyberbeveiliging en biologie die een hoger risico inhouden. Routinematige softwareontwikkeling blijft deel uitmaken van het beoogde gebruik van het model. Als een taak legitiem maar gevoelig is, beschrijf dan duidelijk de reikwijdte en de toegangsrechten, in plaats van ervan uit te gaan dat elke weigering een algemene beperking op het gebied van programmeren is.
Eindoordeel: een goed model om in je dagelijkse werkwijze op te nemen
Sonnet 5.5 verdient zijn plaats door praktisch, controleerbaar werk. De belangrijkste redenen om het te gebruiken zijn de mogelijkheden voor scoped coding en de handige documentverwerking tegen een lagere API-tokenprijs dan bij Opus. Ook voor het schrijven is het een goede toepassing, met een laatste controle op plausibele details die nooit in de opdrachtomschrijving stonden. Onze kleine testset ondersteunt die positionering voor dagelijks gebruik; het levert geen universele overwinning op het gebied van snelheid, kosten of complexe redeneringen.
Begin met een concrete taak waarvan je het resultaat kunt beoordelen. Maak de beperkingen duidelijk, controleer de belangrijke details en stap over op een ander model wanneer het probleem verandert. Probeer Sonnet 5.5 op GlobalGPT om schrijven, programmeren, analyse en de volgende creatieve stap te integreren in één multimodale workflow.
Veelgestelde vragen
Wat is Claude Sonnet 5.5?
Claude Sonnet 5.5 is een Anthropic-model dat op 28 september 2026 is uitgebracht. Het ondersteunt tekst- en afbeeldingsinvoer met tekstuitvoer en is ontworpen voor snel coderen, schrijven, documentverwerking en tool-ondersteunde workflows in het dagelijks gebruik.
Hoeveel kost de Claude Sonnet 5.5?
De standaard API-prijs van Anthropic bedraagt $2 per miljoen invoertokens en $10 per miljoen uitvoertokens. Cache-lezingen kosten $0,10 per miljoen tokens. Claude-app-abonnementen en GlobalGPT-abonnementen vallen buiten deze API-tarieven.
Is Claude Sonnet 5,5 sneller dan Sonnet 5?
De Anthropic genereert resultaten meer dan 30% sneller dan de Sonnet 5. In onze GlobalGPT-schrijftest duurde het 11,60–12,16 seconden om drie volledige antwoorden te genereren. We hebben de Sonnet 5 niet als controlegroep gebruikt, dus onze test meet geen snelheidsverbetering tussen de verschillende generaties.
Is Sonnet 5.5 beter dan Opus 5.5?
Kies Sonnet 5.5 voor duidelijk omschreven taken en een lagere prijs per input-/outputtoken. Opus 5.5 is het betere uitgangspunt voor complexe, open taken waarbij voortdurend beoordelingsvermogen vereist is. Sonnet komt in sommige gepubliceerde evaluaties als beste uit de bus, maar er is geen eenduidige winnaar.
Kan Claude Sonnet 5.5 lange documenten verwerken?
De Claude API specificeert een contextvenster van één miljoen tokens. In onze kleinere test met een synthetisch document van 13.078 woorden selecteerde Sonnet alle 16 in aanmerking komende records en berekende het de juiste totaalwaarde. Dat resultaat betekent echter niet dat de nauwkeurigheid over het volledige opgegeven contextvenster gegarandeerd is.
Kan ik Claude Sonnet 5.5 gebruiken op GlobalGPT?
Ja. GlobalGPT biedt naast andere AI-modellen ook Claude Sonnet 5.5, zodat je op één platform documenten kunt opstellen, coderen en analyseren, en vervolgens verder kunt gaan met beeld- of videowerk.
Bronnen en aantekeningen bij de proeven
De specificaties en prijzen bij de lancering zijn op 13 oktober 2026 gecontroleerd; de onderstaande praktijktests zijn op 1 oktober 2026 uitgevoerd. Belangrijkste bronnen: Aankondiging van de lancering van Anthropic, Sonnet 5.5 modelreferentie, API-prijzen, en Claude abonnementsprijzen. De onafhankelijke context is afkomstig uit „Artificial Analysis“ en het hierboven gelinkte onderzoek van CodeRabbit.
Bij de GlobalGPT-tests werd het eerste voltooide antwoord op drie opdrachten gebruikt, plus twee herhalingen van de schrijfopdrachten. Er werden geen externe hulpmiddelen ingeschakeld. De tijdsmetingen hebben betrekking op volledige antwoorden, inclusief netwerk- en service-overhead; er werd geen waarde voor de redeneringsinspanning geselecteerd. Het factuurpakket was synthetisch en bevatte geen klantgegevens. De afbeelding van de koptekst is speciaal voor deze beoordeling gegenereerd; de overige afbeeldingen zijn schermafbeeldingen van de genoemde websites.









