Claude Fable 5.1 is het nieuwe, algemeen beschikbare model van Anthropic voor programmeren, kenniswerk, het oplossen van langdurige problemen en wetenschappelijk onderzoek. Het werd op 1 september 2026 uitgebracht. De belangrijkste wijziging is niet een hogere API-catalogusprijs: de input blijft $10 per miljoen tokens en de output blijft $50. In plaats daarvan heeft Anthropic de prijs voor cache-leesbewerkingen verlaagd naar $0,25 per miljoen tokens en worden lagere kosten verwacht voor workloads die veel context hergebruiken.
Dat maakt Fable 5.1 zeker het overwegen waard wanneer je werk afhankelijk is van lange documenten, terugkerende context of zorgvuldig afgebakende analyses. Het zorgt er niet voor dat alle toegangsroutes identiek zijn, en het verandert een benchmark van een leverancier niet in een onafhankelijk oordeel. De relevante vraag is eenvoudiger: biedt de route die u van plan bent te gebruiken de context, de controlemogelijkheden, de privacyvoorwaarden en het modelgedrag die uw workflow nodig heeft?
Voor teams die verschillende modelfamilies op één plek met elkaar vergelijken, De multi-model-werkruimte van GlobalGPT is een praktische alternatieve optie naast de officiële methode. Het is handig om beschikbare modellen voor dezelfde taak met elkaar te vergelijken; controleer de huidige map en de dekking van het plan voordat je een platform als je Fable 5.1-toegangspad gaat gebruiken.

Wat is Claude Fable 5.1?
Anthropic heeft Fable 5.1 samen met Mythos 5.1 geïntroduceerd. Het bedrijf beschrijft deze als hetzelfde onderliggende model met verschillende beveiligingsmaatregelen en toegangsregels: Fable is algemeen beschikbaar, terwijl Mythos is voorbehouden aan programma’s met vertrouwde toegang op het gebied van cyberbeveiliging en biowetenschappen. Dat onderscheid is van belang. De mogelijkheden van Mythos mogen niet worden opgevat als gewone Fable-toegang.
Anthropic positioneert Fable 5.1 op het gebied van codering, kenniswerk, langdurige probleemoplossing en wetenschappelijk onderzoek. Dit zijn productclaims, geen belofte dat elke API-omgeving dezelfde tools of beperkingen biedt.
Wat deze release belangrijker maakt dan een gewone naamswijziging van een model, is de combinatie van mogelijkheden, inspanningsbeheersing, cache-economie en een duidelijkere implementatiegrenze. Voor een ontwikkelaar kan dat betekenen dat een model gemakkelijker te rechtvaardigen is bij taken in herhaalde contexten. Voor een onderzoeksteam betekent het dat een sterk aan de bron gebonden antwoord wordt gescheiden van een workflow die nog steeds toegang tot tools, menselijke beoordeling en routespecifieke bewaartermijnen vereist.
- Gebruik het voor: codediagnose, documentsynthese, analyse met veel beperkingen en interpretatie van beeld naar tekst.
- Controleer eerst: contextbeperkingen, beschikbaarheid van tools, bewaartermijn van gegevens, regio en toegang tot het abonnement op de door u gekozen route.
- Trek hieruit niet de conclusie dat: dat Mythos Access, een cloudspecifieke specificatie of een officiële benchmark automatisch van toepassing is op je account.
Identiteit in één oogopslag
Waar kun je Claude Fable 5.1 vinden?
Anthropic meldt dat Fable 5.1 beschikbaar is op al zijn platforms en noemt daarbij AWS, Google Cloud en Microsoft Azure. In de API van Anthropic is de model-ID claude-fabel-5-1. Wat de AWS Bedrock-route betreft, maken gedocumenteerde context-, uitvoer-, invoer-, cache- en bewaarteregels deel uit van de AWS-documentatie en mag er niet zomaar van worden uitgegaan dat deze ook voor alle andere routes gelden.
- Anthropic API: Gebruik de gedocumenteerde model-ID en de huidige platformbeperkingen.
- AWS Bedrock: AWS vermeldt voor zijn route een contextvenster van 1 miljoen tokens, een maximale uitvoer van 128K, invoer van tekst en afbeeldingen, en tekstuitvoer.
- Andere cloudroutes: Controleer de regio, het plan, de ondersteuning voor tools en de gegevensverwerking vóór de migratie.
Toegangsroutes: wat is overdraagbaar en wat niet
Beschouw elke specificatie als routespecifiek. Een modelnaam op zich biedt geen garantie voor dezelfde limieten, invoergegevens, hulpmiddelen of gegevensvoorwaarden.
Model-ID:
claude-fabel-5-1Stroombeperkingen, regio's en ondersteunde bedieningselementen.
1M context, 128K uitvoer, tekst-/afbeeldingsinvoer, tekstuitvoer.
Voorwaarden met betrekking tot regio en account.
Exacte model-ID, gestructureerde JSON-uitvoer en PNG-afbeelding als invoer.
Hulpprogramma's voor bestandssystemen en het uitvoeren van agents.
Waarvoor is Fable 5.1 ontworpen?
De officiële invulling is breed, dus het helpt om een onderscheid te maken tussen wat gedocumenteerd is en wat door een kleine praktische controle kan worden vastgesteld. In onze ‘closed-input first-output’-tests via de Anywhere API produceerde Fable 5.1 een minimale JavaScript-oplossing die nulwaarden behield, een tegenstrijdigheid in het budget van een documentenset opspoorde zonder deze op basis van giswerk op te lossen, een observatieresultaat niet-causaal hield en gelabelde waarden uit een PNG-grafiek haalde. Dat zijn nuttige signalen voor taken met beperkte mogelijkheden, geen herhaling van de langlopende agent-benchmarks van Anthropic.
Diezelfde API-route bood geen toegang tot tools voor het bestandssysteem of validatietools. Om die reden hebben we geen claim gelegd op een echt resultaat met een autonome agent.
Overzichtskaart van mogelijkheden: claim, controle, grens
Claude Fable 5.1 Wijzigingen in prijzen en kosten
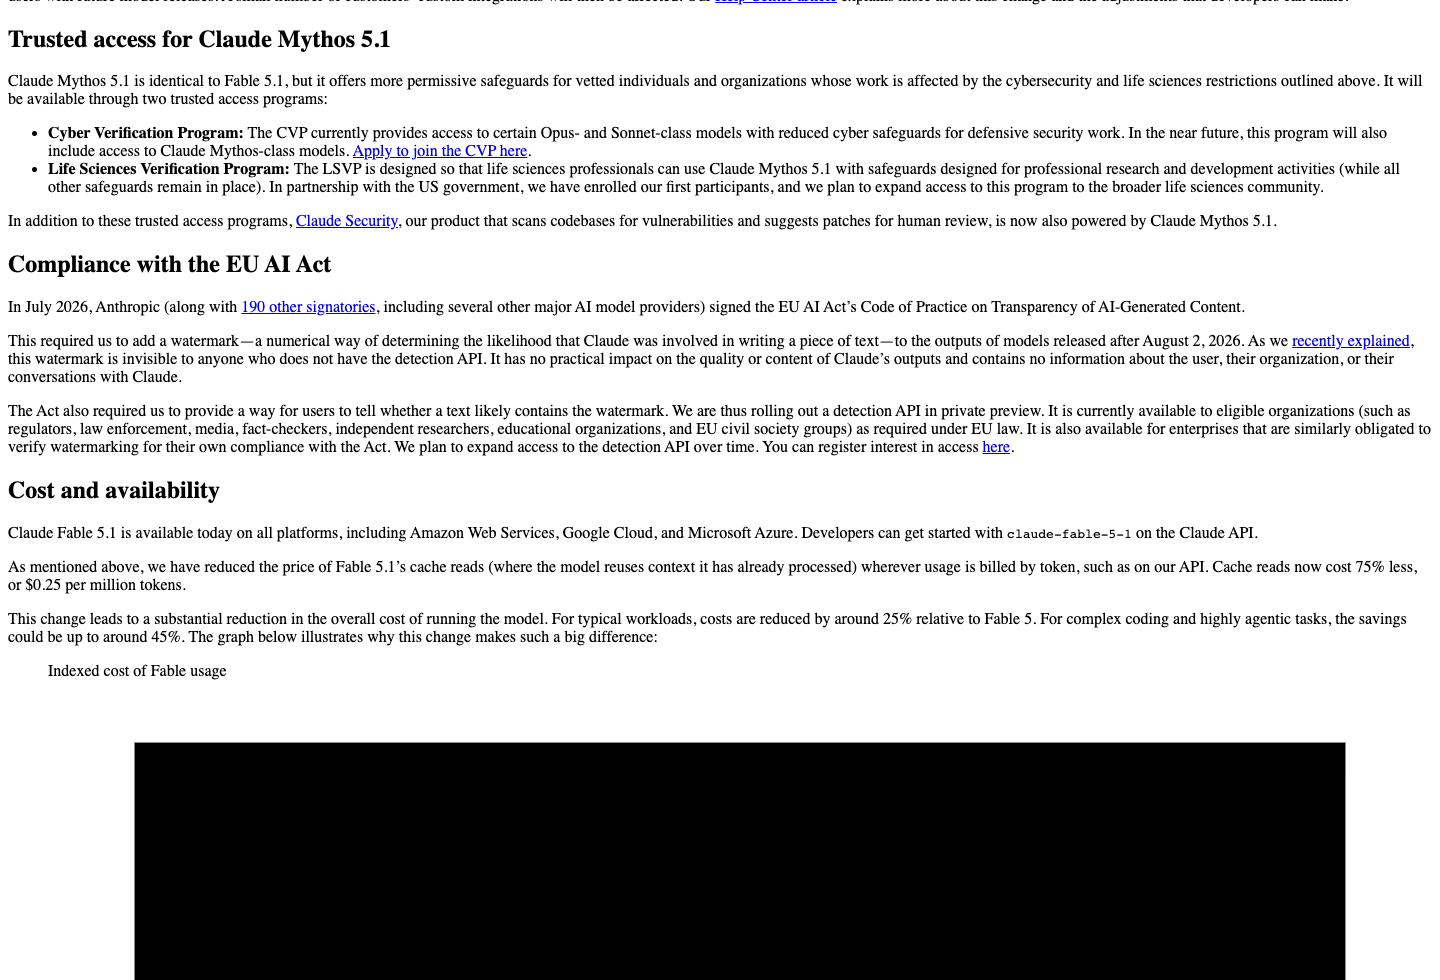
Anthropic vermeldt Fable 5.1 op $10 per miljoen invoertokens en $50 per miljoen uitvoertokens, dezelfde tarieven als bij Fable 5. Cache-lezingen bedragen $0.25 per miljoen tokens. Anthropic schat de kosten voor typische workloads ongeveer 25% lager in en tot ongeveer 45% voor complexe, contextintensieve agentische taken; dit zijn schattingen van Anthropic op basis van de door hen opgegeven aannames voor de workload, geen gegarandeerde korting.
De belangrijkste factor is hergebruik. Een eenmalige prompt profiteert nauwelijks van de tarieven voor cache-lezen, terwijl een workflow die herhaaldelijk een uitgebreide briefing, een samenvatting van de codebase of een beleidspakket verstuurt, daar wel van kan profiteren. Voor de context van de oudere generatie, zie onze Claude Fable 5-prijsgids. Als je een vergelijking maakt tussen afzonderlijke abonnementen in plaats van de facturering op basis van API-tokens, GlobalGPT-plannen een aparte abonnementsoptie voor meerdere modellen aanbieden; het gaat hier niet om een omzetting van de tarieven van de Anthropic-API.
Officiële API-catalogusprijzen
Verschuif de schuifbalk voor het maandelijkse invoervolume. Bij deze schatting wordt ervan uitgegaan dat de output gelijk is aan 20% van de invoer en dat 50% van de invoertokens cache-leesbewerkingen zijn.
10 miljoen invoertokens per maandClaude Fable 5.1 versus Fable 5: is dit een zinvolle upgrade?
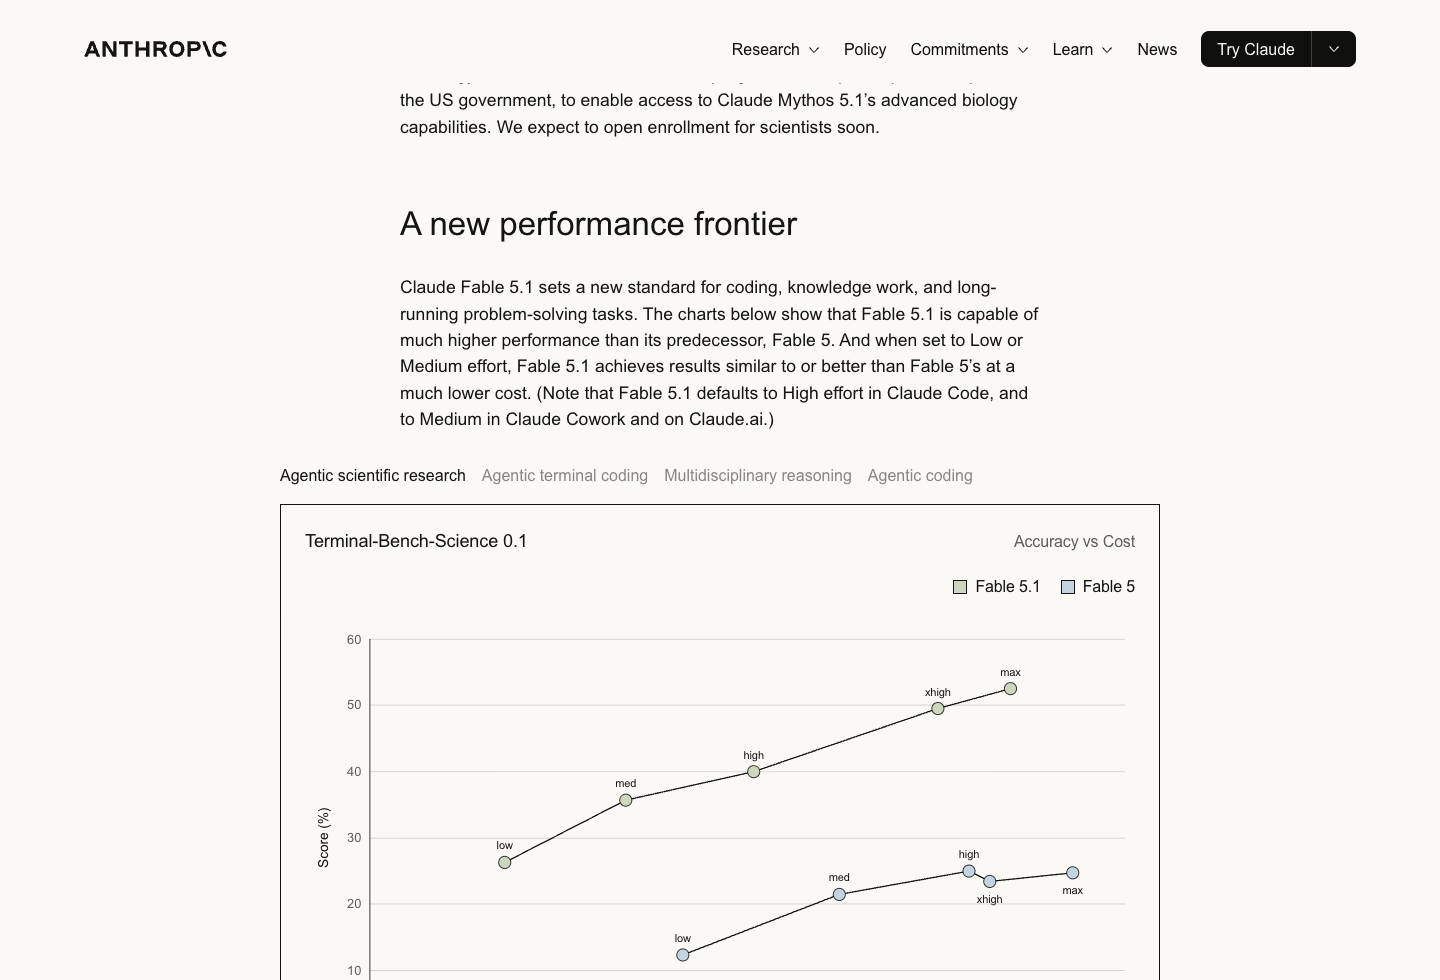
Anthropic scoort hoger dan Fable 5.1 bij verschillende taakspecifieke evaluaties, waaronder 52,6% tegenover 24,7% op Terminal-Bench-Science, 55,81 TP40T tegenover 42,01 TP40T op Terminal-Bench, 31,4% tegenover 17,1% op AutomationBench, en 73,4% tegenover 70,5% op CursorBench. Het GDPval-AA v2-resultaat is 1853 versus 1723. Dit zijn door Anthropic gerapporteerde cijfers met hun eigen testopstellingen en voorwaarden, dus ze dienen eerder als nuttige context dan als een onafhankelijk gereproduceerde algemene ranglijst.
We hebben op dezelfde testlocatie geen directe Fable 5-baseline uitgevoerd. De conclusie over de upgrade is daarom voorlopig: de officiële gegevens wijzen op taakspecifieke verbeteringen en lagere cache-leeskosten, terwijl een onafhankelijke vergelijking tussen Fable 5.1 en Fable 5 nog niet is afgerond.
Als uw keuze verder reikt dan deze ene upgrade, dan is onze Vergelijking tussen Claude Fable 5 en GPT 5.5 is een betere volgende stap dan één benchmarkrij als een universele ranglijst te beschouwen.
Door Anthropic gerapporteerde taakresultaten
Praktijktests: wat we daadwerkelijk hebben getest
We hebben de Anywhere API-route gebruikt /v1/chat/voltooiingen nadat de ID van het geretourneerde model is gecontroleerd claude-fabel-5-1 en een kleine probe met gestructureerde uitvoer. Elk onderstaand resultaat is de eerste geldige uitvoer van een bevroren taak met gesloten invoer. De SVG-invoer werd afgewezen voordat T05 het model bereikte, dus werd dezelfde testopstelling omgezet naar PNG en één keer uitgevoerd; er werd geen geldig resultaat vervangen.
Bewijs van de eerste output
In het antwoord werd uitgelegd waarom de nulwaarden verdwenen waren, werd een minimale wijziging in de code voorgesteld en werd uitdrukkelijk niet beweerd dat er een testrun was uitgevoerd.
{
  "root_cause": "scores.filter(Boolean) verwijdert alle falsy-waarden, inclusief de numerieke score 0, dus normalize([0, 4, null, undefined]) verwijdert de 0 en retourneert [4] in plaats van [0, 4]. Het predikaat is te breed; het zou alleen null en undefined moeten uitsluiten.",
  "unified_diff": "--- a/normalize.js\n+++ b/normalize.js\n@@ -1,3 +1,3 @@\n function normalize(scores) {\n-  return scores.filter(Boolean);\n+  return scores.filter((score) => score != null);\n }",
  "expected_test_results": "normalize([0, 4, null, undefined]) zou [0, 4] moeten retourneren, omdat score != null alleen onwaar is voor null en undefined, dus 0 blijft behouden. normalize([7]) zou [7] moeten retourneren, ongewijzigd. Dit zijn verwachtingen op basis van het lezen van de code; er is geen test uitgevoerd.",
  "remaining_risk": "Andere falsy-waarden die voorheen werden weggefilterd (NaN, lege tekenreeks, false) worden nu behouden, wat overeenkomt met de gestelde eis (alleen null/undefined verwijderen), maar kan als een gedragsverandering naar voren komen als een aanroeper vertrouwde op de oude filtering. Als de invoer geen array kan zijn, genereert de functie nog steeds een fout, net als voorheen."
}Het antwoord bracht de ingediende claims in kaart, stelde het conflict tussen $18.000 en $20.000 vast en liet de oorzaak onopgelost in plaats van er een te verzinnen.
{
  "claims": [{"claim":"Het proefproject ging op 3 maart van start met 120 ingeschreven studenten.","source":"Document A","section":"A1","status":"vermeld"},{"claim":"De aanwezigheid werd wekelijks geregistreerd.","source":"Document A","section":"A2","status":"vermeld"},{"claim":"Bij de controle op 31 maart hadden 96 van de 120 ingeschreven studenten ten minste drie sessies bijgewoond.","bron":"Document B","sectie":"B1","status":"vermeld"},{"bewering":"Het programmabudget bedroeg $18.000.","bron":"Document B","sectie":"B2","status":"tegengesproken"},{"bewering":"In de financiële toelichting staat een goedgekeurd programmabudget van $20.000 vermeld.","bron":"Document C","sectie":"C1","status":"tegengesproken"},{"bewering":"In de toelichting wordt niet vermeld of het verschil in het budget het gevolg is van een herziening of een boekhoudkundige fout.","source":"Document C","section":"C2","status":"vermeld"}],
  "tegenstrijdigheden": [{"onderwerp":"Programmabegroting","bronnen":[{"bron":"Document B","sectie":"B2","waarde":"$18.000"},{"bron":"Document C","sectie":"C1","waarde":"$20.000"}],"beschrijving":"In document B staat dat de programmabegroting $18.000 bedroeg, terwijl in document C een goedgekeurde programmabegroting van $20.000 wordt vermeld."}],
  "onopgelost": [{"kwestie":"Of het verschil van $2.000 tussen de begroting van $18.000 (Document B, B2) en de goedgekeurde begroting van $20.000 (document C, C1) het gevolg is van een herziening of een boekhoudkundige fout.","bron":"document C","sectie":"C2","reden":"In document C wordt expliciet vermeld dat de toelichting geen duidelijkheid verschaft over de oorzaak van het verschil, en geen enkel ander verstrekt document gaat hierop in."}]
}Het geverifieerde chat-eindpunt bood geen tools voor het schrijven van bestanden of voor validatie. De taak is daarom niet verzonden als test voor de modelkwaliteit, en er wordt geen output of score opgegeven.
In het antwoord werd het waargenomen verschil berekend en werd de ongefundeerde causale conclusie verworpen.
{
  "mean_control": {"value": 10, "units": "punten"},
  "mean_treatment": {"value": 14, "units": "punten"},
  "difference": {"value": 4, "units": "punten", "direction": "behandeling minus controlegroep"},
  "supported_conclusion": "In deze dataset had de behandelingsgroep een gemiddelde score die 4 punten hoger lag dan die van de controlegroep (14 versus 10 punten).",
  "unsupported_conclusion": "Dat de behandeling de 4 punten hogere score veroorzaakte; de groepen werden niet willekeurig ingedeeld en er werden geen basisscores verzameld, dus het verschil kan wijzen op reeds bestaande verschillen tussen de groepen.",
  "beperkingen": ["Niet-willekeurige groepsindeling, dus selectiebias kan niet worden uitgesloten", "Geen uitgangsscores, dus reeds bestaande verschillen tussen de groepen kunnen niet worden beoordeeld", "Zeer kleine steekproefomvang (n=4 per groep)", "Er is geen inferentiële statistiek berekend; het verschil is niet getoetst op statistische significantie", "Het observationele onderzoeksontwerp ondersteunt geen causale conclusies"]
}De PNG-run leverde de gelabelde waarden voor april op, maakte onderscheid tussen visuele schattingen en gelabelde waarden, en voorkwam ongefundeerde extrapolatie.
{
  "april_alpha": 30,
  "april_beta": 25,
  "trend": "Zowel Alpha als Beta stijgen gestaag elke maand van januari tot april, waarbij Alpha consequent ongeveer 5 uur boven Beta ligt (visueel geschat: jan ~15/10, feb ~20/15, mrt ~25/20, apr 30/25 zoals aangegeven).",
  "unsupported": ["De waarden voor april zijn expliciet in de grafiek aangegeven; de waarden voor januari, februari en maart zijn uitsluitend visuele schattingen", "Er worden geen gegevens weergegeven van na april of vóór januari, dus er kunnen geen uitspraken worden gedaan over andere maanden", "De eenheden worden aangeduid als studie-uren, maar er wordt geen bron, steekproefomvang of definitie van de alfa-/bètagroepen gegeven"]
}
Beperkingen op het gebied van veiligheid, gegevens en compatibiliteit
Fable 5.1 kan worden gebruikt om kwetsbaarheden in software op te sporen, maar volgens Anthropic is het niet bedoeld voor het ontwikkelen van exploits en kunnen bepaalde activiteiten met dubbel gebruik worden doorgestuurd naar Opus. Voor life-science-onderzoek en toegang tot Mythos gelden afzonderlijke beperkingen. Het bewaren van gegevens is routespecifiek: AWS-documentatie mag bijvoorbeeld niet worden gegeneraliseerd naar elke Claude- of API-route van derden.
Anthropic wijst ook op hiaten in de dekking van zijn eigen afstemming voor scenario’s met een zeer lange context, met meerdere agenten en met onmogelijke taken. Dat is een reden om een implementatie met hoge inzet te valideren aan de hand van je eigen, afgebakende taak, maar geen reden om de gedocumenteerde verbeteringen van het model te negeren.
Voor wie is Claude Fable 5.1 geschikt?
Probeer het eens als uw werk baat heeft bij zorgvuldige coderingsondersteuning, brongebonden synthese, controles op tegenstrijdigheden in documenten of het extraheren van tekst uit afbeeldingen. Controleer eerst of u een specifieke regionale implementatie, voorwaarden zonder gegevensbewaring, een agent die gebruikmaakt van tools of een directe Fable 5-vergelijking nodig hebt. Als u kiest voor een algemeen Claude-abonnement in plaats van API-toegang, dan is de afzonderlijke Claude AI-prijsgids legt het verschil tussen ‘plan’ en ‘API’ uit.
Claude Fable 5.1 Veelgestelde vragen
Wat is het praktische verschil tussen de Claude Fable 5.1 en de Mythos 5.1?
Anthropic beschrijft ze als hetzelfde onderliggende model met verschillende beveiligingsmaatregelen en toegangsregels. Fable 5.1 is de hier besproken route voor algemene beschikbaarheid. Mythos 5.1 is gereserveerd voor programma’s met vertrouwde toegang op het gebied van cyberbeveiliging en biowetenschappen, dus de mogelijkheden van Mythos zijn geen garantie voor een standaard Fable-account.
Kan ik Claude Fable 5.1 gebruiken in de Claude-app, of is dit alleen via de API mogelijk?
Trek geen conclusies over de toegang tot consumentenapps op basis van een API- of cloud aankondiging. Anthropic noemt zijn eigen platforms en grote cloudproviders als toegangsroutes, maar het plan, de regio, het quotum en de toolset zijn afhankelijk van de route. Controleer de exacte accountomvang die u van plan bent te gebruiken voordat u een workflow hieromheen aanpast.
Wat is het juiste modelnummer van de Claude Fable 5.1?
Anthropic-lijsten claude-fabel-5-1 voor de API. Cloudproviders kunnen routespecifieke identificatiecodes gebruiken; kopieer daarom de model-ID uit de documentatie van de provider voor het eindpunt dat je daadwerkelijk aanroept.
Heeft Claude Fable 5.1 een contextvenster van 1 miljoen tokens?
AWS vermeldt voor zijn Bedrock-route een contextvenster van 1 miljoen tokens en een maximale uitvoer van 128K. Dat is nuttig bij het plannen van Bedrock, maar het mag niet zonder meer worden toegepast op elke Claude-API, consument of route van een derde partij zonder de bijbehorende documentatie te raadplegen.
Kan Fable 5.1 afbeeldingen verwerken en genereren?
AWS documenteert tekst- en afbeeldingsinvoer met tekstuitvoer voor de Bedrock-route. Dat betekent dat het herkennen van afbeeldingen daar wordt beschreven; het betekent niet dat het model een afbeeldingsgenerator is of dat elke route dezelfde formaten accepteert. Bij onze API-test met beperkte invoer werkte PNG-invoer nadat SVG door de verzoeklaag was afgewezen.
Wanneer maakt de lagere prijs voor cache-lezen een verschil?
Het maakt wel degelijk uit wanneer dezelfde uitgebreide context bij meerdere verzoeken wordt hergebruikt: bijvoorbeeld een doorlopende opdrachtomschrijving, een beleidscorpus of een uitgebreid onderzoekspakket. Bij afzonderlijke korte prompts zijn het normale invoer- en uitvoervolume de belangrijkste kostenpost. Gebruik de bovenstaande calculator als schatting voor je planning en vergelijk deze vervolgens met het daadwerkelijke cachegedrag van je route.
Kan Fable 5.1 zelfstandig een agent uitvoeren die gereedschap gebruikt?
Dat hangt af van de omgeving rondom het model. Een eindpunt voor het aanvullen van chatberichten kan een gedegen tekstantwoord geven zonder dat er gebruik wordt gemaakt van bestandsschrijven, validatoren, browsen of een repository-sandbox. Onze testroute maakte geen gebruik van die tools, dus werd deze niet gebruikt om te beweren dat er sprake was van uitvoering door een autonome agent.
Is Claude Fable 5.1 echt beter dan Fable 5?
Anthropic laat taakspecifieke prestatieverbeteringen en lagere kosten voor cache-leesbewerkingen zien. Dat is een sterke reden om de upgrade te overwegen voor taken die vergelijkbaar zijn met die van jou, maar het is geen op zichzelf staand oordeel dat deze upgrade in alle gevallen de beste keuze is. In dit artikel is geen Fable 5-referentietest op dezelfde testomgeving uitgevoerd.
Bronnen: Aankondiging van de release van Anthropic; Aankondiging van AWS; Amazon Bedrock-modelkaart.