
De OpenAI Audio Speech API zet tekst om in gesproken audio via POST-https://api.openai.com/v1/audio/speech. Stuur een model, je invoertekst en een stem; sla het antwoord op als MP3 of een ander ondersteund audioformaat. Voor een nieuwe integratie waarvoor instructies nodig zijn over toon en voordracht, begin je met gpt-4o-mini-tts.
Een werkopdracht is slechts de eerste stap. Je hebt ook de juiste factureringseenheid nodig, een afspeelbaar uitvoerbestand en een plan voor lange scripts. Het nieuwere TTS-model van OpenAI maakt gebruik van tekst- en audiotokens voor de prijsbepaling; de oudere TTS-modellen van OpenAI werken op basis van tekens. Dat verschil is van belang bij het maken van een schatting voor een maand aan vertelwerk.
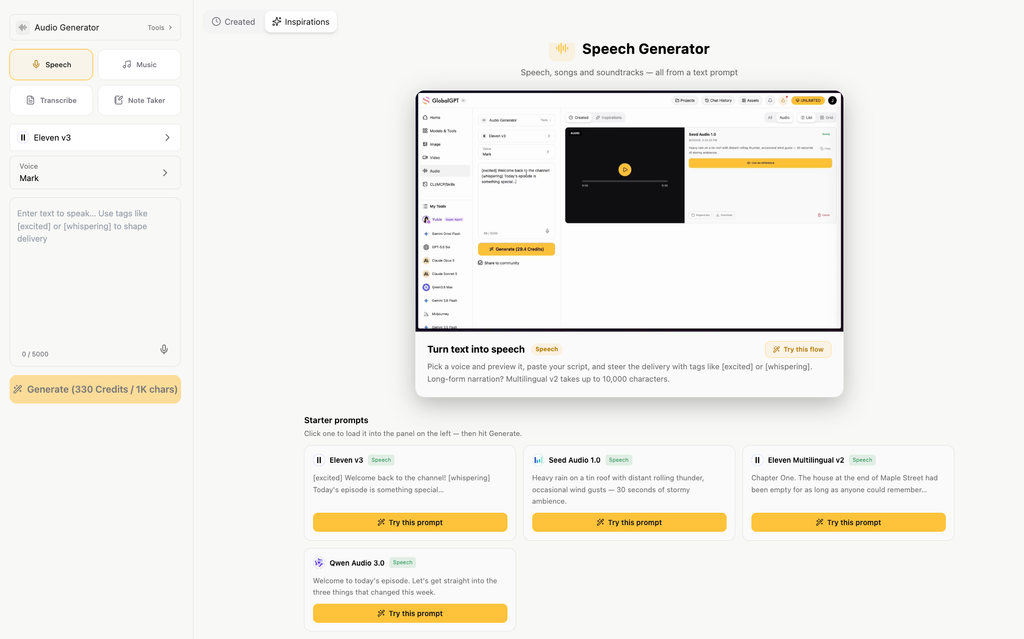
Als je werk ook het schrijven van het script, het maken van beeldmateriaal en het monteren van een video omvat, De audio-werkruimte van GlobalGPT maakt spraakgeneratie toegankelijk via een betaalbaar abonnementsplatform voor meerdere modellen. Je kunt vanuit één dashboard werken met tekst, spraak, afbeeldingen en video, en vervolgens de API en CLI gebruiken voor herhaalbare productiewerkzaamheden. De openbare TTS-API maakt gebruik van een aparte taakworkflow, die hieronder wordt beschreven.
Wat doet de OpenAI Audio Speech API?
De Speech API is een tekst-naar-spraak-eindpunt: uw applicatie levert geschreven tekst aan en ontvangt gegenereerde spraak. Typische toepassingen zijn onder meer productdemonstraties, toegankelijkheidscommentaar, lesmateriaal en korte voice-overs. U kunt de tekst controleren voordat deze wordt uitgesproken, wat handig is wanneer de bewoordingen moeten voldoen aan een goedgekeurd script.
Bij transcriptie is de volgorde omgekeerd: de opgenomen audio gaat erin en er komt tekst uit. Een live spraakassistent stelt nog een extra eis: luisteren en reageren in de vorm van een gesprek. OpenAI’s audiodocumentatie scheidt deze workflows van elkaar. Kies het Speech-eindpunt als je de tekst die je wilt laten voorlezen al hebt.
De spraakgeneratie ondersteunt streaming, waardoor een applicatie audio in stukjes kan ontvangen. Het opslaan van die stream in een bestand zorgt er niet automatisch voor dat deze in een browser wordt afgespeeld of dat er een conversatieagent wordt aangemaakt; je applicatie zorgt nog steeds voor het afspelen en de eventuele conversatielogica. OpenAI vereist ook dat luisteraars duidelijk worden geïnformeerd dat de stem door AI is gegenereerd.
Maak je eerste audiobestand met de OpenAI Speech API
Voer het verzoek uit op een server of op je ontwikkelingscomputer, met een OpenAI-API-sleutel die is opgeslagen in het OPENAI_API_KEY omgevingsvariabele. Gebruik de sleutel niet in JavaScript binnen de browser. In de volgende voorbeelden wordt hetzelfde korte script voor de productrondleiding gebruikt en wordt het resultaat opgeslagen als openai-product-tour.mp3.
Optie 1: een curl-verzoek uitvoeren
OpenAI Speech API · curl
#!/bin/sh
# Stel eerst OPENAI_API_KEY in je serveromgeving in.
curl --fail-with-body --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "Welkom bij de producttour van Acorn Studio. In drie stappen kun je een kort script omzetten in een audiogids. Schrijf eerst het bericht. Kies vervolgens een stem. Sla ten slotte het audiobestand op en test het afspelen op je telefoon.",
    "voice": "coral",
    "instructions": "Spreek duidelijk op een warme, gemoedelijke toon.",
    "response_format": "mp3"
  }' \
  --output openai-product-tour.mp3
Het antwoord bevat audiofragmenten, dus sla het op in een bestand in plaats van te proberen het als JSON te parseren. De --fail-with-body Deze optie zorgt ervoor dat curl bij een HTTP-fout een foutstatus retourneert. Controleer die status voordat je het bestand opent: bij een foutmelding kan er nog steeds JSON in het bestand met de naam .mp3.
Optie 2: gebruik de Python SDK
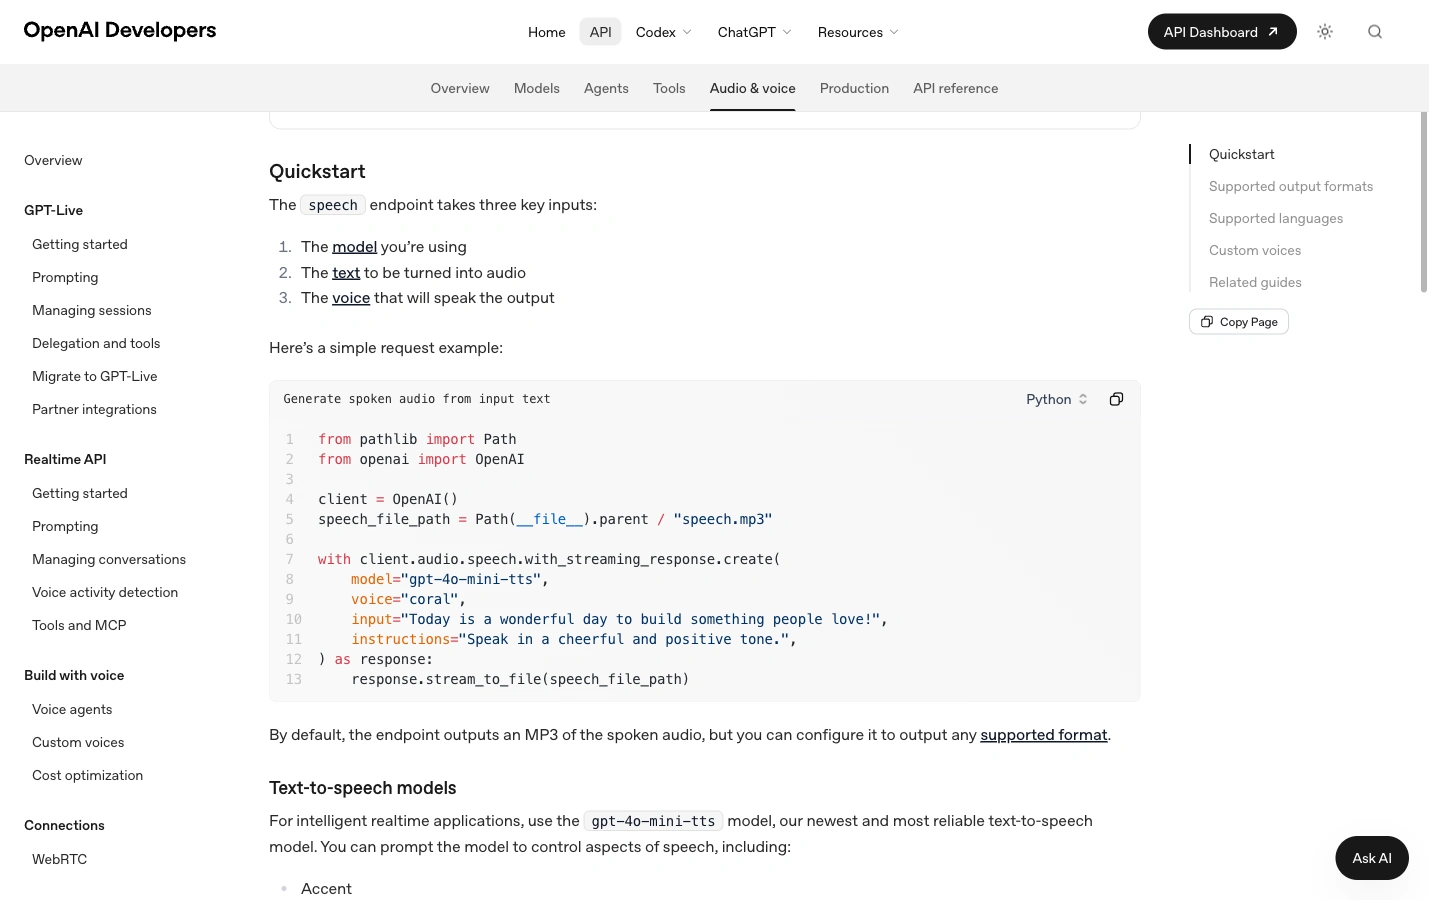
Installeer het OpenAI-pakket met python -m pip install openai. De SDK leest de API-sleutel uit de omgeving. In dit voorbeeld wordt het antwoord direct bij ontvangst weggeschreven, waardoor wordt voorkomen dat het volledige audio-antwoord in je eigen Python-buffer wordt geladen.
OpenAI Speech API · Python
"""Installatie: python -m pip install openai. Stel OPENAI_API_KEY in op de server."""
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
script = (
    "Welkom bij de producttour van Acorn Studio. In drie stappen kun je "
    "een kort script omzetten in een audiogids. Schrijf eerst het bericht. Kies vervolgens "
    "een stem. Sla ten slotte het audiobestand op en test het afspelen op je telefoon."
)

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=script,
    instructions="Spreek duidelijk op een warme, gemoedelijke toon.",
    response_format="mp3",
) as response:
    response.stream_to_file(Path("openai-product-tour.mp3"))

print("openai-product-tour.mp3 opgeslagen")
De drie essentiële gebieden zijn model, invoer, en stem. Hier, instructies vereist een warme, conversatieachtige voordracht; het stuurt de stem aan in plaats van woorden aan de gesproken tekst toe te voegen. Dit veld werkt met GPT-4o Mini TTS en wordt niet ondersteund door tts-1 en tts-1-hd.
Bij een langer document verdeel je de tekst op zins- of alinea-grenzen, nummer je de segmenten en sla je elke uitvoer op onder dat nummer. Zorg ervoor dat de toon en de instructies in alle segmenten hetzelfde blijven. Laat voldoende context over voor een natuurlijke formulering en luister goed naar de overgangen voordat je de samengestelde opname verspreidt.
Kies een model, een stem en een uitvoerformaat
| Model | Hoe kies je? | Leveringsinstructies |
|---|---|---|
gpt-4o-mini-tts | Een uitgangspunt voor een beheersbare vertelstijl en spreekwijze. | Ondersteunt instructies wat betreft toon, stijl en tempo. |
tts-1 | OpenAI maakt dit model geschikt voor spraakgeneratie met een lagere latentie. | Gebruik de ondersteunde spraak- en snelheidsbedieningen; laat weg instructies. |
tts-1-hd | OpenAI zorgt ervoor dat dit model spraak van hogere kwaliteit levert dan TTS-1. | Gebruik de ondersteunde spraak- en snelheidsbedieningen; laat weg instructies. |
De GPT-4o Mini TTS-modelpagina koppelt de modelalias aan de gpt-4o-mini-tts-15-dec-2025 snapshot. Als reproduceerbaar gedrag belangrijk is voor je toepassing, kies dan bewust een gedocumenteerde snapshot en bewaar deze samen met je opgeslagen scripts.
Ingebouwde stemmen en invoerlimieten
In de Speech API-referentiegids worden 13 ingebouwde stemmen voor de GPT-4o Mini TTS vermeld: legering, as, ballade, koraal, echo, fabel, onyx, nova, salie, glans, vers, marin en ceder. OpenAI adviseert marin of ceder voor de beste kwaliteit. Dat is de aanbeveling van OpenAI: kies je stem voor de opname door te luisteren naar je eigen naam, getallen en zinspatronen.
De oudere TTS-modellen ondersteunen een kleiner aantal: alloy, ash, coral, echo, fable, onyx, nova, sage en shimmer. Ga er niet vanuit dat elke stem met elk model werkt. De Referentie voor de Speech API accepteert ook een snelheid tussen 0,25 en 4,0, met 1.0 als standaardinstelling.
Er zijn twee invoergrenzen waarmee rekening moet worden gehouden: de referentiewaarden voor de eindpunten invoer naar 4.096 tekens, en op de productpagina van de Mini TTS staat een maximum van 2.000 invoertokens. Tekens en tokens zijn verschillende eenheden. Controleer beide beperkingen voor Mini TTS, vooral bij meertalige tekst, en splits grote scripts op voordat je ze indient.
Kies het bestandsformaat voor de bestemming
| Formaat | Praktisch gebruik |
|---|---|
| MP3 | Standaarduitvoer: een handig gecomprimeerd bestand om te delen en op het web af te spelen. |
| Opus | Handig voor streaming- en communicatietoepassingen die deze codec ondersteunen. |
| AAC | Bedenk in welke gevallen je afspeelomgeving of mediaworkflow het gebruik van AAC vereist. |
| FLAC | Verliesvrije compressie voor workflows waarbij het audiosignaal behouden moet blijven. |
| WAV | Ongecomprimeerde audio in een vertrouwd bestandsformaat voor bewerking en verwerking. |
| PCM | Onbewerkte 24 kHz, 16-bits signed little-endian samples zonder bestandsheader; je speler moet op deze instellingen zijn ingesteld. |
Begin met MP3 als je een downloadlink of een eenvoudige audiospeler nodig hebt. Kies WAV als je in de volgende stap gaat bewerken. Selecteer ‘raw PCM’ alleen als je programma dit formaat kan interpreteren; het wijzigen van een bestandsnaam van .pcm naar .wav maakt geen WAV-header aan.
Wat kost de OpenAI Speech API?
Volgens de gegevens van 28 september 2026 vermeldt OpenAI de GPT-4o Mini TTS op $0,60 per miljoen tekstinvoer-tokens plus $12 per miljoen audio-outputtoken. Kosten van de TTS-1 $15 per miljoen tekens, en de TTS-1 HD kost $30 per miljoen tekens. Bereken elk model in zijn eigen eenheden.
Prijzen voor de Speech API: houd de eenheden apart
OpenAI rekent zijn nieuwere TTS-model per token en zijn twee eerdere TTS-modellen per teken. GlobalGPT geeft zijn TTS-opdrachten weer in credits.
| Route en model | Tarief | Voorbeeld |
|---|---|---|
| OpenAI · GPT-4o Mini TTS | $0.60 / 1 miljoen tekstinvoer-tokens $12 / 1M audio-uitgangstokens | $0.0606 voor 1.000 tekstinvoer-tokens + 5.000 audio-uitvoer-tokens |
| OpenAI · TTS-1 | $15 / 1 miljoen tekens | $0.015 voor 1.000 tekens |
| OpenAI · TTS-1 HD | $30 / 1 miljoen tekens | $0.030 voor 1.000 tekens |
| GlobalGPT · Eleven v3, Eleven Multilingual v2 of Qwen Audio 3.0 TTS Flash | 330 studiepunten / 1.000 tekens | 330 credits tegen het vermelde tarief van 1.000 tekens; vraag een prijsopgave aan voordat u uw opdracht indient |
Dit zijn prijsvoorbeelden, geen tarieven voor de onderstaande geluidsfragmenten. Tokens, tekens, minuten en credits zijn verschillende eenheden. In de taakraming GlobalGPT wordt het geldende aantal credits vermeld; in de tabel worden credits niet omgerekend naar dollars.
Tarieven gecontroleerd op 28 september 2026. Bronnen: Prijzen voor de OpenAI API en GlobalGPT API-documentatie.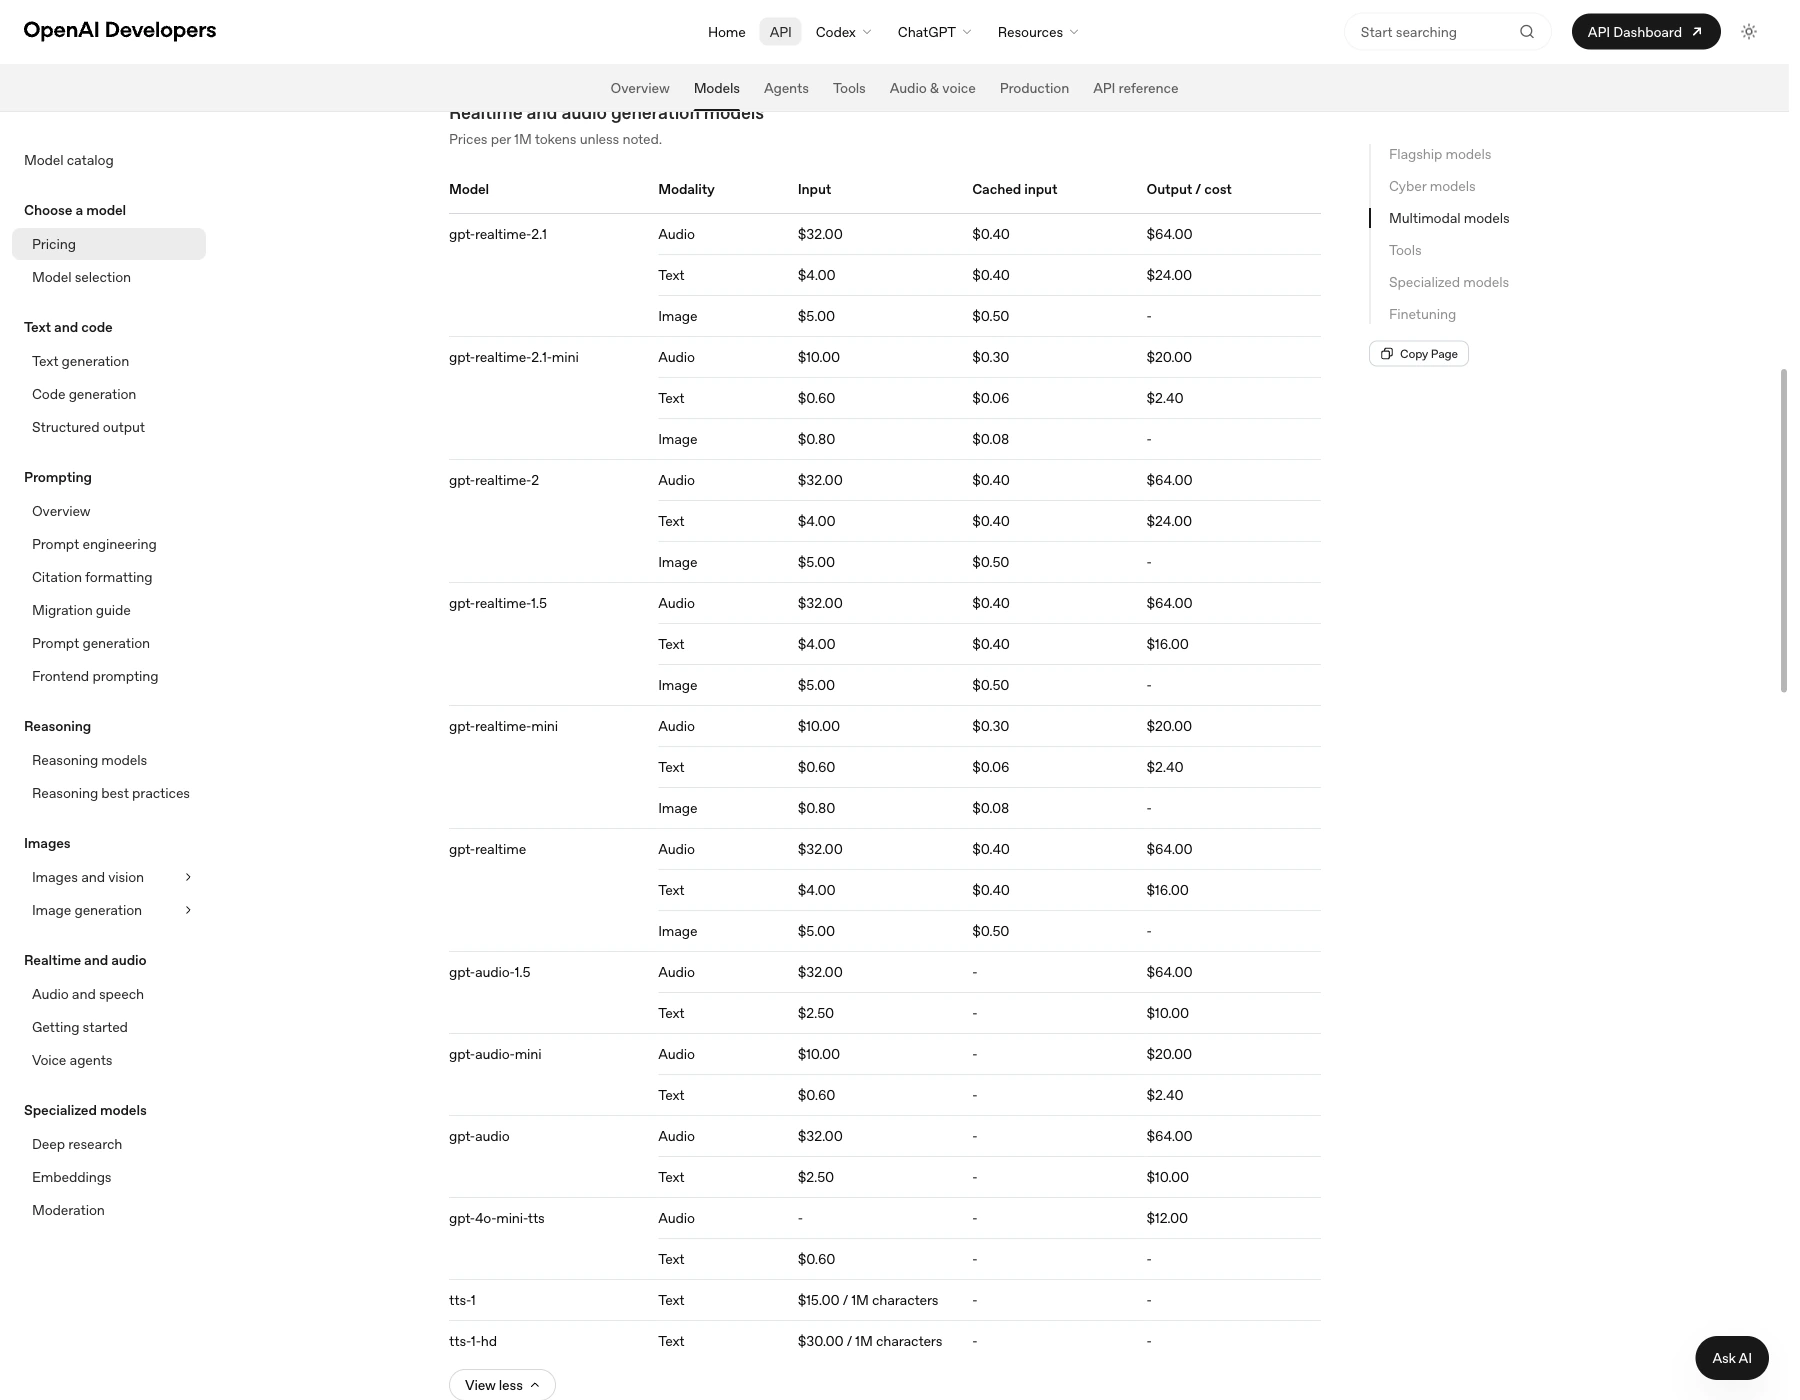
Zo zijn 100 scripts van elk 1.000 tekens samen goed voor 100.000 tekens. Tegen de vermelde tarieven komt dat neer op $1.50 met TTS-1 of $3.00 met TTS-1 HD, vóór andere applicatiekosten. Ditzelfde aantal tekens is onvoldoende om Mini TTS exact te berekenen: je hebt de aantallen tokens voor tekstinvoer en audio-uitvoer nodig.
Maak een schatting van de kosten voor het genereren van spraak
Voer de eenheden in die voor de door u gekozen route in rekening worden gebracht. Er vindt geen automatische omzetting plaats van tekens naar tokens of van minuten naar tokens.
Formule: aantal tekens × $15 ÷ 1.000.000. Het totale aantal tekens kan verspreid zijn over meerdere API-verzoeken.
Tarieven gecontroleerd op 28 september 2026: OpenAI · GlobalGPT. Exclusief opslag, hosting, belastingen en andere onderdelen van je applicatie.
Voer voor de planning de werkelijke gebruikscijfers of expliciete aannames in de calculator in. Beschouw het veld ‘Mini TTS-audio-token’ als een begrotingswaarde totdat u het daadwerkelijke gebruik hebt gemeten. Zet een geschat cijfer per minuut niet om in een gegarandeerde prijs voor elke stem, elk spreektempo of elke taal.
In de GlobalGPT-modelcatalogus worden TTS-prijzen uitgedrukt in credits, en het eindpunt voor schattingen geeft een prijsopgave voor het verzoek dat u van plan bent te verzenden. Houd het verbruik van API-credits gescheiden van de keuze voor een abonnement op een multi-model-werkruimte voor dagelijkse schrijf- en mediatoepassingen. Zo kunt u het budget gemakkelijker bijhouden, zonder ervan uit te gaan dat beide producten één factureringslimiet delen.
Een TTS-workflow opzetten met de GlobalGPT-API
Voor een herhaalbare workflow van script naar spraak naar video, spraak genereren in GlobalGPT en bewaar de rest van het project in dezelfde werkruimte. De GlobalGPT API stelt de mediageneratie voor als taken, terwijl de GlobalGPT CLI verbindingen die compatibel zijn met je terminal en ontwikkeltools.
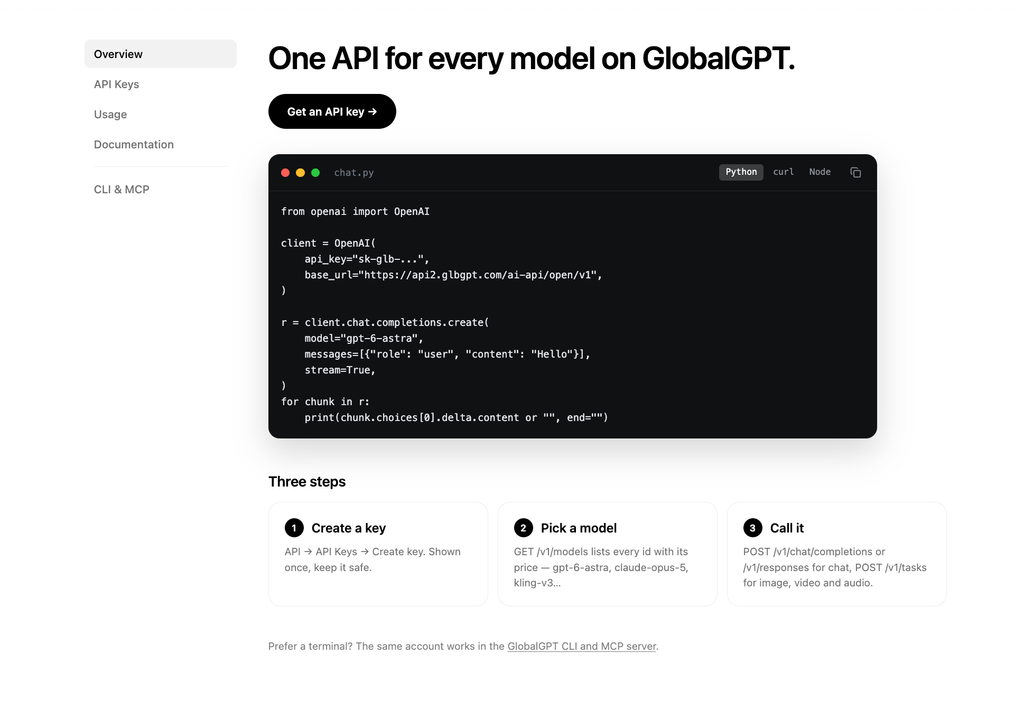
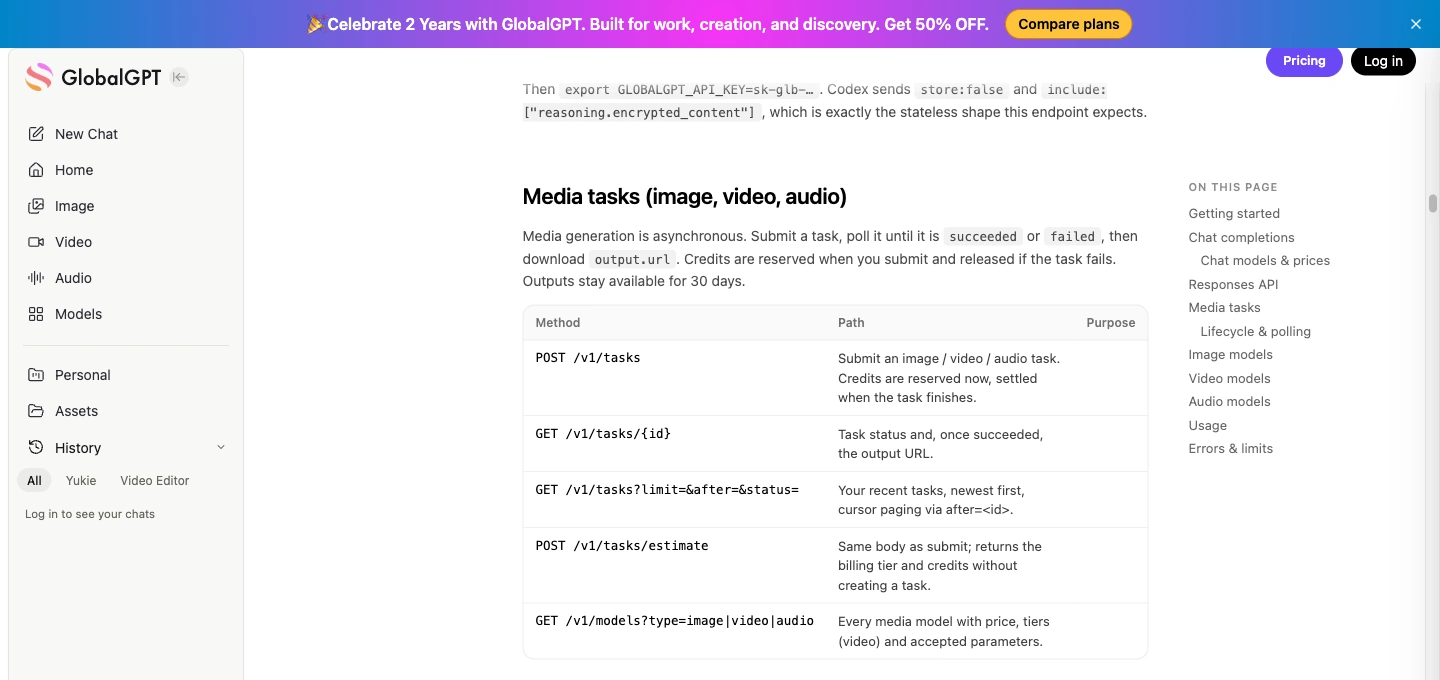
Gebruik de openbare basis-URL https://api2.glbgpt.com/ai-api/open/v1. Stuur TTS-verzoeken naar POST /taken, zoekopdracht GET /taken/{id}, en download output.url nadat de taak is geslaagd. Het tekstveld is prompt. Voer dit taakcontract direct uit; het verschilt van de onmiddellijke audiorespons van OpenAI.
Kies een gedocumenteerd GlobalGPT TTS-model
| Model-ID | Invoer en uitvoer | Nuttig onderscheid |
|---|---|---|
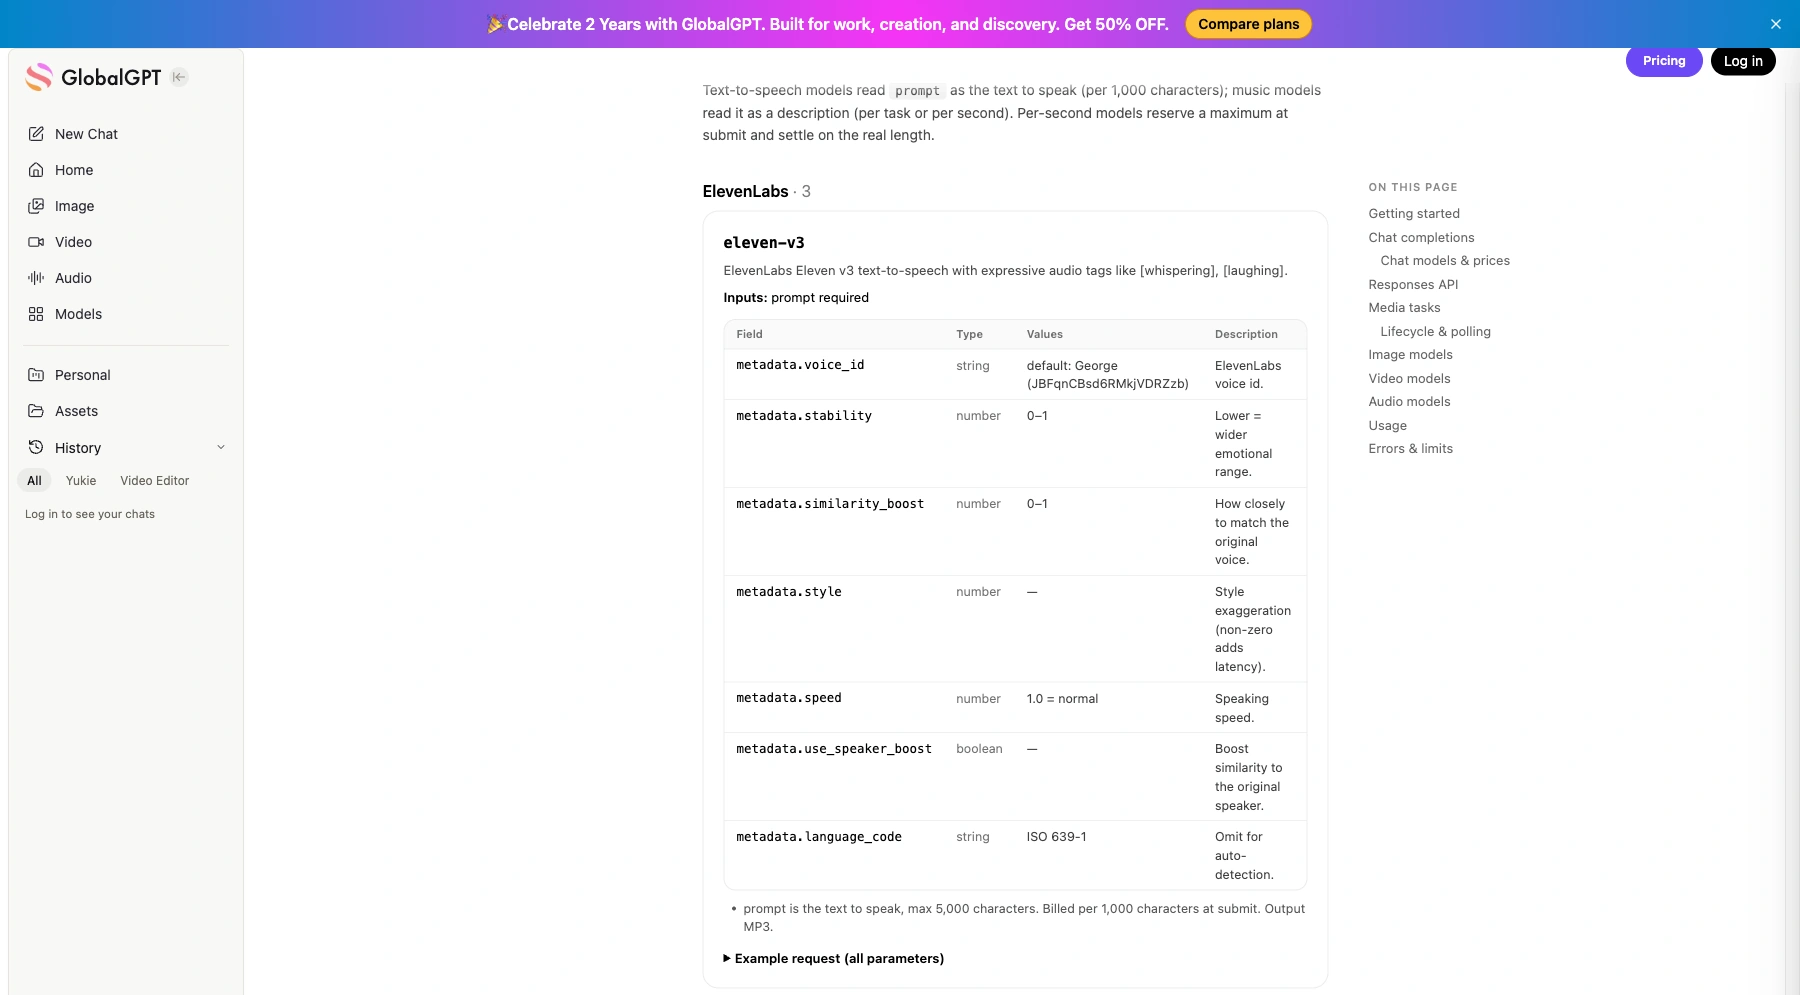
eleven-v3 | Maximaal 5.000 tekens; MP3 | Ondersteunt expressieve audiotags. |
eleven-meertalig-v2 | Maximaal 10.000 tekens; MP3 | 29 talen; audiotags worden als tekst voorgelezen. |
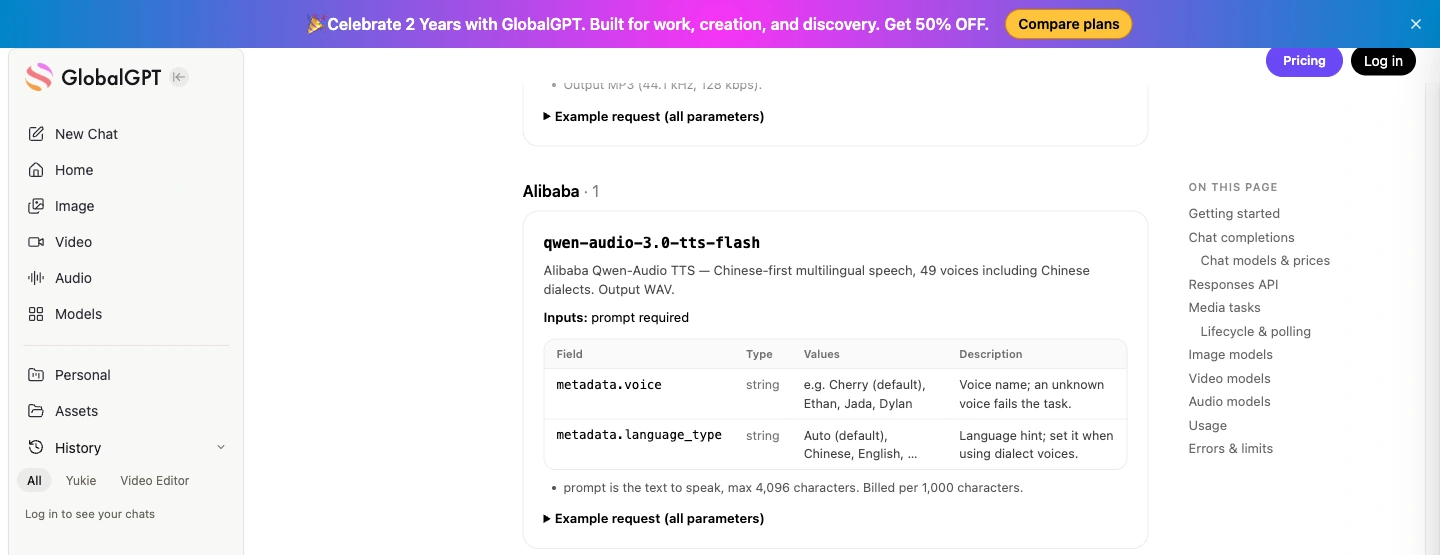
qwen-audio-3.0-tts-flash | Maximaal 4.096 tekens; WAV | 49 stemmen; voor de spraak- en taalbediening worden Qwen-specifieke velden gebruikt. |
Lijst met alle drie de vermeldingen 330 credits per 1.000 tekens. Gebruik POST /tasks/estimate met de beoogde verzoektekst voor de betreffende offerte; volgens de documentatie wordt hierdoor geen taak aangemaakt en worden er geen credits gereserveerd. Voor toegang tot de openbare API worden betaalde credits gebruikt.
Zie voor de bredere creatieworkflow text-to-speech-workflows in GlobalGPT. Als je onderzoek doet naar de apart genoemde open-source Qwen3-TTS-serie, lees dan Qwen3-TTS-modellen en API-opties; beschouw de hierboven genoemde model-ID Qwen-Audio niet als een uitwisselbare Qwen3-TTS-implementatie.
Maak een schatting, dien deze één keer in en bekijk vervolgens de opgeslagen taak
Installeer verzoeken met python -m pip install requests en stel in GLOBALGPT_API_KEY op de server. In het onderstaande voorbeeld wordt Eleven v3 gebruikt, wordt een gedocumenteerde openbare stem-ID geselecteerd en wordt ter illustratie een maximum van 500 credits ingesteld. Pas dat maximum aan uw eigen budget aan voordat u het programma uitvoert.
GlobalGPT openbare TTS-taak-API · Python
"""Installatie van requests; stel GLOBALGPT_API_KEY in. Maakt gebruik van de openbare taak-API van GlobalGPT."""
import json
import os
import time
import uuid
from pathlib import Path
import requests

BASE = "https://api2.glbgpt.com/ai-api/open/v1"
STATE = Path("globalgpt-tts-job.json")
OUTPUT = Path("globalgpt-product-tour.mp3")
MAX_CREDITS = 500  # Je maximum per taak; pas dit aan voordat je het script uitvoert.

payload = {
    "model": "eleven-v3",
    "prompt": (
 "Welkom bij de producttour van Acorn Studio. In drie stappen kun je "
 "een kort script omzetten in een audiogids. Schrijf eerst het bericht. Kies vervolgens "
 "een stem. Sla ten slotte het audiobestand op en test het afspelen op je telefoon."
    ),
    "metadata": {
 "voice_id": "JBFqnCBsd6RMkjVDRZzb",
 "stability": 0.5,
 "language_code": "en",
    },
}

api = requests.Session()
api.headers["Authorization"] = "Bearer " + os.environ["GLOBALGPT_API_KEY"]

if STATE.exists():
    job = json.loads(STATE.read_text())
    if job["payload"] != payload:
 raise RuntimeError("Deze taak hoort bij andere invoer. Gebruik een nieuwe bestandsnaam voor de status.")
else:
    estimate = api.post(BASE + "/tasks/estimate", json=payload, timeout=30)
    estimate.raise_for_status()
    quote = estimate.json()
    print("Geschatte credits:", quote["credits"])
    if quote["credits"] > MAX_CREDITS:
 raise RuntimeError("De schatting overschrijdt je limiet per taak.")
    job = {"payload": payload, "idempotency_key": str(uuid.uuid4())}
    STATE.write_text(json.dumps(job, indent=2))

if "task_id" not in job:
    # De opgeslagen sleutel koppelt een transportherpoging aan dit exacte verzoek.
    submitted = api.post(
 BASE + "/tasks", json=payload,
 headers={"Idempotency-Key": job["idempotency_key"]}, timeout=60,
    )
    submitted.raise_for_status()
    task = submitted.json()
    job["task_id"] = task["id"]
    STATE.write_text(json.dumps(job, indent=2))
    if task.get("ignored_parameters"):
 print("Genegeerde parameters:", task["ignored_parameters"])

print("Taak:", job["task_id"])
deadline = time.monotonic() + 600
while time.monotonic() < deadline:
    checked = api.get(BASE + "/tasks/" + str(job["task_id"]), timeout=30)
    checked.raise_for_status()
    task = checked.json()
    if task.get("ignored_parameters"):
 print("Genegeerde parameters:", task["ignored_parameters"])
    if task["status"] == "failed":
 raise RuntimeError("Genereren mislukt: " + json.dumps(task.get("error", {})))
    if task["status"] == "succeeded":
        # Gebruik een nieuw verzoek: stuur de API-sleutel niet naar de mediahost.
 audio = requests.get(task["output"]["url"], timeout=60)
 audio.raise_for_status()
        OUTPUT.write_bytes(audio.content)
 print("Opgeslagen:", OUTPUT)
 break
    time.sleep(10)
else:
    raise TimeoutError("Taak nog in behandeling. Voer de taak opnieuw uit om de opgeslagen taak-ID op te vragen.")
Het taakbestand slaat het exacte verzoek, een idempotentiesleutel en de taak-ID op. Als de verbinding wordt verbroken, voer je dezelfde taak opnieuw uit, zodat de code de bestaande taak kan hervatten. Gebruik een nieuwe bestandsnaam voor de taak als je bewust andere audio wilt genereren. Houd het taakbestand privé als het script vertrouwelijke informatie bevat.
Controleer genegeerde_parameters zodat een niet-ondersteunde instelling niet stilletjes je standaardconfiguratie wordt. ElevenLabs-instellingen zoals voice_id verschillen van die van Qwen stem en taaltype velden. Controleer elke 5–10 seconden, verwerk een mislukt status, en sla de bestanden die met succes zijn opgeslagen onmiddellijk op: de gedocumenteerde bewaartermijn van de resultaten is 30 dagen.
Luister naar twee voorbeelden van productrondleidingen
Deze twee door AI gegenereerde voorbeelden maken gebruik van hetzelfde productrondleiding-script van 216 tekens, met Eleven v3 en Qwen Audio 3.0 TTS Flash. Beide zijn de eerste uitvoer van één verzoek, met standaard steminstellingen. Ze bieden u twee korte bestanden om te bekijken en te beluisteren; het gaat hier niet om een gecontroleerde vergelijking van op elkaar afgestemde stemmen of een OpenAI-stembenchmark.
Eleven v3: audio bij de productrondleiding
eleven-v3 · voorbeeld van een productrondleiding
- Uitgang
- MP3 · mono · 44,1 kHz
- Lengte
- Ongeveer 15,6 seconden
- Generatie
- Eerste uitvoer · 1 verzoek
Instellingen: de onderstaande exacte tekst, de standaardstem en andere instellingen; geen overschrijving van de stem of uitspraakinstructies. De standaardstemidentiteit is niet opgenomen.
Status en tijdschema: het genereren is gelukt. Uit de tijdstempels van de server blijkt dat er 13 seconden verstreken zijn tussen het indienen en de voltooiing; dit betreft één verzoek, geen latentietest.
Opmerking bij het bestand: Het MP3-bestand bevat een monostream met een frequentie van 44,1 kHz en is ongeveer 251 kB groot. De frames kunnen tot het einde van het bestand worden gelezen.
Kostenoverzicht: Het tarief in de openbare catalogus bedraagt 330 credits per 1.000 tekens. Gebruik een schatting van de benodigde tijd voor een nieuwe aanvraag; dit tarief geldt niet voor de factuur van het voorbeeld.
Praktische toepassing: Een compact MP3-bestand om een korte productpresentatie te beluisteren. Controleer de volledige tekst en het afspelen op het doelapparaat voordat je het in een release gebruikt.
Lees de exacte invoer · 216 tekens
Welkom bij de productrondleiding van Acorn Studio. In drie stappen kun je een kort script omzetten in een audiogids. Schrijf eerst de tekst. Kies vervolgens een stem. Sla ten slotte het audiobestand op en test het afspelen op je telefoon.
Qwen Audio 3.0 TTS Flash: audio voor productrondleiding
qwen-audio-3.0-tts-flash · voorbeeld van de productrondleiding
- Uitgang
- WAV · mono · 24 kHz
- Lengte
- 15,52 seconden aan PCM-gegevens
- Generatie
- Eerste uitvoer · 1 verzoek
Instellingen: de onderstaande exacte tekst, de standaardstem en andere instellingen; geen overschrijving van de stem of uitspraakinstructies. De standaardstemidentiteit is niet opgenomen.
Status en tijdschema: het genereren is gelukt. Uit de tijdstempels van de server blijkt dat er 17 seconden zijn verstreken tussen het indienen en de voltooiing; dit betreft één verzoek, geen latentietest.
Opmerking bij het bestand: Het WAV-bestand bevat mono, 16-bits PCM bij 24 kHz en is ongeveer 745 kB groot. In de header wordt meer gegevens aangegeven dan het bestand daadwerkelijk bevat; de oorspronkelijke uitvoer is hier behouden.
Kostenoverzicht: Het tarief in de openbare catalogus bedraagt 330 credits per 1.000 tekens. Gebruik een schatting van de benodigde tijd voor een nieuwe aanvraag; dit tarief geldt niet voor de factuur van het voorbeeld.
Praktische toepassing: Een WAV-voorbeeldbestand voor het evalueren van een workflow voor gesproken commentaar. Los de inconsistentie in de lengte van de koptekst in je productiepijplijn op en controleer of het bestand volledig kan worden afgespeeld voordat je het verspreidt.
Lees de exacte invoer · 216 tekens
Welkom bij de productrondleiding van Acorn Studio. In drie stappen kun je een kort script omzetten in een audiogids. Schrijf eerst de tekst. Kies vervolgens een stem. Sla ten slotte het audiobestand op en test het afspelen op je telefoon.
Het Qwen-voorbeeld is bij een vergelijkbare duur ongeveer drie keer zo groot als het Eleven-voorbeeld, wat te maken heeft met de verschillende WAV- en MP3-formaten. De WAV-header geeft bovendien aan dat er meer gegevens zijn dan het bestand fysiek bevat. Dat is een probleem met de bestandsindeling dat u in uw doelspeler moet controleren; het zegt op zichzelf niets over de kwaliteit van de gesproken stem.
Veelvoorkomende problemen bij het genereren van spraak oplossen
| Symptoom | Wat moet je als eerste controleren? |
|---|---|
| De opgeslagen MP3-bestand kan niet worden afgespeeld | Controleer de HTTP-status en het responstype. Mogelijk is er een API-fout opgeslagen met een audio-extensie. |
| Het verzoek wijst een spraakopdracht of instructie af | Koppel de stem en de optionele velden aan het geselecteerde model. Oudere OpenAI TTS-modellen ondersteunen geen instructies. |
| Een lang script wordt afgewezen | Controleer het maximale aantal tekens voor de route en de limiet voor Mini TTS-tokens, en splits de tekst vervolgens op natuurlijke scheidingspunten. |
| Er verschijnt een 401- of 429-respons | Controleer de sleutel/het account op foutcode 401. Bij foutcode 429 moet je, voordat je het opnieuw probeert, onderscheid maken tussen tarieflimieten en onvoldoende quota. |
| Een GlobalGPT-verzoek is nog in behandeling | Vraag het ID van de opgeslagen taak op en controleer de status; een time-out is geen reden om een dubbele taak in te dienen. |
| De stem komt niet overeen met de opgegeven instellingen | Controleer de modelspecifieke metagegevens en de `ignored_parameters` voordat je ervan uitgaat dat de instelling is toegepast. |
| De duur van een audiobestand of de schuifbalk ziet er niet goed uit | Vergelijk de metagegevens van het bestand met de daadwerkelijke media-inhoud en test het volledige bestand in de gewenste speler. |
Bij een OpenAI-fout begin je met de richtlijnen voor foutcodes. Sla bij een GlobalGPT-taak het taak-ID en de details van de gerapporteerde fout op. Houd tijdens de ontwikkeling transportfouten, factureringsfouten en een onbevredigende spraakopname apart: voor elk daarvan is een andere oplossing nodig.
Luister, voordat je de gesproken tekst verstuurt, de hele opname af op het apparaat dat je publiek zal gebruiken. Controleer de inleiding, namen en getallen, overgangen en de slotzin. Voeg vlak voor het afspelen een vermelding van het gebruik van een AI-stem toe en bewaar een kopie van de exacte tekst en de modelinstellingen, zodat een bewerkt script opzettelijk opnieuw kan worden gegenereerd.
Veelgestelde vragen
Wat is het OpenAI Audio Speech API-eindpunt?
Gebruik POST https://api.openai.com/v1/audio/speech. De verplichte velden zijn model, input en voice. Het antwoord is een gegenereerd geluidsbestand; MP3 is het standaardformaat.
Is de OpenAI Speech API gratis?
De Speech API hanteert een prijsmodel op basis van gebruik. Houd bij uw budgettering rekening met de huidige API-tarieven in plaats van uit te gaan van een gratis quotum: voor GPT-4o Mini TTS wordt gefactureerd op basis van tokens voor tekstinvoer en audio-uitvoer, terwijl voor TTS-1 en TTS-1 HD per teken wordt gefactureerd.
Kan ik de stem en de spreekstijl aanpassen?
Kies een stem die door uw model wordt ondersteund. GPT-4o Mini TTS accepteert ook instructies voor de manier van spreken, zoals een warme of rustige toon. Het instructieveld werkt niet met TTS-1 of TTS-1 HD.
Ondersteunt de Speech API streaming?
Ja. Het kan gegenereerde audio in stukjes streamen. Je applicatie moet het afspelen nog wel zelf regelen; het streamen van tekst-naar-spraak alleen is niet voldoende voor een volledig live spraakgesprek.
Kan ik GlobalGPT gebruiken door de basis-URL van OpenAI aan te passen?
Gebruik de gedocumenteerde workflow voor mediataken van GlobalGPT voor TTS: verstuur de opdracht via POST /tasks, controleer de status via GET /tasks/{id} en download output.url na succesvolle afhandeling. De gedocumenteerde TTS-catalogus bevat de modellen ElevenLabs en Qwen, elk met hun eigen model-ID’s en parameters.
Met welk audioformaat moet ik beginnen?
Begin met MP3 voor een eenvoudige download of een webspeler. WAV is handig als je het bestand daarna wilt bewerken. Voor onbewerkte PCM heb je een speler nodig die is ingesteld op de samplefrequentie en bitdiepte van het bestand, omdat het geen bestandsheader heeft.
Begin met één kort script, één stem en één opgeslagen bestand. Zodra het afspelen en de kosten voorspelbaar zijn, voeg je dan chunking, herhalingspogingen en de rest van je mediaworkflow toe. Zorg ervoor dat het verzoekformaat, de factureringseenheden en de verwerking van de uitvoer van de gekozen API’s in je implementatie op één lijn blijven.
Geef je volgende script een stem
Stel een korte producttour op, maak een voice-over met ElevenLabs of Qwen en ga verder met afbeeldingen en video in de multimodale werkruimte van GlobalGPT.
Maak spraakopnames met GlobalGPT








